Database · PAPER · 2026
Your Embedding Model is SMARTer Than You Think
요약
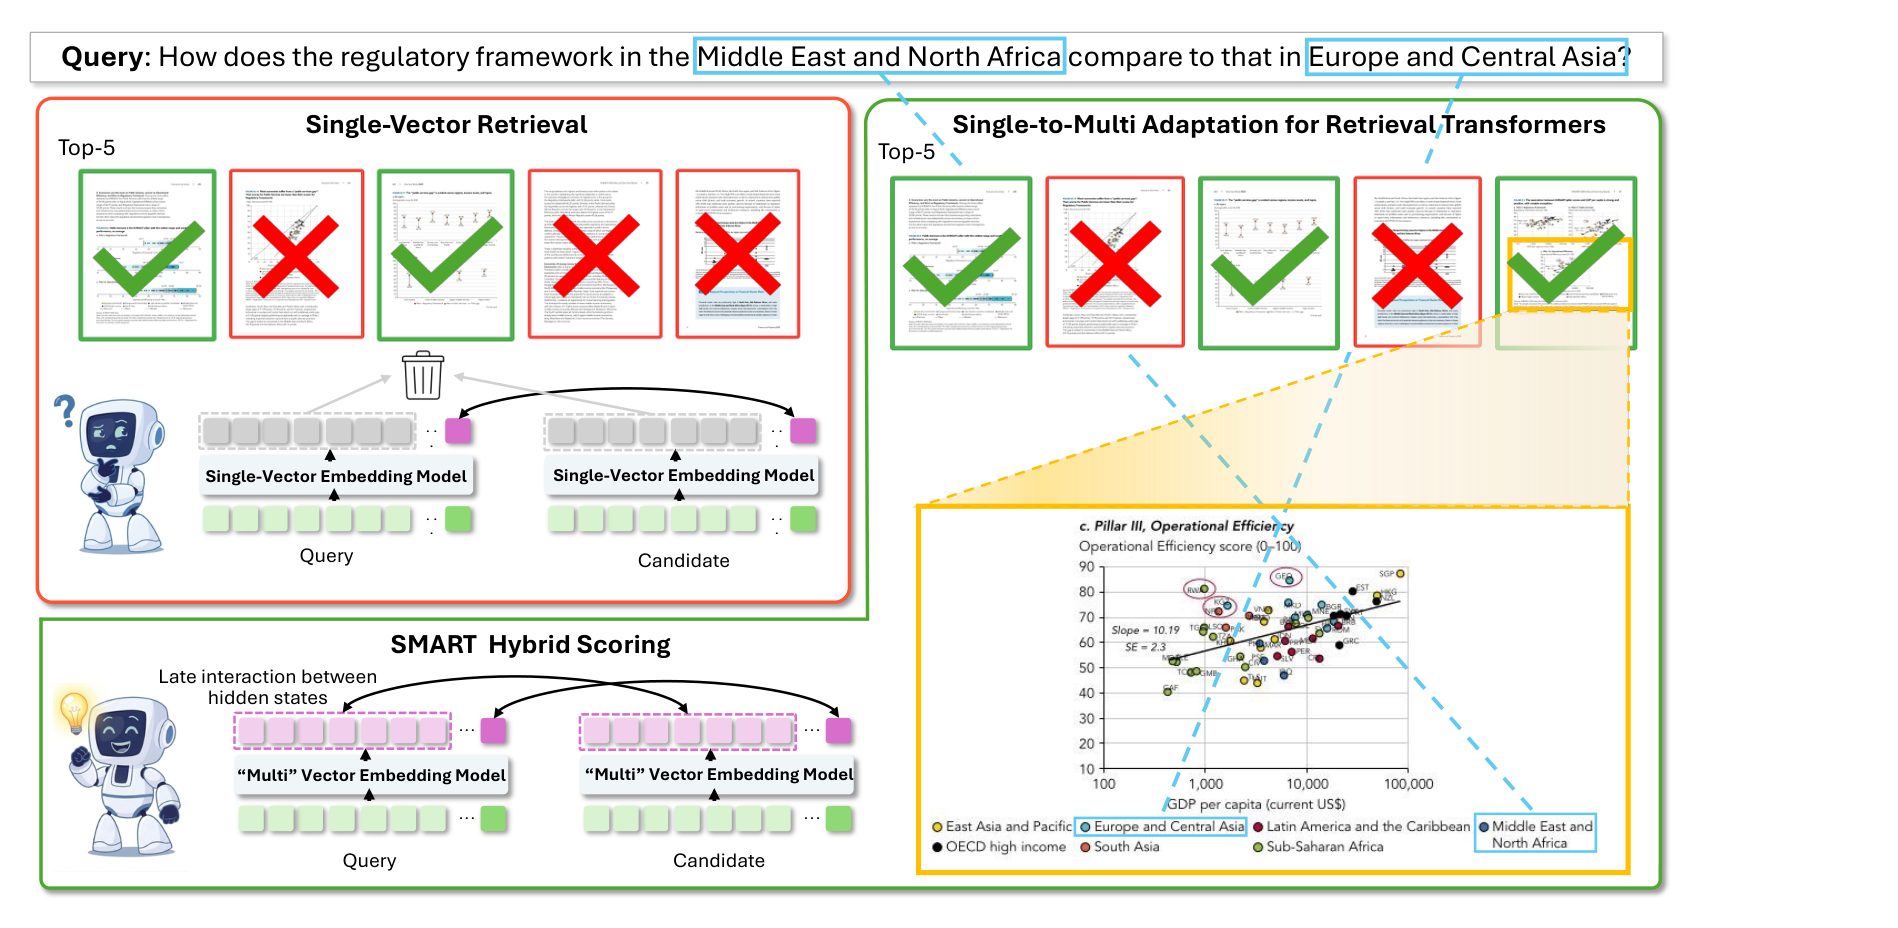
SMART는 이미 학습이 끝난 single-vector 임베딩 모델을 추가 학습 없이 multi-vector 검색기처럼 쓰게 만드는 방법이다. 모델을 바꾸지도, 데이터를 다시 모으지도 않고, 모델이 이미 계산해 놓았지만 버리고 있던 중간 표현을 점수 계산에 다시 끌어들이는 것이 전부다.
출발점은 gradient 경로에 대한 관찰이다. 임베딩 모델을 학습시키는 contrastive loss는 겉보기에 pooling 토큰 하나에만 걸린다. 그런데 그 pooling 토큰의 값은 시퀀스의 모든 토큰이 attention과 residual을 거쳐 만들어 낸 결과이므로, 나머지 토큰들도 전부 gradient 경로 위에 있다. 게다가 loss가 cosine similarity로 정의되어 있어서, 이 간접적인 학습 신호는 나머지 토큰 표현들까지 cosine 검색에 잘 맞는 기하 구조로 정렬시킨다.
저자들이 제안하는 조작은 단순하다. 마지막 층의 non-pooling hidden state에 ColBERT의 MaxSim late interaction을 적용해 토큰 단위 점수 s_late를 얻고, 원래 pooled 점수 s_single에 가중치 없이 그냥 더한다. 두 점수가 같은 마지막 층 cosine 공간에서 나오므로 rescaling도 hyperparameter도 필요 없다는 것이 이 설계의 근거다.
효과는 세 단계로 확인된다. 파라미터를 하나도 갱신하지 않은 상태에서 MMEB-V2의 backbone 다섯 종이 모두 개선되었고, 최상위 모델인 Qwen3-VL-Embedding-8B도 78.83%에서 79.34%로 올랐다. backbone을 동결한 채 작은 adapter 하나를 1시간 50분 학습시키면 2B 모델이 시각 문서 검색에서 81.25%를 기록해 4B짜리 multi-vector 최상위 모델 jina-embeddings-v4의 80.91%를 0.34%p 앞선다. LoRA로 아예 변환하면 처음부터 multi-vector를 학습하는 12시간짜리 경로보다 학습 시간이 약 20% 적으면서 성능은 약 0.63점만 뒤진다.
배경
single-vector 검색의 구조
멀티모달 임베딩 모델은 텍스트 토큰, 시각 토큰, special 토큰이 섞인 긴 시퀀스를 처리한다. 그런데 학습도 사용도 그보다 훨씬 좁은 창구를 거친다. 표준 contrastive 학습은 지정된 pooling 표현 하나에만 supervision을 준다.
pooling 표현으로는 보통 end-of-text 토큰의 마지막 층 hidden state를 쓴다. 이 논문은 이를 <eot> 토큰으로 표기한다. 학습 목적함수는 InfoNCE loss이고, query와 양성 후보의 pooled 점수를 올리고 음성 후보들의 점수를 내린다.
검색 시점에도 같은 readout을 쓴다. query와 후보가 각각 normalize된 벡터 하나로 접히고, 순위 결정은 공유 임베딩 공간의 nearest-neighbor 탐색으로 축소된다. 인덱싱과 탐색이 매우 효율적이라는 것이 이 구조의 장점이다.
표현력의 상한
압축의 대가는 표현력이다. 논문은 이를 single-vector bottleneck이라고 부른다. 관련성이 국소 근거에 크게 의존할 때조차 벡터 하나가 검색 결정 전체를 떠받쳐야 한다는 뜻이다.
문제는 세밀한 멀티모달 검색에서 특히 두드러진다. 후보 문서의 작은 일부에만 있는 텍스트나 시각 속성이 결정적인 경우, single-vector similarity가 높다는 사실은 전체적인 의미 관련성만 알려 줄 뿐 국소 정보를 완전히 무시할 수 있다.
이 한계는 경험적 관찰에 그치지 않는다. 논문이 인용하는 이론적 분석에 따르면, single-vector 방식이 신뢰성 있게 반환할 수 있는 서로 다른 부분집합 순위의 개수가 임베딩 차원 수에 의해 엄격히 제한된다. 차원을 늘리지 않는 한 넘을 수 없는 상한이 존재한다는 의미다.
기존 multi-vector 방식이 치르는 비용
이 병목을 우회하는 기존 방향은 multi-vector 구조다. 토큰이나 패치 단위 표현을 모두 유지하고 검색 시점에 토큰 사이의 상호작용으로 관련성을 계산한다.
| 계열 | 대표 모델 | 접근 | 요구 사항 |
|---|---|---|---|
| 텍스트 late interaction | ColBERT, ColBERTv2 | MaxSim 연산자로 토큰 단위 대조 | 전면 학습 |
| 시각 문서 late interaction | Colpali | 문서 이미지 패치 단위 대조 | 전면 학습 |
| 범용 멀티모달 multi-vector | jina-embeddings-v4 | 다국어와 멀티모달 통합 임베딩 | 전면 학습 |
| 학습 가능 토큰 방식 | MetaEmbed | 학습된 토큰으로 test-time scaling | 추가 토큰 학습 |
세 가지 비용이 공통으로 따라붙는다. 첫째, 과제별 전면 fine-tuning이나 학습 가능한 토큰 도입이 필요하다. 둘째, self-attention 비용이 시퀀스 길이에 제곱으로 늘어나므로 학습 단계의 연산과 메모리 부담이 크다. 셋째, Colpali와 jina 같은 방법은 토큰과 패치 단위 대조를 강조하면서 single-vector 모델이 잘 활용하던 전역 pooled readout을 명시적으로 보존하지 않는다.
논문이 세우는 질문은 여기서 나온다. 기존 backbone과 효율적인 pooled 표현을 그대로 둔 채 기존 single-vector 검색기에 multi-vector 능력을 더할 수 있는가이다.
평가 무대와 지표
주 평가 벤치마크는 MMEB-V2다. 이미지, 문서, 비디오 도메인의 조밀 검색 과제를 폭넓게 포함한다는 이유로 선택되었고 Apache-2.0 라이선스로 공개되어 있다.
| 묶음 | 과제 수 | 도메인 | 지표 |
|---|---|---|---|
| Image RET | 12 | 이미지 검색 | Recall@1 |
| VDRv1 | 10 | 시각 문서 검색 | NDCG@5 |
| VDRv2 | 4 | 시각 문서 검색 | NDCG@5 |
| VR | 6 | 시각 문서 검색 | NDCG@5 |
| OOD | 4 | 시각 문서 검색 | NDCG@5 |
| Video RET | 5 | 비디오 검색 | Recall@1 |
VDRv1, VDRv2, VR, OOD 네 묶음을 묶어 visdoc 부분집합이라고 부른다. 시각 문서 검색은 PDF나 차트처럼 텍스트와 도해가 한 페이지에 섞인 자료를 다루므로 세밀한 정렬이 특히 중요하다. 논문의 학습 실험은 연산 제약 때문에 이 부분집합에서만 수행된다.
두 지표의 성격은 다르다. Recall@1은 1순위 결과가 정답인지만 보는 엄격한 지표이고, NDCG@5는 상위 5개 안에서 정답이 얼마나 앞에 놓였는지를 순위 가중으로 재는 지표다. 따라서 같은 표에 실린 값이라도 Image RET 열과 VDRv1 열의 숫자를 같은 잣대로 비교할 수는 없다.
관련 벤치마크로는 M-BEIR에서 MMEB로 이어진 계보가 있고, 도메인별로는 시각 문서의 ViDoRe와 VisRAG, 이미지 검색의 Jina-VDR, 통합 검색의 UMRB가 있다.
핵심 개념
pooling 토큰은 시퀀스 전체를 대표하도록 지정된 토큰 하나를 뜻한다. 이 논문이 다루는 모델들은 end-of-text 토큰의 마지막 층 표현을 그 자리에 쓴다. 검색 점수는 오직 이 토큰의 벡터로만 계산된다.
non-pooling hidden state는 pooling 토큰과 padding 토큰을 제외한 나머지 토큰들의 마지막 층 표현이다. 모델이 forward pass에서 이미 계산해 놓지만 single-vector 검색에서는 점수 계산에 쓰이지 않고 버려진다. SMART가 되찾아 쓰는 자원이 바로 이것이다.
late interaction은 query와 후보를 각각 벡터 하나로 접기 전에 토큰 단위로 대조하는 방식을 말한다. 인코딩은 따로 하되 점수 계산 시점에 토큰 사이의 상호작용을 계산하기 때문에 늦은(late) 상호작용이라고 부른다.
MaxSim은 late interaction의 구체적인 연산자다. query 토큰 하나마다 후보의 모든 토큰과 cosine similarity를 재고 그중 최댓값을 취한 뒤, query 토큰 전체에 대해 평균한다. query의 각 부분이 후보 어딘가에 얼마나 잘 대응되는지를 재는 셈이다.
hybrid scoring은 이 논문의 점수 함수다. 전역 적합성을 재는 s_single과 국소 근거를 재는 s_late를 가중치 없이 더한다. 두 점수가 같은 층의 같은 cosine 공간에서 나오기 때문에 스케일을 맞출 필요가 없다는 것이 근거다.
local binding은 저자들이 만든 진단 벤치마크의 핵심 개념이다. code 하나와 시각 marker 하나가 같은 panel 안에서 서로 짝지어져 있는 관계를 뜻하며, 문서 전체에 어떤 요소가 존재하는지와는 구별된다.
hard negative는 정답과 겉보기 특징을 최대한 공유하면서 실제로는 오답인 후보를 말한다. 이 논문의 진단 벤치마크는 hard negative를 정답 문서와 완전히 같은 재료로 만들되 결합만 뒤바꾸는 방식으로 구성한다.
방법
학습 목적함수
SMART를 이해하려면 대상 모델들이 어떤 목적함수로 학습되었는지를 먼저 봐야 한다. 표준 contrastive 학습은 query q, 양성 후보 c+, 음성 집합 {c-}에 대해 InfoNCE loss를 최소화한다.
L = -log [ exp(s_single(q, c+)/τ) / (exp(s_single(q,c+)/τ) + Σ_{c-} exp(s_single(q,c-)/τ)) ]
s_single(q, c) = (h^L_{q,eot})^⊤ h^L_{c,eot}   (양쪽 모두 normalize)
이 식에서 점수 s_single은 오직 <eot> 토큰의 마지막 층 표현으로만 계산된다. 인코더가 토큰 단위 표현 전체를 유지하는데도 학습 신호가 직접 닿는 대상은 pooled 임베딩 하나뿐이라는 뜻이다.
τ는 temperature이고, 분모에 음성 후보들의 점수가 들어가므로 양성과의 similarity를 올리는 동시에 음성과의 similarity를 내리는 방향으로 학습이 진행된다.
gradient 경로에 대한 관찰
SMART의 모든 결과는 하나의 관찰 위에 서 있다. contrastive loss가 pooling 토큰에만 걸리더라도 나머지 토큰이 학습 신호에서 배제되지는 않는다는 것이다.
이유는 계산 그래프의 구조에 있다. pooled state는 전체 토큰 시퀀스의 함수다. Transformer의 attention과 residual 경로를 통해 <eot> 토큰의 표현이 모든 non-pooling 토큰에서 정보를 모으므로, pooled state에 기여하는 모든 토큰이 loss의 gradient 경로 위에 놓인다. 논문은 이를 다음 식으로 적는다.
∂L/∂h^l_{q,i} = (∂z_q/∂h^l_{q,i})^⊤ ∂L/∂z_q
여기서 h^l_{q,i}는 layer l의 i번째 query 토큰 hidden state이고, L은 최종 층, z_q는 normalize된 pooled 임베딩이다. 우변의 두 항 모두 0이 아니므로 모든 i에 대해 좌변도 0이 아니다.
저자들은 여기서 한 걸음 물러선다. 이것이 각 토큰이 독립적인 검색 벡터로 supervise된다는 뜻은 아니라고 명시한다. 실제로 loss가 걸리는 대상은 마지막 <eot> 표현 하나뿐이다.
주장의 강도를 낮춰 잡은 이 서술이 중요하다. 만약 각 토큰이 독립적인 검색 벡터로 학습되었다고 주장한다면 그것은 이미 multi-vector 모델을 학습했다는 말이 되어 논문의 전제와 어긋난다. 저자들이 주장하는 것은 그보다 약한 조건, 즉 명시적 학습 없이도 재사용 가능한 정도의 정렬이 부수적으로 생긴다는 것이다.
결정적인 것은 목적함수의 형태다. contrastive 목적함수 자체가 cosine similarity로 정의되어 있으므로, 이 간접 supervision은 hidden state들이 cosine 기반 토큰 단위 검색을 뒷받침하는 방향으로 조직되도록 유도한다. 즉 명시적으로 검색 벡터로 학습되지 않았는데도 검색 벡터처럼 쓸 수 있는 기하 구조가 부수적으로 만들어진다.
이 논증에서 cosine이라는 조건이 왜 필요한지를 짚어 둘 필요가 있다. gradient가 도달한다는 사실만으로는 그 표현을 어떻게 써야 할지 알 수 없다. 목적함수가 cosine similarity로 정의되어 있기 때문에 학습이 밀어붙이는 방향 자체가 방향 벡터 사이의 각도이고, 그래서 나중에 같은 cosine 연산으로 토큰을 대조하는 것이 자연스럽게 성립한다.
이 관찰이 참이라면 따라 나오는 결론은 실용적이다. 이미 배포되어 돌아가는 single-vector 임베딩 모델들이 multi-vector 검색에 필요한 재료를 이미 계산하고 있으면서 점수 계산 단계에서 버리고 있다는 뜻이 된다. 논문의 실험은 전부 이 결론을 검증하는 방향으로 설계되어 있다.
점수 함수
SMART는 backbone과 pooled readout을 건드리지 않고 토큰 단위 readout을 하나 더한다. 토큰 단위 신호는 pooled 점수의 대체물이 아니라 보완물이다. pooled 점수가 query와 후보의 전역 적합성을 잡고, 토큰 단위 대조가 pooled readout에서 압축되어 사라졌을 수 있는 국소 근거를 드러낸다.
| 기호 | 정의 |
|---|---|
M_q, M_c |
padding 토큰과 pooling 토큰을 제외한 query와 후보의 유효 토큰 인덱스 집합 |
h̃^L_{x,i} |
h^L_{x,i} / ‖h^L_{x,i}‖_2, normalize된 마지막 층 hidden state |
s_single(q,c) |
(h^L_{q,eot})^⊤ h^L_{c,eot}, 원래 pooled cosine 점수 |
s_late(q,c) |
`(1/ |
s_hybrid(q,c) |
s_single(q,c) + s_late(q,c), 최종 점수 |
s_late는 후보 hidden state 안에서 query의 국소 coverage를 측정한다. 이 값이 높다는 것은 query의 각 부분이 후보 어딘가에 대응되는 자리를 찾았다는 뜻이다.
s_hybrid 아래에서 높은 순위를 받으려면 두 조건을 동시에 만족해야 한다. query와 전역적으로 적합해야 하고, 동시에 토큰 단위 근거가 국소적으로 뒷받침해야 한다.
unit weight를 쓰는 이유는 SMART를 hyperparameter 없는 방법으로 유지하기 위해서다. 두 항 모두 같은 마지막 층 공간의 normalize된 벡터에서 계산한 cosine 기반 점수이므로 단순 덧셈이 여러 backbone에서 효과적이었다는 것이 저자들이 제시하는 근거다.
마지막 층을 쓰는 선택에도 이유가 붙는다. pooled 임베딩이 그 층에서 읽히므로 원래 single-vector 점수 공간과 가장 직접적으로 호환되기 때문이다. 저자들은 이것이 이전 층에 유용한 정보가 없다는 주장은 아니라고 덧붙이며, 층별 분석 결과를 근거로 든다.
세 가지 사용 모드
같은 점수 함수를 학습 비용이 다른 세 가지 방식으로 쓸 수 있다.
| 모드 | 학습 대상 | 학습 비용 | 위치 |
|---|---|---|---|
| 추론 전용 | 없음 | 0 | 기존 모델에 그대로 적용 |
| 경량 adapter | 마지막 층 위 토큰 단위 Linear 하나 | 1시간 50분 (2B 기준) | backbone 동결 |
| LoRA 변환 | backbone의 LoRA 파라미터 | 3시간 추가 (총 9.5시간) | 기존 single 체크포인트에서 이어서 |
세 모드는 배타적이지 않고 비용 대비 성능의 선택지를 이룬다. 추론 전용은 이미 배포된 인덱스와 모델을 그대로 두고 점수 계산 코드만 바꾸는 수준이고, 나머지 둘은 학습을 감수하는 대신 더 큰 개선을 얻는다.
기존 multi-vector 방식과의 차이
SMART가 쓰는 MaxSim 연산자는 ColBERT가 도입한 것이고 시각 문서에 적용하는 발상은 Colpali가 먼저 했다. 새로운 것은 연산자가 아니라 그 연산자에 넣을 벡터를 어디서 얻는가이다.
| 항목 | ColBERT 계열과 Colpali | jina-embeddings-v4 | MetaEmbed | SMART |
|---|---|---|---|---|
| 토큰 벡터의 출처 | 전면 학습으로 만든 전용 표현 | 전면 학습으로 만든 전용 표현 | 새로 학습한 토큰 | 기존 모델이 이미 만든 hidden state |
| 학습 요구 | 과제별 전면 fine-tuning | 전면 학습 | 학습 가능 토큰 도입 | 없음 또는 경량 |
| 전역 pooled 점수 | 명시적으로 보존하지 않음 | 명시적으로 보존하지 않음 | 해당 없음 | s_single로 그대로 유지 |
논문이 기존 방식과의 차별점으로 드는 지점은 두 가지다. 첫째, 전면 과제별 학습이나 adapter나 학습 가능한 토큰 없이 추론만으로도 쓸 수 있다. 둘째, Colpali와 jina 같은 방법이 토큰과 패치 단위 대조를 강조하면서 놓친 전역 pooled readout을 SMART는 명시적으로 남긴다.
전역 readout을 남기는 선택은 설계 철학의 문제이기도 하다. 저자들은 국소 근거만으로 검색을 결정하는 것이 아니라 전역 적합성과 국소 근거를 모두 요구하는 쪽을 택했고, 부록 D의 ablation이 이 선택을 뒷받침한다.
학습이 필요 없다는 주장의 정확한 범위
"training-free"라는 표현이 세 모드 전체에 적용되는 것은 아니다. 무엇을 학습하지 않는지가 모드마다 다르므로 구분이 필요하다.
| 모드 | 학습하지 않는 것 | 학습하는 것 |
|---|---|---|
| 추론 전용 SMART | backbone, adapter, 추가 토큰 등 파라미터 전부 | 없음. 파라미터 갱신 0회 |
| 경량 adapter | backbone 파라미터 전부 (동결) | LN 뒤에 오는 Linear: R^H → R^d 하나뿐 |
| LoRA 변환 | 처음부터 다시 학습하는 과정 | LoRA 파라미터 (r = 128, α = 256) |
추론 전용 모드에서 "학습이 필요 없다"는 문자 그대로다. 논문 본문은 파라미터 갱신 한 단계 없이(without requiring a single step of additional parameter updates) 개선이 나온다고 적는다. MMEB-V2 결과가 전부 이 조건에서 나온 값이다.
adapter 모드는 학습을 하되 그 대상이 backbone 바깥의 readout 모듈 하나로 제한된다. 논문은 이 Linear가 유일하게 학습되는 readout 모듈이라고 명시한다. adapter는 s_late만으로 학습하고 pooled single-vector 점수는 손대지 않는다.
LoRA 변환 모드에서 절약되는 것은 학습 자체가 아니라 처음부터 학습하는 비용이다. LamRA-Single 체크포인트에서 1 epoch만 이어 학습하므로 총 시간이 짧아진다.
경량 adapter의 구조
backbone을 동결하고 마지막 층 hidden state 위에 토큰 단위 선형 adapter만 학습한다. 유효 hidden state h^L_i ∈ R^H마다 layer normalization을 적용한 뒤 선형 사영과 ℓ2 normalize를 거친다.
r_i = normalize( Linear( LN(h^L_i) ) ) Linear: R^H → R^d
추론 시에는 s_late 식의 normalize된 hidden state를 adapter가 변환한 토큰 벡터 r_i로 대체하고, pooled single-vector 점수는 그대로 둔 채 같은 hybrid scoring을 적용한다.
| 항목 | 설정 |
|---|---|
| 학습 데이터 | Colpali 학습 세트 |
| global batch | 512 |
| 학습 목적함수 | s_late만 사용 |
| 하드웨어 | 48GB A6000 8장 한 노드 |
| 소요 시간 | Qwen3-VL-Embedding-2B 기준 1시간 50분 |
LoRA 변환 실험의 설정
"처음부터 multi-vector 모델을 학습하면 되지 않는가"라는 반문에 답하기 위해 저자들은 single 계열과 multi 계열을 같은 조건에서 직접 학습했다.
| 항목 | 설정 |
|---|---|
| backbone | Qwen3-VL-2B-Instruct (Qwen3-VL-Embedding-2B와 같은 출발 모델) |
| 학습 레시피 | LamRA-Ret |
| 하드웨어 | 80GB A100 8장 한 노드 |
| global batch | 512 |
| LoRA 설정 | r = 128, α = 256 |
| learning rate | cosine annealing, 최대 1e-4, warmup 비율 0.03 |
| 학습 데이터 | Colpali 학습 세트 |
| epoch | LamRA-Single과 LamRA-Multi는 4 epoch, LamRA-Single-Convert는 그 위에서 1 epoch 추가 |
적용 대상 과제와 배제한 과제
저자들은 SMART를 조밀한 corpus 단위 검색 과제에 한정하고, 부록 B에서 배제 이유를 과제군별로 밝힌다.
| 과제군 | 판단 | 이유 |
|---|---|---|
| 이미지 검색, 시각 문서 검색, 비디오 검색 | 적용 대상 | query와 대상의 의미 복잡도가 세밀한 정렬을 요구한다 |
| Classification, VQA | 배제 | 대상이 "dog"나 "43" 같은 저엔트로피 개념이라 벡터 하나로 쉽게 압축된다. 단일 레이블 과제에 토큰 단위 상호작용을 강제하면 의미 있는 국소 정렬이 없는 자리에서 정렬을 찾으려다 잡음이 생긴다 |
| Visual Grounding (이미지) | 배제 | 원래는 주어진 원본 이미지 안에서 crop을 찾는 문제다. 열린 corpus 검색으로 확장하면 "dog" query가 다른 이미지의 유효한 distractor crop과 뒤섞여, 의미상 맞는 결과를 검색해도 감점된다 |
| Video Moment Retrieval | 배제 | "running" 같은 동적 행동을 식별하려면 시공간 전체를 아우르는 추상화가 필요한데, SMART는 토큰 단위 유사도만 계산하고 추론 전용이라 명시적 시간 추론이 없다 |
| Composed Image Retrieval | 조정 후 적용 | 가짜 상관이 남아 성능을 떨어뜨리므로 추론 시점에 query의 시각 토큰을 마스킹한다. 이렇게 하면 전체 검색 정확도가 크게 오른다 |
Video Moment Retrieval에 대해서는 후속 방향도 제시한다. 시간 축의 연속 특징을 이산 의미 단위로 묶는 중간 학습 모듈을 두면 SMART를 적용할 수 있으리라는 것이다.
결과
논문의 실험은 서로 다른 질문에 답하는 여섯 묶음으로 이뤄진다. 각 실험이 무엇을 확인하려는 것인지를 먼저 구분해 두면 수치를 읽기 쉽다.
| 실험 | 확인하려는 것 | 위치 |
|---|---|---|
| 진단 벤치마크 | 국소 근거가 hidden state에 남아 있는가 | 본문 4.1절 |
| MMEB-V2 전체 | 학습 없이 실제 검색 과제에서 통하는가 | 본문 4.2절 |
| adapter 학습 | 가벼운 학습이 얼마나 더 올리는가 | 본문 4.3절 |
| LoRA 변환 | 변환이 처음부터 학습보다 나은가 | 본문 4.4절 |
| hybrid ablation | 전역 anchor를 함께 학습하는 것이 필요한가 | 부록 D |
| 층별 분석 | 어느 층의 hidden state를 써야 하는가 | 본문 4.6절 |
국소 결합을 격리한 진단 벤치마크
자연 검색 벤치마크에서는 전역 의미와 국소 근거와 데이터셋 편향이 얽혀 있어 pooling 병목만 떼어 보기 어렵다. 저자들은 그래서 검색기가 국소 결합을 총량 내용과 구분할 수 있는지 직접 시험하는 통제 벤치마크를 만들었다.
문서 한 쌍 (dA, dB)은 같은 레이아웃을 쓴다. 5×5 격자의 panel이고 각 panel에는 어수선한 차트와 국소 code-marker 결합 하나가 들어 있다. marker는 색과 모양으로 기술되고 짧은 영숫자 code로 라벨된다.
핵심은 hard negative의 구성 방식이다. dB는 레이아웃, code 집합, 시각 marker 기술어 집합을 모두 그대로 보존한 채 panel 사이의 code 할당만 고정점 없는 permutation으로 뒤섞는다. 따라서 모든 query에 대해 negative 문서에도 질의된 code와 질의된 marker가 둘 다 존재하지만 올바른 국소 결합만 없다.
이 구성은 쉬운 전역 단서를 제거한다. 두 문서가 같은 객체, 색, 모양, code, 문서 구조를 담고 있으므로 "요청된 요소가 페이지 어딘가에 있는가"를 확인하는 방식으로는 풀 수 없다. code와 marker가 같은 국소 영역에서 서로 결합되어 있는지를 판정해야 한다.
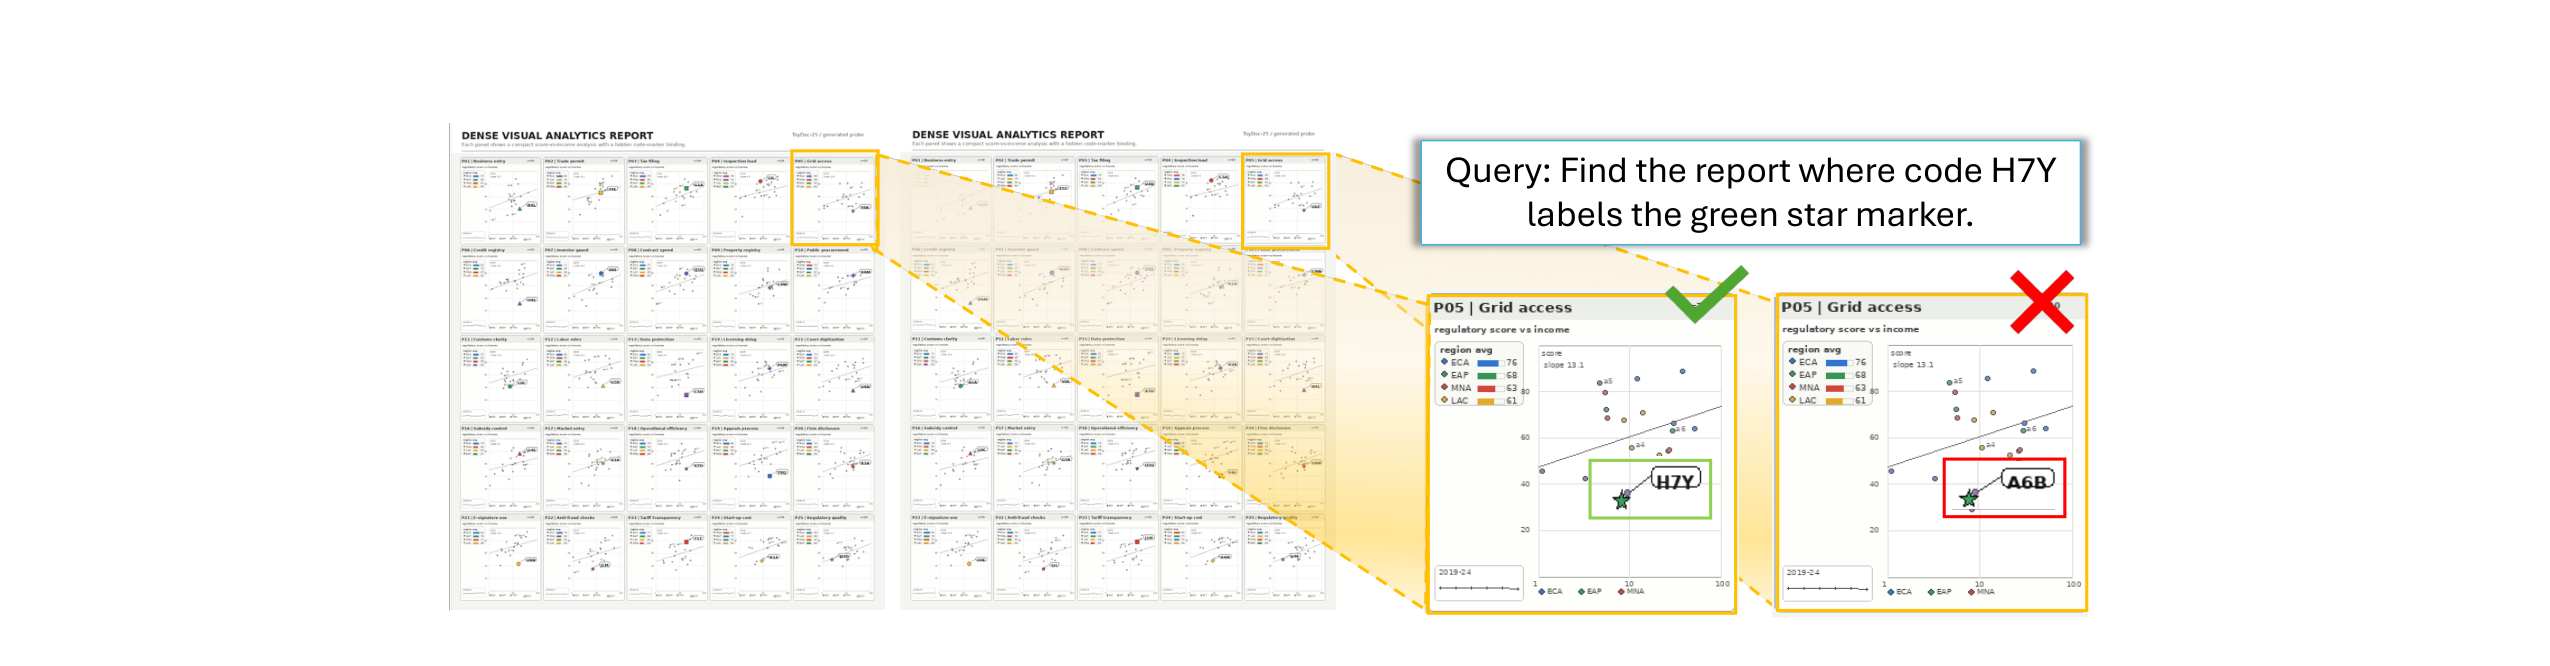
문서 40쌍을 생성했고 각 쌍이 25개 결합을 담아 총 1,000개 query가 나온다. query 형식은 "code x가 빨간 별 marker에 라벨된 보고서를 찾아라"에 해당한다. 각 query마다 같은 쌍에서 나온 두 문서만 순위를 매기고 pairwise 정확도를 보고한다.
| 점수 방식 | pairwise 정확도 |
|---|---|
| 원래 single-vector 점수 | 31.9% |
| late interaction만 (같은 모델의 hidden state) | 56.8% |
hybrid (s_single + s_late) |
42.6% |
| jina-embeddings-v4 multi-vector | 50.9% |
| Colpali multi-vector | 48.7% |
가장 중요한 대비는 첫 두 행이다. 같은 모델의 같은 forward pass에서 나온 표현인데, pooled readout으로 채점하면 31.9%이고 non-pooling hidden state로 채점하면 56.8%다. 두 값의 차이 24.9%p는 정보가 모델에 없어서 생긴 것이 아니라 pooled readout이 통과시키지 못해서 생긴 것이다. 병목이 표현이 아니라 readout에 있다는 저자들의 주장이 여기서 나온다.
hybrid의 42.6%는 late interaction 단독보다 낮고 우연 수준 50%도 밑돈다. 논문은 이것이 이 적대적 설정에서 예상되는 동작이며 자연 검색 환경의 hybrid scoring에 대한 반증으로 읽어서는 안 된다고 명시한다. 원래 pooled 점수가 이미 우연 수준 아래이므로 이를 더하는 것이 중립적인 전역 사전 지식으로 작동하지 않고, 오히려 총량 유사도에 기반한 신호를 다시 들여와 국소 결합 판정을 방해한다는 설명이다.
native multi-vector 검색기 두 종도 우연 수준 근처에 머문다. 저자들은 이를 hidden state 채점이 보편적으로 우월하다는 증거로 읽지 말라고 덧붙이며, 이 벤치마크가 유용한 전역 단서를 의도적으로 제거하고 국소 결합 근거에만 평가를 집중시키도록 설계되었음을 강조한다.
MMEB-V2 전체 결과
추론 전용 SMART를 MMEB-V2의 조밀 검색 과제 전체에 적용한 결과다. 이미지와 비디오 검색은 Recall@1, 시각 문서 검색은 NDCG@5로 보고한다.
| Model | Image RET | VDRv1 | VDRv2 | VR | OOD | Video RET | Average |
|---|---|---|---|---|---|---|---|
| 과제 수 | 12 | 10 | 4 | 6 | 4 | 5 | |
| VLM2Vec-V2.0 | 69.50 | 75.34 | 47.28 | 79.43 | 62.04 | 28.66 | 64.50 |
| + SMART | 69.95 | 80.23 | 51.08 | 82.76 | 64.00 | 30.03 | 67.04 |
| GME-2B | 70.13 | 87.61 | 53.76 | 82.49 | 66.93 | 26.73 | 69.00 |
| + SMART | 71.05 | 87.97 | 57.23 | 84.18 | 67.82 | 26.50 | 70.00 |
| GME-7B | 73.09 | 90.01 | 60.43 | 86.20 | 69.22 | 29.92 | 72.26 |
| + SMART | 73.57 | 90.12 | 61.04 | 87.05 | 69.43 | 29.38 | 72.56 |
| Qwen3-VL-Embed-2B | 74.91 | 84.46 | 65.38 | 86.19 | 69.37 | 54.04 | 74.87 |
| + SMART | 75.33 | 85.52 | 66.61 | 86.87 | 69.90 | 56.05 | 75.77 |
| Qwen3-VL-Embed-8B | 80.09 | 87.29 | 69.35 | 88.78 | 73.27 | 59.01 | 78.83 |
| + SMART | 80.15 | 87.92 | 70.57 | 89.12 | 73.21 | 60.43 | 79.34 |
개선폭은 기존 성능이 낮은 모델에서 크고 높은 모델에서 작다. 가장 약한 baseline인 VLM2Vec-V2.0은 평균 2.54점 올랐고, 논문 본문은 이를 +2.54%로 적는다. 반면 최상위 Qwen3-VL-Embedding-8B는 0.51점 올랐다.
작은 개선폭이 의미가 없는 것은 아니다. 저자들이 강조하는 지점은 SMART가 약한 baseline에만 통하는 방법이 아니라는 데 있다. 고도로 최적화된 최상위 구조에서도 방향이 뒤집히지 않고 일관되게 올라간다는 것이 논지다.
| backbone | 평균 (기존) | 평균 (+SMART) | 증가폭 |
|---|---|---|---|
| VLM2Vec-V2.0 | 64.50 | 67.04 | +2.54 |
| GME-2B | 69.00 | 70.00 | +1.00 |
| GME-7B | 72.26 | 72.56 | +0.30 |
| Qwen3-VL-Embedding-2B | 74.87 | 75.77 | +0.90 |
| Qwen3-VL-Embedding-8B | 78.83 | 79.34 | +0.51 |
도메인별로 보면 시각 문서 검색(VDRv1, VDRv2, VR, OOD)에서 시험한 backbone 네 종 모두 일관되게 개선되었다. 텍스트와 시각 정보의 세밀한 정렬이 특히 중요한 도메인이라서 SMART의 설계 의도와 가장 잘 맞는 자리다.
비디오 검색에서도 상당한 개선이 나왔다. 논문이 본문에 명시한 값은 VLM2Vec +1.37%, Qwen3-VL-Embedding-2B +2.01%, Qwen3-VL-Embedding-8B +1.42%다.
| backbone | Video RET (기존) | Video RET (+SMART) | 증가폭 |
|---|---|---|---|
| VLM2Vec-V2.0 | 28.66 | 30.03 | +1.37 |
| Qwen3-VL-Embedding-2B | 54.04 | 56.05 | +2.01 |
| Qwen3-VL-Embedding-8B | 59.01 | 60.43 | +1.42 |
비디오 검색의 증가폭이 전체 평균 증가폭보다 크다는 점은 눈여겨볼 만하다. Qwen3-VL-Embedding-2B의 전체 평균 증가폭이 0.90인데 비디오만 놓고 보면 2.01이다. 여러 프레임에 흩어진 국소 근거가 pooled 표현에서 특히 많이 손실된다는 해석과 맞는 방향이다.
GME 계열의 비디오 열만 원 표에서 회색 처리되어 있다. GME가 여러 프레임을 다루도록 학습되지 않았고 MMEB-V2가 중간 프레임 하나만 제공하기 때문에 변화가 거의 없다는 것이 이유다. 실제로 GME-2B는 26.73%에서 26.50%로, GME-7B는 29.92%에서 29.38%로 오히려 소폭 내려갔다. 프레임 하나만 보는 모델에게는 늘어난 토큰 단위 근거가 없으므로 예상된 결과다.
adapter 학습 결과
시각 문서 검색 부분집합에서 adapter 학습 효과를 측정한 결과다. 표기에서 ✓는 SMART hybrid scoring, ✗s는 single-vector 점수만, ✗m은 late interaction 점수만, ✓†는 모델을 동결하고 s_late adapter만 학습한 경우를 뜻한다.
| Model | Size | Train / Eval | VDRv1 | VDRv2 | VR | OOD | Avg |
|---|---|---|---|---|---|---|---|
| Qwen3-VL-Embedding | 2B | ✗s / ✗s | 84.60 | 65.33 | 86.34 | 69.27 | 79.27 |
| Qwen3-VL-Embedding | 2B | ✗s / ✓ | 85.52 | 66.61 | 86.87 | 69.90 | 80.10 |
| Qwen3-VL-Embedding | 2B | ✓† / ✓ | 87.09 | 67.08 | 87.99 | 70.73 | 81.25 |
| Qwen3-VL-Embedding | 8B | ✗s / ✗s | 87.29 | 69.35 | 88.78 | 73.27 | 82.33 |
| Qwen3-VL-Embedding | 8B | ✗s / ✓ | 87.92 | 70.57 | 89.12 | 73.21 | 82.88 |
| Qwen3-VL-Embedding | 8B | ✓† / ✓ | 89.42 | 71.25 | 89.67 | 73.99 | 83.89 |
| Colpali-1.3 | 3B | ✗m / ✗m | 83.60 | 52.00 | 81.10 | 43.10 | 71.00 |
| jina-embeddings-v4 | 4B | ✗m / ✗m | 89.94 | 57.36 | 88.74 | 70.18 | 80.91 |
세 행씩 묶어 읽으면 각 모델 크기에서 세 단계가 보인다. 아무것도 하지 않은 상태, 추론 전용 SMART를 적용한 상태, adapter까지 학습한 상태다. 두 크기 모두에서 adapter가 추론 전용보다 약 1점 더 올린다.
8B에서 특히 눈에 띄는 것은 개선폭의 배증이다. 추론 전용 SMART가 82.33%에서 82.88%로 약 0.5점 올렸는데, adapter가 82.33%에서 83.89%로 그 두 배를 올린다. 동결된 backbone이 이미 국소 근거를 담고 있고 가벼운 토큰 단위 readout이 그 근거를 late interaction과 더 잘 맞게 만들 수 있다는 해석이 붙는다.
가장 중요한 비교는 2B와 jina-embeddings-v4 사이에 있다.
| 비교 항목 | Qwen3-VL-Embedding-2B + adapter | jina-embeddings-v4 |
|---|---|---|
| 모델 크기 | 2B에 adapter 하나 | 4B |
| 설계 | single-vector 모델을 변환 | 처음부터 multi-vector |
| 이 논문의 학습 비용 | 1시간 50분 | 해당 없음 (공개 모델) |
| visdoc 평균 | 81.25% | 80.91% |
절반 크기의 모델이 1시간 50분 학습만으로 최상위 multi-vector 모델을 0.34%p 앞선다. 저자들은 이 자원이 학계 수준(academia-level resources)이라는 점을 함께 강조한다.
항목별로 보면 두 모델의 강점이 갈린다. jina-embeddings-v4는 VDRv1에서 89.94% 대 87.09%로, VR에서 88.74% 대 87.99%로 앞선다. 반면 SMART adapter는 VDRv2에서 67.08% 대 57.36%로 크게 앞서고 OOD에서도 70.73% 대 70.18%로 근소하게 앞선다. 평균 우위가 VDRv2 한 항목의 큰 격차에서 나온 것이므로 전 항목에서 앞선다는 뜻은 아니다.
Colpali-1.3의 결과는 multi-vector라는 성질만으로 성능이 보장되지 않는다는 점을 보여 준다. 3B 크기인데도 visdoc 평균 71.00%로 2B single-vector baseline인 79.27%보다 낮고, 특히 OOD에서 43.10%로 크게 떨어진다.
변환과 처음부터 학습의 비교
adapter 결과만으로는 반문이 남는다. 처음부터 multi-vector 모델을 학습하면 더 좋지 않겠는가라는 물음이다. 저자들은 같은 출발 모델과 같은 데이터로 네 모델을 직접 학습해 답한다.
| Model | 학습 시간 | Train / Eval | VDRv1 | VDRv2 | VR | OOD | Avg |
|---|---|---|---|---|---|---|---|
| LamRA-Single | 6.5시간 | ✗s / ✗s | 81.58 | 50.72 | 78.41 | 63.50 | 72.60 |
| LamRA-Single-SMART | 6.5시간 | ✗s / ✓ | 83.02 | 52.25 | 80.52 | 64.50 | 74.18 |
| LamRA-Single-Convert | 9.5시간 | ✓† / ✓ | 86.93 | 54.60 | 84.39 | 67.61 | 77.68 |
| LamRA-Multi | 12시간 | ✗m / ✗m | 87.93 | 54.29 | 85.24 | 67.91 | 78.31 |
1행과 2행의 차이는 추가 학습 없이 추론에만 SMART를 적용한 효과다. 72.60%에서 74.18%로 약 1.6점 올라 앞서의 training-free 결과와 일치한다. 같은 체크포인트, 같은 가중치, 점수 계산 코드만 다르다.
3행은 LamRA-Single 체크포인트에서 같은 레시피로 1 epoch만 더, 이번에는 s_hybrid 목적함수로 학습한 것이다. 3시간이 추가되어 총 9.5시간이다. 4행 LamRA-Multi는 같은 출발 모델에서 s_late만으로 처음부터 학습해 12시간이 걸렸다.
| 비교 항목 | LamRA-Single-Convert | LamRA-Multi | 차이 |
|---|---|---|---|
| 총 학습 시간 | 9.5시간 | 12시간 | 약 20% 절감 |
| visdoc 평균 | 77.68% | 78.31% | 약 0.63점 뒤짐 |
| 학습 방식 | 기존 single 체크포인트에서 1 epoch 연장 | 처음부터 4 epoch |
논문의 결론은 이 표에 담겨 있다. SMART로 single-vector 모델을 multi-vector 모델로 변환하는 편이 처음부터 학습하는 것보다 효율적이며 성능 손실은 크지 않다는 것이다.
이 비교가 성립하려면 조건이 맞아야 한다는 점도 표에 드러난다. 네 모델이 모두 같은 출발 모델 Qwen3-VL-2B-Instruct에서 같은 Colpali 학습 세트로 같은 하드웨어에서 학습되었기 때문에 학습 시간의 차이가 방식의 차이로 귀속된다. 이미 공개된 모델들을 비교하는 방식으로는 얻을 수 없는 통제다.
실용적으로 읽으면 선택지는 두 가지다. 이미 single-vector 모델을 학습해 두었다면 그 체크포인트에서 3시간을 더 들여 변환하는 쪽이 낫고, 아직 아무것도 학습하지 않았고 최고 성능이 필요하다면 12시간을 들여 처음부터 multi-vector로 가는 쪽이 0.63점을 더 준다.
hybrid 목적함수 자체의 ablation
부록 D는 hybrid 설계가 필요한지를 따로 검증한다. 앞의 표에서 LamRA-Multi는 s_late만으로 학습했는데, 학습 시점에 pooled anchor를 함께 쓰면 어떻게 되는지를 본 것이다.
| Model | Size | Train / Eval | VDRv1 | VDRv2 | VR | OOD | Avg |
|---|---|---|---|---|---|---|---|
| LamRA-Single | 2B | ✗s / ✗s | 81.58 | 50.72 | 78.41 | 63.50 | 72.60 |
| LamRA-Single-SMART | 2B | ✗s / ✓ | 83.02 | 52.25 | 50.52 | 64.50 | 74.18 |
| LamRA-Multi | 2B | ✗m / ✗m | 87.93 | 54.29 | 85.24 | 67.91 | 78.31 |
| LamRA-Hybrid | 2B | ✓ / ✓ | 88.14 | 55.81 | 86.39 | 68.90 | 79.10 |
LamRA-Hybrid는 학습된 MaxSim 상호작용과 pooled 단일 토큰 anchor를 결합한 모델로 네 항목 모두에서 가장 높다. 평균 79.10%는 원래 single-vector baseline 72.60% 대비 6.5점 개선이다.
저자들이 이 값에 붙이는 해석은 비교 대상에 있다. 79.10%가 Qwen3-VL-Embedding-2B의 79.27%와 사실상 같은 수준이라는 것이다. 학습 데이터와 연산 예산이 공개되지 않은 대규모 최상위 모델을 학계 규모 자원으로 학습한 모델이 따라잡았다는 주장이며, SMART가 추론 요령을 넘어 학습 시점의 촉매로도 작동한다는 근거로 제시된다.
세 번째 행과 네 번째 행의 비교가 이 ablation의 핵심이다. 두 모델 모두 학습된 토큰 단위 표현을 쓰는데, LamRA-Multi는 s_late만으로 학습했고 LamRA-Hybrid는 pooled anchor를 함께 넣어 학습했다. 78.31%와 79.10%의 차이가 전역 anchor를 학습 시점에 유지한 값이다.
이 결과는 앞서 진단 벤치마크에서 hybrid가 late interaction 단독보다 낮았던 것과 방향이 반대다. 진단 벤치마크는 전역 단서를 의도적으로 무용하게 만든 설정이고, 여기는 전역 적합성이 실제로 유익한 자연 검색 설정이라서 결과가 갈린다. 논문이 진단 벤치마크의 hybrid 값을 stress test로 분리해 해석하라고 미리 못 박은 이유가 이 대비에 있다.
이 표의 두 번째 행 VR 값 50.52%는 앞의 표에서 같은 모델이 기록한 80.52%와 어긋난다. 두 표의 평균이 74.18%로 같으므로 부록 쪽이 오기로 보인다.
층별 분석
late interaction에 쓸 hidden state를 어느 층에서 뽑아야 하는지를 Qwen3-VL-Embedding-2B의 28개 층에서 확인했다. 왼쪽은 layer X의 pooled 표현과 같은 layer X의 hidden state를 짝지은 설정이고, 오른쪽은 전역 anchor를 layer 28 pooled 벡터로 고정한 채 late interaction용 층만 바꾼 설정이다.
| X | X층 pooling VDRv1 | VDRv2 | VR | OOD | 평균 | 마지막층 pooling VDRv1 | VDRv2 | VR | OOD | 평균 |
|---|---|---|---|---|---|---|---|---|---|---|
| 4 | 56.77 | 25.53 | 57.93 | 37.18 | 48.59 | 84.90 | 64.94 | 86.66 | 69.31 | 79.42 |
| 8 | 72.94 | 39.25 | 69.87 | 47.28 | 62.28 | 85.20 | 66.01 | 87.00 | 69.44 | 79.83 |
| 12 | 75.04 | 42.40 | 70.44 | 52.94 | 64.77 | 85.08 | 65.64 | 86.76 | 69.51 | 79.67 |
| 16 | 71.46 | 40.22 | 63.30 | 50.43 | 60.71 | 85.06 | 65.90 | 86.70 | 69.63 | 79.70 |
| 20 | 80.45 | 55.01 | 78.34 | 60.40 | 72.34 | 85.56 | 66.42 | 87.19 | 69.87 | 80.16 |
| 24 | 82.68 | 60.93 | 83.41 | 64.99 | 76.29 | 85.31 | 66.41 | 87.16 | 69.80 | 80.04 |
| 28 | 85.52 | 66.61 | 86.87 | 69.90 | 80.10 | 85.52 | 66.61 | 86.87 | 69.90 | 80.10 |
왼쪽 열은 깊은 층으로 갈수록 거의 단조 상승한다. layer 4에서 48.59%였던 평균이 layer 28에서 80.10%가 되므로, 모델이 층을 거치며 대조에 유효한 표현을 점진적으로 쌓아 올린다는 뜻이다.
오른쪽 열의 양상은 전혀 다르다. anchor를 layer 28 pooled 벡터로 고정하면 layer 4의 hidden state와 짝지어도 평균이 79.42%로 이미 매우 높다. 마지막 층 single vector 하나가 얼마나 안정적인 독립 anchor인지를 보여 주는 대목이다.
주목할 점은 최고값의 위치다. layer 20의 80.16%가 layer 28의 80.10%보다 근소하게 높다. 두 값의 차이가 유의하다고 보기는 어렵지만, 적어도 layer 28 hidden state를 쓰는 것이 최고 성능의 절대 요건은 아니라는 결론은 성립한다. 저자들의 결론은 마지막 층 single vector가 안정적인 anchor 역할을 하고 layer 20 이후의 넓은 late 영역이 세밀한 정보를 담고 있다는 것이다.
두 열의 대비가 알려 주는 것은 anchor와 근거의 역할 분담이다. 왼쪽처럼 anchor까지 얕은 층으로 옮기면 성능이 크게 떨어지지만, 오른쪽처럼 anchor만 마지막 층에 두면 근거를 어느 층에서 가져오든 79%대 후반을 유지한다. 전역 적합성 판정은 마지막 층 pooled 벡터가 거의 혼자 감당하고, 토큰 단위 근거는 보완 역할이라는 hybrid scoring의 설계 의도와 맞아떨어지는 결과다.
방법 설명에서 마지막 층을 쓰는 이유로 든 것이 "이전 층에 정보가 없어서"가 아니라 "pooled 점수 공간과의 호환성"이었던 근거가 이 표다. 왼쪽 열이 보여 주듯 layer 20과 24의 표현은 그 자체로 충분히 좋고, 마지막 층을 고르는 것은 성능이 아니라 두 점수를 가중치 없이 더할 수 있게 만드는 선택이다.
정성 분석
Figure 1은 최상위 모델 Qwen3-VL-Embedding-8B가 실패한 사례다. MMEB-V2 시각 문서 부분집합의 Vidore Economic Reports 과제에서 관련 이미지 세 개 중 하나를 검색하지 못했는데, SMART를 적용하면 교정된다.
교정이 일어난 근거는 차트 legend에 있다. query 텍스트가 묻는 "Middle East and North Africa"와 "Europe and Central Asia"가 문서 안 legend 항목으로 정확히 대응하는데, 문서 전체를 벡터 하나로 압축하면 이렇게 작은 영역의 텍스트가 사라진다. 저자들은 이를 single-vector 모델의 근본적인 한계로 지목한다. 다양한 query와 corpus에 걸친 폭넓은 비교에 최적화된 전역 표현이 세부를 담아내지 못한다는 것이다.
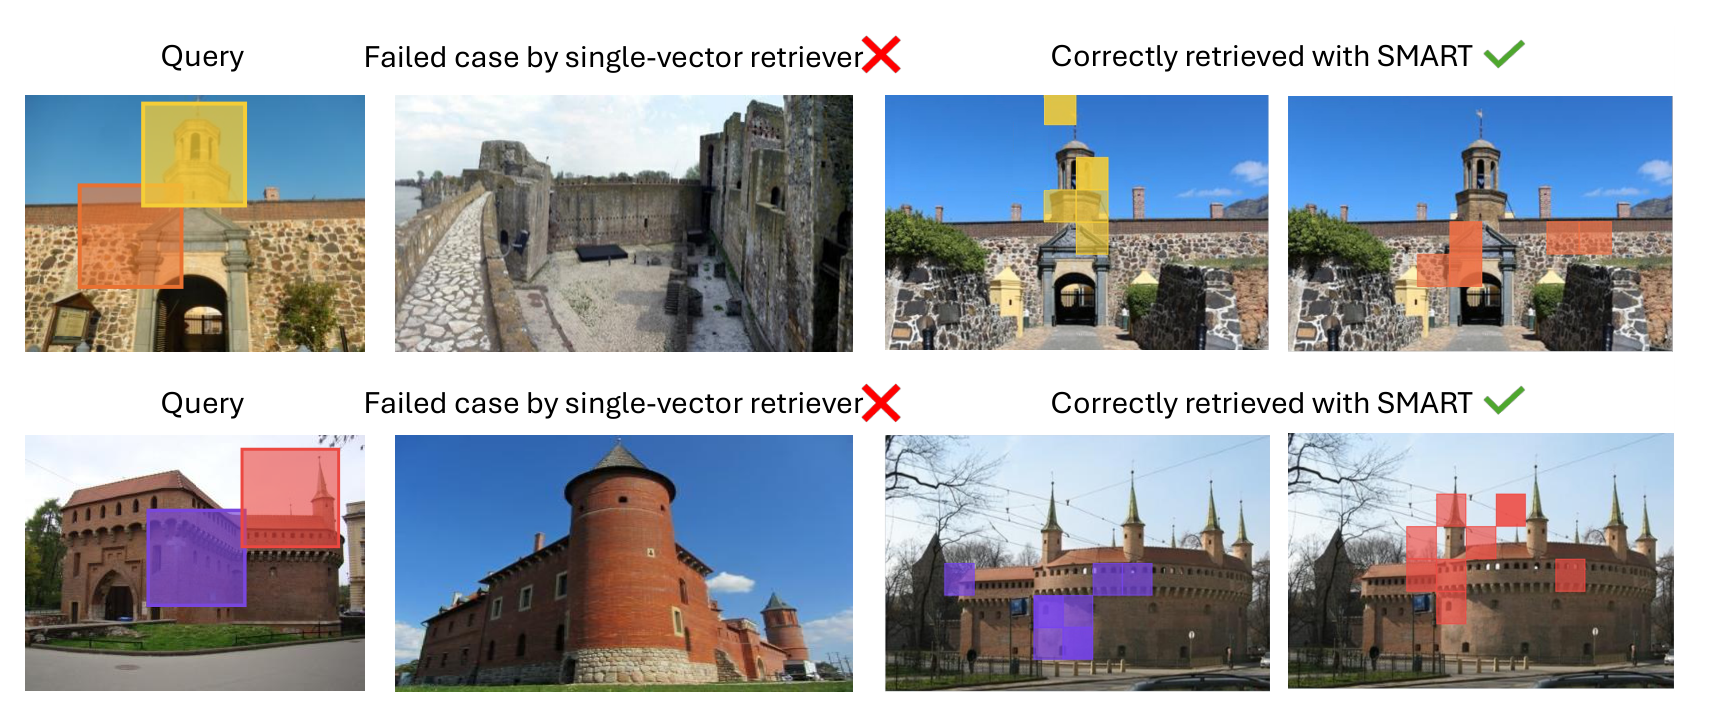
Figure 3은 이미지 사이 검색에서 나타나는 같은 실패 양상이다. single-vector 검색기가 고른 후보들은 성, 요새, 탑, 석조 건축이라는 넓은 시각 범주를 query와 공유하지만 올바른 개체를 식별하는 데 필요한 국소 구조에서 갈린다. pooled 표현 아래에서는 자연스러운 오류라는 것이 저자들의 설명이다.
색깔 상자는 SMART가 실제로 쓴 근거의 위치를 표시한 것이다. 선택된 query 토큰마다 hidden state cosine 유사도가 가장 높은 후보 이미지 토큰을 강조했는데, 이것이 s_late의 MaxSim이 고르는 바로 그 토큰이다. 강조 영역이 이미지 전체에 균일하게 퍼지지 않고 작고 의미 있는 부분에 몰린다는 점이 개별 query 토큰이 평균화된 전역 내용이 아니라 특정 국소 영역과 대응한다는 근거로 제시된다.
부록 C는 사례를 더 든다. single-vector가 Akhtala Monastery와 Visby City Wall을 골라 실패한 자리에서 SMART가 Gradac Monastery와 Będzin Castle을 정확히 검색했다. 상위 5개 후보 토큰을 표시한 그림에서는 강조 패치가 탑, 지붕 구조, 벽, 출입구 같은 건축 세부에 몰린다.
정성 사례들이 공통으로 보여 주는 실패 유형은 하나다. single-vector 검색기가 고르는 오답은 무작위로 틀린 것이 아니라 전역적으로 그럴듯한 오답이다. 넓은 범주는 맞히지만 개체를 특정하는 세부에서 갈리는데, 이것이 바로 pooled 표현이 잘하는 일과 못하는 일의 경계다.
연구 계보
SMART가 조합한 재료는 대부분 기존 연구에서 왔다. 어떤 흐름에서 무엇을 가져왔는지를 짚어 보면 이 논문의 기여 범위가 분명해진다.
| 흐름 | 대표 연구 | SMART가 가져온 것 |
|---|---|---|
| single-vector 멀티모달 임베더 | CLIP, BLIP, SigLIP, UniIR, VLM2Vec, E5-V, GME, Qwen3-VL-Embedding | 적용 대상 모델 전부. 논문은 이 모델들이 non-pooled hidden state에 쓴 연산을 낭비하고 있다고 표현한다 |
| late interaction | ColBERT, ColBERTv2 | MaxSim 연산자 |
| 시각 문서 multi-vector | Colpali, jina-embeddings-v4 | 비교 대상이자 학습 데이터 출처. adapter와 LoRA 학습에 Colpali 학습 세트를 쓴다 |
| test-time scaling multi-vector | MetaEmbed | 학습 가능 토큰 방식과의 대비 |
| 표현력의 이론적 한계 | Weller et al. (2026), Luan et al. (2021), Reimers & Gurevych (2021) | single-vector 표현력이 임베딩 차원에 묶인다는 근거 |
| 학습 목적함수와 레시피 | InfoNCE, LoRA, LamRA-Ret | 학습 설정 전반 |
이론 쪽 인용이 이 논문에서 하는 역할은 문제 설정의 정당화다. single-vector 검색이 세밀한 query에서 실패하는 것이 학습 부족이나 데이터 부족의 문제가 아니라 구조적 상한의 문제라는 주장을 세우기 위해서다.
부록 B의 Composed Image Retrieval 논의는 같은 1저자의 동시기 작업인 "Reasoning-augmented representations for multimodal retrieval"을 가짜 상관의 근거로 인용한다.
한계
저자가 밝힌 한계
| 한계 | 내용 |
|---|---|
| 조밀 검색 과제에 한정 | classification 같은 전역 과제에 추론 전용 도구로 쓰면 이롭지 않다. 부록 B가 VQA, visual grounding, video moment retrieval도 같은 이유로 배제한다 |
| 자체 학습 모델의 평가 범위 | 연산 제약으로 LamRA-Ret 계열을 시각 문서 부분집합에서만 학습하고 평가했다. 이미지 검색이나 비디오 검색에서 변환과 처음부터 학습을 비교한 결과는 없다 |
| CIR의 가짜 상관 | Composed Image Retrieval에서는 SMART를 그대로 쓰면 성능이 떨어져 query 시각 토큰 마스킹이라는 별도 조정이 필요하다 |
| 적대적 설정에서의 hybrid 하락 | toy benchmark에서 hybrid가 late interaction 단독보다 낮은 42.6%로 내려갔다. 전역 신호가 유익하지 않을 때 단순 덧셈이 신호를 약화시킬 수 있다는 뜻인데, 도메인 판정이나 가중치 적응 방안은 제시되지 않는다 |
자료의 내적 모순
부록 D의 Table 5에서 LamRA-Single-SMART의 VR 값이 50.52%로 적혀 있는데, 본문 Table 3의 같은 모델 같은 항목은 80.52%다. 두 표의 평균이 74.18%로 동일하므로 부록 쪽 값이 오기일 가능성이 높다. 실제로 부록 값 네 개를 평균하면 62.57%가 되어 표기된 평균과 맞지 않는다.
같은 표의 캡션은 ✓† 표기를 "LoRA with s_hybrid"로 정의하지만 표 본문에 ✓† 행이 없다. 본문 Table 3에서 그 표기를 쓰는 LamRA-Single-Convert 행이 부록 표에서는 빠져 있기 때문으로 보인다.
논문이 다루지 않은 지점
추론 비용과 저장 공간 증가분에 대한 정량 보고가 없다. 논문은 서론에서 single-vector 방식이 효율적인 인덱싱과 nearest-neighbor 탐색을 보장한다는 점과 기존 multi-vector 학습이 시퀀스 길이 제곱에 비례하는 비용을 치른다는 점을 언급한다. 그러나 SMART를 적용했을 때 후보 토큰 벡터를 모두 보관하는 데 드는 저장 공간이나 MaxSim 계산이 늘리는 질의 지연 시간은 어디에도 측정값으로 제시되지 않는다.
논문이 절약을 주장하는 대상은 학습 비용이다. 추론 전용 모드의 "학습 0회", adapter의 1시간 50분, LoRA 변환의 약 20% 절감이 모두 학습 쪽 수치이고, 검색 서비스 운영 비용에 해당하는 측정은 논문 전체에 없다. 대규모 corpus에서 운영할 때의 인덱스 설계와 질의 지연 시간은 이 논문 밖의 문제로 남는다.
단순 덧셈의 일반성에 대한 ablation도 없다. s_hybrid = s_single + s_late의 unit weight는 두 항이 같은 cosine 공간에 있다는 논거로 정당화되고 여러 backbone에서 효과적이었다는 경험적 진술이 붙지만, 가중치를 바꿔 본 실험이나 다른 normalization을 쓰는 backbone에서의 robustness 검증은 제시되지 않는다. 진단 벤치마크에서 hybrid가 late interaction 단독보다 낮아진 사례가 있으므로, 어떤 조건에서 두 신호의 비중을 조정해야 하는지는 열린 문제다.
부록 D의 LamRA-Hybrid가 최고 성능을 냈지만 그 학습 시간은 보고되지 않았다. 본문 Table 3이 네 모델의 학습 시간을 모두 적는 것과 대비되는 지점이라, 변환 방식과 hybrid 학습 방식 사이의 비용 대비 효과를 직접 비교할 수는 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| single-vector bottleneck | pooled 표현 하나가 검색 결정 전체를 떠받쳐야 해서 국소 근거가 압축되어 사라지는 현상. 이 논문의 출발 문제다 |
| non-pooling hidden state | pooling 토큰과 padding 토큰을 뺀 나머지 토큰들의 마지막 층 표현. 모델이 이미 계산했지만 single-vector 검색이 쓰지 않는 자원이다 |
| MaxSim late interaction | query 토큰마다 후보의 모든 토큰과의 cosine 중 최댓값을 취해 평균한 점수. ColBERT가 도입했다 |
| hybrid scoring | s_single과 s_late의 단순 합. 같은 마지막 층 cosine 공간에서 normalize된 두 점수라서 unit weight로 작동한다 |
| local binding | code 하나와 시각 marker 하나가 같은 panel 안에서 서로 짝지어진 관계. 진단 벤치마크가 격리하려는 대상이다 |
| visdoc | PDF, 차트, legend 같은 시각 문서 검색. MMEB-V2의 VDRv1, VDRv2, VR, OOD가 이 부분집합이다 |
관련 페이지
- Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini: 같은 멀티모달 임베딩 문제를 정반대 방향에서 다룬다. Gemini Embedding 2는 Gemini를 backbone으로 삼아 모델 자체를 키우고 새로 학습해 하나의 vector space를 만드는 쪽이고, SMART는 이미 학습이 끝난 모델의 표현을 그대로 두고 readout만 바꾸는 쪽이다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩 자체를 쓰지 않는 대조 접근이다. DCI는 vector index 대신 agent가 원본 corpus에 직접 접근하게 하고, SMART는 임베딩 안에 이미 있는 국소 정보를 되찾는다. 두 논문 모두 단일 top-k readout이 검색의 표현력을 제한한다는 같은 진단에서 출발하지만 처방이 갈린다.
- PixelRAG: 문서를 텍스트로 파싱하지 않고 스크린샷 이미지로 임베딩하는 접근이다. SMART가 시각 문서 검색에서 쓴 Qwen3-VL-Embedding-2B를 PixelRAG도 스크린샷 데이터로 LoRA fine-tuning해 쓰므로 출발 모델이 겹친다.
- VectifyAI/PageIndex: 문서 안에서 근거를 좁히는 문제를 tree search로 푸는 경로다. SMART는 같은 문제를 토큰 단위 대조로 푼다.