Physical AI · PAPER · 2023
RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
요약
RT-2는 인터넷 규모 데이터로 학습한 vision-language model을 로봇 trajectory 데이터와 함께 co-fine-tune해 로봇 action을 직접 출력하도록 만든 모델이다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 핵심 발상은 action을 또 하나의 언어로 보는 것이다. end-effector의 6-DoF 변위와 gripper 값을 이산화한 뒤 텍스트 토큰으로 적으면, 이미 있는 VLM을 새 파라미터 없이 그대로 fine-tuning해 policy로 쓸 수 있다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
이렇게 만든 모델 계열을 vision-language-action(VLA) 모델이라 부르고, 이 이름을 붙인 것이 이 논문이다. 저자들은 Google DeepMind 소속이며 2023년 7월 arXiv에 공개했다.
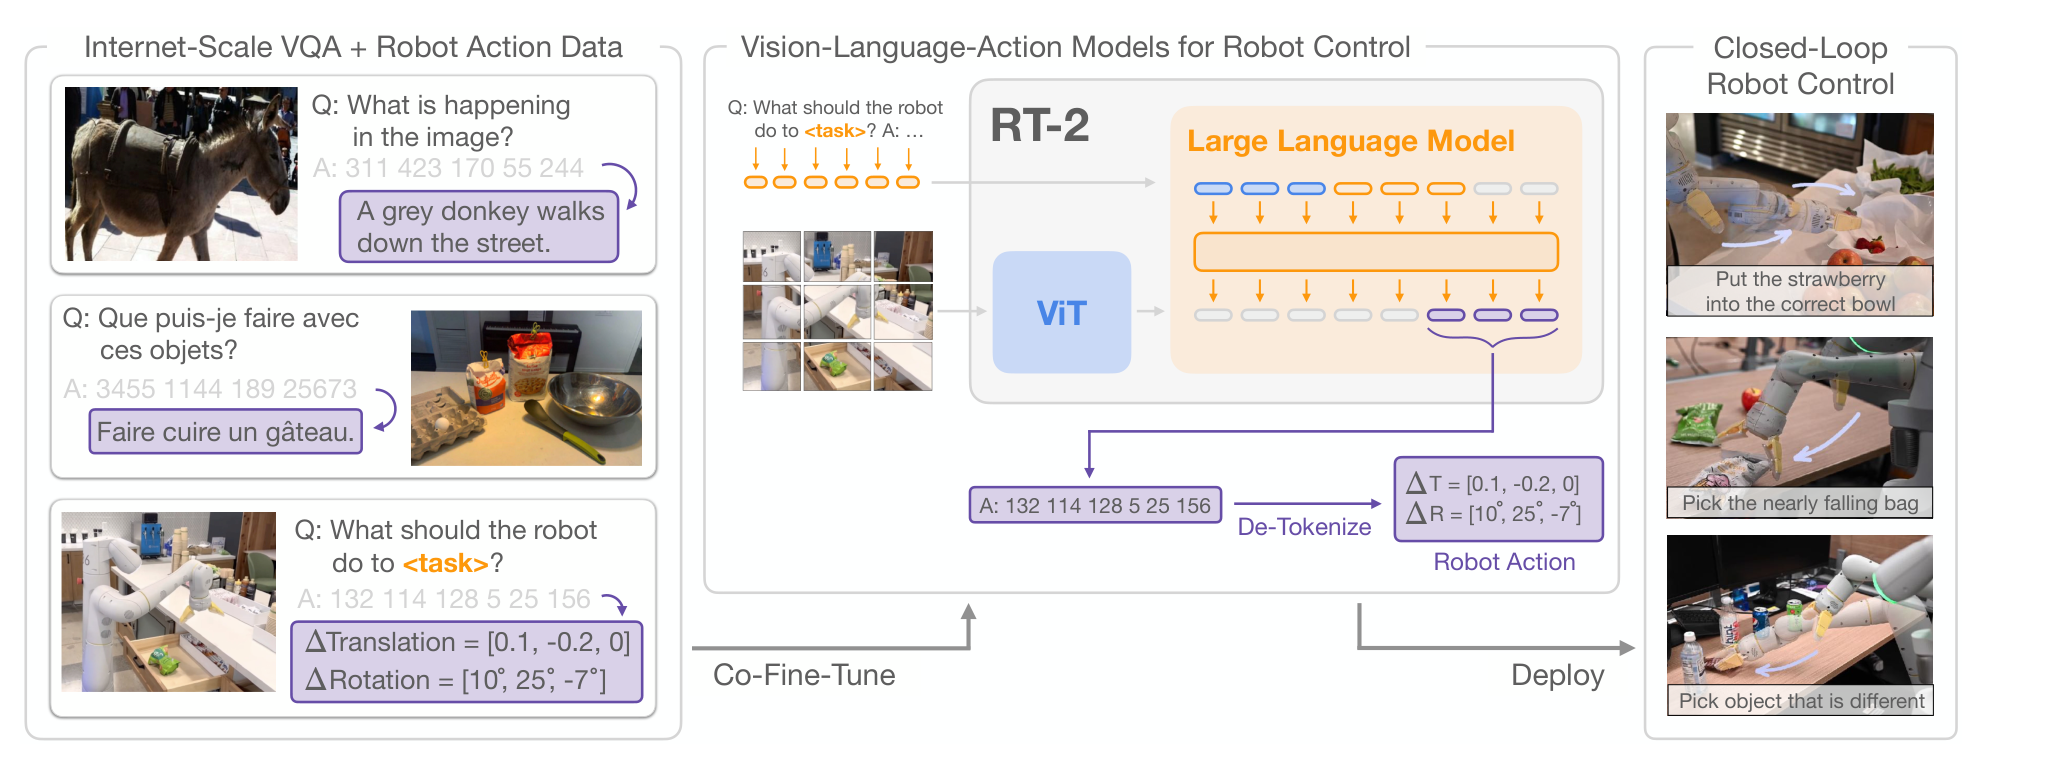
이 접근의 성과는 두 가지로 나타난다. 첫째, 로봇 데이터에 없던 객체, 배경, 환경으로의 일반화가 크게 늘어 unseen 평균 성공률이 RT-1의 32%에서 62%로 오른다. 둘째, 로봇 시연 데이터(demonstration)에 없던 emergent capability가 웹 pre-training에서 전이돼 나타난다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계이고, emergent capability는 학습 데이터에 없던 조합을 모델이 실행해내는 성질을 말한다. 다만 RT-2의 물리 스킬 자체는 여전히 로봇 데이터 분포 안에 갇히고, 늘어나는 것은 그 스킬을 새로운 방식으로 배치하는 능력이다.
배경
로봇 제어에 대형 pre-training 모델을 쓰기 어려웠던 이유는 데이터와 출력 형식이 모두 맞지 않아서다. 가장 강한 언어 모델과 vision-language model은 웹에서 수십억 개 토큰과 이미지로 학습하는데, 로봇 데이터를 그 규모로 모으는 것은 가까운 미래에 불가능하다. 반대로 그런 모델을 로봇에 그대로 붙이기도 어렵다. 모델은 의미와 레이블과 텍스트 프롬프트를 다루는 반면 로봇에는 Cartesian end-effector 명령 같은 grounded된 저수준 action이 필요하다.
그래서 선행 연구는 대부분 상위 계층만 언어 모델에 맡겼다. LLM과 VLM이 지시문(instruction)을 해석해 집기와 놓기 같은 primitive 단위로 쪼개는 상태 기계 역할을 하고, 실제 실행은 별도의 저수준 컨트롤러가 담당하는 구조다. 이 구조에서는 저수준 컨트롤러가 인터넷 규모 모델의 풍부한 의미 지식을 학습 과정에서 전혀 받지 못한다.
RT-2는 이 분리를 없앤다. 즉 대형 vision-language model을 저수준 제어에 직접 통합해 일반화를 높이고 의미 추론이 나타나게 하는 것이 논문의 질문이다. 구현은 단순하다. 로봇 trajectory의 action을 텍스트 토큰으로 바꿔 "멀티모달 문장"으로 만들고, 원래 VQA 데이터와 같은 형식으로 학습에 넣는다.
이 선택은 두 가지 선행 방식과 대비된다. Gato처럼 vision-language-action 구조를 처음부터 새로 설계하는 방식은 pre-training 연산을 새로 들여야 한다. CLIPort처럼 VLM을 policy 안에 모듈로 삽입하는 방식은 2D action space나 보정된 카메라 같은 구조 제약을 함께 들여온다. RT-2는 둘 다 피하고 이미 지불된 pre-training 연산을 그대로 물려받는다.
핵심 개념
RT-2를 읽는 데 필요한 개념은 네 가지다. 각 개념이 뒤의 방법과 결과 절에서 어떤 역할을 하는지 함께 적는다.
action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다. RT-2는 RT-1의 방식을 그대로 물려받아 각 차원을 256개 bin으로 나눈다. 이 표현 덕분에 action이 자연어 토큰과 같은 자리에 들어간다.
co-fine-tuning은 로봇 데이터만 fine-tuning하지 않고 원래 웹 데이터를 배치에 계속 섞어 함께 fine-tuning하는 레시피다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계인데, RT-2의 실험에서 일반화 성능을 좌우하는 것은 모델 구조보다 이 학습 전략이다.
emergent capability는 로봇 데이터에 없었는데 웹 pre-training에서 전이돼 나타난 능력을 가리킨다. 논문은 이를 symbol understanding, reasoning, human recognition 세 범주로 나눠 정량 측정한다. 새로운 물리 동작을 만들어내는 능력이 아니라는 점이 중요하다.
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. RT-2의 가장 큰 모델은 1~3Hz로 동작하는데, 이는 1초에 한 번에서 세 번만 새 action을 낸다는 뜻이다. 이 값이 뒤에서 실시간성 한계의 근거가 된다.
방법
action을 텍스트 문자열로 적기
RT-2의 action space는 세 부분으로 나뉜다. end-effector의 6-DoF 변위(위치 3차원과 회전 3차원), gripper의 확장 정도, 그리고 에피소드 종료를 알리는 이산 명령이다. 종료 명령은 과제를 성공적으로 마쳤다는 신호로 policy가 스스로 내야 한다.
종료 명령을 뺀 연속 차원은 각각 256개 bin으로 균등 이산화한다. 따라서 하나의 action은 8개 정수로 표현되고, fine-tuning 타깃은 이 정수들을 공백으로 이어붙인 문자열 하나가 된다.
"terminate Δpos_x Δpos_y Δpos_z Δrot_x Δrot_y Δrot_z gripper_extension"
예: "1 128 91 241 5 101 127"
입력 형식도 별도 설계 없이 표준 VQA 형식을 그대로 쓴다. 프롬프트는 "Q: what action should the robot take to [task instruction]? A:"이고 답이 위 문자열이다. 즉 모델 입장에서는 이미지를 보고 질문에 답하는 기존 과제와 형식이 같다.
토크나이저에 따른 두 가지 연결 방식
256개 bin을 어떤 토큰에 대응시킬지는 backbone VLM의 토크나이저 사정에 달렸다. 개념은 같지만 구현이 갈리는 지점이다.
| backbone | bin과 토큰의 연결 방식 |
|---|---|
| PaLI-X | 1000까지의 정수마다 고유 토큰이 이미 있어 bin 값을 해당 정수 토큰에 그대로 대응시킨다 |
| PaLM-E | 정수 토큰 체계가 없어 가장 덜 쓰이는 토큰 256개를 골라 action 어휘로 덮어쓴다 |
저자들은 PaLM-E 쪽 방식을 symbol tuning의 일종으로 본다. symbol tuning은 기존 토큰의 의미를 다른 것으로 덮어써 학습하는 기법이며, VLM에서 잘 동작한다고 알려진 선행 결과가 있다.
co-fine-tuning의 데이터 비율
학습 배치마다 로봇 데이터와 웹 데이터의 비율을 조절하되 로봇 쪽 샘플링 가중을 높인다. RT-2-PaLI-X는 로봇 데이터가 학습 혼합의 약 50%, RT-2-PaLM-E는 약 66%를 차지한다.
co-fine-tuning이 단순 fine-tuning보다 나은 이유를 논문은 망각으로 설명한다. 원래 웹 데이터를 fine-tuning 내내 곁에 두면 VLM이 pre-training에서 배운 개념을 덜 잊는다. 반면 로봇 데이터만 쓰면 저수준 action에만 노출돼 웹에서 배운 추상적 시각 개념이 약해진다.
웹 데이터의 대부분은 WebLI다. 109개 언어의 약 100억 개 image-text 쌍을 cross-modal 유사도 상위 10%로 걸러 10억 개 예제로 쓰고, 여기에 여러 captioning과 VQA 데이터셋을 더한다. 로봇 데이터는 RT-1의 것을 그대로 쓴다. 로봇 13대로 17개월간 office kitchen에서 모은 시연 데이터이며, 각 trajectory에 "Pick Object", "Move Object Near Object", "Place Object Upright", "Knock Object Over", "Open Drawer", "Close Drawer" 같은 7종 스킬 중 하나가 자연어 지시문으로 붙어 있다.
출력 어휘 제약
RT-2는 실제 로봇에서 실행 가능한 action 토큰만 내야 한다. 그래서 로봇 action 과제로 프롬프트되면 유효 action 토큰만 샘플링하도록 디코딩 어휘를 제약한다. 반면 일반 vision-language 과제에서는 전체 자연어 토큰을 그대로 허용한다. 하나의 모델이 두 종류의 출력 공간을 프롬프트에 따라 오간다.
backbone 두 종과 학습 설정
RT-2는 두 VLM을 backbone으로 쓴다. 여기서 backbone은 RT-2가 재사용하는 기반 vision-language model을 가리킨다.
| 구성 | RT-2-PaLI-X | RT-2-PaLM-E |
|---|---|---|
| 구조 | encoder-decoder | decoder-only |
| 이미지 처리 | ViT-22B가 이미지당 패치 토큰 생성, projection layer 경유 | ViT-4B가 이미지를 언어 토큰 공간으로 투영 |
| 언어부 | 32B encoder-decoder, UL2 계열 50 layers | decoder-only LLM |
| 실험 규모 | 5B와 55B | 12B |
| 로봇 데이터 비중 | 약 50% | 약 66% |
PaLM-E는 연속 변수를 텍스트 입력에 이어 붙이는 구조라 여러 센서 modality, 객체 중심 표현, 장면 표현을 함께 받을 수 있다. Language-Table 시뮬레이션 실험에는 더 작은 PaLI-3B를 쓰며 ViT-G/14(2B)와 UL2-3B로 구성된다.
학습 목표는 next-token prediction 하나뿐이다. 이 손실이 로봇 학습의 behavioral cloning 손실에 해당한다. behavioral cloning은 시연의 observation에서 action으로 가는 쌍을 지도학습으로 흉내 내는 방법이다. 따라서 언어 과제와 action 과제가 모델 가중치를 완전히 공유하고, action 전용 레이어가 따로 없다.
| 모델 | 학습률 | batch size | gradient step |
|---|---|---|---|
| RT-2-PaLI-X-55B | 1e-3 | 2048 | 8만 |
| RT-2-PaLI-X-5B | 1e-3 | 2048 | 27만 |
| RT-2-PaLM-E-12B | 4e-4 | 512 | 100만 |
| RT-2-PaLI-3B | 1e-3 | 128 | 30만 |
클라우드 추론
수십억에서 수백억 파라미터 VLM은 데스크톱이나 온로봇 GPU로 closed-loop 제어를 수행하기 어렵다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다. RT-2는 모델을 multi-TPU 클라우드 서비스에 배포하고 로봇이 네트워크로 질의하는 프로토콜을 쓴다. 한 클라우드로 여러 로봇을 함께 서빙할 수도 있다.
그 결과 55B RT-2-PaLI-X가 1~3Hz, 5B 버전이 약 5Hz로 동작한다. 저자들은 직접 closed-loop 로봇 제어에 쓴 모델 중 이전보다 한 자릿수 이상 큰 규모라고 적었다.
실험 설계
평가 과제 구성
평가는 7DoF mobile manipulator로 약 6,000회의 실세계 trial을 수행해 이뤄진다. 과제는 seen과 unseen으로 나뉜다.
seen 과제는 RT-1과 같은 지시문 묶음이며 200개가 넘는다. 구성은 물체 집기 36개, 넘어뜨리기 35개, 세워 놓기 35개, 옮기기 48개, 서랍 여닫기 18개, 서랍에서 꺼내 넣기 36개다. 다만 이 평가도 물체 배치, 시각, 로봇 위치가 매번 달라지므로 완전히 동일한 조건의 반복은 아니다.
unseen 평가는 280개가 넘는 과제로 이뤄지고 대부분 pick and place 스킬에 집중한다. 세 범주 각각을 easy와 hard로 나눠 분포 이동의 크기를 조절한다.
| 범주 | easy | hard |
|---|---|---|
| unseen objects | 새로운 일반 물체 | 잡기 어렵고 형태가 특이한 물체(장난감 등) |
| unseen backgrounds | 배경만 바뀐 조건 | 배경 변화가 크고 새 물체가 함께 등장 |
| unseen environments | 주방 싱크대 | 모니터와 사무용품이 놓인 사무 책상 |
unseen 지시문은 각각 1~5회, emergent 평가 지시문은 각각 5회 실행한다. emergent 평가는 분산을 줄이기 위해 A/B testing 방식을 써서 네 모델을 완전히 동일한 조건에서 연속으로 평가한다.
baseline 네 종
baseline은 모두 RT-2와 완전히 동일한 로봇 데이터로 학습한다. 따라서 차이는 데이터가 아니라 pre-training과 구조에서 나온다. 네 baseline은 각각 RT-2의 다른 설계 선택을 검증한다.
| baseline | 구성 | 검증하는 질문 |
|---|---|---|
| RT-1 | 35M 파라미터 Transformer policy. VLM pre-training 없음 | VLM pre-training이 필요한가 |
| VC-1 | 로보틱스용으로 pre-training된 ViT-L 시각 표현. 언어 조건이 없어 Universal Sentence Encoder 임베딩을 이미지 토큰에 이어 붙이고 TokenLearner를 거쳐 RT-1 decoder-only Transformer가 action 토큰을 낸다 | 시각 표현 pre-training으로 충분한가 |
| R3M | Ego4D 사람 활동 영상으로 학습한 ResNet50 표현. 이후 처리는 VC-1과 같다 | 사람 영상 기반 표현으로 충분한가 |
| MOO | VLM이 관심 객체를 이미지 안의 색칠된 픽셀 하나로 표시하고, 그 이미지를 end-to-end policy가 받는다. VLM의 표현 자체는 policy 학습에 쓰이지 않는다 | VLM을 보조 perception 모듈로 두면 충분한가 |
VC-1과 R3M은 pre-training된 가중치를 고정하면 결과가 크게 나빠져 학습 중 해제했다.
결과
일반화
seen 과제에서는 RT-2와 RT-1이 비슷하다. RT-2 두 종이 91%와 93%, RT-1이 92%다. 차이는 일반화에서 벌어진다.
| 모델 | Seen | 객체 easy | 객체 hard | 배경 easy | 배경 hard | 환경 easy | 환경 hard | Unseen 평균 |
|---|---|---|---|---|---|---|---|---|
| R3M | 45 | 32 | 14 | 13 | 9 | 0 | 2 | 12 |
| VC-1 | 63 | 34 | 10 | 13 | 3 | 0 | 0 | 10 |
| RT-1 | 92 | 31 | 43 | 71 | 9 | 26 | 14 | 32 |
| MOO | 75 | 58 | 48 | 38 | 41 | 19 | 3 | 35 |
| RT-2-PaLI-X-55B | 91 | 70 | 62 | 96 | 48 | 63 | 35 | 62 |
| RT-2-PaLM-E-12B | 93 | 84 | 76 | 75 | 71 | 36 | 33 | 62 |
(단위 %, Table 4)
unseen 평균에서 RT-2 두 종이 모두 62%를 기록해, 다음으로 좋은 MOO(35%)와 RT-1(32%) 대비 약 2배, VC-1(10%)과 R3M(12%) 대비 약 6배다. 저자들은 이 격차를 VLA의 강점이 인터넷 규모 pre-training에서 온 시각과 의미 개념의 전이에 있다는 근거로 읽는다.
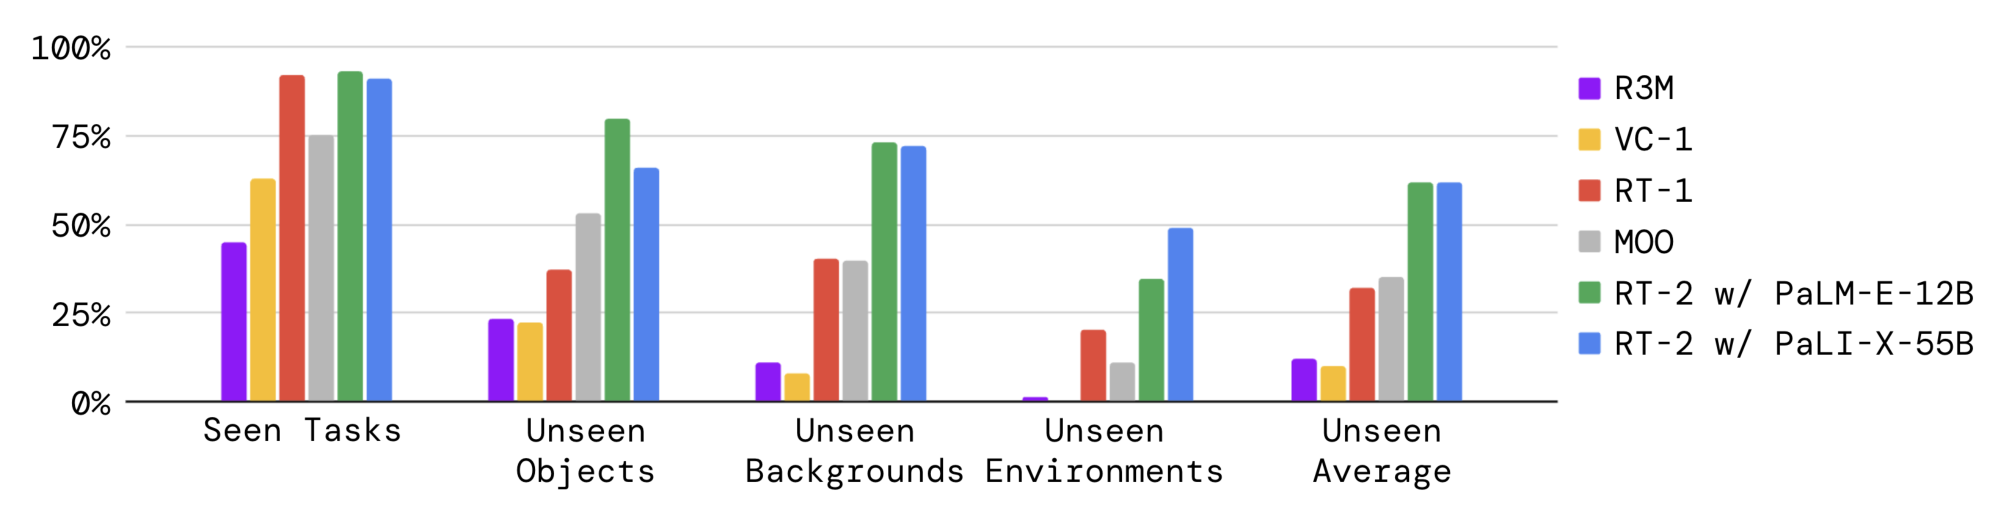
두 RT-2 버전의 강점은 서로 다른 지점에 있다. PaLM-E 기반 모델은 어려운 시나리오에서 앞서고 PaLI-X 기반 모델은 쉬운 쪽에서 앞서, 평균이 같게 나온다. 예를 들어 배경 hard에서는 PaLM-E가 71%로 PaLI-X의 48%를 앞서는 반면, 배경 easy에서는 PaLI-X가 96%로 PaLM-E의 75%를 앞선다. 표현 학습 계열인 R3M과 VC-1은 환경 일반화에서 0~2%로 사실상 실패한다.
논문은 각주로 한 가지 유보 사항을 밝힌다. PaLM-E-12B의 pre-training 혼합에는 high-level VQA planning용 로봇 이미지가 들어 있어 일반화 시나리오의 이미지와 비슷할 수 있다. 다만 그 학습 예제에는 이번 평가 대상인 저수준 action이 포함되지 않는다.
Language-Table 시뮬레이션
다른 로봇과 환경에서도 같은 경향이 나오는지 확인하기 위해 open-source Language-Table 시뮬레이션을 쓴다. 이 환경에서는 작은 PaLI-3B를 co-fine-tune하며, action을 "X Y" 형식의 텍스트로 적는다. X와 Y는 -10에서 +10 사이의 정수이고 end-effector의 2D 직교 변위 setpoint를 나타낸다.
| 모델 | Language-Table 성공률(%) |
|---|---|
| BC-Zero | 72±3 |
| RT-1 | 74±13 |
| LAVA | 77±4 |
| RT-2-PaLI-3B | 90±10 |
RT-2-PaLI-3B가 90±10%로 두 번째로 높은 LAVA(77±4%)를 13%p 앞선다. 모델이 작아 다른 baseline과 비슷한 5Hz로 추론하므로 속도를 희생한 결과도 아니다. 학습은 다섯 가지 예측 과제를 함께 co-fine-tune하는 방식으로 이뤄진다. action 예측 외에 지시문 예측, 로봇 팔 위치 예측, 두 프레임 사이 timestep 수 예측, 성공 여부 예측이 함께 들어간다.
emergent capability
논문은 emergent capability를 세 범주로 나눠 측정한다. symbol understanding은 로봇 데이터에 없던 기호로 물체를 옮기는 능력이고("move apple to 3"), reasoning은 시각 추론과 수학과 다국어를 포함하며("move X near the sum of two plus one"), human recognition은 인물 중심 지시문을 다룬다("move the coke can to the person with glasses").
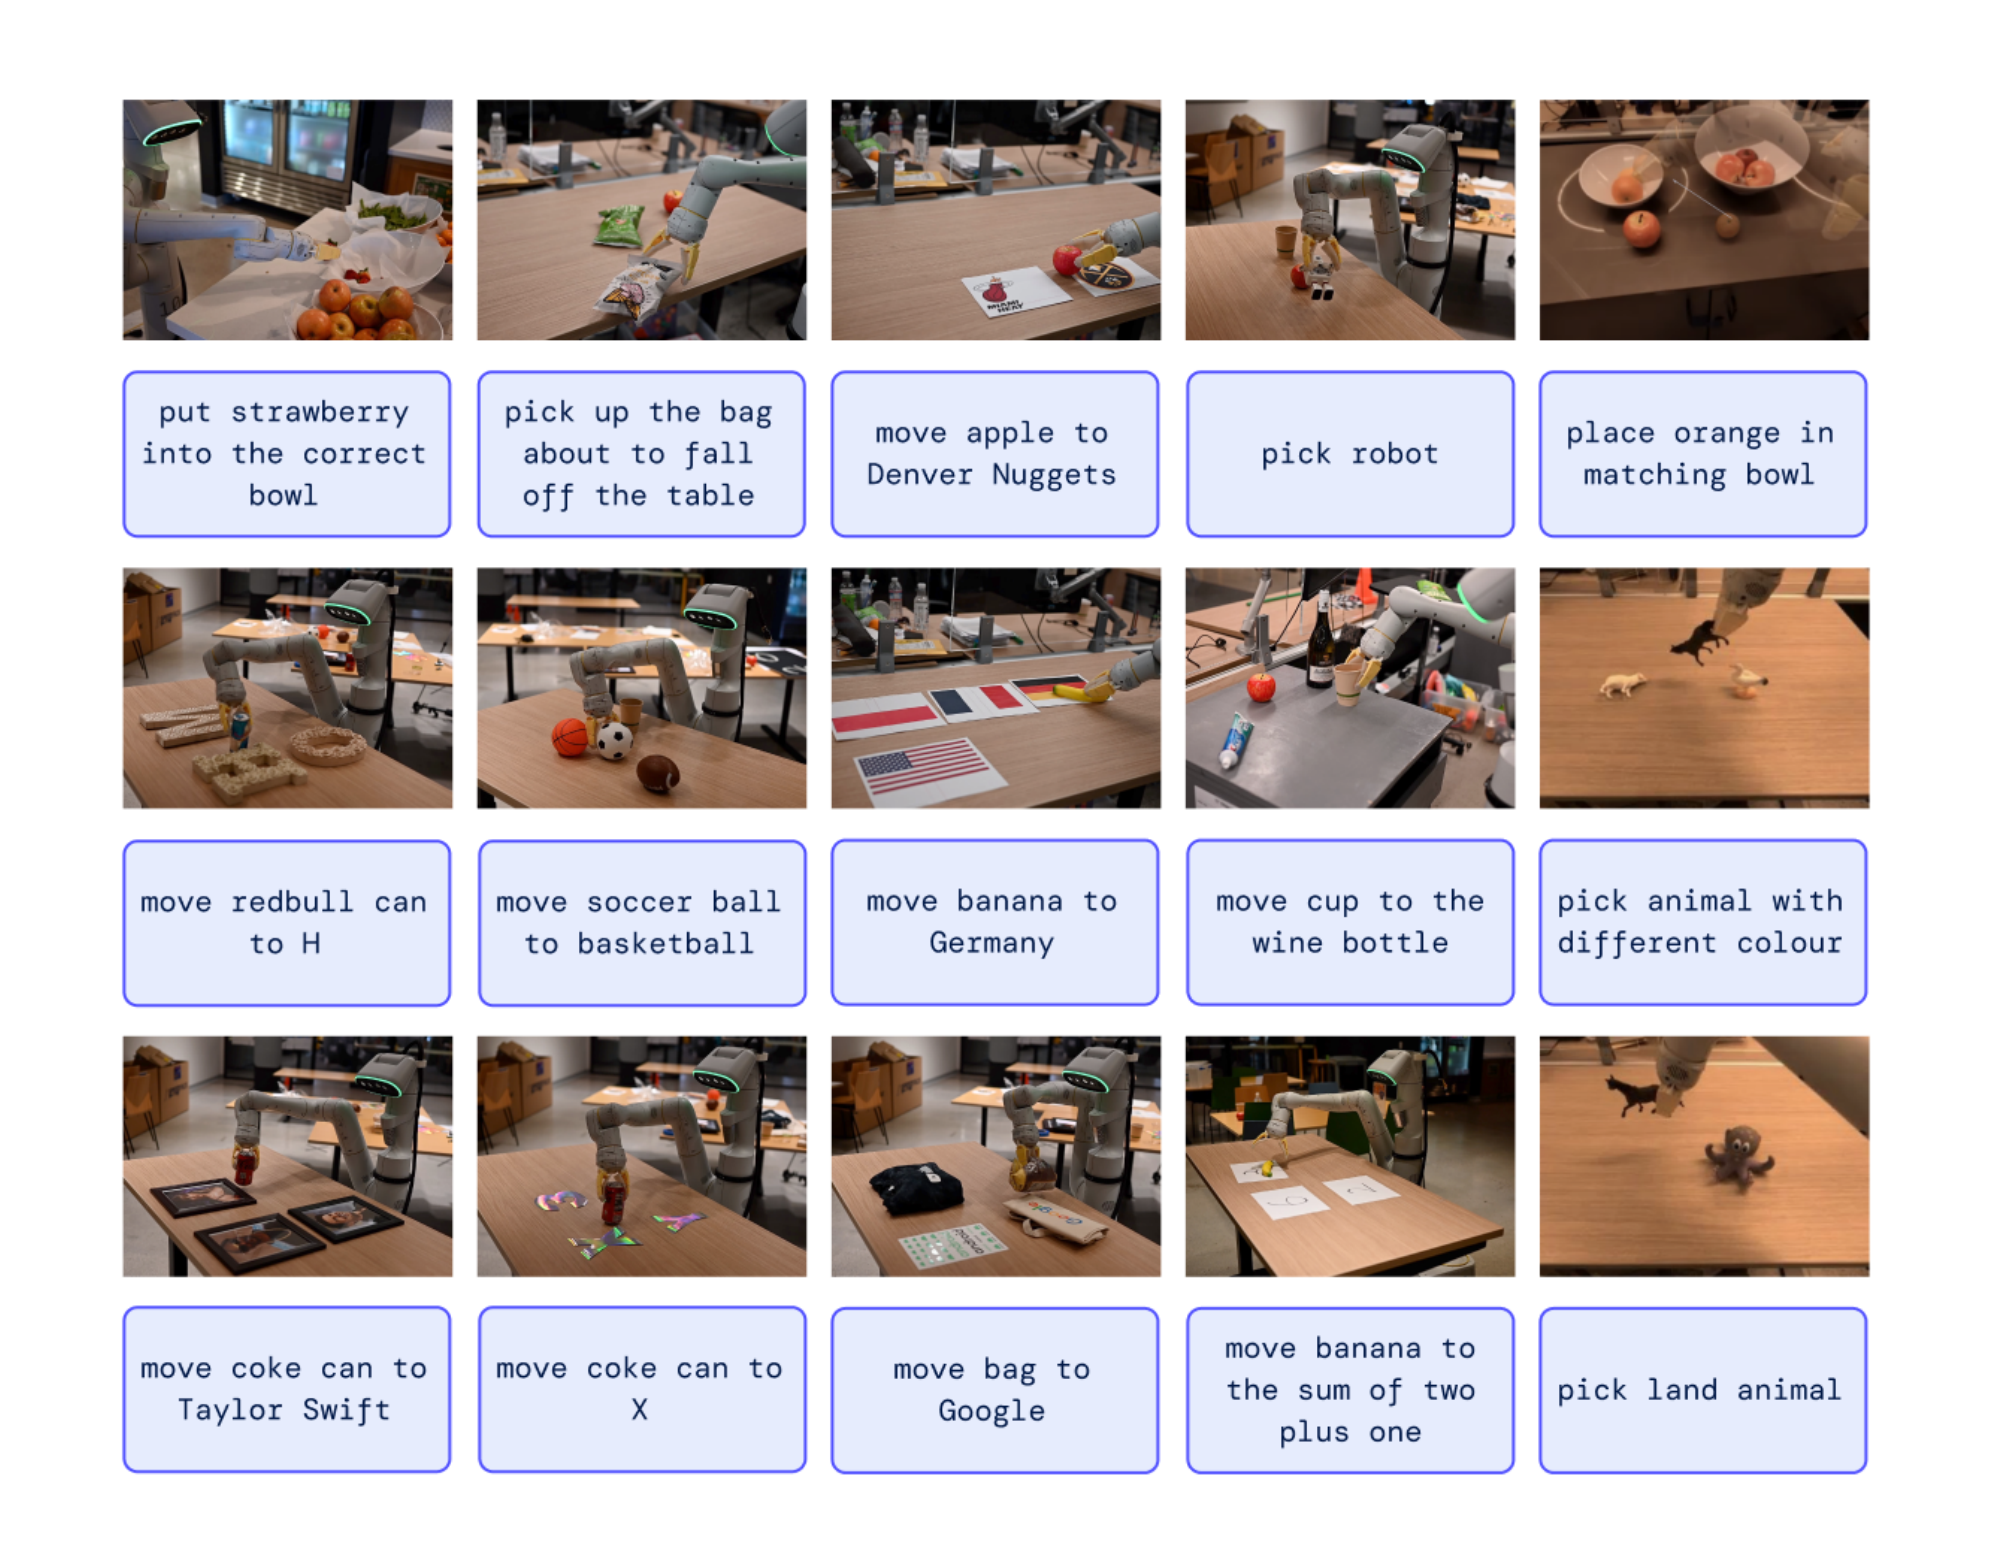
정성 평가에서 드러나는 성격은 두 가지다. "put strawberry into the correct bowl"은 딸기와 그릇이 무엇인지 아는 데 그치지 않고 딸기가 같은 과일들과 함께 놓여야 한다는 장면 맥락 추론을 요구한다. "pick up the bag about to fall off the table"은 두 봉지를 구분하고 위태롭게 놓인 쪽을 찾는 물리적 이해를 요구한다. 두 상황 모두 로봇 데이터에는 없다.
| 모델 | Symbol 1 | Symbol 2 | Symbol 3 | 기호 평균 | 수학 | 로고 | 영양 | 색과 다국어 | 추론 평균 | 유명인 | CelebA | 인물 평균 | 전체 평균 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| VC-1 | 7 | 25 | 0 | 11 | 0 | 8 | 20 | 13 | 10 | 20 | 7 | 13 | 11 |
| RT-1 | 27 | 20 | 0 | 16 | 5 | 0 | 32 | 28 | 16 | 20 | 20 | 20 | 17 |
| RT-2-PaLI-X-55B | 93 | 60 | 93 | 82 | 25 | 52 | 48 | 58 | 46 | 53 | 53 | 53 | 60 |
| RT-2-PaLM-E-12B | 67 | 20 | 20 | 36 | 35 | 56 | 44 | 35 | 43 | 33 | 53 | 43 | 40 |
(단위 %, Table 5)
최고 성능 RT-2-PaLI-X는 전체 평균 60%로 RT-1(17%)의 3배를 넘는다. 격차가 가장 큰 항목은 기호 이해다. 도형과 위치 관계를 다루는 Symbol 3에서 RT-1과 VC-1이 모두 0%인 반면 PaLI-X는 93%를 낸다. 반면 더 작은 PaLM-E 기반 모델이 수학 추론에서는 35%로 PaLI-X의 25%를 앞서는데, PaLM-E의 pre-training 혼합이 계산에 더 강한 모델을 만들었기 때문으로 본다.
크기와 학습 전략 ablation
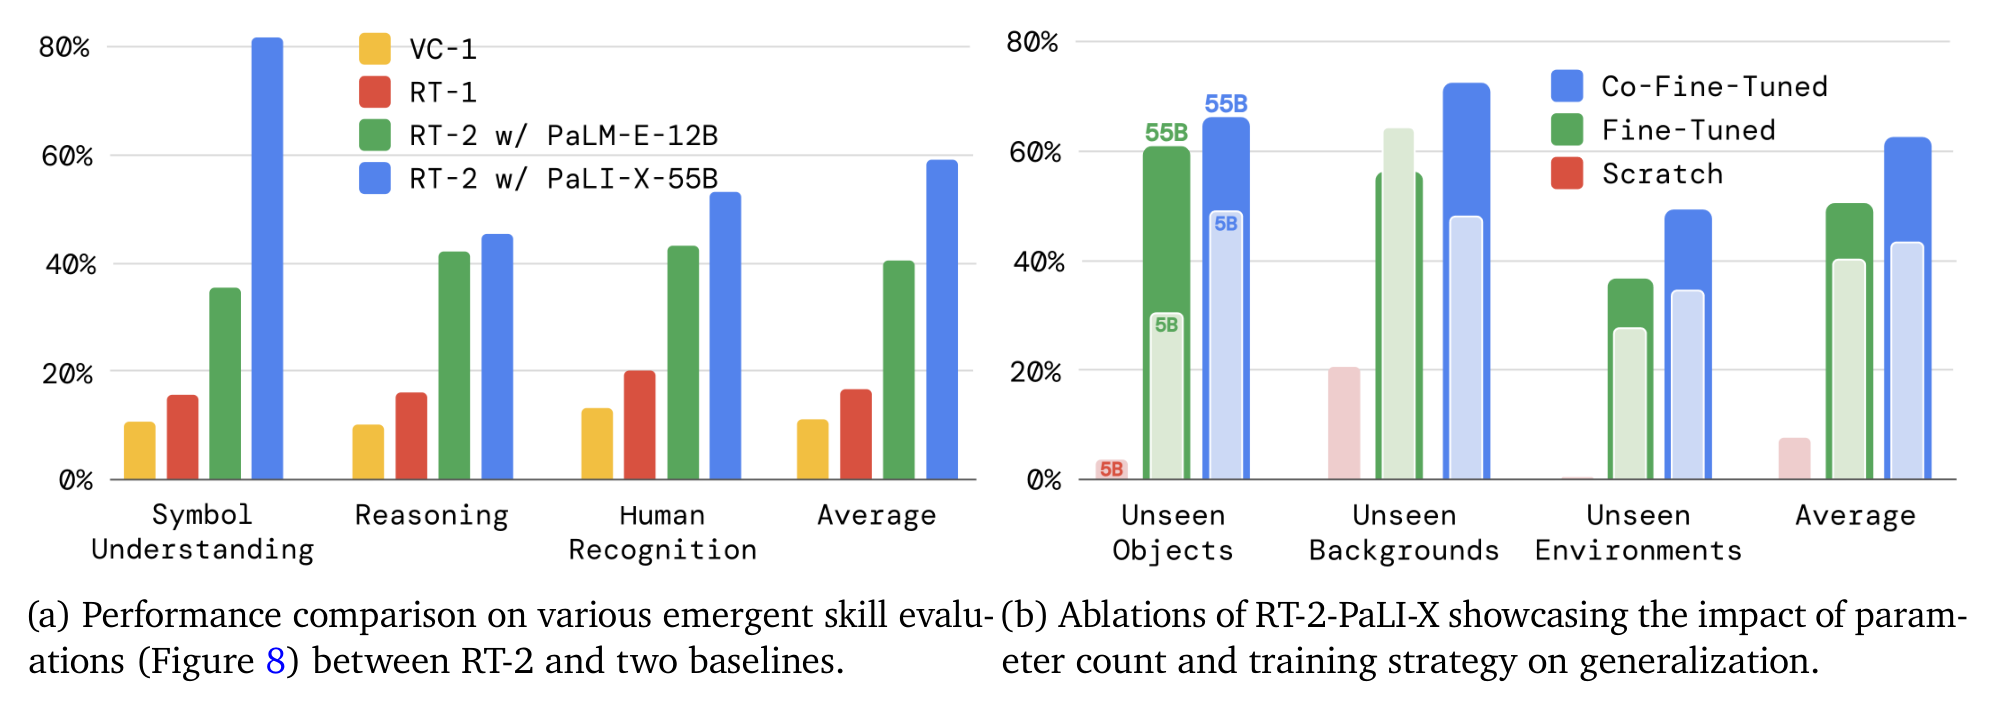
세 학습 방식과 두 크기를 비교한다. 모델 크기를 자유롭게 고를 수 있는 PaLI-X 기반 모델만 쓰고, 일반화가 관심사이므로 seen 과제 평가는 제외한다.
| 크기 | 학습 방식 | 객체 easy | 객체 hard | 배경 easy | 배경 hard | 환경 easy | 환경 hard | 평균 |
|---|---|---|---|---|---|---|---|---|
| 5B | scratch | 0 | 10 | 46 | 0 | 0 | 0 | 9 |
| 5B | fine-tuning | 24 | 38 | 79 | 50 | 36 | 23 | 42 |
| 5B | co-fine-tuning | 60 | 38 | 67 | 29 | 44 | 24 | 44 |
| 55B | fine-tuning | 60 | 62 | 75 | 38 | 57 | 19 | 52 |
| 55B | co-fine-tuning | 70 | 62 | 96 | 48 | 63 | 35 | 63 |
(단위 %, Table 6)
세 가지 결론이 나온다. 먼저 VLM 가중치 없이 scratch로 학습하면 5B에서도 평균 9%로 성능이 매우 낮다. 이 결과를 보고 저자들은 55B scratch 평가를 아예 건너뛰었다. 다음으로 co-fine-tuning이 단순 fine-tuning보다, fine-tuning이 scratch보다 낫다. 마지막으로 모델이 클수록 일반화가 좋아져 55B co-fine-tuning이 평균 63%로 가장 높다.
co-fine-tuning의 이득은 모델 크기에 따라 달라진다. 5B에서는 co-fine-tuning과 fine-tuning의 평균 차이가 2%p로 작고 항목별로 엇갈리지만, 55B에서는 그 차이가 11%p로 벌어진다.
chain-of-thought
PaLM-E 기반 모델을 수백 gradient step만 추가로 fine-tuning해 action 앞에 "Plan" 단계를 생성하게 만든다. 학습 데이터를 "Instruction: I'm hungry. Plan: pick rxbar chocolate. Action: 1 128 124 136 121 158 111 255"처럼 자연어 계획 뒤에 action 토큰이 오도록 증강하는 방식이다.
이 계획 단계는 VQA 데이터의 시각 추론과 조작 데이터의 action 생성 사이를 잇는 다리 역할을 한다. 예를 들어 "못을 박아야 하는데 장면에서 무엇이 쓸모 있을까"라는 프롬프트에 모델은 "Rocks"라는 답과 action을 함께 낸다. "졸리니 마실 것을 가져와라"에는 "Plan: pick redbull can"을 먼저 생성한 뒤 action을 낸다.
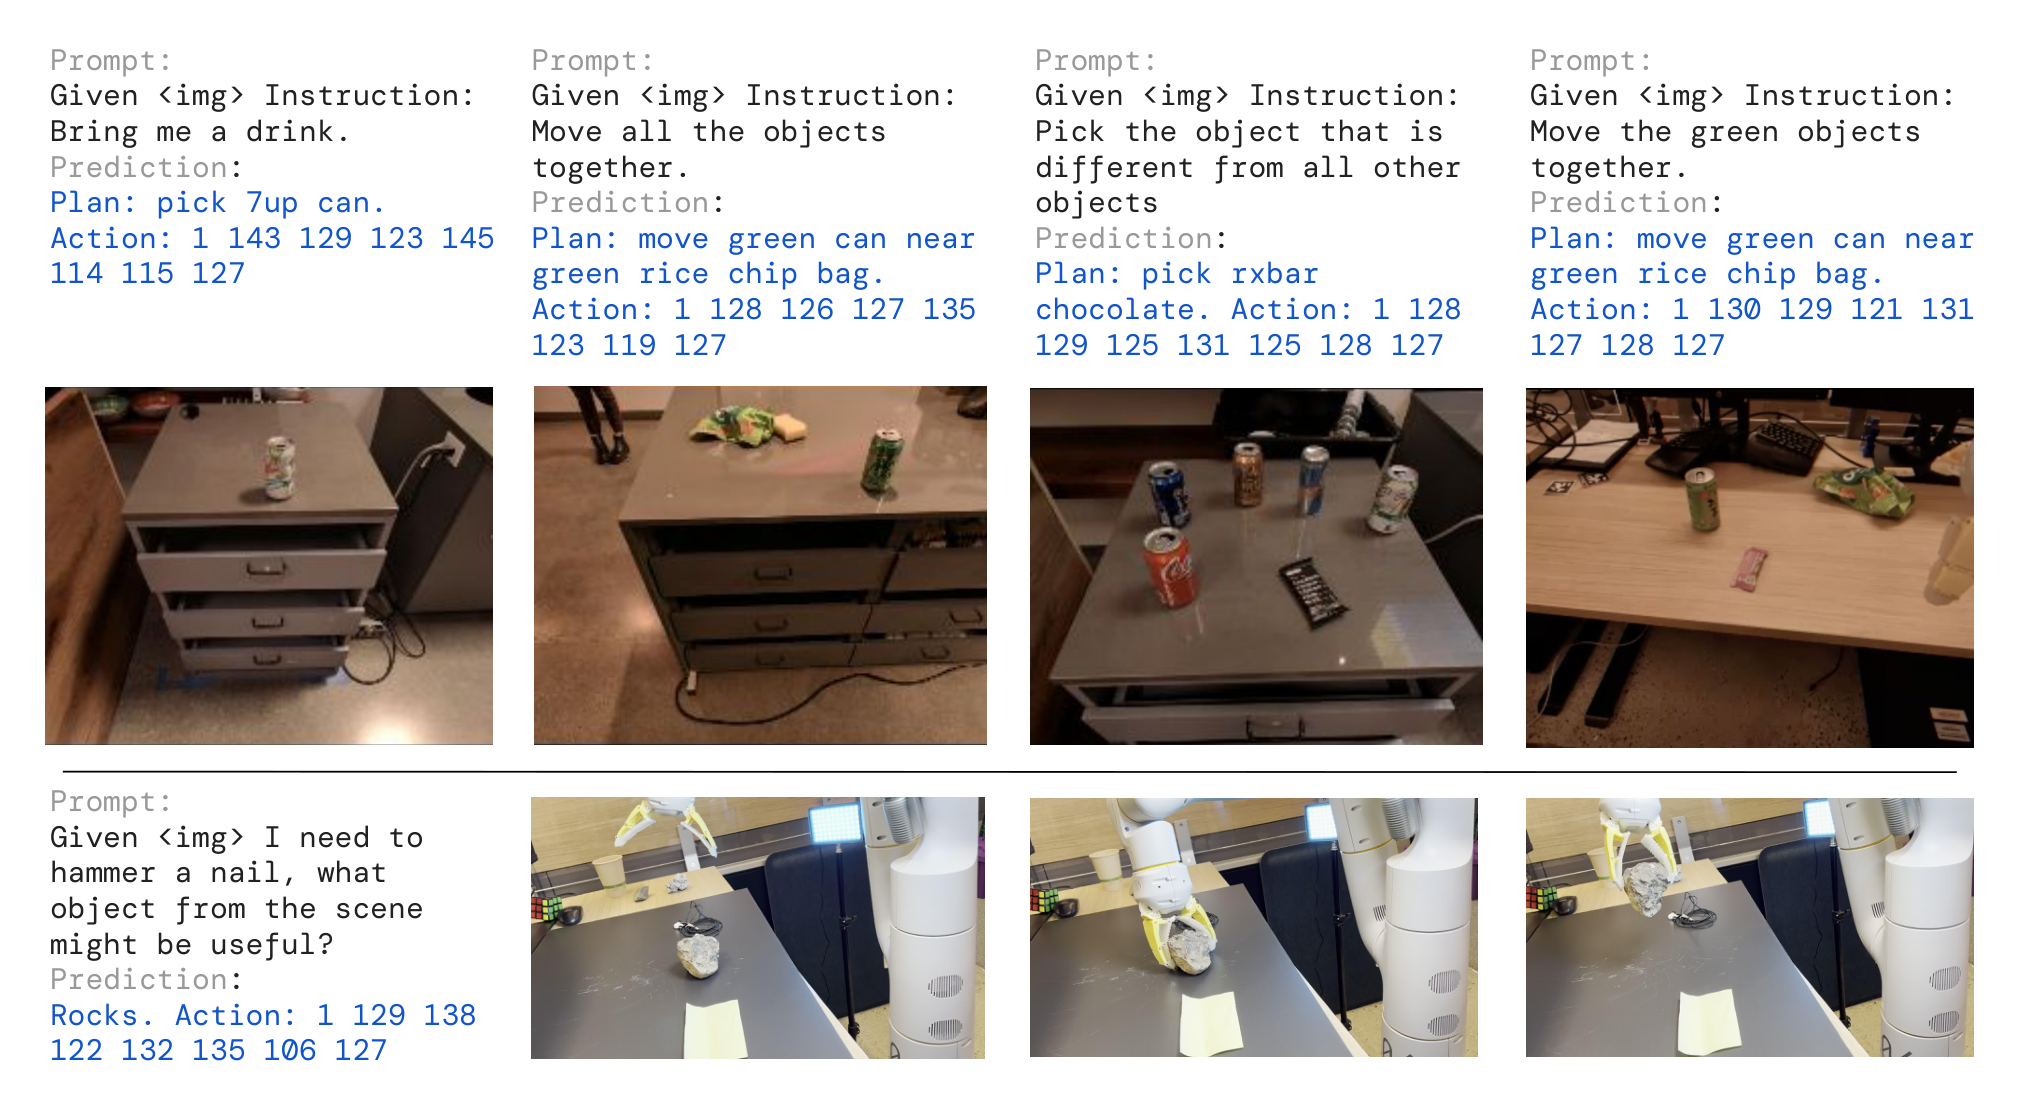
chain-of-thought 평가는 정량 비교 없이 정성 수준에 머문다. 다만 LLM과 VLM을 planner로 쓰는 흐름과 저수준 policy를 하나의 VLA 안에 합칠 수 있다는 초기 근거가 된다.
한계
새 물리 동작 자체는 배우지 못한다. 웹 pre-training은 의미와 시각 개념의 일반화를 넓히지만 로봇의 물리 스킬은 여전히 로봇 데이터 분포 안에 갇힌다. 저자들은 데이터가 스킬 측면에서 충분히 다양하지 않아서라고 보고, 사람 영상 같은 새 데이터 수집 방식을 후속 방향으로 든다.
계산 비용도 높다. 고빈도 제어가 필요한 상황에서는 실시간 추론이 병목이 될 수 있어 양자화와 distillation을 후속 과제로 짚는다. RT-2를 만들 재료가 되는 VLM 자체가 아직 소수라는 점도 한계다. 저자들은 오픈소스 VLM이 늘고 상용 모델이 fine-tuning API를 열기를 기대하는데, fine-tuning API 공개가 VLA를 만들기 위한 충분 조건이라고 적었다.
실패 사례는 부록에 구체적으로 남아 있다. Language-Table에서 RT-2는 처음 보는 객체의 dynamics에 일반화하지 못한다. dynamics는 상태가 action에 따라 어떻게 변하는지의 규칙이다. 모델이 지시문을 제대로 해석해 목표 물체까지 이동하지만 그 물체의 움직임을 제어하지 못하는 형태의 실패다. 펜은 그대로 테이블 밖으로 굴러 떨어지고, 바나나는 무게중심이 접촉점에서 멀어 의도한 방향으로 밀리지 않는다.
실세계 조작에서도 네 유형의 실패가 남는다.
- 손잡이처럼 특정 부위를 지정해 잡기
- 로봇 데이터에 없던 새 동작, 예를 들어 수건으로 닦기나 tool use
- 수건 접기 같은 정밀하고 섬세한 동작
- 여러 층의 간접 추론이 필요한 과제
계보에서의 위치
RT-2는 physical-ai 카테고리에서 VLA 계보의 기준점이다. "pre-training된 VLM을 로봇 데이터로 fine-tuning해 action을 내게 한다"는 레시피의 원형이며, 이후 나온 조작용 VLA가 대부분 여기서 갈라져 나온다.
바로 앞 세대는 RT-1이다. RT-2는 RT-1의 로봇 데이터(로봇 13대, 17개월, office kitchen, 7종 스킬)와 action tokenization(256 bin, 8개 정수)을 그대로 물려받되, backbone을 35M Transformer에서 수십억 파라미터 VLM으로 키웠다. 그래서 RT-1이 seen 과제에서 강했다면 RT-2는 unseen 일반화에서 격차를 벌린다.
한 세대 뒤로 가면 GR00T N1이 RT-1, RT-2, π0, OpenVLA를 VLA-via-finetuning 계보로 묶고 그 후속으로 스스로를 자리매김한다. RT-2가 단일 대형 VLM 안에서 언어와 action을 하나의 손실로 학습했다면, GR00T N1은 VLM(느린 추론)과 DiT(빠른 action)를 dual-system으로 분리하고 데이터 병목을 정면으로 다룬다. 두 논문을 나란히 읽으면 VLA 설계가 단일 backbone에서 dual-system으로, 초점이 아키텍처에서 데이터로 옮겨간 흐름이 보인다.
RT-2가 한계로 지목한 "새 물리 동작을 못 배운다"는 문제는 World Model 서베이가 진단한 병목과 이어진다. 그럴듯한 미래를 그리는 데서 action에 alignment된 실행 가능한 미래를 그리는 데로 넘어가야 한다는 진단이다. backbone VLM 자체를 더 키우자는 방향은 VLM3의 논의 대상이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| VLA | 이미지와 언어 입력에서 로봇 action을 내는 모델 계열. RT-2가 이 이름을 붙였다 |
| co-fine-tuning | 로봇 데이터만 fine-tuning하지 않고 원래 웹 데이터를 배치에 섞어 함께 fine-tuning하는 방식. RT-2 일반화의 핵심 |
| action tokenization | 연속 action을 256 bin으로 이산화해 정수 토큰 문자열로 표현하는 것. RT-1에서 이어받았다 |
| symbol tuning | 기존 토큰의 의미를 다른 것(여기서는 action bin)으로 덮어써 학습하는 기법. PaLM-E의 action 어휘 구성에 쓰인다 |
| output constraint | 로봇 action 프롬프트일 때만 유효 action 토큰으로 디코딩 어휘를 제한하는 장치 |
| emergent capability | 로봇 데이터에 없었는데 웹 pre-training에서 전이돼 나타난 능력. 기호 이해, 추론, 인물 인식 |
관련 페이지
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 이 논문의 한국어 입문 해설. 기초 개념이 낯설면 먼저 읽는다
- RT-1: Robotics Transformer for Real-World Control at Scale: 직접 전신. RT-2가 로봇 데이터와 action tokenization을 그대로 물려받은 모델
- OpenVLA: An Open-Source Vision-Language-Action Model: RT-2의 레시피를 오픈소스로 옮긴 후속 VLA
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: VLA-via-finetuning 계보의 후속. 단일 backbone에서 dual-system으로, 아키텍처에서 데이터로 초점 이동
- World Model for Robot Learning: A Comprehensive Survey: policy와 world model 결합 서베이. RT-2의 새 동작 학습 불가 한계와 이어지는 병목 진단
- VLM3: Vision Language Models Are Native 3D Learners: VLM 아키텍처. RT-2 성능을 좌우하는 backbone 쪽 논의
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브