Physical AI · PAPER · 2024
OpenVLA: An Open-Source Vision-Language-Action Model
요약
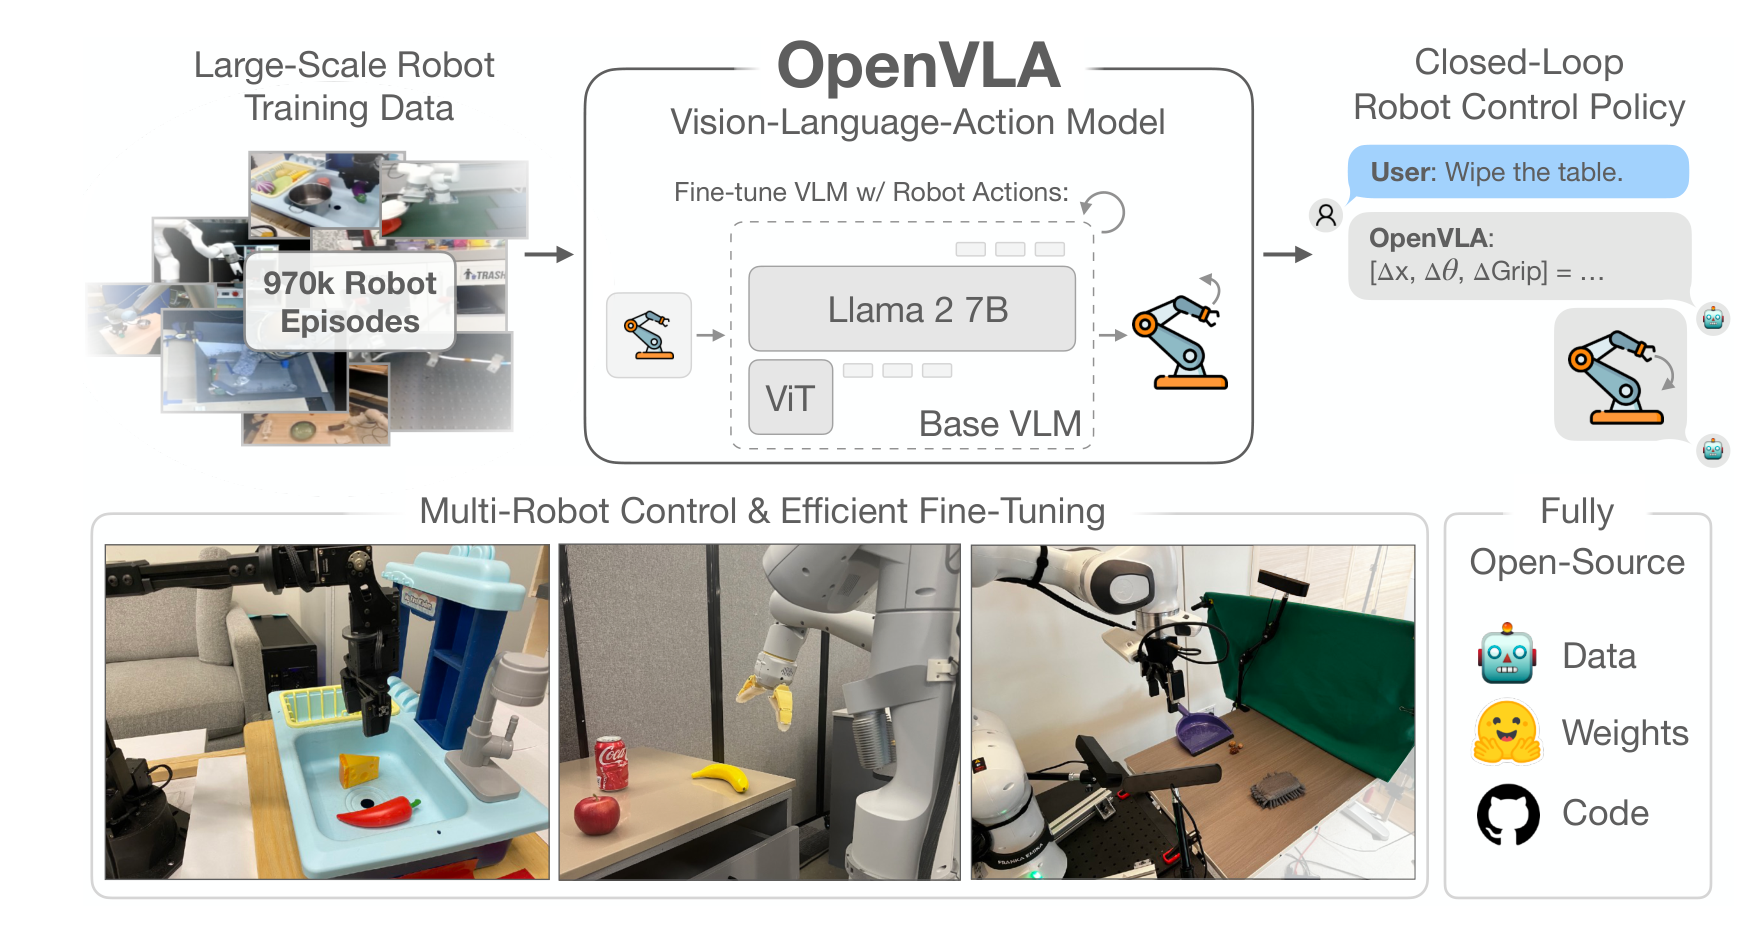
OpenVLA는 완전히 공개된 7B 규모의 vision-language-action model이다. VLA는 vision-language-action model의 약어로, 이미지와 언어 지시문(instruction)을 받아 로봇 제어 action을 직접 출력하는 모델을 가리킨다. Open X-Embodiment에서 추린 97만 개의 실세계 시연 데이터(demonstration)로 Prismatic-7B VLM을 fine-tune했고, 그 결과 55B 규모의 RT-2-X를 29개 평가 task 절대 성공률에서 16.5%p 앞서면서 파라미터는 7분의 1에 그친다.
이 논문의 기여는 성능 수치보다 공개성과 실용성 쪽이 크다. 기존 VLA는 아키텍처와 학습 절차와 데이터 혼합이 모두 비공개여서 후속 연구의 기반이 되지 못했다. 반면 OpenVLA는 model checkpoint, PyTorch 학습 코드, fine-tuning notebook을 전부 열었고 여기에 두 가지 실전 레시피를 처음으로 붙였다. 소비자용 GPU에서 LoRA로 fine-tune하는 방법과 양자화로 서빙 메모리를 절반 이하로 줄이는 방법이다.
배경
학습된 manipulation policy의 고질적 약점은 학습 데이터 밖으로 나가지 못한다는 점이다. 개별 skill이나 개별 지시문에 맞춰 학습한 policy는 물체 위치나 조명이 바뀌는 정도는 감당하지만, 장면에 방해 물체가 놓이거나 처음 보는 물체가 등장하면 흔들리고 학습에 없던 지시문은 아예 수행하지 못한다.
반면 로보틱스 밖의 foundation model은 이런 종류의 일반화를 이미 해낸다. CLIP, SigLIP, Llama 2가 그런 사례이며, 그 능력은 인터넷 규모 pre-training 데이터가 심어 준 사전 지식에서 나온다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계를 말한다.
로봇 쪽에서 같은 규모의 pre-training을 재현하기는 아직 어렵다. 가장 큰 manipulation 데이터셋조차 10만에서 100만 개 수준의 예제에 머문다. 따라서 남는 선택지는 이미 만들어진 vision-language foundation model을 로봇 policy의 뼈대로 쓰는 쪽이며, RT-2가 이 방향을 대표한다.
그런데 VLA가 널리 쓰이지 못하게 막는 요인이 두 가지 남아 있었다. 논문은 이 두 가지를 문제 설정의 출발점으로 삼는다.
- 기존 VLA가 닫혀 있다. 모델 아키텍처, 학습 절차, 데이터 혼합 중 어느 것도 외부에서 볼 수 없다.
- 새 로봇과 새 환경에 적응시킬 때 참고할 fine-tuning 기준이 없다. 특히 소비자용 GPU 같은 범용 하드웨어에서의 절차가 비어 있다.
따라서 OpenVLA의 목표는 성능 기록 경신이 아니다. 오픈소스 언어 모델 생태계가 커진 방식을 로보틱스로 옮겨, 재현과 개조와 fine-tuning이 모두 가능한 generalist VLA를 내놓는 것이 목표다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. OpenVLA에서 observation은 카메라가 찍은 현재 장면 이미지 한 장이고, 여기에 사람이 준 자연어 지시문이 조건으로 함께 들어간다.
generalist policy는 과제별 학습 없이 하나의 모델로 여러 로봇과 여러 과제를 처리하는 policy다. OpenVLA는 특정 로봇 하나에 맞춘 모델이 아니라 여러 embodiment를 추가 학습 없이 제어하는 generalist policy를 지향한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다.
action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다. 언어 모델은 다음 토큰을 맞히도록 학습된 모델이라 연속값을 그대로 내놓지 못하므로, RT-2와 OpenVLA는 action을 토큰으로 바꿔 언어 모델의 출력 공간 안에서 다룬다.
imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법이다. OpenVLA의 학습은 성공한 시연 데이터에 대한 next-token prediction 하나로 끝나며, 강화학습은 쓰지 않는다.
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. 이 값은 뒤의 양자화 실험에서 결정적 변수로 등장하는데, 평가에 쓴 non-blocking controller가 이전 action의 완료를 기다리지 않고 다음 action을 내보내기 때문에 추론이 느려지면 시스템 동역학 자체가 학습 때와 달라진다.
방법
backbone VLM과 fused vision encoder
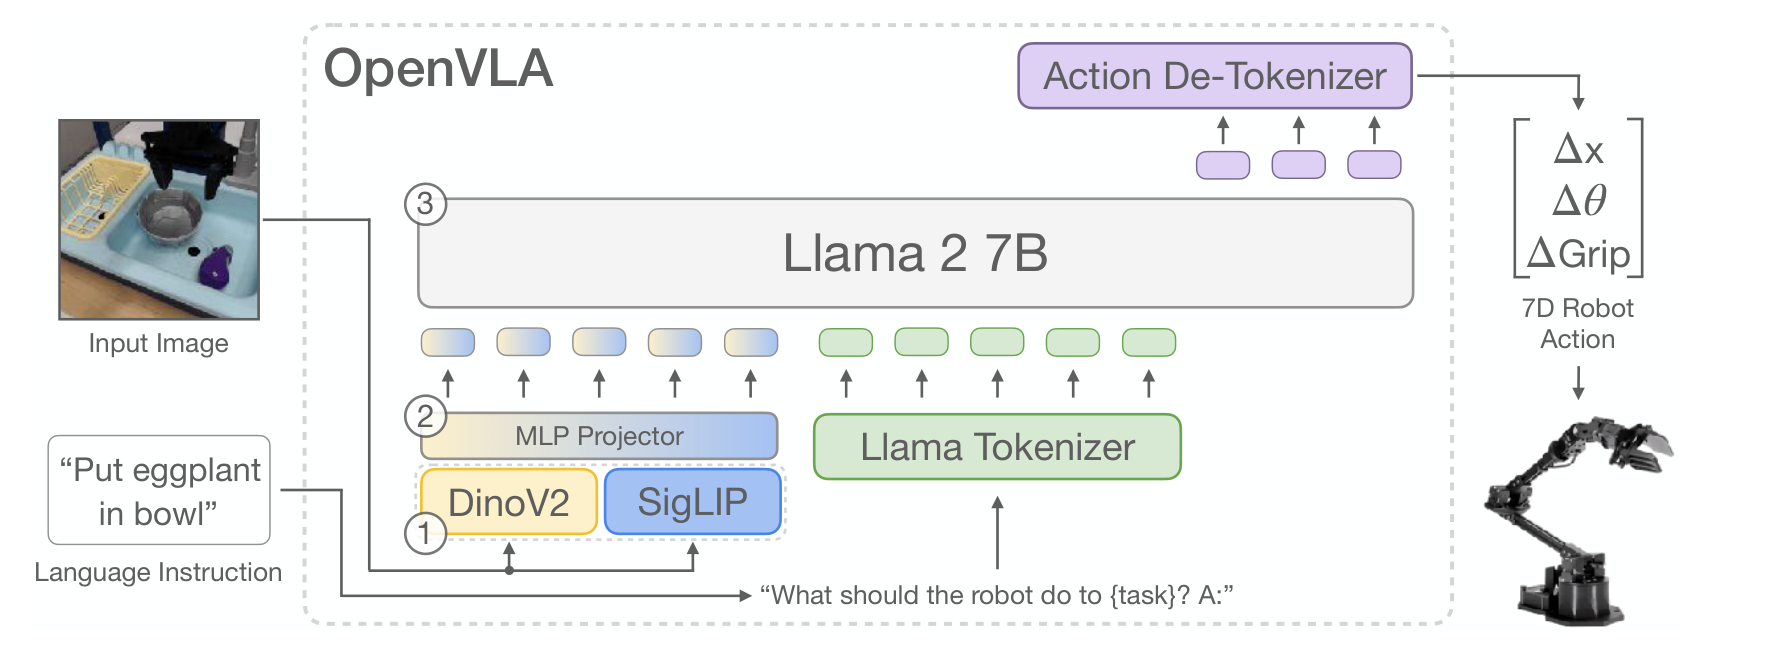
OpenVLA의 토대는 Prismatic-7B VLM이다. 구조는 최근 VLM의 표준 3단 구성을 그대로 따른다. 즉 이미지를 패치 임베딩으로 바꾸는 vision encoder, 그 출력을 언어 모델의 입력 공간으로 옮기는 projector, 그리고 LLM backbone이다.
| 구성 요소 | 내용 | 규모 |
|---|---|---|
| vision encoder | SigLIP과 DINOv2를 함께 통과시킨 뒤 feature를 채널 방향으로 concat | 600M 파라미터 |
| projector | 시각 feature를 언어 모델의 임베딩 공간으로 옮기는 2-layer MLP | 소형 |
| LLM backbone | Llama 2 | 7B 파라미터 |
특징은 vision encoder가 하나가 아니라 둘이라는 점이다. feature는 모델이 입력에서 뽑아낸 중간 표현 벡터를 말하는데, SigLIP은 상위 수준의 의미 정보를 담고 DINOv2는 저수준 공간 정보를 담는다. CLIP이나 SigLIP 단독 encoder를 쓰는 흔한 구성과 달리 DINOv2를 더하면 spatial reasoning, 즉 장면의 공간 관계를 파악하는 능력이 좋아지고 이 능력은 로봇 제어에 특히 유용하다.
Prismatic 자체는 이 세 부품 위에 오픈소스 데이터셋에서 모은 약 100만 개의 LLaVA 1.5 샘플로 fine-tune한 VLM이다.
action을 언어 토큰으로 적기
OpenVLA는 action 예측 문제를 vision-language 과제로 다시 적는다. 입력은 이미지 observation과 "What should the robot do to {task}? A:" 형식의 프롬프트이고, 출력은 action을 나타내는 문자열이다.
연속 action을 언어 모델이 다루려면 이산 토큰으로 바꿔야 한다. RT-2를 따라 각 action 차원을 256개 bin으로 균등 이산화하되, 구간의 기준을 min-max가 아니라 학습 데이터의 1st에서 99th quantile로 잡는다. 드물게 튀는 outlier action이 이산화 간격을 크게 넓혀 실효 해상도를 떨어뜨리는 것을 막기 위해서다.
토큰 자리는 새로 만들지 않고 기존 어휘를 덮어쓴다. Llama 토크나이저가 fine-tuning용으로 예약한 special token은 100개뿐이라 256개 action 토큰을 감당하지 못하기 때문이다. 그래서 RT-2와 마찬가지로 어휘에서 가장 덜 쓰이는 마지막 256개 토큰을 action 토큰으로 대체한다.
학습 목표는 표준 next-token prediction 하나이며, cross-entropy는 예측된 action 토큰에만 매긴다. 최종 출력은 end-effector 기준 7-DoF action, 즉 위치 변화 Δx, 자세 변화 Δθ, 그리퍼 개폐 ΔGrip이고 action de-tokenizer가 토큰을 다시 연속값으로 되돌린다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분을 가리킨다.
학습 데이터 curation
학습 데이터의 원천은 Open X-Embodiment(OpenX)다. 논문 작성 시점 기준으로 70개가 넘는 개별 robot dataset과 200만 개가 넘는 trajectory를 하나의 형식으로 모은 공동 작업의 결과물이다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다.
이 원본을 그대로 쓰지 않고 두 가지 목표로 걸러 낸다.
- 입력과 출력 공간을 일관되게 맞춘다. 3인칭 카메라를 최소 한 대 갖추고 single-arm end-effector 제어를 쓰는 manipulation dataset만 남긴다.
- embodiment와 task와 scene이 고르게 섞이도록 한다. 첫 조건을 통과한 dataset에 Octo의 mixture weight를 그대로 적용해, 다양성이 낮은 dataset의 비중을 낮추고 task와 scene 다양성이 큰 dataset의 비중을 높인다.
이렇게 추린 결과가 97만 개의 시연 데이터다. 최종 혼합에서 비중이 큰 dataset은 다음과 같다.
| dataset | 비율 |
|---|---|
| Bridge | 13.3% |
| Fractal | 12.7% |
| Kuka | 12.7% |
| DROID | 10.0% (학습 후반 제외) |
| BC-Z | 7.5% |
| FMB | 7.1% |
| Language Table | 4.4% |
| Stanford Hydra | 4.4% |
DROID는 최근 공개된 대규모 in-the-wild Franka manipulation dataset으로 10%라는 보수적 가중치로 넣었다. 그런데 학습 내내 DROID의 action token 정확도가 낮게 유지되어, 최종 모델의 품질을 해치지 않도록 학습 마지막 3분의 1 구간에서 혼합에서 제외하고 그 가중치를 나머지 dataset에 재배분했다. 저자들은 DROID의 다양성을 흡수하려면 더 큰 가중치나 더 큰 모델이 필요할 것으로 본다.
설계 결정
최종 학습에 들어가기 전에 BridgeData V2만 쓰는 작은 규모 실험으로 주요 선택지를 하나씩 비교했다. 반복 속도를 높이고 연산 비용을 줄이기 위한 절차다.
| 항목 | 비교 대상 | 최종 선택과 근거 |
|---|---|---|
| VLM backbone | IDEFICS-1, LLaVA, Prismatic | Prismatic. 여러 물체 중 지시 대상을 골라야 하는 language grounding task에서 LLaVA가 IDEFICS-1을 35%p 앞섰고 Prismatic이 다시 LLaVA를 약 10%p 앞섰다 |
| 입력 해상도 | 224×224px, 384×384px | 224×224px. 성능 차이가 없는데 384×384px는 학습에 3배가 걸린다 |
| vision encoder 고정 여부 | frozen, fine-tuned | fine-tuned. pre-training된 vision backbone만으로는 정밀 제어에 필요한 fine-grained 공간 정보가 부족하다 |
| 학습 epoch | 통상 1~2 epoch, 27 epoch | 27 epoch. action token 정확도가 95%를 넘을 때까지 실제 로봇 성능이 계속 올랐다 |
| learning rate | 여러 자릿수에 걸친 탐색, warmup 유무 | 고정 2e-5. VLM pre-training과 같은 값이며 warmup은 이득이 없었다 |
해상도와 epoch 항목의 결론은 일반 VLM 벤치마크의 경험과 어긋난다. 일반 VLM은 해상도를 올리면 대체로 성능이 오르지만 VLA 설정에서는 그 경향이 아직 확인되지 않았고, 1~2 epoch면 충분한 VLM 학습과 달리 VLA는 27 epoch가 필요했다. vision encoder를 freeze하는 편이 낫다는 VLM 통념도 VLA에서는 반대로 뒤집힌다.
학습과 추론 인프라
최종 모델은 A100 GPU 64장으로 14일, 총 21,500 A100-hour를 들여 batch size 2048로 학습했다. 추론은 bfloat16 기준 GPU 메모리 15GB를 쓰며 RTX 4090 한 장에서 약 6Hz로 동작한다. 즉 1초에 여섯 번 새 action을 내는 속도이며, compile이나 speculative decoding 같은 가속 기법은 적용하지 않은 값이다.
로컬 연산 자원이 부족한 환경을 위해 원격 VLA 추론 서버도 함께 공개했다. 로봇 쪽에 강력한 GPU를 두지 않아도 action 예측을 실시간으로 스트리밍받을 수 있다.
공개한 codebase는 PyTorch 기반의 모듈식 구현이다. GPU 한 장에서의 fine-tuning부터 multi-node cluster에서의 수십억 파라미터 학습까지 같은 코드로 확장되며, automatic mixed precision과 FlashAttention과 fully sharded data parallelism을 지원한다. HuggingFace의 AutoModel 클래스와 통합되고 LoRA fine-tuning과 양자화 추론도 기본 제공한다.
결과
평가 설계
실험은 세 가지 질문에 답하도록 구성된다. 추가 학습 없이 여러 로봇을 제어하는 generalist policy로 쓸 수 있는가, 새 로봇 setup에 효과적으로 fine-tune되는가, 그리고 parameter-efficient fine-tuning과 양자화로 연산 요구를 낮출 수 있는가다.
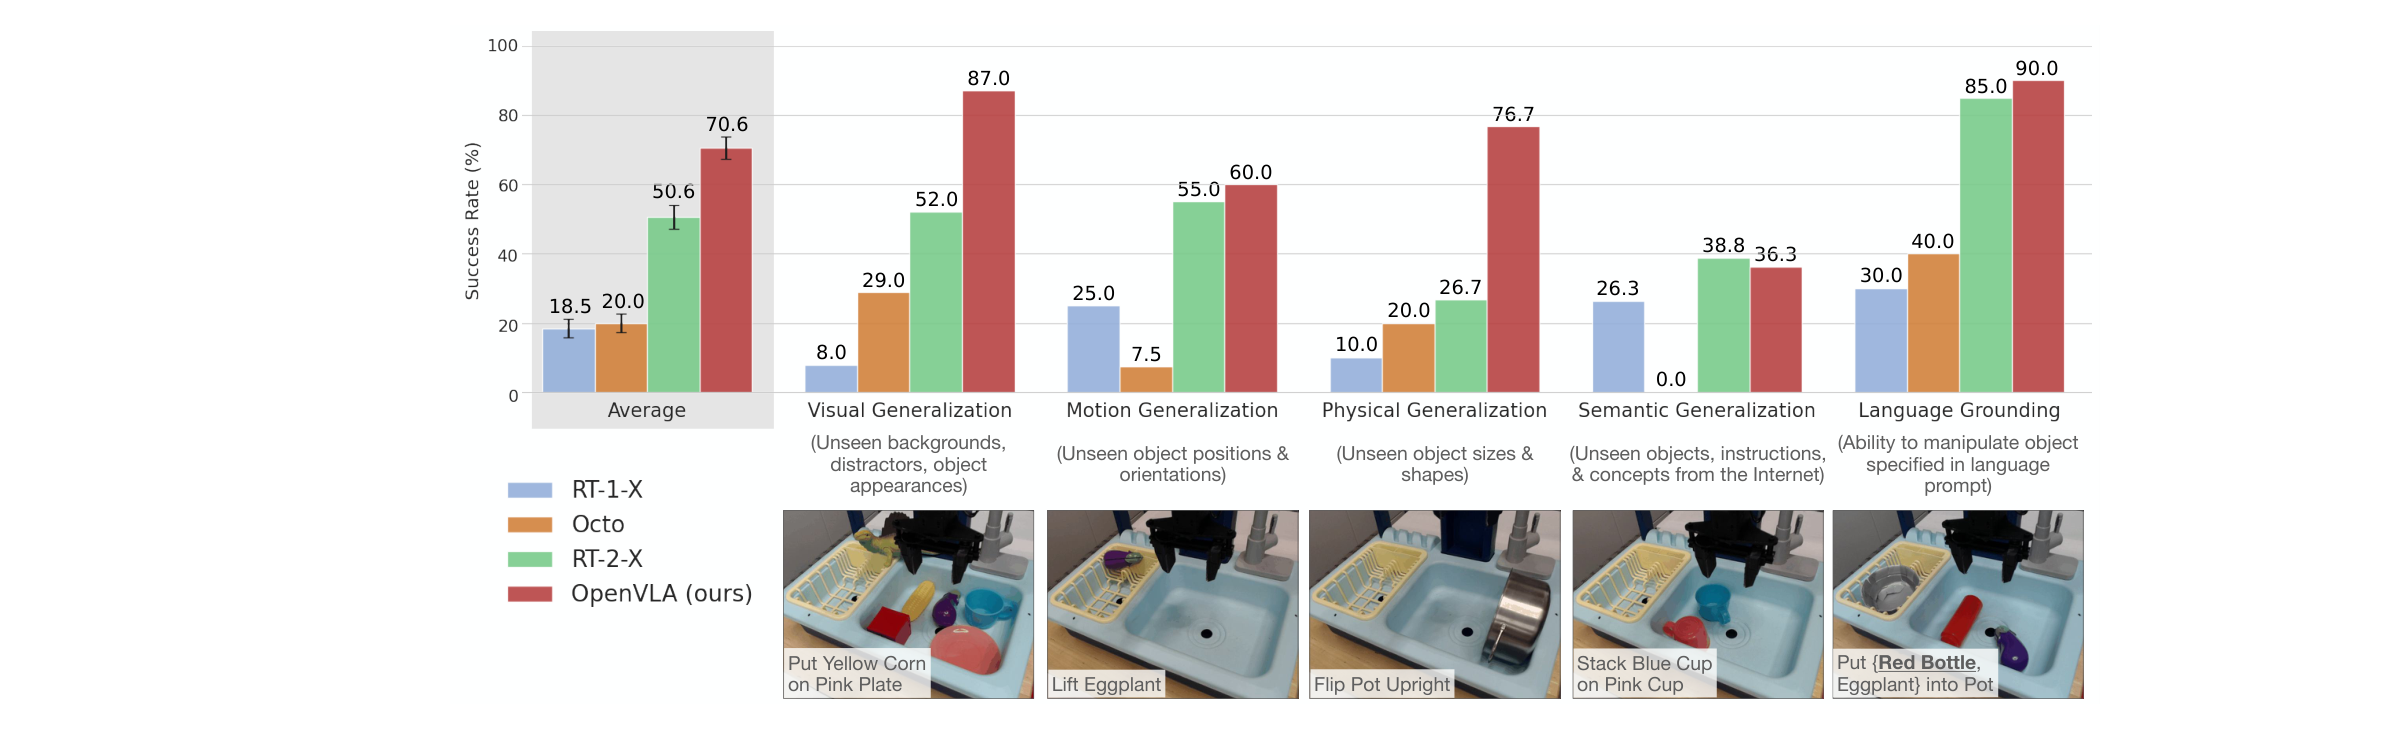
out-of-the-box 평가는 BridgeData V2 평가에 쓰인 WidowX와 RT-1 및 RT-2 평가에 쓰인 Google robot 두 embodiment에서 진행한다. 평가 task는 일반화의 네 측면을 각각 시험하도록 설계했다. visual은 처음 보는 배경과 방해 물체와 색상, motion은 처음 보는 물체 위치와 자세, physical은 처음 보는 크기와 형태, semantic은 처음 보는 대상 물체와 지시문과 인터넷 개념을 다루며, 여기에 여러 물체를 놓고 지시문이 가리키는 대상만 조작하는지 보는 language grounding이 더해진다.
규모는 BridgeData V2가 17개 task에 각 10회씩 총 170 rollout, Google robot이 12개 task에 각 5회씩 총 60 rollout이다. rollout은 policy를 실행해 trajectory를 만들어내는 과정을 말한다. 모든 평가는 같은 task와 같은 초기 상태를 쓰는 A/B 방식으로 진행했고, 어려운 task에서는 대상 물체에 올바로 접근하면 0.5점의 부분 점수를 준다.
비교 대상은 선행 generalist policy 세 가지다. RT-1-X(35M)와 Octo(93M)는 OpenX의 부분집합으로 from-scratch 학습한 Transformer policy이고, RT-2-X(55B)는 인터넷 pre-training된 backbone을 쓴 비공개 VLA로 직전 최고 성능 모델이다.
추가 학습 없는 제어 성능
BridgeData V2 WidowX에서 OpenVLA가 평균 70.6%로 가장 높다. 항목별로 보면 semantic generalization 하나를 빼고 모두 앞선다.
| 항목 | RT-1-X | Octo | RT-2-X | OpenVLA |
|---|---|---|---|---|
| visual generalization | 8.0% | 29.0% | 52.0% | 87.0% |
| motion generalization | 25.0% | 7.5% | 55.0% | 60.0% |
| physical generalization | 10.0% | 20.0% | 26.7% | 76.7% |
| semantic generalization | 26.3% | 0.0% | 38.8% | 36.3% |
| language grounding | 30.0% | 40.0% | 85.0% | 90.0% |
| 전체 평균 | 18.5±2.7% | 20.0±2.6% | 50.6±3.5% | 70.6±3.2% |
RT-2-X가 semantic generalization에서 앞서는 이유는 학습 방식의 차이에 있다. RT-2-X는 더 큰 인터넷 pre-training 데이터를 쓰고 로봇 action 데이터와 인터넷 데이터를 함께 co-fine-tuning해 pre-training 지식을 더 잘 보존한다. co-fine-tuning은 로봇 데이터와 웹 데이터를 한 배치에 섞어 함께 fine-tuning하는 레시피를 말한다. 반면 OpenVLA는 로봇 데이터만으로 fine-tune했다.
Google robot에서는 OpenVLA와 RT-2-X가 대등하고 둘 다 나머지를 크게 앞선다.
| 조건 | RT-1-X | Octo | RT-2-X | OpenVLA |
|---|---|---|---|---|
| in-distribution (5 task) | 32.0% | 44.0% | 72.0% | 88.0% |
| out-of-distribution (7 task) | 34.3% | 14.3% | 82.9% | 82.9% |
| 전체 평균 | 33.3±6.1% | 26.7±5.8% | 78.3±5.4% | 85.0±4.6% |
정성적으로도 RT-2-X와 OpenVLA만 뚜렷이 안정적인 거동을 보인다. 방해 물체가 있어도 올바른 대상에 접근하고, end-effector 자세를 대상 물체의 방향에 맞추며, 불안정하게 쥔 물체를 놓친 뒤 다시 시도하는 복구 행동까지 나온다.
7B 모델이 55B 모델과 대등하거나 앞선 원인으로 논문은 세 가지를 함께 든다. 첫째는 학습 데이터 규모로, OpenVLA가 97만 개인 데 비해 RT-2-X는 35만 개다. 둘째는 더 꼼꼼한 데이터 정제이며 all-zero action 필터링이 그 예다. 셋째는 의미 feature와 공간 feature를 결합한 fused vision encoder다.
신규 로봇 setup 적응
새 로봇 환경 적응은 fine-tuning으로 검증한다. task마다 시연 데이터를 10개에서 150개만 모아 전체 파라미터를 fine-tune하는 단순한 레시피를 썼다.
| setup | 로봇 | control frequency | task와 시연 데이터 수 |
|---|---|---|---|
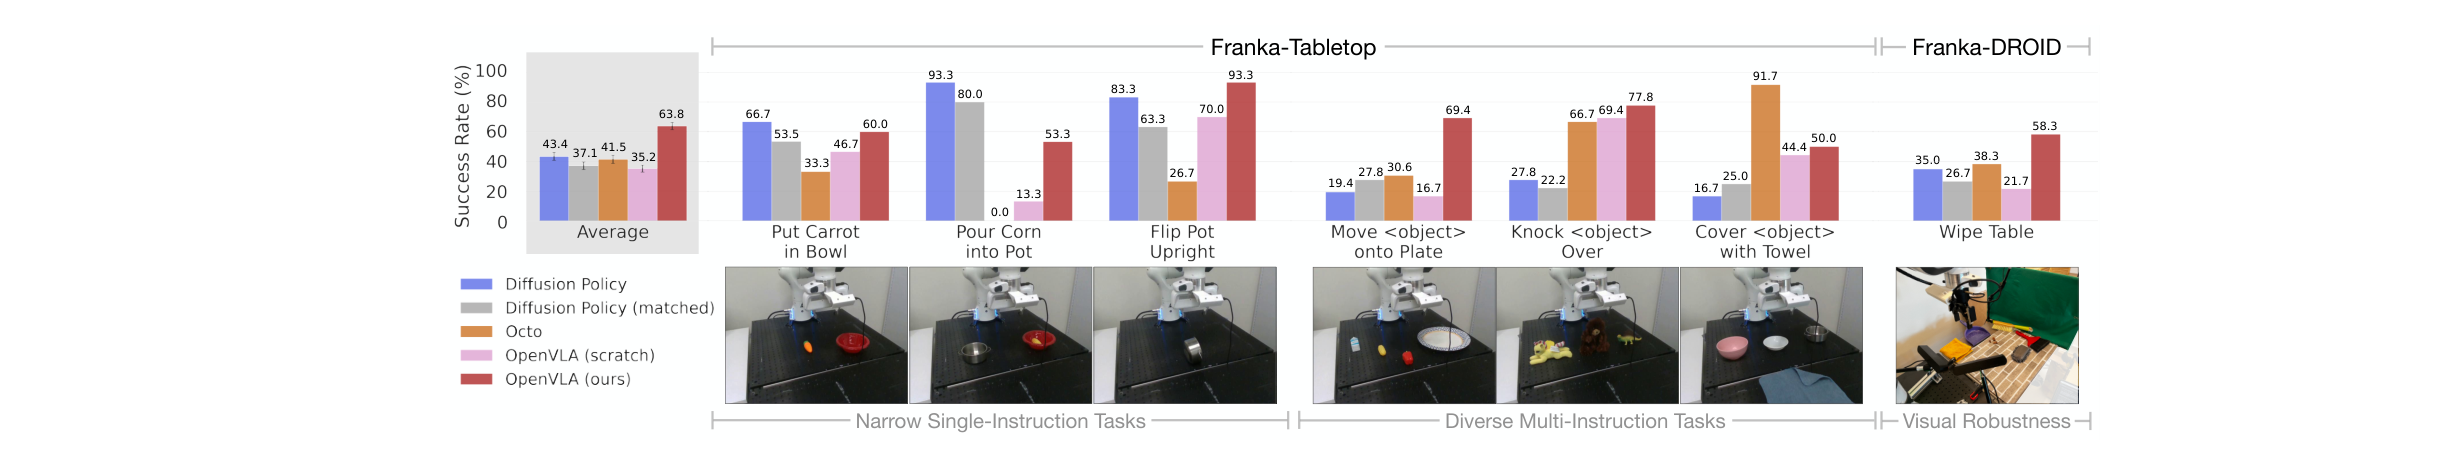
| Franka-Tabletop | 테이블에 고정한 Franka Emika Panda 7-DoF 팔 | 5Hz non-blocking | 단일 지시문 3개(Put Carrot in Bowl 50, Pour Corn into Pot 50, Flip Pot Upright 10) + 다중 지시문 3개(Move object onto Plate 150, Knock object Over 70, Cover object with Towel 45) |
| Franka-DROID | 이동식 책상에 올린 DROID 구성의 Franka 팔 | 15Hz non-blocking | Wipe Table 70 |
두 묶음의 성격이 다르다. 단일 지시문 task는 지시문이 하나로 고정된 좁은 과제인 반면, 다중 지시문 task는 장면에 물체가 셋 놓이고 지시문이 가리키는 대상만 조작해야 한다. Franka-DROID의 Wipe Table은 브러시를 쥐고 작은 물체 세 개를 쓰레받기로 쓸어 담는 과제로, 세 개를 모두 담으면 2점, 한두 개면 1점을 준다.
비교 대상에는 from-scratch로 학습한 Diffusion Policy, 입출력 규격을 OpenVLA에 맞춘 Diffusion Policy(matched), fine-tune한 Octo, 그리고 OpenX pre-training 없이 base VLM을 바로 목표 task에 fine-tune한 OpenVLA(scratch)가 들어간다. 마지막 항목은 대규모 로봇 pre-training의 기여를 분리해 보기 위한 ablation이다.
| setup | Diffusion Policy | DP(matched) | Octo | OpenVLA(scratch) | OpenVLA |
|---|---|---|---|---|---|
| Franka-Tabletop | 48.5±4.9% | 43.4±4.7% | 43.4±4.4% | 43.4±4.6% | 67.2±4.0% |
| Franka-DROID | 35.0±8.0% | 26.7±7.5% | 38.3±8.5% | 21.7±6.6% | 58.3±7.2% |
방법마다 강점이 갈린다. Diffusion Policy는 Put Carrot in Bowl이나 Pour Corn into Pot처럼 지시문이 좁게 고정된 task에서 generalist policy를 앞서거나 대등하다. 반면 여러 물체가 놓이고 언어 조건이 필요한 다중 지시문 task에서는 OpenX로 pre-train된 OpenVLA와 Octo가 더 잘 적응한다. OpenVLA(scratch)의 낮은 성능이 그 원인이 pre-training에 있음을 뒷받침한다.
집계에서는 OpenVLA가 두 setup 모두 가장 높고, 시험한 모든 task에서 성공률 50% 이상을 유지한 유일한 방법이다. 다른 방법은 좁은 task와 다양한 task 중 한쪽에서만 강해 성공률 편차가 크다. 따라서 OpenVLA는 새 downstream imitation learning 과제를 시작할 때의 기본값으로 쓸 만하다.
다만 정교함이 요구되는 좁은 task에서는 Diffusion Policy의 trajectory가 여전히 더 매끄럽고 정밀하다. 저자들은 Diffusion Policy가 쓰는 action chunking과 temporal smoothing을 OpenVLA에 결합하는 것을 후속 방향으로 든다. action chunking은 미래 여러 스텝의 action을 한 묶음으로 한 번에 예측하는 방식이다.
parameter-efficient fine-tuning
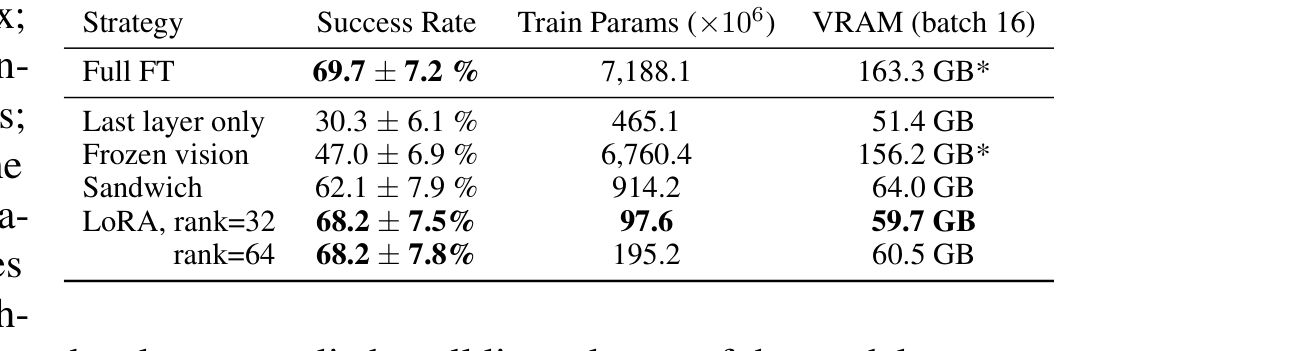
앞 절의 full fine-tuning은 task 하나당 A100 8장으로 5시간에서 15시간이 걸린다. pre-training보다는 훨씬 가볍지만 여전히 서버급 자원이 필요하므로, 논문은 더 가벼운 다섯 가지 방식을 비교한다. Franka-Tabletop의 대표 task 두 개에서 방식당 33 rollout으로 측정했다.
| 전략 | 성공률 | 학습 파라미터 | VRAM (batch 16) |
|---|---|---|---|
| full fine-tuning | 69.7±7.2% | 7,188.1M | 163.3GB (GPU 2장 분산) |
| last layer only | 30.3±6.1% | 465.1M | 51.4GB |
| frozen vision | 47.0±6.9% | 6,760.4M | 156.2GB (GPU 2장 분산) |
| sandwich | 62.1±7.9% | 914.2M | 64.0GB |
| LoRA, r=32 | 68.2±7.5% | 97.6M | 59.7GB |
| LoRA, r=64 | 68.2±7.8% | 195.2M | 60.5GB |
마지막 layer만 학습하거나 vision encoder를 freeze하면 성능이 크게 낮다. 목표 장면에 맞춰 visual feature를 적응시키는 일이 그만큼 중요하다는 뜻이다. vision encoder와 token embedding과 마지막 layer만 푸는 sandwich fine-tuning은 vision encoder를 학습하므로 더 낫고, LLM backbone 전체를 학습하지 않아 메모리도 적게 쓴다.
성능과 메모리의 트레이드오프가 가장 좋은 방식은 LoRA다. LoRA는 저랭크 행렬만 학습해 fine-tuning 비용을 줄이는 기법인데, 전체 파라미터의 1.4%만 학습하고도 full fine-tuning의 69.7%에 사실상 맞먹는 68.2%를 냈다. rank는 성능에 거의 영향이 없어 기본값으로 r=32를 권한다. LoRA를 쓰면 A100 한 장에서 10시간에서 15시간이면 새 task에 적응이 끝나며 이는 full fine-tuning 대비 연산이 8배 적은 값이다.
양자화 추론
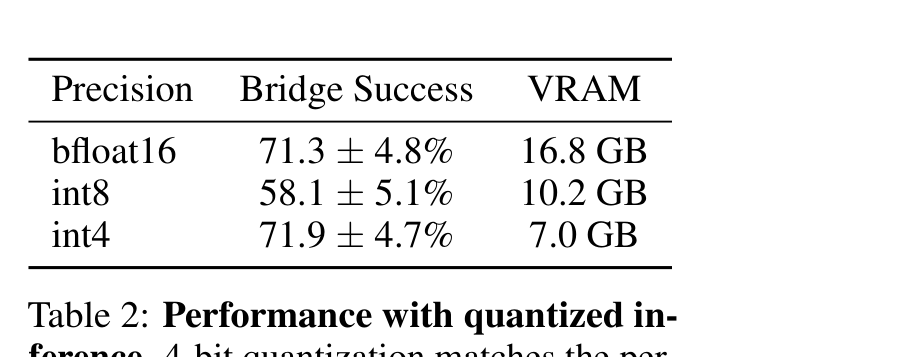
7B 모델인 OpenVLA는 1억 개 미만 파라미터의 Octo 같은 선행 policy보다 추론 메모리를 많이 쓴다. 기본 설정인 bfloat16 저장만으로도 16GB GPU에서 서빙할 수 있는데, 여기서 더 줄일 수 있는지를 8-bit와 4-bit 양자화로 검증한다. 양자화는 가중치를 낮은 비트 수로 줄여 모델을 압축하는 기법이며, 대표 BridgeData V2 task 8개에 방식당 80 rollout으로 측정했다.
| 정밀도 | 성공률 | VRAM |
|---|---|---|
| bfloat16 | 71.3±4.8% | 16.8GB |
| int8 | 58.1±5.1% | 10.2GB |
| int4 | 71.9±4.7% | 7.0GB |
int4는 bfloat16과 사실상 같은 성능을 내면서 GPU 메모리를 절반 이하로 줄인다. 반면 중간 정밀도인 int8만 13.2%p 낮게 나온다.
원인은 정밀도가 아니라 추론 속도다. 양자화 연산이 더해지면서 8-bit는 대부분의 GPU에서 추론이 느려지는 반면, 4-bit는 GPU 메모리 전송이 줄어드는 이득이 양자화 overhead를 상쇄해 오히려 throughput이 높다. 평가에 쓴 A5000에서 int8은 1.2Hz까지 떨어지는데, 이는 학습 데이터를 모을 때 쓴 5Hz non-blocking controller와 시스템 동역학이 크게 달라진다는 뜻이다. int4는 3Hz로 동작해 학습 당시 동역학에 훨씬 가깝다.
이 해석은 추가 실험으로 검증된다. blocking control, 즉 이전 action을 끝까지 실행한 뒤에 다음 action을 예측하는 방식으로 다시 재면 세 정밀도의 속도 차이가 성능에 미치는 영향이 사라진다.
| 정밀도 | non-blocking control | blocking control |
|---|---|---|
| bfloat16 | 71.3±4.8% | 70.0±5.1% |
| int8 | 58.1±5.1% | 74.4±4.9% |
| int4 | 71.9±4.7% | 68.8±5.2% |
blocking control에서 int8은 나머지 둘과 대등해진다. 따라서 int8의 하락은 8-bit 표현이 값을 망가뜨려서가 아니라 느린 추론이 제어 동역학을 바꿨기 때문이다. 두 양자화 모두 offline에서 재면 bfloat16과 비슷한 action token 정확도를 낸다는 사실도 같은 결론을 가리킨다.
구성 요소 ablation
무엇이 성능을 만들었는지는 두 개의 변형 모델로 갈라 봤다. OpenVLA-Bridge는 같은 Prismatic VLM을 OpenX 전체가 아니라 BridgeData V2만으로 fine-tune한 것이고, OpenVLA-Bridge-SigLIP은 거기서 DINOv2까지 제거해 SigLIP 단독 encoder만 남긴 것이다. 대표 task 8개에서 측정했다.
| 모델 | 평균 성공률 | 차이 |
|---|---|---|
| OpenVLA | 76.3±4.8% | 기준 |
| OpenVLA-Bridge | 45.6±5.6% | OpenX 학습 제거로 약 30%p 하락 |
| OpenVLA-Bridge-SigLIP | 40.6±5.5% | DINOv2 추가 제거로 약 5%p 추가 하락 |
영향이 가장 큰 요소는 OpenX 학습이다. Bridge 단독으로 학습하면 절대 성공률이 약 30%p 하락하며, language grounding만 유지되고 나머지 일반화 항목은 모두 낮아진다. OpenX 혼합의 장면과 물체와 task 다양성이 일반화 능력의 핵심 조건이라는 뜻이다. fused encoder의 기여인 5%p는 그보다 작아, DINOv2의 저수준 공간 feature는 일부 상황에서만 일반화를 돕는 것으로 보인다.
vision encoder를 fine-tune할지 freeze할지도 별도로 확인했다. Prismatic 저장소의 서로 다른 두 pre-training 모델을 BridgeData V2에 fine-tune해 비교한 결과다.
| base VLM | task 묶음 | frozen vision | fine-tuned |
|---|---|---|---|
| SigLIP ViT-SO 224px | 단일 물체 2개 task | 85% | 95% |
| SigLIP ViT-SO 224px | language grounding 5개 task | 30% | 55% |
| LLaVA v1.5 7B (재현) | 단일 물체 2개 task | 25% | 90% |
두 경우 모두 vision encoder를 fine-tune한 쪽이 뚜렷이 높다. frozen 조건과 fine-tuned 조건을 모두 시험한 평가만 모으면 80.0% 대 46.7%다. frozen 상태에서는 로봇 거동이 불안정해지는 경우도 있어 개발 초기에 이 방향을 접었다.
시뮬레이션 적응
실세계 데이터로만 pre-train한 모델이 시뮬레이션에도 옮겨지는지를 LIBERO 벤치마크로 확인했다. LIBERO는 로봇 lifelong learning용 시뮬레이션 벤치마크로 Spatial, Object, Goal, Long 네 개의 task suite로 이뤄지며, 각 suite는 10개 task에 사람이 teleoperation으로 만든 시연 데이터 50개씩을 담는다. 여기서는 lifelong 전이가 아니라 각 suite에 대한 지도 fine-tuning 성능만 측정하며, OpenVLA는 LoRA(r=32)로 적응시켰다.
| 방법 | Spatial | Object | Goal | Long | 평균 | 평균 rank |
|---|---|---|---|---|---|---|
| Diffusion Policy (from scratch) | 78.3±1.1% | 92.5±0.7% | 68.3±1.2% | 50.5±1.3% | 72.4±0.7% | 2.5 |
| Octo (fine-tuned) | 78.9±1.0% | 85.7±0.9% | 84.6±0.9% | 51.1±1.3% | 75.1±0.6% | 2 |
| OpenVLA (fine-tuned) | 84.7±0.9% | 88.4±0.8% | 79.2±1.0% | 53.7±1.3% | 76.5±0.6% | 1.5 |
OpenVLA가 평균 성공률과 평균 rank 모두 1위다. 각 suite마다 500 trial을 세 개의 random seed로 반복해 통계당 1,500 trial로 잰 값이다. 다만 실세계 fine-tuning에서 본 만큼의 격차는 아니며, 저자들은 실세계 데이터로만 pre-train한 탓에 시뮬레이션과의 domain gap이 남아 있기 때문으로 본다. 같은 이유로 실세계 데이터로 pre-train한 Octo 역시 from-scratch Diffusion Policy 대비 이득이 작다.
LIBERO 실험에는 데이터 정제가 함께 들어갔다. 원본의 128×128px 이미지를 시뮬레이터 재실행으로 256×256px에서 다시 만들었고, 이동과 회전 성분이 거의 0이면서 그리퍼 상태도 바꾸지 않는 no-op action을 제거했으며, 성공 판정에 실패한 시연 데이터를 걸러 냈다. 제외된 시연 데이터는 각 500개 중 Spatial 68개, Object 46개, Goal 72개, Long 121개다.
부록의 주요 분석
결과 해석에 필요한 분석이 본문 밖에도 두 가지 있다.
첫째는 BridgeData V2 전처리 문제다. 원본 BridgeData V2에는 아무 동작도 하지 않는 all-zero transition이 많이 섞여 있었고 특히 모든 시연 데이터의 첫 timestep이 all-zero action으로 기록되어 있었다. 이를 그대로 학습하면 표현력이 큰 VLA가 all-zero action을 자주 예측해 평가 중 그 자리에 멈춰 선다. OpenVLA는 모든 시연 데이터의 첫 transition을 걸러 내는 단순한 처리로 이 현상을 대부분 없앴다.
반면 RT-2-X는 이 전처리 없이 학습된 비공개 모델이라 재학습이 불가능하므로, 가장 확률이 높은 action 대신 두 번째로 확률이 높은 action을 항상 질의하는 우회로 평가했다. Open X-Embodiment 프로젝트가 쓴 것과 같은 방식이다. 첫 action이 all-zero일 때만 두 번째를 뽑는 동적 질의도 시도했지만, 질의 지연이 로봇 동역학을 흔들어 오히려 성능이 낮았다.
둘째는 평가 환경 재현에서 생기는 분포 이동이다. BridgeData V2 평가는 원본 sink 환경을 다른 장소에서 근사 재현한 것이라 로봇과 싱크와 카메라의 상대 위치, 조명, 배경, 사용 물체가 모두 원본과 조금씩 다르다. 게다가 원본 시연 데이터는 모두 end-effector가 대상 물체 바로 위에서 시작하는 반면, 평가는 Put Eggplant into Pot(Easy Version) 하나를 빼고 싱크 위 고정 위치에서 시작해 로봇이 먼저 수평으로 뻗어야 한다. 이 조건 때문에 RT-1-X와 Octo의 성공률이 선행 논문 보고치보다 낮게 나온다.
계보에서의 위치
OpenVLA는 VLA 계보에서 오픈소스 기준점 역할을 한다. RT-2가 연 레시피를 누구나 재현하고 개조할 수 있게 열었고, 이후 manipulation VLA 연구의 출발선이 됐다.
바로 앞 세대는 RT-2다. OpenVLA는 action을 language token으로 적어 VLM을 fine-tune한다는 핵심 레시피와 256 bin 이산화를 그대로 물려받되 네 가지가 다르다. 강력한 open VLM과 더 풍부한 로봇 pre-training 데이터를 결합해 한 자릿수 작은 크기로 RT-2-X를 앞서고, RT-2-X가 다루지 않은 fine-tuning을 정면으로 검토했으며, parameter-efficient fine-tuning과 양자화를 VLA에 처음 적용했고, 최초의 오픈소스 generalist VLA다. 두 세대 위 RT-1에서 나온 action 이산화가 RT-2를 거쳐 여기까지 이어진다.
같은 시기의 generalist policy와는 결합 방식이 다르다. Octo 같은 선행 연구는 pre-training된 언어 임베딩이나 vision encoder에 from-scratch로 초기화한 모듈을 이어 붙여 학습 중에 둘을 잇는 반면, OpenVLA는 VLM을 통째로 end-to-end fine-tune하고 action을 언어 모델 어휘 안의 토큰으로 다룬다.
한 세대 뒤로 가면 GR00T N1이 RT-1, RT-2, π0, OpenVLA를 VLA-via-finetuning 계보로 묶고 그 후속으로 스스로를 자리매김한다. OpenVLA가 단일 VLM 안에서 언어와 action을 하나의 손실로 학습했다면, GR00T N1은 느린 추론을 맡는 VLM과 빠른 action 생성을 맡는 DiT를 dual-system으로 나눈다. OpenVLA가 한계로 든 6Hz 추론 병목이 이 분리를 부른 동기 중 하나다.
한계
- 단일 이미지 입력만 지원한다. 실제 로봇 setup은 감각 입력 구성이 제각각인데 OpenVLA는 여러 장의 이미지, proprioception, observation history를 아직 받지 못한다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. 이미지와 텍스트가 교차된 데이터로 pre-train된 VLM을 쓰면 더 유연한 입력을 받을 수 있으리라 본다.
- 추론 throughput이 6Hz에 그친다. 50Hz로 동작하는 ALOHA 같은 고빈도 setup에는 올릴 수 없고, 그래서 더 정교한 양손 조작 task를 시험하지 못했다. action chunking이나 speculative decoding 같은 추론 최적화가 후속 방향이다.
- 신뢰성이 아직 충분하지 않다. 선행 generalist policy보다는 낫지만 시험한 task에서 성공률이 대개 90%에 못 미친다.
- 설계 질문 여러 개가 미해결로 남았다. base VLM 크기가 VLA 성능에 미치는 영향, 로봇 action 데이터와 인터넷 규모 vision-language 데이터를 co-training했을 때의 효과, VLA에 가장 알맞은 visual feature가 무엇인지는 연산 제약 때문에 답을 내지 못했다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Prismatic-7B | SigLIP과 DINOv2를 결합한 600M vision encoder, 2-layer MLP projector, Llama 2 7B backbone으로 이뤄진 open VLM. OpenVLA의 출발점 |
| fused vision encoder | 성격이 다른 두 vision encoder의 feature를 채널 방향으로 concat해 쓰는 구성. 의미 feature의 SigLIP과 공간 feature의 DINOv2를 합친다 |
| Open X-Embodiment | 70개 이상의 robot dataset과 200만 개 이상의 trajectory를 하나의 형식으로 통합한 공개 데이터셋. OpenVLA 학습 데이터의 원천 |
| action de-tokenizer | 언어 모델이 낸 이산 action 토큰을 다시 연속 제어값 7-DoF로 되돌리는 모듈 |
| sandwich fine-tuning | vision encoder와 token embedding과 마지막 layer만 풀고 나머지는 freeze하는 PEFT 변형. LoRA보다 성능과 메모리 모두 뒤진다 |
| LIBERO | 로봇 lifelong learning 시뮬레이션 벤치마크. Spatial, Object, Goal, Long 네 개 suite로 OpenVLA의 시뮬레이션 적응성을 검증했다 |
관련 페이지
- 03-06. OpenVLA - 모두의 로보틱스 - VLA 입문: 이 논문의 한국어 입문 해설. 기초 개념이 낯설면 입문 해설로 전체 그림을 잡은 뒤 이 페이지로 넘어오는 순서를 권한다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 직접 전신. OpenVLA가 action 이산화와 fine-tuning 레시피를 물려받은 비공개 VLA이며, OpenVLA는 그 오픈소스 경량 버전이다.
- RT-1: Robotics Transformer for Real-World Control at Scale: 256 bin action 이산화의 출처. RT-2를 거쳐 OpenVLA로 이어진다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: OpenVLA 학습 데이터의 원천이자 비교 대상 RT-1-X와 RT-2-X의 출처.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: VLA-via-finetuning 계보의 후속. 단일 backbone에서 dual-system으로 옮겨 추론 병목에 대응한다.
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 서베이. OpenVLA를 VLM fine-tuning형 VLA의 대표 사례로 분류한다.
- VLM3: Vision Language Models Are Native 3D Learners: VLM 아키텍처 논의. OpenVLA 성능을 좌우하는 backbone과 vision encoder 선택의 배경이다.
- Vision Language Action Models (VLA) & Policies for Robots: OpenVLA를 한 절로 압축한 튜토리얼.
openvla/openvla-7b체크포인트로predict_action까지 가는 최소 추론 경로를 붙였다. - Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.