Physical AI · PAPER · 2026
World Model for Robot Learning: A Comprehensive Survey
요약
로봇 학습 관점에서 world model 문헌을 정리한 43페이지 규모의 서베이다. world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. Nanyang Technological University의 MARS 랩이 주도했고 UC Berkeley, Stanford, University of Tokyo, University of Oxford, Microsoft, ETH Zurich, Princeton, Harvard까지 9개 기관이 참여했다. 저자 명단에는 Pieter Abbeel, Jitendra Malik, Jiajun Wu, Yilun Du, Marc Pollefeys가 함께 올라 있다. 본문 31페이지와 참고문헌 12페이지로 구성되고 인용 문헌은 300건을 넘는다.
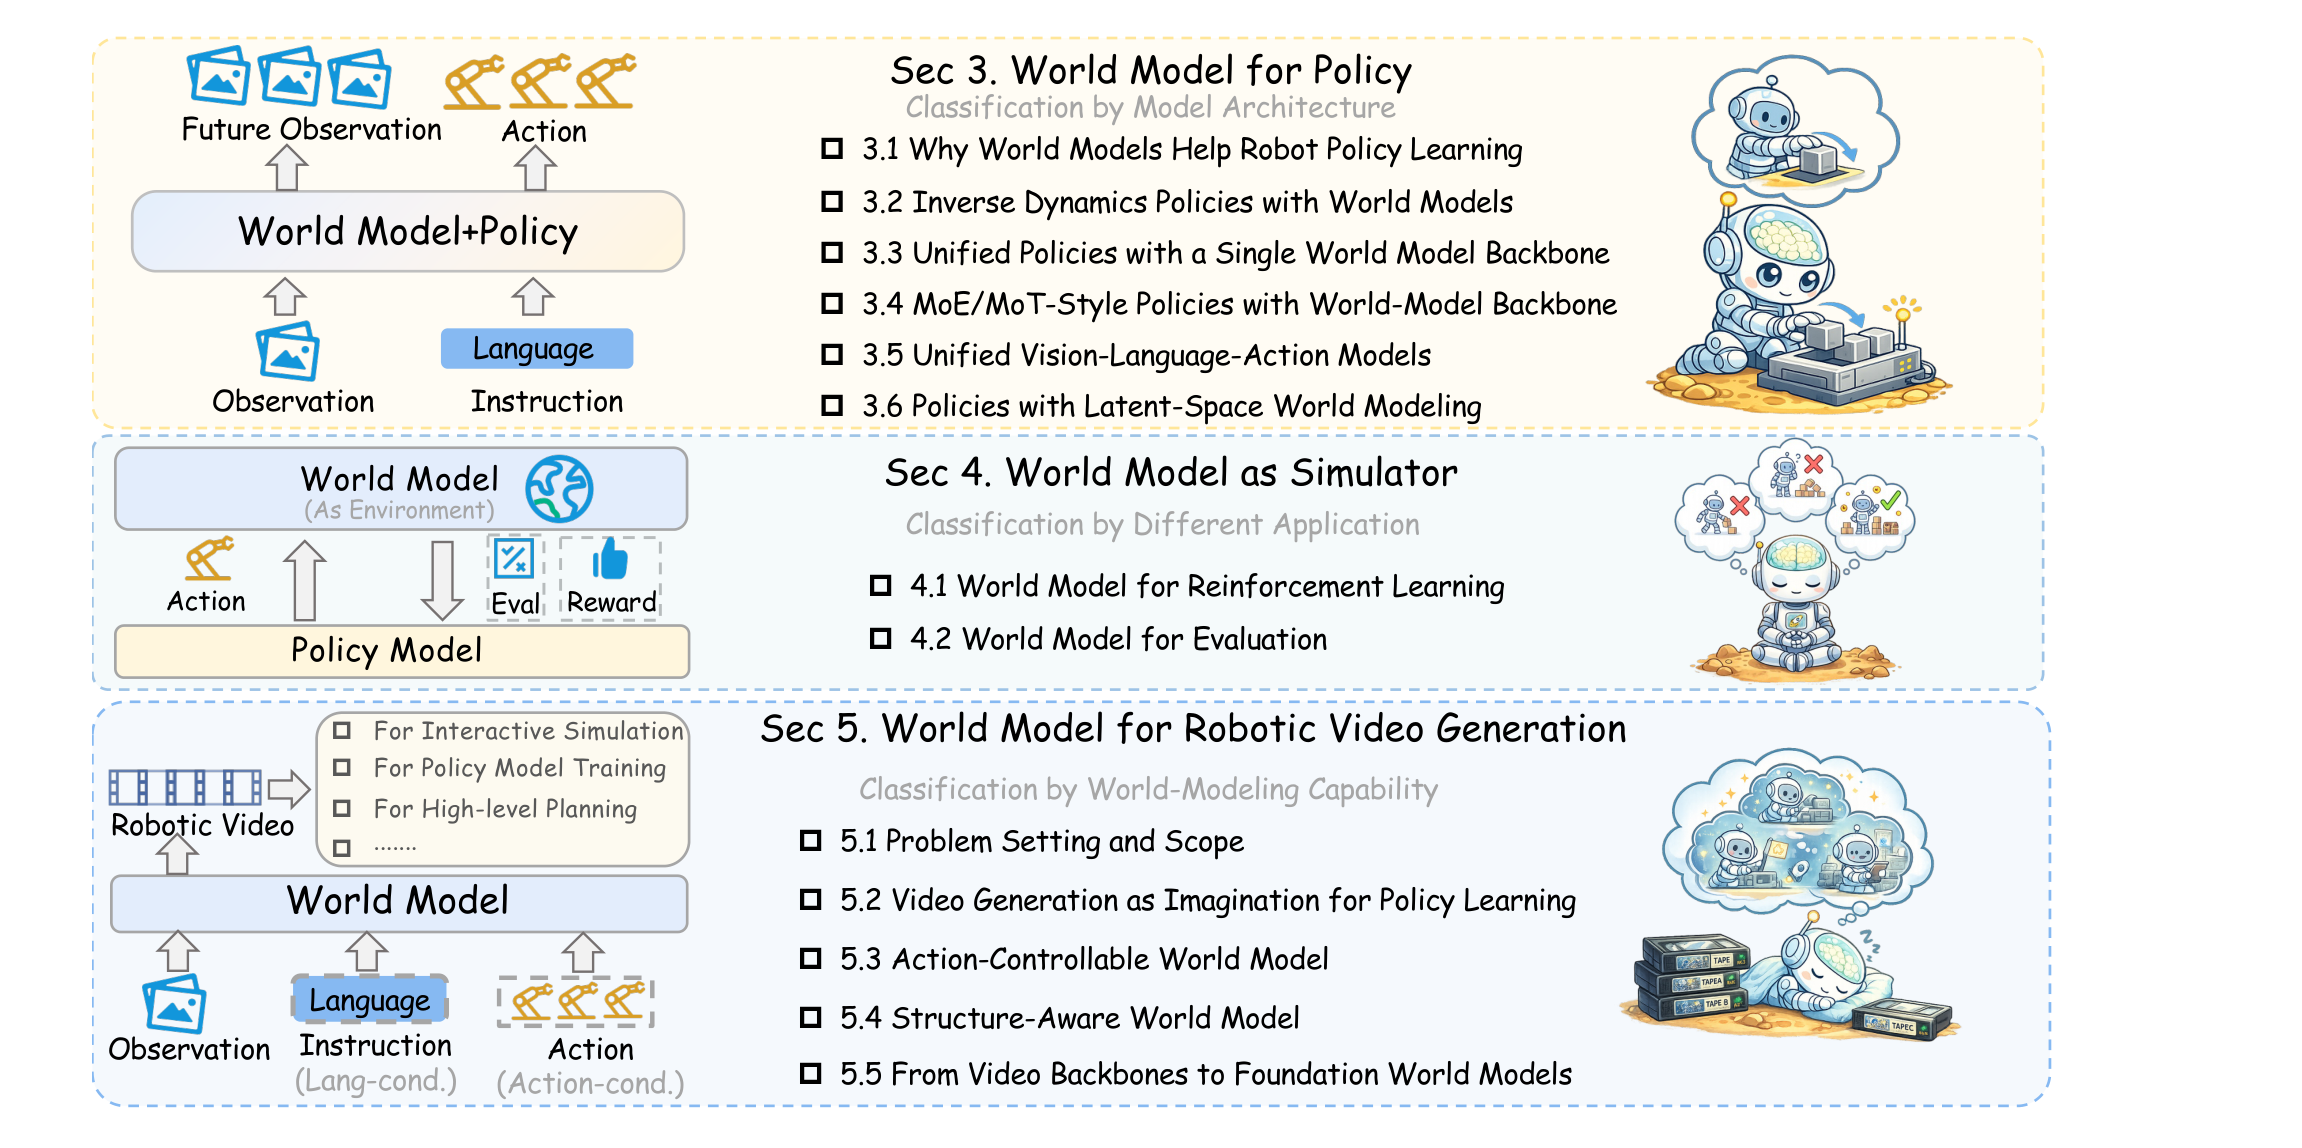
서베이는 문헌을 세 부분으로 나눈다. Sec 3은 world model이 policy와 어떻게 결합하는지를 아키텍처 관점에서 본다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. Sec 4는 학습된 시뮬레이터로서의 쓰임을 응용 관점에서 다루고, Sec 5는 로봇 비디오 world model이 어떤 능력 순서로 발전해 왔는지를 능력 관점에서 다룬다.
이 서베이의 중심 주장은 world model을 생성 모델이 아니라 예측 구조로 보아야 한다는 것이다. 저자들은 그럴듯한 미래 영상을 만든다는 사실만으로는 여기서 말하는 world model 자격을 얻지 못한다고 명시한다. 로봇과 관련된 action 아래에서 미래가 어떻게 변하는지를, 하위 policy 계산에 실제로 쓸 수 있는 형태로 예측해야 한다는 조건이 붙기 때문이다.
분야 진단도 같은 기준 위에 있다. 저자들이 보기에 병목은 더 이상 사실적인 미래를 만드는 데 있지 않다. 미래는 로봇 action과 인과적으로 alignment되어야 하고, long-horizon에서 물리적이고 기구학적으로 자기일관적이어야 하며, 시점과 embodiment가 바뀌어도 흔들리지 않아야 하고, 실제 policy 개선을 지탱할 만큼 실행 가능해야 한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다.
배경
반응형 VLA policy의 한계
이 서베이의 출발점은 순수 반응형 VLA policy가 복잡한 물리 환경에서 부딪히는 한계다. RT-2, OpenVLA, π0 같은 VLA는 멀티모달 observation을 로봇 action으로 곧장 매핑해 지각과 언어 이해와 제어를 하나로 묶는다. 규모를 키울수록 성능이 오르는 경향도 뚜렷하다.
그럼에도 세 가지 약점이 반복해서 관찰된다. long-horizon 추론이 약하고, 어떤 시점의 action이 뒤늦은 성공에 기여했는지 판단하는 temporal credit assignment가 어려우며, compounding error 아래에서 견고성이 떨어진다. compounding error는 policy의 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상이다.
저자들은 이 한계의 원인을 action 예측 용량 부족으로만 보지 않는다. 에이전트의 행위 아래에서 세계가 어떻게 변할지를 내다보는 명시적 예측 구조가 없다는 점을 더 근본적인 원인으로 지목한다. 따라서 world model은 생성 기능의 부가물이 아니라 의미 수준의 의도를 물리적으로 실현 가능한 행위로 잇는 예측 다리로 자리매김된다.
world model 개념의 계보
world model이라는 용어는 로봇 학습보다 훨씬 오래된 지적 계보를 갖는다. 핵심 뜻은 개입이나 action 아래에서 시스템이나 환경이 현재 상태로부터 어떻게 전개되는지를 기술하는 것이고, 가장 표준적인 형태는 다음 상태나 미래 상태 시퀀스를 예측하는 상태 전이 모델이다.
| 시기 | 연구 | 기여 |
|---|---|---|
| 1943 | Craik | 설명의 본질로서 내부 모델 개념 |
| 1960 | Miller et al. | 인지과학에서 정신적 시뮬레이션과 계획을 지탱하는 내부 모델 |
| 1970 | Conant & Ashby | 제어 이론과 모델 기반 의사결정 |
| 1975 | Bryson & Ho | 최적 제어의 형식화 |
| 1978 | Richalet et al. | MPC |
| 1983 | Lozano-Perez | 기하와 제약과 action 결과의 내부 모델을 쓰는 고전 로봇 계획 |
| 2018 | Ha & Schmidhuber | 현대적 부활의 기점 |
현대의 부활은 두 흐름이 함께 밀어 올렸다. 하나는 학습된 동역학을 계획과 policy 개선에 쓰는 model-based 강화학습이고, 다른 하나는 대규모 생성 모델링, 특히 대규모 시각 데이터와 상호작용 데이터에서 풍부한 시공간 규칙성을 배우는 비디오 생성이다. 두 흐름이 겹치면서 픽셀에서 곧바로 예측 표현을 배우고 그것을 embodied 의사결정에 재사용하는 일이 현실적인 선택지가 됐다.
선행 서베이와의 차이
저자들은 선행 서베이인 Zhang et al. 2025d(A step toward world models: A survey on robotic manipulation)와의 차이를 세 가지로 밝힌다. 주요 world model 패러다임을 더 세분화해 본다는 점이 첫째다. policy 학습과 계획, 시뮬레이션, 평가, 데이터 생성에 걸쳐 역할을 폭넓게 분석한다는 점이 둘째다. VLA policy와의 관계 속에서 world model을 로보틱스 중심으로 더 명확히 정의한다는 점이 셋째다.
핵심 개념
world model의 좁은 정의
이 서베이의 world model은 로보틱스와 embodiment를 중심에 둔 좁은 정의를 쓴다. 구체적으로는 로봇 시스템이 action 아래에서 어떻게 전개되는지를 포착하는 에이전트-환경 동역학의 예측 모델을 가리킨다. 일반형은 다음과 같이 적힌다.
p(x_{t+1:t+H} | x_t, a_{t:t+H-1}, l) … (1)
상태 x_t는 시각 observation일 수도 있고 latent state일 수도 있다. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다. 구조화된 물리 상태나 계획용 추상 심볼 상태까지 포함되며, 심볼 표현을 쓰는 경우 world model은 픽셀이 아니라 predicate와 객체 관계, affordance, 인과 과정 위의 전이를 예측한다. 상태 공간 선택에 일부러 중립을 지킨 정식화다.
서베이는 action을 넓은 predictive-control 의미로 쓴다. 저수준 모터 명령 a는 에이전트가 어떻게 움직이는지를 지정하고, 고수준 언어 지시문(instruction) l은 어떤 미래가 실현되어야 하는지를 정한다. 둘 다 action으로 취급하되 표기는 분리해 둔다.
이 정의는 컴퓨터 비전의 일반적 future prediction보다 좁다. 모델이 그럴듯한 미래 이미지나 영상을 만든다는 것만으로는 자격이 없고, 환경 전개를 로봇 상호작용에 유의미하고 하위 policy 계산에 쓸 수 있는 형태로 포착해야 한다. 그래서 embodied 제어에서 가장 중요한 부류는 action으로 조건화된 world model이다. 보기에는 그럴듯해도 action과 어긋난 미래는 closed-loop 의사결정에 가치가 제한적이기 때문이다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다.
비디오 생성 모델과의 관계
비디오 생성 모델은 미래를 이미지나 영상 공간에서 직접 예측하는 모델이다. embodied 설정에서는 다음과 같이 적힌다.
p(v_{t+1:t+H} | o_t, a_{t:t+H-1}, l) … (2)
latent state 기반 world model과 비교하면 미래를 추상 상태 변수가 아니라 시각 증거로 명시하기 때문에 공간과 시간과 상호작용 세부가 더 풍부하게 보존된다. 관점을 바꿔 말하면 비디오 생성 모델은 시각 observation 공간에 인스턴스화된 world model이다. embodied 에이전트가 얻을 수 있는 가장 흔한 상태 형태가 시각 observation이라서, 이 서베이가 다루는 구체적 모델도 대부분 시각 world model이다.
다만 시각으로 명시한다는 선택은 문제를 훨씬 어렵게 만든다. 지각적 사실성만으로 부족하고 네 가지를 함께 지켜야 한다.
- 시간적 일관성(temporal coherence)
- action 일관성(action consistency)
- 물리적 개연성(physical plausibility)
- long-horizon 안정성
저자들은 픽셀 수준 예측이 제어에 최적인 추상화라고 가정해서 비디오 world model에 초점을 맞춘 것이 아니라고 단서를 단다. 최근 로봇 학습 문헌에서 비디오 기반 world model이 두드러지기 때문이라는 설명이다.
로봇 policy의 두 가지 형태
로봇 policy는 물리 제어를 action 예측 과제로 틀 지어, 현재 환경 observation을 미래 action trajectory로 매핑하는 의사결정 모델이다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다. 이 서베이는 전문가의 시연 데이터(demonstration)에서 곧바로 행위를 합성하는 imitation learning 패러다임에 초점을 둔다. imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법이다.
p(a_{t+1:t+k} | o_t, l) … (3)
실무에서는 예측 action을 길이 k의 action chunk로 묶는 방식이 지배적이다. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이고, 시간적 일관성을 확보하고 compounding error를 줄이려는 처방이다.
아키텍처 관점에서 현대 로봇 policy는 두 갈림길로 나뉜다.
| 형태 | 대표 | 특징 |
|---|---|---|
| visuomotor policy | Diffusion Policy 계열 | 과제별 경량 end-to-end 네트워크. 생성 모델링으로 복잡한 action 분포를 높은 정밀도와 낮은 지연으로 포착 |
| generalist VLA | RT-2, OpenVLA, π0 | 대규모 VLM을 로봇 trajectory 데이터로 fine-tuning. 의미 지식과 open-vocabulary 추론 능력을 물려받아 과제 간, embodiment 간 일반화를 노린다 |
VLA의 action 출력은 이산 표현과 연속 표현으로 갈린다. discrete action tokenization은 연속 action을 언어 모델과 같은 어휘 공간의 토큰으로 양자화해 next-token prediction 능력을 그대로 쓰며, RT-2와 OpenVLA가 대표 사례다. 표준 binning 방식이 고주파 제어에서 약한 점은 FAST가 이산 코사인 변환으로 action chunk를 압축해 보완한다. 반면 연속 표현은 action head를 조건부 생성기로 두고 diffusion이나 flow matching으로 시연 데이터의 multimodal 분포 전체를 모델링하며, π 계열이 대표 사례다. flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다.
실행 가능한 world model의 세 능력
embodied AI에서 예측 품질은 action에 쓸모 있는 만큼만 의미가 있다. 저자들은 이 관점에서 실행 가능한 world model이 갖춰야 할 능력을 셋으로 정리한다.
| 능력 | 뜻 | 쓰이는 곳 |
|---|---|---|
| foresight | 실행 전에 미래 상태나 action 결과를 내다본다 | 예측 조건화, 계획 |
| imagination-driven planning | 상상한 rollout으로 후보 행위를 비교하고 고른다 | 결정 시점 선택, MPC |
| data amplification | 시연 데이터나 상호작용 trajectory를 추가로 합성한다 | 학습 데이터 증강 |
rollout은 policy를 실행해 trajectory를 만들어내는 과정이다. 세 능력은 manipulation과 내비게이션, 자율주행처럼 접촉과 동역학 같은 물리 규칙성 추론이 성패를 가르는 과제에서 특히 중요하다. 언어 중심 pre-training만으로는 이런 규칙성이 잡히지 않기 때문이다.
방법
하나의 결합 분포에서 유도되는 네 패러다임
Sec 3.1의 핵심 논증은 서로 달라 보이는 네 모델이 실은 같은 결합 분포를 다르게 질의한 결과라는 것이다. 미래 observation과 미래 action의 결합 조건 분포를 p(o_{t+1:t+k}, a_{t+1:t+k} | o_t, l)로 놓으면 다음이 유도된다.
| 이름 | 정식화 | 유도 방법 |
|---|---|---|
| Policy Model | p(a_{t+1:t+k} | o_t, l) |
observation에 대해 주변화 (5) |
| Passive World Model | p(o_{t+1:t+k} | o_t, l) |
action에 대해 주변화 (6) |
| Controllable World Model | p(o_{t+1:t+k} | o_t, a_{t+1:t+k}) |
action으로 조건화 (7) |
| Inverse Dynamics Model | p(a_{t+1:t+k} | o_{t:t+k}) |
observation trajectory로 조건화 (8) |
이 정리가 실용적으로 중요한 이유는 world model과 policy가 자연스럽게 결합하는 구조를 설명해 주기 때문이다. policy는 world model이 만든 미래 observation을 중간 latent 변수로 쓸 수 있고, Inverse Dynamics Model 스타일 디코더가 그 예측된 미래에서 실행 가능한 action을 복원할 수 있다. Inverse Dynamics Model은 두 프레임만 보고 그 사이를 채울 action chunk를 되짚어 예측하는 모델이다.
따라서 world model을 policy 학습에 넣는 일은 더 일반적으로 보면 action 생성에 예측 구조를 도입하는 일이다. 현재 observation에서 action으로 가는 단일 매핑을 배우는 대신, 미래 observation을 보조 예측 변수로 삼아 action 선택을 안내하거나 제약한다. 로봇 action 데이터가 제한적이고 대규모 예측 pre-training을 쓸 수 있을 때 유용한 귀납 편향이 된다.
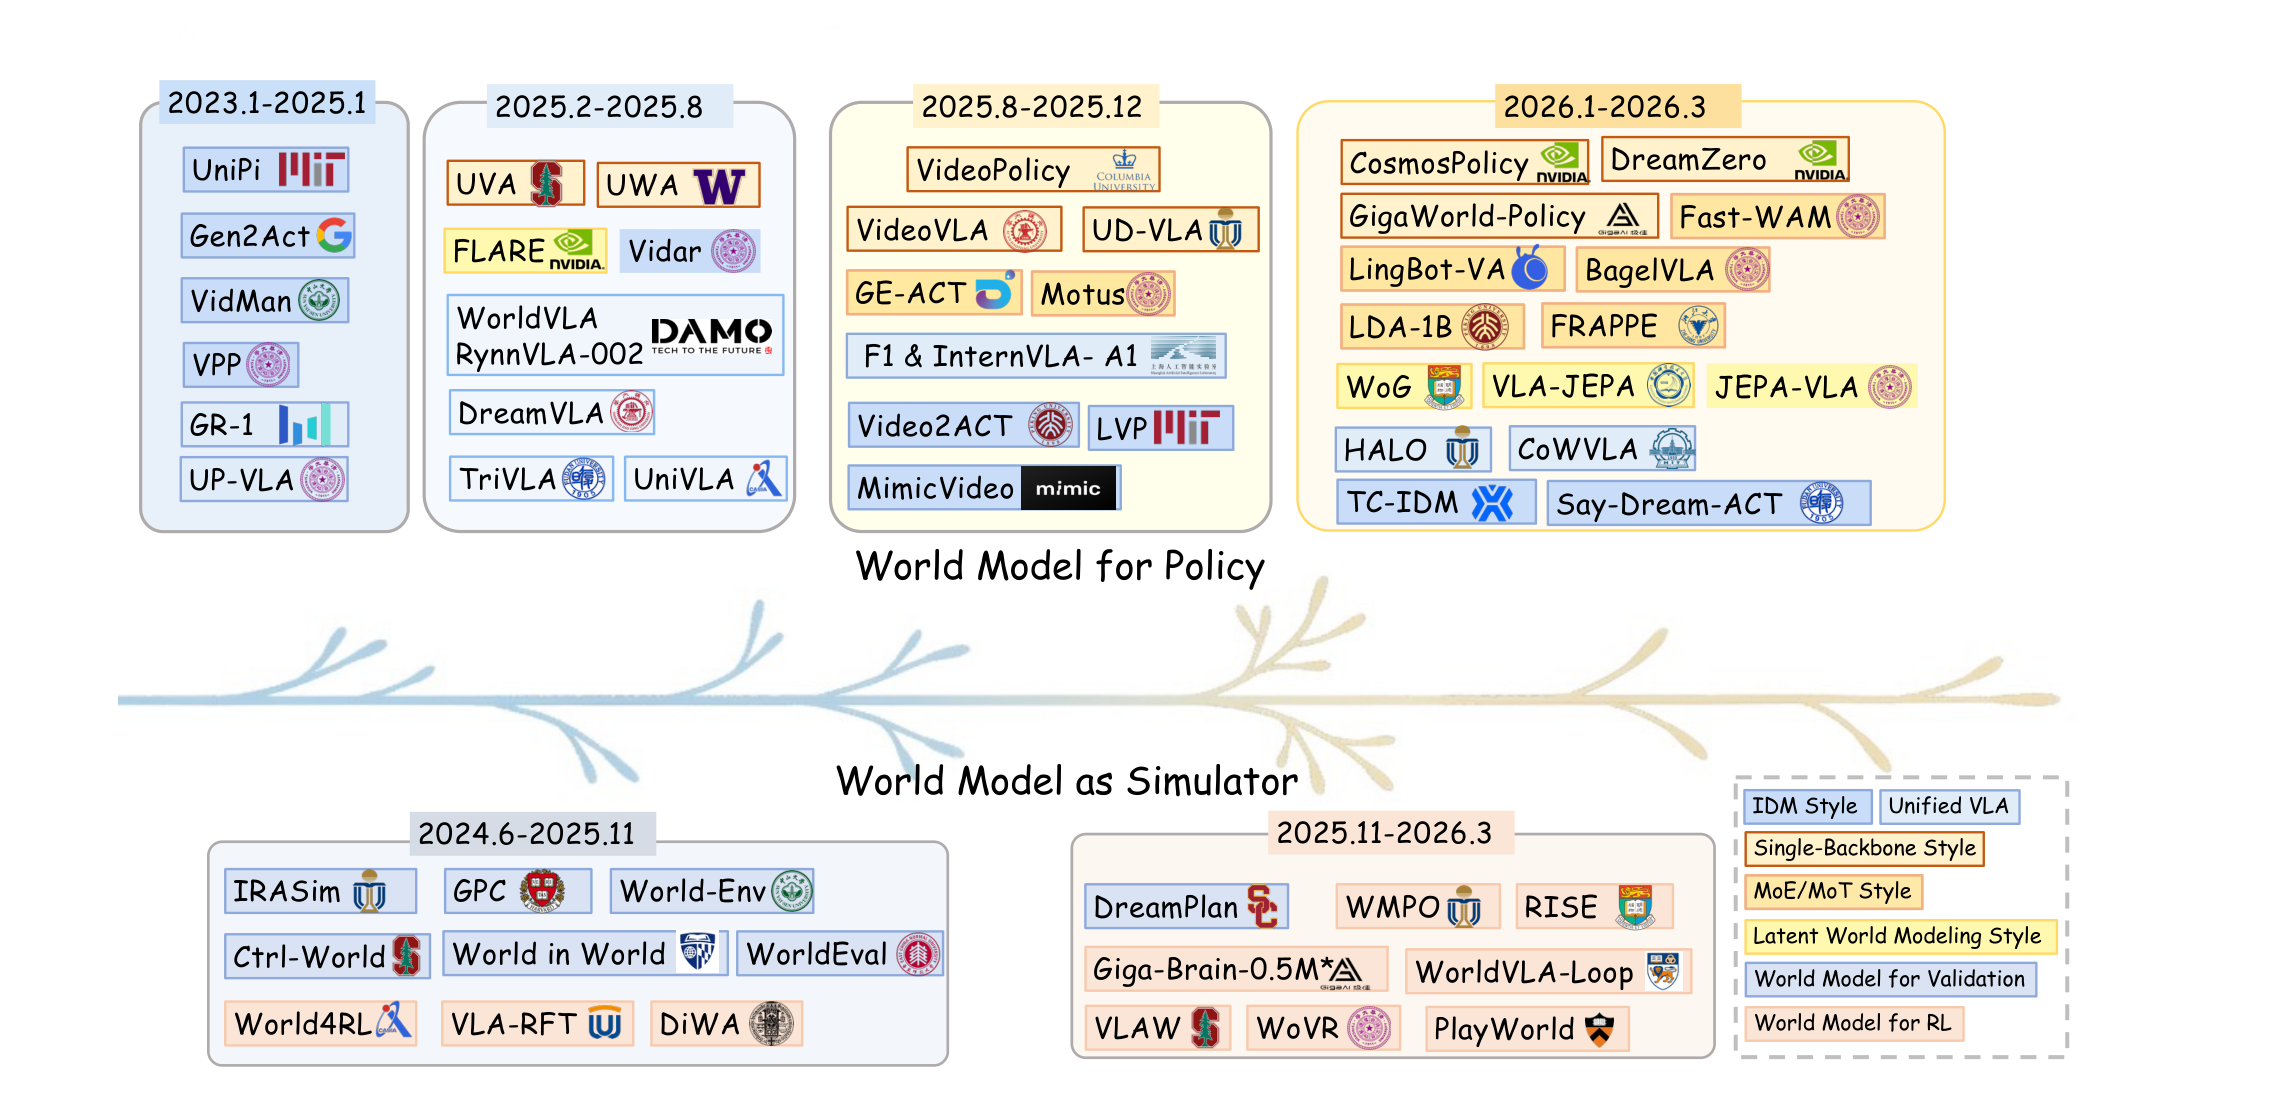
아키텍처 5분류 개관
Sec 3의 흐름은 예측과 실행을 분리하던 predict-then-act 파이프라인에서 예측 제어를 policy 안으로 통합하고 내재화하는 쪽으로 이동한다. 다만 저자들은 이 진행이 비디오 pre-training backbone이 VLM이나 latent, 구조, 심볼 대안보다 본질적으로 우월하다는 뜻은 아니라고 명시한다. 어떤 예측 기반이 가장 효과적인지는 아직 열린 실증 문제다.
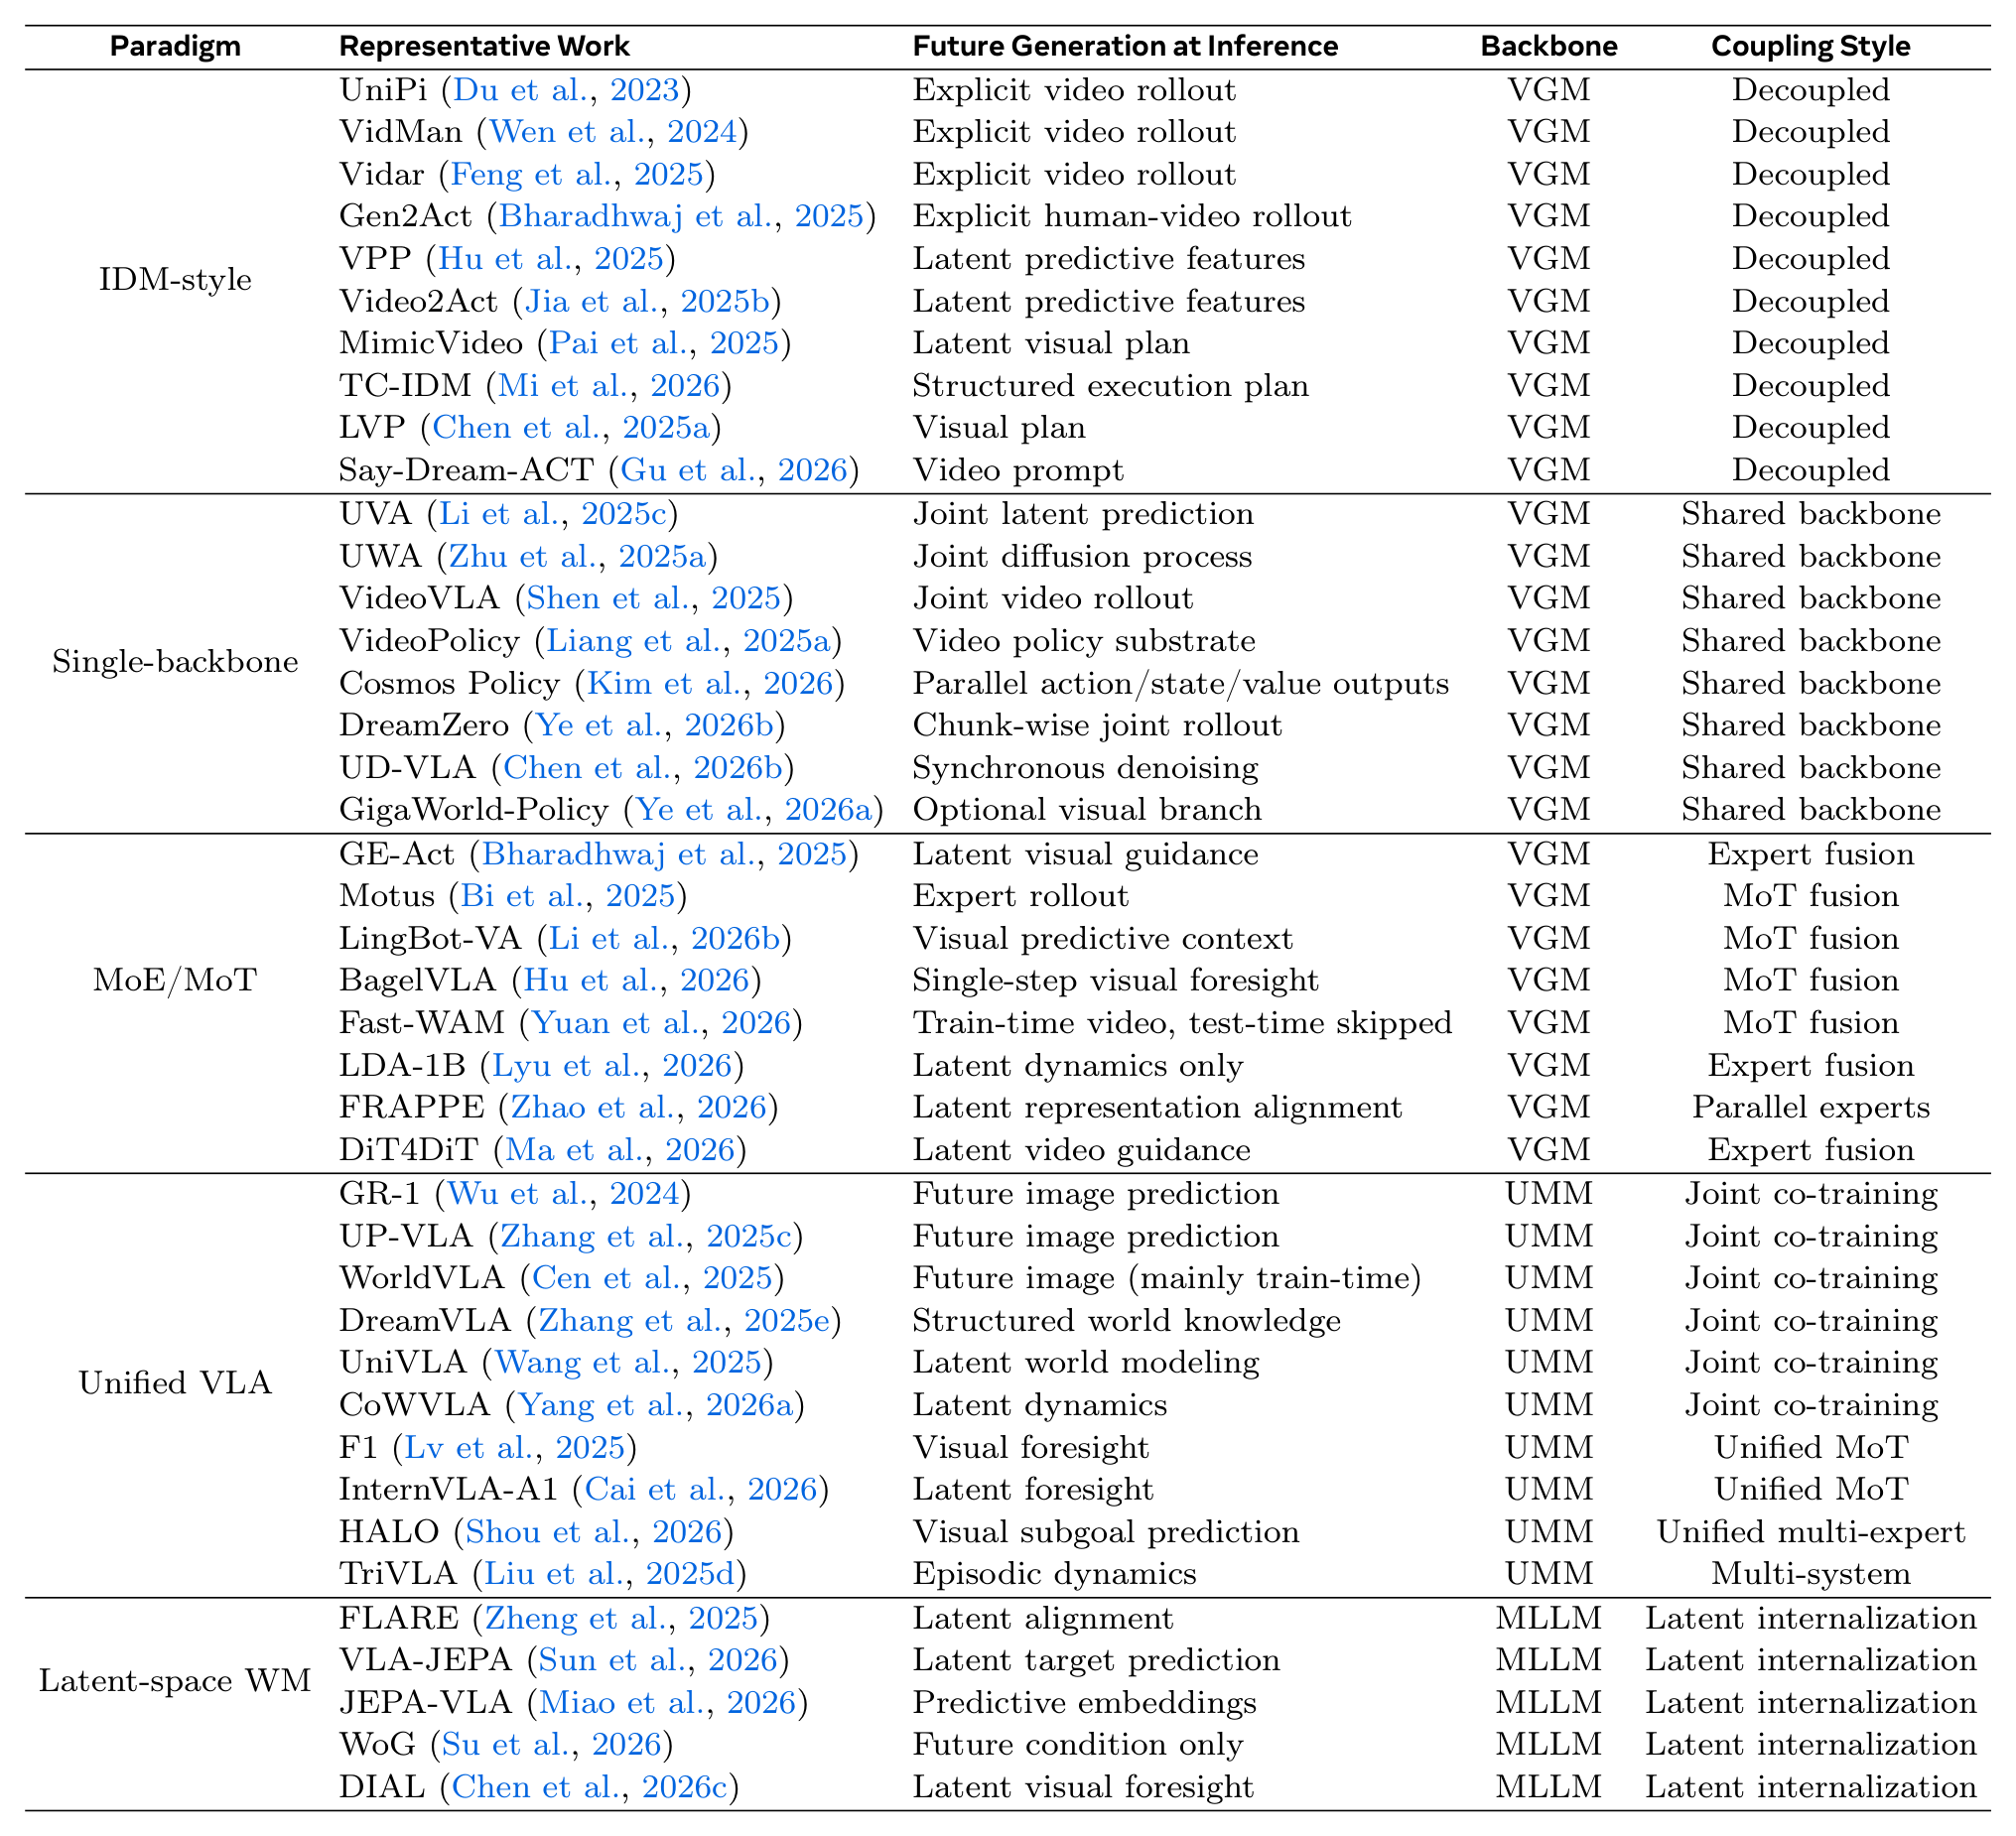
| 패러다임 | 결합 방식 | backbone 계열 | 추론 시 미래 생성 | 대표 연구 |
|---|---|---|---|---|
| IDM-style | 분리(decoupled) | VGM | 명시적 비디오 rollout 또는 latent 예측 특징 | UniPi, VidMan, Vidar, Gen2Act, VPP, Video2Act, MimicVideo, TC-IDM, LVP, Say-Dream-ACT |
| Single-backbone | 공유 backbone | VGM | 공동 latent 예측, 선택적 시각 분기 | UVA, UWA, VideoVLA, VideoPolicy, Cosmos Policy, DreamZero, UD-VLA, GigaWorld-Policy |
| MoE/MoT | expert 융합 | VGM | latent 시각 가이드, expert rollout | GE-Act, Motus, LingBot-VA, BagelVLA, Fast-WAM, LDA-1B, FRAPPE, DiT4DiT |
| Unified VLA | joint co-training, 통합 MoT | UMM | 미래 이미지 예측, 구조화된 world knowledge | GR-1, UP-VLA, WorldVLA, DreamVLA, UniVLA, CoWVLA, F1, InternVLA-A1, HALO, TriVLA |
| Latent-space WM | latent 내재화 | MLLM | latent alignment, 예측 임베딩 | FLARE, VLA-JEPA, JEPA-VLA, WoG, DIAL |
여기서 VGM은 비디오 생성 모델, UMM은 통합 multimodal 모델, MLLM은 이미지와 텍스트를 함께 받아 처리하는 대형 언어 모델을 가리킨다. Table 1은 이 분류에 대표 연구 41건을 배치한다.
IDM-style 분리 구조
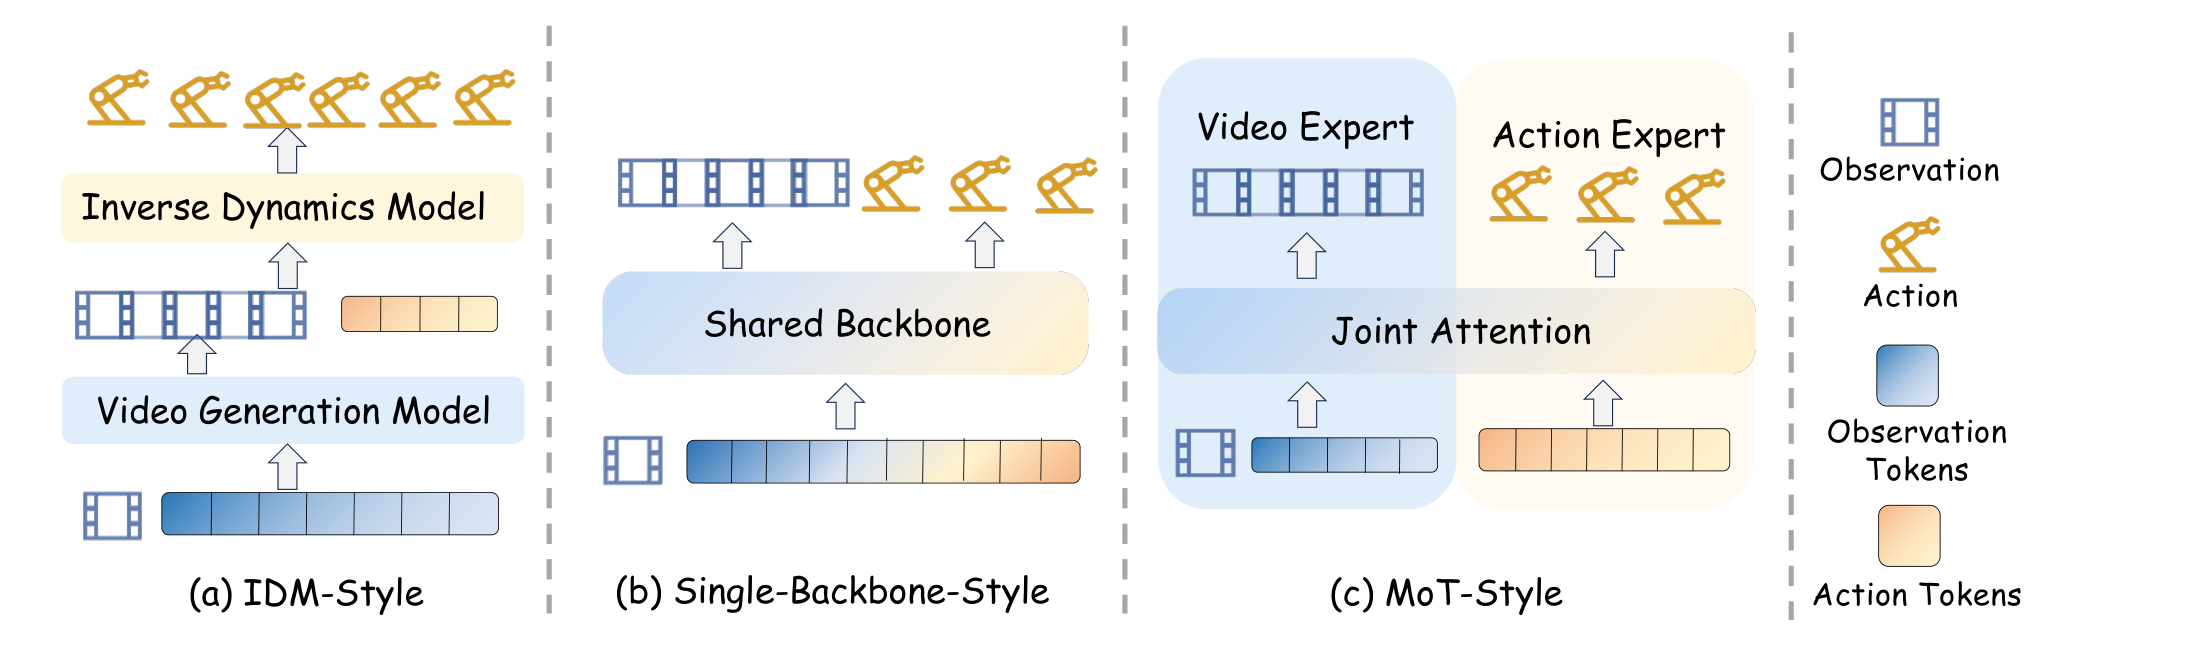
IDM-style은 예측과 action 생성을 서로 다른 두 모듈로 실현하는 분리 설계다. world model이 과제 조건부 미래 observation 시퀀스나 그 latent 표현을 만들면, 별도 policy 모듈이 현재 observation과 예측된 미래로부터 실행 action을 추론한다.
ô_{t+1:t+H} = W(o_t, l)                                        … (9)
π(a | o_t, l) = P(a_t | E_img(o_t), E_text(l), Φ(ô_{t+1:t+H})) … (11)
UniPi가 이 계열의 원형이다. 과제 조건부 미래 비디오를 만든 뒤 인접 프레임을 비교해 action 표현을 뽑는 별도 Inverse Dynamics Model을 학습한다. 후속 연구는 대체로 policy에 어떤 형태의 미래를 보여줄지를 다시 설계하는 쪽으로 진화했다.
| 하위 흐름 | 대표 연구 | 미래 표현의 형태 |
|---|---|---|
| 표준 2단계 유지 | VidMan, Vidar | 픽셀 rollout에 masked inverse dynamics를 더해 action 관련 영역을 강조 |
| 사람 영상 조건화 | Gen2Act | 로봇 중심 rollout 대신 생성된 사람 비디오로 조건화 |
| latent 특징 주입 | VPP, Video2Act | 픽셀 rollout을 버리고 pre-training된 비디오 diffusion의 latent 공간에서 제어 관련 특징만 뽑아 별도 action head에 주입 |
| 목표 조건 탐색 | V2A | 합성된 비디오 상태를 시각 목표로 두고 사후 탐색으로 목표 조건 policy를 학습 |
| 부분 denoise 계획 | MimicVideo | 명시적 비디오 예측 대신 부분적으로 denoise된 latent visual plan |
| 실행 지향 중간물 | TC-IDM, LVP | 도구 중심 기하 trajectory나 재타깃 가능한 visual plan |
| in-context 가이드 | Say-Dream-ACT | 생성된 비디오 계획을 Inverse Dynamics Model 타깃이 아니라 in-context 시각 가이드로 사용 |
3D 구조를 중간물로 삽입하는 보완 흐름도 있다. AVDC는 합성 영상에서 dense correspondence로 action을 복원하고, VidBot은 사람 영상에서 3D 손 trajectory와 상호작용 단서를 뽑는다. Object-centric 3D Motion Field는 객체 중심 3D 모션 구조로 action을 표현하고, NovaFlow는 생성 영상을 실행 가능한 3D object flow로 distillation한다.
이 계열을 정의하는 특징은 아키텍처 분리다. 예측 모델을 먼저 학습한 뒤 동결하거나 가볍게 적응시켜 별도 policy head에 연결하며, action 생성과 함께 최적화하지 않는다. 그 결과 모듈성과 재사용 가능한 비디오 prior, 해석 가능한 미래 예측을 얻는다. 반면 생성된 미래의 충실도와 controllability가 성능 상한을 정하고, 시각적으로 그럴듯하되 action과 어긋난 예측에서 compounding error가 커진다. controllability는 명령한 action 시퀀스를 생성된 미래가 얼마나 정확히 따르는지를 뜻한다.
Single-backbone 통합 생성
Single-backbone은 미래 시각 전개와 미래 action을 하나의 생성 backbone으로 함께 모델링한다. 미래 시각 표현과 action 표현을 이어붙인 x = [z^v; z^a]를 공유 backbone f_θ가 손상된 입력에서 복원하도록 학습한다.
ŷ = f_θ(x̃_τ, o_t, l, τ),  x = [z^v; z^a]        … (13)
L_unified = E[ℓ(ŷ, y)]                          … (14)
타깃 y는 인스턴스에 따라 달라진다. 연속 denoising 모델에서는 diffusion noise, flow matching 변형에서는 velocity field, 이산 denoising 정식화에서는 masked token이 된다.
설계 동기는 비디오 모델이 미래 observation을 상상할 수 있다는 사실 자체가 아니다. pre-training된 비디오 생성 backbone이 시간 순 observation을 모델링하도록 최적화돼 있어 모션 연속성과 시간 인과성, 근사적 물리 동역학에 대한 prior를 담고 있을 수 있다는 기대다. 이미지-텍스트 정렬 목적으로 pre-training돼 의미 대응을 강조하는 VLM backbone과 대비된다. 다만 저자들은 같은 규모의 VLM backbone보다 일관되게 우월한지는 열린 실증 문제라고 못 박는다.
| 연구 | 핵심 설계 |
|---|---|
| UVA | joint video-action latent 공간을 배우되 경량 모달리티별 디코딩 head로 policy 추론이 명시적 비디오 생성을 건너뛰게 한다 |
| UWA | 모달리티별 timestep을 둔 단일 Transformer 안에 비디오 diffusion과 action diffusion을 통합. timestep 제어로 시각적 미래를 주변화해 policy처럼 질의할 수 있다 |
| VideoVLA | Video Diffusion Transformer를 Video-Action Diffusion Transformer로 확장해 pre-training된 비디오 모델 자체를 policy backbone으로 삼는다 |
| VideoPolicy | 비디오 생성을 policy의 주된 기반으로 두고 action 예측을 그 위의 경량 인터페이스 층으로 축소한다 |
| Cosmos Policy | pre-training된 비디오 diffusion 구조를 거의 그대로 두고 action과 미래 상태, value를 원래 diffusion 시퀀스 안의 추가 latent 프레임으로 인코딩한다 |
| DreamZero | autoregressive flow-matching video-action DiT. 자유 주행식 long-horizon rollout 대신 closed-loop chunk 단위 joint denoising으로 compounding error를 제한한다 |
| UD-VLA | 같은 원리를 이산 multimodal 설정으로 옮겨 미래 이미지 토큰과 action 토큰을 하나의 동기 denoising trajectory 안에서 결합한다 |
| GigaWorld-Policy | 미래 action 예측과 action 조건부 미래 비디오 생성을 하나의 공유 Transformer 스택에서 함께 최적화하되, causal 설계로 추론 시 시각 분기를 선택적으로 만든다 |
DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조다. Cosmos Policy는 추론 시점에 출력을 대칭적으로 쓰지 않는다는 점이 특징이다. direct policy 모드에서는 action 출력만 쓰고, planning 모드에서는 미래 상태 예측과 value 예측으로 후보 trajectory에 순위를 매긴다.
저자들의 정리에 따르면 이 계열의 실제 차이는 온라인에서 전체 미래 비디오를 렌더링하는지에 있지 않다. 제어 중에 시각 분기가 얼마나 살아 있는지에서 갈린다.
MoE/MoT expert 결합
MoE/MoT는 완전 파라미터 공유가 늘 최적은 아니라는 가정에서 출발한다. 비디오 예측과 action 생성은 시간 주파수와 표현 스케일, 최적화 요구가 서로 다르기 때문이다. 그래서 비디오와 action, 때로는 언어와 장면 이해까지 별도 expert 스트림으로 유지한 채 층마다 상호작용시킨다.
(h^v_{ℓ+1}, h^a_{ℓ+1}) = F^mix_ℓ(h^v_ℓ, h^a_ℓ; o_t, l) … (15)
F^mix_ℓ은 joint attention이나 cross-attention, shared-attention fusion 같은 층별 상호작용 연산자다. 구조상 π0와 π0.5 같은 expert 분리형 VLA와 닮았으나, backbone이 정적 의미 인코더가 아니라 시간 예측형 비디오 생성기라는 점이 다르다.
이 계열은 세 가지 패턴으로 나뉜다.
- 병렬 expert 결합. GE-Act는 pre-training된 비디오 diffusion world model 옆에 병렬 flow-matching action 경로를 두고 deep cross-attention으로 시각 latent 특징을 주입한다. 전체 비디오를 온라인에서 렌더링하지 않고도 예측 구조를 제어로 옮긴다. 이 패러다임의 초기 형태는 이미지 편집 diffusion 모델로 subgoal을 예측해 목표 조건 policy가 따르게 하는 방식이었다.
- Mixture-of-Transformers 심층 상호작용. Motus는 이해와 비디오 생성, action 세 expert를 둔 Mixture-of-Transformers로 이 설계를 가장 직접 표현한다. LingBot-VA는 비디오 토큰과 action 토큰을 하나의 autoregressive 시퀀스로 교차 배치하고 shared attention을 쓰는 dual-stream MoT로 인과적 world modeling까지 확장한다. BagelVLA는 언어 계획과 시각 예보, action 생성을 한 실행 루프에 엮고 Residual Flow Guidance의 single-step denoising으로 시각 foresight를 실용화한다. DiT4DiT는 비디오 분기의 중간 denoising 특징으로 action 예측을 안내한다.
- latent expert 분리. LDA-1B는 시각 예보를 DINO latent 공간으로 옮기고 multimodal diffusion Transformer 안에서 shared self-attention으로 시각 expert와 action expert를 결합한다. FRAPPE는 미래 observation을 복원하는 대신 병렬 expert 스트림을 visual foundation model에 latent 공간에서 alignment시킨다.
Fast-WAM은 이 계열의 하이브리드에 해당하는데 결론이 특히 시사적이다. shared-attention Mixture-of-Transformers backbone에 비디오 분기와 action 분기를 결합해 놓고도, 주된 이득이 추론 시 명시적 미래 상상보다 학습 시 비디오 co-training에서 온다고 진단한다. co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다.
Unified VLA 내재화
Unified VLA는 명시적 비디오 world model 없이도 같은 multimodal policy backbone 안에서 미래 지향 예측 구조를 배우는 계열이다. 앞의 비디오 backbone 계열과의 차이는 미래 모델링이 별도 예측 모듈로 들어오지 않고 통합 VLA 아키텍처 안에 내재화된다는 점이다.
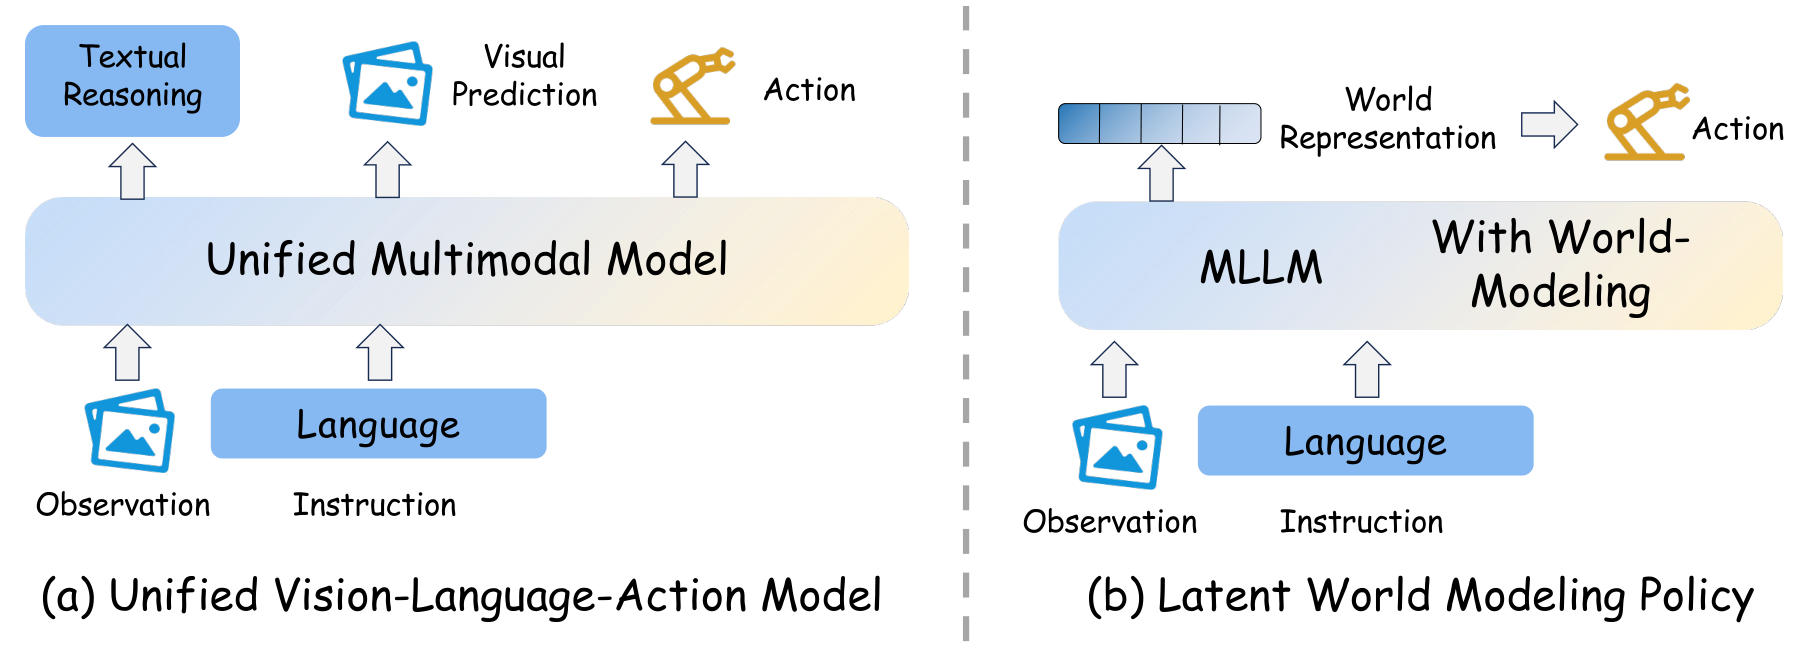
| 하위 부류 | 대표 연구 | 예측 구조 |
|---|---|---|
| 명시적 미래 상태 예측 | GR-1, UP-VLA, WorldVLA | 단일 프레임이나 짧은 시퀀스의 미래 이미지를 통합 학습 목적의 일부로 직접 예측 |
| latent 또는 암묵적 미래 모델링 | DreamVLA, UniVLA, CoWVLA | 미래 프레임 대신 action과 더 밀접한 압축 표현을 예측 |
| multi-expert 통합 모델 | F1, InternVLA-A1, HALO, TriVLA | 학습과 과제 수준에서는 통합돼 있으나 아키텍처 내부에 기능 분화를 유지 |
GR-1은 하나의 GPT 스타일 Transformer 안에서 action과 미래 이미지를 함께 예측한 초기 대표 사례다. WorldVLA는 action과 이미지의 이해와 생성을 하나의 autoregressive 틀에 통합하되, 미래 이미지 예측을 필수 추론 출력이 아니라 주로 joint training 신호로 쓴다. DreamVLA는 동적, 공간, 의미 단서를 담은 구조화된 world knowledge를 예측해 inverse dynamics 모델링을 지원한다. UniVLA는 네이티브 multimodal 토큰화 틀 위에서 post-training 중에 world modeling을 수행해 별도 외부 world model 없이 대규모 비디오 데이터의 인과 동역학을 흡수한다. CoWVLA는 중복된 미래 프레임을 복원하는 대신 latent motion과 압축된 미래 시각 타깃을 모델링한다.
multi-expert 계열에서 F1은 Mixture-of-Transformers 안에서 미래 시각 상태를 계획 타깃으로 예측하고, InternVLA-A1은 경량 latent visual foresight와 foresight 예측 및 action 생성의 공동 최적화를 더한다. HALO는 예측 분기를 visual subgoal 예측과 embodied 추론 쪽으로 밀고, TriVLA는 그라운딩과 episodic 동역학 지각, 제어를 협응하는 하위 시스템으로 조직한다.
이 계열을 가르는 기준은 모델이 독립된 world model을 품고 있는지가 아니다. 미래 지향 예측 모델링이 같은 multimodal policy backbone 안에 내재화돼 있는지가 기준이다.
Latent-space world modeling
Latent-space world modeling은 미래 예측을 표현 공간에서 전부 내재화해 명시적 이미지나 비디오 생성에 의존하지 않는 경로다. 미래 observation을 합성하는 대신 예측 latent 타깃과 미래 인식 임베딩, 압축된 제어 조건을 만들어 같은 policy 틀 안에서 action 생성과 결합한다. 개념적으로는 임베딩 공간에서 예측하는 JEPA 계열과 닿아 있지만, 초점은 JEPA 자체가 아니라 이 원리를 policy 학습의 실용 기제로 바꾼 VLA 기법들이다.
| 연구 | 핵심 설계 |
|---|---|
| FLARE | action denoising 네트워크의 hidden feature를 미래 observation의 latent 임베딩에 맞춘다(Future Latent Representation Alignment) |
| VLA-JEPA | leakage-free state prediction이 핵심. 미래 프레임을 오직 latent 타깃 생산에만 써서 모델이 픽셀 변화로 지름길을 타지 못하게 한다 |
| JEPA-VLA | 별도 latent 예측 head를 붙이는 대신 V-JEPA 2가 이미 배운 예측 임베딩을 backbone으로 채택한다. 정적 시각 표현보다 나은 policy prior라는 판단이다 |
| WoG | world modeling을 action 생성의 조건 공간으로 옮겨, 정밀 제어에 가장 유용한 미래 정보만 action과 함께 예측한다 |
| DIAL | VLM feature 공간의 latent visual foresight를 구조적 병목으로 써서 고수준 의도와 저수준 action을 분리한다 |
이 절 끝에는 심볼릭 world model과 planner 지향 world model이 보완 관점으로 붙는다. 신경망 policy backbone과 달리 predicate와 객체 관계, affordance, operator, 인과 과정 위의 추상 전이 모델을 외재화하고, 심볼릭 계획기나 task-and-motion 계획기가 그것을 질의해 고수준 skill 시퀀스를 만든다. 유용한 world model이 반드시 픽셀 예측에 의존하지 않는다는 점을 강조하려는 배치다.
강화학습 환경으로서의 시뮬레이터
Sec 4는 world model을 예측 모듈이 아니라 환경 자체로 세우는 쪽을 다룬다. 실제 로봇에서 강화학습을 돌리는 일은 느리고 비싸며 리셋이 어렵고 위험할 수 있다. 반면 순수 imitation learning은 시연 데이터의 품질에 갇히고 실패로부터 배우기 어렵다. 그래서 학습된 시뮬레이터 안의 상상 rollout으로 실제 상호작용을 대체한다.
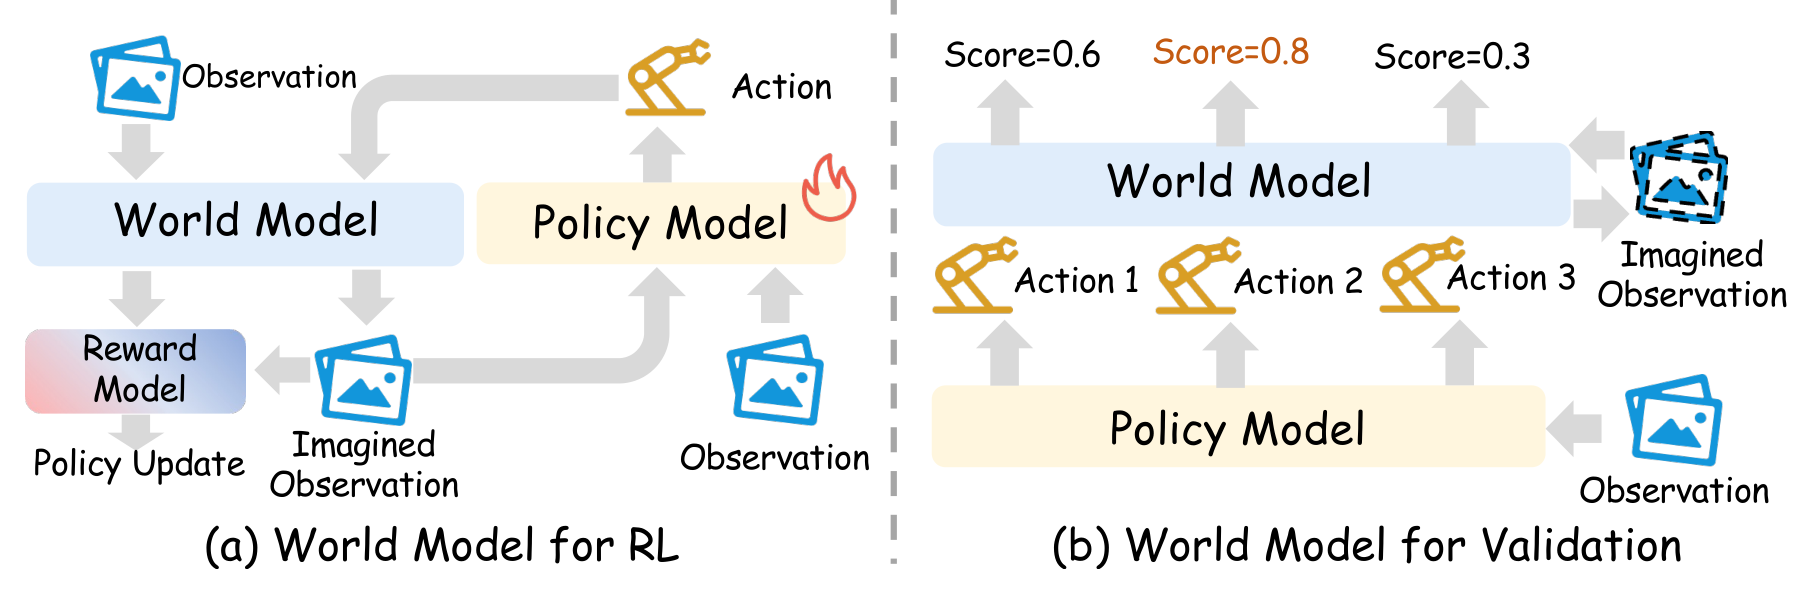
(ô_{t+1}, r̂_t, d̂_t) ~ p_φ(· | o_≤t, a_≤t, l)                  … (16)
J(θ) = E[Σ γ^t r̂_t]                                           … (17)
L_RL(θ) = -E[min(r_t(θ)Â_t, clip(r_t(θ), 1-ε, 1+ε)Â_t)]        … (18)
world model p_φ가 상상 전이를 만들고 필요하면 reward와 종료 신호까지 제공한다. reward는 policy가 얼마나 잘했는지를 알려주는 스칼라 신호이고, Â_t는 어떤 action이 평균보다 얼마나 나은지를 나타내는 advantage다. policy는 GRPO 계열 목적 함수로 개선되며 action chunk나 flow 기반 action head에 맞춘 변형이 함께 쓰인다.
1단계 연구군은 world model을 policy 최적화가 일어나는 환경으로 다룬다는 점에서 같고 reward 설계와 rollout 표현, 최적화 호환성에서 갈린다.
| 연구 | 기여 |
|---|---|
| UniSim, World-Env, VLA-RFT | action 조건부 시뮬레이션과 reward 생성을 결합한 기본 레시피를 세웠다 |
| DiWA | 대규모 play 데이터로 배운 동결 world model만으로 diffusion policy의 완전 오프라인 적응이 가능함을 보였다 |
| World4RL | diffusion world model로 end-to-end 상상 policy 최적화를 수행해 더 높은 충실도의 manipulation 개선을 다룬다 |
| World-Gymnast | 비디오 world model 안의 강화학습이 지도 fine-tuning과 소프트웨어 시뮬레이터를 모두 능가할 수 있음을 보였다 |
| PlayWorld | 자율적 play에서 로봇 world model을 배우고, 학습된 시뮬레이터 안의 강화학습이 실세계 성능을 올린다는 것을 보였다 |
| RehearseVLA | 물리적으로 일관된 world simulator와 reward 및 종료 피드백용 instant reflector로 VLA post-training에 적용했다 |
| WMPO | 픽셀 공간 상상과 on-policy GRPO를 강조한다 |
| ProphRL | FA-GRPO와 FlowScale로 flow 기반 action head에 강화학습 갱신을 맞춘다 |
| RISE | 시뮬레이터에 구성적 동역학과 progress value 추정을 더한다 |
| GigaBrain-0.5M | world model 기반 강화학습을 pre-training된 VLA 적응으로 확장했다 |
2단계는 학습된 시뮬레이터가 그 자체로 불완전하다는 사실을 직접 다룬다. World-VLA-Loop은 미래 observation과 reward를 함께 예측하고 policy 실패 rollout으로 시뮬레이터를 다듬는다. VLAW는 실제 데이터로 시뮬레이터를 고치고 합성 데이터로 VLA를 개선하는 왕복 전략을 쓴다. WoVR은 시뮬레이터 신뢰성을 중심 병목으로 보고 제어 가능한 action 조건부 비디오 모델링과 Keyframe-Initialized Rollouts를 도입하며 co-evolution을 명시적으로 정식화한다.
φ^{k+1} ← UpdateWM(φ^k, D_real ∪ D_policy(π_θ^k))
θ^{k+1} ← UpdatePolicy(θ^k, D̂(φ^{k+1}))                        … (19)
policy rollout이 world model을 다듬고 개선된 world model이 다음 policy 갱신을 위한 더 나은 상상 데이터를 낸다. 초점이 world model 안에서 강화학습을 하는 데서 world model을 함께 고쳐 가며 강화학습을 하는 쪽으로 옮겨 갔다는 것이 저자들의 진단이다.
평가자로서의 world model
같은 예측 능력은 학습이 아니라 판단에도 쓰인다. 현재 observation과 과제 지시문, 후보 action이 주어지면 world model이 예측된 미래를 rollout해 순위 매기기와 기각, 안전 필터링에 쓴다. 저자들은 이 쓰임을 네 가지 형태로 나눈다.
- rollout 기반 후보 평가. GPC는 policy를 재학습하지 않고 배포 시점에 동결된 생성 policy에 action 조건부 world model을 붙여 예측 look-ahead로 후보 action을 온라인에서 순위 매기고 다듬는다. IRASim은 여러 후보 trajectory를 시뮬레이션해 예측 value가 가장 높은 것을 고른다. World-in-World는 이를 closed-loop 계획으로 확장해 후보 계획을 상상 안에서 rollout하고 revision policy로 평가한 뒤 수정한다. DreamPlan은 world model rollout에서 후보 action의 선호 쌍을 만들어 평가자 논리를 학습 신호로 바꾼다.
- MPC의 전이 동역학. TD-MPC2와 LeWorldModel은 latent 공간 MPC가 embodied 에이전트의 long-horizon 추론을 크게 강화한다는 것을 보인다. world model을 통과하는 기울기 기반 계획으로 학습 시연에 명시적으로 없던 전략까지 찾아낸다. world model이 action의 수동적 심판에서 연속 제어 최적화를 위한 능동적 지도로 바뀌는 지점이다.
- policy 평가자. Veo World Simulator를 쓴 Gemini Robotics policy 평가는 비디오 world simulator를 오프라인 policy 평가와 분포 밖 시험, 안전 탐침에 쓴 대규모 사례다. WorldEval은 학습된 world model이 실세계 policy 평가의 확장 가능한 대리자가 될 수 있는지를 정면으로 다뤄, 서로 다른 policy와 같은 policy의 서로 다른 체크포인트까지 상상 안에서 순위 매기고 안전 탐지기 역할도 한다. WorldArena는 벤치마크 수준에서 policy 평가를 embodied world model의 핵심 downstream 용도로 명시한다.
- 명시적 피드백 head. World-Env는 연속 reward 예측과 action 종료 예측을 더하고, VLA-RFT는 제어 가능한 world simulator 안 상상 trajectory에서 계산한 검증된 reward를 쓴다. World-VLA-Loop은 상태 인식 비디오 world model 안에서 미래 observation과 reward를 함께 예측하고, RISE는 상상된 결과를 과제 진척도로 채점하는 progress value model을 도입한다.
JEPA 계열은 인접한 흐름으로 언급된다. V-JEPA 2와 V-JEPA 2.1은 임베딩 공간에서 예측과 계획을 수행하며, 후자는 latent action으로 조건화된 world model이 이미지 목표를 쓰는 zero-shot 로봇 계획을 지탱할 수 있음을 보인다. LeWorldModel은 더 단순하고 빠른 end-to-end JEPA 정식화로 물리적으로 개연성 없는 사건을 탐지할 수 있음도 보인다. 다만 저자들은 이 계열을 아직 완성된 policy 평가자라기보다 예측 계획과 개연성 점검의 인접 방향으로 본다.
평가자에는 단서가 붙는다. 상상한 미래가 후보 action의 인과적 결과를 보존할 때만 평가자가 쓸모 있다. Ctrl-World는 action에 충실한 rollout이 상상 안 policy 평가를 지탱할 수 있음을 보여 이 연결을 명시한다. 반면 WoVR은 환각과 long-horizon 오차가 시각 품질만 떨어뜨리는 데 그치지 않고 평가 신호 자체를 오염시킨다고 경고한다. 평가에는 사실성만으로 부족하고, rollout이 실세계 실행을 따라갈 만큼 신뢰할 수 있는지가 관건이다.
로봇 비디오 world model의 네 단계
Sec 5는 로봇 비디오 생성을 지각적 생성 문제가 아니라 시각적으로 명시된 world model을 구성하는 구체적 기제로 다룬다. 일반 비디오 합성과 달리 예측된 미래는 시각적으로 그럴듯한 데 더해 시간적으로 일관되고 action과 어긋나지 않으며 물리적으로 믿을 만하고 하위 의사결정에 쓸모 있어야 한다.
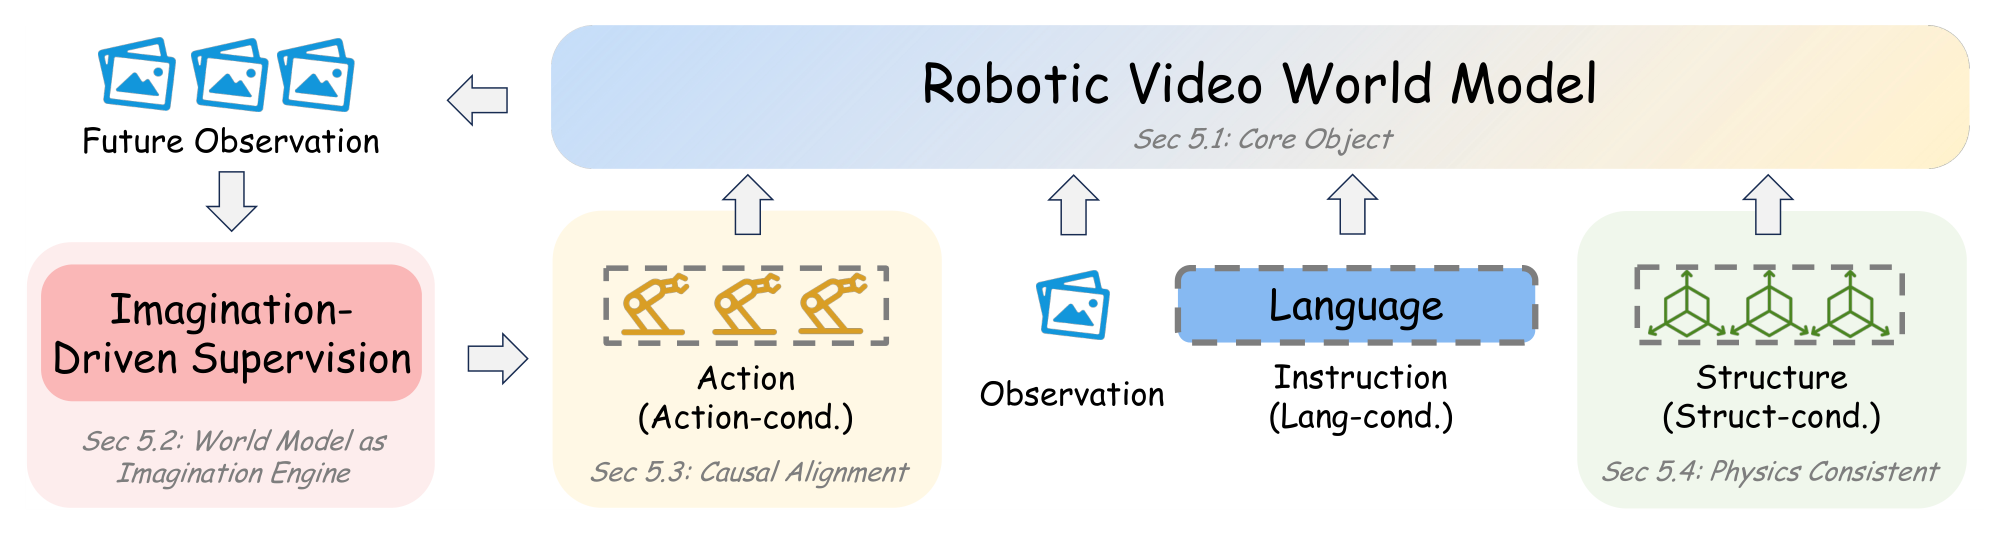
Table 2는 이 능력 중심 분류에 대표 기법을 배치한다. 표기에서 ✓는 원논문이 명시적으로 지원하거나 강조한 항목이고, Foundation-scale은 대규모 pre-training 비디오 모델이나 world foundation model 위에 세운 경우로 한정된다. Main use의 Plan.은 계획, Data는 데이터 생성, Eval.은 평가, Sim.은 시뮬레이션, Sup.은 감독 신호를 뜻한다.
| 단계 | 기법 | Task-cond. | Action-cond. | Structure-aware | Foundation-scale | 주 용도 |
|---|---|---|---|---|---|---|
| Imagination-based | UniPi | ✓ | – | – | ✓ | Plan. |
| Imagination-based | Video Language Planning | ✓ | – | – | ✓ | Plan. |
| Imagination-based | Dreamitate | – | – | – | ✓ | Plan. |
| Imagination-based | RoboDreamer | ✓ | – | – | – | Plan. |
| Imagination-based | ManipDreamer | ✓ | – | ✓ | – | Plan. |
| Imagination-based | DreMa | – | ✓ | ✓ | – | Data |
| Imagination-based | PhysWorld | ✓ | – | ✓ | – | Plan. |
| Imagination-based | DreamGen | ✓ | – | – | ✓ | Data |
| Action-Controllable | IRASim | – | ✓ | – | – | Plan. |
| Action-Controllable | RoboEnvision | ✓ | – | – | – | Plan. |
| Action-Controllable | RoboMaster | – | ✓ | ✓ | – | Data |
| Action-Controllable | Ctrl-World | – | ✓ | ✓ | – | Eval. |
| Action-Controllable | EnerVerse-AC | – | ✓ | ✓ | – | Eval. |
| Action-Controllable | Interactive World Simulator | – | ✓ | – | – | Sim. |
| Action-Controllable | EVA | ✓ | – | – | – | Eval. |
| Structure-Aware | Mask2IV | ✓ | – | ✓ | – | Data |
| Structure-Aware | TesserAct | ✓ | – | ✓ | – | Sup. |
| Structure-Aware | RoboVIP | ✓ | – | ✓ | – | Data |
| Foundation Video WM | Vid2World | – | ✓ | – | ✓ | Sim. |
| Foundation Video WM | Genie Envisioner | ✓ | ✓ | – | ✓ | Sim. |
| Foundation Video WM | DreamDojo | – | ✓ | – | ✓ | Sim. |
| Foundation Video WM | WoW | – | – | – | ✓ | Plan. |
| Foundation Video WM | UnifoLM-WMA-0 | ✓ | ✓ | – | – | Sim. |
| Foundation Video WM | Cosmos Predict 2.5 | ✓ | – | – | ✓ | Sim. |
| Foundation Video WM | GigaWorld-0 | – | – | ✓ | ✓ | Data |
| Foundation Video WM | ABot-PhysWorld | – | ✓ | – | ✓ | Sim. |
1단계인 상상 기반 생성은 강한 생성 prior로 미래 과제 실행을 합성해 감독 신호를 수집된 로봇 trajectory 밖으로 넓히는 데 목적이 있다. Dreamitate는 과제별 사람 시연 데이터로 비디오 diffusion 모델을 fine-tuning하고, 새 장면에서 합성한 실행을 곧바로 실제 로봇 제어의 action 안내용 visual plan으로 쓴다. RoboDreamer는 지시문을 재사용 가능한 primitive로 분해하고 그 구조화된 요소로 조건화하는 구성적 world modeling으로 미학습 조합에 대한 일반화를 높인다. ManipDreamer는 action tree 표현과 depth 및 의미 시각 가이드를 더해 지시 따르기와 시간 및 물리 일관성을 강화한다.
같은 단계 안에서 상상을 학습 가능한 디지털 트윈으로 재해석하는 흐름도 있다. DreMa는 Gaussian Splatting과 물리 시뮬레이터를 결합해 조작 가능한 장면 표현을 복원하고 imitation learning용 추가 시연 데이터를 만든다. PhysWorld는 사실적 모션과 물리적으로 실행 가능한 행위 사이의 간극을 겨냥해 생성 영상에서 물리 world model을 복원하고 객체 중심 residual 강화학습으로 예측 모션을 로봇 action에 grounding한다. DreamGen은 강한 비디오 생성기를 목표 embodiment에 적응시켜 neural trajectory를 합성하고 latent action 모델링이나 inverse dynamics로 실행 가능한 action을 복원한다. neural trajectory는 video world model이 만들어낸 합성 trajectory 데이터이고, latent action은 두 프레임 사이의 시각적 변화를 action 라벨 없이 부호화한 벡터다.
2단계인 action controllability 단계에서 질문은 그럴듯한 미래 영상 생성에서 명령한 action 시퀀스를 미래가 얼마나 정확히 따르는지로 옮겨 간다. IRASim은 manipulation을 trajectory-to-video 문제로 정식화하고 각 Transformer 블록 안에 프레임 단위 action 조건화를 넣어 개별 action과 대응 미래 프레임의 alignment를 강화한다. RoboMaster는 manipulation을 여러 국면으로 분해하고 로봇 팔과 조작 대상의 결합 운동을 함께 모델링해 접촉이 풍부한 상황에서 충실도를 높인다. Ctrl-World는 multi-view 공동 예측과 프레임 단위 action 제어, 메모리 기반 long-horizon 생성을 묶어 policy 평가와 표적 개선을 함께 지원한다. EVA는 사후 정렬 관점에서 시각적으로 그럴듯한 rollout과 물리적으로 실행 가능한 로봇 행위 사이의 실행 가능성 간극을 겨냥해 inverse dynamics reward로 world model을 매끄럽고 embodiment에 일관된 action 시퀀스에 맞춘다.
3단계인 구조 인식 생성은 저차원 action 시퀀스만으로 조건화하는 대신 마스크와 기하, 시점, 정체성 단서를 부호화해 접촉 관계와 장면 구조를 보존한다. Mask2IV는 행위자와 객체의 상호작용 trajectory를 먼저 예측하고 그 trajectory로 조건화해 영상을 만드는 2단계 설계로 조밀한 사용자 마스크 없이도 상호작용 결과를 제어한다. TesserAct는 표현 공간을 2D 비디오에서 RGB와 depth, normal을 아우르는 4D embodied world model로 확장해 공간 일관성을 높이고 더 강한 inverse dynamics와 policy 학습을 가능하게 한다. RoboVIP는 시각 정체성 프롬프트로 multi-view 비디오 diffusion을 안내해 시간적으로 일관된 multi-view observation을 만들고 manipulation 데이터 증강에 쓴다.
4단계는 대규모 비디오 backbone을 재사용 가능한 world model로 전환하는 흐름이다. Vid2World는 로봇 world model을 처음부터 학습하는 대신 pre-training된 비디오 diffusion 모델을 action 조건부 rollout에 적합한 상호작용 world model로 체계적으로 변환한다. Genie Envisioner는 비디오 world modeling과 action 디코딩을 통합한 world foundation 플랫폼으로 확장한다. world foundation model은 여러 downstream Physical AI 환경으로 fine-tuning될 것을 전제로 학습한 범용 world model이다. DreamDojo는 대규모 사람 1인칭 영상으로 pre-training하고 연속 latent action으로 라벨 없는 사람 상호작용과 로봇 제어를 이은 뒤 목표 embodiment로 post-training해, long-horizon 실시간 rollout과 policy 평가, 모델 기반 계획을 지원한다.
WoW는 이 흐름에 다른 논거를 댄다. 물리 직관은 수동적으로 영상만 봐서는 얻어지지 않는다고 보고 방대한 로봇 상호작용 trajectory로 대형 생성 world model을 학습하며, 생성 rollout을 inverse dynamics 및 비평과 결합해 상상에서 action으로 가는 루프를 명시적으로 닫는다. 플랫폼 수준에서는 UnifoLM-WMA-0과 Cosmos Predict 2.5가 재사용 가능한 world backbone 경향을 보여주고, GigaWorld-0은 제어 가능한 비디오 분기와 물리적으로 grounding된 3D 분기를 결합해 대규모 embodied 데이터 합성이라는 데이터 엔진 관점을 전면화한다. ABot-PhysWorld는 physics alignment를 갖춘 world foundation model 쪽으로 이 흐름을 확장한다. physics alignment는 생성 결과가 물리 법칙을 지키는지 재는 평가 기준이다.
내비게이션과 자율주행
내비게이션에서 world model이 쓸모 있는 지점은 영상의 사실성보다 아직 보이지 않는 미래 구조를 계획에 쓸 수 있는 형태로 노출하는 데 있다. 에이전트가 환경의 일부만 볼 수 있는 상황에서 아직 드러나지 않은 공간과 물체, 경로를 추론해야 하기 때문이다.
| 연구 | 접근 |
|---|---|
| Pathdreamer | 미방문 실내 시점의 360도 RGB와 depth, semantic을 생성. 상상 observation으로 계획해도 실제 미래 observation으로 계획한 결과와의 격차가 크게 줄어든다 |
| VISTA | 지시문 조건 시각 상상을 위한 imagine-and-align 전략 |
| VISTAv2 | 후보 action 아래 1인칭 미래를 rollout해 온라인 value map에 투영 |
| NWM | 제어 가능한 비디오 생성을 내비게이션 world model로 명시적으로 정식화 |
| SparseVideoNav | 조밀한 long-horizon rollout을 희소 미래 생성으로 대체해 배치 속도를 높인다 |
| EgoWM | pre-training된 인터넷 규모 비디오 diffusion을 경량 조건화로 action 조건부 1인칭 world model로 적응 |
자율주행은 요구 수준이 더 높다. long-horizon 예보와 다중 에이전트 상호작용, 구조화된 기하, 안전 필수 계획이 모두 걸리기 때문이다. 초기 연구는 두 갈림길을 보인다. 압축되거나 구조화된 예측 상태 쪽에는 도시 주행용 latent 동역학 모델을 배우는 MILE과 3D occupancy 공간에서 world modeling을 정식화한 OccWorld가 있다. 생성 관점 쪽에는 비디오와 텍스트, action 토큰의 multimodal 시퀀스 모델링으로 주행 world modeling을 다루는 GAIA-1과 구조 제약을 둔 diffusion 모델링으로 복잡한 교통 전개를 포착하는 DriveDreamer가 있다.
최근 연구는 계획 지향과 통합 주행 지능 쪽으로 이동한다. Drive-WM은 제어 가능한 multi-view 미래 영상을 만들고 상상된 다중 미래와 이미지 기반 reward로 더 안전한 trajectory를 고른다. UniDWM은 구조와 동역학을 함께 인식하는 latent world 표현을 지각과 예측, 계획의 통합 기반으로 제안한다. DriveWorld-VLA는 latent world 상태를 계획기의 결정 상태로 써서 값비싼 픽셀 rollout 없이 action 조건부 상상이 제어를 안내하게 한다. DriveVLA-W0는 world modeling을 통한 미래 이미지 예측이 저차원 action 감독만으로는 얻지 못하는 조밀한 자기지도 신호를 제공해 end-to-end 주행 VLA의 데이터 스케일링 법칙을 증폭한다고 주장한다. SteerVLA는 고수준 VLM을 의미 수준 world model로 보고, 세밀한 상식 추론을 만들어 저수준 VLA policy를 복잡한 롱테일 주행 상황에서 조향하게 한다.
결과
평가 체계 3층
embodied 지능에서 world model 평가는 일반 컴퓨터 비전의 비디오 생성 모델 평가와 근본적으로 다르다. 실제 물리 동역학과 일관된 action 조건부 미래 상태를 만들 수 있는지가 가치를 정하기 때문이다. 저자들은 기존 벤치마크를 세 층으로 나눈다.
| 층 | 묻는 것 | 대표 벤치마크 |
|---|---|---|
| Open-loop 예측 품질 (7.1.1) | 명령한 행위에 미래가 시간에 걸쳐 충실한가 | RBench, EWMBench, DreamGen Bench, EVA-Bench |
| Closed-loop 과제 유용성 (7.1.2) | 그 예측이 상호작용하는 결정 루프 안에서 쓸모 있는가 | WorldArena, WorldEval, WorldGym, World-in-World |
| 물리 및 실행 가능성 진단 (7.1.3) | 어떤 성질이 실제 제어 사용 가능성을 가르는가 | WorldSimBench, WoW-World-Eval, DrivingGen, WM-ABench |
open-loop 층은 모델을 계획기나 제어 루프에 넣지 않고 미래 observation을 자기회귀로 생성하게 한다. RBench는 다양한 로봇 과제와 embodiment에 걸친 구조 일관성과 물리 개연성, action 완결성을 강조하고, EWMBench는 장면 일관성과 모션 정확성, 의미 alignment로 나눠 보는 분해적 관점을 취한다. DreamGen Bench는 지시 따르기와 physics alignment를 평가해 생성된 rollout이 policy 학습용 합성 경험으로 쓸모 있는지를 묻고, EVA-Bench는 시점과 장면 배치, 모션 분포 변화 아래에서 long-horizon 예측과 도메인 밖 견고성을 강조한다.
closed-loop 층에서는 기준이 바뀐다. 픽셀 정확도보다 policy 순위의 일관성과 value 충실도, 결정 신뢰성이 더 유익한 지표로 자리 잡는다. WorldArena는 합성 데이터 생성과 policy 평가, action 계획이라는 기능적 역할로 평가해 시각적 사실성과 embodied 유용성 사이의 간극을 드러낸다. WorldEval은 학습된 world model 안의 rollout이 로봇 policy와 체크포인트의 상대 순서를 보존하는지를 비교 평가로 다룬다. WorldGym은 학습된 모델을 몬테카를로 평가용 상호작용 환경으로 두고 추정된 policy value와 성공 추세가 실세계와 맞는지를 본다. World-in-World는 이질적인 world model을 온라인 계획 과제에 통합하는 단일 인터페이스를 제공해, 예측과 action이 시간에 걸쳐 상호작용할 때 드러나는 compounding error를 노출한다.
진단 층은 더 표적화된 질문을 던진다. WorldSimBench는 지각 평가와 조작 평가를 결합해 생성 영상이 inverse dynamics 복원과 하위 제어를 지탱할 만큼 action 및 환경 동역학과 일관적인지를 묻는다. WoW-World-Eval은 지각과 계획, 예측, 실행, 일반화를 두루 다루면서 물리 법칙과 실행 지향 기준을 도입하고, 생성 영상이 개연성 있고 실행 가능한 행위를 유도하는지 보는 Inverse Dynamics Model 기반 튜링 테스트를 포함한다. 자율주행 쪽 DrivingGen은 시각적 사실성만이 아니라 trajectory 개연성과 시간 일관성, ego 조건화 아래의 controllability로 평가해 외형 품질과 물리적으로 신뢰할 만한 모션 생성 사이의 상충을 드러낸다. WM-ABench는 공간 및 시간 이해와 모션 지각, 기계적 시뮬레이션, 통제된 반사실 추론 같은 원자 능력으로 평가를 분해한다.
세 층은 함께 층위 있는 평가 틀을 이룬다. 저자들이 여기서 끌어내는 교훈은 어떤 단일 지표도 embodied world model 평가에 충분하지 않다는 것이다.
학습 데이터셋 27종
벤치마크가 평가 방법을 정한다면 학습 데이터셋은 world model이 애초에 무엇을 배울 수 있는지를 정한다. embodied 지능에서 이 데이터는 단순한 영상 모음이 아니라 observation과 action, 과제 진행, embodiment별 제약, 물리 상호작용 동역학이 결합된 에이전트-환경 전이 표본이다. 따라서 데이터셋의 가치는 규모만으로 정해지지 않는다.
Table 3은 27종 자원의 핵심 속성을 정리한다. 열의 뜻은 다음과 같다. X-Emb.는 cross-embodiment 커버리지, Act.는 명시적 action 감독이나 정렬된 action 대리 신호, Obs./3D는 단안 RGB를 넘어서는 multi-view와 depth, LiDAR, 3D 주석 지원, Lang.은 언어 및 과제 조건화, M/C는 힘과 촉각, 오디오, 조밀한 접촉 단서 같은 멀티모달 신호를 가리킨다. ✓는 강한 지원, –는 부분 지원, ✗는 없거나 강조되지 않음을 뜻한다.
| 자원 | 연도 | 출처 | X-Emb. | Act. | Obs./3D | Lang. | M/C |
|---|---|---|---|---|---|---|---|
| RoVid-X | 2026 | Real/Robot video | – | – | – | ✓ | ✗ |
| Open X-Embodiment (OXE) | 2024 | Real | ✓ | ✓ | – | – | – |
| DROID | 2024 | Real | ✗ | ✓ | – | ✓ | – |
| BridgeData V2 | 2023 | Real | ✗ | ✓ | – | ✓ | – |
| AgiBot World | 2025 | Real | – | ✓ | – | ✓ | – |
| Galaxea Open-World Dataset | 2025 | Real | – | ✓ | – | ✓ | – |
| Humanoid Everyday | 2025 | Real | – | ✓ | ✓ | ✓ | ✓ |
| RoboMIND 2.0 | 2025 | Real+Sim | ✓ | ✓ | – | ✓ | ✓ |
| FastUMI-100K | 2025 | Real | – | ✓ | ✓ | ✓ | – |
| BRMData | 2024 | Real | – | ✓ | ✓ | – | – |
| UMI | 2024 | Real | – | ✓ | – | – | ✗ |
| MV-UMI | 2025 | Real | ✓ | ✓ | ✓ | – | ✗ |
| ActiveUMI | 2025 | Real | – | ✓ | ✓ | – | ✗ |
| TWIST2 | 2025 | Real | – | ✓ | – | ✗ | ✗ |
| DexWild | 2025 | Human+Robot | ✓ | – | – | ✗ | ✗ |
| EgoMimic | 2025 | Human+Robot | – | – | ✓ | ✗ | ✗ |
| PHSD / In-N-On | 2025 | Human ego | ✗ | – | – | ✗ | ✗ |
| UniHand | 2025 | Human video | – | – | – | ✓ | ✗ |
| UniHand 2.0 | 2026 | Human+Robot+VLM | ✓ | ✓ | – | ✓ | ✗ |
| Hoi! | 2025 | Human+Robot | ✓ | ✓ | ✓ | ✗ | ✓ |
| FreeTacMan | 2025 | Robot-free | – | ✓ | ✓ | ✗ | ✓ |
| Humanoid Visual-Tactile-Action | 2025 | Real | ✗ | ✓ | – | ✗ | ✓ |
| VTDexManip | 2025 | Human tactile | ✗ | – | – | ✗ | ✓ |
| RH20T | 2023 | Real | – | ✓ | – | ✓ | ✓ |
| RH20T-P | 2025 | Real | – | ✓ | – | ✓ | ✓ |
| RoboTwin 2.0 | 2025 | Sim | ✓ | ✓ | – | ✓ | – |
| Action100M | 2026 | Web video | ✗ | – | ✗ | ✓ | ✗ |
Table 4는 같은 자원을 지원 가능한 world modeling 능력 기준으로 재배열한다. 각 능력에 강한 관련성을 갖는 자원만 추리면 다음과 같다.
| 능력 | 강한 관련 자원 |
|---|---|
| 일반 trajectory pre-training | OXE, DROID, BridgeData V2, AgiBot World, Galaxea, Humanoid Everyday, RoboMIND 2.0, FastUMI-100K, BRMData |
| long-horizon 모델링 | Humanoid Everyday, RoboMIND 2.0, FastUMI-100K, BRMData |
| cross-embodiment 확장 | OXE, RoboMIND 2.0, MV-UMI, DexWild, UniHand 2.0, Hoi!, RoboTwin 2.0 |
| 사람 prior 전이 | UMI, MV-UMI, ActiveUMI, DexWild, EgoMimic, PHSD / In-N-On, UniHand, UniHand 2.0, VTDexManip |
| 접촉과 물리 인식 | Humanoid Everyday, RoboMIND 2.0, Hoi!, FreeTacMan, Humanoid Visual-Tactile-Action, VTDexManip, RH20T, RH20T-P |
| 합성 데이터와 레시피 확장 | UniHand 2.0, RoboTwin 2.0, Action100M |
두 표를 겹쳐 보면 현재 자원이 서로 배타적인 묶음이 아니라 여러 병행 기준 위에 퍼져 있다는 사실이 드러난다. 대규모 로봇 trajectory 코퍼스는 action 조건부 예측에 필요한 기본 전이 커버리지를 제공하고, cross-embodiment 데이터셋은 플랫폼 사이에서 옮겨지는 동역학 prior를 유도한다. 사람 영상과 human-to-robot 자원은 로봇이 직접 모은 trajectory 밖의 상호작용 규칙성을 배우는 경로이고, 촉각과 힘, 접촉이 풍부한 데이터셋은 실행 가능성과 물리 일관성을 grounding하는 데 특히 중요하다.
이 다중 기준 관점은 현재 지형의 핵심 한계도 드러낸다. 자원이 빠르게 늘었어도 실패 복구와 결정에 민감한 변이, 물리적으로 grounding된 조밀한 감독은 대규모 성공 시연 데이터에 비해 여전히 훨씬 희소하다.
LIBERO 4-suite 성적
Table 5는 LIBERO 표준 4-suite 성공률을 world modeling이 policy 학습에 결합되는 방식별로 묶는다. 발표 연도가 아니라 결합 방식으로 묶었다는 점이 이 표의 설계 의도다. 평균이 비슷해도 하위 suite에서 크게 갈릴 수 있어 Spatial과 Object, Goal, Long의 분해를 유지한다.
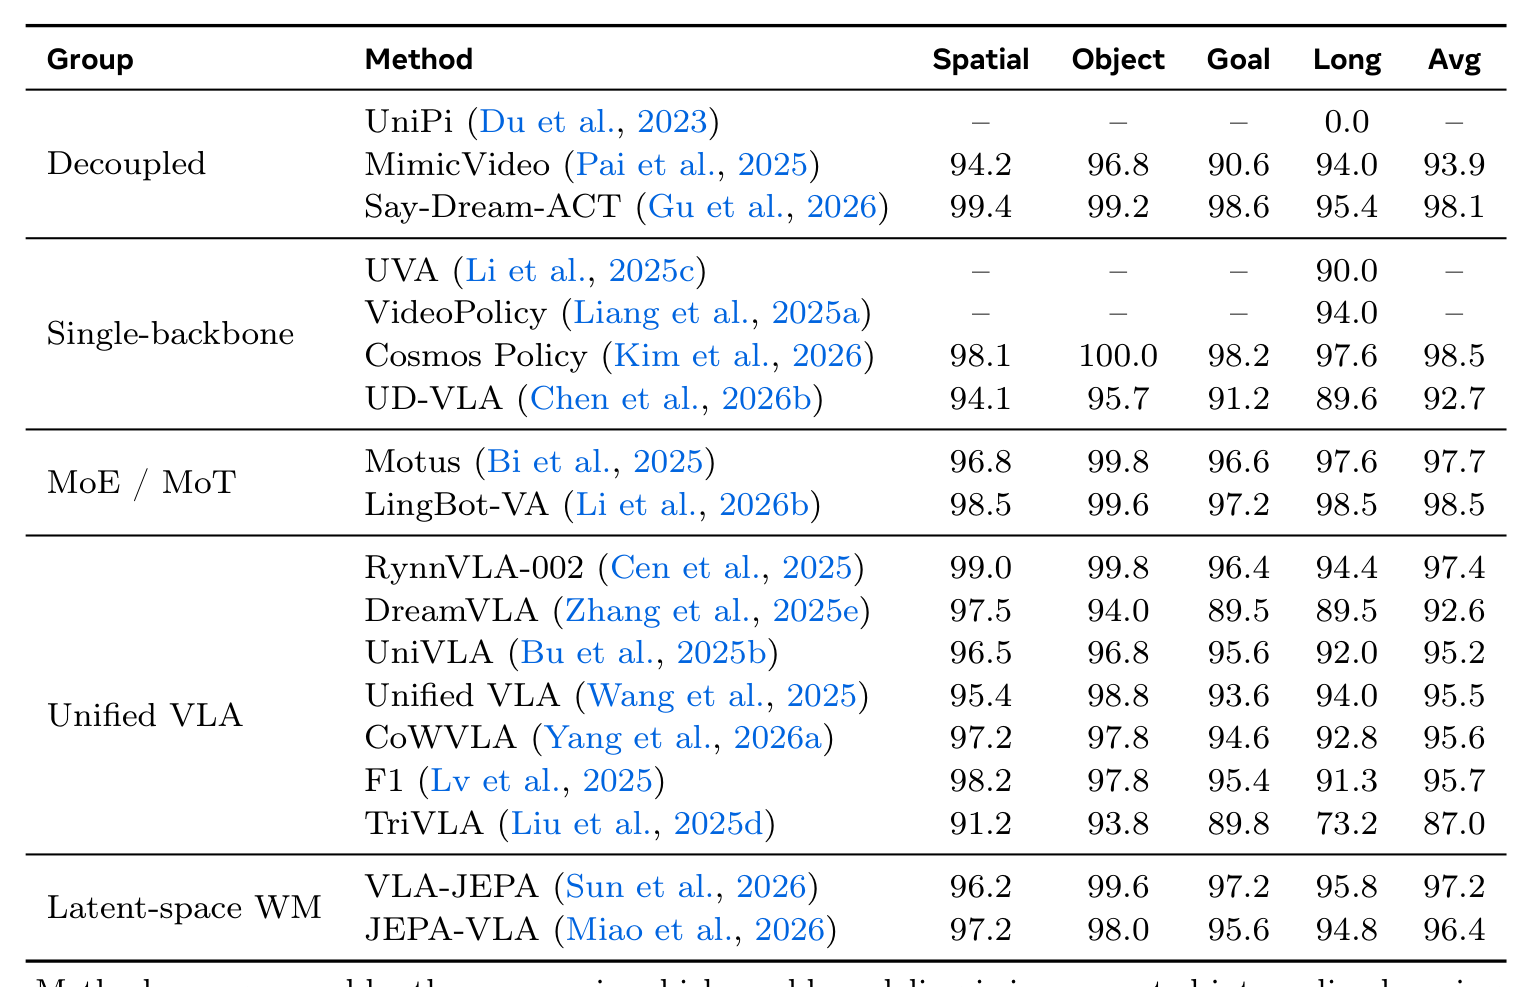
| 그룹 | 기법 | Spatial | Object | Goal | Long | Avg |
|---|---|---|---|---|---|---|
| Decoupled | UniPi | – | – | – | 0.0 | – |
| Decoupled | MimicVideo | 94.2 | 96.8 | 90.6 | 94.0 | 93.9 |
| Decoupled | Say-Dream-ACT | 99.4 | 99.2 | 98.6 | 95.4 | 98.1 |
| Single-backbone | UVA | – | – | – | 90.0 | – |
| Single-backbone | VideoPolicy | – | – | – | 94.0 | – |
| Single-backbone | Cosmos Policy | 98.1 | 100.0 | 98.2 | 97.6 | 98.5 |
| Single-backbone | UD-VLA | 94.1 | 95.7 | 91.2 | 89.6 | 92.7 |
| MoE / MoT | Motus | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| MoE / MoT | LingBot-VA | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| Unified VLA | RynnVLA-002 | 99.0 | 99.8 | 96.4 | 94.4 | 97.4 |
| Unified VLA | DreamVLA | 97.5 | 94.0 | 89.5 | 89.5 | 92.6 |
| Unified VLA | UniVLA | 96.5 | 96.8 | 95.6 | 92.0 | 95.2 |
| Unified VLA | Unified VLA | 95.4 | 98.8 | 93.6 | 94.0 | 95.5 |
| Unified VLA | CoWVLA | 97.2 | 97.8 | 94.6 | 92.8 | 95.6 |
| Unified VLA | F1 | 98.2 | 97.8 | 95.4 | 91.3 | 95.7 |
| Unified VLA | TriVLA | 91.2 | 93.8 | 89.8 | 73.2 | 87.0 |
| Latent-space WM | VLA-JEPA | 96.2 | 99.6 | 97.2 | 95.8 | 97.2 |
| Latent-space WM | JEPA-VLA | 97.2 | 98.0 | 95.6 | 94.8 | 96.4 |
수치는 모두 성공률 백분율이고 –는 표준 프로토콜 아래 직접 보고된 값이 없다는 뜻이다. 2023년 UniPi가 Long suite에서 0.0%였던 것과 최신 기법이 95%에서 98% 사이를 내는 것을 나란히 놓으면 3년 사이의 격차가 그대로 드러난다.
분해 결과가 말해 주는 바는 두 가지다. 첫째, 강한 성능이 특정 아키텍처 패러다임에만 나타나지 않는다. 분리형과 공유 backbone, 통합형, mixture 기반, latent 예측형 모두에서 경쟁력 있는 성적이 나온다. 둘째, Spatial과 Object에서는 대부분 이미 강한 반면 Goal, 특히 Long에서 하락 폭이 크다. TriVLA는 Spatial 91.2%에서 Long 73.2%로 18.0%p 떨어져 이 경향을 가장 뚜렷하게 보여준다. long-horizon manipulation은 확장된 trajectory 전체에 걸쳐 action에 grounding된 일관성을 유지해야 성공하기 때문에 여전히 변별점으로 남는다.
RoboTwin과 CALVIN과 SIMPLER 성적
Table 6은 RoboTwin 2.0과 CALVIN, SIMPLER 계열 결과를 같은 방식으로 묶는다. 열의 뜻은 다음과 같다. RT-A와 RT-B는 각각 무작위화하지 않은 단순 설정과 무작위화한 어려운 설정의 RoboTwin 평가이고, C-A와 C-D는 CALVIN의 ABCD와 ABCDD 프로토콜이며, S-G와 S-W와 S-O는 SIMPLER 계열의 Google Robot, WidowX, 기타 설정 결과다. a/b 형태는 원문이 두 가지 프로토콜 변형을 보고한 경우다.
| 그룹 | 기법 | RT-A | RT-B | C-A | C-D | S-G | S-W | S-O |
|---|---|---|---|---|---|---|---|---|
| Decoupled | UniPi | – | – | 0.92 | – | – | – | – |
| Decoupled | VidMan | – | – | 3.42 | – | – | – | – |
| Decoupled | Vidar | 65.8 | 17.5 | – | – | – | – | – |
| Decoupled | VPP | – | – | 4.33 | – | – | – | – |
| Decoupled | Video2Act | 54.6 | 54.1 | – | – | – | – | – |
| Decoupled | MimicVideo | – | – | – | – | – | – | 46.9/56.3 |
| Single-backbone | VideoVLA | – | – | – | – | 73.1/62.8 | 53.1 | 63.0 |
| Single-backbone | UD-VLA | – | – | – | 4.64 | – | 62.5 | – |
| MoE / MoT | Motus | 88.7 | 87.0 | – | – | – | – | – |
| MoE / MoT | LingBot-VA | 92.9 | 91.6 | – | – | – | – | – |
| MoE / MoT | LingBot-VLA | 88.6 | 86.7 | – | – | – | – | – |
| MoE / MoT | BagelVLA | 75.3 | 20.9 | 4.41 | – | – | – | – |
| MoE / MoT | FRAPPE | 57.5 | 25.5 | – | – | – | – | – |
| Unified VLA | GR-1 | – | – | 3.06 | 4.21 | – | – | – |
| Unified VLA | UP-VLA | – | – | 4.08 | 4.42 | – | – | – |
| Unified VLA | DreamVLA | – | – | 4.44 | – | – | – | – |
| Unified VLA | Unified VLA | – | – | 4.41 | 4.63 | – | 69.8 | – |
| Unified VLA | CoWVLA | – | – | 4.21 | 4.47 | 60.9 | 76.0 | – |
| Unified VLA | F1 | – | – | – | – | – | – | 72.9 |
| Unified VLA | InternVLA-A1 | 89.4 | 87.0 | – | – | – | – | – |
| Unified VLA | HALO | 80.5 | 26.4 | – | – | – | – | – |
| Unified VLA | TriVLA | – | – | 4.37 | – | – | – | – |
| Latent-space WM | VLA-JEPA | – | – | – | – | 65.2 | 57.3 | – |
| Latent-space WM | JEPA-VLA | 73.5 | 17.7 | – | – | – | – | – |
| Latent-space WM | WoG | – | – | – | – | 69.4 | 63.5 | – |
RoboTwin의 두 설정 차이가 특히 눈에 띈다. LingBot-VA는 RT-A 92.9%에서 RT-B 91.6%로 1.3%p만 떨어지고 Motus도 88.7%에서 87.0%로 1.7%p 하락에 그친다. 반면 JEPA-VLA는 73.5%에서 17.7%로 55.8%p, HALO는 80.5%에서 26.4%로 54.1%p, BagelVLA는 75.3%에서 20.9%로 54.4%p 하락한다. 환경을 무작위화하면 상위 기법과 나머지 사이의 간격이 크게 벌어진다.
이 표는 LIBERO보다 embodiment와 프로토콜이 이질적이라 엄밀한 순위 비교에는 덜 적합하다. 다만 벤치마크 사이의 변동을 드러내는 데는 유용하다. 한 벤치마크의 강한 성능이 다른 벤치마크로 반드시 이어지지 않으며, 현재 embodied world model이 embodiment와 action space, 과제 구성, 평가 프로토콜 차이에 여전히 민감하다는 사실을 보여준다.
저자들이 뽑은 세 결론
표준 하위 manipulation 벤치마크에서 embodied world model은 이미 실질적인 쓸모를 보인다는 것이 첫 번째 결론이다.
높은 성능이 여러 설계 패러다임에서 함께 나온다는 것이 두 번째 결론이다. 따라서 photorealistic 비디오 생성은 효과적인 embodied 제어의 필요조건이 아니다.
남은 과제가 long-horizon 견고성과 벤치마크 간 일반화, 그리고 플랫폼을 가로지르는 표준 보고 체계의 부재에 있다는 것이 세 번째 결론이다.
한계
Sec 8은 단순한 규모 확대만으로 해결되지 않는 여섯 가지 과제를 꼽는다.
- Causal conditioning gaps (8.1). 많은 예측 목적 함수가 observation 이력과 과제 의도에서 주로 학습된다. 그래서 생성된 미래가 의미상 그럴듯하고 의도와 일치하면서도 실행 대기 중인 action의 물리적 결과에는 충실하지 않을 수 있다. 이 약한 action 조건화 탓에 정밀 closed-loop 제어에서 유용성이 줄어든다. WorldVLA의 암묵적 통합 학습 전략이 완화 시도로 언급된다.
- Efficiency bottlenecks (8.2). world model 기반 policy는 VLA보다 학습과 추론 모두 훨씬 무겁다. 미래 비디오와 action을 함께 예측하거나 policy 학습 전에 fine-tuning이 필요해서 적응 비용이 크고, diffusion 기반 비디오 예측의 반복 denoising이 추론 지연을 키운다. 대응은 세 가지다. 경량 어댑터로 기반 모델을 대체로 동결하는 파라미터 효율 전략, MimicVideo와 LingBot-VA처럼 세밀한 시각 디테일보다 모션 동역학을 우선하는 부분 denoising, LeWorldModel처럼 latent 공간으로 옮겨 고차원 생성을 피하는 방식이다. 더 나아가 Fast-WAM은 world modeling을 학습 단계에만 쓰고 배포 시점에서 제거한다.
- Multi-modal perception bottlenecks (8.3). 현재 world model은 시각 합성에는 뛰어나지만 실세계 상호작용의 물리 동역학과는 분리돼 있다. 시각과 proprioception에 치우쳐 마찰과 강성, 접촉 안정성처럼 직접 관찰되지 않는 속성을 잡지 못한다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이다. 촉각 센서는 고주파 순간 사건을 잡지만 저차원 신호라 joint latent 최적화에서 고차원 시각 특징에 희석되거나 압도되기 쉽다. 주파수와 차원이 다른 비동기 신호를 정렬하고 시각 지배를 막는 것이 구조적 과제다.
- Classical control integration (8.4). MPC는 action 최적화를 위해 world model rollout을 반복해야 해서 고용량 모델의 실시간 배치를 심하게 제약한다. 더 근본적으로는 학습된 동역학의 신경망 표현력과 Lyapunov 안정성이나 robust control 같은 형식적 제어 보증을 어떻게 양립시킬지가 남는다. MPC에 국한하지 않고 성숙한 제어 원리와 학습된 동역학을 융합하는 것이 자기적응형 로봇 시스템으로 가는 경로로 제시된다.
- Symbolic structure integration (8.5). 픽셀 기반 rollout에서 long-horizon으로 갈수록 커지는 compounding error는 계획 신뢰성을 떨어뜨리는데, 심볼릭 표현은 저수준 세부를 추상화하고 이산적이거나 규칙 기반인 전이를 모델링해 이를 완화한다. 다만 적절한 추상화와 perceptual grounding이 필요하고, 고차원 observation이 사전 정의된 심볼로 깔끔히 매핑되지 않으면 동작하지 않는다. 학습된 지각 표현과 심볼 구조를 결합한 하이브리드가 유망한 방향으로 꼽힌다.
- Evaluation metrics (8.6). 널리 합의된 평가 지표가 없다. 시각적으로 그럴듯해도 action 조건부 동역학과 인과 일관성, controllability를 못 지키는 모델이 있고, 반대로 시각적 사실성이 낮아도 계획이나 policy 평가에 유용할 수 있다. 저자들은 과제 성공률과 policy 순위 충실도, 실행 가능성 진단 같은 소수 표준 지표 집합을 세워 그럴듯하기만 한 모델과 실제로 실행 가능한 모델을 구분하자고 제안한다.
이 여섯 가지에 더해 서베이 자체의 한계도 읽을 때 감안해야 한다. 실험이 없는 taxonomy 서베이라 Table 5와 Table 6의 수치는 모두 원논문이 직접 보고한 값의 취합이고 동일 조건 재현이 아니다. 저자들도 프로토콜이 서로 달라 엄밀한 순위 비교에는 부적합하다고 명시한다. 또한 인용 문헌 상당수가 2026년 arXiv 프리프린트여서 동료 심사를 거치지 않은 결과가 많다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| action-conditioned world model | action으로 조건화된 world model. 보기에는 그럴듯해도 action과 어긋난 미래는 closed-loop 의사결정에 가치가 제한적이라서, 저자들이 embodied 제어에서 가장 중요하다고 지목한 부류 |
| passive / controllable world model | action에 대해 주변화한 예측기와 action으로 조건화한 예측기. 같은 결합 분포의 서로 다른 질의다 |
| MoT (Mixture-of-Transformers) | 모달리티별 expert를 유지한 채 shared attention으로 결합하는 희소 아키텍처. 비디오와 action의 시간 주파수 차이를 흡수한다 |
| JEPA | 픽셀이 아니라 임베딩 공간에서 예측하는 joint-embedding predictive architecture. Latent-space world modeling 계열의 개념적 뿌리 |
| co-evolution | policy rollout이 world model을 다듬고 개선된 world model이 더 나은 상상 데이터를 내는 왕복 갱신. 식 (19) |
| VGM / UMM / MLLM | Table 1의 backbone 계열 구분. 비디오 생성 모델, 통합 multimodal 모델, multimodal 대형 언어 모델 |
관련 페이지
- A Comprehensive Survey on World Models for Embodied AI: 같은 world model을 embodied AI 전반에서 다룬 자매 서베이. 이 페이지가 로봇 policy와의 결합 방식을 아키텍처 기준으로 5분류하는 반면, 저쪽은 embodied AI 응용 전반으로 범위를 넓혀 정리한다.
- Generative Physical AI in Vision: A Survey: 같은 논의를 로봇 policy가 아니라 영상과 3D 생성 쪽에서 다룬 서베이. 학습된 시뮬레이터 역할을 physics-aware generation이라는 이름으로 정리하고, 명시적 물리 엔진을 결합하는 여섯 가지 배선을 구분한다.
- Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models: world model을 로봇 학습이 아니라 내비게이션 관점에서 다룬 서베이. policy 결합 5분류의 자리에 history/memory와 generalization ability라는 두 challenge가 들어선다.
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: 이 서베이가 Unified VLA로 분류한 GR-1의 원논문. 미래 프레임 예측과 action 예측을 하나의 backbone에서 같은 토큰 시퀀스로 처리하는 방식을 논문 하나로 확인할 수 있다.
- 03-14. Groot N1.5 - 모두의 로보틱스 - VLA 입문: 이 서베이가 Latent-space world modeling으로 분류한 FLARE와 imagination-based로 분류한 DreamGen이 실제로 한 모델(GR00T N1.5) 안에서 함께 쓰인 사례.
- RT-1: Robotics Transformer for Real-World Control at Scale: 예측 구조 없이 observation에서 action으로 곧장 가는 반응형 policy의 출발점. 이 서베이가 진단하는 long-horizon 약점의 기준선에 해당한다.
- VLM3: Vision Language Models Are Native 3D Learners: 표준 VLM이 구조 변경 없이 metric depth와 camera pose 같은 3D 양을 숫자 텍스트로 예측하도록 학습한 논문. 미래 상태를 예측하는 world model은 아니지만, 이런 3D 이해 능력은 world model이 물리 세계에 grounding할 때의 바탕이 된다.
외부 참조
- arXiv: https://arxiv.org/abs/2605.00080
- GitHub (지속 갱신): https://github.com/NTUMARS/Awesome-World-Model-for-Robotics-Policy
- 프로젝트 페이지: https://ntumars.github.io/wm-robot-survey/
- 선행 서베이: Zhang et al., A step toward world models: A survey on robotic manipulation, arXiv:2511.02097 (2025). wiki 미수록