LLMs · PAPER · 2023
Finite Scalar Quantization: VQ-VAE Made Simple
요약
FSQ(finite scalar quantization)는 VQ-VAE의 latent에 쓰이는 벡터 양자화(vector quantization, VQ)를 스칼라 양자화로 바꾼 방식이다. 인코더의 마지막 층이 표현을 보통 10 미만의 소수 차원 d로 투영하면, 각 차원을 tanh 같은 bounding 함수로 제한한 뒤 정수로 반올림한다. 차원마다 가질 수 있는 값이 L개이므로 반올림 결과는 L^d개의 격자점 중 하나가 되고, 이 격자점의 집합이 별도 파라미터 없이 정의되는 암묵적 codebook이다. 예를 들어 d = 3, L = 3이면 codebook은 3^3 = 27개 정수 벡터로 이뤄진다.
논문의 핵심 주장은 이 단순한 교체만으로 VQ를 그대로 대체(drop-in replacement)할 수 있다는 것이다. FSQ는 commitment 손실, codebook 재초기화, codebook splitting, entropy 페널티 같은 VQ의 보조 장치를 하나도 쓰지 않는다. 그런데도 codebook 사용률이 대부분의 모델에서 약 100%이고, 이미지 생성(MaskGIT)과 dense prediction(UViM의 depth estimation, colorization, panoptic segmentation)에서 VQ 대비 0.5~3%의 지표 하락만으로 매우 비슷한 결과를 낸다. 저자들은 큰 codebook에서 VQ가 최적화 난점 때문에 오히려 FSQ보다 나쁘다는 점도 보였다.
논문이 내세우는 기여는 세 가지이고, 각각 다른 실험이 뒷받침한다.
| 기여 | 내용 | 근거 실험 |
|---|---|---|
| drop-in replacement 검증 | MaskGIT와 UViM에서 양자화기만 FSQ로 바꿔 각 지표에서 0.5~3% 하락으로 매우 비슷한 시각 결과를 얻는다 | MaskGIT ImageNet 256, UViM 세 과제 |
| VQ 대 FSQ 트레이드오프 분석 | codebook 크기에 따른 scaling 거동과 압축 관점의 표현 복잡도를 특성화한다. FSQ는 큰 codebook을 활용해 재구성과 샘플 품질을 함께 높이고 사용률이 약 100%다 | 128×128 ImageNet codebook sweep |
| VQ 일반성의 실익 검증 | VQ 정식화의 완전한 일반성은 FSQ 대비 이득이 거의 없고 큰 codebook에서는 오히려 나쁘다. FSQ는 인코더 출력을 bound하고 codebook C를 고정한 VQ로 볼 수 있다 | 트레이드오프 연구의 사용률과 FID 곡선 |
이 페이지는 논문의 전개 순서를 따라 VQ의 문제, FSQ의 정식화와 구현, 하이퍼파라미터 규칙, 그리고 트레이드오프 연구와 MaskGIT, UViM 실험을 표로 정리한다. 논문의 Table 1과 Table 2는 이미지 대신 마크다운 표로 옮겼다.
배경
VQ-VAE와 이산 표현의 쓰임
VQ는 Gray(1984)가 도입한 고전 기법으로, 신경망으로 이산 표현을 학습하는 문맥에서 다시 주목받았다. VQ-VAE(Van Den Oord et al., 2017)의 성공 이후 Esser et al.(2020)과 Villegas et al.(2022)은 GAN 손실로 학습한 VQ-VAE의 표현 위에 autoregressive Transformer를 올려 강력한 이미지 생성과 비디오 생성 모델을 만들었다. 같은 시기에 VQ는 이미지(BEiT, MAGE)와 오디오(vq-wav2vec) 표현 학습의 구성 요소가 됐고, 저자들은 차세대 multimodal LLM(CM3, MAGVLT 등)의 유망한 구성 요소로 소개한다.
VQ-VAE의 목표는 입력 데이터의 압축된 의미 표현을 유도하는 codebook C를 학습하는 것이다. 순전파에서 이미지 x는 표현 z(보통 특징 벡터의 열)로 인코딩되고, z의 각 벡터는 C에서 가장 가까운 벡터로 교체된다. 이 교체 연산이 곧 양자화다.
VQ 정식화의 최적화 난점
VQ의 양자화 연산은 미분이 불가능하다. Van Den Oord et al.은 STE(straight-through estimator, Bengio et al., 2013)로 디코더 입력의 그래디언트를 인코더 출력에 그대로 복사해 인코더를 학습시킨다. 그러나 STE는 codebook 벡터 자체에는 그래디언트를 주지 못한다. 그래서 codeword 벡터를 양자화 전 표현 쪽으로 끌어당기고 그 반대 방향으로도 당기는 보조 손실 두 개를 추가한다.
이 정식화는 최적화가 어렵고, codebook 크기를 키울수록 많은 codeword가 쓰이지 않는 codebook 미활용 문제로 이어진다. 후속 연구들은 이를 여러 장치로 보완해 왔다.
| 보완 장치 | 대표 연구 | 내용 |
|---|---|---|
| commitment 손실과 codebook EMA | Van Den Oord et al. (2017) | 원 정식화에 포함된 보조 손실과 지수이동평균 갱신 |
| soft EM | Roy et al. (2018) | 기대값 최대화로 VQ-VAE 학습 |
| random restart | Dhariwal et al. (2020) | 사용률이 낮아진 벡터를 인코더 출력으로 되돌린다 |
| 주기적 재초기화 | Łańcucki et al. (2020) | 오프라인 clustering으로 codebook을 다시 만든다 |
| l2 정규화와 저차원 lookup | Yu et al. (2021) | ViT 기반 VQ-GAN에서 벡터를 정규화하고 lookup 공간을 낮춘다 |
| stochastic 양자화 | Takida et al. (2022), Williams et al. (2020) | 인코더 출력에 가우시안 노이즈를 더해 양자화를 흉내 내고 annealing한다 |
| 재파라미터화와 교대 최적화 | Huh et al. (2023) | vanilla VQ의 학습 난점을 분석하고 개선된 commitment 손실을 제안한다 |
| codebook splitting | Linde et al. (1980), UViM | 쓰이지 않는 벡터를 가장 자주 쓰이는 임베딩을 둘로 쪼개 대체한다 |
저자들이 원 정식화를 단순화하며 세운 목표는 세 가지다. 보조 손실을 없애고, 설계 자체로 높은 codebook 사용률을 얻고, 기능적 설정을 그대로 두어 VQ의 drop-in replacement가 되게 하는 것이다.
압축 문헌의 스칼라 양자화
FSQ의 착안점은 신경망 압축(neural compression) 문헌이다. Ballé et al.(2016)과 Theis et al.(2017) 이후 이 분야는 표현 z의 스칼라 성분 각각을 독립적으로 가장 가까운 정수로 반올림해 이산 코드를 얻는다. 현재 압축 문헌 대부분은 정수 범위를 인코더가 제한하지 않고 표현의 entropy만 제약하는 unbounded 스칼라 양자화를 쓴다. 일부 연구는 양자화기의 범위를 bound했는데, Mentzer et al.(2018)은 d = 16, L = 5로 고화질 이미지를 표현했고 Tschannen et al.(2018)과 Agustsson et al.(2019)은 d = 5, L = 5로 극한 압축을 다뤘다.
두 분야의 목표는 반대 방향이다. 신경망 이미지 압축은 대체로 high bitrate 재구성을 목표로 하므로 복잡한 표현의 entropy를 줄이는 것이 과제다. 반면 VQ-VAE 표현 학습은 강하게 제약된 표현의 entropy를 높여 최대한 활용하는 것이 목표다. 저자들은 bounded 스칼라 양자화, 즉 FSQ가 압축 이외의 vision 과제에 쓰인 적이 없다고 보고, 강력한 Transformer와 결합해 FSQ를 재조명한다.
| 항목 | 신경망 이미지 압축 | VQ-VAE 표현 학습 |
|---|---|---|
| 양자화 방식 | 대체로 unbounded 스칼라 양자화 | 벡터 양자화 |
| 목표 | high bitrate 재구성 | 강하게 제약된 이산 표현 위의 생성과 예측 |
| entropy에 대한 목표 | 복잡한 표현의 entropy를 줄인다 | 제약된 표현의 entropy를 높여 최대한 활용한다 |
| bounded 양자화 선례 | Mentzer et al. 2018 (d = 16, L = 5), Tschannen et al. 2018과 Agustsson et al. 2019 (d = 5, L = 5) | 저자들이 아는 한 이 논문 이전에는 없음 |
VQ 대안과의 관계
VQ의 문제를 codebook 구조를 바꿔 다루는 연구도 있다. FSQ는 이들과 달리 학습되는 codebook 자체를 없앤다는 점에서 구분된다.
| 계열 | 대표 연구 | 내용 | FSQ와의 차이 |
|---|---|---|---|
| residual quantization (RVQ) | Lee et al. (2022) 이미지, Zeghidour et al. (2021) 오디오 | 양자화 잔차를 추가로 저장해 코드를 정제한다 | codebook을 여러 단계로 학습한다 |
| product quantization (PQ) | Chen et al. (2020), El-Nouby et al. (2022) | codebook을 작은 codebook들의 곱으로 분해한다 | 곱 구조는 비슷하지만 부분 codebook을 학습한다 |
| 토큰 수 절감 | Huang et al. (2023) | VQ-VAE가 내는 토큰 수를 줄여 추론을 효율화한다 | 양자화 방식이 아니라 토큰 수를 다룬다 |
| 오디오의 FSQ | Donahue et al. (2019), Dieleman et al. (2021) | 인코더가 bounded 표현을 내도록 margin 손실을 쓴다 | 이 논문은 tanh 기반 bounding 함수로 별도 손실 없이 bound한다 |
| 채널별 codebook | Hsu et al. (2023) | 채널마다 codebook을 두어 학습된 격자를 만든다 | 격자가 고정이며 vanilla VQ 손실을 쓰지 않는다 |
핵심 개념
codebook은 이산 표현이 고를 수 있는 코드의 집합이다. VQ에서는 크기 |C| × d의 학습 파라미터이고, FSQ에서는 채널별 값 집합의 곱집합으로 정의되는 격자라 파라미터가 없다. 이 문서에서 codebook 크기 |C|는 표현이 저장할 수 있는 최대 정보량을 뜻하며, 2^10이면 10비트다.
암묵적 codebook은 FSQ에서 채널별 레벨 집합의 곱집합으로 자동 정의되는 codebook이다. 명시적으로 저장하지 않아도 각 격자점을 정수 하나로 번호 매길 수 있으므로, Transformer 입장에서는 VQ의 codebook 인덱스와 똑같은 정수 토큰 열이 된다.
Voronoi 분할은 공간의 각 점을 가장 가까운 대표점에 배정해 얻는 분할이다. VQ는 codebook 벡터를 대표점으로 삼는 학습 가능한 Voronoi 분할이고, FSQ는 대표점이 고정된 격자점인 특수한 경우다.
codebook 사용률은 검증 집합을 인코딩할 때 한 번 이상 쓰인 codeword의 비율이다. codebook이 커질수록 다수의 codeword가 쓰이지 않는 현상을 codebook collapse 또는 codebook 미활용이라 부르며, VQ의 잘 알려진 문제다.
STE는 미분 불가능한 반올림이나 최근접 탐색의 그래디언트를 1로 대체해 통과시키는 기법이다. VQ와 FSQ 모두 STE로 인코더에 그래디언트를 전달한다.
compression cost는 표현 밑에 깔린 이산 분포를 Transformer가 모델링하기 얼마나 어려운지 재는 대리 지표다. 이산 코드의 분포를 예측하는 Transformer는 entropy coding과 결합하면 표현을 무손실 압축할 수 있으므로, 그 비트 수가 모델링 복잡도를 나타낸다.
classifier-free guidance(CFG)는 클래스 조건부 logit과 무조건부 logit을 보간해 생성 분포를 조절하는 기법이다. diffusion 문헌에서 왔으며 이 논문은 MaskGIT에 적용해 precision과 recall의 균형을 조정한다.
방법
설계 목표
| 목표 | 내용 | FSQ의 대응 |
|---|---|---|
| i) 보조 손실 제거 | commitment 손실, codebook 손실, entropy 손실 없이 학습한다 | 재구성 손실만으로 학습한다 |
| ii) 설계에 의한 높은 codebook 사용률 | 재초기화나 splitting 없이 사용률이 높게 나오도록 만든다 | STE를 통과한 재구성 그래디언트가 정보를 여러 bin에 퍼뜨린다 |
| iii) 기능적 설정 유지 | VQ의 drop-in replacement가 되도록 입출력 인터페이스를 그대로 둔다 | 격자점을 정수로 열거해 VQ 인덱스와 같은 토큰 열을 낸다 |
FSQ 정식화
FSQ는 d차원 표현 z ∈ R^d를 유한한 codeword 집합으로 양자화한다. 먼저 bounding 함수 f를 적용하고 정수로 반올림한다. f는 ẑ = round(f(z))의 각 채널이 L개 값 중 하나를 갖도록 고르며, 기본형은 f: z ↦ ⌊L/2⌋ tanh(z)다. 따라서 ẑ는 채널별 codebook 집합의 곱집합인 암묵적 codebook C에 속하고 |C| = L^d다. i번째 채널을 L_i개 값으로 보내는 일반형은 |C| = ∏ L_i다.
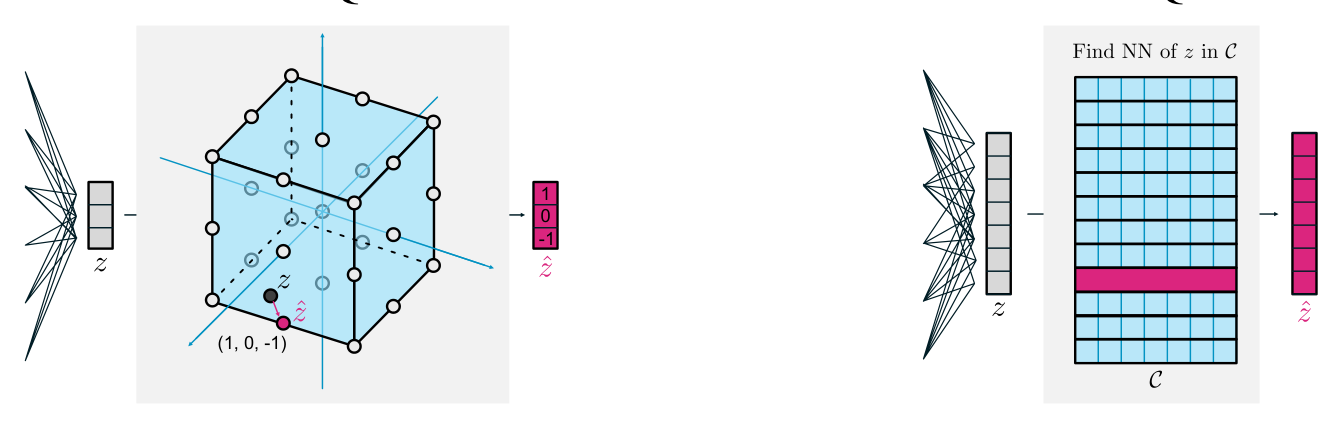
Figure 1의 예는 d = 3, L = 3이다. codebook은 C = {(−1, −1, −1), (−1, −1, 0), (−1, −1, 1), ..., (1, 1, 1)}이고 |C| = 27이다. 그림에서 인코더 출력 z는 정육면체 안의 한 점이고, 양자화 결과 ẑ = (1, 0, −1)은 그 점에서 가장 가까운 격자점이다. C의 벡터를 열거하면 임의의 ẑ를 {1, ..., L^d}의 정수 하나로 보내는 전단사가 생기므로, VQ 앞뒤 층의 출력과 입력 차원만 맞추면 Transformer 학습 같은 어떤 설정에서도 VQ를 FSQ로 바꿀 수 있다.
반올림의 그래디언트는 VQ-VAE처럼 STE로 통과시키며 그래디언트를 1로 대체한다. ML 프레임워크에서는 stop gradient(sg) 연산 한 줄로 round_ste: x ↦ x + sg(round(x) − x)처럼 구현한다. 재구성 손실로 학습하는 autoencoder 안에 FSQ를 두면 재구성 손실을 줄이는 방향의 그래디언트가 인코더에 전달되어 정보를 여러 양자화 bin에 퍼뜨리도록 강제한다. 즉 인코더가 모든 codeword를 쓰는 편이 손실이 낮으므로, 보조 손실 없이도 모든 codeword를 쓰는 양자화기가 된다.
FSQ가 동작하는 직관
VQ는 VQ-VAE의 고차원 latent 공간에 학습 가능한 Voronoi 분할을 정의한다. 이 분할은 입력 공간(이미지)의 복잡한 비선형 분할로 이어진다. 반면 FSQ는 훨씬 낮은 차원의 공간에서 단순하고 고정된 격자 분할에 의존한다.
저자들은 이것이 가능한 이유를 VAE의 모델 용량에서 찾는다. 일반적인 응용에서 VAE의 용량이 비교적 크기 때문에 VQ의 비선형성이 인코더와 디코더에 흡수될 수 있고, 따라서 FSQ의 단순한 격자로도 VQ와 비슷한 복잡도의 입력 공간 분할이 가능하다. 즉 분할의 복잡도를 양자화기가 아니라 인코더와 디코더가 담당한다.
VQ와 FSQ의 구성 비교
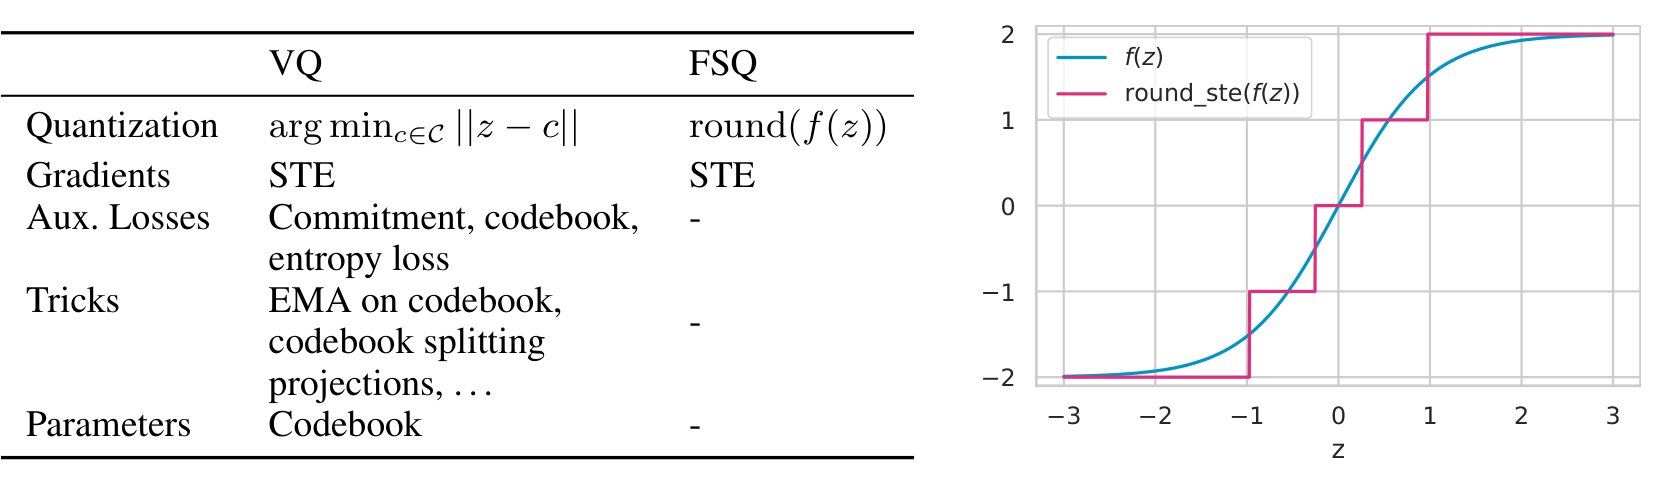
| 항목 | VQ | FSQ |
|---|---|---|
| 양자화 | arg min_{c ∈ C} ‖z − c‖ (최근접 탐색) | round(f(z)) (bound 후 반올림) |
| 그래디언트 | STE | STE |
| 보조 손실 | commitment 손실, codebook 손실, entropy 손실 | 없음 |
| 보조 장치 | codebook EMA, codebook splitting, projection 등 | 없음 |
| 파라미터 | codebook ( | C |
| latent 차원 d | 보통 512 이상 | 보통 10 미만 |
Figure 2 오른쪽은 L = 5인 채널 하나의 거동이다. f(z)는 z를 [−2, 2] 범위의 S자 곡선으로 압축하고, round_ste(f(z))는 그 곡선을 −2, −1, 0, 1, 2 다섯 계단으로 바꾼다. 순전파는 계단을 따르고 역전파는 곡선의 그래디언트 대신 1을 그대로 통과시킨다.
bounding 함수의 구현
양자화가 정수 반올림으로 수행되므로 L이 짝수인 채널은 대칭인 tanh만으로는 L개 값을 만들 수 없고 비대칭 f가 필요하다. 부록 A.1의 Jax 구현은 이를 offset과 shift로 처리한다.
| 단계 | 구현 | 역할 |
|---|---|---|
| half_l | (L − 1) × (1 − eps) / 2, eps = 1e-3 | tanh 출력의 반폭. eps는 경계값이 정확히 반올림 경계에 걸리지 않게 한다 |
| offset | L이 홀수면 0.0, 짝수면 0.5 | 짝수 L에서 격자를 반 칸 밀어 정수 L개가 나오게 한다 |
| shift | tan(offset / half_l) | offset을 상쇄해 z = 0이 격자 중앙에 오게 한다 |
| bound(z) | tanh(z + shift) × half_l − offset | 채널별 범위 제한 |
| quantize(z) | round_ste(bound(z)) / (L // 2) | 반올림 뒤 [−1, 1]로 재정규화 |
| codes_to_indexes | scale-and-shift한 코드와 basis [1, cumprod(L[:-1])]의 내적 | 코드를 정수 인덱스로 변환 |
| indexes_to_codes | 인덱스를 basis로 나눈 몫을 L로 나눈 나머지 | 인덱스를 채널별 코드로 복원 |
부록 코드의 수식을 L에 대입하면 홀수와 짝수 채널의 차이가 드러난다. 다음 값은 위 표의 식으로 계산한 것이다.
| L | half_l | offset | shift | bound(z)의 범위 | 반올림 결과 |
|---|---|---|---|---|---|
| 5 (홀수) | 1.998 | 0 | 0 | (−1.998, 1.998) | {−2, −1, 0, 1, 2} |
| 4 (짝수) | 1.4985 | 0.5 | 약 0.347 | (−1.9985, 0.9985) | {−2, −1, 0, 1} |
| 8 (짝수) | 3.4965 | 0.5 | 약 0.144 | (−3.9965, 2.9965) | {−4, −3, −2, −1, 0, 1, 2, 3} |
홀수 L에서는 tanh의 대칭 범위를 그대로 반올림하면 0을 중심으로 L개 정수가 나온다. 짝수 L에서는 범위를 0.5만큼 아래로 밀어야 정수가 L개가 되고, shift는 밀린 만큼을 입력 쪽에서 되돌려 z = 0 근처가 격자 중앙 부근에 오게 한다. eps = 1e-3은 tanh의 극한값이 정확히 반올림 경계에 놓이지 않도록 범위를 아주 조금 좁힌다.
FSQ 클래스는 생성 시 codebook_size = ∏ L_i를 계산하고 indexes_to_codes(arange(codebook_size))로 암묵적 codebook 전체를 열거해 둔다. 이 열거가 Transformer의 어휘와 FSQ 코드 사이의 사상 역할을 한다.
MaskGIT 설정 L = [8, 5, 5, 5]를 예로 들면 basis는 [1, 8, 40, 200]이다. 0부터 시작하는 채널별 코드 (a, b, c, d)의 인덱스는 a + 8b + 40c + 200d이고, 최대 인덱스는 7 + 32 + 160 + 800 = 999다. 즉 1,000개 격자점이 0부터 999까지의 정수와 일대일로 대응하며, 이 정수가 Stage II Transformer가 예측하는 토큰이다.
하이퍼파라미터와 레벨 선택
FSQ의 하이퍼파라미터는 채널 수 d와 채널별 레벨 수 L = [L_1, ..., L_d]뿐이다. 대부분의 실험에서는 공정한 비교를 위해 대체하려는 VQ codebook 크기를 목표 |C|로 삼았다. 다만 ∏ L_i ≈ |C|를 만족하는 (d, L_i) 조합은 여럿이고 모든 선택이 최적은 아니다. 저자들이 찾은 단순 규칙은 모든 채널에서 L_i ≥ 5를 쓰는 것이며, 이 규칙이 고려한 모든 과제에서 잘 동작했다.
| 목표 크기 |C| | 2^8 | 2^10 | 2^12 | 2^14 | 2^16 |
|---|---|---|---|---|---|
| 권장 L (Table 1) | [8, 6, 5] | [8, 5, 5, 5] | [7, 5, 5, 5, 5] | [8, 8, 8, 6, 5] | [8, 8, 8, 5, 5, 5] |
| 채널 수 d | 3 | 4 | 5 | 5 | 6 |
| ∏ L_i | 240 | 1,000 | 4,375 | 15,360 | 64,000 |
부록 A.4.1은 128×128 ImageNet MaskGIT에서 여러 L 구성을 탐색한 결과를 Figure 10으로 보이고, 2^4부터 2^16까지 확장한 권장표를 덧붙인다.
| 크기 | 2^4 | 2^6 | 2^8 | 2^9 | 2^10 | 2^11 | 2^12 | 2^14 | 2^16 |
|---|---|---|---|---|---|---|---|---|---|
| 권장 L (부록 표기 그대로) | [5, 3] | [8, 8] | [8, 6, 5] | [8, 8, 8] | [8, 5, 5, 5] | [8, 8, 6, 5] | [7, 5, 5, 5] | [8, 8, 8, 6, 5] | [8, 8, 8, 5, 5, 5] |
| ∏ L_i | 15 | 64 | 240 | 512 | 1,000 | 1,920 | 875 | 15,360 | 64,000 |
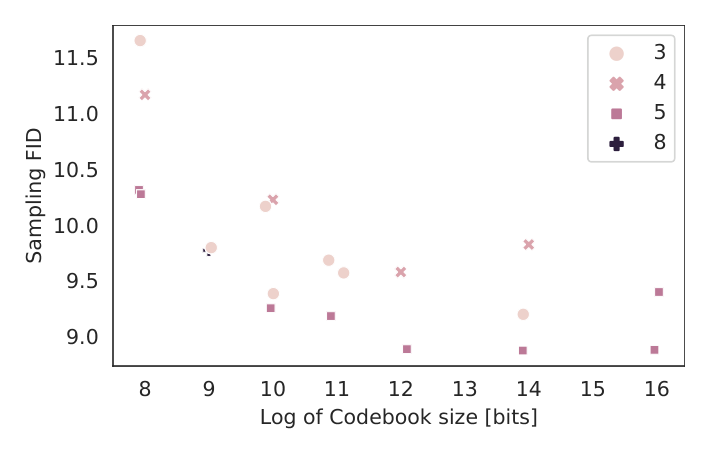
Figure 10에서 같은 codebook 크기 안에서는 최소 L_i가 5인 구성(네모 마커)이 최소 L_i가 3이나 4인 구성보다 낮은 Sampling FID를 낸다. 예를 들어 10비트 부근에서 최소 L_i가 5인 모델은 약 9.3인데 3이나 4인 모델은 약 10.2다. 이 결과가 L_i ≥ 5 규칙의 근거다. 부록 표의 2^12 항목은 곱이 875라 2^12에 맞지 않는데, 이 불일치는 한계 절에 따로 적는다.
파라미터 수 비교
VQ는 크기 |C| × d의 codebook을 학습한다. 흔한 설정인 |C| = 2^12 = 4096, d = 512면 codebook만 200만 파라미터다. FSQ에는 이 파라미터가 없다. 또한 FSQ의 d가 VQ보다 훨씬 작으므로(같은 |C|에서 FSQ는 d = 5) 마지막 인코더 층의 파라미터도 적다.
| 항목 | VQ (|C| = 4096, d = 512) | FSQ (|C| = 4375, d = 5) | |---|---|---| | codebook 파라미터 | 약 200만 | 0 | | 마지막 인코더 층 출력 차원 | 512 | 5 | | 보상 시도 | 해당 없음 | 인코더 끝과 디코더 시작에 dense 층 추가, 추가 이득 없음 |
저자들은 줄어든 파라미터를 보상하려고 VAE 인코더 끝과 디코더 시작에 dense 층을 더 두어 봤지만 추가 이득이 없었다. 따라서 이 논문의 모든 모델에서 같은 codebook 크기의 FSQ가 VQ보다 파라미터가 적다.
적용 대상 모델
FSQ를 검증하는 두 모델 계열은 설계가 크게 다르다. autoencoder가 convolutional인지 Transformer 기반인지, 생성 Transformer가 masked인지 완전 autoregressive인지, decoder-only인지 encoder-decoder인지가 모두 다르다. 그런데도 양자화기만 바꾸는 방식이 양쪽에서 통했다는 점이 drop-in replacement 주장의 근거다.
| 항목 | MaskGIT (Chang et al., 2022) | UViM (Kolesnikov et al., 2022) |
|---|---|---|
| 과제 | 클래스 조건부 이미지 생성 | depth estimation, colorization, panoptic segmentation |
| Stage I | convolutional VQ-GAN autoencoder(Esser et al., 2020)를 재구성 목적으로 학습한 뒤 고정 | Transformer 기반 VQ-VAE가 목표 과제의 레이블 공간을 모델링 |
| side information | 없음 | 인코더와 디코더가 과제 입력(RGB 또는 grayscale 이미지)을 context로 받을 수 있음 |
| Stage II | BERT 방식 masked Transformer가 양자화 표현을 예측 | encoder-decoder Transformer가 과제 입력을 받아 양자화 토큰으로 dense 레이블을 예측 |
| 추론 | MASK 토큰과 클래스 토큰으로 시작해 확신도 높은 위치부터 토큰을 채우는 과정을 반복 | 입력에 조건화해 코드를 autoregressive하게 샘플링한 뒤 VQ-VAE 디코더에 입력 |
| 가중치 공유 | 해당 없음 | 세 과제가 아키텍처를 공유하되 가중치는 과제별로 학습 |
MaskGIT의 Stage II는 표현 ẑ의 토큰 일부를 무작위로 MASK 토큰으로 바꾼 ẑ_M을 클래스 토큰과 함께 Transformer에 넣고, masked 토큰마다 분포를 예측하도록 학습한다. 추론은 다음 단계를 반복한다.
| 단계 | 처리 |
|---|---|
| 초기화 | MASK 토큰만으로 채운 입력과 클래스 토큰을 Transformer에 넣는다 |
| 선택과 샘플링 | 예측 확신도에 따라 일부 위치를 고르고 그 위치의 토큰을 샘플링한다 |
| 교체와 반복 | 샘플링한 토큰으로 입력의 MASK를 교체하고 모델을 다시 실행하며, 모든 토큰이 드러날 때까지 반복한다 |
이 논문은 추론에 cosine 스케줄로 12 스텝을 쓴다. 양자화기가 FSQ로 바뀌어도 이 절차는 그대로이며, 토큰 어휘가 VQ의 codebook 인덱스에서 FSQ의 격자점 인덱스로 바뀔 뿐이다.
실험 설정
| 실험 | 데이터 | Stage I | Stage II | VQ 설정 | FSQ 설정 |
|---|---|---|---|---|---|
| 트레이드오프 연구 | 128×128 ImageNet, MaskGIT | 100 epoch, 약 50만 스텝, 배치 256 | 200 epoch, 약 100만 스텝, 배치 256 | MaskGIT의 entropy 손실(가중치 0.1), codebook 크기만 sweep | 목표 크기에 맞춰 d와 L_i를 여러 가지로 탐색 |
| MaskGIT | ImageNet 256, 공개 GitHub 코드 | 100만 스텝, 배치 512 (원 설정은 200만 스텝, 배치 256) | 250만 스텝, 배치 256 | codebook 1024(10비트) + entropy 손실 (공개 모델과 동일) | L = [8, 5, 5, 5] |
| UViM | 세 과제, 공개 GitHub 코드 | 과제별 VQ-VAE | 과제별 Transformer를 3회 학습해 평균 | codeword 4096(12비트) + codebook splitting (공개 결과와 동일) | L = [7, 5, 5, 5, 5] |
트레이드오프 연구는 논문 원 설정보다 낮은 해상도와 짧은 학습으로 codebook 크기와 하이퍼파라미터를 sweep하기 위한 것이다. MaskGIT 추론은 cosine 스케줄로 12 스텝을 써서 이미지 한 장을 샘플링하며, 나머지 하이퍼파라미터는 MaskGIT GitHub의 vqgan_config.py와 maskgit_class_cond_config.py를 그대로 따른다.
평가 지표
| 지표 | 정의 | 비고 |
|---|---|---|
| Reconstruction FID | GAN 손실로 학습한 autoencoder에 검증 이미지 5만 장을 통과시켜 얻은 FID | Stage II Transformer가 데이터를 완벽히 모델링했을 때 도달할 수 있는 FID. ADM TensorFlow Suite로 5만 장 재구성을 학습 집합과 비교 |
| Codebook Usage | 검증 집합을 인코딩할 때 한 번 이상 쓰인 codeword의 비율 | |
| Sampling FID | Stage II Transformer로 클래스 조건부 샘플링한 표현을 디코딩해 얻은 FID | |
| Compression Cost | Transformer 출력과 entropy coding으로 표현을 무손실 압축했을 때의 비트 수 | masked Transformer는 결정적 masking 스케줄만 있으면 되며 M2T(Mentzer et al., 2023)의 스케줄을 쓴다 |
| Precision / Recall | Sajjadi et al.(2018)의 정의 | precision은 샘플의 품질, recall은 샘플이 실제 분포를 덮는 비율 |
PQ, RMSE, FID-5k |
UViM 논문을 따라 panoptic segmentation은 panoptic quality, depth estimation은 RMSE, colorization은 FID-5k |
UViM GitHub의 평가 suite 사용 |
평가 도구 차이는 절대값에 영향을 준다. ADM TensorFlow Suite로 MaskGIT GitHub의 공식 체크포인트를 평가하면 ADM-FID-train이 4.916으로, MaskGIT 논문이 보고한 6.19와 다르다. 그래서 논문은 비교 대상 모델을 모두 같은 suite로 다시 평가했다.
classifier-free guidance 도입
초기 실험에서 FSQ는 VQ와 다른 Precision과 Recall 지점에 놓였다. FSQ가 recall은 높고 precision은 낮았다. 저자들은 diffusion 문헌의 CFG(Ho & Salimans, 2022)를 MaskGIT에 추가해 이 균형을 조정했다.
| 단계 | 처리 |
|---|---|
| 학습 | 클래스 레이블의 10%를 MASK 토큰으로 바꿔 모델이 무조건부 분포도 배우게 한다 |
| 추론 | 클래스 c에 조건화한 logit l_c와 무조건부 logit l_∅로 l' = l_c + α(l_c − l_∅)를 계산한다 |
| 효과 | α가 CFG 추론 weight이며, 예측 분포를 무조건부 분포에서 멀어지는 방향으로 당긴다 |
저자들은 이 기법이 masked Transformer 맥락에서 Chang et al.(2023, Muse)의 2.7절 등에서 이미 탐구된 것임을 명시한다. 따라서 CFG 자체는 이 논문의 기여가 아니라 FSQ와 VQ를 같은 조건에서 비교하기 위한 도구다.
masking 비율 하한
MaskGIT는 학습 중 비율 r ~ U[0, 1]을 뽑고 N_M = ⌈cos(π/2 × (1 − r)) × S⌉개 토큰을 무작위로 마스킹한다. S는 시퀀스 길이로 ImageNet 256 모델에서는 16^2 = 256이다. 공개 코드로 초기 실험을 하자 Stage II Transformer 손실에 약간의 불안정이 나타났다.
저자들은 N_M = 1처럼 토큰 하나만 마스킹되어 손실이 예측 하나에서만 나오는 스텝이 원인일 것으로 보았다. 그래서 r을 r_min = 1 − arccos(0.45) × 2/π로 하한을 두어 모든 학습 스텝에서 N_M > 0.45 S가 되게 했다. 0.45 대신 다른 값도 시험한 결과 0.2를 넘는 값은 모두 안정화에 도움이 됐고, 논문 전체에서는 0.45를 썼다. 이 하한은 트레이드오프 연구와 ImageNet 256 실험 양쪽에 적용된다.
결과
트레이드오프 연구
Figure 3의 가로축은 codebook 크기 |C|이고 2^4부터 2^16까지 sweep했다. 네 패널은 Reconstruction FID, Sampling FID, codebook 사용률, compression cost다.
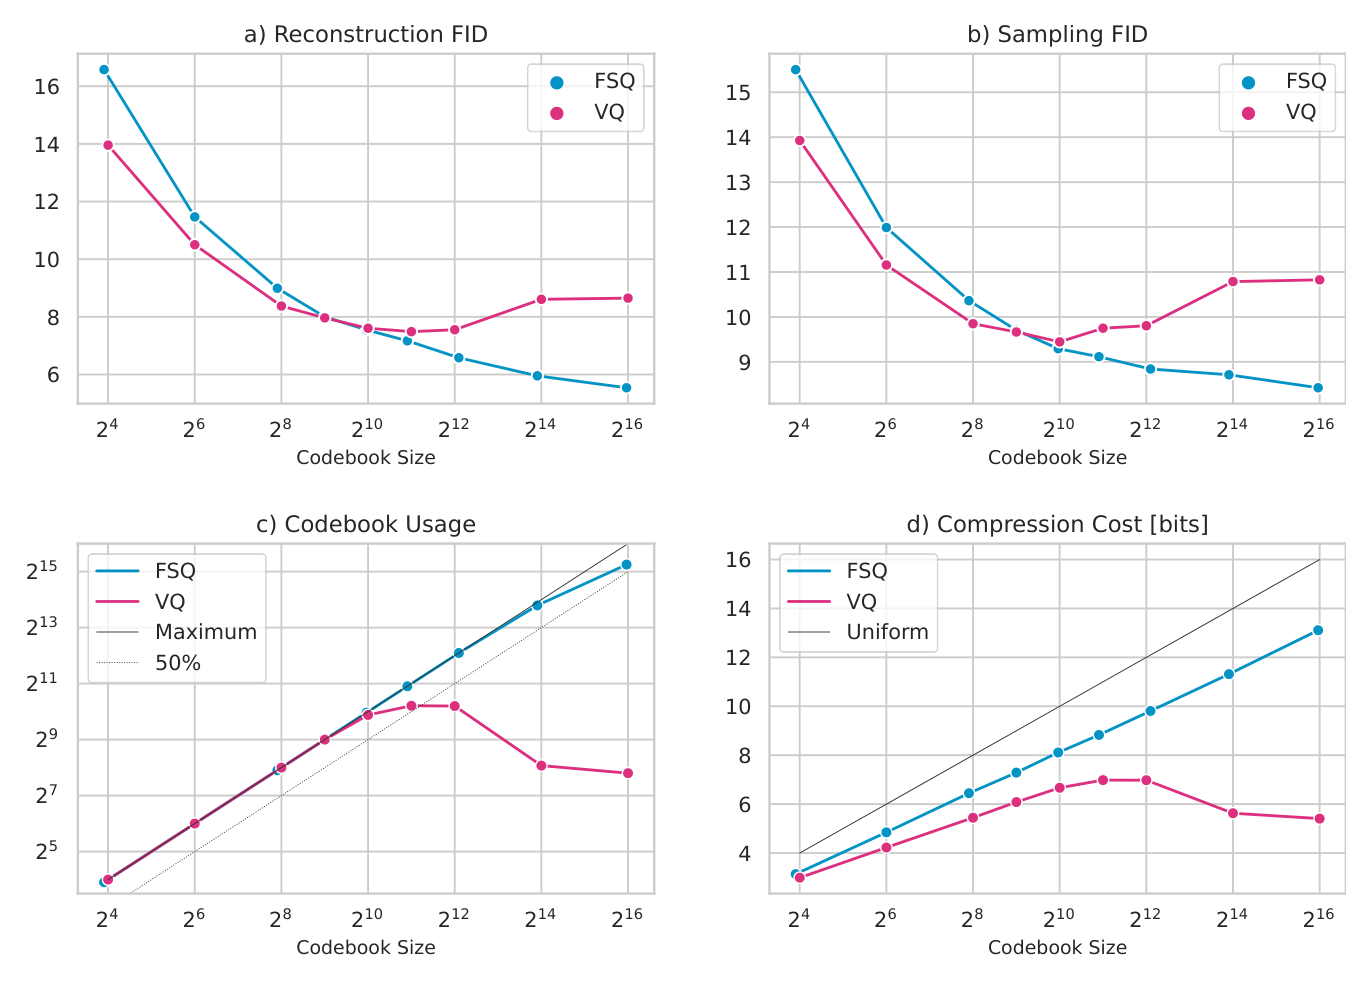
다음 표는 그래프에서 읽은 근사값이다. 본문 텍스트에 수치 표가 없으므로 소수점 첫째 자리는 판독 오차를 포함한다.
| 크기 | Reconstruction FID (FSQ / VQ) | Sampling FID (FSQ / VQ) | Compression cost 비트 (FSQ / VQ) |
|---|---|---|---|
| 2^4 | 약 16.6 / 14.0 | 약 15.5 / 13.9 | 약 3.2 / 3.0 |
| 2^8 | 약 9.0 / 8.4 | 약 10.3 / 9.9 | 약 6.4 / 5.4 |
| 2^10 | 약 7.6 / 7.6 | 약 9.3 / 9.4 | 약 8.1 / 6.6 |
| 2^12 | 약 6.6 / 7.6 | 약 8.9 / 9.8 | 약 9.8 / 7.0 |
| 2^16 | 약 5.5 / 8.6 | 약 8.5 / 10.8 | 약 13.1 / 5.4 |
codebook 사용률 패널은 두 방식의 차이를 가장 뚜렷하게 보여준다. 다음은 그래프에서 읽은 근사값이며 세로축은 실제로 쓰인 codeword 수다.
| 크기 | FSQ 사용 codeword 수 | VQ 사용 codeword 수 |
|---|---|---|
| 2^8 | 약 2^8 (최대와 일치) | 약 2^8 (최대와 일치) |
| 2^10 | 약 2^10 | 약 2^9.8 |
| 2^12 | 약 2^12 | 약 2^10 |
| 2^14 | 약 2^13.8 | 약 2^8.1 |
| 2^16 | 약 2^15.3 | 약 2^7.8 |
저자들이 본문에 적은 관찰은 다섯 가지다.
| 관찰 | 내용 |
|---|---|
| codebook 크기와 Reconstruction FID의 상관 | FSQ는 codebook을 키울수록 재구성 FID가 계속 좋아진다. 저장할 비트가 늘면 재구성이 좋아진다는 압축 관점의 기대와 일치한다. VQ는 entropy 정규화에도 불구하고 2^11개 코드에서 최소가 된 뒤 나빠지며, 이 지점은 사용률이 줄기 시작하는 지점과 일치한다 |
| Sampling FID | Stage I의 우위가 codebook을 키울수록 더 나은 Sampling FID로 이어진다. 2^10을 넘는 codebook에서 FSQ가 더 나은 Sampling FID와 높은 사용률을 얻고 VQ 지표는 나빠지기 시작한다 |
| codebook 사용률 | FSQ는 아무 장치 없이 2^14 = 16,384 크기에서 거의 모든 codeword를 쓰고, 2^16에서는 2^15개 넘게 활용한다. VQ는 2^11보다 큰 codebook에서 사용률이 50% 아래로 떨어지고, 그보다 큰 codebook에서도 2^10개 넘는 codeword를 활용하지 못한다 |
| codebook 확장 이득의 감소 | compression cost가 계속 오르므로 양자화 표현이 Transformer가 모델링하기에 더 복잡해진다. FSQ의 Sampling FID는 약 2^12개 codeword부터 포화한다 |
| 레벨 수 선택 | 부록 A.4.1에서 L_i < 5는 성능이 떨어진다 |
작은 codebook에서는 VQ가 FSQ를 근소하게 앞선다. 저자들은 VQ의 더 높은 표현력 때문일 것으로 추정한다. 그래프에서 2^4의 재구성 FID는 VQ 약 14.0, FSQ 약 16.6이고 2^9 부근에서 두 곡선이 만난다.
패널 d)의 Uniform 선은 코드를 균등 분포로 가정했을 때의 비용인 log2 |C|비트로, 2^4에서 4비트, 2^16에서 16비트다. 두 곡선이 이 선보다 아래에 있는 만큼 Transformer가 표현의 통계 구조를 활용해 압축하는 것이며, FSQ의 곡선은 크기가 커져도 Uniform 선과 비슷한 기울기로 계속 올라가는 반면, VQ의 곡선은 2^12 이후 꺾여 내려온다.
compression cost 패널은 두 가지를 더 보여준다. 첫째, 이 과제에서 FSQ 표현 밑의 이산 분포는 일반적으로 VQ보다 약간 모델링하기 어렵다. 같은 Transformer를 서로 다른 VAE에 학습시켰을 때 FSQ의 compression cost가 모든 크기에서 더 높다. 둘째, VQ의 compression cost는 사용률과 상관되어 사용률이 떨어지면 코드가 다시 모델링하기 쉬워진다. 그래프에서 VQ의 비용은 2^11에서 2^12 사이 약 7.0비트로 정점을 찍고 2^16에서 약 5.4비트로 내려온다. 같은 모델 군 안에서는 compression cost와 Sampling FID가 반상관이다.
MaskGIT 이미지 생성
Figure 4 상단 표의 값이다. † 표시는 ADM TensorFlow Suite로 평가했다는 뜻이며, 비교 대상을 모두 같은 도구로 다시 평가했다.
| 모델 | 출처 | CFG weight | Sampling FID ↓ | Precision ↑ | Recall ↑ | codebook 사용률 ↑ |
|---|---|---|---|---|---|---|
| MaskGIT (VQ) | 저자 재학습 | 0.1 | 4.509 | 0.860 | 0.465 | 81% |
| MaskGIT (FSQ) | 저자 재학습 | 0.2 | 4.534 | 0.864 | 0.453 | 100% |
| MaskGIT (VQ) | GitHub 공식 체크포인트 | 없음 | 4.916 | 0.836 | 0.489 | 기재 없음 |
| ADM (Dhariwal & Nichol, 2021) | 참조 | 1.5 | 4.59 | 0.83 | 0.52 | 해당 없음 |
FSQ와 VQ의 Sampling FID 차이는 0.025로, 두 양자화기는 매우 비슷한 FID, precision, recall을 냈다. codebook 사용률은 FSQ가 100%, VQ가 81%로 여기서도 FSQ가 codebook을 남김없이 쓴다. Figure 5의 무선별 샘플(ImageNet 클래스 330, 320, 510, 454, 모델당 두 장씩)도 정성적으로 비슷하다. 트레이드오프 연구에 근거해 더 큰 codebook도 시도했지만 추가 이득은 없었다.
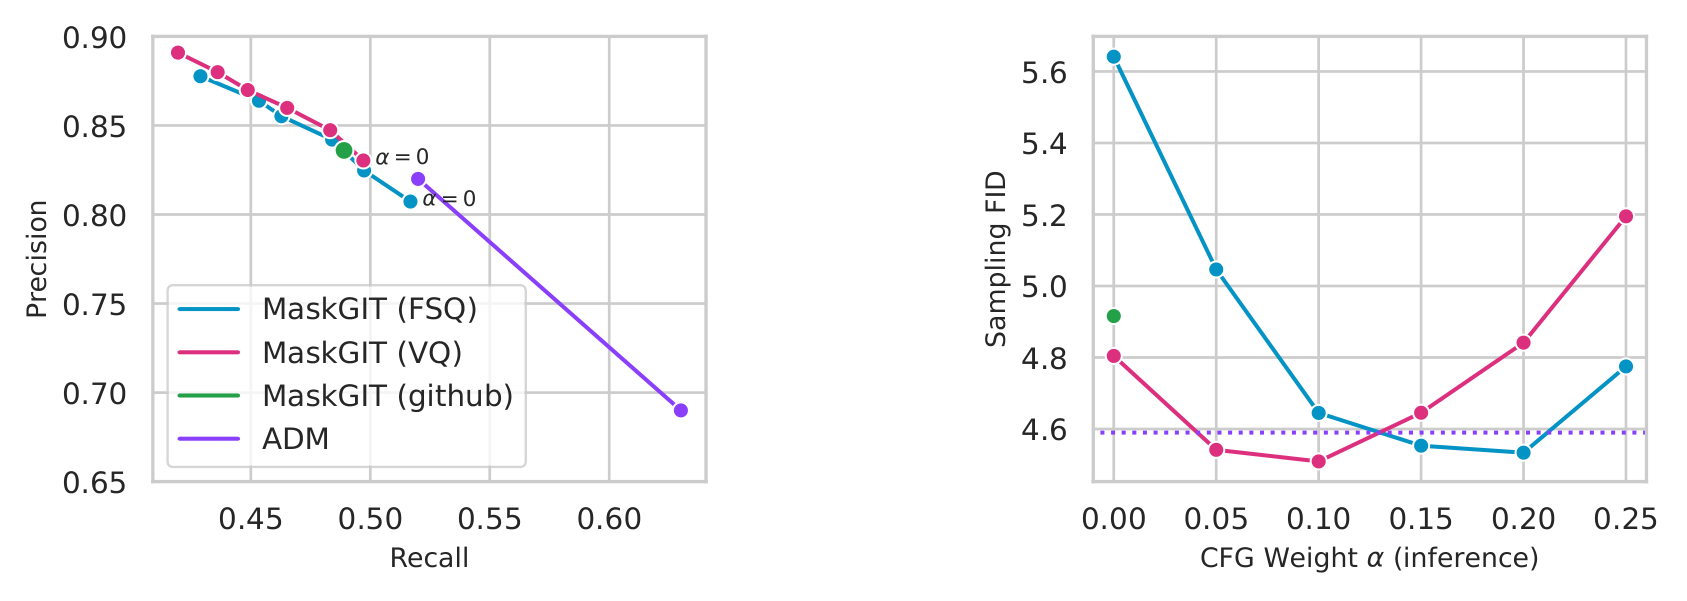
CFG weight α를 sweep하면 두 모델은 Precision과 Recall 공간에서 매우 비슷한 영역을 덮고 매우 비슷한 최소 FID에 도달한다. 다음은 Figure 4 오른쪽 그래프에서 읽은 근사값이다.
| α | 0 | 0.05 | 0.10 | 0.15 | 0.20 | 0.25 |
|---|---|---|---|---|---|---|
| Sampling FID (FSQ) | 약 5.65 | 약 5.05 | 약 4.65 | 약 4.56 | 약 4.53 | 약 4.78 |
| Sampling FID (VQ) | 약 4.80 | 약 4.55 | 약 4.51 | 약 4.65 | 약 4.85 | 약 5.20 |
α = 0에서는 FSQ가 VQ보다 FID가 높고 recall은 높으며 precision은 낮다. Figure 4 왼쪽 그래프에서 α = 0인 점은 FSQ가 recall 약 0.52, precision 약 0.81이고 VQ가 recall 약 0.50, precision 약 0.83이다. α를 올리면 두 곡선은 recall이 낮아지고 precision이 높아지는 같은 방향으로 움직이며 거의 같은 궤적 위에 놓인다. FSQ는 α = 0.2에서, VQ는 α = 0.1에서 FID 최소에 도달하고 두 최소값은 거의 같다. ADM의 CFG weight 1.5는 논문의 α와 절대값으로 비교할 수 없어 수평선으로만 표시했다.
precision과 recall은 트레이드오프 관계다. precision은 생성 샘플이 실제 데이터 분포 안에 얼마나 들어가는지, recall은 실제 분포를 샘플이 얼마나 넓게 덮는지를 잰다. CFG는 예측 분포를 조건부 쪽으로 밀어 precision을 올리는 대신 recall을 낮추므로, α 하나로 두 양자화기를 같은 트레이드오프 곡선 위에서 비교할 수 있다.
UViM dense prediction
Table 2의 값이다. 각 값은 3회 학습 평균과 표준편차이고, † 표시는 UViM GitHub 평가 suite를 썼다는 뜻이다.
| 과제 (데이터, 지표) | 모델 | 출처 | 지표 값 | codebook 사용률 |
|---|---|---|---|---|
| depth estimation (NYU Depth v2, RMSE ↓) | UViM (VQ) | 저자 재학습 | 0.468 ± 0.012 | 99% |
| UViM (FSQ) | 저자 재학습 | 0.473 ± 0.012 | 99% | |
| UViM (VQ, splitting 없음) | 저자 재학습 | 0.490 ± 0.0037 | 0.78% | |
| UViM (VQ) | GitHub | 0.463 | 기재 없음 | |
| DenseDepth (Alhashim & Wonka, 2018) | baseline | 0.465 | 해당 없음 | |
| panoptic segmentation (COCO Panoptic, PQ ↑) | UViM (VQ) | 저자 재학습 | 43.4 ± 0.0008 | 100% |
| UViM (FSQ) | 저자 재학습 | 43.2 ± 0.0014 | 100% | |
| UViM (VQ, context 없음) | 저자 재학습 | 39.0 ± 0.0023 | 99% | |
| UViM (FSQ, context 없음) | 저자 재학습 | 40.2 ± 0.0019 | 99% | |
| UViM (VQ) | GitHub | 43.1 | 기재 없음 | |
| DETR-R101 (Carion et al., 2020) | baseline | 45.1 | 해당 없음 | |
colorization (ImageNet, FID-5k ↓) |
UViM (VQ) | 저자 재학습 | 16.90 ± 0.056 | 100% |
| UViM (FSQ) | 저자 재학습 | 17.55 ± 0.057 | 100% | |
| UViM (VQ) | GitHub | 16.99 ± 0.057 | 기재 없음 | |
| ColTran (Kumar et al., 2021) | baseline | 19.37 | 해당 없음 |
세 과제 모두에서 FSQ는 VQ에 비해 경쟁력 있는 지표를 냈다. depth RMSE는 0.473 대 0.468, panoptic PQ는 43.2 대 43.4, colorization FID-5k는 17.55 대 16.90으로 FSQ가 근소하게 나쁘다. Table 2 캡션은 이를 "경쟁력 있지만 근소하게 나쁜 결과"로 정리한다. 저자들이 재학습한 VQ 모델은 GitHub 참조값과 비슷한 지표를 얻었다.
두 ablation은 FSQ의 장점을 더 분명히 보여준다.
| ablation | 과제 | 결과 |
|---|---|---|
| context 제거 | panoptic segmentation | VAE 인코더와 디코더에 주던 원본 RGB 입력을 없애면 둘 다 PQ가 낮아지지만 FSQ의 하락이 더 작다. VQ는 43.4에서 39.0으로 4.4 낮아지고 FSQ는 43.2에서 40.2로 3.0 낮아진다 |
| codebook splitting 제거 | depth estimation | VQ의 RMSE가 0.468에서 0.490으로 유의미하게 나빠지고, 사용률이 99%에서 0.78%로 100배 넘게(two orders of magnitude) 떨어진다. 예측에 들쭉날쭉한 가장자리가 나타난다 |
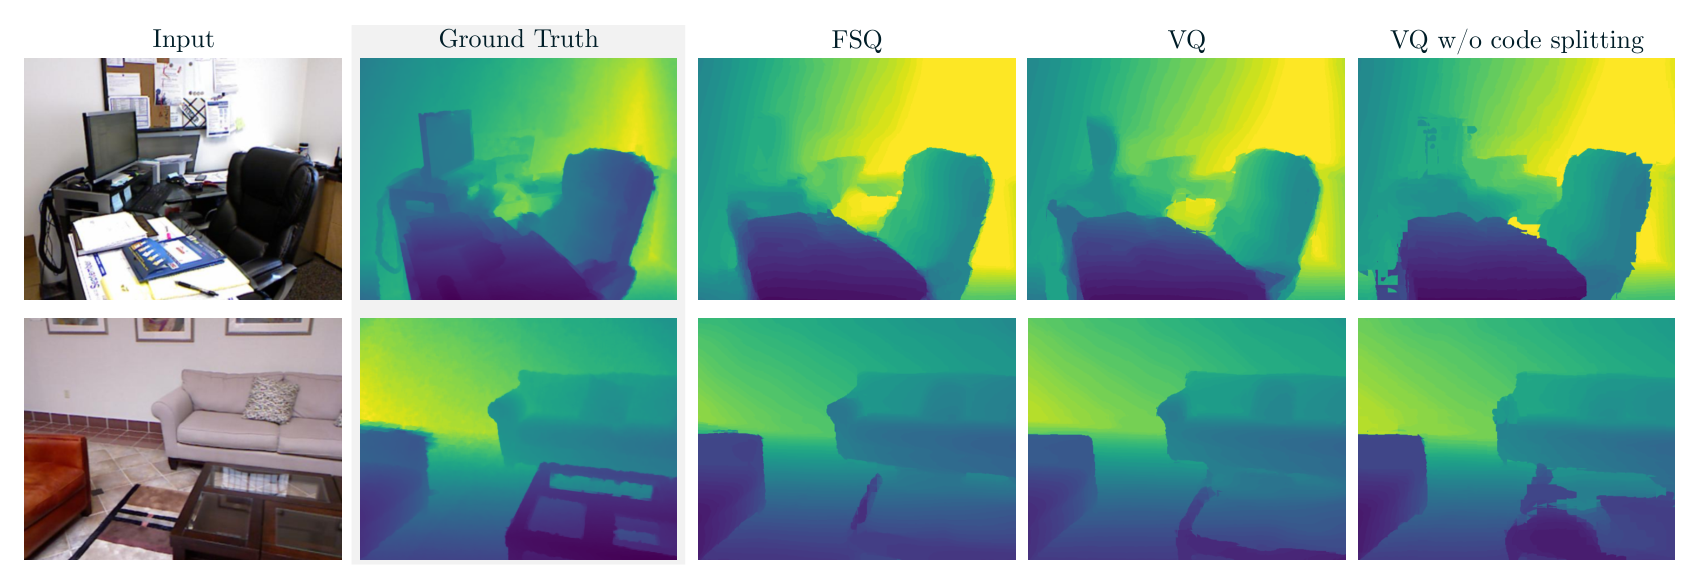
codebook splitting은 UViM이 codebook 미활용을 막으려고 채택한 Linde et al.(1980)의 알고리즘이다. 학습 중 쓰이지 않는 벡터를 탐지하고, 가장 자주 쓰이는 임베딩을 노이즈를 더한 두 개로 쪼개 그 자리를 대체한다. panoptic segmentation에서 splitting을 끄면 학습이 불안정해져 depth estimation으로 ablation했다. FSQ는 이런 보조 알고리즘 없이 99% 사용률을 얻는다.
의미론 분석
문헌에서는 VQ-VAE와 VQ-GAN의 codebook이 의미 있는 코드를 학습한다고 흔히 주장된다. 그런데 FSQ는 명시적 codebook을 학습하지 않는데도 VQ와 비슷한 샘플을 낸다. 부록 A.3의 소규모 연구에서 저자들은 어느 양자화기에서도 특정 코드가 고정된 시각 개념을 나타낸다는 증거를 찾지 못했고, 둘의 거동은 매우 비슷했다.
| 실험 | 절차 | 관찰 |
|---|---|---|
| 평균 표현 (Figure 9 왼쪽) | ImageNet 검증 집합 전체를 인코딩해 marginal histogram을 만들고, 거기서 16×16 표현 3개를 샘플링해 각 디코더로 디코딩 | FSQ-GAN과 VQ-GAN 모두 비슷한 패치 뒤범벅(soup of patches)을 만든다 |
| 단일 코드 공유 (Figure 9 오른쪽) | marginal histogram에서 가장 흔한 코드 3개를 골라 모든 공간 위치에 같은 코드를 채운 표현을 디코딩 | 단순한 격자 텍스처나 단색에 가까운 출력 |
| representation stitching (Figure 8) | 검증 이미지 A의 위 절반과 B의 아래 절반을 픽셀 공간에서 이은 것과, FSQ-GAN과 VQ-GAN의 표현을 latent 공간에서 이어 디코딩한 것을 비교 | 두 디코더 모두 표현 공간의 급격한 전환을 픽셀 공간의 부드러운 전환으로 바꾼다 |
이 조사는 개별 코드가 아주 추상적인 개념을 배우지 않는다는 점을 시사한다. 최종 RGB 이미지를 결정하는 것은 코드 조합과 디코더 가중치다.
세 실험의 종합
| 실험 | FSQ 설정 | VQ 설정 | 주요 지표 (FSQ / VQ) | 사용률 (FSQ / VQ) | 판정 |
|---|---|---|---|---|---|
| 트레이드오프 (128×128 ImageNet) | 목표 크기별 L 탐색 | entropy 손실 가중치 0.1 | 2^16에서 Reconstruction FID 약 5.5 / 8.6 | 2^16에서 2^15 이상 / 2^10 미만 | 2^10을 넘는 codebook에서 FSQ 우세 |
| MaskGIT (ImageNet 256) | L = [8, 5, 5, 5], CFG 0.2 | codebook 1024 + entropy 손실, CFG 0.1 | Sampling FID 4.534 / 4.509 | 100% / 81% | 대등 |
| UViM depth estimation | L = [7, 5, 5, 5, 5] | codeword 4096 + splitting | RMSE 0.473 / 0.468 | 99% / 99% | 대등. splitting을 끈 VQ는 0.490과 0.78% |
| UViM panoptic segmentation | 동일 | 동일 | PQ 43.2 / 43.4 | 100% / 100% | 대등. context를 끄면 FSQ 40.2 대 VQ 39.0 |
| UViM colorization | 동일 | 동일 | FID-5k 17.55 / 16.90 |
100% / 100% | FSQ 근소 열세 |
세 실험을 합치면 FSQ의 성격이 드러난다. 최고 지표에서는 VQ가 근소하게 앞서지만, 그 차이는 0.5~3% 범위 안이다. 반면 codebook 사용률과 큰 codebook에서의 scaling, 보조 장치 없는 학습 안정성에서는 FSQ가 일관되게 앞선다. 따라서 FSQ의 장점은 절대 성능이 아니라 단순성과 큰 codebook에서의 안정성이다.
한계
저자가 명시한 것은 다음과 같다.
- 모든 과제에서 FSQ의 지표는 VQ보다 근소하게 나쁘다. 기여 요약에서는 0.5~3% 하락으로 정량화했다.
- 작은 codebook에서는 재구성 FID에서 VQ가 FSQ를 근소하게 앞선다. 저자들은 VQ의 더 높은 표현력 때문일 것으로 추정한다.
- 트레이드오프 과제에서 FSQ 표현의 이산 분포는 일반적으로 VQ보다 약간 모델링하기 어렵다. compression cost가 모든 크기에서 더 높고, Sampling FID는 약 2^12개 codeword부터 포화해 codebook 확장의 이득이 줄어든다.
- MaskGIT 256에서 더 큰 codebook을 시도했지만 추가 이득이 없었다.
- (d, L_i) 조합은 모든 선택이 최적은 아니며 L_i < 5는 성능이 떨어진다.
- 향후 과제는 FSQ를 더 많은 응용에서 탐구하는 것이다.
자료에 기술이 없어 확인할 수 없는 것은 다음과 같다.
- 게재 학회, 학습에 쓴 하드웨어와 시간.
- 오디오나 비디오 등 이미지 밖 도메인에서의 FSQ 결과.
- 트레이드오프 연구의 정확한 수치. Figure 3 그래프로만 제시되어 이 페이지의 판독표는 근사값이다.
자료 내적 모순이 하나 있다. 본문 Table 1은 2^12에 [7, 5, 5, 5, 5](곱 4,375)를 적고, 부록 A.4.1의 권장표는 2^12에 [7, 5, 5, 5](곱 875)를 적는다. 후자는 2^12에 맞지 않는다. UViM 실험은 Table 1의 [7, 5, 5, 5, 5]를 썼다고 본문에 명시돼 있으므로, 이 페이지는 본문 Table 1을 따른다.
재현성과 윤리에 관해 저자들은 부록 A.1의 참조 코드와 GitHub의 Colab을 제공한다. 윤리 진술에서는 FSQ가 VQ의 drop-in replacement이므로 VQ가 쓰이는 모든 도메인에 적용될 수 있고, 생성 모델은 편향에 주의해야 하지만 VQ 기반 방법에 없는 새로운 윤리 문제는 생기지 않는다고 적었다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| FSQ | finite scalar quantization. VAE 표현을 저차원으로 투영해 각 차원을 bound한 뒤 정수로 반올림하는 양자화기. 차원별 값 집합의 곱집합이 암묵적 codebook이 된다 |
| codebook | 이산 표현이 고를 수 있는 코드의 집합. VQ에서는 학습 파라미터이고 FSQ에서는 격자로 암묵적으로 정의된다 |
| codebook collapse | codebook이 커질수록 다수의 codeword가 쓰이지 않는 현상. 논문은 underutilized codebooks라고도 부른다 |
| STE | straight-through estimator. 미분 불가능한 반올림이나 최근접 탐색의 그래디언트를 1로 대체해 통과시키는 기법 |
| codebook splitting | 쓰이지 않는 벡터를 가장 자주 쓰이는 임베딩을 둘로 쪼개 대체하는 VQ 보조 장치. Linde et al.(1980)의 알고리즘이며 UViM이 쓴다 |
| compression cost | Transformer와 entropy coding으로 표현을 무손실 압축했을 때의 비트 수. 이산 분포의 모델링 난이도를 재는 대리 지표 |
관련 페이지
- High-Resolution Image Synthesis with Latent Diffusion Models: LDM의 VQ-reg autoencoder는 디코더 안에 벡터 양자화 층을 둔다. FSQ는 그 양자화 층을 단순화한 방식이라 latent tokenizer 계보에서 이어진다
- Cosmos World Foundation Model Platform for Physical AI: Cosmos의 discrete tokenizer가 FSQ로 6차원 latent를 (8, 8, 8, 5, 5, 5) 레벨로 양자화해 어휘 크기 64,000을 만든다. 이 논문 Table 1의 2^16 권장값과 같은 구성이다
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: 모션 토큰에 VQ-VAE 대신 FSQ를 채택하며 codebook collapse가 없고 commitment 손실과 codebook EMA가 필요 없다는 점을 근거로 든다
- 용어집: LLMs (Terminology Glossary): 양자화, 그래디언트, 임베딩 등 이 페이지가 따르는 용어 표기