Physical AI · PAPER · 2025
SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control
요약
SONIC은 motion tracking을 humanoid 제어의 확장 가능한 기본 과제로 놓고 모델과 데이터와 compute를 함께 키운 whole-body control foundation model이다. motion tracking은 mocap의 목표 포즈를 프레임 단위로 따라가게 학습하는 과제이고, whole-body control은 균형과 이동을 포함해 몸 전체를 함께 제어하는 문제다. NVIDIA GEAR가 27명을 투입해 파라미터 1.2M에서 42M, 모션 1억 프레임 이상(611시간), 21,000 GPU hours(128 GPU로 7일)까지 규모를 키웠고 결과 policy를 Unitree G1에 배포했다.
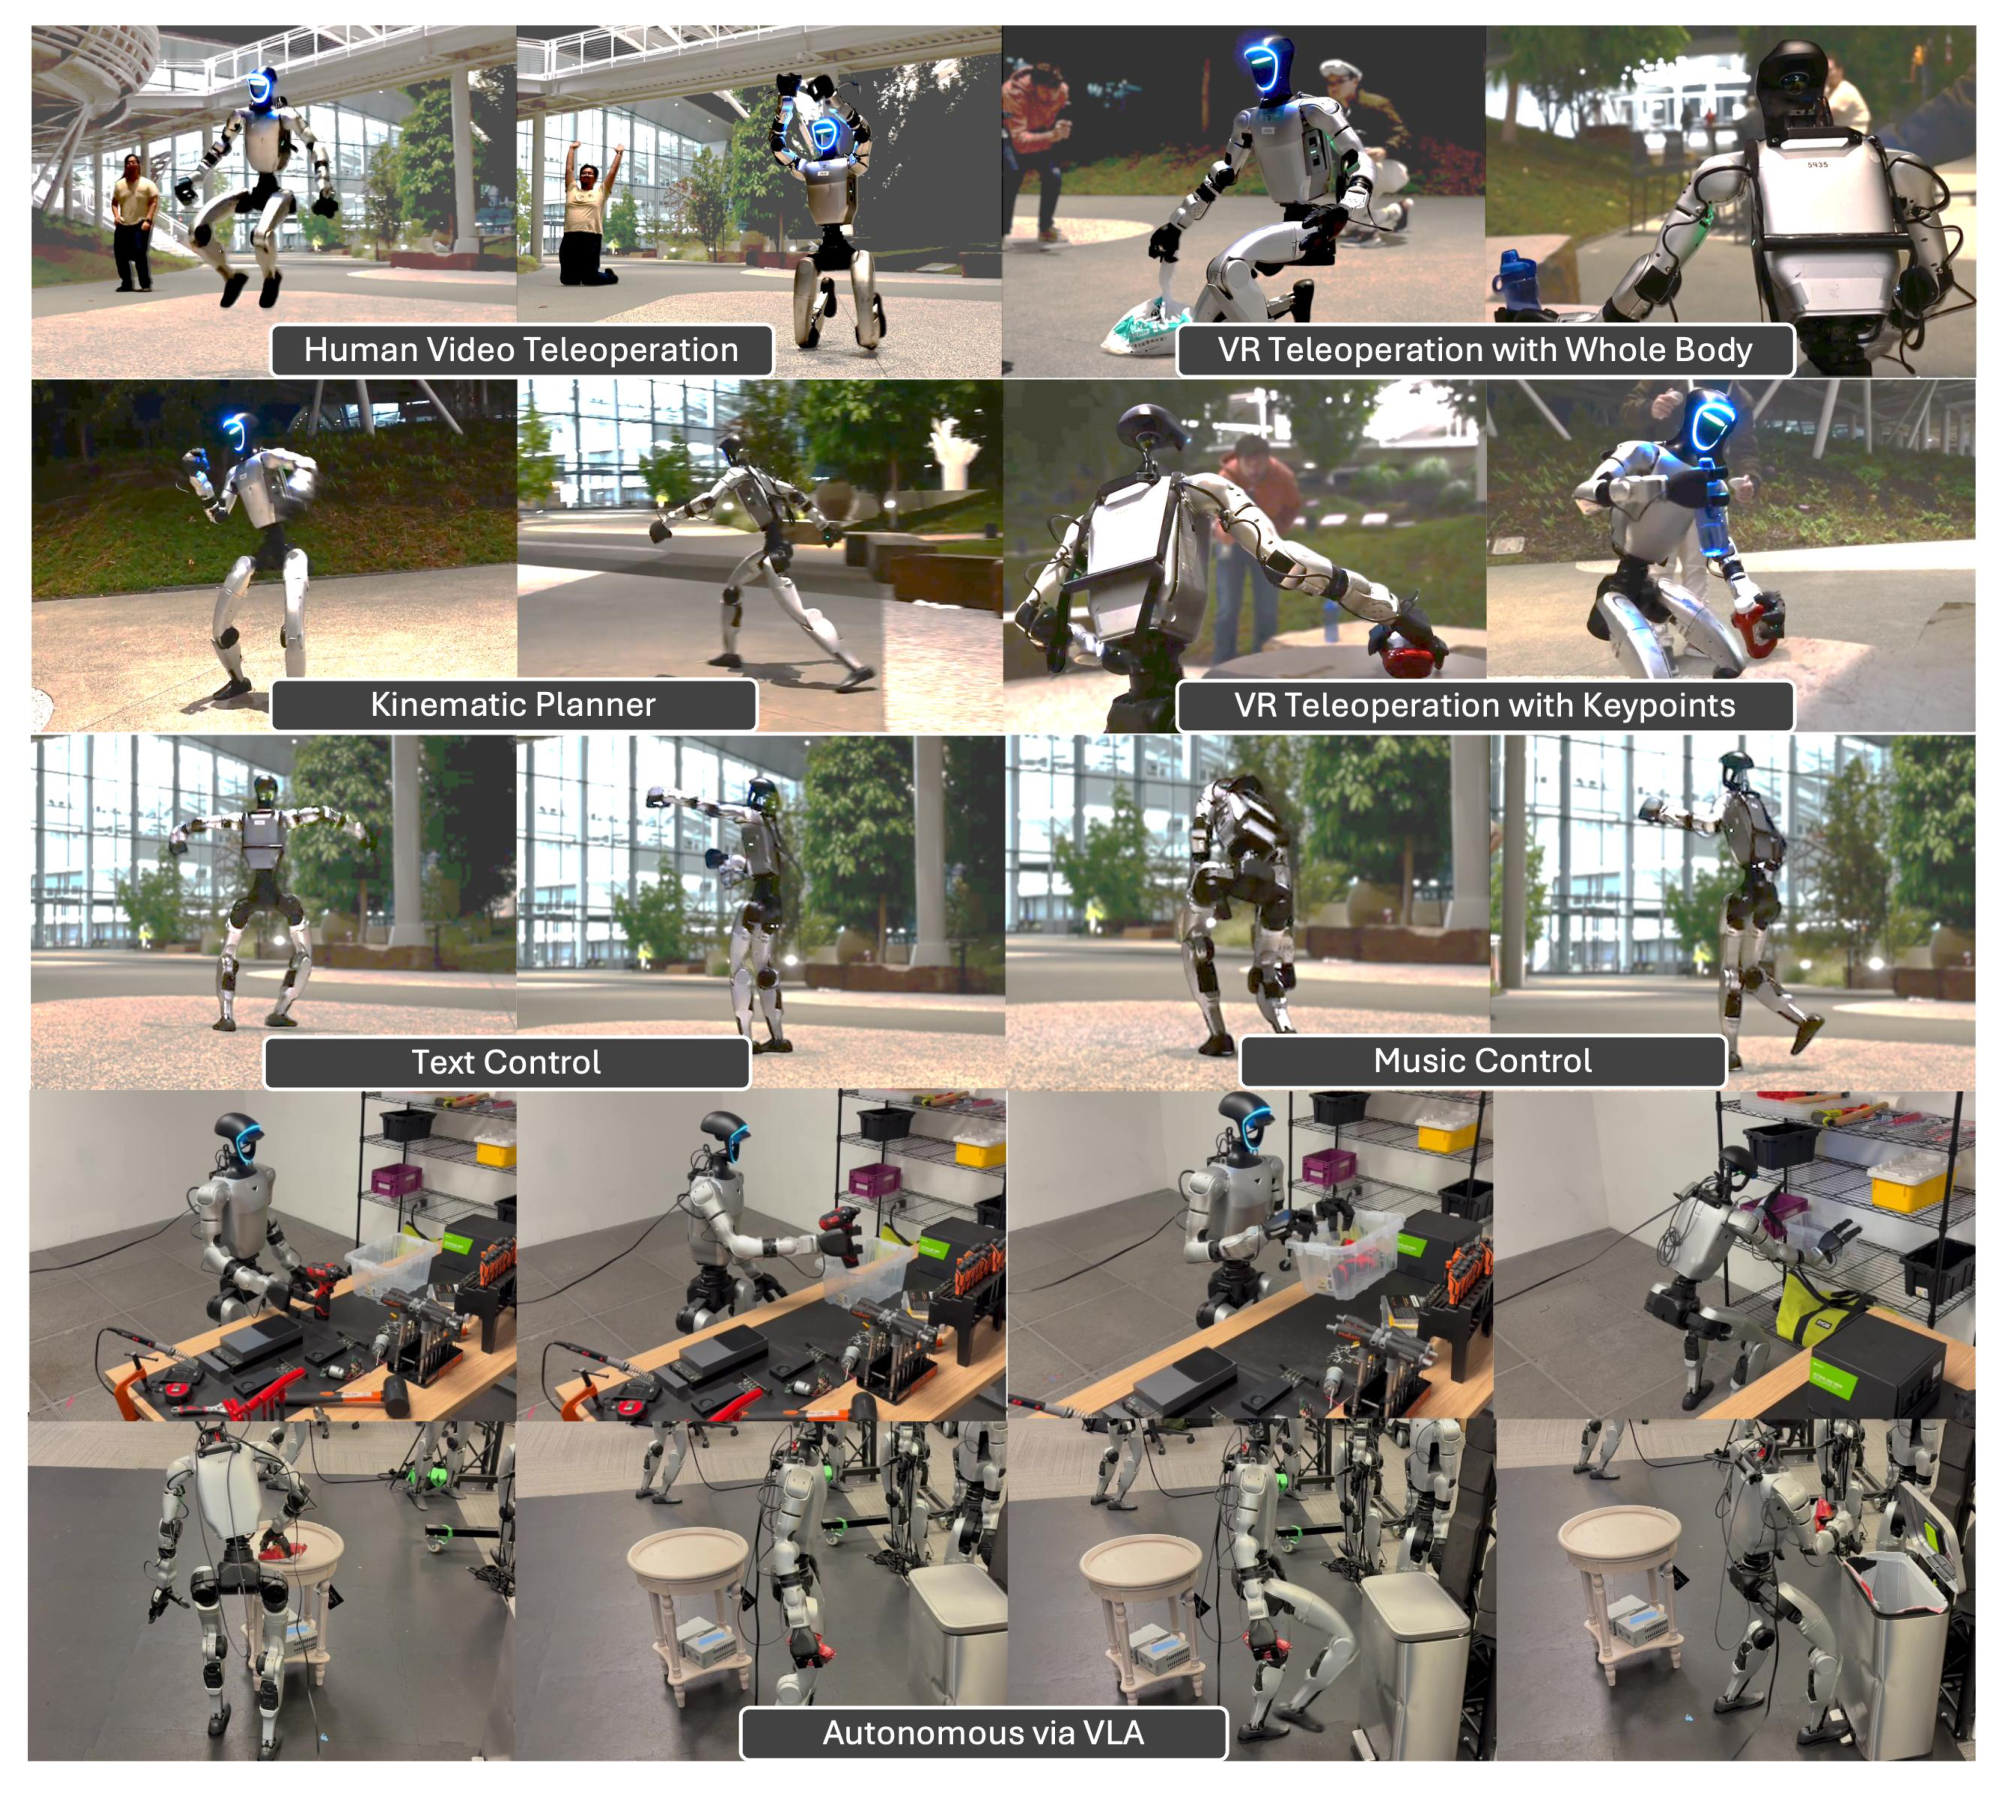
논문의 무게중심은 규모 자체보다 그 위에 올린 두 겹의 응용층에 있다. 실시간 kinematic planner가 사용자 의도를 짧은 참조 모션으로 바꿔 내비게이션과 게임패드 제어를 받아내고, robot과 human과 hybrid 세 입력을 FSQ로 양자화한 universal token space가 VR teleoperation과 VLA 추론을 같은 policy에 연결한다.
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하고, action space는 그 policy가 낼 수 있는 action의 집합이다. 이 universal token을 action space로 쓴 GR00T N1.5는 페달을 밟아 쓰레기통을 열고 캔을 버리는 전신 loco-manipulation을 자율로 수행한다.
배경
humanoid 제어는 다른 AI 분야가 겪은 규모 확대를 겪지 않았다. GPT 계열은 GPU 2만 5천 개 이상에서 학습하고 영상 생성 모델도 수천 GPU를 쓰는 반면, 최고 수준의 humanoid 제어 policy는 3층 MLP 정도의 작은 신경망을 GPU 몇 장으로 단일 과제에 맞춰 학습한 것이 보통이다.
저자들은 그 원인을 모델 용량이나 compute가 아니라 학습 과제의 선택에서 찾는다. reward는 policy가 얼마나 잘했는지를 알려주는 스칼라 신호인데, 과제별 reward를 손으로 설계하는 방식에서는 앞으로 걷기를 잘하게 만든 reward가 춤이나 기상 동작이나 teleoperation에 거의 신호를 주지 못한다. 즉 새 능력마다 목적함수를 다시 짜야 하므로 규모를 키울 통로가 막힌다.
목적함수를 통일하려던 선행 시도는 다른 벽에 부딪혔다. AMP와 ASE와 CALM 같은 생성적 imitation은 모션 분포 정합과 간단한 과제 reward를 결합해 목적함수를 하나로 묶었지만, 데이터가 다양해질수록 discriminator의 판별 과제가 어려워지고 피드백이 부실해져 mode collapse로 이어진다고 보고됐다.
motion tracking은 두 문제를 동시에 피한다. mocap 프레임마다 명시적 목표 포즈가 주어지므로 reward engineering 없이 dense supervision을 얻고, 데이터가 커져도 학습 신호의 밀도가 떨어지지 않는다. 게다가 걷기와 춤과 스포츠와 물체 상호작용을 담은 mocap 데이터셋은 수십 년의 연구 축적 덕에 이미 대규모로 존재한다.
남은 과제는 응용의 폭이다. 쓸모 있는 컨트롤러는 teleoperation과 목표지향 과제와 내비게이션과 vision-language 명령까지 받아야 하는데, 선행 motion tracking 연구들은 대체로 학습 데이터에서의 전신 추종 결과를 보이는 데 머물렀다. SONIC은 규모 확대와 인터페이스 통합을 함께 다뤄 이 간극을 메우려 한다.
핵심 개념
universal token은 서로 다른 형식의 모션 명령이 공통으로 매핑되는 양자화된 latent를 가리킨다. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 뜻하며, robot 모션과 human의 SMPL 포즈와 VR 키포인트가 각자의 encoder를 거쳐 같은 token 공간에 놓이므로 하나의 policy가 여러 인터페이스를 재학습 없이 받는다.
reference lookahead는 encoder가 현재 프레임 이후 몇 초 분량의 참조 모션을 미리 받는지를 뜻한다. SONIC의 세 encoder는 모두 미래 10프레임을 보되 프레임 간격이 달라, robot과 hybrid encoder는 1.0초 앞을, human encoder는 0.2초 앞을 본다. 미래 프레임을 함께 주는 이유는 policy가 다음 동작을 미리 준비하는 선행 거동을 익히게 하기 위해서다.
평가는 성공률과 MPJPE-L을 중심으로 한다. MPJPE-L은 root 상대 좌표계에서 잰 관절 위치 오차의 평균이고 pelvis, 무릎, 발목, torso, 팔꿈치, 손목을 포함한 14개 body link에서 mm 단위로 계산한다. 물리적 충실도는 참조 모션과의 속도 차이와 가속도 차이로 추가 측정한다.
성공 판정 기준도 선행 연구와 다르다. root 높이나 end-effector 높이가 참조 대비 0.25m를 넘게 벗어나거나 root 방향이 1 radian을 넘게 어긋나면 실패로 본다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분을 말한다. 선행 연구의 전역 root 위치 0.5m 기준을 쓰지 않는 이유는 SONIC이 전역 trajectory 추종이 아니라 국소 추종을 하기 때문이고, 이 기준이 넘어짐 같은 물리적으로 의미 있는 실패를 잡는다.
방법
데이터셋과 분할
원본은 남녀 성비를 맞춘 약 700시간 규모의 mocap 컬렉션이다. 클립 길이는 1초에서 180초까지 분포하고 대부분의 동작을 여러 배우가 여러 테이크로 수행해 배우 내부와 배우 사이의 변이가 함께 담긴다.
GMR과 PyRoki로 Unitree G1에 retarget한 뒤 계단 오르기나 착석처럼 대상 로봇이 실행할 수 없는 동작을 걸러 611시간을 남겼다. retargeting은 사람 동작 데이터를 로봇 형상에 맞게 변환하는 과정을 말한다. 남은 데이터는 50Hz 기준 1억 프레임 이상, 클립 수로는 317,189개이고 33개 main category 아래 sub-category로 나뉜다. 기본과 고급 locomotion, 제스처, 댄스, 전투, 물체 조작, tool use, 부상 보행, 스타일 변형, 역할극이 포함되며 모든 모션은 좌우 미러링으로 쌍을 이룬다.
분할 설계가 평가의 신뢰도를 좌우한다. test-content는 학습에 전혀 없던 sub-category만 모아 새로운 동작 내용에 대한 일반화를 재고, test-repetition은 sub-category가 100% 겹치되 클립이 겹치지 않아 같은 동작의 다른 수행에 대한 강건성을 잰다.
| 항목 | Train | test-content | test-repetition |
|---|---|---|---|
| 클립 수 | 317,189 | 6,998 | 6,306 |
| 시간 | 611시간 | 15시간 | 12시간 |
| sub-category 수 | 8,447 | 182 | 1,088 |
| 학습과의 sub-category 중복 | 기준 | 0% | 100% |
| 학습과의 클립 중복 | 기준 | 0% | 0% |
두 test 분할의 구성은 학습 세트와 다르다. 학습에서 큰 비중을 차지하는 Combat(50,162개)은 두 분할에 한 클립도 들어가지 않았고 Acting과 Roleplay(68,742개)도 test-repetition에 20개만 남아, 평가는 사실상 locomotion과 제스처와 부상 보행 중심으로 이뤄진다.
외부 벤치마크로는 PHUMA를 쓴다. 모션 6만 8천 개 규모이고 영상 기반 포즈 추정 결과를 다른 retargeting 파이프라인으로 모은 데이터라 자체 held-out 분할보다 분포가 훨씬 멀다. 학습 데이터의 상당 부분은 BONES-SEED로 공개됐는데, 배우 522명의 모션 시퀀스 142,220개(288시간)를 SOMA와 Unitree G1 포맷으로 담고 자연어 설명과 시간 분할 라벨을 붙였다.
universal control policy
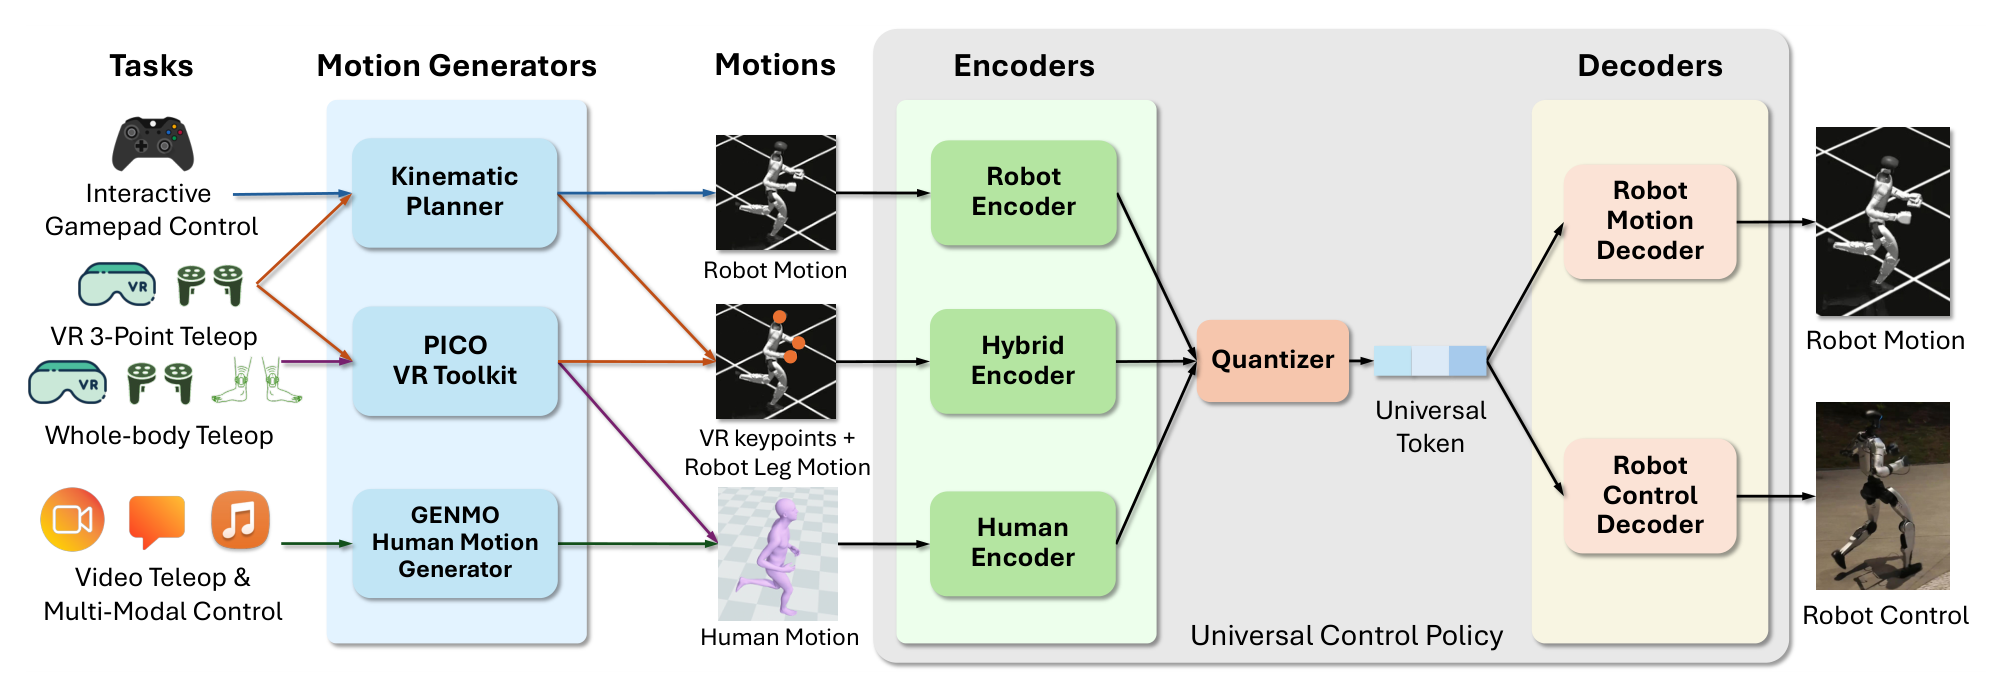
문제는 MDP로 정식화하고 PPO로 학습하며 시뮬레이터는 Isaac Lab이다. 상태는 proprioception과 motion command 두 덩이로 나뉜다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이며, 여기서는 관절 위치와 속도, root 각속도, root 프레임의 중력 벡터, 직전 action을 10스텝 히스토리로 이어붙인다. 모든 값은 회전 불변성을 위해 로봇 로컬 프레임에서 표현하고 회전은 6D 표현을 쓴다. action은 29차원 목표 관절 위치이며 각 관절의 PD 제어기가 이를 추종한다.
구조의 핵심은 세 encoder를 하나의 latent로 모으는 것이다. 세 encoder는 모두 MLP이고 보는 미래 프레임 수도 10으로 같으며 프레임 간격만 다르다.
| encoder | 입력 | reference lookahead | 대응 인터페이스 |
|---|---|---|---|
| robot motion encoder | 미래 프레임의 로봇 관절 위치와 속도 | 1.0초 | 사전 녹화 클립, kinematic planner, 게임패드 |
| human motion encoder | SMPL 3D 관절 위치 | 0.2초 | VR 전신 teleoperation, 영상과 텍스트와 음악 제어 |
| hybrid motion encoder | 현재 프레임의 상체 sparse keypoint(머리와 양손)와 미래 프레임의 하체 로봇 모션 | 1.0초 | VR 3-point teleoperation |
세 출력은 Finite Scalar Quantization으로 양자화되어 universal token이 된다. 토큰은 2개이고 기본 설정은 FSQ-32-32, 즉 토큰당 차원 32와 양자화 레벨 32다. 두 토큰을 합친 64차원이 VLA 쪽에 action space로 노출된다.
VQ-VAE 대신 FSQ를 택한 근거는 세 가지다. codebook의 큰 부분이 쓰이지 않는 codebook collapse가 없고, 별도의 commitment loss나 codebook EMA 갱신이 필요 없으며, straight-through 그래디언트 추정이 PPO와 함께 최적화하기에 깔끔하다. 33개 main category와 8,447개 sub-category라는 다양성에서 codebook 미사용 구간은 실제로 발생 가능한 위험이다.
디코더는 둘이다. robot control decoder는 universal token과 proprioception을 함께 받아 모터 명령을 내고, robot motion decoder는 토큰만 받아 로봇 모션 명령을 복원해 보조 감독을 준다. 입력이 human motion일 때 후자의 복원 손실이 사실상 human에서 robot으로 가는 retargeting loss로 작동하며, 런타임에 명시적 retargeting 단계를 생략할 수 있는 근거가 여기에 있다.
reward와 domain randomization
reward는 추종 항과 페널티 항의 합이다. 추종 항은 참조 모션과의 오차를 지수 형태로 줄이고, 페널티 항은 실제 기기에서 문제가 되는 거동을 억제한다.
| 구분 | 항목 | 가중치 |
|---|---|---|
| 추종 | root 위치 / root 방향 | 각 0.5 |
| 추종 | body link 위치와 방향, 선속도와 각속도 (root 상대) | 각 1.0 |
| 추종 | end-effector 위치 (머리, 양 손목, 양 발목) | 2.0 |
| 페널티 | action 변화율 | -0.1 |
| 페널티 | 관절 한계 이탈 | -10.0 |
| 페널티 | 의도하지 않은 접촉 | -0.1 |
| 페널티 | anti-shake (머리와 손목 각속도) | -0.005 |
| 페널티 | 발 가속도 | -0.0000025 |
end-effector 위치에 가장 큰 가중치 2.0이 붙은 점이 눈에 띈다. 즉 머리와 손목과 발목의 위치 정확도를 다른 항목보다 강하게 요구한다. anti-shake와 발 가속도 페널티는 떨림을 줄이고 발 접촉을 매끄럽게 만든다.
domain randomization은 시뮬레이션 파라미터를 흔들어 sim2real 간극을 줄이는 기법이다. 정적 마찰 계수는 0.3에서 1.6, 동적 마찰 계수는 0.3에서 1.2, 반발 계수는 0에서 0.5 범위에서 뽑고 기본 관절 위치와 base 무게중심에도 교란을 준다. 여기에 1초에서 3초 동안 지속되는 root 속도 교란을 주기적으로 넣어 외부에서 미는 상황을 흉내 낸다.
목표 motion command 자체에도 jitter를 준다는 점이 SONIC 특유의 선택이다. 목표 위치와 방향과 속도와 관절 각도가 모두 흔들리는데, 이 항목이 뒤에서 planner가 만든 노이즈 섞인 참조 모션을 트래커가 견디는 근거가 된다.
손실 함수와 최적화
손실은 네 항의 합이며 하나의 end-to-end 학습 루프에서 함께 최적화한다.
| 손실 항 | 정의 | 역할 |
|---|---|---|
| PPO 손실 | 표준 PPO 목적함수 | 제어 성능 자체를 학습 |
| 복원 손실 | 세 토큰 각각에서 복원한 로봇 모션과 실제 로봇 모션의 오차 | latent 품질 향상, human 입력일 때는 retargeting loss |
| 토큰 정렬 손실 | 세 encoder 출력의 세 쌍에 걸린 L2 거리 | 같은 모션이면 입력 형식이 달라도 같은 토큰을 내게 강제 |
| 순환 일관성 손실 | human 토큰에서 복원한 로봇 모션을 다시 인코딩한 값과 원래 robot 토큰의 거리 | human에서 robot으로 갔다 돌아와도 모션 특성이 보존되게 함 |
갱신 대상은 손실마다 나뉜다. PPO 손실은 encoder와 quantizer와 control decoder와 critic을, 나머지 세 손실은 encoder와 quantizer와 motion decoder를 갱신한다. 그래디언트가 straight-through 추정으로 FSQ를 통과하므로 PPO가 encoder 표현 자체를 다듬는다.
학습은 asymmetric actor-critic 구조를 쓴다. critic만 base 선속도와 전체 link 상태와 노이즈 없는 observation 같은 특권 시뮬레이션 정보를 보고, actor는 배포 시점에 얻을 수 있는 입력만 쓴다.
양자화와 강화학습을 엮으면 학습이 불안정해질 것이라는 우려는 실험에서 확인되지 않았다. 저자들은 어떤 모델 규모에서도 불안정을 관찰하지 못했고 오히려 보조 손실이 latent를 정규화해 PPO 최적화를 안정화했다고 보고한다. 샘플링은 데이터셋을 1초 bin으로 나누고 상한을 씌운 실패율에 비례해 가중치를 주는 적응 방식이라, 어려운 모션을 집중 연습하는 것과 전체를 고르게 덮는 것 사이의 균형을 맞춘다.
생성형 kinematic planner
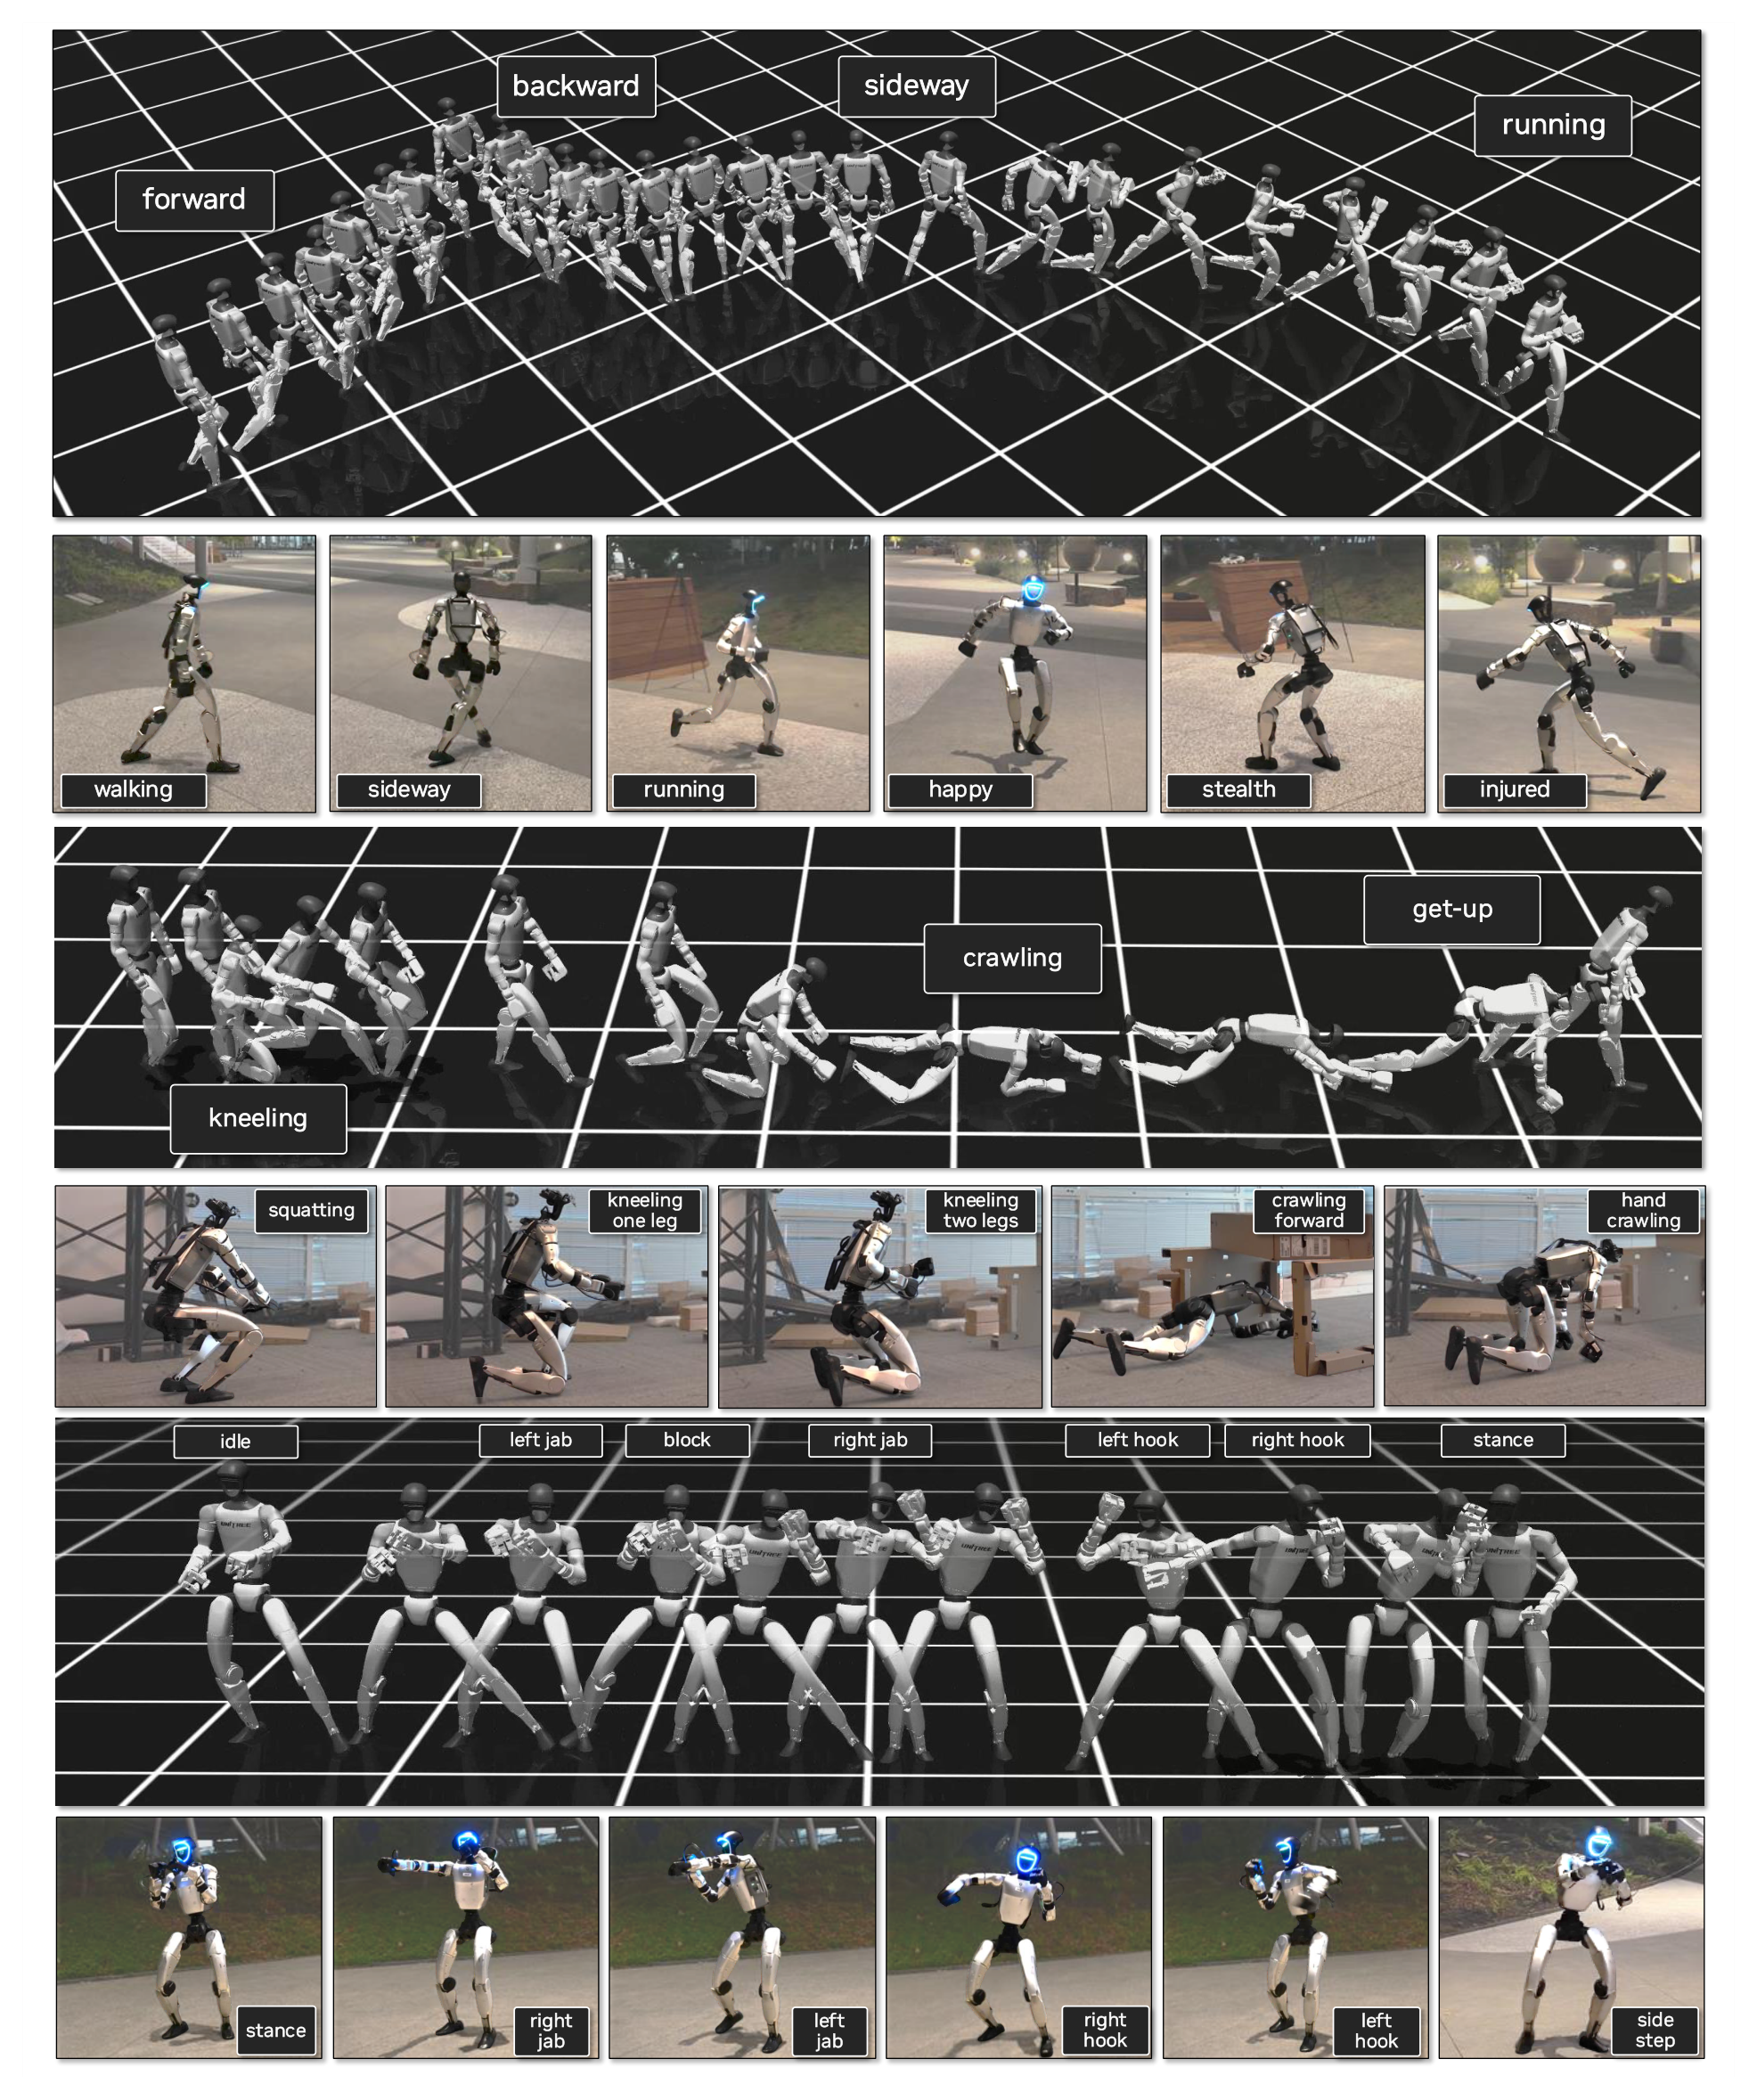
planner는 트래커와 같은 데이터로 학습한 대규모 latent 생성 모델이며, 계획을 autoregressive motion in-betweening으로 정식화한다. 0.8초에서 2.4초 사이 구간의 양 끝 keyframe을 context와 target으로 두고 그 사이를 채우며, 구간 길이는 planner가 자동으로 정한다.
계획은 latent 공간에서 이뤄진다. 연속 모션을 downsampling rate 4로 토큰열로 인코딩한 뒤, sparse한 제약에서 전체 토큰열을 한 번에 예측하는 대신 masked token prediction으로 confidence가 높은 토큰부터 확정해 나가고 추론 시 확정 비율은 코사인 스케줄을 따른다. 모션 표현으로 국소 정규화 회전 대신 전역 관절 회전을 쓰는데, 스쿼트나 기어가기처럼 heading이 잘 정의되지 않는 동작의 생성 품질 때문이다.
root trajectory는 critically damped spring model이 만든다. pelvis의 x축 위치, y축 위치, 투영 heading 각도 세 값에 적용하고 컨트롤러가 속도만 지정하면 그 속도로 1.0초 뒤에 도달할 위치를 계산해 목표 keyframe을 놓는다. 저자들은 planner가 damping 계수 선택에 강건하고 spring model 없이도 대체로 동작한다고 밝히면서도, 6.0m/s에서 -6.0m/s로 급반전하는 비현실적 명령을 걸러 거동의 예측 가능성을 높이는 안전장치로서의 값은 인정한다.
target keyframe을 만드는 방법은 응용마다 다르다.
- 내비게이션: 원하는 스타일의 navigation 클립에서 무작위 구간을 골라 목표 root trajectory 위에 배치한다.
- 복싱 같은 엔터테인먼트: 스타일에 맞는 클립에서 가장 표현적인 구간을 고른다. 펀치라면 팔이 최대로 뻗은 프레임이다.
- 스쿼트와 무릎보행: 원하는 높이에 따라 모션 클립 라이브러리에서 온라인으로 검색한다.
- motion layering: 상체를 지정하면 하체는 planner가 생성한다.
효율이 이 설계의 실용적 강점이다. 스킬 하나당 대표 클립 한 개만으로 25개 이상의 스킬과 스타일을 재학습 없이 다룬다. 반면 기존 방식은 제한된 클립 모음을 쓰고 여러 전문가 모델이나 action 라벨 사이를 전환해야 해서 불연속적이고 부자연스러운 전환과 정지가 생긴다.
지원 범위도 구체적이다. 내비게이션은 0.0m/s에서 6.0m/s의 속도와 0도에서 360도의 방향 명령을 받고 취한 걸음, 부상 보행, 은밀한 이동 같은 스타일을 지원한다. 스쿼트와 무릎보행에서는 pelvis 높이를 0.3m에서 0.8m까지 제어하고, 좁은 공간을 위한 기어가기는 팔꿈치와 무릎으로 0.5m/s까지 전방향 이동한다. 추론은 일반 노트북에서 5ms 미만, Jetson Orin GPU에서 12ms가 걸리고 재계획은 100ms마다 또는 사용자 명령이 갱신되는 즉시 일어난다.
인터페이스와 온보드 배포
영상과 텍스트와 음악 제어는 GEM이 담당한다. GEM은 추정을 제약된 생성으로 보는 통합 모델이며 텍스트와 오디오와 영상 조건을 섞어 받아 human motion을 생성하고, 생성 결과는 human motion encoder를 거쳐 policy로 들어간다. 영상 제어는 라이브 단안 웹캠 스트림도 지원하고 60fps 이상으로 포즈를 추정하므로 전용 mocap 장비 없이 teleoperation이 가능하다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식을 말한다.
VR 인터페이스는 두 가지이고 서로 다른 encoder를 탄다.
| 인터페이스 | 장비 | 스트리밍 신호 | 경유 경로 |
|---|---|---|---|
| VR 전신 teleoperation | PICO 헤드셋, 발목 트래커 2개, 컨트롤러 | 87차원. 전신 관절 위치 63차원, root 방향 quaternion 4차원, 손목 각 6차원, 손가락 관절 14차원 | human motion encoder |
| VR 3-point teleoperation | PICO 헤드셋, 컨트롤러 (발목 트래커 없음) | 상체 SE(3) 포즈 3개(머리와 양 손목), 손가락 관절 각도, 허리 높이, locomotion mode, navigation 명령 | kinematic planner와 hybrid encoder |
3-point 인터페이스는 정밀한 발 배치가 필요 없는 과제를 위한 경량 구성이다. 하체는 planner가 생성하므로 장비가 가볍고 데이터 수집을 확장하기 쉽다. 두 인터페이스가 같은 universal token space를 쓰기 때문에, 어느 쪽으로 모은 시연 데이터(demonstration)든 같은 VLA 학습에 함께 쓸 수 있다.
배포 대상은 관절 29개를 구동하는 Unitree G1이고 추론은 모두 Jetson Orin GPU에서 온보드로 실행한다. TensorRT와 CUDA Graph로 실행 그래프를 미리 기록해 두므로 policy forward는 1ms에서 2ms, 모션 생성은 약 12ms이며 지연 편차가 작다. 시스템은 역할별로 주기가 다른 네 루프를 동시에 실행한다.
| 루프 | 주기 | 역할 |
|---|---|---|
| control loop | 50Hz | observation을 조립하고 encoder와 policy를 호출해 관절 목표를 만든다. 학습 시 시뮬레이션 스텝과 같은 주기 |
| command writer | 500Hz | Unitree 저수준 API로 모터 목표를 스트리밍한다. policy 루프를 막지 않는다 |
| input interface | 100Hz | 조작자 입력을 독립적으로 표본화한다. 키보드, 게임패드, VR, 네트워크 스트림 전환을 지원 |
| kinematic planner | 10Hz | 조작자의 고수준 명령에서 짧은 참조 trajectory를 제안한다 |
인터페이스 전환을 가볍게 만든 설계가 이 스택의 특징이다. 사전 녹화 클립과 planner가 만든 trajectory와 외부 스트림이 모두 같은 모션 시퀀스 구조를 채우므로 control loop는 모션의 출처를 알 필요가 없고, encoder mode가 그 구조의 필드로 실려 있어 소스를 바꾸면 encoder도 자동으로 선택된다. 실물 실험은 전부 가장 큰 42M 모델로 수행했다.
결과
스케일링
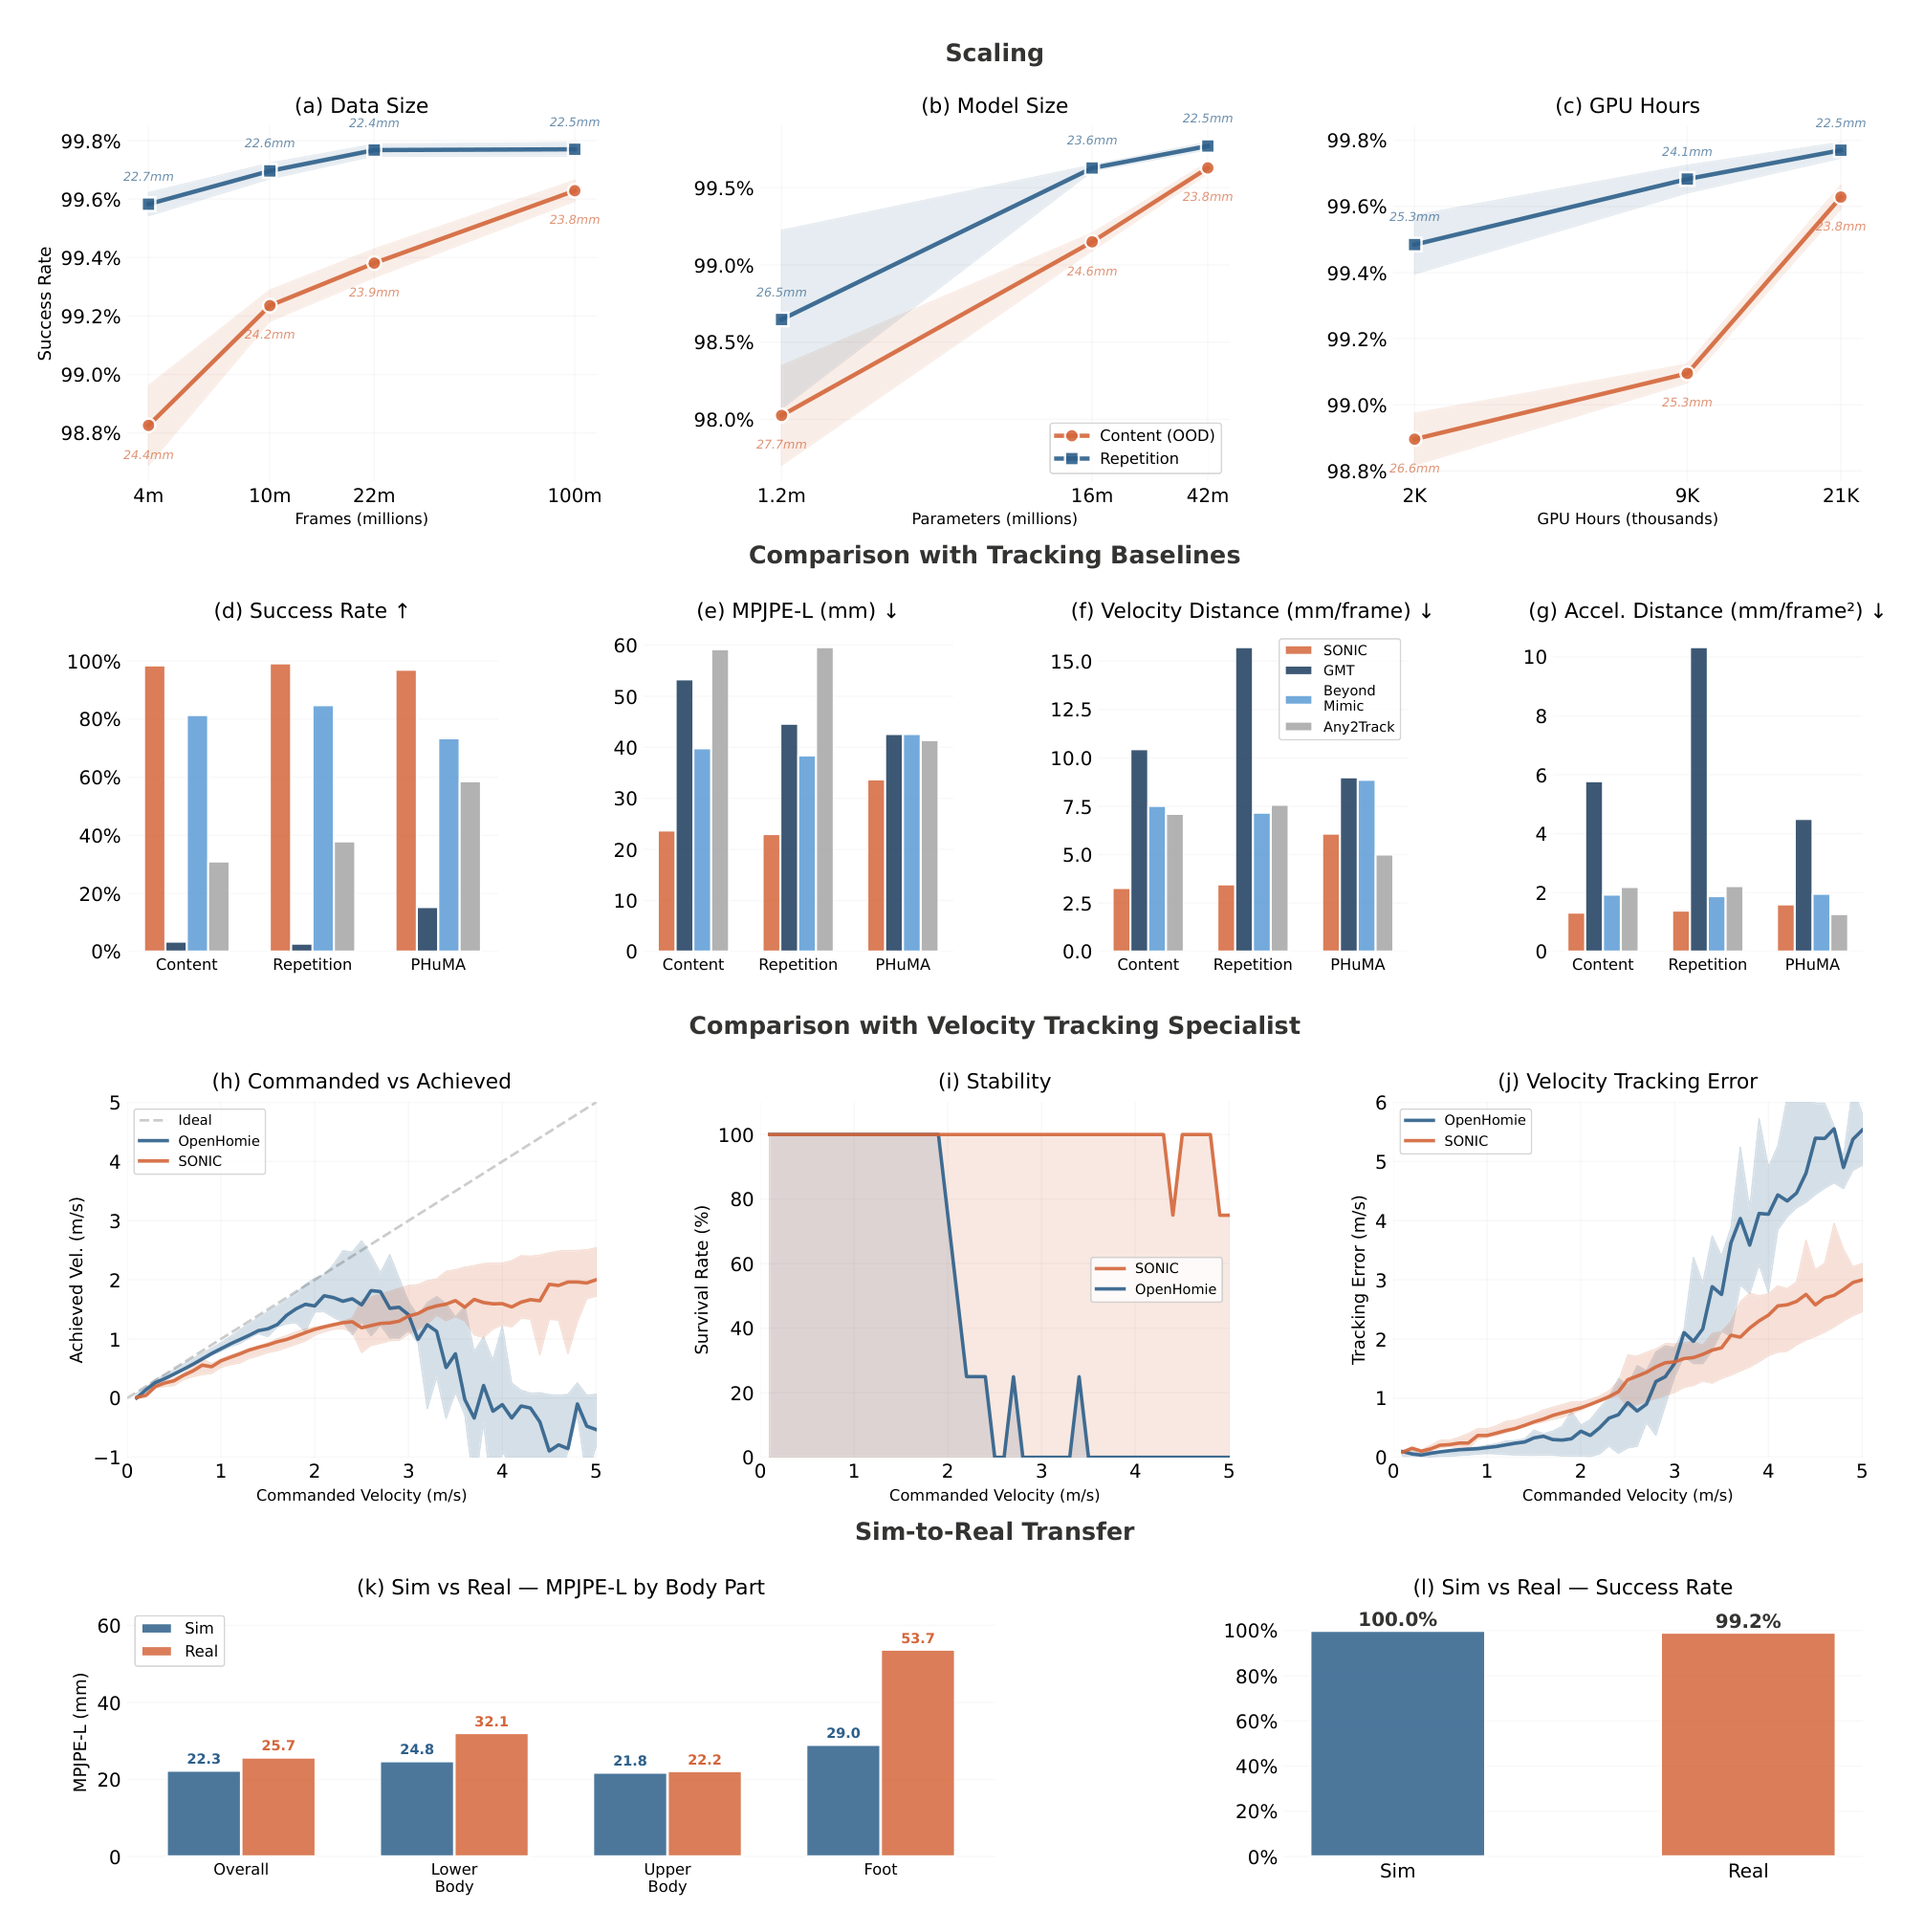
데이터와 모델과 compute 세 기준 모두에서 단조 개선이 나온다. 데이터는 400만, 1000만, 2200만, 1억 프레임(각각 클립 2만, 5만, 11만, 31만 개)으로 늘렸고 작은 부분집합은 sub-category에 걸쳐 균일 샘플링해 분포 다양성을 보존했다. 모델은 1.2M에서 16M을 거쳐 42M 파라미터로, compute는 16, 32, 128 GPU로 각각 50,000 iteration까지 학습해 약 2,000, 9,000, 21,000 GPU hours를 썼다.
| 기준 | 설정 | test-content MPJPE-L | test-repetition MPJPE-L |
|---|---|---|---|
| 데이터 | 400만 프레임 | 24.4mm | 22.7mm |
| 데이터 | 1억 프레임 | 23.8mm | 22.5mm |
| 모델 | 1.2M 파라미터 | 27.7mm | 26.5mm |
| 모델 | 16M 파라미터 | 24.6mm | 23.6mm |
| 모델 | 42M 파라미터 | 23.8mm | 22.5mm |
| compute | 약 2,000 GPU hours | 26.6mm | 25.3mm |
| compute | 약 9,000 GPU hours | 25.3mm | 24.1mm |
| compute | 약 21,000 GPU hours | 23.8mm | 22.5mm |
성공률로 보면 가장 큰 설정이 test-content에서 99.6%이고 가장 작은 1.2M이 98.0%다. 즉 성공률은 이미 포화 구간에 가깝고 규모의 이득은 주로 추종 정확도에서 나타난다.
개선폭이 OOD인 test-content에서 더 크게 벌어진다는 점이 스케일과 일반화를 잇는 근거다. compute 측면에서는 같은 iteration 수라도 GPU가 많을수록 batch가 커져 최적화가 안정되고 최종 성능이 높아진다. 각 설정마다 6개 평가 체크포인트에서 잰 표준편차를 함께 보고했다.
트래커 베이스라인 비교
비교 대상은 GMT, Any2Track, BeyondMimic이고 프로토콜 일관성을 위해 모두 MuJoCo에서 같은 종료 조건으로 평가했다. BeyondMimic은 단일 모션 트래커라 공개 코드로 다중 모션 추종을 다시 학습시켰다.
| 방법 | test-content | test-repetition | PHUMA |
|---|---|---|---|
| SONIC | 98.7% | 99.6% | 97.0% |
| BeyondMimic | 81.6% | 85.8% | 73.4% |
| Any2Track | 31.1% | 38.4% | 58.6% |
추종 정확도에서도 SONIC이 23.2mm MPJPE-L로 BeyondMimic의 39.1mm보다 41% 낮다. 특히 주목할 값은 PHUMA의 97.0%다. PHUMA는 영상 기반 포즈 추정 결과를 다른 retargeting 파이프라인으로 모은 데이터라 자체 held-out 분할보다 분포가 훨씬 먼데도 성능이 유지된다.
다만 해석 범위는 논문 스스로 좁혀 뒀다. Any2Track과 BeyondMimic은 LaFAN, GMT는 AMASS로 학습해 학습 데이터와 retargeting 파이프라인이 통일되지 않았으므로, 이 비교는 데이터 정합 벤치마크가 아니라 cross-dataset 일반화와 스케일 효과의 증거로 읽어야 한다.
specialist와의 대조
가장 날카로운 결과는 속도 추종 전문 컨트롤러와의 비교에서 나온다. OpenHomie는 상체 inverse kinematics 제어와 하체 속도 추종에 최적화된 단일 과제 locomotion 컨트롤러이고, 두 시스템을 MuJoCo에서 0m/s부터 5m/s까지의 명령 범위로 평가했다.
범용 트래커인 SONIC의 전체 생존율이 98.5%인 반면 특화 컨트롤러인 OpenHomie는 43.0%다. OpenHomie의 생존율은 약 1.5m/s를 넘어서면 20% 아래로 하락하는 반면, SONIC은 약 4m/s까지 거의 100%의 안정성을 유지한다.
compute를 늘렸을 때의 반응도 갈린다. OpenHomie는 8 GPU에서 정점을 찍고 32 GPU에서는 오히려 나빠진다.
| 설정 | OpenHomie 속도 추종 오차 | OpenHomie 생존율 |
|---|---|---|
| 1 GPU (환경 4,000개) | 0.290m/s | 93.8% |
| 1 GPU (환경 8,000개) | 0.338m/s | 95.0% |
| 8 GPU | 0.180m/s | 95.0% |
| 32 GPU (4 노드) | 0.288m/s | 91.2% |
저자들은 이 차이를 학습 목적함수의 성격으로 설명한다. 과제 특화 reward engineering은 policy가 목표 동작을 익히고 나면 개선 여지가 포화한다. 반면 motion tracking은 다양한 모션 분포에 대해 프레임 단위 dense supervision을 계속 공급하므로 용량과 데이터 throughput을 늘릴수록 이득이 이어진다.
sim2real 전이
실물 평가는 123개 모션 시퀀스에 대해 시퀀스당 1회 시행으로 진행했다. 성공률은 시뮬레이션 100.0%에서 실제 로봇 99.2%로 거의 유지된다.
| 부위 | 시뮬레이션 MPJPE-L | 실제 로봇 MPJPE-L | 차이 |
|---|---|---|---|
| 전체 | 22.3mm | 25.7mm | +3.4mm |
| 상체 | 21.8mm | 22.2mm | +0.4mm |
| 하체 | 24.8mm | 32.1mm | +7.3mm |
| 발 | 29.0mm | 53.7mm | +24.7mm |
간극이 부위마다 크게 다르다는 것이 이 표의 핵심 정보다. 상체는 0.4mm 차이로 사실상 동일하지만 발은 오차가 두 배 가까이 커진다. 저자들은 실제 접촉 dynamics 아래에서 정밀한 발 배치가 어렵다는 점을 원인으로 든다. dynamics는 상태가 action에 따라 어떻게 변하는지의 규칙을 말한다.
외란에 대한 강건성도 따로 확인했다. policy 실행 중에 약 11kg 물체를 머리 높이 위에서 떨어뜨려도 로봇이 충격을 흡수하고 균형을 유지하며 추종을 이어간다. 복구 모듈이나 policy 적응 없이 얻은 결과다.
VLA 주도 loco-manipulation
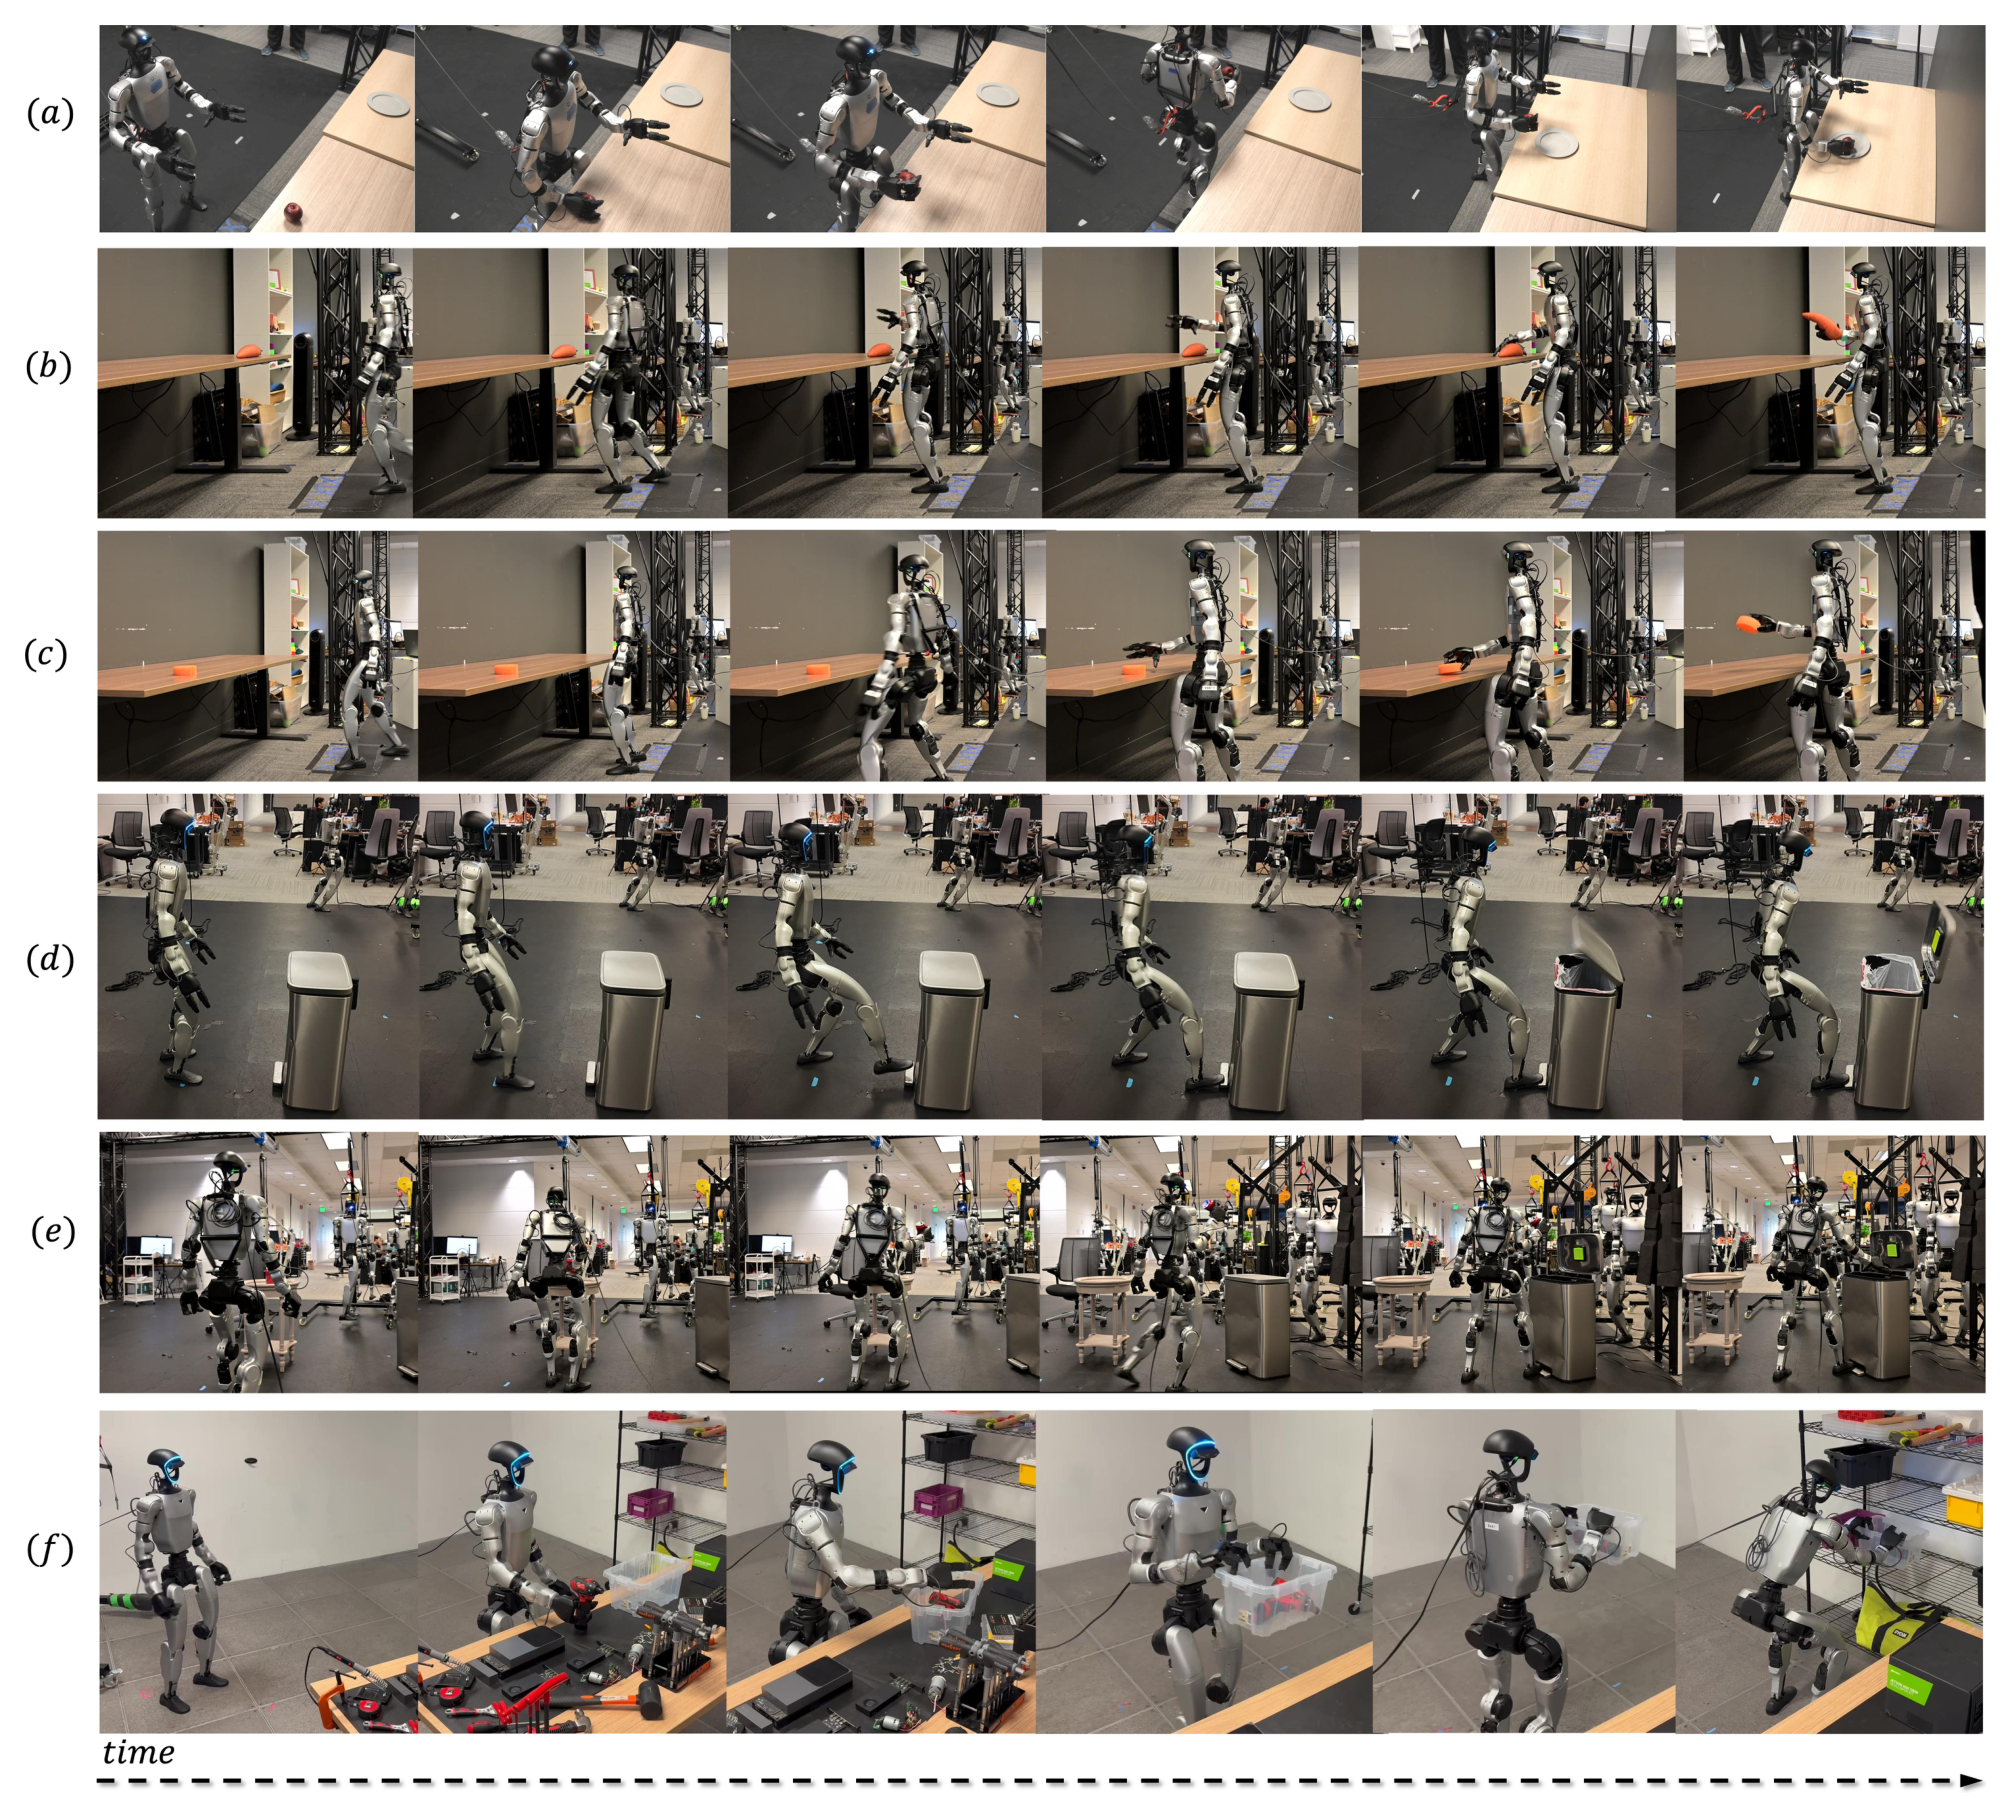
GR00T N1.5를 teleoperation 데이터로 fine-tuning해 universal token 인터페이스에 연결했다. 전신 과제에서 VLA는 universal motion token 64차원과 손 관절 14차원을 합친 78차원 action을 예측하며, 판정은 부분 점수가 없는 이진 판정이다.
| 과제 | 인터페이스 | 학습 데이터 | 시행 | 성공률 |
|---|---|---|---|---|
| Apple to plate | 3-point | 300 trajectory | 20 | 90% |
| Object pickup (carrot) | whole-body | 3,900 trajectory | 20 | 75% |
| Object pickup (scrub) | whole-body | 3,900 trajectory | 20 | 95% |
| Open trash can (foot) | whole-body | 200 trajectory | 10 | 70% |
| Soda can to trash can | whole-body | 1,000 trajectory | 10 | 60% |
| Drill and box relocation | whole-body | 300 trajectory | 10 | 70% |
| 5개 과제 평균 | 75% |
과제 평균 75%는 물체 종류만 다른 두 pickup 변형을 하나의 과제로 묶어 계산한 값이다. 두 변형은 같은 policy를 공유하며 학습 데이터 3,900개는 물체 13종에 각 300개씩 모은 것이고, 테이블 높이를 24인치에서 30인치 사이로, 시작 위치를 무작위로 바꿔 수집했다.
가장 어려운 soda can 과제는 다섯 스킬을 순서대로 이어야 끝난다. 테이블로 걸어가 한 손으로 캔을 들고, 쓰레기통으로 이동해 한 발로 페달을 밟아 뚜껑을 열면서 다른 발로 균형을 잡고, 캔을 던져 넣는다. 즉 손 조작과 발 조작과 동적 균형이 하나의 action 시퀀스 안에서 동시에 요구된다.
쓰레기통 열기 과제는 발을 manipulator로 쓴다는 점에서 성격이 다르다. closed-loop VLA 제어 아래에서 정밀한 발 배치와 한 다리 동적 균형을 요구하며, closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식을 말한다. 상체 제어와 locomotion을 분리하는 action space에서는 만들기 어려운 종류의 동작이다.
3-point 인터페이스를 쓰는 apple to plate 과제만 경로가 다르다. VLA가 universal token이 아니라 teleoperation 포맷 신호(상체 포즈 3개, base 높이, navigation 명령)를 그대로 내면 kinematic planner와 hybrid encoder를 거쳐 policy가 실행한다.
설계 ablation
VLA action space
가장 큰 성능 차이는 VLA가 무엇을 예측하게 하느냐에서 나온다. FSQ 토큰을 예측하는 78차원 구성과 SMPL 전신 포즈와 손 관절을 직접 예측하는 81차원 구성을 비교했다.
| 과제 | FSQ 토큰 | SMPL 포즈 직접 예측 | 차이 |
|---|---|---|---|
| Carrot pickup | 75% | 60% | +15%p |
| Open trash can (foot) | 70% | 20% | +50%p |
| Soda can to trash can | 60% | 0% | +60%p |
| 평균 | 68% | 27% | +42%p |
과제가 복잡할수록 격차가 커진다는 점이 중요하다. 단순한 pickup에서는 15%p 차이지만 여러 단계를 이어야 하는 long-horizon 과제인 soda can에서는 SMPL 직접 예측이 0%로 아예 실패한다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
저자들의 설명은 양자화된 latent의 압축성이다. FSQ 토큰은 저차원 이산 action space라 teleoperation 시연 데이터에서 배우기 쉬운 반면, 고차원 연속 SMPL 포즈 공간은 작은 예측 오차를 큰 추종 실패로 증폭한다. 실제로 SMPL 예측은 급격하고 방향 제어가 나쁜 동작을 냈고 토큰 예측은 눈에 띄게 매끄러웠다.
양자화기 설계
FSQ와 VQ-VAE 비교는 128 GPU 설정에서, 용량 스윕은 compute 제약 때문에 32 GPU에서 수행했다. 따라서 두 묶음의 절대 수치를 직접 비교하면 안 된다.
| 설정 | test-content 성공률 | test-content MPJPE-L | test-repetition 성공률 | test-repetition MPJPE-L |
|---|---|---|---|---|
| FSQ (128 GPU) | 99.3% | 26.6mm | 99.6% | 25.5mm |
| VQ-VAE (128 GPU) | 98.7% | 35.3mm | 99.3% | 32.2mm |
| FSQ-16-16 (32 GPU) | 96.9% | 35.7mm | 97.5% | 32.7mm |
| FSQ-16-32 (32 GPU) | 98.3% | 29.7mm | 98.7% | 28.4mm |
| FSQ-32-16 (32 GPU) | 98.3% | 30.3mm | 98.4% | 28.9mm |
| FSQ-32-32 (32 GPU) | 98.8% | 27.5mm | 99.3% | 26.3mm |
FSQ가 VQ-VAE를 test-content MPJPE-L에서 8.7mm 앞선다. 공정한 비교를 위해 VQ-VAE는 head 4개, codebook 크기 512, 토큰 2개로 용량을 맞춘 다중 head 구성을 썼다.
용량 스윕에서는 레벨보다 토큰 차원의 영향이 크다. 레벨만 16에서 32로 올리면 35.7mm에서 30.3mm가 되지만, 차원만 16에서 32로 올리면 35.7mm에서 29.7mm로 더 크게 개선된다. 즉 다양한 모션을 추종하는 데는 양자화 granularity보다 표현 용량이 더 중요하다.
encoder 3종과 consistency loss
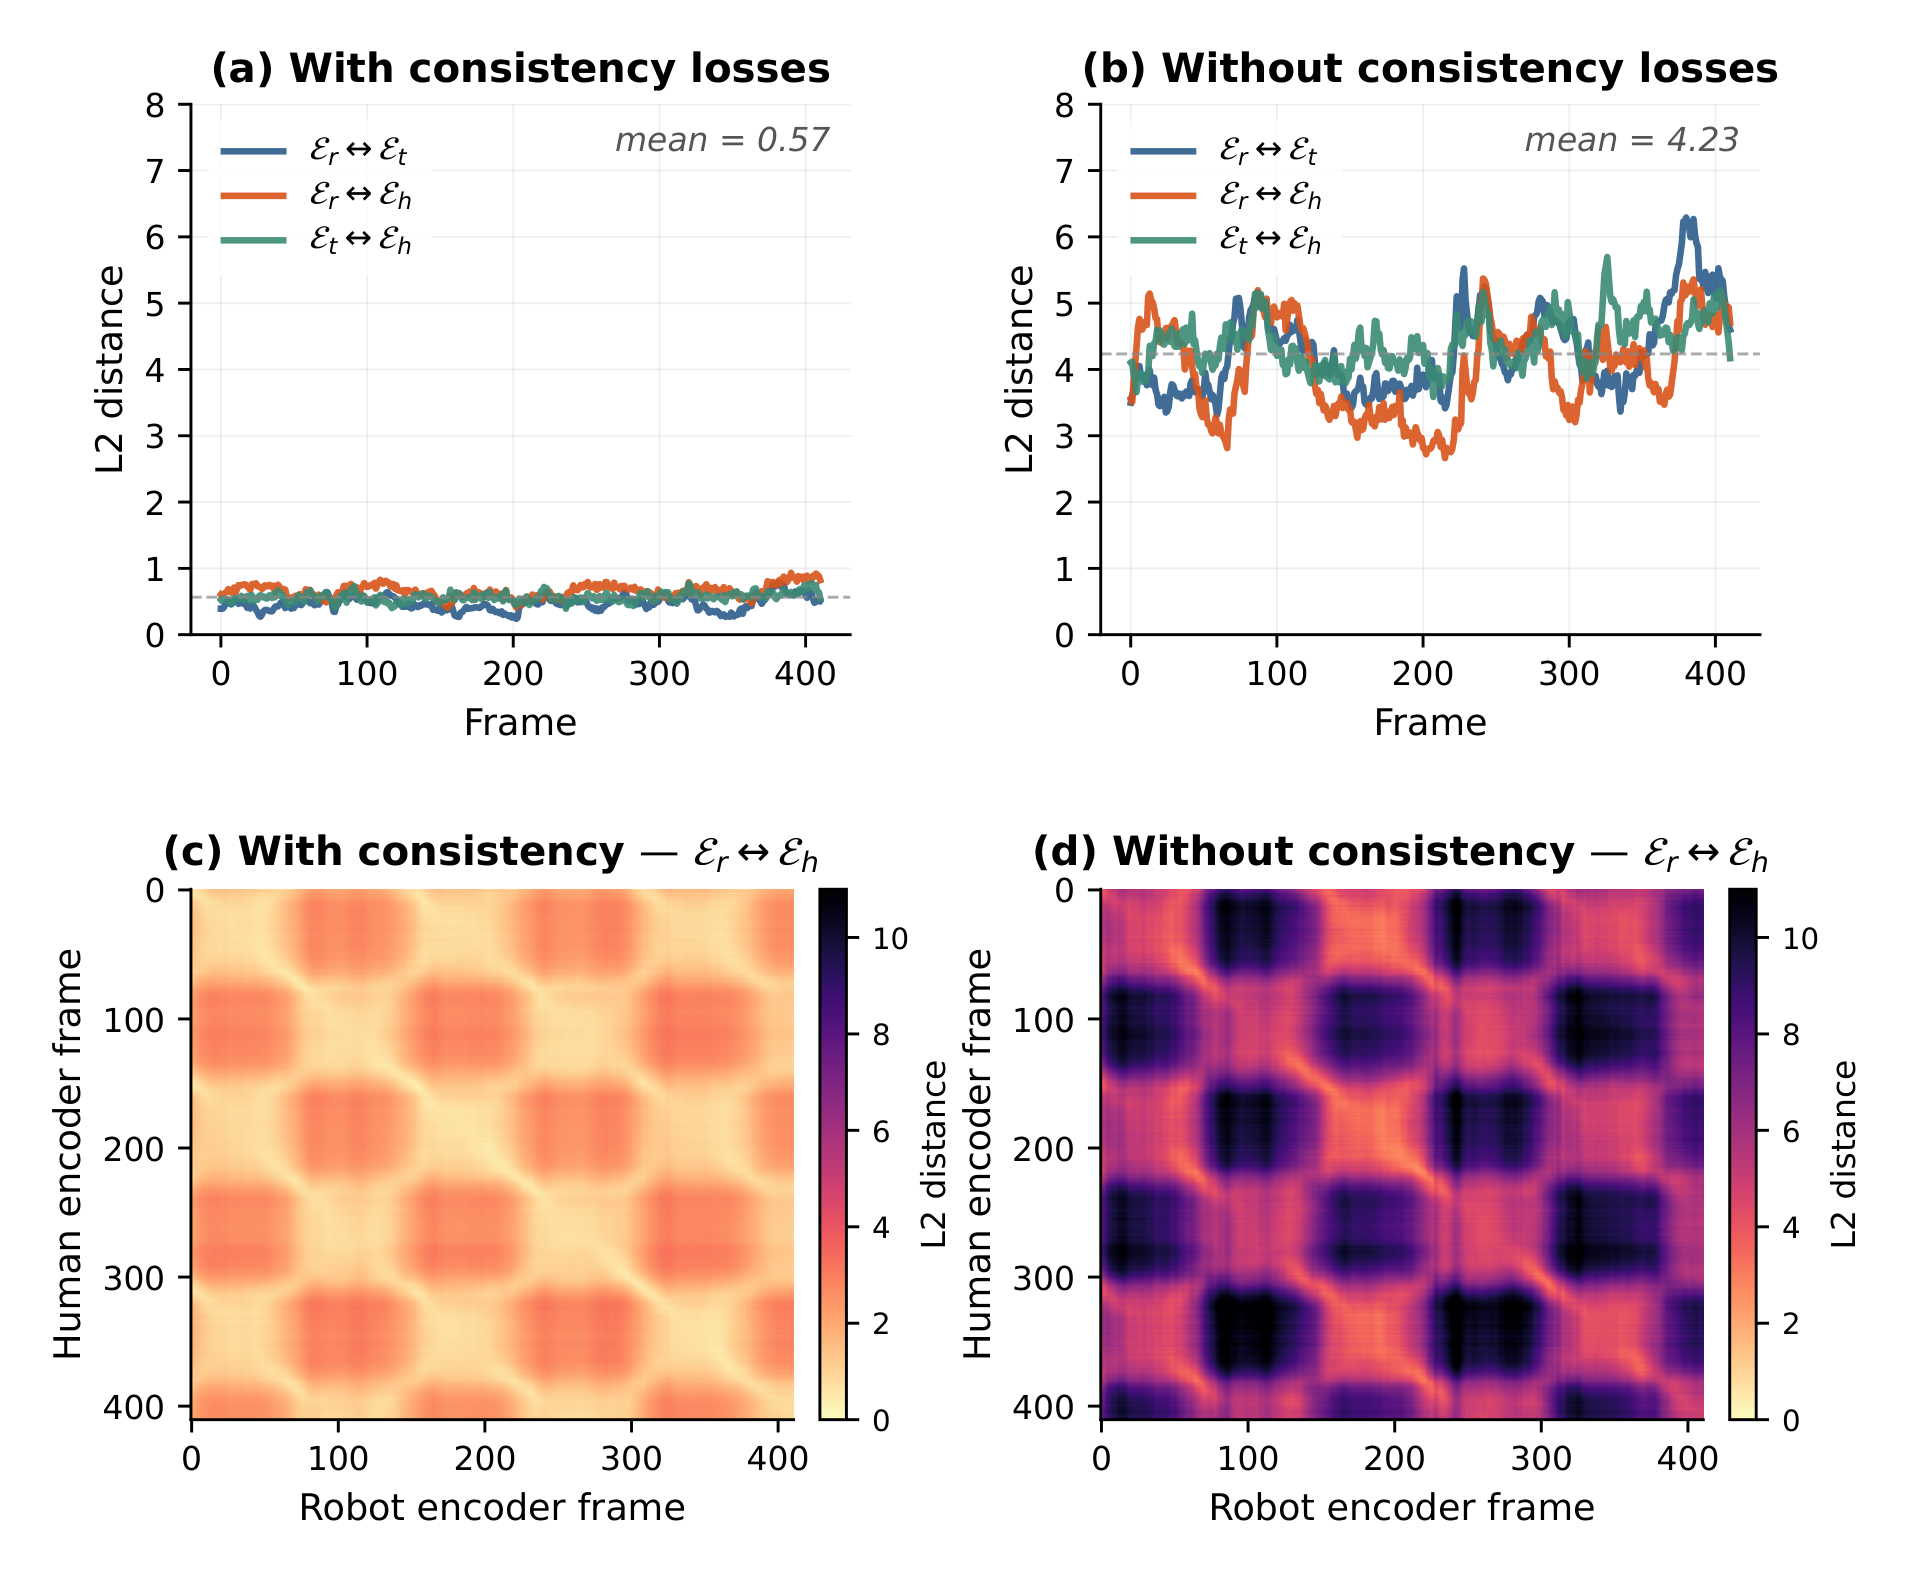
세 encoder는 입력 형식이 전혀 다른데도 모두 99.2% 이상의 성공률을 유지한다.
| encoder | test-content 성공률 | test-content MPJPE-L | test-repetition 성공률 | test-repetition MPJPE-L |
|---|---|---|---|---|
| robot | 99.6% | 23.8mm | 99.8% | 22.5mm |
| human | 99.6% | 24.4mm | 99.8% | 23.1mm |
| hybrid | 99.2% | 26.5mm | 99.7% | 25.2mm |
human encoder가 robot encoder보다 0.6mm 뒤지는 데 그친다는 것은 SMPL 포즈에서 로봇 제어로 가는 변환이 latent 안에서 충분히 이뤄졌다는 뜻이다. hybrid encoder가 2.7mm 뒤지는 이유는 observation이 부분적이기 때문이다. 상체 sparse keypoint만 받으므로 나머지를 추론해야 한다.
토큰 정렬 손실과 순환 일관성 손실을 빼면 encoder 사이 발산이 8배로 커진다. 기어가기 모션에서 encoder 쌍 사이 L2 거리 평균이 0.57에서 4.23으로 뛴다. 이 정렬은 downstream VLA 학습의 전제 조건이다. VLA가 토큰을 직접 예측하는 구조이므로, 서로 다른 encoder로 모은 teleoperation 데이터가 같은 latent 공간에 놓여야 VLA에 일관된 학습 분포를 줄 수 있다.
kinematic planner의 위치
planner는 트래커의 일부가 아니라 그 위에 결합한 응용층이다. 트래커 자체는 모션의 출처를 가리지 않으므로 다른 planner로 교체할 수 있고, 실제로 트래커의 추종 성능은 사전 녹화 참조 모션으로 독립 검증했다. planner가 만든 참조 모션에 대한 강건성은 학습 중의 motion command domain randomization과 배포 시 spring model 필터링에서 온다.
한계
저자들이 명시한 한계는 장기 운용에 필요한 안전성과 에너지 효율을 형식적으로 다루지 않았다는 점이다. 트래커가 planner 출력의 노이즈를 견디도록 설계했지만, 더 극한의 조건이나 매우 동적인 동작에서는 균형을 잃을 수 있다.
추종에 실패하는 동작 범주도 남아 있다. test-content에서 좀비 기어가기와 책상다리 앉기는 추종에 실패했다. 데이터 준비 단계에서 계단 오르기와 착석을 이미 제외했다는 점과 함께 보면, 로봇 형상 자체가 감당하지 못하는 동작이 여전히 존재한다.
베이스라인 비교의 해석 범위는 논문 스스로 좁혀 뒀다. 학습 데이터와 retargeting 파이프라인이 통일되지 않았으므로 데이터 정합 벤치마크로 읽으면 안 된다. 양자화기 용량 스윕도 32 GPU에서 수행해 최종 설정과 조건이 다르다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| motion tracking | 참조 모션의 프레임별 목표 포즈를 물리 시뮬레이션 안의 로봇이 따라가게 하는 과제. reward engineering 없이 dense supervision을 준다 |
| universal token | robot과 human과 hybrid 세 입력이 공통으로 매핑되는 양자화된 latent. VLA의 action space로도 쓰인다 |
| FSQ | Finite Scalar Quantization. 학습된 codebook 없이 차원별 고정 레벨로 latent를 양자화하는 방식이며 codebook collapse가 없다 |
| MPJPE-L | root 상대 좌표계에서 잰 관절 위치 오차의 평균. 14개 body link에서 mm 단위로 계산한다 |
| test-content / test-repetition | 학습에 없던 sub-category만 모은 분할과, sub-category는 겹치되 클립이 다른 분할. 각각 새 동작 내용과 새 수행에 대한 일반화를 잰다 |
| hybrid motion | 상체 sparse keypoint와 하체 로봇 모션을 합친 명령 형식. VR 3-point teleoperation에 대응한다 |
| reference lookahead | encoder가 현재 프레임 이후 몇 초 분량의 참조 모션을 미리 받는지를 가리키는 값. SONIC은 robot과 hybrid가 1.0초, human이 0.2초다 |
관련 페이지
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): 이 논문의 공식 구현 저장소. 학습 코드와 C++ 배포 스택과 G1 체크포인트가 들어 있어 여기 적은 방법을 실행 가능한 형태로 확인할 수 있다.
- GEAR-SONIC 프로젝트 페이지 (SONIC 공식 데모): 같은 프로젝트의 공식 데모 페이지. MPJPE-L 수치로는 판단하기 어려운 동작의 질을 영상으로 남긴 곳이다.
- GR00T N1.5: universal token을 action space로 받아 loco-manipulation을 수행한 VLA foundation model.
- World Model for Robot Learning: A Comprehensive Survey: robot learning 서베이. SONIC은 world model 없이 dense mocap supervision으로 가는 경로라서, 서베이가 정리한 미래 예측 계열과 대비해 읽으면 두 접근의 분기점이 보인다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 기준과 학습 경로 허브.