Physical AI · PAPER · 2025
Cosmos World Foundation Model Platform for Physical AI
요약
Cosmos는 NVIDIA가 Physical AI 개발자에게 world model 전체를 넘겨주려고 만든 플랫폼이다. world model은 환경의 dynamics를 학습해 미래를 예측하는 모델을 말한다. 여기에 foundation을 붙인 world foundation model은 특정 로봇 하나가 아니라 여러 downstream 환경으로 fine-tuning될 것을 전제로 학습한 범용 world model을 가리키며, 논문은 이를 WFM으로 줄여 쓴다.
논문이 한 묶음으로 공개한 것은 다섯 가지다. 2천만 시간 분량 영상을 거르는 curation 파이프라인, continuous와 discrete 두 종류의 video 토크나이저, diffusion 계열과 autoregressive 계열을 합친 pre-trained 모델 8종, post-training 사례 세 건, 입력과 출력을 함께 검사하는 Guardrail이다. 학습에는 H100 1만 장을 3개월 썼고 가중치는 NVIDIA Open Model License로 공개했다.
이 논문의 성격은 단일 모델 제안이 아니라 플랫폼 공개다. 따라서 개별 모델의 절대 성능보다, pre-training으로 generalist를 만들고 post-training으로 환경별 특화 모델을 얻는 구도와 그 구도를 지탱하는 부품 목록을 함께 읽는 것이 적절하다.
배경
Physical AI는 센서로 세상을 보고 액추에이터로 세상을 바꾸는 AI 시스템을 가리킨다. 논문은 이 분야가 데이터 확장에서 막혀 있다는 진단에서 출발한다.
막히는 이유는 필요한 데이터의 형태에 있다. Physical AI를 학습시키려면 observation과 action이 번갈아 이어진 시퀀스가 있어야 하는데, 그 action이 물리 세계를 실제로 건드려 기기와 환경을 손상시킬 수 있다. observation은 매 timestep에 시스템이 받는 센서 입력이고, action은 시스템이 내보내는 제어 명령이다. 탐색적 action이 필수인 초기 단계일수록 위험이 커진다.
WFM은 이 문제에 대한 답으로 제시된다. Physical AI가 안전하게 상호작용할 수 있는 물리 세계의 디지털 트윈을 만들어 두면 실제 기기를 손상시키지 않고도 데이터와 평가를 얻을 수 있다. 논문 초록은 Physical AI에 디지털 트윈이 둘 필요하다고 적는다. 자기 자신의 디지털 트윈이 policy 모델이고 세상의 디지털 트윈이 world model이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
핵심 개념
WFM의 형식화
WFM은 과거 영상 x(0:t)와 현재 perturbation c(t)를 받아 다음 상태 x(t+1)을 내놓는 함수다. perturbation은 world model이 미래를 예측할 때 함께 받는 현재 입력을 가리키며, Physical AI가 취한 action일 수도 있고 무작위 입력일 수도 있으며 그 입력을 서술한 텍스트일 수도 있다.
이 추상화가 논문 전체의 뼈대다. 즉 텍스트 조건 생성, 과거 영상 조건 생성, camera pose 조건 생성, trajectory 조건 생성이 모두 perturbation의 한 형태로 같은 틀에 들어간다.
pre-training과 post-training
Cosmos는 WFM을 pre-trained와 post-trained 둘로 나눈다. pre-trained WFM은 대규모 다양한 영상으로 학습한 generalist이고, post-trained WFM은 목표 환경에서 모은 훨씬 작은 데이터로 특화시킨 모델이다.
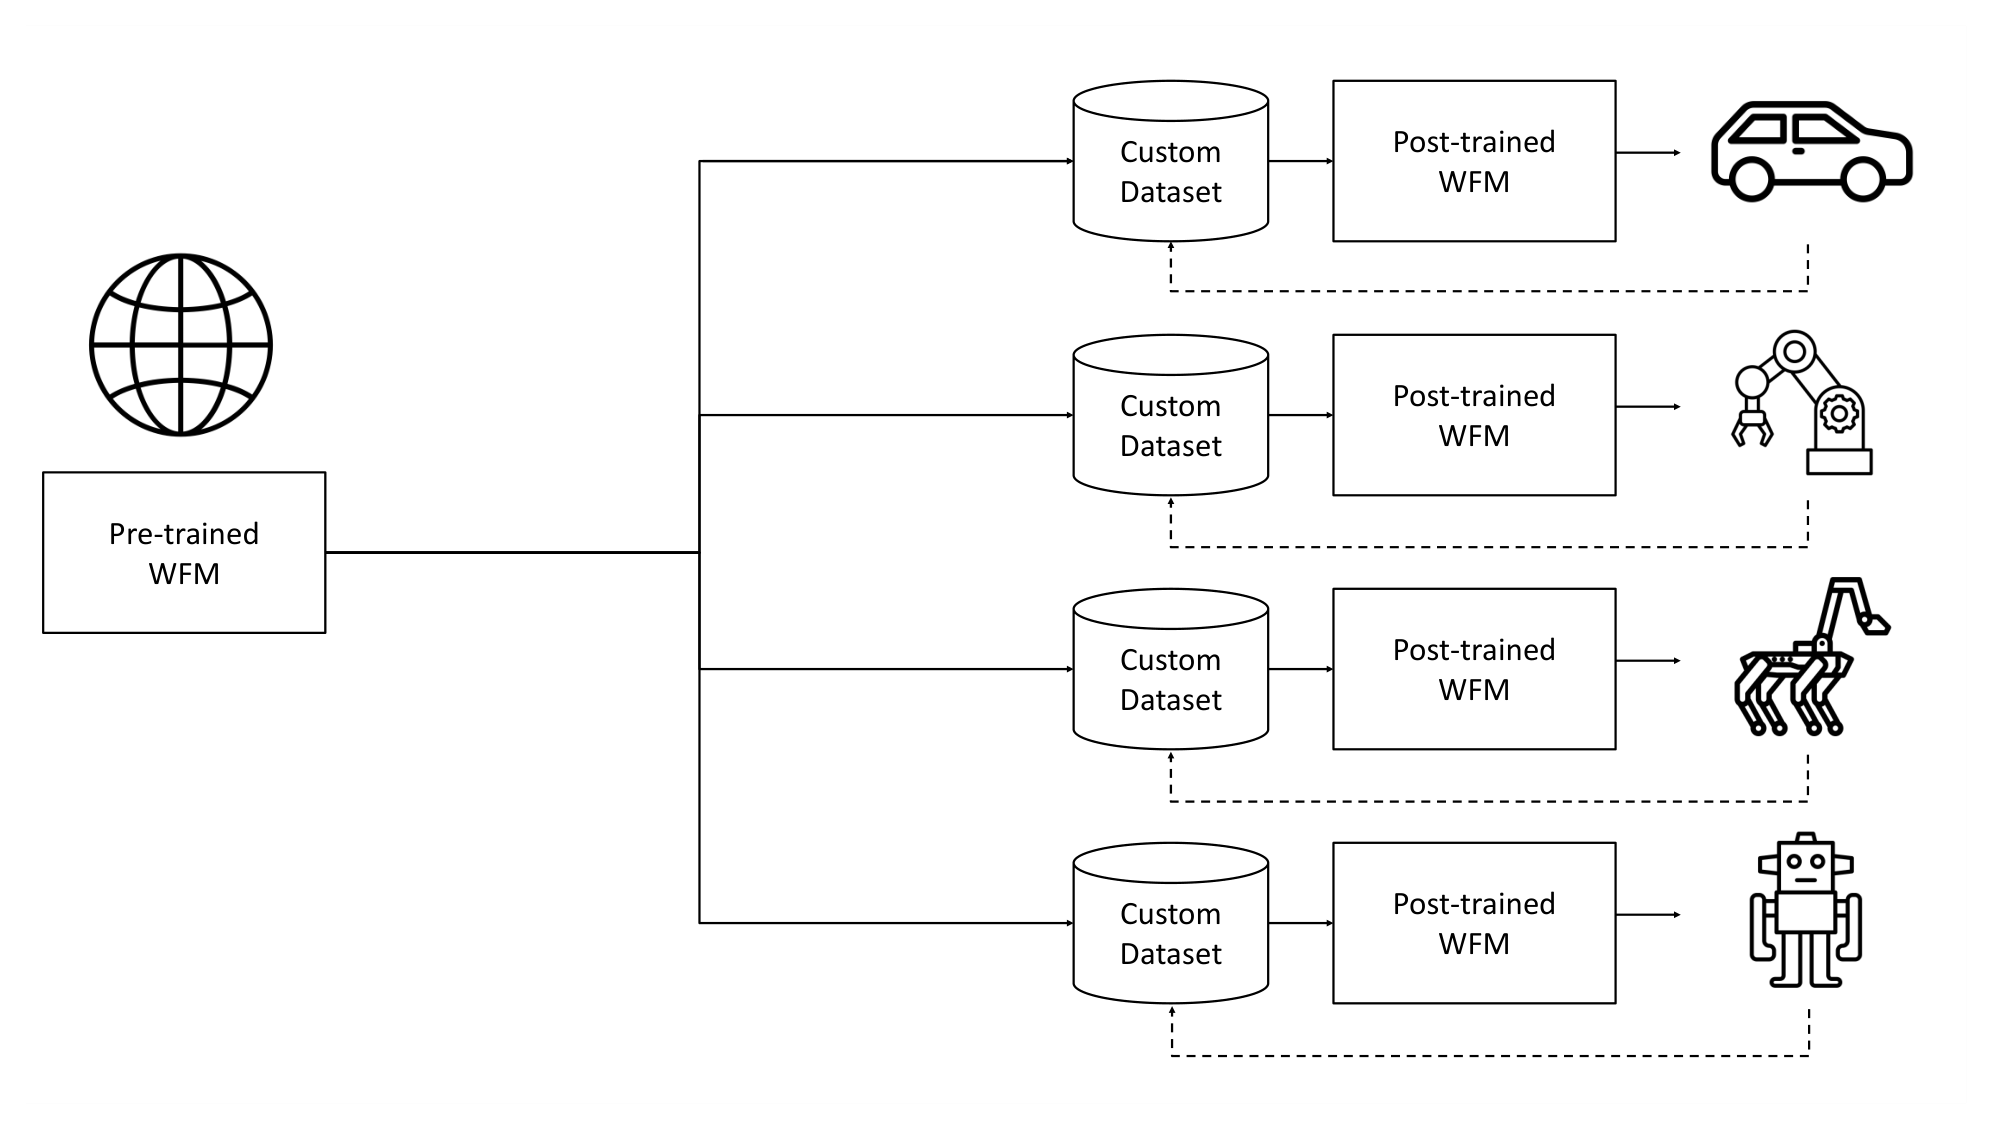
post-training 데이터는 목표 환경에서 수집한 prompt와 영상의 쌍이다. prompt 자리에는 텍스트뿐 아니라 action 명령이나 trajectory가 들어갈 수 있어서, 같은 pre-trained 모델이 자율주행 차량용으로도 humanoid용으로도 갈라져 나온다.
이 분리가 비용 구조를 바꾼다. 개발자는 2천만 시간짜리 영상 수집과 H100 1만 장 학습을 되풀이하지 않고, 자기 환경에서 모은 소량 데이터로 fine-tuning만 하면 된다.
WFM의 쓰임새
논문 2.1절은 WFM이 Physical AI 개발에서 쓰일 다섯 가지 방식을 든다.
| 쓰임새 | 내용 |
|---|---|
| policy evaluation | 실제 기기에 올리지 않고 WFM 안에서 policy를 실행해 가망 없는 후보를 걸러낸다 |
| policy initialization | dynamics를 이미 배운 WFM을 policy의 초기값으로 삼아 데이터 부족을 메운다 |
| policy training | reward 모델과 짝지어 강화학습 환경으로 쓴다 |
| planning과 model-predictive control | 여러 action 시퀀스의 결과를 미리 시뮬레이션해 가장 좋은 것을 고른다 |
| 합성 데이터 생성 | depth나 semantic map 같은 렌더링 메타데이터에 조건을 걸어 학습 데이터를 만든다 |
저자들은 이 목록에 대한 실증 결과가 이 논문에 없다고 직접 밝힌다. 따라서 다섯 항목은 검증된 성과가 아니라 향후 계획으로 읽어야 한다.
continuous 토큰과 discrete 토큰
토크나이저는 영상을 압축된 토큰으로 바꾸고 다시 복원하는 인코더-디코더다. Cosmos는 성격이 다른 두 종류를 함께 만들었다.
| 종류 | 출력 형태 | 쓰는 모델 | 대표 설정 |
|---|---|---|---|
| continuous | C차원 임베딩 벡터 | diffusion 계열 | Cosmos-Tokenize1-CV8×8×8-720p |
| discrete | 양자화된 정수 인덱스 | autoregressive 계열 | Cosmos-Tokenize1-DV8×16×16-720p |
두 계열을 모두 만든 이유는 각자 다른 강점이 있어서다. diffusion은 생성 품질이 높고, autoregressive는 LLM 커뮤니티가 쌓아 둔 학습과 추론 기법을 그대로 물려받을 수 있다.
방법
플랫폼 구성
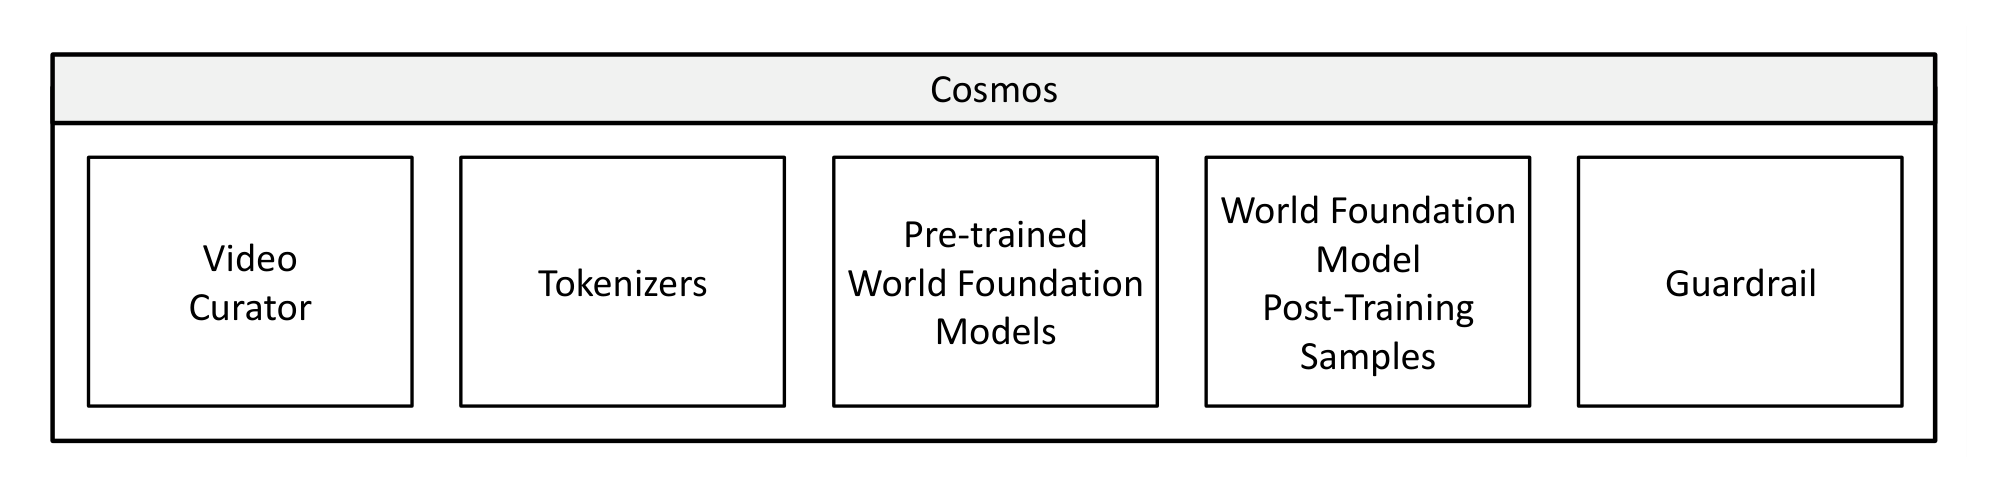
| 구성 요소 | 역할 |
|---|---|
| Video Curator | 2천만 시간 raw 영상에서 학습에 쓸 수 있는 클립을 뽑는다 |
| Tokenizer | 영상을 continuous 또는 discrete 토큰으로 압축하고 복원한다 |
| pre-trained WFM | diffusion 4종과 autoregressive 4종의 generalist 모델 |
| post-training 샘플 | camera control, robot manipulation, 자율주행 세 가지 적용 예 |
| Guardrail | 입력 텍스트와 출력 영상을 각각 검사해 유해 생성을 막는다 |
데이터 curation
raw 데이터는 720p부터 4k까지 약 2천만 시간이다. 자체 보유분과 공개 인터넷 영상을 섞었고, Physical AI 응용을 겨냥해 카테고리 비율을 미리 정해 두었다.
| 카테고리 | 비율 |
|---|---|
| 자연 현상 | 20% |
| 손동작과 물체 조작 | 16% |
| 공간 인지와 내비게이션 | 16% |
| 주행 | 11% |
| 사람의 움직임 | 10% |
| 1인칭 시점 | 8% |
| 역동적 카메라 | 8% |
| 합성 렌더링 | 4% |
| 기타 | 7% |
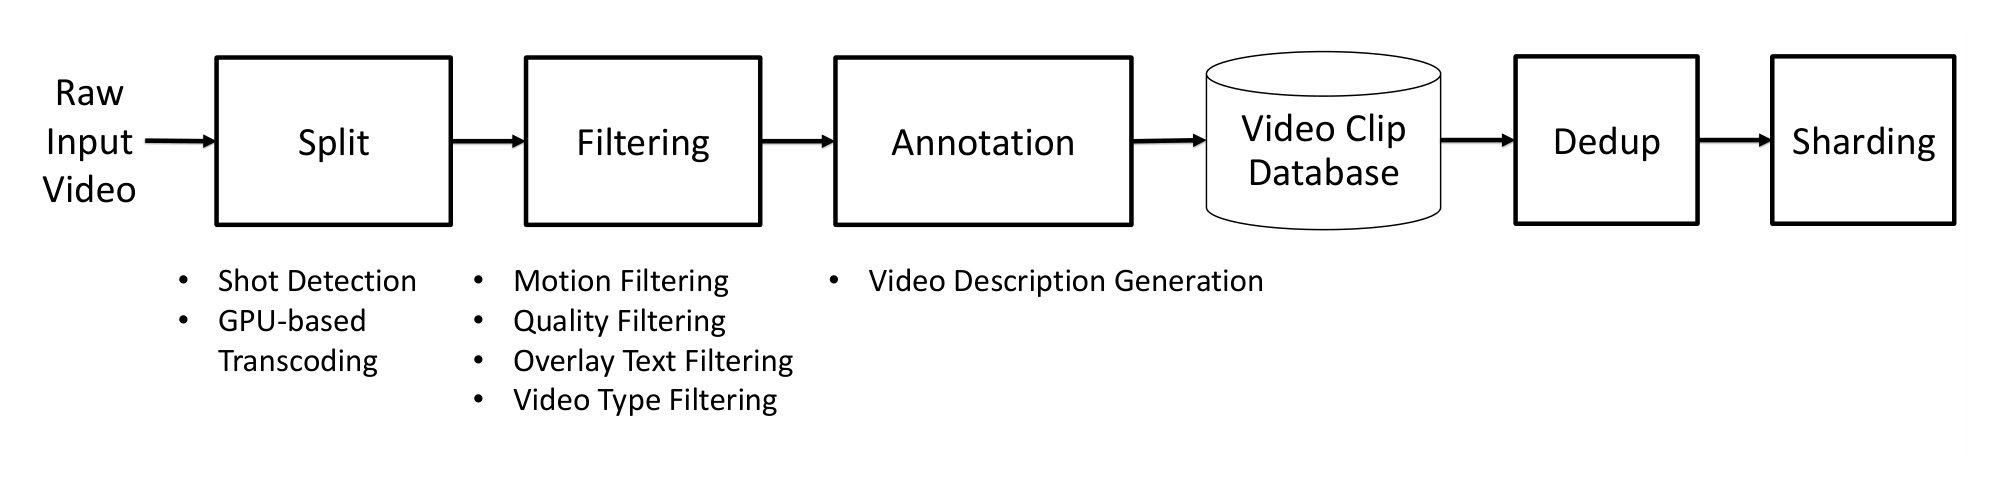
파이프라인은 다섯 단계로 이어진다.
- split: shot 전환을 찾아 잘라낸다. 2초 미만 클립은 버리고 60초 초과 클립은 다시 쪼갠다
- filtering: 움직임, 화질, 오버레이 텍스트, 영상 유형 네 항목으로 거른다
- annotation: VLM이 256프레임마다 캡션을 붙인다
- dedup: 의미 기준 중복 제거로 학습 데이터의 약 30%를 덜어낸다
- sharding: 해상도와 종횡비와 길이별로 묶어 webdataset으로 만든다
결과는 pre-training용 약 1억 개 클립과 fine-tuning용 약 1천만 개 클립이다.
shot 분할은 알고리즘 선택이 결과를 크게 가른다. 저자들은 ShotBench라는 자체 벤치마크를 만들어 네 방법을 비교했다.
| 데이터셋 | PySceneDetect | Panda70M | TransNetV2 | AutoShot |
|---|---|---|---|---|
| BBC | 0.889 | 0.777 | 0.967 | 0.952 |
| RAI | 0.831 | 0.829 | 0.919 | 0.906 |
| SHOT | 0.718 | 0.622 | 0.821 | 0.834 |
| ClipShots | 0.477 | 0.513 | 0.726 | 0.711 |
표의 값은 F1 점수다. 색 히스토그램 임계값을 쓰는 PySceneDetect와 CLIP 임베딩을 덧붙인 Panda70M보다, 학습 기반인 TransNetV2와 AutoShot이 네 데이터셋 모두에서 앞선다. 최종 선택은 TransNetV2인데, 편집이 심한 어려운 전환에서 더 낫고 GPU 가속으로 throughput을 올리기 쉽다는 이유에서다.
transcoding 단계에서는 하드웨어 활용이 throughput을 결정한다. throughput은 정해진 시간 안에 처리해낸 양을 뜻한다. NVIDIA L40S는 디코더(NVDEC)와 인코더(NVENC)를 모두 갖고 있어, NVDEC만 있는 H100보다 throughput이 약 17% 높다(초당 영상 0.0674개 대 0.0574개). 여기에 ffmpeg 대신 PyNvideoCodec을 쓰면 초당 0.3702개까지 올라가고, 개선을 모두 합치면 throughput이 약 6.5배가 된다.
filtering의 네 항목은 각각 다른 모델이 맡는다.
- 움직임: optical flow를 입력으로 받는 ViT 분류기를 쓴다. TensorRT로 가속한 optical flow 추정망을 입력으로 삼을 때 정확도가 가장 높았다
- 화질: 사람이 채점한 영상으로 학습한 DOVER 기반 품질 모델로 하위 15%를 버린다. 미적 점수 기준은 3.5로 느슨하게 잡았는데, Physical AI에는 미적 완성도가 덜 중요해서다
- 오버레이 텍스트: InternVideo2 임베딩을 받는 MLP 이진 분류기를 쓴다. 원래 장면에 있던 글자가 아니라 후처리로 덧붙인 자막을 겨냥한다
- 영상 유형: 자체 분류 체계로 라벨을 붙여 추상 패턴과 게임 화면과 애니메이션을 제외하고, 사람의 행위와 관련된 카테고리는 upsampling한다
annotation은 VILA 13B를 영상 캡션용으로 fine-tuning해 쓴다. 클립에서 8프레임을 균등 추출해 넣으면 평균 559자, 97단어짜리 캡션이 나온다. FP8로 양자화한 TensorRT-LLM 엔진을 쓰면 throughput이 PyTorch FP16 기준 초당 0.21개에서 1.96개로 약 10배가 된다.
중복 제거는 SemDeDup과 DataComp의 방식을 따른다. filtering에서 이미 계산한 InternVideo2 임베딩을 다시 써서 k=10,000으로 k-means 군집을 만들고, 군집 안에서만 쌍별 거리를 계산해 중복을 찾는다. 중복이 발견되면 해상도가 가장 높은 영상을 남긴다.
infra는 Ray 기반 스트리밍 파이프라인이다. 데이터 전송과 연산을 분리해 메모리 요구가 데이터셋 크기가 아니라 파이프라인 복잡도에 비례하게 만들고, 네트워크 대역폭과 NVDEC와 GPU 연산을 동시에 쓰도록 단계별 병렬화를 잡았다.
토크나이저
Cosmos Tokenizer의 설계 특징은 wavelet 공간 동작과 시간 방향 causality다. 입력은 먼저 2단계 wavelet 변환을 거쳐 x, y, t 세 방향으로 각각 4배 줄어들고, 이후 단계는 현재와 과거 프레임만 보고 계산한다. wavelet 변환을 앞에 두는 이유는 픽셀 수준의 중복을 먼저 걷어내 나머지 layer가 의미 수준 압축에 집중하게 하기 위해서다.
causality에는 이점이 둘 붙는다. 단일 프레임을 넣으면 그대로 이미지 토크나이저가 되므로 이미지와 영상을 한 네트워크로 함께 학습시킬 수 있고, 인과 순서로 동작하는 Physical AI 시스템과 성격이 맞는다.
내부 구조는 residual block과 downsampling block을 번갈아 쌓은 형태다. 3D convolution은 공간(1×k×k)과 시간(k×1×1)으로 나눠 적용하고, 시간축에는 k-1만큼 왼쪽 padding을 넣어 causality를 지킨다. 정규화는 GroupNorm 대신 LayerNorm을 쓰는데, latent나 복원 결과의 특정 영역에 큰 값이 몰리는 현상을 막기 위해서다.
continuous 쪽은 KL 항이 없는 순수 autoencoder로 16차원 latent를 내놓는다. discrete 쪽은 FSQ로 6차원 latent를 (8, 8, 8, 5, 5, 5) 레벨로 양자화해 어휘 크기 64,000의 정수 인덱스를 만든다. 두 경우 모두 latent에는 보조 손실을 걸지 않고 디코더 최종 출력만 지도한다.
학습은 2단계다. 1단계는 픽셀 L1 손실과 VGG-19 기반 perceptual 손실을 쓰고, 2단계는 시간 방향 부드러움을 위한 optical flow 손실과 선명도를 위한 Gram matrix 손실을 더한다. 마지막 fine-tuning 단계에서는 adversarial 손실을 추가해 높은 압축률에서의 디테일을 살린다.
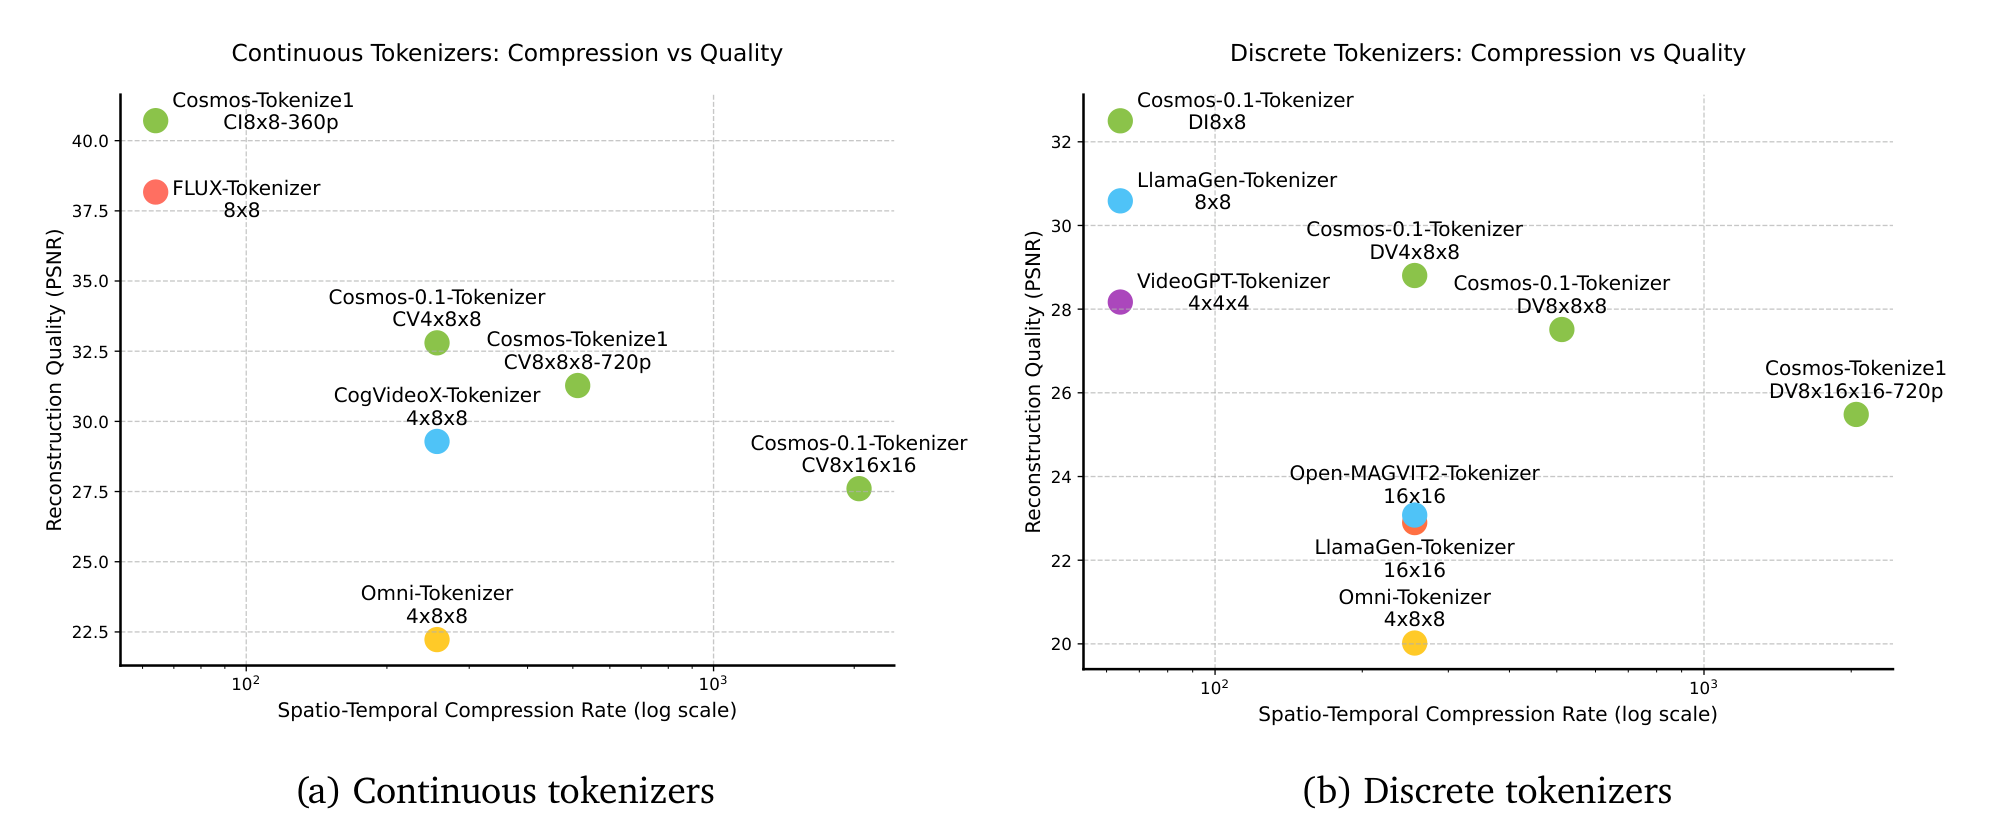
성능은 압축률과 복원 품질의 절충으로 읽는다. DAVIS 영상에서 기존 최고 대비 PSNR이 4dB 올랐고 최대 12배 빠르며, A100 80GB 한 장에서 1080p 8초 또는 720p 10초를 메모리 초과 없이 한 번에 인코딩한다.
| 토크나이저 | DAVIS PSNR | TokenBench PSNR |
|---|---|---|
| CogVideoX-Tokenizer 4×8×8 | 29.29 | 32.06 |
| Omni-Tokenizer 4×8×8 | 22.23 | 24.48 |
| Cosmos-Tokenize1-CV4×8×8-360p | 35.85 | 38.42 |
| Cosmos-Tokenize1-CV8×8×8-720p | 31.28 | 35.13 |
같은 4×8×8 압축률에서 Cosmos가 CogVideoX보다 DAVIS PSNR이 6.56dB 높다. 압축률을 8×8×8로 두 배 높인 설정도 CogVideoX의 4×8×8보다 여전히 앞선다. 즉 더 세게 압축하면서 품질도 유지한다.
런타임에서도 격차가 있다. 720×1280 영상 기준 프레임당 인코딩과 디코딩 시간이 CogVideoX 414ms, Omni-Tokenizer 82.9ms인 데 비해 Cosmos-0.1-Tokenizer-CV4×8×8은 34.8ms이고 파라미터 수도 더 적다.
평가용으로는 TokenBench를 새로 만들어 공개했다. BDD100K, EgoExo-4D, BridgeData V2, Panda-70M에서 각각 영상 100개씩 뽑아 앞 10초를 잘라 쓰는 영상 500개짜리 세트로, 주행과 1인칭 시점과 robot manipulation을 한 벤치마크에 담는다.
모델 지도
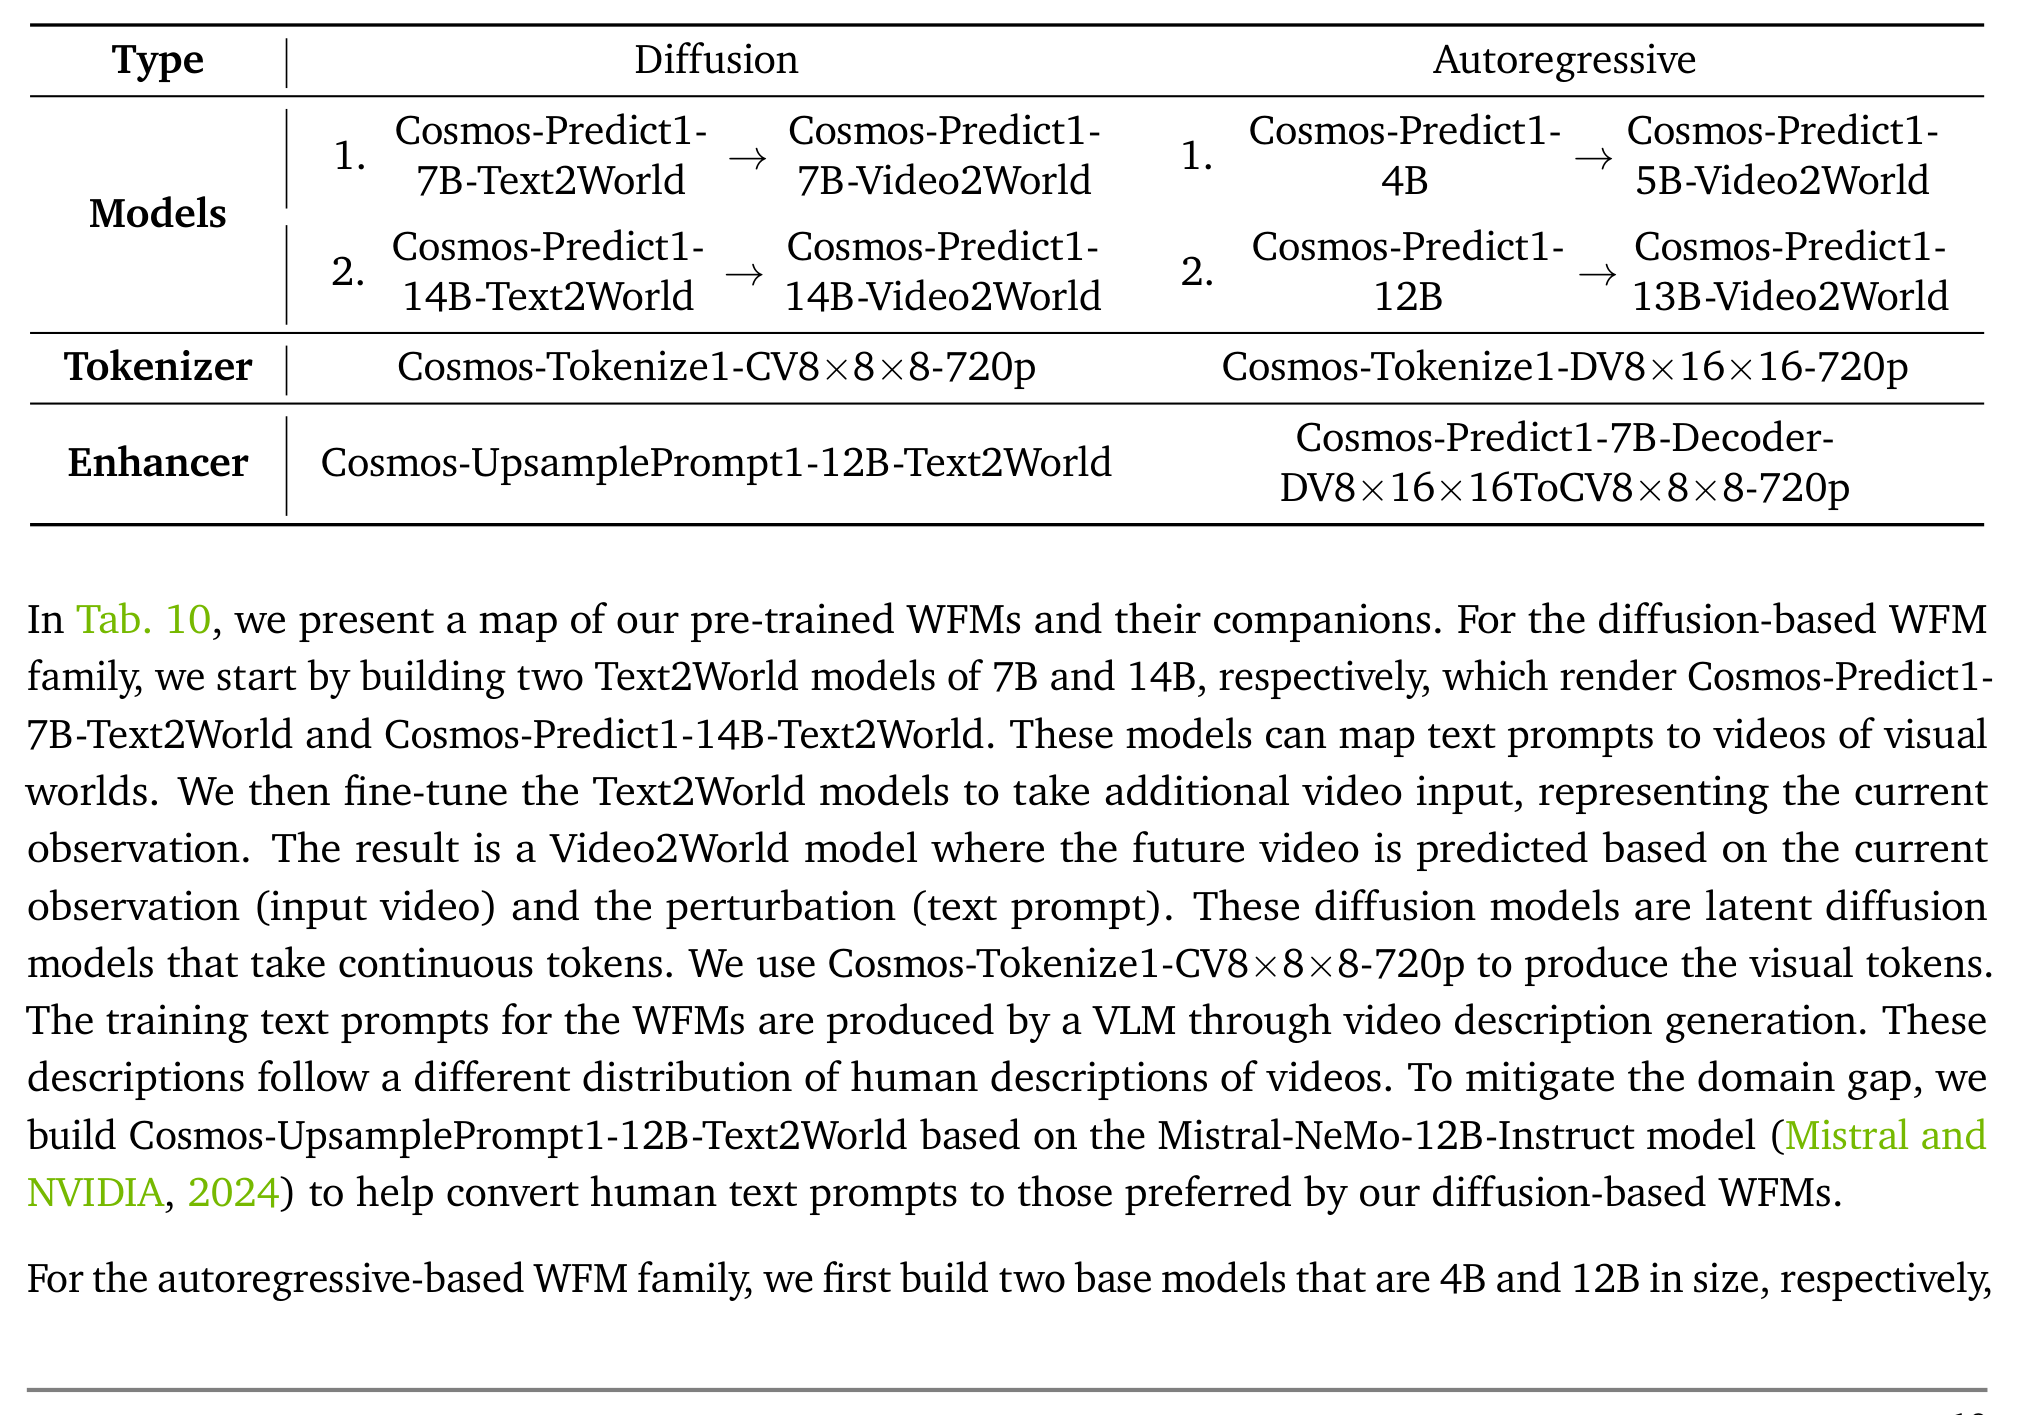
| 계열 | base 모델 | Video2World 파생 | 토크나이저 | enhancer |
|---|---|---|---|---|
| diffusion | 7B-Text2World, 14B-Text2World | 7B-Video2World, 14B-Video2World | CV8×8×8-720p | prompt upsampler (12B) |
| autoregressive | 4B, 12B | 5B-Video2World, 13B-Video2World | DV8×16×16-720p | diffusion decoder (7B) |
두 계열의 구성이 대칭이다. 각각 base 모델 둘과 파생 모델 둘을 두고, 계열별 약점을 보완하는 enhancer를 하나씩 붙였다. diffusion 쪽 약점은 학습 캡션과 사용자 prompt의 분포 차이이고, autoregressive 쪽 약점은 discrete 토큰의 압축 왜곡이다.
Text2World는 텍스트만 받아 영상을 만드는 모드이고, Video2World는 과거 영상에 텍스트를 더해 미래를 잇는 모드다. 두 계열 모두 base 모델을 먼저 학습한 뒤 영상 조건을 받도록 fine-tuning해 Video2World를 얻는다.
diffusion 계열 WFM
diffusion 계열은 토크나이저가 만든 latent 위에서 동작하는 latent diffusion이다. 학습 목표는 EDM의 denoising score matching이며, 저자들은 최근 영상 생성 모델이 쓰는 flow matching 형식화와 이론적으로 동등하고 preconditioning 설계와 하이퍼파라미터만 다르다고 적었다. flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이다.
손실 설계에 한 가지 장치가 들어간다. 노이즈 레벨별 손실을 다중 과제 학습으로 보고, 불확실성 함수 u(σ)를 MLP로 두어 모델이 자신 없어 하는 레벨의 기여를 낮춘다. 동시에 그 불확실성 자체에 벌점을 부과해 u(σ)가 커지는 방향을 억제한다.
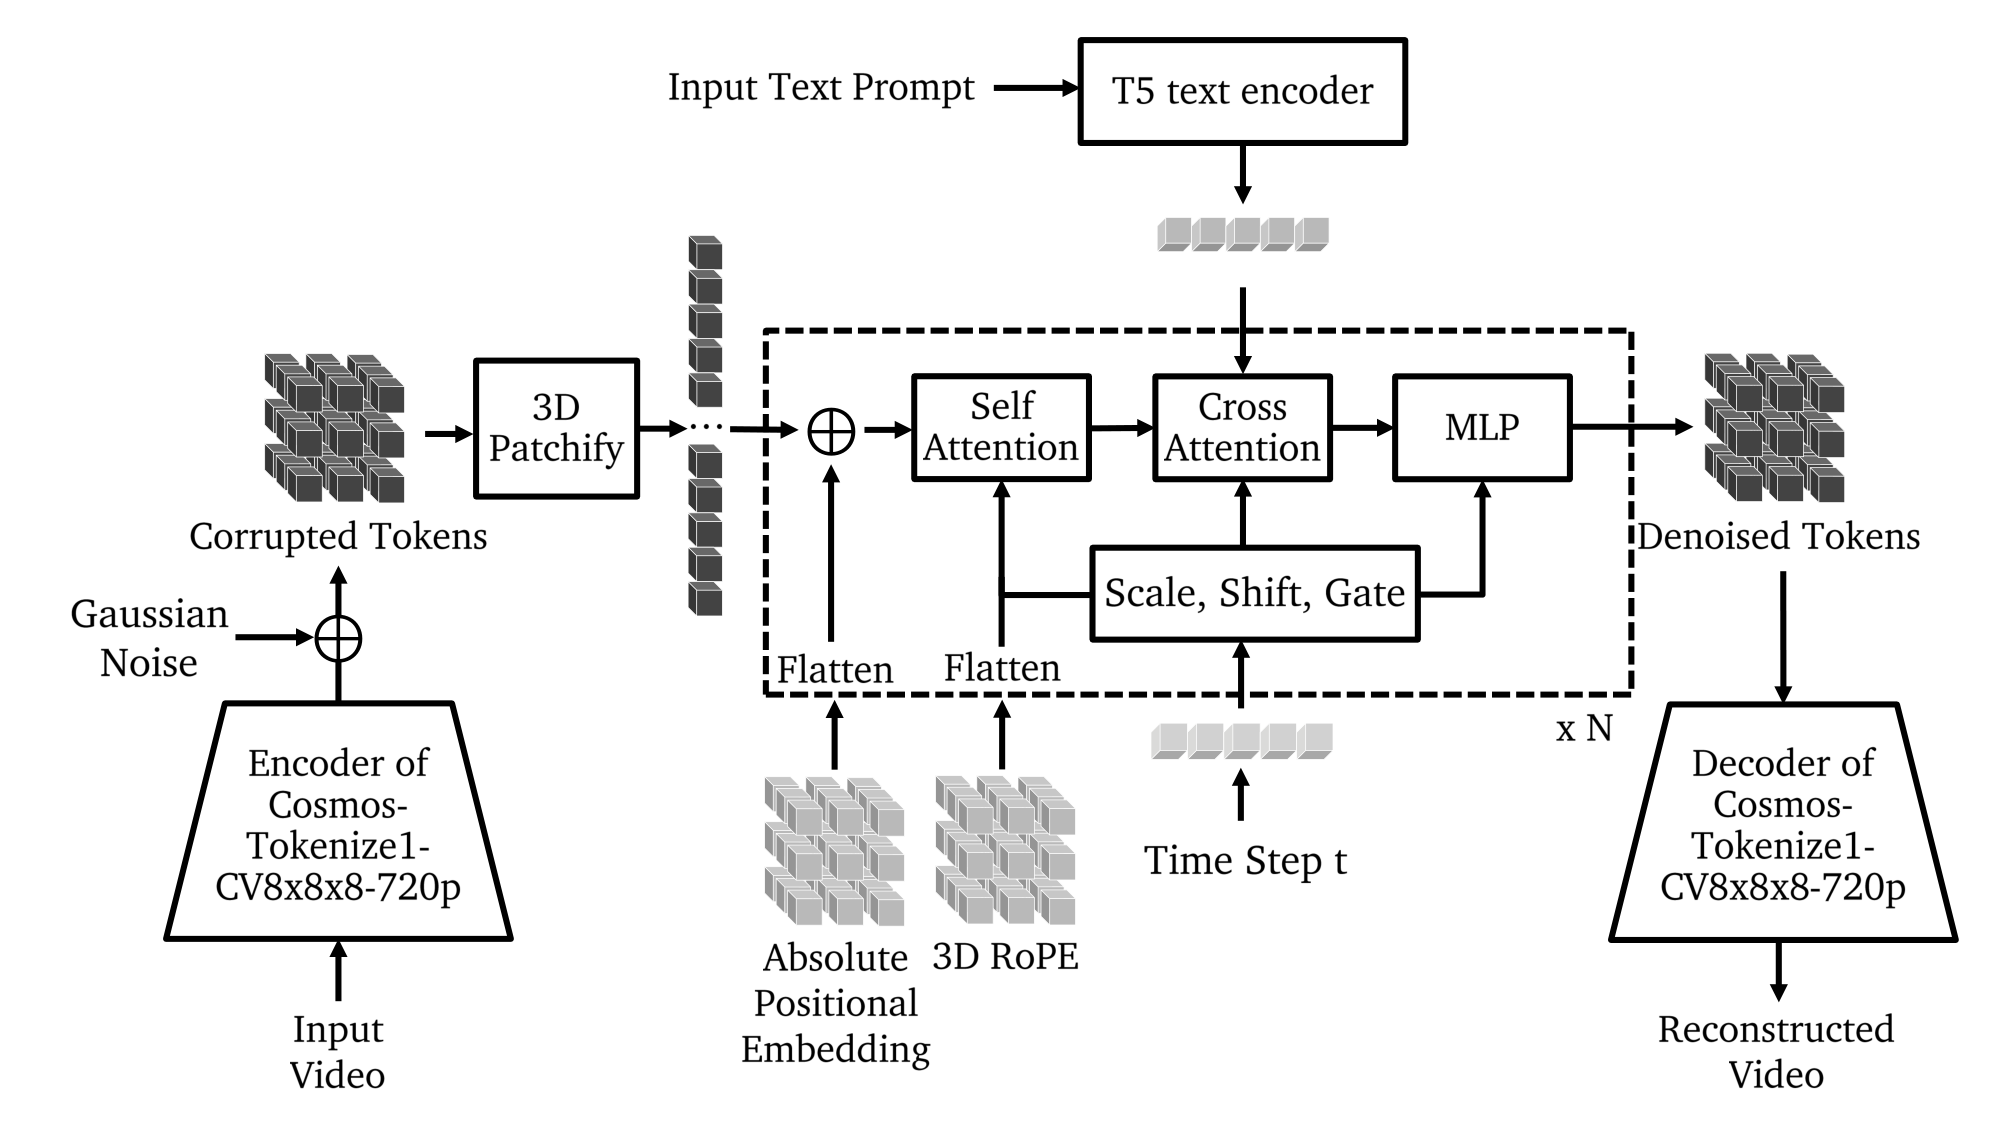
네트워크는 DiT를 영상용으로 고친 구조다. DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조를 말한다. 주요 변경은 네 가지다.
- 3D patchify: latent를 (1, 2, 2) 큐브 단위로 잘라 1차원 시공간 시퀀스로 편다
- 하이브리드 위치 임베딩: FPS를 반영한 3D RoPE에 학습되는 절대 위치 임베딩을 블록마다 더한다. RoPE 덕분에 해상도나 길이를 바꾸는 점진적 학습에서 5,000 스텝 안에 쓸 만한 성능으로 수렴한다
- cross-attention: T5-XXL 임베딩을 길이 512로 zero-padding해 key와 value로 넣는다. query와 key는 RMSNorm으로 정규화해 학습 초기의 attention 붕괴를 막는다
- AdaLN-LoRA: adaptive layer norm의 dense projection을 저랭크 근사로 바꿔 파라미터를 11B에서 7B로 36% 줄였고 평가 지표는 그대로 유지했다
| 설정 | 7B | 14B |
|---|---|---|
| layer 수 | 28 | 36 |
| 모델 차원 | 4,096 | 5,120 |
| FFN hidden 차원 | 16,384 | 20,480 |
| attention head 수 | 32 | 40 |
| AdaLN-LoRA 차원 | 256 | 256 |
학습은 해상도와 길이를 점진적으로 올린다. 512p(640×512) 57프레임에서 시작해 720p(1280×704) 121프레임으로 옮기고, 마지막에 고품질 부분집합으로 fine-tuning한다. 문맥 길이는 이 과정에서 10,240에서 56,320으로 늘어난다. 종횡비는 1:1, 3:4, 4:3, 9:16, 16:9 다섯 묶음으로 나눠 학습해 여러 비율을 함께 다룬다.
메모리 요구가 커서 병렬화가 필수다. 14B 모델은 파라미터와 그래디언트와 옵티마이저 상태만 약 280GB이고, 720p 학습에서 활성값이 약 310GB다. FSDP로 64등분하면 앞의 280GB가 GPU당 약 4GB가 되고, context parallelism을 8로 두면 활성값이 GPU당 약 40GB가 된다. 저자들은 tensor parallelism과 sequence parallelism 없이도 HunyuanVideo나 MovieGen과 비슷한 MFU를 얻었다고 적었다.
Video2World는 Text2World에 영상 조건을 붙여 얻는다. 조건 프레임은 시간축으로 이어 붙이고, 조건 프레임과 생성 프레임을 구분하는 이진 마스크를 채널축으로 함께 넣는다. 손실은 조건 프레임 위치를 제외하고 계산한다. 추론에서 입력 프레임의 품질이 흔들려도 견디도록 학습 중에 조건 프레임에 노이즈를 섞어 준다.
학습용 텍스트 prompt는 VLM이 만든 캡션이라 사람이 쓰는 문장과 분포가 다르다. 이 간극은 Mistral-NeMo-12B-Instruct를 fine-tuning한 prompt upsampler가 메운다. 학습 데이터는 긴 캡션에서 짧은 캡션을 거꾸로 만들어 짝을 맞췄다. Video2World용으로는 별도 학습 없이 Pixtral-12B를 zero-shot으로 쓴다.
autoregressive 계열 WFM
autoregressive 계열은 Llama3 스타일 GPT를 영상 토큰 예측용으로 처음부터 학습시킨 모델이다. 학습 목표는 다음 영상 토큰의 negative log-likelihood 최소화다. 언어로 pre-training하지 않았으므로 언어 이해 능력은 없고, 텍스트를 쓰려면 T5-XXL 임베딩을 self-attention 층마다 붙인 cross-attention으로 넣어야 한다.
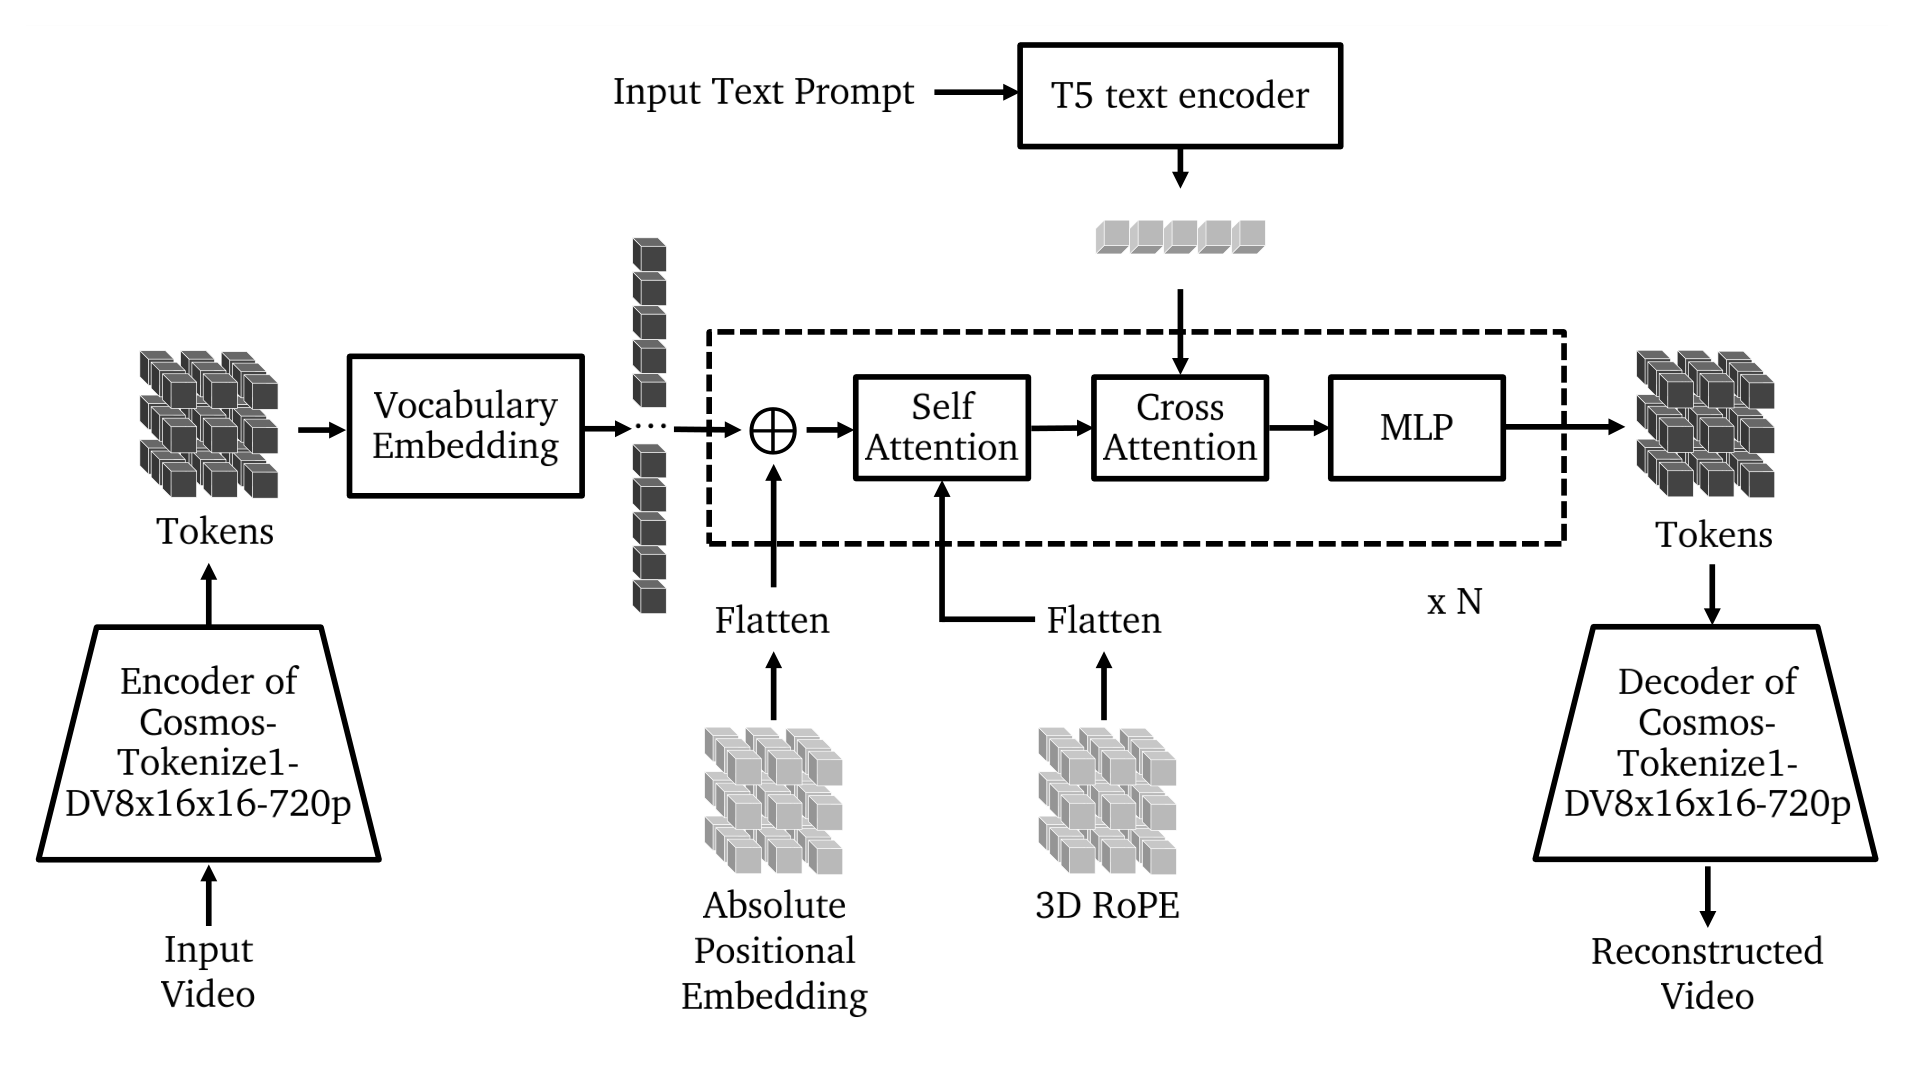
학습 안정성 장치가 둘 붙는다. QKNorm은 query와 key를 정규화한 뒤 고정 상수 1/√d 대신 학습되는 γ로 스케일해 softmax 포화를 막는다. z-loss는 logit 제곱합에 λ=3×10^-4를 곱해 손실에 더한다. 저자들은 노드 수를 크게 늘릴 때 z-loss가 그래디언트 norm을 정상 범위로 유지하는 데 결정적이었다고 적었다.
학습은 3단계로 나뉜다.
| 단계 | 문맥 | 내용 |
|---|---|---|
| 1 | 17프레임 | 첫 프레임만 주고 뒤따르는 16프레임을 예측한다 |
| 1.1 | 34프레임 | 시간축 RoPE에 YaRN 확장을 걸어 문맥을 늘린다 |
| 2 | 34프레임 | cross-attention을 새로 초기화해 텍스트 조건을 넣는다 |
해상도는 640×1024로 고정한다. 마지막에는 LLM 관행을 따라 고품질 데이터로 학습률을 0까지 선형 감쇠시키는 cooling-down을 3만 회 반복한다. 12B 모델은 파라미터와 그래디언트와 옵티마이저 상태만 약 192GB라 H100 한 장에 들어가지 않으므로 tensor parallelism과 sequence parallelism으로 나눈다.
추론 쪽에서는 LLM 최적화 기법을 그대로 가져온다. KV 캐시, tensor parallelism, torch.compile에 더해 Medusa 방식의 speculative decoding을 적용했다. Medusa head는 backbone 뒤에 붙어 뒤따르는 토큰 여러 개를 병렬로 예측하고, 그 결과를 rejection sampling으로 검증한다.
| 모델 | head 없을 때 throughput | head 9개일 때 throughput | forward pass 변화 |
|---|---|---|---|
| Cosmos-Predict1-4B | 초당 444.95토큰 | 초당 894.67토큰 | 7,680회에서 1,812회로 |
| Cosmos-Predict1-5B-Video2World | 초당 303.61토큰 | 초당 982.77토큰 | 10,240회에서 1,799회로 |
head를 9개 둘 때 throughput이 4B에서 2.0배, 5B에서 3.2배가 된다. head를 12개로 더 늘리면 forward pass는 줄지만 throughput이 오히려 떨어져, 9개가 절충점이다. fine-tuning 범위도 실험으로 정했다. Medusa head만 학습시키면 다중 토큰 예측이 부정확하고 전체를 fine-tuning하면 품질이 떨어져, 마지막 두 Transformer layer와 unembedding layer만 여는 방식을 골랐다.
해상도를 320×512로 낮추면 실시간 생성에 닿는다. 목표 Physical AI 도메인 영상으로 토크나이저와 4B 모델을 차례로 fine-tuning하고 Medusa head를 붙이면 초당 10.08프레임이 나와, 10FPS 영상을 실시간으로 생성한다.
discrete 토크나이저의 압축률이 높은 만큼 결과가 흐려지는 문제는 남는다. diffusion decoder가 이를 보정한다. 같은 영상을 DV8×16×16과 CV8×8×8 두 토크나이저로 각각 토큰화한 뒤, discrete 토큰 쪽을 조건 입력으로 주고 continuous 쪽 노이즈를 걷어내도록 7B Text2World를 fine-tuning한 모델이다. 추론에서는 autoregressive 모델이 낸 discrete 토큰을 조건으로 받아 continuous 토큰을 만들고, 그것을 CV8×8×8 디코더가 RGB 영상으로 되돌린다.
Guardrail
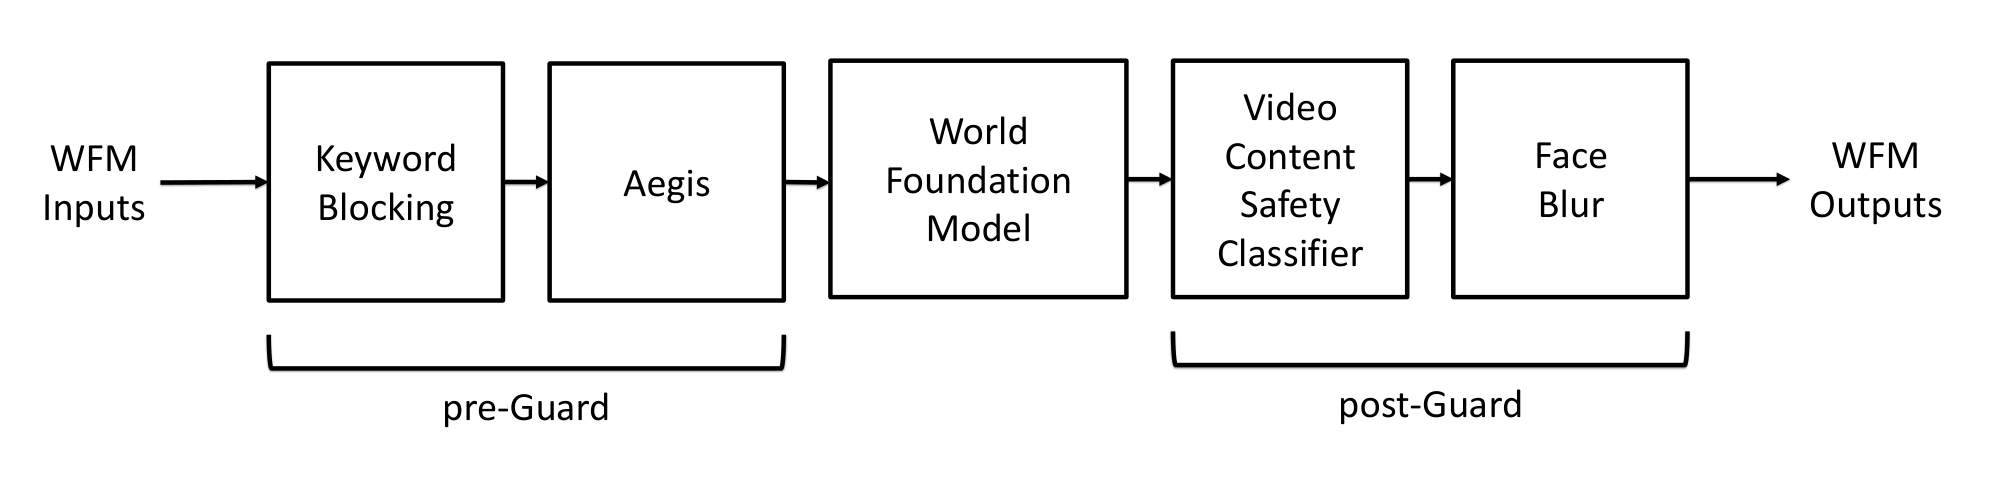
pre-Guard는 텍스트 입력을 막는 2단 장치다. 1차는 WordNet 표제어 추출을 거친 단어를 블록리스트와 대조하는 키워드 차단이고, 2차는 Aegis-AI-Content-Safety-LlamaGuard의 defensive 버전이다. defensive 버전은 permissive 버전보다 허용 범위를 좁게 잡는다. 차단 대상 범주는 폭력, 성적 내용, 범죄 계획, 무기, 약물 남용, 자살, 아동 성착취물, 혐오, 괴롭힘, 협박, 욕설이다.
post-Guard는 출력 영상을 막는 장치다. 프레임마다 SigLIP 임베딩을 뽑아 MLP 분류기에 넣고, 한 프레임이라도 unsafe로 판정되면 영상 전체를 막는다. 이어 RetinaFace로 20×20 픽셀보다 큰 얼굴 영역을 찾아 픽셀화한다.
검증은 전담 red team이 맡았다. 논문 공개 시점까지 유해 내용을 폭넓게 겨냥해 만든 프롬프트와 영상 쌍 1만 건 이상을 시험했고, 유해 범주별로 1에서 5까지 점수를 매기며 문제가 나타난 시작과 끝 프레임까지 표시했다.
결과
3D 일관성
생성 영상은 3D 세계의 2D 투영이므로 다중 뷰 기하 도구로 일관성을 잴 수 있다. 평가는 RealEstate10K 테스트셋에서 뽑은 정적 장면 영상 500개로 진행했다.
지표는 두 종류다. 하나는 에피폴라 기하 제약이 얼마나 지켜지는지 재는 Sampson error와 카메라 pose 추정 성공률이고, 다른 하나는 8프레임마다 한 장씩 빼 둔 뒤 나머지 프레임으로 3D Gaussian splatting을 학습해 그 빠진 뷰를 복원한 품질이다.
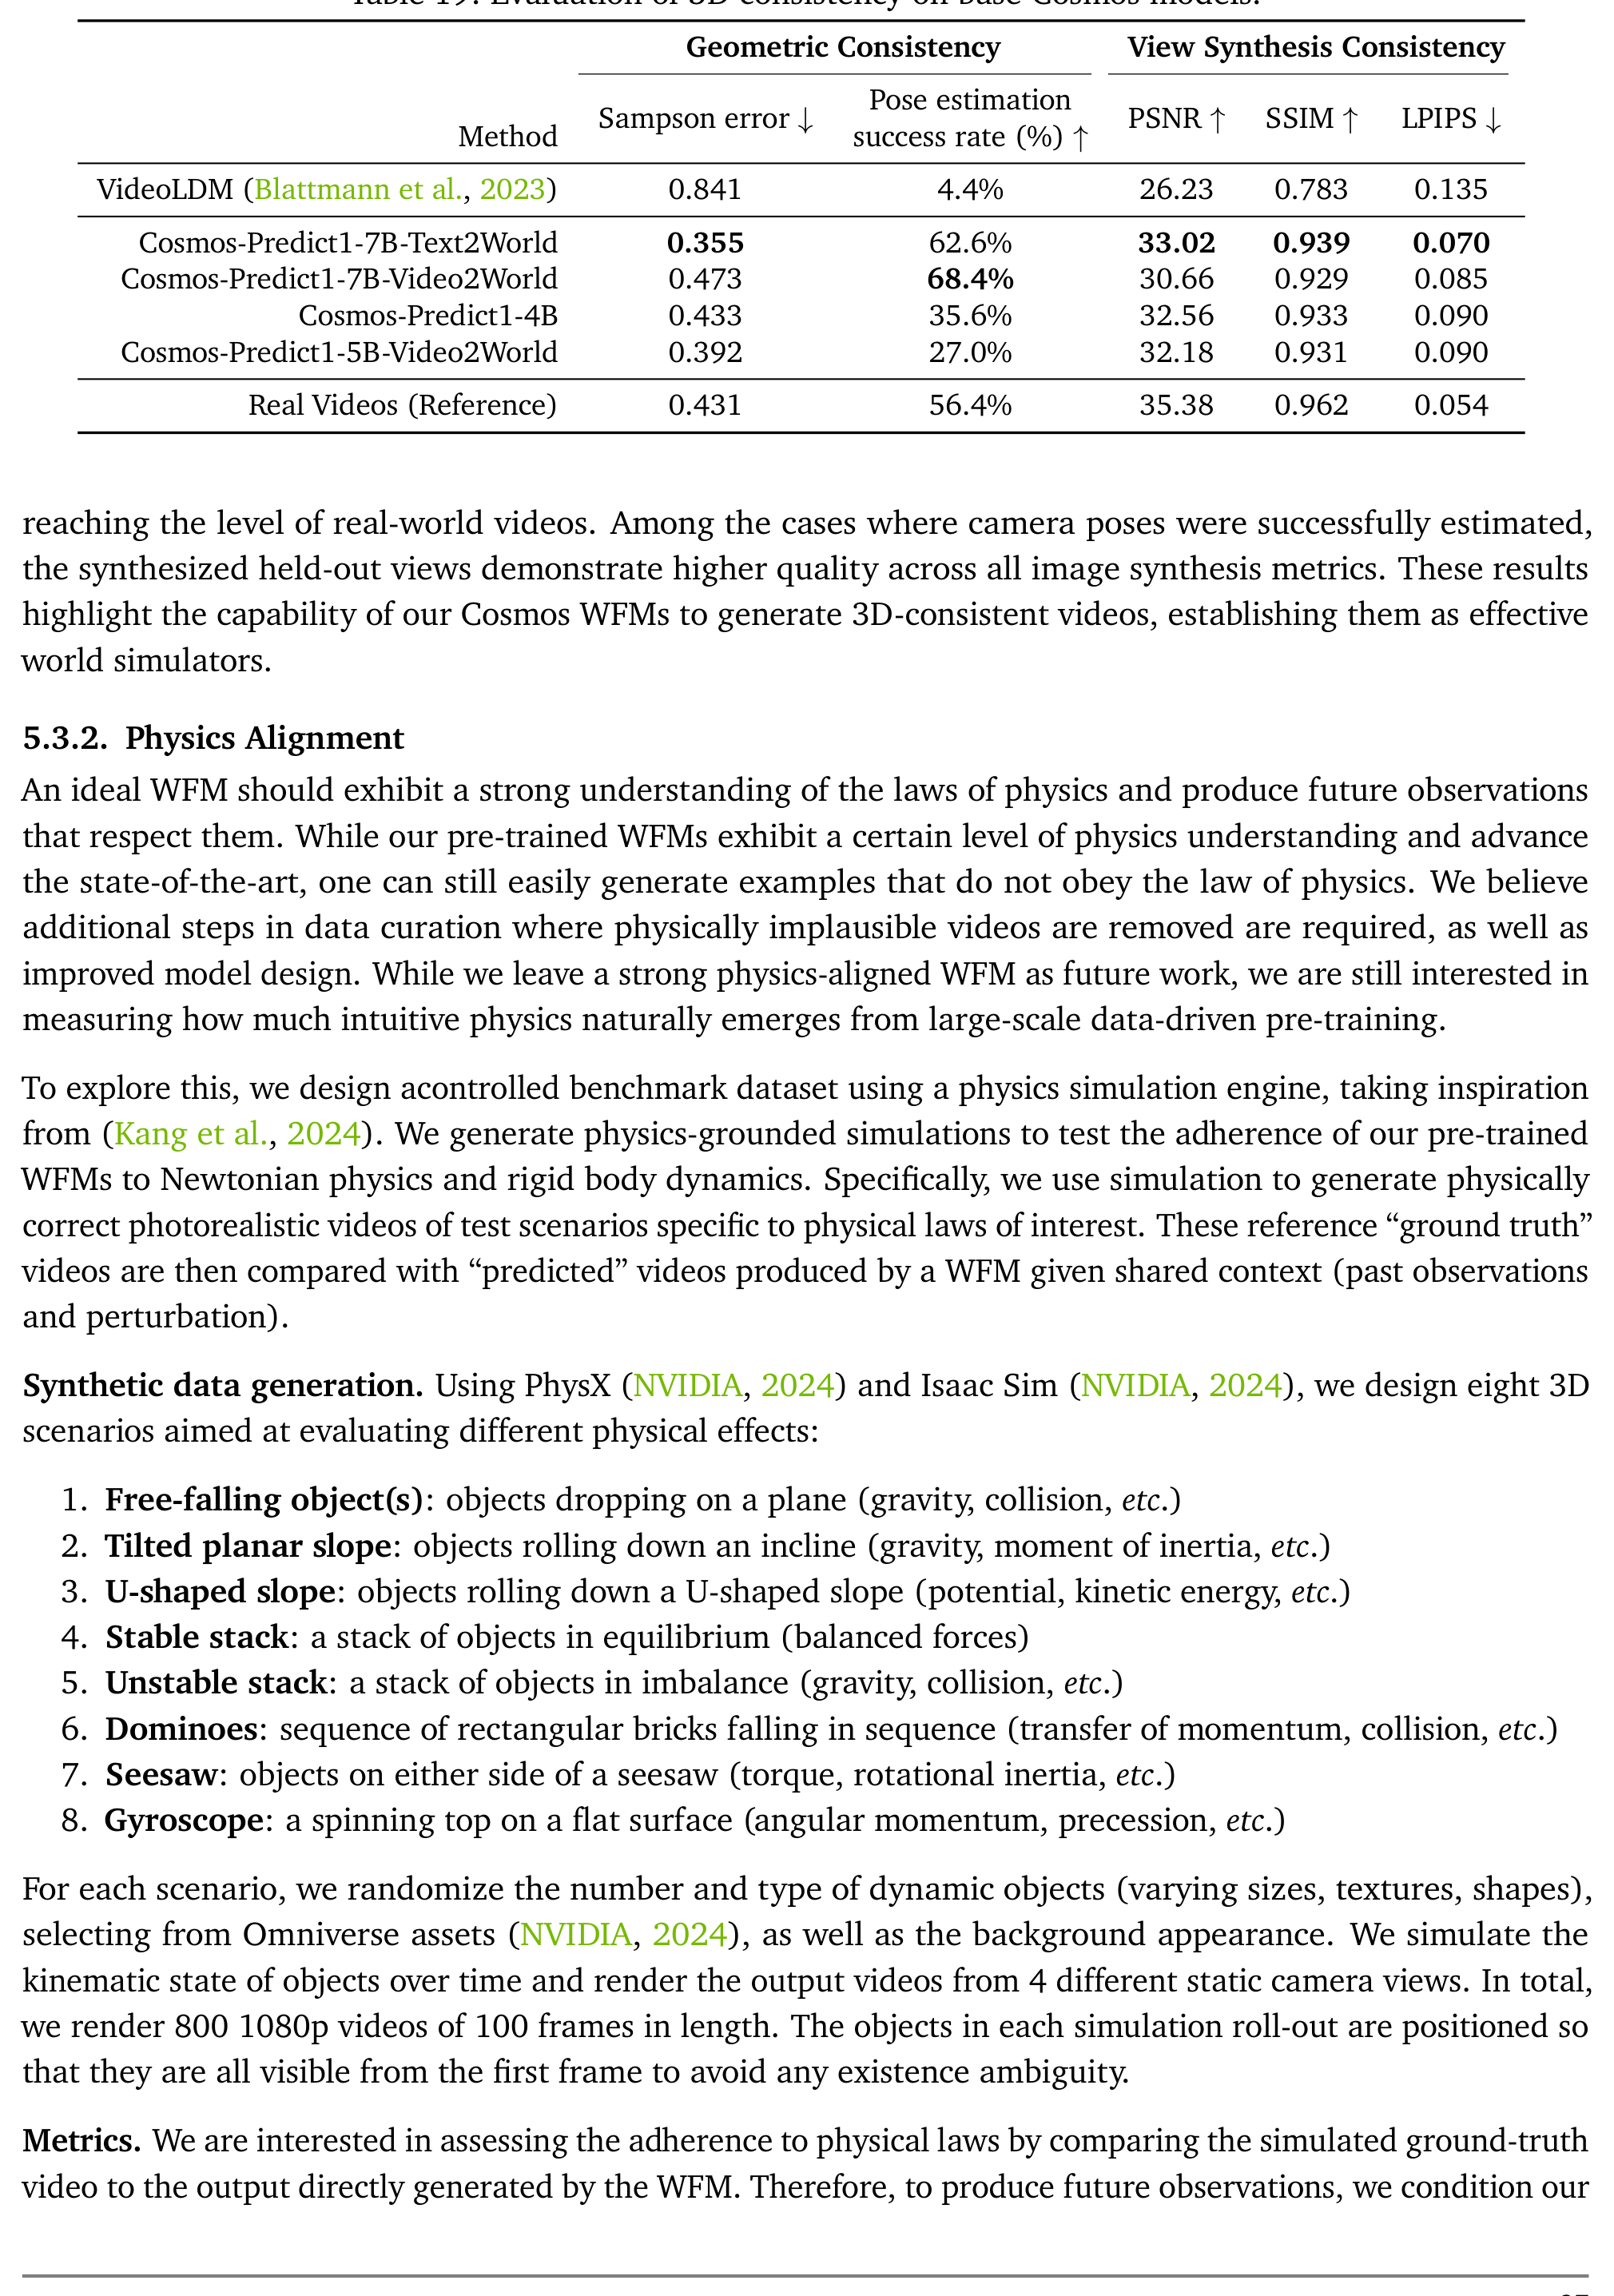
| 모델 | Sampson error | pose 추정 성공률 | PSNR |
|---|---|---|---|
| VideoLDM | 0.841 | 4.4% | 26.23 |
| Cosmos-Predict1-7B-Text2World | 0.355 | 62.6% | 33.02 |
| Cosmos-Predict1-7B-Video2World | 0.473 | 68.4% | 30.66 |
| Cosmos-Predict1-4B | 0.433 | 35.6% | 32.56 |
| Cosmos-Predict1-5B-Video2World | 0.392 | 27.0% | 32.18 |
| 실제 영상(참조) | 0.431 | 56.4% | 35.38 |
Sampson error는 낮을수록, 나머지 둘은 높을수록 좋다. 7B-Text2World는 기준선 VideoLDM 대비 Sampson error를 0.841에서 0.355로 줄이고 pose 추정 성공률을 4.4%에서 62.6%로 58.2%p 올린다. novel view 합성 PSNR도 26.23에서 33.02로 올라 실제 영상의 35.38에 가까워진다.
가장 눈에 띄는 값은 pose 추정 성공률이다. 두 diffusion 모델 모두 실제 영상의 56.4%를 넘어선다. 저자들은 이를 전반적 화질 개선과 3D 일관성 개선이 함께 반영된 결과로 해석한다.
autoregressive 계열은 같은 표에서 diffusion보다 낮다. 4B의 pose 추정 성공률은 35.6%, 5B-Video2World는 27.0%로 실제 영상 수준에 미치지 못한다.
physics alignment
physics alignment는 시뮬레이터로 만든 물리적으로 옳은 영상을 정답 삼아 생성 결과가 물리 법칙을 지키는지 재는 평가 기준이다. 데이터는 PhysX와 Isaac Sim으로 직접 만들었다.
시나리오는 여덟 가지다. 자유낙하, 경사면 굴러내림, U자 슬로프, 안정 적층, 불안정 적층, 도미노, 시소, 자이로스코프이며 중력과 충돌, 관성 모멘트, 위치 에너지와 운동 에너지, 운동량 전달, 토크, 각운동량을 각각 겨냥한다. 물체의 개수와 종류와 배경을 무작위로 바꾸고 고정 카메라 4각도로 렌더해 1080p 100프레임 영상 800개를 얻었다.
지표는 세 수준으로 나뉜다. 픽셀 수준은 PSNR과 SSIM, feature 수준은 DreamSim 유사도, 객체 수준은 첫 프레임의 정답 분할 마스크를 SAMURAI로 추적해 얻은 평균 IoU다. 객체 수준 지표를 따로 두는 이유는 배경 변화나 전반적 화질 같은 교란 요인을 걷어내고 물체의 거동만 보기 위해서다.
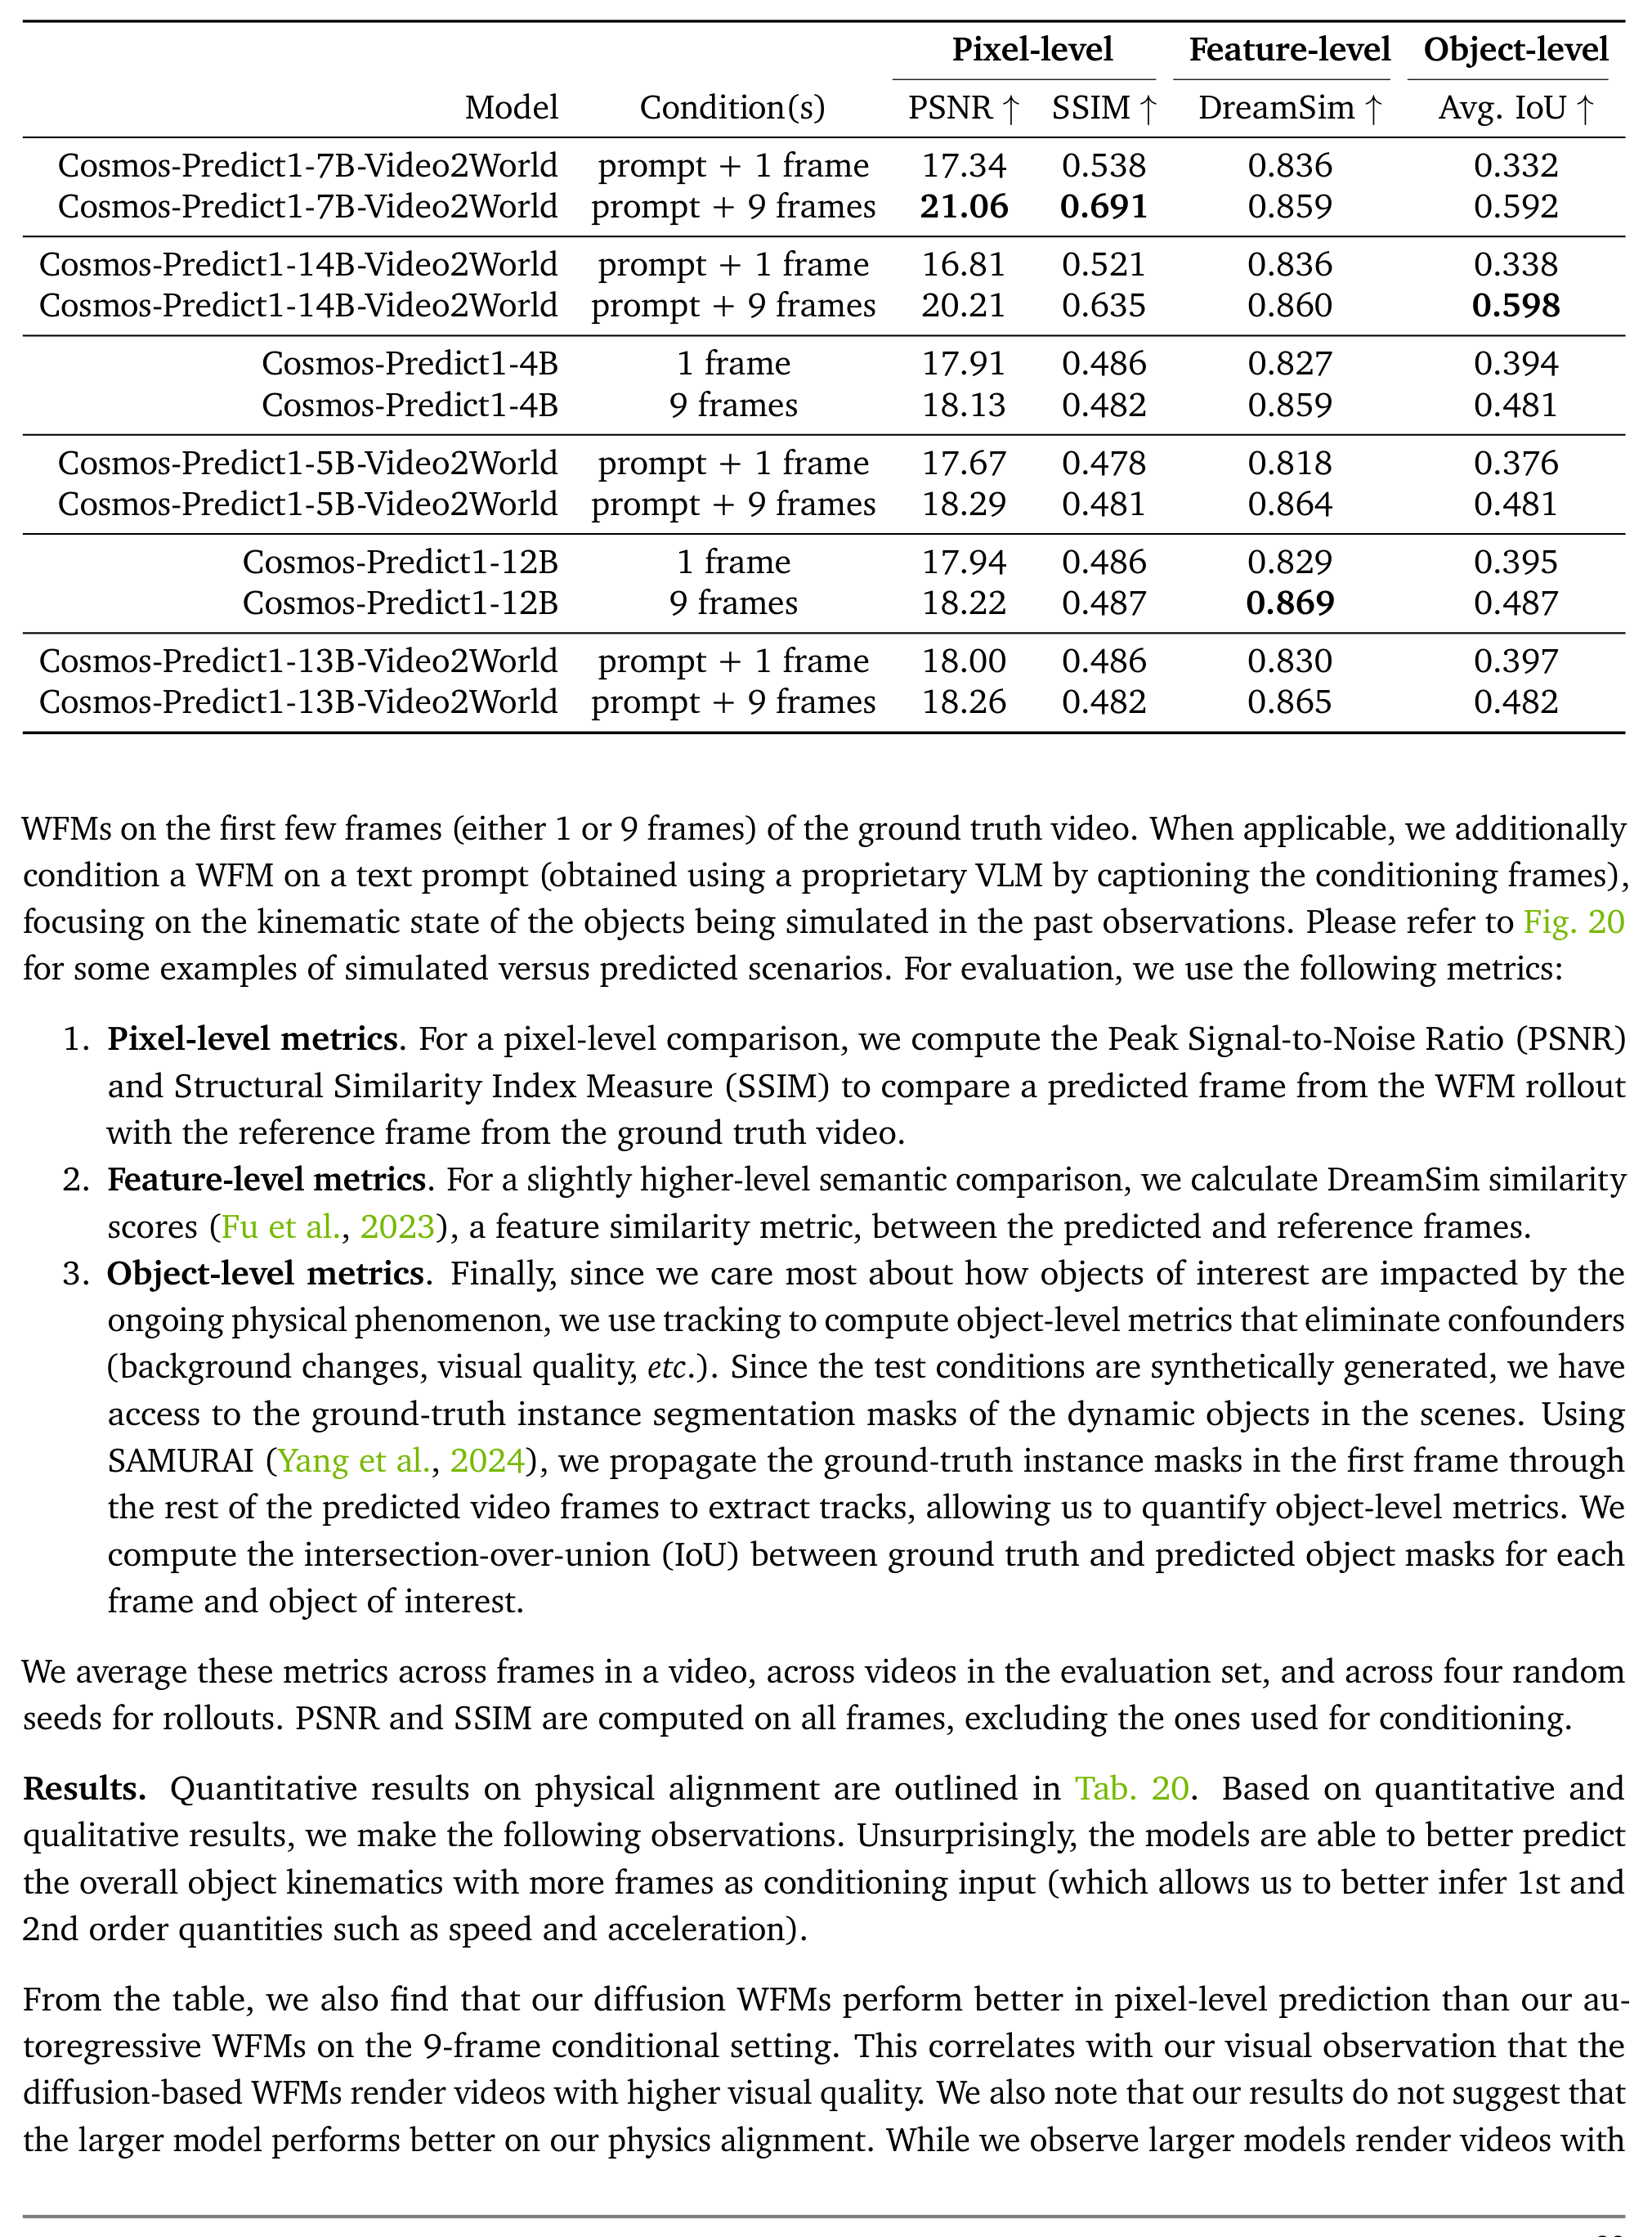
| 모델 | 조건 | PSNR | 평균 IoU |
|---|---|---|---|
| 7B-Video2World | prompt + 1프레임 | 17.34 | 0.332 |
| 7B-Video2World | prompt + 9프레임 | 21.06 | 0.592 |
| 14B-Video2World | prompt + 9프레임 | 20.21 | 0.598 |
| 4B | 9프레임 | 18.13 | 0.481 |
| 12B | 9프레임 | 18.22 | 0.487 |
| 13B-Video2World | prompt + 9프레임 | 18.26 | 0.482 |
결과는 조건 프레임 수와 모델 크기에 대해 서로 다른 방향을 가리킨다.
조건 프레임을 늘리면 크게 좋아진다. 7B-Video2World의 평균 IoU는 1프레임 조건에서 0.332, 9프레임 조건에서 0.592다. 프레임이 여러 장 있어야 속도와 가속도 같은 1차, 2차 물리량을 추정할 수 있기 때문이다.
반면 모델을 키워도 거의 좋아지지 않는다. 7B에서 14B로 두 배 키운 결과가 평균 IoU 0.592에서 0.598이다. autoregressive 계열은 0.48 근처에 몰려 있어 4B와 12B의 차이도 미미하다. 저자들은 큰 모델이 더 나은 화질을 내지만 물리 준수에서는 모든 변종이 똑같이 고전한다고 정리하며, 데이터 curation과 모델 설계 양쪽의 개선이 필요하다고 적었다.
실패 유형도 함께 기록했다. 물체가 갑자기 나타나거나 사라지는 object impermanence, 형태 변형, 그럴듯하지 않은 운동, 중력 위반이다.
autoregressive 계열의 실패율
autoregressive 계열에서 반복해서 나타나는 실패는 물체가 화면 아래에서 갑자기 솟아오르는 현상이다. 저자들은 Physical AI 입력 100개로 평가 세트를 만들고 생성 결과를 사람이 직접 확인해 실패율을 셌다.
| 모델 | 이미지 1장 조건 | 영상 9프레임 조건 |
|---|---|---|
| Cosmos-Predict1-4B | 15% | 1% |
| Cosmos-Predict1-5B-Video2World | 7% | 2% |
| Cosmos-Predict1-12B | 2% | 1% |
| Cosmos-Predict1-13B-Video2World | 3% | 0% |
이미지 한 장만 줄 때는 모델 크기가 실패율을 크게 좌우한다. 4B의 15%가 12B에서 2%로 13%p 떨어진다. 반면 9프레임을 주면 모든 모델이 0%에서 2% 사이로 내려온다. 즉 조건을 넉넉히 주는 편이 파라미터를 늘리는 편보다 적은 비용으로 같은 효과를 내는 구간이 있다.
camera control post-training
camera control은 단일 참조 이미지에서 출발해 3D 공간을 이동할 수 있는 세계를 만드는 과제다. 학습에는 정적 장면 영상 데이터셋 DL3DV-10K를 쓰고, 256프레임 단위로 자른 뒤 GLOMAP으로 structure-from-motion을 수행해 프레임마다 camera pose를 붙였다.
조건은 Plücker 좌표로 준다. camera 중심과 광선 방향으로 만든 6차원 좌표를 latent와 같은 공간 크기로 계산해 이어 붙인다. 토크나이저의 시간 압축률이 8배이므로 8프레임마다 네 번째 프레임의 Plücker 임베딩을 해당 latent에 대응시킨다.
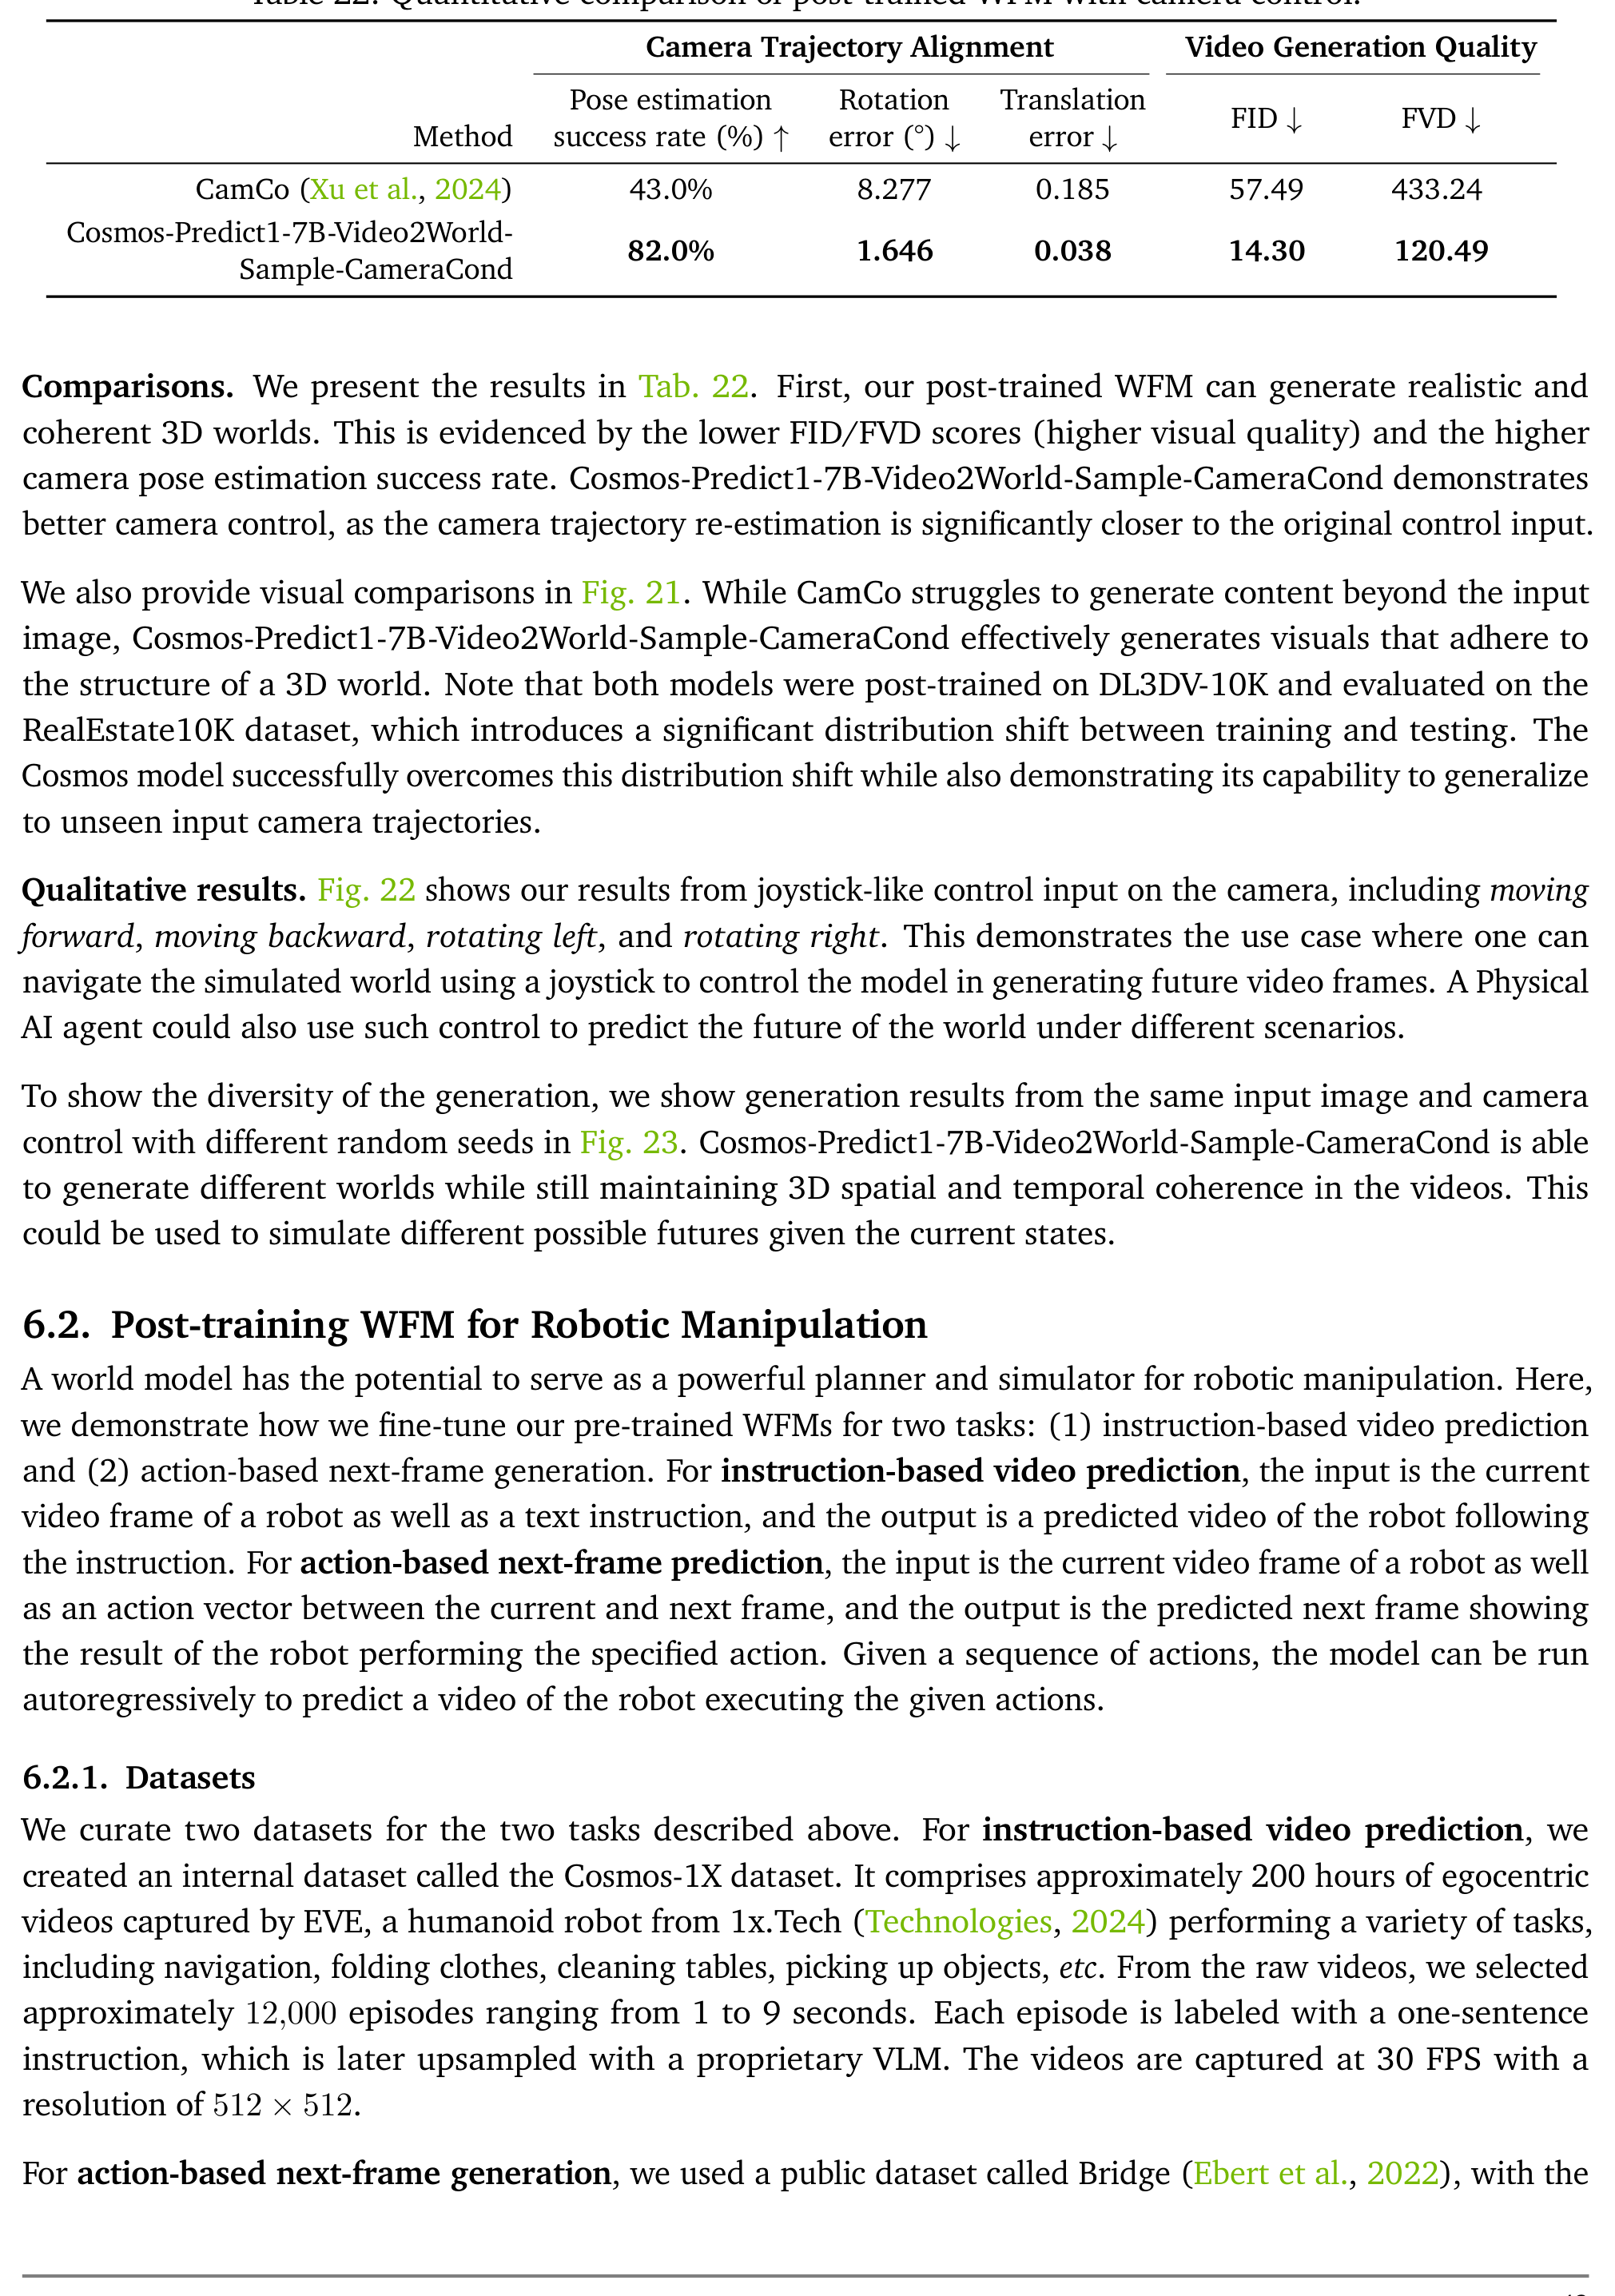
| 지표 | CamCo | Cosmos-Predict1-7B-Video2World-Sample-CameraCond |
|---|---|---|
| pose 추정 성공률 | 43.0% | 82.0% |
| 회전 오차 | 8.277° | 1.646° |
| 이동 오차 | 0.185 | 0.038 |
| FID | 57.49 | 14.30 |
| FVD | 433.24 | 120.49 |
전 항목에서 개선됐다. pose 추정 성공률은 39%p 올랐고, 회전 오차는 5분의 1로, FVD는 3.6분의 1로 줄었다.
이 비교에는 분포 이동이 끼어 있다. 두 모델 모두 DL3DV-10K로 post-training하고 평가는 RealEstate10K에서 했다. CamCo는 이 차이 때문에 입력 이미지 너머의 내용을 만들어내지 못하고 pose를 추정할 수 없는 영상을 내놓는 경우가 많았던 반면, Cosmos는 학습에서 보지 못한 camera trajectory까지 따라간다.
조작 방식도 실용적이다. 전진, 후진, 좌회전, 우회전 네 가지 조이스틱 입력으로 생성 방향을 지정할 수 있고, 같은 입력 이미지와 같은 camera 조건에서 seed만 바꾸면 서로 다른 미래를 만들어낸다. 뒤쪽 성질은 하나의 현재 상태에서 여러 가능한 미래를 시뮬레이션하는 용도에 해당한다.
robot manipulation post-training
robot manipulation은 두 과제로 나뉜다. 하나는 현재 프레임과 지시문(instruction)을 받아 그 지시를 따르는 영상을 예측하는 과제이고, 다른 하나는 현재 프레임과 action 벡터를 받아 다음 프레임을 예측하는 과제다. 뒤쪽은 action 시퀀스를 차례로 넣어 autoregressive하게 영상 전체를 만들 수 있다.
지시문 조건 예측에는 Cosmos-1X 데이터셋을 만들어 썼다. 1X Technologies의 humanoid EVE가 1인칭으로 찍은 약 200시간 영상에서 1초에서 9초 사이 episode 약 1만 2천 개를 골랐고, 30FPS 512×512 해상도에 한 문장짜리 지시문 라벨을 붙인 뒤 VLM으로 늘렸다. 과제는 내비게이션, 옷 개기, 탁자 닦기, 물체 집기 등이다.
평가는 사람이 했다. 평가자 10명이 같은 지시문으로 만든 익명 영상 쌍을 놓고 네 기준으로 비교했다. 지시 따르기, 물체 유지, 사실성, 그리고 로봇이 계획을 세우기에 적절한가를 묻는 종합 판단이다. 23개 episode에 대한 결과에서 7B 모델은 종합 선호도 78.3%로 기준선 VideoLDM-Instruction의 13.0%를 크게 앞섰고, 물체 유지 항목에서는 82.6% 대 8.7%였다. 5B 모델도 네 기준 모두에서 기준선보다 선호도가 높았다.
action 조건 예측에는 공개 데이터셋 Bridge를 썼다. 주방 환경에서 로봇 팔을 3인칭으로 찍은 episode 약 2만 개이고 320×256 해상도에 5FPS다. action은 OpenVLA와 같은 규격인 그리퍼 좌표계의 7차원 벡터로, 위치 변화량 3개와 자세 변화량 3개와 그리퍼 개폐로 이루어진다.
조건을 주입하는 위치는 계열마다 다르다. autoregressive 5B 모델은 action 임베더 MLP의 출력을 cross-attention으로 넣고, diffusion 7B 모델은 같은 출력을 DiT 모듈의 timestep 임베딩에 더한다.
| 모델 | PSNR | SSIM | FVD |
|---|---|---|---|
| IRASim-Action | 19.13 | 0.64 | 593 |
| Cosmos-Predict1-5B-Video2World-Sample-ActionCond | 19.95 | 0.80 | 434 |
| Cosmos-Predict1-7B-Video2World-Sample-ActionCond | 21.14 | 0.82 | 190 |
Bridge 공식 테스트셋에서 무작위로 고른 episode 100개로 잰 값이다. diffusion 기반 7B가 기준선 IRASim-Action의 FVD 593을 190까지 낮춰 가장 좋다.
자율주행 post-training
자율주행은 여섯 카메라 뷰를 동시에 만들어야 한다는 점에서 앞의 두 사례와 다르다. 대부분의 자율주행 차량이 여러 방향을 보는 카메라를 달고 있어서다.
데이터는 NVIDIA 내부의 RDS 데이터셋이다. 20초짜리 서라운드 뷰 클립 약 360만 개, 시간으로 약 2만 시간이며 앞, 좌, 우, 뒤, 좌후방, 우후방 여섯 뷰와 ego 차량의 움직임 정보를 함께 담는다. 표본은 속성 태그로 분포를 맞춰 뽑았다. 주변 차량 밀도, 날씨, 조도, ego 차량 속도, ego 차량 거동, 도로 유형이 태그이고, 톨게이트와 교량과 터널과 과속방지턱 같은 드문 구조물은 2차 마이닝으로 최소 개수를 채웠다.
아키텍처 변경은 두 가지다. 위치 임베딩은 뷰마다 독립으로 그대로 쓰고 뷰의 차이는 전역 view 임베딩으로 표현한다. cross-attention은 뷰마다 그 뷰의 캡션만 참조하도록 나눈다. 반면 여섯 뷰 전체는 하나의 상태로 묶여 self-attention을 공유한다. 출력은 848×480 해상도의 57프레임 영상 여섯 개다.
| 지표 | VideoLDM-MultiView | MultiView | MultiView-TrajectoryCond | 실제 영상 |
|---|---|---|---|---|
| FID | 60.84 | 32.16 | 미보고 | 참조값 없음 |
| FVD | 884.46 | 210.23 | 미보고 | 참조값 없음 |
| TSE | 1.24 | 0.68 | 0.59 | 0.69 |
| CSE | 6.48 | 2.11 | 2.02 | 1.71 |
TSE는 뷰 하나의 인접 프레임 사이 Sampson error로 시간 방향 일관성을 재고, CSE는 서로 다른 뷰 사이 Sampson error로 뷰 사이 일관성을 잰다. 시간 방향 일관성은 0.68로 실제 영상의 0.69에 사실상 도달했다. 반면 뷰 사이 일관성은 2.11로 실제 영상 1.71에 못 미친다. trajectory 조건을 추가하면 두 값이 각각 0.59와 2.02로 조금 더 좋아진다.
trajectory 조건은 3D 공간의 점 64개로 준다. 0.1초 간격으로 ego 차량의 이동을 적은 시퀀스다. 이 조건이 실제로 지켜지는지는 생성 영상에서 camera pose를 되추정해 잰다. trajectory 추종 오차는 실제 영상 기준값보다 7cm 이내로만 벌어진다.
물체 수준 검증도 했다. 생성한 8초 영상 20개에서 YOLOv11x로 물체 157개를 추적하고 사람이 확인한 결과, 사람과 차량이 하나로 합쳐지는 것처럼 물리적으로 불가능한 사례가 하나도 없었다.
일반화도 유지된다. 학습 분포 밖 장면인 얼음 성 앞 주행이나 강 위 주행에서도 여섯 뷰의 일관성이 유지된다.
한계
모델의 한계
저자들은 결론에서 현재 모델이 물리 세계의 믿을 만한 시뮬레이터에 못 미친다고 명시한다. 구체적인 문제는 세 가지다.
- object permanence 부족: 물체가 예고 없이 나타나거나 사라진다
- 접촉이 많은 상황의 dynamics 부정확
- 지시문 따르기의 불일치
생성 영상의 사실감이 물리 원칙 준수로 이어지지는 않는다는 점도 함께 적었다. 중력, 빛의 상호작용, 유체 거동이 그 예다.
autoregressive 계열에는 별도의 한계가 하나 더 있다. prompt upsampler로 늘린 prompt를 넣어도 Text2World 결과가 나아지지 않는다. 저자들은 이 모델들이 학습 대부분을 순수 영상 생성으로 보내 텍스트 입력을 활용하도록 충분히 강제받지 않았기 때문으로 추정한다.
평가의 한계
평가 방법 자체도 미해결로 남았다. 물리적 충실도를 사람이 채점할 기준을 세우기 어렵고 개인차가 크며, 그 점수가 downstream Physical AI 과제 지표와 같은 방향으로 움직인다는 보장도 없다. 대안으로는 멀티모달 LLM 기반 자동 평가자와 기존 물리 시뮬레이터를 쓴 재현 가능한 평가를 제시한다.
여기에 더해 논문 2.1절이 든 다섯 가지 쓰임새에는 실증 결과가 없다. 이 점은 저자들이 직접 밝힌 것이며, 목록을 성과가 아니라 향후 계획으로 읽어야 하는 이유다.
diffusion과 autoregressive 비교
현재 시점의 결론은 diffusion 우세다. 3D 일관성 평가와 로봇 영상 생성 양쪽에서 diffusion 계열이 더 나은 생성 품질을 낸다. fine-tuning으로 camera pose, end-effector 위치, 차량 trajectory 같은 다양한 조건을 붙이기 쉽고, 여섯 뷰 동시 생성 같은 새 출력 형식으로도 확장된다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분을 말한다.
다만 autoregressive 쪽에 남은 여지가 두 가지 있다. LLM 가중치를 물려받아 world knowledge를 상속하는 길과, causal attention용 추론 최적화 기법을 그대로 쓰는 길이다. world knowledge는 물체와 행위와 환경에 대해 모델이 미리 갖고 있는 사전 지식을 말한다. 이 둘이 실현되면 상호작용 제어나 실시간 처리가 필요한 응용에서 autoregressive가 더 적합해질 수 있다.
두 계열의 경계도 고정되어 있지 않다. 양방향 attention을 쓰는 diffusion Transformer를 causal attention 학생 모델로 distillation해 KV 캐시를 쓰게 만든 연구가 있고, 반대로 autoregressive 모델에 국소적 양방향 attention과 diffusion head를 결합한 연구도 있다. 저자들은 이런 혼합 구조를 유망한 연구 방향으로 든다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| WFM (world foundation model) | 여러 downstream Physical AI 환경으로 fine-tuning될 것을 전제로 만든 범용 world model. 이 논문의 중심 개념 |
| perturbation | world model이 미래를 예측할 때 함께 받는 현재 입력. action, 텍스트, 무작위 입력을 한 이름으로 묶는다 |
| Text2World / Video2World | 텍스트만 받아 영상을 만드는 모드와, 과거 영상에 텍스트를 더해 미래를 잇는 모드 |
| FSQ (Finite-Scalar-Quantization) | 각 latent 차원을 정해진 레벨 수로 반올림해 양자화하는 방식. Cosmos는 (8, 8, 8, 5, 5, 5)로 어휘 크기 64,000을 만든다 |
| diffusion decoder | discrete 토큰의 압축 왜곡을 continuous 공간으로 옮겨 보정하는 후처리 모델 |
| physics alignment | 시뮬레이터로 만든 물리적으로 옳은 영상을 정답 삼아 생성 영상의 물리 준수를 재는 이 논문의 평가 방식 |
관련 페이지
- A Comprehensive Survey on World Models for Embodied AI: world model을 로보틱스, 자율주행, 범용 비디오 세 종류로 나눈 서베이. Cosmos는 그중 범용 계열의 대표 사례로 놓인다
- World Model for Robot Learning: A Comprehensive Survey: world model을 policy로 쓰는 경로와 시뮬레이터로 쓰는 경로를 가른 서베이. Cosmos가 겨냥한 쪽은 시뮬레이터 경로다
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: 영상으로 pre-training한 뒤 action으로 fine-tuning하는 world-action model 흐름. Cosmos의 2단 구도와 같은 계보다
- Generative Physical AI in Vision: A Survey: 생성 모델로 물리를 다루는 연구 전반을 정리한 서베이. physics alignment 문제의식이 겹친다
- Physical AI 연구 한 번에 살펴보기 2편: 물리를 이해하는 생성 모델과 월드 시뮬레이터: 위 서베이를 한국어로 풀어 쓴 해설. 생성과 시뮬레이션의 구분을 먼저 잡고 싶을 때 읽는다
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 같은 NVIDIA의 humanoid VLA. Cosmos가 세상의 디지털 트윈이라면 GR00T는 자기 자신의 디지털 트윈에 해당한다
- OpenVLA: An Open-Source Vision-Language-Action Model: Bridge 데이터셋의 그리퍼 7차원 action 규격을 Cosmos의 action 조건 post-training이 그대로 따른다
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: Physical AI를 LLM의 world knowledge에서 출발시키는 서베이. Cosmos는 그 좌표계에서 시각 예측 층에 놓인다
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control: humanoid whole-body control foundation model. Cosmos의 discrete 토크나이저와 같은 FSQ 양자화를 써서 서로 다른 입력을 하나의 토큰 공간에 담는다
- Physical AI 카테고리 지도와 학습 경로: 도메인 허브
- 용어집: Physical AI (Terminology Glossary): world foundation model, perturbation, physics alignment 표기의 SSOT