LLMs · PAPER · 2022
Scalable Diffusion Models with Transformers
요약
DiT(Diffusion Transformer)는 diffusion model의 backbone을 convolution 기반 U-Net에서 표준 Transformer로 바꾼 아키텍처다. diffusion model은 데이터에 noise를 단계적으로 더한 뒤 그 과정을 되돌리는 방향을 학습해 이미지를 생성하는 모델이며, 이 논문 이전까지는 예외 없이 U-Net을 backbone으로 썼다. Peebles와 Xie는 VAE로 압축한 latent를 patch 토큰 시퀀스로 바꿔 ViT와 거의 같은 Transformer에 입력하면 U-Net의 inductive bias 없이도 같은 일을 할 수 있고, Transformer가 다른 도메인에서 보인 scaling 성질까지 그대로 따라온다는 것을 보인다.
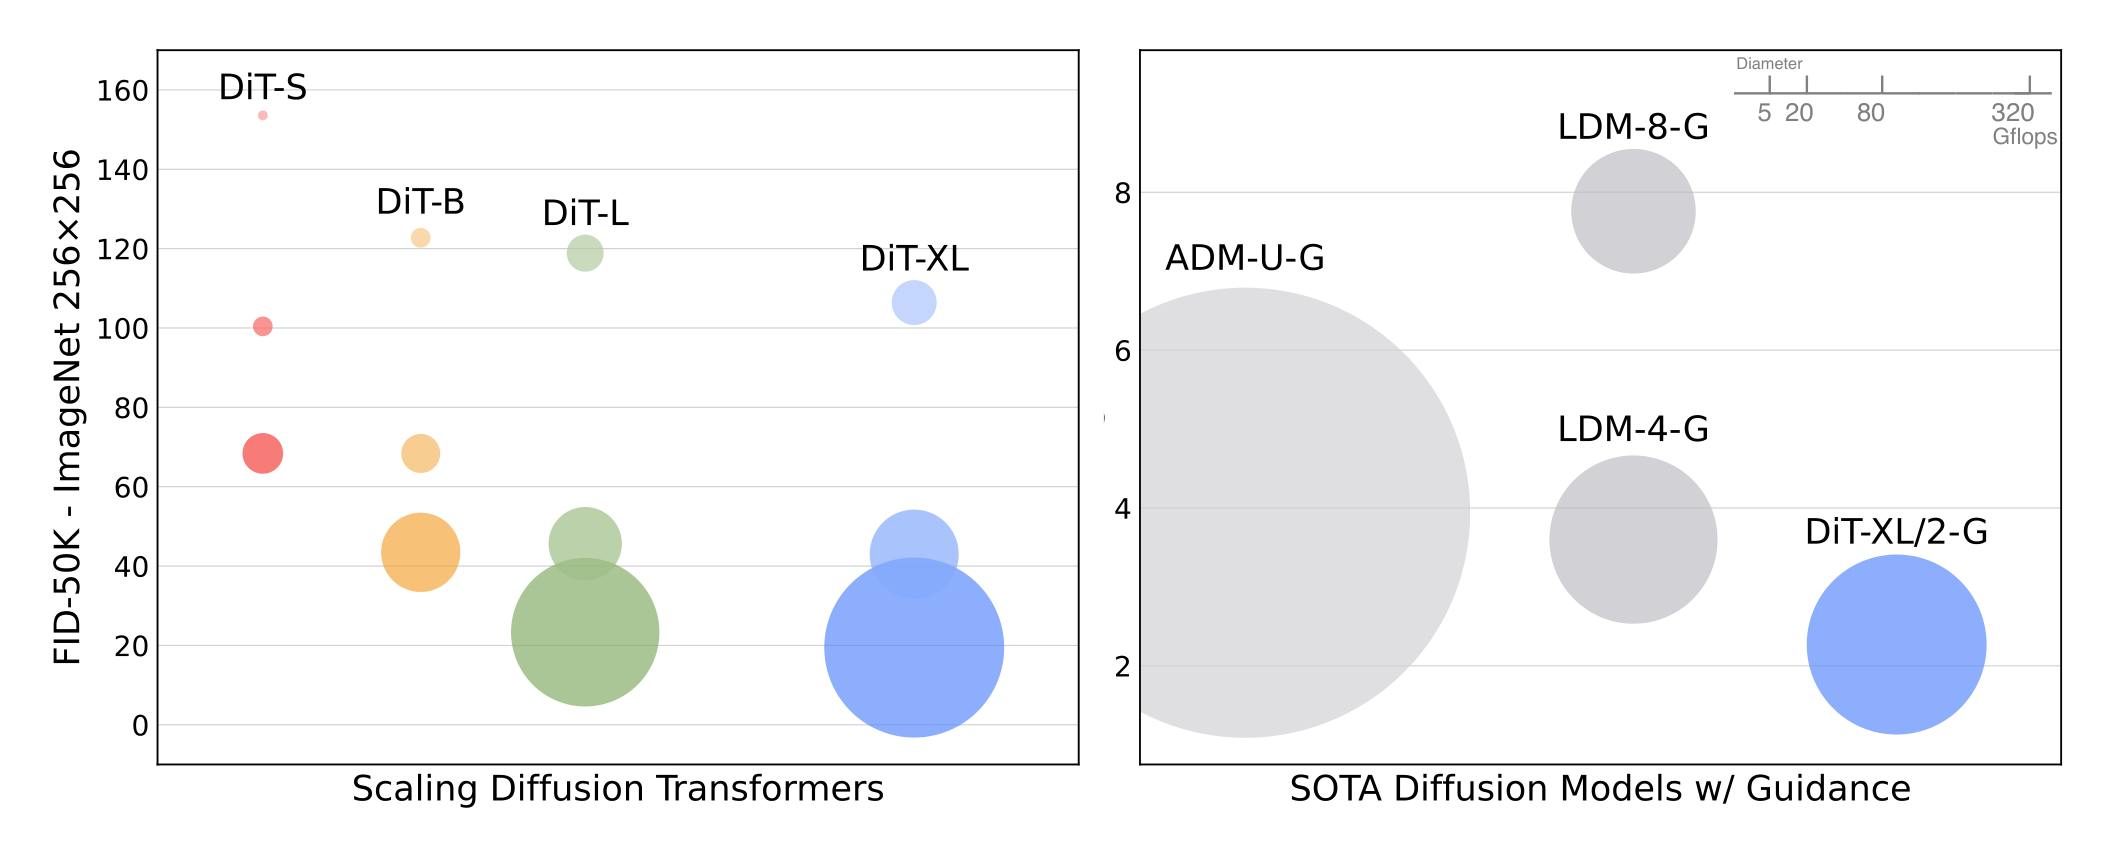
논문의 중심 발견은 연산량과 품질의 관계다. 아키텍처 복잡도를 파라미터 수가 아니라 forward pass 1회의 연산량인 Gflops로 재면, 12개 DiT 설정에서 Gflops와 FID-50K의 상관계수가 -0.93이다. Transformer를 깊고 넓게 키우든 patch를 작게 잘라 토큰 수를 늘리든 Gflops가 커지면 FID가 내려간다. 반대로 작은 모델에 샘플링 step을 늘려 test-time 연산을 더해도 큰 모델의 품질에는 이르지 못한다.
가장 큰 설정인 DiT-XL/2는 classifier-free guidance와 함께 ImageNet 256×256에서 FID 2.27을 기록해 LDM(3.60)과 StyleGAN-XL(2.30)을 포함한 모든 기존 생성 모델보다 낮은 FID를 냈다. 512×512에서는 FID 3.04로 기존 diffusion model 중 최저다. 이 결과를 118.6 Gflops로 얻었으므로 픽셀 공간 U-Net인 ADM(1120 Gflops)보다 훨씬 적은 연산으로 더 나은 품질에 도달한 셈이다.
배경
U-Net이 diffusion model의 기본 backbone이 된 경위
Transformer는 지난 5년 사이 자연어 처리와 비전을 비롯한 여러 도메인의 신경망 아키텍처를 대체했다. 그러나 이미지 생성 모델 가운데 diffusion model은 예외였다. Transformer가 자기회귀 모델에는 널리 쓰였지만, 이미지 생성의 최전선에 있던 diffusion model은 모두 convolution U-Net을 backbone으로 택하고 있었다.
이 U-Net은 Ho 외(2020)가 DDPM에 처음 도입한 것으로 PixelCNN++에서 물려받은 구조다. ResNet block으로 이루어진 convolution 모델에, 표준 U-Net과 달리 저해상도 단계에 공간 self-attention block을 삽입한 형태다. Dhariwal과 Nichol(ADM)이 adaptive normalization으로 조건을 주입하는 방식이나 convolution 채널 수 같은 세부를 ablation했지만, Ho 외의 상위 설계는 그대로 유지됐다.
아키텍처 통일이라는 문제의식
저자들은 diffusion model에서 아키텍처 선택이 갖는 의미를 해명하고 후속 생성 모델 연구를 위한 경험적 baseline을 제공하는 것을 목표로 삼는다. U-Net의 inductive bias가 diffusion model 성능에 필수가 아니라면 Transformer 같은 표준 설계로 대체할 수 있다. 그러면 diffusion model도 다른 도메인의 모범 사례와 학습 레시피를 물려받고, scalability와 robustness, 효율성 같은 성질을 유지하며, 도메인 간 연구도 쉬워진다.
DiT는 ViT의 모범 사례를 따른다. ViT는 시각 인식에서 convolution 신경망(ResNet 등)보다 효과적으로 scaling된다는 점이 이미 알려져 있었다. 따라서 논문의 관심은 backbone 교체 자체보다 "네트워크 복잡도 대비 샘플 품질"이라는 scaling 거동에 있다.
복잡도 지표로서의 Gflops
이미지 생성 문헌은 아키텍처 복잡도를 파라미터 수로 재는 관행이 있다. 그러나 파라미터 수는 해상도처럼 성능에 크게 영향을 주는 요인을 반영하지 못하므로 이미지 모델의 복잡도 대리 지표로는 부족하다. 이 논문은 아키텍처 설계 문헌을 따라 이론 Gflops로 복잡도를 잰다. 어떤 복잡도 지표가 최선인지는 응용에 따라 달라 여전히 논쟁 중이라고 저자들도 인정한다. 가장 가까운 선행 연구는 Nichol과 Dhariwal이 U-Net 계열의 scalability와 Gflops 성질을 분석한 작업이며, 이 논문은 같은 분석을 Transformer 계열에 적용한다.
핵심 개념
DDPM은 Gaussian noise를 단계적으로 더하는 forward process와 그것을 되돌리는 reverse process로 구성된다. forward process는 q(x_t|x_0) = N(x_t; sqrt(ᾱ_t) x_0, (1-ᾱ_t)I)이고 ᾱ_t는 하이퍼파라미터다. 재매개화하면 x_t = sqrt(ᾱ_t) x_0 + sqrt(1-ᾱ_t) ε_t로 샘플링할 수 있다. reverse process p_θ(x_{t-1}|x_t) = N(μ_θ(x_t), Σ_θ(x_t))의 평균과 공분산을 신경망이 예측한다. μ_θ를 noise 예측 network ε_θ로 다시 매개화하면 학습 목표가 예측 noise와 실제 noise의 MSE인 L_simple = ||ε_θ(x_t) - ε_t||²로 줄어든다. 공분산 Σ_θ까지 학습하려면 전체 KL 항이 필요하므로, DiT는 Nichol과 Dhariwal을 따라 ε_θ는 L_simple로, Σ_θ는 전체 변분 하한 L로 학습한다. 학습이 끝나면 x_{t_max} ~ N(0, I)에서 시작해 x_{t-1} ~ p_θ(x_{t-1}|x_t)를 반복해 이미지를 얻는다.
classifier-free guidance는 조건부 diffusion model의 샘플링을 log p(c|x)가 높은 x 쪽으로 유도하는 기법이다. Bayes 규칙으로 ∇_x log p(c|x) ∝ ∇_x log p(x|c) - ∇_x log p(x)가 성립하고, diffusion model의 출력을 score function으로 해석하면 예측 noise를 ε̂_θ(x_t, c) = ε_θ(x_t, ∅) + s(ε_θ(x_t, c) - ε_θ(x_t, ∅))로 바꾸는 것과 같다. s > 1이 guidance scale이며 s = 1이면 표준 샘플링이다. 조건 없는 예측 ε_θ(x_t, ∅)는 학습 중 조건 c를 무작위로 떨어뜨리고 학습된 null 임베딩 ∅으로 대체해 얻는다. 이 기법은 일반 샘플링보다 훨씬 좋은 샘플을 내는 것으로 널리 알려져 있으며 DiT에서도 같은 추세가 유지된다.
latent diffusion model(LDM)은 고해상도 픽셀 공간에서 diffusion을 학습하는 비용 문제를 두 단계로 푼다. 먼저 이미지를 작은 공간 표현으로 압축하는 autoencoder(인코더 E)를 학습하고, 이미지 x 대신 표현 z = E(x)의 diffusion model을 학습한다. E는 고정하며, 생성 시에는 diffusion model에서 z를 샘플링한 뒤 디코더로 x = D(z)를 복원한다. LDM은 ADM 같은 픽셀 공간 모델이 쓰는 Gflops의 일부만으로 좋은 성능을 내므로, 연산 효율을 중시하는 이 논문은 latent 공간을 출발점으로 삼는다.
ViT는 이미지를 patch 단위로 잘라 각 patch를 하나의 토큰으로 선형 임베딩한 뒤 표준 Transformer로 처리하는 인식 모델이다. DiT는 이 patch 토큰 방식을 latent 공간의 diffusion model에 옮긴다. 결과적으로 DiT 파이프라인은 기성 convolution VAE와 Transformer DDPM을 결합한 하이브리드 구성이다. 저자들은 DiT가 픽셀 공간에도 수정 없이 적용된다고 밝히지만 이 논문은 latent 공간만 실험한다.
이 논문은 표기 규약이 몇 가지 있다.
| 표기 | 뜻 |
|---|---|
| DiT-XL/2 | 모델 설정 XL에 patch size p = 2. 숫자가 작을수록 토큰이 많고 Gflops가 크다 |
| -G, cfg=1.50 | classifier-free guidance를 scale 1.50으로 적용한 결과 |
| Gflops | forward pass 1회의 이론 부동소수점 연산량(10억 단위). 파라미터 수 대신 쓰는 복잡도 지표 |
| FID-50K, FID-10K | 생성 샘플 5만 개 또는 1만 개로 잰 Fréchet Inception Distance. 낮을수록 좋다 |
| sFID, IS, Precision, Recall | 보조 지표. sFID는 낮을수록, 나머지는 높을수록 좋다 |
| ft-MSE, ft-EMA | Stable Diffusion의 VAE 디코더 가중치 2종. scaling 분석은 ft-MSE, 최종 벤치마크는 ft-EMA로 쟀다 |
| 40만 step, 700만 step | scaling 실험은 12개 모델을 40만 step까지, 최종 256×256 XL/2는 700만 step, 512×512 XL/2는 300만 step까지 학습했다 |
방법
전체 구조
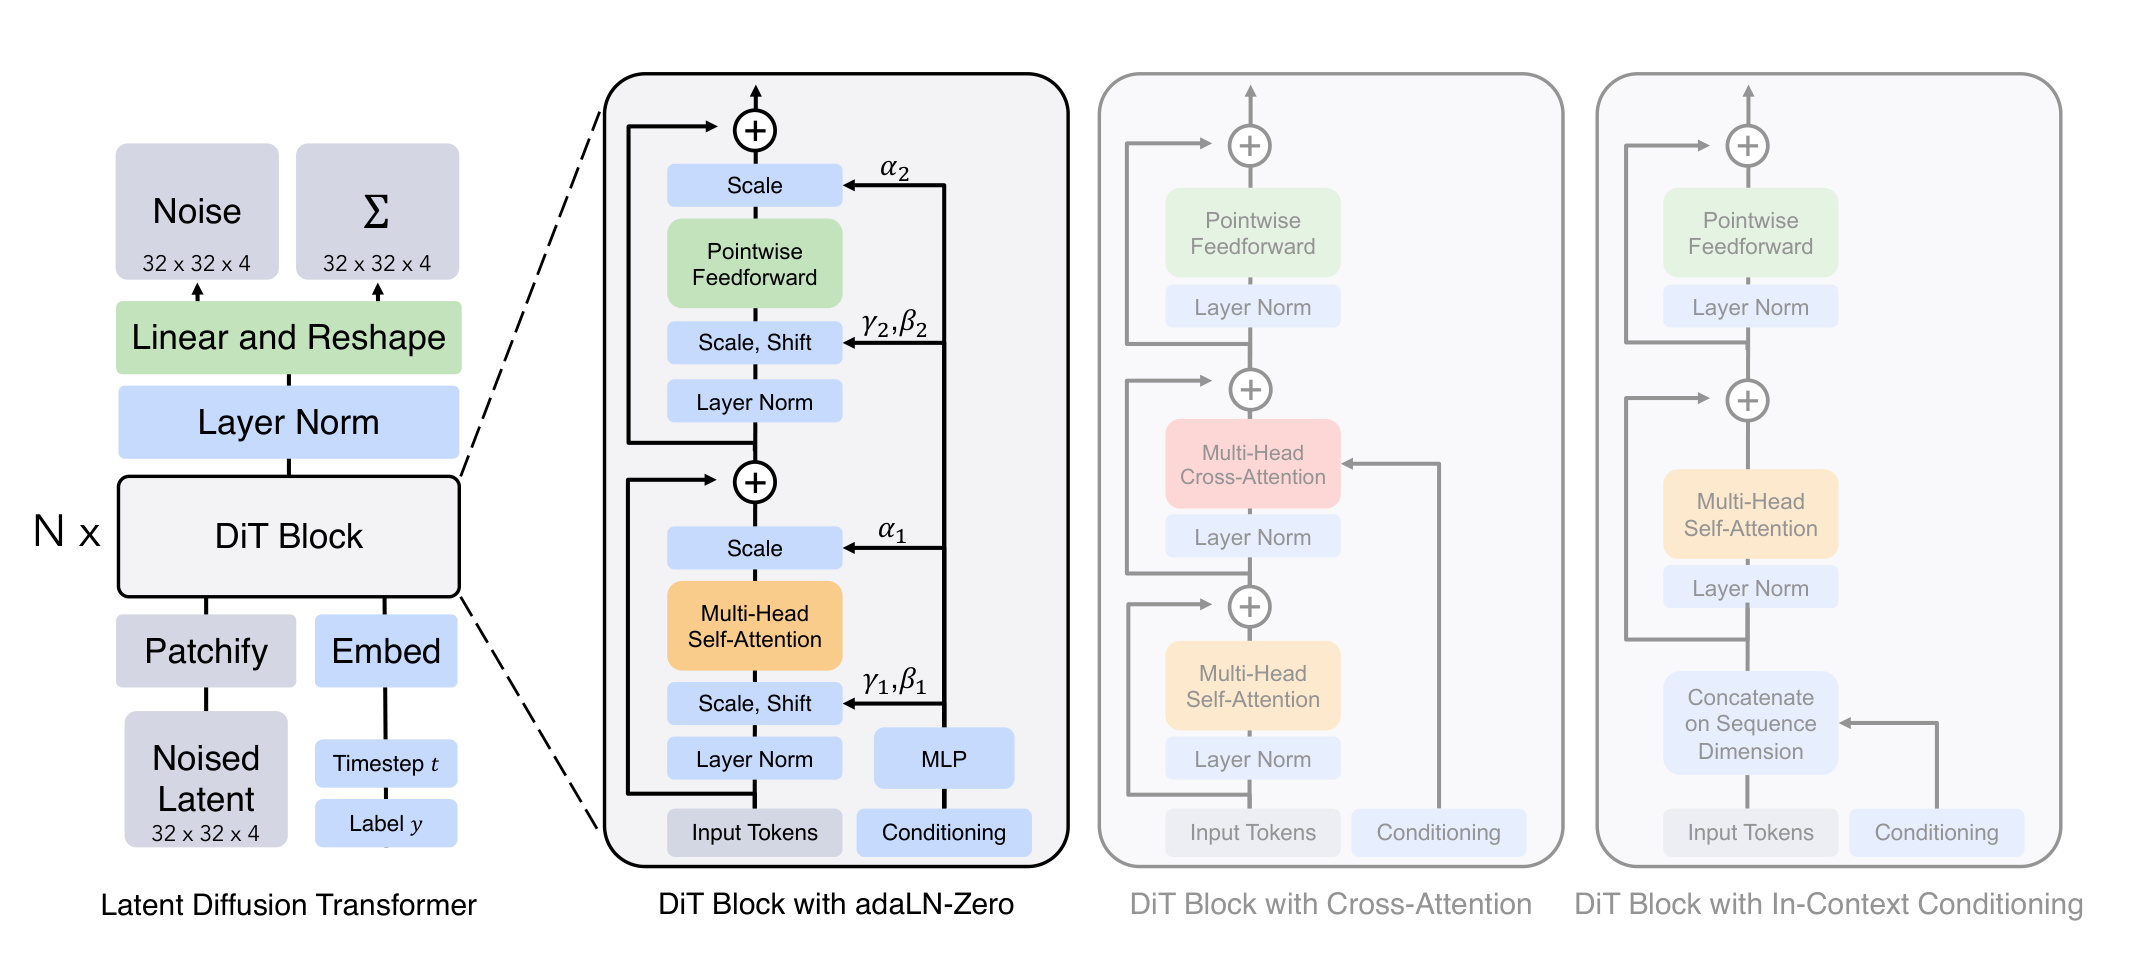
DiT는 표준 Transformer 아키텍처에 최대한 충실하게 설계해 scaling 성질을 그대로 유지하려 한다. 입력은 VAE가 만든 noised latent(256×256×3 이미지에서 32×32×4)이고, 이를 patchify로 토큰 시퀀스로 바꾼 뒤 DiT block N개를 통과시키고 마지막에 선형 디코더로 noise와 공분산 예측을 복원한다. timestep t와 class label y는 별도 임베딩을 거쳐 각 block의 conditioning 입력이 된다. 설계 공간은 patch size, block 구조, 모델 크기 세 가지다.
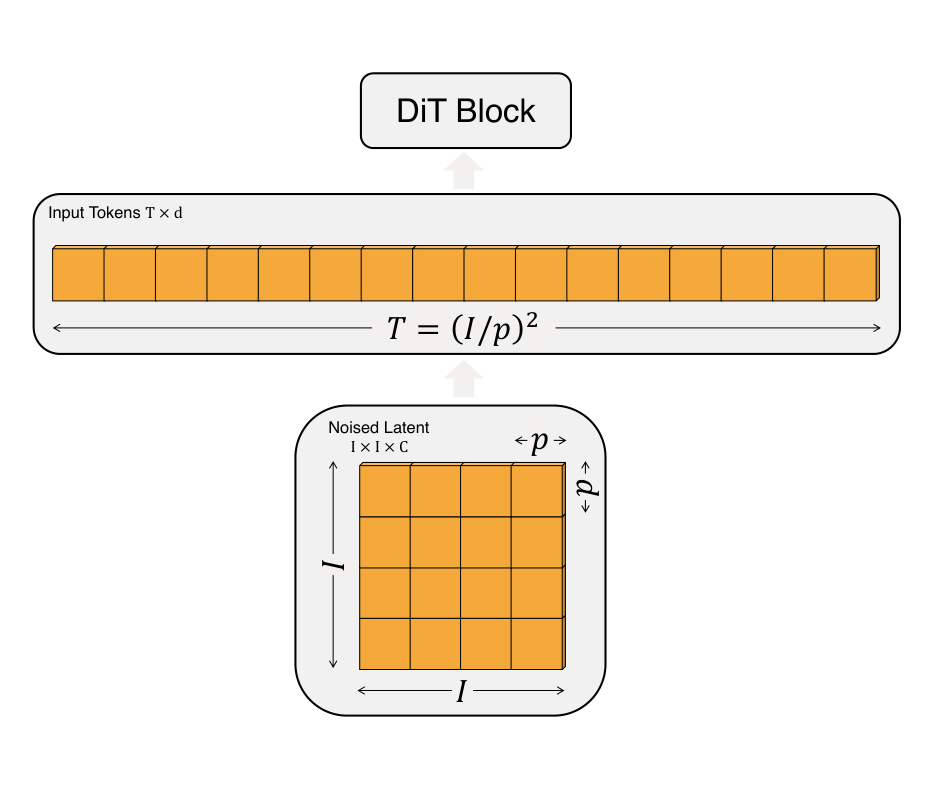
forward pass를 텐서 형태 기준으로 따라가면 다음과 같다. 256×256 이미지와 patch size 2를 기준으로 적었다.
| 단계 | 입력에서 출력으로 | 설명 |
|---|---|---|
| VAE 인코더 | 256×256×3 이미지에서 32×32×4 latent | 고정된 Stable Diffusion VAE. downsample 배율 8 |
| noise 추가 | x_0에서 x_t | forward process로 timestep t의 noised latent를 만든다 |
| patchify | 32×32×4에서 T×d 토큰 시퀀스 | p = 2면 T = 256. 각 patch를 선형 임베딩하고 sine-cosine positional 임베딩을 더한다 |
| conditioning 임베딩 | timestep t와 label y에서 d차원 벡터 | t는 256차원 frequency 임베딩과 2-layer MLP를 거친다. 두 임베딩의 합이 adaLN의 입력이다 |
| DiT block × N | T×d에서 T×d | adaLN-Zero가 γ, β, α를 회귀해 self-attention과 MLP의 출력을 조절한다 |
| 마지막 layer norm과 선형 디코더 | T×d에서 T×(p×p×2C) | 토큰마다 patch 크기의 noise와 공분산 값을 낸다 |
| reshape | 32×32×4 noise 예측과 32×32×4 공분산 예측 | Figure 3 왼쪽 상단의 두 출력 |
| VAE 디코더 (생성 시) | 샘플링한 latent에서 256×256×3 이미지 | diffusion 샘플링이 끝난 뒤 한 번만 실행한다 |
설계 공간은 세 요소로 요약된다. 논문은 이 세 요소의 조합을 실험해 어떤 요소가 품질을 좌우하는지 본다.
| 설계 요소 | 선택지 | 효과 |
|---|---|---|
| patch size p | 2, 4, 8 | 토큰 수 T = (I/p)². 파라미터는 거의 그대로이고 Gflops만 바뀐다 |
| block 구조 | in-context, cross-attention, adaLN, adaLN-Zero | 조건 주입 방식. ablation 뒤 adaLN-Zero를 기본값으로 채택한다 |
| 모델 크기 | S, B, L, XL | layer 수 N, hidden size d, head 수를 함께 키운다. 0.3에서 118.6 Gflops |
patchify
patchify는 DiT의 첫 layer로, 공간 표현 z를 각 patch를 선형 임베딩해 차원 d인 토큰 T개의 시퀀스로 바꾼다. 이어서 ViT의 sine-cosine positional 임베딩을 모든 토큰에 더한다. 토큰 수는 patch size p로 정해지며 T = (I/p)²이다. p를 절반으로 줄이면 T가 4배가 되므로 Transformer Gflops도 최소 4배가 된다. 반면 p를 바꿔도 파라미터 수는 거의 변하지 않는다. 즉 patch size는 파라미터를 늘리지 않고 연산량만 조절하는 손잡이다.
| 입력 latent | patch size p | 토큰 수 T | 비고 |
|---|---|---|---|
| 32×32×4 (256×256 이미지) | 8 | 16 | 설계 공간 최소 |
| 32×32×4 | 4 | 64 | Table 1의 Gflops 기준 |
| 32×32×4 | 2 | 256 | DiT-XL/2 256×256 |
| 64×64×4 (512×512 이미지) | 2 | 1024 | DiT-XL/2 512×512, 524.6 Gflops |
conditioning block 설계 4종
diffusion model은 noised 이미지 외에 timestep t와 class label c 같은 조건 입력을 처리해야 한다. 논문은 표준 ViT block에 조건을 주입하는 방식을 네 가지로 나눠 설계 공간에 포함한다. 네 방식은 표준 ViT block에 작지만 중요한 수정을 더한 것이다.
| block | 조건 주입 방식 | Gflops (XL/2) | 특징 |
|---|---|---|---|
| in-context conditioning | t와 c의 임베딩 벡터를 토큰 2개로 이미지 토큰 시퀀스 뒤에 붙이고 이미지 토큰과 똑같이 처리한다. 마지막 block 뒤에 조건 토큰을 제거한다 | 119.4 | ViT의 cls 토큰과 비슷하다. 표준 ViT block을 수정 없이 쓰며 추가 Gflops가 무시할 수준이다 |
| cross-attention | t와 c의 임베딩을 길이 2인 별도 시퀀스로 두고, multi-head self-attention 뒤에 multi-head cross-attention layer를 추가한다 | 137.6 | Vaswani 외의 원 설계와 LDM의 class 조건 방식과 비슷하다. 약 15% overhead로 Gflops 증가가 가장 크다 |
| adaLN | layer norm의 dimension별 scale γ와 shift β를 직접 학습하지 않고 t와 c 임베딩의 합에서 회귀한다 | 118.6 | GAN과 U-Net diffusion model의 adaptive normalization 관행을 따른다. Gflops 증가가 가장 작고, 모든 토큰에 같은 함수를 적용하는 유일한 방식이다 |
| adaLN-Zero | adaLN에 더해 residual 연결 직전에 적용하는 dimension별 scaling α도 회귀한다. α를 내는 MLP를 0 벡터를 출력하도록 초기화해 DiT block 전체가 항등 함수로 시작한다 | 118.6 | 추가 Gflops는 adaLN과 같이 무시할 수준이다 |
Figure 3 가운데 그림을 보면 adaLN-Zero block 하나가 conditioning MLP에서 벡터 여섯 개를 회귀한다. self-attention 앞의 layer norm에 γ₁과 β₁, attention 출력의 residual 직전에 α₁, MLP 앞의 layer norm에 γ₂와 β₂, MLP 출력의 residual 직전에 α₂가 적용된다. adaLN은 이 가운데 γ와 β 네 개만 회귀하므로 MLP 출력 크기가 hidden size의 4배이고, adaLN-Zero는 α 두 개가 더해져 6배가 된다.
| 회귀 벡터 | 적용 위치 | adaLN | adaLN-Zero |
|---|---|---|---|
| γ₁, β₁ | multi-head self-attention 앞 layer norm의 scale과 shift | 있음 | 있음 |
| α₁ | self-attention 출력이 residual에 더해지기 직전의 scale | 없음 | 있음 (0으로 초기화) |
| γ₂, β₂ | pointwise feedforward 앞 layer norm의 scale과 shift | 있음 | 있음 |
| α₂ | feedforward 출력이 residual에 더해지기 직전의 scale | 없음 | 있음 (0으로 초기화) |
α가 0이면 attention과 feedforward의 기여가 모두 0이 되어 block 출력이 입력 토큰과 같아진다. 따라서 adaLN-Zero DiT는 학습 시작 시점에 모든 block이 항등 함수인 상태에서 출발한다.
adaLN-Zero의 초기화는 ResNet 연구에서 왔다. Goyal 외는 각 residual block의 마지막 batch norm scale γ를 0으로 초기화하면 대규모 지도학습이 빨라진다는 것을 보였고, diffusion U-Net도 각 block의 마지막 convolution layer를 residual 연결 전에 0으로 초기화한다. adaLN-Zero는 같은 발상을 DiT block에 적용한 것이다. 구현 세부로, 각 adaLN 계층은 timestep과 class 임베딩의 합을 SiLU와 선형 layer에 통과시켜 hidden size의 4배(adaLN) 또는 6배(adaLN-Zero) 크기 출력을 낸다.
모델 크기
DiT는 hidden 차원 d인 block N개를 쌓는다. ViT를 따라 N, d, attention head 수를 함께 키우는 표준 Transformer 설정을 쓰며, S, B, L은 ViT의 설정을 그대로 가져오고 XL은 이 논문이 가장 큰 모델로 새로 추가한 설정이다. 네 설정에 patch size 3종을 곱하면 12개 모델이 되고 Gflops 범위는 0.3에서 118.6까지 넓게 퍼진다.
| 모델 | layer N | hidden size d | head 수 | Gflops (I=32, p=4) |
|---|---|---|---|---|
| DiT-S | 12 | 384 | 6 | 1.4 |
| DiT-B | 12 | 768 | 12 | 5.6 |
| DiT-L | 24 | 1024 | 16 | 19.7 |
| DiT-XL | 28 | 1152 | 16 | 29.1 |
Transformer 디코더
마지막 DiT block을 지난 이미지 토큰 시퀀스는 noise 예측과 대각 공분산 예측으로 디코딩해야 하며, 두 출력 모두 원래 공간 입력과 같은 형태다. DiT는 표준 선형 디코더를 쓴다. 마지막 layer norm(adaLN을 쓰면 adaptive)을 적용한 뒤 각 토큰을 p×p×2C 텐서로 선형 디코딩하고, 디코딩된 토큰을 원래 공간 배치로 되돌린다. C는 DiT 입력의 채널 수이므로 채널 2C는 noise용 C개와 공분산용 C개로 나뉜다.
학습 설정
학습 하이퍼파라미터는 거의 전부 ADM에서 가져왔고 모델 크기와 patch size에 관계없이 동일하다. 학습률, 감쇠와 warmup 일정, Adam β₁/β₂, weight decay를 튜닝하지 않았다.
| 항목 | 설정 |
|---|---|
| 데이터 | ImageNet class-conditional, 256×256과 512×512 |
| 초기화 | 마지막 선형 layer는 0, 나머지는 ViT 표준 초기화 |
| 최적화 | AdamW, 학습률 1×10⁻⁴ 고정, weight decay 없음, batch 256 |
| 데이터 증강 | 수평 뒤집기만 |
| warmup과 정규화 | 없음. 모든 설정에서 학습이 안정적이었고 손실 급증을 관찰하지 못했다 |
| EMA | 감쇠 0.9999. 보고 수치는 모두 EMA 모델 |
| VAE | Stable Diffusion의 pre-training된 VAE. downsample 배율 8, 인코더와 디코더 합쳐 8,400만 파라미터 |
| diffusion 일정 | t_max = 1000, 1×10⁻⁴에서 2×10⁻²까지 선형 분산 일정. ADM의 공분산 매개화와 timestep, label 임베딩 방식 |
| timestep 임베딩 | 256차원 frequency 임베딩 뒤에 hidden size 차원의 2-layer MLP(SiLU) |
| 비선형 | Transformer 본체는 GELU(tanh 근사) |
| 구현과 자원 | JAX, TPU v3 pod. DiT-XL/2는 TPU v3-256 pod에서 batch 256으로 초당 약 5.7 iteration |
ViT를 학습한 선행 연구 다수와 달리 학습률 warmup이나 정규화 없이도 DiT는 높은 성능에 도달했다. Transformer 학습에서 흔히 보이는 손실 급증도 없었다.
평가 방식
scaling 성능은 이미지 생성 모델의 표준 지표인 FID로 잰다. 선행 연구와 비교할 때는 관례대로 250 DDPM 샘플링 step으로 FID-50K를 보고한다. FID는 구현 세부에 민감하므로 모든 값은 샘플을 내보내 ADM의 TensorFlow 평가 suite로 계산했다. 본문 실험의 FID는 별도 표기가 없으면 guidance 없이 잰 값이고, Inception Score, sFID, Precision/Recall을 보조 지표로 함께 보고한다.
결과
실험은 다섯 가지 질문에 차례로 답한다. 각 절이 하나씩 다룬다.
| 질문 | 실험 | 결론 |
|---|---|---|
| 조건을 어떻게 주입해야 하는가 | DiT-XL/2 4종 block 비교 | adaLN-Zero가 FID 최저, 연산 추가도 최소 |
| 모델 크기와 patch size를 키우면 좋아지는가 | 12개 모델 40만 step | 두 방향 모두 학습 전 구간에서 FID 개선 |
| 품질을 결정하는 변수는 무엇인가 | Gflops 대 FID 산점도 | Gflops와 FID 상관 -0.93. 파라미터 수가 아니라 연산량 |
| 큰 모델이 연산 효율도 좋은가 | 총 학습 연산량 대 FID | 큰 모델이 같은 연산량에서 더 낮은 FID |
| 샘플링 연산이 모델 연산을 대신할 수 있는가 | 샘플링 step 16에서 1000까지 | 대신하지 못한다 |
block 설계 ablation
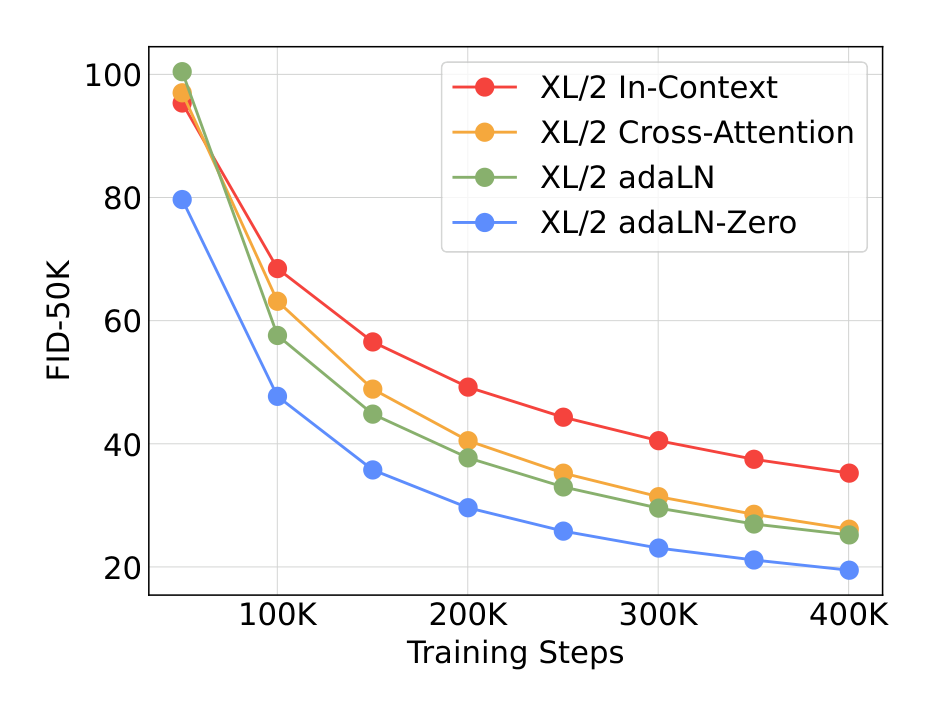
Gflops가 가장 큰 DiT-XL/2 4개를 block 설계만 다르게 학습해 FID를 추적했다. adaLN-Zero가 cross-attention과 in-context보다 FID가 낮으면서 연산 효율도 가장 좋았다. 40만 step에서 adaLN-Zero의 FID는 in-context의 거의 절반이어서 conditioning 방식이 모델 품질에 결정적임을 보여준다. 초기화도 중요하다. 연산량이 같은 adaLN보다 각 block을 항등 함수로 초기화한 adaLN-Zero가 뚜렷이 낫다. 이후 논문의 모든 모델은 adaLN-Zero block을 쓴다.
| block (DiT-XL/2, 40만 step) | Gflops | 파라미터 (M) | FID-50K (guidance 없음) |
|---|---|---|---|
| in-context | 119.37 | 449 | 35.24 |
| cross-attention | 137.62 | 598 | 26.14 |
| adaLN | 118.56 | 600 | 25.21 |
| adaLN-Zero | 118.64 | 675 | 19.47 |
모델 크기와 patch size scaling
설정 4종(S, B, L, XL)과 patch size 3종(8, 4, 2)을 조합한 12개 모델을 40만 step 학습했다. DiT-L과 DiT-XL은 다른 설정보다 상대 Gflops 차이가 작다는 점에 유의한다. 모든 경우에 모델을 키우거나 patch를 줄이면 diffusion model이 뚜렷이 좋아진다.
| 모델 | Gflops | 파라미터 (M) | FID-50K (40만 step, guidance 없음) |
|---|---|---|---|
| DiT-S/8 | 0.36 | 33 | 153.60 |
| DiT-S/4 | 1.41 | 33 | 100.41 |
| DiT-S/2 | 6.06 | 33 | 68.40 |
| DiT-B/8 | 1.42 | 131 | 122.74 |
| DiT-B/4 | 5.56 | 130 | 68.38 |
| DiT-B/2 | 23.01 | 130 | 43.47 |
| DiT-L/8 | 5.01 | 459 | 118.87 |
| DiT-L/4 | 19.70 | 458 | 45.64 |
| DiT-L/2 | 80.71 | 458 | 23.33 |
| DiT-XL/8 | 7.39 | 676 | 106.41 |
| DiT-XL/4 | 29.05 | 675 | 43.01 |
| DiT-XL/2 | 118.64 | 675 | 19.47 |
표는 두 방향의 scaling을 함께 보여준다. patch size를 고정하고 모델을 키우면(예: S/2 68.40에서 B/2 43.47, L/2 23.33, XL/2 19.47) FID가 학습 전 구간에서 내려간다. 모델 크기를 고정하고 patch를 줄여도(예: XL/8 106.41에서 XL/4 43.01, XL/2 19.47) 파라미터가 거의 그대로인데 FID가 크게 내려간다. 후자는 DiT가 처리하는 토큰 수만 늘린 결과다.
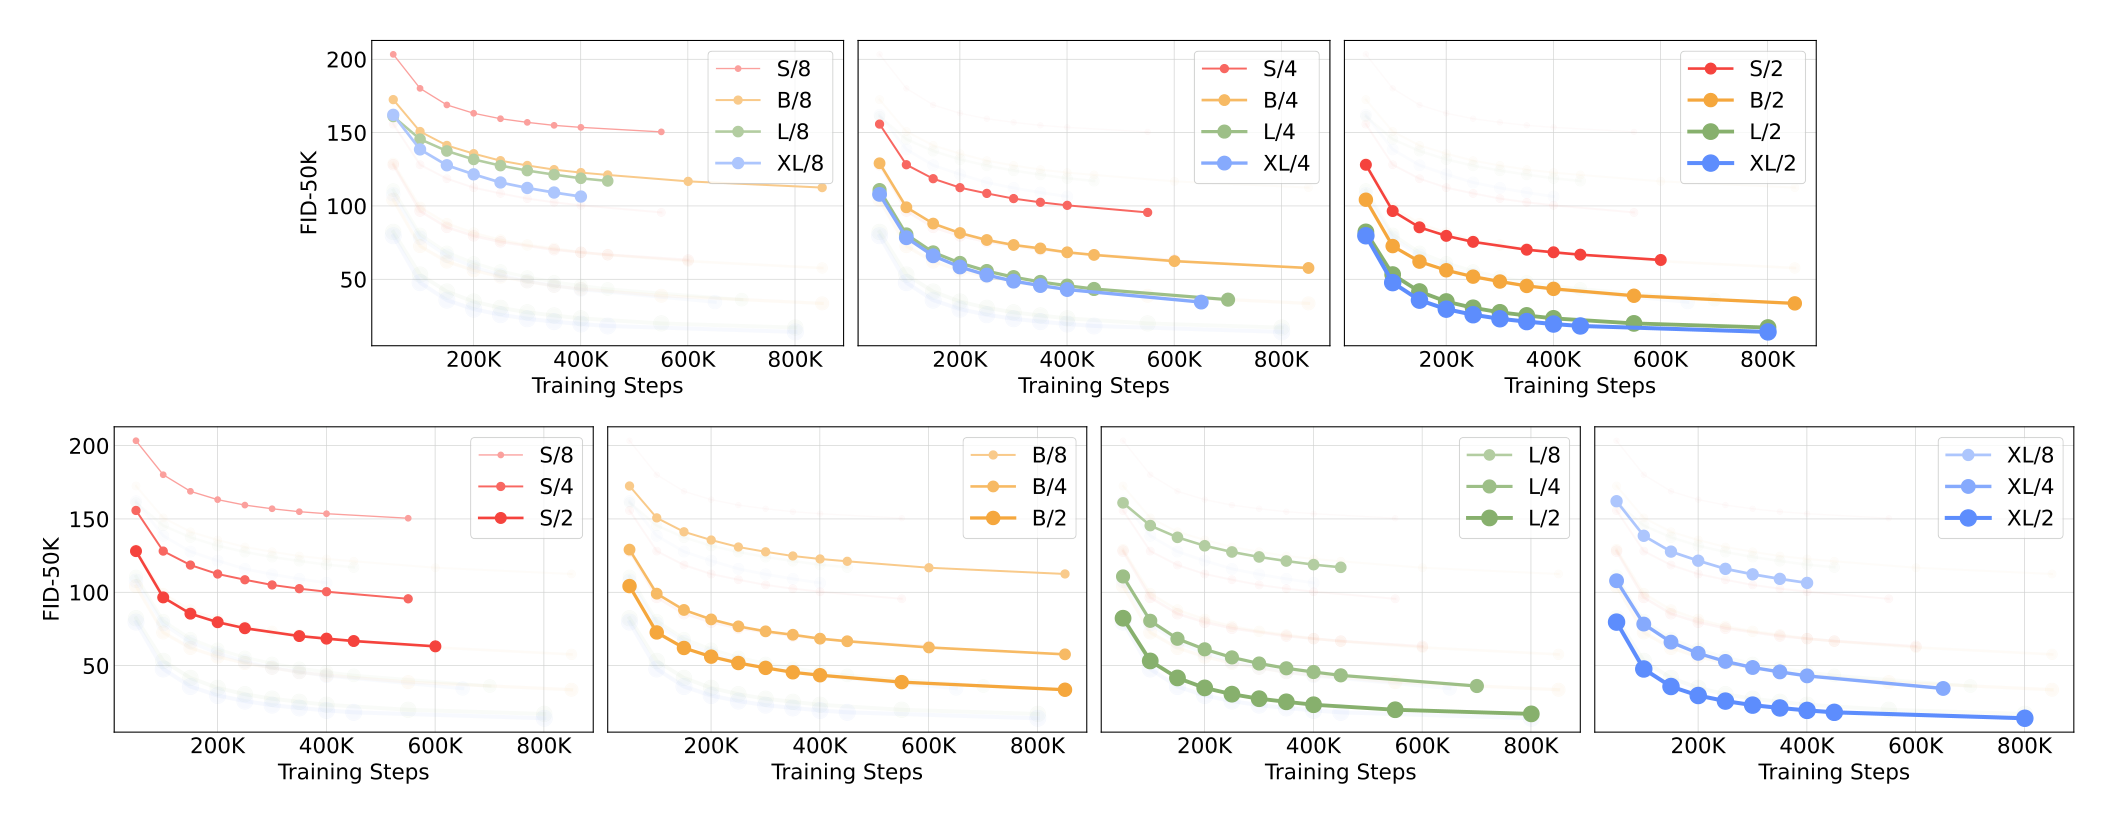
Gflops가 성능을 결정한다
Figure 6의 결과는 파라미터 수가 DiT 품질을 유일하게 결정하지 않는다는 것을 시사한다. 모델 크기를 고정하고 patch size를 줄이면 Transformer의 총 파라미터는 사실상 그대로(실제로는 약간 감소)이고 Gflops만 늘어나는데 성능이 좋아지기 때문이다. 이를 확인하기 위해 40만 step의 FID-50K를 모델 Gflops에 대해 그리면, 총 Gflops가 비슷한 설정은 FID도 비슷하다. 예를 들어 DiT-S/2(6.06 Gflops)의 FID 68.40과 DiT-B/4(5.56 Gflops)의 FID 68.38은 파라미터가 33M과 130M으로 4배 차이 나는데도 거의 같다. 모델 Gflops와 FID-50K의 상관계수는 -0.93이며, 저자들은 추가 모델 연산이 DiT 개선의 핵심 요소라고 결론짓는다.
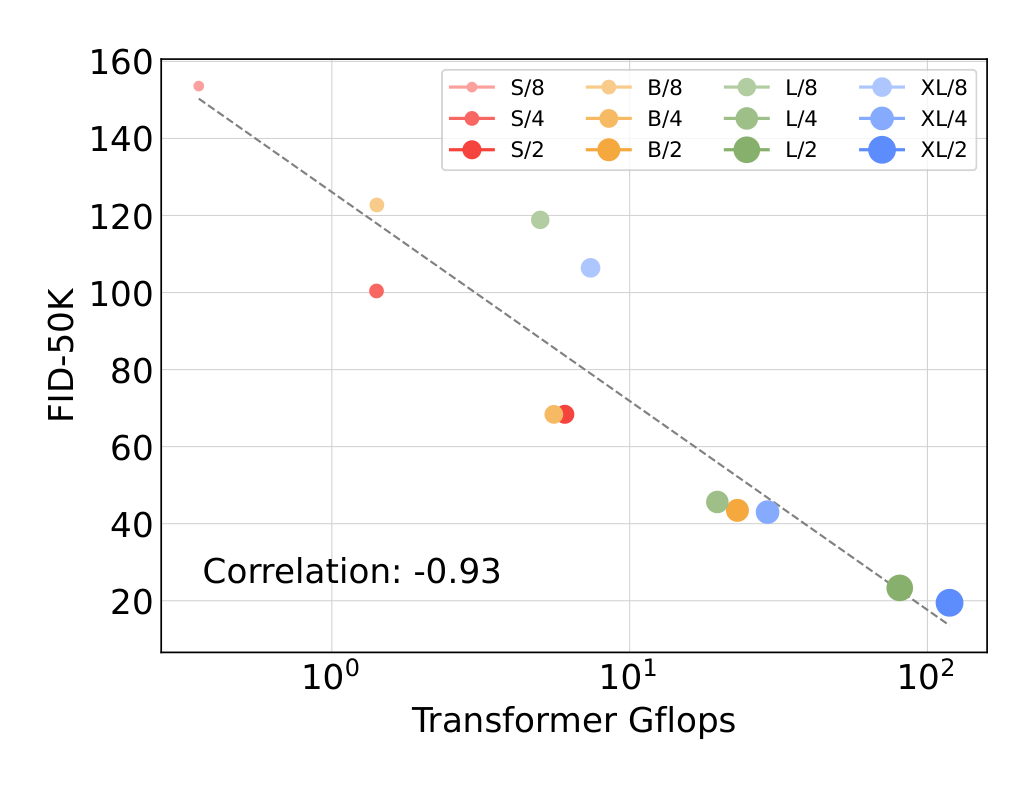
이 추세는 FID 이외의 지표에서도 유지된다. 부록 Figure 12는 40만 step에서 Transformer Gflops와 다섯 지표의 상관을 함께 보인다. Inception Score와 Precision이 모델 규모 확대의 이득을 특히 크게 받는다.
| 지표 | Transformer Gflops와의 상관계수 | 방향 |
|---|---|---|
| FID-50K | -0.93 | 낮을수록 좋음 |
| sFID | -0.86 | 낮을수록 좋음 |
| Inception Score | 0.90 | 높을수록 좋음 |
| Precision | 0.93 | 높을수록 좋음 |
| Recall | 0.86 | 높을수록 좋음 |
큰 모델의 연산 효율
총 학습 연산량은 모델 Gflops × batch size × 학습 step × 3으로 추정한다. 계수 3은 backward pass가 forward pass의 2배 연산이라는 근사다. 이 연산량에 대해 FID를 그리면(Figure 9) 작은 DiT 모델은 오래 학습하더라도 결국 더 적은 step을 학습한 큰 모델보다 연산 효율이 떨어진다. patch size만 다른 모델도 학습 Gflops를 맞춰 비교하면 성능 궤적이 다르며, XL/4는 약 10¹⁰ Gflops 이후 XL/2에 뒤진다. 학습 손실 곡선(부록 Figure 13)도 같은 방향이다. Transformer 크기든 토큰 수든 Gflops를 키우면 손실이 더 빨리 내려가고 더 낮은 값에서 포화한다. 저자들은 이를 언어 모델에서 scaling된 Transformer가 손실 곡선과 downstream 성능 모두 개선되는 추세와 같은 현상으로 본다.
scaling 효과는 샘플에서도 눈에 보인다. 40만 step에서 12개 모델에 같은 시작 noise, 샘플링 noise, class label을 주고 뽑은 샘플(Figure 7)은 모델 크기와 토큰 수를 키울수록 시각 충실도가 뚜렷이 좋아진다.
ImageNet 256×256 벤치마크
scaling 분석 뒤에 Gflops가 가장 큰 DiT-XL/2를 700만 step까지 계속 학습했다. classifier-free guidance를 쓰면 LDM이 세운 직전 최고 FID-50K 3.60을 2.27로 낮춰 모든 기존 diffusion model을 앞선다. StyleGAN-XL(2.30)을 포함한 모든 기존 생성 모델 중에서도 FID가 가장 낮다. DiT-XL/2는 시험한 모든 guidance scale에서 LDM-4와 LDM-8보다 recall이 높다. ADM과 비슷한 235만 step만 학습해도 FID 2.55로 여전히 모든 기존 diffusion model보다 낫다.
| 모델 | FID | sFID | IS | Precision | Recall |
|---|---|---|---|---|---|
| BigGAN-deep | 6.95 | 7.36 | 171.4 | 0.87 | 0.28 |
| StyleGAN-XL | 2.30 | 4.02 | 265.12 | 0.78 | 0.53 |
| ADM | 10.94 | 6.02 | 100.98 | 0.69 | 0.63 |
| ADM-U | 7.49 | 5.13 | 127.49 | 0.72 | 0.63 |
| ADM-G | 4.59 | 5.25 | 186.70 | 0.82 | 0.52 |
| ADM-G, ADM-U | 3.94 | 6.14 | 215.84 | 0.83 | 0.53 |
| CDM | 4.88 | - | 158.71 | - | - |
| LDM-8 | 15.51 | - | 79.03 | 0.65 | 0.63 |
| LDM-8-G | 7.76 | - | 209.52 | 0.84 | 0.35 |
| LDM-4 | 10.56 | - | 103.49 | 0.71 | 0.62 |
| LDM-4-G (cfg=1.25) | 3.95 | - | 178.22 | 0.81 | 0.55 |
| LDM-4-G (cfg=1.50) | 3.60 | - | 247.67 | 0.87 | 0.48 |
| DiT-XL/2 | 9.62 | 6.85 | 121.50 | 0.67 | 0.67 |
| DiT-XL/2-G (cfg=1.25) | 3.22 | 5.28 | 201.77 | 0.76 | 0.62 |
| DiT-XL/2-G (cfg=1.50) | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
표에서 guidance의 효과도 읽힌다. guidance 없는 DiT-XL/2는 FID 9.62에 recall 0.67로 다양성이 가장 높고, scale을 1.25와 1.50으로 올리면 FID와 IS, Precision이 좋아지는 대신 recall이 0.62와 0.57로 내려간다. 부록에서 저자들은 guidance scale이 클수록 시각 충실도는 오르고 다양성은 준다고 밝힌다.
연산 효율 면에서 DiT-XL/2(118.6 Gflops)는 latent 공간 U-Net인 LDM-4(103.6 Gflops)와 비슷한 수준이고, 픽셀 공간 U-Net인 ADM(1120 Gflops)이나 ADM-U(742 Gflops)보다 훨씬 적은 연산을 쓴다. 부록 Table 6이 이 baseline들의 Gflops를 해상도별로 정리한다. DDPM 구성 요소만 센 값이다.
| 모델 | 해상도 | base Gflops | upsampler Gflops | 총 Gflops |
|---|---|---|---|---|
| ADM | 128×128 | 307 | - | 307 |
| ADM | 256×256 | 1120 | - | 1120 |
| ADM | 512×512 | 1983 | - | 1983 |
| ADM-U | 256×256 | 110 | 632 | 742 |
| ADM-U | 512×512 | 307 | 2506 | 2813 |
| LDM-4 | 256×256 | 104 | - | 104 |
| LDM-8 | 256×256 | 57 | - | 57 |
ImageNet 512×512 벤치마크
256×256 모델과 같은 하이퍼파라미터로 새 DiT-XL/2를 512×512에서 300만 step 학습했다. 64×64×4 입력 latent를 p = 2로 patchify하면 토큰 1024개를 처리하고 524.6 Gflops가 된다. guidance와 함께 ADM의 직전 최고 FID 3.85를 3.04로 낮춰 이 해상도의 모든 기존 diffusion model을 앞선다. 토큰이 4배로 늘었어도 ADM(1983 Gflops)이나 ADM-U(2813 Gflops)보다 연산이 훨씬 적다.
| 모델 | FID | sFID | IS | Precision | Recall |
|---|---|---|---|---|---|
| BigGAN-deep | 8.43 | 8.13 | 177.90 | 0.88 | 0.29 |
| StyleGAN-XL | 2.41 | 4.06 | 267.75 | 0.77 | 0.52 |
| ADM | 23.24 | 10.19 | 58.06 | 0.73 | 0.60 |
| ADM-U | 9.96 | 5.62 | 121.78 | 0.75 | 0.64 |
| ADM-G | 7.72 | 6.57 | 172.71 | 0.87 | 0.42 |
| ADM-G, ADM-U | 3.85 | 5.86 | 221.72 | 0.84 | 0.53 |
| DiT-XL/2 | 12.03 | 7.12 | 105.25 | 0.75 | 0.64 |
| DiT-XL/2-G (cfg=1.25) | 4.64 | 5.77 | 174.77 | 0.81 | 0.57 |
| DiT-XL/2-G (cfg=1.50) | 3.04 | 5.02 | 240.82 | 0.84 | 0.54 |
이 표의 Precision과 Recall은 선행 연구(ADM)를 따라 실제 샘플 1000개로 계산했다. 512×512에서는 StyleGAN-XL(FID 2.41)이 DiT-XL/2-G(3.04)보다 여전히 낮은 FID를 유지하므로, "모든 기존 모델을 앞선다"는 서술은 256×256에 한정된다.
guidance scale의 효과
두 해상도의 DiT-XL/2 행만 모으면 guidance scale이 지표를 어떻게 움직이는지 드러난다. scale이 커질수록 FID와 IS, Precision이 좋아지고 Recall이 내려간다. 즉 guidance는 충실도를 사고 다양성을 내주는 손잡이이며, 두 해상도에서 같은 방향으로 움직인다.
| 해상도 | guidance scale | FID | sFID | IS | Precision | Recall |
|---|---|---|---|---|---|---|
| 256×256 | 없음 | 9.62 | 6.85 | 121.50 | 0.67 | 0.67 |
| 256×256 | 1.25 | 3.22 | 5.28 | 201.77 | 0.76 | 0.62 |
| 256×256 | 1.50 | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
| 512×512 | 없음 | 12.03 | 7.12 | 105.25 | 0.75 | 0.64 |
| 512×512 | 1.25 | 4.64 | 5.77 | 174.77 | 0.81 | 0.57 |
| 512×512 | 1.50 | 3.04 | 5.02 | 240.82 | 0.84 | 0.54 |
U-Net 모델과의 연산 효율 비교
Table 2, Table 3, Table 6의 값을 해상도별로 맞춰 놓으면 DiT의 연산 효율이 분명해진다. 256×256에서 DiT-XL/2는 LDM-4보다 Gflops가 약간 많지만 FID는 3.60에서 2.27로 낮고, 픽셀 공간 U-Net인 ADM 계열보다는 Gflops가 6분의 1에서 10분의 1 수준이다. 512×512에서도 ADM-U의 5분의 1 이하 연산으로 더 낮은 FID를 낸다.
| 해상도 | 모델 | Gflops | 최저 FID (guidance 포함) |
|---|---|---|---|
| 256×256 | DiT-XL/2 | 118.6 | 2.27 |
| 256×256 | LDM-4 | 103.6 (본문 표기) / 104 (Table 6) | 3.60 (LDM-4-G) |
| 256×256 | LDM-8 | 57 | 7.76 (LDM-8-G) |
| 256×256 | ADM | 1120 | 4.59 (ADM-G) |
| 256×256 | ADM-U | 742 | 3.94 (ADM-G, ADM-U) |
| 512×512 | DiT-XL/2 | 524.6 | 3.04 |
| 512×512 | ADM | 1983 | 7.72 (ADM-G) |
| 512×512 | ADM-U | 2813 | 3.85 (ADM-G, ADM-U) |
모델 연산 대 샘플링 연산
diffusion model은 학습 뒤에도 샘플링 step을 늘려 이미지당 연산을 더 쓸 수 있다는 점이 독특하다. 모델 Gflops가 품질을 크게 좌우한다면, 작은 모델이 샘플링 연산을 더 써서 큰 모델을 넘어설 수 있는지가 자연스러운 질문이다. 저자들은 40만 step 학습한 12개 모델 각각에 16, 32, 64, 128, 256, 1000 step 샘플링으로 FID-10K를 쟀다.
| 비교 | 샘플링 step | 이미지당 샘플링 연산 | FID-10K |
|---|---|---|---|
| DiT-L/2 | 1000 | 80.7 Tflops | 25.9 |
| DiT-XL/2 | 128 | 15.2 Tflops | 23.7 |
DiT-XL/2는 L/2의 5분의 1 연산으로 샘플링해도 FID-10K가 더 낮다. 일반적으로 샘플링 연산을 늘려도 모델 연산 부족을 보상하지 못한다.
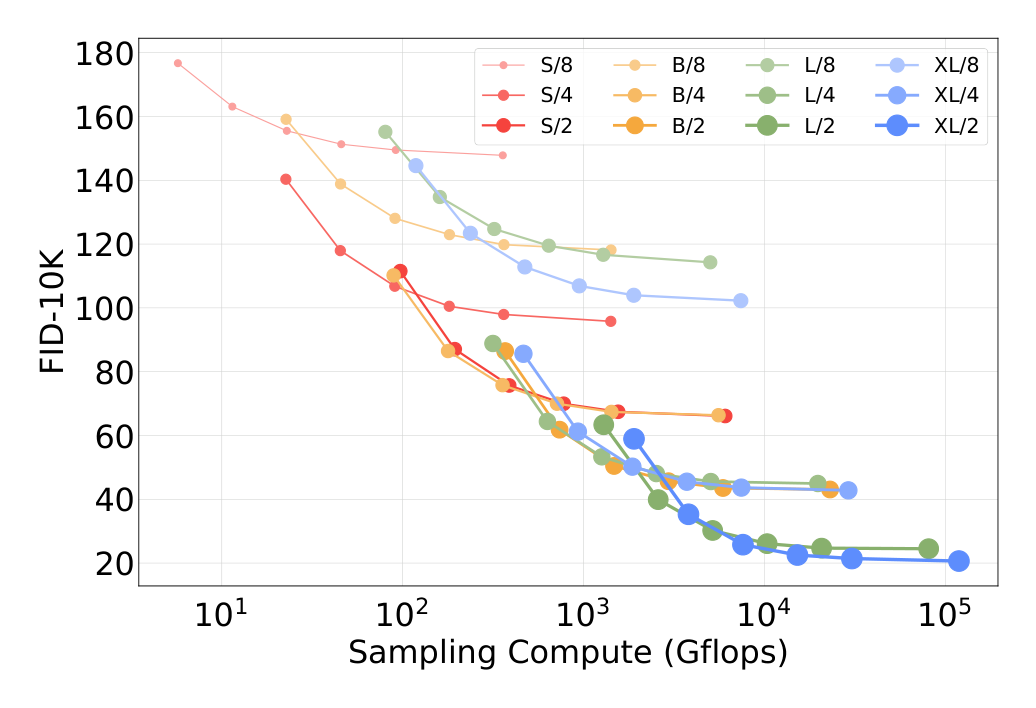
장기 학습 모델의 상세
부록 Table 4는 본문 실험에 쓰인 모든 DiT 모델의 상세를 담는다. 12개 scaling 모델과 block ablation 4개 외에 DiT-XL/2를 더 오래 학습한 값이 있다. 두 XL/2 모델 모두 FID 포화를 관찰하지 못해 가능한 한 오래 학습했다. 이 표의 FID-50K는 guidance 없이 ft-MSE 디코더로 잰 값이며, 파라미터와 Gflops는 VAE(8,400만 파라미터)를 제외한 수치다.
| 모델 | 해상도 | Gflops | 파라미터 (M) | 학습 step (천) | FID-50K (guidance 없음) |
|---|---|---|---|---|---|
| DiT-XL/2 | 256×256 | 118.64 | 675 | 400 | 19.47 |
| DiT-XL/2 | 256×256 | 118.64 | 675 | 2352 | 10.67 |
| DiT-XL/2 | 256×256 | 118.64 | 675 | 7000 | 9.62 |
| DiT-XL/2 | 512×512 | 524.60 | 675 | 1301 | 13.78 |
| DiT-XL/2 | 512×512 | 524.60 | 675 | 3000 | 11.93 |
VAE 디코더 ablation
실험 전체에서 기성 pre-training된 VAE를 썼다. ft-MSE와 ft-EMA는 LDM의 원래 f8 모델에서 디코더 가중치만 fine-tuning한 Stable Diffusion 디코더다. 5절 scaling 분석은 ft-MSE 디코더로 지표를 추적했고, Table 2와 Table 3의 최종 수치는 ft-EMA 디코더로 보고했다. 인코더가 같으므로 diffusion model을 다시 학습하지 않고 디코더만 바꿔 비교할 수 있다. 세 디코더의 결과는 서로 비슷하며, LDM의 원래 디코더를 써도 XL/2는 모든 기존 diffusion model을 앞선다.
| 디코더 (DiT-XL/2-G, cfg=1.5, 256×256) | FID | sFID | IS | Precision | Recall |
|---|---|---|---|---|---|
| original (LDM) | 2.46 | 5.18 | 271.56 | 0.82 | 0.57 |
| ft-MSE | 2.30 | 4.73 | 276.09 | 0.83 | 0.57 |
| ft-EMA | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
채널 일부에만 적용한 guidance
부록 A에 따르면 guidance 실험에서는 latent 4채널 전부가 아니라 앞 3채널에만 guidance를 적용했다. 조사 결과 scale을 조정하면 3채널과 4채널 guidance의 FID가 비슷했으며, 3채널 scale (1+x)는 4채널 scale (1+3x/4)로 잘 근사된다. 저자들은 일부 원소에만 guidance를 걸어도 좋은 성능이 나오는 현상이 흥미롭다고 보고 그 분석을 향후 과제로 남겼다.
| guidance 채널 | scale | FID-50K |
|---|---|---|
| 앞 3채널 | 1.5 | 2.27 |
| 4채널 전부 | 1.375 | 2.20 |
부록 샘플 목록
부록 B의 Figure 14부터 33까지는 두 DiT-XL/2 모델의 uncurated 샘플이다. 250 DDPM 샘플링 step과 ft-EMA 디코더로 생성했고, guidance scale과 class label을 바꿔 가며 다양성과 충실도의 관계를 보여준다. Figure 1과 Figure 11은 선별 샘플이며 Figure 11은 512×512에 scale 6.0, 256×256에 scale 4.0을 썼다.
| Figure | 해상도 | guidance scale | class label |
|---|---|---|---|
| 14, 15 | 512×512 | 4.0 | arctic wolf (270), volcano (980) |
| 16, 17 | 512×512 | 4.0 | husky (250), sulphur-crested cockatoo (89) |
| 18, 19 | 512×512 | 4.0 | cliff drop-off (972), balloon (417) |
| 20, 21 | 512×512 | 4.0 | lion (291), otter (360) |
| 22, 23 | 512×512 | 2.0 | red panda (387), panda (388) |
| 24, 25 | 512×512 | 1.5 | coral reef (973), macaw (88) |
| 26, 27 | 256×256 | 4.0 | macaw (88), dog sled (537) |
| 28, 29 | 256×256 | 4.0 | arctic fox (279), loggerhead sea turtle (33) |
| 30, 31 | 256×256 | 2.0 | golden retriever (207), lake shore (975) |
| 32, 33 | 256×256 | 1.5 | space shuttle (812), ice cream (928) |
관련 연구 맥락
DiT의 위치는 관련 연구를 계열별로 놓고 보면 분명해진다. Transformer는 언어, 비전, 강화학습, 메타러닝에서 도메인 특화 아키텍처를 대체했고 모델 크기와 학습 연산, 데이터에 대한 scaling 성질을 보였다. 이미지 생성에서도 픽셀 자기회귀 모델, 이산 codebook 위의 자기회귀 모델과 masked 생성 모델에 쓰였고 자기회귀 계열은 20B 파라미터까지 scaling됐다. 그러나 DDPM에서 Transformer는 DALL-E 2의 CLIP 이미지 임베딩 생성처럼 비공간 데이터에 한해 쓰였을 뿐, 이미지 diffusion model의 backbone으로 순수 Transformer를 쓴 사례는 없었다.
| 계열 | 대표 연구 (논문 인용 기준) | DiT와의 관계 |
|---|---|---|
| Transformer와 scaling | Vaswani 외 2017, ViT(Dosovitskiy 외 2020), Zhai 외 2022, Kaplan 외 2020 | 설정(S, B, L)과 scaling 관행, 손실 곡선 해석을 가져온다 |
| Transformer 기반 이미지 생성 | 픽셀 자기회귀(Chen 외 2020, Parmar 외 2018), codebook 자기회귀와 masked 생성(Esser 외 2020, Chang 외 2022, Yu 외 2022) | Transformer가 생성에 쓰인 선례. diffusion backbone은 다루지 않았다 |
| DDPM과 U-Net | Ho 외 2020, Dhariwal과 Nichol 2021(ADM), Nichol과 Dhariwal 2021 | 교체 대상인 backbone. 학습 하이퍼파라미터와 공분산 학습 방식을 물려받는다 |
| 샘플링 개선 | classifier-free guidance(Ho와 Salimans 2021), DDIM(Song 외 2020), cascaded DDPM(CDM) | DiT도 classifier-free guidance로 최종 수치를 낸다 |
| latent diffusion | Rombach 외 2022 | 두 단계 틀과 Stable Diffusion VAE를 그대로 쓴다 |
| 동시대 연구 | Jabri 외 2022 | attention 기반의 효율적 DDPM 아키텍처. DiT는 순수 Transformer를 탐구한다 |
| 복잡도 지표 | Radosavovic 외 2019, 2020 | Gflops로 복잡도를 재는 설계 문헌 |
한계
이 논문의 한계는 저자가 직접 적은 것과 자료를 읽으며 확인할 수 있는 것으로 나뉜다. 후자는 저자가 한계로 규정하지 않은 사실이므로 해석에 주의한다.
저자가 명시한 것:
- class-conditional 한정: 이 논문은 ImageNet class-conditional 생성만 다룬다. text 조건이나 다른 데이터셋 실험은 없다.
- 3채널 guidance 현상: 앞 3채널에만 guidance를 걸어도 성능이 좋은 이유는 설명하지 않았다.
- guidance의 다양성 손실: guidance scale을 키우면 시각 충실도가 오르는 대신 샘플 다양성이 준다.
- 복잡도 지표의 불확실성: Gflops를 복잡도 지표로 쓰지만, 어떤 지표가 최선인지는 응용에 따라 달라 아직 논쟁 중이라고 저자들이 인정한다.
자료에서 확인할 수 있으나 저자가 한계로 명시하지 않은 것:
- GAN 대비 우위의 범위: 256×256에서 sFID는 StyleGAN-XL(4.02)이 DiT-XL/2-G(4.60)보다 낮고, 512×512에서는 FID도 StyleGAN-XL(2.41)이 DiT-XL/2-G(3.04)보다 낮다. "모든 기존 생성 모델을 앞선다"는 서술은 256×256 FID에 한정된다.
- latent 표현 품질: VAE를 고정하고 기성 모델을 쓰므로 latent 표현 자체의 품질은 다루지 않는다. Table 5의 디코더 ablation은 디코더 가중치 3종만 비교한다.
- 디코더에 따른 수치 차이: Table 4의 512×512 XL/2 300만 step FID 11.93(ft-MSE)과 Table 3의 12.03(ft-EMA)은 디코더가 달라 생긴 차이다. Table 4 주석이 디코더 기준을 명시하므로 자료의 내적 모순은 아니다.
- 연산 효율 비교의 조건: 118.6 Gflops와 비교되는 ADM-U 742 Gflops는 256×256 값이고 2813 Gflops는 512×512 값이다. 해상도를 맞춰 읽어야 한다.
- latent 공간 한정 실험: 저자들은 DiT가 픽셀 공간에도 수정 없이 적용된다고 밝히지만 픽셀 공간 실험 결과는 없다.
후속 방향
저자들이 결론에서 제시한 방향은 두 가지이고, 부록에서 하나를 더 남겼다.
- 계속 scaling: 두 XL/2 모델 모두 FID 포화를 관찰하지 못했고 scaling 결과가 유망하므로, 후속 연구는 더 큰 모델과 더 많은 토큰으로 DiT를 계속 scaling해야 한다.
- text-to-image backbone: DALL-E 2나 Stable Diffusion 같은 text-to-image 모델의 drop-in backbone으로 DiT를 탐구할 수 있다. 이 논문은 class 조건만 실험했으므로 text 조건에서의 결과는 열린 문제다.
- 부분 채널 guidance 분석: latent 일부 원소에만 guidance를 걸어도 성능이 좋은 현상은 향후 과제로 남았다.
저장소 안에서의 위치
이 저장소에서 DiT는 생성 모델 기초 계보의 가운데에 놓인다. 앞에는 LDM이 있다. DiT는 LDM이 연 두 단계 틀과 Stable Diffusion VAE를 그대로 쓰고 U-Net backbone만 Transformer로 바꾸므로, 두 페이지를 이어 읽으면 "무엇을 유지하고 무엇을 바꿨는지"가 분명해진다. Table 2의 LDM-4-G(FID 3.60)는 DiT-XL/2-G(2.27)의 직접 비교 대상이기도 하다.
뒤에는 π0이 있다. π0-small의 action expert는 DiT 구조를 쓰고 adaLN-Zero 방식으로 flow matching의 timestep τ를 주입한다. 이미지 생성용으로 제안된 backbone과 conditioning 방식이 로봇 action 생성으로 옮겨간 경로이며, 그 생성 기법의 뿌리는 Flow Matching 페이지에 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| DiT (Diffusion Transformer) | U-Net 대신 표준 Transformer를 backbone으로 쓰는 diffusion model. latent patch 토큰 시퀀스 위에서 동작한다 |
| patchify | I×I×C latent를 p×p patch로 잘라 길이 T=(I/p)²인 토큰 시퀀스로 바꾸는 DiT의 첫 layer |
| adaLN-Zero | layer norm의 scale과 shift에 더해 residual 직전의 dimension별 scaling α를 timestep과 class 임베딩에서 회귀하고, α를 0으로 초기화해 block을 항등 함수로 시작하는 conditioning 설계. DiT 기본값 |
| classifier-free guidance | 조건 있는 예측과 조건 없는 예측의 차이를 scale s배로 증폭해 조건 충실도를 높이는 샘플링 기법. 모델명의 -G 접미사 |
| in-context conditioning | timestep과 class 임베딩을 토큰 2개로 시퀀스에 덧붙이는 가장 단순한 조건 주입 방식. ablation에서 FID가 가장 높았다 |
| Gflops | forward pass 1회의 이론 부동소수점 연산량(10억 단위). 이 논문이 파라미터 수 대신 쓰는 아키텍처 복잡도 지표 |
| ft-MSE, ft-EMA | LDM f8 VAE에서 디코더만 fine-tuning한 Stable Diffusion 디코더 가중치 2종. scaling 분석은 ft-MSE, 최종 벤치마크는 ft-EMA로 쟀다 |
관련 페이지
- High-Resolution Image Synthesis with Latent Diffusion Models: DiT가 그대로 빌려 쓰는 latent diffusion 틀과 Stable Diffusion VAE의 원 논문. DiT는 이 틀의 U-Net backbone만 Transformer로 바꾸며, Table 2의 LDM-4-G(FID 3.60)가 직접 비교 대상이다.
- Flow Matching for Generative Modeling: DDPM과 다른 학습 목표로 생성 모델을 학습하는 같은 시기의 논문. DiT 논문은 이를 인용하지 않지만, 아래 π0 페이지에서 DiT 구조와 flow matching이 한 모델 안에서 결합된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0-small의 action expert가 DiT 구조와 adaLN-Zero 방식의 timestep 주입을 채택한 VLA 논문. 이미지 생성용 backbone이 로봇 action 생성으로 옮겨간 사례다.
- 용어집: LLMs (Terminology Glossary): 일반 학습과 아키텍처 용어의 canonical 표기.