LLMs · PAPER · 2022
High-Resolution Image Synthesis with Latent Diffusion Models
요약
Latent Diffusion Model(LDM)은 diffusion model을 RGB pixel space가 아니라 미리 학습한 autoencoder의 저차원 latent space에서 학습시키는 생성 모델이다. 지각되지 않는 고주파 세부는 autoencoder가 제거하고 diffusion model은 의미 있는 구조만 배우므로, 품질을 유지하면서 학습과 추론 비용이 함께 줄어든다.
논문은 여기에 두 가지 장치를 더한다. 첫째, UNet backbone에 cross-attention을 결합해 text, bounding box layout, class label 같은 다양한 조건을 하나의 메커니즘으로 받는다. 둘째, super-resolution이나 inpainting처럼 조건이 공간적으로 정렬된 과제에서는 조건을 입력에 concat하고 모델을 convolutional 방식으로 적용해 학습 해상도 256²를 넘는 약 1024² 이미지를 만든다.
결과로 class-conditional ImageNet에서 LDM-4-G가 FID 3.60으로 ADM-G(4.59)를 더 적은 파라미터(400M 대 608M)로 앞섰고, Places inpainting에서 새 최고 기록(전체 샘플 FID 1.50)을 세웠다. MS-COCO text-to-image에서는 1.45B 파라미터로 GLIDE(6B)와 Make-A-Scene(4B)에 대등했다. 같은 wiki의 DiT 논문은 이 논문을 Stable Diffusion의 VAE 출처로 인용하며, LDM 틀 위에서 UNet backbone을 Transformer로 바꾼다.
배경
pixel space diffusion의 비용
diffusion model은 denoising autoencoder를 순차적으로 적용해 이미지 생성 과정을 분해하는 likelihood 기반 생성 모델이다. 논문이 나온 시점에 diffusion model은 class-conditional 합성과 super-resolution에서 최고 성능을 냈고, GAN과 달리 mode collapse와 학습 불안정이 없으며 파라미터 공유 덕분에 autoregressive 모델처럼 수십억 파라미터를 쓰지 않고도 자연 이미지의 복잡한 분포를 모델링했다.
문제는 비용이다. likelihood 기반 모델은 mode-covering 성질 때문에 데이터의 지각되지 않는 세부를 모델링하는 데 과도한 용량과 연산을 쓴다. DDPM의 reweighted 변분 목표가 초기 denoising step을 덜 샘플링해 이 문제를 완화하지만, 학습과 평가는 여전히 고차원 RGB 공간에서 함수 평가와 그래디언트 계산을 반복해야 한다. 그 결과 가장 강력한 diffusion model의 학습에는 1501,000 V100-day가 들고, 단일 A100으로 5만 장을 샘플링하는 데 약 5일이 걸리며, 한 샘플에 251,000 step을 순차 실행해야 한다.
저자는 이 비용이 두 가지 결과를 낳는다고 본다. 학습에 필요한 자원을 극소수 연구 집단만 갖추어 탄소 발자국이 크고, 학습된 모델의 평가도 시간과 메모리 면에서 비싸다. 따라서 성능을 해치지 않으면서 학습과 샘플링의 연산 복잡도를 함께 줄이는 방법이 접근성을 높이는 열쇠가 된다.
기존 생성 모델 계보
논문은 관련 연구를 다음과 같이 정리한다.
| 계열 | 대표 모델 | 강점 | 한계 |
|---|---|---|---|
| GAN | BigGAN, StyleGAN | 고해상도 이미지를 빠르게 샘플링하고 지각 품질이 좋다 | 최적화가 어렵고 전체 데이터 분포를 담기 힘들다 |
| VAE, flow 기반 | NICE, RealNVP, Glow, NVAE | 고해상도 합성이 효율적이다 | 샘플 품질이 GAN에 못 미친다 |
| autoregressive 모델(ARM) | PixelRNN, PixelCNN, Sparse Transformer, iGPT와 두 단계 접근 VQ-VAE-2, VQGAN, DALL-E | 밀도 추정이 강하다 | 연산이 많은 구조와 순차 샘플링 때문에 저해상도에 머문다. 두 단계 접근은 압축된 discrete latent를 ARM으로 모델링하지만 ARM 학습에 필요한 높은 압축률이 성능을 제한한다 |
| diffusion model(DM) | DDPM, ADM, SR3, CDM | 밀도 추정과 샘플 품질 모두 최고 수준이고 UNet backbone이 이미지의 inductive bias와 잘 맞는다 | pixel space 평가라 추론이 느리고 학습 비용이 매우 크다 |
| latent에서의 score 기반 모델 | LSGM, D2C | 인코더와 diffusion prior를 결합한다 | LSGM은 인코더와 prior를 동시에 학습해 재구성과 생성 사이의 미묘한 가중치 조정이 필요하고, D2C는 얼굴처럼 구조가 강한 이미지에 집중한다 |
VQGAN과 DALL-E 같은 두 단계 접근은 1단계에서 이미지를 discrete latent로 압축하고 2단계에서 Transformer로 latent 분포를 배운다. 이때 latent를 임의의 1D 순서로 펼쳐 autoregressive하게 모델링하므로 latent의 2차원 구조를 대부분 무시하고, Transformer 학습이 감당할 수 있도록 압축률을 높여야 하므로 재구성 품질이 떨어진다. 압축을 줄이면 파라미터가 수십억 개로 늘고 연산 비용이 커진다.
rate-distortion 관점
논문의 출발점은 학습된 pixel space diffusion model의 rate-distortion 곡선 분석이다. 디지털 이미지의 bit 대부분은 지각되지 않는 세부에 해당하며, likelihood 기반 모델의 학습은 두 구간으로 나뉜다. 앞 구간인 perceptual compression은 고주파 세부를 제거하지만 의미 변화는 거의 배우지 않고, 뒤 구간인 semantic compression에서 실제 생성 모델이 데이터의 의미 구성과 개념 구성을 배운다.
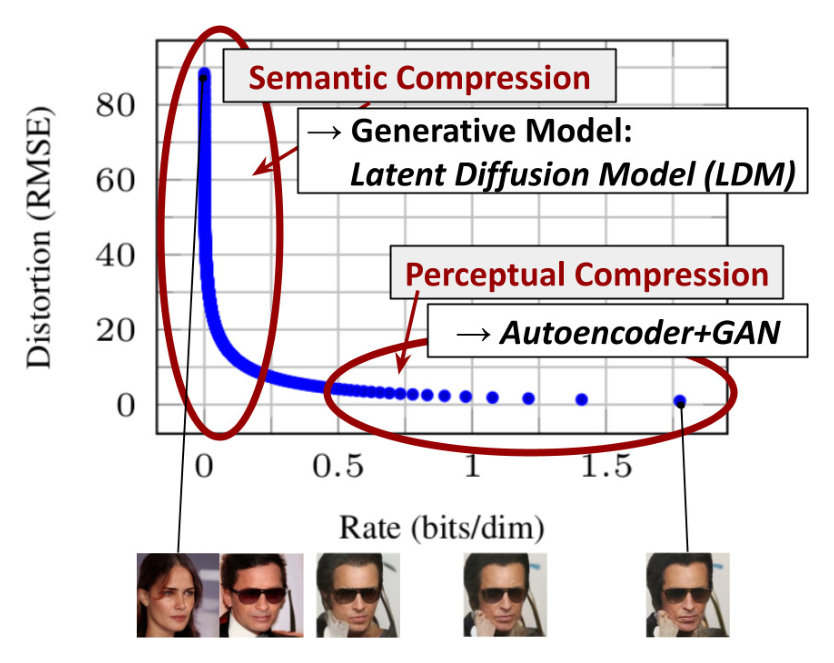
diffusion model은 해당 손실 항을 최소화해 의미 없는 정보를 억제할 수 있지만, 그래디언트와 backbone은 여전히 모든 픽셀에서 평가돼야 하므로 불필요한 연산이 생긴다. 따라서 논문은 지각적으로 동등하되 연산에 더 적합한 공간을 먼저 찾고, 그 공간에서 diffusion model을 학습하는 전략을 택한다.
논문이 내세우는 기여
서론은 기여를 여섯 가지로 정리한다.
| 번호 | 기여 | 근거 절 |
|---|---|---|
| (i) | 순수 Transformer 기반 접근보다 고차원 데이터로 매끄럽게 확장된다. 더 충실한 재구성을 주는 압축 수준에서 동작하고(Fig 1) megapixel 고해상도 합성에 효율적으로 적용된다 | Sec 3, 4.3.2 |
| (ii) | unconditional 합성, inpainting, stochastic super-resolution 등 여러 과제와 데이터셋에서 경쟁력 있는 성능을 내면서 학습과 추론 비용을 함께 낮춘다 | Sec 4.2, 4.4, 4.5 |
| (iii) | 인코더와 디코더를 score 기반 prior와 동시에 학습하는 LSGM과 달리 재구성과 생성 능력 사이의 미묘한 가중치 조정이 필요 없다. 재구성이 매우 충실하고 latent 정규화가 거의 필요 없다 | Sec 3.1, 4.2 |
| (iv) | super-resolution, inpainting, semantic synthesis처럼 조건이 조밀한 과제에서 convolutional 방식으로 약 1024² 이미지를 만든다 | Sec 4.3.2 |
| (v) | cross-attention 기반 범용 conditioning으로 multi-modal 학습을 가능하게 하고 class-conditional, text-to-image, layout-to-image 모델을 학습한다 | Sec 3.3, 4.3.1 |
| (vi) | pre-training된 latent diffusion 모델과 autoencoder를 공개한다 | github.com/CompVis/latent-diffusion |
v1과 v2의 차이
raw는 2022년 4월 13일의 v2이며 부록 A가 v1 대비 변경을 밝힌다. v1의 날짜는 raw 본문에 없다.
| 항목 | v2에서의 변경 |
|---|---|
| text-to-image | 1.45B 파라미터 모델을 새로 학습해 Sec 4.3 결과를 갱신했다. 같은 시기에 나온 GLIDE, LAFITE와 이후에 나온 Make-A-Scene과의 비교를 추가했다 |
| class-conditional ImageNet | 더 큰 batch size로 재학습해 Table 3과 Sec D.4를 갱신했다. Fig 26과 Fig 27의 정성 결과도 갱신했다 |
| guidance | text-to-image와 class-conditional 모델 모두 classifier-free guidance를 적용해 시각적 충실도를 높였다 |
| user study | Saharia et al.의 방식으로 inpainting과 super-resolution 모델의 사람 평가를 추가했다 |
| 그림 배치 | Fig 5를 본문에 추가하고 Fig 18을 부록으로 옮겼으며 Fig 13을 부록에 추가했다 |
핵심 개념
diffusion model은 정규분포 변수를 점진적으로 denoising해 데이터 분포 p(x)를 배우는 확률 모델이다. 길이 T의 고정 Markov chain으로 데이터에 noise를 더하는 forward 과정을 정하고, 그 역과정을 신경망 ε_θ(x_t, t)가 각 시점의 noise를 예측하는 형태로 학습한다.
latent와 다운샘플링 계수 f는 1단계 autoencoder의 출력과 압축 정도를 뜻한다. 인코더 E가 H×W×3 이미지를 h×w×c 텐서 z로 바꿀 때 f = H/h = W/w이고, 논문은 f = 2^m을 실험한다. LDM-f는 계수 f로 학습한 모델을, LDM-1은 압축 없는 pixel 기반 diffusion을 가리킨다. 예를 들어 LDM-4는 256×256 이미지를 64×64×3 latent로, LDM-8은 32×32×4 latent로 줄인다.
inductive bias는 모델 구조가 데이터에 대해 미리 가정하는 성질을 뜻한다. UNet은 2D convolution으로 구성돼 공간적으로 이웃한 픽셀이 서로 관련된다는 가정을 품고 있으며, 논문은 이 성질 덕분에 diffusion model이 이미지 같은 공간 데이터에 효과적이라고 본다.
perceptual compression과 semantic compression은 rate-distortion 곡선에서 본 학습의 두 구간이다. 전자는 autoencoder가 맡아 지각되지 않는 세부를 걷어내고, 후자는 diffusion model이 맡아 의미 구성을 배운다.
KL-reg와 VQ-reg는 latent 분산이 임의로 커지지 않도록 autoencoder에 거는 두 정규화다. KL-reg는 VAE처럼 표준정규 분포를 향한 약한 KL penalty이고, VQ-reg는 VQGAN처럼 디코더 안에 벡터 양자화(vector quantization) 층을 두는 방식이다.
cross-attention conditioning은 조건 y를 도메인별 인코더 τ_θ로 바꾼 뒤 UNet 중간 층의 cross-attention에 key와 value로 주입하는 방식이다. query는 UNet 자신의 표현에서 나온다.
classifier-free guidance는 Ho and Salimans가 제안한 guidance 기법으로 scale s로 조건 반영 강도를 조절한다. 논문은 접미사 -G로 guidance를 적용한 모델을 표기한다. DDIM은 Song et al.의 sampler로 step 수와 η 값으로 설정하며, 실험 전반에서 10~500 step을 쓴다.
FID는 생성 이미지와 실제 이미지의 feature 분포 거리로 낮을수록 좋고, Inception Score(IS)는 높을수록 좋다. Precision과 Recall은 생성 분포가 데이터 manifold를 얼마나 정확히, 얼마나 넓게 덮는지를 잰다. R-FID는 autoencoder가 복원한 이미지의 FID로 1단계의 재구성 품질을 나타낸다.
convolutional 샘플링은 공간 조건을 concat한 LDM을 학습 해상도보다 큰 입력에 convolution처럼 적용해 512²에서 1024² 이미지를 만드는 방식이다. 학습은 256² crop으로 하고 평가에서만 크기를 키운다.
방법
두 단계 학습의 전체 구조
LDM은 압축 학습과 생성 학습을 명시적으로 분리한다. 1단계에서 이미지 공간과 지각적으로 동등하되 차원이 낮은 공간을 배우는 autoencoder를 학습하고, 2단계에서 그 latent space 안에서 diffusion model을 학습한다. 샘플링 결과는 디코더를 한 번 통과시켜 이미지로 복원한다.
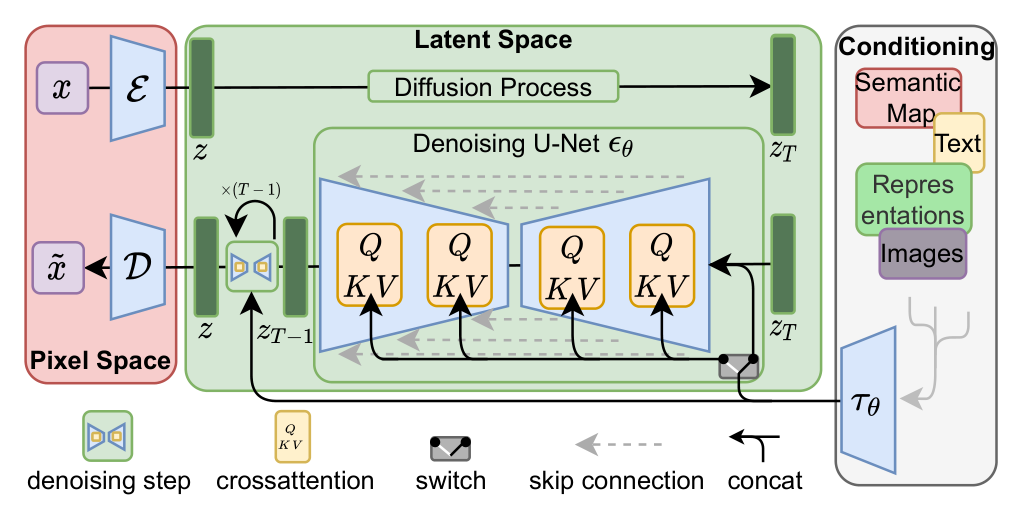
이 분리의 이점은 세 가지다.
- 저차원 공간에서 샘플링하므로 diffusion model의 연산이 훨씬 효율적이다.
- UNet 구조에서 물려받은 inductive bias가 공간 구조를 가진 데이터에 효과적이어서, 이전 접근이 요구한 품질을 깎는 공격적 압축이 필요 없다.
- 범용 압축 모델을 한 번만 학습하면 여러 diffusion model 학습이나 단일 이미지 CLIP-guided 합성 같은 다른 응용에 latent space를 재사용할 수 있다.
1단계 autoencoder
autoencoder는 VQGAN을 따라 perceptual 손실과 patch 기반 adversarial 손실을 결합해 학습한다. adversarial 손실은 재구성을 이미지 manifold에 가두어 국소 사실성을 강제하며, L2나 L1 같은 pixel space 손실만 쓸 때 생기는 흐릿함을 피한다. 부록 G의 전체 목표는 재구성 손실 L_rec, patch 기반 판별기 D_ψ의 adversarial 손실 L_adv, 정규화 손실 L_reg의 min-max 결합이다.
| 정규화 | 방식 | 가까운 모델 | 세부 |
|---|---|---|---|
| KL-reg | 학습된 latent에 표준정규 분포를 향한 약한 KL penalty를 건다 | VAE | KL 항의 가중치는 약 10^-6이다. diffusion 학습 시 z = E_μ(x) + E_σ(x) ε로 샘플링한다 |
| VQ-reg | 디코더 안에 벡터 양자화 층을 두고 codebook을 학습한다 | VQGAN(양자화 층을 디코더가 흡수한 형태) | codebook 차원을 크게 잡아 정규화를 약하게 한다. diffusion 학습에는 양자화 이전의 z를 쓰고 양자화 연산은 디코더의 첫 층으로 본다 |
두 정규화 모두 매우 약하게 건다. 후속 diffusion model이 latent의 2차원 구조를 그대로 다루도록 설계됐기 때문에 비교적 온화한 압축률로도 매우 좋은 재구성을 얻고, 그만큼 latent space에 대한 정규화가 거의 필요 없다.
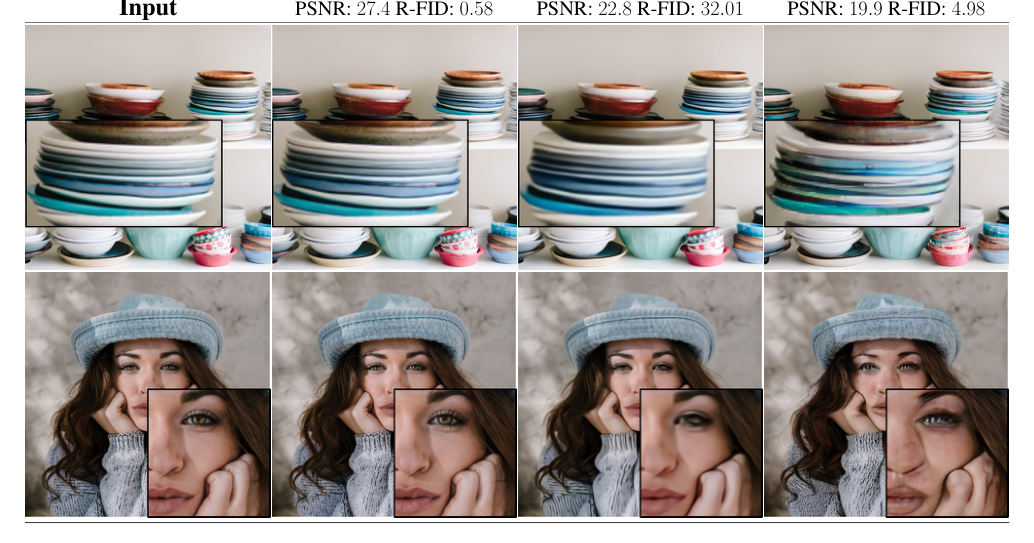
부록 D.2의 Table 8은 OpenImages로 학습하고 ImageNet-Val에서 평가한 autoencoder 전체 목록이다. 주요 행은 다음과 같다.
| f | 정규화와 codebook | c | R-FID | R-IS | PSNR | PSIM | SSIM |
|---|---|---|---|---|---|---|---|
| 16 | VQGAN, 16384 | 256 | 4.98 | - | 19.9±3.4 | 1.83±0.42 | 0.51±0.18 |
| 16 | VQGAN, 1024 | 256 | 7.94 | - | 19.4±3.3 | 1.98±0.43 | 0.50±0.18 |
| 8 | DALL-E, 8192 | - | 32.01 | - | 22.8±2.1 | 1.95±0.51 | 0.73±0.13 |
| 32 | VQ 16384 | 16 | 31.83 | 40.40±1.07 | 17.45±2.90 | 2.58±0.48 | 0.41±0.18 |
| 16 | VQ 16384 | 8 | 5.15 | 144.55±3.74 | 20.83±3.61 | 1.73±0.43 | 0.54±0.18 |
| 8 | VQ 16384 | 4 | 1.14 | 201.92±3.97 | 23.07±3.99 | 1.17±0.36 | 0.65±0.16 |
| 8 | VQ 256 | 4 | 1.49 | 194.20±3.87 | 22.35±3.81 | 1.26±0.37 | 0.62±0.16 |
| 4 | VQ 8192 | 3 | 0.58 | 224.78±5.35 | 27.43±4.26 | 0.53±0.21 | 0.82±0.10 |
| 4(attention 없음) | VQ 8192 | 3 | 1.06 | 221.94±4.58 | 25.21±4.17 | 0.72±0.26 | 0.76±0.12 |
| 4 | VQ 256 | 3 | 0.47 | 223.81±4.58 | 26.43±4.22 | 0.62±0.24 | 0.80±0.11 |
| 2 | VQ 2048 | 2 | 0.16 | 232.75±5.09 | 30.85±4.12 | 0.27±0.12 | 0.91±0.05 |
| 2 | VQ 64 | 2 | 0.40 | 226.62±4.83 | 29.13±3.46 | 0.38±0.13 | 0.90±0.05 |
| 32 | KL | 64 | 2.04 | 189.53±3.68 | 22.27±3.93 | 1.41±0.40 | 0.61±0.17 |
| 32 | KL | 16 | 7.3 | 132.75±2.71 | 20.38±3.56 | 1.88±0.45 | 0.53±0.18 |
| 16 | KL | 16 | 0.87 | 210.31±3.97 | 24.08±4.22 | 1.07±0.36 | 0.68±0.15 |
| 16 | KL | 8 | 2.63 | 178.68±4.08 | 21.94±3.92 | 1.49±0.42 | 0.59±0.17 |
| 8 | KL | 4 | 0.90 | 209.90±4.92 | 24.19±4.19 | 1.02±0.35 | 0.69±0.15 |
| 4 | KL | 3 | 0.27 | 227.57±4.89 | 27.53±4.54 | 0.55±0.24 | 0.82±0.11 |
| 2 | KL | 2 | 0.086 | 232.66±5.16 | 32.47±4.19 | 0.20±0.09 | 0.93±0.04 |
표가 보여주는 경향은 명확하다. 같은 f라면 KL-reg가 VQ-reg보다 R-FID가 조금 낮고, f가 작을수록 재구성이 좋아진다. 그러나 4.1절의 실험에서는 VQ-reg latent에서 학습한 LDM이 때때로 더 좋은 샘플 품질을 냈다. 즉 1단계 재구성 품질과 2단계 샘플 품질이 정비례하지는 않는다.
2단계 latent diffusion
이미지 합성에서 가장 성공한 diffusion model(DDPM, ADM, SR3)은 변분 하한의 reweighted 변형을 목표로 쓰며, 이는 denoising score-matching과 같은 형태다. 모델은 같은 가중치의 denoising autoencoder 열 ε_θ(x_t, t), t = 1...T로 해석되고 목표는 다음과 같이 단순화된다.
- pixel space: L_DM = E_{x, ε~N(0,1), t}[‖ε − ε_θ(x_t, t)‖²₂], t는 {1, ..., T}에서 균등 샘플링 (Eq 1)
- latent space: L_LDM = E_{E(x), ε~N(0,1), t}[‖ε − ε_θ(z_t, t)‖²₂] (Eq 2)
부록 B는 이 목표의 유도를 담는다. diffusion 과정은 signal-to-noise ratio SNR(t) = α_t²/σ_t²로 규정되고 forward 과정은 q(x_t|x_0) = N(x_t|α_t x_0, σ_t² I)다. ELBO의 각 항은 x_0의 추정 x_θ(x_t, t)를 통해 KL 항으로 분해되며, reparameterization ε_θ(x_t, t) = (x_t − α_t x_θ(x_t, t))/σ_t로 재구성 항을 denoising 목표로 바꾼 뒤 모든 항에 같은 가중치를 주면 Eq 1이 된다.
latent space의 backbone ε_θ(∘, t)는 시점 t로 조건화된 UNet이며 주로 2D convolution 층으로 구성한다. forward 과정이 고정돼 있으므로 학습 중 z_t는 인코더 E에서 바로 얻고, p(z)에서 나온 샘플은 디코더 D를 한 번 통과시켜 이미지로 복원한다. 고주파 세부가 추상화된 이 공간에서는 likelihood 기반 모델이 의미 있는 bit에 집중하고 더 낮은 차원에서 효율적으로 학습할 수 있다.
conditioning 메커니즘
diffusion model은 조건부 denoising autoencoder ε_θ(z_t, t, y)로 p(z|y)를 모델링할 수 있다. 그러나 당시 diffusion model의 conditioning은 ADM의 class label이나 SR3의 흐린 입력 이미지 정도에 머물렀다. LDM은 Transformer의 cross-attention을 UNet backbone에 결합해 다양한 modality를 받는다.
도메인별 인코더 τ_θ가 조건 y를 중간 표현 τ_θ(y) ∈ R^{M×d_τ}로 투영하고, UNet의 중간 층에 다음 cross-attention으로 사상한다.
- Attention(Q, K, V) = softmax(QK^T/√d) V
- Q = W_Q^{(i)} φ_i(z_t), K = W_K^{(i)} τ_θ(y), V = W_V^{(i)} τ_θ(y)
- φ_i(z_t) ∈ R^{N×d_ε^i}는 UNet의 평탄화한 중간 표현이고, W_Q, W_K, W_V는 학습 가능한 투영 행렬이다
조건부 목표는 L_LDM = E_{E(x), y, ε, t}[‖ε − ε_θ(z_t, t, τ_θ(y))‖²₂](Eq 3)이며 τ_θ와 ε_θ를 함께 최적화한다. τ_θ는 도메인별 전문가로 파라미터화할 수 있어, 예를 들어 text prompt에는 unmasked Transformer를 쓴다.
| 과제 | τ_θ 구현 | 세부 |
|---|---|---|
| text-to-image | unmasked Transformer(x-transformers 기반), BERT 토크나이저 | seq-length 77, depth N 32, dim 1280 |
| layout-to-image | unmasked Transformer | bounding box를 (l, b, c) 튜플로 이산화한다. l은 왼쪽 위, b는 오른쪽 아래 위치, c는 class. seq-length 92, depth 16, dim 512 |
| class-conditional | 단일 학습 가능 임베딩 층 | class y를 ζ ∈ R^{1×512}로 사상 |
| super-resolution, inpainting, semantic synthesis | identity, 조건을 UNet 입력에 concat | 공간적으로 정렬된 조건에 사용 |
Transformer τ_θ는 토큰 임베딩과 위치 임베딩을 더한 뒤 LayerNorm, multi-head self-attention, position-wise MLP 블록을 N번 반복한다(Eq 18~24). UNet 쪽은 ADM의 ablated UNet에서 self-attention 층을 self-attention, MLP, cross-attention이 번갈아 나오는 얕은 unmasked Transformer T블록으로 바꾼 구조다. Table 16의 블록 구조는 다음과 같다.
| 단계 | 연산 | 텐서 크기 |
|---|---|---|
| 입력 | h×w×c | |
| 1 | LayerNorm | h×w×c |
| 2 | Conv1x1 | h×w×(d×n_h) |
| 3 | Reshape | (h×w)×(d×n_h) |
| 4 (T번 반복) | SelfAttention | (h×w)×(d×n_h) |
| 4 (T번 반복) | MLP | (h×w)×(d×n_h) |
| 4 (T번 반복) | CrossAttention | (h×w)×(d×n_h) |
| 5 | Reshape | h×w×(d×n_h) |
| 6 | Conv1x1 | h×w×c |
여기서 n_h는 attention head 수, d는 head당 차원이다. MLP와 cross-attention을 빼면 ablated UNet과 같다. τ_θ를 시점 t에도 조건화하면 표현력이 늘 수 있지만 추론 속도가 떨어져 채택하지 않았고 향후 과제로 남겼다.
latent 스케일과 convolutional 샘플링
공간적으로 정렬된 조건을 ε_θ 입력에 concat하면 LDM은 범용 image-to-image 변환 모델이 된다. semantic synthesis는 풍경 이미지와 semantic map 쌍으로 학습하며, 다운샘플링한 semantic map을 f = 4 VQ-reg 모델의 latent 표현과 concat한다. 384² 이미지에서 자른 256² crop으로 학습해도 convolutional 방식으로 평가하면 megapixel 영역까지 일반화한다.
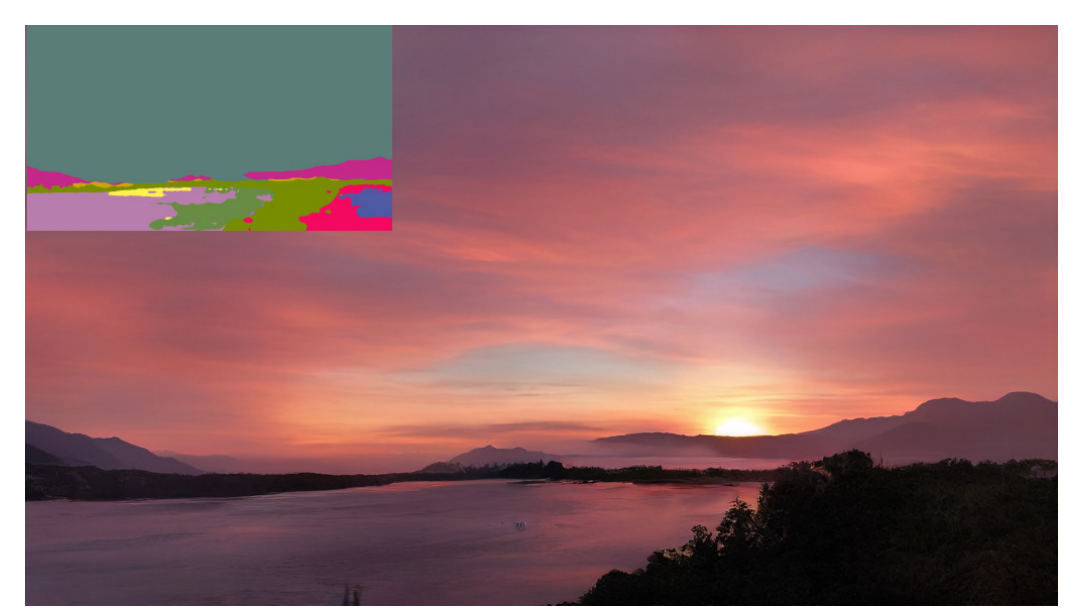
이 응용에서는 latent space의 스케일이 유도하는 signal-to-noise ratio Var(z)/σ_t²가 결과를 크게 좌우한다. KL-reg 모델의 latent에서 바로 학습하면 이 비율이 매우 높아 reverse 과정 초반에 의미 세부를 과도하게 할당한다. 부록 G는 첫 batch에서 성분별 분산 σ̂²을 추정해 z ← z/σ̂로 rescaling하는 방법을 적는데, 이렇게 하면 SNR이 낮아져 convolutional 샘플링 결과가 좋아진다(Fig 15). VQ-reg latent는 분산이 1에 가까워 rescaling이 필요 없다. rescaling과 classifier-free guidance를 결합하면 text-conditional LDM-KL-8-G로도 256²보다 큰 이미지를 직접 합성할 수 있다(Fig 13).
post-hoc image guiding
부록 C는 ADM의 classifier guiding을 image-to-image 변환으로 재해석한다. ε-parameterized 모델의 guiding은 ε̂ ← ε_θ(z_t, t) + √(1 − α_t²) ∇_{z_t} log p_Φ(y|z_t)로, score ε_θ를 조건부 분포로 보정하는 갱신이다. 논문은 guiding 분포를 p_Φ(y|T(D(z_0(z_t))))로 두어 목표 이미지 y와 미분 가능한 변환 T(identity, downsampling 등)를 받는 범용 image-to-image 과제로 바꾼다.
분산 1의 Gaussian guider를 가정하면 log p_Φ(y|z_t) = −½‖y − T(D(z_0(z_t)))‖²₂라는 L2 회귀 목표가 된다. 256² unconditional 샘플로 512² convolutional 합성을 guiding하면(T는 2× bicubic downsampling) 균질하거나 어긋난 전역 구조가 회복된다(Fig 14). L2 대신 LPIPS를 쓰는 perceptual guider는 super-resolution의 PSNR과 SSIM을 끌어올리는 데 쓴다.
결과
실험 설정
압축률 분석의 모든 모델은 단일 NVIDIA A100에서 같은 step 수와 같은 파라미터 수로 학습했다. Table 13의 ImageNet conditional 모델 설정은 다음과 같다.
| 항목 | LDM-1 | LDM-2 | LDM-4 | LDM-8 | LDM-16 | LDM-32 |
|---|---|---|---|---|---|---|
| z-shape | 256×256×3 | 128×128×2 | 64×64×3 | 32×32×4 | 16×16×8 | 8×8×32 |
| codebook 크기 | - | 2048 | 8192 | 16384 | 16384 | 16384 |
| 모델 크기 | 396M | 391M | 391M | 395M | 395M | 395M |
| 채널 | 192 | 192 | 192 | 256 | 256 | 256 |
| batch size | 7 | 9 | 40 | 64 | 112 | 112 |
| iteration | 200만 | 200만 | 200만 | 200만 | 200만 | 200만 |
| learning rate | 4.9e-5 | 6.3e-5 | 8e-5 | 6.4e-5 | 4.5e-5 | 4.5e-5 |
diffusion step은 모두 1000, noise schedule은 linear, conditioning은 cross-attention(임베딩 차원 512)이다. batch size가 f에 따라 7에서 112까지 늘어나는 것은 같은 GPU 메모리에서 latent가 작을수록 더 많은 샘플을 처리할 수 있기 때문이다. learning rate는 각 모델이 안정적으로 학습되는 최대값으로 잡아 실행마다 조금씩 다르다.
평가 세부(부록 E.3)는 다음과 같다. unconditional과 class-conditional의 FID, Precision, Recall은 5만 장 샘플과 전체 학습 세트로 추정하고 torch-fidelity로 계산했다. 데이터 처리 파이프라인이 다르면 결과가 달라질 수 있어 Dhariwal and Nichol의 스크립트로도 평가했는데, ImageNet 7.76 대 7.77과 LSUN-Bedrooms 2.95 대 3.0으로 조금 달랐다. 효율 분석(Fig 6, 7, 17)은 5,000장 기준이라 Table 1과 Table 10의 값과 다를 수 있다.
압축률 f 분석
f ∈ {1, 2, 4, 8, 16, 32}를 비교한 결과, 너무 작은 f는 학습을 느리게 하고 너무 큰 f는 품질을 일찍 정체시킨다.
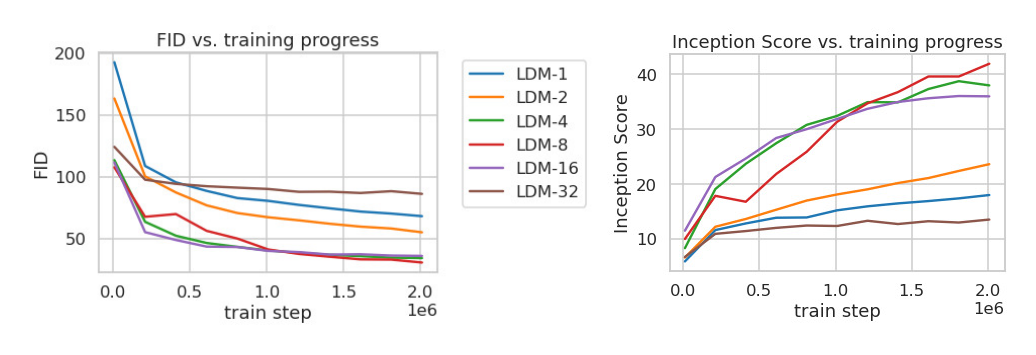
LDM-1과 LDM-2의 느린 학습은 perceptual compression 대부분을 diffusion model에 떠넘긴 결과이고, LDM-32의 정체는 1단계 압축이 지나쳐 정보가 손실된 결과다. LDM-4에서 LDM-16이 효율과 지각적 충실도의 균형을 이루며, 200만 step 후 pixel 기반 LDM-1과 LDM-8의 FID 격차는 38에 이른다. 부록 D.5의 Fig 17은 같은 분석을 35 V100-day 예산 기준으로 다시 그린 것으로 정성적으로 같은 결과를 보인다.
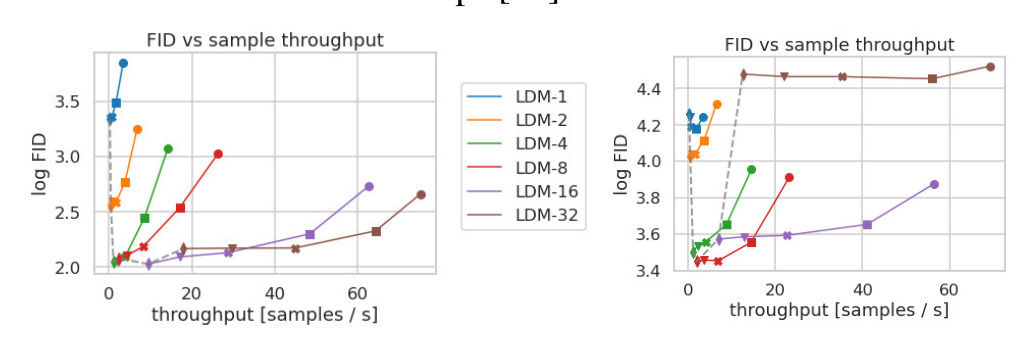
샘플링 속도까지 함께 보면 LDM-4와 LDM-8이 가장 좋은 조건이다. CelebA-HQ 50만 step과 ImageNet 200만 step 모델을 DDIM step 10, 20, 50, 100, 200으로 비교하면, LDM-4와 LDM-8은 perceptual compression과 conceptual compression 비율이 맞지 않는 모델보다 낮은 FID를 내고, 특히 pixel 기반 LDM-1보다 훨씬 낮은 FID를 훨씬 높은 throughput으로 낸다. ImageNet 같은 복잡한 데이터셋은 압축률을 낮춰야 품질이 유지된다.
unconditional 합성
256² 이미지의 unconditional 모델을 네 데이터셋에서 학습하고 FID와 Precision, Recall로 평가했다(Table 1).
| 데이터셋 | 모델 | FID | Precision | Recall |
|---|---|---|---|---|
| CelebA-HQ | DC-VAE | 15.8 | - | - |
| CelebA-HQ | VQGAN+T(k=400) | 10.2 | - | - |
| CelebA-HQ | PGGAN | 8.0 | - | - |
| CelebA-HQ | LSGM | 7.22 | - | - |
| CelebA-HQ | UDM | 7.16 | - | - |
| CelebA-HQ | LDM-4(500 DDIM step) | 5.11 | 0.72 | 0.49 |
| FFHQ | ImageBART | 9.57 | - | - |
| FFHQ | U-Net GAN(+aug) | 10.9(7.6) | - | - |
| FFHQ | UDM | 5.54 | - | - |
| FFHQ | StyleGAN | 4.16 | 0.71 | 0.46 |
| FFHQ | ProjectedGAN | 3.08 | 0.65 | 0.46 |
| FFHQ | LDM-4(200 step) | 4.98 | 0.73 | 0.50 |
| LSUN-Churches | DDPM | 7.89 | - | - |
| LSUN-Churches | ImageBART | 7.32 | - | - |
| LSUN-Churches | PGGAN | 6.42 | - | - |
| LSUN-Churches | StyleGAN | 4.21 | - | - |
| LSUN-Churches | StyleGAN2 | 3.86 | - | - |
| LSUN-Churches | ProjectedGAN | 1.59 | 0.61 | 0.44 |
| LSUN-Churches | LDM-8(KL-reg, 200 step) | 4.02 | 0.64 | 0.52 |
| LSUN-Bedrooms | ImageBART | 5.51 | - | - |
| LSUN-Bedrooms | DDPM | 4.9 | - | - |
| LSUN-Bedrooms | UDM | 4.57 | - | - |
| LSUN-Bedrooms | StyleGAN | 2.35 | 0.59 | 0.48 |
| LSUN-Bedrooms | ADM | 1.90 | 0.66 | 0.51 |
| LSUN-Bedrooms | ProjectedGAN | 1.52 | 0.61 | 0.34 |
| LSUN-Bedrooms | LDM-4(200 step) | 2.95 | 0.66 | 0.48 |
CelebA-HQ에서는 FID 5.11로 당시 최고 성능을 기록해 이전 likelihood 기반 모델과 GAN을 모두 앞섰다. 1단계와 latent diffusion을 함께 학습하는 LSGM(7.22)보다도 좋은데, LDM은 고정된 공간에서 diffusion을 학습하므로 재구성 품질과 latent prior 학습 사이의 가중치 조정 문제를 피한다. diffusion 기반 이전 접근은 LSUN-Bedrooms를 제외한 모든 데이터셋에서 앞섰고, Bedrooms에서는 ADM(1.90)에 근접하면서 파라미터는 절반, 학습 자원은 4분의 1이다. Precision과 Recall에서는 GAN 기반 방법을 꾸준히 앞서, adversarial 목표보다 mode-covering likelihood 목표가 유리하다는 점을 확인했다.
text-to-image
LAION-400M에서 1.45B 파라미터 KL-reg LDM을 language prompt로 조건화해 학습했다. BERT 토크나이저와 Transformer τ_θ가 latent code를 추론하고 multi-head cross-attention으로 UNet에 사상한다. 언어 표현 학습과 시각 합성을 각각의 도메인 전문가에게 맡긴 이 조합은 복잡한 사용자 지정 prompt에도 잘 일반화한다.
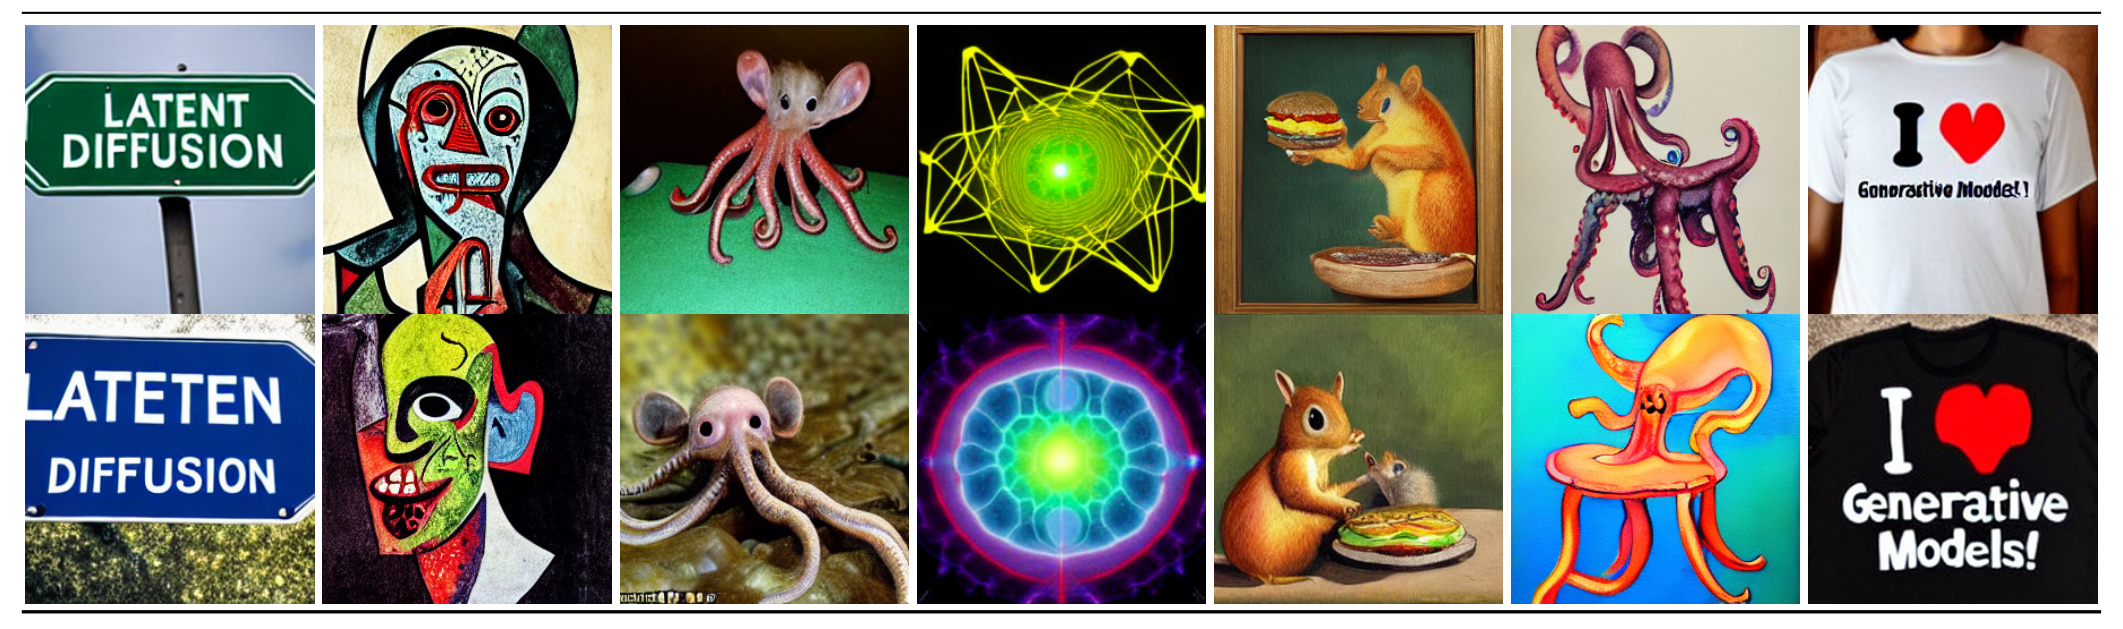
정량 평가는 MS-COCO validation set 3만 장과 비교해 256×256에서 수행했다(Table 2).
| 모델 | FID | IS | 파라미터 | 설정 |
|---|---|---|---|---|
| CogView | 27.10 | 18.20 | 4B | self-ranking, rejection rate 0.017 |
| LAFITE | 26.94 | 26.02 | 75M | |
| GLIDE | 12.24 | - | 6B | 277 DDIM step, c.f.g. s = 3 |
| Make-A-Scene | 11.84 | - | 4B | AR 모델용 c.f.g. s = 5 |
| LDM-KL-8 | 23.31 | 20.03±0.33 | 1.45B | 250 DDIM step |
| LDM-KL-8-G | 12.63 | 30.29±0.42 | 1.45B | 250 DDIM step, c.f.g. s = 1.5 |
guidance 없는 LDM-KL-8은 CogView와 LAFITE 같은 AR과 GAN 기반 방법을 앞서고, classifier-free guidance를 적용한 LDM-KL-8-G는 FID 12.63으로 GLIDE(12.24)와 Make-A-Scene(11.84)에 대등하면서 파라미터는 각각 6B와 4B 대비 1.45B로 크게 적다. IS 30.29는 표에서 가장 높다. 이 모델의 학습 설정은 f = 8, z-shape 32×32×4, 채널 320, attention head 8, batch size 680, 39만 iteration, learning rate 1.0e-4이다(Table 15).
layout-to-image
cross-attention conditioning의 유연성을 더 확인하기 위해 OpenImages의 semantic layout으로 학습하고 COCO로 fine-tuning한 모델도 학습했다. 평가는 COCO Segmentation Challenge split의 증강 없는 2,048장(Jahn et al.과 같은 샘플)과 OpenImages validation set의 center-crop 2,048장으로 한다(Table 9).
| 모델 | COCO 256² FID | OpenImages 256² FID | OpenImages 512² FID |
|---|---|---|---|
| LostGAN-V2 | 42.55 | - | - |
| OC-GAN | 41.65 | - | - |
| SPADE | 41.11 | - | - |
| VQGAN+T | 56.58 | 45.33 | 48.11 |
| LDM-8(100 step, COCO 처음부터 학습) | 42.06 | - | - |
| LDM-4(200 step, OpenImages에서 fine-tuning) | 40.91 | 32.02 | 35.80 |
COCO만으로 학습한 모델은 같은 프로토콜의 최신 모델과 같은 수준이고, OpenImages 모델에서 fine-tuning하면 이를 넘어선다. OpenImages에서는 Jahn et al.의 VQGAN+T보다 FID가 약 11 낮다.
class-conditional ImageNet
4.1절에서 가장 좋았던 f ∈ {4, 8} 모델을 class-conditional ImageNet에서 평가했다(Table 3과 부록 Table 10).
| 모델 | FID | IS | Precision | Recall | 파라미터 | 설정 |
|---|---|---|---|---|---|---|
| SR3 | 11.30 | - | - | - | 625M | |
| ImageBART | 21.19 / 7.44 | - | - | - | 3.5B | 후자는 classifier rejection rate 0.05 |
| VQGAN+T | 17.04 / 5.88 | 70.6±1.8 / 304.8±3.6 | - | - | 1.3B | 후자는 rejection rate 0.05 |
| BigGAN-deep | 6.95 | 203.6±2.6 | 0.87 | 0.28 | 340M | |
| ADM | 10.94 | 100.98 | 0.69 | 0.63 | 554M | 250 DDIM step |
| ADM-G | 4.59 | 186.7 | 0.82 | 0.52 | 608M | 250 DDIM step |
| ADM-G, ADM-U | 3.85 | 221.72 | 0.84 | 0.53 | n/a | 2×250 DDIM step |
| CDM | 4.88 | 158.71±2.26 | - | - | n/a | 2×100 DDIM step |
| LDM-8 | 17.41 | 72.92±2.6 | 0.65 | 0.62 | 395M | 200 DDIM step, 290만 step, batch 64 |
| LDM-8-G | 8.11 | 190.43±2.60 | 0.83 | 0.36 | 506M | classifier scale 10, 290만 step |
| LDM-8 | 15.51 | 79.03±1.03 | 0.65 | 0.63 | 395M | 480만 step, batch 64 |
| LDM-8-G | 7.76 | 209.52±4.24 | 0.84 | 0.35 | 506M | classifier scale 10, 480만 step |
| LDM-4 | 10.56 | 103.49±1.24 | 0.71 | 0.62 | 400M | 250 DDIM step, 17.8만 step, batch 1200 |
| LDM-4-G | 3.95 | 178.22±2.43 | 0.81 | 0.55 | 400M | c.f.g. scale 1.25 |
| LDM-4-G | 3.60 | 247.67±5.59 | 0.87 | 0.48 | 400M | c.f.g. scale 1.5 |
LDM-4-G(scale 1.5)는 FID 3.60과 IS 247.67로 당시 최고 diffusion model ADM-G(4.59, 186.7)를 앞서면서 파라미터는 608M 대비 400M이다. 두 단계 cascade인 ADM-G, ADM-U(3.85)보다도 낮다. guidance 없는 LDM-4(10.56)와 ADM(10.94)이 비슷한 데서 보듯 guidance가 FID를 크게 낮추고, scale을 1.25에서 1.5로 올리면 FID와 IS는 좋아지지만 Recall은 0.55에서 0.48로 떨어진다. LDM-8-G는 latent space에서 값싸게 학습한 noise scale별 classifier로 guiding한 결과다.
super-resolution
SR3를 따라 bicubic 4× 다운샘플링으로 열화를 고정하고 SR3의 데이터 처리 파이프라인대로 ImageNet에서 학습했다. OpenImages로 pre-training한 f = 4 VQ-reg autoencoder를 쓰고 저해상도 조건 y를 UNet 입력에 concat한다(τ_θ는 identity). 짧은 변이 256px 미만인 이미지는 학습과 평가에서 제외한다(Table 5와 부록 Table 11).
| 모델 | FID(val 기준 / train 기준) | IS | PSNR | SSIM | 파라미터 | 샘플/초(A100) |
|---|---|---|---|---|---|---|
| Image Regression | 15.2 | 121.1 | 27.9 | 0.801 | 625M | N/A |
| SR3 | 5.2 | 180.1 | 26.4 | 0.762 | 625M | N/A |
| LDM-4(100 step) | 2.8 / 4.8 | 166.3 | 24.4±3.8 | 0.69±0.14 | 169M | 4.62 |
| LDM-4(big, 100 step) | 2.4 / 4.3 | 174.9 | 24.7±4.1 | 0.71±0.15 | 552M | 4.5 |
| LDM-4(50 step, guiding) | 4.4 / 6.4 | 153.7 | 25.8±3.7 | 0.74±0.12 | 184M | 0.38 |
| LDM-4(100 step, guiding) | 4.4 / 6.4 | 154.1 | 25.7±3.7 | 0.73±0.12 | ||
| LDM-4(100 step, +15 epoch) | 2.6 / 4.6 | 169.76±5.03 | 24.4±3.8 | 0.69±0.14 | ||
| Pixel-DM(100 step, +15 epoch) | 5.1 / 7.1 | 163.06±4.67 | 24.1±3.3 | 0.59±0.12 |
LDM-SR은 FID에서 SR3를 앞서고 SR3는 IS에서 앞선다. 단순 회귀 모델이 PSNR과 SSIM에서 가장 높은데, 저자는 두 지표가 사람의 지각과 잘 맞지 않고 정렬이 불완전한 고주파 세부보다 흐릿함을 선호한다고 지적한다. 같은 연산량과 비슷한 파라미터 수의 pixel space baseline(Pixel-DM)과 비교하면 LDM-4가 더 낮은 FID를 훨씬 빠른 샘플링으로 낸다. perceptual 손실 기반 guider는 PSNR과 SSIM을 올리는 대신 FID가 4.4로 나빠지고 throughput이 0.38로 떨어진다.
user study(Table 4)는 SR3의 2-alternative forced choice 프로토콜을 따르며 피험자가 이미지를 3초 관찰한다.
| 과제 | 항목 | 비교 대상 | LDM-4 |
|---|---|---|---|
| SR on ImageNet | Task 1: ground truth 대비 선호 | Pixel-DM(f1) 16.0% | 30.4% |
| SR on ImageNet | Task 2: 두 생성 결과 중 선호 | Pixel-DM(f1) 29.4% | 70.6% |
| Inpainting on Places | Task 1: ground truth 대비 선호 | LaMa 13.6% | 21.0% |
| Inpainting on Places | Task 2: 두 생성 결과 중 선호 | LaMa 31.9% | 68.1% |
bicubic 열화는 다른 전처리를 거친 이미지에 일반화되지 않는다. 그래서 JPEG 압축 noise와 카메라 센서 noise, 여러 보간 방식의 다운샘플링, Gaussian blur와 Gaussian noise를 무작위 순서로 적용하는 BSR 열화 파이프라인을 완화된 파라미터로 써서 범용 모델 LDM-BSR을 학습했다. LDM-BSR은 class-conditional LDM 샘플과 웹에서 수집한 이미지를 1024²로 키우며 고정 열화 모델보다 훨씬 선명하다(Fig 18, Fig 19).
inpainting
inpainting은 이미지의 마스크 영역을 새 내용으로 채우는 과제다. 평가는 Fast Fourier Convolution 기반 전용 구조를 쓰는 LaMa의 프로토콜을 따른다. LaMa 코드로 합성 마스크를 만들고 Places에서 validation 2,000장과 test 3만 장을 고정해 256×256 crop으로 학습하고 512×512 crop으로 평가한다.
먼저 1단계 설계 선택이 효율에 미치는 영향을 파라미터 수를 고정한 채 비교했다(Table 6).
| 모델(정규화) | 학습 throughput(샘플/초) | 샘플링 throughput @256 / @512 | 학습+검증 시간/epoch | FID(2,000장, 6 epoch) |
|---|---|---|---|---|
| LDM-1(1단계 없음) | 0.11 | 0.26 / 0.07 | 20.66 | 24.74 |
| LDM-4(KL, attention 있음) | 0.32 | 0.97 / 0.34 | 7.66 | 15.21 |
| LDM-4(VQ, attention 있음) | 0.33 | 0.97 / 0.34 | 7.04 | 14.99 |
| LDM-4(VQ, attention 없음) | 0.35 | 0.99 / 0.36 | 6.66 | 15.95 |
pixel 기반과 latent 기반 사이에 최소 2.7배 속도 향상과 최소 1.6배 FID 개선을 관찰했다고 저자는 적는다. 실제로 epoch당 시간은 20.66시간에서 7.66시간으로 2.7배 줄었고 512² 샘플링 throughput은 0.07에서 0.34로 약 4.9배 늘었다. attention 없는 1단계는 고해상도 디코딩의 GPU 메모리를 줄인다.
다른 inpainting 방법과의 비교는 다음과 같다(Table 7).
| 모델 | 40~50% 마스크 FID | LPIPS | 전체 FID | LPIPS |
|---|---|---|---|---|
| LDM-4(big, w/ ft) | 9.39 | 0.246±0.042 | 1.50 | 0.137±0.080 |
| LDM-4(big, w/o ft) | 12.89 | 0.257±0.047 | 2.40 | 0.142±0.085 |
| LDM-4(w/ attn) | 11.87 | 0.257±0.042 | 2.15 | 0.144±0.084 |
| LDM-4(w/o attn) | 12.60 | 0.259±0.041 | 2.37 | 0.145±0.084 |
| LaMa(재계산) | 12.31 | 0.243±0.038 | 2.23 | 0.134±0.080 |
| LaMa(보고값) | 12.0 | 0.24 | 2.21 | 0.14 |
| CoModGAN | 10.4 | 0.26 | 1.82 | 0.15 |
| RegionWise | 21.3 | 0.27 | 4.75 | 0.15 |
| DeepFill v2 | 22.1 | 0.28 | 5.20 | 0.16 |
| EdgeConnect | 30.5 | 0.28 | 8.37 | 0.16 |
attention 있는 LDM-4는 LaMa보다 FID가 좋고 LPIPS는 조금 높다. 저자는 LaMa가 결과를 하나만 내므로 평균 이미지에 가까운 복원을 하는 반면 LDM은 다양한 결과를 내기 때문이라고 해석한다(Fig 21). user study에서도 피험자는 LaMa보다 LDM을 선호했다.
이어서 attention 없는 VQ-reg 1단계 위에 더 큰 diffusion model(big)을 학습했다. ADM을 따라 feature 계층 세 단계에 attention을 두고 BigGAN residual block으로 up/down 샘플링하며 파라미터는 215M에서 387M으로 늘었다. 학습 후 256²와 512² 샘플 품질에 차이가 있었는데 저자는 추가 attention 모듈이 원인이라고 추정한다. 512²에서 반 epoch fine-tuning하자 새로운 feature 통계에 적응해 inpainting FID 최고 기록(big, w/o attn, w/ ft: 40~50% 마스크 9.39, 전체 1.50)을 세웠다.
연산량 비교
부록 F의 Table 18은 학습 연산량을 V100-day로, 추론 throughput을 A100 초당 샘플 수로 비교한다. 논문의 모델은 모두 단일 A100으로 학습했으므로 UNet 기준 2.2배 가속을 가정해 V100-day로 환산했다.
| 데이터셋 | 모델 | 학습 연산량(V100-day) | 추론 throughput | 파라미터 | FID |
|---|---|---|---|---|---|
| LSUN-Churches | StyleGAN2 | 64 | - | 59M | 3.86 |
| LSUN-Churches | LDM-8(100 step, 41만) | 18 | 6.80 | 256M | 4.02 |
| LSUN-Bedrooms | ADM(1000 step) | 232 | 0.03 | 552M | 1.9 |
| LSUN-Bedrooms | LDM-4(200 step, 190만) | 60(전체 55) | 1.07 | 274M | 2.95 |
| CelebA-HQ | LDM-4(500 step, 41만) | 14.4 | 0.43 | 274M | 5.11 |
| FFHQ | StyleGAN2 | 32.13 | - | 59M | 3.8 |
| FFHQ | LDM-4(200 step, 63.5만) | 26 | 1.07 | 274M | 4.98 |
| ImageNet | VQGAN-f-4(1단계) | 29 | - | 55M | R-FID 0.58 |
| ImageNet | VQGAN-f-8(1단계) | 66 | - | 68M | R-FID 1.14 |
| ImageNet | BigGAN-deep | 128~256 | - | 340M | 6.95 |
| ImageNet | ADM(250 step) | 916 | 0.12 | 554M | 10.94 |
| ImageNet | ADM-G(25 step) | 916 + classifier 46 = 962 | 0.7 | 608M | 5.58 |
| ImageNet | ADM-G(250 step) | 962 | 0.07 | 608M | 4.59 |
| ImageNet | ADM-G, ADM-U(250 step) | 329 + 30 = 349 | n/a | n/a | 3.85 |
| ImageNet | LDM-8-G(100 step, 290만) | 79 + classifier 12 = 91 | 1.93 | 506M | 8.11 |
| ImageNet | LDM-8(200 step, 290만) | 79 | 1.9 | 395M | 17.41 |
| ImageNet | LDM-4(250 step, 17.8만) | 271 | 0.7 | 400M | 10.56 |
| ImageNet | LDM-4-G(scale 1.25) | 271 | 0.4 | 400M | 3.95 |
| ImageNet | LDM-4-G(scale 1.5) | 271 | 0.4 | 400M | 3.60 |
LSUN-Bedrooms에서 LDM-4는 ADM 학습 연산량의 약 4분의 1(232 대 60 V100-day)로 근접한 FID를 내고 추론 throughput은 0.03에서 1.07로 약 36배 높다. ImageNet에서 LDM-4-G는 ADM-G의 962 V100-day 대비 271 V100-day로 더 낮은 FID를 낸다. 1단계 autoencoder 학습 비용(f = 4는 29, f = 8은 66 V100-day)은 한 번만 들고 여러 모델에 재사용된다.
conditional 모델 hyperparameter
Table 15는 본문 실험에 쓴 conditional 모델 6종의 설정을 담는다. inpainting 모델만 V100 8장으로 학습했고 나머지는 단일 A100이다.
| 항목 | text-to-image | layout(OpenImages) | layout(COCO) | class(ImageNet) | super-resolution | inpainting | semantic map |
|---|---|---|---|---|---|---|---|
| f | 8 | 4 | 8 | 4 | 4 | 4 | 8 |
| z-shape | 32×32×4 | 64×64×3 | 32×32×4 | 64×64×3 | 64×64×3 | 64×64×3 | 32×32×4 |
| codebook 크기 | - | 8192 | 16384 | 8192 | 8192 | 8192 | 16384 |
| 모델 크기 | 1.45B | 306M | 345M | 395M | 169M | 215M | 215M |
| 채널 | 320 | 128 | 192 | 192 | 160 | 128 | 128 |
| batch size | 680 | 24 | 48 | 1200 | 64 | 128 | 48 |
| iteration | 39만 | 440만 | 17만 | 17.8만 | 86만 | 36만 | 36만 |
| learning rate | 1.0e-4 | 4.8e-5 | 4.8e-5 | 1.0e-4 | 6.4e-5 | 1.0e-6 | 4.8e-5 |
| conditioning | cross-attention | cross-attention | cross-attention | cross-attention | concat | concat | concat |
| 임베딩 차원 / Transformer depth | 1280 / 1 | 512 / 3 | 512 / 2 | 512 / 1 | - | - | - |
text-to-image 모델만 attention head 8개를 쓰고 나머지는 1개다. COCO layout 모델은 dropout 0.1을 쓴다. Table 1의 unconditional 모델 설정(Table 12)은 다음과 같다.
| 항목 | CelebA-HQ | FFHQ | LSUN-Churches | LSUN-Bedrooms |
|---|---|---|---|---|
| f | 4 | 4 | 8(KL-reg) | 4 |
| z-shape | 64×64×3 | 64×64×3 | - | 64×64×3 |
| codebook 크기 | 8192 | 8192 | - | 8192 |
| 파라미터 | 274M | 274M | 294M | 274M |
| 채널 | 224 | 224 | 192 | 224 |
| channel multiplier | 1,2,3,4 | 1,2,3,4 | 1,2,2,4,4 | 1,2,3,4 |
| attention 해상도 | 32, 16, 8 | 32, 16, 8 | 32, 16, 8, 4 | 32, 16, 8 |
| head 채널 | 32 | 32 | 24 | 32 |
| batch size | 48 | 42 | 96 | 48 |
| iteration | 41만 | 63.5만 | 50만 | 190만 |
| learning rate | 9.6e-5 | 8.4e-5 | 5e-5 | 9.6e-5 |
네 모델 모두 diffusion step 1000과 linear noise schedule을 쓰고 단일 A100에서 학습했다. Fig 7의 CelebA-HQ 비교에 쓴 LDM-1부터 LDM-32(Table 14)는 파라미터 258M에서 274M, batch size 9에서 128, 50만 iteration으로 맞췄고, 더 일찍 수렴한 모델은 가장 좋은 checkpoint로 FID를 평가했다.
부록 갤러리의 샘플링 설정
부록 H의 정성 결과는 모델마다 다른 샘플링 설정을 쓴다. 캡션에 적힌 설정과 FID는 다음과 같다.
| 그림 | 모델 | guidance | DDIM step | η | FID |
|---|---|---|---|---|---|
| Fig 5 | text-to-image LDM-8(KL) | c.f.g. s = 10.0 | 200 | 1.0 | - |
| Fig 16 | layout-to-image LDM-4 | - | 100 | 0 | - |
| Fig 26 | ImageNet LDM-4 | c.f.g. s = 5.0 | 200 | 1.0 | - |
| Fig 27 | ImageNet LDM-4 | c.f.g. s = 3.0 | 200 | 1.0 | - |
| Fig 28 | CelebA-HQ LDM-4 | - | 500 | 0 | 5.15 |
| Fig 29 | FFHQ LDM-4 | - | 200 | 1 | 4.98 |
| Fig 30 | LSUN-Churches LDM-8 | - | 200 | 0 | 4.48 |
| Fig 31 | LSUN-Bedrooms LDM-4 | - | 200 | 1 | 2.95 |
비교적 작은 데이터셋으로 학습한 CelebA-HQ, FFHQ, LSUN-Churches 모델에 대해서는 VGG-16 feature space에서 생성 샘플의 nearest neighbor 10장을 학습 데이터에서 찾아 보인다(Fig 32~34). 생성 샘플이 학습 이미지를 그대로 복제하지 않는지 확인하는 용도다.
한계
저자가 명시한 한계
- 샘플링 속도: pixel 기반보다 연산량이 크게 줄었지만 순차적 샘플링 과정 때문에 GAN보다 여전히 느리다. 관련 연구 절은 고급 샘플링 전략과 계층적 접근이 추론 속도 문제를 부분적으로 해결한다고 적는다.
- 재구성 병목: f = 4 autoencoder의 품질 손실은 매우 작지만 pixel space에서 미세한 정확도가 필요한 과제에서는 재구성 능력이 병목이 될 수 있다. 저자는 super-resolution 모델이 이미 이 점에서 어느 정도 제한된다고 가정한다.
실험에서 드러난 제약
저자가 한계 절에 적지는 않았지만 실험 절에서 확인되는 제약은 다음과 같다.
- ImageNet처럼 복잡한 데이터셋은 압축률을 낮춰야 품질이 유지되므로 단일 f가 모든 과제에 최적은 아니다.
- KL-reg latent는 rescaling 없이는 convolutional 샘플링에서 SNR이 지나치게 높다.
- unconditional 모델의 convolutional 샘플링은 전역 구조가 어긋날 수 있어 image guiding이 필요하다.
- bicubic 열화로 학습한 LDM-SR은 다른 전처리를 거친 이미지에 일반화되지 않아 별도의 LDM-BSR이 필요했다.
- big inpainting 모델은 256²와 512² 사이 품질 차이가 있어 512²에서 fine-tuning이 필요했다. 원인은 저자의 추정(추가 attention 모듈)이다.
- τ_θ를 시점 t에 조건화하는 변형은 추론 속도 때문에 분석하지 않았다.
사회적 영향
저자는 생성 모델을 양날의 검으로 본다. 학습과 추론 비용을 낮추는 접근은 기술 접근을 넓히고 탐색을 민주화하지만, 조작된 데이터와 허위 정보, 스팸을 만들고 퍼뜨리기도 쉬워진다. 특히 deep fake의 피해는 여성에게 집중된다. 생성 모델이 학습 데이터를 드러낼 수 있다는 점은 동의 없이 수집된 민감한 데이터에서 문제가 되는데, 이미지 diffusion model에 어느 정도 해당하는지는 아직 충분히 이해되지 않았다. adversarial 학습과 likelihood 목표를 결합한 두 단계 접근이 데이터를 얼마나 왜곡하는지도 남은 연구 과제다.
자료 내적 불일치
같은 문서 안에서 값이 다르게 적힌 곳이 있다. 삭제하지 않고 기록한다.
| 위치 | 불일치 |
|---|---|
| Table 1 대 Fig 28 캡션 | CelebA-HQ LDM-4의 FID가 5.11과 5.15로 다르다. 설정은 둘 다 500 DDIM step, η = 0이다 |
| Table 1 대 Fig 30 캡션 | LSUN-Churches LDM-8의 FID가 4.02와 4.48로 다르다 |
| Table 12 대 Table 18 | LSUN-Churches 모델이 294M 파라미터, 50만 iteration과 256M, 41만 step으로 다르고, 샘플링 step도 Table 1은 200, Table 18은 100이다 |
| Table 18 | LSUN-Bedrooms LDM-4 행의 generator compute 60이 overall compute 55보다 크다 |
| Table 13, Table 14 | LDM-32의 z-shape가 "88 × 8 × 32"로 적혀 있다. 다른 열의 규칙대로면 8 × 8 × 32다 |
| Sec 4.5 본문 대 Table 6 | 본문은 FID 개선이 최소 1.6배라고 적지만 VQ attention 없음 행은 24.74/15.95 = 1.55배다 |
자료에서 확인할 수 없는 것
- 게재 학회는 raw 본문(arXiv v2)에 없다. 같은 wiki의 DiT 논문과 Flow Matching 논문 참고문헌이 CVPR 2022로 인용한다.
- Stable Diffusion과의 관계는 raw 본문에 없다. DiT 논문이 Stable Diffusion의 VAE 출처로 이 논문을 인용한다.
- Table 6은 figures.json에 항목이 없고 tab05 크롭에 대신 담겨 있다. tab01, tab04, tab08, tab09, tab14 크롭은 다른 내용을 담고 있어 해당 표는 본문 마크다운 표로만 옮겼다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| LDM-f | 다운샘플링 계수 f의 autoencoder latent에서 학습한 diffusion model. LDM-1은 pixel 기반, 접미사 -G는 guidance 적용 |
| perceptual compression / semantic compression | rate-distortion 곡선의 두 구간. 앞 구간은 autoencoder가 고주파 세부를 걷어내고 뒤 구간은 diffusion model이 의미 구성을 배운다 |
| KL-reg / VQ-reg | autoencoder latent의 두 정규화. 표준정규 분포를 향한 약한 KL penalty(가중치 약 10^-6)와 디코더 내부의 벡터 양자화 층 |
| cross-attention conditioning | 조건 y를 τ_θ로 바꿔 UNet 중간 층의 cross-attention에 key와 value로 주입하는 방식 |
| convolutional 샘플링 | 공간 조건을 concat한 LDM을 학습 해상도보다 큰 입력에 적용해 512²에서 1024² 이미지를 만드는 방식 |
| R-FID | autoencoder가 복원한 이미지의 FID. 1단계 재구성 품질 지표 |
관련 페이지
- Scalable Diffusion Models with Transformers: LDM 틀 안에서 denoising UNet backbone을 Transformer(DiT)로 바꾼 후속 연구. Stable Diffusion의 VAE(f = 8, 256×256×3을 32×32×4로 압축)를 그대로 쓰고 ImageNet 256×256에서 LDM-4-G의 FID 3.60을 2.27로 갱신했다.
- Flow Matching for Generative Modeling: diffusion 기반 이미지 생성의 최근 발전 사례로 이 논문을 인용하며, denoising 목표 대신 속도장을 회귀하는 Flow Matching을 제안한다. LDM의 2단계 목표 함수를 대체할 수 있는 학습 방식이다.
- Finite Scalar Quantization: VQ-VAE Made Simple: VQ-reg autoencoder가 쓰는 벡터 양자화 층을 finite scalar quantization으로 단순화한 연구. VQGAN 계보의 1단계 tokenizer 설계에서 맞닿는다.
- Cosmos World Foundation Model Platform for Physical AI: Cosmos의 diffusion 계열 world model이 토크나이저 latent 위에서 동작하는 latent diffusion이다. 영상 도메인에서 같은 두 단계 구조를 쓴다.
- Generative Physical AI in Vision: A Survey: 생성 physical AI 서베이. diffusion model의 샘플링 효율 문제와 latent diffusion이 연산을 latent space로 옮긴 계보를 배경 지식으로 정리한다.
- 용어집: LLMs (Terminology Glossary): attention, backbone, 임베딩, 양자화 등 이 페이지가 쓰는 모델 용어의 canonical 표기.