Physical AI · ARTICLE · 2026
03-03. RT-1 - 모두의 로보틱스 - VLA 입문
요약
RT-1(Brohan 2022) 논문을 처음 읽는 사람을 위한 한국어 입문 해설이다. "모두의 로보틱스 - VLA 입문" 시리즈의 03-03편으로, 로봇 학습의 기초 개념부터 시작해 RT-1의 문제 설정과 모델 구조, 데이터, 실험 결과, 설계 ablation까지 차례대로 다룬다.
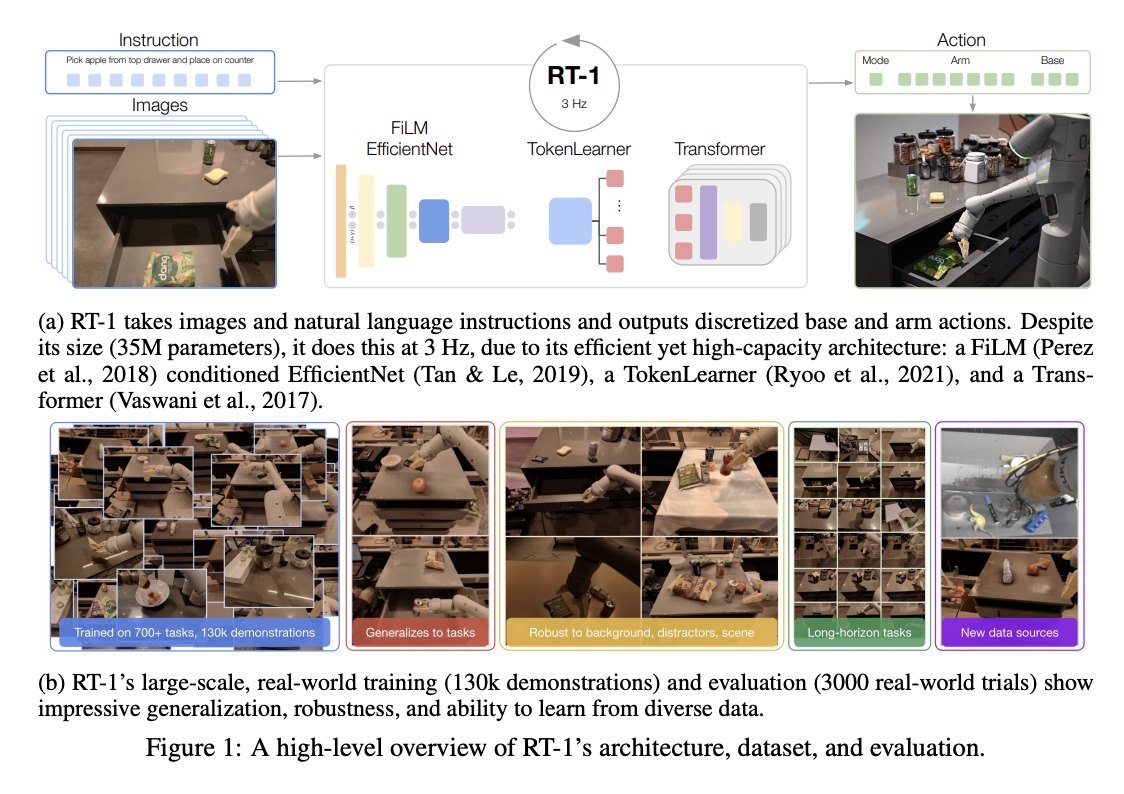
RT-1은 자연어 처리와 비전에서 검증된 흐름, 즉 하나의 큰 모델이 여러 작업을 학습하고 일반화하는 방식이 로봇에서도 가능한지를 실증한 논문이다. 이 페이지는 그 검증 과정을 원문의 전개 순서대로 따라간다. 원 논문은 RT-1: Robotics Transformer for Real-World Control at Scale에 정리되어 있으므로, 이 입문 페이지를 먼저 읽고 원 논문 페이지로 넘어가는 순서를 권한다.
배경
로봇 데이터는 텍스트나 이미지와 달리 수집 비용이 크다. 텍스트와 이미지는 인터넷에서 대규모로 수집할 수 있지만, 로봇 데이터는 실제 로봇을 움직이고 환경을 준비하고 사람의 시연까지 거쳐야 나온다. 따라서 RT-1 이전의 로봇 학습은 대체로 특정 작업용 데이터를 모아 특정 작업용 policy를 따로 학습하는 방식으로 발전해 왔다.
이 방식은 정해진 작업 하나에서는 강할 수 있지만, 물체가 바뀌거나 배경이 달라지거나 지시문 조합이 달라지면 다시 데이터를 모으고 다시 학습해야 한다. 논문은 이 한계를 출발점으로 삼는다.
RT-1의 기여는 Transformer를 로봇에 적용한 것 자체가 아니라, 다음 세 가지를 함께 검증한 데 있다.
- 로봇에서도 범용 backbone 모델이 가능한지
- 대규모 multi-task 데이터가 generalization을 높이는지
- 그런 모델을 실제 제어에 쓸 만큼 효율적으로 만들 수 있는지
특히 성능뿐 아니라 실시간 제어까지 함께 문제로 다룬 점이 기존 연구와 구분된다. 이 관점에서 RT-1은 로봇 학습이 task-specific 방식에서 generalist policy로 넘어가는 전환점에 놓인 연구다.
핵심 개념
원문은 본론에 앞서 기초 개념을 공들여 풀이한다. 이 절의 개념만 잡으면 뒤의 모델 구조는 자연스럽게 읽힌다.
policy와 episode
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 즉 무엇을 분류하는 모델이 아니라 로봇이 다음에 어떻게 움직일지를 결정하는 모델이다. RT-1에서는 이미지와 지시문(instruction)을 입력받아 action distribution을 만들고 거기서 action을 골라 로봇에 적용한다.
로봇은 한 번만 판단하고 끝나지 않는다. action이 실행되면 장면이 바뀌고, policy는 새 이미지를 보고 다음 action을 낸다. 작업 시작부터 종료까지의 이 전체 시도가 episode이고, 그 안에서 observation을 받아 action을 내는 한 단위가 timestep이다. 따라서 로봇 policy는 정적인 입력 하나를 처리하는 모델이 아니라 시간에 따라 반복적으로 행동을 내는 순차 의사결정 시스템으로 이해해야 한다.
imitation learning과 behavioral cloning
RT-1의 학습 방식은 강화학습이 아니라 imitation learning이다. imitation learning은 성공한 시연 데이터(demonstration)를 흉내 내 policy를 학습하는 방법이고, 그중에서도 behavioral cloning은 시연 데이터의 observation과 action 쌍을 지도학습으로 맞히게 학습한다. 즉 잘한 예시를 보고 그대로 모사하는 방식이다.
action의 구성
RT-1의 action은 클래스 레이블 하나가 아니라 11차원 복합 제어 신호다. arm movement 7차원(x, y, z, roll, pitch, yaw, gripper 개폐), base movement 3차원(x, y, yaw), 그리고 arm 제어, base 제어, episode 종료 중 하나를 고르는 mode 1차원으로 구성된다.
즉 "왼쪽으로 가라" 같은 단일 명령이 아니라 팔, 바퀴, 그리퍼, 종료 여부를 함께 담은 신호다. RT-1은 이미지와 지시문을 함께 보고 이 action을 예측하기 때문에 vision-language-action policy로 분류된다.
실시간 제어 조건
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. RT-1은 3Hz로 동작한다. 즉 1초에 3번 새 action을 낸다. 논문은 사람이 이런 조작 작업을 2~4초에 끝내는 것을 기준으로, 지나치게 느리지 않으려면 최소 3Hz가 필요하다고 본다.
3Hz 기준으로 한 제어 루프는 약 333ms다. 그런데 이 시간에는 센서 캡처, 전처리, 명령 전달, 로봇 적용 지연이 함께 들어가므로 모델이 전부 쓸 수 없다. 따라서 모델 자체의 추론 예산은 100ms 이하로 잡는다. 여기에 매 timestep 새 observation을 받아 action을 갱신하는 closed-loop control까지 더하면, RT-1이 정확도만이 아니라 속도를 설계 조건으로 삼은 이유가 설명된다.
이 절의 내용을 합치면 RT-1의 목표는 다음과 같이 정의된다. 일정한 주기로 action을 갱신하고, 그 주기 안에 들어올 만큼 빠르고, closed-loop 안에서 안정적으로 동작하는 Transformer 기반 policy를 만드는 것이다.
모델 구조
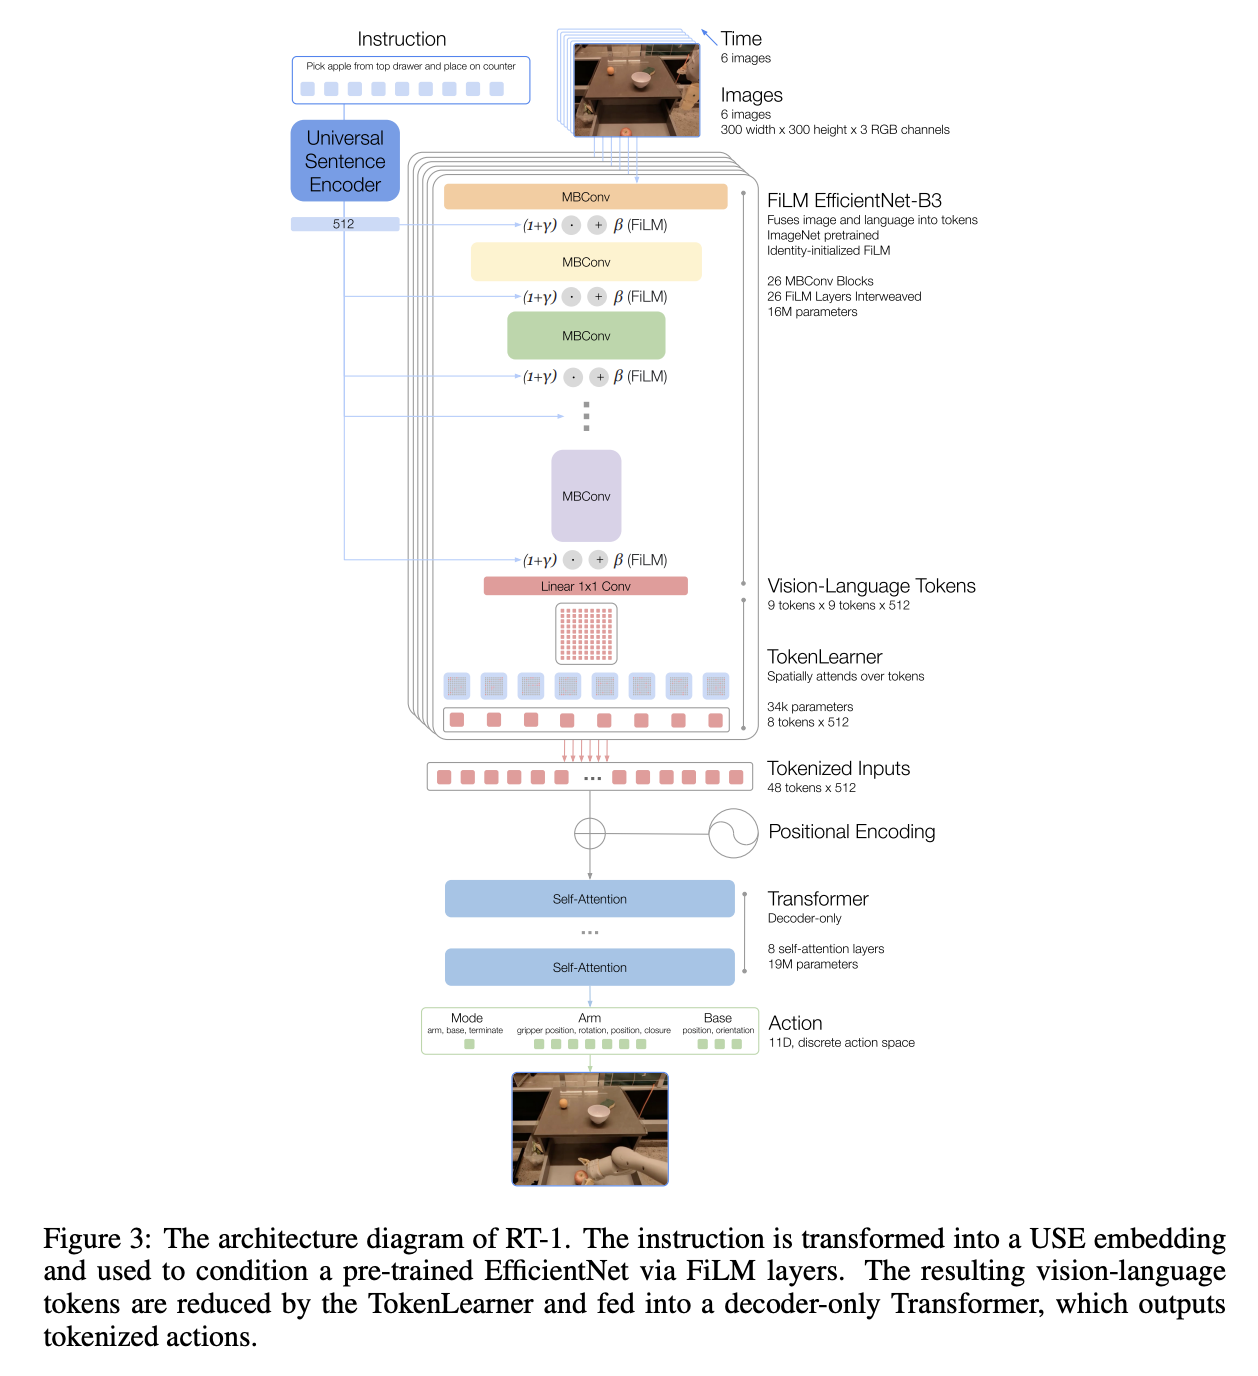
RT-1의 구조는 세 단계로 나뉜다. 이미지와 지시문을 토큰으로 바꾸고, 중요한 시각 정보만 압축하고, Transformer가 action token을 예측한다.
| 구분 | 내용 |
|---|---|
| 입력 | 최근 6장의 300×300 이미지 히스토리 + 지시문 한 문장 |
| 출력 | arm 7차원, base 3차원, mode 1차원의 11차원 action (차원별 256 bin 이산화) |
| 손실 | categorical cross-entropy |
| 제약 | 추론 예산 100ms 이하, 3Hz 제어 |
이미지 인코딩과 FiLM
이미지는 Transformer에 바로 들어가지 않는다. 먼저 ImageNet으로 pre-training된 EfficientNet-B3를 통과해 9×9×512 feature map이 되고, 이를 펼쳐 81개의 visual token으로 쓴다. 원본 픽셀 대신 이미 압축된 시각 특징을 다음 단계로 넘기는 구조다.
FiLM은 언어 임베딩으로 이미지 특징을 조건화하는 장치다. 예를 들어 지시문이 "drawer를 열어라"면 drawer 쪽 정보가, "apple을 집어라"면 apple과 gripper 주변 정보가 더 중요해져야 한다. RT-1은 지시문을 Universal Sentence Encoder로 임베딩한 뒤 FiLM layer를 통해 EfficientNet 내부에 주입해, 이미지 인코딩 단계부터 "이번 작업에서 무엇이 중요한가"를 반영한다. 또한 FiLM의 affine 가중치를 0으로 초기화해 학습 초반에는 항등 변환으로 동작하게 한 세부도 원 논문 그대로 설명한다.
TokenLearner
81개 token을 그대로 Transformer에 적용하면 계산량이 크고, 모든 token이 지금 작업에 똑같이 중요한 것도 아니다. TokenLearner는 여러 시각 token 중 중요한 것만 추려 압축하는 모듈로, RT-1은 이것으로 이미지당 81개 token을 8개로 줄인다. 즉 장면 전체를 균등하게 처리하는 대신 지금 행동 결정에 중요한 부분만 압축해서 보는 전략이다.
Transformer와 action 예측
6장의 이미지에서 8개씩 나온 token을 모으면 48개가 된다. 여기에 position encoding을 더해 decoder-only Transformer(self-attention 8층, 19M 파라미터)에 입력하면 action token이 나온다. 언어 모델이 다음 단어를 예측하듯 RT-1은 다음 action token을 예측하며, 출력이 문장이 아니라 로봇 행동이라는 점만 다르다.
action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다. 예를 들어 x축 이동값을 실수 하나로 회귀하는 대신 256개 구간 중 몇 번째인지를 맞힌다. 이산화를 택한 근거는 시연 데이터의 multi-modal 행동 분포다. 같은 상황에서도 시연자마다 다른 경로를 갈 수 있는데, Gaussian 연속 회귀는 하나의 mode만 표현하는 반면 차원별 이산화는 이런 복잡한 분포를 담을 수 있다. 분류형 손실인 categorical cross-entropy와 자연스럽게 연결되는 것도 장점이다.
추론 속도 확보 장치
100ms 예산은 두 장치로 맞춘다. TokenLearner로 token 수를 줄여 2.4배, 겹치는 window의 token을 재사용해 1.7배 가속한다. 따라서 RT-1의 구조는 복잡한 요소를 많이 쌓은 구조가 아니라, 중요한 정보만 남겨 실제 제어 가능한 속도를 맞춘 구조로 이해하는 편이 정확하다.
데이터
논문은 좋은 generalization을 위해 데이터가 규모와 폭을 함께 갖추고, task들 사이에 구조적 연결성이 있어야 한다고 본다. RT-1의 데이터 구성이 이 원칙을 그대로 반영한다.
- 13대의 로봇 fleet으로 17개월 동안 약 13만 개(130k)의 시연 데이터를 수집했다.
- 수행 가능한 지시문은 700개 이상이고, Table 1에 744개가 정리되어 있다.
- 로봇은 Everyday Robots의 mobile manipulator로, 7자유도 arm과 two-finger gripper와 mobile base를 갖췄다. action에 arm, base, gripper가 모두 들어가는 이유가 이 하드웨어 구성이다.
- 데이터 수집은 robot classroom에서, 평가는 조명과 배경과 구조가 다른 두 실제 office kitchen에서 진행했다.
지시문과 skill의 구분도 중요하다. "pick iced tea can"은 하나의 지시문이고, 이것이 속한 더 큰 동작 범주가 Pick Object skill이다. 같은 skill이 다양한 물체와 조합되도록 데이터를 설계했기 때문에, 모델이 비슷한 패턴을 발견해 새로운 조합으로 확장할 여지가 생긴다. RT-1이 generalist policy를 지향할 수 있었던 바탕이 이 연결된 데이터 구성이다.
평가와 결과
RT-1의 평가는 하나의 숫자가 아니라 네 항목으로 나뉜다.
| 평가 항목 | 내용 | 규모 |
|---|---|---|
| seen task | 학습에 포함된 지시문을 조건(물체 배치, 시간대, 로봇 위치)을 바꿔가며 안정적으로 수행하는지 | 200개 이상 task |
| unseen task | 학습에서 본 skill과 object를 새로운 조합으로 묶은 지시문에 일반화하는지 | 21개 지시문 |
| robustness | distractor(주변 물체 증가)와 background(조명, 배경, 표면 변화)를 견디는지 | 30개 + 22개 task |
| long-horizon | 여러 skill을 이어야 하는 긴 시나리오를 수행하는지 | SayCan 결합 평가 |
기본 성능
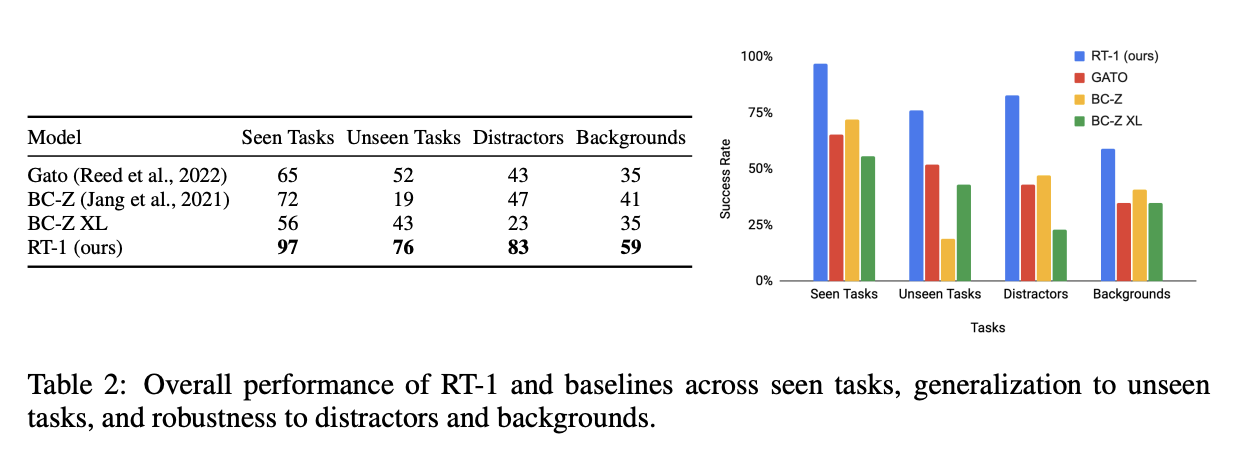
| 항목 | RT-1 | 두 번째로 높은 모델 대비 |
|---|---|---|
| seen | 97% | 최고 |
| unseen | 76% | +25%p |
| distractor | 83% | +36%p |
| background | 59% | +18%p |
실제 Google kitchen에서 일반화 난이도를 L1부터 L3까지 나눈 평가에서도 RT-1이 전체적으로 가장 강하다. 새로운 countertop 배치와 조명 변화가 있는 L1에서 특히 높고, 가장 어려운 L3에서도 Gato보다 확실히 높으며 BC-Z 계열과 비슷하거나 더 낫다.
이질적 데이터 흡수
RT-1은 성격이 다른 데이터를 함께 학습해도 원래 성능을 잃지 않는다.
- 실세계에서 본 적 없는 물체의 simulation 데이터를 더하면, 원래 하던 실제 task 성능은 거의 유지되면서 simulation에서만 본 물체의 실제 성능이 크게 오른다. sim 물체에 대한 seen skill은 23%에서 87%로, unseen skill은 7%에서 33%로 오른다.
- 전혀 다른 Kuka 로봇의 bin-picking 데이터를 함께 학습하면 classroom 평가는 92%에서 90%로 거의 유지되면서 bin-picking 평가가 22%에서 39%로 거의 2배가 된다. 반면 Kuka 데이터만으로 학습하면 두 평가 모두 0%다.
즉 다른 로봇의 데이터를 그대로 복사해 쓰는 것은 아니지만, 함께 학습하면 새로운 조작 유형으로 일반화가 넓어진다.
긴 작업과 데이터 구성
SayCan planner의 저수준 실행기로 결합했을 때 RT-1은 두 kitchen 모두 planning 87%에 Kitchen1 execution 67%로 가장 높았고, 학습 환경과 크게 다른 Kitchen2에서도 성능 저하가 크지 않았다. 최대 50 step까지 이어지는 시나리오도 수행한다.
데이터 구성에 대한 결론도 명확하다. task 다양성을 유지한 채 양만 줄이면 성능이 비교적 점진적으로 하락하지만, 다양성을 줄인 좁은 데이터에서는 하락이 훨씬 크다. 따라서 양보다 다양성이 generalization에 더 중요하다는 것이 Table 7의 결론이다.
설계 ablation
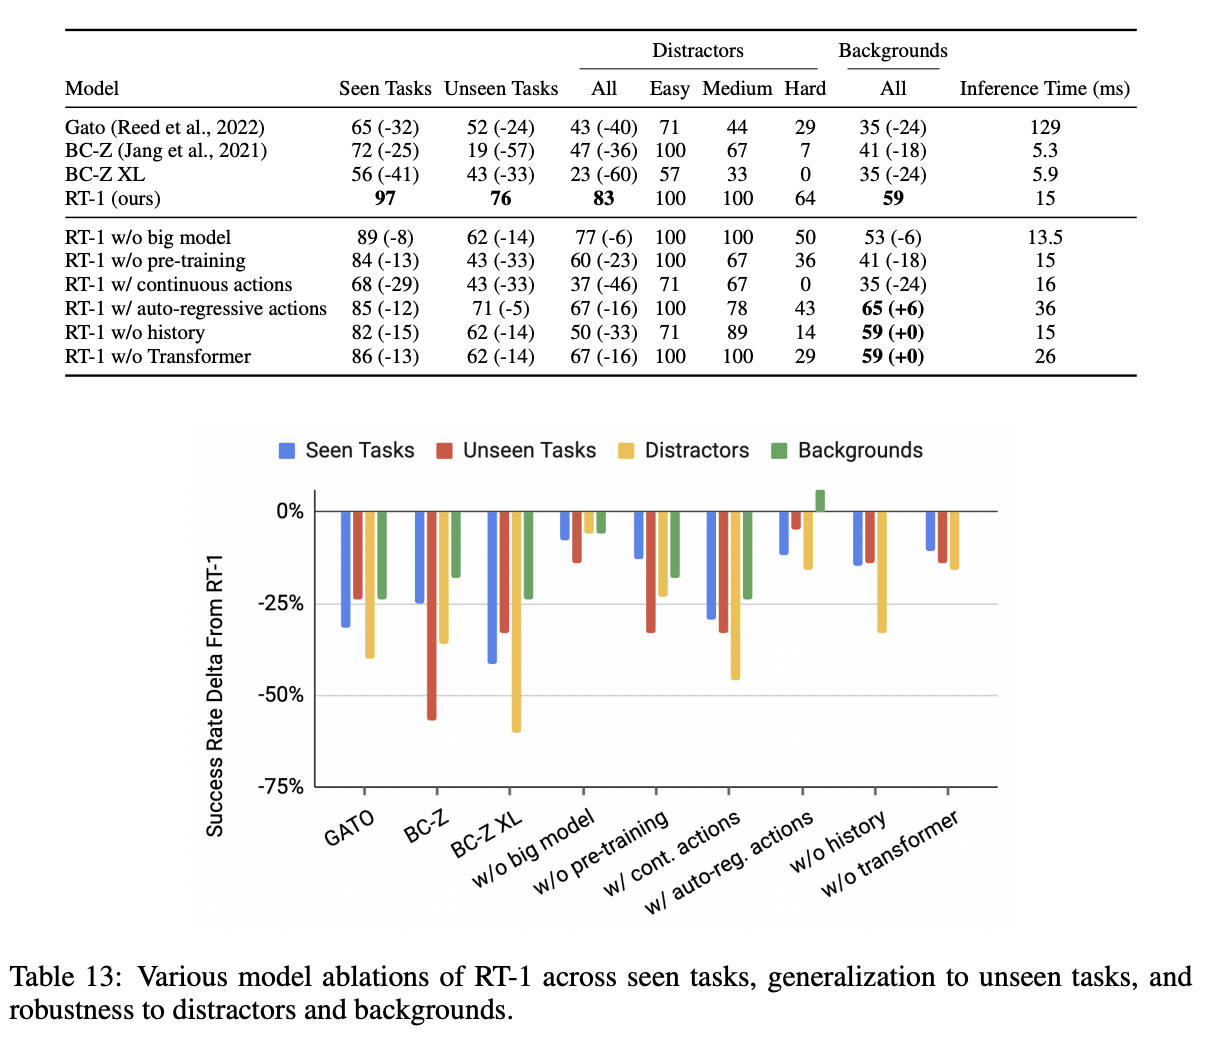
Table 13은 RT-1의 성능이 어느 설계에서 나오는지를 항목별로 확인한다.
| 변경 | 결과 (seen / unseen / distractor / background, %) | 해석 |
|---|---|---|
| full RT-1 | 97 / 76 / 83 / 59 | 기준 |
| continuous action으로 교체 | 68 / 43 / 37 / 35 | 이산화가 multi-modal 분포 표현의 핵심 |
| ImageNet pre-training 제거 | 84 / 43 / 60 / 41 | 시각 일반화의 바탕. unseen이 33%p 하락 |
| observation history 제거 | 82 / 62 / 50 / 59 | 시간 맥락이 distractor 상황에 중요. hard distractor는 64%에서 14%로 |
| Transformer 제거 | 86 / 62 / 67 / 59 | backbone만으로는 부족. unseen과 distractor 격차 큼 |
| 모델 35M을 21M으로 축소 | 89 / 62 / 77 / 53 | 하락 폭이 크지는 않지만 full model이 일관되게 우위 |
| auto-regressive action 추가 | 85 / 71 / 67 / 65 | 성능 이득 없이 추론이 15ms에서 36ms로 2배 이상 지연. 최종안에서 제외 |
이 표가 보여주듯 RT-1은 Transformer를 로봇에 적용한 연구가 아니다. action 표현, 시각 pre-training, 시간 맥락, 추론 속도가 함께 맞물리도록 조율된 구조이고, 그 조합이 일반화와 robustness로 이어졌다.
한계
이 해설이 정리하는 RT-1의 한계는 원 논문의 것을 그대로 따른다.
- behavioral cloning 기반이라 시연을 재현하는 데는 강하지만 시연 데이터에 없는 새 전략을 스스로 탐색하지는 못한다.
- unseen task 일반화도 이미 본 skill과 object를 새로 조합하는 compositional generalization 범위에 머문다. 완전히 새로운 물리 상호작용을 배우는 단계는 아니다.
- 긴 작업의 좋은 성적은 SayCan 같은 상위 planner와 결합했을 때 나온다. RT-1 자체는 계획을 세우기보다 안정적인 low-level 실행기에 가깝다.
- 다른 로봇 데이터를 흡수할 가능성은 보였지만, action space와 형상이 다른 로봇까지 자연스럽게 일반화하는 multi-embodiment 단계에는 이르지 못했다.
- 13대 로봇으로 17개월간 약 13만 개의 시연 데이터를 모아야 했던 수집 비용은 누구나 재현할 수 있는 설정이 아니다.
- background robustness 59%는 seen 97%와 비교하면 여전히 격차가 크다. 환경이 크게 바뀔수록 성능 저하가 남아 있다.
이런 한계에도 RT-1의 의의는 분명하다. 로봇 policy가 generalist backbone 방향으로 갈 수 있다는 것을 실제 로봇 수준에서 처음 설득력 있게 보여줬고, 이후 VLA 연구가 이어받을 데이터 구성, 언어 조건화, action 표현, 실시간 구조라는 설계 원칙을 남겼다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| FiLM | 언어 임베딩으로 이미지 특징을 조건화하는 장치. RT-1은 EfficientNet 내부에 FiLM layer를 삽입해 지시문에 맞게 시각 특징을 조절한다 |
| Universal Sentence Encoder (USE) | 문장을 벡터로 바꾸는 임베딩 모델. 지시문을 FiLM 조건으로 쓰기 위한 입력을 만든다 |
| TokenLearner | 다수의 시각 token 중 중요한 것만 추려 압축하는 모듈. 81개를 8개로 줄여 추론을 가속한다 |
| action tokenization | 연속 제어값을 차원별 256개 bin으로 이산화해 분류 문제처럼 다루는 방식 |
| control frequency | 초당 action 갱신 횟수. RT-1은 3Hz, 모델 추론 예산은 100ms 이하 |
| compositional generalization | 학습한 skill과 object를 새로운 조합으로 묶어 낯선 지시문을 수행하는 일반화. RT-1의 unseen 평가가 주로 이 범주다 |
관련 페이지
- RT-1: Robotics Transformer for Real-World Control at Scale: 이 페이지가 해설하는 원 논문. 입문 페이지를 먼저 읽고 원 논문 페이지로 넘어가는 순서를 권한다.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 다음 편. RT-1의 action tokenization을 웹 스케일 VLM과 결합한 RT-2를 다룬다.
- [실리콘밸리 RFM 기술 및 현황] - 1편: RFM의 등장 배경과 실리콘밸리의 Robot Intelligence 스타트업의 현황: RT-1이 속한 VLA와 로봇 foundation model 계보를 업계 시각에서 조망한 글.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.