Physical AI · ARTICLE · 2023
Open X-Embodiment: Robotic Learning Datasets and RT-X Models
요약
Open X-Embodiment는 21개 기관 34개 연구실이 각자 보유하던 로봇 데이터셋 60종을 하나의 표준 형식으로 합친 공개 데이터셋이고, RT-X는 그 데이터로 학습한 모델 계열이다. 데이터셋은 22개 embodiment에서 모은 100만 개 이상의 실제 로봇 trajectory를 담으며, 공개 시점 기준 가장 큰 오픈소스 실제 로봇 데이터셋으로 소개된다.
RT-1과 RT-2를 이 데이터 혼합으로 다시 학습한 RT-1-X와 RT-2-X는 각 데이터셋 전용으로 만들어진 모델보다 높은 성공률을 냈다. 즉 서로 다른 로봇의 데이터를 섞는 것이 성능을 깎지 않고 오히려 서로를 끌어올린다. RT-1과 RT-2가 하나의 모델로 여러 과제를 다뤘다면, RT-X가 넓힌 것은 과제의 수가 아니라 로봇의 종류다.
이 페이지가 다루는 자료는 논문(arXiv 2310.08864)을 요약한 프로젝트 페이지다. 따라서 실험 조건과 평가 프로토콜과 ablation은 담겨 있지 않고, 데이터셋 구성과 두 모델의 대비가 도식 몇 장으로 압축돼 있다. ablation은 구성 요소를 하나씩 빼거나 바꿔가며 성능 변화를 확인하는 실험을 말한다.
배경
로보틱스에는 아직 범용 backbone이 없다는 문제의식이 abstract 첫머리에 놓여 있다. NLP와 컴퓨터 비전에서는 다양한 데이터로 학습한 대형 모델이 여러 downstream 응용의 공통 출발점이 되는 통합이 일어났다. 반면 로봇 학습은 관행적으로 응용마다, 로봇마다, 심지어 환경마다 별도의 모델을 학습해 왔다.
프로젝트는 그 통합이 로보틱스에서도 일어날 수 있는지를 검증 대상으로 삼는다. 구체적으로는 새로운 로봇과 과제와 환경에 효율적으로 적응하는 generalist X-robot policy를 학습할 수 있는지를 확인한다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
검증에 앞서 두 가지가 먼저 필요하다. 하나는 여러 로봇의 데이터를 한 형식으로 읽을 수 있게 정리한 데이터이고, 다른 하나는 그 데이터 혼합 위에서 학습되는 모델이다. 프로젝트의 산출물 세 가지가 그 순서를 그대로 따른다.
- 표준 데이터 형식으로 통일한 Open X-Embodiment 데이터셋
- 그 데이터 혼합으로 학습한 RT-X 모델 계열
- 여러 로봇에 걸친 policy가 실제로 이득을 낸다는 실험 결과
핵심 개념
embodiment
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. 팔이 하나인 로봇과 양팔 로봇과 4족 보행 로봇은 관절 수도 다르고 제어 명령의 형식도 다르므로 서로 다른 embodiment다.
따라서 한 로봇에서 모은 데이터를 다른 로봇의 학습에 그대로 쓸 수는 없다. 출력 형식을 공통 규격으로 맞추는 작업이 먼저 있어야 하고, 이 프로젝트의 표준 형식이 그 역할을 맡는다.
positive transfer
positive transfer는 다른 로봇이나 다른 과제의 데이터를 함께 학습했을 때 성능이 떨어지지 않고 오히려 오르는 현상을 말한다. 프로젝트의 핵심 주장이 여기에 있다. 이질적인 데이터는 서로 간섭해 성능을 깎을 수도 있는데, RT-X 실험은 반대 방향의 결과를 보고한다.
Original Method
Original Method는 각 데이터셋을 만든 팀이 자기 데이터에 맞춰 최적화해 둔 모델을 가리키는 이름이다. 페이지는 이 모델을 합리적인 기준선으로 설명한다. 데이터를 만든 사람이 그 데이터에 맞게 조율했으므로 해당 과제에서 잘 동작할 것으로 기대할 수 있기 때문이다.
emergent skill
emergent skill은 개별 데이터셋에는 없던 과제를 가리키며, 여기서는 특히 물체 사이의 공간 관계를 이해해야 풀리는 지시가 대상이다. 예를 들어 "move apple on cloth"와 "move apple near cloth"는 전치사 하나만 다르지만 로봇이 실제로 내야 할 동작은 서로 다르다.
데이터셋 구성
규모
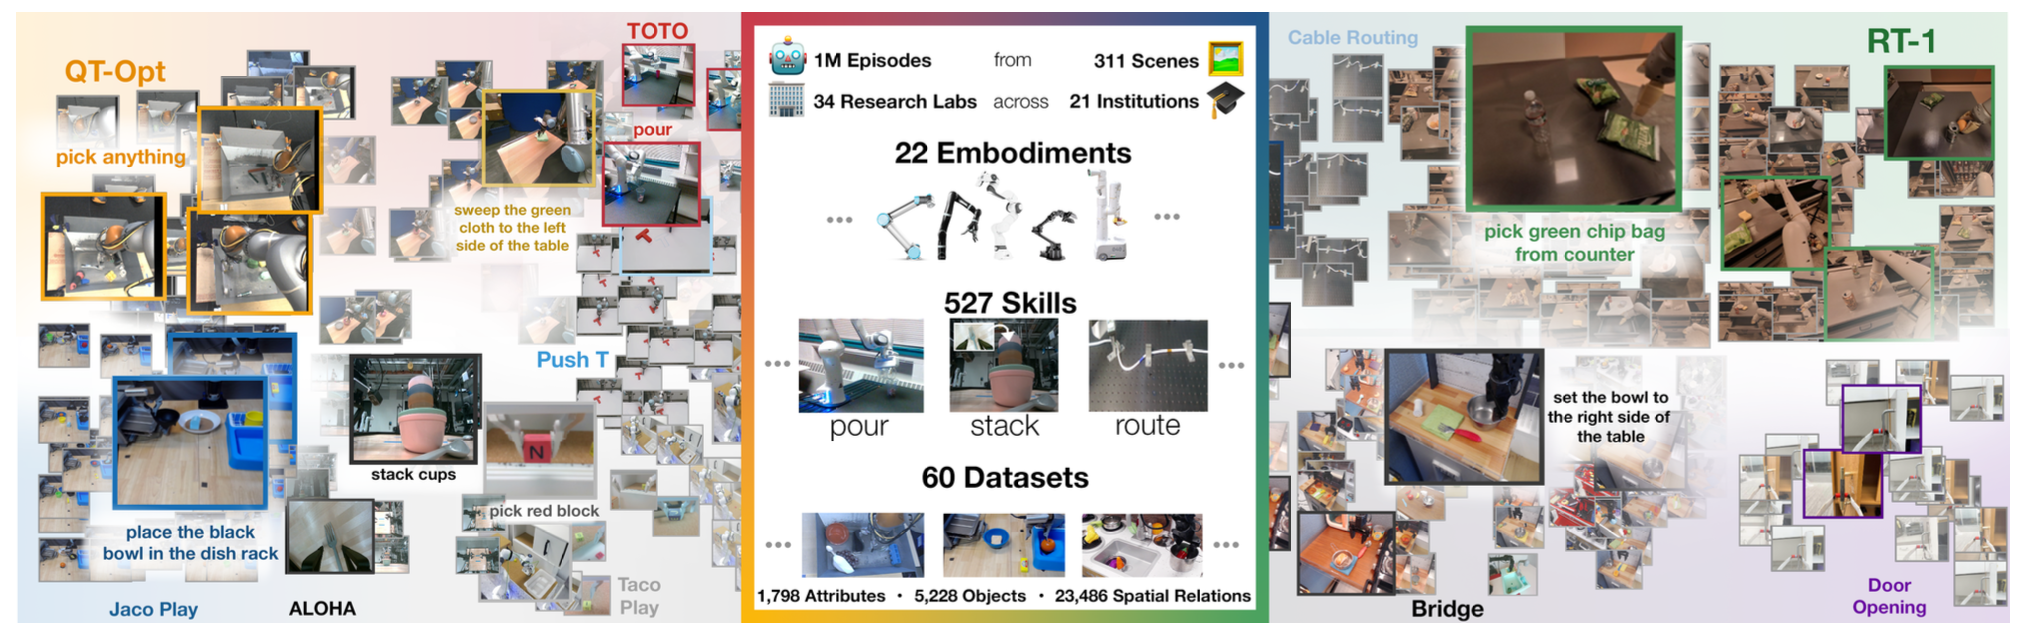
Open X-Embodiment 데이터셋은 새로 수집한 데이터가 아니라 이미 존재하던 데이터셋 60종을 모아 표준 형식으로 옮긴 결과다. 34개 연구실이 각자 쌓아 둔 자료를 21개 기관이 협업해 하나로 풀링했다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이고, episode는 과제 시작부터 종료까지의 한 실행 단위다.
| 항목 | 규모 |
|---|---|
| episode | 100만 건 |
| scene | 311종 |
| embodiment | 22종 |
| skill | 527종 (task 16만 266개) |
| 편입 데이터셋 | 60종 |
| 연구실 / 기관 | 34개 / 21개 |
| 속성 / 객체 / 공간 관계 | 1,798개 / 5,228개 / 23,486종 |
로봇 구성은 단일 팔부터 양팔 로봇과 4족 보행 로봇까지 걸쳐 있다. skill 527종에는 pour와 stack과 route처럼 성격이 다른 조작 유형이 함께 들어간다.
편입 데이터셋과 분포
편입된 데이터셋에는 QT-Opt, Bridge, RT-1, ALOHA, TOTO, Jaco Play, Taco Play, Push T, Cable Routing, Door Opening 등이 있다. 전체 목록과 각 데이터셋의 인용 정보는 프로젝트가 공개한 스프레드시트에 정리돼 있다.
분포 분석은 두 가지를 보여준다. 먼저 시각적으로 구분되는 scene의 수는 embodiment 사이에 비교적 고르게 퍼져 있고, 일상적인 행동과 가정용 물체가 폭넓게 포함돼 있다.
반면 trajectory 수는 xArm과 Google Robot과 Kuka iiwa 몇 종에 몰려 있고, skill 분포에서도 picking과 moving이 다른 skill을 크게 앞선다. 따라서 장면의 다양성은 확보됐지만 로봇별 데이터 양과 skill 종류는 균형이 맞지 않는다.
방법
두 모델 계열
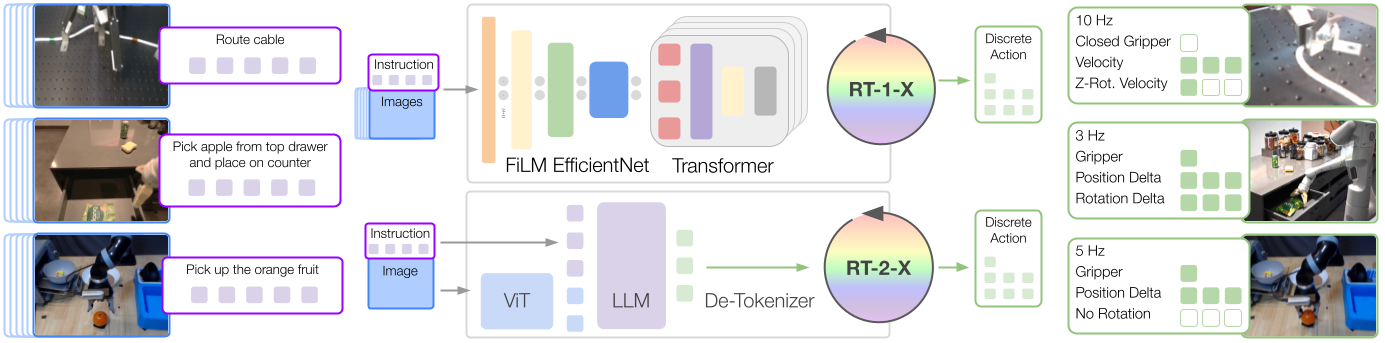
RT-X는 새 아키텍처가 아니라 기존 두 모델을 이 데이터 혼합으로 다시 학습한 결과다. 데이터 혼합으로 학습한 쪽에 -X를 붙여 각각 RT-1-X와 RT-2-X로 부른다.
| 모델 | 원 모델의 성격 | 입력 경로 | 출력 |
|---|---|---|---|
| RT-1-X | 로봇 제어용으로 설계된 효율적 Transformer 구조 | 지시문과 이미지 히스토리가 FiLM EfficientNet을 거쳐 Transformer로 들어간다 | 이산 action |
| RT-2-X | action을 자연어 토큰으로 출력하도록 co-fine-tuning한 대형 VLM | 지시문과 이미지 한 장이 ViT와 LLM을 거쳐 de-tokenizer로 들어간다 | 이산 action |
co-fine-tuning은 로봇 데이터만 쓰지 않고 웹 데이터를 배치에 계속 섞는 학습 레시피를 말한다. 지시문(instruction)은 로봇에게 과제를 지정하는 자연어 문장이다. 두 모델의 차이는 입력 경로와 규모에 있고, 출력이 이산 action이라는 점은 같다.
action 형식 통일
서로 다른 로봇을 한 모델에 태우려면 출력 형식을 하나로 맞춰야 한다. 두 모델 모두 그리퍼 기준 좌표계에서 action을 표현한다. 형식은 x, y, z, roll, pitch, yaw와 그리퍼 개폐로 이루어진 7차원 벡터, 또는 그 값들의 변화율이다.
모든 로봇이 7개 차원을 다 쓰지는 않는다. 어떤 로봇이 쓰지 않는 차원은 학습 시 값을 0으로 채운다. 따라서 회전 제어가 없는 로봇의 데이터도 같은 7차원 형식 안에서 함께 학습된다.
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. embodiment마다 다른 control frequency는 통일하지 않고 그대로 둔다. 프로젝트 도식이 예시로 나란히 놓은 세 가지 구성은 다음과 같다.
| 예시 embodiment | control frequency | 실제로 쓰는 출력 |
|---|---|---|
| 케이블 배선 로봇 | 10Hz | 그리퍼 개폐, 속도 3차원, z축 회전 속도 |
| 서랍 조작 로봇 | 3Hz | 그리퍼 개폐, 위치 변화량 3차원, 회전 변화량 3차원 |
| 과일 집기 로봇 | 5Hz | 그리퍼 개폐, 위치 변화량 3차원 (회전 없음) |
10Hz는 1초에 10번, 3Hz는 1초에 3번 새 action을 낸다는 뜻이다. 즉 같은 모델이 로봇마다 다른 주기와 다른 출력 조합으로 동작한다.
결과
소규모 데이터 영역의 RT-1-X
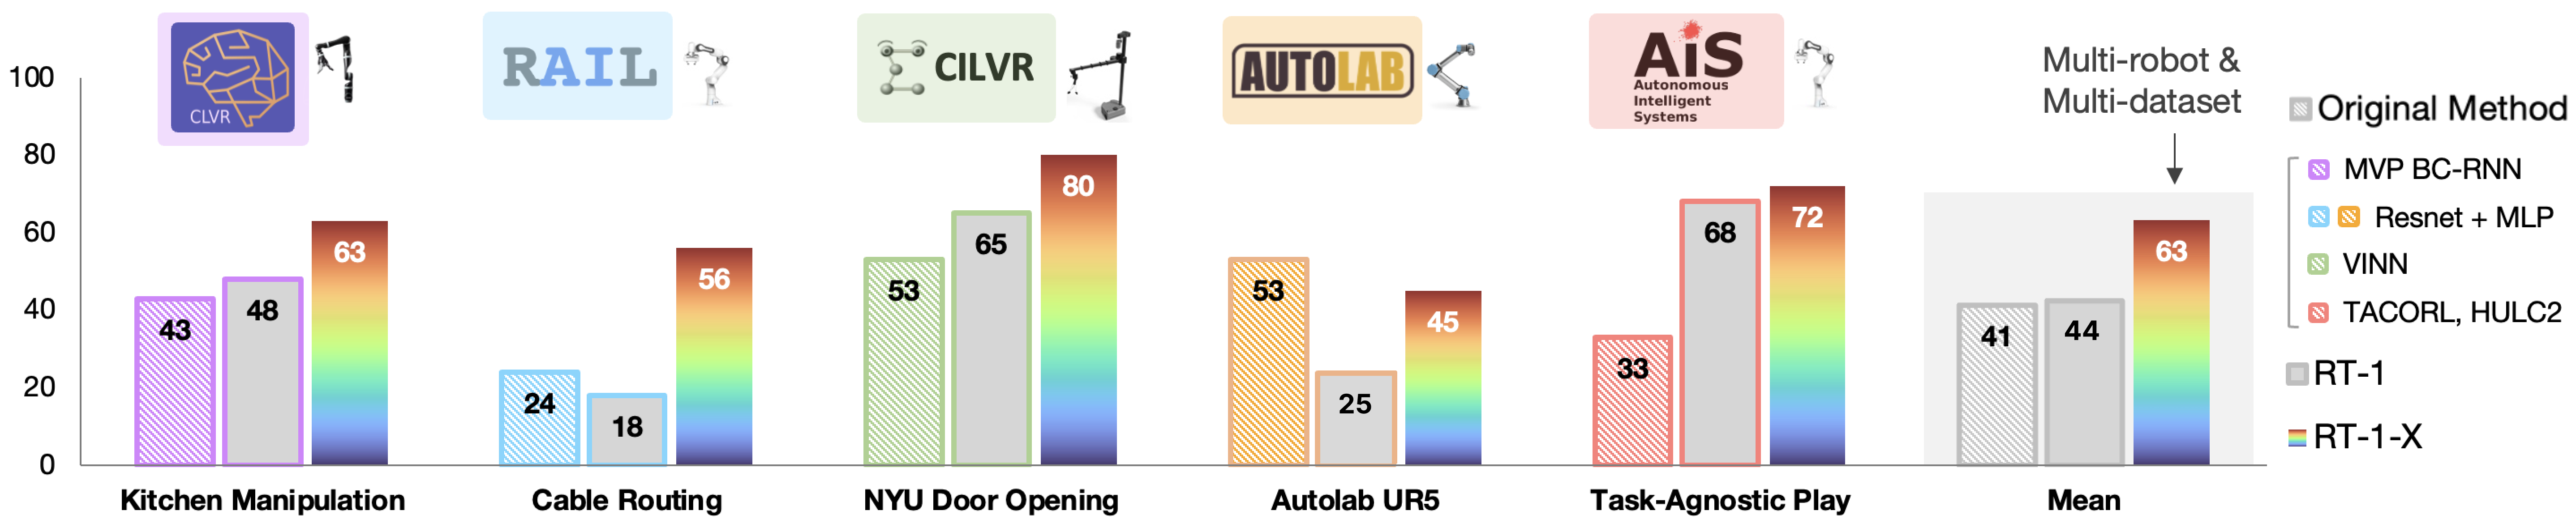
RT-1-X는 대학 연구실 6곳의 실제 기기에서 평가했다. UC Berkeley의 RAIL과 AUTOLab, University of Freiburg의 AiS, NYU의 CILVR, Stanford의 IRIS, USC의 CLVR이 참여했다. 데이터가 적은 영역에서 진행한 평가이며, 비교 대상은 Original Method와 해당 데이터만으로 학습한 RT-1이다.
| 과제 | Original Method | RT-1 | RT-1-X |
|---|---|---|---|
| Kitchen Manipulation (USC CLVR) | 43% (MVP BC-RNN) | 48% | 63% |
| Cable Routing (Berkeley RAIL) | 24% (ResNet + MLP) | 18% | 56% |
| NYU Door Opening (NYU CILVR) | 53% (VINN) | 65% | 80% |
| Autolab UR5 (Berkeley AUTOLab) | 53% (ResNet + MLP) | 25% | 45% |
| Task-Agnostic Play (Freiburg AiS) | 33% (TACORL, HULC2) | 68% | 72% |
| 평균 | 41% | 44% | 63% |
평균 성공률은 Original Method 41%, RT-1 44%, RT-1-X 63%다. 페이지는 이를 소규모 데이터 영역에서 50% 개선이라고 표현한다. 즉 기준선 성공률의 절반가량에 해당하는 상승 폭이다.
과제별로 보면 이득이 균일하지 않다. Cable Routing은 24%에서 56%로 32%p 올라 개선 폭이 가장 크고, NYU Door Opening도 53%에서 80%로 27%p 올랐다. 반면 Autolab UR5는 Original Method 53%에 RT-1-X 45%로 8%p 낮아 유일하게 뒤진다.
RT-1과의 비교도 함께 봐야 한다. 같은 데이터만으로 학습한 RT-1은 Cable Routing 18%와 Autolab UR5 25%처럼 Original Method보다 낮은 과제가 있다. 따라서 63%라는 평균은 RT-1 아키텍처 자체가 아니라 여러 로봇의 데이터를 함께 학습한 데서 나온 결과로 읽어야 한다.
emergent skill 영역의 RT-2-X
RT-2-X는 개별 데이터셋에 없던 과제, 즉 emergent skill에서 평가했다. 평가 과제는 절대 방향으로의 이동과 객체 기준 상대 이동, 그리고 전치사에 따라 동작이 달라지는 지시로 구성된다.
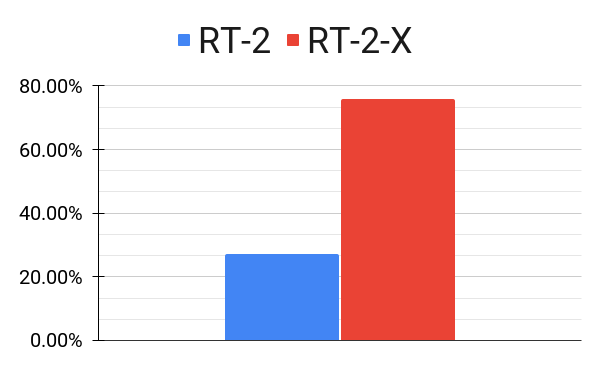
성공률은 RT-2 약 27%에서 RT-2-X 약 76%로 올랐다. 약 3배 차이이며, RT-2가 수행하지 못하던 과제를 RT-2-X가 수행한다는 뜻이다.
정성적 결과는 두 방향이다. 첫째, "move apple on cloth"와 "move apple near cloth"처럼 전치사만 바꾼 지시에서 로봇의 저수준 동작이 달라졌다. 둘째, 절대 위치와 객체 기준 상대 위치 양쪽에서 공간 관계 이해를 보였고, "move apple between can & orange"처럼 두 물체 사이를 지정하는 지시도 수행했다.
페이지는 55B 규모의 RT-2-X를 대학 연구실 환경에서 학습에 없던 과제를 수행한 모델 중 현재까지 가장 큰 사례의 하나로 소개한다.
한계
페이지 자체는 한계 절을 따로 두지 않는다. 아래는 자료를 읽으며 확인되는 것만 정리한 것이다.
- cross-embodiment 학습이 항상 이득은 아니다. Autolab UR5에서는 RT-1-X가 Original Method보다 8%p 낮았다.
- trajectory 분포가 몇몇 embodiment에 쏠려 있고 skill도 picking과 moving에 몰려 있어 데이터 균형 문제가 남는다.
- RT-2-X는 55B 규모라 직접 실행하기 어렵고, 접근 경로가 API 신청 폼으로 제한된다.
- 데이터셋은 기여 신청 폼으로 계속 늘려가는 진행형 프로젝트다. 따라서 이 페이지가 적는 규모는 공개 시점의 값이다.
자료 형식에서 오는 한계가 가장 크다. 실험 조건과 평가 프로토콜과 ablation이 프로젝트 페이지에 없으므로 세부는 arXiv 2310.08864 논문을 확인해야 한다. 코드는 google-deepmind/open_x_embodiment에 공개돼 있고, 편입 데이터셋 목록과 각각의 인용 정보는 프로젝트가 링크한 스프레드시트에 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Open X-Embodiment (OXE) | 34개 연구실의 데이터셋 60종을 표준 형식으로 합친 공개 실제 로봇 데이터셋. 22개 embodiment에서 모은 100만 개 이상의 trajectory를 담는다 |
| RT-X | OXE 데이터 혼합으로 학습한 모델 계열. RT-1 기반이 RT-1-X, RT-2 기반이 RT-2-X다 |
| positive transfer | 다른 로봇이나 다른 과제의 데이터를 함께 학습했을 때 성능이 떨어지지 않고 오히려 오르는 현상 |
| X-robot policy | 여러 embodiment에서 공통으로 쓰이도록 학습한 policy를 프로젝트가 부르는 이름 |
| Original Method | 각 데이터셋을 만든 팀이 자기 데이터에 맞춰 최적화해 둔 모델. RT-1-X 비교의 기준선이다 |
| emergent skill | 개별 데이터셋에는 없던 과제. 여기서는 공간 관계와 전치사 이해가 필요한 지시를 가리킨다 |
관련 페이지
- RT-1: Robotics Transformer for Real-World Control at Scale: RT-1-X의 원본 논문. 약 13만 개의 시연 데이터(demonstration)로 학습한 35M 규모 Transformer policy이며, 다른 로봇의 데이터를 흡수할 수 있다는 관찰이 RT-X의 출발점이 됐다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: RT-2-X의 원본 논문. action을 텍스트 토큰으로 적어 VLM을 policy로 쓰는 레시피를 세웠다.
- 03-03. RT-1 - 모두의 로보틱스 - VLA 입문: RT-1의 한국어 입문 해설. policy와 action tokenization 같은 기초 개념이 낯설면 먼저 읽는다.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: RT-2의 한국어 입문 해설. RT-2-X가 물려받은 co-fine-tuning 레시피를 다룬다.
- 03-06. OpenVLA - 모두의 로보틱스 - VLA 입문: OpenVLA의 한국어 입문 해설. 이 데이터셋에서 어떤 기준으로 학습 데이터를 추렸는지 설명한다.
- OpenVLA: An Open-Source Vision-Language-Action Model: 이 데이터셋에서 추린 약 97만 개 시연 데이터로 학습한 오픈소스 VLA. 7B 규모로 55B RT-2-X를 앞섰다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 편입 데이터셋 중 하나인 ALOHA의 원 논문.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: cross-embodiment 학습을 humanoid로 확장한 후속 계열.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.