Physical AI · ARTICLE · 2026
03-06. OpenVLA - 모두의 로보틱스 - VLA 입문
요약
OpenVLA(Kim 2024) 논문을 처음 읽는 사람을 위한 한국어 입문 해설이다. "모두의 로보틱스 - VLA 입문" 시리즈의 03-06편으로, OpenVLA의 등장 배경부터 입출력 구조, 모델 구성, 학습 데이터, 설계 선택 비교, 평가 결과, 배포 비용 실험까지 원문의 전개 순서를 그대로 따라간다.
OpenVLA의 문제의식은 성능이 아니라 접근성에 있다. RT-2가 vision-language model을 로봇 제어에 잇는 방향을 보여줬지만 모델도 학습 절차도 fine-tuning 방식도 공개되지 않아 다른 연구자가 재현하거나 자기 로봇에 맞게 고칠 수 없었고, OpenVLA는 그 자리를 7B 규모의 오픈소스 모델로 채운다. 원 논문은 OpenVLA: An Open-Source Vision-Language-Action Model에 정리되어 있으므로, 이 입문 페이지로 전체 그림을 잡은 뒤 원 논문 페이지로 넘어가는 순서를 권한다.
배경
OpenVLA는 Gato에서 RT-1과 RT-2로 이어진 흐름 위에 놓인다. Gato는 하나의 큰 모델이 여러 종류의 과제를 함께 다룰 수 있다는 가능성을 보였고, RT-1은 이 방향을 실제 로봇 조작 데이터로 확장해 generalist robot policy의 형태를 구체화했다. RT-2는 인터넷 규모의 vision-language model을 로봇 action 예측에 연결해 VLA의 대표적인 구성을 제시했다.
바로 앞 편에서 다룬 ACT는 성격이 다른 접근이다. ACT는 대규모 vision-language 기반 일반화를 넓히기보다 정밀 조작에서 imitation learning이 쉽게 실패하는 문제를 다루며 action을 어떤 방식으로 예측할지에 집중했다. 반면 OpenVLA는 RT-1과 RT-2의 흐름으로 되돌아와, 이미지와 언어를 함께 이해하는 foundation model을 실제 로봇 action 예측에 연결할 수 있는지를 이어서 검토한다.
이 흐름에는 성능과 별개의 문제가 남아 있었다. 좋은 성능을 낸 VLA 모델은 대부분 비공개였고, 모델 구조와 학습 절차와 fine-tuning 방식이 충분히 공개되지 않아 다른 연구자가 재현하거나 새 로봇에 맞게 수정하기 어려웠다.
논문은 VLA의 확산을 막는 요인을 두 가지로 지목한다.
- 모델과 학습 절차의 비공개성
- 새 환경에 적응시킬 때 참고할 효율적인 fine-tuning 기준의 부재
따라서 OpenVLA의 목표는 새 모델을 하나 더 제안하는 데 있지 않다. RT-2가 보여준 방향을 오픈소스로 다시 구현하고, 다른 연구자가 실제로 가져다 fine-tuning할 수 있는 형태까지 갖추는 것이 목표다.
핵심 개념
policy와 generalist policy
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. OpenVLA에서 observation은 카메라가 찍은 현재 장면 이미지이고, 여기에 사람이 준 자연어 지시문(instruction)이 함께 조건으로 들어간다.
generalist policy는 과제별로 따로 학습하지 않고 하나의 모델로 여러 로봇과 여러 과제를 처리하는 policy다. OpenVLA는 특정 로봇 하나에 맞춘 policy가 아니라, 대규모 로봇 조작 데이터로 학습해 여러 embodiment에 쓸 수 있는 generalist policy를 지향한다.
Open X-Embodiment와 데이터 선별
Open X-Embodiment는 여러 연구기관과 여러 로봇 시스템에서 수집한 로봇 조작 데이터를 한데 모은 대규모 데이터 모음이다. 여러 종류의 로봇이 여러 환경에서 여러 과제를 수행한 기록이 함께 들어 있다.
OpenVLA는 이 데이터를 그대로 쓰지 않는다. 데이터셋마다 카메라 구성과 로봇 종류와 action 기록 방식이 달라서, 그대로 섞으면 입력과 출력 형식이 지나치게 흩어지기 때문이다.
그래서 세 가지 조건으로 걸러 입력과 출력 공간을 맞춘다.
- manipulation 데이터일 것. 즉 물체를 집고 옮기고 넣고 정리하는 것처럼 손이나 그리퍼로 물체와 상호작용하는 기록이어야 한다.
- 3인칭 시점 카메라가 최소 한 대 있을 것. 손목에 달린 카메라가 아니라 작업 공간을 밖에서 바라보는 카메라를 뜻하며, 이 시점이 있어야 물체 위치와 로봇 손 위치와 장면 전체를 함께 보고 action을 예측할 수 있다.
- 단일 팔 end-effector 제어를 쓸 것. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분을 가리킨다.
이렇게 추린 결과가 약 97만 개의 trajectory다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다.
입력과 출력
OpenVLA의 입출력 틀은 RT-1이나 RT-2와 같다. 현재 장면 이미지와 자연어 지시문을 함께 받아 로봇이 수행할 action을 낸다.
| 구분 | 내용 |
|---|---|
| 입력 | 현재 시점의 이미지 한 장 + 자연어 지시문 |
| 출력 | end-effector 기준 7차원 action (Δx, Δθ, ΔGrip) |
| 학습 데이터 | Open X-Embodiment에서 선별한 약 97만 개 trajectory |
| 기반 모델 | Prismatic-7B (SigLIP + DINOv2, 2-layer MLP projector, Llama 2 7B) |
| 목표 | 여러 로봇과 여러 과제에 적용 가능한 오픈소스 generalist policy |
단일 이미지 입력
OpenVLA는 현재 시점의 이미지 한 장만 본다. 긴 영상이나 여러 시점의 observation 기록을 쌓아 쓰지 않고, 지금 보이는 장면 하나와 지시문만으로 다음 action을 정한다.
예를 들어 논문 그림의 지시문은 "Put eggplant in bowl"이다. 모델은 이미지에서 가지와 그릇의 위치를 파악하고, 지시문에서 가지를 그릇 안에 넣어야 한다는 목표를 읽어내야 한다.
앞 편의 ACT와 비교하면 이 선택이 분명해진다.
| 모델 | 입력 구성 | 설계 의도 |
|---|---|---|
| ACT | 카메라 여러 대의 이미지 + 현재 관절 상태 | 정밀 조작에 필요한 상태 정보를 최대한 확보 |
| OpenVLA | 이미지 한 장 + 자연어 지시문 | 여러 로봇에 공통으로 적용 가능한 단순한 입력 |
단순한 입력은 범용으로 쓰기 좋지만 대가가 있다. 이미지 한 장에 보이지 않는 정보, 과거의 움직임, 로봇 내부 상태를 반영할 통로가 없기 때문이다. 따라서 OpenVLA는 강한 vision-language model을 로봇 action 예측에 연결한 모델인 동시에, 현재 버전은 단일 이미지 기반 policy라는 제약을 함께 갖는다.
7차원 action 출력
OpenVLA의 최종 출력은 자연어 문장이 아니라 로봇을 실제로 움직이는 7차원 숫자 명령이다. end-effector의 위치 변화 Δx, 자세 변화 Δθ, 그리퍼 개폐 ΔGrip으로 구성된다.
이 출력 형식을 고정한 이유는 여러 로봇의 데이터를 함께 학습하기 위해서다. 단일 팔 end-effector 제어 데이터만 골라 쓰면 서로 다른 로봇에서 모은 기록도 "이미지와 지시문을 보고 팔 끝의 다음 움직임을 예측한다"는 하나의 형식으로 정리된다.
action tokenization 방식
action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다. 언어 모델은 다음 토큰을 예측하도록 만들어진 모델이라 연속적인 action 값을 그대로 출력하기 어렵기 때문에, OpenVLA도 RT-2와 마찬가지로 action을 토큰으로 바꿔 예측한다.
큰 틀은 RT-2와 같고 구간을 나누는 기준만 다르다. RT-2는 action 값의 최소값에서 최대값까지를 256개 구간으로 나눈 반면, OpenVLA는 학습 데이터에서 각 action 차원의 1%에서 99%까지 범위를 256개 구간으로 나눈다.
기준을 바꾼 이유는 드물게 튀는 값 때문이다. 로봇 데이터에는 아주 가끔 큰 움직임이나 비정상적으로 튀는 action 값이 섞이는데, 이런 값까지 포함해 최소값과 최대값을 잡으면 전체 구간이 불필요하게 넓어지고 자주 등장하는 작은 움직임이 거칠게 나뉜다. 1%에서 99% 범위를 쓰면 극단값의 영향이 줄어 자주 나오는 action 범위를 더 세밀하게 표현할 수 있다.
토큰 자리는 새로 만들지 않는다. Llama 토크나이저는 fine-tuning 시점에 추가할 수 있는 특수 토큰 수가 많지 않아서, OpenVLA는 기존 어휘에서 가장 적게 쓰이는 마지막 256개 토큰을 action 전용으로 덮어쓴다. 즉 별도의 출력 공간을 만드는 대신 action을 기존 언어 모델의 토큰 공간 안으로 끌어들인 셈이다.
모델 구조
OpenVLA의 구조는 vision encoder, projector, LLM backbone 세 부분으로 나뉜다. 이미지를 이해하고, 그 표현을 언어 모델이 읽을 수 있는 형식으로 바꾸고, 언어 모델이 action token을 생성한 뒤 최종 로봇 action으로 되돌리는 흐름이다.
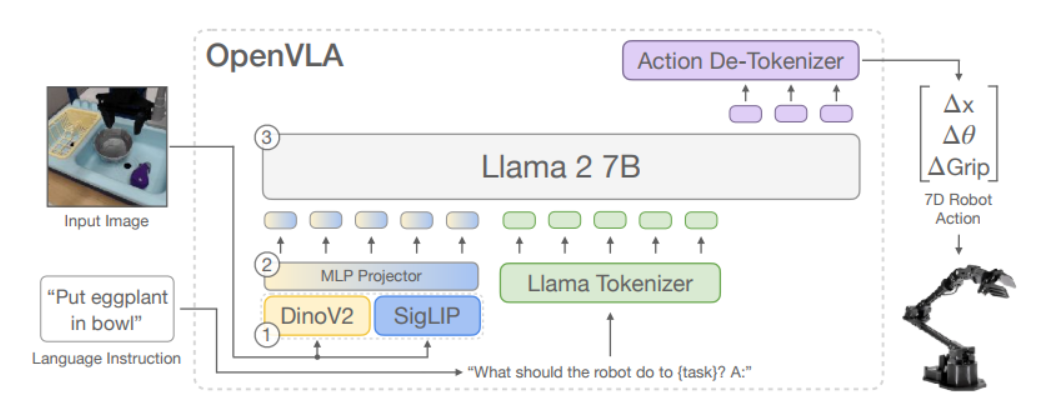
이 구조는 로봇 전용 backbone을 처음부터 설계한 결과가 아니다. Prismatic-7B라는 기존 open VLM을 가져와 로봇 action 예측에 맞게 fine-tuning한 형태에 가깝다.
fused vision encoder 구성
OpenVLA는 vision encoder를 하나만 쓰지 않고 SigLIP와 DINOv2를 함께 쓴다. 입력 이미지가 두 인코더를 각각 통과한 뒤, 두 feature를 채널 방향으로 이어 붙여 하나의 시각 표현을 만든다. feature는 모델이 입력에서 뽑아낸 중간 표현 벡터를 가리킨다.
두 인코더를 함께 쓰는 이유는 보는 정보의 성격이 다르기 때문이다. SigLIP는 의미 정보에 강해 무엇이 있는지를 잘 잡고, DINOv2는 저수준의 공간 정보를 보완해 그것이 어디에 어떤 자세로 놓였는지를 채운다.
이 차이는 manipulation에서 특히 중요하다. 컵이나 그릇을 다룰 때는 물체가 있다는 사실만으로 부족하고, 어디에 놓였고 어느 방향으로 기울었고 손끝을 어느 각도로 접근시켜야 하는지가 결과를 좌우한다. 논문도 DINOv2를 추가한 근거를 spatial reasoning, 즉 장면의 공간 관계를 파악하는 능력의 향상으로 설명하며, Appendix에서 DINOv2를 제거한 SigLIP-only 구조가 평균 성능이 더 낮았다고 보고한다.
projector의 역할
vision encoder가 만든 feature는 곧바로 언어 모델로 들어가지 않고 2-layer MLP projector를 거쳐 언어 모델의 임베딩 공간으로 옮겨진다. vision encoder는 이미지에서 feature를 뽑고 LLM backbone은 텍스트 토큰을 처리하도록 학습된 모델이라, 두 표현 공간을 맞춰 주는 단계가 필요하다.
projector의 역할은 복잡한 추론이 아니라 연결이다. 즉 시각 정보를 언어 모델이 읽을 수 있는 형식으로 바꿔 주는 연결부다.
LLM backbone과 action token 생성
backbone은 Llama 2 7B다. OpenVLA는 로봇용 네트워크를 새로 설계하지 않고, 이미 성능이 검증된 언어 모델 위에 시각 feature와 action 예측을 결합했다.
여기서 Llama 2는 자연어 문장 대신 action token 시퀀스를 생성한다. 즉 OpenVLA는 이미지와 지시문을 받아 로봇 action을 직접 회귀하는 것이 아니라, action token을 순차적으로 예측한 뒤 그 토큰을 다시 최종 로봇 action으로 되돌린다. 이 구조의 핵심은 LLM을 문장 생성기가 아니라 action token을 만드는 policy backbone으로 쓴다는 점이다.
backbone 선택 근거
기반 VLM으로 Prismatic-7B를 고른 데는 두 가지 이유가 있다. 첫째는 성능이다. 저자들은 IDEFICS-1, LLaVA, Prismatic을 비교했고, 단일 물체 장면에서는 차이가 작았지만 여러 물체가 동시에 놓이고 지시문에 따라 올바른 대상을 골라야 하는 과제에서 LLaVA가 IDEFICS-1보다 강했으며 Prismatic 기반 policy가 다시 그보다 높았다. 논문은 그 이유의 하나로 SigLIP와 DINOv2를 결합한 vision backbone이 주는 spatial reasoning 이점을 든다.
둘째는 확장성이다. Prismatic은 codebase가 더 모듈화되어 있고 다루기 쉬워 로봇 action 예측으로 확장하기 좋은 기반이었다. 즉 Prismatic 선택은 성능만이 아니라 오픈소스로 고쳐 쓰기 좋다는 점까지 함께 고려한 결과다.
학습 데이터와 학습 설정
OpenVLA의 학습은 pre-training된 Prismatic-7B를 로봇 action 예측에 맞게 fine-tuning하는 과정이다. 새 policy를 처음부터 학습하는 대신 이미 이미지와 언어를 함께 다룰 수 있는 모델 위에 action 예측 능력을 결합한다.
데이터는 앞서 정리한 세 조건으로 걸러낸 약 97만 개의 trajectory다. 여기에 더해 혼합 비율도 조정한다. Octo가 쓴 혼합 비율을 참고해 다양성이 낮은 데이터셋의 비중을 낮추고 장면과 과제 다양성이 큰 데이터셋의 비중을 높였다.
DROID는 처음에 포함했다가 제외했다. 이 데이터에서는 action token 정확도가 계속 낮게 유지돼, 최종 학습의 마지막 3분의 1 구간에서 혼합에서 뺐다. 따라서 OpenVLA의 성능은 데이터 양만이 아니라 어떤 데이터를 어떤 비율로 섞었는지와도 이어져 있다.
손실은 예측된 action token에만 계산된다. 새로운 손실 함수를 설계한 것이 아니라, 기존 vision-language model을 일관된 데이터 형식 위에서 action 예측 과제로 fine-tuning하는 구성이다.
설계 선택
논문은 최종 모델을 바로 만들지 않고 주요 설계 항목을 하나씩 비교했다. 이 비교가 OpenVLA가 지금 형태가 된 이유를 설명한다.
| 항목 | 비교 대상 | 최종 선택과 근거 |
|---|---|---|
| VLM backbone | IDEFICS-1, LLaVA, Prismatic | Prismatic. 여러 물체 중 지시 대상을 골라야 하는 과제에서 가장 강했고 codebase 확장성도 좋았다 |
| 입력 해상도 | 224×224, 384×384 | 224×224. 성능 차이가 거의 없는데 384×384는 학습 시간이 약 3배 들었다 |
| vision encoder 고정 여부 | frozen, fine-tuned | fine-tuned. 인터넷 이미지로 배운 일반 visual feature만으로는 제어에 필요한 공간 정보가 모자랐다 |
| 학습 epoch | 일반적인 1~2 epoch, 27 epoch | 27 epoch. action token 정확도가 95%를 넘을 때까지 실제 로봇 성능이 계속 올랐다 |
| learning rate | 여러 값 비교, warmup 유무 | 고정 2e-5. warmup은 별다른 이득이 없었다 |
해상도와 epoch 항목의 결론은 VLM 일반 벤치마크의 경험과 어긋난다. 해상도를 키우면 대체로 성능이 오르는 일반 VLM과 달리 이 VLA 설정에서는 이득이 없었고, 1~2 epoch면 충분한 일반 VLM 학습과 달리 27 epoch가 필요했다. 즉 VLA 학습은 foundation model 위에 약간만 결합하는 수준이 아니라 action 예측에 충분히 적응할 때까지 반복이 필요한 과정이다.
결과
평가는 두 가지 질문으로 나뉜다. 추가 학습 없이 바로 쓸 수 있는 generalist policy인지, 그리고 새 로봇과 새 과제에 잘 적응하는지다.
추가 학습 없는 성능
첫 번째 평가는 BridgeData V2의 WidowX와 RT-1 및 RT-2 평가에 쓰인 Google robot에서 진행했다. 평가 항목은 visual generalization, motion generalization, physical generalization, semantic generalization, language grounding 다섯 가지다.
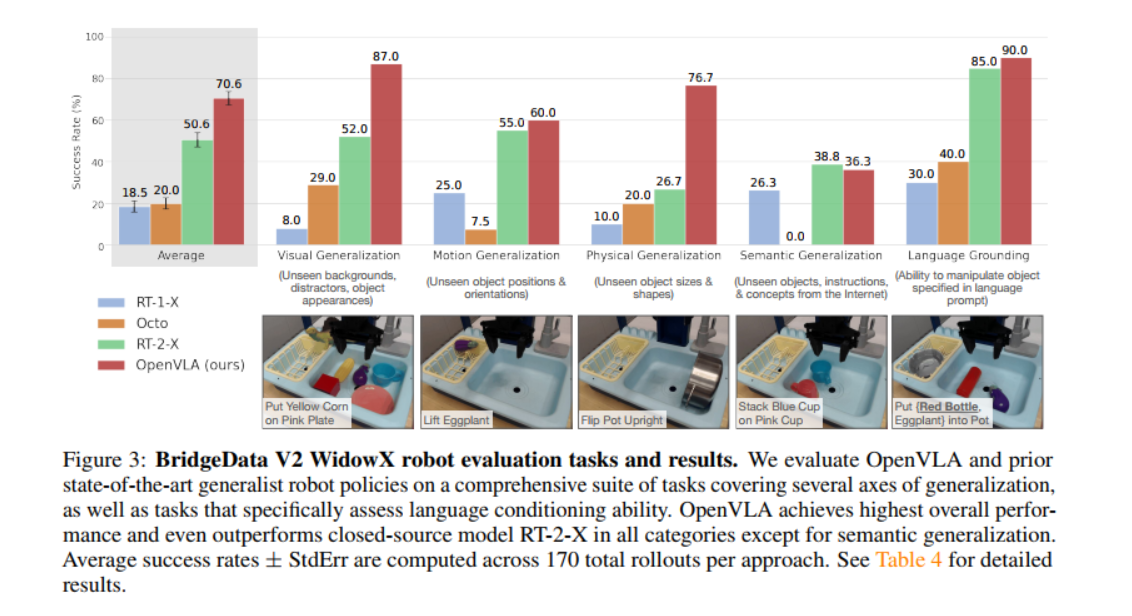
| 평가 환경과 항목 | OpenVLA | 비교 모델 |
|---|---|---|
| BridgeData V2 WidowX 평균 | 70.6% | RT-2-X 50.6%, Octo 20.0%, RT-1-X 18.5% |
| BridgeData V2 semantic generalization | 36.3% | RT-2-X 38.8% |
| Google robot 평균 | 85.0% | RT-2-X 78.3% |
| Google robot OOD generalization | 82.9% | RT-2-X 82.9% |
WidowX에서 OpenVLA는 평균 70.6%로 RT-1-X와 Octo를 크게 앞서고 RT-2-X보다도 20.0%p 높다. 다섯 항목 중 뒤진 것은 semantic generalization 하나뿐이며 그 차이도 36.3%와 38.8%로 크지 않다. Google robot에서는 평균 85.0%로 RT-2-X 78.3%와 비슷한 수준이고, 학습 분포 밖 상황을 다루는 OOD generalization은 82.9%로 동률이다.
7B 모델이 55B 규모의 RT-2-X와 대등하거나 앞섰다는 점이 이 결과의 핵심이다. 논문은 그 원인을 모델 크기가 아니라 네 요소의 조합에서 찾는다.
- 더 큰 규모의 로봇 학습 데이터
- 더 정교한 데이터 정제 과정
- SigLIP와 DINOv2를 결합한 fused vision encoder
- open backbone 위에서 일관되게 구성한 VLA 학습 파이프라인
새 로봇과 새 과제 적응
두 번째 평가는 fine-tuning이다. Franka-Tabletop과 Franka-DROID 환경에서 과제마다 10개에서 150개의 시연 데이터(demonstration)만 주고 OpenVLA를 적응시킨다. 비교 대상은 Diffusion Policy, 입출력 조건을 맞춘 Diffusion Policy(matched), Octo, 그리고 Open X-Embodiment pre-training 없이 바로 목표 과제에 맞춘 OpenVLA(scratch)다.
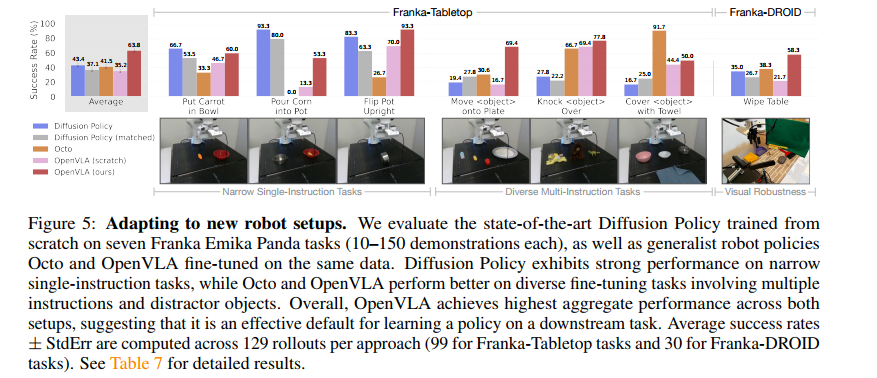
결과는 과제 성격에 따라 달라진다. "Put Carrot in Bowl"처럼 지시문이 하나로 좁게 고정된 과제에서는 처음부터 학습한 Diffusion Policy가 강했다. 반면 장면에 물체가 여럿이고 지시문에 따라 대상을 골라야 하는 과제에서는 pre-training된 OpenVLA와 Octo 같은 generalist policy가 더 잘 적응했다.
전체 평균은 OpenVLA가 63.8%로 가장 높았고, 7개 과제 전부에서 성공률 50% 이상을 유지한 유일한 접근이었다. 즉 OpenVLA는 좁은 과제 하나에 최적화된 모델이라기보다 새로운 downstream imitation learning 과제를 시작할 때의 기본값으로 쓰기 좋은 모델이다.
논문은 Diffusion Policy의 장점도 인정한다. 아주 정교한 과제에서는 Diffusion Policy가 더 부드럽고 정밀한 trajectory를 낸다고 보고하며, OpenVLA에 action chunking이나 temporal smoothing을 결합하면 이 약점을 줄일 수 있다고 본다. action chunking은 미래 여러 스텝의 action을 한 묶음으로 예측하는 방식으로, 앞 편 ACT가 다룬 기법과 그대로 이어지는 대목이다.
배포 비용
이 논문의 실용적 기여는 성능 좋은 VLA를 제안한 데서 끝나지 않고 현실적인 비용으로 fine-tuning하고 배포할 수 있는지까지 실험한 데 있다.
LoRA fine-tuning 비교
논문은 full fine-tuning, last layer only, frozen vision, sandwich fine-tuning, LoRA rank 32와 64를 비교한다. LoRA는 저랭크 행렬만 학습해 fine-tuning 비용을 줄이는 기법이다.
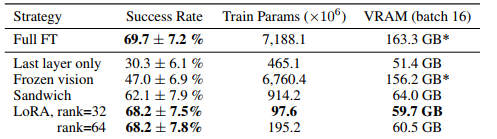
| 전략 | 성공률 | 학습 파라미터 | VRAM |
|---|---|---|---|
| full fine-tuning | 69.7±7.2% | 7,188.1M | 163.3GB |
| LoRA rank 32 | 68.2±7.5% | 97.6M | 59.7GB |
두 전략의 성공률 차이는 1.5%p인 반면 학습 파라미터는 약 74분의 1로 줄고 VRAM은 163.3GB에서 59.7GB로 내려간다. rank 32와 64 사이에 뚜렷한 차이가 없어 논문은 기본값으로 rank 32를 권한다. LoRA를 쓰면 A100 한 장에서 10시간에서 15시간이면 새 과제에 OpenVLA를 적응시킬 수 있다.
양자화
추론 단계에서는 bfloat16, int8, int4를 비교한다. 양자화는 가중치를 낮은 비트 수로 줄여 모델을 압축하는 기법이다.
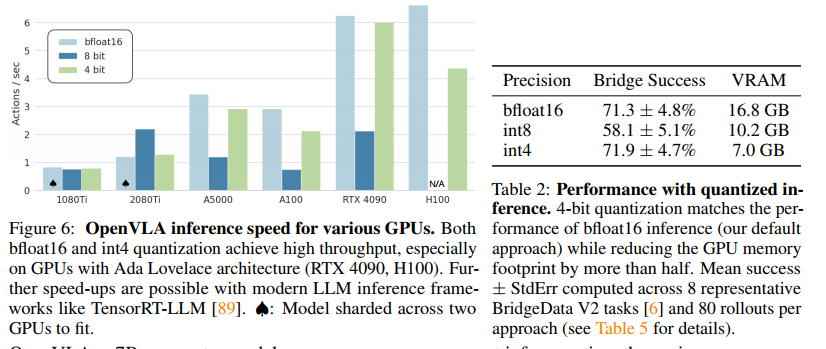
| 정밀도 | 성공률 | VRAM |
|---|---|---|
| bfloat16 | 71.3±4.8% | 16.8GB |
| int8 | 58.1±5.1% | 10.2GB |
| int4 | 71.9±4.7% | 7.0GB |
int4는 메모리를 절반 이하로 줄이면서 bfloat16과 대등한 성능을 유지한다. 반면 중간 정밀도인 int8만 13.2%p 낮게 나온다.
원인은 정밀도가 아니라 추론 속도다. A5000에서 int8은 약 1.2Hz로 동작해, 학습 때 쓴 5Hz non-blocking control과 시스템 동역학이 크게 달라졌다. non-blocking control은 이전 action의 완료를 기다리지 않고 다음 action을 내보내는 제어 방식이라, 추론이 느려지면 학습 때와 다른 조건이 된다.
int4는 약 3Hz로 학습 조건에 더 가까운 동역학을 유지했고, blocking control 조건으로 다시 실험한 Appendix에서는 int8도 나머지와 비슷한 성능을 냈다. 즉 int8의 하락은 8-bit라서 값이 틀어졌기 때문이 아니라 느린 추론 속도가 실제 제어 동역학을 바꿨기 때문이다.
한계
single-image observation만 지원한다는 것이 첫 번째 한계다. 멀티뷰 카메라, proprioception, observation history를 활용하지 못한다. proprioception은 관절 각도처럼 로봇 자신의 상태를 아는 감각 입력을 말하는데, 실제 로봇 시스템이 훨씬 다양한 감각 입력을 쓴다는 점에서 확장이 필요한 부분이다.
추론 속도도 제약이다. OpenVLA는 4090에서 약 6Hz로 동작하는 반면 ALOHA 같은 시스템은 50Hz 수준의 control frequency를 요구한다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하며, 논문은 이 격차의 해법으로 추론 최적화, action chunking, speculative decoding을 든다.
신뢰도도 아직 충분하지 않다. 이전 generalist policy보다 강하다고 해도 대부분 과제에서 성공률이 90% 미만이라, OpenVLA는 강한 출발점이지 곧바로 쓸 수 있는 완성된 산업용 policy는 아니다.
이런 한계에도 OpenVLA가 남긴 기여는 네 가지다.
- pre-training된 vision-language model을 policy로 확장했다.
- 연속 action을 토큰 예측 문제로 다시 정의했다.
- 대규모 로봇 데이터 혼합 위에서 generalist policy를 학습했다.
- LoRA와 양자화로 다른 연구자가 실제로 가져다 쓸 수 있는 비용까지 맞췄다.
로봇 제어를 별도의 문제로 떼어내지 않고 foundation model의 연장선 위에서 다시 정의한 것이 이 논문의 관점이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| OpenVLA | Prismatic-7B를 로봇 action 예측으로 fine-tuning한 7B 규모의 오픈소스 vision-language-action model |
| Prismatic-7B | SigLIP와 DINOv2로 구성한 vision encoder, 2-layer MLP projector, Llama 2 7B backbone을 묶은 open VLM. OpenVLA의 출발점 |
| fused vision encoder | 성격이 다른 두 vision encoder의 feature를 채널 방향으로 이어 붙여 쓰는 구성. OpenVLA는 의미 정보의 SigLIP와 공간 정보의 DINOv2를 결합한다 |
| projector | vision encoder의 feature를 언어 모델의 임베딩 공간으로 옮기는 2-layer MLP 연결부 |
| action tokenization | 연속적인 로봇 action을 구간으로 나눠 토큰으로 표현하는 기법. OpenVLA는 1%에서 99% 범위를 256개 구간으로 나눈다 |
| non-blocking control | 이전 action의 완료를 기다리지 않고 다음 action을 내보내는 제어 방식. 추론 속도가 느려지면 학습 때와 동역학이 달라진다 |
관련 페이지
- OpenVLA: An Open-Source Vision-Language-Action Model: 이 페이지가 해설하는 원 논문. 실험 조건과 ablation은 원 논문 페이지가 더 자세하므로 입문으로 감을 잡은 뒤 넘어가는 순서를 권한다.
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: 같은 시리즈 바로 앞 편(03-05). 정밀 조작과 action chunking을 다루며, OpenVLA가 약점 보완책으로 언급하는 기법이 여기서 나온다.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-04편. OpenVLA가 이어받은 action tokenization의 원형을 다룬다.
- 03-03. RT-1 - 모두의 로보틱스 - VLA 입문: 같은 시리즈 03-03편. 입출력 구조와 generalist policy 개념의 출발점이다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: OpenVLA 학습 데이터의 출처. 약 97만 개 trajectory가 어떤 데이터에서 선별됐는지 확인할 수 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.