Physical AI · ARTICLE · 2026
03-09. Pi-0.6 - 모두의 로보틱스 - VLA 입문
요약
π0.6 논문을 처음 읽는 사람을 위한 한국어 입문 해설이다. "모두의 로보틱스 - VLA 입문" 시리즈의 03-09편으로, 강화학습의 기본 개념에서 출발해 RECAP의 수식 유도, π0.6과 π0.6의 아키텍처, 3단계 학습 루프, 실험 결과까지 원문의 전개 순서를 그대로 따라간다.
π*0.6은 π 계열 논문 중 강화학습을 VLA 학습에 사용한 첫 연구다. 앞선 편들이 VLA 아키텍처가 어떻게 바뀌어 왔는지를 따라갔다면, 이 편은 같은 아키텍처를 무엇으로 학습시킬지로 초점을 옮긴다. 원 논문은 π*0.6: a VLA That Learns From Experience에 정리되어 있으므로, 이 입문 페이지로 강화학습 배경을 잡은 뒤 원 논문 페이지로 넘어가는 순서를 권한다.
배경
π 계열은 π0과 π0.5까지 무엇을 학습 데이터로 넣을지를 다뤄 왔고, π0.6에서 처음으로 강화학습을 학습 방법의 중심에 놓는다. 해설은 이 위치 선정을 첫 문장에서 밝히며 시작한다. 즉 π0.6을 새 아키텍처가 아니라 새 학습 레시피로 소개한다.
적용된 방법은 RECAP이라는 advantage conditioning 기반 강화학습이다. advantage conditioning은 어떤 action이 평균보다 나은지를 텍스트 지표로 적어 모델 입력에 붙이는 방식을 말한다. 해설은 이 방식이 π 모델의 강점인 이질적 데이터 활용과 2단계 학습 과정에 특히 잘 맞았다고 정리한다.
원문이 밝히는 성과는 두 가지다. 어려운 과제의 성공 확률이 2배로 올랐고, 실패 확률은 2배 이상 낮아졌다.
구성상 특징은 예비 지식의 비중이다. 강화학습 설명만 전체 분량의 3분의 1을 차지한다. 원 논문이 Section III에 압축해 둔 정의를 풀어 쓴 것으로, 강화학습 배경이 없는 독자가 RECAP 수식에서 막히지 않도록 미리 길을 내는 구성이다.
핵심 개념
강화학습의 기본 구성
강화학습은 agent가 환경과 주고받는 하나의 순환 구조로 요약된다. agent가 action을 내보내면 environment가 새로운 observation과 reward를 돌려주고, agent는 그것을 보고 다음 action을 정한다.
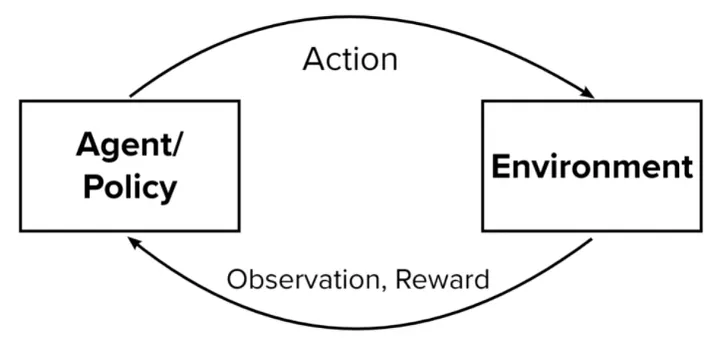
해설은 이 도식의 기호마다 로봇 맥락의 예시를 붙인다. 추상적인 기호를 로봇의 실제 상황으로 옮겨 두면 뒤의 수식이 읽히기 때문이다.
| 요소 | 뜻 | 로봇에서의 예 |
|---|---|---|
| agent | 학습하는 AI나 로봇 자신 | 과제를 수행하는 로봇 |
| observation | 현재 agent가 보는 상황이자 agent의 상태 | 로봇 카메라에 찍힌 탁자 위 컵 |
| action | agent가 취하는 동작 | 팔을 3cm 앞으로 뻗는다 |
| policy | agent의 전략이자 규칙. 주어진 observation에서 어떤 action을 할 확률인지를 준다 | 컵을 보고 팔을 뻗을 확률 분포 |
| reward | 특정 상황에서 특정 action을 했을 때 받는 즉각적인 점수 | 컵을 성공적으로 집었을 때의 점수 |
| return | 종료까지 받은 reward를 모두 합친 총점 | 한 번의 시도가 끝났을 때의 누적 점수 |
| objective | 그 policy를 따랐을 때 기대되는 총점의 평균 | 학습이 최대화하려는 목표값 |
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 수식으로는 observation이 주어졌을 때 특정 action을 고를 확률로 적으며, 좋은 agent일수록 좋은 action에 높은 확률을 준다. return은 R(τ) = Σ r_t로 정의되고, objective J(π)는 그 return의 기대값이다.
따라서 강화학습의 목표는 매 순간 action을 고르는 policy를 최적화해 장기 누적 return을 최대화하는 것으로 정리된다. 학습은 새로운 시도를 해 보는 탐험과 이미 잘 아는 action을 쓰는 활용을 반복하면서 진행된다.
value function과 advantage
value function과 advantage는 agent가 자신이 잘하고 있는지를 재는 두 지표다. RECAP은 두 지표를 모두 쓰기 때문에 해설은 이 절을 따로 둔다.
value function은 현재 상황의 가치, 즉 지금 policy대로 계속 행동했을 때 앞으로 받을 총점의 기대값이다. 수식으로는 현재 timestep t부터 종료 시점 T까지 예측된 reward를 더한 값이다.
advantage는 특정 action의 비교 우위를 가리킨다. 행동하기 전에 기대되던 가치보다 지금 이 action을 골랐을 때 점수를 얼마나 더 받는지를 뜻한다. 값이 0보다 크면 평균보다 좋은 action이고, 0보다 작으면 평균보다 나쁜 action이다.
regularized RL
regularized RL은 objective에 제약 항을 더해 policy가 검증된 행동에서 크게 벗어나지 않게 막는 방식이다. 해설은 이 절을 π*0.6 논문에서 중요하게 다루는 대목으로 지목한다.
제약이 필요한 이유는 점수만 노리는 학습의 위험 때문이다. 점수를 높이는 데만 집중하면 모델이 꼼수를 부리거나 엉뚱하고 위험한 동작을 낼 수 있다. 반면 로봇 학습에는 사람이 직접 조종해 모아 둔 안전하고 검증된 데이터가 이미 있고, 이 데이터가 정의하는 policy를 reference policy라고 부른다.
그래서 objective를 J(π, π_ref) = E[Σ γ^t r_t] − β E[D(π ‖ π_ref)] 형태로 고친다. 앞항은 그대로 점수를 최대화하고, 뒷항은 두 policy가 얼마나 다른지를 재는 KL divergence로 페널티를 준다. 즉 점수는 최대한 높이되 검증된 행동 방식에서 너무 멀어지지 말라는 제약이다. 두 policy의 거리가 멀어질수록 β만큼의 페널티가 커진다.
방법
RECAP의 세 단계
RECAP은 데이터 수집, value function 학습, advantage conditioned training의 세 단계를 반복하는 학습 전략이다. PPO나 Q-Learning 같은 일반적인 강화학습 알고리즘은 VLA처럼 큰 모델에 적용하면 학습이 매우 불안정하고 계산 비용도 크다. 따라서 저자들은 복잡한 policy gradient 계산 대신 advantage를 조건으로 주는 방식을 택했다.
| 단계 | 하는 일 | 산출물 |
|---|---|---|
| data collection | 로봇이 과제를 수행하며 성공과 실패 라벨을 모은다. 로봇이 실수하면 사람이 개입해 교정한 데이터도 함께 모은다 | 성공과 실패가 섞인 로봇 데이터, 사람의 개입 데이터 |
| value function training | 수집한 전체 데이터로 현재 상황에서 실패를 감지하거나 작업 완료까지 걸릴 기대 시간을 예측하는 다목적 value function을 학습한다 | 여러 과제를 함께 평가하는 value function |
| advantage conditioned training | 학습된 value function으로 각 action의 advantage를 계산해 우위 여부 꼬리표를 만들고, 이 지표를 VLA 프롬프트에 조건으로 붙여 학습한다 | advantage를 조건으로 받는 VLA policy |
세 단계를 처음부터 다 하는 것은 아니다. 사람이 직접 조작한 데이터에서는 두 번째와 세 번째 단계만 수행하고, 그 뒤에 로봇이 스스로 수행하며 모은 자율 수집 데이터를 더해 첫 단계부터 다시 반복한다. 이 방식은 기존의 복잡한 최적화 기법보다 단순하면서도 성공과 실패가 섞인 데이터에서 좋은 policy를 뽑아내는 데 효과적이었다.
distributional value function 학습
value function은 가치를 하나의 숫자로 회귀하지 않고 201개 구간의 확률 분포로 예측한다. observation과 지시문(instruction)을 함께 받아 여러 과제를 평가할 수 있어야 하기 때문에, 현재 상황이 어느 구간에 속할지를 확률로 내놓는 형태를 택했다.
학습과 추론은 다음 순서로 이어진다.
- 현재 상태에서 앞으로 달성할 return이 속할 것으로 예상되는 구간과 실제 결과를 비교해 cross entropy를 최소화하는 방향으로 학습한다.
- 추론 시에는 각 구간이 나타내는 값과 그 구간에 속할 예측 확률을 곱해 가중합을 구한다. 실제 가치는 연속값이어야 하므로 이 가중합으로 되살린다.
- 학습 데이터는 pre-training 단계에서 100% 사람이 조종한 시연 데이터(demonstration)를 쓰고, 이후 post-training 단계에서는 사람의 데이터와 로봇 자신의 데이터를 가중 결합해 쓴다.
value function 모델은 VLA policy와 동일한 구조를 갖되 연산 효율을 위해 더 작은 VLM backbone을 쓴다.
해설은 이 설계에 대한 논문의 자평도 그대로 옮긴다. episode를 끝까지 보고 정답을 매기는 on-policy Monte Carlo 방식은 강화학습에서 널리 쓰이는 off-policy Q-function보다 수학적으로 덜 최적화된 방식이다. 그럼에도 구조가 훨씬 단순하고 신뢰성이 높으며 기존 imitation learning을 크게 앞서는 성능을 보여 최종 채택했다.
policy extraction의 필요 조건
policy extraction은 학습된 value function을 이용해 action을 내는 policy를 개선하는 절차를 가리킨다. 해설은 좋은 policy extraction이 갖춰야 할 조건을 먼저 세 가지로 세운 다음, 기존 방법이 왜 그 조건을 못 채우는지를 짚는다.
- 다양한 데이터셋에서 작동할 것
- 큰 VLA 모델에도 쉽게 적용될 만큼 확장 가능할 것
- 데이터에 좋지 않은 표본이 섞여 있어도 효과적으로 학습할 것
AWR 같은 가중치 기반 방법이 이 조건에 걸린다. π 모델의 핵심인 flow matching에 적용하기에는 수학적으로 너무 복잡하거나, 나쁜 데이터를 버리는 필터링 방식이라 세 번째 조건을 채우지 못한다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다.
최적 policy 유도
해설은 논문의 유도를 한 단계씩 모두 보여 준다. 수식 자체보다 각 단계에서 무엇이 사라지고 무엇이 남는지를 따라가는 것이 이 절의 목적이다.
출발점은 이론적으로 최적인 policy를 π̂(a|o) ∝ π_ref(a|o) p(I|A(o,a))^β 로 정의하는 대목이다. 기존 policy에 그 action이 개선을 가져올 확률을 곱한 형태다. 지수함수 가중치로 확률을 무작정 올리는 대신 확실히 나아질 확률만큼만 부드럽게 개선하자는 뜻이고, 논문은 이 방식이 기존보다 성능이 좋아지는 것을 보장한다고 밝힌다.
여기에 베이즈 정리를 적용하면 개선 확률이 p(I|A) ∝ π_ref(a|I,o,ℓ) / π_ref(a|o,ℓ) 로 바뀐다. 이 결과를 원식에 대입하면 π̂(a|o,ℓ) ∝ π_ref(a|o,ℓ) (π_ref(a|I,o,ℓ) / π_ref(a|o,ℓ))^β 가 된다.
β를 1로 두면 π_ref(a|o,ℓ) 끼리 약분되어 식이 π̂(a|o,ℓ) = π_ref(a|I,o,ℓ) 로 줄어든다. 저자는 이 지점을 수학적 트릭이라고 부른다. 개선 확률을 따로 모델링할 필요 없이, 성공 지표 I를 조건으로 받는 policy 하나만 학습하면 된다는 결론이 나오기 때문이다.
이상적인 policy는 수학적 개념이라 모델에 그대로 넣을 수 없다. 따라서 실제 학습하는 신경망이 이 이상적인 policy를 최대한 똑같이 따라 하도록 min_θ E[KL(π̂ ‖ π_θ)] 를 최소화하는 것으로 마무리된다.
이진 지표 설계
성공 지표 I는 advantage를 임계값으로 잘라 만든 이진 값이다. 특정 action의 advantage 점수가 과제별 임계값 ε_ℓ를 넘으면 I=1, 넘지 못하면 I=0을 붙인다.
해설은 이렇게 둘로 가르는 것을 로봇의 과격한 움직임을 막는 장치로 읽는다. 기준을 엄격하게 세워야 실제 배치에서 극단적으로 거친 동작이 나오는 현상을 방지할 수 있기 때문이다.
policy 모델은 여기에 Classifier-Free Guidance 기법을 차용한다. 지표가 주어졌을 때와 주어지지 않았을 때 모두 데이터의 action을 잘 흉내 내도록 negative log-likelihood를 최소화하는 방향으로 학습한다.
데이터에 지표를 붙이는 규칙은 단순하다. 사람의 조종 데이터와 개입 데이터에는 무조건 I=1을 주고 집중적으로 학습시킨다. 반면 로봇이 실수한 데이터도 버리지 않고 I=0 꼬리표와 함께 학습시킨다. 해설은 실패 데이터를 이렇게 쓰는 방식을 오답 노트에 비유한다.
모델 구조
π0.6의 아키텍처
π0.6은 π0.5의 구조를 대부분 유지하되 성능을 위해 일부를 수정한 모델이다. 해설이 꼽는 변경점은 세 가지다.
| 구성 요소 | 내용 | 효과 |
|---|---|---|
| backbone VLM | Gemma 3 4B로 교체 | 시각적 상황 판단과 언어 이해 능력 향상 |
| action expert | 860M 파라미터로 확대 | 50Hz 고속 제어 |
| knowledge insulation | action expert 쪽에 stop-gradient 적용 | 연속 동작 학습이 언어와 시각 지식을 훼손하지 않음 |
action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음이다. 50Hz는 로봇이 1초에 50번 새로운 action을 갱신한다는 뜻으로, 섬세한 조작에 필요한 제어 속도다.
knowledge insulation은 정교한 연속 동작을 학습할 때 생기는 연산이 모델이 원래 가진 언어와 시각 지식을 훼손하지 않도록 gradient의 전파를 끊는 기법이다. 따라서 로봇은 언어와 시각 능력을 유지하면서 동시에 섬세한 손기술을 갖출 수 있다.
π*0.6의 advantage conditioning
π0.6을 π*0.6으로 만드는 변경은 advantage conditioning 하나뿐이다. 모델은 입력값에 Advantage: positive 또는 Advantage: negative 라는 텍스트 지표를 추가로 받는다. 지금 하려는 action이 성공으로 가는 길인지를 알려주는 피드백에 해당한다.
학습과 실행에서의 쓰임이 다르다. 학습 과정에서는 성공적인 action 데이터에 positive 라벨을, 실패하거나 비효율적인 action에 negative 라벨을 붙여 함께 학습한다. 반면 실제 로봇을 구동할 때는 positive 조건을 강제로 주어 모델이 항상 성공 확률이 가장 높은 동작만 고르게 유도한다.
이 계층 구조 덕분에 로봇은 미션을 인식하고, subtask를 계획하고, advantage를 확인한 뒤 최종 action을 생성하는 흐름을 갖는다. subtask는 상위 추론이 텍스트로 내놓는 중간 단계 명령이다.
3단계 학습 루프
RECAP의 학습은 pre-training, SFT, post-training과 RL의 세 단계를 반복하는 루프다.
| 단계 | 데이터 | 하는 일 |
|---|---|---|
| pre-training | 대량의 로봇 데이터와 웹의 시각 언어 데이터 | 사물의 이름과 위치, 로봇의 기본 움직임을 익혀 범용 VLA가 될 능력을 기른다 |
| SFT | 에스프레소 머신 조작처럼 특정 과제를 전문가가 수행한 데이터 | 해당 과제를 잘 수행하도록 fine-tuning한다 |
| post-training과 RL | 로봇이 스스로 모은 자율 수집 데이터와 사람의 교정 데이터 | value function을 갱신하고 advantage 라벨을 다시 계산해 policy를 정교화한다 |
SFT 단계에서는 지표를 항상 positive로 고정한다. 해설은 그 이유를 이것이 정답이라는 가이드로 삼기 위해서라고 풀이한다.
마지막 단계에서 사람의 교정 데이터가 특히 중요하다. 로봇이 잘못된 동작을 할 때 사람이 개입해 바로잡아 준 기록은 강한 학습 신호가 되기 때문이다. 이 과정을 반복할수록 로봇의 성능이 계속 개선된다.
value function 라벨링
value function의 라벨은 성공까지 몇 단계가 남았는지를 예측하는 값으로 정의된다. 복잡한 수식 대신 남은 단계 수를 세는 단순한 규칙을 택한 것이 특징이다.
- 성공하면 0점
- 앞으로 남은 단계마다 −1점
- 실패하면 큰 감점
이런 sparse reward 설계는 로봇이 최대한 빠르고 효율적으로 임무를 완수하도록 유도한다. 남은 단계가 많을수록 점수가 낮아지므로 짧은 경로를 고르는 편이 유리하기 때문이다.
value function 자체는 Gemma 3 기반 670M 모델을 쓴다. 현재 장면을 보고 성공 가능성을 예측하며, 이 예측치가 좋아지는 방향의 action이 positive advantage로 반영된다.
결과
해설은 논문의 Figure 7부터 Figure 10까지를 캡처해 실은 뒤 방향성만 서술한다. 개별 수치를 하나씩 옮기지는 않는다.
π0.5와 비교했을 때 π0.6이 크게 앞서고, 여기에 RECAP까지 적용하면 가장 좋은 성적이 나온다. 향상 폭은 시간당 성공 횟수에서 특히 크며, 정확도도 모든 과제에서 우수했다.
반복 학습의 효과도 함께 짚는다. iteration을 0회에서 점차 늘려 갈수록 시간당 성공 횟수와 성공률이 나란히 오르는 그래프를 두고, 해설은 이것을 강화학습의 실질적인 효과로 본다.
policy extraction 방식을 비교한 그림도 같은 방향을 가리킨다. 다른 강화학습 방법과 나란히 두었을 때 advantage conditioning을 쓴 경우의 성공률과 시간당 성공 횟수가 가장 높았다.
원문의 결론
원문은 π0.6의 위치를 두 문장으로 정리한다. 기존 π 모델이 VLM의 변형이었던 것과 달리 π0.6은 강화학습을 활용한 첫 π 모델이라는 점이 하나이고, VLA에 value function을 더해 advantage 지표를 주어 성공 확률이 높은 쪽으로 action을 고르게 한 것이 핵심 아이디어라는 점이 다른 하나다.
원문이 함께 강조하는 것은 데이터 수집 쪽의 의미다. 강화학습을 단순히 학습 방법으로만 쓴 것이 아니라 데이터 수집 과정을 자동화해 로봇의 행동과 상황을 더 다양하게 모을 수 있게 되었다는 점을 유의미한 연구 결과로 꼽는다.
한계
이 해설이 다루는 범위는 방법론과 결과까지다. 원 논문의 한계 절은 옮기지 않는다. 사람 손이 드는 라벨링과 개입 및 리셋 비용, 단순한 탐색 전략, on-policy value 추정의 한계가 원 논문에 들어 있으므로 그 내용은 π*0.6: a VLA That Learns From Experience에서 확인해야 한다.
방법 자체의 한계 중 하나는 본문 안에서 언급된다. episode를 끝까지 보고 정답을 매기는 on-policy Monte Carlo 방식이 off-policy Q-function보다 수학적으로 덜 최적화되어 있다는 자평이다. 단순함과 신뢰성을 얻는 대신 이론적 최적성을 일부 내준 선택이다.
수치를 옮기지 않은 점도 이 해설을 읽을 때 감안해야 한다. 결과 절은 그래프 캡처와 방향성 서술로 대신하므로, 구체적인 성공률과 ablation 수치가 필요하면 원 논문 페이지를 참고한다.
표기도 흔들린다. 원문은 모델 이름을 Pi-0.6과 Pi-0.6*로 적는데, 별표 위치가 논문 표기인 π*0.6과 달라 뒤에 붙는 경우가 섞여 있다. 이 wiki 페이지는 논문 표기를 따랐다.
옮겨 온 도식 중 저자 자작은 강화학습 루프 하나뿐이다. 나머지는 논문 figure를 영문 캡션째로 캡처한 것이라 원본 크롭이 더 깨끗하며, 그 크롭은 원 논문 페이지에 이미 정리되어 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| RECAP | 데이터 수집, value function 학습, advantage conditioned training의 세 단계를 반복하는 강화학습 전략. π*0.6의 학습 방법 |
| advantage | 특정 action의 비교 우위. 기대되던 가치보다 그 action이 점수를 얼마나 더 받는지를 뜻하며, 0보다 크면 평균보다 좋은 action이다 |
| advantage conditioning | advantage의 이진 지표를 텍스트로 모델 입력에 붙여 학습하고, 실행 시에는 positive를 강제하는 방식 |
| regularized RL | objective에 KL divergence 페널티를 더해 policy가 reference policy에서 크게 벗어나지 않게 막는 방식 |
| knowledge insulation | 연속 동작 학습이 모델의 언어와 시각 지식을 훼손하지 않도록 gradient 전파를 끊는 기법. π0.6이 그대로 쓴다 |
| sparse reward | 성공에 0점, 남은 단계마다 −1점, 실패에 큰 감점을 주는 value function 라벨링 방식 |
관련 페이지
- π*0.6: a VLA That Learns From Experience: 이 페이지가 해설하는 원 논문. 수치와 ablation과 한계 절은 원 논문 페이지에 정리되어 있다.
- π*0.6: a VLA that Learns from Experience: 같은 모델의 공식 블로그 글. 배치 규모와 영상 자료가 들어 있다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: π0.6이 구조를 이어받은 직전 모델 π0.5.
- 03-06. OpenVLA - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 03-06편. 아키텍처를 다루는 앞 흐름의 마지막 편에 해당한다.
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 03-05편.
- 03-04. RT-2 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 03-04편.
- 03-03. RT-1 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 03-03편.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.