Physical AI · ARTICLE · 2026
03-04. RT-2 - 모두의 로보틱스 - VLA 입문
요약
RT-2(Brohan 2023) 논문을 처음 읽는 사람을 위한 한국어 입문 해설이다. "모두의 로보틱스 - VLA 입문" 시리즈의 03-04편으로, 앞 편인 03-03. RT-1 - 모두의 로보틱스 - VLA 입문가 다룬 RT-1의 후속 모델을 등장 배경, 모델 구조, 실험 결과, 의의와 한계 순서로 따라간다.
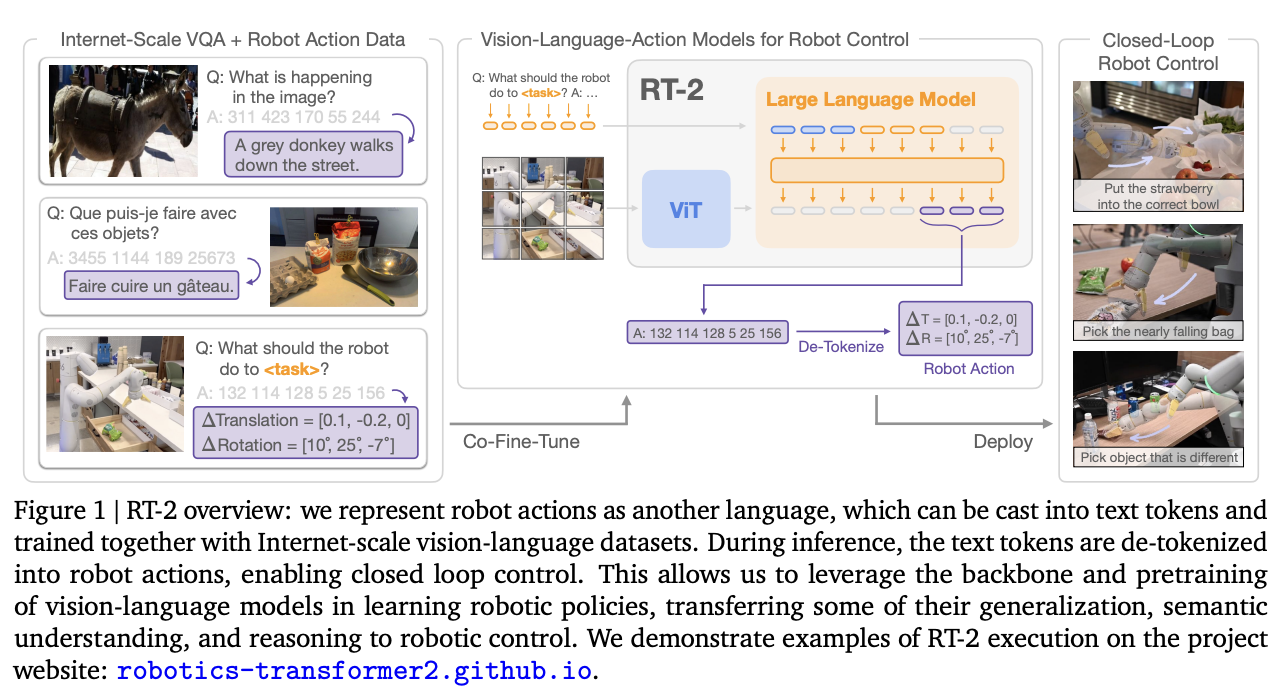
RT-2의 발상은 로봇 action을 언어처럼 다루는 데 있다. action을 텍스트 토큰으로 적으면 기존 vision-language model의 토큰 예측 구조를 그대로 둔 채 출력 표현만 바꿔 로봇 policy로 확장할 수 있다. 여기서 policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 원 논문은 RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control에 정리되어 있으므로, 이 입문 페이지로 감을 잡은 뒤 원 논문 페이지로 넘어가는 순서를 권한다.
배경
RT-2는 RT-1 계열이 보여준 end-to-end 로봇 policy의 흐름을 이어받으면서 그 학습 범위를 로봇 데이터 바깥으로 넓힌 모델이다. RT-1이 로봇 데이터 안에서 시각 입력과 지시문(instruction)을 action으로 연결하는 데 집중했다면, RT-2는 여기에 웹 규모 vision-language pre-training이 가진 시맨틱 이해와 추론 능력을 직접 연결한다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계다.
이 접근의 특징은 로봇 전용 모듈을 여러 개 추가하지 않는다는 점이다. 모델이 원래 잘하던 일인 토큰 예측이라는 구조를 유지한 채 출력에 action 표현만 추가한다. 따라서 논문은 이 방식을 단순하고 일반적인 하나의 레시피로 제시한다.
다만 웹에서 배운 지식이 그대로 로봇 skill로 바뀌는 것은 아니다. 집기, 놓기, 이동 같은 물리적 동작 자체는 여전히 로봇 데이터에서 배운다. 반면 웹 데이터에서 얻는 것은 그 동작을 언제, 어디에, 어떤 대상에 써야 하는지를 더 넓게 판단하는 능력에 가깝다.
그래서 RT-2의 강점은 완전히 새로운 motion을 만들어내는 데 있지 않고 이미 배운 동작을 더 다양한 상황에 맞게 꺼내 쓰는 데 있다. 이 성격이 뒤의 실험에서 novel object, symbol understanding, reasoning 같은 평가 항목으로 이어진다.
핵심 개념
본론에 들어가기 전에 네 개념을 먼저 잡아두면 모델 구조와 실험 결과가 자연스럽게 읽힌다.
action token
action은 policy가 출력하는 제어 명령이다. RT-2는 RT-1이 쓰던 방식을 그대로 물려받아 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸고, 각 차원을 256개 bin으로 표현한다. 이렇게 만든 값을 텍스트 토큰과 같은 자리에 적기 때문에 vision-language model이 문장을 이어 쓰듯 action을 생성할 수 있다.
co-fine-tuning
co-fine-tuning은 로봇 데이터와 웹 vision-language 데이터를 한 배치에 섞어 함께 fine-tuning하는 레시피를 말한다. fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계다. RT-2의 성능은 구조 자체보다 pre-training과 co-fine-tuning의 조합에 크게 의존한다.
emergent capability
emergent capability는 웹에서 학습한 개념과 관계를 바탕으로 이미 학습된 action을 새로운 기준으로 선택하는 능력을 가리킨다. 새로운 물리적 동작을 만들어내는 능력이 아니라는 점이 중요하다. 즉 로봇의 skill 자체는 그대로지만 그 skill을 언제 쓸지가 더 이상 고정되어 있지 않다.
control frequency
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. RT-2는 모델 크기에 따라 약 13Hz에서 5Hz 사이로 동작한다. 55B 모델이 13Hz라는 것은 1초에 한 번에서 세 번만 새 action을 낸다는 뜻이고, 이 값이 뒤에서 실시간성 한계의 근거가 된다.
모델 구조
RT-2는 PaLI-X와 PaLM-E를 backbone으로 사용하며, 이미지와 텍스트를 처리하던 모델의 출력 공간에 로봇 action을 포함시키는 방식으로 확장한다. 여기서 backbone은 RT-2가 재사용하는 기반 vision-language model을 가리킨다. 따라서 RT-2-PaLI-X와 RT-2-PaLM-E는 각각의 vision-language model 위에 로봇 제어용 출력 표현을 추가한 형태로 볼 수 있다.
backbone별 구현 차이
같은 개념이라도 각 모델의 토크나이저 설계에 맞춰 구현이 조정된다.
| 구분 | RT-2-PaLI-X | RT-2-PaLM-E |
|---|---|---|
| 실험 규모 | 5B와 55B | 12B |
| action token 연결 방식 | 토크나이저가 이미 1000 이하 정수 토큰을 갖고 있어 action bin 값(128, 91 등)을 바로 대응시킨다 | 정수를 바로 대응시킬 체계가 없어 거의 쓰이지 않던 토큰 256개를 골라 action 전용으로 역할을 다시 부여한다 |
| 배치 내 로봇 데이터 비중 | 약 50% | 약 66% |
PaLI-X 쪽은 번호가 이미 적힌 서랍에 값을 바로 넣는 것에 가깝고, PaLM-E 쪽은 남는 서랍에 새 라벨을 붙여 action 전용으로 바꿔 쓰는 것에 가깝다. 이 차이는 개념의 차이가 아니라 토크나이저 사정에 맞춘 구현의 차이다.
co-fine-tuning의 역할
RT-2는 학습 과정에서 웹 규모 vision-language 데이터와 로봇 데이터를 함께 사용한다. pre-training된 vision-language model을 로봇 데이터만으로 fine-tuning하면 기존에 학습한 시각적, 시맨틱 표현이 약해질 수 있기 때문이다.
논문은 웹 vision-language 데이터와 로봇 trajectory 데이터를 함께 학습하는 이 방식을 co-fine-tuning이라 부른다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 실제로 로봇 데이터만 쓰는 fine-tuning보다 co-fine-tuning이 더 나은 일반화 성능을 보였는데, 원래의 학습 데이터를 함께 유지하면 기존 개념을 덜 잊기 때문이다.
배치에서는 로봇 데이터의 sampling weight를 높여 두 데이터의 비율을 조정했다. 그 결과 RT-2-PaLI-X는 로봇 데이터를 약 50%, RT-2-PaLM-E는 약 66% 비중으로 포함한다.
출력 제한과 추론 인프라
추론 시에는 과제에 따라 생성할 수 있는 토큰을 제한해 실행 불가능한 출력을 방지한다.
- 로봇 제어 과제에서는 action token만 생성한다.
- 일반 vision-language 과제에서는 자연어 전체를 생성할 수 있다.
또한 대형 모델을 실제 제어에 연결하기 위해 RT-2는 클라우드 기반 추론 구조를 쓴다. 로봇은 네트워크를 통해 action을 받아 제어에 사용하며, control frequency는 55B 모델이 약 1~3Hz, 5B 모델이 약 5Hz다.
RT-2의 구현은 다음 네 요소로 요약된다.
- 기존 vision-language model을 확장한 구조
- 연속 action의 이산화 표현
- 웹 데이터와 로봇 데이터를 함께 쓰는 co-fine-tuning
- 출력 제한과 클라우드 추론 구조
실험과 결과
논문은 실험을 다음 네 가지 질문으로 구성한다.
- 학습에 쓴 과제뿐 아니라 새로운 물체, 배경, 환경에서도 잘 동작하는지
- 웹에서 학습한 지식이 실제 로봇 action으로 이어지면서 새로운 능력이 나타나는지
- 이런 일반화가 모델 크기와 학습 방식에 따라 어떻게 달라지는지
- vision-language model에서 자주 언급되는 chain-of-thought가 로봇 action에도 도움이 되는지
실험 설정
약 6,000개의 평가 trajectory를 7DoF 모바일 매니퓰레이터 환경에서 수집해 비교한다. 학습에는 로봇의 시연 데이터(demonstration)와 웹 규모 vision-language 데이터를 함께 쓴다.
| 모델 | 성격 |
|---|---|
| RT-1 | 순수 로봇 policy baseline |
| VC-1, R3M | pre-training된 representation learning을 결합한 baseline |
| MOO | 관심 객체만 추출하는 vision-language model을 보조 perception 모듈처럼 쓰는 baseline |
| RT-2 | vision-language model 자체가 직접 action token을 생성하는 방식 |
일반화 성능
성능은 네 가지 조건으로 나눠 평가한다. seen task, unseen object, unseen background, unseen environment다.
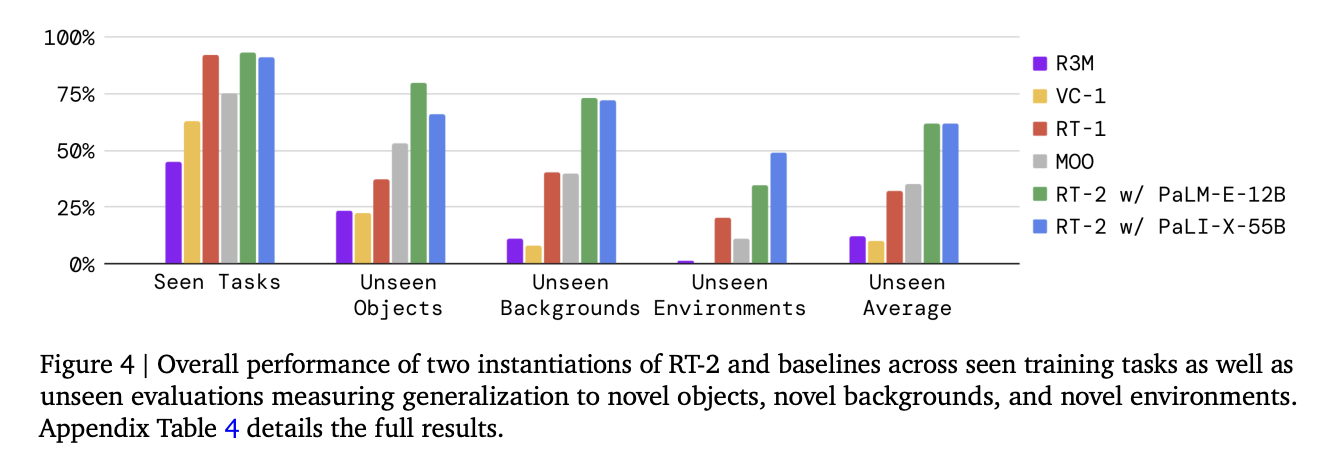
seen task에서는 RT-1과 큰 차이가 없지만 unseen 조건에서는 차이가 크게 벌어진다. RT-2는 novel object, background, environment에서 RT-1과 MOO 대비 약 2배, 다른 baseline 대비 최대 6배까지 성능이 오른다. 즉 RT-2의 차이는 학습 범위 안이 아니라 분포 밖에서 더 분명하게 드러난다.
다른 환경에서의 검증
Language-Table 환경에서도 같은 경향이 나타난다. 작은 RT-2-PaLI-3B가 가장 높은 성공률을 기록해, 웹 pre-training 기반 표현이 특정 환경에만 통하는 것이 아님을 보여준다.
| 모델 | Language-Table 성공률(%) |
|---|---|
| RT-2-PaLI-3B | 90±10 |
| LAVA | 77±4 |
| RT-1 | 74±13 |
emergent capability의 세 범주
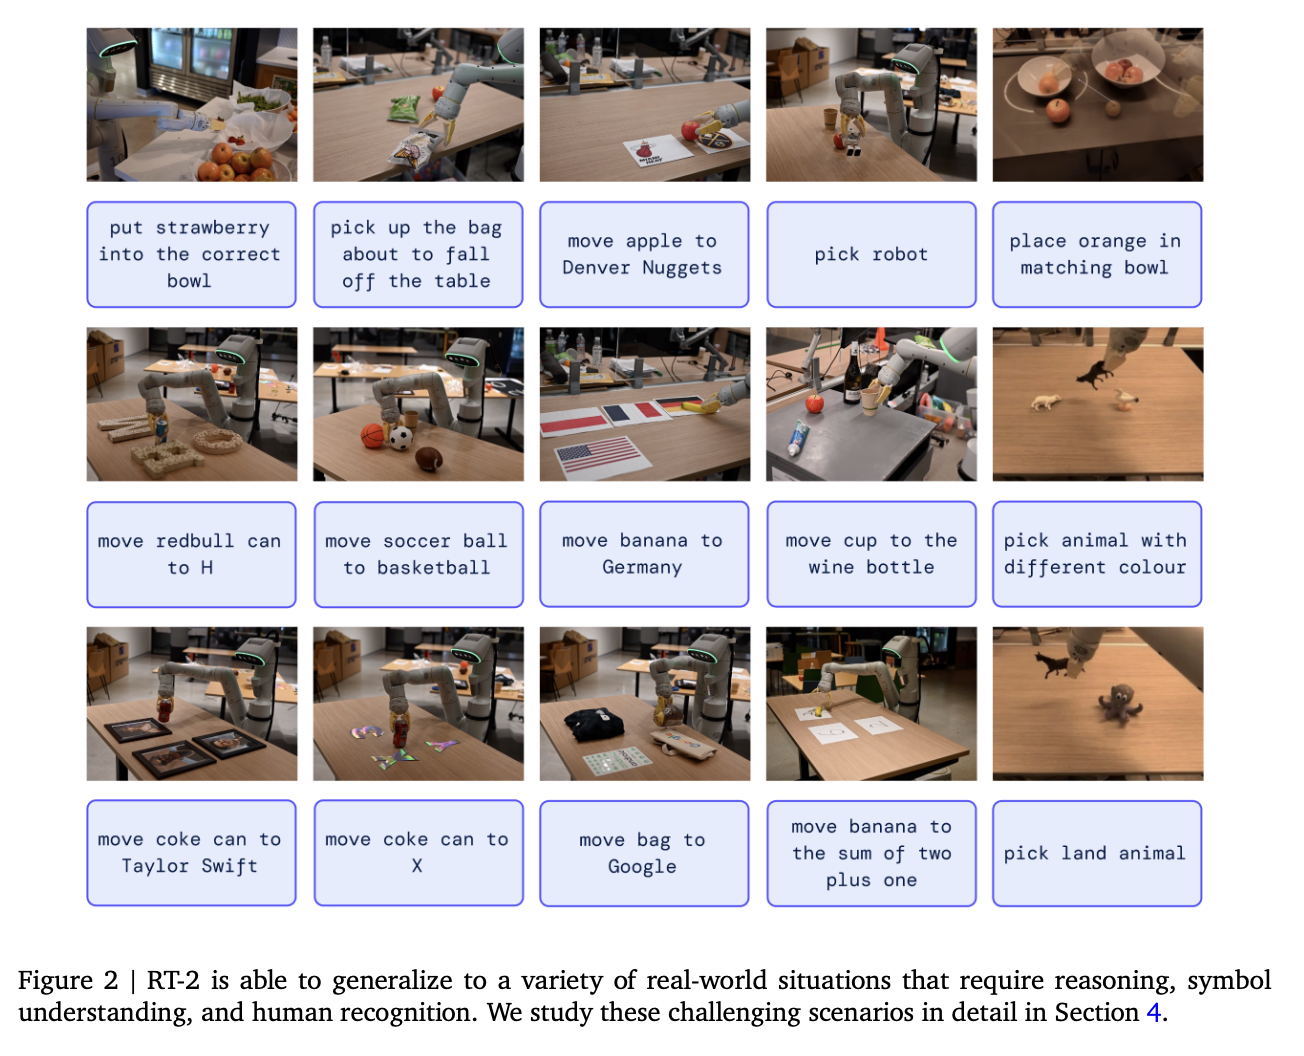
RT-2에서 가장 중요한 변화는 단순한 일반화 성능 향상이 아니라 시맨틱 이해가 실제 action 선택에 개입하기 시작했다는 점이다. 여기서 시맨틱은 눈에 보이는 것의 뜻과 관계를 이해하는 능력을 가리킨다. 논문은 이 변화를 symbol understanding, reasoning, human recognition 세 범주로 정리한다.
| 범주 | 요구되는 능력 | 지시문 예시 |
|---|---|---|
| symbol understanding | 숫자, 문자, 아이콘이 무엇을 뜻하는지 이해하고 그 위치를 장면 안에서 찾아 action으로 연결한다 | "move coke can to X", "move coke can near 3", "place above star" |
| reasoning | 수학적 관계, 의미 기반 판단, 색 같은 관계 이해, 다국어 표현을 해석한 뒤 대상을 고른다 | "move banana to the sum of two plus one", "smallest number", "pick a healthy drink", "move apple to cup with same color" |
| human recognition | 특정 인물의 특징이나 identity를 구분한 뒤 그 위치로 action을 잇는다 | "move coke can to Taylor Swift", "person with glasses", "man with white hair" |
symbol understanding은 단순한 물체 인식만으로는 수행할 수 없는 지시문을 다룬다. 예를 들어 "move coke can to X"에서는 장면 속 문자 X를 먼저 식별해야 하는데, 이런 문자는 로봇의 시연 데이터에 없더라도 웹에서 이미지와 텍스트를 함께 보며 배운 기호 이해로 찾을 수 있다. 위치를 찾은 다음에는 로봇 데이터에서 배운 pick-and-place 동작을 실행한다.
reasoning은 인식보다 한 단계 더 나아간다. "move banana to the sum of two plus one"은 2 더하기 1이 3이라는 계산과 그에 대응하는 위치 찾기를 함께 요구한다. 즉 모델은 웹에서 배운 언어와 수 개념을 써서 지시문의 뜻을 해석한 뒤 그 숫자 위치로 바나나를 옮긴다.
human recognition은 객체 검출이 아니라 사람의 identity 구분을 요구한다. "move coke can to Taylor Swift"에서 로봇이 사람을 다루는 법을 새로 배운 것은 아니고, 웹에서 학습한 인물과 얼굴과 이름의 연결 지식으로 목표 인물을 찾아 그 위치로 캔을 옮긴다.
세 범주는 공통으로 하나의 변화를 보여준다. 기존 policy가 위치 기반으로 대상을 골랐다면 RT-2는 개념 기반으로 고른다. 이 작업들은 로봇 데이터에 직접 포함되지 않았지만 RT-2는 기존 baseline보다 높은 성공률을 낸다.
모델 크기와 학습 방식
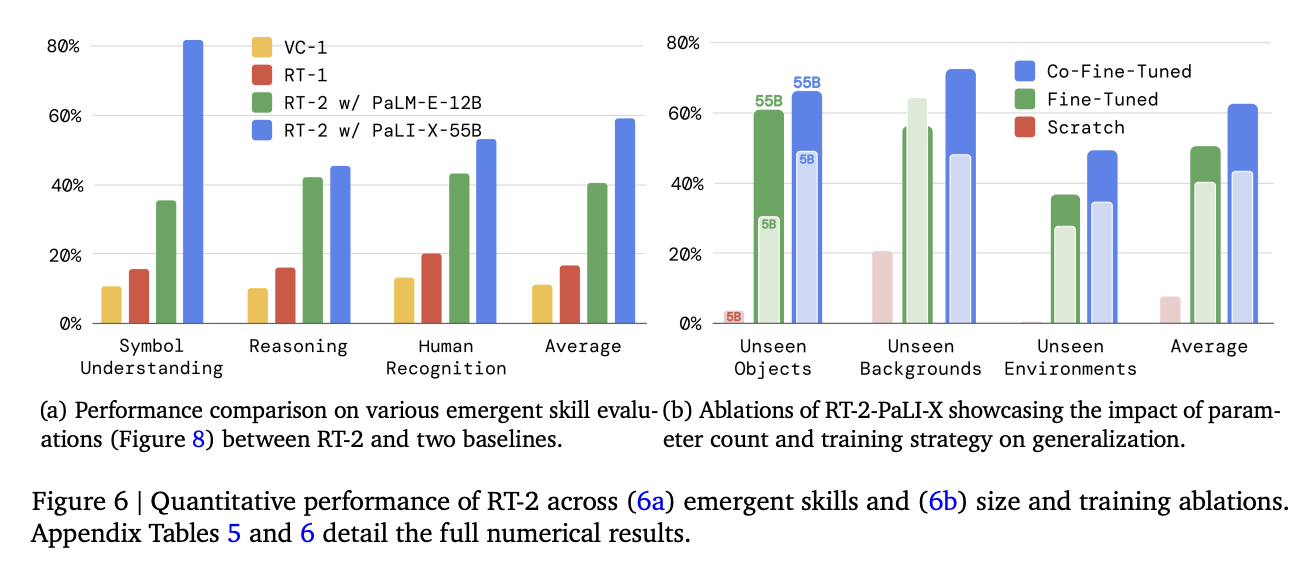
Figure 6(a)는 emergent skill 평가에서 RT-2와 baseline의 차이를 정량적으로 비교하고, Figure 6(b)는 모델 크기와 학습 방식이 일반화에 어떤 영향을 주는지 보여준다. 모델 크기와 학습 방식에 관한 결과는 다음 세 가지다.
- 큰 모델이라도 pre-training 없이 scratch로 학습하면 잘 되지 않았다.
- pre-training된 모델을 로봇 데이터만으로 fine-tuning하는 것보다 웹 데이터와 로봇 데이터를 함께 쓰는 co-fine-tuning이 더 잘 일반화했다.
- 모델 크기가 클수록 성능이 향상됐다.
논문은 co-fine-tuning의 이득을 기존 vision-language 학습에서 얻은 개념을 잊지 않게 해준다는 쪽으로 해석한다. 따라서 RT-2의 성능은 구조 자체보다 pre-training과 co-fine-tuning의 조합에 크게 의존한다.
chain-of-thought 가능성
논문은 action 앞에 자연어 계획을 먼저 생성하는 구조도 실험한다. PaLM-E 기반 RT-2 변형에 짧게 추가 학습을 해서 "Instruction, Plan, Action" 형식으로 출력하게 만드는 방식이다. 예를 들어 "Bring me a drink"라는 지시문에 대해 "Plan: pick 7up can"을 먼저 생성한 뒤 action을 낸다.
논문은 이 구조를 VQA 데이터의 자연어 추론과 manipulation 데이터의 action 생성을 이어주는 다리로 설명한다. 정량 비교보다는 정성 결과에 가깝지만, 저자들은 이런 형식이 더 복잡한 지시문을 다루는 데 도움이 될 수 있다고 본다.
의의
해설은 RT-2의 의의를 세 가지로 정리한다.
첫째, 로봇 policy의 학습 범위를 로봇 데이터 바깥으로 확장했다. 기존 로봇 policy가 시연 데이터 안에서 시각 입력과 지시문을 action으로 연결하는 구조였다면, RT-2는 웹 규모 vision-language pre-training에서 얻은 표현을 action 예측 과정 안으로 직접 가져온다. 따라서 로봇 policy는 로봇 데이터만으로 닫힌 체계가 아니게 된다.
둘째, 일반화의 원인을 데이터 양이 아니라 표현의 성격과 학습 방식에서 설명하게 만들었다. RT-2는 unseen object, unseen background, unseen environment 같은 분포 밖 조건에서 더 강했고, scratch 학습이나 로봇 데이터만의 fine-tuning보다 co-fine-tuning이 더 잘 작동했다. 즉 일반화가 모델 크기 증가보다 pre-training된 시맨틱 표현을 유지하는 방식과 더 깊게 연결된다는 뜻이다.
셋째, 복잡한 전용 구조 없이도 VLA를 구현할 수 있는 경로를 제시했다. RT-2는 기존 vision-language model의 토큰 예측 구조를 유지한 채 action을 토큰 형태로 연결하고, 출력 제한과 co-fine-tuning으로 실제 제어 문제까지 확장한다. 이 점에서 RT-2는 완성형 시스템이라기보다 이후 VLA 연구의 방법론적 출발점에 해당한다.
한계
skill 자체는 확장되지 않는다
RT-2의 가장 중요한 한계는 새로운 physical skill을 학습하지는 못한다는 점이다. 웹 규모 pre-training이 시맨틱과 시각 일반화를 높여주기는 하지만, 로봇이 실제로 수행할 수 있는 동작은 여전히 로봇 데이터에 포함된 skill distribution에 제한된다.
즉 RT-2는 action을 더 잘 선택하게 만들 뿐 action 자체를 새로 생성하지는 못한다. 저자들은 이것이 현재 데이터셋의 skill 다양성이 충분하지 않기 때문이라고 보고, 사람 비디오 같은 새로운 데이터 수집 방식을 제안한다.
계산 비용과 실시간성
RT-2는 최대 55B 규모의 모델을 실제 closed-loop control에 연결하고 이를 클라우드(multi-TPU)로 서빙한다. 이 접근은 원리적으로는 동작하지만 계산 비용이 높고 control frequency가 약 1~3Hz 수준에 머문다는 제약을 함께 가진다.
따라서 더 빠른 제어가 필요한 환경에서는 추론 속도와 비용이 병목이 된다. 논문은 해결 방향으로 양자화, distillation, 경량화, 더 저렴한 하드웨어에서의 실행 가능성을 제시한다.
모델 접근성과 생태계
RT-2 같은 접근은 fine-tuning이 가능한 대형 vision-language model을 전제한다. 그런데 당시에는 이런 모델이 제한된 환경에서만 접근 가능하거나 proprietary하게 운영되는 경우가 많았다.
이 때문에 발상이 흥미롭더라도 누구나 재현하거나 확장하기는 어려운 구조였다. 저자들은 더 많은 open-source 모델과 fine-tuning API 개방이 필요하다고 말한다.
이 세 한계를 합치면 RT-2의 위치가 분명해진다. 개념적 돌파구는 확실하지만 skill 다양성, 추론 비용, 모델 접근성 측면에서는 아직 초기 단계였다. RT-1이 generalist policy의 가능성을 열었다면 RT-2는 그다음 단계인 VLA 흐름의 출발점을 만든 연구이고, 이후 OpenVLA와 더 넓은 Physical AI 연구의 토대가 된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| action token | 로봇 action을 차원별 이산 bin으로 나눠 텍스트 토큰처럼 적은 표현. vision-language model의 출력 공간을 그대로 쓰기 위한 장치다 |
| co-fine-tuning | 로봇 데이터와 웹 vision-language 데이터를 한 배치에 섞어 함께 fine-tuning하는 레시피. pre-training에서 얻은 개념 유지가 목적이다 |
| emergent capability | 로봇의 시연 데이터에 없던 기호 이해, 추론, 인물 인식이 웹 pre-training에서 전이돼 action 선택에 반영되는 능력. 새 동작 생성이 아니라 기존 동작의 새로운 배치를 뜻한다 |
| backbone | RT-2가 재사용하는 기반 vision-language model. PaLI-X와 PaLM-E 두 종류를 쓴다 |
| control frequency | 초당 action 갱신 횟수. RT-2는 55B에서 약 1~3Hz, 5B에서 약 5Hz다 |
| skill distribution | 로봇 데이터가 담고 있는 물리적 동작의 분포. RT-2가 낼 수 있는 동작의 상한을 정한다 |
관련 페이지
- 03-03. RT-1 - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 바로 앞 편인 03-03편. RT-1의 기초 개념과 아키텍처를 먼저 익히고 이 페이지로 오는 순서를 권한다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 이 페이지가 해설하는 원 논문. 정보량과 정확도는 원 논문 페이지가 더 크므로 입문으로 감을 잡은 뒤 그 페이지로 넘어가는 편이 좋다.
- RT-1: Robotics Transformer for Real-World Control at Scale: RT-2가 로봇 데이터와 256 bin action 이산화를 그대로 물려받은 직접 전신 논문.
- 03-06. OpenVLA - 모두의 로보틱스 - VLA 입문: 같은 시리즈의 03-06편. RT-2가 보여준 방향을 오픈소스 모델로 옮긴 OpenVLA를 다룬다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.