Physical AI · ARTICLE · 2026
HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System (프로젝트 페이지)
요약
HiVLA 프로젝트 페이지는 논문의 핵심만 추린 한 화면짜리 소개 사이트다. 저자 정보와 링크, 티저 도식, 초록, 파이프라인 도식, RoboTwin 결과 표, BibTeX로 구성되며 시연 영상은 없다.
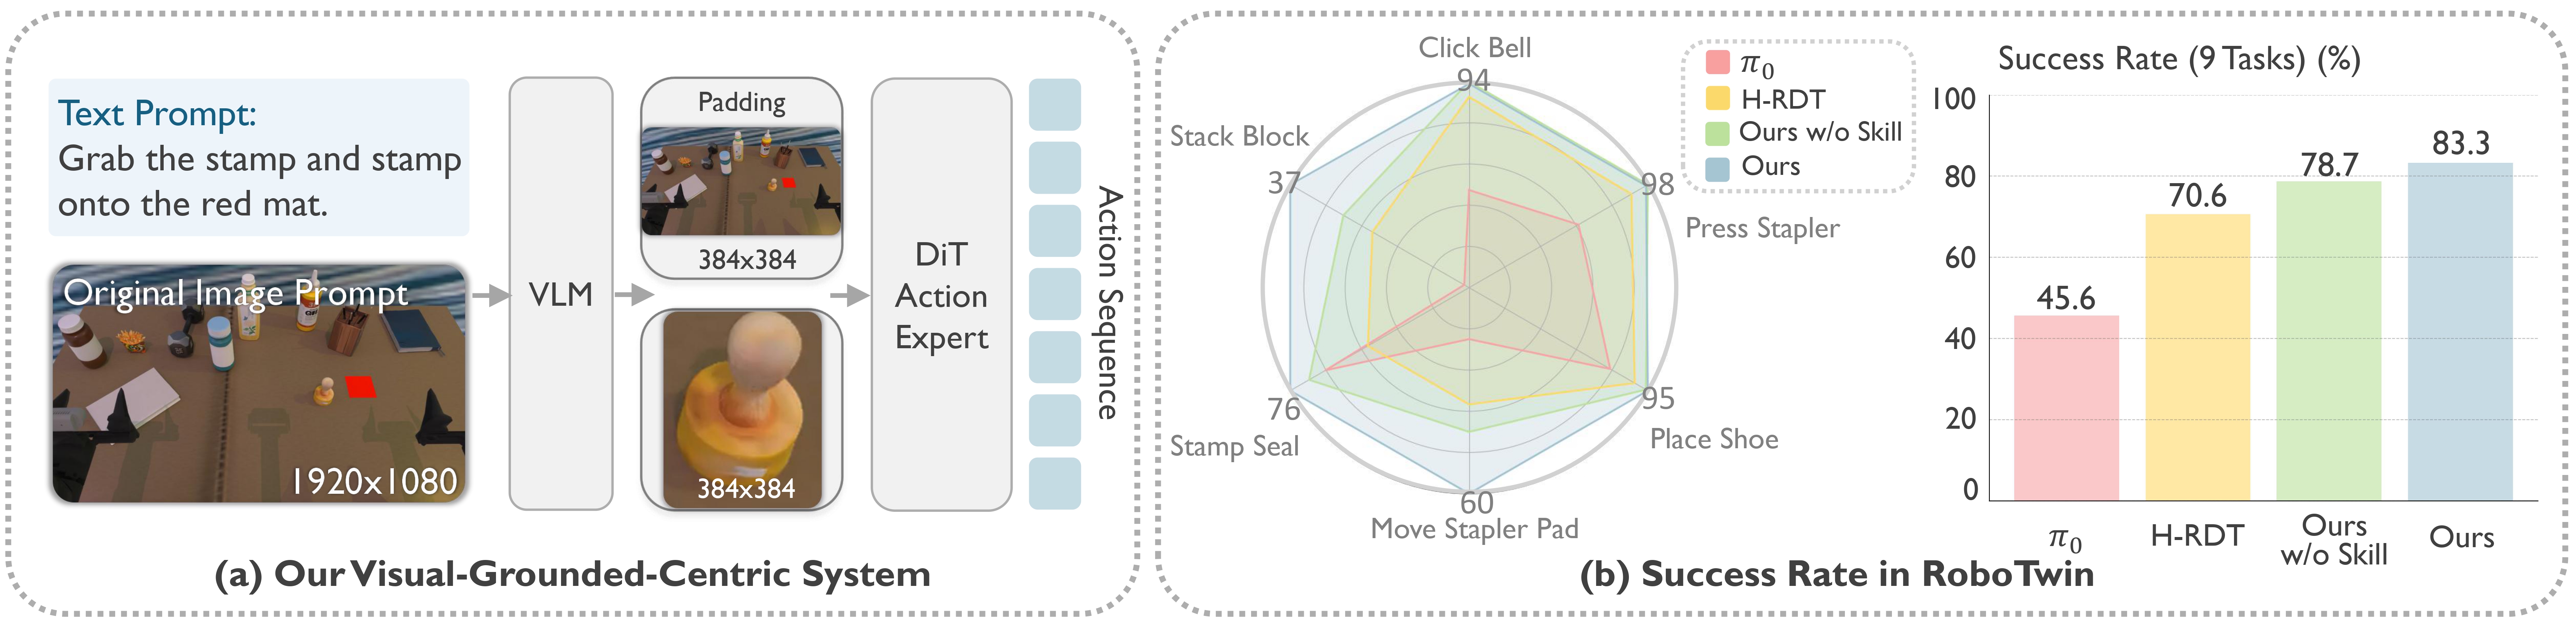
페이지가 제공하는 고유한 가치는 도식 두 장의 해상도다. 논문 PDF에서 잘라낸 크롭보다 웹용 원본이 크기 때문에 세부 라벨을 읽기 쉽다. 티저는 6846×1654이고 파이프라인은 2881×1051이다.
수치와 방법 설명은 논문과 동일하며 페이지에만 있는 새 정보는 없다. 실제 로봇 결과, robustness 실험, ablation, VLM planner 평가는 모두 빠져 있으므로 상세한 내용은 HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System를 참고한다.
배경
프로젝트 페이지는 논문 공개와 함께 만들어지는 관행적 형식을 따른다. 제목과 저자 소속을 먼저 보여주고, Paper와 arXiv 링크를 나란히 두며, 코드 링크 자리는 공개 예정 상태로 남겨 두었다.
소속은 네 기관이다. HKU, Shanghai AI Lab, SJTU, CUHK이며 Tianshuo Yang과 Guanyu Chen이 공동 1저자로 표시된다.
핵심 개념
페이지가 반복해서 쓰는 용어는 세 가지다.
visual-grounded-centric. VLM이 낸 bounding box와 그로부터 잘라낸 고해상도 크롭을 상위와 하위를 잇는 주 인터페이스로 삼는 설계 관점이다. 페이지 제목에 그대로 들어가 있다.
hierarchical. 상위 의미 계획과 하위 모터 제어를 명시적으로 분리한 구조를 가리킨다. 초록은 이 분리가 end-to-end VLA의 절충을 푸는 열쇠라고 적는다.
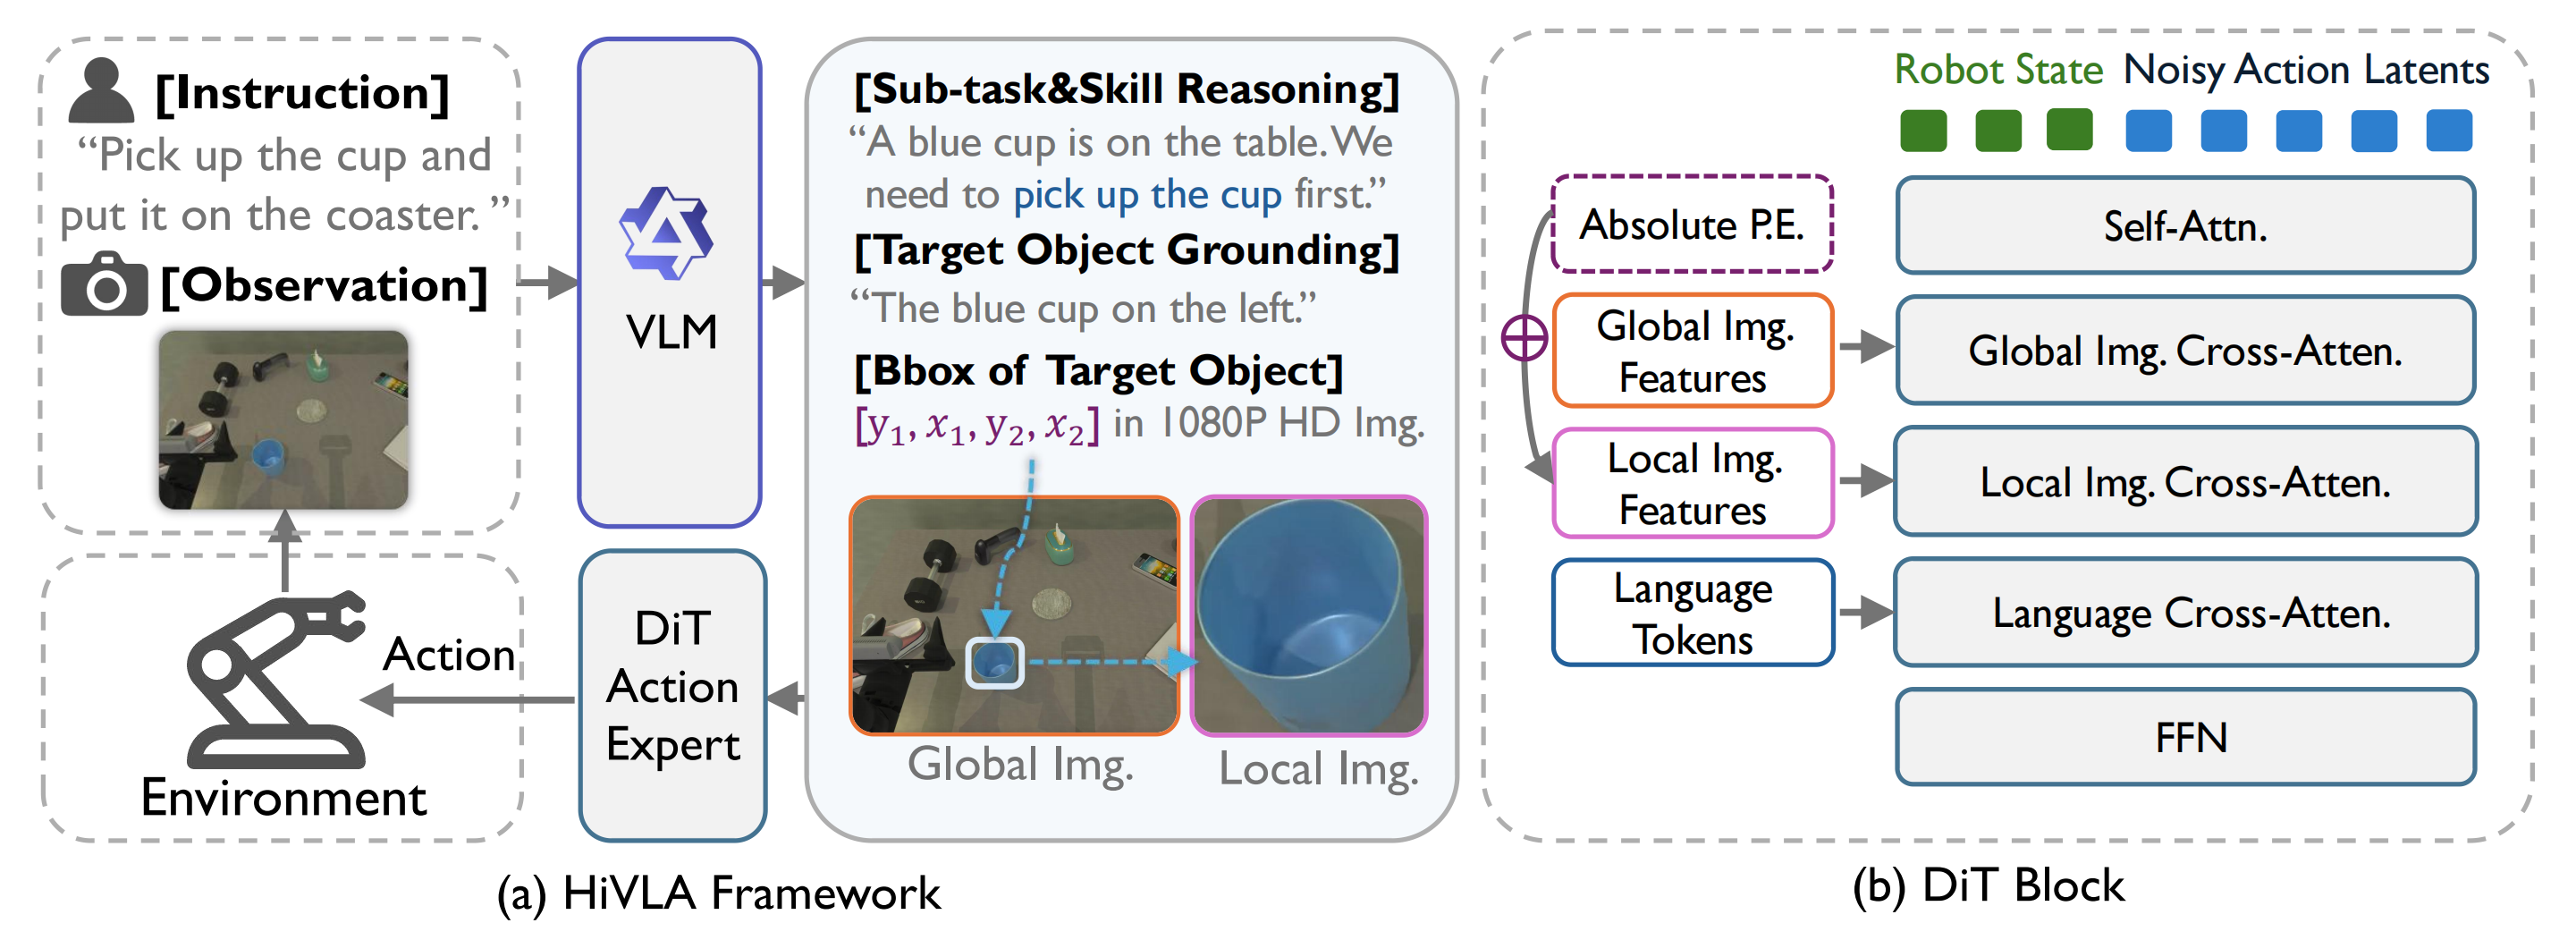
cascaded cross-attention. DiT 블록 하나 안에서 global 이미지, 국소 이미지, 언어를 각각 별도의 cross-attention 층으로 순서대로 주입하는 구조다. 파이프라인 도식의 (b) 부분이 이 구조를 그린다.
방법
초록이 서술하는 구조
초록은 문제 제기로 시작한다. end-to-end VLA를 좁은 제어 데이터로 fine-tuning하면 기반 VLM에서 물려받은 추론 능력이 손상된다는 지적이다. HiVLA는 상위 의미 계획과 하위 모터 제어를 명시적으로 분리해 이 절충을 해소한다.
상위에서는 VLM planner가 과제 분해와 visual grounding을 수행해 구조화된 계획을 만든다. grounding은 모델 출력을 외부 근거나 물리 세계에 붙들어 매는 것을 뜻한다. 계획은 두 요소로 구성된다.
| 요소 | 내용 |
|---|---|
| subtask 지시문 | 다음에 수행할 단계를 설명하는 문장 |
| 대상 bounding box | 그 단계의 대상 물체를 감싸는 정확한 사각 영역 |
하위에서는 flow matching 기반 DiT action expert가 그 계획을 물리 action으로 옮긴다. flow matching은 잡음 분포에서 데이터 분포로 향하는 벡터장을 학습해 표본을 만드는 생성 기법이고, action expert는 상위 모델이 넘긴 계획을 받아 연속 제어 명령을 생성하는 하위 모델을 가리킨다.
초록이 밝히는 분리 구조의 이점은 두 가지다. VLM의 zero-shot 추론 능력이 보존되고, 두 구성 요소를 각각 독립적으로 개선할 수 있다.
파이프라인 도식이 서술하는 조건 주입
파이프라인 캡션은 도식을 두 부분으로 나눠 설명한다.
(a)는 분리된 프레임워크다. VLM이 사용자 지시문을 명시적인 구조화 계획으로 분해하고, skill 수준 subtask와 고해상도 대상 크롭을 뽑는 데 쓰이는 bounding box를 함께 낸다.
(b)는 실행부다. DiT action expert가 cascaded cross-attention 블록을 쓴다. 잡음 섞인 action latent를 세 조건에 순차로 조건화하는데, 순서는 global 시각 문맥, 위치 정보를 담은 국소 특징, 언어 토큰이다. 캡션은 이 설계가 상위 추론과 하위 제어를 잇는다고 적는다.
도식에는 캡션이 말하지 않는 세부도 들어 있다. 블록 안의 층 순서는 self-attention, global 이미지 cross-attention, local 이미지 cross-attention, 언어 cross-attention, FFN이다. 입력 쪽에는 Robot State 토큰과 Noisy Action Latents 토큰이 함께 들어가고, 국소 이미지 특징에는 Absolute P.E.가 더해진다.
결과
페이지가 싣는 유일한 수치는 RoboTwin 시뮬레이터 결과 표다. 논문 Table 1과 같은 내용이며 Easy 4개와 Hard 5개로 나뉜다.
| 구분 | 과제 | π0 | π0.5 | StarVLA | H-RDT | Ours w/o Skill | Ours |
|---|---|---|---|---|---|---|---|
| Easy | Click Bell | 45% | 65% | 71% | 88% | 95% | 94% |
| Easy | Click Clock | 53% | 66% | 83% | 93% | 97% | 97% |
| Easy | Press Stapler | 60% | 69% | 63% | 89% | 98% | 97% |
| Easy | Lift Pot | 59% | 21% | 18% | 92% | 96% | 96% |
| Easy | 평균 | 54.3% | 55.3% | 58.8% | 90.5% | 96.5% | 96.0% |
| Hard | Place Shoe | 75% | 68% | 61% | 88% | 94% | 95% |
| Hard | Move Stapler | 15% | 17% | 15% | 34% | 42% | 60% |
| Hard | Stamp Seal | 61% | 42% | 25% | 43% | 68% | 76% |
| Hard | Stack 3 Blocks | 1% | 1% | 16% | 20% | 26% | 37% |
| Hard | Click 3 Bells | 41% | 54% | 66% | 88% | 92% | 98% |
| Hard | 평균 | 38.6% | 36.4% | 36.6% | 54.6% | 64.4% | 73.2% |
| 전체 | 평균 | 45.6% | 44.8% | 46.4% | 70.6% | 78.7% | 83.3% |
표 아래 설명은 HiVLA가 long-horizon 과제와 시각적으로 까다로운 과제에서 특히 앞선다고 적는다. long-horizon은 여러 단계를 순차로 완수해야 성공으로 인정되는 긴 과제를 가리킨다.
원문은 최고 성적을 굵게, 두 번째 성적을 밑줄로 표시했다고 밝히지만 수집한 마크다운에서는 서식이 제거되어 그 구분이 남아 있지 않다. 어느 값이 최고이고 두 번째인지는 수치를 직접 비교해야 한다.
티저 도식의 오른쪽 차트가 같은 표를 두 가지 방식으로 다시 보여준다. 레이더 차트는 6개 대표 과제에서 π0, H-RDT, Ours w/o Skill, Ours의 성적을 겹쳐 그리고, 막대 그래프는 9개 과제 전체 평균을 45.6%, 70.6%, 78.7%, 83.3% 순으로 나열한다.
논문과의 대응
프로젝트 페이지와 논문의 관계는 다음과 같다.
| 항목 | 프로젝트 페이지 | 논문 |
|---|---|---|
| 초록 | 전문 게재 | 동일 |
| 티저 도식 | 웹용 고해상도 원본 | Figure 1 |
| 파이프라인 도식 | 웹용 고해상도 원본 | Figure 2 |
| RoboTwin 결과 | 표 하나 | Table 1 |
| 과제 시각화 | 없음 | Figure 3, Figure 4, Figure 5 |
| robustness 실험 | 없음 | Table 2 |
| 실제 로봇 결과 | 없음 | Table 3 |
| ablation | 없음 | Table 4 |
| 아키텍처 사양 | 없음 | Table 5 |
| VLM planner 평가 | 없음 | Table 6 |
| 시스템 프롬프트 | 없음 | Table 7 |
| 과제별 지시문 | 없음 | Table 8 |
| 지연 시간과 control frequency | 없음 | 본문 5.1절 |
페이지만 보면 시뮬레이션 성적 하나로 판단하게 된다. 실제 로봇에서 baseline이 30회 중 0회 성공하는 조건을 통과했다는 결과, bounding box 잡음을 100% 주입해도 57.0%가 유지된다는 robustness, cross-attention 주입 순서만으로 9.2%p가 갈린다는 ablation은 모두 논문에만 있다.
한계
페이지는 한계를 다루지 않는다. 자료 자체의 제약은 다음과 같다.
- 논문 본문의 실험 대부분이 빠져 있다. 실제 로봇 결과, robustness, ablation, planner 평가가 모두 없다.
- 시연 영상이 없다. 페이지에 embed된 video 요소가 하나도 없어 정지 이미지 두 장이 시각 자료의 전부다. VLA 프로젝트 페이지가 보통 rollout 영상을 싣는 것과 대비된다.
- 코드 링크가 자기 페이지로 되돌아오는 자리표시자 상태다.
- 발행 날짜 표기가 없다. 논문 arXiv 판이 2026년 5월 10일자이므로 그 이후로 추정할 수 있을 뿐이다.
- 결과 표의 굵기와 밑줄 서식이 마크다운 수집 과정에서 사라졌다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| visual-grounded-centric | VLM이 낸 bounding box와 그로부터 잘라낸 고해상도 크롭을 상위와 하위를 잇는 주 인터페이스로 삼는 설계 관점 |
| cascaded cross-attention | DiT 블록 하나 안에서 global 이미지, 국소 이미지, 언어를 각각 별도의 cross-attention 층으로 순서대로 주입하는 구조 |
| Ours w/o Skill | subtask 문장 대신 전체 지시문을 그대로 조건으로 준 ablation 변형 |
관련 페이지
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System: 같은 연구의 논문. 이 페이지가 생략한 실험 전체가 담겨 있다
- Cortex 프로젝트 페이지: 양방향 alignment 인터페이스 요약과 추가 지표: 같은 형식의 계층형 VLA 프로젝트 페이지. 시연 영상과 추가 결과를 함께 싣는 구성과 비교할 수 있다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 결과 표의 비교 대상 π0.5
- 용어집: Physical AI (Terminology Glossary): 이 페이지의 전문 용어 표기 기준