Physical AI · PAPER · 2026
VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model
요약
VLA-JEPA는 action 라벨이 없는 사람 영상에서 VLA policy가 쓸 latent action을 배우는 pre-training 프레임워크다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하고, latent action은 두 프레임 사이에 무엇이 바뀌었는지를 명시적 제어 명령 대신 모델 내부 표현으로 담은 변수를 말한다. 논문의 핵심 주장은 기존 latent action 학습이 픽셀 변화에 묶여 제어와 무관한 외형, 카메라 움직임, 미래 정보 누출을 배운다는 것이고, 해법은 미래 프레임을 입력이 아니라 학습 목표로만 쓰는 leakage-free state prediction이다.
구현은 세 부품으로 이뤄진다. Qwen3-VL-2B backbone이 현재 observation과 지시문(instruction)에서 latent action 토큰을 내고, 동결된 V-JEPA2 인코더가 현재와 미래 프레임의 latent 상태를 만들며, autoregressive Transformer인 latent world model이 latent action을 조건으로 다음 latent 상태를 예측한다. 예측 상태와 실제 상태의 차이가 손실이고, 로봇 데이터에서는 여기에 flow matching action head의 손실을 더해 end-to-end로 학습한다.
성능은 세 벤치마크와 실제 로봇에서 검증됐다. LIBERO 평균 97.2%, SimplerEnv Google Robot 평균 65.2%, LIBERO-Plus 평균 79.5%로 각 벤치마크의 비교 대상 중 가장 높은 평균이며, 특히 perturbation을 가한 LIBERO-Plus에서 두 번째로 높은 OpenVLA-OFT를 9.9%p 앞선다. 실제 Franka 로봇에서는 in-distribution 성공률 0.70으로 π0(0.57)와 π0.5(0.37)를 앞섰고, 사람 영상에서 배운 반복 grasping 동작이 나타났다.
배경
VLA는 웹 규모로 pre-training된 VLM에 로봇 action 출력을 붙인 모델이다. RT 시리즈가 멀티모달 LLM을 로봇 시연 데이터(demonstration)로 fine-tuning하는 길을 열었고, OpenVLA, π0, GR00T N1 같은 후속 모델이 manipulation 성능을 끌어올렸다. 그러나 이 계열은 action 라벨이 붙은 대규모 로봇 데이터에 의존하며, 그 데이터는 수집 비용이 크고 범위가 좁다.
인터넷의 사람 영상은 이 병목을 풀 후보다. 라벨은 없지만 양이 많고 다양하며, 시간에 따라 장면이 어떻게 바뀌는지를 풍부하게 보여준다. 그래서 LAPA, UniVLA, MotoGPT 같은 latent action pre-training 계열은 영상에서 프레임 전이를 latent action으로 압축해 VLA가 이를 예측하도록 먼저 학습하고, 그 뒤에 실제 로봇 제어로 옮긴다. villa-x, XR-1, CLAP, VITA는 사람 영상과 로봇 영상 양쪽에서 latent action을 뽑아 통합 codebook으로 실제 action 공간에 맞춘다.
논문은 이 계열의 목적 함수가 제어에 필요한 것을 배우지 못하는 경우가 많다고 본다. 체화된 agent에게 유용한 action은 픽셀 차이를 압축한 기술자가 아니라, 상호작용 아래에서 상태가 어떻게 변할지를 담는 변수여야 한다. pre-training 목표가 여기서 어긋나면 downstream policy는 시간적으로는 예측력이 있지만 제어 가능한 구조와는 약하게만 묶인 표현을 물려받고, 결과적으로 취약한 동작, 낮은 전이 성능, 비효율적인 fine-tuning으로 이어진다.
네 가지 실패 유형
논문은 라벨 없는 영상 위에 세운 latent action 파이프라인에서 반복되는 실패를 네 가지로 정리한다.
| 유형 | 원인 | 결과 |
|---|---|---|
| 픽셀 수준 목적 함수의 외형 편향 | 미래 픽셀을 직접 예측하거나 프레임 간 변화를 latent로 압축한다. VQ-VAE로 압축해도 감독 신호는 질감, 조명, 배경 잡동사니, 시점 변화처럼 시각적으로 크게 변하는 요인에 지배된다 | 분산은 크지만 제어와 거의 무관한 요인을 배운다 |
| 실제 영상의 잡음 움직임 증폭 | 사람 영상과 야외 영상에서는 카메라 움직임과 인과 관계 없는 배경 변화가 상호작용에 의한 상태 변화보다 강하다 | latent action이 과제와 무관한 움직임(nuisance motion)을 담는 프레임 차분 인코더로 변한다 |
| 정보 누출에 의한 지름길 | 현재 observation과 미래 observation을 같은 모듈에 함께 넣거나, 학습 중 미래 문맥이 action 변수에 영향을 주도록 둔다 | latent action이 상태 전이를 설명하는 대신 미래 자체를 부호화한다. 학습 손실은 낮아지지만 제어에 의미 없는 변수가 된다 |
| 다단계 학습 파이프라인 | 위 문제를 완화하려고 표현 pre-training, latent action 학습과 alignment, policy 학습의 세 단계 이상을 거친다 | 공학 복잡도가 오르고 단계 간 불일치가 생기며 방법을 깨끗하게 학습하고 평가하기 어렵다 |
네 유형의 공통 원인은 목적 함수가 암묵적으로 픽셀 변화에 고정돼 있다는 점이다. 논문은 여기서 설계 원칙 하나를 끌어낸다. action과 관련된 전이 구조를 반영하는 미래 latent 상태를 예측하되, 미래 정보가 예측기에 새어 들어가지 못하게 막는다는 원칙이다. 이 원칙은 픽셀 재구성을 latent 공간 alignment로 대체하는 JEPA와 맞아떨어진다.
JEPA 계보
JEPA(Joint-Embedding Predictive Architecture)는 이미지의 가려진 영역이나 영상의 미래를 픽셀이 아니라 표현 공간에서 예측하는 자기지도학습 구조다. I-JEPA가 이미지에, V-JEPA와 V-JEPA 2가 영상에 적용했다. 픽셀 대신 표현을 맞추므로 저수준 잡음에 robust하고 의미 추상화를 촉진한다. VLA-JEPA는 V-JEPA2 인코더를 동결된 목표 인코더로 쓰고, 그 위에 로봇 제어용 예측기를 latent world model로 학습한다. world model은 환경의 dynamics를 학습해 미래를 예측하는 모델이다.
핵심 개념
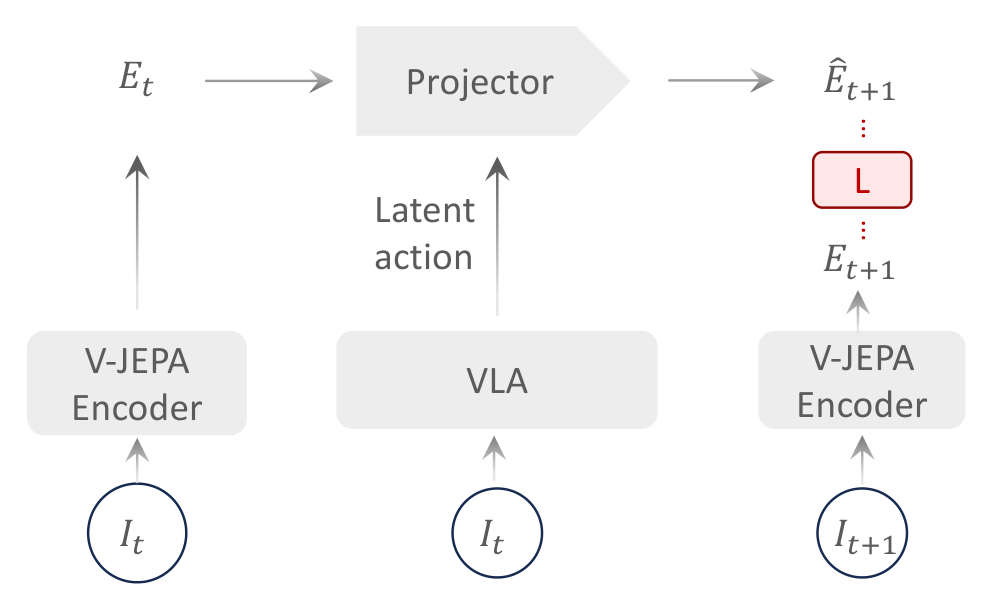
leakage-free state prediction. 미래 프레임을 예측기의 입력이 아니라 학습 목표를 만드는 데만 쓰는 설계다. 목표 인코더는 미래 프레임에서 latent 표현을 만들고, 학생 경로인 VLM backbone은 현재 observation만 본다. 미래를 입력으로 받는 경로가 없으므로 latent action이 미래를 그대로 베끼는 지름길이 구조적으로 막힌다.
latent predictive alignment. 픽셀 재구성 대신 예측 latent 상태와 목표 latent 상태를 맞추는 학습 목표다. 감독이 latent 공간에서 이뤄지므로 카메라 움직임이나 무관한 배경 변화처럼 픽셀에서는 크지만 의미 공간에서는 작은 변화에 robust하다.
latent action 토큰. VLM 어휘에 추가한 학습 가능한 특수 토큰 ⟨latent_i⟩다. i번째 시점의 상태 전이를 요약하며, ⟨latent_0⟩은 s_0과 s_1 사이의 전이를 나타낸다. 토큰 수는 항상 프레임 수에서 1을 뺀 값이다.
latent world model. 상태 시퀀스와 latent action 시퀀스를 받아 다음 상태 chunk를 예측하는 autoregressive Transformer다. 같은 시점 안에서는 모든 토큰이 서로를 보고 시점 사이에서는 과거만 보는 time-causal attention을 쓴다.
두 단계 레시피. 사람 영상과 로봇 데이터로 latent world model 목적 함수를 한 번에 pre-training하고, 그 뒤 action head를 fine-tuning한다. 기존 latent action 파이프라인이 세 단계 이상을 거치는 것과 대비된다.
방법
전체 학습 흐름
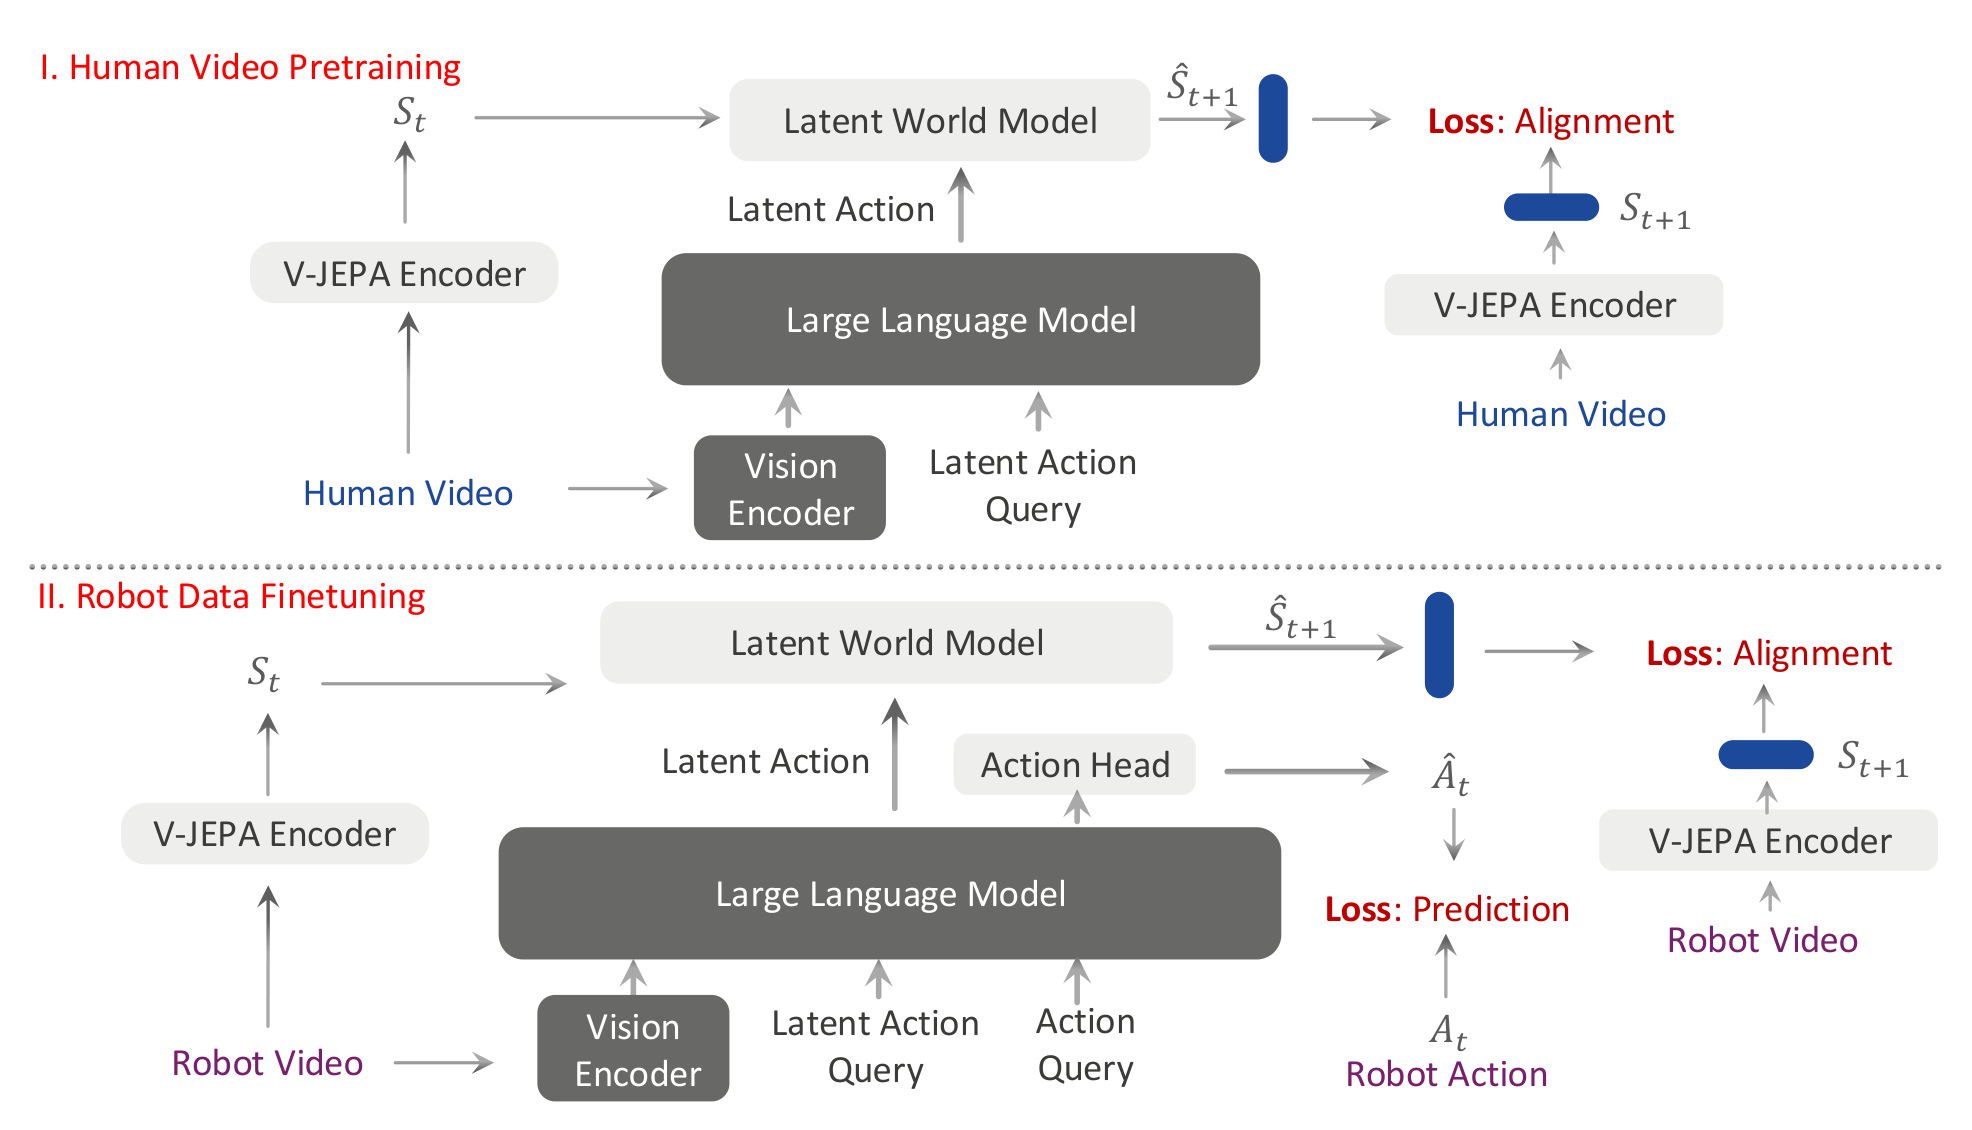
VLA-JEPA는 action 라벨이 없는 사람 영상과 action 라벨이 있는 로봇 데이터를 함께 pre-training하는 통합 프레임워크다. 두 데이터는 같은 latent world model 목적 함수를 공유하고, 로봇 데이터에만 action 예측 손실이 더해진다.
| 단계 | 데이터 | 학습 대상 | 손실 |
|---|---|---|---|
| I. 사람 영상 pre-training | Something-Something-v2 22만 개 영상 | VLM의 latent action 토큰과 latent world model | alignment 손실 L_WM |
| I. 로봇 데이터 pre-training (동시) | Droid 7만 6천 개 trajectory | 위 구성 요소에 flow matching action head 추가 | L_FM + β L_WM |
| II. 로봇 데이터 fine-tuning | 벤치마크별 시연 데이터 | 전체 end-to-end | L_FM + β L_WM |
backbone과 특수 토큰
backbone은 Qwen3-VL이다. Qwen3 위에 SigLIP-2를 시각 인코더로 결합한 VLM으로, 대규모 pre-training에서 얻은 이미지 이해와 핵심 물체 탐지 같은 world knowledge를 로봇 제어로 옮기는 역할을 맡는다. world knowledge는 모델이 웹 데이터에서 습득한 물체, 장면, 상식에 대한 지식을 뜻한다.
VLM에서 연속 latent action 표현을 뽑기 위해 두 종류의 학습 가능한 토큰을 어휘에 추가한다.
| 토큰 | 역할 | 비고 |
|---|---|---|
| ⟨latent_i⟩ | i번째 시점의 상태 전이를 요약하는 latent action 토큰 | 입력 시퀀스에서 K번 복제해 가변 길이 부호화를 가능하게 한다. K = 24 / T이고 T는 미래 영상 horizon이다 |
| ⟨action⟩ | latent action 토큰 뒤에 붙는 embodied action 토큰 | 32번 반복한 시퀀스가 flow matching action head의 조건 신호가 된다 |
K와 반복 횟수 32는 모두 경험적으로 찾은 최적값이다. 예를 들어 T = 8이면 K = 3이고, 이는 부록 설정표의 시점당 action 토큰 3개와 일치한다.
상태 인코더
사람 영상 데이터셋은 여러 시점(view)에서 찍은 영상 집합과 지시문 하나의 쌍으로 정의된다. 각 시점 영상은 시각 t_0부터 t_n까지의 프레임 시퀀스다.
논문이 world state encoder라 부르는 상태 인코더는 같은 episode의 여러 시점 observation을 하나의 상태 표현으로 합친다. 자기지도로 학습된 V-JEPA2 인코더가 시점별 영상 표현을 만들고, 시점별 표현을 벡터 연결로 이어 붙인 것이 시각 t_i의 통합 상태 s_ti다 (식 1). 이 인코더는 pre-training 내내 동결되며, 예측 목표를 만드는 stop-gradient 경로로만 쓰인다.
시점 수는 2개로 고정된다. 카메라가 2개 미만이면 상태 표현을 복제해 두 벌로 이어 붙이고, 2개를 넘으면 두 시점만 고른다.
latent world model과 예측 목적 함수
학습 가능한 latent action 토큰이 상태 전이 dynamics를 잡도록 autoregressive Transformer 기반 world model의 상태 예측 목적 함수를 둔다. 절차는 세 단계다.
- VLM이 초기 시각 t_0의 다중 시점 observation과 지시문을 입력받고, 특수 토큰 ⟨latent_i⟩를 world dynamics를 요약하는 latent 표현 z_ti로 사상한다 (식 2). VLM은 t_0의 프레임만 보고 뒤 시점의 프레임은 보지 않는다.
- world model이 부호화된 상태 시퀀스 s_t0:i와 조건 변수 z_t0:i를 받아 다음 상태 chunk ŝ_t1:i+1을 예측한다 (식 3).
- 예측 상태와 V-JEPA2가 만든 실제 상태의 차이를 예측 horizon T에 걸쳐 합한 것이 world modeling 손실 L_WM이다 (식 5). world model과 VLM은 teacher forcing으로 함께 최적화한다.
world model의 attention 마스킹은 두 규칙을 결합한다. 같은 시점 안에서는 K개의 latent action 토큰과 N개의 이미지 latent 토큰이 양방향 full attention으로 서로를 보고, 시점 사이에서는 t 시점 토큰이 t 이하 시점만 볼 수 있으며 미래 시점은 마스킹된다. 즉 시점 내부는 양방향이고 시점 사이는 causal이다.
ELBO 해석
JEPA 관점에서 이 목적 함수는 의미 공간에서 예측 로그 가능도의 evidence lower bound(ELBO)를 최대화하는 것으로 볼 수 있다 (식 4). 동결된 V-JEPA2 인코더가 stop-gradient로 목표 상태를 만들고 world model이 온라인 예측기 역할을 한다. ELBO는 재구성 항과 KL 항으로 나뉘는데, V-JEPA2 인코더가 결정론적 임베딩을 내므로 KL 항은 사라지고 ELBO는 latent 공간의 재구성 손실로 줄어든다. 따라서 실제 구현은 latent 상태의 회귀 손실 하나로 단순해진다.
action head와 결합 목적 함수
로봇 데이터셋의 다중 시점 RGB 영상에도 같은 L_WM을 적용해 latent action 표현을 로봇 도메인에 맞춘다. 실제 action 예측에서는 latent action이 초기 이미지 observation, 지시문과 같은 자격의 조건 신호로 쓰인다. 이를 위해 ⟨action⟩ 토큰을 latent action 토큰 뒤에 붙이고, VLM의 causal attention이 ⟨action⟩, latent action 토큰, 초기 시각 observation, 지시문 사이의 의존 관계를 잡게 한다. 그 출력 z_a가 action head의 조건 신호다 (식 6).
action head는 conditional flow matching으로 연속 action trajectory 분포를 모델링한다. flow matching은 잡음 분포에서 데이터 분포로 향하는 벡터장을 학습해 표본을 만드는 생성 기법이다. horizon H의 실제 action 시퀀스 a_0:H와 가우시안 잡음 ε 사이를 시간 t에 대해 선형 보간한 a_t = (1 - t)ε + t a_0:H를 정의하고 (식 7), action head는 z_a에 조건화된 벡터장 v_θ(a_t, t | z_a)를 파라미터화한다. 손실 L_FM은 예측 속도장과 목표 속도 (a_0:H - ε) 사이의 L2 거리다 (식 8). 추론 시에는 학습된 벡터장을 잡음에서 데이터 공간으로 적분해 action trajectory를 얻는다.
action 라벨이 있는 로봇 데이터의 전체 손실은 L = L_FM + β L_WM이다 (식 9). β는 조정 가능한 하이퍼파라미터이며 논문은 값을 밝히지 않는다.
아키텍처 사양
| 구성 요소 | 내용 |
|---|---|
| VLM backbone | Qwen3-VL-2B. dense Transformer이며 시각 인코더는 Vision Transformer와 3D 합성곱 모듈로 구성된다 |
| 상태 인코더 | V-JEPA2 인코더 체크포인트. 동결 |
| latent world model | 무작위 초기화한 predictor. action 입력은 VLM이 만든 latent action 토큰이다 |
| action head | flow matching 기반 Transformer인 DiT-B. DiT는 diffusion 모델의 U-Net을 Transformer로 바꾼 구조다 |
latent world model 설정은 다음과 같다 (Table 5).
| 항목 | 값 |
|---|---|
| Transformer 층 수 | 12 |
| attention head | 8 |
| 이미지 토큰 차원 | 2048 |
| 시점당 이미지 토큰 수 | 256 |
| action 토큰 차원 | 2048 |
| 시점당 action 토큰 수 | 3 |
| 시점 수 | 2 |
| 미래 영상 horizon | 8 |
action head 설정은 다음과 같다 (Table 6).
| 항목 | 값 |
|---|---|
| Transformer 층 수 | 16 |
| attention head | 12 |
| 토큰 차원 | 1024 |
| 상태 차원 | 8 |
| action 차원 | 7 |
| 미래 action horizon | 7 |
| 위치 인코딩 | 학습 가능 |
| denoising 단계 수 | 4 |
action 차원 7은 end-effector delta 위치 3차원, delta axis-angle 3차원, 그리퍼 1차원에 대응한다. denoising 단계가 4단계라는 것은 추론 시 벡터장을 네 번만 적분해 action trajectory를 만든다는 뜻이다.
학습 절차
pre-training에서는 상태 인코더를 뺀 모든 파라미터를 학습한다. 전처리와 최적화 설정은 다음과 같다.
- VLM 입력 observation 이미지는 224×224로, 상태 인코더용 영상 클립은 256×256으로 크기를 맞춘다.
- 관절 위치 제어로 pre-training된 모델(π0 등)은 관절 공간 delta 위치를 action으로 쓰고, end-effector 제어로 pre-training된 모델(VLA-JEPA)은 end-effector delta 위치와 delta axis-angle을 action으로 쓴다. 둘 다 min-max 정규화로 [0, 1]에 맞추고 그리퍼 명령은 {0, 1}로 이진화한다.
- 배치 크기 32를 GPU 8대에서 병렬로 실행해 전체 배치는 256이다.
- 학습률은 선형 warmup 뒤 cosine 스케줄이고, 최고 학습률은 VLM과 latent world model이 1e-5, action head가 1e-4다.
- 모든 실험은 NVIDIA A100 GPU 8대에서 수행했다.
단계별 학습 스텝과 데이터는 다음과 같다.
| 단계 | 데이터 | 스텝 수 | 시작점 |
|---|---|---|---|
| pre-training | SSv2와 Droid 결합 | 5만 | 처음부터 |
| 시뮬레이션 이어 학습 | LIBERO 약 2천 개 시연 데이터, 또는 Fractal과 BridgeV2 | 3만 | 마지막 pre-training 체크포인트 |
| 실제 로봇 fine-tuning | 3개 과제 100개 시연 데이터 | 2만 | 마지막 pre-training 체크포인트 |
LIBERO와 LIBERO-Plus 평가는 같은 LIBERO 데이터셋으로 학습한 모델을 쓰며 LIBERO-Plus의 증강 데이터는 쓰지 않는다. SimplerEnv는 두 로봇 embodiment에 대응하는 Fractal과 BridgeV2로 post-training한다.
결과
평가 환경
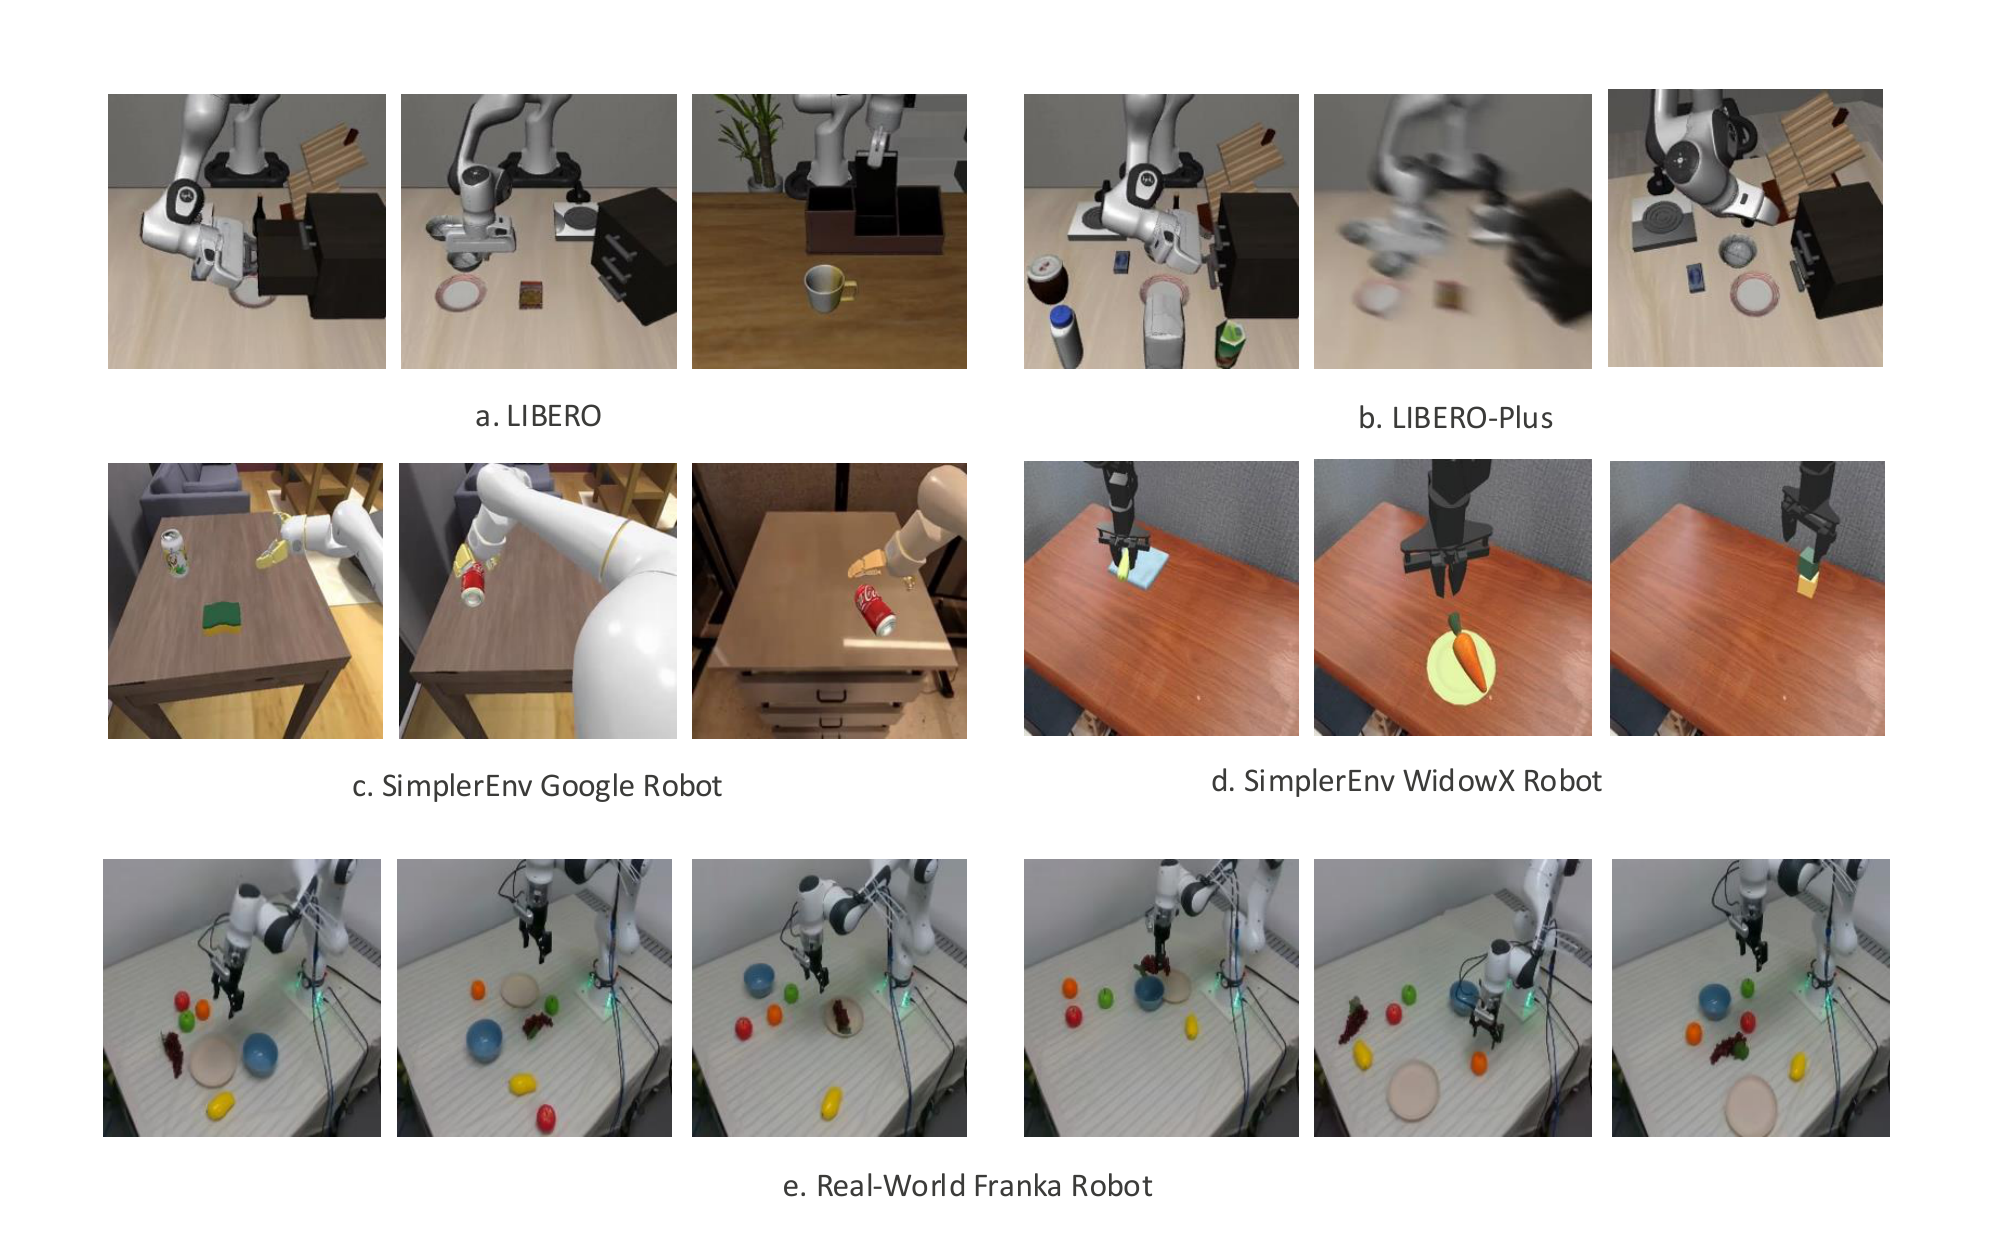
시뮬레이션 환경은 두 종류이고 벤치마크는 세 가지다. 세 벤치마크는 서로 다른 분포 시나리오를 대표한다.
| 벤치마크 | 플랫폼 | 성격 | 시나리오 |
|---|---|---|---|
| LIBERO | Franka Emika Panda 팔, 4개 suite | manipulation의 평생 학습 연구용 | 시뮬레이션 전문가 데이터로 학습해 in-distribution 과제에서 검증 |
| SimplerEnv | WidowX와 Google Robot | 조명, 색, 질감, 카메라 pose가 다양해 실제와 시뮬레이션의 외형 격차를 잇는다 | 실제 데이터로 학습해 시뮬레이션에서 평가하는 real-to-sim 격차의 OOD |
| LIBERO-Plus | LIBERO 4개 suite에 perturbation 7종 | VLA를 체계적으로 스트레스 테스트하는 대규모 벤치마크 | 시뮬레이션 전문가 데이터로 학습해 OOD 과제에서 검증 |
perturbation은 카메라, 로봇 초기 상태, 언어, 조명, 배경, 잡음, 물체 배치처럼 과제의 목표와 무관하게 입력을 바꾸는 교란을 뜻한다.
baseline은 latent action 계열 VLA, 미래 예측 계열 VLA, 공개 최신 VLA를 아우르는 12종이다. Moto, LAPA, UniVLA, villa-X, CoT-VLA, WorldVLA, RoboVLMs, GR00T N1, OpenVLA-OFT, π0, π0-Fast, π0.5다. 이 중 LAPA, UniVLA, villa-X, CoT-VLA는 사람 영상이나 latent action으로 pre-training한 계열이고, OpenVLA-OFT, π0, π0.5는 대규모 로봇 데이터로 pre-training한 계열이다.
LIBERO
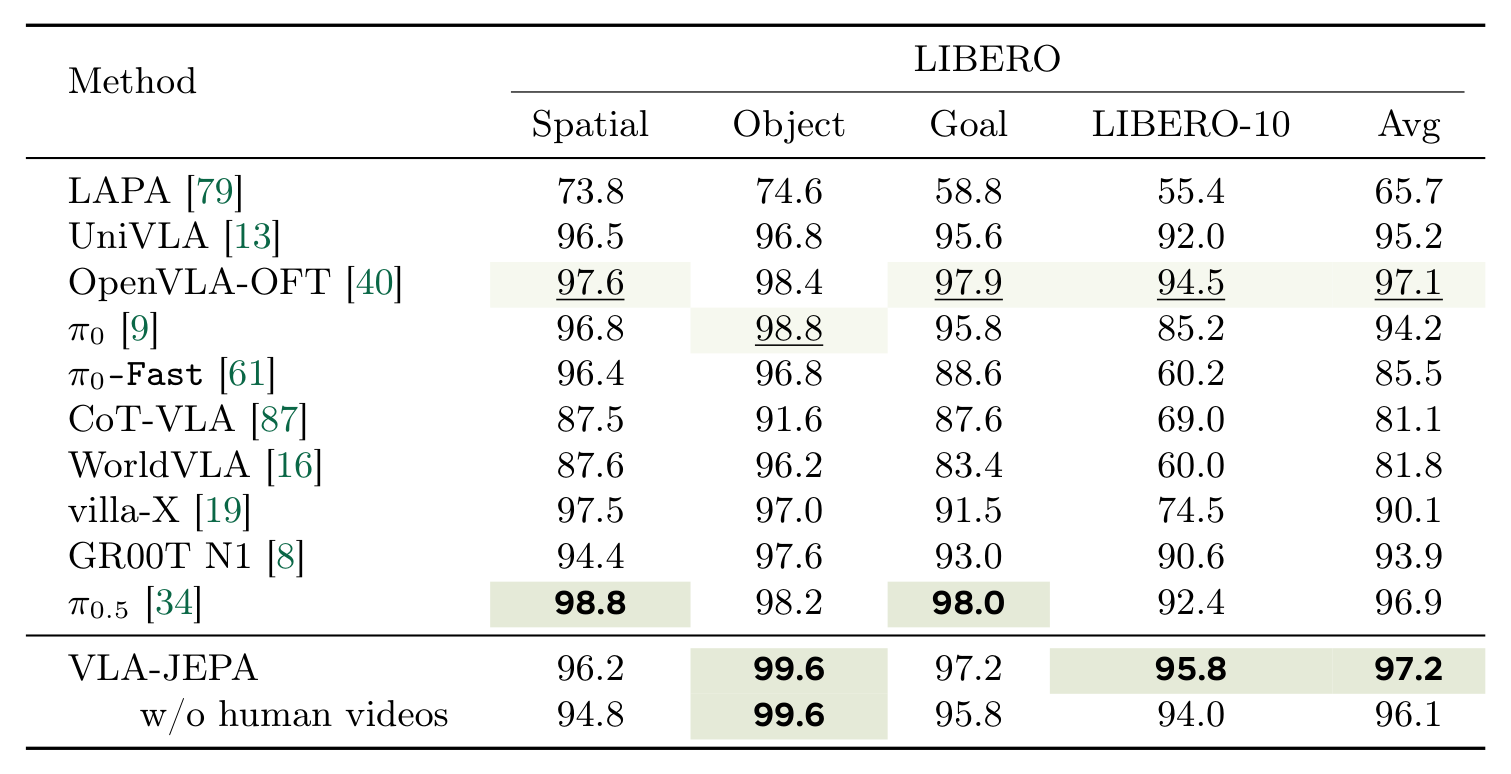
과제마다 50개 episode, suite마다 500개 episode를 평가한다.
| 방법 | Spatial | Object | Goal | LIBERO-10 | 평균 |
|---|---|---|---|---|---|
| LAPA | 73.8 | 74.6 | 58.8 | 55.4 | 65.7 |
| UniVLA | 96.5 | 96.8 | 95.6 | 92.0 | 95.2 |
| OpenVLA-OFT | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| π0 | 96.8 | 98.8 | 95.8 | 85.2 | 94.2 |
| π0-Fast | 96.4 | 96.8 | 88.6 | 60.2 | 85.5 |
| CoT-VLA | 87.5 | 91.6 | 87.6 | 69.0 | 81.1 |
| WorldVLA | 87.6 | 96.2 | 83.4 | 60.0 | 81.8 |
| villa-X | 97.5 | 97.0 | 91.5 | 74.5 | 90.1 |
| GR00T N1 | 94.4 | 97.6 | 93.0 | 90.6 | 93.9 |
| π0.5 | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| VLA-JEPA | 96.2 | 99.6 | 97.2 | 95.8 | 97.2 |
| VLA-JEPA (사람 영상 제외) | 94.8 | 99.6 | 95.8 | 94.0 | 96.1 |
VLA-JEPA는 4개 suite 중 Object(99.6%)와 LIBERO-10(95.8%)에서 최고 성적이고 평균 97.2%로 전체 1위다. 상위권인 OpenVLA-OFT(97.1%)와 π0.5(96.9%)는 방대한 로봇 데이터로 pre-training된 모델인데, VLA-JEPA는 더 적은 학습 데이터로 이들과 같거나 높은 평균을 냈다.
사람 영상이나 latent action으로 pre-training한 계열과의 격차는 더 크다. UniVLA 95.2%, villa-X 90.1%, CoT-VLA 81.1%, LAPA 65.7%가 모두 VLA-JEPA보다 낮다. 논문은 이 결과를 1절에서 지적한 픽셀 고정과 정보 누출 문제가 실제 성능 격차로 나타난 것으로 해석한다. LIBERO-10은 여러 단계를 이어야 하는 long-horizon suite인데, 여기서 VLA-JEPA가 95.8%로 π0(85.2%)를 10.6%p, villa-X(74.5%)를 21.3%p 앞선다는 점도 눈에 띈다.
SimplerEnv
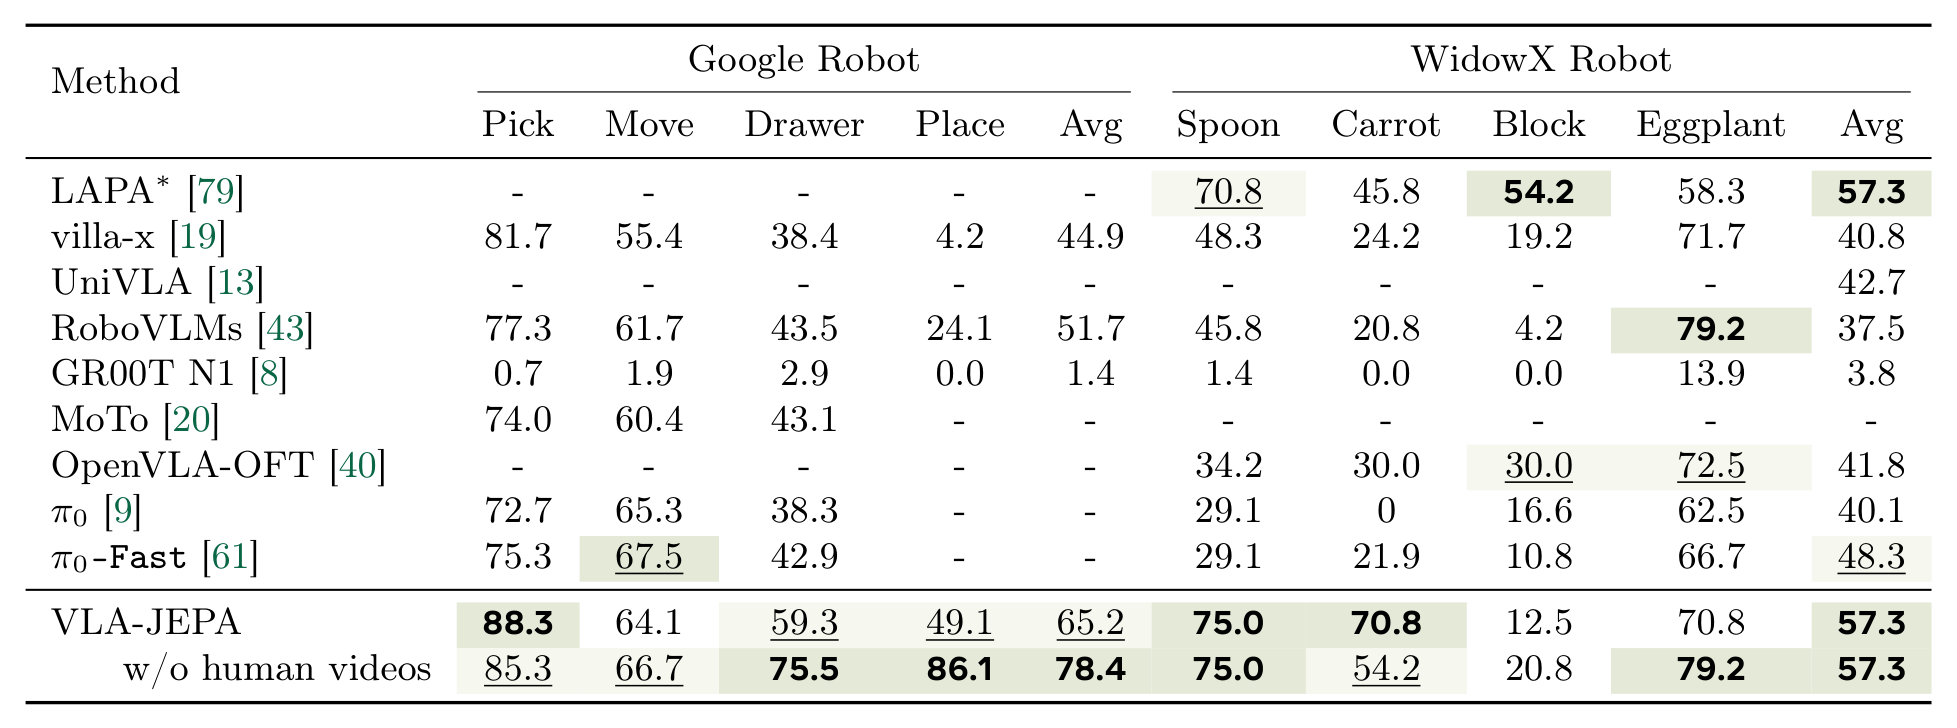
visual matching 설정에서 과제별 평균 성공률을 보고한다. LAPA의 별표(*)는 시뮬레이션 환경에서 수집한 in-distribution 전문가 시연 데이터로 학습했다는 뜻이고, 나머지는 OXE 데이터셋의 부분집합으로 학습했다.
| 방법 | Google Pick | Google Move | Google Drawer | Google Place | Google 평균 | WidowX Spoon | WidowX Carrot | WidowX Block | WidowX Eggplant | WidowX 평균 |
|---|---|---|---|---|---|---|---|---|---|---|
| LAPA* | - | - | - | - | - | 70.8 | 45.8 | 54.2 | 58.3 | 57.3 |
| villa-x | 81.7 | 55.4 | 38.4 | 4.2 | 44.9 | 48.3 | 24.2 | 19.2 | 71.7 | 40.8 |
| UniVLA | - | - | - | - | - | - | - | - | - | 42.7 |
| RoboVLMs | 77.3 | 61.7 | 43.5 | 24.1 | 51.7 | 45.8 | 20.8 | 4.2 | 79.2 | 37.5 |
| GR00T N1 | 0.7 | 1.9 | 2.9 | 0.0 | 1.4 | 1.4 | 0.0 | 0.0 | 13.9 | 3.8 |
| MoTo | 74.0 | 60.4 | 43.1 | - | - | - | - | - | - | - |
| OpenVLA-OFT | - | - | - | - | - | 34.2 | 30.0 | 30.0 | 72.5 | 41.8 |
| π0 | 72.7 | 65.3 | 38.3 | - | - | 29.1 | 0 | 16.6 | 62.5 | 40.1 |
| π0-Fast | 75.3 | 67.5 | 42.9 | - | - | 29.1 | 21.9 | 10.8 | 66.7 | 48.3 |
| VLA-JEPA | 88.3 | 64.1 | 59.3 | 49.1 | 65.2 | 75.0 | 70.8 | 12.5 | 70.8 | 57.3 |
| VLA-JEPA (사람 영상 제외) | 85.3 | 66.7 | 75.5 | 86.1 | 78.4 | 75.0 | 54.2 | 20.8 | 79.2 | 57.3 |
VLA-JEPA는 Google Robot과 WidowX Robot 각각에서 4개 과제 중 2개에서 최고 성적이다. Google Robot 평균은 65.2%로 가장 높고, 두 번째인 RoboVLMs(51.7%)를 13.5%p 앞선다. WidowX Robot 평균은 57.3%로 LAPA*와 같은 값이다.
논문은 SimplerEnv에서 로봇 데이터 품질이 성능을 크게 좌우한다고 분석한다. SimplerEnv는 전문가 시연 데이터를 제공하지 않으므로 각 방법이 어떤 데이터로 post-training했는지가 결과를 가른다. LAPA는 SimplerEnv에서 성공한 rollout만 뽑아 전문가 시연 데이터로 쓰는데, 100개 rollout만으로도 real-to-sim 격차가 줄어 WidowX에서 높은 성적을 낸다. villa-X는 대규모 로봇 데이터와 사람 영상으로 학습했다. 반면 VLA-JEPA와 UniVLA, RoboVLMs, Moto는 villa-X가 쓴 학습 데이터의 1% 미만을 쓰며, 그중 VLA-JEPA가 가장 경쟁력 있는 결과를 냈다.
사람 영상을 뺀 변형이 Google Robot에서 평균 78.4%로 본 모델(65.2%)보다 13.2%p 높다는 점은 뒤의 분석 절에서 다룬다.
LIBERO-Plus
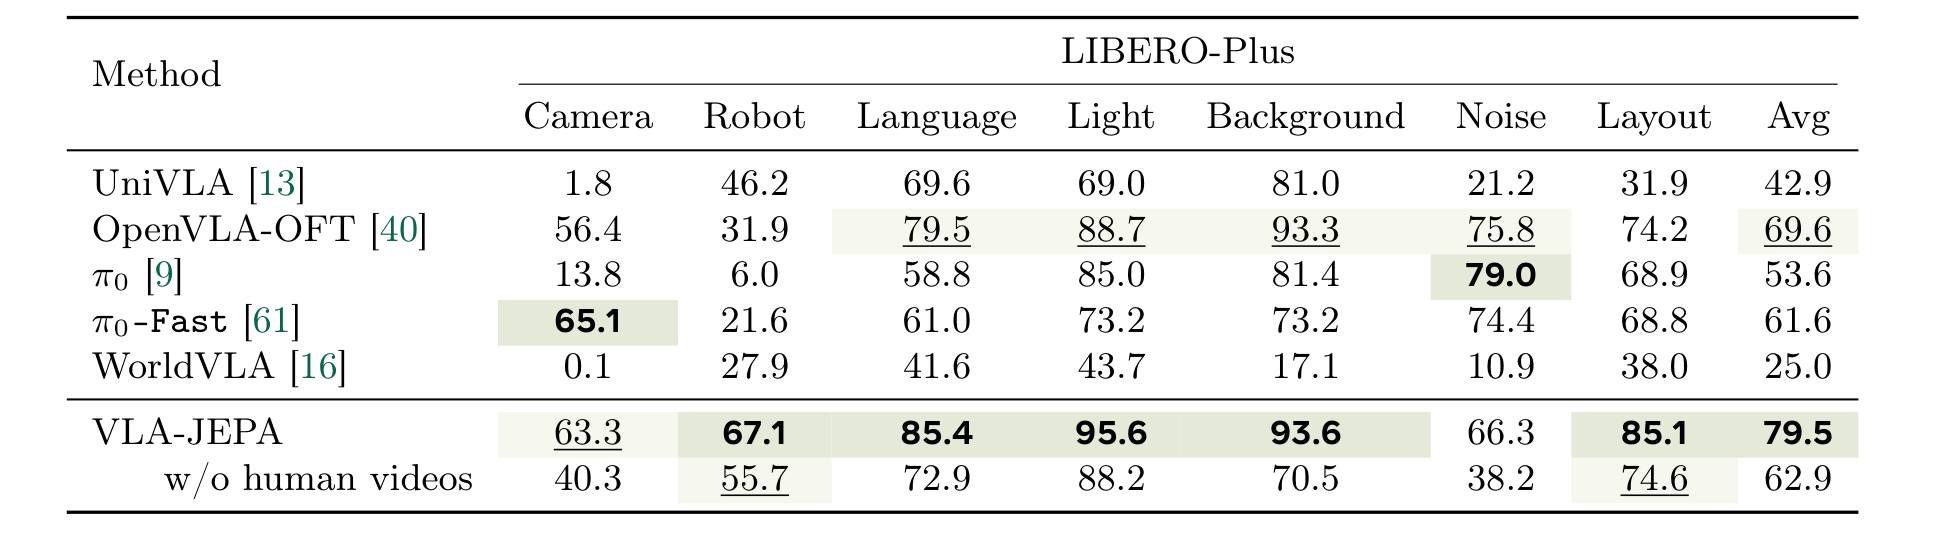
perturbation 항목마다 LIBERO 4개 suite 전체의 평균 성공률을 보고한다.
| 방법 | Camera | Robot | Language | Light | Background | Noise | Layout | 평균 |
|---|---|---|---|---|---|---|---|---|
| UniVLA | 1.8 | 46.2 | 69.6 | 69.0 | 81.0 | 21.2 | 31.9 | 42.9 |
| OpenVLA-OFT | 56.4 | 31.9 | 79.5 | 88.7 | 93.3 | 75.8 | 74.2 | 69.6 |
| π0 | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.9 | 53.6 |
| π0-Fast | 65.1 | 21.6 | 61.0 | 73.2 | 73.2 | 74.4 | 68.8 | 61.6 |
| WorldVLA | 0.1 | 27.9 | 41.6 | 43.7 | 17.1 | 10.9 | 38.0 | 25.0 |
| VLA-JEPA | 63.3 | 67.1 | 85.4 | 95.6 | 93.6 | 66.3 | 85.1 | 79.5 |
| VLA-JEPA (사람 영상 제외) | 40.3 | 55.7 | 72.9 | 88.2 | 70.5 | 38.2 | 74.6 | 62.9 |
VLA-JEPA는 7개 항목 중 Robot, Language, Light, Background, Layout의 5개에서 최고이고 평균 79.5%로 두 번째인 OpenVLA-OFT(69.6%)를 9.9%p 앞선다. Camera(63.3%)는 π0-Fast(65.1%)에 이어 두 번째이고, Noise(66.3%)는 π0(79.0%)와 OpenVLA-OFT(75.8%)보다 낮다.
같은 LIBERO 데이터로 학습했는데도 in-distribution인 Table 1과 격차가 크게 벌어진다. LIBERO 평균에서 OpenVLA-OFT와 VLA-JEPA의 차이는 0.1%p인데 LIBERO-Plus에서는 9.9%p다. π0는 LIBERO 94.2%에서 LIBERO-Plus 53.6%로 크게 하락하며 특히 Robot 항목에서 6.0%다. UniVLA는 Camera 항목에서 1.8%로 거의 동작하지 않는다.
논문은 이 결과를 두 가지로 해석한다. 첫째, latent action이 텍스트 데이터에 견줄 만한 world knowledge 표현을 갖췄다는 근거로 본다. 둘째, Language, Light, Background, Layout에서의 우위는 latent action이 과제와 무관한 교란을 처리한다는 증거이며, 이것이 더 robust하고 일반화된 policy로 이어진다고 본다.
실제 로봇 실험
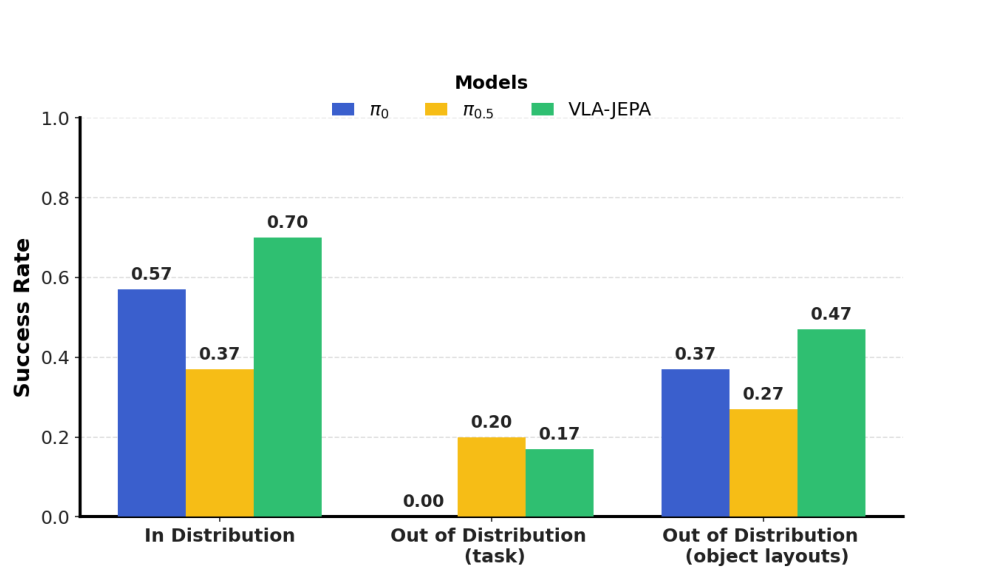
하드웨어는 Franka Research 3 팔, Robotiq 2F-85 그리퍼, Intel RealSense D435 카메라 3대(3인칭 2대, 손목 1대)다. 학습용 시연 데이터 100개는 포도, 사과, 망고, 오렌지를 탁자에서 접시나 그릇으로 옮기는 pick-and-place 3개 과제에서 모았다. 과제마다 10회 독립 시행의 평균 성공률을 보고하며, 공정한 비교를 위해 π0와 π0.5도 같은 시연 데이터로 fine-tuning했다.
in-distribution 평가 외에 두 가지 OOD 프로토콜을 둔다.
| 프로토콜 | 내용 | 검증 목적 |
|---|---|---|
| task OOD | 학습 데이터에 없는 과제 수행. 바나나를 그릇에, 복숭아를 접시에, 포도를 선반 맨 위 칸에 옮기기 | 기본 skill의 습득과 전이 |
| object layout OOD | 학습에 쓴 3개 과제를 골라 물체 배치를 무작위로 섞기 | 어수선한 탁상 환경에서의 robustness |
| 설정 | π0 | π0.5 | VLA-JEPA |
|---|---|---|---|
| in-distribution | 0.57 | 0.37 | 0.70 |
| task OOD | 0.00 | 0.20 | 0.17 |
| object layout OOD | 0.37 | 0.27 | 0.47 |
VLA-JEPA는 in-distribution과 object layout OOD에서 최고이고 task OOD에서는 π0.5에 이어 두 번째다. 논문은 배포 중 관찰한 정성적 차이를 함께 적는다.
- π0.5는 지시문을 따라 대상 물체에 접촉하는 정확도가 VLA-JEPA보다 높다. 그러나 위치 제어가 로봇 팔의 안전 경계를 자주 넘어 실행에 실패한다.
- VLA-JEPA는 텍스트 지시문에 대한 세밀한 추론이 부족해 명령과 다른 물체를 집는 경향이 있다. 반면 안전 제약을 어기는 일은 드물고 실행 trajectory가 훨씬 안정적이다.
- VLA-JEPA는 grasping 실패 후 그리퍼를 다시 열어 재시도하는 반복 grasping을 익혔다. π0와 π0.5에서는 관찰되지 않은 동작이다.
부록 B의 과제별 관찰은 다음과 같다.
| 과제 | 관찰 |
|---|---|
| 바나나를 그릇에 | π0.5와 VLA-JEPA 모두 약 50% 성공률 |
| 복숭아를 접시에 | 불규칙한 모양 때문에 로봇이 안전 경계를 자주 침범한다 |
| 포도를 선반 맨 위 칸에 | 학습 데이터에 선반이 없어 세 모델 모두 end-effector를 맨 위 칸에 놓지 못했다. π0와 π0.5는 선반에 직접 충돌한 반면 VLA-JEPA는 선반 뒤쪽에서 접근해 end-effector를 더 높이 들어 올렸다 |
| object layout OOD | π0와 π0.5는 grasping 실패 후 그리퍼를 열지 않고 멈춘다. 학습 데이터에 재시도 시연이 없기 때문이다. VLA-JEPA는 곧바로 그리퍼를 열고 다시 시도한다 |
논문은 반복 grasping을 사람 영상 pre-training의 핵심 이점으로 본다. 로봇 시연 데이터에는 실패 후 재시도 장면이 드물지만 사람 영상에는 흔하다. 반복 grasping은 추가 물리 dynamics를 배우는 문제가 아니라 언제 다시 잡을지를 배우는 문제이며, 그 시점 판단을 익히면 policy가 자기 dynamics로 옮겨 실행할 수 있다는 것이 논문의 주장이다.
분석
사람 영상의 역할
세 벤치마크에서 사람 영상 pre-training의 효과는 시나리오에 따라 다르다.
| 벤치마크 | 시나리오 | 사람 영상 포함 | 사람 영상 제외 | 차이 |
|---|---|---|---|---|
| LIBERO 평균 | in-distribution | 97.2% | 96.1% | +1.1%p |
| SimplerEnv Google 평균 | real-to-sim OOD | 65.2% | 78.4% | -13.2%p |
| SimplerEnv WidowX 평균 | real-to-sim OOD | 57.3% | 57.3% | 0 |
| LIBERO-Plus 평균 | perturbation OOD | 79.5% | 62.9% | +16.6%p |
LIBERO와 SimplerEnv에서는 사람 영상을 빼도 성능이 크게 떨어지지 않고, SimplerEnv Google Robot에서는 오히려 뺀 쪽이 높다. 논문은 in-distribution과 real-to-sim OOD에서는 고품질 전문가 시연 데이터가 사람 영상보다 중요하다고 해석한다.
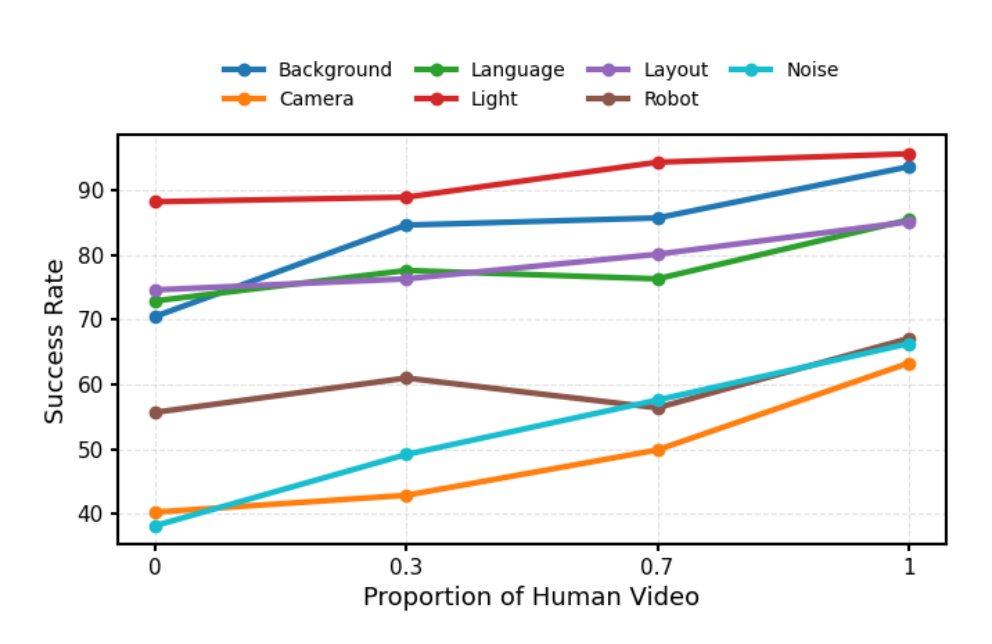
반면 LIBERO-Plus에서는 사람 영상이 평균을 16.6%p 끌어올린다. 항목별로 보면 Camera가 40.3%에서 63.3%로, Noise가 38.2%에서 66.3%로, Background가 70.5%에서 93.6%로 오른다. 논문의 해석은 사람 영상에 action trajectory 정보가 없어 로봇 action의 물리 dynamics를 직접 배울 수는 없고, 대신 반복 grasping 같은 기존 skill의 robustness와 안정성을 높이는 것이 주된 효과라는 것이다. 사람이 영상을 보고 skill을 배울 때 첫 시도는 실패하고 반복 시도로 영상 지식과 물리 dynamics의 대응을 세워 가는 과정과 닮았다고 설명한다.
Figure 5는 pre-training 데이터의 사람 영상 비율을 0, 0.3, 0.7, 1로 늘렸을 때 LIBERO-Plus 항목별 성공률 변화를 보인다. 비율이 오를수록 robustness가 일관되게 개선되며, 논문은 이를 사람 영상이 새 action 실행 능력을 더하는 것이 아니라 기존 skill 목록을 강화한다는 가설의 근거로 든다.
attention 시각화
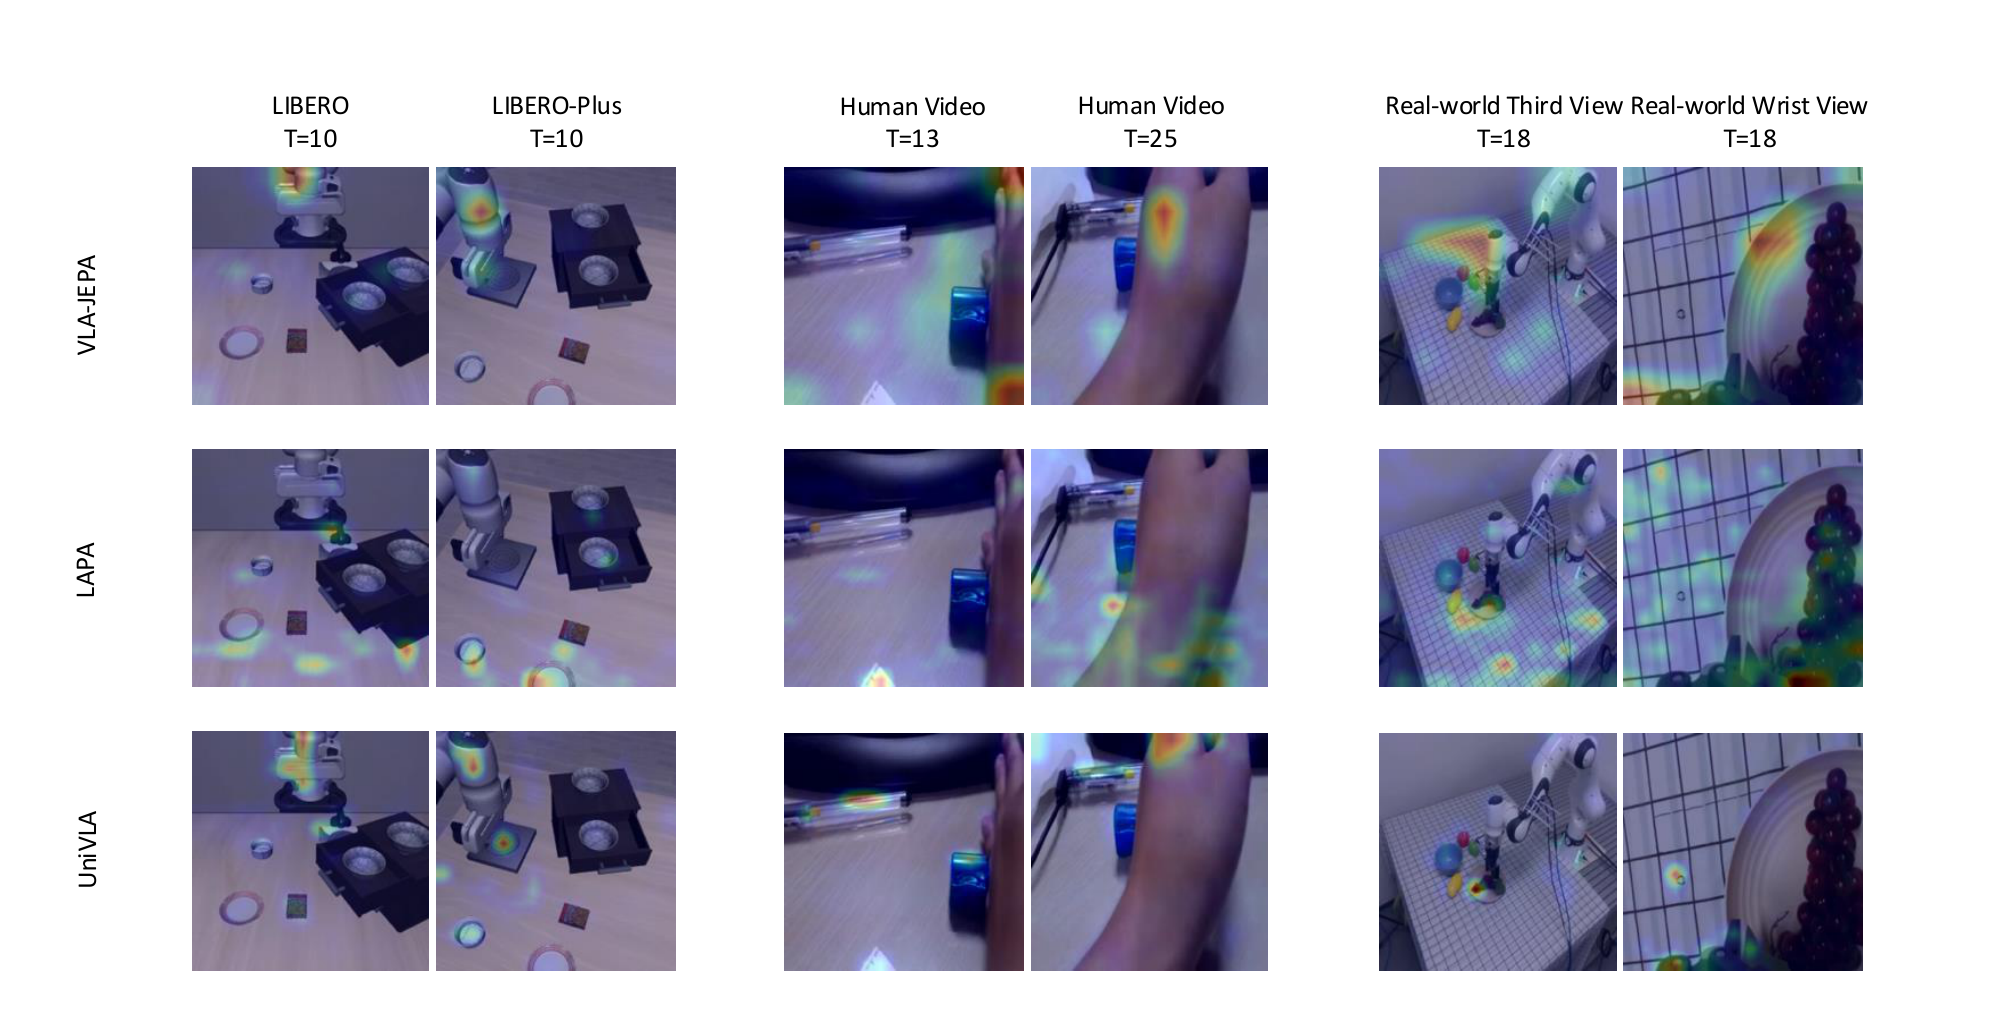
통합 pre-training은 기존 2단계 pre-training 패러다임을 일관되게 앞선다. latent action 토큰이 담는 정보를 보기 위해 LAPA, UniVLA, VLA-JEPA 세 모델의 내부 attention 맵에서 latent action 토큰이 이미지 토큰에 주는 가중치를 시각화했다. 입력은 시뮬레이션, 사람 영상, 실제 로봇 이미지의 세 종류다. 공정한 비교를 위해 세 모델 모두 시뮬레이션과 실제 데이터에 fine-tuning하지 않은 pre-training 체크포인트만 썼다.
| 모델 | attention 양상 | 논문의 해석 |
|---|---|---|
| LAPA | 지나치게 조밀한 시각 정보에 집중해 탁상의 무관한 물체까지 포함한다 | pre-training 단계의 정보 누출로 latent action이 목표 이미지의 압축 표현으로 퇴화했다 |
| UniVLA | 과제 관련 텍스트 안내로 LAPA의 문제를 완화하지만 의미를 과도하게 강조해 사람 영상의 정지된 펜이나 실제 손목 시점의 식탁보 질감 같은 배경 요소를 본다 | 의미 편향 |
| VLA-JEPA | 로봇 팔, 손, 조작 대상 물체에 집중한다 | 통합 pre-training이 과제와 무관한 정보의 영향을 줄인다 |
미래 영상 horizon
latent action 토큰 수는 항상 프레임 수에서 1을 뺀 값이므로 미래 영상 horizon T가 latent action 토큰 수를 정한다. T를 4, 8, 16으로 바꾸고 다른 하이퍼파라미터를 고정한 채 LIBERO에 바로 fine-tuning했다.
| T | Spatial | Object | Goal | LIBERO-10 | 평균 |
|---|---|---|---|---|---|
| 4 | 95.0 | 99.2 | 95.8 | 89.0 | 94.8 |
| 8 | 94.8 | 99.8 | 95.8 | 94.0 | 96.1 |
| 16 | 92.8 | 98.8 | 98.0 | 92.2 | 95.5 |
영상 horizon이 미리 정한 action horizon(7)에 가까운 T = 8일 때 평균이 가장 높다. 논문은 이를 latent action이 embodied action 생성에 유효하다는 근거로 든다. T가 너무 작으면 부호화되는 정보가 부족해 특히 long-horizon 과제인 LIBERO-10에서 89.0%로 낮고, T가 너무 크면 중복 정보가 들어와 목표가 단순한 Goal suite에서는 98.0%로 최고지만 세밀한 manipulation이 필요한 Spatial suite에서는 92.8%로 가장 낮다.
한계
논문이 명시한 한계와 관찰은 다음과 같다.
- VLA-JEPA는 텍스트 지시문에 대한 세밀한 추론이 부족해 실제 로봇에서 명령과 다른 물체를 집는 경향이 있다. task OOD 성공률도 π0.5(0.20)보다 낮은 0.17이다.
- 사람 영상 pre-training은 새 action 실행 능력을 더하지 못하고 기존 skill의 robustness를 높이는 데 그친다. in-distribution과 real-to-sim OOD에서는 사람 영상보다 고품질 전문가 시연 데이터가 성능을 좌우한다.
- 선반처럼 학습 데이터에 없는 구조물이 등장하는 과제는 세 모델 모두 완수하지 못했다.
- LIBERO-Plus의 Noise 항목에서는 π0와 OpenVLA-OFT보다 낮다.
- 결론에서 밝힌 향후 방향은 사람 영상 pre-training 패러다임을 로봇 데이터와 텍스트 기반 추론 데이터로 확장해 일반화와 robustness를 더 높이는 것이다.
자료에 기술이 없어 확인할 수 없는 점은 다음과 같다.
- β와 K 같은 하이퍼파라미터의 실제 값과 민감도 실험이 없다. K = 24 / T 공식만 부록에 있다.
- 실제 로봇 결과의 시행 횟수가 과제당 10회로 적어 통계적 유의성을 논하기 어렵다.
- Table 2의 본문 서술과 표 수치가 어긋난다. 본문은 villa-X가 WidowX Robot에서 최고 평균 성공률을 냈다고 적지만 표에서 villa-x의 WidowX 평균은 40.8이고 최고값 57.3은 LAPA와 VLA-JEPA다. 또 VLA-JEPA가 WidowX에서 두 번째로 높다고 적지만 표에서는 LAPA와 동률 1위다.
- 학습에 쓴 사람 영상은 Something-Something-v2 한 종류다. 야외 영상이나 egocentric 대규모 데이터셋에서도 같은 효과가 나는지는 검증되지 않았다.
- 추론 속도, 파라미터 수 대비 효율, action head의 4단계 denoising이 실시간 제어에 충분한지에 대한 서술이 없다.
- 프로젝트 페이지의 초록은 "sample efficiency and generalization"에서의 이득을 말하고 arXiv v2 초록은 "generalization and robustness"를 말한다. sample efficiency를 직접 잰 실험은 논문에 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| leakage-free state prediction | 미래 프레임을 예측기 입력이 아니라 학습 목표를 만드는 데만 써서 latent action이 미래 자체를 부호화하는 지름길을 막는 VLA-JEPA의 핵심 설계 |
| latent predictive alignment | 픽셀 재구성 대신 예측 latent 상태와 목표 latent 상태를 맞추는 JEPA 방식의 학습 목표 |
| latent world model | 상태 시퀀스와 latent action을 받아 다음 상태 chunk를 예측하는 autoregressive Transformer. time-causal attention을 쓴다 |
| time-causal attention | 같은 시점 안에서는 양방향 full attention, 시점 사이에서는 과거만 보는 causal attention을 결합한 마스킹 방식 |
| ⟨latent_i⟩ 토큰 | i번째 시점의 상태 전이를 요약하도록 VLM 어휘에 추가한 학습 가능한 latent action 토큰. K = 24 / T번 반복해 넣는다 |
| LIBERO-Plus | LIBERO 4개 suite에 Camera, Robot, Language, Light, Background, Noise, Layout 7종 perturbation을 가해 VLA의 robustness를 검사하는 벤치마크 |
관련 페이지
- VLA-JEPA: Enhancing Vision-Language-Action Model with Latent World Model (프로젝트 페이지): 같은 논문의 공식 프로젝트 페이지. 고해상도 도식과 시연 영상 안내
- VLA-JEPA (ginwind/VLA-JEPA, GitHub repo): 공식 코드 저장소. 학습과 세 벤치마크 평가 절차, starVLA 기반 구조
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: world-action model 계보 해설. latent action 계열과 V-JEPA 2 latent world model 방향을 함께 짚는다
- World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA): 같은 해설의 한국어 번역. 비디오 backbone으로 policy를 학습하는 두 번째 레시피
- World Model for Robot Learning: A Comprehensive Survey: 로봇 학습용 world model survey. LAPA, UniVLA 등 latent action 계열의 위치
- A Comprehensive Survey on World Models for Embodied AI: world model survey. JEPA 계보와 V-JEPA 2의 자리
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: GR-1. 사람 영상에서 미래 프레임을 픽셀로 예측하는 video generative pre-training으로, VLA-JEPA가 대비하는 픽셀 수준 목적 함수의 대표
- π0: A Vision-Language-Action Flow Model for General Robot Control: π0. flow matching action head의 원형이자 실제 로봇 비교 대상
- π0.5: a Vision-Language-Action Model with Open-World Generalization: π0.5. LIBERO와 실제 로봇 비교 대상
- OpenVLA: An Open-Source Vision-Language-Action Model: OpenVLA. LIBERO와 LIBERO-Plus 비교 대상인 OpenVLA-OFT의 기반
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: GR00T N1. LIBERO와 SimplerEnv 비교 대상
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: LIBERO 벤치마크를 실패 복구 관점으로 확장한 연구. 반복 grasping 관찰과 연결된다
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System: HiVLA. VLA-JEPA 코드의 기반인 starVLA 코드베이스를 비교 대상으로 쓴 논문
- Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models: LaRA-VLA. 다음 프레임 visual latent 예측을 EMA 목표 인코더로 감독하고 텍스트 CoT까지 latent로 내재화한 VLA. 미래 latent 예측을 쓴다는 점에서 비교된다
- H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning: H-JEPA. 같은 JEPA 계열 latent 예측을 여러 시간 척도의 계층으로 쌓아 planning에 쓰는 world model