Physical AI · ARTICLE · 2025
WALL-OSS: Igniting VLMs toward the Embodied Space (X Square Robot 프로젝트 페이지)
요약
WALL-OSS 논문의 공식 프로젝트 페이지다. X Square Robot이 2025년 9월 논문 공개에 맞춰 x2robot.com에 올린 소개 페이지로, 논문 abstract를 거의 그대로 옮기고 핵심 도식 세 개를 실으며 평가 과제의 실행 장면을 26편의 영상으로 보여 준다.
이 페이지에는 논문에 없는 새 주장이나 새 수치가 없다. 추출된 산문은 abstract를 포함해 3,300자 안팎이고, EVALUATE와 Model과 DATA 세 절은 논문 문장을 줄여 적은 것이다. 그럼에도 이 페이지를 따로 보관하는 이유는 영상에 있다. 논문이 정지 프레임 몇 장으로 보여 주는 실행 과정을 이 페이지는 총 11분 46초 분량의 영상으로 보여 주며, 로봇이 실제로 어느 속도로 얼마나 매끄럽게 움직이는지는 이 영상으로만 확인된다.
배경
WALL-OSS 자료는 저장소 안에서 네 편으로 나뉘어 있고 각각 맡는 범위가 다르다. 아키텍처와 실험 수치는 논문 페이지가 담당하므로, 이 페이지는 회사가 대중 앞에 무엇을 골라 내놓았는지를 기록하는 자리로 쓴다.
| 자료 | 맡는 범위 |
|---|---|
| 논문 | 아키텍처, 학습 커리큘럼, 전체 실험표, 한계 |
| 프로젝트 페이지 | 공개 요약, 데모 영상, 도식 세 개 |
| wall-x 저장소 | 코드 |
| 한국어 해설 | 논문을 수식 단위로 푼 입문 글 |
논문은 2025년 9월 8일 자로 코드 주소와 이 프로젝트 페이지 주소를 함께 싣는다. 즉 세 자료가 같은 시점에 한 묶음으로 공개된 것이고, 프로젝트 페이지는 그중 대중 공개 창구에 해당한다.
핵심 개념
WALL-OSS는 vision-language model을 로봇 영역으로 옮길 때 생기는 불일치를 정면으로 다루는 embodied foundation model이다. abstract가 지목하는 불일치는 modality, pre-training 데이터 분포, 학습 목적함수 세 가지이며, 그 결과 action의 이해와 생성이 병목으로 남는다고 본다.
Unified Cross-Level CoT는 이 페이지가 모델의 핵심으로 내세우는 이름이다. 지시문(instruction) 추론과 subgoal 분해와 세밀한 action 합성을 하나의 미분 가능한 틀 안에서 함께 처리한다는 뜻이며, 여기서 subtask는 상위 추론이 텍스트로 내놓는 중간 단계 명령을 말한다.
학습은 Inspiration과 Integration 두 단계로 나뉜다. 앞 단계에서 쓰이는 embodied VQA는 로봇 시점 이미지에 대해 조작 가능성이나 다음 단계를 묻고 답하게 하는 질의응답 과제다. 같은 단계에서 쓰이는 FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이며, action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음을 뜻한다.
뒤 단계인 Integration은 flow matching으로 고빈도 연속 제어를 학습한다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다.
co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. 이 페이지가 Overall 절에서 유일하게 강조하는 결론이 바로 co-training의 효과다.
페이지 구성
abstract
abstract는 WALL-OSS가 대규모 멀티모달 pre-training으로 세 가지를 달성했다고 적는다.
- embodiment를 인지하는 vision-language 이해
- 언어와 action 사이의 강한 연결
- 견고한 manipulation 능력
이어서 결과 문장은 긴 호흡의 manipulation에서 높은 성공률을 보였고 지시 이행 능력이 강하며 여러 baseline을 앞선다고 정리한다. 논문 abstract와 견주면 두 군데가 다른데, 자세한 비교는 아래 "논문과 어긋나는 대목" 절에 표로 두었다.
평가 과제와 데모 영상
EVALUATE 절은 여섯 개의 manipulation 과제를 설계했다고 밝힌다. 그중 set-table, tidy-bedroom, place-by-color 세 과제는 pre-training에서 본 적 없는 새 과제이며, 새 과제에 대한 적응 능력을 재려고 넣은 것이다.
영상은 세 묶음으로 나뉘어 있다. 묶음마다 편수와 길이 분포가 뚜렷하게 다르고, 이 차이 자체가 회사가 각 능력을 어떻게 보여 주려 했는지를 드러낸다.
| 묶음 | 편수 | 총 길이 | 평균 길이 |
|---|---|---|---|
| Reasoning | 11편 | 5분 9초 | 약 28초 |
| Long-Horizon Planning and Action Robustness | 5편 | 3분 50초 | 46초 |
| Instruction Following | 10편 | 2분 47초 | 약 17초 |
| 합계 | 26편 | 11분 46초 | 약 27초 |
긴 호흡의 계획 능력을 보여 주는 묶음은 편수가 가장 적은 대신 한 편이 가장 길고, 최장 영상은 1분 8초다. 반면 지시 이행 묶음은 편수가 많고 한 편이 짧으며 최단 영상은 4초다. 즉 앞 묶음은 하나의 과제를 끝까지 따라가는 데 목적이 있고, 뒤 묶음은 지시를 바꿔 가며 반응이 달라지는 장면을 여러 번 보여 주는 데 목적이 있다.
영상은 수집 대상이 아니었으므로 raw/에는 남아 있지 않다. 따라서 동작 속도나 실패 양상을 확인하려면 원 URL을 직접 열어야 한다.
모델 구조
Model 절의 본문은 세 문장으로 끝난다. backbone이 Qwen2.5-VL-3B라는 것, 입력이 1인칭 카메라와 팔에 달린 카메라의 영상과 텍스트 지시문이라는 것, 출력이 학습 단계에 따라 달라지되 입력 구성은 내내 같다는 것이다. 페이지는 이 모델 이름을 QwenVL2.5-3B로 적어 논문 표기와 순서가 다르다.
구조의 실제 내용은 본문이 아니라 도식이 담고 있다.
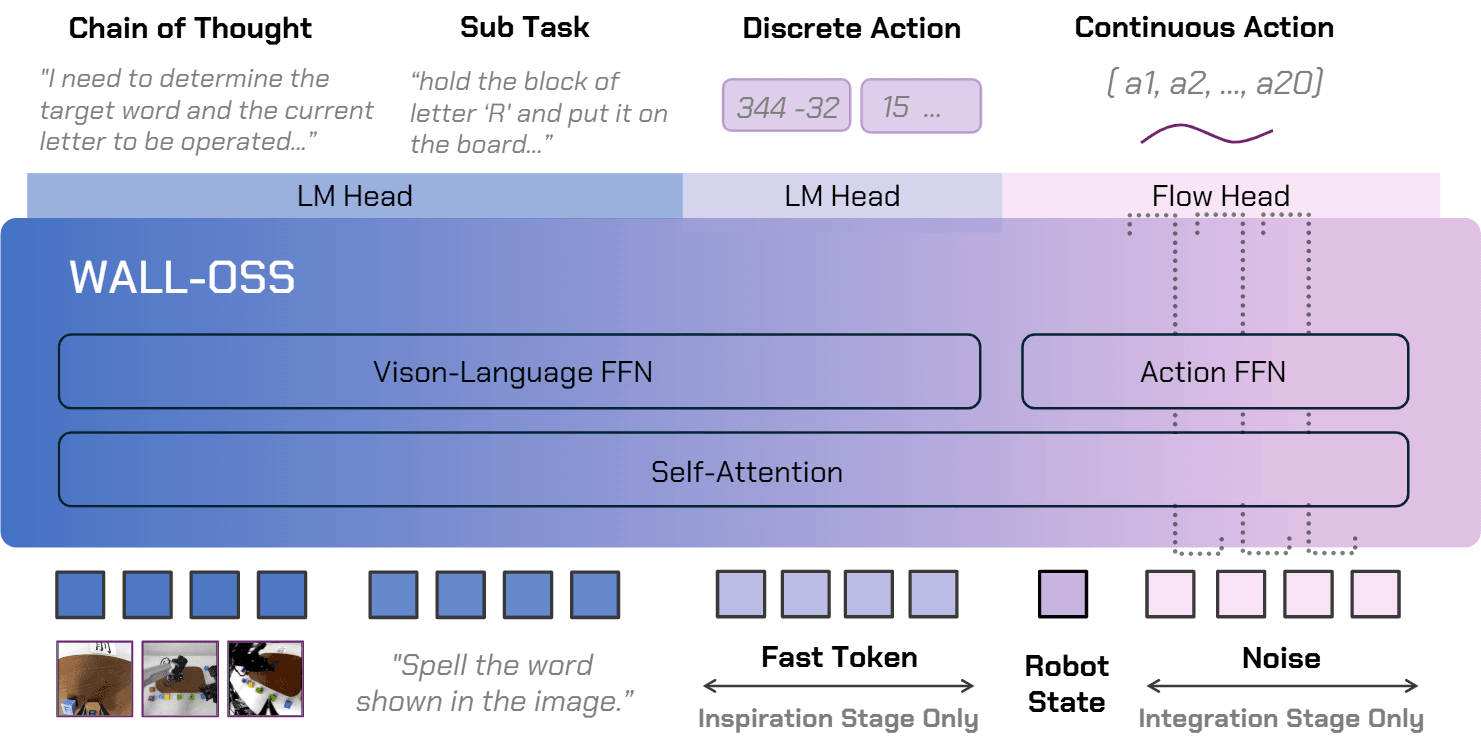
도식에서 읽히는 설계는 세 가지다. 첫째로 Self-Attention은 하나만 두고 FFN만 vision-language용과 action용으로 나눈다. 둘째로 출력 head가 둘이어서 LM Head는 Chain of Thought와 Sub Task와 이산 action을, Flow Head는 a1부터 a20까지 20스텝 연속 action을 낸다. 셋째로 입력 토큰 중 Fast Token은 Inspiration 단계에서만, Robot State와 Noise는 Integration 단계에서만 쓰인다.
이 modality별 경로 분리가 static router에 해당한다. static router는 입력 종류에 따라 처리 경로를 고정 규칙으로 나누는 분기 장치다. 다만 페이지 본문은 이 분기 구조도 mixture-of-experts 구성도 설명하지 않으므로, 구조를 이해하려면 도식을 직접 보거나 논문 페이지로 가야 한다.
도식에 실린 예시도 Unified Cross-Level CoT가 어떤 모습인지 보여 준다. 지시문은 "Spell the word shown in the image."이고, 모델은 목표 단어와 현재 다룰 글자를 정해야 한다는 Chain of Thought를 낸 뒤 글자 R 블록을 집어 보드에 놓으라는 Sub Task로 내려가고, 마지막에 이산 action과 연속 action으로 이어진다.
학습 데이터
DATA 절은 embodiment 중심의 다원 데이터셋을 구성한 이유로 두 가지를 든다. 대규모로 정렬된 VLA 감독 데이터가 부족하다는 점과 현재 vision-language model의 공간 이해가 부족하다는 점이다.
데이터는 세 부분으로 나뉘며 각각 맡는 목적이 다르다.
| 구성 | 목적 |
|---|---|
| 자체 수집 robot action 데이터 | 높은 품질과 과제 복잡도 확보 |
| open-source action 데이터 | 서로 다른 형상과 환경에 대한 generalization |
| 멀티모달 VQA 데이터 | 언어와 시각 능력 유지 및 공간과 시간 추론 감독 추가 |
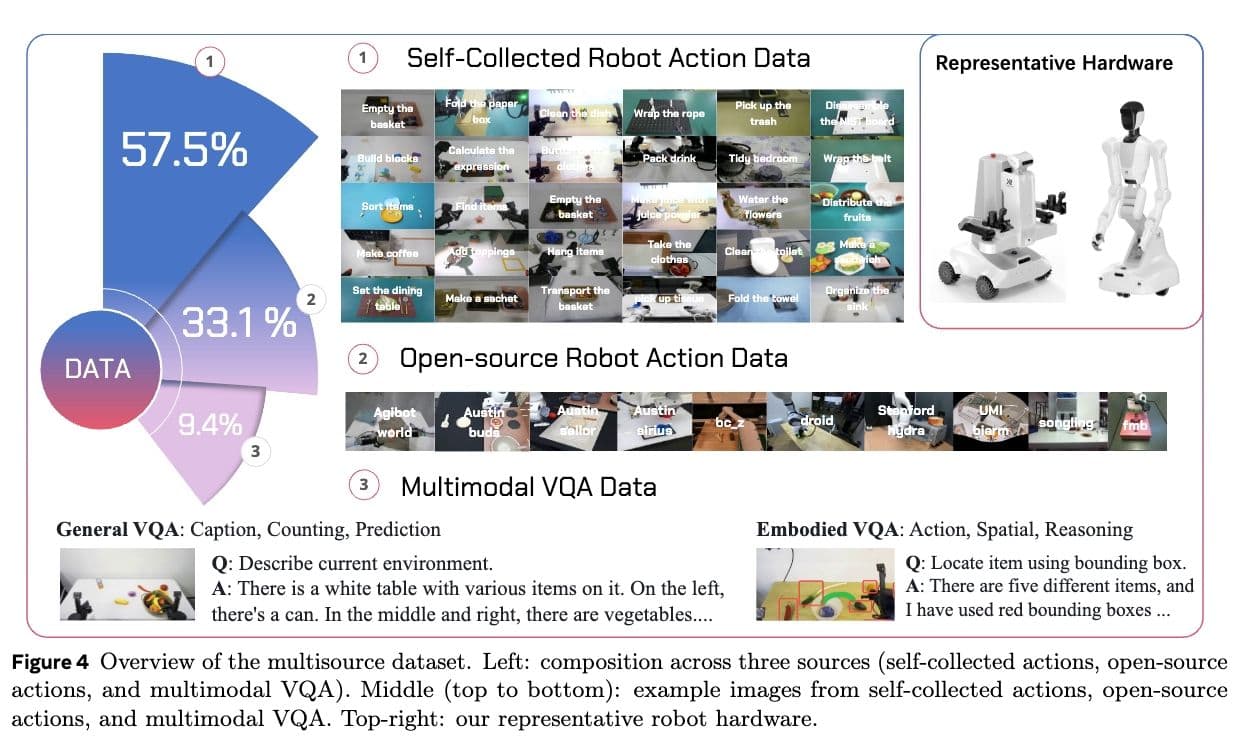
도식은 본문이 비율을 밝히지 않은 세 부분의 구성비를 보여 준다. 자체 수집 데이터가 57.5%로 가장 크고, open-source action이 33.1%, 멀티모달 VQA가 9.4%다. 즉 절반 이상이 회사가 직접 모은 데이터이고, VQA는 열에 하나 정도로 섞여 있다.
도식은 원천의 이름도 함께 적는다. open-source 쪽에는 Agibot world, Austin buds, Austin sailor, Austin sirius, bc_z, droid, Stanford hydra, UMI, songling, fmb가 나열되고, VQA 쪽은 캡션과 개수 세기와 예측을 다루는 General VQA와 action, 공간, 추론을 다루는 embodied VQA로 갈린다.
corpus 규모에 대해 페이지는 수만 시간을 넘는다고 적는다. 이 표현은 논문의 서술과 어긋나므로 아래 절에서 따로 다룬다.
두 단계 커리큘럼의 역할 분담은 논문과 같게 적혀 있다. Inspiration은 embodied VQA와 지시 이행과 FAST 기반 이산 action prior로 vision-language model에 대략의 action 인지를 넣으면서 공간 추론을 끌어올린다. Integration은 실제 trajectory와 정규화된 open-source trajectory 위에서 flow matching으로 고빈도 연속 제어를 학습하되, 먼저 action 분기만 학습한 뒤 vision-language model과 함께 최적화해 정렬을 조이고 망각을 줄인다.
co-training 결론
Overall 절은 한 문단뿐이며 멀티모달 co-training의 효과를 결론으로 내세운다. co-training이 세밀한 지시 이행 능력을 크게 높이고, pre-training 단계가 멀티모달 action 정렬의 바탕을 만들며, fine-tuning 단계까지 이 전략을 유지하면 지시에 근거한 실행 능력이 더 커진다는 내용이다.
수치는 도식 하나로만 제시된다. in-distribution 6과제와 out-of-distribution 4과제에 대해 WALL-OSS와 π0와 diffusion policy를 견주는 막대이며, 논문 Figure 7과 같은 그림이다. 이 페이지에는 표가 하나도 없으므로 과제별 수치와 해석은 Igniting VLMs toward the Embodied Space에서 확인한다.
논문과 어긋나는 대목
프로젝트 페이지와 논문을 대조하면 네 군데가 다르다. 어느 것도 큰 주장의 차이는 아니지만, 이 페이지를 인용할 때는 논문 쪽 표기를 따르는 편이 안전하다.
| 항목 | 프로젝트 페이지 | 논문 |
|---|---|---|
| corpus 규모 | 수만 시간을 넘는다 | 10,000시간을 넘는다 |
| abstract 성과 나열 | 지시 이행 능력 다음에 곧바로 baseline 우위로 넘어간다 | 사이에 복잡한 이해와 추론이 한 항목 더 있다 |
| abstract 결론부 | vision-language model에서 VLA embodied foundation model로 가는 경로 | vision-language model에서 embodied foundation model로 가는 경로 |
| 데이터 도식 라벨 | 이미지에 Figure 4로 인쇄되어 있다 | 최종본에서는 Figure 5다 |
corpus 규모의 차이가 가장 눈에 띈다. 같은 수치를 다르게 반올림한 것인지, 페이지가 더 나중 시점의 규모를 적은 것인지는 두 자료만으로 판단할 수 없다.
데이터 도식의 라벨 차이는 페이지가 논문 최종본보다 앞선 버전의 그림을 그대로 올렸음을 뜻한다. 이미지 안에 인쇄된 캡션이 "Figure 4 Overview of the multisource dataset"인 반면, 논문 본문에서 같은 그림은 Figure 5로 번호가 매겨져 있다.
한계
이 자료 자체의 한계는 한계 서술이 통째로 없다는 점이다. 논문 6.2절이 다루는 3D 데이터 희소성, 정밀 manipulation에서 π0가 앞선다는 자기 평가, 계획 감독이 전체 프레임의 1%에 그친다는 점이 모두 빠져 있다. 홍보용 페이지의 성격상 예상되는 누락이지만, 이 자료만 보고 모델의 약점을 판단해서는 안 된다.
정량 자료도 얇다. 표가 하나도 없고 수치는 막대 도식 하나로만 제시되므로, 과제별 성능을 정확히 읽으려면 논문을 봐야 한다.
페이지 고유 자산인 영상이 저장소에 남아 있지 않은 것도 한계다. 수집 범위가 텍스트와 정지 이미지였으므로, 영상의 내용은 위 표의 편수와 길이 정보로만 간접 확인된다.
수집 메모
추출된 본문은 26,000자를 넘지만 실제 산문은 3,300자 안팎이다. 나머지는 영상 26편 각각에 딸린 자막 설정 UI 문자열이 그대로 반복된 것이다.
사이트 제목 태그가 "X Square Official Site X Square Robot WALL-A Large Operating Model Robot"이어서 추출기가 잡은 제목도 페이지 내용과 어긋났고, frontmatter의 title은 실제 내용에 맞춰 다시 적었다.
추출된 본문에는 링크가 하나도 남아 있지 않고 도식 세 개의 이미지 주소만 남았다. 따라서 코드 저장소 주소는 이 페이지의 추출본이 아니라 논문 첫 장에 실린 주소를 근거로 삼는다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Unified Cross-Level CoT | 지시문 추론과 subgoal 분해와 세밀한 action 합성을 하나의 미분 가능한 틀 안에서 처리하는 구성. 페이지가 모델의 핵심으로 내세우는 이름이다 |
| embodied VQA | 로봇 시점 이미지에 대해 조작 가능성이나 다음 단계를 묻고 답하게 하는 질의응답 과제. Inspiration 단계의 주요 데이터다 |
| FAST tokenizer | action chunk를 압축해 이산 토큰으로 적는 방식. Inspiration 단계에서 이산 action prior를 만드는 데 쓰인다 |
| flow matching | noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법. Integration 단계의 고빈도 연속 제어가 이 방식을 쓴다 |
| static router | 입력 종류에 따라 처리 경로를 고정 규칙으로 나누는 분기 장치. 도식의 FFN 분리가 여기 해당하지만 페이지 본문에는 설명이 없다 |
| co-training | 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식. Overall 절이 유일하게 내세우는 결론이다 |
| WALL-A | 논문 도식에서 WALL-OSS 구조를 가리킬 때만 쓰인 이름. 사이트 제목 태그에도 "WALL-A Large Operating Model"로 남아 있다 |
관련 페이지
- Igniting VLMs toward the Embodied Space: 이 페이지가 요약하는 원문. 아키텍처, 전체 실험표, 한계는 모두 논문 페이지에 있다.
- Wall-X: Building General-Purpose Robots Based on Embodied Foundation Model: 논문 첫 장에서 코드 주소로 연결되는 저장소.
- 03-11. WALL-OSS - 모두의 로보틱스 - VLA 입문: 같은 논문을 수식 단위로 푼 한국어 입문 해설.
- Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere: 후속 모델. 프로젝트 페이지 주소가 x2robot.com/en/oss로 따로 있다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.