Physical AI · ARTICLE · 2026
τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation
요약
τ0-VLA 연구진이 논문과 함께 2026년 7월 27일에 공개한 프로젝트 페이지다. 수식과 알고리즘 없이 같은 내용을 해설 문체로 다시 설명하고, 논문의 정지 프레임으로는 확인할 수 없는 rollout 영상 일곱 편을 붙였다.
논문을 이미 읽은 사람이 이 페이지에서 추가로 얻을 것은 세 가지다. 첫째, 논문 본문에 수치가 실리지 않은 두 개의 개선 폭이 여기 적혀 있다. 선택적 test-time computation이 다음 subtask 정확도를 15~24%p 올리고, 교정 가능한 execution memory가 11.0%p를 더한다. 둘째, 12분까지 이어지는 과제를 로봇이 실제로 어떤 속도로 수행하고 어떻게 회복하는지를 영상으로 볼 수 있다. 셋째, 논문 Figure 2와 같은 구조도가 PDF 크롭보다 훨씬 뚜렷한 해상도로 실려 있다.
반대로 이 페이지만으로는 방법을 재현할 수 없다. 손실 함수, 데이터 구성 비율, routing 임계값, embodiment별 성능표가 모두 빠져 있다.
배경
이 페이지가 문제를 제시하는 방식
도입부는 가정 과제의 길이를 출발점으로 삼는다. 밀크티 한 잔을 만들려면 우유와 차를 순서대로 붓고 토핑을 넣고 뚜껑을 덮고 빨대를 꽂는 수십 단계를 거쳐야 하고, 집 청소는 이동하면서 옷을 모으고 가방을 걸고 담요를 건네고 쓰레기를 버리는 일을 끊김 없이 이어가야 한다.
과제가 몇 초에서 몇 분으로 길어지면 어려움의 성격이 바뀐다는 것이 이 페이지의 핵심 진단이다. 정밀한 실행도 여전히 중요하지만, long-horizon 과제의 성패는 점점 더 진행 상황 추적, 결과 예측, subtask 계획에 좌우된다. 로봇은 무엇을 끝냈는지 기억하고 다음 단계를 고르고 실패했을 때 회복해야 한다.
기존 hierarchical VLA의 한계
hierarchical VLA는 언어로 표현한 subtask를 상위 추론과 하위 제어 사이의 인터페이스로 노출한다. 여기까지는 이미 확립된 설계다.
문제는 대부분의 시스템이 상위 결정을 여전히 한 번의 forward pass로 끝낸다는 데 있다. 현재 observation과 실행 이력을 다음 subtask로 곧장 매핑할 뿐, 대안을 명시적으로 비교하거나 그 대안이 만들 물리적 상태를 추정하지 않는다. observation은 매 timestep에 policy가 받는 센서 입력을 말한다.
결과적으로 나쁜 결정은 실행이 끝난 뒤에야 드러나고, 그때는 환경이 이미 바뀌어 있다.
subtask가 탐색 단위인 이유
페이지는 subtask가 간결하면서 의미가 구조화된 탐색 공간을 이룬다고 설명하고 근거로 세 가지를 든다.
- subtask는 드문드문 있는 결정 경계에서만 발생한다.
- 과제의 논리적 단계와 하나씩 대응한다.
- 시각적으로 평가할 수 있는 의미 있는 변화를 만든다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. τ0-VLA에는 서로 다른 시간 척도에서 동작하는 두 개의 policy가 있다.
world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. 이 페이지에서는 후보 subtask가 실행된 뒤의 장면을 그리는 역할을 맡는다.
execution memory는 지금까지 완료한 단계를 담은 진행 기록이다. 페이지가 강조하는 점은 이 기록이 시각 증거와 충돌할 때 진행, rollback, 재시도 중 하나로 스스로 교정된다는 것이다.
test-time computation은 추론 시점에 연산을 더 써서 결정 품질을 올리는 절차다. 페이지는 여기에 선택적(selective)이라는 수식어를 붙여 항상 켜는 방식과 구분한다.
페이지가 설명하는 방법
두 개의 시간 척도
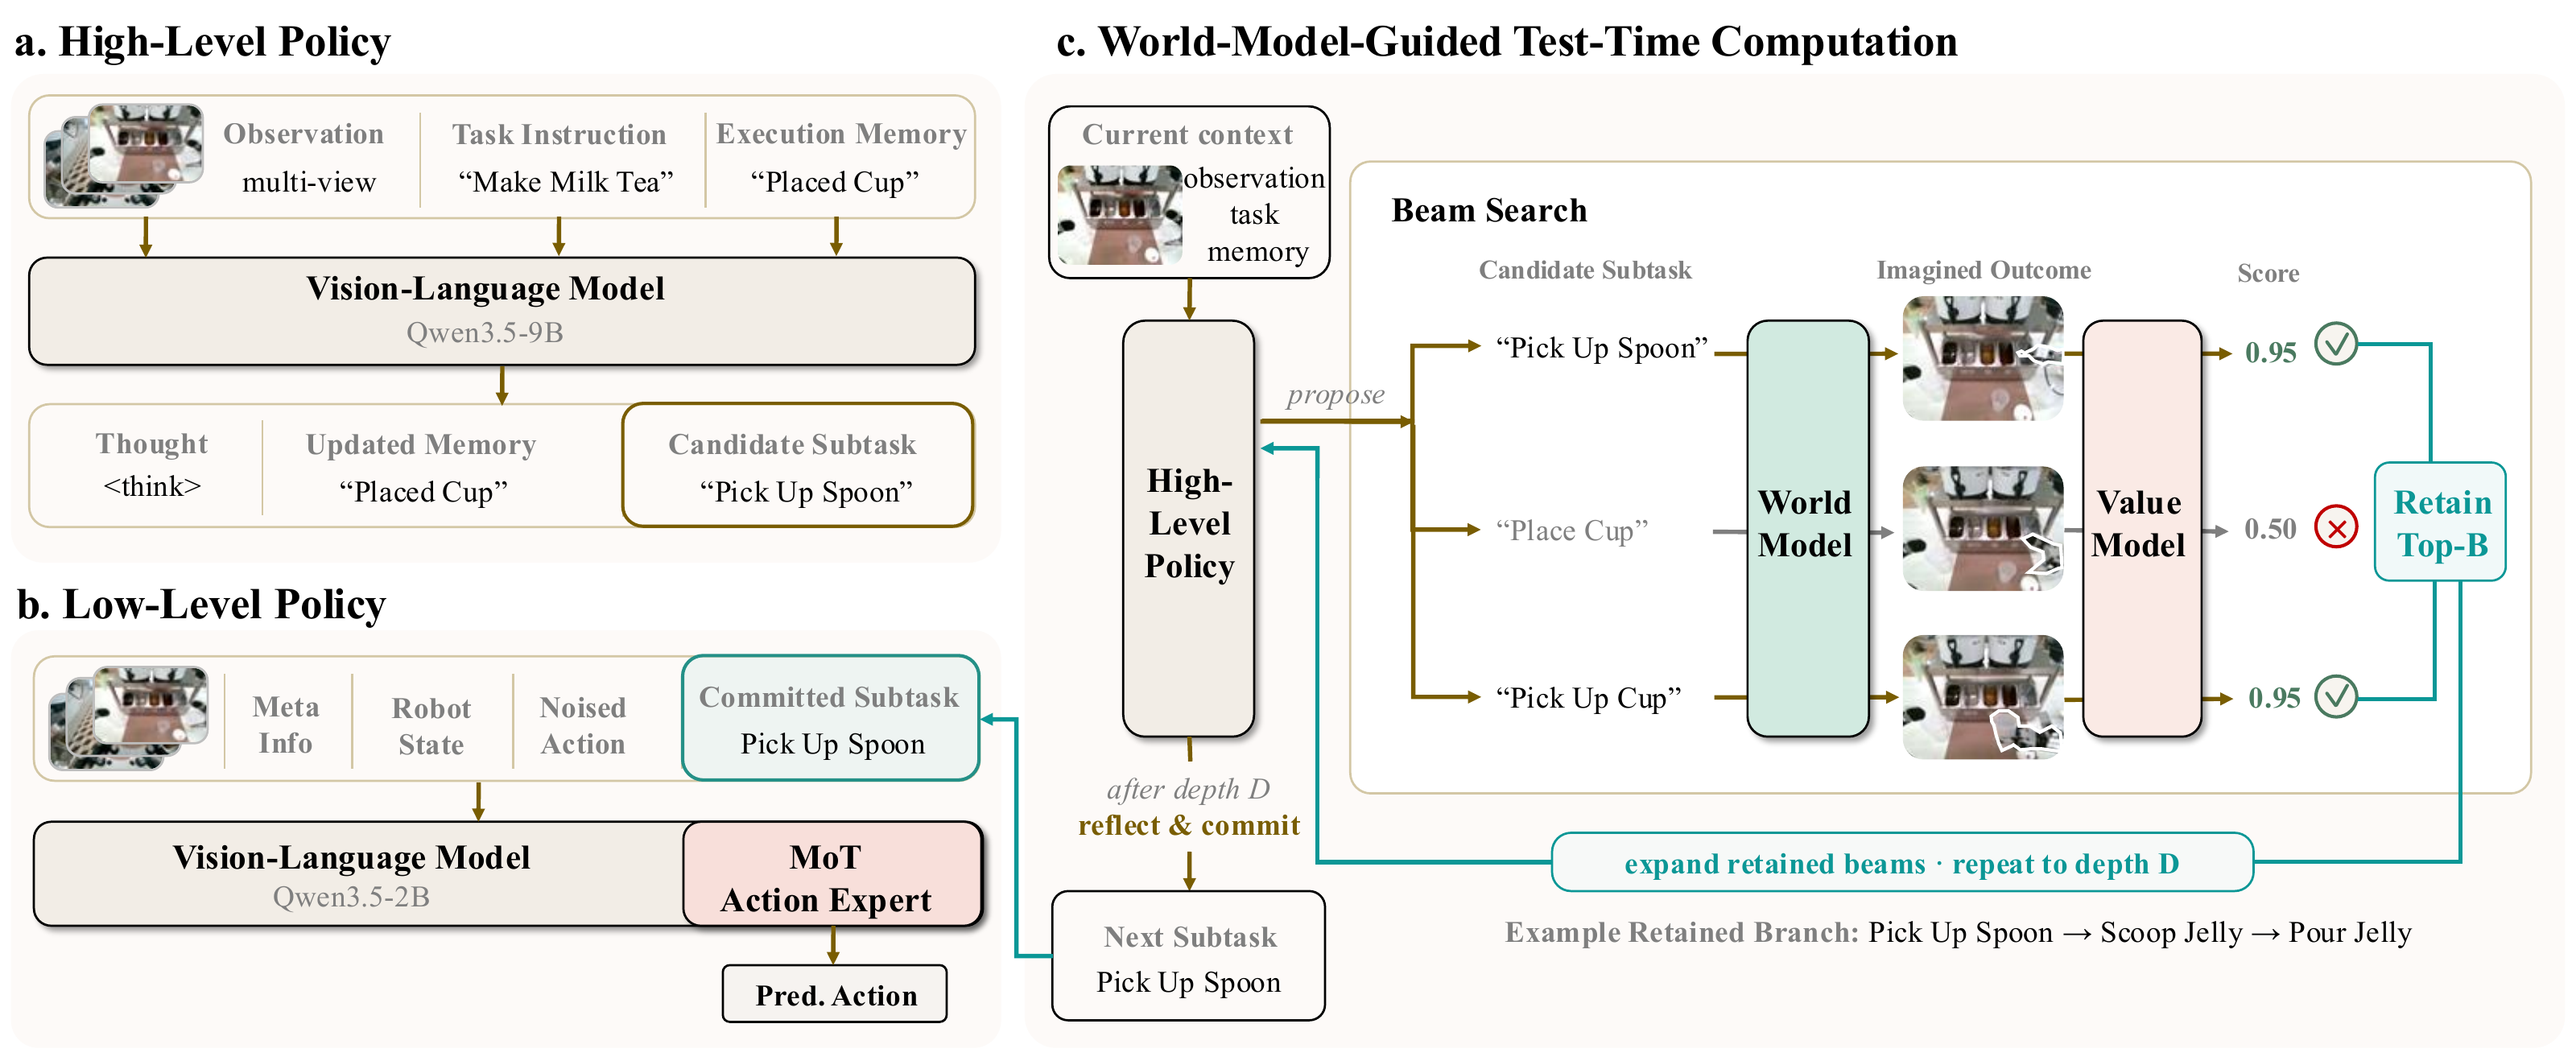
τ0-VLA는 서로 다른 시간 척도에서 동작하는 두 policy로 이뤄진다. subtask 경계에서 high-level policy가 지시문(instruction)과 현재 observation과 execution memory를 읽어 다음 subtask를 고르고 진행 기록을 갱신하며, low-level policy가 그 subtask를 더 빠른 제어 주기로 실행한다.
즉시 실행할지 연산을 더 쓸지는 토큰 확신 통계가 정한다. 확신이 낮은 결정에서는 대안 subtask를 제안하고, world model로 실행 후 결과를 예측하며, value model이 그 예측 결과에서 후보 품질 점수를 낸다. search와 반성이 이 분기들을 비교한 뒤 하나로 확정한다.
선택한 subtask의 실제 결과는 다음 결정 전에 memory를 갱신해 예측과 실제 사이의 closed-loop를 닫는다. 페이지는 이 선택적 test-time computation이 in-domain과 분포 이동 환경 전반에서 다음 subtask 정확도를 15~24%p 올린다고 적는다.
memory 동기화와 교정
이 loop가 신뢰를 유지하려면 execution memory가 물리 세계와 동기화된 상태여야 한다. grasping이 실패하거나 물체가 사라지면 그럴듯해 보이던 진행 기록이 틀린 것이 된다.
새 시각 증거가 memory와 충돌하면 τ0-VLA는 진행하거나 되돌리거나 재시도할 수 있다. 뒤처진 기록과 지나치게 낙관적인 기록을 모두 고치면서 이미 유효한 앞쪽 진행은 보존한다.
이 교정 행동은 기존 시연 데이터(demonstration)에서 파생한 memory를 perturbation으로 변형해 학습하며 별도의 교정 데이터셋을 수집하지 않는다. 페이지는 그 결과로 얻은 교정 가능한 memory만으로 다음 subtask 정확도가 11.0%p 올랐다고 밝힌다. 논문 본문에는 execution memory 단독 ablation 절이 없으므로 이 수치는 프로젝트 페이지에서만 확인된다.
하위 실행과 통합 인터페이스
subtask가 정해지면 pre-training된 vision-language backbone과 Mixture-of-Transformers action expert가 다중 시점 observation과 로봇 상태와 언어로부터 action chunk를 만든다. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다.
같은 low-level policy가 직접 실행에서는 원래 지시문을, 계층 실행에서는 상위가 고른 경계 지어진 subtask를 받는다. 두 설정에서 제어 인터페이스가 동일하다는 뜻이다.
40차원 공유 인터페이스는 end-effector 운동, 팔 관절, 그리퍼, 허리, 이동 베이스를 고정형과 양팔형과 이동형 플랫폼에 걸쳐 지원한다. embodiment마다 사용 가능한 상태와 제어 차원을 이 표현에 매핑하고 쓰지 않는 슬롯은 마스킹한다.
학습은 40,115시간의 이종 실제 로봇 경험과 멀티모달 데이터를 결합해 과제와 embodiment를 가로지르는 공유 pre-training foundation을 만들고, 배포마다 대상 설정에 맞춰 따로 fine-tuning한다.
결과
long-horizon 네 과제
페이지가 싣는 유일한 수치 표는 논문 Table I의 성공률 부분이다.
| 방법 | Clean Room | Prepare Ingredients | Stir Fry | Milk Tea | 평균 |
|---|---|---|---|---|---|
| GR00T N1.7 | 0 / 10 | 1 / 10 | 0 / 10 | 0 / 10 | 2.5% |
| LingBot-VLA | 0 / 10 | 0 / 10 | 0 / 10 | 0 / 10 | 0.0% |
| π0.5 | 4 / 10 | 2 / 10 | 0 / 10 | 3 / 10 | 22.5% |
| τ0-VLA | 4 / 10 | 2 / 10 | 0 / 10 | 5 / 10 | 27.5% |
| τ0-VLA (계층 구조, Plan Once) | 5 / 10 | 4 / 10 | 4 / 10 | 5 / 10 | 45.0% |
두 τ0-VLA 설정은 같은 low-level policy를 쓰고 beam search 없이 과제당 10회 시행했다. 페이지는 차이가 low-level policy를 어떻게 안내하느냐에 있다고 해석한다. 직접 실행은 모든 action을 전체 지시문에 조건화해 policy가 에피소드 내내 현재 단계를 스스로 추론하게 두는 반면, 계층 실행은 최신 observation과 execution memory에서 고른 경계 지어진 subtask를 준다. 따라서 27.5%에서 45.0%로의 향상은 실행 policy 자체의 변화가 아니라 진행을 명시적으로 추적하고 다음 할 일을 정하는 데서 온다.
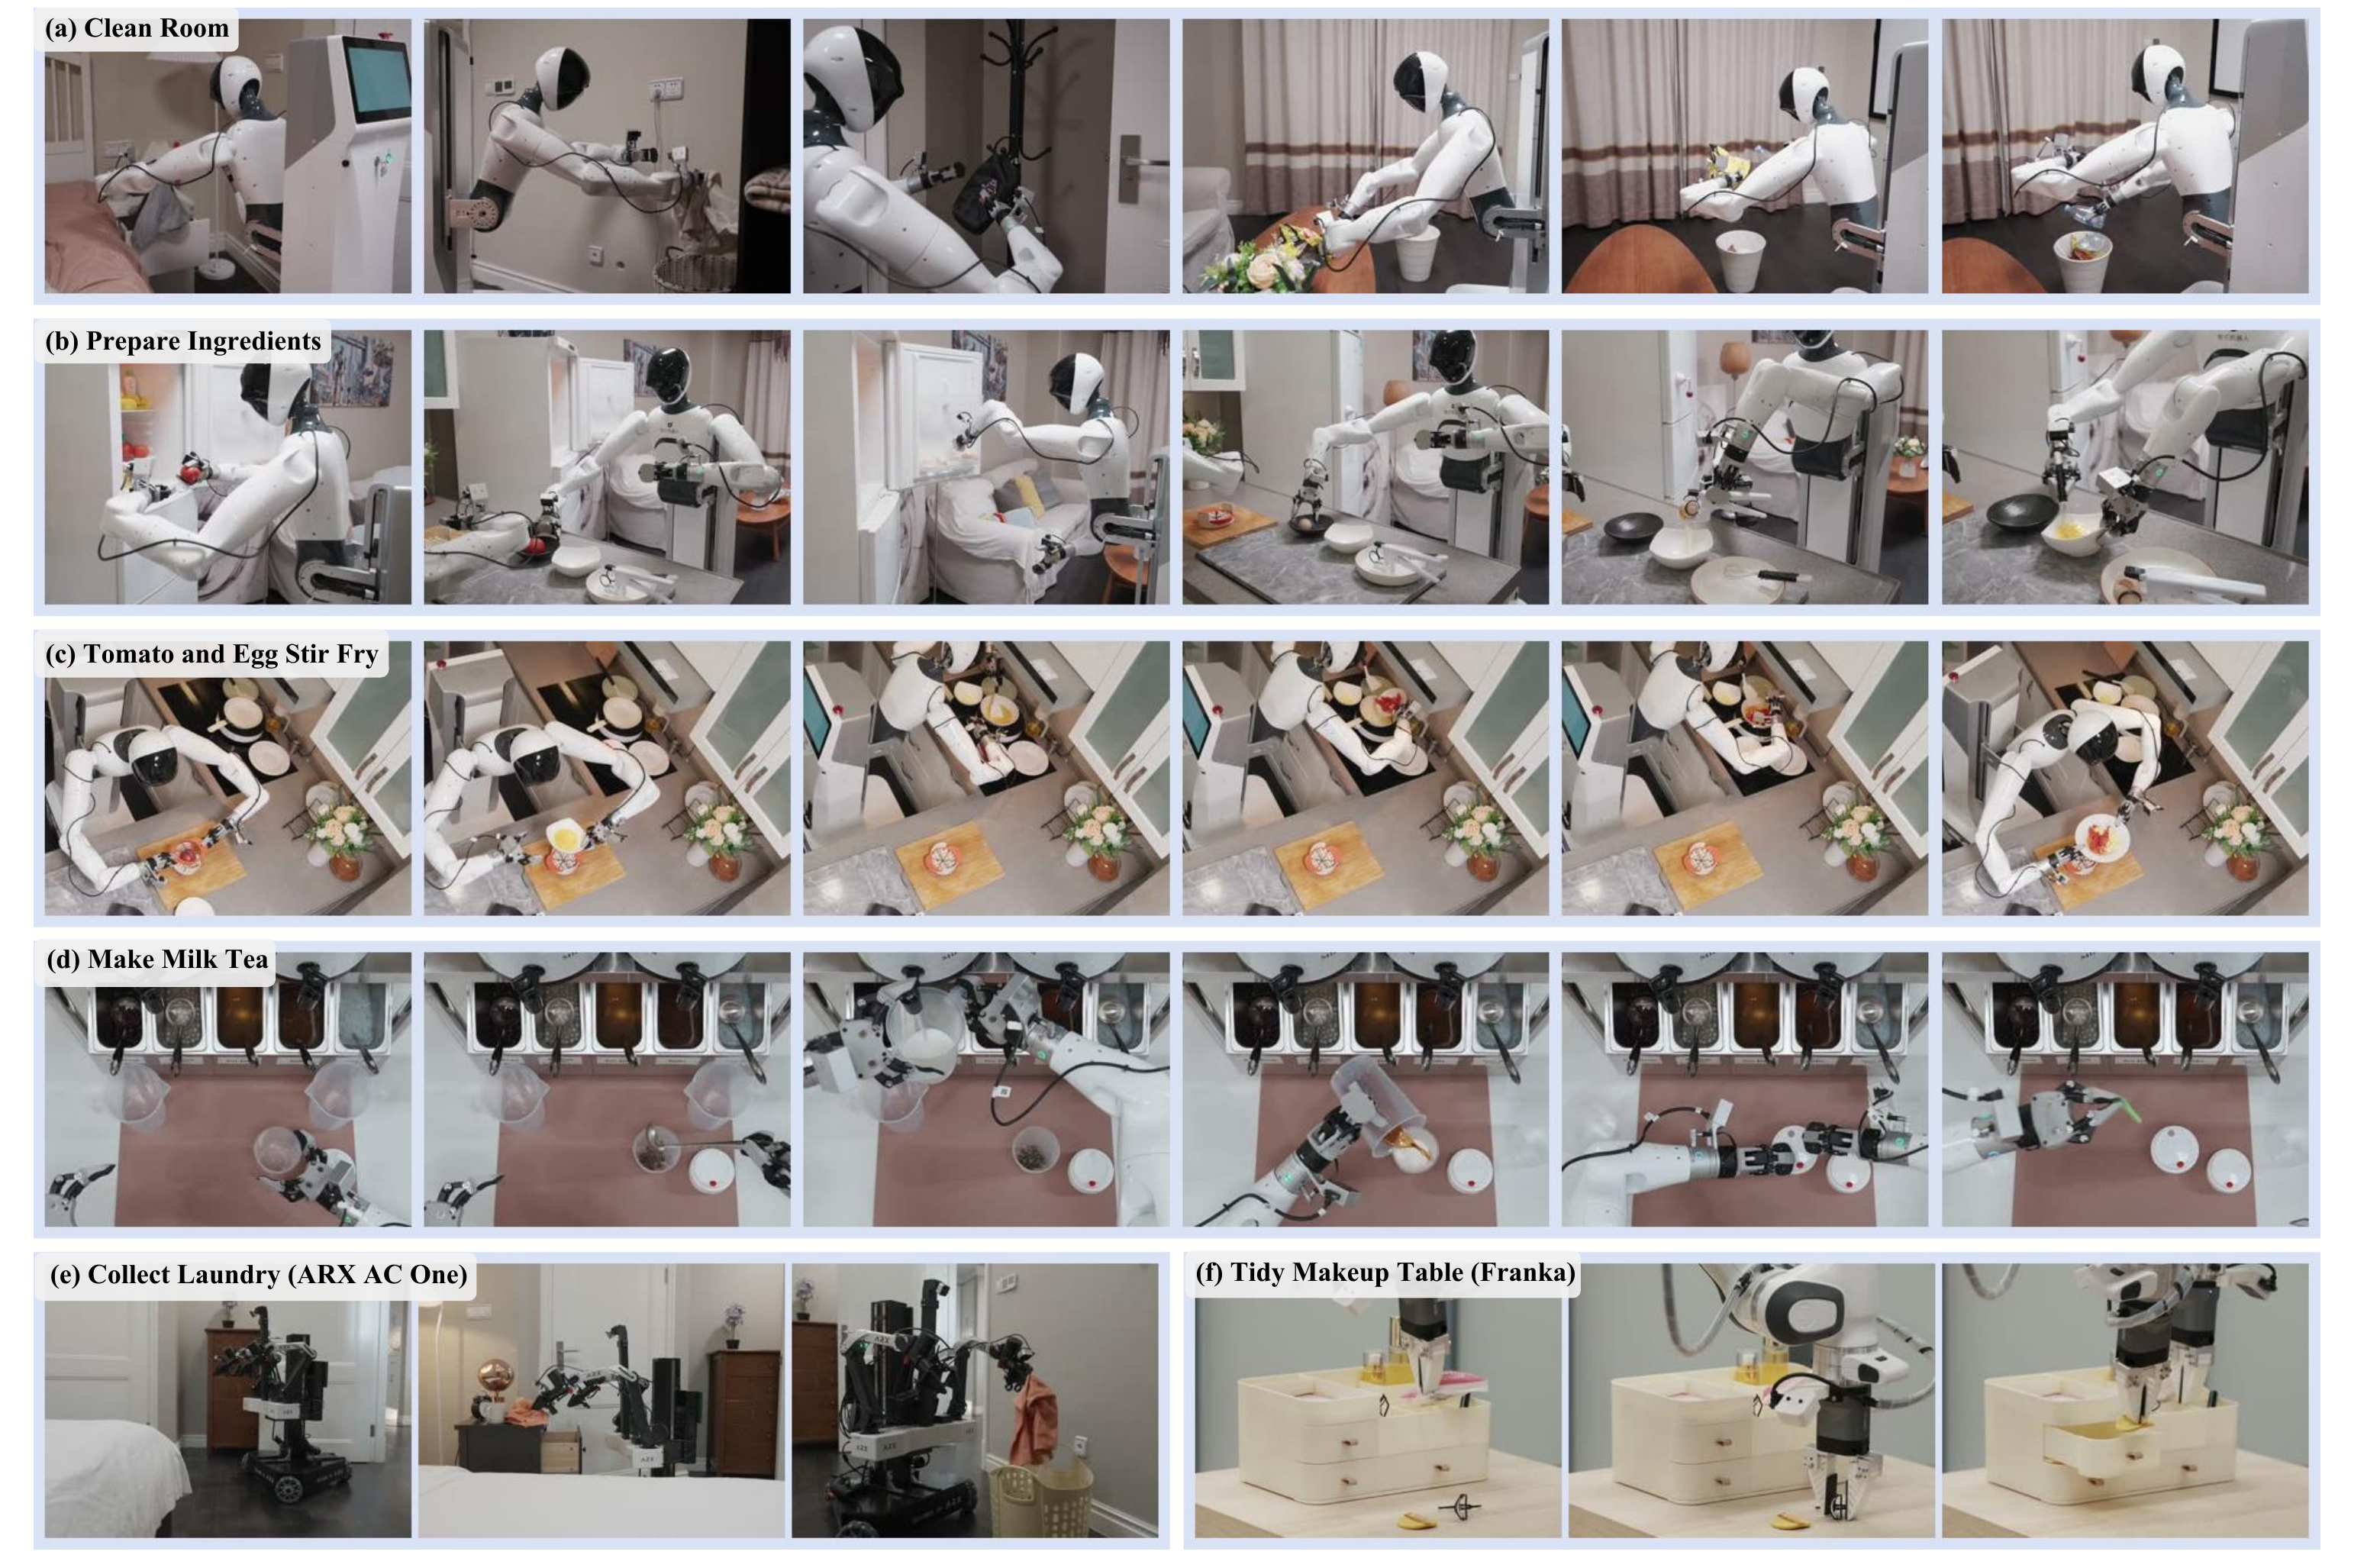
평가한 네 과제는 13~25단계이며 에피소드는 최대 12분까지 이어진다. 필요한 능력으로 주행, 물체 탐색, articulated object 상호작용, tool use, 조리, 불완전한 실행으로부터의 회복을 든다.
영상으로 제공되는 것
페이지의 실질적 가치는 rollout 영상에 있다. 일곱 편의 구성은 다음과 같다.
| 영상 | 내용 |
|---|---|
| 종합 데모 | 페이지 최상단의 전체 소개 영상 |
| Prepare Ingredients와 Clean Room | 14단계와 25단계 과제를 한 편에 담았다 |
| Make Milk Tea | 13단계 |
| Tomato and Egg Stir Fry (전면) | 22단계를 전면 시점에서 |
| Tomato and Egg Stir Fry (후면) | 같은 과제를 후면 시점에서 |
| Collect Laundry | ARX AC One, 5단계 |
| Tidy Makeup Table | Franka, 8단계 |
같은 과제를 전면과 후면 두 시점으로 나눠 실은 것은 조리 과제에서 팔 움직임과 조리 도구 상태를 한 시점만으로는 확인하기 어렵기 때문이다. embodiment 간 평가의 두 과제는 수치 표 없이 영상으로만 제시된다.
test-time computation
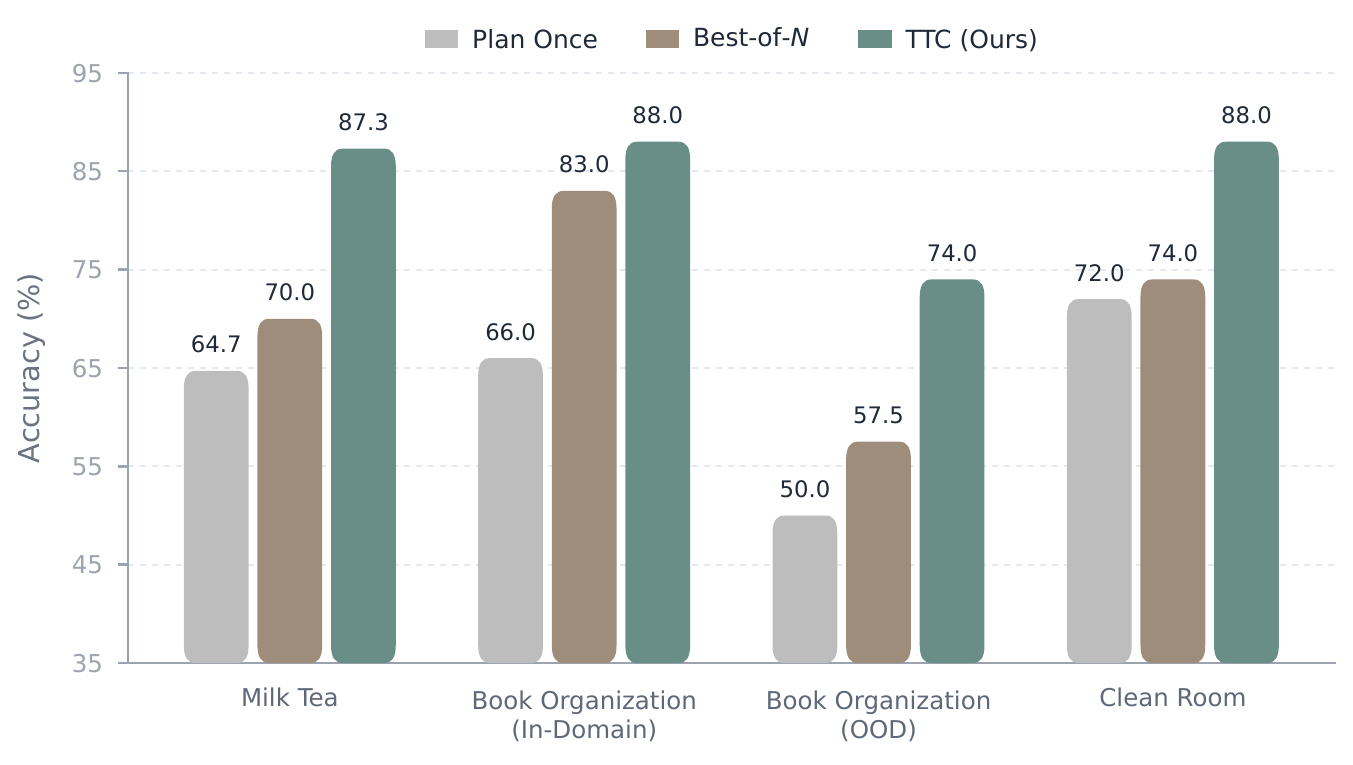
페이지는 Plan Once, Best-of-N, TTC 세 가지를 비교한다. Plan Once는 한 번만 예측하고, Best-of-N은 여러 한 단계 후보를 뽑아 점수를 매기며, TTC는 다단계 분기를 결과 예측과 반성으로 확장한 뒤 확정한다.
효과는 분포 이동에서 가장 뚜렷하다. 학습에 없던 Book Organization 배열에서 TTC는 74.0%의 다음 subtask 정확도를 냈고 Plan Once는 50.0%, Best-of-N은 57.5%였다. 결정 시점에 결과를 예측하는 것이 한 번의 forward 예측이나 한 단계 후보 순위 매기기를 넘어서는 증거를 준다는 설명이다.
closed-loop 실행 향상은 low-level policy를 고정한 채 측정했다.
| 과제 | Plan Once | TTC |
|---|---|---|
| Make Milk Tea | 5/10 | 7/10 |
| Book Organization | 6/10 | 9/10 |
| Clean Room | 5/10 | 7/10 |
Milk Tea에서는 두 변형 모두 이미 평균 91% 이상의 순서를 완료하며 남은 실패는 뚜껑 부착과 빨대 삽입에 몰려 있다. TTC는 Progress를 95.38%까지 올려, 마지막 접촉이 많은 manipulation이 주된 병목임을 드러낸다.
연산량의 한계 효용
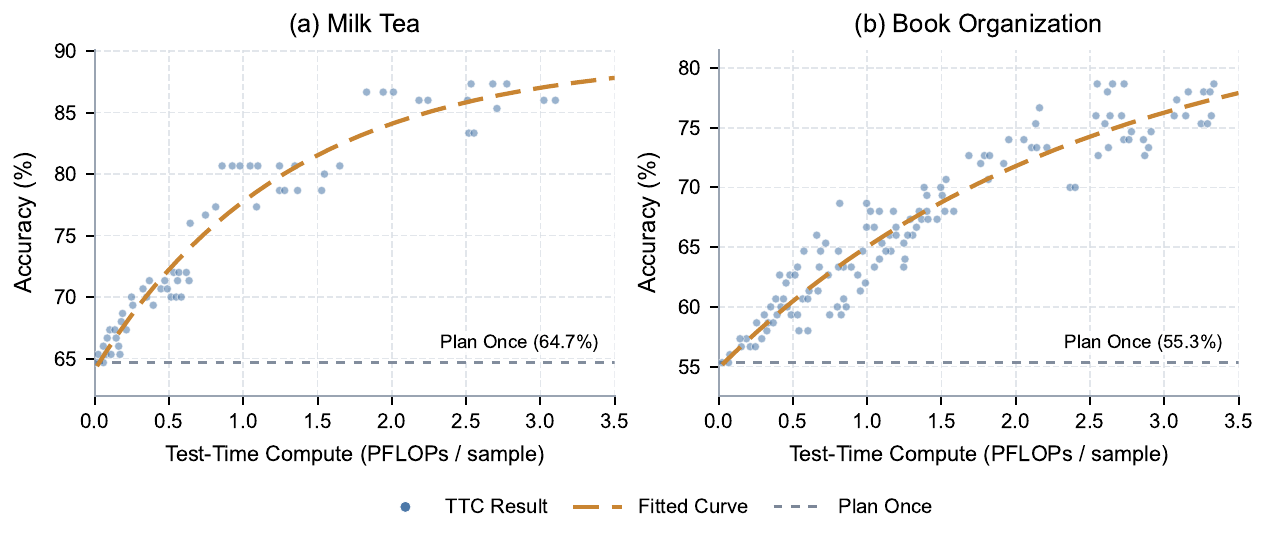
연산량 증가의 효과는 무한하지 않다. 정확도는 낮거나 중간 예산에서 빠르게 오르다가 점차 포화한다. 확신 기반 라우팅이 결정이 불확실할 때만 추가 추론을 배분하고 확신이 높은 결정은 그대로 진행시켜 선택적 test-time computation을 가능하게 한다.
논문과 어긋나는 표기 한 곳
정확도 막대그래프에서 Clean Room의 TTC 값이 88.0%로 적혀 있는데 논문 Figure 4의 같은 막대는 87.0%다. 나머지 열한 개 값은 논문과 일치한다.
어느 쪽이 맞는지는 본문으로 판별된다. 페이지 본문이 말하는 개선 폭 하한 15%p는 Clean Room의 Plan Once 72.0%에서 87.0%를 뺀 값과 맞는다. 88.0%였다면 하한이 16%p가 된다. 따라서 논문 쪽 87.0%를 정본으로 본다.
한계
페이지가 직접 말하는 한계는 두 가지다.
- 연산 대비 이득의 포화: 정확도가 낮은 예산에서 빠르게 오른 뒤 평탄해진다.
- 마지막 접촉 단계: Milk Tea에서 Progress가 95.38%에 이르러도 뚜껑 부착과 빨대 삽입이 남는다.
자료 자체의 한계도 분명하다. 이 페이지는 논문의 대중용 요약이라 알고리즘, 손실 함수, 데이터 구성 비율, routing 임계값 같은 재현에 필요한 세부를 담지 않는다. 논문 Table II의 embodiment별 성능과 Table III의 closed-loop Progress 수치도 일부만 문장으로 언급된다. 따라서 이 페이지만으로는 방법을 재현할 수 없고 논문을 함께 읽어야 한다.
마무리 절이 제시하는 향후 방향은 이 closed-loop를 더 풍부한 과제와 더 긴 배포로 확장하는 것이다. 작은 오류가 과제 수준 실패로 번지기 전에 로봇이 언제 숙고하고 결과를 검증하고 계획을 고칠지를 스스로 정하게 만드는 것이 목표다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| test-time computation | 결정이 불확실할 때만 추론 연산을 더 쓰는 절차. 페이지는 선택적이라는 수식어로 항상 켜는 방식과 구분한다 |
| execution memory | 지금까지 완료한 단계를 담은 진행 기록. 새 시각 증거와 충돌하면 진행, rollback, 재시도 중 하나로 교정된다 |
| revisable memory | 스스로 고칠 수 있게 학습된 execution memory. 페이지는 이것만으로 다음 subtask 정확도가 11.0%p 올랐다고 적는다 |
| Plan Once | 결정 지점마다 한 번만 예측하는 상위 기준선 |
| Best-of-N | 한 단계 후보 N개를 뽑아 점수를 매기고 최고점을 고르는 기준선 |
| 확신 기반 라우팅 | 토큰 확신 통계로 추가 추론을 켤지 정하는 규칙 |
관련 페이지
- τ0-VLA (sii-research/tau-0-vla, GitHub repo): 공식 코드 저장소. low-level policy와 proposal model, world model을 공개하고 LIBERO 재현 레시피를 싣는다. value model과 reflective model은 미공개다.
- τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation: 이 페이지가 요약하는 원 논문. 알고리즘, 학습 세부, 전체 성능표는 원 논문 페이지에 있다.
- Cortex 프로젝트 페이지: 양방향 alignment 인터페이스 요약과 추가 지표: 같은 형식의 VLA 프로젝트 페이지. 논문과 페이지를 나란히 수집한 다른 사례다.
- WALL-OSS: Igniting VLMs toward the Embodied Space (X Square Robot 프로젝트 페이지): 또 다른 VLA 프로젝트 페이지 사례.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이 페이지의 표에서 가장 강한 기준선인 π0.5의 원 논문.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 전체 지도.