Physical AI · PAPER · 2026
Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere
요약
Wall-OSS-0.5는 3B VLM backbone에 action 생성부를 결합한 4B 규모의 오픈소스 VLA다. 20종이 넘는 embodiment에서 모은 데이터로 pre-training하며, 한 epoch마다 100만 개가 넘는 로봇 trajectory와 grounding된 멀티모달 corpus를 함께 소비한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻하고, trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
이 기술 보고서가 검증하는 명제는 하나로 좁혀져 있다. VLA pre-training이 그 자체로 실행 가능한 로봇 동작을 만들어내는지, 아니면 downstream policy 학습의 더 나은 초기값을 줄 뿐인지가 그 명제다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
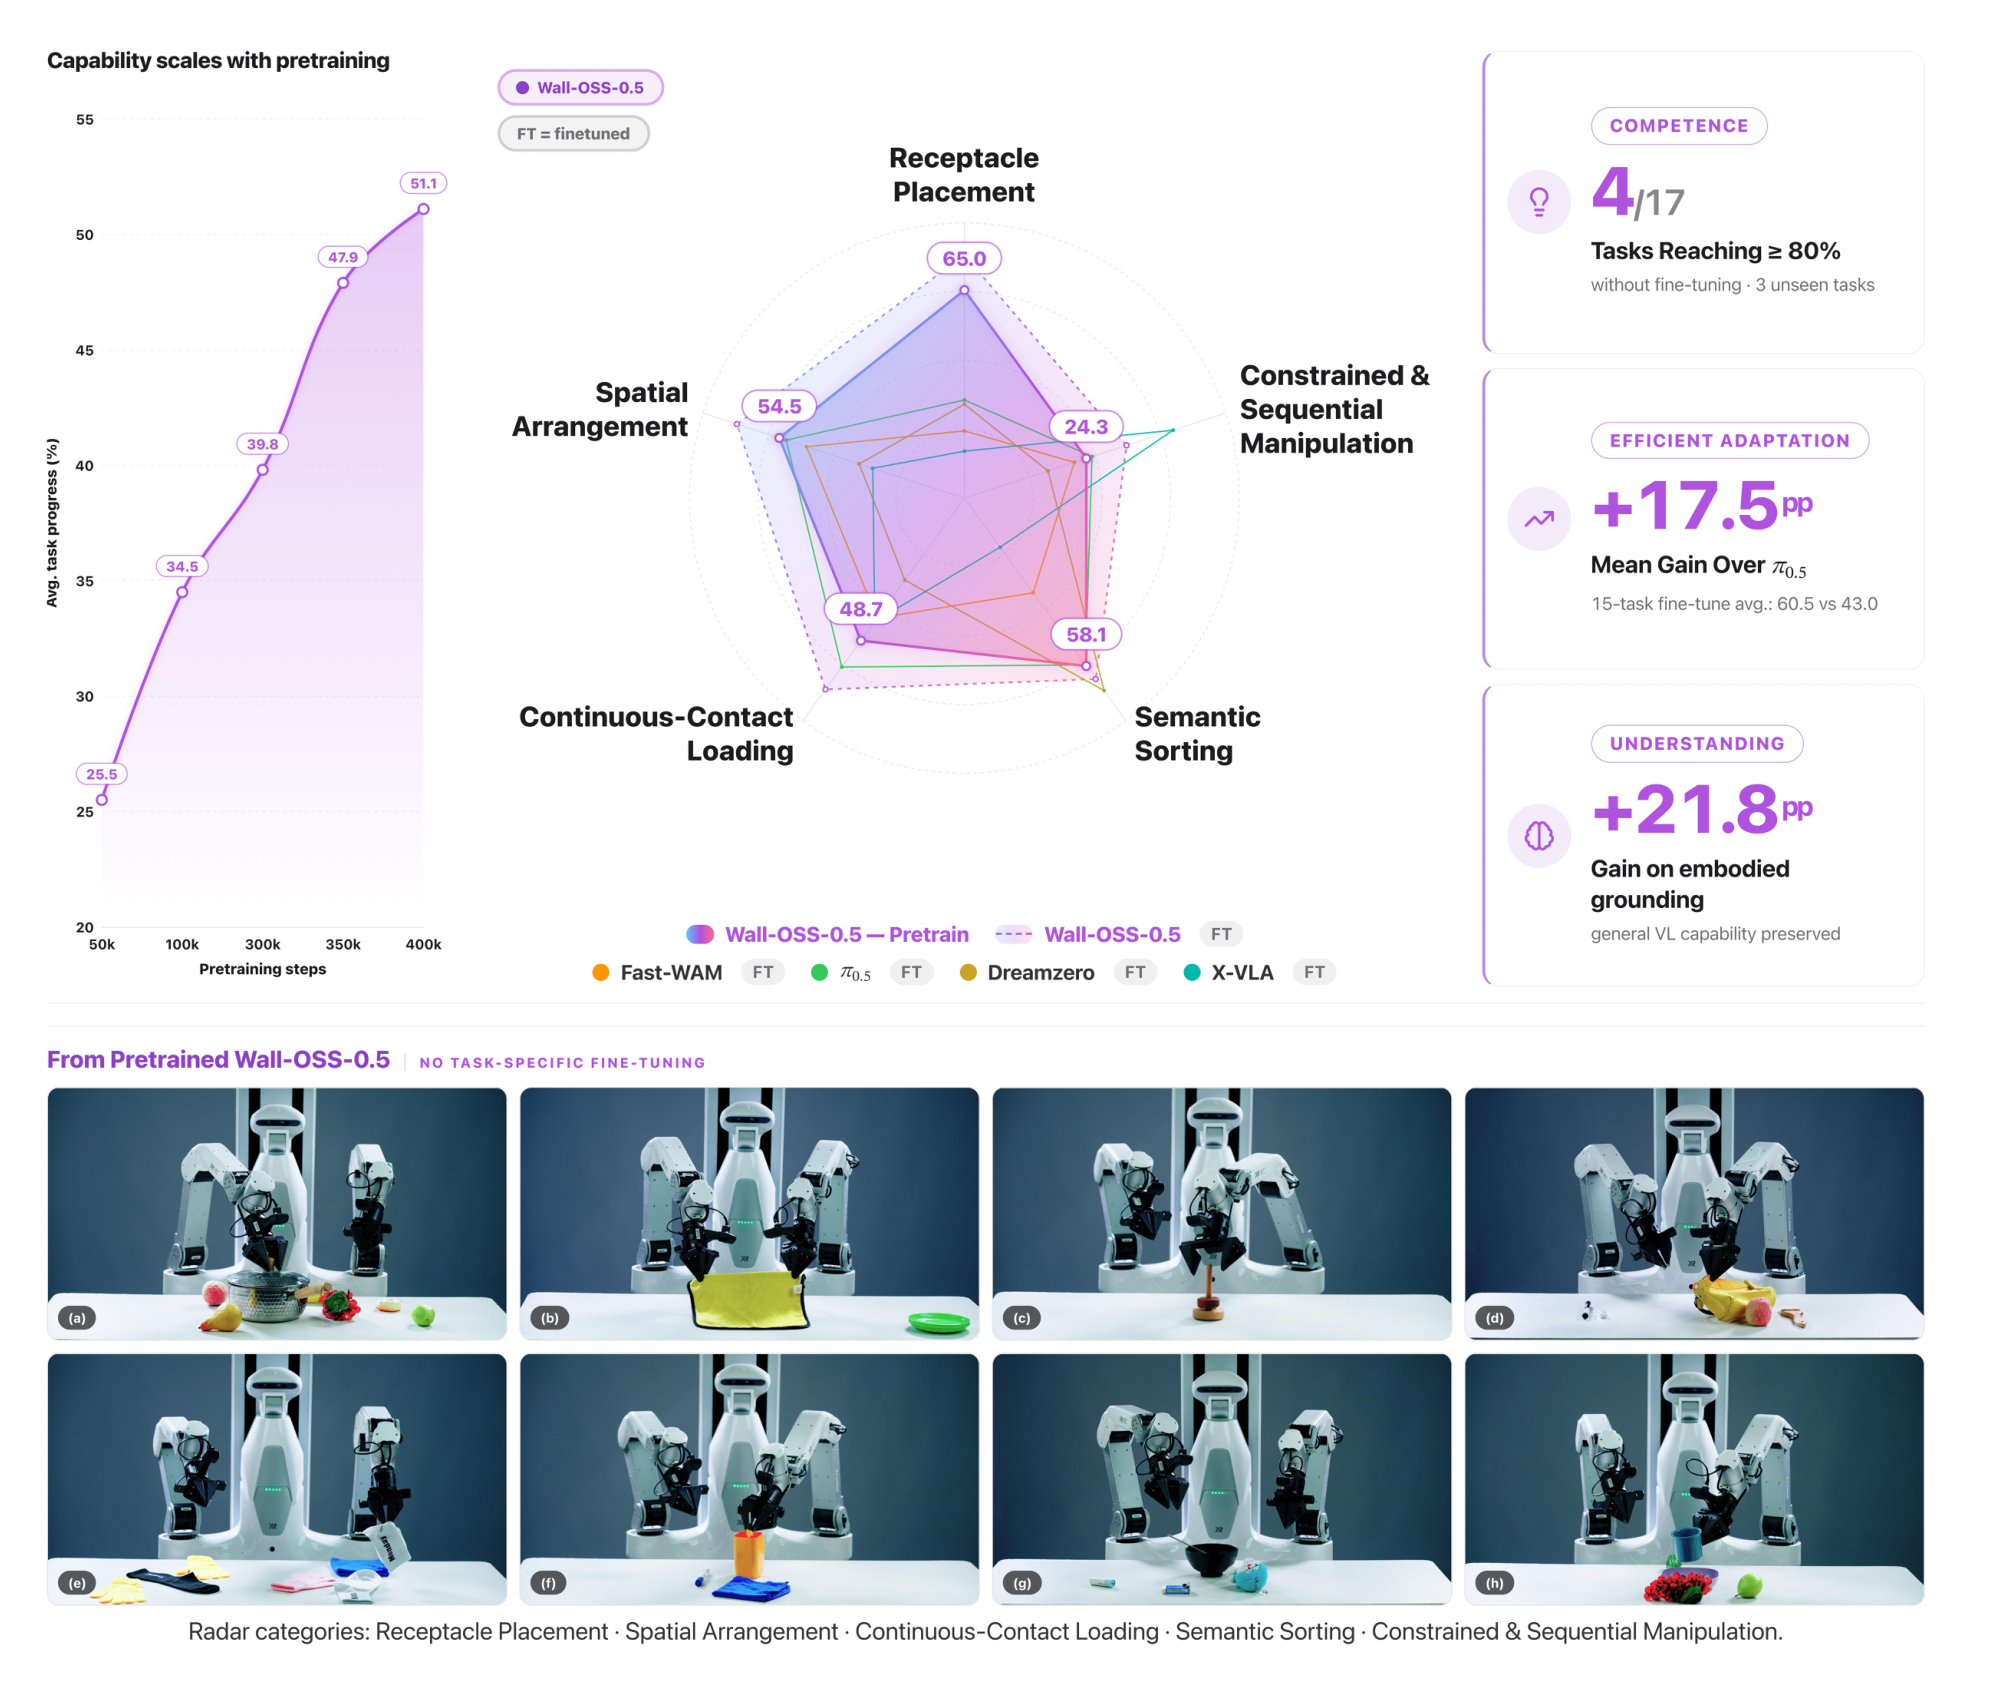
답을 내기 위해 저자들은 pre-training을 마친 체크포인트를 fine-tuning 없이 실제 로봇에 그대로 올려 평가한다. 17과제 zero-shot 스위트에서 40만 스텝 체크포인트의 평균 task progress가 51.1%이고, Block Sorting 100%처럼 fine-tuning 없이 사실상 완수하는 과제가 나온다. 같은 체크포인트를 fine-tuning하면 15과제 평균 60.5%로 π0.5를 17.5%p 앞선다.
방법 쪽 핵심은 gradient-bridged co-training이다. 이산 action 토큰의 cross-entropy는 backbone을 제어 쪽으로 미는 다리이고, 멀티모달 데이터의 cross-entropy는 vision-language 능력을 붙잡아 두는 닻이며, flow matching은 배포 시 실제로 쓰는 연속 action 생성기다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다.
배경
VLA 논문의 성적표가 거의 예외 없이 과제별 fine-tuning 이후에 찍혀 왔다는 관찰이 이 보고서의 출발점이다. VLA 모델은 pre-training된 VLM에서 perception과 추론 능력을 물려받지만 보고되는 성적이 downstream fine-tuning 이후의 값이라, pre-training의 기여와 fine-tuning의 기여가 분리되지 않는다.
저자들은 기준을 배포 관점으로 바꿔 세우고 이를 deployment-oriented VLA pretraining이라 부른다. 이 기준을 만족하려면 모델은 fine-tuning 없이 쓸 만한 manipulation을 실행하고, 물려받은 vision-language 능력을 유지해 지시문(instruction)에 계속 붙어 있어야 하며, downstream 적응을 더 적은 데이터로 가능하게 만드는 prior를 제공해야 한다. 지시문은 로봇에게 과제를 지정하는 자연어 문장이다.
기술적 출발점은 VLA 학습에 내재한 긴장이다. flow matching은 양자화되지 않은 action을 직접 모델링하므로 자연스러운 실행 인터페이스이지만 그것만으로는 backbone을 약하게만 갱신하고, 반대로 이산 action 토큰 예측은 VLM 고유의 next-token cross-entropy를 쓰므로 backbone을 강하게 빚지만 디코딩된 결과가 정밀 제어에 쓰기에 거칠다. 기존의 절충인 gradient 동결과 차단은 VLM prior를 보존하는 대신 정밀한 action 목표가 대형 backbone을 빚지 못하게 막는 대가를 치른다.
핵심 개념
task progress는 성공과 실패의 이진 판정 대신 과제의 부분 완료 정도를 0%에서 100% 사이로 재는 척도다. 과제마다 만점 10점의 단계별 채점 기준을 미리 정해 두고 실제 점수를 만점으로 나눠 100을 곱하며, 각 과제는 10회 실행으로 평가한다.
seen과 unseen은 현재 로봇에서의 수집 이력으로 나뉜다. seen은 pre-training 데이터 분포 안에 있는 과제이고, unseen은 현재 embodiment에서 동일 과제로 수집된 적이 없으며 소품 조합도 새로운 과제다.
gradient bridge는 이산 action 토큰의 cross-entropy가 backbone을 제어 쪽으로 옮기는 통로를 가리키는 이름이다. VLM pre-training과 같은 autoregressive 인터페이스를 공유하므로 flow matching보다 backbone을 훨씬 세게 갱신하고, 그 gradient 방향이 flow matching의 방향과 양의 상관을 유지하므로 연속 제어가 나중에 활용할 feature를 빚는다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이다. Wall-OSS-0.5는 이산 action 토큰 경로와 연속 flow matching 경로 모두 1초 분량의 chunk를 예측하고, 그 안의 프레임 수는 데이터 원천의 control frequency에 맞춘다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
방법
backbone 라우팅
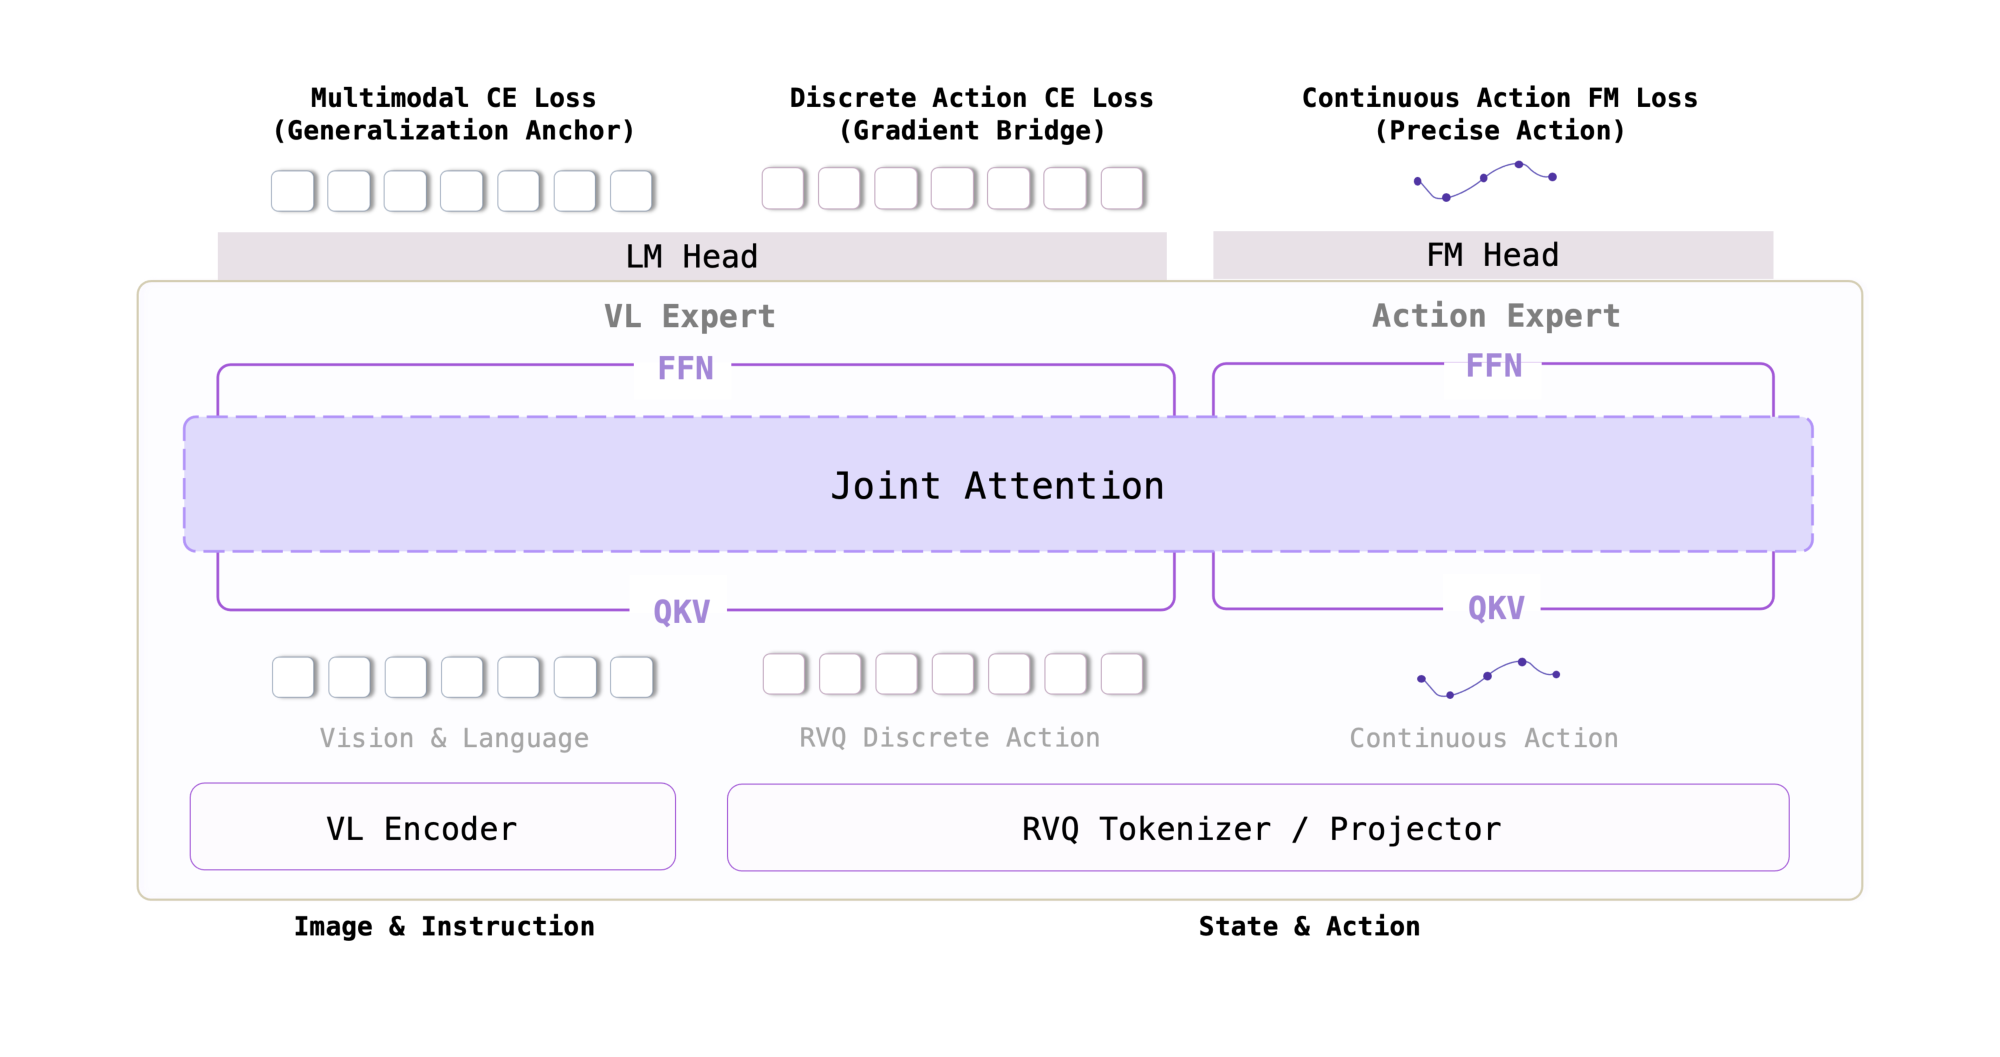
Wall-OSS-0.5는 Qwen2.5-VL-3B-Instruct에서 출발해 Mixture-of-Transformers backbone으로 확장한 결과 4B가 넘는 파라미터를 갖는다. 원래의 3B VLM이 VL Expert로 남고, 새로 붙인 Action Expert가 연속 action 생성 용량을 맡는다. 토큰은 종류에 따라 두 expert로 나뉜다.
| 토큰 스트림 | 처리 expert | 학습 목표 |
|---|---|---|
| vision | VL Expert | 멀티모달 CE와 action 토큰 CE |
| language | VL Expert | 멀티모달 CE와 action 토큰 CE |
| proprioception | VL Expert | action 토큰 CE |
| 이산 action 토큰 | VL Expert | action 토큰 CE |
| 노이즈가 낀 연속 action 토큰 | Action Expert | flow matching |
proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력이고, CE는 cross-entropy의 약어다.
이 분리가 gradient를 끊는 장치가 아니라는 점이 π0.5와 갈리는 대목이다. 두 expert가 같은 시퀀스 수준 attention 문맥을 공유하므로 Action Expert가 시각과 언어 정보를 참조할 수 있고, flow matching gradient도 공유 attention을 타고 VL Expert까지 흘러간다. 즉 이 구조는 gradient 격리가 아니라 라우팅 분해다. 다만 attention mask가 두 action 경로를 서로 보이지 않게 만들어, 이산 경로와 연속 경로를 따로 학습하고 따로 평가할 수 있다.
gradient-bridged co-training
세 목표를 단일 단계에서 함께 최적화하는 것이 이 레시피의 핵심이다. 전체 손실은 flow matching 손실에 action 토큰 CE와 멀티모달 CE를 각각 0.01 가중치로 더한 형태다.
가중치 0.01이 작아 보이지만 실제 효과는 반대다. Action-Space Supervision 아래에서 flow matching 손실이 두 CE 항보다 두 자릿수 작기 때문에, 이 가중치가 오히려 세 항의 규모를 비슷하게 맞춰 언어형 예측이 action 학습을 압도하지 않게 막는다. 두 CE 사이의 상대 비중은 배치 구성으로 조절하며 action 데이터와 멀티모달 데이터를 9 대 1로 섞는다.
셋을 모두 유지해야 하는 근거는 gradient 분석이다. 학습 초기를 지나면 flow matching이 backbone 갱신에서 차지하는 몫은 5% 남짓으로 안정되고 나머지 대부분을 두 CE 항이 가져간다. 그럼에도 작지만 꾸준한 flow matching 잔여분은 action 품질에 여전히 기여하며, backbone을 실제로 빚는 일은 action 토큰 CE가 맡는다.
배포 시점에는 이산 경로가 쓰이지 않는다. 추론의 기본 디코딩 경로는 연속 flow matching이고, 이산 경로의 역할은 학습 중 gradient bridge를 나르는 데 국한된다.
Vision-Aligned RVQ Action Tokenizer
이산 action 토큰을 쓰는 이유는 next-token cross-entropy가 VLM backbone과 가장 직접적으로 호환되는 학습 인터페이스이기 때문이다. 따라서 tokenizer는 복원 오차를 줄이는 압축기가 아니라 구조화된 action 의미를 backbone에 노출하는 장치여야 한다.
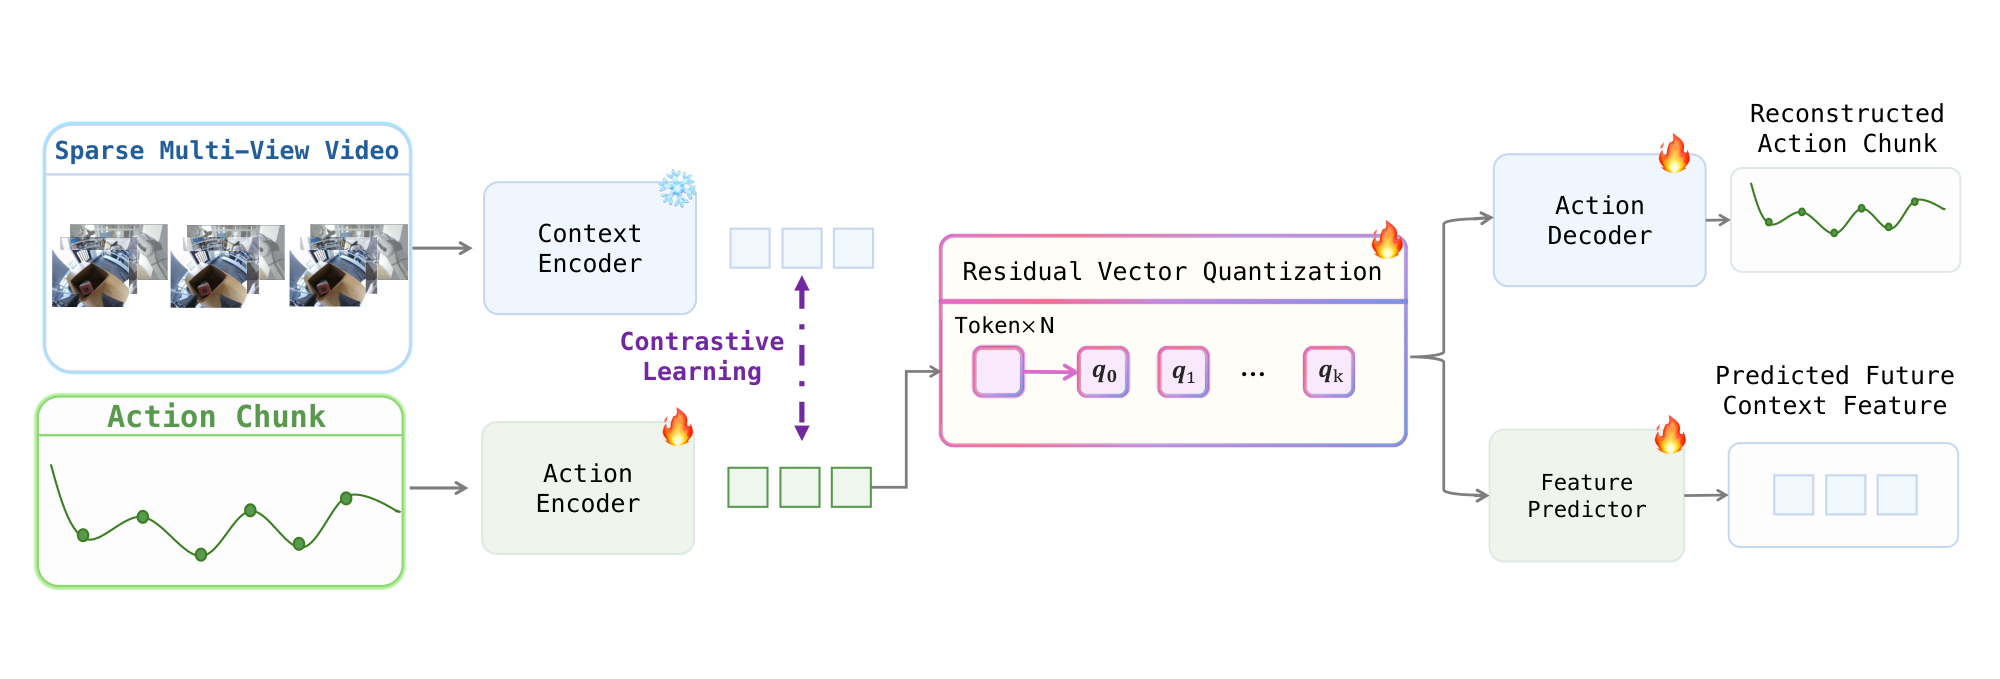
저자들은 규칙 기반인 FAST tokenizer를 학습형 Vision-Aligned RVQ Action Tokenizer로 대체한다. FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식으로 토큰 효율은 좋지만, 규칙 기반 압축기라 의미를 담는 능력이 제한적이라는 것이 저자들의 진단이다.
tokenizer는 delta action 공간에서 동작하며 Encoder-RVQ-Decoder 구조를 따른다. encoder가 observation으로 조건화된 action chunk를 temporal cross-attention으로 압축하고, RVQ codebook이 앞쪽 레벨에서 거친 움직임 구조를 뒤쪽 레벨에서 잔차 보정을 잡아 다단계 이산 토큰을 만들며, decoder가 observation 상태를 조건으로 원래 시퀀스를 복원한다. 여기에 세 가지 보조 목표가 토큰 공간을 함께 빚는다.
- 시각과 action의 alignment가 action latent를 VLM 시각 feature 쪽으로 당긴다.
- 다음 프레임 예측이 토큰에 행동의 결과를 담게 한다.
- DCT 영역 복원이 고주파 떨림을 억제한다.
그 결과 얻어지는 이산 action 표현은 복원 가능하면서 시각적으로 alignment되어 있고 물리적으로 매끄럽다.
Action-Space Supervision
flow matching은 노이즈가 낀 action chunk에서 출발해 깨끗한 action으로 옮겨 가는 velocity field를 학습한다. Wall-OSS-0.5는 linear Gaussian 경로를 쓰되 timestep을 Beta(1.5, 1)에서 뽑아 고노이즈 구간에 확률 질량을 몰아 주며, 이 timestep 샘플링 편향은 π0에서 가져왔다.
네트워크의 출력은 여전히 velocity이지만 손실을 거는 위치가 다르다. 예측한 velocity로 복원한 action과 정답 action의 차이에 손실을 걸며, 이는 velocity 공간에서 (1−τ)² 가중을 준 것과 수학적으로 같다. 따라서 trajectory의 전체 모양이 잡히는 고노이즈 구간이 자동으로 강조된다.
근거는 로봇 action 신호의 스펙트럼 성질이다. 로봇 action 시퀀스는 저차원이고 매끄러워 과제에 필요한 구조가 고주파 세부보다 저주파 trajectory 형태에 몰려 있는 반면, 자연 이미지는 고주파와 저주파 성분 모두가 풍부한 의미를 담는다. 따라서 로봇 action에서는 고노이즈 구간의 감독 품질이 생성 품질의 천장을 결정한다는 것이 저자들의 가설이다. 형태는 diffusion 모델의 x-prediction과 닮았지만, 동기가 분산이 아니라 주파수 구조에서 나온다는 점이 다르다.
action 인터페이스
입력은 VLM 대화 형식을 그대로 따른다. 시스템 차례에 embodiment prompt를 적고, 사용자 차례에 카메라별 이미지 토큰과 지시문, 텍스트 숫자로 이산화한 proprioception 토큰을 넣으며, 어시스턴트 차례에 이산 action 토큰과 연속 action 질의 토큰이 온다.
지시문은 최종 목표만 적은 goal 수준과 중간 하위 목표를 시간순으로 나열한 step 수준 두 가지로 달리고 학습 중 스텝마다 한 수준을 뽑아 쓰므로, 모델이 여러 추상 수준의 지시를 모두 따를 수 있다. 두 종류 모두 LLM으로 표현을 늘려 표현이 굳는 것을 막고, proprioception 토큰은 잡음 없는 로봇 상태에 대한 의존을 줄이려고 무작위로 누락되거나 교란된다.
회전은 SO(3)의 불연속과 짐벌 락을 피하려고 오일러각이나 사원수 대신 6D 표현을 쓴다. 최종 action space는 26차원이다.
| 구성 요소 | 차원 | 설명 |
|---|---|---|
| 팔당 상대 3D 위치 | 3 × 2 | 현재 end-effector pose 기준 상대값 |
| 팔당 상대 6D 회전 | 6 × 2 | 현재 end-effector pose 기준 상대값 |
| 팔당 그리퍼 상태 | 1 × 2 | 값이 클수록 더 넓게 벌어진다 |
| 이동 베이스 속도 | 3 | 모바일 manipulator용 |
| 리프트 높이 | 1 | 몸통 상하 구동 |
| 머리 구동 | 2 | 시점 제어 |
end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이다. 추론 시에는 이산 토큰을 실행 가능한 action으로 디코딩하지 않고, Action Expert가 다단계 flow matching denoising으로 연속 action chunk를 만든다.
최적화 설정
optimizer는 Muon이며 각 expert의 2D 파라미터에 적용하고 시각 임베딩과 LM head는 AdamW가 맡는다. Muon은 momentum을 직교화한 뒤 갱신에 쓰므로 gradient 크기에 무관한 갱신을 만드는데, Action Expert와 VL Expert의 gradient 규모가 크게 다른 이 설정에서 그 불변성이 중요하다고 적는다. 분산 런타임 DMuon은 행렬 파라미터마다 소유 rank를 정해 Newton-Schulz 갱신을 한 번만 수행하고 갱신 상태의 broadcast를 다음 forward와 겹쳐, optimizer 추가 비용을 순진한 구현의 약 2배에서 약 0.02배로 줄인다.
pre-training은 전역 배치 8192, bf16 혼합 정밀도, gradient clipping 1.0, 선형 warmup을 붙인 cosine 스케줄에 peak learning rate 1e-4로 진행하고, 이미지는 종횡비를 유지한 채 긴 변을 448픽셀로 맞춘다. fine-tuning은 learning rate 5e-5에 모든 모듈을 학습 가능하게 두고 pre-training과 같은 결합 목표를 유지한다.
추론 최적화
manipulation policy는 환경과 closed-loop로 동작하므로 지연이 늘면 구동이 밀리고 동적 목표 추적이 나빠진다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다. 고해상도 입력은 이 요건을 더 어렵게 만드는데, ViT의 계산량이 이미지 토큰 수의 제곱으로 늘고 길어진 시각 문맥이 KV 캐시를 부풀려 이후의 모든 attention 연산을 늘리기 때문이다.
최적화는 프로파일링으로 찾은 두 병목을 각각 겨냥한다.
- denoising 스텝은 memory-bound라 GPU 커널 실행 시간이 CPU 실행 지연보다 짧고, 그래서 커널 사이의 빈 구간이 지연을 지배한다. 스텝별 계산 그래프가 고정이므로 denoising 스텝 전체를 CUDA Graph 하나로 캡처해 CPU 디스패치를 임계 경로에서 제거한다.
- RoPE와 RMSNorm처럼 개별로는 싸지만 매번 중간 텐서를 만들어 HBM 대역폭을 소모하는 연산을, 레지스터 안에서 끝나는 단일 CUDA 커널로 융합해 2배에서 10배의 속도 향상을 얻는다.
측정은 RTX 5090 한 장에 3시점 이미지를 넣고 진행했다.
| 입력 해상도 | 제어 주기 | 비고 |
|---|---|---|
| 224 × 224 | 21Hz | denoising 스텝 T는 10 |
| 448 × 448 | 15Hz | PyTorch eager 대비 4배 |
448 × 448에서 15Hz는 1초에 15번 새로운 action chunk를 계산한다는 뜻이다. baseline이 ViT의 제곱 비용과 부풀어 오른 KV 캐시에 가장 크게 묶이는 구간이 고해상도이므로 상대적 이득도 여기서 가장 크다.
데이터
로봇 manipulation 데이터
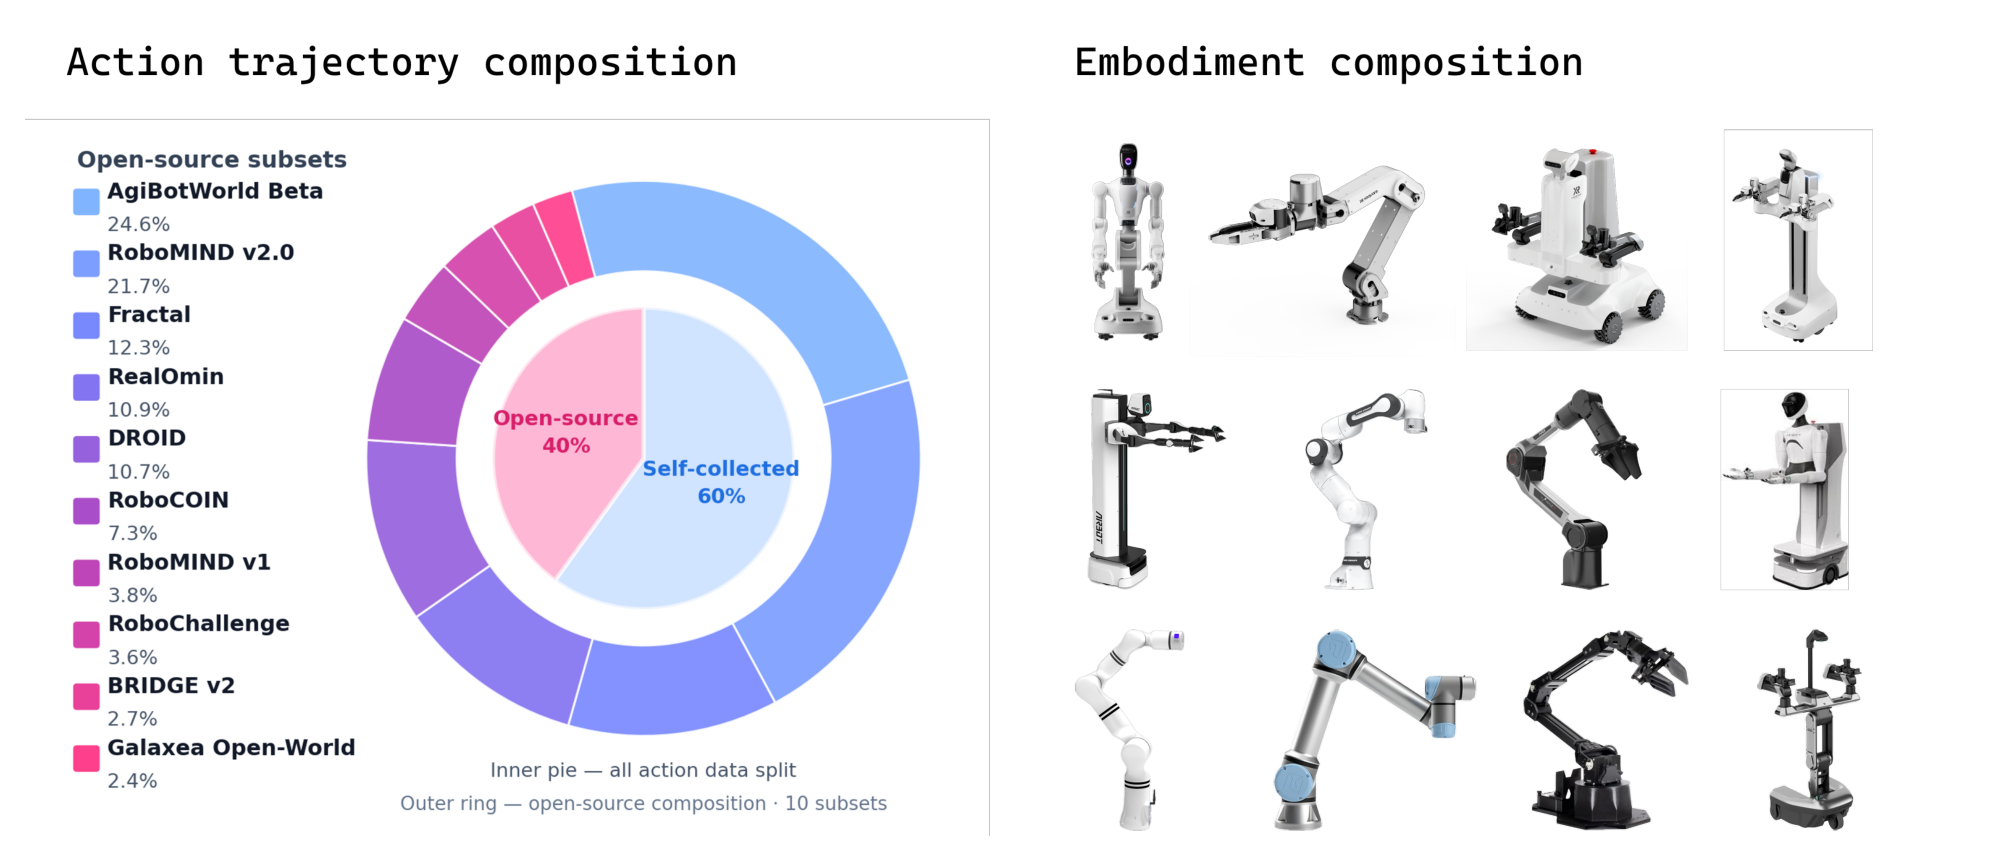
자체 수집분이 manipulation pre-training corpus의 중심이며 수천 개의 서로 다른 과제를 담는다. 플랫폼은 탁상형 양팔 시스템과 이동형 manipulator 두 계열이고, 여기에 특정 로봇 형상에 데이터를 묶지 않는 저비용 수집 장치 XRZero-G0가 더해진다. 장면은 가정, 산업, 사무 같은 비정형 실제 환경과 재현성을 위한 통제 수집실로 나뉘며, 과제 라벨은 조작 난이도, trajectory 길이, 공간 추론과 변형체 상호작용 같은 특수 속성 세 항목으로 달린다.
언어 주석은 episode 수준과 구간 수준 양쪽에 붙는다. episode마다 목표만 적은 짧은 지시와 중간 하위 목표를 나열한 상세 지시를 함께 달고, 긴 teleoperation trajectory는 원자적 하위 목표 단위로 잘라 각 구간에 맞는 지시를 달아 기본 지시문 수천 개와 표현 변형 수만 개를 만든다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다.
open-source 데이터는 embodiment와 장면 범위를 넓힌다. 형식 정렬과 메타데이터 검증, 원천 간 필드 매핑으로 통합한 뒤 타임스탬프 연속성, action과 observation의 정합성, 프레임 이상 여부로 걸러 10개 부분집합을 남겼다.
전처리와 샘플링
같은 embodiment라도 데이터셋마다 좌표계 방향과 회전 표현 규약, 그리퍼 상태 극성이 어긋나므로 그대로 두면 잡음이 되어 co-training의 효과를 깎는다. 따라서 action 주석이 있는 모든 데이터셋에 통일 전처리를 적용한다.
- action space 통일: 양팔 end-effector pose, 관절 위치, 그리퍼 상태, 이동 베이스 운동, 리프트와 허리 구동, 머리 운동을 공통 스키마로 맞춘다. x가 앞, y가 왼쪽, z가 위이며 회전 0은 그리퍼가 정면을 보며 수평으로 벌어진 자세다. 관절 상태만 있는 데이터셋은 플랫폼 URDF로 forward kinematics를 수행해 end-effector pose를 복원한다.
- 시간 정렬: 타임스탬프 기준으로 영상 프레임과 action 프레임을 맞추고, 1대1 대응이 불가능하면 가장 가까운 타임스탬프의 상태 프레임을 짝짓는다.
- 오류 보정: 카메라 매핑이 뒤바뀌었거나 end-effector pose가 이상한 기록을 찾아 가능한 경우 보정하고 나머지는 버린다.
- 정지 프레임 제거: 거의 정지한 프레임은 같은 observation에 0에 가까운 action과 0이 아닌 action이 함께 붙어 감독 신호를 흐리고 추론 시 멈칫거림을 만든다. 제거 후에는 과제 실행의 박자가 눈에 띄게 조밀해진다.
샘플링은 원천 간 규모 차이와 원천 안의 과제별 롱테일을 함께 다룬다. 비례 샘플링을 쓰면 빈도가 높은 과제가 매 epoch의 gradient를 지배하므로, 원천과 과제 라벨로 그룹을 묶어 그룹 크기의 제곱근에 비례하는 가중치를 주고 그룹별 상한과 반복 재배분으로 큰 그룹이 예산을 독차지하지 않게 한다. 이렇게 뽑은 한 epoch이 100만 trajectory를 넘고 자체 수집이 약 60%, open-source가 약 40%다.
멀티모달 corpus
멀티모달 데이터는 gradient-bridged co-training에서 일반성의 닻 역할을 한다. 멀티모달 CE를 나르면서 backbone을 grounding된 vision-language 이해에 묶어 두고, 물체 인식과 장면 구성, 공간 관계, affordance, 과제 관련 상호작용 단서를 함께 감독한다. affordance는 물체가 허용하는 상호작용 가능성을 뜻한다. corpus 규모는 약 9,000만 샘플이며 7,800만은 open-source 데이터, 1,200만은 action trajectory에서 직접 합성한 embodied bridge 데이터다.
| 범주 | 과제 유형 | 대표 데이터셋 |
|---|---|---|
| 일반 vision-language | captioning, VQA, pointing, 추론 | CAPSFUSION, Cambrian, PixMo-Cap, COCO, VQAv2, PixMo-Point, OneThinker |
| embodied perception | grounding, pointing, 공간, affordance | RoboPoint, SpaceThinker, OpenSpaces, SpaceOm, RefSpatial, CrossPoint, SenseNova-SI |
| embodied cognition | 과제 VQA, 상호작용, 장기 추론 | Robo2VLM, EO-Data, RoboVQA, Cosmos-Reason1 |
bridge라는 이름이 붙은 이유는 이 샘플이 멀티모달 이해와 action 예측을 명시적으로 잇기 때문이다. action 학습과 같은 trajectory, 같은 observation, 같은 과제 맥락에서 자동 생성되므로 실행 가능한 로봇 동작과 처음부터 붙어 있다. bridge 데이터는 물체 이해, 공간 이해, 장면 이해, 과제 이해 네 층위로 조직되며, pointing과 grounding 과제에서는 좌표 주석을 텍스트 형식의 전용 공간 토큰으로 통일한다.
결과
fine-tuning 없는 실제 로봇 평가
평가 스위트는 17과제로 구성되며 그중 12개가 seen, 5개가 unseen이다. 과제 유형은 의미 이해, 강체, 변형체, 정밀, 장기 다단계 manipulation 다섯 범주에 걸친다.
| 구분 | 5만 | 10만 | 20만 | 30만 | 35만 | 40만 |
|---|---|---|---|---|---|---|
| seen 12과제 평균 | 26.1% | 31.7% | 40.1% | 40.4% | 48.1% | 50.0% |
| unseen 5과제 평균 | 24.2% | 41.0% | 38.8% | 34.8% | 47.6% | 53.6% |
| 전체 17과제 평균 | 25.5% | 34.5% | 39.8% | 38.7% | 47.9% | 51.1% |
전체 평균이 5만 스텝의 25.5%에서 40만 스텝의 51.1%로 두 배가 된다. 체크포인트 단위의 등락은 있지만 seen과 unseen이 나란히 오르며, 40만 스텝에서는 unseen이 53.6%로 seen의 50.0%를 근소하게 넘는다. 다만 두 그룹의 난이도가 맞춰져 있지 않으므로 절대 순서보다 추세가 더 많은 정보를 준다.
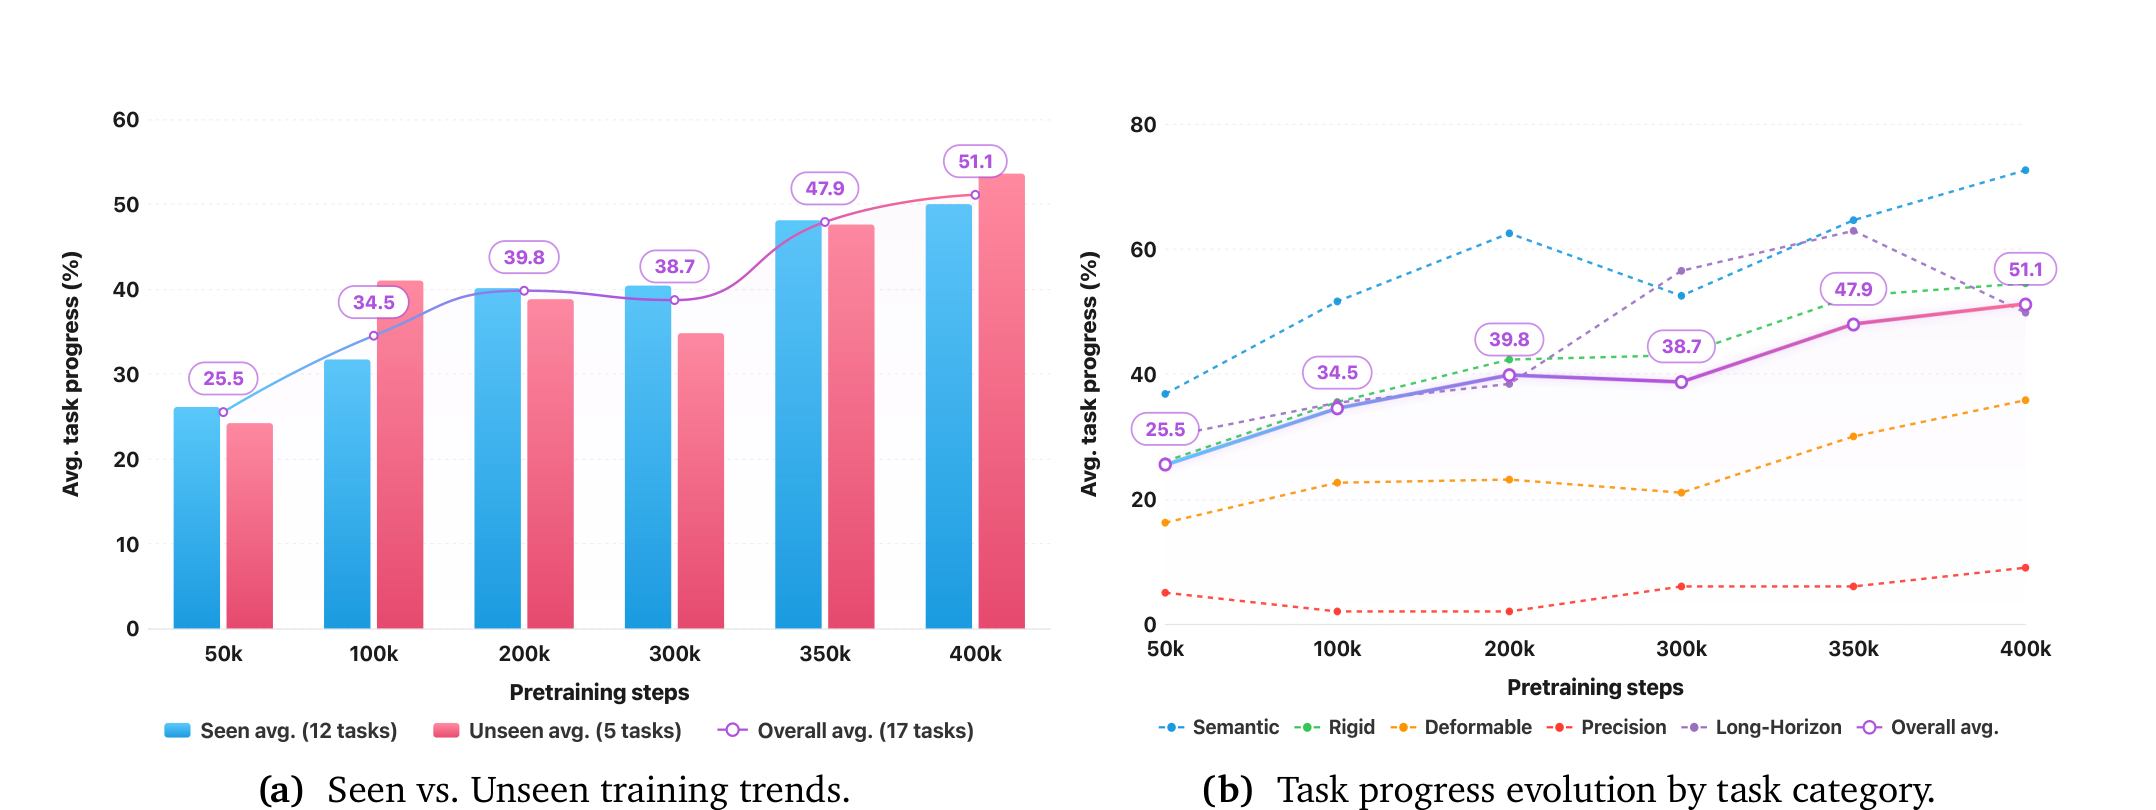
범주별로는 의미 이해 과제가 40만 스텝 평균 72.6%로 가장 강하다. 어떤 색이 어느 자리에 대응하는지, 고리를 기둥에 꽂아야 하는지 같은 시각 의미 판단이 성패를 가르는 과제들이며, 이 결과는 action 토큰 CE가 action 경로를 VLM의 의미 prior에 노출한다는 설계와 맞아떨어진다.
40만 스텝 성적을 기준으로 과제는 세 등급으로 갈린다.
| 등급 | 기준 | 해당 과제 |
|---|---|---|
| zero-shot 숙달 | 60% 이상 | Block Sorting 100%, Fruit Sorting 96%, Ring Stacking 86%, Rope Tightening 82%, Cup Grasping 64%, Bean Pouring 60% |
| 부분 숙달 | 40%에서 60% | Switch Pressing 55%, Number Ordering 54%, Flower Arranging 51%, Package Sorting 48.5% |
| zero-shot 범위 밖 | 20% 미만 | Towel Folding 10%, Table Setting 9%, Charger Plugging 9% |
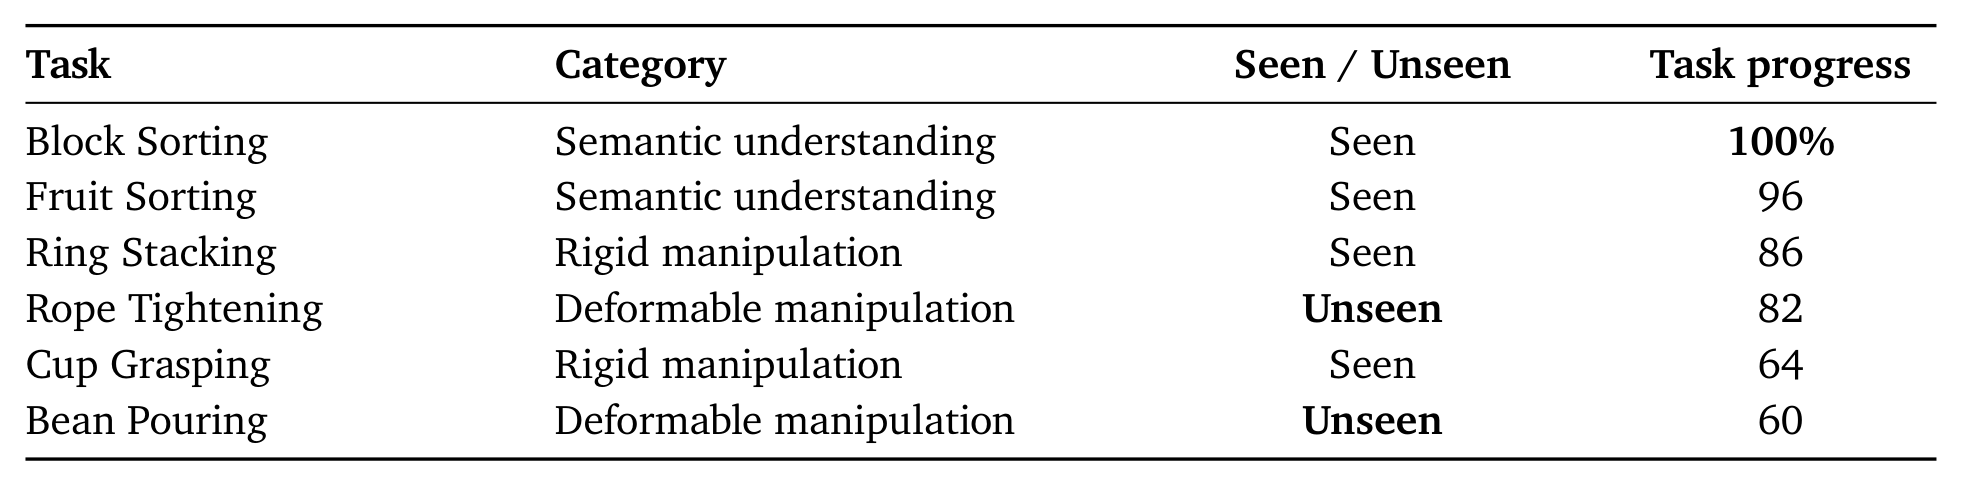
부분 숙달 등급의 과제는 접근, 잡기, 이동 같은 기초 조작은 익혔지만 마지막 정밀 실행에서 미끄러진다. 저자들은 이 구간이 곧 fine-tuning이 메워야 할 능력 격차라고 본다.
범위 밖 등급이 변형체와 정밀 조작에 몰린 데는 두 가지 이유가 붙는다. 첫째, 이 과제들은 강체 pick-and-place보다 본질적으로 어렵고 요구되는 정밀도와 상태 인식이 fine-tuning 없이 도달할 수준을 넘어선다. 둘째, 천 가장자리를 집거나 trajectory를 따라 접거나 삽입을 위해 정렬을 세밀하게 맞추는 동작 패턴은 데이터셋에서 상대적으로 고립되어 있어 다른 과제의 action 분포와 겹치는 부분이 적다.
과제별 추이를 보면 능력이 계단처럼 나타난다.
| 과제 | 5만 | 10만 | 20만 | 30만 | 35만 | 40만 |
|---|---|---|---|---|---|---|
| Block Sorting (seen) | 46% | 85% | 87.5% | 51.5% | 96% | 100% |
| Fruit Sorting (seen) | 41% | 19% | 81% | 61% | 61% | 96% |
| Ring Stacking (seen) | 18% | 18% | 51% | 73% | 100% | 86% |
| Rope Tightening (unseen) | 26% | 30% | 54% | 60% | 62% | 82% |
| Bean Pouring (unseen) | 12% | 50% | 19% | 13% | 50% | 60% |
| Pot Lid Covering (unseen) | 0% | 18% | 23% | 15% | 26% | 30% |
Block Sorting은 중후반에 50%대에서 100%로 뛰고, Ring Stacking은 35만 스텝에서 100%에 닿았다가 40만 스텝에서 86%로 내려앉는다. 저자들은 이 계단식 출현을 대형 언어 모델의 emergent capability에 비유한다. emergent capability는 학습 데이터에 없던 조합을 모델이 실행해내는 성질을 말한다. 전체 평균이 40만 스텝에서도 계속 오르는 중이므로 pre-training이 아직 포화하지 않았다고 본다.
unseen의 의미를 저자들이 스스로 좁혀 둔 대목도 있다. 이 과제들은 현재 embodiment에서 동일 과제로 수집된 적이 없고 소품 조합도 완전히 새롭지만, pre-training corpus의 open-source 데이터에 의미상 관련된 조작 경험이 들어 있을 수 있다. 따라서 여기서의 일반화는 완전히 새로운 기술의 습득이라기보다 장면과 소품을 건너뛰는 기술 전이에 가깝다.
fine-tuning 이후 비교
비교 대상은 서로 다른 두 패러다임의 pre-training된 로봇 foundation model로, π0.5는 VLA이고 DreamZero는 world-action model이다. 세 모델 모두 각자의 공식 가중치에서 출발해 15과제(manipulation 10개 + reasoning 5개)에 같은 데이터와 같은 프로토콜로 fine-tuning했으며, 과제당 시연 데이터(demonstration)는 약 500개 trajectory다.
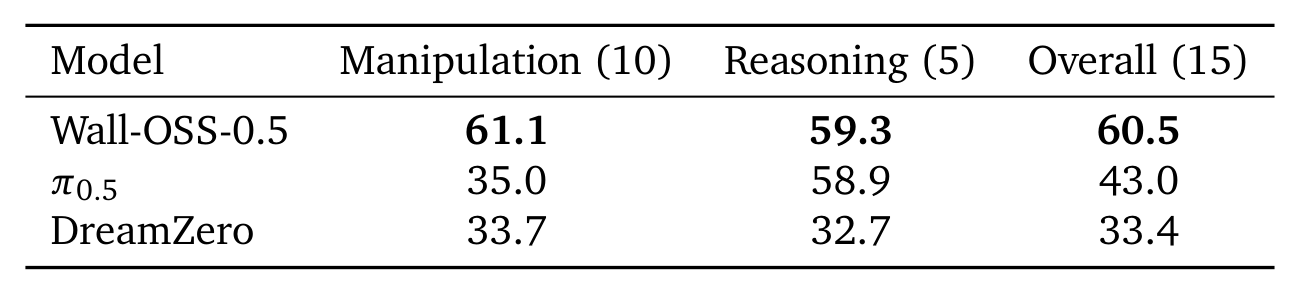
| 모델 | manipulation 10과제 | reasoning 5과제 | 전체 15과제 |
|---|---|---|---|
| Wall-OSS-0.5 | 61.1% | 59.3% | 60.5% |
| π0.5 | 35.0% | 58.9% | 43.0% |
| DreamZero | 33.7% | 32.7% | 33.4% |
Wall-OSS-0.5는 전체 평균 60.5%로 π0.5를 17.5%p, DreamZero를 27.1%p 앞서며 15과제 중 10개에서 최고점을 낸다. 격차가 벌어지는 곳은 manipulation 쪽으로 여기서는 π0.5와의 차이가 26.1%p로 커지는 반면, reasoning 쪽은 59.3% 대 58.9%로 사실상 붙어 있다.
| 과제 | 범주 | Wall-OSS-0.5 | π0.5 | DreamZero |
|---|---|---|---|---|
| Color Block Sorting | manipulation | 96% | 42% | 27% |
| Ring Stacking | manipulation | 91% | 60% | 27% |
| Spoon-in-Bowl | manipulation | 80% | 43% | 54% |
| Object-to-Basket | manipulation | 74.8% | 37% | 97.8% |
| Glasses Rack Placement | manipulation | 66% | 87% | 37% |
| Cup Triangle Stacking | manipulation | 58% | 18% | 25% |
| Drawer Organization | manipulation | 52% | 7% | 7% |
| Power Cord Plugging | manipulation | 50% | 21% | 24% |
| Water Pouring | manipulation | 25% | 19% | 12% |
| Pencil Case Packing | manipulation | 18.5% | 16% | 26% |
| Fruit Basket Placement | reasoning | 86% | 94% | 45% |
| Earphone Sorting | reasoning | 82% | 73% | 66% |
| Shape Sorting | reasoning | 68% | 63% | 36% |
| Object Matching | reasoning | 44.5% | 51.5% | 13.5% |
| Sequential Button Pressing | reasoning | 16% | 13% | 3% |
Color Block Sorting, Ring Stacking, Drawer Organization, Spoon-in-Bowl 네 과제에서 π0.5를 30%p 이상 앞서는데, 모두 의미 이해와 중간 정밀도 위치 결정, 다단계 조작을 함께 요구한다. 반대로 π0.5가 앞서는 과제는 Glasses Rack Placement, Fruit Basket Placement, Object Matching 셋이다. 남은 약점인 Pencil Case Packing 18.5%는 지퍼를 열고 물건을 넣은 뒤 닫는 정밀 양팔 조작이라 현재의 데이터 예산으로 채우기 어렵다고 본다.
fine-tuning 성적이 pre-training 성적을 따라간다는 관찰도 붙는다. fine-tuning 후 가장 강한 Color Block Sorting 96%와 Ring Stacking 91%는 zero-shot에서도 각각 100%와 86%였고, 반대로 zero-shot이 낮았던 Drawer Organization이 52%로 뛴 사례는 fine-tuning의 증폭 효과를 보여준다. 즉 pre-training이 세운 능력의 토대가 fine-tuning 성능의 천장에 크게 영향을 준다.
다중 과제 fine-tuning 확장
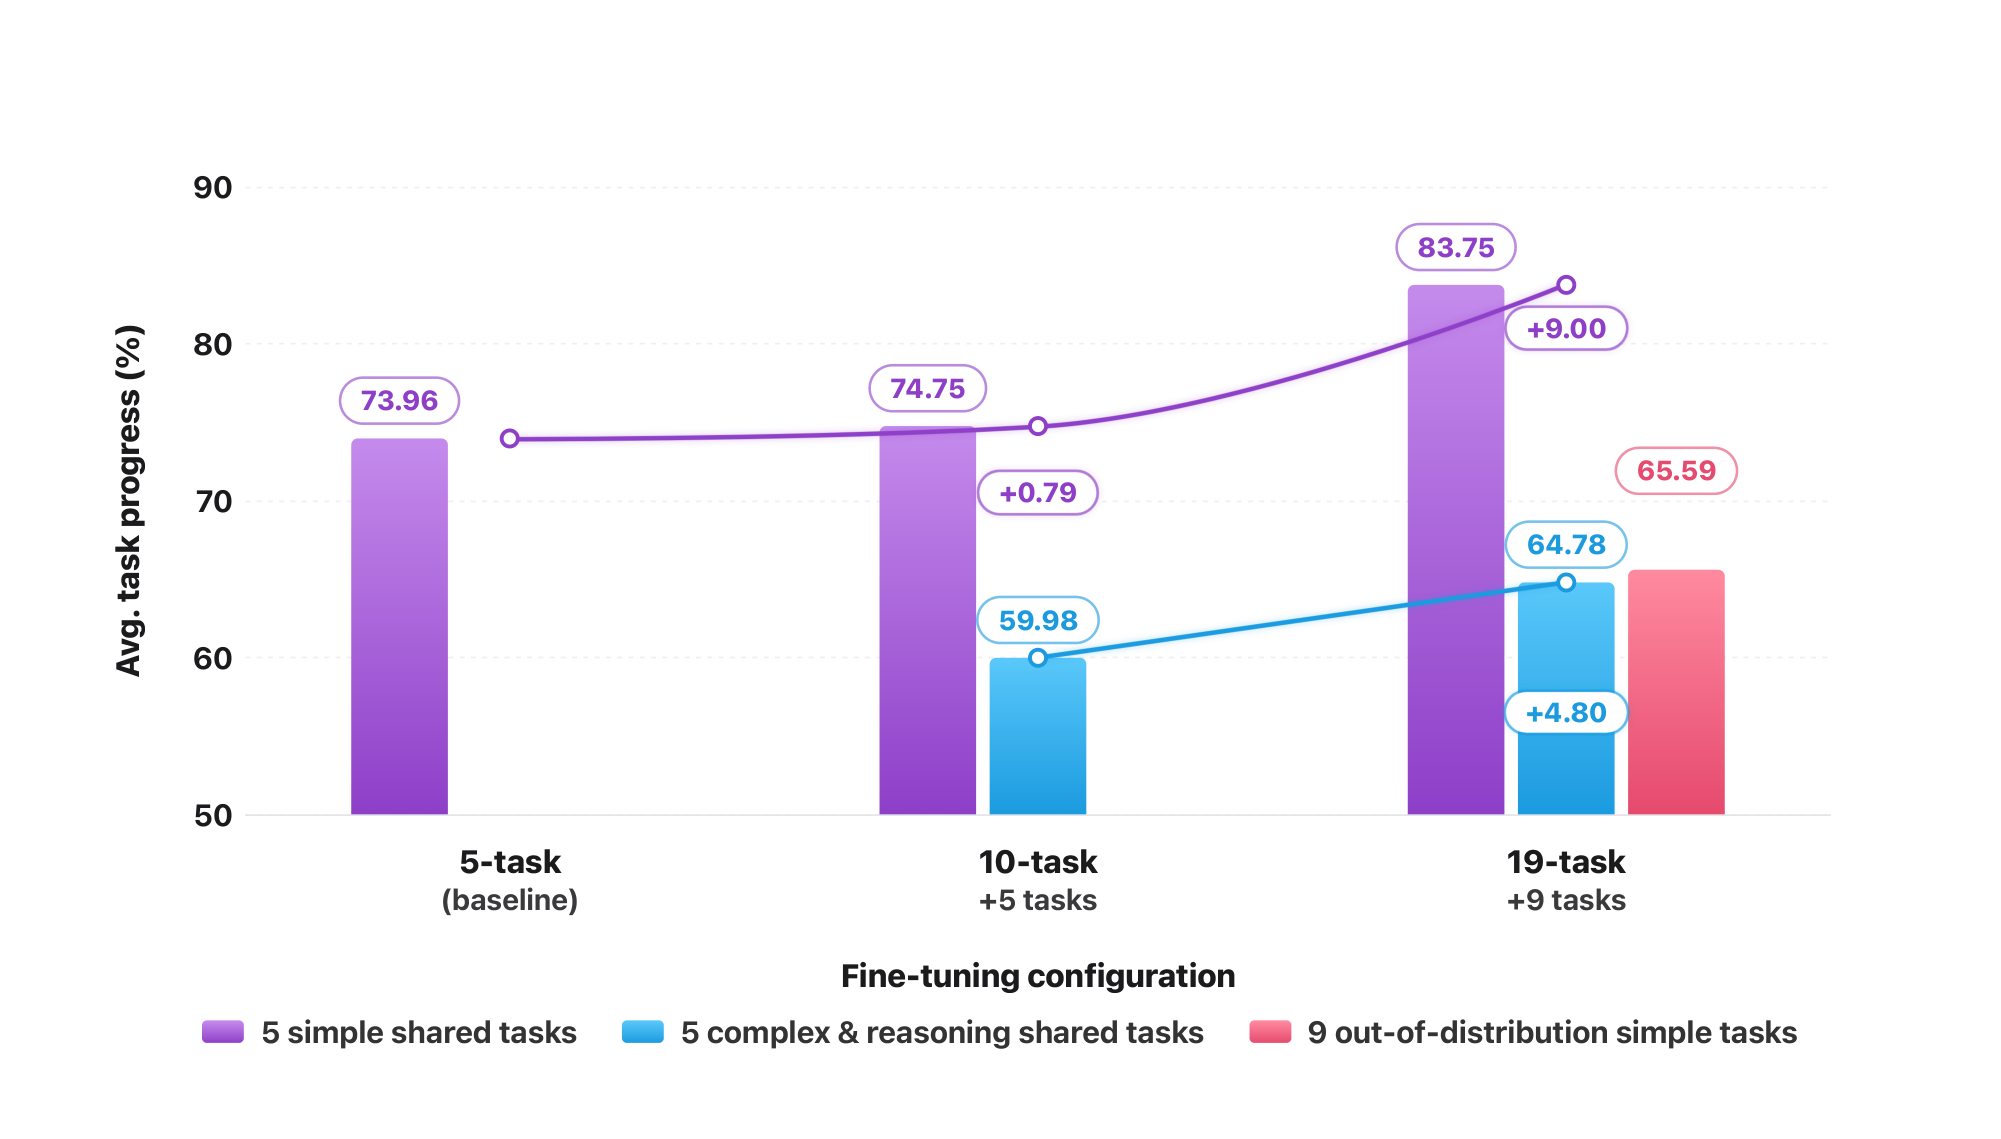
fine-tuning 과제 집합을 5개, 10개, 19개로 늘리면서 같은 체크포인트에서 각각 6 epoch씩 학습했다. 10과제 구성은 5과제에 난이도가 높거나 다단계 추론이 필요한 과제 5개를, 19과제 구성은 거기에 manipulation 과제 9개를 더한 것이다. 새로 더한 9과제는 배경 환경과 embodiment 분포가 기존 10과제와 눈에 띄게 달라 과제 수뿐 아니라 장면과 물체 범위도 함께 넓힌다.
| 평가 부분집합 | 5과제 구성 | 10과제 구성 | 19과제 구성 |
|---|---|---|---|
| 공유 단순 5과제 | 73.96% | 74.75% | 83.75% |
| 공유 10과제 | 해당 없음 | 59.98% | 64.78% |
| 새로 더한 9과제 | 해당 없음 | 해당 없음 | 65.59% |
과제를 늘리면 기존 과제가 희석될 것으로 예상하기 쉽지만 결과는 반대다. 공유 5과제는 9.8%p, 공유 10과제는 4.8%p 오르며 분포가 다른 9과제를 넣은 뒤에도 그 이득이 유지된다. 과제별로 보면 Package Sorting이 10과제 구성의 50.75%에서 19과제 구성의 82.75%로, Switch Pressing이 53%에서 76%로 오른다.
저자들은 통째 과제 전이보다 세부 능력 수준의 보충이 원인일 가능성이 크다고 본다. 새로 더한 9과제가 전체 형태는 크게 달라도 접근, 정렬, 잡기, 조정, 놓기 같은 원자적 동작 패턴이 학습에 노출되는 빈도를 늘리고, 물체 묘사 방식과 지시 표현, 환경 교란 조건의 조합 공간을 넓힌다는 설명이다.
멀티모달 능력의 변화
co-training이 멀티모달 이해에 미친 영향은 backbone인 Qwen2.5-VL-3B를 기준선으로 삼아 일반 VQA 두 개와 로봇 실행에 직결되는 embodied 이해 세 개, 모두 5개 벤치마크에서 측정했다.
| 항목 | 벤치마크 | Qwen2.5-VL-3B | Wall-OSS-0.5 | 변화 |
|---|---|---|---|---|
| 일반 VQA | RealWorld VQA | 59.2% | 44.2% | −15.0%p |
| 일반 VQA | ERQA | 38.3% | 32.8% | −5.5%p |
| embodied 장면 | EO-Bench | 20.8% | 24.7% | +3.9%p |
| embodied grounding | Embodied Grounding | 9.0% | 30.8% | +21.8%p |
| 배치 추론 | Where2Place | 4.0% | 15.0% | +11.0%p |
embodied 쪽은 오르고 개방 도메인 VQA는 내려간다. 가장 큰 상승인 Embodied Grounding은 로봇 1인칭 시점 이미지에서 조작 대상을 좌표로 짚는 내부 제작 벤치마크이며, backbone의 기준선 9.0%가 원래 pre-training 초점 밖이라 낮았던 것이 상승 폭을 키웠다. 세 embodied 항목의 상승은 "어디를 보고, 어디를 가리키고, 어디에 놓을지"라는 로봇 실행 파이프라인의 핵심 perception 요구와 대응한다.
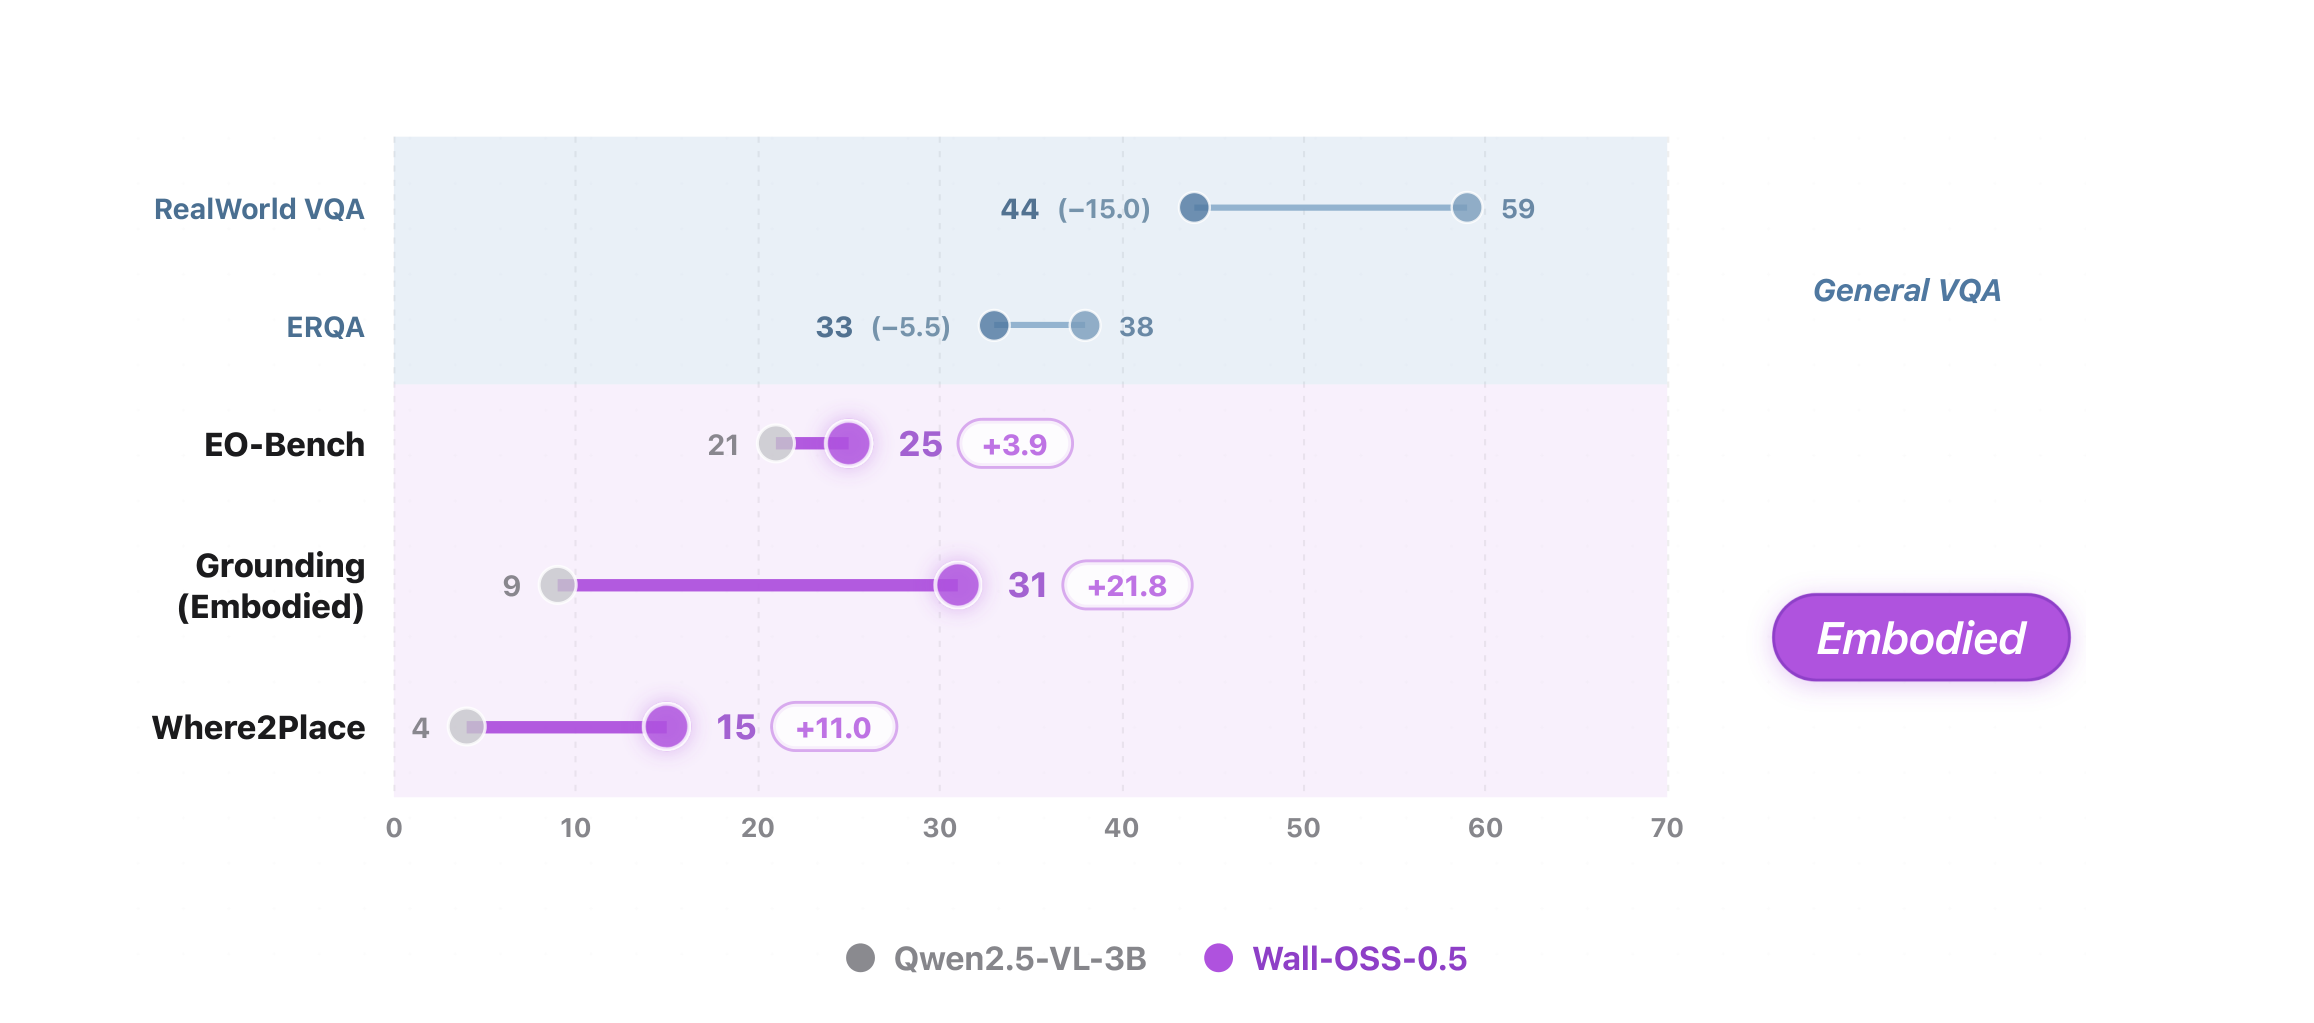
저자들은 이 변화를 손실이 아니라 특화로 읽는다. action 실행이 주 목적인 모델이 embodied 공간 판단 신호를 얻는 대신 개방 도메인 VQA 성능의 일부를 내주는 교환이며, 일반 이미지 이해에서 전용 VLM과 경쟁하는 것이 목표가 아니라는 설명이다.
다만 특화 압력을 방치한 것은 아니다. 사전 실험에서 embodied bridge 데이터가 모자라면 강한 action 토큰 예측 목표가 로봇 observation 분포에서의 멀티모달 점수까지 크게 떨어뜨린다는 것을 확인했고, 1,200만 개의 bridge 샘플은 그 압력을 상쇄하는 로봇 시점 grounding과 공간 판단 감독으로 투입됐다.
설계 ablation
co-training 전략 비교
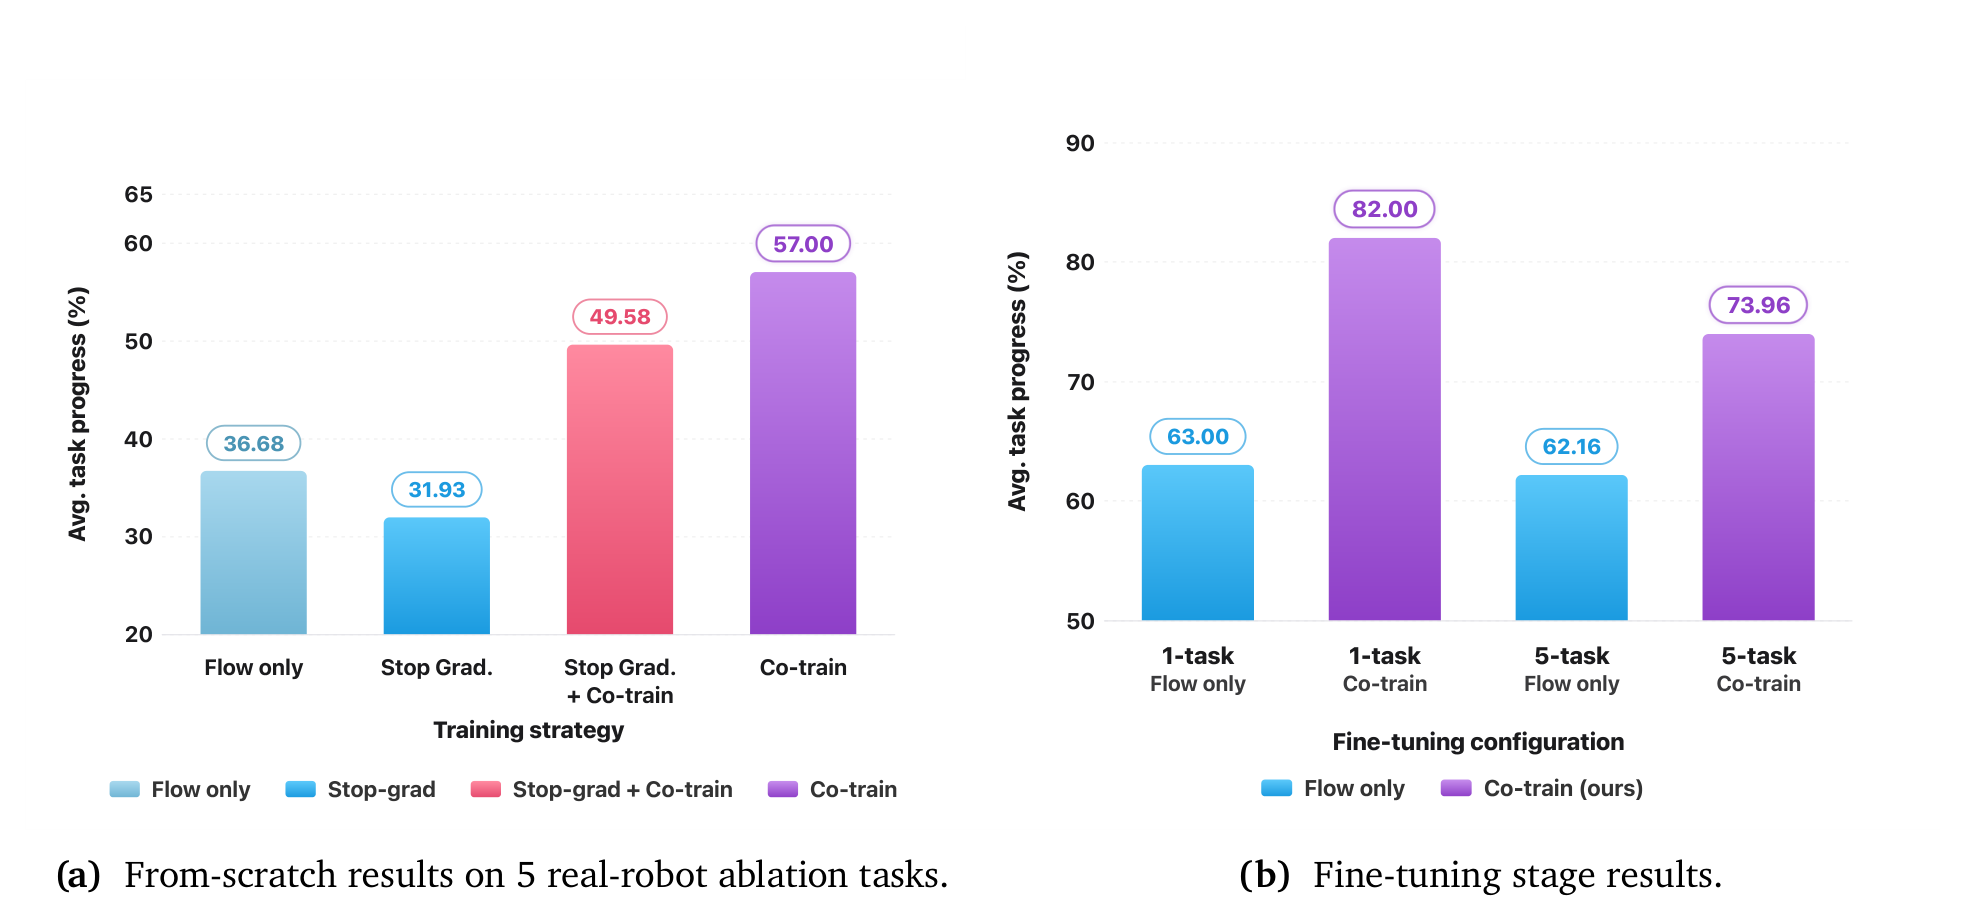
네 가지 학습 전략을 VLM backbone만 pre-training 가중치로 초기화한 채 밑바닥부터 학습해 비교했다. 실제 로봇 5과제에서 7만 스텝씩 동일 설정으로 수행했으며, 이 5과제는 밑바닥 학습이 가능한 부분집합이라 앞선 17과제 평가와 절대값을 직접 비교할 수는 없다.
| 전략 | 구성 | 평균 task progress |
|---|---|---|
| co-training | action 토큰 CE, flow matching, 멀티모달 CE를 함께 최적화하고 모든 gradient가 backbone까지 흐른다 | 57.00% |
| stop-gradient 후 co-training | stop-gradient로 먼저 학습한 뒤 gradient 차단을 풀어 전환한다 | 49.58% |
| flow only | action 토큰 CE를 제거하고 flow matching과 멀티모달 CE만 최적화한다 | 36.68% |
| stop-gradient | flow matching gradient를 backbone에서 차단하고 두 CE만 backbone을 갱신한다 | 31.93% |
세 신호 중 어느 하나를 빼거나 2단계로 대체하면 실제 로봇 성능이 7.4%p에서 25.1%p 떨어진다. 네 전략의 VQA 점수는 촘촘하게 모여 있고 그중 stop-gradient가 근소하게 앞선다.
VQA에서 근소하게 앞선 stop-gradient가 모든 action 과제에서 최하위라는 점이 이 실험의 핵심이다. stop-gradient는 flow 손실 수렴이 느리고 최종값도 높아 Action Expert가 과소적합되었음을 보여주는 반면, co-training의 flow 손실은 flow only와 stop-gradient 양쪽보다 빠르게 수렴한다.
이 결론은 pre-training에 그치지 않는다. fine-tuning 단계에서도 이산 action 토큰이 backbone에 더 효율적인 적응 신호를 주어, 1과제 구성에서 flow only 63.00% 대 co-training 82.00%, 5과제 구성에서 flow only 62.16% 대 co-training 73.96%로 갈린다. 따라서 fine-tuning 단계에도 같은 co-training 구성을 적용한다.
Action-Space Supervision
action 공간 손실과 velocity 공간 손실은 LIBERO 시뮬레이션에서 통제 비교했다. 두 조건 모두 pre-training backbone과 같은 구조를 Qwen2.5-VL 가중치로 초기화하고 Action Expert는 밑바닥부터 학습했으며, 전역 배치 128에 나머지 하이퍼파라미터는 동일하다.
action 공간 손실이 2만 5천 스텝에서 평균 성공률 96.5%로 최고점을 찍어 velocity 공간 손실의 최고점을 6.2%p 앞선다. 수렴도 빨라서 2만 스텝 만에 95.8%에 도달하는 반면, velocity 공간 손실은 3만 5천 스텝을 다 써도 90.3%를 넘지 못하고 2만 스텝 부근에서 큰 등락을 보인다. action 공간 손실은 2만 스텝 이후 92.5%에서 96.5% 범위를 유지한다.
유일한 예외는 학습 초기인 1만 스텝 구간이다. action 공간 손실이 velocity 공간 손실에 (1−τ)² 가중을 준 것과 같아 저노이즈 구간의 gradient 신호가 초기에 희박하기 때문이며, 고노이즈 감독으로 저주파 trajectory 구조를 확보하고 나면 성능이 빠르게 올라간다.
RVQ tokenizer
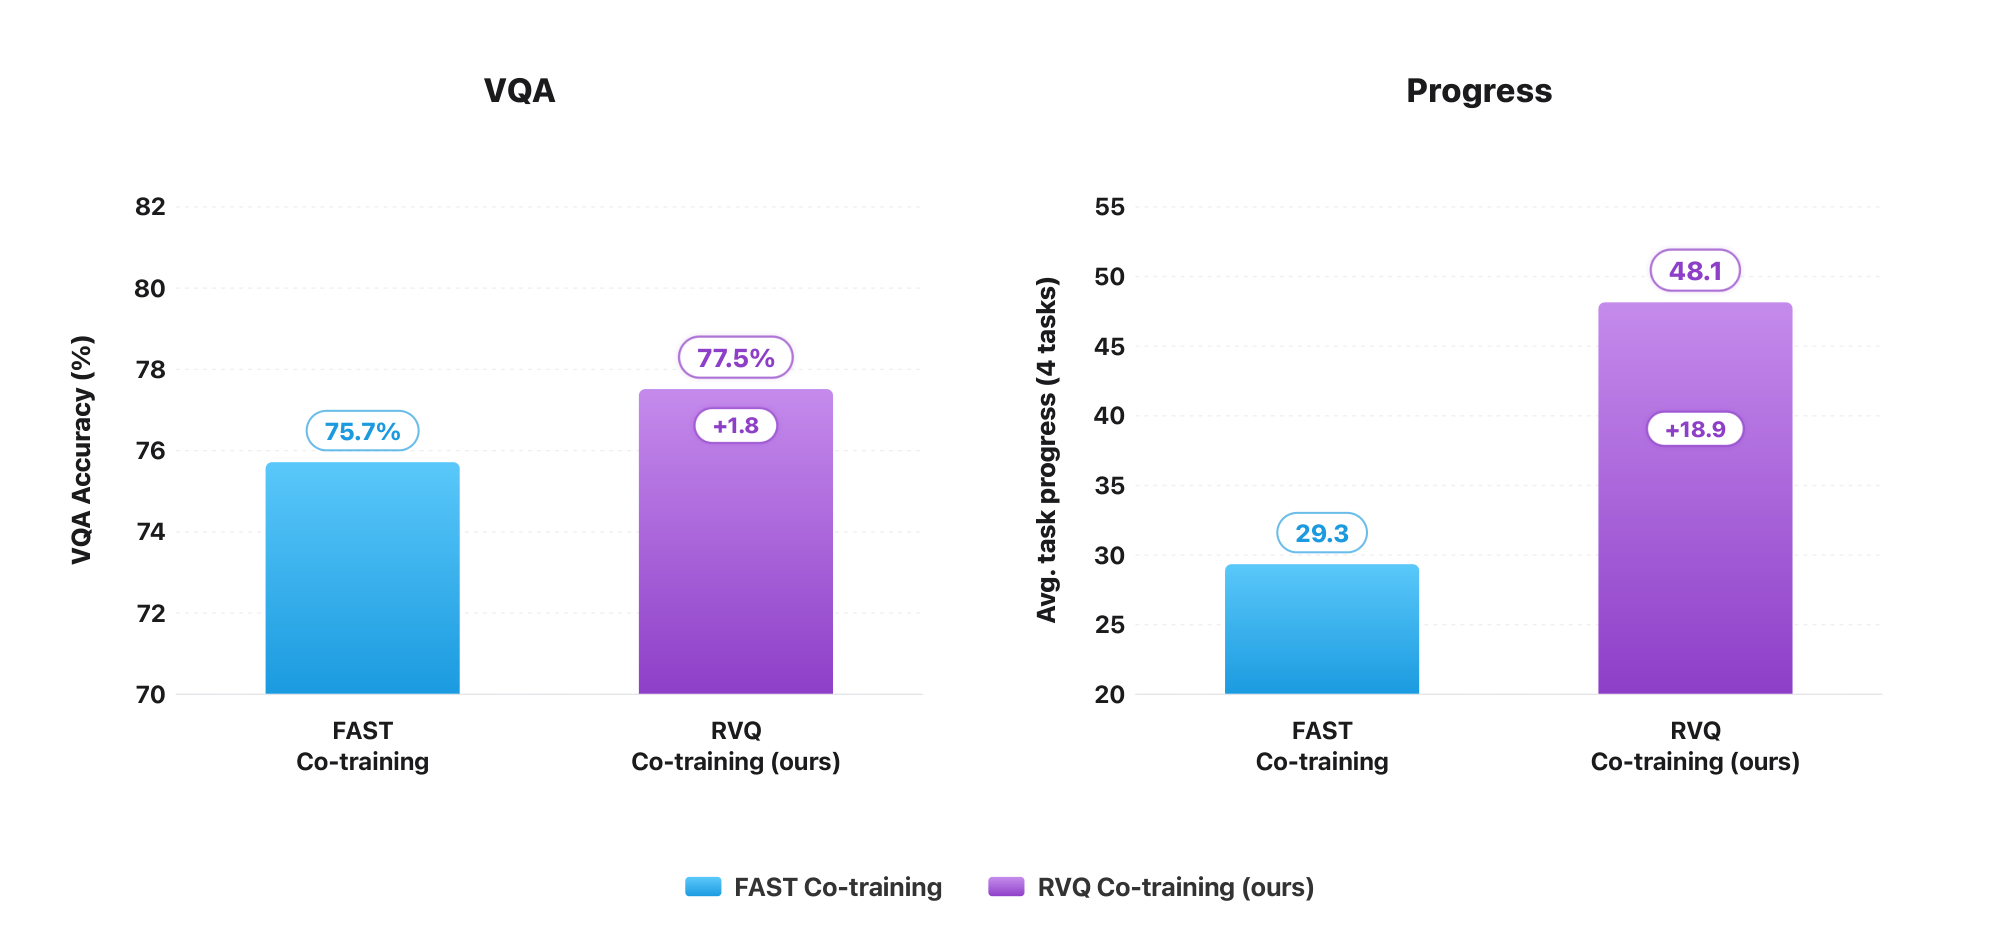
tokenizer만 바꾼 통제 실험으로 Vision-Aligned RVQ Action Tokenizer와 FAST tokenizer를 비교했다. 동일한 co-training 설정에서 VLM backbone 가중치부터 학습했으며, 평가는 실제 로봇 4과제와 VQA 과제 하나로 구성했다.
| 지표 | FAST co-training | RVQ co-training | 변화 |
|---|---|---|---|
| VQA 정확도 | 75.7% | 77.5% | +1.8%p |
| 실제 로봇 4과제 평균 task progress | 29.3% | 48.1% | +18.9%p |
VQA 정확도가 유지되는 데 그치지 않고 올랐다는 점이 첫 번째 결과다. tokenizer 학습에 쓴 보조 목표인 시각과 action의 alignment와 다음 프레임 예측이 토큰 표현을 빚으면서 VLM의 전반적 시각 의미 이해에도 기여했다는 해석이다.
두 번째 결과인 실제 로봇 성적의 큰 상승은 해석의 폭이 더 넓다. 이 평가가 이산 토큰 디코딩이 아니라 flow matching이 만든 연속 action으로 이뤄지므로, tokenizer 품질의 이득이 이산 경로에만 갇히지 않고 연속 action 생성의 품질까지 끌어올린다는 뜻이다.
한계
gradient bridge의 동역학이 3B VLM backbone에서만 검증됐다. 더 큰 backbone으로 규모를 키우면 세 학습 신호의 상대적 기하와 상호작용 세기가 크게 달라질 수 있다.
입력이 단일 프레임 이미지라 시간 기억과 지속적 상태 추적이 필요한 long-horizon 과제의 zero-shot 성능이 제약된다. 실제로 zero-shot 범위 밖 등급에 장기 다단계 과제가 몰려 있다.
Vision-Aligned RVQ Action Tokenizer와 그에 딸린 학습 파이프라인이 26차원 action 표현에 고정되어 있다. 따라서 손가락이 많은 dexterous hand처럼 자유도가 큰 embodiment에는 그대로 적용하기 어렵다.
평가가 여전히 사람이 설계한 채점 기준에 기댄다. 현재의 실제 로봇 벤치마크는 31개 과제를 다루지만 다중 로봇 협업, 장시간 배치, 넓은 개방 세계 상호작용은 아직 포함하지 않는다.
후속 계획으로는 더 큰 VLM backbone으로의 확장, long-horizon 과제를 위한 시간 observation과 계층적 계획의 도입, 다양한 로봇 형상을 지원하는 더 일반적인 action 표현의 탐색을 든다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| gradient-bridged co-training | 이산 action 토큰 CE를 backbone을 미는 다리로, 멀티모달 CE를 vision-language 능력의 닻으로, flow matching을 배포용 생성기로 쓰는 단일 단계 학습 레시피 |
| Mixture-of-Transformers | 층마다 VL Expert와 Action Expert를 따로 두되 attention 문맥을 공유해 gradient가 양쪽으로 흐르게 하는 backbone 구성. 약어는 MoT |
| Vision-Aligned RVQ Action Tokenizer | residual vector quantization으로 action chunk를 다단계 이산 토큰으로 만들되 시각 feature alignment와 다음 프레임 예측까지 학습 목표에 포함한 학습형 tokenizer |
| Action-Space Supervision | flow matching 손실을 velocity가 아니라 복원된 action 공간에 걸어 고노이즈 구간을 강조하는 방식. velocity 공간의 (1−τ)² 가중과 등가다 |
| embodied bridge data | action pre-training corpus의 trajectory에서 자동 생성한 멀티모달 감독 데이터. 로봇 시점의 grounding과 공간 판단을 담아 이해와 실행을 잇는다 |
| task progress | 과제의 부분 완료 정도를 0%에서 100%로 재는 척도. 단계별 채점 기준의 실제 점수를 만점으로 나눠 100을 곱하며 과제당 10회 실행으로 평가한다 |
관련 페이지
- Igniting VLMs toward the Embodied Space: 같은 팀의 전작 WALL-OSS. Inspiration과 Integration 두 단계였던 커리큘럼이 여기서 단일 단계 co-training으로 합쳐지고, FAST tokenizer가 학습형 RVQ로 바뀐다.
- 03-11. WALL-OSS - 모두의 로보틱스 - VLA 입문: 전작 WALL-OSS의 한국어 입문 해설. VLA 구조와 손실 함수가 낯설면 이 해설을 먼저 읽는다.
- Wall-X: Building General-Purpose Robots Based on Embodied Foundation Model: 이 모델의 학습과 추론 코드 저장소. 1.1.0이 서빙 런타임과 DMuon 지원을 담았다.
- WALL-OSS: Igniting VLMs toward the Embodied Space (X Square Robot 프로젝트 페이지): X Square Robot의 오픈소스 프로젝트 페이지. 모델 공개 범위와 배포 스택을 소개한다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 가장 가까운 비교 대상. FAST 기반 autoregressive 경로와 flow matching 경로를 co-training하되 stop-gradient를 쓴다는 점에서 갈린다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching action expert 계열의 출발점. Beta 분포 timestep 샘플링 편향도 여기서 가져왔다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: action을 텍스트 토큰으로 이산화한 초기 계열. 차원별 단순 이산화의 정밀도 한계를 보인 선례로 인용된다.
- OpenVLA: An Open-Source Vision-Language-Action Model: RT-2의 이산화 방식을 오픈소스로 옮긴 모델. 같은 선례 묶음에 들어간다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 고용량 planner와 경량 controller를 나누는 계층형 계열. Wall-OSS-0.5는 계층 분리 대신 층 단위 expert 라우팅을 택한다.
- Flow Matching for Generative Modeling: Action-Space Supervision이 다시 쓰는 flow matching의 토대.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: cross-embodiment 데이터 통합의 선례. 이 보고서의 mixture도 20종이 넘는 embodiment를 담는다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.