Physical AI · PAPER · 2025
Igniting VLMs toward the Embodied Space
요약
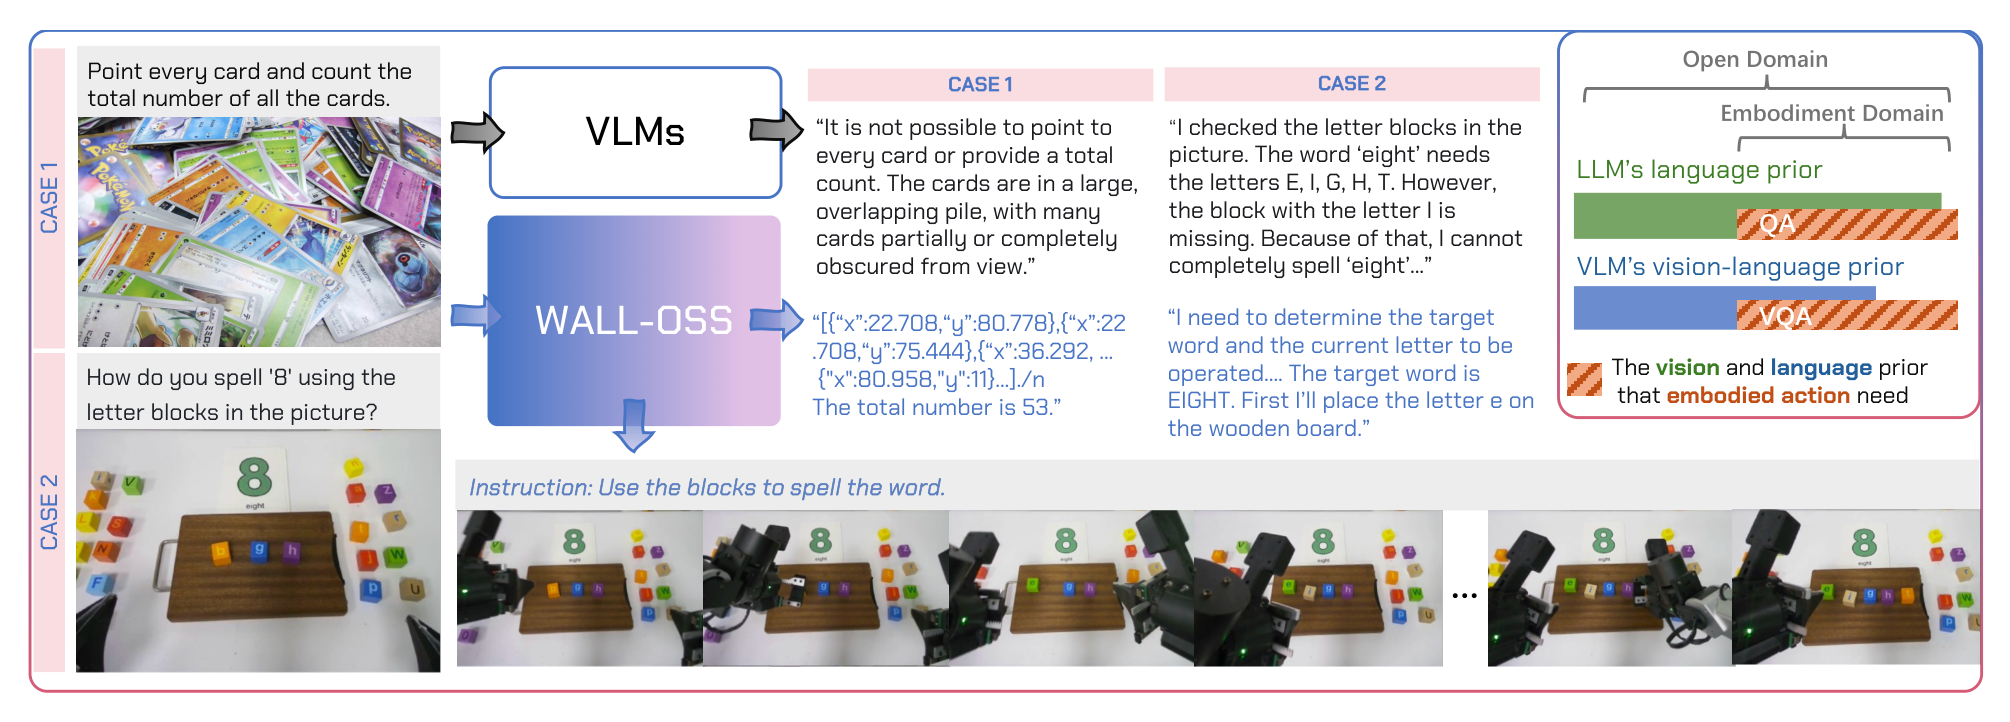
WALL-OSS는 X Square Robot이 2025년 9월에 공개한 embodied foundation model이다. Qwen2.5-VL-3B를 backbone으로 삼아 이미지와 언어를 이해하는 능력을 유지하면서, 같은 모델이 로봇의 연속 action까지 직접 생성한다.
이 논문의 주장은 VLM을 로봇으로 옮길 때 생기는 어긋남이 하나가 아니라 셋이고, 구조와 학습 커리큘럼을 함께 고쳐야 메워진다는 것이다. 따라서 해법도 세 가지가 짝을 이룬다. Self-Attention은 공유한 채 FFN만 vision-language용과 action용으로 나누는 tightly coupled 구조, 이산 action prior를 먼저 심고 연속 제어로 넘어가는 두 단계 커리큘럼, 그리고 지시문부터 연속 action까지를 하나의 미분 가능한 사슬로 묶는 Uni-CoT다.
학습 코드와 체크포인트를 함께 공개한 것도 논문이 스스로 든 기여다. embodied 범용 foundation model이 아직 드물어 재현 가능한 연구 기반이 부족하다는 것이 이유다.
배경
언어와 시각에서 foundation model이 빠르게 발전한 근거는 인터넷에 텍스트와 이미지가 넘칠 만큼 쌓여 있다는 사실이다. 반면 embodied 영역에서는 정렬된 vision-language-action 데이터가 희소하고 형식도 제각각이라, 밑바닥부터 학습해서는 action 모달리티의 일반화도 모달리티 사이의 연결도 얻기 어렵다.
그래서 최근 연구는 잘 학습된 VLM backbone을 action 공간으로 옮기는 경로를 택했다. OpenVLA와 π0가 대표적이며, 연속 action을 모델링하면서 vision과 language의 prior를 action 공간으로 끌고 오는 방식이다.
문제는 그 이전이 순탄하지 않다는 점이다. pre-training된 VLM에 action head를 붙이고 로봇 trajectory로 지도학습하는 단순한 fine-tuning은 심각한 weight drift를 일으킨다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이고, weight drift는 fine-tuning 중 가중치가 pre-training 시점에서 멀어져 원래 능력을 잃는 현상이다.
weight drift를 피하려는 대표적 처방이 knowledge insulation이다. VLM 파라미터의 변화를 최소화해 pre-training된 능력을 보존하는 방향인데, 논문은 여기에 두 가지 반론을 든다. 첫째, 느슨하게 결합된 구조는 semantics와 제어의 결합을 약하게 만든다. 둘째, VLM 자체가 embodied 영역에서 부실하기 때문에, vision-language prior 밖에 있는 action을 시키면 성능이 크게 하락한다.
VLM과 로봇 사이의 세 가지 gap
논문은 위 상황을 세 가지 gap으로 나눈다. 각 gap이 뒤에 나오는 설계 하나씩과 대응하므로, 이 구분이 논문 전체의 뼈대다.
| gap | 내용 | 대응 설계 |
|---|---|---|
| 모달리티와 데이터 규모 | action은 3D 공간과 시간 위에서 연속이고, 텍스트와의 의미 정렬을 밀어 줄 대규모 데이터가 없다. 게다가 embodied 장면에서는 여러 subtask와 구체적 동작 서술이 하나의 상위 지시문으로 뭉뚱그려진다 | Uni-CoT |
| pre-training 분포 | embodied 데이터는 1인칭 시점, 어안 왜곡, 자기 가림이 많아 인터넷 이미지와 통계가 다르다. 그래서 VLM은 공간 추론과 진행 상황 파악에서 약하다 | embodied VQA와 이산 action prior |
| 학습 목표 | VLM은 이산 시퀀스 위의 next-token prediction으로 학습되는 반면, action trajectory는 연속 고주파 신호라 diffusion이나 flow matching 같은 조건부 생성 목표에 더 어울린다 | mixture-of-experts 구조와 두 단계 커리큘럼 |
세 번째 gap에는 부연이 필요하다. 생성 목표를 VLM에 그대로 이식하면 토큰화 방식의 간극과 독립성 가정이 커져 언어와 action의 정렬이 오히려 약해진다. π0처럼 action을 상위 수준에서 이산화해 텍스트 토큰과 맞춘 뒤, 연속 신호는 self-attention을 통해 VLM 중간 표현과 상호작용시키는 절충안도 있지만, 논문은 그런 느슨한 결합으로는 텍스트와 action의 결속이 충분히 학습되지 않아 지시 이행이 부족해진다고 본다.
핵심 개념
embodied VQA는 로봇 시점 이미지에 대해 조작 가능성이나 다음 단계를 묻고 답하게 하는 질의응답 과제다. 일반 VQA가 인터넷 사진을 설명하게 한다면, embodied VQA는 1인칭 카메라에 잡힌 작업대 위에서 어떤 물체가 어디 있고 지금 어느 단계까지 왔는지를 묻는다.
FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이다. action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음을 말한다. 압축은 DCT로 저주파 성분만 남기고 양자화한 뒤 BPE로 자주 나오는 패턴을 묶는 순서로 진행된다.
flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다. WALL-OSS는 Integration 단계에서 이 기법으로 연속 action을 생성한다.
static router는 입력 종류에 따라 처리 경로를 고정 규칙으로 나누는 분기 장치다. 학습으로 경로를 정하는 softmax router나 top-k router와 달리, 어떤 feature가 어느 FFN으로 갈지가 미리 정해져 있다.
co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. WALL-OSS는 fine-tuning 시점에도 action 생성과 VQA를 함께 학습해 이 전략을 유지한다.
task progress는 성공과 실패의 이분법 대신 과제를 어디까지 진행했는지를 0%에서 100% 사이로 매기는 척도다. 여러 단계로 이루어진 과제에서 부분 성공을 구분하려고 쓴다.
compounding error는 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상이다. 모듈을 나눈 파이프라인에서는 모듈 경계마다 이 오차가 더해지므로, 단계가 많은 long-horizon 과제일수록 손해가 커진다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
방법
VLM을 action으로 옮기는 세 가지 설계
Figure 2가 VLA 구조를 셋으로 나눈다. 세 설계의 차이는 pre-training된 VLM의 어느 부분을 action과 공유하느냐에 있다.
| 설계 | 파라미터 공유 방식 | 대표 모델 | 논문이 지적하는 약점 |
|---|---|---|---|
| 통합형 | Self-Attention과 FFN을 모두 공유하고 action까지 next-token prediction으로 처리 | RT-2, OpenVLA | action 감독이 VLM 가중치 분포를 크게 흔들어 weight drift가 생기고, action에 과적합되면서 지시 이행과 일반화가 크게 하락한다 |
| 분리형 | action 예측용 브랜치를 따로 두고 VLM에서 정보만 참조 | π0 | vision과 language가 action 생성의 보조 신호로 밀려나, 결합이 느슨해져 지시 이행 능력이 약해진다 |
| WALL-OSS | Self-Attention은 공유하고 FFN만 vision-language용과 action용으로 분리 | WALL-OSS | 논문이 제안하는 절충안 |
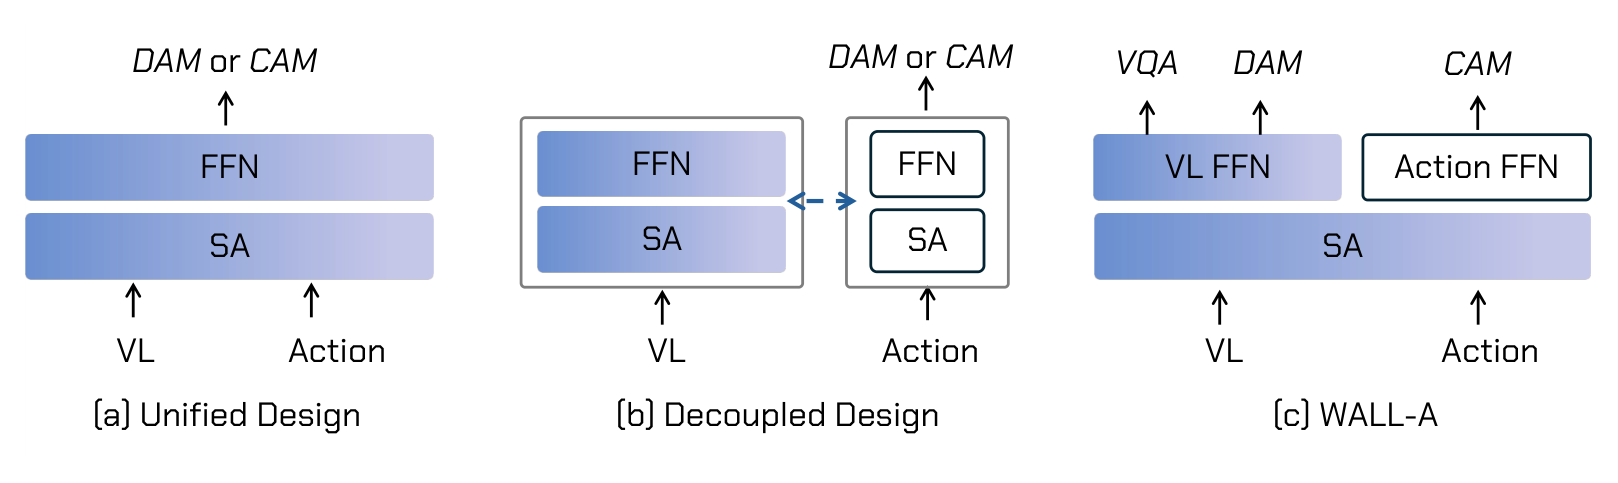
WALL-OSS의 절충 지점은 명확하다. 파라미터를 FFN 수준에서만 나누므로 학습 과제에 따라 다른 FFN이 활성화되지만, cross-modal 문맥은 공유된 attention 층에서 계속 섞인다. 즉 분리형처럼 action 학습이 vision-language 가중치를 직접 덮어쓰지 않으면서도, 통합형처럼 두 모달리티가 같은 문맥을 공유한다.
WALL-OSS 아키텍처
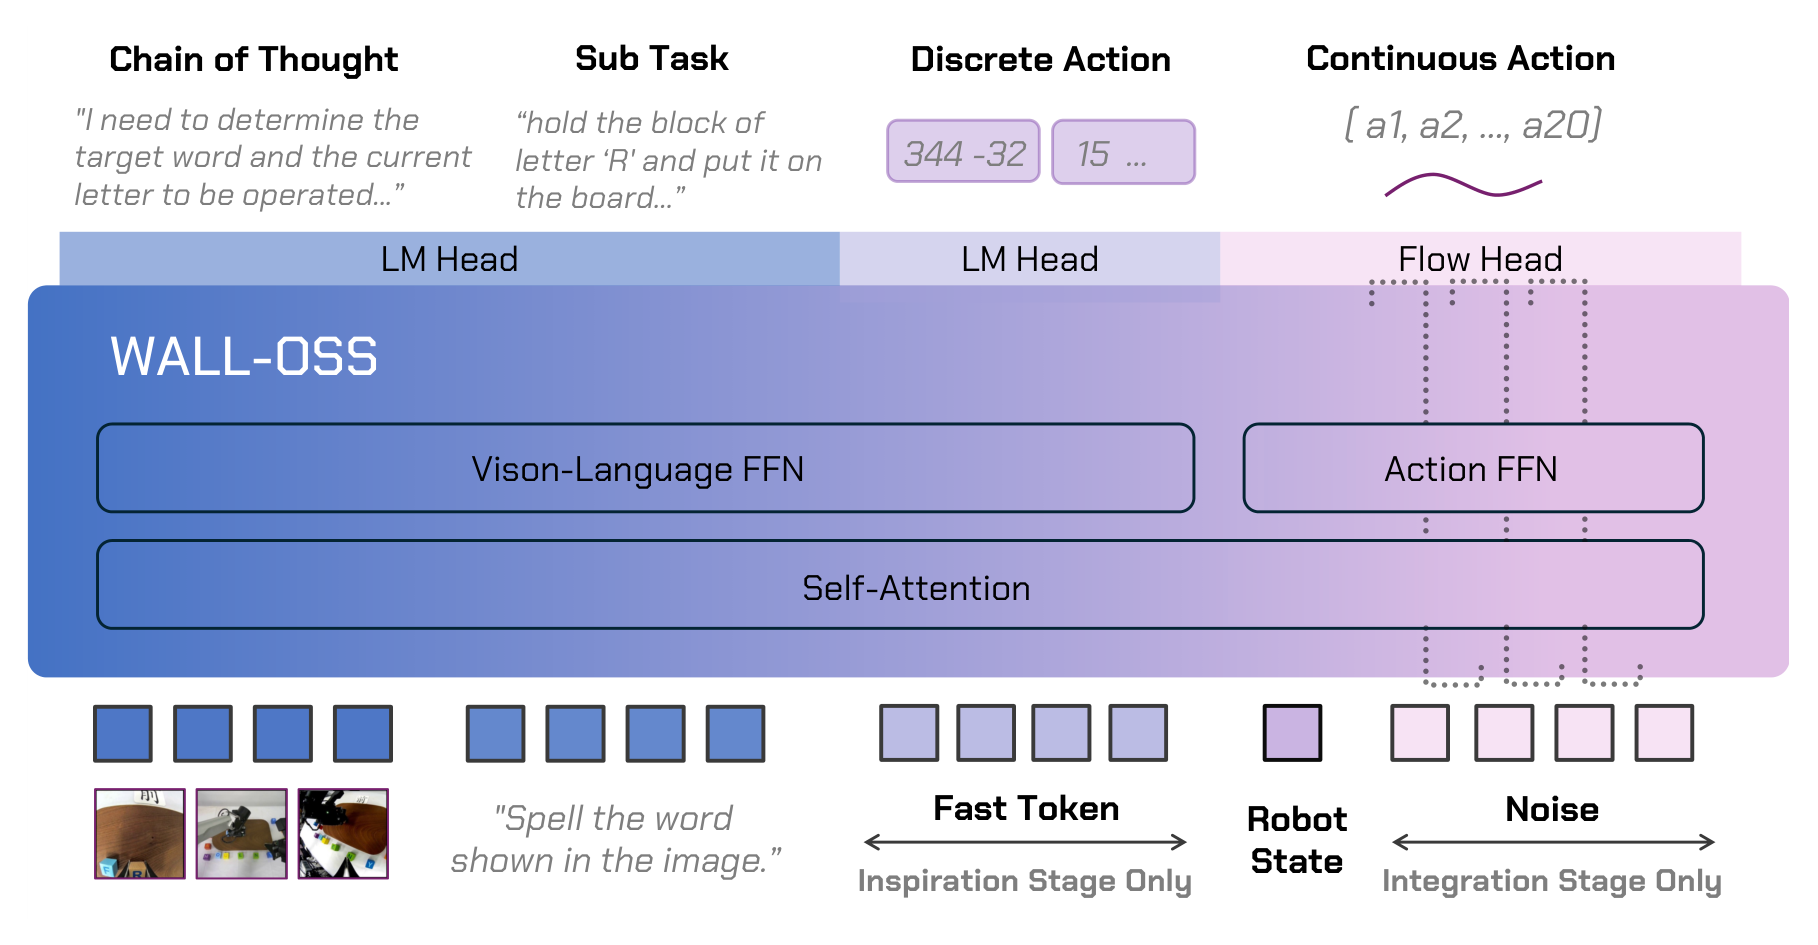
backbone은 Qwen2.5-VL-3B다. 입력은 1인칭 카메라와 팔에 달린 카메라의 영상, 그리고 텍스트 지시문이다. 논문은 입력 쌍을 c = (vision, instruction)으로 적고, backbone이 만든 인코딩을 h = F_θ(c)로 적는다.
출력은 학습 단계에 따라 달라진다. 두 개의 head가 서로 다른 형태의 출력을 맡는다.
| head | 출력 | 쓰이는 단계 |
|---|---|---|
| LM Head | CoT 문장, subtask 문장, FAST 이산 action 토큰 | Inspiration 단계에서 이산 action 토큰까지 함께 낸다 |
| Flow Head | 연속 action 20스텝 | Integration 단계에서만 쓰인다 |
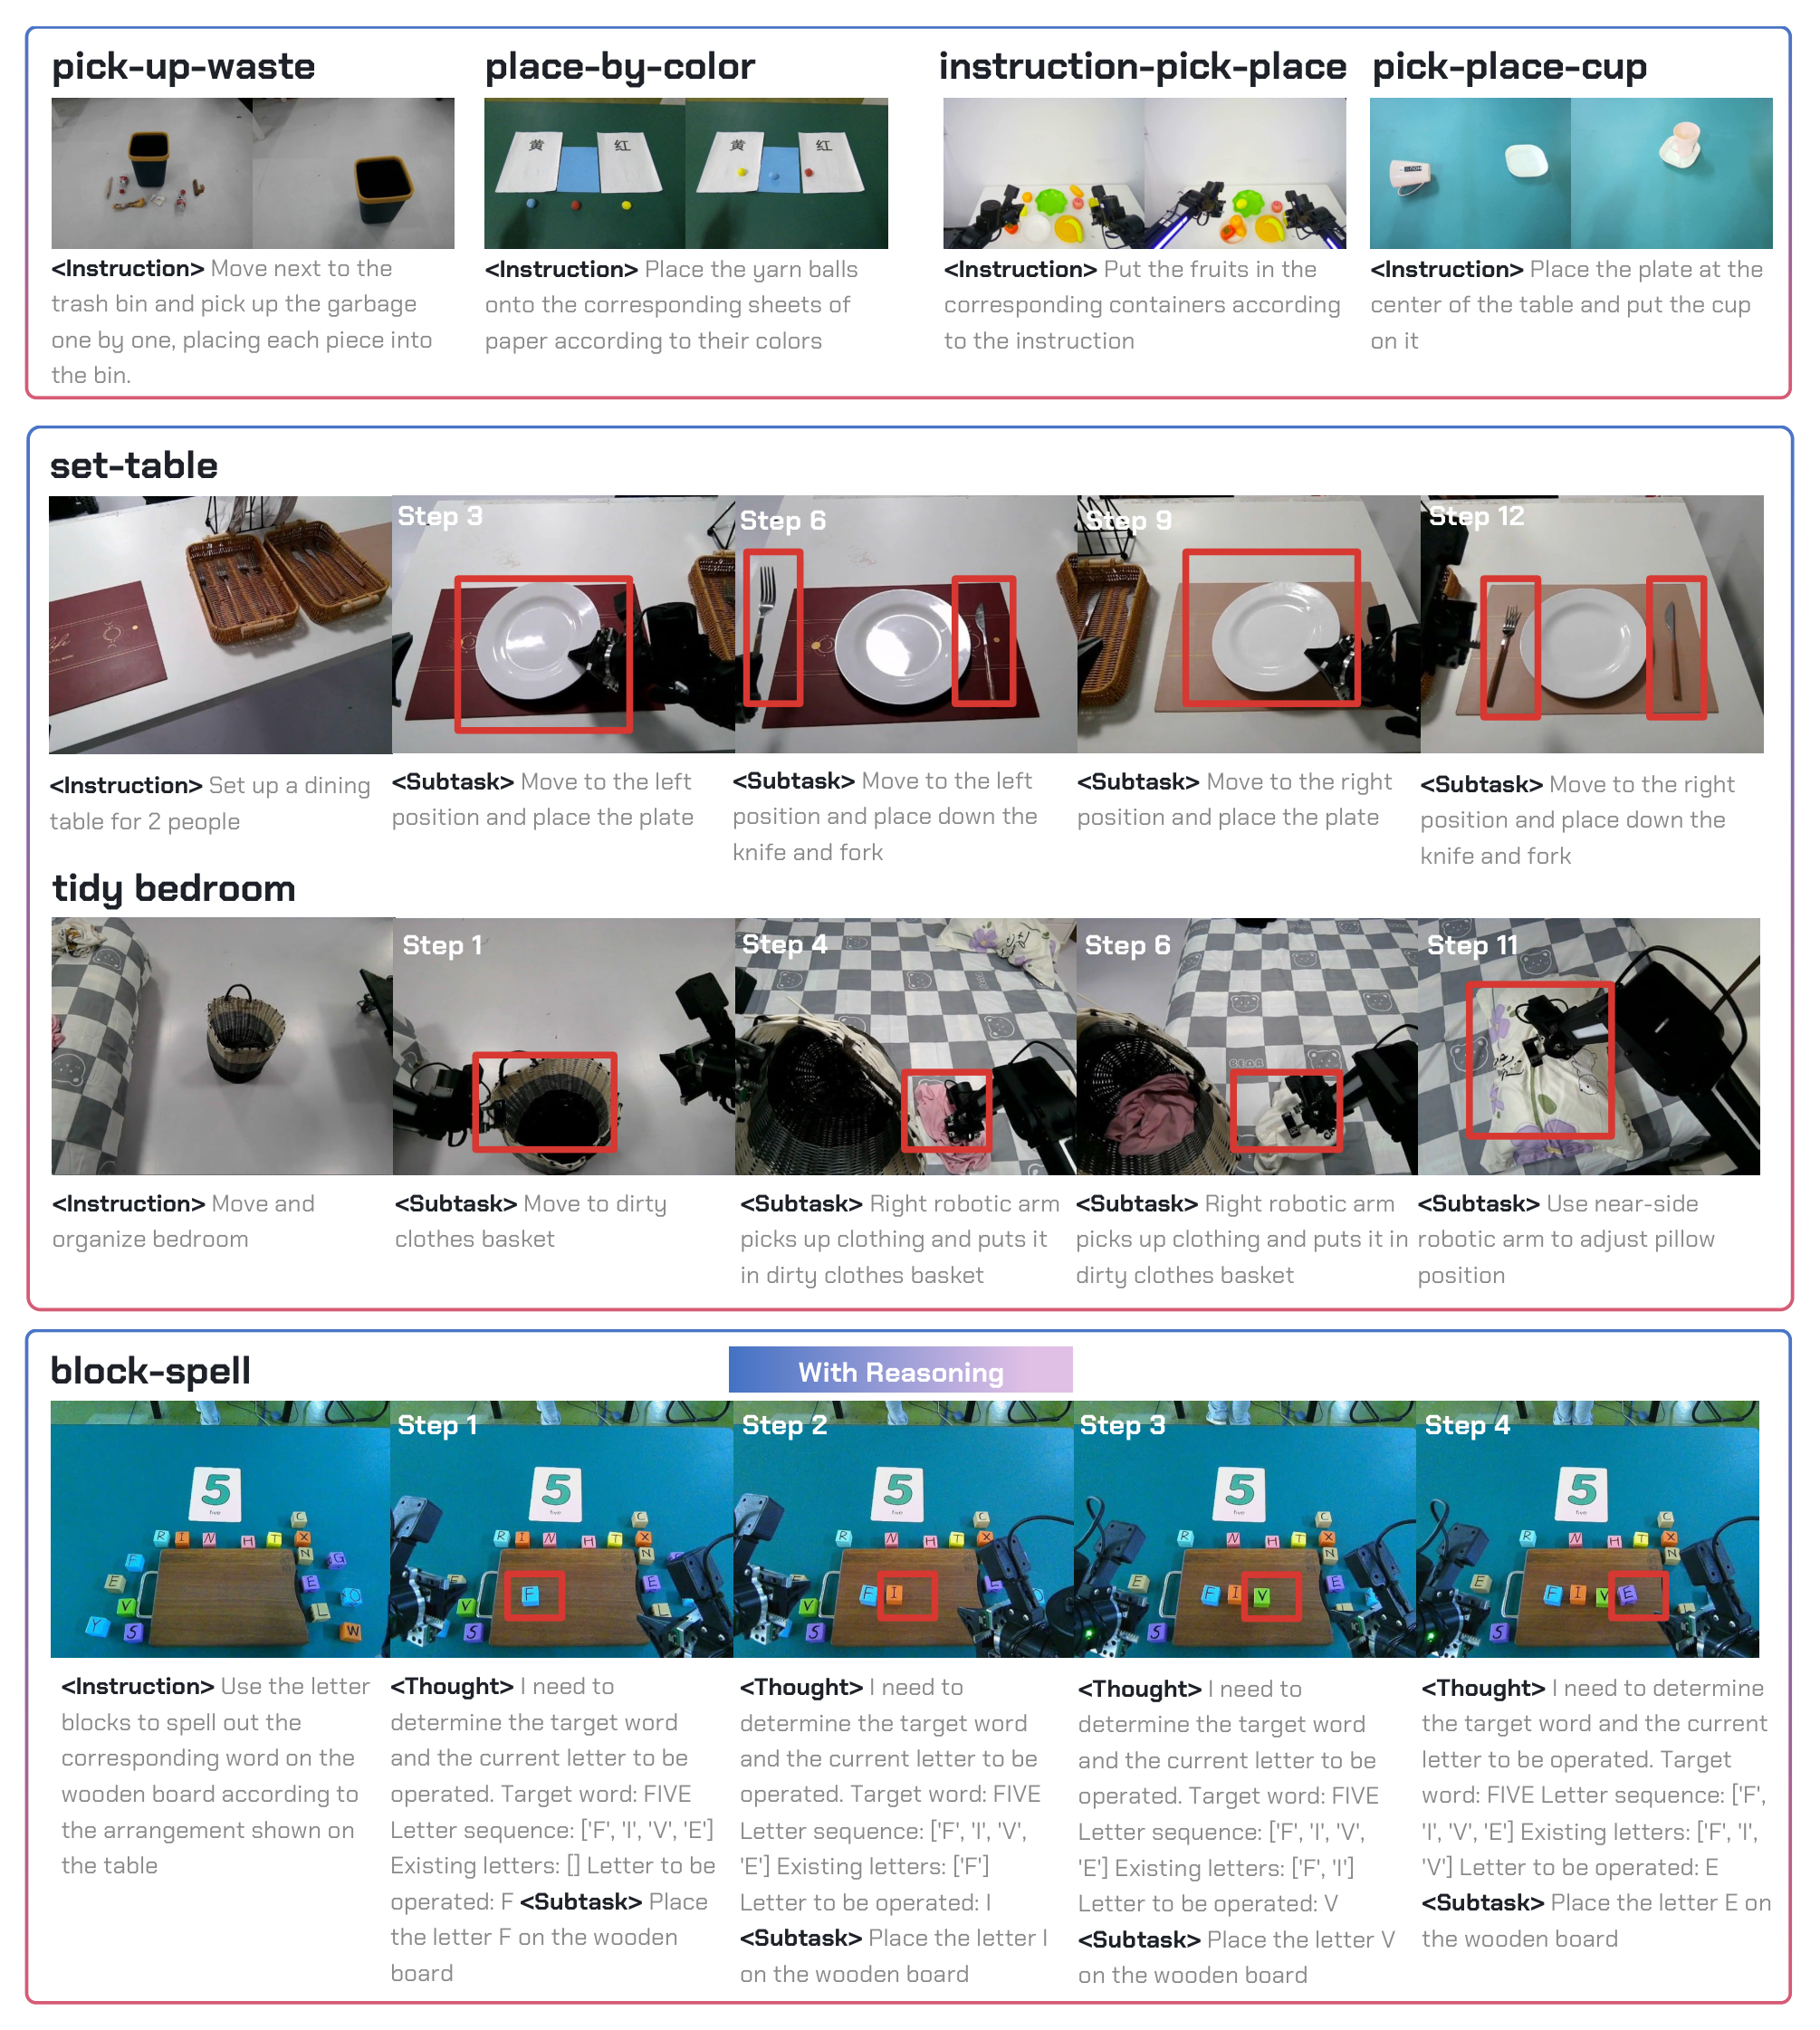
subtask는 상위 추론이 텍스트로 내놓는 중간 단계 명령이다. 예를 들어 "2인용 식탁을 차려라"라는 지시문에 대해 "왼쪽으로 이동해 접시를 놓아라"가 subtask에 해당한다.
Inspiration 단계
Inspiration 단계의 목표는 VLM에 거친 수준의 action 감각과 embodied 공간 추론을 심는 것이다. 이 단계에서는 VLM의 원래 FFN을 그대로 쓰고 Action FFN을 따로 활성화하지 않는다.
학습 목표는 두 가지가 결합된 형태다. 하나는 embodied VQA를 포함한 vision-language 과제이고, 다른 하나는 FAST tokenizer로 만든 이산 action 토큰을 맞히는 과제다. 손실은 두 항의 가중합이며 둘 다 cross-entropy다.
z_1:K = FAST(a)                                    # DCT → 양자화 → BPE
L_Inspiration = λ_VQA * Σ_t −log p_θ(τ_t | τ_<t, c)
              + λ_D   * Σ_k −log p_θ(z_k | z_<k, c)
여기서 a는 연속 action trajectory, z_1:K는 FAST tokenization으로 얻은 이산 action 토큰, τ_t는 t번째 텍스트 토큰이다. λ_VQA와 λ_D는 두 항의 가중치다.
vision-language 쪽 목표는 embodied VQA 하나가 아니라 네 가지를 함께 쓴다. masked language modeling, 이미지와 영상에 대한 텍스트 대조 학습, 지시 이행, 그리고 시간 순서와 인과관계 모델링이다. 마지막 항목이 진행 상황 파악 능력과 직결된다.
이 단계를 지나면 모델은 논문 표현으로 "coarse, semantically grounded action awareness"를 갖는다. 즉 정밀하지는 않지만 의미에 연결된 action 감각을 얻은 상태다.
Integration 단계
Integration 단계는 이산 action 예측을 flow matching 기반 연속 action 모델링으로 교체한다. 그리고 다시 두 phase로 나뉜다.
- Phase 1: VLM을 얼린 채 Action FFN 아래의 flow head만 학습해 velocity field를 회귀한다. Inspiration 단계에서 얻은 감독이 cross-modal attention을 안정시켜, 연속 action 학습에 믿을 만한 초기값을 준다.
- Phase 2: VLM을 풀어 두 모듈을 함께 최적화한다. gradient가 backbone과 flow head 양쪽으로 흐른다.
손실은 noise를 섞은 샘플에서 velocity field를 회귀하는 형태다.
x_t = (1 − ρ(t)) * x_0 + ρ(t) * ε
L_Integration = λ_C * E[ w(t) * ‖ v_φ(x_t, h, t) − (ε − x_0) ‖²₂ ]
x_0는 깨끗한 action 샘플, x_t는 시각 t에서 노이즈가 섞인 샘플, ε는 가우시안 노이즈, ρ(t)는 노이즈 스케줄, v_φ는 velocity field 신경망, w(t)는 가중 함수다. 노이즈 스케줄은 ρ가 0에 가까운 구간, 즉 노이즈가 많은 초기 구간을 더 자주 뽑도록 Beta 분포로 편향시킨다.
라우팅은 학습되는 router가 아니라 static router다. action 계열 feature는 Action FFN으로, vision-language feature는 Vision-Language FFN으로 고정 경로를 탄다. 따라서 어떤 데이터가 어느 전문가를 갱신하는지가 학습 내내 예측 가능하다.
Uni-CoT
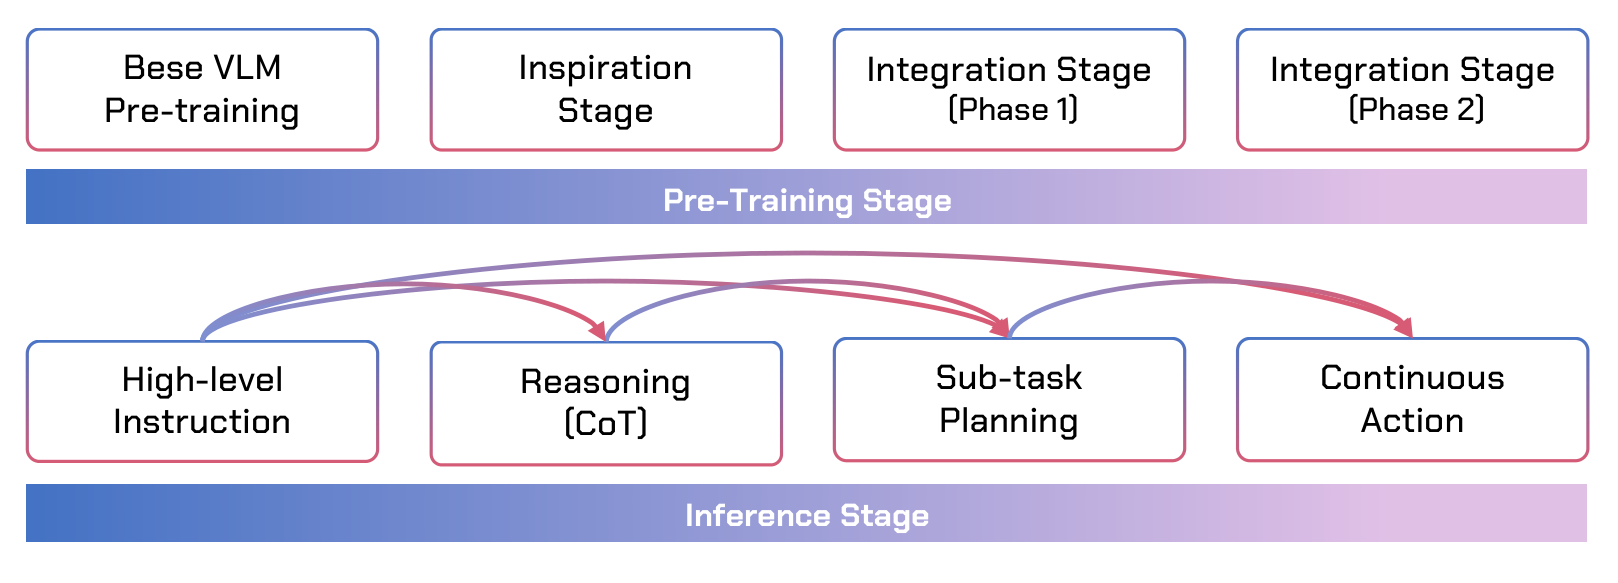
Uni-CoT는 CoT를 텍스트 추론에 한정하지 않고 의미에서 감각운동까지 이어지는 사슬 전체로 넓힌 형식이다. 사슬은 지시문에서 시작해 CoT 추론, subtask 계획, 연속 action으로 이어진다.
대비되는 설계는 계층형 파이프라인이다. SayCan이나 Code-as-Policies처럼 planner와 controller를 나눈 구성, Hi Robot이나 GR00T N1 같은 계층 구조가 여기에 속한다. 그런 설계는 단기적으로 학습과 실행의 난이도를 낮추지만, 모듈 사이 인터페이스가 미분 불가능하고 전체 성능이 각 모듈의 용량에 묶이며 단계마다 compounding error가 커진다.
학습에는 path-drop objective를 쓴다. 중간 추론 c를 조건으로 주기도 하고 빼기도 하면서 학습하므로, 하나의 모델 안에 전체 사슬을 따라가는 경로와 지시문에서 곧바로 action으로 가는 경로가 함께 들어간다.
min_θ E_(v,x,c,a) [ ℓ_act( F_θ(v, x, c), a_1:T ) + λ * ℓ_VQA( H_θ(v, x), y ) ]
v는 시각 입력, x는 언어 지시문, c는 선택적 CoT, a_1:T는 길이 T의 목표 action trajectory다. H_θ는 embodied VQA head이고 y는 그에 대한 정답이다.
이 형식이 주는 이득은 두 가지다. 첫째, 추론 시점에 과제 난이도와 문맥에 따라 CoT와 subtask 분해를 부를지 말지를 모델이 스스로 정한다. 둘째, 끝난 subtask의 action을 내보내면서 다음 추론을 이어갈 수 있어, 사람과 실시간으로 주고받는 상황에서 asynchronous control이 가능해진다.
학습 corpus
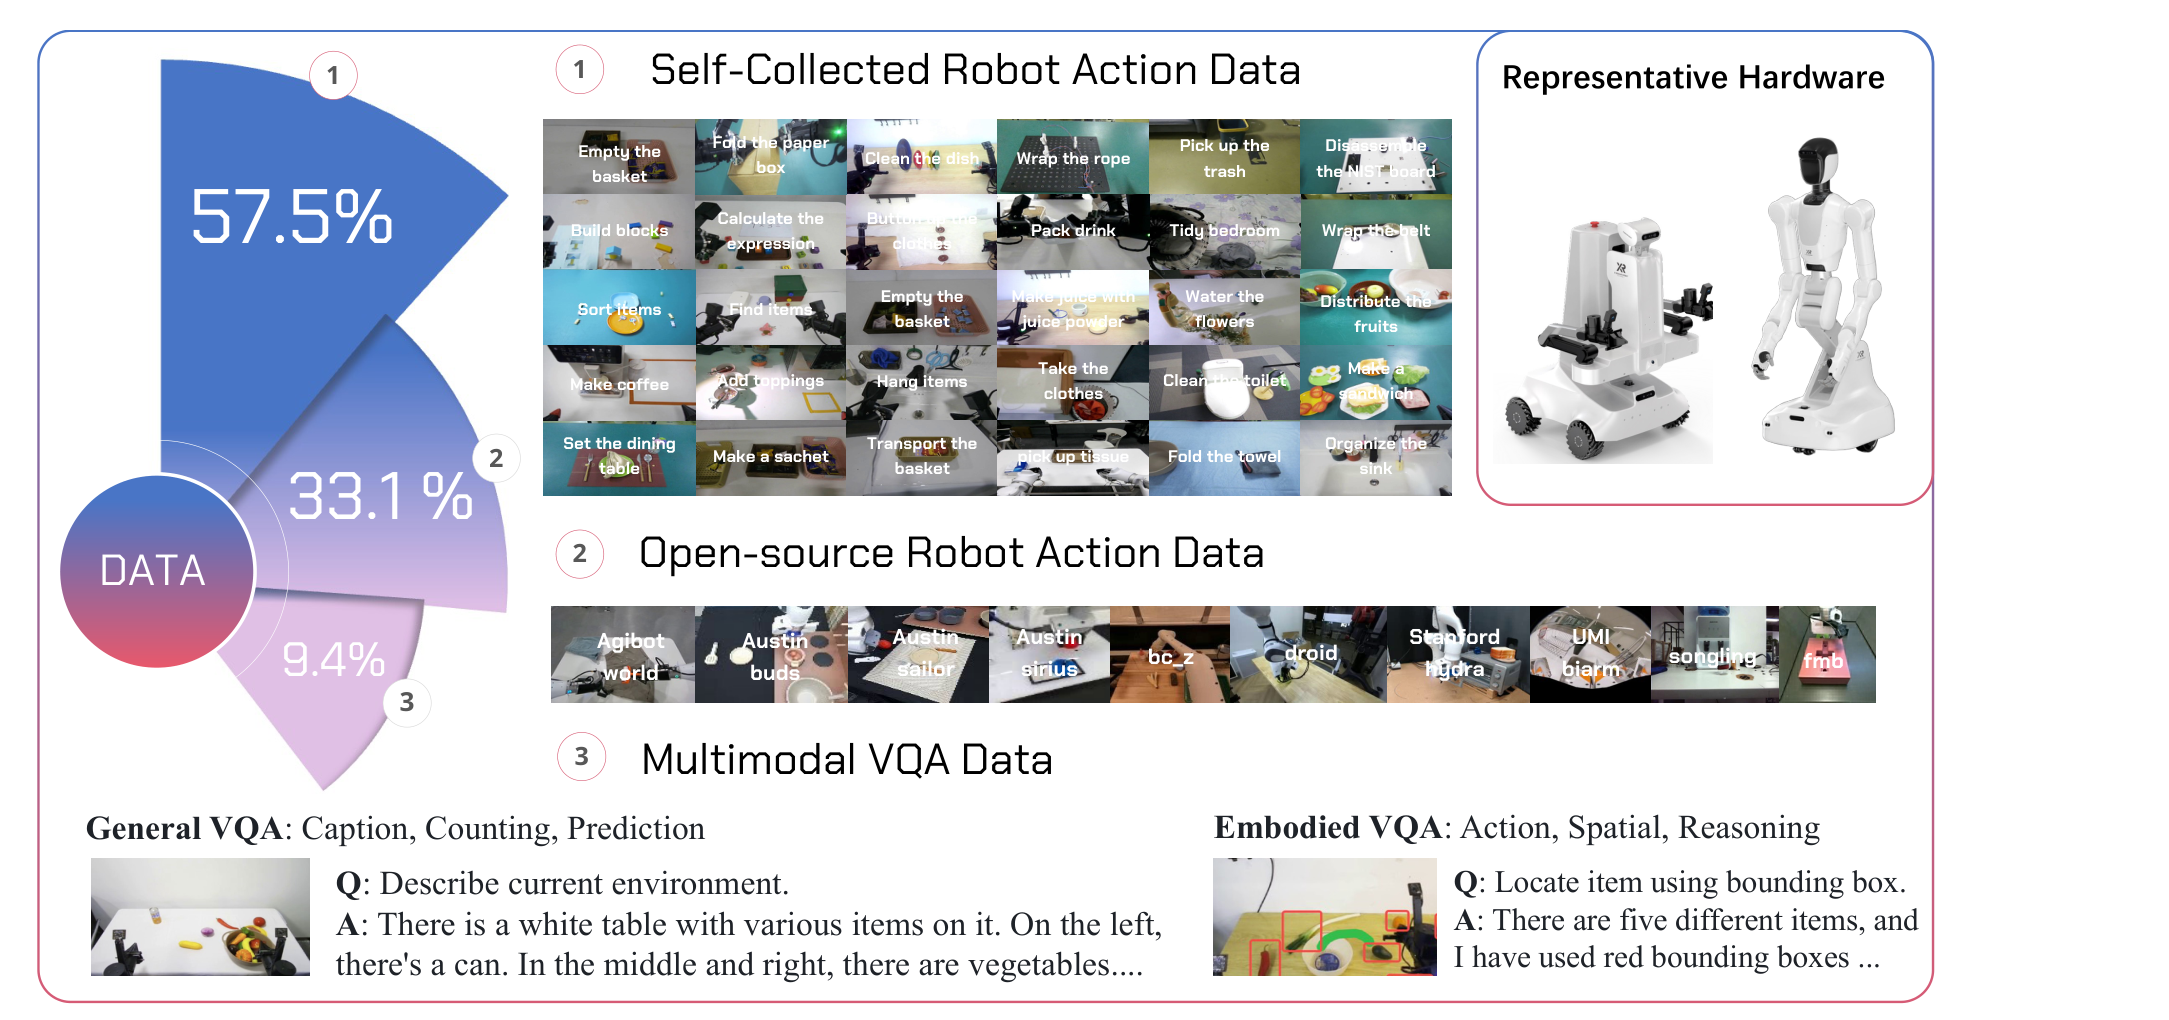
corpus는 세 원천으로 구성된다. 각 원천이 맡는 역할이 다르다.
| 원천 | 비중 | 역할 |
|---|---|---|
| 자체 수집 로봇 action 데이터 | 57.5% | 품질과 과제 복잡도를 담당한다 |
| open-source 로봇 action 데이터 | 33.1% | 형상과 환경을 가로지르는 일반화를 담당한다 |
| 멀티모달 VQA 데이터 | 9.4% | vision-language 능력을 보존하고 공간, 시간, 추론 감독을 추가한다 |
전체 규모는 논문 4절 도입에서 1만 시간 이상으로 적혀 있다. 다만 4.4절에서는 같은 corpus를 수만 시간으로 적어 두 표기가 어긋난다.
두 단계 커리큘럼에 맞춰 데이터도 역할을 나눈다. Inspiration 단계는 embodied VQA와 지시 이행, FAST 이산 action prior에 집중하고, Integration 단계는 자체 수집 trajectory와 규격을 맞춘 open-source trajectory 위에서 고주파 연속 제어에 집중한다.
자체 수집 데이터의 범위는 다음과 같다.
- 플랫폼: 탁상형 팔, 이동식 스탠드, 바퀴형 양팔 시스템, 바퀴형 humanoid. 1인칭 카메라, 3인칭 카메라, 팔에 달린 카메라를 함께 쓴다.
- 장면: 주방 청소, 옷 입히기와 정리, 이동하며 집어 놓기, 조립.
- 과제 구성: 명시적 지시문 아래 정밀도와 일반화를 요구하는 짧은 manipulation, 그리고 목표는 분명하지만 절차가 암묵적이라 과제 분해와 진행 상황 추적이 필요한 long-horizon 추론 과제.
- 주석과 품질 관리: 여러 모델을 결합한 파이프라인으로 단계별 주석을 달고 사람이 표본 검수해, trajectory 위에 곧바로 CoT 형태의 단계 감독을 붙인다. 여기에 다중 센서 타임스탬프 동기화, 이상치 제거, 저품질 프레임과 정지 프레임 제거, 규칙 기반 검증과 수동 감사, 조명과 배경의 자동 증강이 더해진다.
샘플링에도 장치가 있다. 장면, 물체, 과제, 형상을 기준으로 층화해 환경 교차와 형상 교차 검증 세트를 만들고, long-horizon 과제와 희귀한 skill에는 temperature를 조절한 재샘플링과 어려운 예시의 상향 샘플링을 적용한다. 두 학습 단계 모두 원천별 할당량을 정해 섞으며, 시각 입력에는 가벼운 domain randomization과 occlusion perturbation을 적용한다.
open-source 데이터 표준화
open-source action 데이터는 AgiBot World, DROID, BC-Z, RH20T, Bridge Data V2, UMI-biarm, FMB 등 24종을 모았다. 센서 형태와 조작 방식, 환경 변화가 서로 다른 데이터를 함께 pre-training에 쓰려면 규격을 맞춰야 한다.
| 표준화 항목 | 내용 |
|---|---|
| 좌표계와 단위 | 위치는 미터, 각도는 라디안으로 통일한다 |
| 형상 정규화 | 자유도를 최대로 표현하는 템플릿을 두고, 단일 팔과 양팔, 바퀴형, humanoid에서 빠진 관절은 마스킹과 자리표시자로 채운다 |
| 인식 정렬 | 카메라 내부와 외부 파라미터, 타임스탬프를 통일하고 프레임 레이트와 해상도를 재샘플링하며 다중 시점 영상의 채널을 맞춘다 |
| action 시간축 정규화 | control frequency를 표준화하고 trajectory를 flow matching 격자에 맞춰 재샘플링하거나 보간한다 |
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. 원천마다 이 값이 다르면 같은 동작도 서로 다른 길이의 시퀀스가 되므로, 시간축 정규화가 flow matching 학습의 전제가 된다.
VQA 데이터
VQA는 성격이 다른 두 계열로 나뉘고, 각각이 건드리는 부분도 다르다.
일반 VQA는 CapsFusion, Cambrian, PixMo, RoboPoint, Robo2VLM, COCO, VQAv2 같은 공개 데이터와 자체 trajectory에 붙인 일반 주석을 함께 쓴다. 이 신호는 manipulation과 관련이 약해서 action head를 직접 건드리지 않고 vision-language backbone을 정규화하는 역할만 한다.
embodied VQA는 자체 trajectory에서 자동 생성 파이프라인으로 만든다. 네 가지 질문 유형이 있다.
- Action Planning VQA: 다음 subgoal을 추론하게 한다.
- Spatial and Temporal QA: 위치 지정, 순서 판단, 진행 상황 파악을 묻는다.
- Perception VQA: 물체의 속성을 묻는다.
- Cognition and Affordance: 상호작용 가능성을 묻는다.
정답 형식은 과제를 가로질러 공유할 수 있도록 통일했다. <box>[x1,y1,x2,y2]</box>와 <point>[x,y]</point>가 기본이고, 필요하면 <mask> 부호화와 자연어 서술을 쓴다. 이 형식이 지시문에서 CoT, subtask, 연속 action으로 이어지는 사슬을 명시적으로 연결하므로, embodied VQA는 Uni-CoT와 tightly coupled 구조 양쪽에 직접 기여한다.
실험 설계
평가 과제
평가는 Embodied VQA 벤치마크 하나와 로봇 manipulation 과제들로 구성된다. 과제 설계의 기준은 세 가지 능력이다. 언어 지시문 이해와 추론과 일반화, long-horizon 다단계 과제의 계획과 실행, 그리고 action 정확도와 강건성이다.
| 과제 | 목표 능력 | fine-tuning episode | 설명 |
|---|---|---|---|
| instruction-pick-place | 지시 이행과 일반화 | 없음 | 다양한 자연어 지시문을 따라 지정된 물체를 집어 지정된 위치에 놓는다. fine-tuning에서 제외하고 zero-shot 평가에만 쓴다 |
| place-by-color | 지시 이행과 추론 | 500 | 색이 같은 종이 위에 실뭉치를 놓는다. 색을 눈으로 맞추는 조건과 "red"라는 글자가 인쇄된 흰 종이에 놓는 조건 두 가지가 있다 |
| block-spell | 추론 | 1,600 | 장난감 블록으로 답을 철자한다. 그림 카드의 물체 이름을 철자하거나 간단한 산술식을 풀어 그 답을 철자한다 |
| set-table | long-horizon 계획 | 1,500 | 접시와 나이프와 포크를 가져다 2인분 자리를 차린다. 접시는 가운데, 커트러리는 양옆에 놓는다 |
| tidy-bedroom | long-horizon 계획 | 1,000 | 침대의 옷을 빨래 바구니에 넣고 베개를 제자리에 놓는다 |
| collect-waste | action 정확도와 강건성 | 900 | 쓰레기통으로 이동해 주변에 흩어진 쓰레기를 모아 정확히 버린다 |
| pick-place-cup | action 정확도와 강건성 | 500 | 컵을 접시 위에 놓는다. 뒤집힌 컵이나 손잡이 방향이 틀어진 컵처럼 초기 상태가 달라져 재배치가 필요하다 |
set-table, tidy-bedroom, place-by-color 세 과제는 pre-training 데이터에 없다. 따라서 이 세 과제는 새 과제에 대한 적응 능력을 재는 시험이다.
한 가지 표기 차이를 짚어 둘 필요가 있다. 5.1.1절은 collect-waste의 fine-tuning episode를 900개로 적지만, 결과 절은 같은 과제를 시연 데이터(demonstration) 1,000개로 적는다.
베이스라인과 평가 프로토콜
비교 대상은 VLA 학습의 서로 다른 두 방식을 대표하는 모델이다.
| 구분 | WALL-OSS | π0 | Diffusion Policy |
|---|---|---|---|
| VLM pre-training 가중치 | 사용 | 사용 | 사용하지 않고 밑바닥부터 학습 |
| action 생성 | flow matching | flow matching | 조건부 denoising diffusion |
| 지시문 형식 | Uni-CoT로 subtask를 스스로 생성 | Flat 또는 GPT4-Subtask | Flat 또는 GPT4-Subtask |
| action과 VQA 동시 학습 | 지원 | 미지원 | 미지원 |
베이스라인에는 두 가지 지시문 방식을 적용했다. Flat은 상위 과제 지시문만으로 학습하는 방식이고, GPT4-Subtask는 사람이 주석한 subtask 분해로 학습한 뒤 추론 시점에 GPT-4가 subtask를 생성해 주는 방식이다. 이 대비가 과제 분해의 기여와 구조 자체의 기여를 분리해 준다.
WALL-OSS만 action과 VQA를 함께 학습할 수 있으므로 교차 샘플링 비율을 정해 두었다. subtask가 아닌 VQA 샘플은 1대 15, subtask 샘플은 1대 100 비율로 섞는다.
평가는 blind 제3자 프로토콜로 진행했다. 학습팀이 환경 구성과 과제별 초기 상태, 표준 채점 기준을 담은 문서를 만들고, 모델 개발과 학습에 참여하지 않은 제3자가 어떤 버전인지 모르는 상태에서 그 문서대로 채점한다. 주관적 편향을 줄이려는 장치다.
결과
embodied 장면 이해
첫 확인 사항은 pre-training이 vision-language 정렬을 보존할 뿐 아니라 embodied 장면 이해까지 끌어올렸는지다. 비교 대상은 backbone인 Qwen2.5-VL-3B 자신이다.
| 항목 | Qwen2.5-VL-3B | WALL-OSS | 차이 |
|---|---|---|---|
| Object Grounding | 46.1% | 91.6% | +45.5%p |
| Scene Captioning | 57.7% | 87.6% | +29.9%p |
| Action Planning | 59.8% | 69.0% | +9.2%p |
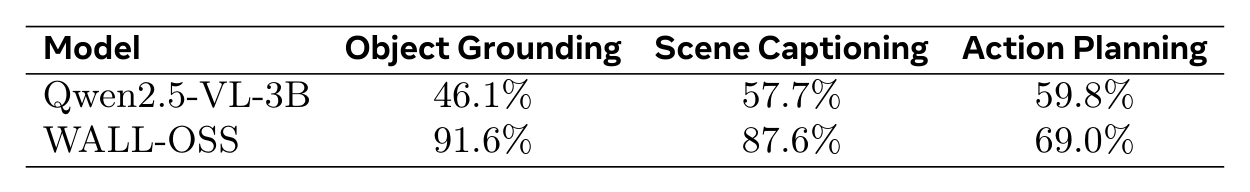
세 항목의 상승 폭이 다르다는 점이 해석의 실마리다. Object Grounding에서 차이가 가장 큰데, backbone은 pre-training 데이터에 드문 조작 장면에서 로봇 팔에 시선을 뺏겨 위치 지정에 실패하는 경우가 많다. Scene Captioning에서도 backbone은 장면과 무관한 환각을 내는 반면 WALL-OSS는 팔의 조작 동작까지 짚어 서술한다. 반면 Action Planning은 두 모델 모두 현재 단계를 잘못 판단하는 경향이 있어 차이가 9.2%p에 그친다.
zero-shot 지시 이행
집기-놓기 과제에서 fine-tuning 없이 새 지시문을 따르는지 확인했다. 조건은 두 가지로, pre-training에서 본 물체와 용기를 지시하는 경우와 완전히 새로운 물품을 지시하는 경우다.
- 본 적 있는 물체 지시: task progress 평균 85%
- 처음 보는 물체 지시: task progress 평균 61%
실패의 성격이 중요하다. 대부분은 지시한 대상을 잘못 알아들어서가 아니라, 낯선 물체를 집거나 놓을 때 자세가 조금씩 어긋나서 생긴다. 즉 언어 이해가 아니라 정밀 제어가 병목이다.
action 정확도와 환경 일반화
pre-training이 action 자체의 정확도에 주는 영향은 collect-waste와 pick-place-cup 두 과제에서 성공률로 측정했다. 앞 절의 task progress와는 다른 척도다.
| 조건 | WALL-OSS | π0 | Diffusion Policy |
|---|---|---|---|
| collect-waste, in-distribution (시연 데이터 1,000개) | 100% | 100% | 80% |
| pick-place-cup, in-distribution (시연 데이터 500개) | 90% 이상 | 90% 이상 | 20% 미만 |
| collect-waste, out-of-distribution (새 환경) | 80% 이상 | 80% 이상 | 0% |
이 표의 세 행이 pre-training의 효과가 언제 드러나는지를 보여 준다. 데이터가 넉넉하고 환경이 학습과 같으면 pre-training 없는 Diffusion Policy도 80%로 따라온다. 그러나 시연 데이터가 500개로 줄고 초기 상태가 다양해지는 pick-place-cup에서는 20% 미만으로 하락하고, 환경이 바뀌면 0%가 되어 과제를 전혀 끝내지 못한다. 따라서 pre-training은 action 정확도뿐 아니라 데이터 효율과 새 환경 일반화의 전제 조건이다.
long-horizon 과제와 subtask 생성
set-table과 tidy-bedroom은 pre-training 데이터에 없고 단계가 다섯 개를 넘으며, 평균 실행 시간이 각각 3분과 5분을 넘는다. 단계가 길수록 감독이 늦게 도착하고 compounding error가 커지므로, 이 두 과제가 계획 능력을 가르는 시험대가 된다.
fine-tuning에서 WALL-OSS는 action 생성과 subtask 예측을 함께 학습한다. 주목할 점은 subtask 라벨이 붙은 학습 데이터가 전체의 1%뿐인데도 모델이 쓸 만한 subtask 문장을 꾸준히 만들어낸다는 것이다. 추론 시에는 subtask를 먼저 생성하고 그 문장을 조건으로 action을 낸다.
베이스라인의 실패 양상이 subtask 안내의 역할을 드러낸다. 접시를 집는 것 같은 저수준 동작만 보면 세 모델의 실력이 비슷한데, 베이스라인은 단계 혼동을 일으켜 같은 자리에 커트러리를 반복해 놓거나 식탁의 나머지 부분을 채우지 못한다. 비슷한 시각 입력에서 그럴듯한 행동이 여럿일 때 선택이 흔들리는 것도 같은 원인이다. 공간이 더 복잡한 tidy-bedroom에서는 이 문제가 심해져, 옷가지처럼 목표 물체가 현재 시야 밖으로 나가면 베이스라인이 효과 없는 동작을 반복하는 상태에 머문다.
전 과제 task progress는 Figure 7이 정리한다.
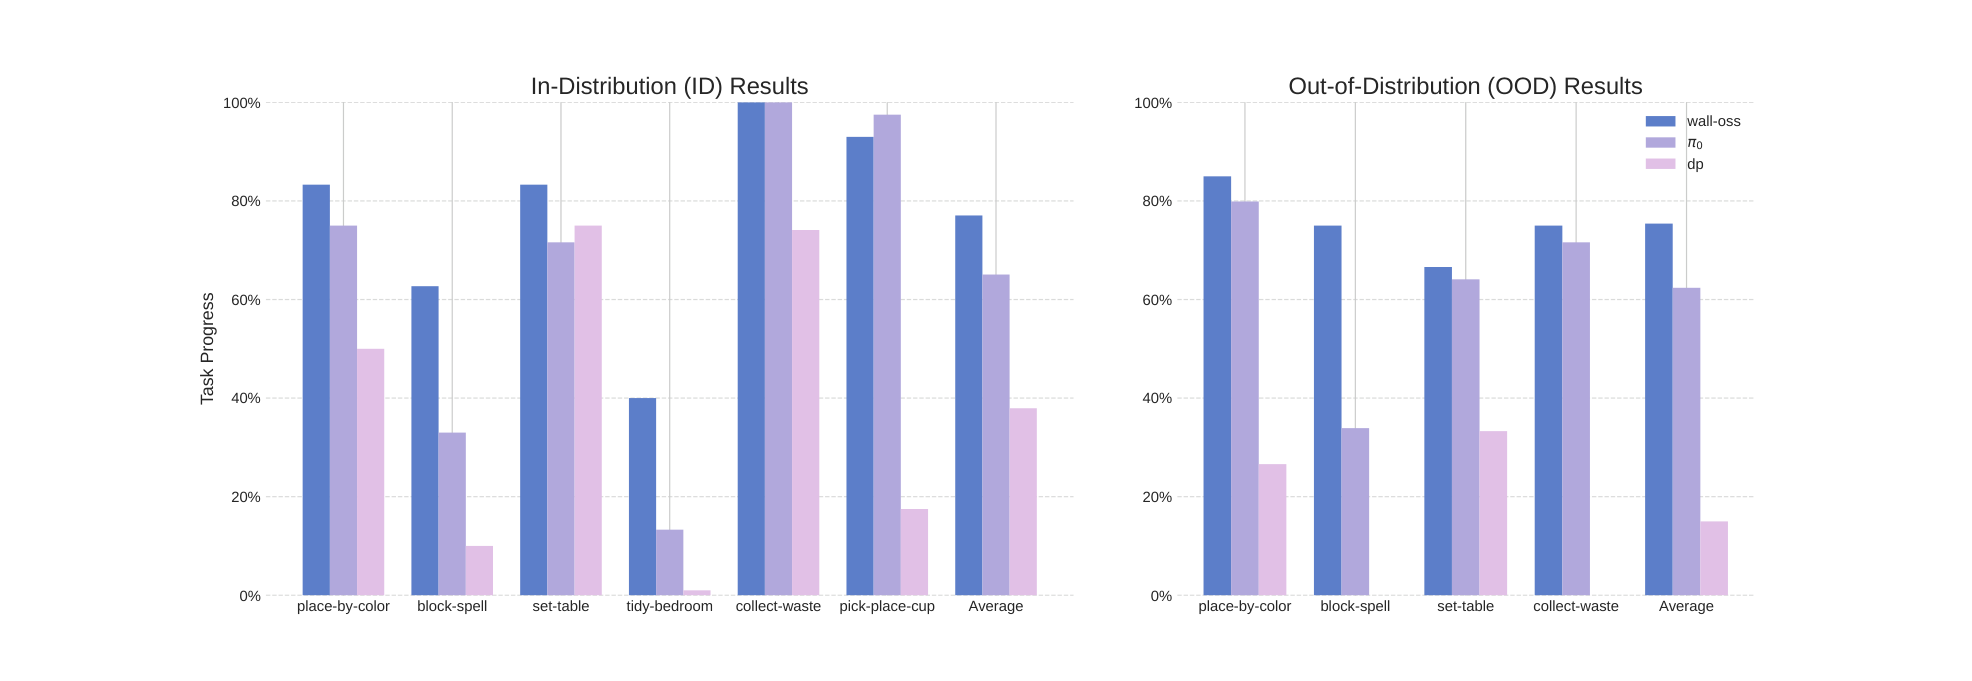
| 과제 | 조건 | WALL-OSS | π0 | Diffusion Policy |
|---|---|---|---|---|
| place-by-color | ID | 83% | 75% | 50% |
| block-spell | ID | 63% | 33% | 10% |
| set-table | ID | 83% | 72% | 75% |
| tidy-bedroom | ID | 40% | 13% | 1% |
| collect-waste | ID | 100% | 100% | 74% |
| pick-place-cup | ID | 93% | 98% | 18% |
| 6과제 평균 | ID | 77% | 65% | 38% |
| place-by-color | OOD | 85% | 80% | 27% |
| block-spell | OOD | 75% | 34% | 0% |
| set-table | OOD | 67% | 64% | 33% |
| collect-waste | OOD | 75% | 72% | 0% |
| 4과제 평균 | OOD | 75% | 62% | 15% |
위 표의 개별 과제 값은 Figure 7의 막대에서 읽은 것이라 소수점 단위의 오차가 있을 수 있다. 평균값은 논문이 그림에 함께 적은 수치다.
과제별로 보면 우열의 크기가 고르지 않다. pick-place-cup처럼 정밀 조작이 지배하는 과제에서는 π0가 98%로 WALL-OSS의 93%보다 높다. 반대로 단계가 길고 추론이 필요한 tidy-bedroom과 block-spell에서 격차가 가장 크게 벌어진다. in-distribution에서 out-of-distribution으로 넘어갈 때의 하락 폭도 갈린다. WALL-OSS는 77%에서 75%로 거의 유지되고 π0는 65%에서 62%로 소폭 내려가지만, Diffusion Policy는 38%에서 15%로 크게 하락한다.
추론이 필요한 과제
place-by-color와 block-spell은 중간 논리 추론을 요구하도록 설계됐다. WALL-OSS는 fine-tuning에서 CoT 추론 흔적과 하위 지시문을 함께 생성하도록 학습하는데, 이때도 감독이 붙는 프레임은 전체의 1%다. 추론 시에는 모델이 CoT와 하위 지시문을 스스로 만들어 action 생성의 조건 입력으로 쓴다.
CoT의 효과는 조건에 따라 다르다. 빨간 실뭉치를 빨간 종이에 놓는 것처럼 시각적으로 바로 맞출 수 있는 조건에서는 CoT의 이득이 거의 없다. 반면 "red"라는 글자가 인쇄된 종이에 놓아야 하는 조건에서는 WALL-OSS가 모든 베이스라인보다 크게 앞선다. 즉 직접 매핑하는 모델은 시각적으로 자명한 과제에 머물고, 중간 추론이 필요한 지시문 조건 과제에는 CoT가 필수다.
block-spell에서는 Flat 설정의 베이스라인이 task progress 거의 0에 수렴했다. 그래서 논문은 베이스라인을 GPT4-Subtask 설정으로만 보고한다. 그렇게 보조를 붙여도 WALL-OSS가 in-distribution과 out-of-distribution 모두에서 앞선다. 논문의 진단은 두 가지다. GPT-4가 옳은 하위 지시문을 뽑아내더라도 시점이 늦고 1인칭 시야가 가려진 상황 같은 문맥에 맞춰 주지 못하며, 상위 계획과 저수준 실행 모듈이 끊겨 있어 지시 이행 성능이 떨어진다.
멀티모달 co-training ablation
block-spell에서 π0가 특정 글자 블록을 식별하고 다루는 데 유독 약했던 이유를 찾기 위해, 논문은 fine-tuning 구성 세 가지를 비교하는 ablation을 진행했다.
- WALL-OSS (Multi-modal Co-training): action 생성, CoT와 subtask 생성, 2D referring expression grounding을 함께 학습한다.
- WALL-OSS (Action-only): subtask 지시문만 주고 action 생성만 학습한다.
- π0 (Action-only): 구조가 비슷한 VLA를 action 생성만으로 학습한다.
평가는 "letter A를 집어라"처럼 정밀한 지시문을 주고 올바른 블록을 고르는지 보는 방식이다.
| 블록 종류 | WALL-OSS (co-training) | WALL-OSS (action only) | π0 (action only) |
|---|---|---|---|
| 글자 블록 | 87% | 26% | 9% |
| 숫자 블록 | 95% | 80% | 35% |
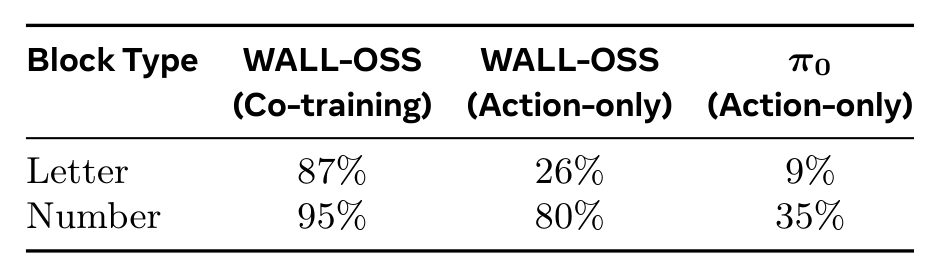
세 열의 간격이 두 가지를 말한다. 첫째, 같은 WALL-OSS라도 co-training을 빼면 글자 블록 정확도가 87%에서 26%로 61%p 하락한다. 둘째, action만 학습한 조건끼리 비교해도 WALL-OSS가 π0보다 크게 높은데, π0의 9%는 무작위 선택에 가까운 값이다. 따라서 pre-training 단계가 멀티모달 정렬의 토대를 놓고, fine-tuning에서 co-training을 유지하는 것이 그 토대를 실제 실행으로 이어 준다.
숫자 블록과 글자 블록의 차이도 눈여겨볼 만하다. 숫자는 종류가 10개로 적어 action only 설정에서도 80%가 나오지만, 종류가 26개인 글자에서는 같은 설정이 26%로 내려간다. 구별해야 할 대상이 늘어날수록 언어와 시각의 정밀한 결합이 필요해진다.
한계
정밀 manipulation은 여전히 π0가 낫다고 논문이 스스로 적는다. WALL-OSS의 우위는 embodied 환경의 grounding과 추론, 그리고 out-of-distribution 일반화에 몰려 있고, pick-place-cup 같은 과제의 수치가 이를 뒷받침한다.
3D 데이터 희소성도 해결되지 않았다. 3D-VLA나 PointVLA처럼 3D 시각을 2D와 action 사이의 다리로 쓰려는 시도가 있지만 3D 데이터 자체를 구하기 어렵고, VGGT나 π3 같은 3D 기반 모델도 정밀 action 예측에 필요한 정확도에 못 미친다.
계획 능력이 전체 학습 프레임의 1%에 해당하는 CoT와 subtask 감독에 의존한다는 점도 남는다. 실행 시간이 3분에서 5분을 넘고 공간 복잡도가 높은 과제에서는 이 얇은 감독만으로 안정적인 계획을 유지하기 어렵다.
향후 방향
논문은 두 가지 경로를 나란히 열어 둔다. 하나는 미래 프레임 예측 같은 중간 표현이나 3D 같은 중간 모달리티를 도입해 vision-language에서 action으로 가는 매핑의 난이도를 낮추는 길이고, 다른 하나는 끝까지 end-to-end로 가는 길이다. 논문은 둘을 대립이 아니라 수렴하는 두 경로로 보고, AGI까지의 상대적 효율만이 문제라고 적는다.
각 경로의 손익도 짚는다. 영상과 3D는 텍스트와 action의 쌍보다 action과의 상관이 높아 감독 신호의 희소함을 덜어 주지만, 3D 데이터는 여전히 부족하다. 대규모 영상 예측은 인터넷 데이터를 쓸 수 있는 대신 중복 감독을 낳는다. 사람은 모든 세부를 예측하지 않고 의도에 따라 선택적으로 지각하기 때문이다. 이 관찰이 행동 예측을 위한 양방향 world modeling으로 이어진다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Uni-CoT | 지시문에서 CoT 추론, subtask, 연속 action까지를 하나의 미분 가능한 사슬로 묶은 학습과 추론 형식 |
| Inspiration 단계 | embodied VQA와 FAST 이산 action 토큰으로 VLM에 거친 action 감각을 심는 첫 번째 pre-training 단계 |
| Integration 단계 | flow matching으로 연속 action을 학습하는 두 번째 단계. VLM을 얼리는 Phase 1과 함께 최적화하는 Phase 2로 나뉜다 |
| static router | 학습으로 정하지 않고 토큰 종류에 따라 고정 경로로 FFN을 배정하는 라우팅 |
| weight drift | action 감독이 VLM 원래 가중치 분포를 흔들어 vision-language 능력이 퇴화하는 현상 |
| task progress | 성공과 실패의 이분법 대신 과제를 어디까지 진행했는지를 0%에서 100%로 매기는 척도 |
| path-drop objective | 중간 추론 c를 조건에 넣기도 하고 빼기도 하며 학습해, 추론 시 CoT 사용 여부를 모델이 고르게 하는 목표 |
관련 페이지
- Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere: 같은 팀의 후속. 두 단계 커리큘럼이 단일 단계 co-training으로 합쳐지고 FAST tokenizer가 학습형 RVQ tokenizer로 바뀐다
- Wall-X: Building General-Purpose Robots Based on Embodied Foundation Model: 학습과 추론 코드 저장소. README의 인용 블록이 이 논문을 가리킨다
- WALL-OSS: Igniting VLMs toward the Embodied Space (X Square Robot 프로젝트 페이지): 공식 프로젝트 페이지. 같은 도식을 쓰되 평가 과제를 영상으로 보여 준다
- 03-11. WALL-OSS - 모두의 로보틱스 - VLA 입문: 이 논문을 수식 단위로 푼 한국어 해설
- π0: A Vision-Language-Action Flow Model for General Robot Control: 분리형 설계의 대표이자 주된 비교 대상. 정밀 manipulation에서는 여전히 앞선다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: subtask를 먼저 내놓고 그 문장을 조건으로 action을 내는 구조. Uni-CoT와 목적이 겹친다
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 통합형 설계의 대표. weight drift 문제의 근거로 인용된다
- OpenVLA: An Open-Source Vision-Language-Action Model: 통합형 설계를 오픈소스로 옮긴 사례. RT-2와 함께 인용된다
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 계층 구조의 대표. Uni-CoT가 대비 대상으로 지목한다
- Flow Matching for Generative Modeling: Integration 단계 연속 action 생성의 토대
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: open-source action 데이터 통합의 선례
- Physical AI 카테고리 지도와 학습 경로: 도메인 허브