Database · PAPER · 2025
Rethinking Retrieval: From Traditional Retrieval Augmented Generation to Agentic and Non-Vector Reasoning Systems in the Financial Domain for Large Language Models
요약
이 논문은 금융 문서 질의응답에서 임베딩을 쓰는 RAG와 쓰지 않는 RAG 중 무엇이 나은지를 같은 조건에서 처음으로 측정한 결과를 보고한다. PricewaterhouseCoopers U.S.의 연구진 9명이 Fortune 500 기업의 미국 SEC filing 1,200건과 직접 만든 150문항 벤치마크 위에서 두 architecture를 맞붙였다.
결과는 임베딩 쪽의 우세였다. hybrid search와 metadata filtering을 쓰는 vector 기반 agentic RAG가 문서 구조를 따라 내려가는 hierarchical node-based 시스템을 상대로 68% win rate를 얻었고, 지연도 5.2초 대 5.98초로 더 짧았다.
논문은 여기서 멈추지 않고 vector 쪽 architecture에 붙일 수 있는 기법 두 가지를 따로 측정했다. cross-encoder reranking은 MRR@5를 0.160에서 0.750으로 올렸고, small-to-big retrieval은 지연 0.2초 추가와 비용 증가 없이 65% win rate를 얻었다. 즉 이 논문의 실질적 결론은 "vector가 이겼다"보다는 "vector 위에 무엇을 얹으면 얼마나 좋아지고 얼마를 내야 하는가"의 측정치에 가깝다.
배경
금융 문서 질의응답이 어려운 이유
SEC filing은 일반 문서보다 훨씬 길고 용어가 좁다. 논문이 관련 연구에서 정리한 세 양식의 성격은 다음과 같다.
| 양식 | 성격 | 분량 |
|---|---|---|
| Form 10-K | 연차보고서 | 100쪽에서 300쪽 |
| Form 10-Q | 분기보고서 | 30쪽에서 80쪽 |
| Form 8-K | 중요 사건 공시 | 사건 단위 |
이 논문이 모은 코퍼스는 문서당 평균 73,175 토큰이다. 이 정도 길이면 문서 하나를 통째로 프롬프트에 넣는 방식이 성립하지 않는다. 질문 하나에 답하려면 수십만 토큰짜리 문서 더미에서 근거가 있는 몇 문단을 찾아내야 한다.
여기에 금융 질의 특유의 성질이 겹친다. 여러 절이나 여러 문서를 오가야 답이 나오는 multi-hop 질의가 흔하고, 표와 정형 문구가 반복되어 표면적으로 비슷한 chunk가 많다.
임베딩 없는 retrieval이라는 대안
기존 RAG는 문서를 chunk로 잘라 임베딩으로 바꾸고 질의 임베딩과의 거리로 후보를 고른다. 임베딩은 텍스트를 고정 차원 벡터로 바꾼 표현이다. 이 방식에는 preprocessing 단계에서 전체 코퍼스를 임베딩해 저장해야 한다는 부담이 따른다.
이에 대한 대안으로 문서의 목차 구조 자체를 인덱스로 삼는 접근이 등장했다. 문서를 절 단위 노드의 트리로 바꾸고, 질의가 들어오면 LLM이 트리를 타고 내려가며 관련 노드를 골라 그 페이지 범위를 읽는다. 임베딩 계산이 아예 없어진다.
논문은 이 계열의 출처로 두 자료를 인용한다. PageIndex 저장소(VectifyAI 2024)와 pageindex.ai의 Mafin 2.5 블로그 글(VectifyAI 2025)이다. 그리고 이 접근이 복잡한 질의에서 semantic vector 검색 대비 얼마나 효과적인지가 아직 불분명하다는 점을 연구 공백으로 지목한다.
고급 RAG 기법의 지형
기본형 RAG는 multi-hop 질의와 장문 문서를 다루는 데 한계가 있고, 그래서 여러 보강 기법이 나왔다. 논문은 관련 연구에서 이 기법들을 파이프라인의 어느 단계에 개입하는지에 따라 셋으로 나눈다.
| 개입 단계 | 기법 | 논문이 인용한 근거 |
|---|---|---|
| retrieval 이전 | small-to-big chunking, chunking 최적화 | Chiang 2024, Anthropic 2024 |
| retrieval 중간 | 질의 재작성, metadata filtering | Ma 2023, Anthropic 2024, Dadopoulos 2025 |
| retrieval 이후 | cross-encoder reranking, corrective retrieval | Nogueira and Cho 2019, Sun 2023, Yan 2024, Asai 2023 |
이 논문이 측정한 두 기법은 이 분류의 양 끝에 있다. small-to-big retrieval은 retrieval 이전 단계에 개입하고, cross-encoder reranking은 retrieval 이후 단계에 개입한다. 서로 겹치지 않는 자리에서 동작하므로 각각 독립적으로 평가할 수 있고, 논문도 그렇게 설계했다.
여기에 두 계열이 더 얹힌다. agentic RAG는 LLM agent에 retrieval 도구를 쥐여 주어 질의를 동적으로 구성하게 하는 방향이고, hybrid retrieval은 semantic vector 검색에 BM25 같은 lexical 방법을 결합하는 방향이다. 이 논문의 vector baseline은 두 계열을 모두 채택한다.
장문 컨텍스트 자체의 문제도 배경에 깔려 있다. 논문은 모델이 긴 컨텍스트의 중간부 정보에 접근하기 어려워한다는 "lost in the middle" 현상(Liu 2023)을 인용하며, 이것이 컨텍스트를 무작정 넓히는 방식의 상한을 만든다고 본다. 관련 절 전체를 통째로 넣는 hierarchical 방식이 불리해질 수 있는 이유이기도 하다.
이 논문이 채운 공백
논문은 두 가지 공백을 함께 지적한다. 첫째로 금융 문서에서 vector RAG와 non-vector RAG를 체계적으로 비교한 연구가 없다. 둘째로 cross-encoder reranking이나 small-to-big chunk retrieval 같은 고급 기법이 금융 질의응답의 정확도, 답변 품질, 지연, 비용에 각각 어떤 영향을 주는지를 통제된 조건에서 분리해 잰 연구가 없다.
두 번째 공백이 이 논문의 실험 설계를 규정한다. 기법을 한꺼번에 얹어 최종 성능만 보고하면 어느 기법이 얼마를 기여했는지 알 수 없다. 그래서 각 기법을 같은 vector baseline 위에 하나씩만 올려 baseline과 직접 비교하는 구조를 택했다.
핵심 개념
agentic RAG는 LLM이 retrieval 도구를 직접 호출하며 검색 질의를 스스로 구성하는 RAG를 뜻한다. 고정된 파이프라인이 질의를 그대로 검색에 넘기는 대신, 모델이 질문을 읽고 검색어를 만들고 필요하면 다시 검색한다.
hybrid search는 semantic vector 검색과 lexical 검색을 함께 쓰는 검색이다. 의미가 비슷한 문단과 단어가 그대로 겹치는 문단을 모두 잡기 위한 구성이다.
cross-encoder reranking은 1차 검색이 뽑은 후보를 정밀 모델로 다시 정렬하는 단계다. bi-encoder는 질의와 문서를 따로 인코딩해 벡터 거리를 재지만, cross-encoder는 질의와 후보 chunk를 한 입력으로 묶어 함께 인코딩한다. 정확도가 높은 대신 후보 하나마다 모델을 한 번씩 돌려야 해서 느리다. 그래서 1차로 후보를 좁힌 뒤 2단계로 적용하는 것이 표준이다.
small-to-big retrieval은 작은 chunk로 검색 정밀도를 유지하면서 LLM에 넘길 때는 인접 chunk를 붙여 더 넓은 컨텍스트를 주는 전략이다. 검색 단위와 생성 단위를 분리하는 발상이다.
metadata filtering은 chunk에 붙여 둔 속성으로 검색 범위를 미리 좁히는 방식이다. SEC filing이라면 연도, 양식 종류, 기업명 같은 값이 여기 해당한다. 질문이 특정 기업의 특정 분기를 지목하면 나머지 문서를 아예 후보에서 빼 버릴 수 있다.
corrective RAG는 retrieval 결과의 품질을 먼저 평가하고 미흡하다고 판단되면 질의를 다시 써서 검색을 반복하는 방식이다. 한 번의 검색으로 끝내지 않는다는 점에서 agentic 구성과 성격이 맞닿아 있다.
node tree는 문서 구조를 표현하는 계층 자료다. 노드 하나가 문서의 한 절에 대응하고 제목과 페이지 범위를 갖는다.
MRR과 Recall@5는 이 논문이 쓰는 두 retrieval 지표다. MRR은 첫 관련 chunk의 순위 역수를 질의 전체에 대해 평균한 값이고, Recall@5는 상위 5개 안에 관련 chunk가 들어온 비율이다. 두 지표는 성격이 다르다. Recall@5는 정답이 후보 안에 있는지만 보고, MRR은 그 정답이 몇 번째에 있는지까지 본다.
이 차이가 이 논문의 reranking 결과를 읽는 열쇠가 된다. Recall@5가 0.50에서 1.00으로 오르면 "정답을 아예 못 찾던 절반을 찾아냈다"는 뜻이고, MRR@5가 0.160에서 0.750으로 오르면 "찾은 정답이 훨씬 앞자리에 놓였다"는 뜻이다. 두 지표가 같이 오른 것은 두 종류의 개선이 동시에 일어났다는 의미다.
win rate는 이 논문이 답변 품질을 재는 단위다. 두 시스템의 답변을 judge 모델이 나란히 놓고 더 나은 쪽을 고르며, 여러 질의에 걸쳐 선호된 비율을 집계한다. 절대 점수가 아니라 상대 비교라서, 같은 65%라도 상대가 누구였는지를 함께 봐야 의미가 정해진다.
평가 설계
코퍼스와 벤치마크
논문은 평가 자산을 직접 만들었다. 기성 금융 벤치마크(FinanceBench, FinQA, TAT-QA)는 관련 연구에서 인용만 하고 실험에는 쓰지 않는다.
| 항목 | 값 |
|---|---|
| 문서 수 | SEC filing 1,200건 |
| 문서 종류 | 10-K, 10-Q, 8-K |
| 대상 기업 | Fortune 500 |
| 기간 | 2020년부터 2025년 |
| 문서 평균 길이 | 73,175 토큰 |
| 질문 수 | 150문항 |
질문은 난이도를 셋으로 나눠 균형을 맞췄다. 각 질문에는 정답과 근거 페이지 위치를 사람이 직접 붙였고, 이 페이지 번호가 retrieval 지표의 ground truth가 된다.
| 질문 유형 | 문항 수 | 성격 |
|---|---|---|
| multi-hop | 65 | 여러 근거를 이어야 답이 나온다 |
| single-hop | 65 | 단일 근거로 답할 수 있다 |
| summary | 20 | 넓은 범위를 요약해야 한다 |
150문항 전체를 모든 실험에 쓰지는 않았다. 실험마다 별도 하위 집합을 구성했다.
| 실험 | 사용 문항 수 |
|---|---|
| architecture 비교 | 75 |
| cross-encoder reranking 평가 | 50 |
| small-to-big retrieval 평가 | 50 |
측정 항목
평가는 네 방향에서 이뤄진다.
| 측정 항목 | 방법 |
|---|---|
| retrieval 정확도 | MRR과 Recall@5, ground truth는 annotation된 페이지 번호 |
| 답변 품질 | Claude 4.5 Sonnet의 pairwise 비교로 win rate 산출 |
| 지연 | 질의 제출부터 답변 생성까지 end-to-end |
| 비용 | preprocessing 비용과 runtime 비용을 분리 |
답변 품질 평가에 쓴 기준은 여섯 가지다. accuracy, completeness, clarity, conciseness, relevance, style이다. judge가 두 시스템의 답변을 나란히 놓고 선호를 고르며, win rate는 각 시스템이 선호된 비교의 비율이다.
실험 구성 요소
두 architecture와 두 기법 모두 답변 생성 모델은 GPT-4o로 고정했다. 비교 대상 외의 변수를 묶어 두기 위한 설계다.
| 역할 | 사용 모델 또는 서비스 |
|---|---|
| 답변 생성 | OpenAI GPT-4o |
| 임베딩 | OpenAI text-embedding-ada-002 |
| reranker | Cohere rerank-english-v3.0 |
| LLM judge | Anthropic Claude 4.5 Sonnet |
| vector DB | Azure AI Search |
| node tree 생성 | GPT-4o (GPT-4.1 mini, Gemini 2.5 Flash와 비교 후 채택) |
방법
두 architecture의 설계 대비
비교 대상 둘은 "질문에 맞는 문단을 어떻게 찾을 것인가"에 대한 답이 정반대다. 한쪽은 의미 유사도를 미리 계산해 두고, 다른 쪽은 질의 시점에 LLM이 문서 지도를 읽는다.
| 설계 항목 | vector 기반 agentic RAG | hierarchical node-based |
|---|---|---|
| 인덱싱 단위 | 512 토큰 chunk | 문서의 절에 대응하는 노드 |
| preprocessing 산출물 | chunk 임베딩과 metadata | 페이지 범위를 담은 node tree |
| 후보 선정 방식 | semantic과 lexical을 결합한 hybrid search | LLM의 계층 traversal |
| 임베딩 사용 | 사용 | 사용하지 않음 |
| 질의 시점 비용 | 검색과 LLM 추론 | LLM 추론 |
| preprocessing 비용 | 임베딩 생성 | node tree 생성 (10-K 한 건당 30.62달러) |
| 실패가 나는 지점 | 의미가 겹치는 chunk의 오선정 | table-of-contents 단계의 노드 오선정 |
vector 기반 agentic RAG
논문의 baseline이자 최종 승자다. 구성은 다음과 같다.
- 문서를 512 토큰 chunk로 자르고 chunk 사이에 50 토큰 overlap을 둔다.
- 각 chunk를
text-embedding-ada-002로 임베딩해 metadata와 함께 Azure AI Search에 저장한다. - 질의 시점에 LLM agent가 검색 질의를 직접 만들고 hybrid search로 top-k chunk를 가져온다.
논문 서론은 이 baseline을 "hybrid search with metadata filtering, corrective RAG, and standard token-based chunking"으로 요약한다. corrective RAG는 retrieval 결과 품질을 평가해 미흡하면 질의를 다시 쓰는 방식으로, Yan 2024의 CRAG를 인용한다. 다만 이 인용은 서론 한 문장에만 나오고 방법 절의 시스템 서술에서는 다시 언급되지 않아, 실제 구현 수준까지는 확인할 수 없다.
lexical 쪽 구현도 마찬가지다. 관련 연구 절은 hybrid retrieval의 일반적 정의를 설명하며 BM25를 인용하지만, 자체 시스템을 서술하는 절은 "semantic matching과 lexical matching의 결합"이라고만 적고 lexical 구현의 이름을 밝히지 않는다.
hierarchical node-based reasoning 시스템
비교 대상은 임베딩을 전혀 쓰지 않는다. 문서마다 목차 형태의 계층 트리를 만들어 두고, 질의가 들어오면 LLM이 그 트리를 타고 내려간다.
노드 하나는 다음 필드를 갖는다.
| 필드 | 뜻 |
|---|---|
title |
절 제목 |
start_index |
절이 시작하는 페이지 |
end_index |
절이 끝나는 페이지 |
node_id |
노드 식별자 |
nodes |
하위 절을 담는 중첩 배열 |
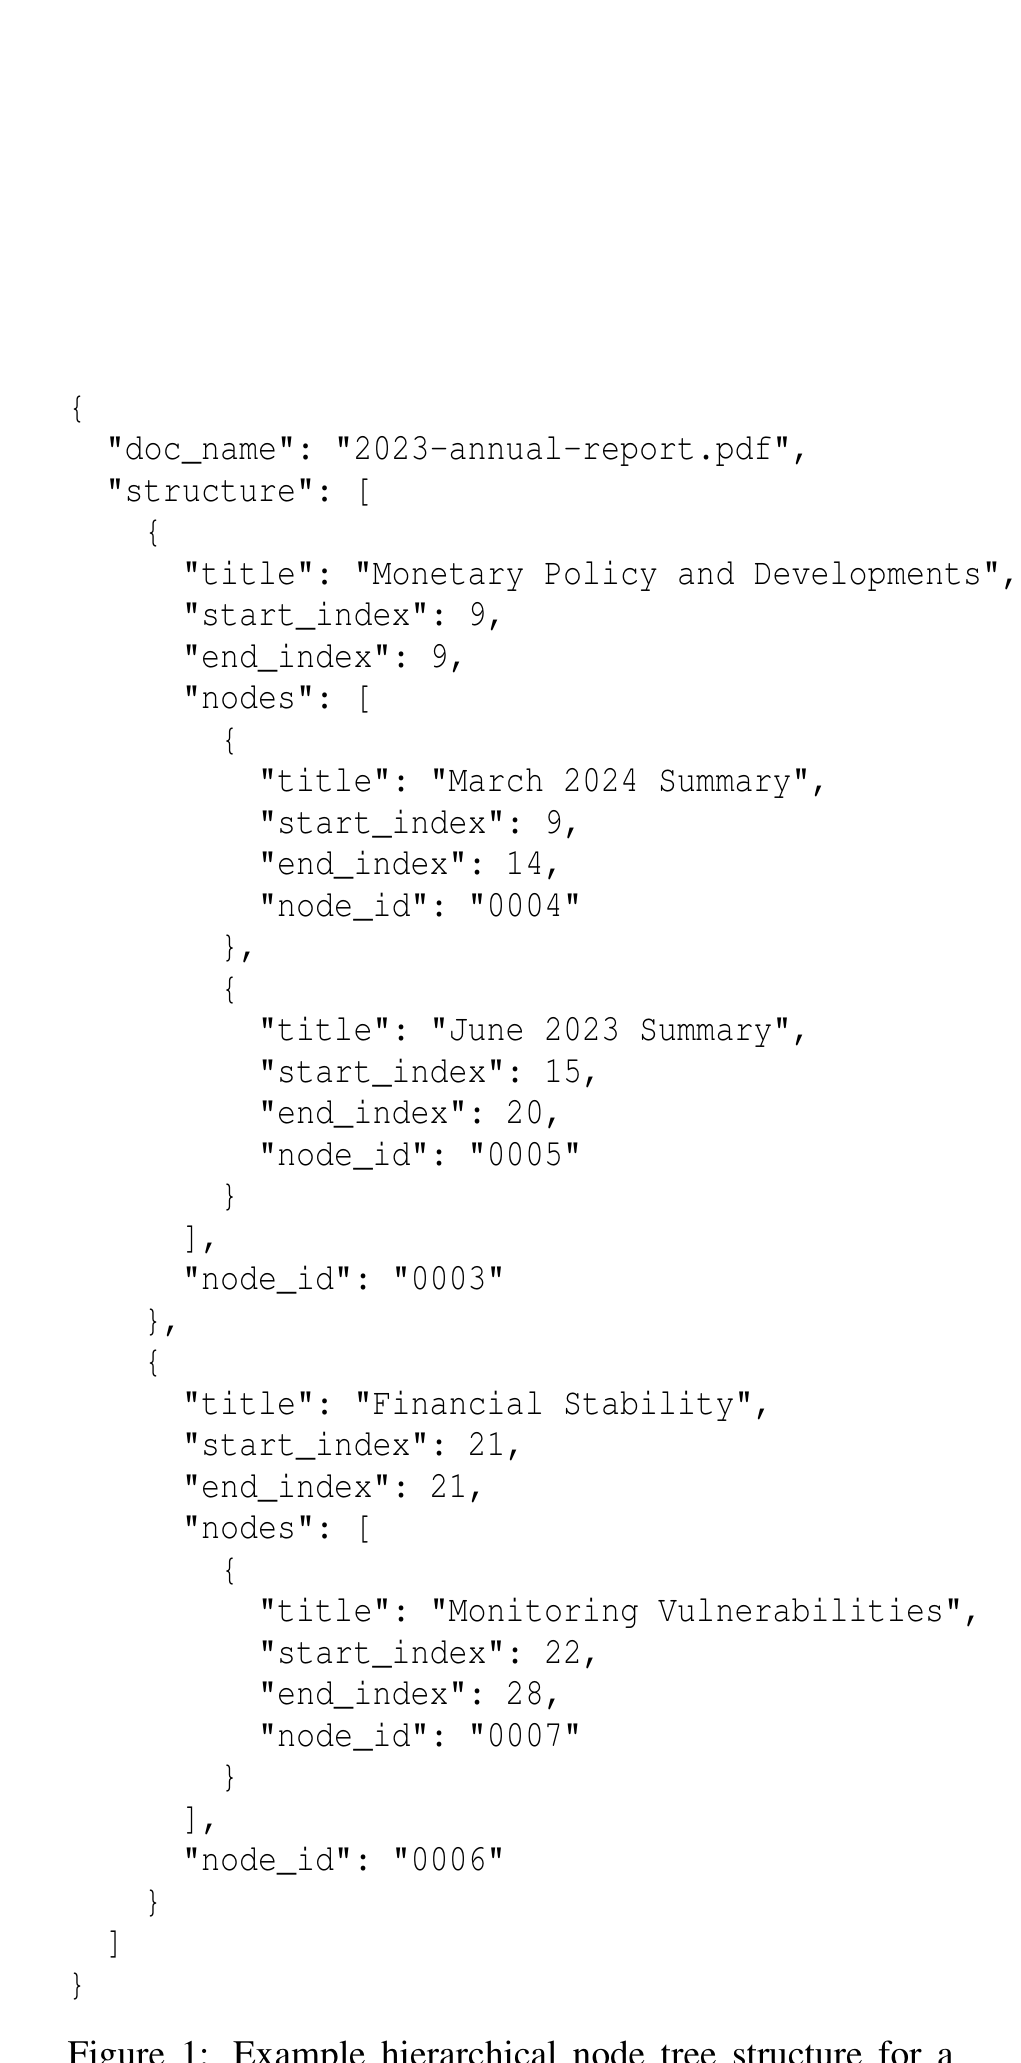
질의 시점의 동작은 두 단계다. LLM이 계층을 traversal하며 관련 노드를 고르고, 선택된 노드의 페이지 범위를 컨텍스트로 읽는다. 임베딩 생성 비용이 사라지는 대신 문서 구조를 탐색하는 LLM의 추론 능력에 전적으로 의존하게 된다.
node tree 생성 모델로는 세 후보를 비교했다. GPT-4o가 구조 일관성 면에서 가장 나았고 Gemini 2.5 Flash는 호환성 문제를 보여, 최종 생성에는 GPT-4o를 썼다.
cross-encoder reranking
vector 기반 architecture 위에 독립적으로 얹어 baseline vector retrieval과 비교했다. 동작은 두 단계다.
- vector 검색이 개 chunk를 가져온다.
- cross-encoder가 질의와 chunk 쌍을 함께 인코딩해 점수를 매기고 상위 개를 남긴다.
제약은 하나뿐이고, 논문은 (10, 5)부터 (100, 30)까지 조합 10가지를 측정했다.
small-to-big retrieval
역시 vector 기반 architecture 위에 독립적으로 적용했다. vector 검색으로 target chunk를 찾은 뒤 바로 앞뒤 chunk를 붙여 컨텍스트를 넓히는 방식이다.
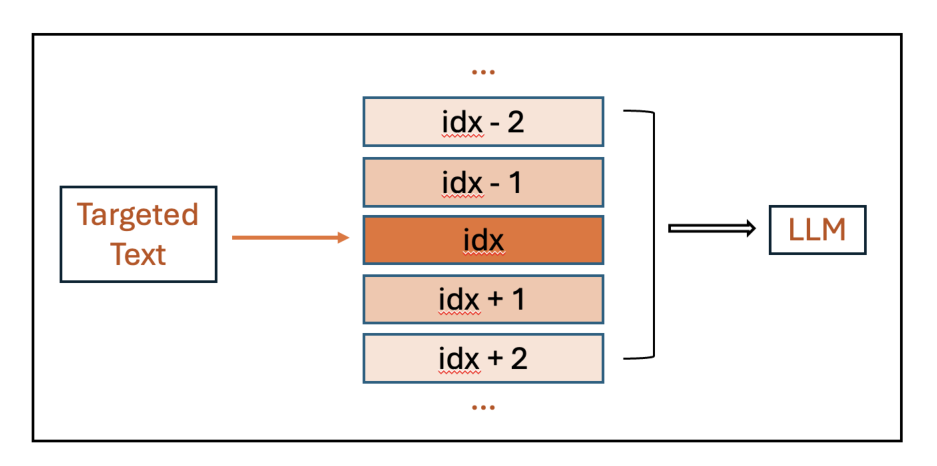
구현 방식은 두 가지를 비교했다. 인접 chunk를 순차로 가져오는 동기 방식과 병렬로 가져오는 비동기 방식이다.
결과
architecture 비교
75문항 하위 집합에서 vector 기반 agentic RAG가 68% win rate를 얻었다. 지연도 vector 쪽이 짧았다.
| 시스템 | win rate | 평균 지연 | 실패 |
|---|---|---|---|
| vector 기반 agentic RAG | 68% | 5.20초 | 없음 |
| hierarchical node-based | 논문 미기재 | 5.98초 | 답변 실패 2건, 오답 2건 |
hierarchical 시스템이 무너진 지점은 두 곳이다. 첫째로 context window 제약에 부딪혀 2문항에 답하지 못하고 2문항에 오답을 냈다. 둘째로 답을 낸 경우에도 품질 비교에서 밀렸다. vector 시스템은 모든 질문에서 관련 컨텍스트 retrieval에 성공했다.
논문은 패배 원인을 table-of-contents 단계의 선택 병목으로 특정한다. LLM이 문서 구조에서 관련 절을 고르는 능력이 vector의 semantic matching보다 못했다는 것이다. 이 단계에서 잘못 고르면 그 아래 traversal이 아무리 정교해도 소용이 없으므로, 계층 접근의 성능은 첫 선택에 크게 좌우된다.
지연이 비슷한데도 두 시스템의 비용 구조는 다르다. 논문의 discussion은 hierarchical 쪽에 10-K당 30.62달러의 preprocessing 비용이 든다고 적는데, 이 값은 Table 1에서 온 것이고 그 표의 캡션은 대상을 한 기업의 filing으로 규정한다. 단위 표기가 어긋나는 지점이라 한계 절에서 따로 다룬다. 논문은 그럼에도 vector 시스템의 답변 품질 우위가 정확도가 중요한 응용에서는 인프라 투자를 정당화한다고 적는다.
cross-encoder reranking
이 논문에서 효과 크기가 가장 큰 결과다. baseline vector retrieval의 MRR@5는 0.160이었는데, 최적 설정에서 0.750까지 올랐다.
| MRR@5 | Recall@5 | 평균 지연 | |
|---|---|---|---|
| baseline (reranking 없음) | 0.160 | 0.50 | 0.22초 |
| (100, 20) | 0.519 | 1.00 | 6.01초 |
| (100, 30) | 0.519 | 1.00 | 5.33초 |
| (75, 25) | 0.536 | 1.00 | 4.52초 |
| (75, 15) | 0.536 | 1.00 | 3.03초 |
| (50, 10) | 0.550 | 1.00 | 4.15초 |
| (10, 5) | 0.750 | 1.00 | 2.02초 |
| (50, 5) | 0.550 | 1.00 | 2.52초 |
| (20, 10) | 0.566 | 1.00 | 1.61초 |
| (20, 5) | 0.479 | 1.00 | 2.13초 |
| (10, 10) | 0.625 | 1.00 | 1.24초 |
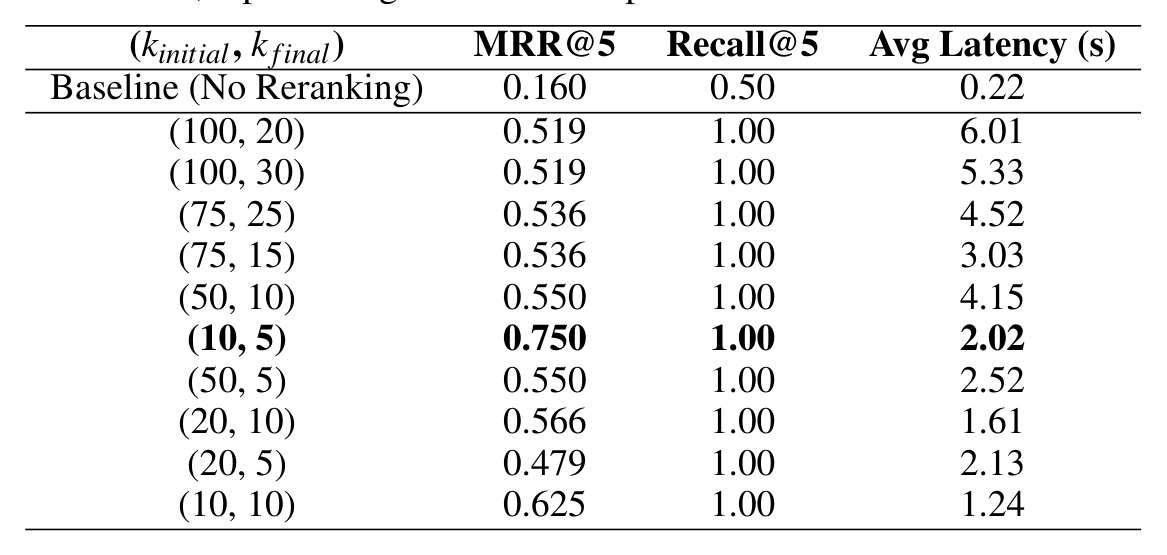
표가 보여주는 것은 세 가지다.
첫째로 시험한 모든 reranking 설정이 Recall@5 1.00을 기록했다. baseline의 0.50과 비교하면 두 배다. 즉 reranking을 붙이는 순간 정답 chunk가 상위 5개 안에 항상 들어왔다. 논문은 이를 reranking이 순위 품질뿐 아니라 coverage도 개선한 것으로 해석한다.
둘째로 초기 retrieval 깊이를 키운다고 좋아지지 않았다. 가장 얕은 (10, 5)가 MRR@5 0.750으로 최고였고, 이 50 이상인 구간은 수확 체감을 보였다. 논문은 이 현상 자체는 보고하되 원인은 설명하지 않는다.
셋째로 지연과 품질의 절충점이 설정마다 다르다. 응답 2초 미만이 요구되는 상황이라면 (10, 10)이 대안이 된다.
| 요구 조건 | 권장 설정 | MRR@5 | 지연 |
|---|---|---|---|
| 정확도 최우선 | (10, 5) | 0.750 | 2.02초 |
| 응답 2초 미만 | (10, 10) | 0.625 | 1.24초 |
small-to-big retrieval
비용 대비 효과가 가장 좋은 기법이다.
| 항목 | 값 |
|---|---|
| baseline chunking 대비 win rate | 65% |
| 추가 지연 | 0.2초 |
| 질의당 비용 | 0.000078달러 (증가 없음) |
| 비동기 구현 지연 | 0.17초 |
| 동기 구현 지연 | 0.34초 |
비동기 구현이 인접 chunk를 병렬 질의해 동기 구현의 약 절반 시간에 끝났다. 질의당 비용이 그대로인 이유는 추가로 붙이는 chunk가 이미 저장된 데이터를 읽는 것이라 새 임베딩 계산이나 추가 모델 호출이 필요 없기 때문이다.
다만 효과는 질의 유형에 달렸다. 답이 고립된 단일 사실인 needle-in-haystack 질의에서는 컨텍스트를 넓혀도 이득이 제한적이다. 반면 chunk 경계를 넘나드는 근거가 필요한 multi-hop 추론 질의에서는 답변 품질이 크게 좋아진다.
preprocessing 비용
hierarchical 접근에만 붙는 비용이다. 한 기업의 filing을 node tree로 바꾸는 데 드는 비용을 모델 3종으로 비교했다.
| 항목 | 평균 10-Q | 평균 10-K |
|---|---|---|
| 총 토큰 | 214만 9,038 | 333만 6,665 |
| OpenAI GPT-4o 비용 | 7.21달러 | 30.62달러 |
| Google Gemini 2.5 Flash 비용 | 0.99달러 | 5.94달러 |
| OpenAI GPT-4.1 mini 비용 | 4.23달러 | 22.27달러 |
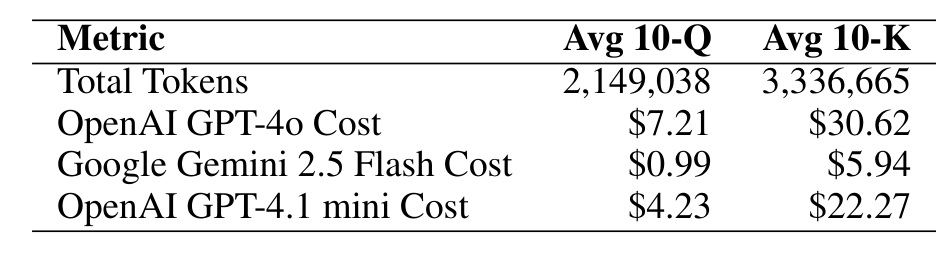
Gemini 2.5 Flash가 가장 저렴하지만 호환성 문제로 최종 채택되지 않았다. 비용만 보면 GPT-4o의 19% 수준이다.
여기에 선택 변수가 하나 더 있다. 노드마다 요약문을 붙일지 여부다. 요약을 붙이면 LLM이 traversal할 때 참고할 설명이 풍부해지지만 출력 토큰이 늘어난다. 논문은 filing 한 건 기준으로 두 경우를 나눠 측정했다.
| 지표 | summary 포함 10-Q | summary 포함 10-K | summary 미포함 10-Q | summary 미포함 10-K |
|---|---|---|---|---|
| 총 토큰 | 12만 6,414 | 66만 7,333 | 5만 6,833 | 29만 9,622 |
| 입력 토큰 | 11만 7,115 | 62만 7,381 | 5만 2,080 | 28만 1,536 |
| 출력 토큰 | 9,299 | 39만 9,952 | 4,753 | 1만 8,086 |
| 지연 | 48.46초 | 144.61초 | 44.18초 | 125.95초 |
| GPT-4o 비용 | 0.42달러 | 6.12달러 | 0.20달러 | 0.97달러 |
| Gemini 2.5 Flash 비용 | 0.06달러 | 1.19달러 | 0.03달러 | 0.13달러 |
| GPT-4.1 mini 비용 | 0.25달러 | 4.45달러 | 0.11달러 | 0.71달러 |
10-K 한 건을 GPT-4o로 처리할 때 요약 포함 비용이 0.97달러에서 6.12달러로 6.3배 늘어난다. 논문은 질의 복잡도에 따라 요약 포함 여부를 정하는 선택적 적용을 후속 과제로 제안한다.
비용 구조를 architecture 단위로 놓고 보면 차이가 분명해진다. hierarchical 쪽은 문서를 넣는 시점에 큰 비용을 한 번 치르고 질의 시점 비용은 낮다. vector 쪽은 임베딩 생성이라는 훨씬 가벼운 preprocessing만 있고 질의 시점에 검색과 reranking 비용이 붙는다. 코퍼스가 자주 갱신되면 전자의 부담이 반복해서 발생한다.
측정 결과 종합
논문이 잰 세 가지를 한 표에 놓으면 각 선택지가 무엇을 주고 무엇을 요구하는지가 드러난다.
| 선택 | 얻는 것 | 치르는 것 |
|---|---|---|
| hierarchical 대신 vector agentic RAG | 68% win rate, 답변 실패 0건 | 임베딩 인덱스 구축과 유지 |
| cross-encoder reranking (10, 5) 적용 | MRR@5 0.160에서 0.750, Recall@5 0.50에서 1.00 | 지연 0.22초에서 2.02초 |
| cross-encoder reranking (10, 10) 적용 | MRR@5 0.625, Recall@5 1.00 | 지연 1.24초 |
| small-to-big retrieval 적용 | 65% win rate | 지연 0.2초, 추가 비용 없음 |
| node-level summary 포함 | traversal용 노드 설명이 풍부해짐 | 10-K 한 건당 0.97달러에서 6.12달러 |
지연 관점에서 보면 세 기법의 성격이 다르다. small-to-big은 0.2초를 더하고 끝나지만, reranking은 baseline의 0.22초를 2.02초로 아홉 배 넘게 늘린다. 그럼에도 논문이 reranking을 권하는 근거는 retrieval 지표의 개선 폭이다. baseline 상태에서는 질의 절반에서 정답 chunk가 상위 5개 안에 들어오지도 못했다.
한편 architecture 비교의 지연 차이는 작다. 5.20초와 5.98초의 차이는 reranking 하나를 붙이고 떼는 것보다 작으므로, 두 architecture 사이의 선택은 지연이 아니라 답변 품질과 비용 구조로 결정된다.
한계
저자가 명시한 한계
| 한계 | 내용 |
|---|---|
| 질문 집합의 편향 | hierarchical의 열세가 질문 집합이 특정 사실 retrieval에 치우친 결과일 수 있다고 저자 스스로 밝힌다 |
| hybrid 미구현 | 임베딩으로 후보 노드를 좁힌 뒤 LLM traversal을 적용하는 조합을 제안만 하고 실험하지 않았다 |
| reranker 단일 | Cohere rerank-english-v3.0 한 종류만 평가했다. LLM 기반 reranker와 금융 전용 reranker와의 비교를 후속 과제로 남겼다 |
| 확장 폭 고정 | small-to-big에서 앞뒤 chunk 한 개씩만 붙였다. 다른 창 크기가 답변 품질과 컨텍스트 산만도에 미치는 영향은 미측정이다 |
| 기법 효과의 조건 의존 | small-to-big의 이득이 needle-in-haystack 질의에서는 제한적이라고 명시한다 |
| 선택적 요약 미검증 | 질의 복잡도 기반의 요약 포함 판단을 제안만 했다 |
이 표의 첫 항목과 마지막 두 항목은 성격이 다르다. 첫 항목은 이미 나온 결과의 해석 범위를 좁히는 단서이고, 나머지는 아직 재지 않은 것의 목록이다. 결론을 인용할 때 구분해서 다뤄야 한다.
첫 번째 항목은 이 논문의 결론을 읽을 때 가장 중요한 단서다. 저자는 hierarchical의 패배를 두 가지로 해석할 여지를 남긴다. LLM이 복잡한 금융 질의에서 계층 탐색에 실제로 약했거나, 아니면 질문 집합이 hierarchical traversal에 유리한 광범위 문서 요약보다 특정 사실 retrieval에 치우쳤을 수 있다는 것이다. 이 논문의 150문항 중 summary 유형은 20문항으로 전체의 13%에 그친다.
논문에 기술이 없어 확인할 수 없는 부분
| 항목 | 내용 |
|---|---|
| hierarchical win rate | vector 쪽 68%만 적혀 있고 상대 값은 본문에 없다. 무승부 처리 방식도 기술되지 않았다 |
| 하위 집합 구성 | 75문항, 50문항, 50문항이 서로 겹치는지와 선정 기준이 기술되지 않았다 |
| 임베딩 모델 단일 | text-embedding-ada-002 하나만 썼고 저자는 이를 한계로 다루지 않는다 |
| 도메인 일반화 | 미국 SEC filing에 한정되며 다른 장문 도메인으로의 확장은 논의되지 않는다 |
| 비용 손익 분기 | 1회성 preprocessing 비용과 누적 질의 비용의 균형점을 계산한 모델이 없다 |
| 지표 역전의 원인 | Table 4에서 (20, 5)의 MRR@5 0.479가 (100, 20)의 0.519보다 낮은 역전이 설명되지 않는다 |
자료 자체의 내적 모순
논문 안에서 값이 어긋나는 곳이 두 군데 있다.
Table 2의 10-K 토큰 합계. 총 토큰 66만 7,333이 입력 62만 7,381과 출력 39만 9,952의 합인 102만 7,333과 맞지 않는다. 출력이 3만 9,952였다면 합이 정확히 총 토큰과 같아진다. 같은 표의 10-Q 열과 Table 3의 두 열은 모두 입력과 출력의 합이 총 토큰과 일치하므로, 10-K 출력 토큰이 자릿수 오기일 가능성이 높다. 다만 원문 값이 그렇게 인쇄되어 있어 표에는 원문 그대로 옮겼다.
small-to-big의 확장 폭. Figure 2의 도식과 캡션은 target chunk의 앞뒤 두 칸씩(idx-2, idx-1, idx+1, idx+2)을 붙이는 5칸 창을 보여준다. 반면 방법 절과 discussion은 "바로 앞뒤 chunk 한 개씩"이라고 적는다. 실제 구현이 어느 쪽인지는 본문만으로 판정할 수 없다.
10-K 한 건당 preprocessing 비용. discussion은 같은 절 안에서 GPT-4o의 10-K 처리 비용을 두 값으로 적는다. 하나는 "10-K filing 한 건당 30.62달러"이고 다른 하나는 "요약 포함 시 10-K당 0.97달러에서 6.12달러"다. 앞 값은 Table 1에서 왔는데 Table 1의 캡션은 그 값을 "한 기업의 filing"에 대한 것으로 규정하고 총 토큰도 333만으로 적는다. 뒤 값이 나온 Table 2의 10-K 총 토큰은 66만이다. 토큰 규모가 다섯 배 차이 나므로 두 값의 단위가 서로 다를 가능성이 높지만, discussion은 둘 다 "per 10-K"로 표기한다. 이 페이지는 표별 단위를 구분해 적었고, 30.62달러를 인용할 때는 그것이 Table 1 기준임을 함께 밝힌다.
후속 방향
논문이 제시한 다음 단계는 세 가지다.
- vector와 hierarchical의 결합. 임베딩으로 후보 노드 범위를 먼저 좁히고 그 안에서 LLM이 traversal하면, table-of-contents 선택 병목을 줄이면서 구조적 추론의 이점을 유지할 수 있다.
- reranker 계열 확장. LLM 기반 reranker와 금융 도메인 전용 reranker를 함께 재면 정확도와 지연의 절충 지형이 더 선명해진다.
- 선택적 요약 포함. 질의 복잡도를 보고 node-level summary를 붙일지 말지 정하면 6.3배 비용 차이를 필요한 곳에만 쓸 수 있다.
세 방향은 모두 "무엇을 얼마나 쓸지 미리 정하지 말고 질의를 보고 정하자"는 하나의 발상으로 묶인다. 후보 노드 범위도, reranker 종류도, 요약 포함 여부도 질의에 따라 달라져야 한다는 것이다.
저자 계보를 보면 이 방향이 우연이 아니다. 제1저자 Lumer는 PwC에서 agentic 시스템의 retrieval을 다뤄 온 연구자로, 논문 참고문헌에 Toolshed(2024), MemTool(2025a), ScaleMCP(2025b), Tool-to-Agent Retrieval(2025c)이 인용된다. 네 연구 모두 도구나 에이전트를 동적으로 골라 쓰는 문제를 다룬다. 이 논문은 같은 문제의식을 문서 retrieval로 옮겨 온 셈이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| MRR | 첫 관련 chunk의 순위 역수를 질의 전체에 대해 평균한 값이다. 1에 가까울수록 정답이 앞에 온다 |
| Recall@5 | 상위 5개 결과 안에 관련 chunk가 포함된 비율이다 |
| cross-encoder reranking | 질의와 후보 chunk를 한 입력으로 묶어 함께 인코딩해 점수를 매기는 2단계 정렬이다 |
| small-to-big retrieval | 작은 chunk로 검색하고 LLM에 넘길 때는 인접 chunk를 붙여 컨텍스트를 넓히는 전략이다 |
| hierarchical node-based reasoning RAG | 문서를 목차 트리로 바꾸고 LLM이 노드를 traversal해 페이지 범위를 읽는 임베딩 없는 방식이다 |
| LLM-as-a-Judge (pairwise) | 두 시스템의 답변을 LLM이 비교해 승자를 고르고 win rate를 집계하는 평가 방법이다 |
관련 페이지
- VectifyAI/PageIndex: 이 논문이 hierarchical 접근의 출처로 인용한 PageIndex 저장소다. 논문은 저장소 자체를 평가한 것이 아니라 같은 구조의 시스템을 자체 구현해 비교했으므로, 두 페이지의 수치를 서로 옮겨 쓰지 않는다.
- Vectorless RAG: PageIndex: 임베딩 없는 RAG를 입문 수준으로 소개하는 튜토리얼이다. 이 논문은 같은 접근을 금융 도메인에서 정량 비교해 반대 방향의 근거를 제시한다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩 없이 원문을 직접 뒤지는 접근을 다룬 다른 논문이다. 결론 방향은 이 논문과 반대지만, 두 논문 모두 대상 task에 따라 architecture 선택이 갈린다는 관점을 공유한다.
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: 임베딩 기반 chunk retrieval을 다른 방향에서 재검토한 논문으로, 이 논문의 vector baseline이 무엇을 전제하는지 비교해 읽을 수 있다.
- GraphRAG: From Local to Global: 문서를 graph로 인덱싱해 요약형 질의를 다루는 접근이다. 이 논문이 약세를 확인한 summary 유형 질의를 정면으로 겨냥한다는 점에서 대비된다.
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): knowledge graph의 계층 구조 위에서 후보 경로를 좁히는 방식이다. 이 논문이 후속 과제로 제안한 "후보를 먼저 좁힌 뒤 구조를 타고 내려간다"는 발상과 문제의식이 겹친다.
- RAG는 더 이상 vector search + LLM이 아니다: 다섯 가지 production RAG 아키텍처 (Pandey, LinkedIn): RAG를 단일 패턴이 아니라 설계 공간으로 보는 관점을 제공한다. 이 논문은 그 공간 안에서 hybrid search, agentic 구성, reranking, 컨텍스트 확장을 금융 도메인 수치로 채운 사례에 해당한다.