Database · PAPER · 2026
LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26)
요약
LeanRAG는 지식 그래프를 인덱스로 쓰는 RAG에서 그래프를 만드는 방식과 그래프를 뒤지는 방식을 한 쌍으로 함께 설계한 프레임워크다. Shanghai AI Lab을 중심으로 한 여덟 명의 저자가 AAAI-26에 발표했다.
출발점은 앞선 연구들이 계층 구조로 옮겨 가면서도 풀지 못한 두 가지 결함이다. 하나는 상위 요약 노드들이 서로 이어지지 않아 개념 무리 사이를 넘나드는 추론이 막히는 semantic island이고, 다른 하나는 retrieval이 그래프의 모양을 활용하지 못하고 평면 목록 위 유사도 탐색으로 되돌아가는 structure-retrieval mismatch다.
해결책도 두 가지다. 첫째, semantic aggregation은 entity를 클러스터로 묶어 상위 entity를 만들 뿐 아니라 상위 entity 사이의 relation까지 LLM으로 만들어, 어느 층에서나 이동할 수 있는 semantic network를 구성한다. 둘째, LCA 기반 bottom-up retrieval은 질의(query)를 가장 세밀한 base 층 entity에만 붙인 다음, 그 seed들의 최소 공통 조상까지 이어지는 경로만 모아 작은 서브그래프를 만든다.
UltraDomain의 네 데이터셋에서 1에서 10 척도 지표 16칸 중 11칸이 단독 1위이고 1칸이 공동 1위이며, retrieval된 context의 토큰 수는 baseline 평균 대비 46% 줄었다. 두 ablation은 상위 relation이 Diversity에 가장 크게 기여한다는 점과, 그래프만으로는 부족하고 원문 chunk가 함께 있어야 한다는 점을 보인다.
배경
RAG가 안고 있던 chunking dilemma
RAG는 외부 코퍼스에서 관련 텍스트 chunk를 가져와 생성의 context로 붙여 LLM의 정적 지식 한계와 환각을 줄이는 방법이다. 논문은 이 방식의 근본 난점을 chunking dilemma라고 부른다.
chunk를 작게 자르면 맥락이 끊기고, 크게 자르면 잡음이 섞여 모델의 초점이 흐려진다. 여기에 임베딩 유사도만으로는 복잡한 추론에 필요한 깊은 의미 관련성을 잡지 못한다는 문제가 겹친다. 그 결과 응답이 불완전하거나 맥락에 어긋나게 된다.
극복 시도는 두 방향으로 갈렸다. retriever 자체를 개선하는 쪽은 희소 방식 BM25에서 밀집 모델 DPR과 Contriever로 옮겨 갔고, 문서를 조직하는 쪽은 텍스트 chunk의 계층 요약을 만들어 여러 수준에서 가져오게 했다. 후자의 대표가 RAPTOR로, 재귀 요약 클러스터 트리를 만들어 세밀한 세부와 상위 요약을 함께 제공한다.
다만 이 방법들은 지식을 선형 구조나 단순 계층으로만 다룬다. entity와 개념 사이의 복잡한 비계층 관계를 명시적으로 모델링하지 않기 때문에, 그런 연결을 따라가야 답할 수 있는 질의에서 한계가 남는다. 이 한계가 KG 기반 RAG로 넘어가는 동기가 되었다.
지식 그래프 기반 RAG의 계보
지식을 entity와 relation의 그래프로 표현하면 LLM에 더 구조적인 context를 줄 수 있다. 논문은 이 계보를 세 단계로 정리한다.
| 단계 | 대표 방법 | 무엇을 했는가 | 남은 문제 |
|---|---|---|---|
| 1세대 그래프 구조 도입 | GraphRAG (Edge et al. 2024) | 문서를 community 기반 KG로 조직해 지역 맥락을 chunk보다 잘 보존 | community가 크고 거칠어 retrieval 시 정보 중복이 크다 |
| 1세대 중심성 활용 | FastGraphRAG | PageRank로 중요한 노드를 우선 | 중요도 순위만으로는 구조를 쓰는 것이 아니다 |
| 2세대 계층 도입 | HiRAG (Huang et al. 2025a) | entity를 클러스터링해 다중 수준 요약을 만든다. 논문이 인정하는 당시 state-of-the-art | 상위 요약 노드 사이에 relation이 없다 |
| 2세대 이원 검색 | LightRAG (Guo et al. 2024) | dual-level 구성으로 global과 local retrieval의 균형 | retrieval이 인덱싱과 분리되어 있다 |
산업 적용 사례로는 고객 서비스에서 과거 지원 티켓으로 KG를 만들어 구조화된 context를 제공한 연구(Xu et al. 2024)가 인용된다.
남아 있던 두 문제
LeanRAG가 문제로 세운 것은 다음 두 가지다. 이 구분이 논문 전체의 뼈대이므로 결과를 읽을 때도 계속 참조된다.
| 문제 | 정의 | 어디서 생기는가 | LeanRAG의 대응 |
|---|---|---|---|
| Semantic islands | 상위 개념 요약 노드들이 서로를 가리키는 explicit relation 없이 고립된 상태 | 계층 요약을 만들되 relation은 만들지 않는 HiRAG, RAPTOR 계열 | aggregated relation 생성 |
| Structure-retrieval mismatch | retrieval이 그래프 위상을 쓰지 못하고 평면화된 노드 목록 위 단순 의미 탐색으로 퇴화 | retrieval이 인덱싱과 분리되어 설계된 구조 | LCA 기반 bottom-up 순회 |
두 번째 문제에는 부연이 붙는다. 기존 방법에서 구조 정보는 retrieval이 끝난 뒤 결과를 넓히는 데만 쓰이고, 정작 무엇을 찾을지 고르는 결정적 단계에는 개입하지 못한다. 그래서 논문은 retrieval을 지식 구조와 함께 설계해야 한다고 주장한다.
기존 절차의 형식화
논문은 비교 기준이 되는 KG 기반 RAG의 기본 절차를 먼저 형식화한다. 지식 그래프는 로 쓴다. 는 entity 집합, 은 relation 집합이고, 와 은 각각 entity 설명문과 relation 설명문의 모음이다. 노드와 간선 양쪽에 자연어 설명문이 붙어 있다는 점이 이 형식화의 특징이다.
질의 가 들어오면 먼저 설명문 임베딩과의 유사도로 상위 개 entity를 고른다.
이어서 뽑힌 노드들의 모든 쌍 사이 경로를 합쳐 relation 경로 을 만든다.
와 로 만든 서브그래프 가 생성기에 전달된다. 이 절차에서 문제가 되는 자리는 두 곳이다. 첫째, 유사도 탐색의 대상 가 그래프 전체라서 상위 요약 노드와 base 노드가 한 목록에 섞인다. 둘째, 경로 계산이 모든 노드 쌍에 대해 이루어져 뽑는 entity 수가 늘수록 중간 노드가 빠르게 늘어난다. LeanRAG는 첫째를 anchoring 대상 축소로, 둘째를 LCA 경로 한정으로 바꾼다.
논문이 내세운 기여
논문이 Introduction 말미에 스스로 정리한 기여는 세 항목이다.
| 기여 | 내용 |
|---|---|
| semantic aggregation 알고리즘 | 요약 수준 개념 노드 사이에 새 relational edge를 만들어 다중 해상도 지식 지도를 구성한다. 세밀한 사실과 상위 주제 연결을 한 구조 안에 함께 보존하는 것이 목표다 |
| bottom-up entity retrieval 전략 | 관련도가 높은 anchor 노드에서 출발해 의미 있는 경로를 따라서만 context를 넓혀, 정밀하고 압축된 evidence 서브그래프를 만든다 |
| 여러 QA 과제에서의 state-of-the-art | 응답 품질과 효율 양쪽에서 기존 방법을 앞선다고 주장한다 |
논문의 네 연구 질문
실험 절은 네 개의 연구 질문으로 구성된다. 각 질문은 앞에서 세운 두 문제와 짝을 이룬다.
| 연구 질문 | 무엇을 묻는가 | 어느 문제와 맞물리는가 |
|---|---|---|
| RQ1 | 여러 도메인에서 기존 방법 대비 QA 성능이 어떤가 | 두 문제 전체 |
| RQ2 | retrieval 전략이 중복을 줄이면서 생성 품질을 올리는가 | structure-retrieval mismatch |
| RQ3 | 상위 entity 사이 relation 생성이 응답 품질에 얼마나 기여하는가 | semantic islands |
| RQ4 | 그래프에서 가져온 구조 지식만으로 충분한가, 아니면 원문 context가 필요한가 | 방법의 전제 검증 |
RQ3가 semantic island 문제의 직접 검증이라는 점이 특히 중요하다. 상위 relation을 빼면 LeanRAG는 상위 노드가 고립된 기존 계층 방법과 같은 구조가 되므로, 이 ablation의 결과가 곧 문제 설정 자체의 타당성 근거가 된다.
핵심 개념
이 페이지에서 반복해 쓰는 용어를 먼저 풀어 둔다.
entity는 지식 그래프의 노드로, 문서에서 뽑아낸 개체 하나를 가리키며 이름과 설명문을 함께 가진다. relation은 두 entity를 잇는 간선이고 역시 설명문을 가진다. 논문이 다루는 그래프는 노드와 간선 양쪽에 자연어 설명문이 붙어 있는 형태다.
hierarchy는 평면 그래프 위에 상위 층을 쌓아 만든 다층 구조다. 아래 층의 여러 노드가 위 층의 노드 하나로 묶이며, 위로 갈수록 추상적인 view가 된다. 층 사이의 부모 자식 관계가 명시적으로 유지되므로 어떤 노드에서 출발해도 위로 올라가는 길이 하나로 정해진다.
community와 hierarchy는 비슷해 보이지만 역할이 다르다. community는 같은 층 안에서 노드를 묶은 덩어리이고, 논문은 GraphRAG 계열의 community가 크고 거칠어 retrieval 시 중복을 키운다고 지적한다. hierarchy는 층 사이의 포함 관계를 명시해 두어, 어느 수준의 추상도로 볼지를 골라 가며 이동할 수 있게 한다.
aggregated entity는 한 클러스터를 대표해 새로 만들어진 상위 노드다. 클러스터 안의 entity 목록과 그 사이 relation을 함께 본 LLM이 이름과 설명문을 생성한다.
aggregated relation은 같은 층의 두 aggregated entity를 잇는 새 간선이다. 이것이 LeanRAG가 앞선 계층 방법과 갈리는 지점이다.
connectivity strength는 두 클러스터에 각각 속한 노드들을 잇던 base 층 relation의 개수다. 이 값이 클수록 두 클러스터가 원래 그래프에서 긴밀하게 얽혀 있었다는 뜻이다.
seed entity는 질의와 가장 비슷한 base 층 entity들이다. LeanRAG의 탐색은 항상 여기서 시작한다.
lowest common ancestor는 hierarchy에서 여러 seed의 공통 조상 가운데 depth가 가장 작은 노드다. 이 노드를 목적지로 삼으면 seed들에서 목적지까지의 경로 길이 합이 최소가 된다.
방법
전체 구조
논문은 전체 파이프라인을 세 부분으로 그린다. 문서에서 삼중항을 뽑아 평면 KG를 만드는 구축 단계, 그 위에 층을 쌓는 aggregation 단계, 질의를 받아 서브그래프를 만들고 답을 생성하는 추론 단계다.
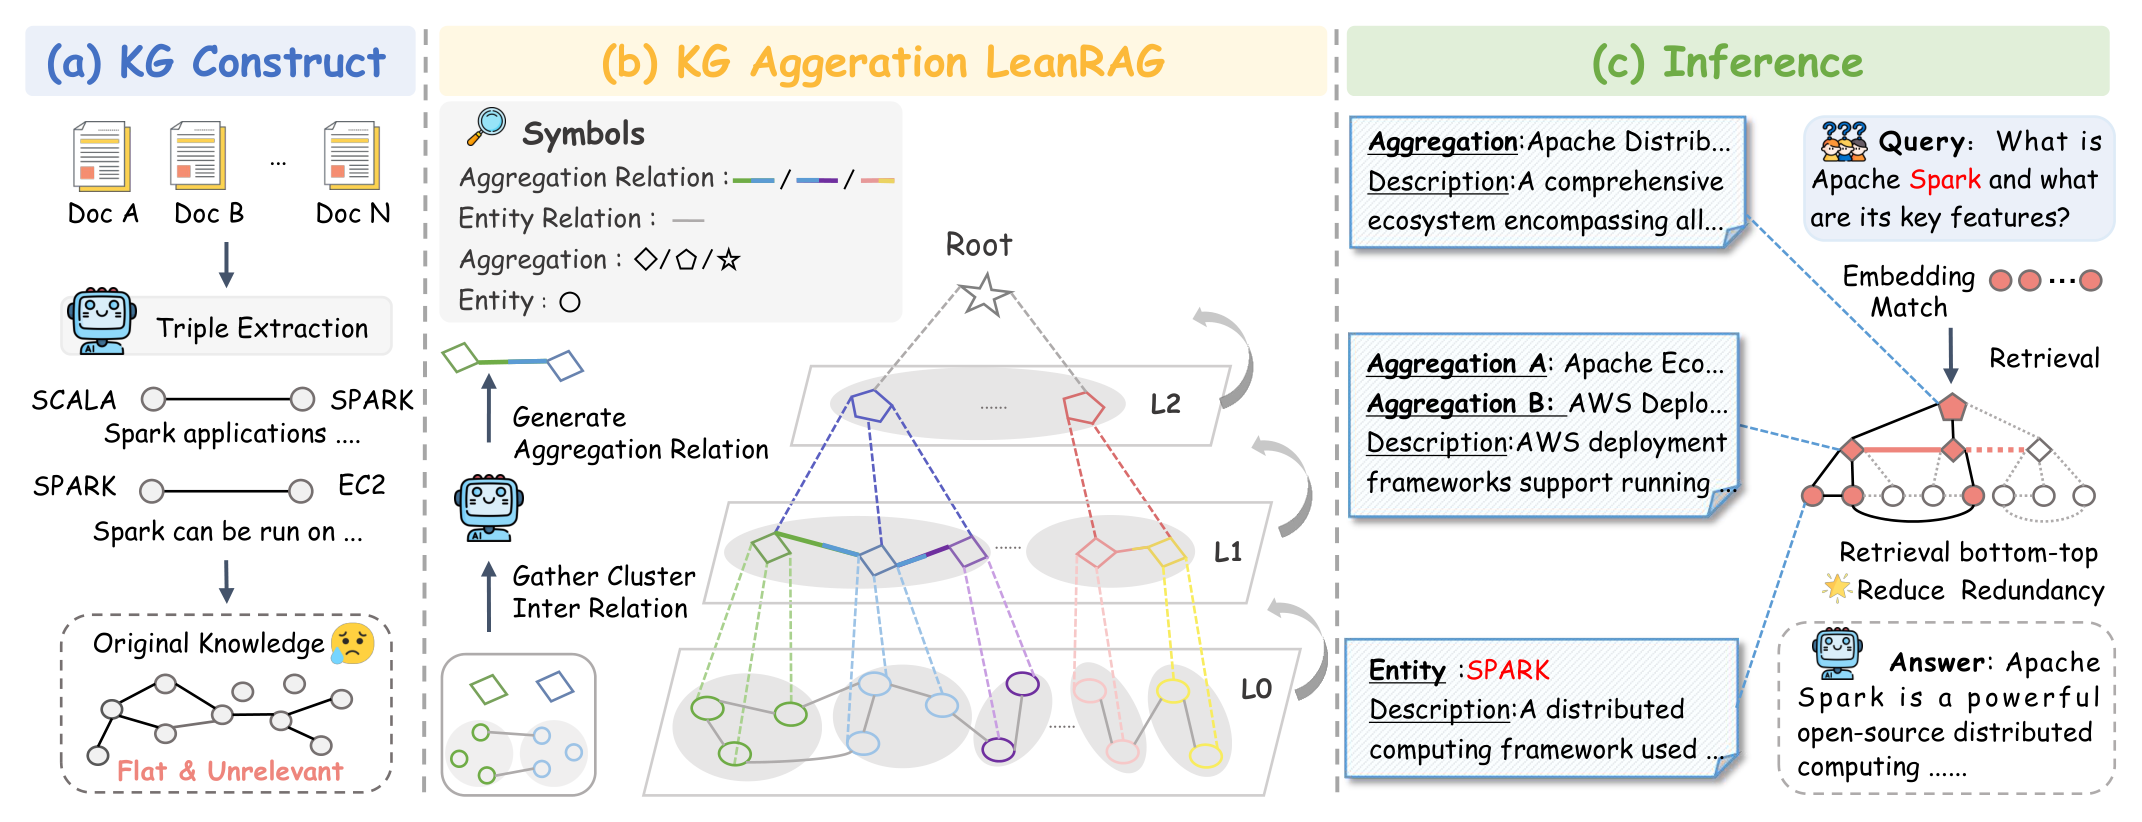
그림이 쓰는 예시는 Apache Spark다. 문서에서 뽑힌 삼중항은 SCALA와 SPARK를 잇는 "Spark applications"와 SPARK와 EC2를 잇는 "Spark can be run on" 같은 형태다. 이렇게 만들어진 L0 층은 평면적이고 서로 무관해 보이는 상태다.
층이 올라가면 SPARK entity는 "Apache Distributed"로 시작하는 aggregated entity에 묶이고, 그 위에서 다시 "Apache Eco"로 시작하는 Aggregation A와 "AWS Deplo"로 시작하는 Aggregation B가 서로 relation으로 이어진다. 질의 "What is Apache Spark and what are its key features?"가 들어오면 base 층의 SPARK entity에 붙은 뒤 위쪽 두 aggregation까지 경로를 따라 올라간다.
Apache Spark 예시로 따라가는 전체 흐름
같은 예시를 단계별로 따라가면 인덱싱과 retrieval이 어떻게 맞물리는지 드러난다.
인덱싱 단계에서는 문서 A부터 N까지를 읽어 삼중항을 뽑는다. 그림에 보이는 두 삼중항은 SCALA와 SPARK를 잇는 "Spark applications"와 SPARK와 EC2를 잇는 "Spark can be run on"이다. 이렇게 얻은 원본 지식의 상태를 그림은 평면적이고 서로 무관하다고 표시한다.
L0에서 L1로 올라가는 단계에서는 색으로 구분된 여러 클러스터가 생기고 각 클러스터가 상위 노드 하나로 묶인다. SPARK를 포함한 클러스터는 "Apache Distributed"로 시작하는 상위 entity가 되며 그 설명문은 "포괄적인 생태계"라는 표현으로 시작한다. 같은 단계에서 클러스터 사이를 잇던 relation들이 모여 상위 노드 사이의 aggregation relation이 된다.
L1에서 L2로 다시 올라가면 Aggregation A와 Aggregation B가 나타난다. 두 노드는 같은 층에 있으면서 서로 relation으로 이어져 있고 그 위에 Root가 놓인다. 가로 방향 연결이 없다면 Apache 생태계와 AWS 배포라는 두 주제는 Root를 거쳐야만 만나게 된다.
추론 단계에서 질의가 들어오면 임베딩 매칭으로 base 층의 SPARK를 비롯한 seed entity들이 선택된다. 이어서 아래에서 위로 올라가는 경로가 그려지고, 그림은 이 방향을 "Retrieval bottom-top"으로, 그 효과를 "Reduce Redundancy"로 표시한다. 최종 답변은 "Apache Spark is a powerful open-source distributed computing"으로 시작하는 문장으로 제시된다.
그래프를 쌓는 세 단계
평면 KG 에서 시작해 를 아래에서 위로 만든다. 각 층은 아래 층을 더 추상화한 view다. 한 층을 올리는 절차는 세 단계로 나뉜다.
| 단계 | 입력 | 처리 | 출력 |
|---|---|---|---|
| 재귀 semantic clustering | 아래 층 entity 설명문 | 임베딩 후 Gaussian Mixture Model로 분할 | 겹치지 않는 개 클러스터 |
| aggregated entity 생성 | 클러스터와 그 내부 relation | 전용 프롬프트로 유도한 LLM | 상위 entity 이름과 설명문, 부모 자식 링크 |
| aggregated relation 생성 | 두 클러스터를 잇던 base relation 집합 | connectivity strength 판정 후 LLM 요약 또는 텍스트 연결 | 같은 층 상위 entity 사이 relation |
1단계 재귀 semantic clustering
각 entity의 설명문 를 pre-training된 임베딩 모델 로 인코딩해 층 전체의 임베딩 집합을 얻는다.
여기에 Gaussian Mixture Model을 적용해 entity들을 서로 겹치지 않는 개 클러스터로 나눈다. 이 두 단계 절차는 RAPTOR의 텍스트 표현 클러스터링을 따른 것이라고 논문이 명시한다.
클러스터 개수 을 어떻게 정하는지에 대해 본문이 밝히는 것은 한 문장뿐이다. GMM의 클러스터 개수와 나머지 주요 hyperparameter를 held-out validation set에서 튜닝했다고만 적는다. 이 저장소의 세미나 자료는 Bayesian Information Criterion으로 자동 결정한다고 설명하지만, 논문 본문에는 그 기준이 나오지 않는다.
2단계 aggregated entity 생성
각 클러스터 에 대해 그 클러스터의 집합적 의미를 대표하는 상위 entity 와 설명문 를 만든다.
생성 함수 가 보는 입력은 두 가지다. 클러스터 안의 entity 목록과, 그 entity들 사이에 원래 있던 relation 집합 다. 노드만 보고 요약하는 것이 아니라 노드 사이의 연결까지 보고 요약한다는 점이 중요하다.
새로 만들어진 entity 집합 가 다음 층을 이루고, 각 자식 는 부모 로 연결된다. 실제 구현에서 는 전용 프롬프트 로 유도한 LLM이며, 프롬프트는 간결한 이름과 구성 요소를 요약한 설명문을 함께 내도록 지시한다.
3단계 aggregated relation 생성
상위 층에서 semantic island가 생기지 않도록 상위 entity 사이에 새 relation을 명시적으로 만든다. 이 절차가 논문의 첫 번째 기여다.
두 상위 entity 에 대해, 원래 그래프에서 클러스터 와 에 각각 속한 노드들을 잇던 relation 집합 를 모은다. 그 개수를 connectivity strength 로 정의하고, 임계값 와 비교해 두 경로 중 하나를 고른다.
| 조건 | 판단 | 처리 | 비용 |
|---|---|---|---|
| 의미 있는 상위 관계가 존재한다 | LLM 함수 이 새 relation으로 요약 | LLM 호출 발생 | |
| 뒷받침이 약하다 | 원래 relation들을 텍스트로 이어 붙이기만 한다 | LLM 호출 없음 |
는 data-dependent hyper-parameter다. 추상화 수준마다 그래프 밀도가 다르므로 layer index에 따라 값이 달라질 수 있고, 뒷받침이 충분한 relation만 위층으로 전파되게 하는 역할을 한다. 다만 실제 사용값이나 결정 절차는 본문에 없다.
이 세 단계를 재귀적으로 반복하면 각 층이 아래 층보다 추상적이면서도 의미상 일관된 다층 KG가 만들어진다.
그래프를 뒤지는 세 단계
1단계 base 층 anchoring
질의 를 가장 구체적인 사실에 붙이기 위해, 원래 그래프인 base 층 의 entity만 대상으로 밀집 탐색을 수행한다.
상위 요약 노드를 anchoring 대상에서 뺀 것이 설계상의 선택이다. 논문의 문제 제기에 따르면 기존 방법의 초기 탐색은 평면화된 노드 목록 위에서 이루어지는데, LeanRAG는 그 목록을 base 층으로 한정해 출발점을 지식 베이스의 가장 관련 깊은 부분에 고정한다.
2단계 LCA 경로 순회
기존 KG 기반 RAG는 평면 그래프에서 seed 노드 쌍 사이의 모든 경로를 찾는다. 이 방식은 잡음과 중복을 늘리는 중간 노드를 대량으로 가져온다.
LeanRAG는 대신 hierarchy 전체를 써서 seed들을 가장 가까운 공유 개념으로 잇는 최소 서브그래프를 만든다. 두 seed의 lowest common ancestor 는 공통 조상 가운데 depth가 가장 작은 노드이고, 이렇게 잡으면 두 seed에서 까지의 경로 길이 합이 최소가 되어 정보 중복을 피할 수 있다.
hierarchy가 tree 형태이므로 이 shortest path는 자식에서 부모로 이어지는 직선 chain이다. 별도의 경로 탐색 알고리즘 없이 부모 링크만 따라 올라가면 된다.
최종 서브그래프는 다음과 같이 정의된다.
| 구성 요소 | 내용 | 어디서 오는가 |
|---|---|---|
| LCA 경로 위의 모든 entity | seed에서 까지의 부모 chain | |
| LCA 경로 위의 relation | 부모 자식 링크와 그 설명문 | |
| 같은 층 상위 entity 사이의 relation | 3단계에서 만든 aggregated relation |
가 결과에 항상 포함되는 것이 핵심이다. 세로 방향의 부모 자식 경로만으로는 서로 다른 개념 무리를 잇지 못하는데, 가로 방향의 aggregated relation이 그 연결을 공급한다.
3단계 원문 chunk 첨부
마지막으로 base entity가 추출된 원문 chunk를 supporting evidence로 함께 돌려준다. 논문은 이 절차의 효과를 다음과 같이 서술한다. retrieval 결과가 관련 entity의 나열에 그치지 않고 구체적 사실에서 공유 추상 개념으로 이어지는 연결된 서술 구조가 되며, 그 덕분에 정보 중복이 줄고 생성기가 받는 context가 더 구조화된다.
이 단계의 필요성은 뒤의 RQ4 ablation이 직접 검증한다.
LCA 경로가 중복을 줄이는 이유
두 방식의 차이는 경로를 어디서 찾느냐에 있다. 기존 방식은 평면 그래프 안에서 seed 쌍마다 경로를 찾는다. seed가 개면 쌍은 개이고, 각 경로가 지나는 중간 노드가 모두 결과에 들어온다. 이 중간 노드들은 질의와 직접 관련이 없어도 연결을 잇기 위해 포함되므로 잡음이 된다.
LCA 방식은 경로를 hierarchy 안에서 찾는다. 목적지가 하나로 고정되므로 경로 개수가 seed 개수와 같아지고, tree 구조라서 각 경로는 부모 링크를 따라 올라가는 chain 하나가 된다.
| 항목 | 평면 그래프 전체 경로 탐색 | LCA 경로 탐색 |
|---|---|---|
| 탐색 공간 | base 층 그래프 | hierarchy |
| 경로 개수 | seed 쌍의 수만큼 | seed 개수만큼 |
| 목적지 | 상대 seed 노드 | 공통 조상 하나 |
| 경로 형태 | 임의 길이의 그래프 경로 | 부모 링크를 따라 올라가는 chain |
| 부수 결과 | 관련 없는 중간 노드 다수 유입 | 경로 위 노드와 같은 층 relation만 |
논문이 LCA를 depth가 가장 작은 공통 조상으로 정의한 이유도 여기에 있다. 그렇게 잡아야 두 seed에서 목적지까지의 경로 길이 합이 최소가 되고, 그만큼 결과에 들어오는 노드가 줄어든다.
여기에 가로 방향 연결이 더해진다. 세로 경로만 모으면 서로 다른 클러스터에 속한 seed들이 공통 조상에서야 만나는데, 같은 층의 aggregated relation을 함께 넣으면 그보다 아래 층에서도 두 무리가 이어진다. 논문이 결과를 관련 entity의 나열이 아니라 연결된 서술 구조라고 부르는 근거가 이 두 방향의 조합이다.
기존 방법과의 대비
논문의 Figure 1은 네 가지 구성을 한 화면에 놓고 비교한다.
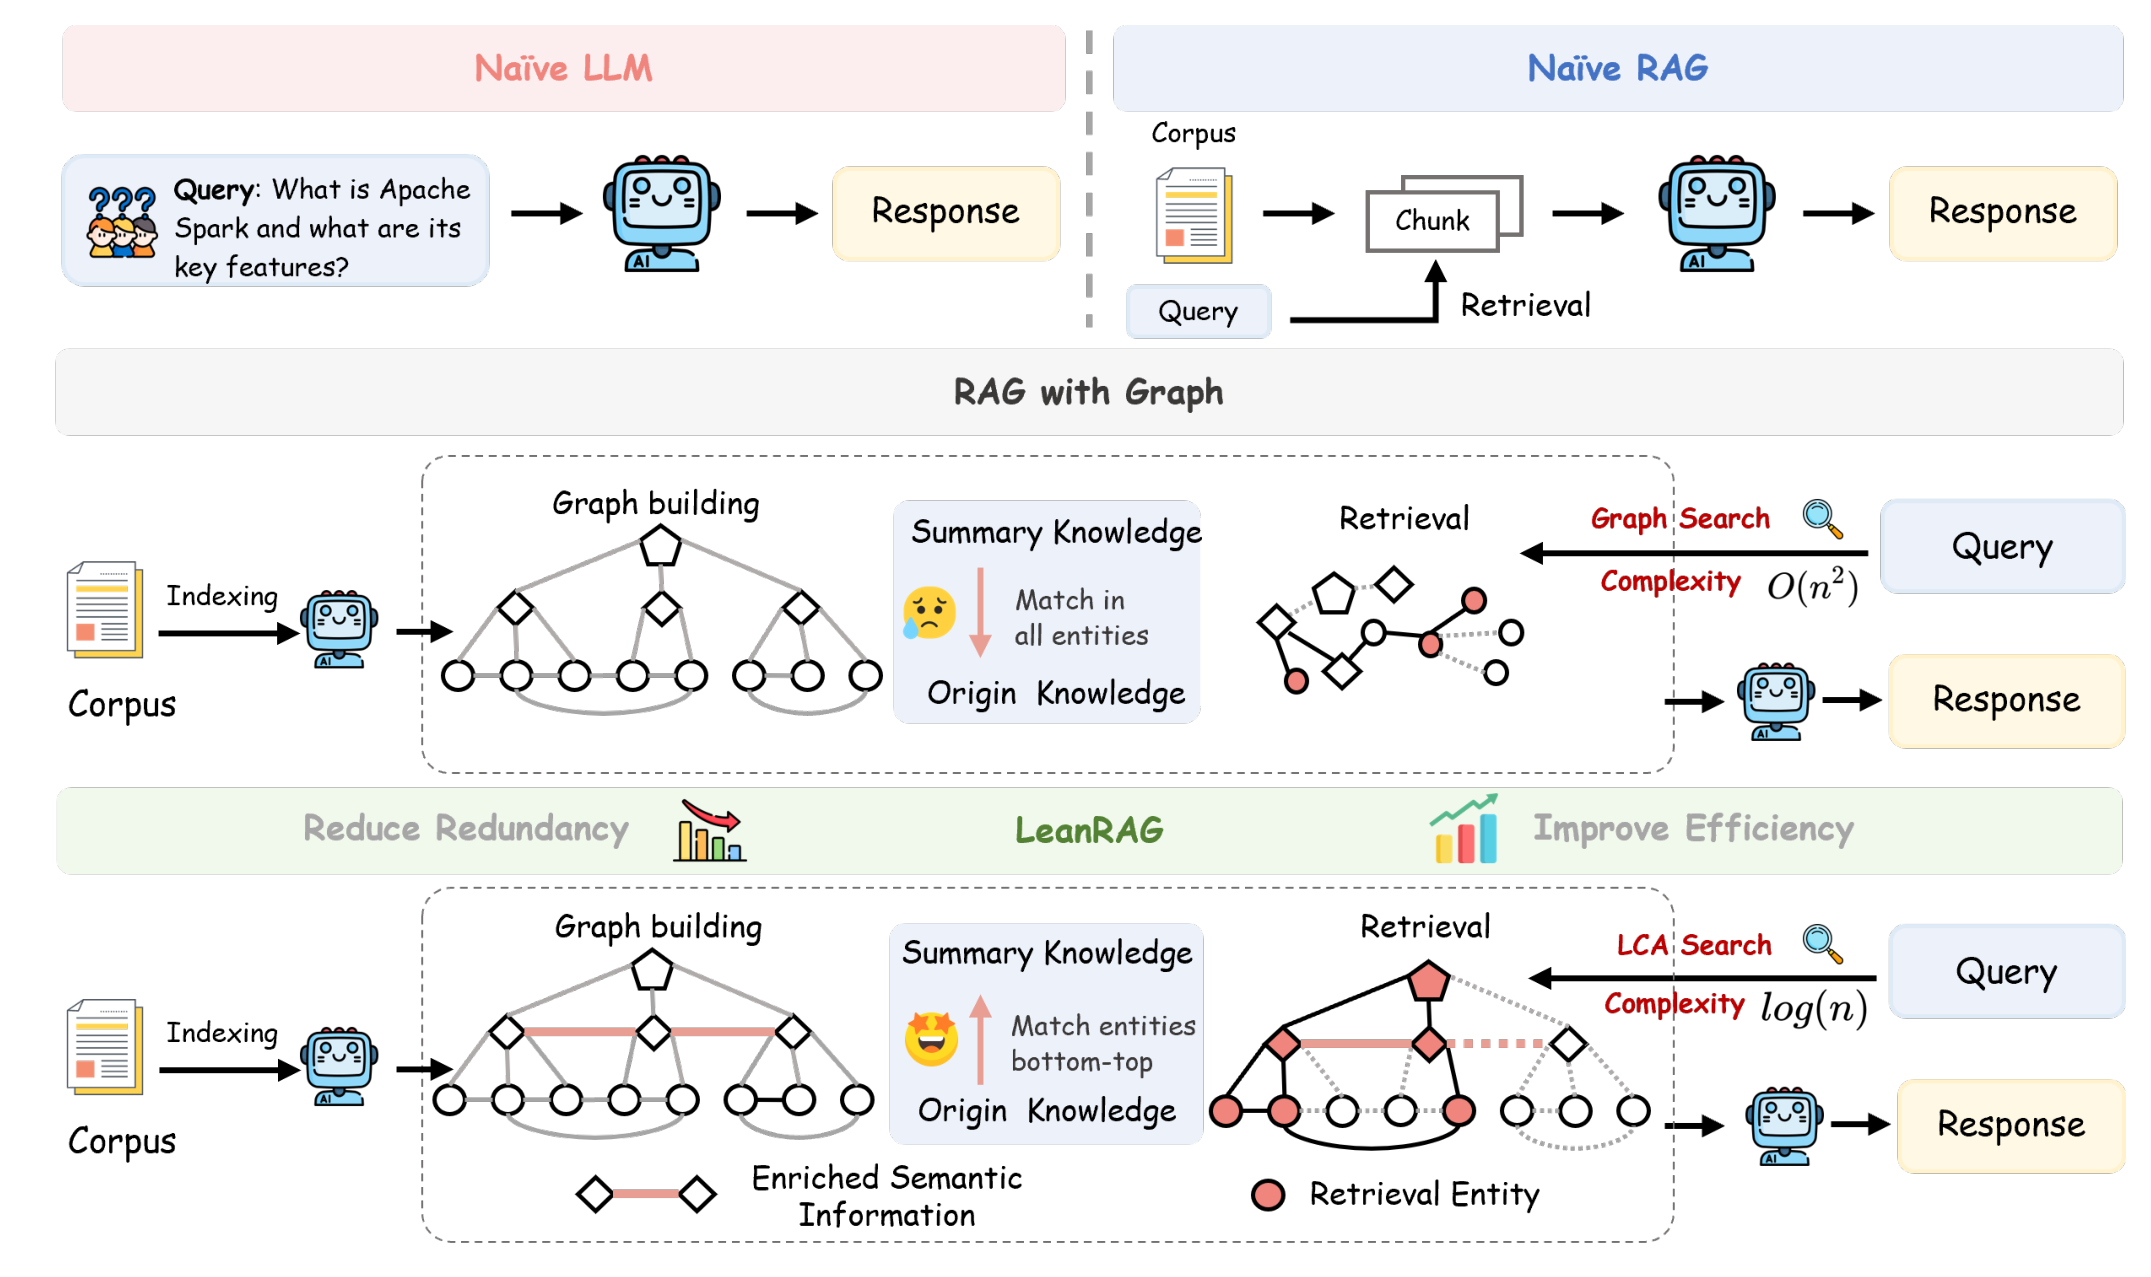
| 구성 | 인덱스 | 탐색 방식 | 그림의 복잡도 표기 | 요약 지식 활용 |
|---|---|---|---|---|
| Naive LLM | 없음 | 없음 | 표기 없음 | 없음 |
| Naive RAG | 텍스트 chunk | 질의와 chunk 유사도 | 표기 없음 | 없음 |
| 그래프 기반 RAG | 계층 그래프 | Graph Search | 모든 entity에서 매칭 | |
| LeanRAG | 상위 relation이 추가된 계층 그래프 | LCA Search | 아래에서 위로 entity 매칭 |
이 복잡도 표기는 도식 안 주석일 뿐 본문 어디에도 유도나 측정이 없다. 효율 개선 주장의 실제 근거는 뒤의 retrieval 토큰 수 비교 하나다.
그림의 LeanRAG 쪽에는 "Enriched Semantic Information"이라는 이름으로 상위 노드 사이를 잇는 굵은 선이 따로 표시된다. 같은 층을 가로지르는 이 선이 aggregated relation이고, 위쪽 그래프 기반 RAG 도해에는 그 선이 없다.
실험 설정
데이터셋과 baseline
| 항목 | 내용 |
|---|---|
| 벤치마크 | UltraDomain (Qian et al. 2024의 MemoRAG 논문 제시) |
| 사용 데이터셋 | Mix, CS, Legal, Agriculture 네 종 |
| 선택 근거 | 선행 연구 LightRAG(Guo et al. 2024)와 같은 구성을 따랐다 |
| 벤치마크 성격 | 긴 context 과제와 전문 도메인의 상위 수준 질의 |
비교 대상은 여섯 종이다.
| Baseline | 방식 | 논문의 설명 |
|---|---|---|
| NaiveRAG (Lewis et al. 2020) | 평면 chunk RAG | 코퍼스에서 의미가 비슷한 텍스트 chunk를 가져오는 기초 방식 |
| GraphRAG (Edge et al. 2024) | community 기반 KG | local search mode를 사용. global mode는 계산 비용이 크고 지역 맥락 근거가 부족하다는 이유 |
| LightRAG (Guo et al. 2024) | dual-level retrieval | KG 기반 텍스트 인덱싱 위의 이원 검색 |
| KAG (Liang et al. 2025) | 지식과 텍스트 상호 인덱싱 | logic-form 유도로 LLM 생성과 KG 추론을 정렬 |
| FastGraphRAG | PageRank 중심성 | 중요도가 높은 노드를 우선. 저자 연도 인용 없이 PageRank 인용만 붙는다 |
| HiRAG (Huang et al. 2025a) | 계층 요약 | 논문이 당시 state-of-the-art로 인정하는 대상 |
평가 지표와 채점 절차
| 지표 | 무엇을 재는가 |
|---|---|
| Comprehensiveness | 답변이 질의를 얼마나 빠짐없이 다루는가 |
| Empowerment | 실무적 유용성과 행동 가능한 정보를 주는 능력 |
| Diversity | 제시된 정보와 관점의 폭 |
| Overall | 앞의 세 가지와 기타 요인을 함께 고려한 총괄 품질 |
지표 정의는 HiRAG의 것을 따랐다. 채점은 DeepSeek-V3를 LLM-as-a-Judge로 써서 1에서 10 척도로 매기며, 각 질의와 답변 쌍을 5회 채점한다. 여기에 더해 두 답변을 직접 놓고 어느 쪽이 나은지 고르게 하는 win rate 방식도 함께 쓴다.
두 방식은 결과를 읽는 법이 다르다. 점수 방식은 여러 방법을 한 표에 늘어놓고 절대 수준을 비교할 수 있지만, 상위권이 8점대에 몰리면 차이가 소수점 둘째 자리로 줄어 판별력이 떨어진다. win rate 방식은 두 답변을 직접 견주므로 작은 차이도 승패로 드러나지만 두 방법씩만 비교할 수 있다.
| 실험 | 채점 방식 | 비교 대상 |
|---|---|---|
| RQ1 전체 성능 | 1에서 10 척도 점수, 5회 평균 | LeanRAG와 baseline 6종 |
| RQ3 상위 relation | win rate | LeanRAG와 relation 제거 변형 |
| RQ4 원문 context | 1에서 10 척도 점수 | LeanRAG와 원문 제거 변형 |
모델 구성
| 역할 | 모델 | 비고 |
|---|---|---|
| 생성기 | DeepSeek-V3 | 모든 방법에 같은 모델을 써서 비교 조건을 맞췄다 |
| 판정자 | DeepSeek-V3 | 생성기와 같은 모델이다 |
| 임베딩 | BGE-M3 (Chen et al. 2024) | retrieval용 텍스트 임베딩 |
| RQ2 재구현 | Qwen3-14B (Yang et al. 2025) | 중복 측정을 효율적으로 하기 위해 baseline을 이 모델로 다시 구현했다 |
주요 실험은 상용 API 서비스로 수행했고, GMM 클러스터 개수를 포함한 주요 hyperparameter는 held-out validation set에서 튜닝했다.
결과
전체 성능
1에서 10 척도 점수이고 값은 평균과 표준편차다. 굵은 표기는 그 칸의 최고값이다.
| 데이터셋 | 지표 | LeanRAG | HiRAG | Naive | GraphRAG | LightRAG | FastGraphRAG | KAG |
|---|---|---|---|---|---|---|---|---|
| Mix | Comprehensiveness | 8.89±0.01 | 8.72±0.02 | 8.20±0.01 | 8.52±0.01 | 8.19±0.02 | 6.56±0.02 | 7.90±0.03 |
| Mix | Empowerment | 8.16±0.02 | 7.86±0.03 | 7.52±0.03 | 7.73±0.02 | 7.56±0.03 | 5.82±0.03 | 7.41±0.04 |
| Mix | Diversity | 7.73±0.01 | 7.21±0.02 | 6.65±0.03 | 7.04±0.02 | 6.69±0.04 | 4.88±0.03 | 6.42±0.04 |
| Mix | Overall | 8.59±0.01 | 8.08±0.02 | 7.47±0.02 | 7.87±0.01 | 7.61±0.04 | 5.76±0.02 | 7.25±0.03 |
| CS | Comprehensiveness | 8.92±0.01 | 8.92±0.01 | 8.94±0.01 | 8.55±0.02 | 8.76±0.02 | 6.79±0.01 | 8.22±0.02 |
| CS | Empowerment | 8.68±0.02 | 8.66±0.02 | 8.69±0.04 | 8.28±0.04 | 8.50±0.04 | 6.67±0.04 | 8.52±0.05 |
| CS | Diversity | 7.87±0.02 | 7.84±0.02 | 7.79±0.02 | 7.42±0.02 | 7.63±0.04 | 5.45±0.04 | 7.03±0.02 |
| CS | Overall | 8.82±0.02 | 8.77±0.02 | 8.77±0.03 | 8.37±0.04 | 8.59±0.04 | 6.31±0.03 | 7.99±0.03 |
| Legal | Comprehensiveness | 8.88±0.02 | 8.68±0.02 | 8.85±0.01 | 8.95±0.01 | 8.24±0.02 | 3.87±0.02 | 8.41±0.02 |
| Legal | Empowerment | 8.42±0.03 | 8.18±0.06 | 8.28±0.03 | 8.33±0.02 | 7.83±0.05 | 3.53±0.03 | 8.20±0.03 |
| Legal | Diversity | 7.49±0.03 | 7.00±0.03 | 7.10±0.04 | 7.47±0.03 | 6.87±0.01 | 2.87±0.02 | 6.71±0.01 |
| Legal | Overall | 8.49±0.04 | 8.00±0.04 | 8.21±0.03 | 8.44±0.01 | 7.74±0.03 | 3.43±0.02 | 7.83±0.03 |
| Agriculture | Comprehensiveness | 8.94±0.06 | 8.99±0.00 | 8.85±0.01 | 8.97±0.01 | 8.71±0.01 | 3.28±0.01 | 8.22±0.01 |
| Agriculture | Empowerment | 8.66±0.02 | 8.52±0.02 | 8.51±0.03 | 8.52±0.02 | 8.23±0.02 | 3.29±0.05 | 8.33±0.06 |
| Agriculture | Diversity | 8.06±0.03 | 7.98±0.02 | 7.76±0.06 | 7.95±0.02 | 7.68±0.03 | 3.01±0.03 | 7.07±0.02 |
| Agriculture | Overall | 8.87±0.02 | 8.87±0.03 | 8.69±0.03 | 8.85±0.01 | 8.56±0.02 | 3.17±0.02 | 7.95±0.03 |
Diversity에서 LeanRAG는 네 데이터셋 모두 1위다. 다만 격차는 데이터셋에 따라 크게 다르다. Overall과 Diversity 두 지표에서 LeanRAG와 두 번째로 높은 방법의 차이를 데이터셋별로 뽑으면 다음과 같다.
| 데이터셋 | Overall 격차 | 두 번째 방법 | Diversity 격차 | 두 번째 방법 |
|---|---|---|---|---|
| Mix | 0.51점 | HiRAG 8.08 | 0.52점 | HiRAG 7.21 |
| CS | 0.05점 | HiRAG 8.77과 Naive 8.77 | 0.03점 | HiRAG 7.84 |
| Legal | 0.05점 | GraphRAG 8.44 | 0.02점 | GraphRAG 7.47 |
| Agriculture | 0.00점 | HiRAG 8.87 | 0.08점 | HiRAG 7.98 |
LeanRAG의 우위는 사실상 Mix 한 데이터셋에 몰려 있다. 나머지 세 데이터셋에서는 두 번째 방법과의 차이가 0.1점 미만이고 표준편차와 같은 자릿수다.
Mix는 여러 도메인이 섞인 데이터셋이라는 점에서 나머지 셋과 성격이 다르다. 모든 방법의 절대 점수도 Mix에서 가장 낮게 나오는데, 예를 들어 LightRAG의 Overall이 Mix에서 7.61점인 반면 CS에서는 8.59점, Agriculture에서는 8.56점이다. 서로 다른 주제가 뒤섞여 개념 무리를 넘나드는 추론이 필요한 조건에서 LeanRAG의 격차가 커진다는 읽기가 가능하고, 이는 semantic island 문제 설정과 방향이 맞는다. 다만 논문은 이 데이터셋별 차이를 따로 논의하지 않는다.
FastGraphRAG는 네 데이터셋 모두에서 크게 낮다. Legal과 Agriculture의 Overall이 각각 3.43점과 3.17점으로 같은 칸의 LeanRAG보다 5점 이상 낮다. 다른 baseline들이 7점대 후반에서 8점대 후반에 몰려 있는 것과 대비된다.
LeanRAG가 1위가 아닌 칸
논문 본문은 "거의 모든 baseline을 앞선다"와 "대다수 지표에서 state-of-the-art이고 나머지에서도 높은 경쟁력"이라는 표현을 쓴다. 16개 칸 가운데 LeanRAG가 최고값이 아닌 칸은 네 곳이고, 격차는 모두 0.1점 미만이다.
| 데이터셋 | 지표 | LeanRAG | 1위 방법과 값 | 차이 |
|---|---|---|---|---|
| CS | Comprehensiveness | 8.92 | Naive 8.94 | 0.02점 낮음 |
| CS | Empowerment | 8.68 | Naive 8.69 | 0.01점 낮음 |
| Legal | Comprehensiveness | 8.88 | GraphRAG 8.95 | 0.07점 낮음 |
| Agriculture | Comprehensiveness | 8.94 | HiRAG 8.99 | 0.05점 낮음 |
예외 네 칸 중 세 칸이 Comprehensiveness라는 점이 눈에 띈다. 나머지 하나도 CS의 Empowerment로, 두 칸 모두 그래프 없이 chunk만 쓰는 NaiveRAG가 1위다. 즉 답변의 충실성만 놓고 보면 평면 chunk 방식이 여전히 경쟁력을 유지하고, LeanRAG의 우위는 정보의 폭과 총괄 품질 쪽에 몰려 있다.
Agriculture의 Overall은 LeanRAG와 HiRAG가 소수점 두 자리까지 8.87점으로 같고 표준편차만 0.02와 0.03으로 다르다. 논문 표는 이 칸에서 LeanRAG를 굵게 표기한다.
논문 자신의 해석은 두 가지다. 첫째, 기존 KG 기반 RAG의 정보 밀집형 community 구조를 걷어냈는데도 aggregation이 질의 관련 정보를 충분히 공급한다는 점을 Comprehensiveness가 보여준다. 둘째, Empowerment와 Diversity는 제공 정보의 관련성을 재는 지표인데, 클러스터 사이 relation을 세운 덕분에 정보의 폭이 늘어 이 두 지표에서 최적 성능이 나왔다.
retrieval 중복
중복 지표로는 retrieval된 context의 토큰 개수를 쓴다. 성능이 비슷한 수준일 때 토큰 수가 적으면 덜 중복된 context라는 전제다. 이 실험만 모든 baseline을 Qwen3-14B로 다시 구현해 측정했다.
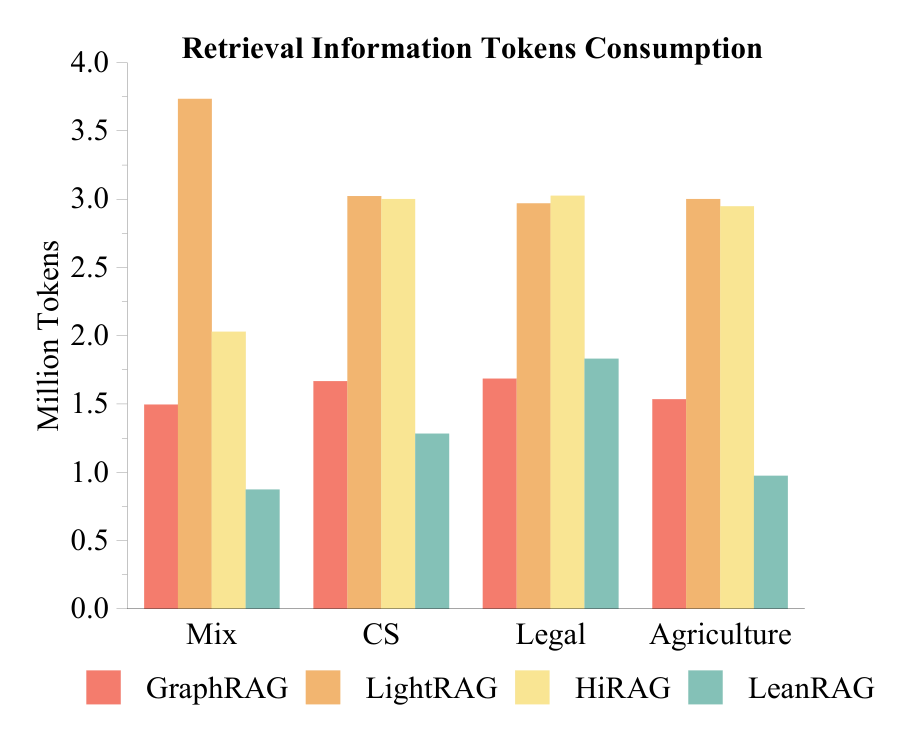
논문 본문에 수치 표는 없다. 아래 값은 그림의 눈금에서 읽은 근사값이다.
| 데이터셋 | GraphRAG | LightRAG | HiRAG | LeanRAG |
|---|---|---|---|---|
| Mix | 약 1.5백만 | 약 3.7백만 | 약 2.0백만 | 약 0.9백만 |
| CS | 약 1.7백만 | 약 3.0백만 | 약 3.0백만 | 약 1.3백만 |
| Legal | 약 1.7백만 | 약 3.0백만 | 약 3.0백만 | 약 1.8백만 |
| Agriculture | 약 1.5백만 | 약 3.0백만 | 약 2.9백만 | 약 1.0백만 |
본문 주장은 두 문장이다. LeanRAG가 모든 baseline보다 뚜렷하게 압축된 context를 가져오며, 평균적으로 baseline 대비 46% 작다. 원인은 LCA 기반 순회가 hierarchy를 따라 좁은 서브그래프를 만드는 데 있고, 더 큰 community를 통째로 가져오는 방법들과 대비된다는 설명이다.
위 근사값으로 데이터셋별 감소율을 계산하면 46%라는 단일 수치 뒤에 상당한 편차가 있다는 점이 드러난다. 세 baseline의 평균 대비 LeanRAG의 감소율은 다음과 같다.
| 데이터셋 | baseline 세 종의 평균 | LeanRAG | 감소율 |
|---|---|---|---|
| Mix | 약 2.4백만 | 약 0.9백만 | 약 63% |
| CS | 약 2.6백만 | 약 1.3백만 | 약 49% |
| Legal | 약 2.6백만 | 약 1.8백만 | 약 30% |
| Agriculture | 약 2.5백만 | 약 1.0백만 | 약 60% |
네 값의 평균은 약 50%로 논문이 제시한 46%와 가깝지만, 데이터셋 사이의 폭은 30%에서 63%까지 벌어진다. 다만 이 계산은 그림 눈금에서 읽은 값을 근거로 하므로 자릿수 수준의 참고로만 쓸 수 있고, 논문이 평균을 어떤 방식으로 냈는지도 밝혀져 있지 않다.
그림은 본문이 언급하지 않는 두 가지를 더 보여준다. 첫째, LightRAG가 네 데이터셋 모두에서 GraphRAG보다 토큰을 많이 쓴다. entity와 relation 텍스트에 원문 chunk까지 붙이는 구조 때문으로 볼 수 있다. 둘째, Legal에서는 GraphRAG 막대가 LeanRAG보다 낮다. 이 한 칸에서 본문의 "모든 baseline보다 압축된다"는 서술이 그림과 어긋난다.
상위 relation의 기여
LeanRAG와 상위 entity 사이 relation 정보를 뺀 변형을 두고 두 답변을 직접 비교했다. 왼쪽이 LeanRAG, 오른쪽이 변형의 승률이다.
| 지표 | Mix | CS | Legal | Agriculture |
|---|---|---|---|---|
| Comprehensiveness | 51.5% 대 48.6% | 54.5% 대 45.5% | 55.5% 대 44.5% | 54.0% 대 46.0% |
| Empowerment | 55.0% 대 45.0% | 55.5% 대 44.5% | 56.5% 대 43.5% | 59.5% 대 40.5% |
| Diversity | 59.6% 대 40.4% | 66.0% 대 34.0% | 57.0% 대 43.0% | 63.0% 대 37.0% |
| Overall | 53.8% 대 46.2% | 58.5% 대 41.5% | 56.5% 대 43.5% | 58.0% 대 42.0% |
16개 비교 모두 LeanRAG가 우세하다. 지표별로 보면 우세폭이 가장 큰 것은 Diversity이고, 그중에서도 CS가 66.0% 대 34.0%로 격차가 가장 크다. 가장 작은 격차는 Mix의 Comprehensiveness로 51.5% 대 48.6%다.
| 지표 | 네 데이터셋 승률 범위 | 해석 |
|---|---|---|
| Comprehensiveness | 51.5%에서 55.5% | 상위 relation을 빼도 충실성은 크게 흔들리지 않는다 |
| Empowerment | 55.0%에서 59.5% | 중간 정도 기여 |
| Diversity | 57.0%에서 66.0% | 기여가 가장 크다 |
| Overall | 53.8%에서 58.5% | Diversity의 개선이 총괄 점수를 끌어올린다 |
논문 해석은 이렇다. relation 경로를 제거하면 retrieval의 다양성, 곧 정보의 폭이 뚜렷하게 줄어든다. 클러스터 사이에 관계를 세우는 것이 고립된 entity들을 실제로 이어 주어 retrieval이 쓸 수 있는 정보를 넓힌다는 뜻이다. 이 관계를 명시적으로 반환하는 것 자체도 retrieval을 강화해 답변 품질을 끌어올린다.
이 결과는 semantic island 문제 설정과 직접 맞물린다. 상위 노드를 잇는 relation이 없으면 서로 다른 개념 무리의 정보가 한 답변에 함께 들어오지 못하고, 그 손실이 Diversity 지표에 가장 먼저 나타난다.
원문 context의 필요성
비교 대상 변형은 계층 retrieval 절차를 그대로 두되, 생성기에 주는 context에서 base 수준 entity에 연결된 원문 chunk를 빼고 entity 이름과 설명문만 남긴 것이다.
| 데이터셋 | 지표 | LeanRAG | 원문 제거 | 하락폭 |
|---|---|---|---|---|
| Mix | Comprehensiveness | 8.89±0.01 | 8.15±0.02 | 0.74점 |
| Mix | Empowerment | 8.16±0.02 | 7.80±0.01 | 0.36점 |
| Mix | Diversity | 7.73±0.01 | 7.26±0.02 | 0.47점 |
| Mix | Overall | 8.59±0.01 | 7.93±0.01 | 0.66점 |
| CS | Comprehensiveness | 8.92±0.01 | 8.66±0.02 | 0.26점 |
| CS | Empowerment | 8.68±0.02 | 8.19±0.03 | 0.49점 |
| CS | Diversity | 7.87±0.02 | 7.57±0.02 | 0.30점 |
| CS | Overall | 8.82±0.02 | 8.34±0.02 | 0.48점 |
| Legal | Comprehensiveness | 8.88±0.02 | 8.49±0.01 | 0.39점 |
| Legal | Empowerment | 8.42±0.03 | 8.11±0.04 | 0.31점 |
| Legal | Diversity | 7.49±0.03 | 7.09±0.04 | 0.40점 |
| Legal | Overall | 8.49±0.04 | 8.00±0.04 | 0.49점 |
| Agriculture | Comprehensiveness | 8.94±0.06 | 8.65±0.01 | 0.29점 |
| Agriculture | Empowerment | 8.66±0.02 | 8.16±0.05 | 0.50점 |
| Agriculture | Diversity | 8.06±0.03 | 7.88±0.05 | 0.18점 |
| Agriculture | Overall | 8.87±0.02 | 8.53±0.03 | 0.34점 |
16개 칸이 모두 하락한다. 가장 큰 하락은 Mix의 Comprehensiveness로 0.74점이고, 가장 작은 하락은 Agriculture의 Diversity로 0.18점이다.
데이터셋별로 구성 지표 세 가지 중 하락폭이 가장 큰 항목을 뽑으면 다음과 같다.
| 데이터셋 | 하락폭 최대 지표 | 하락폭 최소 지표 |
|---|---|---|
| Mix | Comprehensiveness 0.74점 | Empowerment 0.36점 |
| CS | Empowerment 0.49점 | Comprehensiveness 0.26점 |
| Legal | Diversity 0.40점 | Empowerment 0.31점 |
| Agriculture | Empowerment 0.50점 | Diversity 0.18점 |
논문의 결론은 원문 chunk가 상세 설명, 근거, 미묘한 표현을 담고 있어 충실하고 실행 가능한 답을 만드는 데 필요하다는 것이다. 구조화된 entity 정보만으로 구성한 context는 의미상 초점은 맞지만 LLM이 필요로 하는 서술의 풍부함이 없다.
여기서 저자들은 계층 그래프의 역할을 다시 규정한다. 그래프는 답을 만드는 재료가 아니라 비구조 텍스트의 결정적 구간을 정확히 짚어 주는 semantic index이자 navigation system이다. 구조 탐색이 길을 안내하고 비구조 텍스트가 내용을 채우는 협업이 state-of-the-art의 조건이라는 것이 최종 주장이다.
이 결과는 앞선 RQ2와 함께 읽어야 뜻이 분명해진다. RQ2는 가져오는 토큰을 46% 줄였다고 말하고, RQ4는 그 줄인 context에서 원문 chunk를 더 빼면 품질이 떨어진다고 말한다. 두 결과를 합치면 LeanRAG가 줄인 대상은 원문이 아니라 그래프 순회가 만들어 내던 중간 노드와 중복 relation이라는 해석이 된다.
논문의 결론
결론 절은 네 문장으로 요약된다. semantic island와 structure-retrieval mismatch를 지식 aggregation과 retrieval의 긴밀한 공동 설계로 푼다는 것, 계층 aggregation 알고리즘이 추상 요약 개념 사이에 explicit relation을 만들어 이동 가능한 semantic network를 구성한다는 것, 이를 보완하는 bottom-up LCA retrieval이 그 구조를 효율적으로 순회한다는 것, 그리고 실험이 중복을 크게 줄이면서 state-of-the-art 성능을 낸다는 것이다.
ablation에 대한 결론은 한 문장으로 정리된다. 요약 생성과 원문 context 양쪽이 모두 있어야 충실하고 다양한 답변이 나온다는 것이다.
한계
논문이 다루지 않은 범위
논문에는 별도의 Limitations 절이 없다. 아래는 본문에서 확인되는 공백을 정리한 것이다.
| 항목 | 본문 상태 | 왜 문제인가 |
|---|---|---|
| LCA 깊이 분석 | 정성 case study 없음 | LCA가 자주 root에 닿는다면 최소 서브그래프라는 성질이 약해지는데 확인할 근거가 없다 |
| 효율과 지연 시간 | 직접 측정 없음 | 효율 주장의 근거가 retrieval 토큰 개수 하나뿐이다. 인덱싱 비용과 질의 지연 시간은 다루지 않는다 |
| 임계값 | 성격만 서술 | 실제 사용값과 민감도 분석이 없다 |
| 클러스터 개수 | 튜닝했다는 한 문장 | 층별 클러스터 개수, 최대 층 수, 결정 기준이 없다 |
| 고정 외부 KG | 실험 없음 | 원문 chunk가 함께 있는 상황을 전제하므로 기성 KG에서의 동작은 미검증이다 |
| KG가 아닌 그래프 | 실험 없음 | 인용 그래프나 소셜 그래프처럼 설명문이 없는 그래프는 다루지 않는다 |
| 판정자 다양성 | 단일 판정자 | 채점자와 생성기가 모두 DeepSeek-V3다 |
| 코드 공개 | 정보 없음 | 본문과 PDF 링크 주석 어디에도 저장소 주소가 없다 |
마지막 항목은 이 페이지의 이전 판을 정정한 결과다. 이전 frontmatter와 본문이 적고 있던 GitHub 주소는 raw PDF 어디에도 근거가 없어 삭제했다.
자료 자체의 내적 모순
논문 안에서 서로 어긋나는 서술이 여섯 건 확인된다. 삭제하지 않고 그대로 기록한다.
| 항목 | 한 쪽 서술 | 다른 쪽 서술 |
|---|---|---|
| RQ3의 표 참조 | 같은 문단 앞부분은 결과가 Table 2에 정리되어 있다고 적는다 | 바로 다음 문장은 Table 3을 가리키며 그 표가 결과를 보여준다고 적는다 |
| win rate 합계 | Mix의 Comprehensiveness가 51.5%와 48.6%로 합이 100.1%다 | 나머지 15개 쌍은 모두 합이 정확히 100%다 |
| 토큰 압축 범위 | 본문은 모든 baseline보다 압축된 context를 가져온다고 적는다 | Figure 3의 Legal에서는 GraphRAG 막대가 LeanRAG보다 낮다 |
| 하락이 큰 지표 | 본문은 가장 큰 하락이 Comprehensiveness와 Empowerment에서 일관되게 나타난다고 적는다 | Mix의 Empowerment 하락은 네 지표 중 가장 작고, CS의 Comprehensiveness 하락도 가장 작다. Legal에서 하락폭이 가장 큰 구성 지표는 Diversity다 |
| 하락 범위 | 본문은 "거의 모든 평가 지표"라고 한정한다 | 해당 표의 16개 칸은 전부 하락 표시다 |
| 모델 표기 | Implementation Details는 Qwen3-14b로 적는다 | RQ2 실험 설정은 Qwen3-14B-Instruct로 적는다 |
GraphRAG local search 귀속에 대한 주의
논문은 baseline 설명에서 GraphRAG(Edge et al. 2024)의 local search mode를 사용한다고 적는다. 이 표현을 그대로 옮기면 원논문에 대한 오귀속이 된다.
이 저장소가 보유한 Edge 2024 원논문 PDF 26쪽 전문을 확인한 결과는 다음과 같다.
| 표현 | 원논문 등장 횟수 | 의미 |
|---|---|---|
| local search | 0회 | 원논문에는 이 개념 자체가 없다 |
| global search | 6회 | 실험 조건 C0에서 C3까지를 묶어 부르는 이름이다 |
| map-reduce | 6회 | 원논문이 다루는 유일한 질의 방식이다 |
| community summar | 34회 | 인덱스의 핵심 구성 요소다 |
원논문이 규정한 질의 절차는 community summary 기반 map-reduce 단일 모드다. local과 global을 나란히 놓는 이원 구성은 Microsoft의 공식 구현체가 도입한 것이고, 같은 구현체에는 DRIFT search도 함께 있다. 따라서 LeanRAG가 실제로 비교한 대상은 원논문이 규정한 절차가 아니라 구현체의 한 모드로 보아야 한다.
이 구분은 결과 해석에도 영향을 준다. 전체 성능 표에서 GraphRAG는 Legal의 Comprehensiveness에서 1위이고 Agriculture의 Overall에서도 LeanRAG와 0.02점 차이다. 이 수치는 Edge 2024가 제안한 map-reduce 요약 방식의 성능이 아니라 구현체 local search mode의 성능이다.
인용 관계
이 논문이 각 자료를 어떤 표기로 인용하는지 정리해 둔다. 우리 저장소의 파일명과 어긋나는 항목이 있어 그대로 옮기면 혼동이 생긴다.
| 대상 | 이 논문의 인용 표기 | 우리 저장소 상태 |
|---|---|---|
| GraphRAG | Edge et al. 2024, arXiv:2404.16130 | edge-2024-from-local-to-global로 보유 |
| LightRAG | Guo et al. 2024, arXiv:2410.05779 | guo-2025-lightrag-simple-and-fast로 보유. 이 논문은 2024년 arXiv 판으로 인용하며 학회 게재 정보를 적지 않는다 |
| HiRAG | Huang et al. 2025a, arXiv:2503.10150 | 미보유 |
| RAPTOR | Sarthi et al. 2024, ICLR | 미보유 |
| KAG | Liang et al. 2025, WWW 2025 Companion Proceedings | 미보유 |
| NaiveRAG | Lewis et al. 2020, NeurIPS 33권 | 미보유 |
| UltraDomain | Qian et al. 2024, MemoRAG, arXiv:2409.05591 | 미보유. 벤치마크 출처가 MemoRAG 논문이다 |
| BGE-M3 | Chen et al. 2024, arXiv:2402.03216 | 미보유 |
| DeepSeek-V3 | Liu et al. 2024, arXiv:2412.19437 | 미보유 |
| Qwen3 | Yang et al. 2025, arXiv:2505.09388 | 미보유 |
| GMM | Reynolds 2015, Encyclopedia of Biometrics | 미보유 |
LightRAG 항목이 특히 주의할 지점이다. 이 논문은 LightRAG를 2024년 arXiv 판으로만 인용하므로, 이 페이지에서 LightRAG의 게재 연도나 학회를 이 논문의 근거로 삼을 수 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Semantic islands | 계층 KG의 상위 요약 노드들이 서로를 잇는 explicit relation 없이 고립되어 개념 무리 사이 추론이 막히는 상태 |
| Aggregated relation | 같은 층의 두 상위 entity를 잇는 새 relation. connectivity strength가 임계값을 넘으면 LLM이 요약하고, 넘지 않으면 원래 relation들을 텍스트로 이어 붙인다 |
| Connectivity strength | 두 클러스터에 각각 속한 노드들을 잇던 base 층 relation의 개수 |
| Seed entity | 질의 임베딩과 base 층 entity 설명문 임베딩의 유사도로 뽑은 상위 개 entity. 구조 탐색의 출발점이다 |
| Lowest common ancestor | hierarchy에서 seed들의 공통 조상 가운데 depth가 가장 작은 노드. 이 노드를 목적지로 삼으면 경로 길이 합이 최소가 된다 |
| Inter-cluster relation | 같은 층 상위 entity 사이 relation 가운데 retrieval 결과에 항상 포함되는 것들. cross-community 정보를 공급한다 |
관련 페이지
- GraphRAG: From Local to Global: 이 논문이 1세대 KG 기반 RAG의 출발점으로 인용하는 GraphRAG 원논문이자 Table 1의 baseline이다. 다만 LeanRAG가 baseline으로 쓴 local search mode는 원논문이 아니라 공식 구현체의 기능이라는 점을 위 한계 절에서 정리했다.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): 같은 UltraDomain 네 데이터셋을 쓰는 주요 baseline이다. 평면 KG에 dual-level 검색을 얹은 구성이어서 LeanRAG의 계층 구성과 정면으로 대비된다. 원문 첨부 ablation에서 두 논문의 결과가 반대 방향으로 나온다.
- Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): 이 논문과 LightRAG를 함께 비교한 세미나 자료다. GMM 클러스터 개수를 BIC로 정한다는 설명과 UltraDomain의 규모 정보는 이 자료에만 있고 논문 본문에는 없다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: GraphRAG 계열 자료를 묶은 합성 페이지다. 서로 다른 평가 구성 때문에 네 방법의 직접 비교가 어렵다는 점과, 원문 첨부 효과의 상반된 결과를 미해결 문제로 정리해 두었다.
- microsoft/graphrag: GraphRAG 공식 구현체 페이지다. local search와 global search, DRIFT search 같은 원논문 밖 검색 모드가 여기에 있다.