Database · REPO · 2026
PixelRAG
요약
PixelRAG는 문서를 텍스트로 파싱하지 않고 스크린샷으로 렌더링해 그 이미지 자체를 검색하는 RAG 프레임워크다. 검색 단위가 텍스트 chunk가 아니라 페이지 스크린샷 조각이므로, HTML 파싱이 버리는 표와 차트와 레이아웃이 검색 단계까지 살아남는다.
구현은 두 부분으로 이뤄진다. 하나는 웹페이지와 PDF와 이미지를 스크린샷 타일로 만드는 렌더러이고, 다른 하나는 그 타일 이미지를 검색 가능한 벡터로 바꾸는 임베딩 모델이다. 임베딩 모델은 Qwen/Qwen3-VL-Embedding-2B를 스크린샷 데이터로 LoRA fine-tuning한 것이다.
저장소는 위키피디아 828만 페이지 사전 구축 인덱스를 API 키 없이 쓰는 호스팅 엔드포인트로 함께 공개하고, 렌더러를 Claude Code 플러그인 pixelbrowse로도 배포한다. Berkeley Sky Computing Lab과 BAIR와 Berkeley NLP Group의 연구팀이 Apache-2.0으로 공개했으며, 원 논문은 arXiv:2606.28344다.
프로젝트 정보
| 항목 | 내용 |
|---|---|
| 저장소 | StarTrail-org/PixelRAG |
| 논문 | PIXELRAG: Web Screenshots Beat Text for Retrieval-Augmented Generation (arXiv:2606.28344, cs.IR, 2026) |
| 저자 | Yichuan Wang와 Zhifei Li가 공동 1저자이고, 이어서 Zirui Wang, Paul Teiletche, Lesheng Jin |
| 지도 | Matei Zaharia, Joseph E. Gonzalez, Sewon Min 세 사람이 동등하게 맡았다 |
| 소속 | Berkeley Sky Computing Lab, BAIR, Berkeley NLP Group |
| 라이선스 | Apache-2.0 |
| 운영 서비스 | 웹 데모 pixelrag.ai, 검색 API api.pixelrag.ai, 상태 페이지 status.pixelrag.ai |
| 커뮤니티 | GitHub Actions CI 배지와 Slack 초대 링크 |
저장소의 계보도 README에 드러난다. 감사 표시에 Rulin Shao의 지원과 함께 Claude Code와 OpenAI Codex가 오픈소스 기여자에게 제공한 크레딧이 적혀 있고, 그 크레딧을 같은 조직의 이전 프로젝트 LEANN 작업으로 얻었다고 밝힌다.
배경
텍스트 기반 RAG는 문서를 텍스트로 옮기는 단계에서 정보를 잃는다. HTML을 파싱해 텍스트 chunk를 만들면 문자열은 남지만, 그 문자열이 어떤 표의 어느 칸에 있었는지, 어떤 차트의 어떤 축을 가리켰는지는 사라진다. 저장소의 표어가 이 문제를 그대로 말한다. "Search any document by how it looks, not just the text it contains."
파싱이 버리는 대상
README가 이름을 들어 언급하는 대상은 표, 차트, 레이아웃, 인포그래픽 네 가지다. 이들의 공통점은 정보가 문자열 자체가 아니라 문자열의 배치에 담겨 있다는 것이다. 문자열만 뽑아내면 배치가 사라지고, 배치가 사라지면 각 값이 무엇을 가리키는지도 함께 사라진다.
네 가지 중 표의 경우는 저장소가 직접 예시를 든다.
표가 사라지는 예시
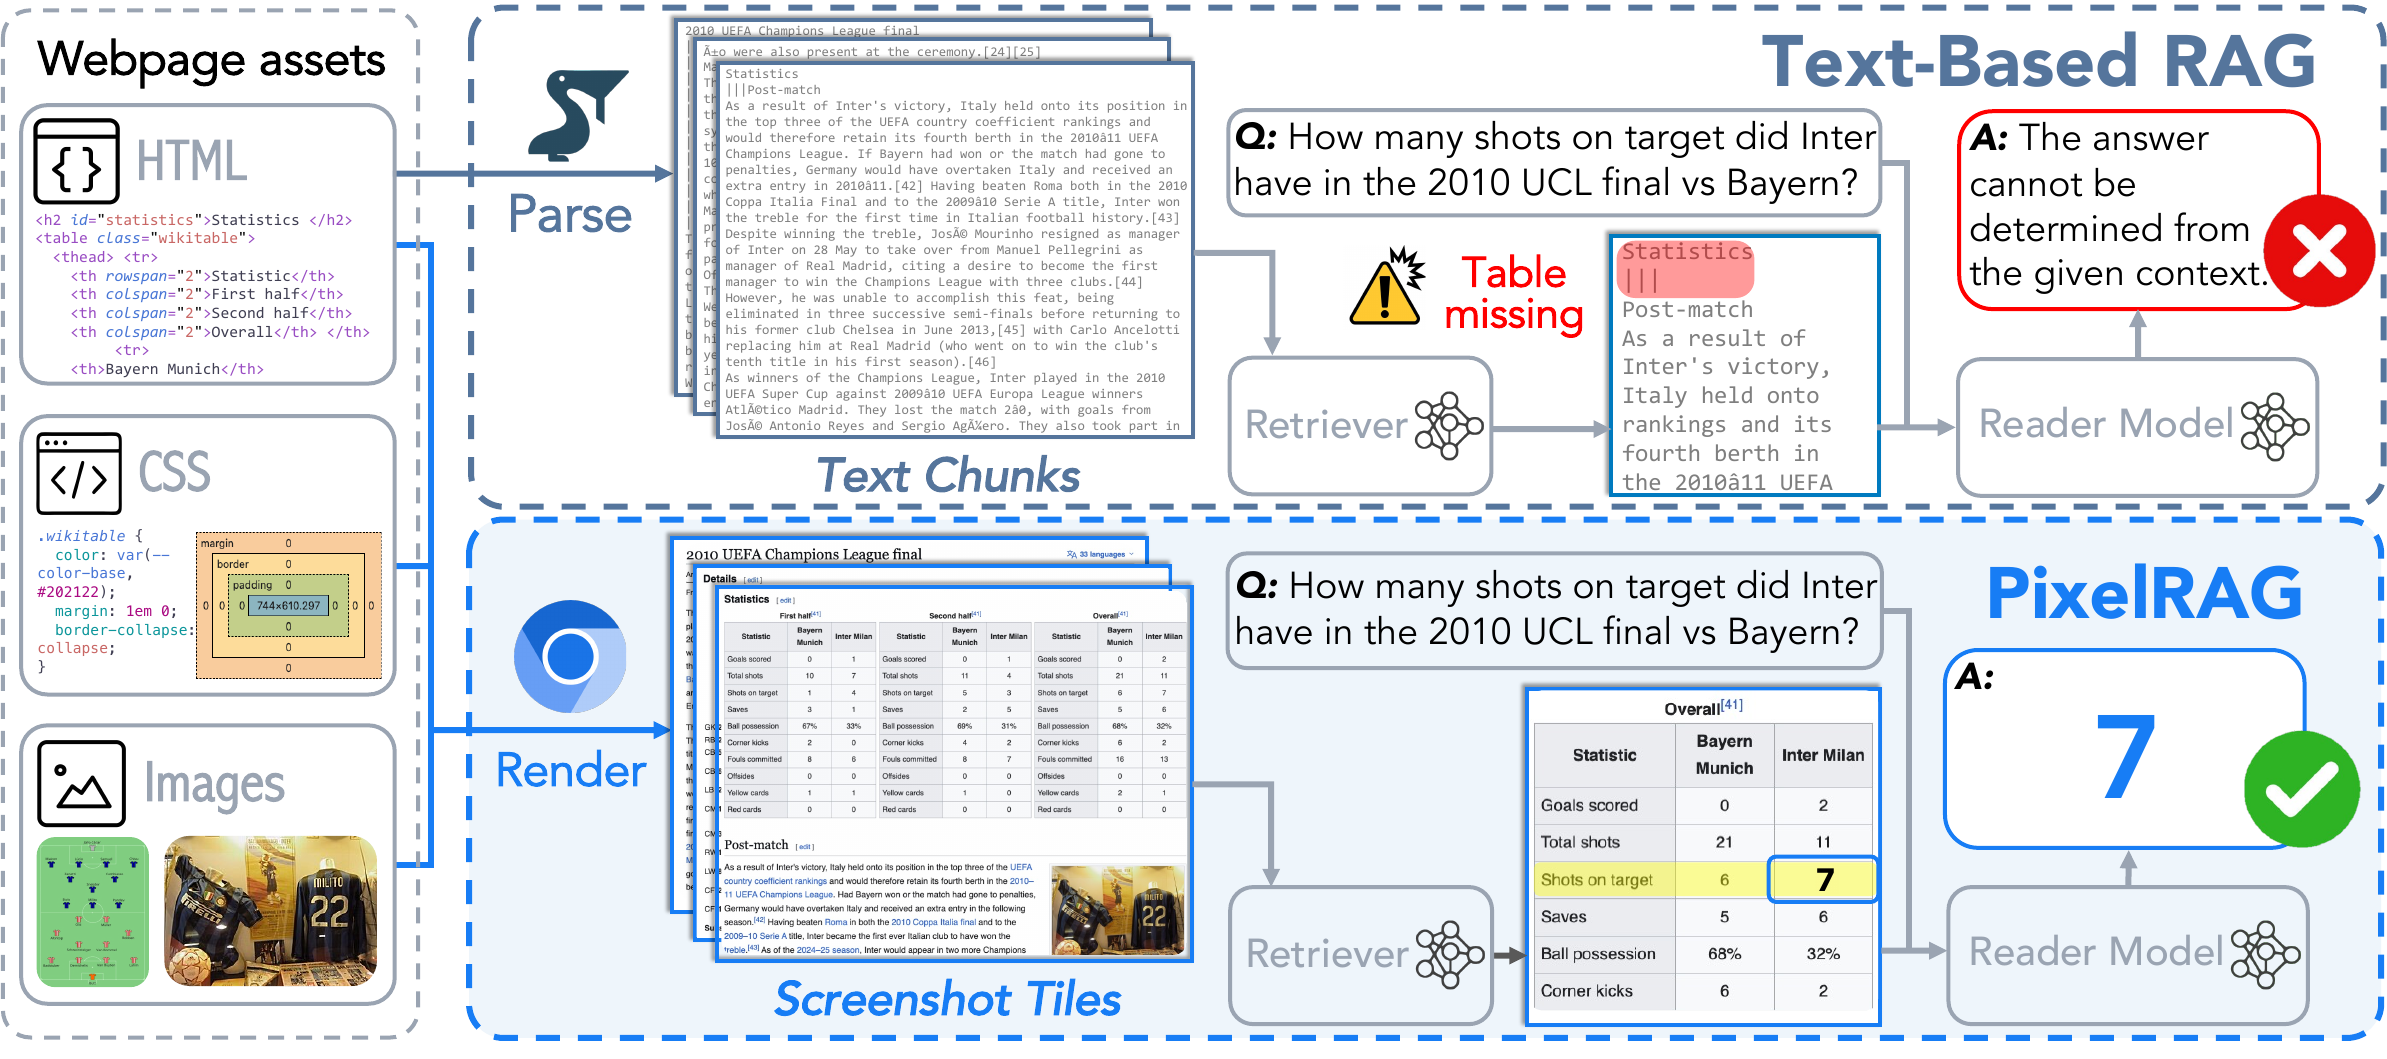
Figure 2는 이 손실을 질문 하나로 보인다. 대상 문서는 2010 UEFA 챔피언스리그 결승 위키피디아 페이지이고, 질문은 "인터가 바이에른과의 2010 UCL 결승에서 유효 슈팅을 몇 개 기록했는가"다.
텍스트 기반 경로에서는 HTML이 파싱을 거쳐 텍스트 chunk가 된다. 이 과정에서 경기 통계 표가 사라지고, retriever가 가져온 chunk에는 "Statistics"라는 제목과 그 뒤의 산문만 남는다. reader 모델은 "주어진 컨텍스트로는 답을 결정할 수 없다"고 답한다.
PixelRAG 경로에서는 같은 페이지의 HTML과 CSS와 이미지가 함께 브라우저에서 렌더링돼 스크린샷 타일이 된다. 통계 표는 화면에 보이는 모습 그대로 타일 안에 남고, retriever가 그 타일을 가져오며, reader 모델은 표에서 유효 슈팅 값 7을 직접 읽는다.
이 차이가 만들어지는 지점은 검색 알고리즘이 아니라 그 앞 단계다. 무엇을 인덱싱 대상으로 삼을지가 결과를 가른다.
두 가지 핵심 요소
README는 이 접근이 성립하는 조건을 두 가지로 정리한다.
| 요소 | 내용 | 없으면 생기는 문제 |
|---|---|---|
| 렌더링 | 문서를 파싱하지 않고 이미지로 만든다 | 시각 구조가 인덱싱 전에 사라진다 |
| 시각 임베딩 | 스크린샷 데이터로 LoRA fine-tuning한 Qwen3-VL-Embedding이 페이지 이미지를 임베딩한다 |
이미지가 남아도 질의(query)로 찾아낼 수 없다 |
핵심 개념
screenshot tile은 한 페이지를 검색 단위로 자른 스크린샷 조각이다. 텍스트 RAG의 텍스트 chunk가 맡던 자리를 이미지가 대신한다.
visual search는 텍스트가 아니라 이미지를 질의로 주고 인덱스를 검색하는 방식이다. 호스팅 엔드포인트가 이미지 질의를 받는다고 명시한다.
reader 모델은 retriever가 가져온 근거를 읽고 최종 답을 만드는 모델이다. PixelRAG에서는 그 근거가 텍스트가 아니라 이미지이므로, reader 모델이 이미지를 읽을 수 있어야 한다.
LoRA는 저랭크 행렬만 학습해 fine-tuning 비용을 줄이는 기법이다. PixelRAG는 Qwen/Qwen3-VL-Embedding-2B 전체를 다시 학습하지 않고 어댑터만 학습해 웹페이지 검색에 맞춘다.
backbone은 상위 head가 올라타는 pre-training된 특징 추출 본체를 뜻한다. 저장소가 학습셋을 함께 공개하는 이유는 더 큰 Qwen이나 다른 임베딩 모델을 backbone으로 바꿔 같은 방식을 적용할 수 있게 하기 위해서다.
설치와 첫 실행
기본 설치는 한 줄이다. pip install pixelrag이면 렌더러와 CLI가 함께 들어온다. Python 3.10 이상이면 동작하고, 로컬 재현 예시는 GPU 없이도 실행된다.
README는 이 도구의 핵심 연산을 두 가지로 제시한다. 페이지를 스크린샷으로 render하는 것과, 시각 인덱스를 search하는 것이다. 두 연산이 각각 명령 한 줄에 대응한다.
| 연산 | 명령 | 결과 |
|---|---|---|
| render | pixelshot https://en.wikipedia.org/wiki/Python --output ./tiles |
지정한 페이지가 스크린샷 타일로 저장된다 |
| search | https://api.pixelrag.ai/search에 질의 JSON을 POST |
위키피디아 828만 페이지 인덱스에서 관련 문서를 반환한다 |
search 쪽은 설치조차 필요 없다. 호스팅 엔드포인트가 사전 구축 인덱스를 이미 서빙하고 있어서 curl 한 줄로 결과를 받는다.
시작 경로는 목적에 따라 나뉜다.
| 목적 | 경로 | 준비물 |
|---|---|---|
| 검색 결과만 확인 | 호스팅 API 또는 웹 데모 pixelrag.ai |
없음 |
| 예제를 코드로 따라가기 | Colab 노트북 demos/quickstart.ipynb |
브라우저 |
| 사전 구축 인덱스 직접 운영 | Hugging Face에서 인덱스를 받아 pixelrag serve |
저장 공간과 pixelrag[serve] |
| 자체 문서 인덱싱 | pixelrag.yaml 작성 후 pixelrag index build |
pixelrag[index] |
| 임베딩 모델 재학습 | train/ 별도 uv 프로젝트 |
고정된 CUDA 환경 |
준비물의 폭이 넓다는 점이 이 저장소의 특징이다. 첫 번째 경로는 설치가 전혀 없고, 마지막 경로는 버전이 고정된 학습 환경과 GPU 자원을 요구한다.
방법
파이프라인 단계
캡처는 독립 명령 pixelshot이고, 나머지 단계는 pixelrag <stage> 우산 명령 아래 있다. 각 단계가 별도 extras로 나뉘어 있어 필요한 단계만 설치한다.
| 명령 | 하는 일 | 설치 |
|---|---|---|
pixelshot |
문서를 이미지 타일로 변환 (Playwright CDP, PDF) | pip install pixelrag |
pixelrag chunk, embed, build-index |
타일을 벡터로, 벡터를 FAISS 인덱스로 | pip install 'pixelrag[embed]' |
pixelrag index |
source에서 ingest와 embed를 거쳐 index까지 오케스트레이션 | pip install 'pixelrag[index]' |
pixelrag serve |
FAISS 검색 API (FastAPI, CPU 또는 GPU) | pip install 'pixelrag[serve]' |
단계 사이 관계는 README가 ASCII 다이어그램으로 적는다. render ←── index ──→ embed는 index가 렌더링과 임베딩을 함께 호출하는 오케스트레이터라는 뜻이고, serve (independent)는 검색 서버가 인덱스만 있으면 독립적으로 동작한다는 뜻이며, train → serve (HTTP)는 학습 쪽이 HTTP로 서빙과 이어진다는 뜻이다.
학습 프로젝트는 루트와 분리돼 있다. train/은 torch==2.9.1+cu129와 transformers==4.57.1과 cuDNN 9.20으로 환경을 고정한 별도 uv 프로젝트라, 루트가 아니라 train/ 안에서 설치해야 한다.
렌더링
렌더링 대상은 웹 URL과 로컬 파일 양쪽이고, 한 명령에 자유롭게 섞을 수 있다.
| 입력 | 처리 방식 | 추가 요구 |
|---|---|---|
| 웹페이지 | headless Chromium을 CDP로 구동해 타일 생성 | 없음 |
타일 변환, --dpi 200 같은 해상도 지정 가능 |
poppler와 pip install 'pixelrag[pdf]' |
|
| 이미지 | 렌더링 대상 문서 유형으로 명시 | 없음 |
CLI는 pixelshot https://en.wikipedia.org/wiki/Python -o ./tiles 형태로 쓴다. Python API도 있어서 from pixelrag_render import render_url 후 render_url(url, "./tiles")을 호출하면 같은 타일이 나온다. README는 이 API의 용도로 에이전트가 읽을 이미지를 만드는 경우를 든다.
Chrome 조달 방식은 플랫폼에 따라 다르다.
| 플랫폼 | Chrome 조달 | 비고 |
|---|---|---|
| linux-x64 | 번들된 turbo headless_shell이 자동 설치된다 |
자동 설치는 이 플랫폼에서만 동작한다 |
| Windows, macOS | 시스템 Chrome이나 Chromium, 또는 Playwright Chromium을 표준 설치 경로에서 자동 탐지 | 실패하면 CHROME_PATH로 바이너리를 직접 지정 |
렌더링은 매번 격리된 일회용 Chrome 프로필에서 실행된다. 사용자가 Chrome을 열어 둔 상태에서도 프로필이 충돌하지 않고 동작한다는 뜻이다.
임베딩과 인덱싱
pixelrag[embed]를 설치하면 오케스트레이터 없이 각 단계를 따로 실행할 수 있다. 대규모 코퍼스를 나눠 처리하거나 특정 단계만 다시 돌려야 할 때 쓰는 경로다.
| 명령 | 인자 예시 | 역할 |
|---|---|---|
pixelrag chunk |
--tiles-dir ./tiles |
타일을 chunk 단위로 분할 |
pixelrag embed |
--shard-dir ./tiles --output-dir ./embeddings --gpu-ids 0,1 |
타일을 임베딩 벡터로 변환, 다중 GPU 지정 가능 |
pixelrag build-index |
--embeddings-dir ./embeddings --output-dir ./index |
임베딩을 FAISS 인덱스로 빌드 |
자체 문서를 인덱싱할 때는 오케스트레이터를 쓴다. pixelrag.yaml을 두고 pixelrag index build를 실행한 뒤 pixelrag serve로 띄우는 흐름이다. Linux(CUDA)와 macOS(Apple Silicon MPS) 양쪽에서 동작한다.
| 설정 키 | 예시 값 | 뜻 |
|---|---|---|
source.type |
local |
입력 소스 종류 |
source.path |
./my_docs, ./paper.pdf |
입력 디렉터리 또는 파일 |
embed.model |
Qwen/Qwen3-VL-Embedding-2B |
임베딩 모델 |
embed.device |
auto |
Linux는 cuda, macOS는 mps, 둘 다 없으면 cpu로 폴백 |
output |
./my_index |
인덱스 출력 경로 |
device: auto 한 줄이 백엔드 선택을 대신하므로, 같은 설정 파일을 노트북과 GPU 서버에서 그대로 쓸 수 있다.
검색 API
검색 요청 형식은 호스팅 엔드포인트와 로컬 서버가 같다. 두 경로를 오갈 때 클라이언트 코드를 바꾸지 않아도 된다.
| 항목 | 호스팅 | 로컬 |
|---|---|---|
| 엔드포인트 | https://api.pixelrag.ai/search |
http://localhost:30001/search (포트는 --port로 지정) |
| 인증 | 설정도 API 키도 필요 없다 | 해당 없음 |
| 요청 | POST, {"queries": [{"text": "..."}], "n_docs": 5} |
동일 |
| 이미지 질의 | 지원한다고 명시 | README에 언급 없음 |
| 대상 인덱스 | 위키피디아 828만 페이지 사전 구축 인덱스 | --index-dir로 지정한 인덱스 |
n_docs는 가져올 문서 수다. 상태 확인용으로 https://api.pixelrag.ai/status가 따로 있고, API 레퍼런스는 pixelrag.ai/docs에 있다.
사전 구축 인덱스
사전 구축 인덱스는 Hugging Face 데이터셋 저장소 StarTrail-org/pixelrag-faiss-indexes에 있으며 FAISS 인덱스 네 개를 담는다.
| 인덱스 | 내용 | 크기 |
|---|---|---|
| base Wikipedia pixel | 기본 모델로 만든 위키피디아 픽셀 인덱스, 경로 search_index_normed_v2/ |
약 217GB |
| LoRA Wikipedia pixel | LoRA 어댑터를 적용해 만든 위키피디아 픽셀 인덱스 | README에 없음 |
| Wikipedia text | 위키피디아 텍스트 인덱스 | README에 없음 |
| news pixel | 뉴스 픽셀 인덱스 | README에 없음 |
네 개를 모두 받을 필요는 없다. huggingface-cli download에 --include "search_index_normed_v2/*"를 주면 base 인덱스만 내려받는다. 같은 저장소가 픽셀 인덱스와 텍스트 인덱스를 나란히 두고 있어서, 같은 코퍼스에 대해 두 방식을 직접 비교할 수 있는 구조다.
학습과 공개 자산
fine-tuning은 train/ 아래 별도 uv 프로젝트 wiki-screenshot-training에 있다. Qwen/Qwen3-VL-Embedding-2B를 웹페이지 검색용으로 LoRA fine-tuning하며, cd train && uv sync 후 그 안에서 실행한다. 전체 레시피는 train/README.md에 있다.
다만 쓰기 위해 학습할 필요는 없다. 학습된 어댑터가 이미 공개돼 있다.
| 공개 자산 | 위치 | 용도 |
|---|---|---|
| LoRA 어댑터 | Chrisyichuan/wiki-screenshot-embedding-lora (lora_vit/ckpt200) |
재학습 없이 바로 사용 |
| 학습셋 | Chrisyichuan/screenshot-training-natural-filtered-v2 |
다른 backbone에 같은 방식 적용 |
| 데이터 큐레이션 문서 | train/docs/synthetic_data_pipeline.md |
LLM 기반 질의 증강 생성, 필터링, hard-negative mining |
학습셋까지 공개한 이유를 README는 명시한다. 더 큰 Qwen이나 다른 임베딩 모델을 backbone으로 바꿔 같은 방식을 적용해 보라는 것이다.
pixelbrowse 플러그인
렌더러는 검색 파이프라인과 별개로 Claude Code 플러그인으로도 배포된다. Claude가 raw HTML을 가져오는 대신 pixelshot으로 페이지를 스크린샷해 이미지를 읽으므로, 차트와 다이어그램과 표와 레이아웃을 사람이 보는 방식으로 인식한다.
| 단계 | 명령 | 비고 |
|---|---|---|
| CLI를 PATH에 설치 | uv tool install pixelrag 또는 pipx install pixelrag |
프로젝트 venv에 그냥 pip install하면 pixelshot이 PATH에서 빠질 수 있다 |
| 마켓플레이스 등록 | claude plugin marketplace add StarTrail-org/PixelRAG |
저장소를 클론할 필요는 없다 |
| 플러그인 설치 | claude plugin install pixelbrowse@pixelrag-plugins |
호출 방식은 두 가지다. 비대화형에서는 claude -p "screenshot https://news.ycombinator.com and summarize the top stories"처럼 프롬프트로 지시하고, 대화형 세션에서는 슬래시 커맨드 /screenshot https://example.com을 쓴다.
구조가 가볍다는 점을 README가 강조한다. MCP 서버도 백엔드도 없이 스킬이 로컬에서 pixelshot을 호출할 뿐이다.
적용 시나리오
README가 직접 제시하는 사용 경로는 네 가지다. 각 경로가 저장소의 어느 기능에 기대는지를 함께 보면 도입 비용을 가늠할 수 있다.
| 시나리오 | 근거가 되는 저장소 기능 |
|---|---|
| 위키피디아 대상 질의응답 | 828만 페이지 호스팅 인덱스와 인증 없는 검색 API |
| 자체 문서 검색 | pixelrag.yaml과 pixelrag index build, 로컬 PDF 인덱싱 예시 |
| 에이전트에게 페이지를 보여주기 | pixelbrowse 플러그인과 render_url Python API |
| 다른 backbone으로 방식 이식 | 공개 학습셋과 데이터 큐레이션 문서 |
세 번째 경로는 검색 인덱스를 전혀 쓰지 않는다는 점에서 나머지와 성격이 다르다. 렌더러만 떼어 쓰는 용법이고, 그래서 pixelshot이 독립 명령으로 분리돼 있다.
정보 손실 지점의 대조
같은 database 카테고리 안에도 문서를 검색 가능하게 만드는 방식이 여럿 있다. 접근마다 정보가 어디서 손실되는지가 다르다. 아래 표는 각 접근이 무엇을 검색 단위로 삼는지만 비교한 것이고, 성능 수치는 각 페이지가 담당한다.
| 접근 | 검색 단위 | 인덱스 구성 |
|---|---|---|
| 텍스트 chunk RAG (Figure 2의 비교 대상) | 파싱된 텍스트 chunk | 텍스트 임베딩 벡터 인덱스 |
| 멀티모달 지식 그래프 (RAG-Anything) | 이미지와 표와 수식을 1급 단위로 포함한 그래프 노드 | 지식 그래프와 임베딩 병행 |
| 네이티브 멀티모달 임베더 (Gemini Embedding 2) | 여러 modality를 하나의 backbone이 매핑한 벡터 | 단일 벡터 공간 |
| 원문 직접 탐색 (DCI) | 원문 파일 자체 | 임베딩과 인덱스를 두지 않는다 |
| PixelRAG | 페이지 스크린샷 타일 | 페이지 이미지 임베딩 FAISS 인덱스 |
PixelRAG의 위치는 이 비교에서 분명해진다. 파싱을 개선하거나 그래프로 보완하는 대신 파싱 단계 자체를 렌더링으로 대체한다. 문서가 화면에 보이는 모습이 곧 인덱싱 대상이 되므로, 파싱기가 표를 어떻게 처리하는지에 결과가 좌우되지 않는다.
대신 인덱싱 대상이 텍스트에서 이미지로 바뀌면서 비용의 성격도 달라진다. 위키피디아 base 픽셀 인덱스 하나가 약 217GB이고, 같은 Hugging Face 저장소가 위키피디아 텍스트 인덱스를 따로 두고 있다. 두 인덱스가 같은 코퍼스를 서로 다른 형식으로 담고 있으므로, 저장 비용과 검색 품질의 교환 관계를 같은 조건에서 직접 확인할 수 있는 구조다.
결과
README에는 recall이나 latency 같은 정량 벤치마크 표가 없다. 대신 실제로 운영 중인 서비스와 재현 가능한 예시로 결과를 보인다.
| 근거 | 내용 |
|---|---|
| 호스팅 인덱스 | 위키피디아 828만 페이지 인덱스를 설정과 API 키 없이 공개 운영한다. curl 한 줄로 검색된다 |
| 웹 데모 | pixelrag.ai에서 브라우저로 바로 시험할 수 있다 |
| Colab 노트북 | demos/quickstart.ipynb가 페이지를 렌더링하고 호스팅 인덱스를 검색하며, 결과 이미지를 인라인으로 보여준다 |
| 로컬 재현 | 샘플 PDF(assets/pixelrag-paper.pdf) 한 개를 인덱싱한 뒤 "Overview of PixelRAG and the diagram"으로 검색하면 개요 다이어그램이 있는 2쪽이 나와야 한다고 명시한다 |
로컬 재현 예시의 소요 시간도 함께 안내한다. 샘플 PDF 한 개를 인덱싱하는 데 Apple M 시리즈에서 약 3분, GPU에서 약 1분이 걸린다. 이 예시는 GPU 없이도 동작하며 macOS(Apple Silicon)나 Python 3.10 이상이 있는 아무 기기에서 실행된다. 즉 접근 방식을 확인해 보는 비용이 노트북 한 대 수준이다.
한계
- 정량 벤치마크가 README에 없다. recall이나 latency 같은 수치 비교는 이 저장소 문서에 없다. 저장소는 사용법과 데모 중심이고, 수치를 확인하려면 논문(arXiv:2606.28344)을 따로 봐야 한다.
- 대규모 인덱스의 저장 비용이 크다. 위키피디아 base 픽셀 인덱스 하나가 약 217GB다. 나머지 세 인덱스의 크기는 README에 없어서 전체 규모를 알 수 없다.
- turbo 렌더링이 linux-x64 전용이다. 번들된 turbo
headless_shell은 linux-x64에서만 자동 설치되고, Windows와 macOS는 시스템 Chrome이나 Playwright Chromium에 의존한다. 자동 탐지가 실패하면CHROME_PATH를 직접 지정해야 한다. - 학습 환경이 루트와 분리돼 있다.
train/은torch와transformers와 cuDNN 버전을 고정한 별도 uv 프로젝트라, fine-tuning을 시도하려면 별도 설치 절차를 거쳐야 한다. - 설치 경로에 따라 CLI가 PATH에서 빠질 수 있다. README 본문은
pixelshot이pip install pixelrag로 함께 설치된다고 적으면서, 플러그인 절에서는 프로젝트 venv에 그냥 설치하면 PATH에 없을 수 있다고 경고한다. 격리 설치 도구를 권장하는 이유가 여기에 있다. - 단계 간 디렉터리 규약이 문서화되지 않았다. 독립 실행 예시에서
pixelrag chunk --tiles-dir ./tiles의 출력 위치가 명시되지 않은 채, 다음 단계가pixelrag embed --shard-dir ./tiles로 같은./tiles를 가리킨다. chunk의 산출물이 어디에 쌓이는지 README만으로는 확인되지 않는다. - 설계 근거가 저장소 밖에 있다. 타일 분할 기준, 임베딩 차원, 검색 파라미터 같은 선택의 근거는 README 범위 밖이고 논문에 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| PixelRAG | 문서를 텍스트로 파싱하지 않고 스크린샷 이미지로 렌더링해 그 이미지를 직접 검색하는 RAG 방식 |
| pixelshot | 웹페이지와 PDF와 이미지를 스크린샷 타일로 변환하는 독립 CLI 명령. pip install pixelrag에 포함된다 |
| screenshot tile | 한 페이지를 검색 단위로 자른 스크린샷 조각. 텍스트 RAG의 텍스트 chunk에 대응한다 |
| pixelbrowse | pixelshot을 호출해 Claude가 raw HTML 대신 스크린샷 이미지를 읽게 하는 Claude Code 플러그인 스킬 |
| visual search | 텍스트가 아니라 이미지를 질의로 주고 인덱스를 검색하는 방식. 호스팅 API가 지원한다 |
| Qwen3-VL-Embedding | PixelRAG가 스크린샷 데이터로 LoRA fine-tuning하는 비전 언어 임베딩 모델 |
관련 페이지
- RAG-Anything: All-in-One RAG Framework: 이미지와 표와 수식을 1급 단위로 다루는 멀티모달 RAG. 텍스트 파싱이 잃는 정보를 그래프 구조로 되살리는 쪽이라, 파싱 자체를 렌더링으로 대체하는 PixelRAG와 해법이 갈린다.
- Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini: 하나의 backbone이 여러 modality를 단일 벡터 공간에 매핑하는 네이티브 멀티모달 임베더. PixelRAG는 기존 비전 언어 모델을 스크린샷 데이터로 LoRA fine-tuning해 같은 목표에 이르는 경로를 택한다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩과 인덱스를 두지 않고 에이전트가 원문을 직접 탐색하는 대조 접근. 검색 인터페이스를 없애는 쪽과 인덱싱 대상을 이미지로 바꾸는 쪽이라는 점에서 방향이 반대다.
- 용어집: LLMs (Terminology Glossary): fine-tuning, LoRA, backbone, 임베딩의 canonical 표기.