Database · PAPER · 2026
Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini
요약
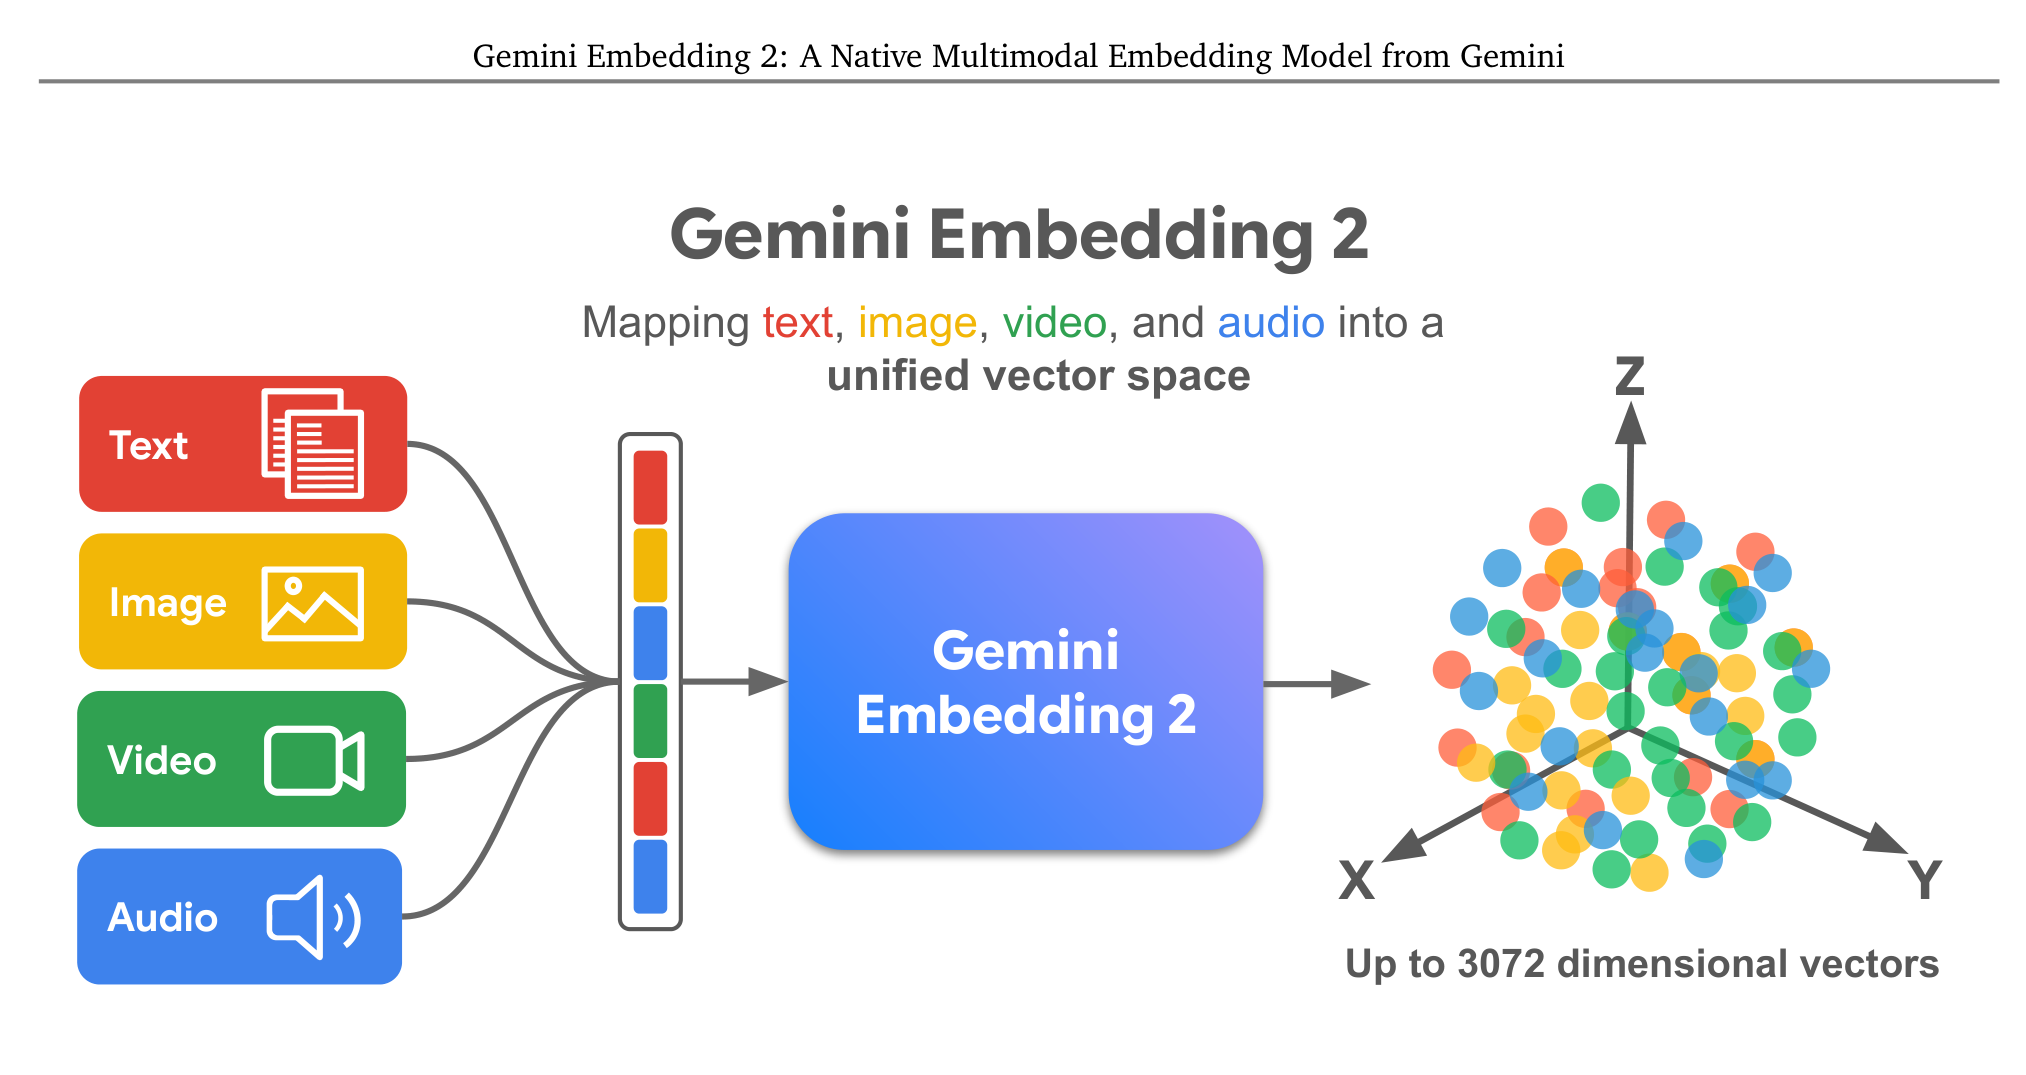
Gemini Embedding 2는 Gemini를 backbone으로 초기화해 만든 임베딩 모델이다. backbone은 상위 모듈이 올라타는 특징 추출 본체를 뜻하고, 여기서는 Gemini의 파라미터로 초기화한 Transformer가 그 자리를 맡는다. 텍스트, 이미지, 비디오, 오디오를 각각 처리할 뿐 아니라 이들이 한 시퀀스 안에 섞여 들어오는 입력까지 하나의 vector space에 매핑한다.
이 모델이 겨냥한 것은 CLIP과 ALIGN이 세운 late-fusion 구조의 한계다. 그 구조는 modality마다 인코더를 따로 두고 짝지어진 데이터로 두 인코더를 정렬시키는데, 그러면 이미지와 텍스트가 뒤섞인 입력을 다룰 방법이 없다. Gemini Embedding 2는 modality 변환 자체를 Gemini에 맡겨 인코더를 하나로 줄인다.
성능은 서로 다른 세 가지 벤치마크 묶음에서 확인된다. multimodal retrieval 종합 점수는 77.2로 Amazon Nova MME(68.2)와 Voyage-3.5-multimodal(70.0)을 앞서고, 텍스트 전용 벤치마크인 MTEB Multilingual에서 69.9, MTEB Code v1에서 84.0을 기록했다. 오디오에서는 ASR로 전사한 뒤 임베딩하는 기존 방식(평균 mrr@10 70.40)보다 raw audio를 직접 임베딩하는 방식(73.99)이 일관되게 좋았고, 언어를 넘나드는 검색에서 격차가 5.01점으로 가장 컸다.
배경
late-fusion dual-tower가 막힌 지점
임베딩 모델의 기존 multimodal 접근은 dual-tower였다. CLIP, ALIGN, SigLIP 2, CoCa가 대표적이며, 이미지 인코더와 텍스트 인코더를 따로 두고 짝지어진 이미지-텍스트 데이터로 두 출력이 같은 공간에 놓이도록 학습시킨다.
저자들은 이 late-fusion 방식이 두 가지를 못 한다고 지적한다. 첫째, mixed-modality 입력을 다루지 못한다. 이미지와 질문 문장이 한 덩어리로 들어오는 query는 어느 인코더로 보낼지 정할 수 없다. 둘째, modality 사이의 상호작용을 쓰지 못해 표현이 얕아진다. 두 인코더가 각자 계산을 마친 뒤에야 만나기 때문이다.
MLLM은 이 제약을 풀 수 있는 출발점이다. MLLM은 이미지와 텍스트를 함께 받아 처리하는 대형 언어 모델을 가리키며, 내부에서 modality들이 서로 attention을 주고받는다. 저자들의 주장은 이 깊은 융합을 임베딩에도 그대로 쓰자는 것이다.
겨냥한 응용
저자들이 이 모델의 목적지로 지목하는 곳은 학술 벤치마크가 아니라 기업 환경이다. 논문이 직접 나열하는 응용은 문서 retrieval, 비디오 추천, 오디오 기반 검색, 그리고 RAG다.
이 응용들의 공통점은 다루는 자료가 원래부터 여러 modality에 걸쳐 있다는 것이다. 제품 문서 한 페이지에는 문장과 표와 도해가 섞여 있고, 비디오 한 편에는 화면과 발화와 자막이 함께 있다. 그런데 각 modality가 담고 있는 정보는 서로 같지 않다. 저자들의 표현으로는 modality들이 본래 동질적이지 않으므로, 모든 modality에서 나온 풍부한 의미 정보를 함께 쓸 때 이득이 생긴다.
특히 강조하는 것은 interleaved 시퀀스가 열어 주는 새로운 검색 형태다. 이미지와 텍스트와 비디오를 하나의 query로 묶을 수 있으면, 시각 단서와 텍스트 단서를 결합해 긴 비디오 안의 특정 시점을 지목하는 검색이 가능해진다. 기존 dual-tower로는 이런 query를 표현할 방법 자체가 없었다.
텍스트 전용 선행 모델
Gemini Embedding 2에는 텍스트 전용 선행 모델 Gemini Embedding이 있다. 2025년에 발표됐고 합성 데이터 활용과 Gemini의 다국어 pre-training 덕분에 MMTEB 리더보드에서 최상위를 기록했다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계를 말한다.
이 논문의 실질적 질문은 modality를 늘리면 텍스트 성능이 희생되는가다. 결과 절에서 보듯 답은 그렇지 않다는 쪽이었다.
관련 연구의 세 흐름
| 흐름 | 대표 연구 | 핵심 |
|---|---|---|
| LLM 기반 텍스트 임베더 | BERT, RoBERTa, BGE 계열, E5, Gecko, NV-Embed | 인코더 전용에서 디코더 전용 대형 backbone으로 이동. Gecko는 대형 LLM 교사에서 distillation, NV-Embed는 합성 데이터와 instruction-tuned contrastive 학습 |
| multimodal 임베더 | CLIP, ALIGN, SigLIP 2, CoCa, Amazon Nova MME, SAIL-Embedding | dual-tower에서 통합 의미 공간으로 이동. SAIL-Embedding은 산업 추천 환경의 sequence-to-item 예측까지 다룬다 |
| bidirectional attention 적응 | MoCa, MM-Embed | causal backbone에 양방향 문맥을 부여하는 문제. MoCa는 interleaved 입력 복원 목적함수로, MM-Embed는 modality-aware hard negative mining으로 접근 |
저자들은 이 세 흐름이 그동안 따로 다뤄졌으며 Gemini Embedding 2가 하나의 모델로 통합한다고 주장한다. 여기에 기업 문서 응용도 포함된다. 타일 기반 vision 인코더를 여럿 섞어 PDF와 차트와 표를 임베딩하는 기존 방식은 chunking 전략 같은 파이프라인 구성 요소에 RAG 품질을 종속시킨다는 것이 저자들의 지적이다.
핵심 개념
native multimodal embedding은 modality별 인코더 없이 단일 backbone이 모든 modality와 그 조합을 직접 임베딩하는 방식이다. late-fusion과 대비되는 이름이며, 이 논문의 제목에 들어간 native가 이 뜻이다.
interleaved 입력은 이미지, 텍스트, 비디오가 하나의 시퀀스 안에 섞여 들어오는 입력 형태다. 저자들이 드는 예는 시각 단서와 텍스트 단서를 함께 넣어 긴 비디오 안의 특정 시점을 찾는 검색이다.
bidirectional attention은 토큰이 앞뒤 양방향을 모두 참조하게 하는 attention 방식이다. 생성용 Gemini는 앞쪽 토큰만 보는 causal 방식이지만, 임베딩은 시퀀스 전체를 한 번에 요약해야 하므로 뒤쪽을 보지 못할 이유가 없다. 이 논문은 causal 제약을 풀고 fine-tuning한다. fine-tuning은 pre-training을 마친 모델을 특정 과제 데이터로 더 학습시키는 단계다.
mean pooling은 토큰 임베딩 시퀀스를 길이 방향으로 단순 평균 내 벡터 하나로 만드는 방법이다. 선행 연구가 단순 pooling만으로도 모델 적응에 충분함을 보였다는 것이 이 선택의 근거다.
NCE는 positive와 negative를 구분하도록 학습하는 contrastive 손실 계열이다. 여기서 negative는 두 종류로 나뉜다. in-batch negative는 같은 배치 안 다른 예제의 정답을 자동으로 오답으로 삼는 것이고, hard negative는 모델이 헷갈리기 쉬운 오답을 데이터에 미리 넣어 둔 것이다.
**MRL(Matryoshka Representation Learning)**은 임베딩 벡터의 앞부분 부분 차원들을 각각 독립적으로 쓸 수 있는 표현으로 만드는 기법이다. 3,072차원 벡터의 앞 768차원만 잘라 써도 품질이 유지되므로 저장 비용과 검색 비용을 필요에 맞게 줄일 수 있다.
task string은 "question answering"이나 "fact checking"처럼 과제의 성격을 알려 주는 짧은 문자열이다. query 앞에 붙여 같은 모델이 여러 과제를 구분해 처리하도록 돕는다. BGE 계열과 E5가 확립한 instruction-tuned 표현의 계보에 있는 장치다.
zero-shot은 해당 과제의 학습 데이터를 전혀 쓰지 않은 상태로 평가한다는 뜻이다. 이 논문에서 비디오 세 과제와 특화 도메인 네 과제가 이 조건으로 측정됐고, 저자들이 일반화의 근거로 삼는 지점이다.
model soup은 여러 fine-tuning 체크포인트의 가중치를 평균해 일반화를 얻는 기법이다. 추가 학습 없이 가중치 산술만으로 여러 실행의 강점을 섞는다.
ASR cascade는 오디오를 ASR로 텍스트로 바꾼 뒤 그 텍스트를 임베딩하는 파이프라인이다. 이 논문이 native audio 입력의 비교 기준으로 삼는 구성이다.
방법
모델 아키텍처
파이프라인은 네 단계다. 저자들은 Gemini 파라미터에서 초기화하는 것 자체를 임베딩 모델의 pre-training 단계로 본다고 명시한다.
| 단계 | 처리 | 산출물 |
|---|---|---|
| 1. 토큰화 | Gemini가 지원하는 raw 포맷의 이미지, 비디오, 오디오를 그대로 받아 토큰 시퀀스로 변환한다 | 길이 L의 시퀀스 T |
| 2. 인코딩 | Gemini에서 초기화한 bidirectional attention Transformer M이 처리한다 | 토큰 임베딩 L × d_M |
| 3. pooling | 시퀀스 방향으로 mean pooling을 적용한다 | 벡터 d_M |
| 4. projection | 랜덤 초기화 linear projection f로 목표 차원에 맞춘다 | 최종 임베딩 d = 3,072 |
modality마다 raw 포맷을 토큰으로 바꾸는 절차가 다르다는 점이 선행 텍스트 전용 모델과의 결정적 차이다. Gemini Embedding 2는 그 변환기를 새로 만들지 않고 Gemini에 위임한다. 따라서 지원 modality의 범위는 Gemini가 소화하는 포맷의 범위와 같아진다.
선행 텍스트 전용 모델과 달라진 점
표현을 만드는 방식 자체는 선행 Gemini Embedding과 거의 같다. 저자들이 결정적 차이로 꼽는 것은 modality마다 raw 포맷을 토큰 시퀀스로 바꾸는 절차가 다르다는 점 하나다.
| 항목 | Gemini Embedding (텍스트 전용) | Gemini Embedding 2 |
|---|---|---|
| 입력 modality | 텍스트 | 텍스트, 이미지, 비디오, 오디오와 이들의 조합 |
| 토큰화 | 텍스트 토크나이저 | Gemini가 raw 포맷을 직접 변환 |
| 손실 | NCE with in-batch negatives | 동일 (저자들이 선행 버전과 같다고 명시) |
| 다단계 학습 | Gecko 계보의 다단계 | 동일 계보, 여기에 model soup 추가 |
| MTEB Multilingual Mean (Task) | 68.4 | 69.9 |
| MTEB Code v1 Mean | 76.0 | 84.0 |
| CoIR Mean | 73.9 | 82.3 |
설계 판단의 핵심은 임베딩 모델 쪽에 modality 처리기를 새로 만들지 않았다는 것이다. modality 변환을 backbone에 위임했기 때문에 지원 범위가 Gemini의 지원 범위를 따라간다. 반대로 말하면 Gemini가 다루지 못하는 포맷은 이 모델도 다루지 못한다.
학습 목적함수
학습 예제 하나는 query q_i, 정답 target p_i^+, 그리고 선택적으로 hard negative target p_i^-로 구성된다. query 임베딩은 task string t를 query 앞에 이어 붙인 뒤 계산한다.
손실은 배치 크기 B에 대한 log-softmax 형태이며 구성은 다음과 같다.
| 위치 | 항 | 역할 |
|---|---|---|
| 분자 | exp(sim(q_i, p_i^+) / τ) | 정답 쌍의 유사도를 높인다 |
| 분모 1항 | exp(sim(q_i, p_i^+) / τ) | 분자와 같은 항 |
| 분모 2항 | exp(sim(q_i, p_i^-) / τ) | hard negative. 해당 과제에 hard negative가 없으면 이 항이 빠진다 |
| 분모 3항 | Σ_j mask(i, j) × exp(sim(q_i, p_j^+) / τ) | 배치 안 다른 예제의 정답을 오답으로 쓴다 |
유사도는 cosine similarity이고 temperature τ로 나눈다. τ의 실제 값은 논문에 없다.
mask(i, j)는 q_i = q_j이거나 p_i^+ = p_j^+이면 0, 아니면 1이다. 레이블 수가 적은 classification 과제에서는 같은 정답 레이블이 배치 안에 여러 번 등장하는데, 이 장치가 없으면 정답을 오답으로 밀어내는 학습 신호가 생긴다.
task string augmentation은 여기에 붙는 보조 기법이다. 텍스트 전용 과제의 query 앞에 "question answering"이나 "fact checking" 같은 문자열을 붙이되 학습 중 무작위로 떼어낸다. task string 없이 들어오는 입력, 특히 텍스트가 아닌 modality 입력에도 모델이 견디게 하는 것이 목적이다.
여러 차원을 한 번에 학습하는 MRL
MRL은 위 손실을 임베딩 차원의 k개 겹치는 부분 차원에 각각 적용한다. 앞 768차원에 손실 하나, 앞 1,536차원에 손실 하나를 두고 합치는 식이다.
| 항목 | 값 |
|---|---|
| 기본 출력 차원 | 3,072 |
| MRL 최적화 대상 차원 | 768, 1,536 |
| 학습 실행 횟수 | 1회 (차원별 재학습 없음) |
효과는 다운스트림 선택지가 늘어나는 것이다. 검색 인덱스 크기가 부담이면 앞 768차원만 저장하고, 정확도가 우선이면 3,072차원을 그대로 쓴다. 차원마다 별도 모델을 학습하고 배포할 필요가 없다.
3단계 학습 레시피
학습은 PFT, FT, model soup 순으로 진행된다. Gecko와 선행 Gemini Embedding에서 이어받은 다단계 구성이다.
| 단계 | 사용 데이터 | 배치 구성 | 목적 |
|---|---|---|---|
| PFT (Pre-Fine-Tuning) | 이미지, 텍스트, 코드 | 큰 배치, 배치 하나에 과제 하나 | 자기회귀 생성에서 인코딩으로 파라미터를 적응시킨다 |
| FT (Fine-Tuning) | 텍스트, 코드, 문서, 이미지, 오디오, 비디오 | 과제별로 배치 크기를 따로 조정, 배치 하나에 과제 하나 | 전 modality를 학습하고 modality 사이 정렬을 만든다 |
| Model Soup | 개별 FT 실행의 체크포인트들 | 해당 없음 | 가중치 평균으로 일반화를 얻는다 |
PFT 단계는 잡음이 섞인 query-target 쌍을 대량으로 쓴다. 큰 배치를 쓰는 이유가 여기 있다. 배치가 크면 그래디언트가 안정되어 잡음의 영향이 줄어든다. 이 단계에는 오디오와 비디오가 들어가지 않는다.
FT 단계에서 전부는 아니지만 상당수 과제가 query, target, hard negative 삼중항을 갖는다. modality 사이 정렬은 single-modality 배치와 cross-modality 배치를 함께 학습해서 만든다. model soup에서는 같은 실행 안의 체크포인트 평균, 다른 실행 사이의 평균, 여러 가중 평균 조합을 실험했다.
저자들이 명시적으로 남긴 경험칙은 하이퍼파라미터 민감도다. modality 전체의 성능 균형이 multi-task 설정의 sampling rate와 배치 크기에 크게 좌우됐고, 각 과제의 sampling rate는 이론이 아니라 실험으로 정했다.
native audio와 ASR cascade 비교 설계
오디오 평가는 MSEB의 passage retrieval split에서 이루어진다. 과제는 음성 query를 받아 대규모 텍스트 문서 코퍼스에서 관련 정보를 찾는 것이며, 두 구성을 나란히 놓고 비교한다.
| 구성 | 처리 경로 |
|---|---|
| Gemini Embedding 2 + ASR | raw audio를 ASR로 전사한 뒤 그 텍스트를 인코딩한다 |
| Gemini Embedding 2 + native audio | 중간 전사 없이 raw audio를 직접 인코딩한다 |
저자들이 제시하는 가설은 cascade의 구조적 결함이 오류 전파라는 것이다. ASR은 모호한 오디오를 반드시 하나의 텍스트로 확정해야 하며, 그 확정이 틀리면 다운스트림 retrieval은 완전히 다른 query를 받는다. 논문이 드는 예는 발음이 거의 같은 "recognize speech"와 "wreck a nice beach"다.
native 방식은 그런 확정을 강요하지 않는다. 임베딩이 원 음향 신호의 모호함을 그대로 담고 있어서 prosody, intonation, 강세 같은 단서가 남는다. 평가는 같은 언어 안에서 검색하는 PassageInLang과 언어를 넘나드는 PassageCrossLang 두 구간으로 나눠 측정한다.
결과
평가에 쓰인 벤치마크
결과를 읽기 전에 어떤 벤치마크가 무엇을 재는지 정리해 둔다. 논문은 학술 중심 벤치마크와 기업 중심 벤치마크를 함께 쓴다고 밝힌다.
| 벤치마크 | 측정 대상 | 지표 | 규모와 설정 |
|---|---|---|---|
| GUIEC | instance 단위 이미지 검색 | R@1 | 20만 장 인덱스 |
| ImageNet | 이미지에서 이미지 검색 | R@1 | 명시 없음 |
| MSCOCO, Flickr30k | 기본 이미지 캡션 대응 | R@1 | 테스트셋 전체를 대상으로 cosine similarity 검색 |
| DOCCI, TextCaps | 긴 캡션, 공간 추론, 장면 텍스트 이해 | R@1 | 같은 방식 |
| Vatex, MSR-VTT, YouCook2 | 텍스트에서 비디오 검색 | NDCG@10 | 1 FPS, 최대 32 프레임 임베딩 |
| EncyclopedicVQA | 이미지와 질문을 함께 임베딩해 정답 검색 | R@20 | multimodal 임베딩 능력 측정 |
| ViDoRe V2 | 페이지 단위 시각 구조, 레이아웃, 삽입 텍스트 이해 | NDCG@10 | 문서 retrieval |
| MMTEB | 다국어 텍스트 임베딩 | 혼합 | 250개 넘는 언어, 10가지 유형, 132개 과제 |
| MTEB Code v1 | 코드 retrieval | 혼합 | 15개 프로그래밍 언어, 12개 과제 |
| CoIR | 코드 정보 검색 | 혼합 | 9개 언어, 10개 과제 |
| MSEB | 음성 query로 텍스트 문서 검색 | mrr@10 | passage retrieval split만 사용 |
| MicroVQA, ArtCap, AstroLLaVA, Recipe1M | 특화 도메인 zero-shot | R@5 | 4개 도메인, 이미지에서 텍스트 |
이미지와 텍스트는 따로 임베딩한 뒤 query와 문서 사이 cosine similarity로 검색한다. 저자들이 별도로 짚는 점은 이 모든 평가가 과제별 지시문 없이 이루어졌다는 것이다. 경쟁 모델들이 과제별 지시문에 기대는 것과 달리 별도 프롬프트 조정 없이 측정했다고 서술한다.
multimodal retrieval 종합
비교 대상은 Voyage-3.5-multimodal, Amazon Nova MME, 그리고 Google의 이전 모델 multimodalembedding@001이다. GUIEC는 20만 장 인덱스에서 instance 단위로 검색하는 과제이고, 비디오는 1 FPS로 최대 32 프레임까지 임베딩한다.
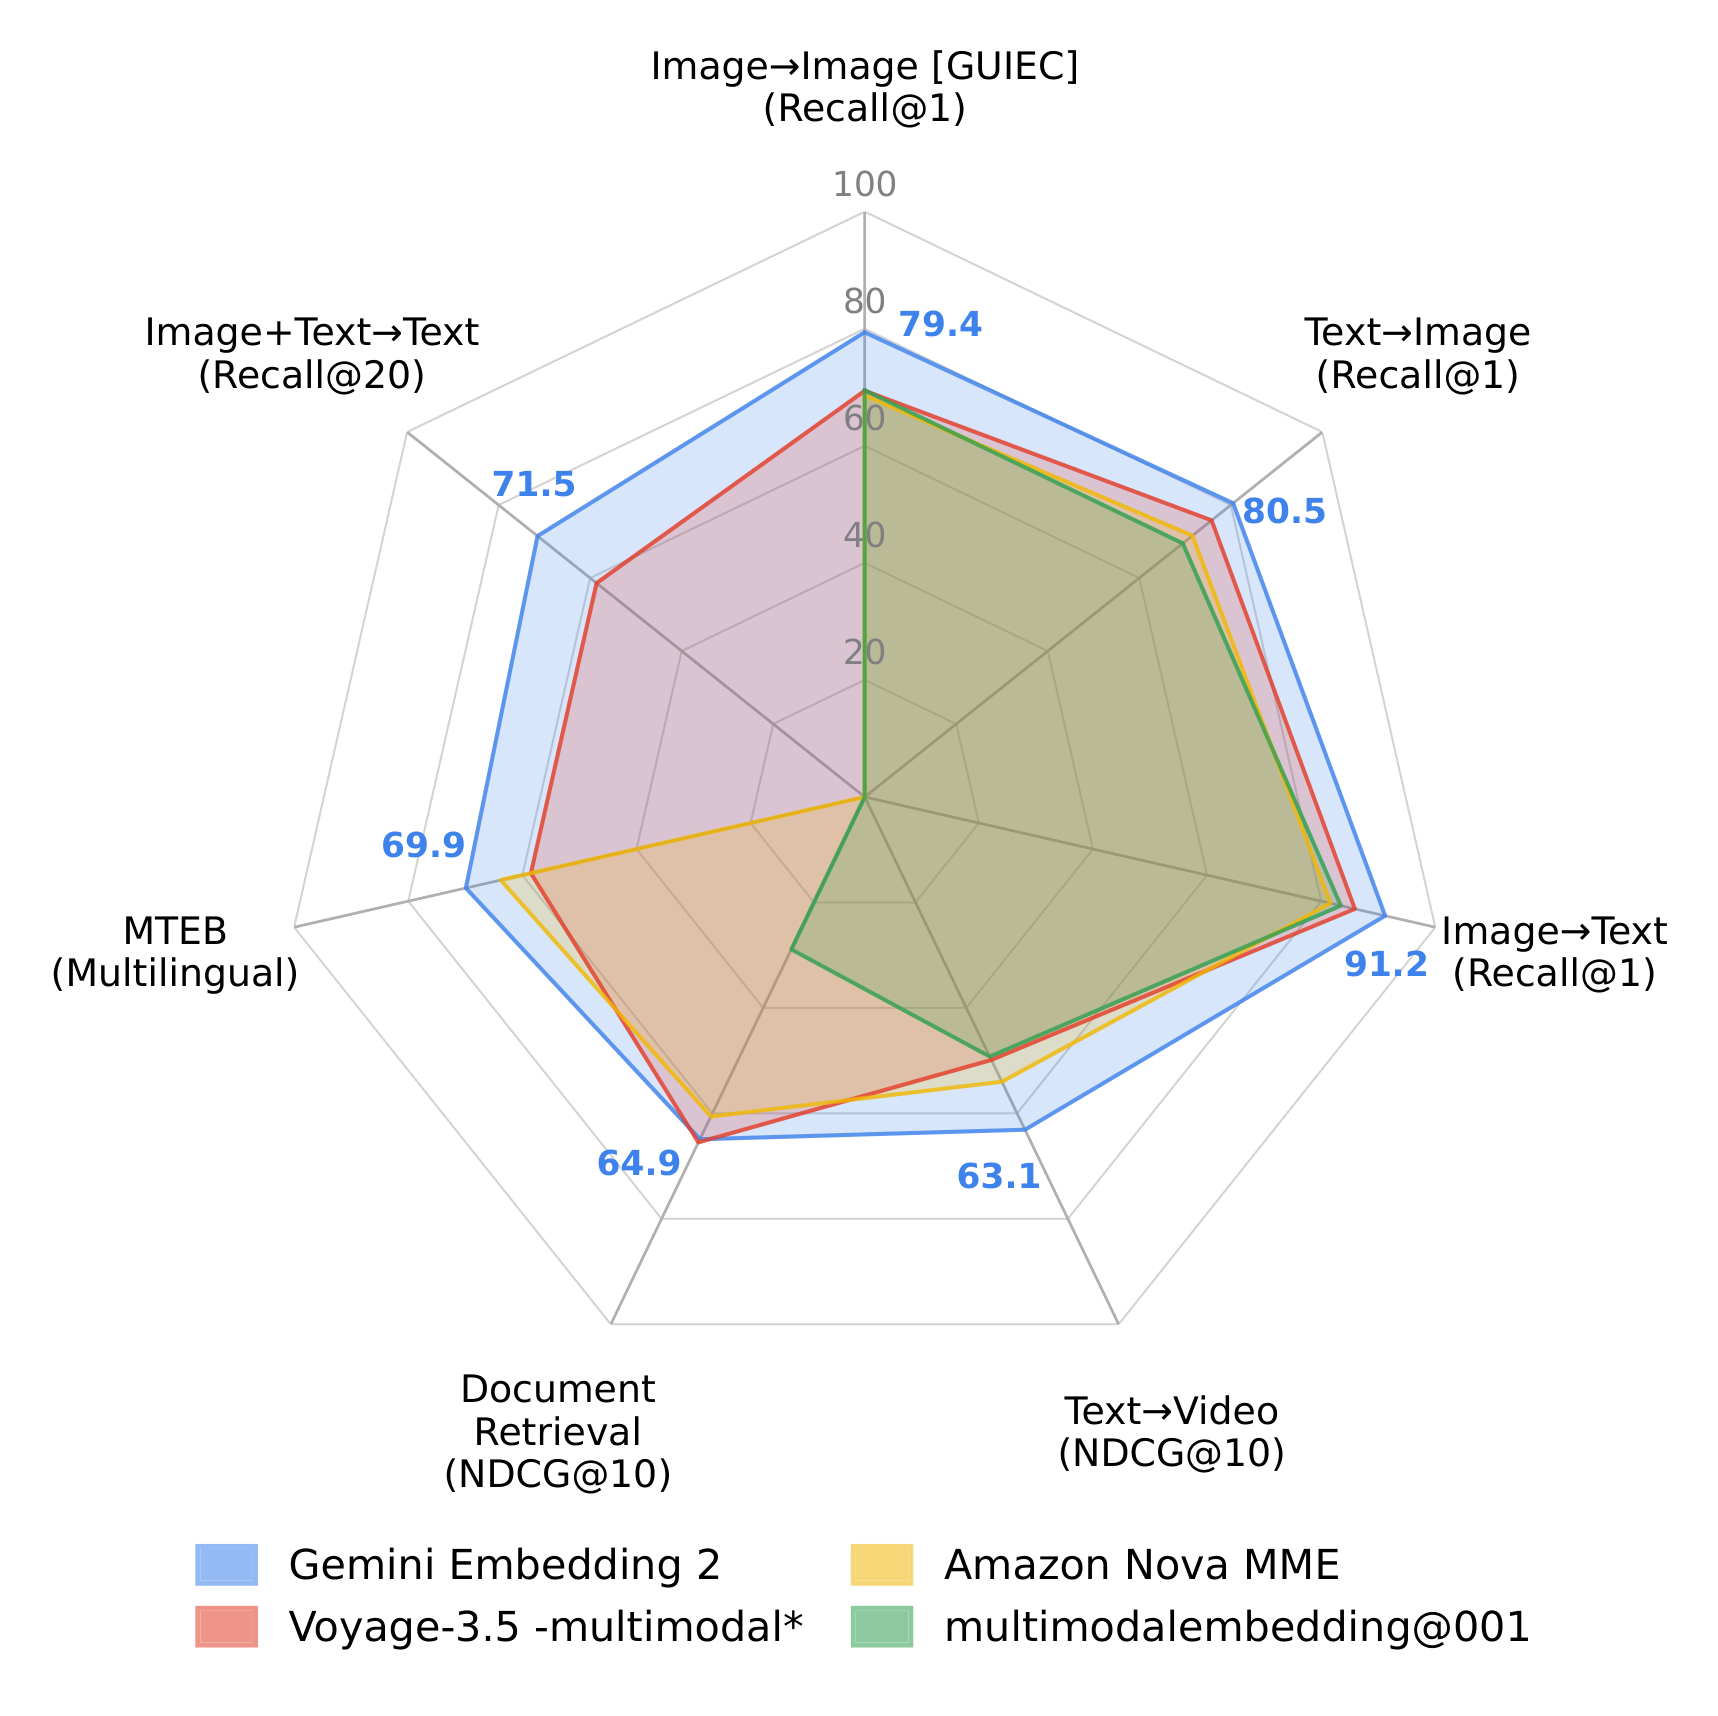
| 과제 묶음 | 데이터셋 | 지표 | Gemini Embedding 2 | Nova MME | Voyage-3.5-mm | legacy |
|---|---|---|---|---|---|---|
| Image to Image | GUIEC | R@1 | 79.4 | 68.6 | 69.4 | 69.5 |
| Image to Image | ImageNet | R@1 | 83.6 | 미보고 | 미보고 | 71.8 |
| Text to Image | Mean | R@1 | 80.5 | 71.6 | 75.8 | 69.5 |
| Text to Image | MSCOCO | R@1 | 62.9 | 57.2 | 58.1 | 53.1 |
| Text to Image | Flickr30k | R@1 | 89.1 | 81.6 | 89.9 | 81.4 |
| Text to Image | DOCCI | R@1 | 93.4 | 84.0 | 83.8 | 미보고 |
| Text to Image | TextCaps | R@1 | 89.6 | 76.0 | 79.4 | 74.0 |
| Image to Text | Mean | R@1 | 91.2 | 81.6 | 85.9 | 83.4 |
| Image to Text | MSCOCO | R@1 | 78.8 | 68.3 | 74.5 | 68.2 |
| Image to Text | Flickr30k | R@1 | 97.4 | 87.5 | 94.5 | 94.0 |
| Image to Text | DOCCI | R@1 | 91.3 | 76.5 | 77.4 | 미보고 |
| Image to Text | TextCaps | R@1 | 97.4 | 88.9 | 88.6 | 88.1 |
| Text to Video | Mean | NDCG@10 | 63.1 | 54.0 | 49.9 | 49.2 |
| Text to Video | Vatex | NDCG@10 | 68.8 | 60.3 | 55.2 | 54.9 |
| Text to Video | MSR-VTT | NDCG@10 | 68.0 | 67.0 | 63.0 | 57.9 |
| Text to Video | YouCook2 | NDCG@10 | 52.5 | 34.7 | 31.4 | 34.9 |
| Image+Text to Text | EncyclopedicVQA | R@20 | 71.5 | 미보고 | 58.6 | 미보고 |
| Document | ViDoRe V2 | NDCG@10 | 64.9 | 60.6 | 65.5 | 28.9 |
| 종합 | Overall | 혼합 | 77.2 | 68.2 | 70.0 | 64.1 |
| 지원 modality | V/A/I/T | V/A/I/T | V/I/T | I/T |
이 표에서 Gemini Embedding 2가 1위가 아닌 항목은 두 개뿐이다. Text to Image의 Flickr30k에서 89.1로 Voyage-3.5-multimodal(89.9)에 0.8%p 뒤지고, 문서 retrieval인 ViDoRe V2에서 64.9로 같은 모델(65.5)에 0.6점 뒤진다.
격차가 가장 큰 곳은 긴 캡션 데이터셋과 비디오다. Text to Image DOCCI에서 93.4로 두 번째로 높은 Nova MME(84.0)를 9.4%p 앞서고, Text to Video YouCook2에서 52.5로 두 번째로 높은 Nova MME(34.7)를 17.8%p 앞선다. 비디오가 특히 눈에 띄는 이유는 학습 혼합에 Vatex, MSR-VTT, YouCook2의 in-domain 학습 split을 넣지 않았기 때문이다. 즉 세 과제 모두 zero-shot 결과다.
ViDoRe V2는 페이지 단위 시각 구조와 레이아웃, 삽입 텍스트 이해를 함께 요구하는 과제다. 저자들은 이 비교에서 Video/Audio/Image/Text 전체 modality를 지원하는 모델이 Amazon Nova MME와 자사 모델 둘뿐이라는 점을 함께 짚으며, 동시에 최적화하는 과제 범위를 고려하면 64.9도 주목할 만하다고 서술한다.
텍스트 벤치마크
MMTEB은 250개 넘는 언어와 10가지 과제 유형을 담고, 부록 기준 132개 개별 과제로 구성된다. MTEB Code v1은 15개 프로그래밍 언어의 코드 retrieval 과제 12개, CoIR은 9개 언어의 과제 10개다.
| 벤치마크 | 항목 | Gemini Embedding 2 | Nova MME | Gemini Embedding (텍스트 전용) | voyage-3.5 / voyage-code-3 |
|---|---|---|---|---|---|
| MTEB Multilingual | Mean (Task) | 69.9 | 63.8 | 68.4 | 58.5 |
| MTEB Multilingual | Mean (Type) | 61.2 | 미보고 | 59.6 | 51.9 |
| MTEB Multilingual | Bitext Mining | 85.4 | 미보고 | 79.3 | 60.5 |
| MTEB Multilingual | Classification | 73.1 | 미보고 | 71.8 | 58.5 |
| MTEB Multilingual | Clustering | 55.3 | 미보고 | 54.6 | 45.9 |
| MTEB Multilingual | Inst. Retrieval | 2.9 | 미보고 | 5.2 | 6.5 |
| MTEB Multilingual | Multilabel Class. | 32.2 | 미보고 | 29.2 | 21.7 |
| MTEB Multilingual | Pair Class. | 83.2 | 미보고 | 83.6 | 76.0 |
| MTEB Multilingual | Reranking | 69.0 | 미보고 | 65.7 | 64.2 |
| MTEB Multilingual | Retrieval | 70.0 | 미보고 | 67.7 | 64.0 |
| MTEB Multilingual | STS | 79.4 | 미보고 | 79.4 | 70.0 |
| MTEB Code v1 | Mean | 84.0 | 미보고 | 76.0 | 미보고 |
| CoIR | Mean | 82.3 | 미보고 | 73.9 | 78.5 |
| 지원 modality | V/A/I/T | V/A/I/T | T | T |
가장 중요한 관찰은 multimodal 확장이 텍스트 성능을 깎지 않았다는 점이다. 선행 텍스트 전용 모델의 MTEB Multilingual Mean (Task)가 68.4인데 Gemini Embedding 2가 69.9로 올라섰다. 본문은 같은 값을 68.32로 적어 표와 소수점 표기가 다르다.
다만 전 항목 1위는 아니다. 9개 과제 유형 중 세 곳에서 밀린다.
| 유형 | Gemini Embedding 2 | 앞선 모델 | 차이 |
|---|---|---|---|
| Instruction Retrieval | 2.9 | voyage-3.5 (6.5) | -3.6 |
| Pair Classification | 83.2 | Gemini Embedding (83.6) | -0.4 |
| STS | 79.4 | Gemini Embedding (79.4) | 0.0 (동률) |
Instruction Retrieval의 2.9는 절대 수준이 낮다는 점에서 단순한 순위 문제가 아니다. 부록의 개별 과제를 보면 Robust04InstructionRetrieval이 -0.44, News21InstructionRetrieval이 2.64, Core17InstructionRetrieval이 6.44이며 세 값의 평균이 2.9다. 지시문을 반영해 순위를 다시 매기라는 과제 유형에서는 임베딩 하나로 신호를 만들기 어렵다는 뜻이다.
코드 쪽 결과는 강하다. MTEB Code v1에서 84.0으로 선행 텍스트 전용 모델(76.0)을 8.0점 앞서고, CoIR에서 82.3으로 코드 특화 모델 voyage-code-3(78.5)를 3.8점 앞선다. MTEB Code v1에는 voyage-code-3 값이 보고되지 않았으므로 이 벤치마크에서의 직접 비교는 성립하지 않는다.
오디오 retrieval
| 구성 | 평균 mrr@10 | Passage In-Lang | Passage Cross-Lang |
|---|---|---|---|
| Gemini Embedding 2 + ASR | 70.40 | 73.58 | 67.55 |
| Gemini Embedding 2 + native audio | 73.99 | 75.58 | 72.56 |
| 차이 | +3.59 | +2.00 | +5.01 |
두 구간의 상승폭 차이가 이 실험의 핵심이다. 같은 언어 안 검색에서는 2.00점 오르지만 언어를 넘나드는 검색에서는 5.01점 오른다. 즉 native audio의 이득은 단순히 ASR 오류를 피한 것만이 아니다.
저자들의 해석은 modality에 구애받지 않는 latent space가 원 오디오의 발화 언어와 무관하게 의미 특징을 정렬한다는 것이다. ASR 전사기는 특정 언어의 음소 경계를 전제로 동작하므로 언어가 바뀌면 그 전제가 곧 제약이 된다. 직접 임베딩은 그 경계를 거치지 않는다.
같은 언어 구간의 이득에 대해서는 다른 설명을 든다. cascade 구조의 결함은 ASR이 모호한 입력에 대해서도 반드시 하나의 텍스트를 골라야 한다는 데 있다. 그 선택이 틀리면 다운스트림 retrieval은 원래 질문과 다른 질문을 받게 되며, 검색 단계에서 되돌릴 방법이 없다. 저자들은 이를 파이프라인 구조의 오류 전파라고 부른다.
native 임베딩은 그 선택을 미룬다. 음향 신호의 모호함이 연속적인 표현 안에 남아 있으므로 검색 단계가 여러 해석 가능성을 동시에 반영할 수 있다. prosody, intonation, 강세 같은 단서가 임베딩에 보존된다는 것이 저자들의 설명이다. 다만 이 해석은 정성적 근거이며, 논문은 ASR 오류율과 검색 성능 사이의 상관을 따로 측정하지 않는다.
이 결과는 문서 처리 쪽에도 시사점을 준다. 오디오를 텍스트로 바꾼 뒤 임베딩하는 것과 이미지를 텍스트로 바꾼 뒤 임베딩하는 것은 같은 형태의 파이프라인이고, 같은 형태의 오류 전파를 안는다. 이 논문이 오디오에서 그 중간 단계를 없앤 것과 같은 논리가 문서 이미지 검색에도 적용된다.
특화 도메인 zero-shot
임베딩 모델이 학습 분포 밖 도메인에서 얼마나 버티는지를 네 도메인에서 측정한다. MicroVQA는 현미경과 바이오사이언스, ArtCap은 회화, AstroLLaVA는 천문, Recipe1M은 요리다. 지표는 이미지에서 텍스트를 찾는 R@5다.
| 모델 | 변형 | MicroVQA | ArtCap | AstroLLaVA | Recipe1M Ingredients | Recipe1M Instructions |
|---|---|---|---|---|---|---|
| CLIP | Base Patch32 | 34.1 | 34.1 | 21.2 | 64.6 | 61.1 |
| CLIP | Large Patch14 | 44.4 | 49.4 | 28.8 | 76.5 | 74.6 |
| CLIP | Large Patch14-336 | 46.7 | 52.2 | 31.6 | 76.0 | 75.6 |
| ALIGN | Base | 48.1 | 49.2 | 18.4 | 70.3 | 70.8 |
| SigLIP 2 | Base Patch16-256 | 23.0 | 16.3 | 6.3 | 69.8 | 70.7 |
| SigLIP 2 | Large Patch16-384 | 27.4 | 7.3 | 11.0 | 78.7 | 78.3 |
| SigLIP 2 | Giant Patch16-384 | 33.3 | 8.4 | 13.2 | 81.2 | 80.4 |
| TIPS | Base Patch14 | 14.8 | 59.3 | 6.9 | 60.7 | 59.3 |
| TIPS | Large Patch14 | 21.5 | 59.9 | 8.9 | 61.3 | 63.0 |
| TIPS | Giant Patch14 | 20.0 | 65.2 | 10.1 | 66.0 | 65.6 |
| Voyage-3.5-multimodal | 해당 없음 | 53.3 | 48.7 | 30.3 | 미보고 | 미보고 |
| Gemini Embedding 2 | 해당 없음 | 79.3 | 67.7 | 64.4 | 90.2 | 92.1 |
절대 점수만 보면 천문에서 64.4로 baseline 성능을 사실상 두 배로 올렸고, 미생물에서는 79.3으로 48% 넘게 앞선다. Recipe1M에서는 재료 90.2와 조리법 92.1로 90선을 넘었으며, 두 번째로 높은 SigLIP2-Giant(81.2와 80.4)와의 차이가 각각 9.0%p와 11.7%p다.
저자들이 더 강조하는 것은 도메인 사이 일관성이다. 기존 모델들은 도메인마다 진폭이 크다.
| 모델 계열 | 가장 좋은 도메인 | 가장 나쁜 도메인 | 진폭 |
|---|---|---|---|
| TIPS Giant Patch14 | ArtCap 65.2 | MicroVQA 20.0 | 45.2%p |
| SigLIP 2 Giant Patch16-384 | Recipe1M Ingredients 81.2 | ArtCap 8.4 | 72.8%p |
| Gemini Embedding 2 | Recipe1M Instructions 92.1 | AstroLLaVA 64.4 | 27.7%p |
TIPS는 회화에서 잘하지만 현미경 이미지에서 크게 하락하고, SigLIP 2는 그 반대다. Gemini Embedding 2에는 이런 도메인 의존적 진폭이 나타나지 않으며, 저자들은 이를 별도 조정 없이 바로 쓸 수 있는 표현이라는 근거로 든다.
실무 관점에서 이 일관성은 절대 점수보다 중요할 수 있다. 도입 시점에 어느 도메인에서 성능이 무너질지 예측할 수 없다면 모델을 도메인마다 다르게 골라야 하는데, 진폭이 작으면 그 선택 비용이 사라진다. 저자들이 상정하는 사용자로 실험실 생물학자, 천체물리학자, 요리 플랫폼, 디지털 인문학 연구자를 함께 나열하는 것도 같은 맥락이다.
합성 데이터의 효과
MTEB Code v1에서 3개 과제만 골라 본 ablation이다. 표 캡션은 이 ablation 모델들이 souping을 제외한 구성이라고 명시한다.
| 모델 | Average | CodeFeedbackMT | CodeFeedbackST | SyntheticText2SQL |
|---|---|---|---|---|
| Gemini Embedding (이전 텍스트 전용) | 70.5 | 56.3 | 85.3 | 70.0 |
| Gemini Embedding 2, 합성 데이터 없음 | 73.0 | 57.9 | 85.5 | 75.7 |
| Gemini Embedding 2, 합성 데이터 사용 | 86.3 (+15.8) | 92.3 | 88.6 | 78.1 |
표에 붙은 +15.8은 합성 데이터만의 기여가 아니다. 이전 텍스트 전용 모델(70.5)을 기준으로 잰 총 상승폭이며, 본문도 "이전 Gemini Embedding 모델 대비 평균 +15.81"이라고 적는다. 이 값 안에는 모델 자체의 개선(70.5에서 73.0으로 2.5점)과 합성 데이터의 기여(73.0에서 86.3으로 13.3점)가 함께 들어 있다.
과제별로 보면 편차가 크다. CodeFeedbackMT는 57.9에서 92.3으로 34.4점 올랐지만 CodeFeedbackST는 85.5에서 88.6으로 3.1점, SyntheticText2SQL은 75.7에서 78.1로 2.4점 올랐다. 합성 데이터의 효과가 과제 성격에 따라 크게 갈린다는 뜻이다.
PFT와 FT의 기여 분리
10개 과제에서 PFT 체크포인트와 최종 FT 체크포인트를 비교하면 두 단계의 역할이 나뉜다.
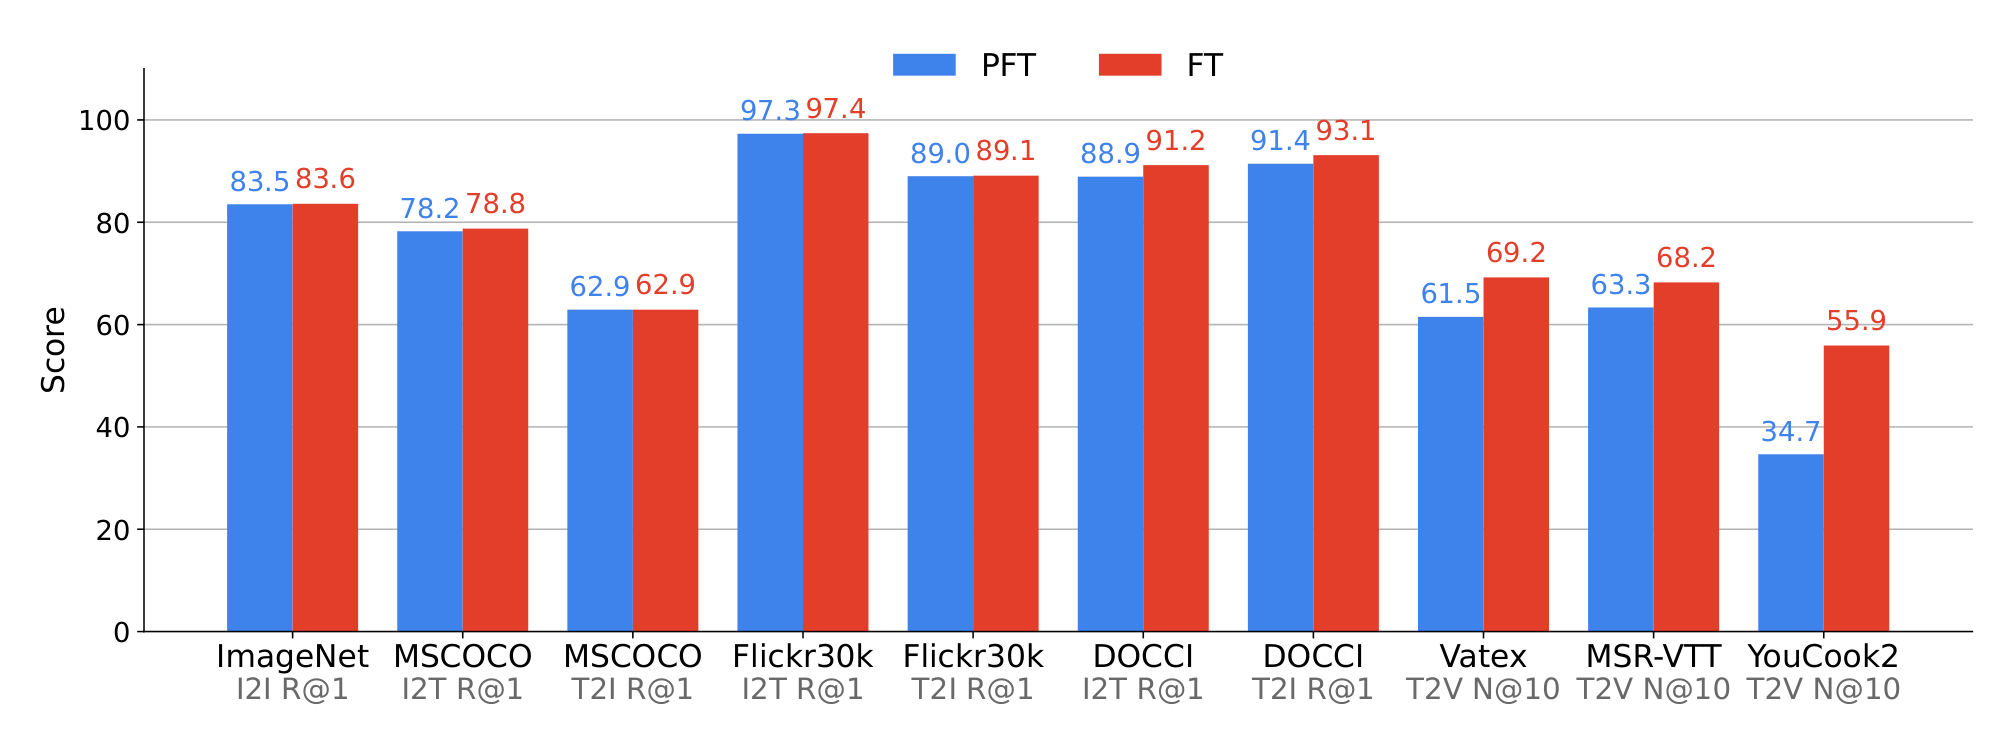
| 과제 | 지표 | PFT | FT | 차이 |
|---|---|---|---|---|
| ImageNet | I2I R@1 | 83.5 | 83.6 | +0.1 |
| MSCOCO | I2T R@1 | 78.2 | 78.8 | +0.6 |
| MSCOCO | T2I R@1 | 62.9 | 62.9 | 0.0 |
| Flickr30k | I2T R@1 | 97.3 | 97.4 | +0.1 |
| Flickr30k | T2I R@1 | 89.0 | 89.1 | +0.1 |
| DOCCI | I2T R@1 | 88.9 | 91.2 | +2.3 |
| DOCCI | T2I R@1 | 91.4 | 93.1 | +1.7 |
| Vatex | T2V NDCG@10 | 61.5 | 69.2 | +7.7 |
| MSR-VTT | T2V NDCG@10 | 63.3 | 68.2 | +4.9 |
| YouCook2 | T2V NDCG@10 | 34.7 | 55.9 | +21.2 |
이미지 과제에서 FT의 기여는 대부분 1%p 미만이다. MSCOCO Text to Image는 62.9로 아예 변화가 없다. 반면 비디오 과제에서는 FT가 결정적이며, YouCook2는 34.7에서 55.9로 21.2점 올랐다. 저자들의 설명은 FT 단계에서 비디오 학습 데이터가 추가로 들어가기 때문이라는 것이다. PFT 단계 데이터에는 이미지, 텍스트, 코드만 들어간다는 §3.3의 서술과 일치한다.
실무적 함의는 어떤 modality를 쓸 것이냐에 따라 필요한 단계가 다르다는 점이다. 이미지 검색만 필요하면 PFT 수준의 적응으로 대부분을 얻을 수 있고, 비디오가 목적이면 FT가 반드시 필요하다.
in-domain 데이터와 model soup의 균형
fine-tuning 혼합에 목표 과제의 학습 split을 넣고 추가 데이터를 1 epoch 학습한 결과다. 수천 스텝과 O(k) 규모의 데이터만으로도 목표 과제 지표가 크게 움직인다.
| 구성 | MSR-VTT | Δ | YouCook2 | Δ | Vatex | Δ |
|---|---|---|---|---|---|---|
| baseline Gemini Embedding 2 | 68.2 | 기준 | 55.9 | 기준 | 69.2 | 기준 |
| + MSR-VTT 데이터 (FTmix-m) | 75.0 | +6.8 | 56.1 | +0.2 | 71.7 | +2.5 |
| + MSR-VTT와 Vatex 데이터 (FTmix-mv) | 76.1 | +7.9 | 55.3 | -0.6 | 79.5 | +10.3 |
| soup 2:1 (w_base=2, w_ft=1) | 71.7 | +3.5 | 56.1 | +0.2 | 74.5 | +5.3 |
| soup 1:1 (w_base=1, w_ft=1) | 73.7 | +5.5 | 56.8 | +0.9 | 76.8 | +7.6 |
세 행을 나란히 읽으면 잘 알려진 상충이 그대로 나타난다. MSR-VTT와 Vatex 데이터를 넣으면 두 과제는 각각 7.9점과 10.3점 오르지만, 학습에 넣지 않은 YouCook2가 55.9에서 55.3으로 0.6%p 내려간다.
model soup은 이 상충을 완화한다. baseline과 fine-tuning된 가중치를 1대1로 평균하면 MSR-VTT는 +5.5, Vatex는 +7.6으로 in-domain 이득의 상당 부분을 유지하면서 YouCook2도 56.8로 baseline보다 0.9%p 높아진다. 세 과제 모두에서 baseline을 넘는 구성은 이 1대1 soup뿐이다.
2대1 soup은 baseline 가중치를 더 크게 주는 만큼 이득도 작다. MSR-VTT +3.5, Vatex +5.3이며 YouCook2는 +0.2에 그친다. 저자들의 해석은 단순 가중치 보간이 과제 특화 지식과 원 모델의 강건성을 함께 유지한다는 것이다.
이 실험이 보여 주는 운영 방식은 특정 과제를 겨냥한 fine-tuning을 별도 모델로 배포하지 않고 원 모델과 섞어 하나로 배포하는 것이다. 필요한 것은 추가 학습이 아니라 두 체크포인트의 가중치 평균 한 번이며, 섞는 비율만 조절해도 in-domain 이득과 out-of-domain 안정성 사이의 지점을 고를 수 있다.
개별 과제 전체 결과
부록 §8은 개별 과제 점수를 전부 공개한다. MTEB Multilingual은 132개 과제, MTEB Code는 12개 과제다. 종합 점수만 보면 가려지는 편차가 여기서 드러난다.
| 벤치마크 | 상위 과제 | 하위 과제 |
|---|---|---|
| MTEB Multilingual (132개) | IndicGenBenchFloresBitextMining 99.22, HagridRetrieval 99.19, BUCC.v2 99.09, IN22GenBitextMining 98.43, NepaliNewsClassification 97.98 | Robust04InstructionRetrieval -0.44, News21InstructionRetrieval 2.64, MultiEURLEXMultilabelClassification 4.70, Core17InstructionRetrieval 6.44, TempReasonL1 7.77, SpartQA 8.74 |
| MTEB Code (12개) | AppsRetrieval 98.60, StackOverflowQA 97.89, CodeSearchNetCCRetrieval 96.25, CodeTransOceanContest 93.19 | CodeTransOceanDL 33.72, CosQA 52.05, SyntheticText2SQL 78.11 |
과제 성격에 따른 격차가 100점 가까이 벌어진다. bitext mining처럼 두 언어의 같은 문장을 짝짓는 과제는 99점대에 이르는 반면, 지시문 반영이나 시간 추론이 필요한 과제는 한 자릿수에 머문다. 임베딩 하나로는 의미 유사도를 넘어서는 조건을 표현하기 어렵다는 신호로 읽을 수 있다.
과제 이름이 유형을 드러내므로 몇 가지를 골라 성격별로 늘어놓으면 편차의 모양이 보인다.
| 과제 | 성격 | 점수 |
|---|---|---|
| IndicGenBenchFloresBitextMining | 다국어 문장 짝짓기 | 99.22 |
| BUCC.v2 | 다국어 문장 짝짓기 | 99.09 |
| IN22GenBitextMining | 다국어 문장 짝짓기 | 98.43 |
| NTREXBitextMining | 다국어 문장 짝짓기 | 96.48 |
| Tatoeba | 다국어 문장 짝짓기 | 89.35 |
| BibleNLPBitextMining | 다국어 문장 짝짓기 | 34.09 |
| HagridRetrieval | 검색 | 99.19 |
| WikipediaRetrievalMultilingual | 검색 | 94.82 |
| BelebeleRetrieval | 검색 | 93.81 |
| MLQARetrieval | 검색 | 84.51 |
| TRECCOVID | 검색 | 77.57 |
| MIRACLRetrievalHardNegatives | 검색 | 71.15 |
| SCIDOCS | 검색 | 25.68 |
| Core17InstructionRetrieval | 지시문 반영 검색 | 6.44 |
| News21InstructionRetrieval | 지시문 반영 검색 | 2.64 |
| Robust04InstructionRetrieval | 지시문 반영 검색 | -0.44 |
| WikipediaRerankingMultilingual | reranking | 93.25 |
| AlloprofReranking | reranking | 84.16 |
| VoyageMMarcoReranking | reranking | 71.89 |
| WebLINXCandidatesReranking | reranking | 19.01 |
| STS15 | 문장 유사도 | 90.67 |
| STS13 | 문장 유사도 | 89.69 |
| FinParaSTS | 문장 유사도 | 32.37 |
| NepaliNewsClassification | 분류 | 97.98 |
| DBpediaClassification | 분류 | 93.83 |
| KorSarcasmClassification | 분류 | 64.39 |
| KorHateSpeechMLClassification | 분류 | 26.39 |
| MultiEURLEXMultilabelClassification | 다중 레이블 분류 | 4.70 |
| StackExchangeClustering.v2 | 군집화 | 92.18 |
| WikiClusteringP2P.v2 | 군집화 | 28.51 |
| SpartQA | 공간 추론 | 8.74 |
| TempReasonL1 | 시간 추론 | 7.77 |
같은 유형 안에서도 편차가 크다는 점이 눈에 띈다. 다국어 문장 짝짓기는 대부분 90점대지만 BibleNLPBitextMining은 34.09에 머물고, 검색 유형도 99.19에서 25.68까지 벌어진다. 유형 평균만 보면 이런 분포가 가려진다.
한국어 과제는 두 개가 등재되어 있고 둘 사이 차이가 38.00%p다. KorSarcasmClassification은 64.39, KorHateSpeechMLClassification은 26.39다. 후자는 다중 레이블 분류 과제이며, 이 유형의 전체 평균(32.2) 자체가 낮은 구간에 속한다.
MTEB Code 쪽은 12개 과제가 전부 공개되어 있어 표 하나로 옮겨 둘 수 있다.
| 과제 | 점수 |
|---|---|
| AppsRetrieval | 98.60 |
| StackOverflowQA | 97.89 |
| CodeSearchNetCCRetrieval | 96.25 |
| CodeTransOceanContest | 93.19 |
| CodeSearchNetRetrieval | 92.96 |
| CodeFeedbackMT | 92.30 |
| CodeEditSearchRetrieval | 91.94 |
| COIRCodeSearchNetRetrieval | 91.90 |
| CodeFeedbackST | 88.59 |
| SyntheticText2SQL | 78.11 |
| CosQA | 52.05 |
| CodeTransOceanDL | 33.72 |
12개 과제 점수의 산술 평균은 83.96으로 본문의 84.0과 일치한다. 여기서도 분포는 고르지 않다. 상위 8개 과제가 88점을 넘는 반면 CosQA는 52.05, CodeTransOceanDL은 33.72다. 종합 84.0이라는 숫자는 대부분의 코드 검색 과제에서 매우 높은 성능을 내되 두 과제에서 크게 뒤처지는 분포의 평균이다.
한계
저자가 밝힌 한계
논문에 Limitations 절이 없다. §6 Future Work와 §7 Conclusion만 있으며, 한계에 해당하는 언급은 본문 여기저기에 흩어져 있다.
- multi-task 설정의 sampling rate와 배치 크기에 modality 균형이 민감하다.
- in-domain 데이터를 좁게 추가하면 out-of-domain 과제 성능이 소폭 내려간다.
저자가 제시한 향후 방향은 세 가지다. 검색 시스템의 ranking 같은 신호를 임베딩 학습에 흡수하는 것, agentic RAG를 겨냥해 다운스트림 RAG 파이프라인과 함께 임베딩을 end-to-end로 fine-tuning하는 것, interleaved multimodal 응용에 맞는 새 평가 프레임워크를 학계에 요청하는 것이다. 세 번째 항목은 현재 벤치마크가 이 모델의 핵심 기능인 interleaved 입력을 제대로 재지 못한다는 자기 진단이기도 하다.
자료에서 확인되는 공백
| 항목 | 상태 |
|---|---|
| 모델 크기와 파라미터 수 | 비공개 |
| 사용한 Gemini 변형 | 비공개 (참고문헌은 Gemini 2.5 기술 보고서를 가리킨다) |
| 학습 연산량과 데이터 규모 | 비공개 |
| temperature τ, 배치 크기, sampling rate 실제 값 | 비공개 |
| 추론 지연시간과 서빙 비용 | 논문에 측정값 없음 |
| ViDoRe V2 열세의 원인 분석 | 없음 |
| Instruction Retrieval 하락(5.2에서 2.9)의 설명 | 없음 |
외부에서 이 모델을 재현할 수 없다는 것이 이 목록의 결론이다. 임베딩 차원과 벤치마크 점수만 공개되어 있어, 비용 대비 성능을 따져 도입을 판단하려면 API 실측이 따로 필요하다.
자료 내적 모순
같은 논문이 같은 값을 다르게 적는 지점이 여럿 있다. 삭제하지 않고 기록해 둔다.
| 항목 | 값 A | 값 B | 비고 |
|---|---|---|---|
| YouCook2 NDCG@10 | Table 1의 52.5 | Figure 3의 FT 막대와 Table 6 baseline의 55.9 | 3.4점 차이로 가장 크다 |
| Vatex NDCG@10 | Table 1의 68.8 | Figure 3와 Table 6의 69.2 | |
| MSR-VTT NDCG@10 | Table 1의 68.0 | Figure 3와 Table 6의 68.2 | |
| DOCCI I2T R@1 | Table 1의 91.3 | Figure 3의 91.2 | |
| DOCCI T2I R@1 | Table 1의 93.4 | Figure 3의 93.1 | |
| 선행 모델 MTEB Mean (Task) | 본문의 68.32 | Table 2의 68.4 | 반올림 차이 |
| MMTEB 과제 유형 수 | 본문이 나열한 10개 | Table 2의 9개 행 | Summarization이 표에서 빠졌다 |
| Table 5의 souping 여부 | 캡션은 souping 제외라고 적는다 | 합성 데이터 사용 행의 92.3, 88.6, 78.1이 최종 모델 전체 결과인 Table 8의 92.30, 88.59, 78.11과 일치한다 | |
| 문서 날짜 | 첫 줄의 2026-5-27 | arXiv 등록 표시 2026-05-26 | |
| MSR-VTT 참고문헌 | Table 1과 §1은 [10] | §4.1은 [39] | 같은 논문이 두 번 등재되어 있다 |
| GUIEC 참고문헌 | Table 1은 [28] (Google 블로그) | §4.1은 [38] (Kaggle 대회 페이지) |
비디오 지표의 어긋남은 Table 1이 souping을 포함한 최종 모델이고 Figure 3와 Table 6이 souping 이전 FT 체크포인트일 가능성이 있으나, 논문은 그 구분을 명시하지 않는다.
도입 판단에서 남는 질문
저자들이 결론에서 내세우는 실무적 장점은 과제별 지시문을 만들 필요가 없다는 것이다. 지시문 설계와 유지에 드는 비용이 사라지고, 하나의 통합된 latent space가 서로 다른 자료 사이를 오가는 검색을 가능하게 한다는 서술이다.
그러나 도입을 판단하려면 이 논문에 없는 정보가 필요하다.
| 판단 항목 | 논문이 답하는가 | 대안 |
|---|---|---|
| 검색 품질 | 답한다. 위 표에 정리한 12개 벤치마크 묶음의 점수가 공개되어 있다 | 해당 없음 |
| 인덱스 크기 조절 | 답한다. MRL로 768, 1,536, 3,072차원 선택이 가능하다 | 해당 없음 |
| 임베딩 생성 비용 | 답하지 않는다 | API 실측이 필요하다 |
| 검색 지연시간 | 답하지 않는다 | API 실측이 필요하다 |
| 자체 호스팅 가능 여부 | 답하지 않는다. 모델 크기와 가중치 공개 여부에 대한 언급이 없다 | 해당 없음 |
| 도메인 fine-tuning 가능 여부 | 답하지 않는다 | 향후 과제 항목에 end-to-end fine-tuning이 언급되어 있을 뿐이다 |
이 논문은 품질 근거는 충분히 제시하되 운영 비용 근거는 제시하지 않는다. 특히 Instruction Retrieval 유형에서 2.9에 그친 점은 지시문 없이 쓰는 설계가 모든 과제에서 이득이 아님을 보여 준다. 지시문의 의도를 순위에 반영해야 하는 검색이라면 임베딩 단독으로는 부족하고 reranking 같은 후처리가 따로 필요하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| native multimodal embedding | modality별 인코더 없이 단일 backbone이 모든 modality와 그 조합을 직접 임베딩하는 방식 |
| late-fusion (dual-tower) | CLIP과 ALIGN처럼 modality별 인코더가 따로 임베딩한 뒤 contrastive 손실로 정렬하는 방식. mixed-modality 입력 처리가 약하다 |
| MRL (Matryoshka Representation Learning) | 임베딩 벡터의 앞부분 부분 차원들을 동시에 학습 가능한 표현으로 만드는 기법. 차원을 잘라 써도 품질이 유지된다 |
| PFT (Pre-Fine-Tuning) | 자기회귀 생성에서 인코딩으로 파라미터를 적응시키는 1차 학습 단계. 잡음 섞인 대량 데이터와 큰 배치를 쓴다 |
| model soup | 여러 fine-tuning 체크포인트의 가중치를 평균해 일반화를 얻는 기법 |
| ASR cascade | 오디오를 ASR로 텍스트로 바꾼 뒤 텍스트를 임베딩하는 파이프라인. 오류 전파가 약점이다 |
관련 페이지
- Your Embedding Model is SMARTer Than You Think: 같은 문제를 반대 방향에서 푼다. Gemini Embedding 2가 단일 벡터의 표현력 자체를 키우는 쪽이라면, SMART는 이미 학습된 임베딩 모델에 late-interaction을 결합해 재학습 없이 성능을 끌어올린다. 두 페이지를 함께 읽으면 임베딩 품질을 모델에서 얻을지 검색 방식에서 얻을지의 선택지가 드러난다.
- PixelRAG: 문서를 텍스트로 변환하지 않고 이미지 그대로 검색하는 접근이다. Gemini Embedding 2가 ViDoRe V2에서 페이지 단위 시각 구조를 다루는 문제와 겹치며, 이 논문이 native audio로 ASR 경유를 없앤 논리를 문서 쪽에 적용한 사례로 볼 수 있다.
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩 인덱스 자체를 쓰지 않는 대조 접근이다. 이 논문이 더 좋은 임베딩으로 retrieval을 개선하는 동안, Direct Corpus Interaction은 임베딩을 걷어내고 에이전트가 코퍼스를 직접 탐색하게 한다. Instruction Retrieval 유형에서 2.9에 그친 이 모델의 결과가 그 주장에 힘을 싣는 근거로 읽힌다.
- RAG-Anything: All-in-One RAG Framework: multimodal RAG 파이프라인 쪽 자료다. RAG-Anything이 modality별 처리와 하이브리드 retrieval로 풀던 문제를 Gemini Embedding 2는 임베딩 계층에서 흡수하려 한다.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): 텍스트 전용 graph RAG. 임베딩 교체가 다국어와 코드 도메인의 검색 품질에 어떻게 반영되는지 비교하는 참고점이다.