Database · PAPER · 2025
RAG-Anything: All-in-One RAG Framework
요약
RAG-Anything은 이미지와 표와 수식을 텍스트와 같은 등급의 지식 단위로 다루는 통합 multimodal RAG 프레임워크다. 홍콩대학교 연구진이 2025년 10월 arXiv에 공개했고(2510.12323), 구현체는 HKUDS/RAG-Anything으로 열려 있다.
기존 RAG는 지식 저장소가 평문 텍스트로만 이루어져 있다고 가정한다. 실제 문서는 그렇지 않다. 논문의 출발점은 이 가정과 현실의 어긋남이며, 해법은 두 가지다. 하나는 비텍스트 자료를 자체 노드로 삼는 그래프와 텍스트에서 뽑은 그래프를 따로 만든 뒤 병합하는 dual-graph construction이고, 다른 하나는 그래프 구조 탐색과 임베딩 유사도 검색을 병렬로 수행하는 cross-modal hybrid retrieval이다.
성능은 두 개의 장문 문서 QA 벤치마크로 검증했다. DocBench 전체 정확도 63.4%로 MMGraphRAG(61.0%), LightRAG(58.4%), GPT-4o-mini(51.2%)를 앞섰고, MMLongBench에서도 42.8%로 세 baseline(38.9%, 37.7%, 33.5%)을 앞섰다. 격차는 문서가 길수록 커져 100페이지가 넘는 구간에서는 MMGraphRAG와 13%p 이상 벌어진다. Ablation은 성능 향상의 대부분이 reranking이 아니라 그래프 구축에서 온다는 것을 보인다.
배경
텍스트 전용 RAG가 놓치는 것
RAG는 LLM이 학습 시점에 고정된 지식의 경계를 넘도록 외부 지식을 추론 시점에 가져오는 방식이다. 논문은 이 방식이 지식 저장소를 평문 텍스트 문서의 모음으로 가정한다는 점을 문제로 짚는다.
현실의 문서는 텍스트, 시각 요소, 구조화 표, 수식이 섞여 있다. 텍스트만 다루는 시스템은 비텍스트 정보를 버리거나 부실한 텍스트 근사로 평탄화하는 두 가지 선택지밖에 갖지 못한다.
논문은 손실이 특히 큰 세 영역을 든다. 과학 연구는 실험 결과를 그래프와 도해와 통계 시각화로 전달하고, 금융 분석은 시장 차트와 상관 행렬과 실적 표에 통찰을 담으며, 의학 문헌 분석은 영상 이미지와 진단 차트와 임상 데이터 표에 의존한다. 세 영역 모두 핵심 정보가 비텍스트 형식에만 존재하고 평문 변환에 저항한다.
가장 단순한 해법은 모든 비텍스트 내용을 텍스트 서술로 바꾸는 것이다. 논문은 이 방식이 심각한 정보 손실을 낳는다고 본다. 차트와 도해와 공간 배치가 담은 의미의 밀도는 텍스트만으로 담을 수 없기 때문이다. 따라서 필요한 것은 변환이 아니라 모달리티 복잡성을 그대로 다루면서 각 유형이 담은 정보를 온전히 보존하는 구성 요소라는 것이 논문의 판단이다.
저자가 정의한 세 가지 기술 과제
논문은 multimodal RAG를 텍스트 전용 RAG보다 어렵게 만드는 요인을 세 가지로 나눈다. 이 구분이 뒤에 나올 설계와 일대일로 대응하므로 먼저 확인해 두면 방법 절을 읽기 쉽다.
| 과제 | 내용 | 요구되는 것 | 논문의 대응 |
|---|---|---|---|
| Unified Multimodal Representation | 서로 다른 정보 유형을 고유 특성과 상호 관계를 잃지 않은 채 통합해야 한다 | 모달리티 내부 의존성과 모달리티 사이 의존성을 함께 담는 인코더 | Multimodal Knowledge Unification |
| Structure-Aware Decomposition | 복잡한 레이아웃을 공간적, 계층적 관계를 유지한 채 파싱해야 한다 | 문서 구조를 해석하고 요소의 위치 맥락을 보존하는 파서 | 모달리티별 전용 파서와 atomic content unit 추상화 |
| Cross-Modal Retrieval | 모달리티 사이를 오가며 그 연결 위에서 추론하는 검색이 필요하다 | 텍스트와 이미지와 구조화 데이터의 의미 대응을 이해하는 정렬 체계 | Cross-Modal Hybrid Retrieval |
세 과제는 문서가 길어질수록 증폭된다. 근거가 여러 모달리티와 여러 절에 흩어져 있으면 이질적 정보원 사이의 조율된 추론이 필요해지기 때문이다. 논문이 장문 문서 성능을 핵심 검증 항목으로 삼은 이유가 여기에 있다.
핵심 개념
atomic content unit은 문서를 분해한 모달리티 일관 최소 단위를 말한다. 각 지식 원본 k_i는 {c_j = (t_j, x_j)} 열로 분해되며, t_j가 text, image, table, equation 같은 모달리티 유형이고 x_j가 그 단위의 원본 내용이다. 이 추상화 덕분에 PPT와 PDF와 XLS가 같은 처리 경로를 탄다.
anchor node는 비텍스트 단위 하나를 대표하는 그래프 노드다. 논문 표기로 v_mm_j이며, 그 단위 안에서 추출된 세부 entity들이 이 노드에 belongs_to 엣지로 묶인다. 표 하나가 노드 하나로 축약되는 것이 아니라, 표를 대표하는 노드 아래에 행 헤더와 열 헤더와 셀과 단위가 각각 노드로 달리는 구조다.
dual-graph construction은 비텍스트 자료에서 만든 그래프와 텍스트에서 만든 그래프를 따로 구축한 뒤 병합하는 전략이다. 논문은 처음부터 단일 통합 그래프를 만들면 모달리티 고유의 구조 신호를 놓칠 위험이 있다고 설명한다.
dereferencing은 검색된 multimodal chunk의 텍스트 대리 표현을 원본 시각 자료로 되돌리는 과정이다. 검색은 텍스트 임베딩 공간에서 값싸게 하고, 생성 시점에는 원본 이미지를 VLM에 직접 입력해 해석 충실도를 확보하는 분업이다.
**모달리티 선호(modality preference)**는 질의의 어휘에서 추론한 신호다. 질의에 "figure", "chart", "table", "equation" 같은 단어가 있으면 관련 정보가 어느 모달리티에 있을지에 대한 명시적 단서가 된다는 것이 논문의 관찰이다.
방법
전체 흐름
RAG-Anything은 세 단계로 구성된다. 이질적 multimodal 지식을 위한 범용 인덱싱, cross-modal 적응 검색, 지식을 반영한 응답 생성이다.
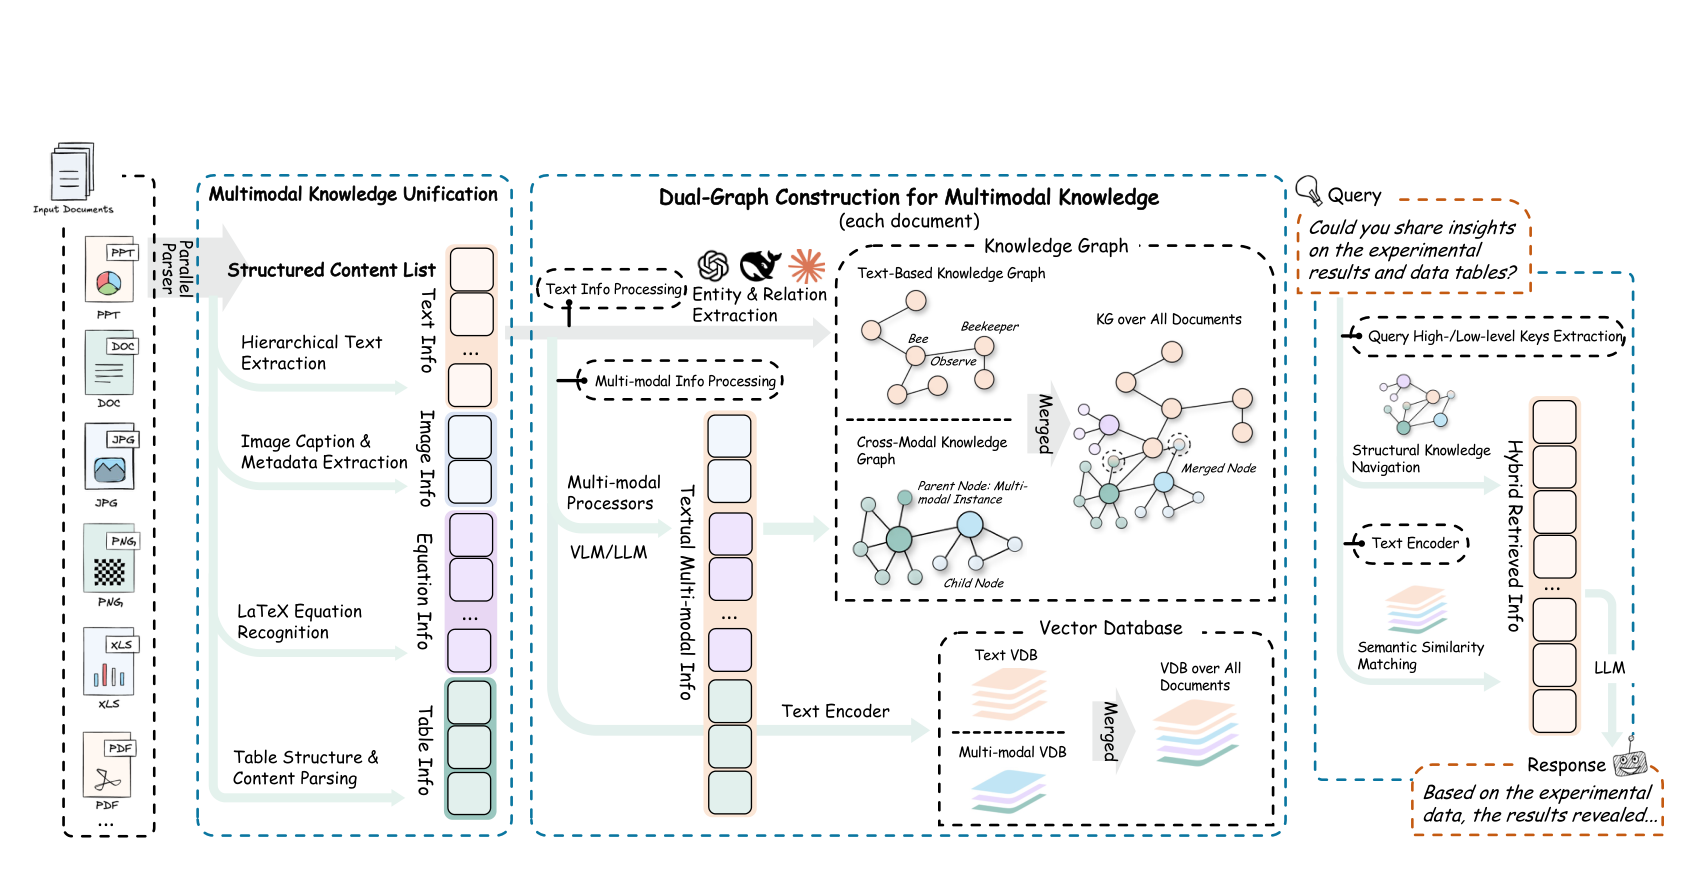
Figure 1의 왼쪽이 문서 분해, 가운데가 그래프 구축과 인덱스 생성, 오른쪽이 질의 처리다. 입력 포맷으로 PPT, DOC, JPG, PNG, XLS, PDF가 나열되어 있다.
모달리티 통합
Parallel Parser가 입력 문서를 atomic content unit 열로 분해한다. 문서를 텍스트 조각으로 자르기만 하는 기존 파이프라인과 달리, 구조적 맥락과 의미 정렬을 보존한 채 분해하는 것이 목표다. 그림은 캡션에, 수식은 주변 정의에, 표는 설명 문단에 결속된 상태를 유지한다.
| 모달리티 | 처리 이름 | 보존되는 정보 |
|---|---|---|
| 텍스트 | Hierarchical Text Extraction | 의미 단위 문단과 목록 항목의 계층 |
| 이미지 | Image Caption & Metadata Extraction | 캡션과 상호 참조 |
| 수식 | LaTeX Equation Recognition | 기호 표현 |
| 표 | Table Structure & Content Parsing | 헤더와 값이 구분된 셀 구조 |
이 정규화가 다양한 파일 포맷을 하나의 처리, 인덱싱, 검색 경로로 흡수한다.
cross-modal knowledge graph
비텍스트 단위 c_j마다 multimodal large language model이 서로 용도가 다른 두 가지 텍스트 표현을 만든다.
| 표현 | 표기 | 용도 |
|---|---|---|
| 상세 서술 | d_chunk_j |
cross-modal retrieval 최적화. 그래프 추출의 입력이기도 하다 |
| entity 요약 | e_entity_j |
그래프 구축용. entity name, type, description을 담는다 |
생성은 컨텍스트를 함께 본다. 각 단위를 지역 이웃 C_j = {c_k | |k - j| <= δ}와 함께 처리하며 δ가 컨텍스트 윈도우 크기를 정한다. 이 장치가 있어야 표현이 그 단위의 문서 내 역할을 반영한다는 것이 논문의 설명이다.
그래프 구조는 비텍스트 단위를 anchor로 삼아 만든다. 추출 루틴 R(·)이 d_chunk_j를 읽어 세부 entity 집합 V_j와 관계 집합 E_j를 낸다.
(V_j, E_j) = R(d_chunk_j)Ṽ = {v_mm_j}_j ∪ ⋃_j V_jẼ = ⋃_j E_j ∪ ⋃_j {(u -belongs_to-> v_mm_j) : u ∈ V_j}
즉 노드 집합은 anchor 노드들과 각 단위 내부 entity들의 합집합이고, 엣지 집합은 내부 관계들과 각 내부 entity를 자기 anchor에 잇는 belongs_to 엣지들의 합집합이다. 이 구조가 비텍스트 내용을 주변 텍스트 맥락에 결속시키면서도 모달리티 고유의 grounding을 유지한다.
text-based knowledge graph
t_j = text인 chunk에는 named entity recognition과 relation extraction을 적용해 전통적 그래프를 만든다. 논문은 이 부분을 LightRAG(Guo et al., 2024)와 GraphRAG(Edge et al., 2024)에서 확립된 방법론과 유사한 방식이라고만 밝힌다. 텍스트는 이미 의미 정보가 풍부하므로 multimodal 컨텍스트 통합이 필요 없다는 것이 이 부분을 단순하게 둔 이유다.
두 그래프의 차이를 나란히 보면 dual-graph라는 이름의 의미가 분명해진다.
| 기준 | Cross-Modal KG | Text-Based KG |
|---|---|---|
| 입력 | 이미지, 표, 수식 단위 | 텍스트 chunk |
| 추출 도구 | MLLM이 만든 d_chunk_j에 추출 루틴 적용 |
named entity recognition과 relation extraction |
| 컨텍스트 반영 | 지역 이웃 C_j를 함께 입력 |
필요 없음 |
| 고유 구조 | anchor 노드와 belongs_to 엣지 |
entity와 의미 관계 |
| 담당하는 것 | 모달리티 grounding | 텍스트 의미 연결의 포괄적 확보 |
그래프 병합과 인덱스 생성
두 그래프는 상보적인 측면을 담고 있어 병합했을 때 시각과 텍스트의 연합, 그리고 세밀한 텍스트 관계를 함께 쓸 수 있다.
- Entity Alignment and Graph Fusion: entity name을 1차 매칭 키로 삼아 두 그래프에서 의미가 같은 entity를 찾고 표현을 통합해
G = (V, E)를 만든다. - Dense Representation Generation: 모든 그래프 entity, 관계, 그리고 모달리티를 가리지 않은 atomic content chunk를 인코딩해 임베딩 테이블
T = {emb(s) : s ∈ V ∪ E ∪ {c_j}_j}를 만든다. - 최종 검색 인덱스는 그래프와 임베딩 테이블의 쌍
I = (G, T)다. 구조 표현과 dense vector 공간을 함께 갖는 형태다.
인덱싱 전체는 단계별 산출물로 나눌 수 있다. 각 단계가 앞 단계의 산출물을 입력으로 받는 직선 구조이며, 그래프 구축 단계에서만 두 경로로 나뉘었다가 다시 합쳐진다.
| 단계 | 입력 | 산출물 |
|---|---|---|
| Multimodal Knowledge Unification | 원본 문서 k_i |
atomic content unit 열 {c_j = (t_j, x_j)} |
| Multi-modal Processors | 비텍스트 단위 c_j와 지역 이웃 C_j |
상세 서술 d_chunk_j와 entity 요약 e_entity_j |
| Cross-Modal KG 구축 | d_chunk_j |
anchor 노드 v_mm_j와 내부 entity 및 belongs_to 엣지, 즉 (Ṽ, Ẽ) |
| Text-Based KG 구축 | 텍스트 chunk x_j |
entity와 의미 관계 |
| Entity Alignment and Graph Fusion | 위 두 그래프 | 통합 그래프 G = (V, E) |
| Dense Representation Generation | V, E, 모든 chunk |
임베딩 테이블 T |
| 최종 | G와 T |
검색 인덱스 I = (G, T) |
cross-modal hybrid retrieval
검색은 인덱스 I 위에서 이루어진다. 논문이 기존 방법의 한계로 지목한 것은 단일 모달리티 안의 의미 유사도에만 기대어 시각, 수식, 표, 텍스트 요소 사이의 연결을 포착하지 못한다는 점이다.
검색은 질의 인코딩에서 시작한다. 질의 q에서 어휘 단서와 모달리티 선호를 뽑고, 동시에 인덱싱과 같은 encoder로 통합 임베딩 e_q를 만든다. 같은 encoder를 쓰는 것이 질의 표현과 지식 표현의 일관성을 보장하는 장치다.
그다음 두 경로가 병렬로 동작한다.
| 경로 | 해결하는 문제 | 동작 | 산출 |
|---|---|---|---|
| Structural Knowledge Navigation | 중간 entity를 거쳐 연결된 지식이나 cross-modal 관계를 키워드 검색이 놓친다 | 키워드 매칭과 entity 인식으로 그래프 구성 요소를 찾고, 질의어와의 정확 매칭에서 출발해 지정된 hop 거리 안에서 이웃을 확장한다 | C_stru(q) |
| Semantic Similarity Matching | 구조적으로 직접 연결되어 있지 않지만 의미상 관련된 내용을 구조 탐색이 놓친다 | e_q와 임베딩 테이블 T의 모든 구성 요소 사이에서 dense vector 유사도 검색을 수행한다 |
코사인 유사도 top-k C_seman(q) |
두 경로의 결과는 C(q) = C_stru(q) ∪ C_seman(q)로 모인다. 그대로 합치면 각 경로가 제공하는 서로 다른 근거를 무시하게 되고 중복도 처리하지 못하므로, multi-signal fusion scoring이 세 신호를 결합해 최종 순위 C*(q)를 정한다.
| 신호 | 출처 |
|---|---|
| 구조 중요도 | 그래프 위상 |
| 의미 유사도 | 임베딩 공간의 점수 |
| 모달리티 선호 | 질의 어휘 분석에서 추론 |
논문은 δ, hop 거리, top-k의 k, 그리고 세 신호의 결합 가중치를 수치로 명시하지 않는다.
검색에서 합성으로
합성 단계가 다루는 문제는 시각 의미를 보존하면서 여러 정보원에 걸친 grounding을 유지하는 것이다. 텍스트만 쓰면 시각 정보를 잃고, 단순한 multimodal 방식은 모달리티 통합에 실패한다는 것이 논문의 진단이다.
- 텍스트 컨텍스트 구성: 상위 후보
C*(q)에 속한 구성 요소의 텍스트 표현을 이어 붙인다. entity summary, relationship description, chunk content가 모두 들어가며, 모달리티 유형과 계층 출처를 나타내는 구분자를 사이에 삽입한다. 이 구분자가 있어야 언어 모델이 이질적 지식 요소를 구분해 읽는다. - 시각 내용 복원: 시각 자료에 대응하는 multimodal chunk는 dereferencing으로 원본을 복원해
V*(q)를 만든다. - 통합 생성:
Response = VLM(q, P(q), V*(q))로 질의와 텍스트 컨텍스트와 시각 자료를 함께 조건으로 삼는다.
모달리티별 프롬프트 설계
Appendix A.3은 세 가지 프롬프트를 전문으로 싣는다. 셋 다 {context} 자리에 주변 내용을 함께 입력하고 같은 JSON 구조로 반환받는다는 점이 공통이다. 반환 구조는 detailed_description과 entity_info이고, entity_info는 entity_name, entity_type, 100단어 이내 summary로 구성된다.
| 프롬프트 | 요구하는 분석 항목 | 특기 지시 |
|---|---|---|
| Vision Analysis (Figure 7) | 전체 구도와 배치, 모든 객체와 텍스트와 시각 요소, 요소 사이 관계와 주변 맥락과의 연결, 색과 조명과 시각 양식, 동작, 차트와 도해 같은 기술 요소 | 대명사 대신 항상 고유한 이름을 쓸 것 |
| Table Analysis (Figure 8) | 표 구조와 구성, 열 헤더의 의미, 핵심 데이터와 패턴, 통계적 경향, 데이터 요소 사이 관계, 주변 맥락에서의 의의 | 일반적 지칭 대신 항상 구체적 이름과 값을 쓸 것 |
| Equation Analysis (Figure 9) | 수학적 의미와 해석, 주변 맥락에서의 변수 정의, 사용된 연산과 함수, 적용 도메인, 물리적이거나 이론적인 의의, 다른 수식과의 관계, 실제 활용 | 항상 정확한 수학 용어를 쓸 것 |
세 프롬프트가 공통으로 요구하는 것은 대상 자체의 서술이 아니라 주변 내용과의 연결이다. 이 설계가 앞에서 본 컨텍스트 윈도우 δ와 짝을 이룬다.
실험 설정
벤치마크
평가는 두 개의 multimodal 문서 QA 벤치마크로 수행했다.
| 벤치마크 | 문서 수 | 평균 페이지 | 평균 토큰 | 문서 유형 수 | 질문 수 |
|---|---|---|---|---|---|
| DocBench (Zou et al., 2024) | 229 | 66 | 46,377 | 5 | 1,102 |
| MMLongBench (Ma et al., 2024) | 135 | 47.5 | 21,214 | 7 | 1,082 |
DocBench의 다섯 도메인은 Academia, Finance, Government, Laws, News이고 질문은 전문가가 작성했다. 평균 4만 6천여 토큰이라는 규모가 장문 이해 난이도를 만든다. MMLongBench는 장문 multimodal 문서 이해에 초점을 둔 벤치마크로 7개 유형에 걸쳐 전문가가 주석한 1,082개 질문을 담는다.
문서 유형별 분포
Appendix A.1은 유형별 세부 통계를 제공한다. 평균 페이지 수의 편차가 크다는 점이 두 벤치마크의 성격을 보여준다.
DocBench:
| 유형 | Acad. | Fin. | Gov. | Law. | News |
|---|---|---|---|---|---|
| 문서 수 | 49 | 40 | 44 | 46 | 50 |
| 질문 수 | 303 | 288 | 148 | 191 | 172 |
| 평균 페이지 | 11 | 192 | 69 | 58 | 1 |
MMLongBench:
| 유형 | Res. | Tut. | Acad. | Guid. | Broch. | Admin. | Fin. |
|---|---|---|---|---|---|---|---|
| 문서 수 | 34 | 17 | 26 | 22 | 15 | 10 | 11 |
| 질문 수 | 292 | 138 | 199 | 155 | 100 | 81 | 117 |
| 평균 페이지 | 39 | 58 | 35 | 78 | 30 | 17 | 87 |
DocBench는 금융 보고서가 평균 192페이지로 가장 길고 News가 1페이지짜리 신문 기사라서, 같은 벤치마크 안에서 길이 범위가 매우 넓다. MMLongBench는 연구 보고서와 튜토리얼과 학술 논문이 평균 35페이지에서 58페이지 사이이고 안내서가 약 78페이지이며 금융 보고서가 87페이지로 가장 길다.
baseline
| Baseline | 성격 | 논문이 지적한 한계 |
|---|---|---|
| GPT-4o-mini | 텍스트와 이미지를 함께 이해하는 모델. 128K 토큰 context window로 문서 전체를 직접 처리한다 | 검색 구조 없이 컨텍스트에 모두 담는 방식이다 |
| LightRAG (Guo et al., 2024) | 구조화 지식 표현과 dual-level retrieval을 결합한 graph 기반 RAG | 텍스트 전용 처리로 제한된다 |
| MMGraphRAG (Wan & Yu, 2025) | 텍스트와 시각 내용을 아우르는 통합 KG를 만들고, multimodal entity 분석에 spectral clustering을 쓰며 추론 경로를 따라 컨텍스트를 검색한다 | 기본적인 이미지 처리만 더했을 뿐 표와 수식을 plain text로 취급해 구조 정보를 잃는다 |
구현 설정과 판정 방식
| 항목 | 값 |
|---|---|
| backbone LLM (모든 baseline 공통) | GPT-4o-mini |
| 문서 파서 | MinerU (Wang et al., 2024) |
| 임베딩 모델 | text-embedding-3-large, 3072차원 |
| reranker | bge-reranker-v2-m3 |
| entity와 relation 합산 토큰 한도 | 20,000 토큰 |
| chunk 토큰 한도 | 12,000 토큰 |
| 출력 형식 | 한 문장으로 제약 |
| GPT-4o-mini baseline 입력 | 문서를 최대 50페이지까지 144 dpi 이미지로 이어 붙여 입력 |
| 정확도 판정 | GPT-4o-mini judge |
판정 프롬프트(Figure 10)는 정확도를 0 또는 1의 이진값으로 내고 짧은 근거를 함께 JSON으로 반환하게 한다. 판정 지침 가운데 결과 해석에 영향을 주는 항목이 셋 있다. 문체와 형식이 아니라 사실 정합성만 본다는 것, 정답 정보를 담은 채 부가 설명이 붙은 부분 일치는 정확으로 인정한다는 것, 그리고 예상 답이 "Not answerable"이고 생성 답이 답할 수 없다는 취지면 정확으로 처리한다는 것이다. 마지막 항목이 DocBench의 Una. 열이 무엇을 재는지를 규정한다.
결과
DocBench
| Method | Aca. | Fin. | Gov. | Law. | News | Txt. | Mm. | Una. | Overall |
|---|---|---|---|---|---|---|---|---|---|
| GPT-4o-mini | 40.3 | 46.9 | 60.3 | 59.2 | 61.0 | 61.0 | 43.8 | 49.6 | 51.2 |
| LightRAG | 53.8 | 56.2 | 59.5 | 61.8 | 65.7 | 85.0 | 59.7 | 46.8 | 58.4 |
| MMGraphRAG | 64.3 | 52.8 | 64.9 | 40.0 | 61.5 | 67.6 | 66.0 | 60.5 | 61.0 |
| RAG-Anything | 61.4 | 67.0 | 61.5 | 60.2 | 66.3 | 85.0 | 76.3 | 46.0 | 63.4 |
전체 정확도는 RAG-Anything이 63.4%로 가장 높다. 다만 우위가 전 항목에 걸친 것은 아니라서, 세부 항목의 1위는 다음처럼 갈린다.
| 항목 | 1위 | 값 | RAG-Anything |
|---|---|---|---|
| Aca. | MMGraphRAG | 64.3 | 61.4 |
| Fin. | RAG-Anything | 67.0 | 67.0 |
| Gov. | MMGraphRAG | 64.9 | 61.5 |
| Law. | LightRAG | 61.8 | 60.2 |
| News | RAG-Anything | 66.3 | 66.3 |
| Txt. (텍스트 전용 질문) | LightRAG와 동률 | 85.0 | 85.0 |
| Mm. (멀티모달 질문) | RAG-Anything | 76.3 | 76.3 |
| Una. (답할 수 없는 질문) | MMGraphRAG | 60.5 | 46.0 |
멀티모달 질문에서 76.3%로 2위 MMGraphRAG의 66.0%를 10.3%p 앞선 것이 전체 우위를 만든 주된 요인이다. 반대로 답할 수 없는 질문 항목의 46.0%는 네 방법 중 가장 낮다. 질의에 대한 근거를 그래프에서 잘 찾아내는 성질이 "근거가 없다"고 판단해야 하는 상황에서는 불리하게 작용한 것으로 읽히지만, 논문은 이 항목을 따로 논의하지 않는다.
질문 유형별 정리
DocBench는 도메인 외에 질문 유형으로도 결과를 나눈다. 세 유형을 따로 보면 각 방법의 성격 차이가 도메인 표보다 선명하게 드러난다.
| 질문 유형 | GPT-4o-mini | LightRAG | MMGraphRAG | RAG-Anything | 읽는 법 |
|---|---|---|---|---|---|
| Txt. 텍스트 전용 | 61.0 | 85.0 | 67.6 | 85.0 | 텍스트만으로 답할 수 있는 질문에서는 그래프 기반 텍스트 검색이 이미 상한에 가깝고 RAG-Anything이 LightRAG와 동률이다 |
| Mm. 멀티모달 | 43.8 | 59.7 | 66.0 | 76.3 | 이미지와 표를 봐야 하는 질문에서 방법 사이 격차가 가장 크다. RAG-Anything이 2위를 10.3%p 앞선다 |
| Una. 답할 수 없음 | 49.6 | 46.8 | 60.5 | 46.0 | 근거가 없다고 판단해야 하는 질문에서는 RAG-Anything이 가장 낮다 |
세 줄을 함께 보면 RAG-Anything의 전체 우위가 어디에서 왔는지 분명해진다. 텍스트 전용 질문은 LightRAG 수준을 유지하면서 멀티모달 질문에서만 큰 폭으로 앞서는 형태다. 반면 답할 수 없는 질문 항목은 MMGraphRAG보다 14.5%p 낮아, 근거를 적극적으로 찾아내는 설계가 이 항목에서는 역방향으로 작용한 것으로 보인다. 논문은 이 항목을 별도로 논의하지 않는다.
MMLongBench
| Method | Res. | Tut. | Acad. | Guid. | Broch. | Admin. | Fin. | Overall |
|---|---|---|---|---|---|---|---|---|
| GPT-4o-mini | 35.5 | 44.0 | 24.6 | 33.1 | 29.5 | 46.8 | 31.1 | 33.5 |
| LightRAG | 40.8 | 34.1 | 36.2 | 39.4 | 41.0 | 44.4 | 38.3 | 38.9 |
| MMGraphRAG | 40.8 | 36.5 | 35.7 | 35.8 | 28.2 | 46.9 | 38.5 | 37.7 |
| RAG-Anything | 46.6 | 43.5 | 38.7 | 43.9 | 34.0 | 45.7 | 43.6 | 42.8 |
전체 42.8%로 1위이고, 저자가 강조하는 것은 정보 밀도가 높은 Research Reports(46.6%)와 Financial Reports(43.6%)에서 가장 높은 값을 얻었다는 점이다. 여기서도 Tut.은 GPT-4o-mini(44.0%), Broch.는 LightRAG(41.0%), Admin.은 MMGraphRAG(46.9%)가 1위다. 세 항목 모두 문서가 짧은 유형(브로슈어 평균 30페이지, 행정 문서 평균 17페이지)이라는 공통점이 있다.
MMLongBench 전체에서 MMGraphRAG(37.7%)가 LightRAG(38.9%)보다 낮다는 점도 눈에 띈다. 이미지 처리를 더한 것만으로는 이득이 보장되지 않는다는 뜻이며, 표와 수식까지 구조로 다루어야 한다는 논문의 주장과 방향이 같다.
문서 길이별 성능
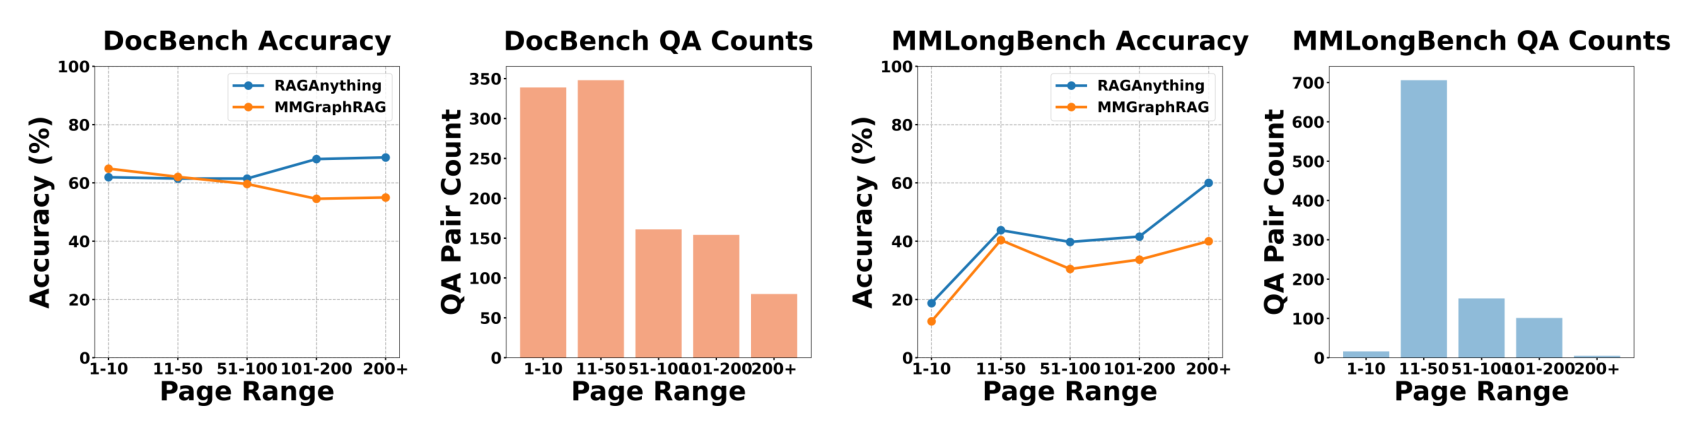
Figure 2는 두 벤치마크 각각에 대해 정확도 선 그래프와 QA 쌍 개수 막대 그래프를 나란히 놓는다. 정확도 비교 대상은 MMGraphRAG 하나다.
| 벤치마크 | 구간 | RAG-Anything | MMGraphRAG | 차이 |
|---|---|---|---|---|
| DocBench | 101~200 페이지 | 68.2% | 54.6% | 13.6%p |
| DocBench | 200페이지 초과 | 68.8% | 55.0% | 13.8%p |
| MMLongBench | 11~50 페이지 | 값 미공개 | 값 미공개 | 3.4%p |
| MMLongBench | 51~100 페이지 | 값 미공개 | 값 미공개 | 9.3%p |
| MMLongBench | 101~200 페이지 | 값 미공개 | 값 미공개 | 7.9%p |
짧은 문서에서는 두 방법이 비슷하고 길이가 늘수록 격차가 커진다는 것이 저자의 관찰이다. 저자가 제시한 설명은 dual-graph가 페이지를 넘나드는 entity 정렬을 제공하고, 구조 탐색과 의미 검색의 결합이 흩어진 multimodal 근거를 모은다는 것이다.
이 결과를 읽을 때 함께 볼 것이 QA 쌍 개수 막대다. DocBench는 110페이지 약 340개, 1150페이지 약 350개, 51100페이지 약 160개, 101200페이지 약 155개, 200페이지 초과 약 80개로 분포한다. MMLongBench는 11~50페이지 구간에 약 700개가 몰려 있고 200페이지 초과 구간은 거의 비어 있다. 가장 큰 격차가 나타나는 구간이 표본이 가장 적은 구간이기도 하다는 점은 결과 해석의 폭을 좁힌다.
ablation
| 변형 | Aca. | Fin. | Gov. | Law. | News | Txt. | Mm. | Una. | Overall |
|---|---|---|---|---|---|---|---|---|---|
| Chunk-only | 55.8 | 61.5 | 60.1 | 60.7 | 64.0 | 81.6 | 66.2 | 43.5 | 60.0 |
| w/o Reranker | 60.9 | 63.5 | 58.8 | 60.2 | 68.6 | 81.7 | 74.7 | 45.4 | 62.4 |
| RAG-Anything | 61.4 | 67.0 | 61.5 | 60.2 | 66.3 | 85.0 | 76.3 | 46.0 | 63.4 |
Chunk-only는 dual-graph construction을 건너뛰고 전통적 chunk 검색만 쓰는 변형이고, w/o Reranker는 cross-modal reranking만 제거하고 그래프 구조는 유지한 변형이다. 두 변형을 순서대로 보면 각 구성 요소의 기여를 분리할 수 있다.
| 구성 요소 | 기여 | 산출 근거 |
|---|---|---|
| 그래프 구축 | 2.4%p | w/o Reranker 62.4% 빼기 Chunk-only 60.0% |
| cross-modal reranking | 1.0%p | 전체 모델 63.4% 빼기 w/o Reranker 62.4% |
저자의 결론은 그래프 구축이 필수이고 reranking의 개선폭은 작다는 것이다. 세부 항목을 보면 이 차이가 더 뚜렷하다. 멀티모달 질문(Mm.) 항목은 Chunk-only 66.2%에서 전체 모델 76.3%로 10.1%p 오르는데, 이는 전체 상승폭 3.4%p의 세 배에 가깝다. 그래프가 기여하는 부분이 멀티모달 근거를 찾는 능력에 집중되어 있다는 뜻이다. 반면 News 항목은 w/o Reranker가 68.6%로 전체 모델의 66.3%보다 높아, reranking이 모든 도메인에서 이득을 주지는 않는다.
사례 연구
논문은 본문에서 DocBench의 두 사례를 상세히 다룬다. 두 사례 모두 baseline이 표면적 텍스트 단서에 의존하거나 복잡한 시각 요소를 평문으로 평탄화해서 실패하는 반면, RAG-Anything은 모달리티를 반영한 그래프로 관계를 유지한다는 점을 보인다.
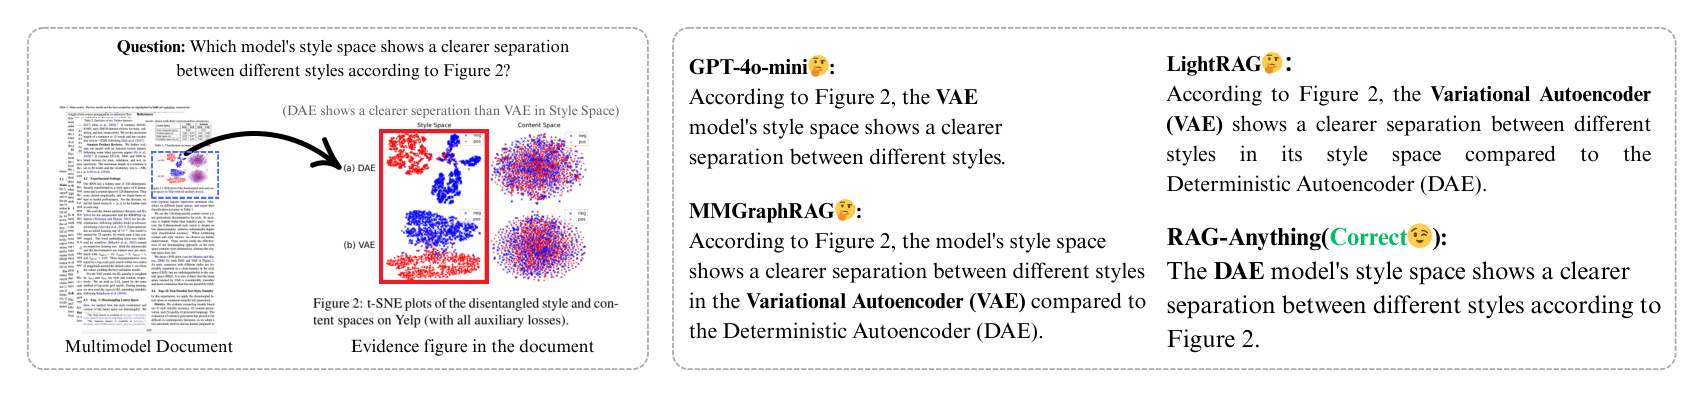
첫 사례는 Yelp 데이터의 t-SNE 그림이다. 질의는 style space에서 서로 다른 style을 더 뚜렷하게 분리하는 모델이 무엇인지 묻는데, 그림에는 style space 패널과 content space 패널이 나란히 놓여 있다. 정답은 DAE이고 GPT-4o-mini와 MMGraphRAG와 LightRAG 셋 다 VAE라고 답했다. RAG-Anything은 패널, 축 제목, 범례, 캡션을 노드로 두는 시각 레이아웃 그래프를 만들고 패널이 특정 플롯을 담는다는 관계, 캡션이 맥락을 제공한다는 관계, 부그림 사이의 계층 관계를 엣지로 표현해 style space 패널에 집중했다.
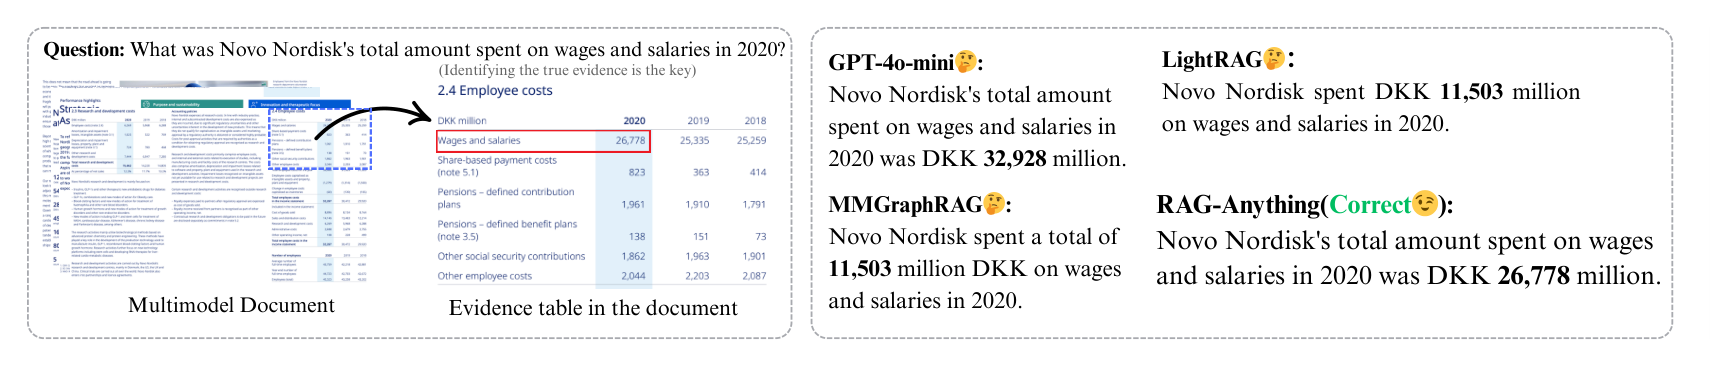
두 번째 사례는 Novo Nordisk의 2020년 임금 총액을 묻는 질의다. 정답은 DKK 26,778백만이다. GPT-4o-mini는 32,928백만, MMGraphRAG와 LightRAG는 둘 다 11,503백만으로 답했다. RAG-Anything은 행 헤더, 열 헤더인 연도, 데이터 셀, 단위를 각각 노드로 두고 row-of, column-of, header-applies-to, unit-of 엣지로 잇는다. 이 구조가 "Share-based payment costs" 같은 인접 항목과의 혼동을 막았다.
저자가 이 두 사례에서 끌어낸 결론은 MMGraphRAG의 실패 원인이 이미지 모달리티 entity만 다루고 표 셀과 행 헤더와 열 헤더 같은 다른 모달리티 entity를 무시하는 데 있다는 것이다.
Appendix A.2는 같은 형식의 사례를 둘 더 싣는다.
| 사례 | 질의 | 정답 | baseline 응답 |
|---|---|---|---|
| Figure 5, 막대 그래프 판독 | Twitter15에서 정확도가 가장 낮은 GCAN sub-model 구성 | -S-A, source tweet embedding과 dual co-attention을 함께 제거한 구성 |
GPT-4o-mini는 dual co-attention만, MMGraphRAG와 LightRAG는 source tweet만 제거한 구성이라고 답했다 |
| Figure 6, 표 탐색 | Evidence Inference 데이터셋에서 AUPRC가 가장 높은 모델 조합 | GloVe + LSTM - Attention, 0.506 | GPT-4o-mini 0.455, MMGraphRAG 0.708, LightRAG 0.429로 모두 오답 |
Figure 5 사례에서 RAG-Anything은 막대와 축 라벨과 범례를 노드로 두고 bar-of, label-applies-to 관계로 이었다. Figure 6 사례의 난점은 같은 행 이름이 여러 데이터셋 구간에서 반복된다는 점이었고, 헤더와 데이터 셀을 row-of와 column-of로 연결한 구조가 Evidence Inference 구간을 정확히 분리했다.
네 사례에 등장한 엣지 유형을 모으면 RAG-Anything이 어떤 종류의 구조를 명시적으로 기록하는지 확인할 수 있다. 논문 본문이 열거한 것만 옮긴다.
| 대상 | 노드 | 엣지 유형 |
|---|---|---|
| 표 | 행 헤더, 열 헤더, 데이터 셀, 단위 | row-of, column-of, header-applies-to, unit-of |
| 막대 그래프 | 막대, 축 라벨, 범례 | bar-of, label-applies-to |
| 다중 패널 그림 | 패널, 축 제목, 범례, 캡션 | 패널이 플롯을 담는 관계, 캡션이 맥락을 제공하는 관계, 부그림 사이의 계층 관계 |
이 목록이 MMGraphRAG와의 차이를 설명한다. MMGraphRAG는 이미지 모달리티 entity만 다루므로 표 셀과 행 헤더와 열 헤더에 해당하는 노드 자체가 없고, 그래서 표 질의에서 구조적 모호성을 해소하지 못한다.
한계
저자가 밝힌 두 가지 실패 유형
Appendix A.5는 실패 사례를 체계적으로 분석해 두 가지 구조적 문제를 제시한다. 저자는 이를 예외적 사례가 아니라 현재 multimodal RAG 구조가 공유하는 근본 문제로 규정한다.
| 실패 유형 | 증상 | 저자의 진단 |
|---|---|---|
| Text-Centric Retrieval Bias | 질의가 명시적으로 시각 정보를 요구해도 텍스트 자료를 우선 검색한다. 시각 내용에 정확한 키워드가 없을 때 특히 두드러진다 | cross-modal attention의 근본적 취약점 |
| Rigid Spatial Processing | 위에서 아래로, 왼쪽에서 오른쪽으로 훑는 순서를 기본값으로 삼아 비표준 레이아웃에 적응하지 못한다 | 문서 맥락이나 질의 의도와 무관하게 공간 해석이 고정되어 있다 |
첫 번째 문제에는 세밀도 불일치가 겹친다. 검색된 텍스트는 주제상 관련이 있어도 시각 자료와 정보의 세밀도 수준이 다르다. 이미지는 정확한 수치나 세부 도해나 공간 관계를 담는데 대응 텍스트는 대체로 일반적이고 개념적인 서술이라, 시스템이 서로 맞지 않는 상세도를 조화시키려다 오히려 잘못된 방향으로 이끌린다.
두 번째 문제의 구체적 형태는 문서마다 다르다. 표는 열 방향 해석이 필요하고, 기술 도해는 특정 방향 흐름을 따르며, 학술 그림은 예상 밖 위치에 놓인 주석에 핵심 정보를 담기도 한다. 실패 사례에서는 정답이 모델의 기본 처리 순서와 반대 방향으로 시각 요소를 통합해야 얻어지는 것이었다.
논문은 실패 사례를 그림으로도 제시한다. Figure 11은 아래에서 위로 읽어야 하는 NER 구조도를 다루는데 네 방법 모두 순서를 잘못 읽었다. Figure 12는 표 구조 자체가 모호한 사례다.
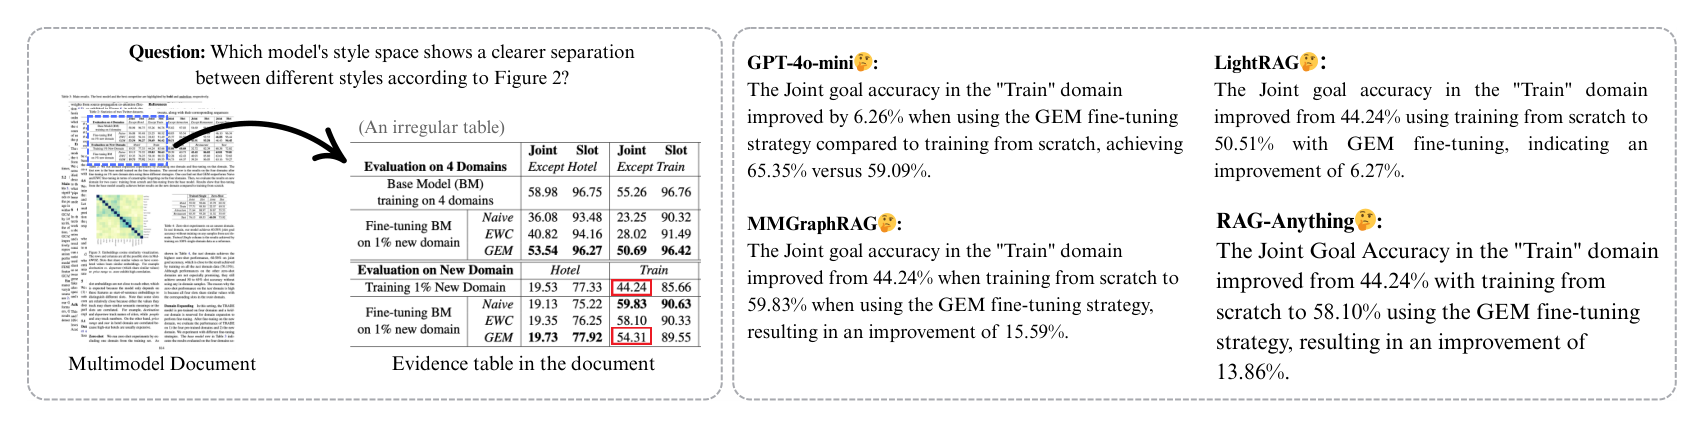
Figure 12의 표는 GEM 행에 전용 셀 경계가 없고 Joint 열과 Slot 열이 명확한 구분 없이 병합되어 있다. 네 방법 모두 GEM fine-tuning 적용 시 Train 도메인 Joint goal accuracy를 잘못 읽었고, 정답으로 표시된 값은 44.24%에서 54.31%로의 변화다. 저자는 이 사례에서 layout-aware parsing 강화와 시각 처리 능력 통합이라는 두 방향을 제시한다.
논문이 측정하지 않은 항목
저자가 명시적으로 한계로 적지는 않았지만, 논문 범위 밖이라서 이 페이지만으로 답할 수 없는 항목이 있다.
| 항목 | 상태 |
|---|---|
| 인덱싱 비용과 시간 | dual-graph 구축은 비텍스트 단위마다 MLLM 호출을 요구하지만 baseline과의 비교 측정이 없다. latency라는 단어가 본문에 나오지 않는다 |
| backbone 다양성 | 모든 실험이 GPT-4o-mini 하나로 통일되어 오픈소스 LLM이나 VLM에서의 재현성은 확인되지 않았다 |
| judge 편향 | 응답 생성과 정확도 판정에 같은 GPT-4o-mini를 쓴다. 판정 일관성은 근거로 제시되지만 self-judge 편향 검토는 없다 |
| 평가 형식 | 두 벤치마크 모두 정답이 있는 QA 쌍 기반이고 출력이 한 문장으로 제약된다. 자유 형식 응답 품질은 범위 밖이다 |
| 하이퍼파라미터 | 컨텍스트 윈도우 δ, hop 거리, top-k의 k, fusion 가중치 산식이 모두 수치로 제시되지 않는다 |
자료 자체의 내적 모순
raw PDF를 대조하는 과정에서 논문 안에서 값이나 표기가 어긋나는 지점이 확인되었다. 삭제하지 않고 기록해 둔다.
| 지점 | 내용 |
|---|---|
| 평균 페이지 수 | Table 1은 DocBench 평균을 66페이지로 적었지만, Table 5의 유형별 문서 수와 평균 페이지로 가중평균을 내면 (49×11 + 40×192 + 44×69 + 46×58 + 50×1) / 229 = 61.0페이지다. MMLongBench는 Table 1이 47.5페이지, Table 6 기준 가중평균이 48.3페이지로 근사한다 |
| Figure 12의 질문 문구 | Figure 12에 적힌 질문은 Figure 3의 질문과 같은 t-SNE style space 문항이다. 그러나 그림 안의 네 응답과 A.5 본문 서술은 모두 GEM fine-tuning의 Joint goal accuracy를 다룬다. 질문 라벨이 잘못 복사된 것으로 보인다 |
| 실패 유형 명칭 | 5절 결론은 두 번째 유형을 "rigid spatial processing patterns"라 부르고, A.5의 요약 항목은 "Document Structure Processing Challenges", 그 아래 Issue 2는 다시 "Rigid Spatial Processing Patterns"로 적는다 |
| 1절 문단 중복 | 도입부에 같은 문장이 document-intensive와 knowledge-intensive만 바꾼 채 두 번 나온다 |
계보와 위치
논문은 4절에서 선행 연구를 두 흐름으로 나눈다. Graph-Enhanced RAG는 GraphRAG(Edge et al., 2024) 이후 두 방향으로 전개되었다고 본다. 하나는 검색 효율을 위해 그래프 구조를 최적화하는 계열로 LightRAG의 희소화 인덱스, GNN-RAG(Mavromatis & Karypis, 2024), HippoRAG(Jimenez Gutierrez et al., 2024)가 여기 속한다. 다른 하나는 다층 추론을 위해 정보를 집계하는 계열로 RAPTOR(Sarthi et al., 2024)와 ArchRAG(Wang et al., 2025)가 해당한다. 저자는 두 계열 모두 텍스트 중심이고 입력이 동질적이라는 한계를 공유한다고 지적하며, RAG-Anything을 GraphRAG를 모든 모달리티로 확장한 작업으로 위치 짓는다.
Multimodal RAG 쪽 선행 연구는 모달리티별 전용 구조에 의존한다는 공통 제약으로 정리한다.
| 선행 연구 | 접근 | 논문이 지적한 한계 |
|---|---|---|
| VideoRAG (Ren et al., 2025) | 비디오 이해를 위한 dual-channel 구조 | 모달리티 특화 구조 의존 |
| MM-VID (Lin et al., 2023) | 비디오를 텍스트로 변환 | 시각 정보 손실 |
| VisRAG (Yu et al., 2025) | 문서 레이아웃을 이미지로 보존 | 세밀한 관계 누락 |
| MMGraphRAG (Wan & Yu, 2025) | scene graph와 텍스트 표현을 연결 | 표와 수식을 plain text로 처리하는 구조적 맹점 |
저자는 이 제약의 근원을 architectural fragmentation으로 지목한다. 모달리티마다 전용 파이프라인이 필요하면 새 모달리티가 등장할 때마다 구조와 융합 방식을 다시 설계해야 하고, 그 과정에서 cross-modal alignment 난이도와 모달리티 편향과 정보 병목이 생긴다는 논지다. RAG-Anything이 내세우는 해법은 모든 모달리티를 같은 방식의 구조 모델링으로 처리하는 통합 그래프 프레임워크다.
인용된 서베이는 Abootorabi et al.(2025)의 multimodal RAG 서베이, Zhang et al.(2025)의 graph RAG 서베이, Bei et al.(2025)의 그래프와 AI 에이전트 taxonomy 세 편이다.
한 가지 주의할 지점이 있다. 이 논문은 GraphRAG를 인용하면서 local search와 global search라는 이원 구성을 언급하지 않는다. 두 이름은 GraphRAG 원논문(Edge et al., 2024)이 아니라 microsoft/graphrag 구현체가 도입한 것이며, 자세한 근거는 GraphRAG: From Local to Global 페이지에 있다. RAG-Anything 논문에는 그 오귀속이 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| atomic content unit | 문서를 분해한 모달리티 일관 최소 단위 c_j = (t_j, x_j). t_j가 모달리티 유형이고 x_j가 원본 내용이다 |
anchor node v_mm_j |
비텍스트 단위 하나를 대표하는 그래프 노드. 그 단위에서 추출된 세부 entity들이 belongs_to 엣지로 이 노드에 묶인다 |
| dual-graph construction | cross-modal KG와 text-based KG를 따로 만든 뒤 entity name 매칭으로 병합하는 전략 |
| multi-signal fusion scoring | 구조 중요도, 의미 유사도, 모달리티 선호 세 신호를 결합해 검색 후보를 재랭킹하는 방식 |
| dereferencing | 검색된 multimodal chunk의 텍스트 대리 표현을 원본 시각 자료로 되돌려 VLM에 직접 입력하는 과정 |
| architectural fragmentation | 모달리티마다 별도 파이프라인을 두는 구조가 낳는 파편화. 논문이 기존 multimodal RAG의 근본 문제로 지목한 개념이다 |
관련 페이지
- HKUDS/RAG-Anything: 이 논문의 오픈소스 구현체 페이지. 설치와 사용 방법, 실제 코드 수준의 파이프라인 구성을 다룬다. 논문이 수식으로 기술한 dual-graph와 hybrid retrieval이 코드에서 어떤 형태인지 확인할 때 함께 읽는다.
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): 같은 연구실의 선행작. RAG-Anything의 text-based KG가 이 계열의 방법론과 유사하다고 논문이 밝힌 대상이며, LightRAG의 학회 게재 정보와 인덱싱 비용 실측치는 이 논문이 아니라 그 페이지가 근거다.
- RAG-Anything 한국어 소개글 (PyTorchKR, 2026): RAG-Anything을 다룬 한국어 소개글. 설치와 코드 예제 중심의 입문 자료이므로, 벤치마크 수치나 방법 세부를 인용할 때는 논문인 이 페이지를 우선한다.
- GraphRAG: From Local to Global: RAG-Anything이 계보의 출발점으로 지목한 GraphRAG 원논문. local search와 global search라는 이원 구성이 원논문이 아니라 공식 구현체의 것이라는 구분도 그 페이지에서 확인할 수 있다.
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): 계층 knowledge graph와 LCA 기반 검색으로 LightRAG를 확장한 연구. RAG-Anything이 모달리티 방향으로 확장했다면 LeanRAG는 추상화 수준 방향으로 확장한 사례여서 비교 대상이 된다.
- Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): LightRAG와 LeanRAG를 함께 다룬 세미나 자료. 그래프 기반 RAG 계열의 논문과 구현 사이 간극을 비판적으로 검토한다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: GraphRAG부터 LightRAG와 RAG-Anything과 LeanRAG까지 묶은 계열 overview. 데이터셋과 judge 설정이 서로 달라 head-to-head 비교가 불가능한 지점을 정리해 두었다.