Physical AI · PAPER · 2025
GR-3 Technical Report
요약
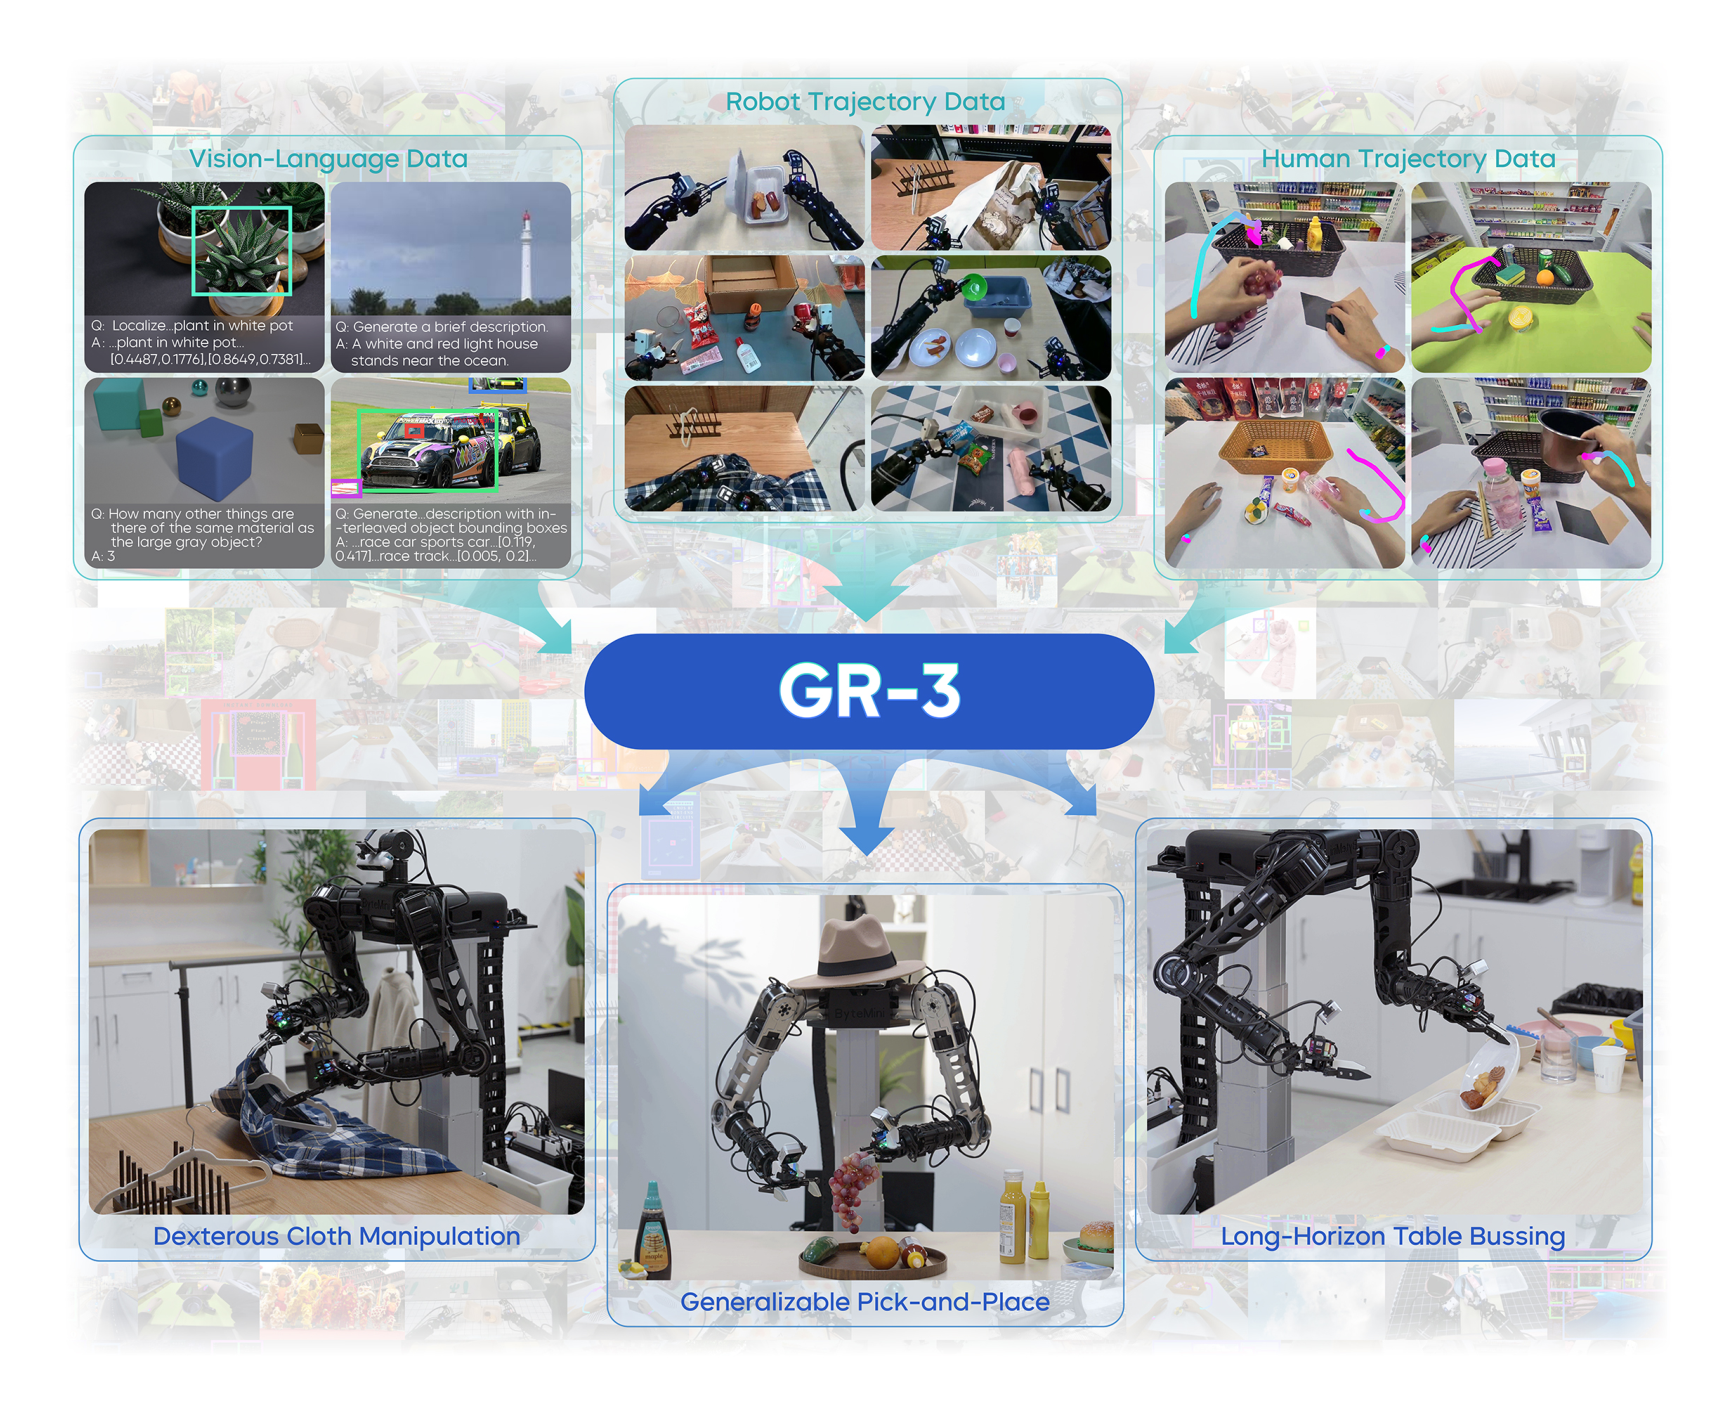
GR-3는 ByteDance Seed가 2025년 7월에 공개한 4B 규모의 vision-language-action(VLA) 모델이다. pre-training된 VLM인 Qwen2.5-VL-3B-Instruct가 카메라 영상과 언어 지시문(instruction)을 처리하고, 별도의 action DiT가 flow matching으로 action chunk를 생성한다. 학습 데이터는 teleoperation으로 모은 로봇 trajectory, 웹에서 큐레이션한 vision-language 데이터, VR 기기로 모은 사람 trajectory 세 종류다.
보고서가 내세우는 능력은 셋이다. 학습에 없던 물체와 환경과 추상 개념이 든 지시문에 일반화하고, 물체당 사람 trajectory 10개만으로 새 물체에 적응하며, 양팔 manipulation과 이동이 함께 필요한 long-horizon 과제를 안정적으로 수행한다. 이 능력은 22-DoF 양팔 이동 로봇 ByteMini에서 세 가지 실제 과제로 검증되며, 모든 설정에서 baseline π0를 앞선다.
배경
VLA 모델은 pre-training된 VLM 위에 action 예측 능력을 결합해 자연어 지시문으로 다양한 과제를 수행하는 로봇 policy를 만드는 접근이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. RT-2, OpenVLA, π0, π0.5 같은 선행 모델이 이 경로의 가능성을 보였다.
보고서는 이 흐름에 남은 세 가지 어려움을 출발점으로 삼는다.
| 어려움 | 내용 |
|---|---|
| out-of-distribution 지시문 준수 | 로봇 trajectory 데이터에 없는 물체 범주나 복잡한 개념이 든 지시문을 따르는 일이 여전히 어렵다 |
| 적응 비용 | VLA 모델은 policy 학습에 대량의 시연 데이터(demonstration)가 필요해 새 설정에 적응하는 비용이 크다 |
| long-horizon 신뢰성 | compounding error 때문에 변형 물체 조작 같은 dexterous 기술이 필요한 긴 과제에서 안정성을 확보하기 어렵다 |
compounding error는 policy의 작은 예측 오차가 시간에 따라 누적되어 학습 분포에서 벗어난 상태로 이어지는 현상이다. GR-3의 설계는 이 세 어려움에 각각 co-training, 사람 trajectory few-shot 학습, 안정적인 imitation learning 레시피로 대응한다.
핵심 개념
action chunk는 한 번의 추론으로 여러 timestep의 action을 묶어 내는 출력 단위다. GR-3는 길이 k의 action chunk a_t = a_{t:t+k}를 한 번에 생성하며, 이 값이 로봇의 19개 자유도를 제어한다.
flow matching은 노이즈에서 시작해 정답 분포로 향하는 속도장을 학습하는 생성 기법이다. GR-3는 diffusion model 대신 flow matching으로 action chunk를 만들고, 추론 시 Euler 적분 5단계로 노이즈를 action으로 바꾼다.
DiT는 diffusion 계열 생성을 Transformer 블록으로 구현한 구조다. GR-3의 action DiT는 VLM backbone의 KV cache를 조건으로 받아 action chunk를 예측한다.
co-training은 로봇 데이터만이 아니라 웹 vision-language 데이터를 배치에 계속 섞는 레시피다. 로봇 trajectory는 flow matching 목표로, vision-language 데이터는 next-token prediction 목표로 같은 VLM backbone을 학습시킨다.
imitation learning은 시연 데이터의 observation과 action 쌍을 흉내 내도록 policy를 학습하는 방법이다. GR-3의 기본 학습 목표는 전문가 시연 데이터에 대한 policy의 log-likelihood 최대화이며, 이것을 flow matching 손실로 구현한다.
task progress는 과제를 구성하는 milestone 중 완료한 비율이다. 전체 성공만 세는 성공률과 달리 부분 성공을 점수에 반영하므로 long-horizon 과제의 평가에 쓰인다.
방법
모델 구조
GR-3는 지시문 l, observation o_t, 로봇 상태 s_t를 받아 action chunk를 내는 end-to-end policy π_θ(l, o_t, s_t)다. 구조는 mixture-of-transformers 방식이며, 서로 다른 역할의 Transformer 두 개가 KV cache로 이어진다.
| 구성 요소 | 내용 |
|---|---|
| VLM backbone | Qwen2.5-VL-3B-Instruct. 머리와 양 손목 카메라 영상과 지시문을 처리한다 |
| action DiT | VLM 층 수의 절반. VLM 후반부 절반 층의 KV cache만 조건으로 쓴다 |
| DiT 입력 토큰 | 길이 k의 action chunk를 k개 토큰으로 표현하고 로봇 상태 토큰과 이어 붙인다 |
| timestep 주입 | flow matching timestep을 AdaLN으로 넣는다 |
| attention mask | DiT 안에서 causal mask를 써 action chunk 내부의 시간 의존성을 모델링한다 |
| 총 파라미터 | 4B |
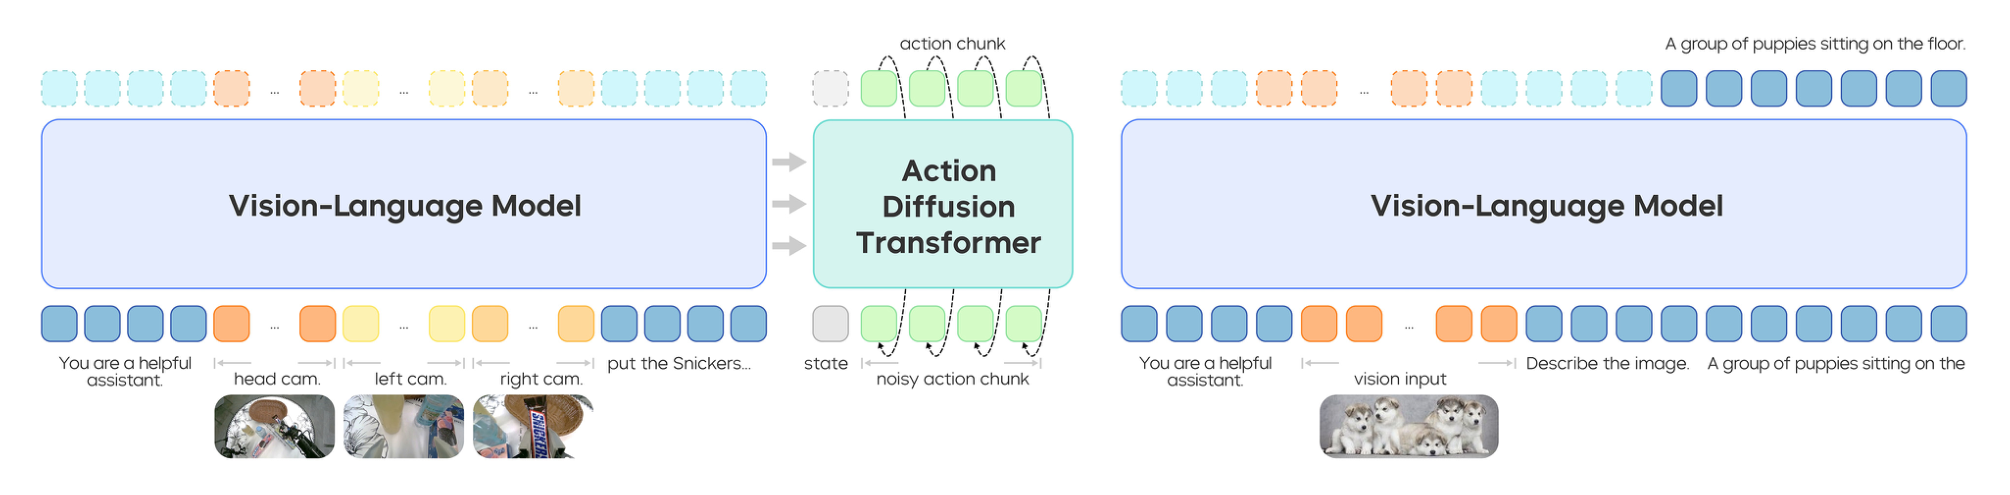
action DiT를 VLM의 절반 크기로 두고 KV cache도 후반부 절반만 쓰는 것은 추론 속도를 위한 선택이다. VLM 전체를 한 번 통과한 뒤 DiT가 여러 번 반복되는 flow matching 추론에서 DiT의 크기가 지연을 좌우하기 때문이다.
RMSNorm으로 학습 안정화
초기 실험에서 학습 불안정이 자주 나타났다. 저자들은 QK norm에서 착안해 DiT 블록의 attention과 FFN 안에 있는 선형층 뒤에 RMSNorm을 추가했다. 이 변경으로 학습 전 구간의 안정성이 크게 좋아졌다.
효과는 안정성에 그치지 않는다. 뒤의 table bussing ablation에서 RMSNorm을 뺀 모델은 지시문을 잘 따르지 못하고 새 목적지에 일반화하지 못했다. 즉 정규화 하나가 지시문 준수 능력을 좌우한다는 것이 이 보고서의 발견 중 하나다.
flow matching 학습 목표
학습은 전문가 시연 데이터 D에서 (a_t, o_t, s_t, l)을 뽑아 flow matching 손실을 최소화한다.
- τ ~ U(0, 1)은 flow matching timestep이고 t는 episode timestep이다
- 노이즈 action chunk는 a_t^τ = (1 − τ)ε + τ a_t로 만들며 ε ~ N(0, I)이다
- 정답 flow는 u(a_t^τ | a_t) = a_t − ε이다
- 손실은 모델 출력 v_θ(l, o_t, s_t, a_t^τ)와 u의 제곱 오차 기댓값이다
학습 속도를 위해 VLM backbone 한 번의 forward에 대해 flow matching timestep을 여러 개 샘플링해 손실을 함께 계산한다. VLM forward가 DiT forward보다 훨씬 비싸므로, 같은 VLM 출력으로 여러 τ의 손실을 얻으면 계산량 대비 학습 신호가 늘어난다.
추론은 a_t^{τ=0} ~ N(0, I)에서 시작해 a_t^{τ+Δτ} = a_t^τ + v_θ(l, o_t, s_t, a_t^τ)Δτ로 τ = 0에서 1까지 적분한다. Δτ = 0.2이므로 DiT를 5번 반복해 action chunk 하나를 얻는다.
로봇 trajectory 수집과 데이터 스케줄러
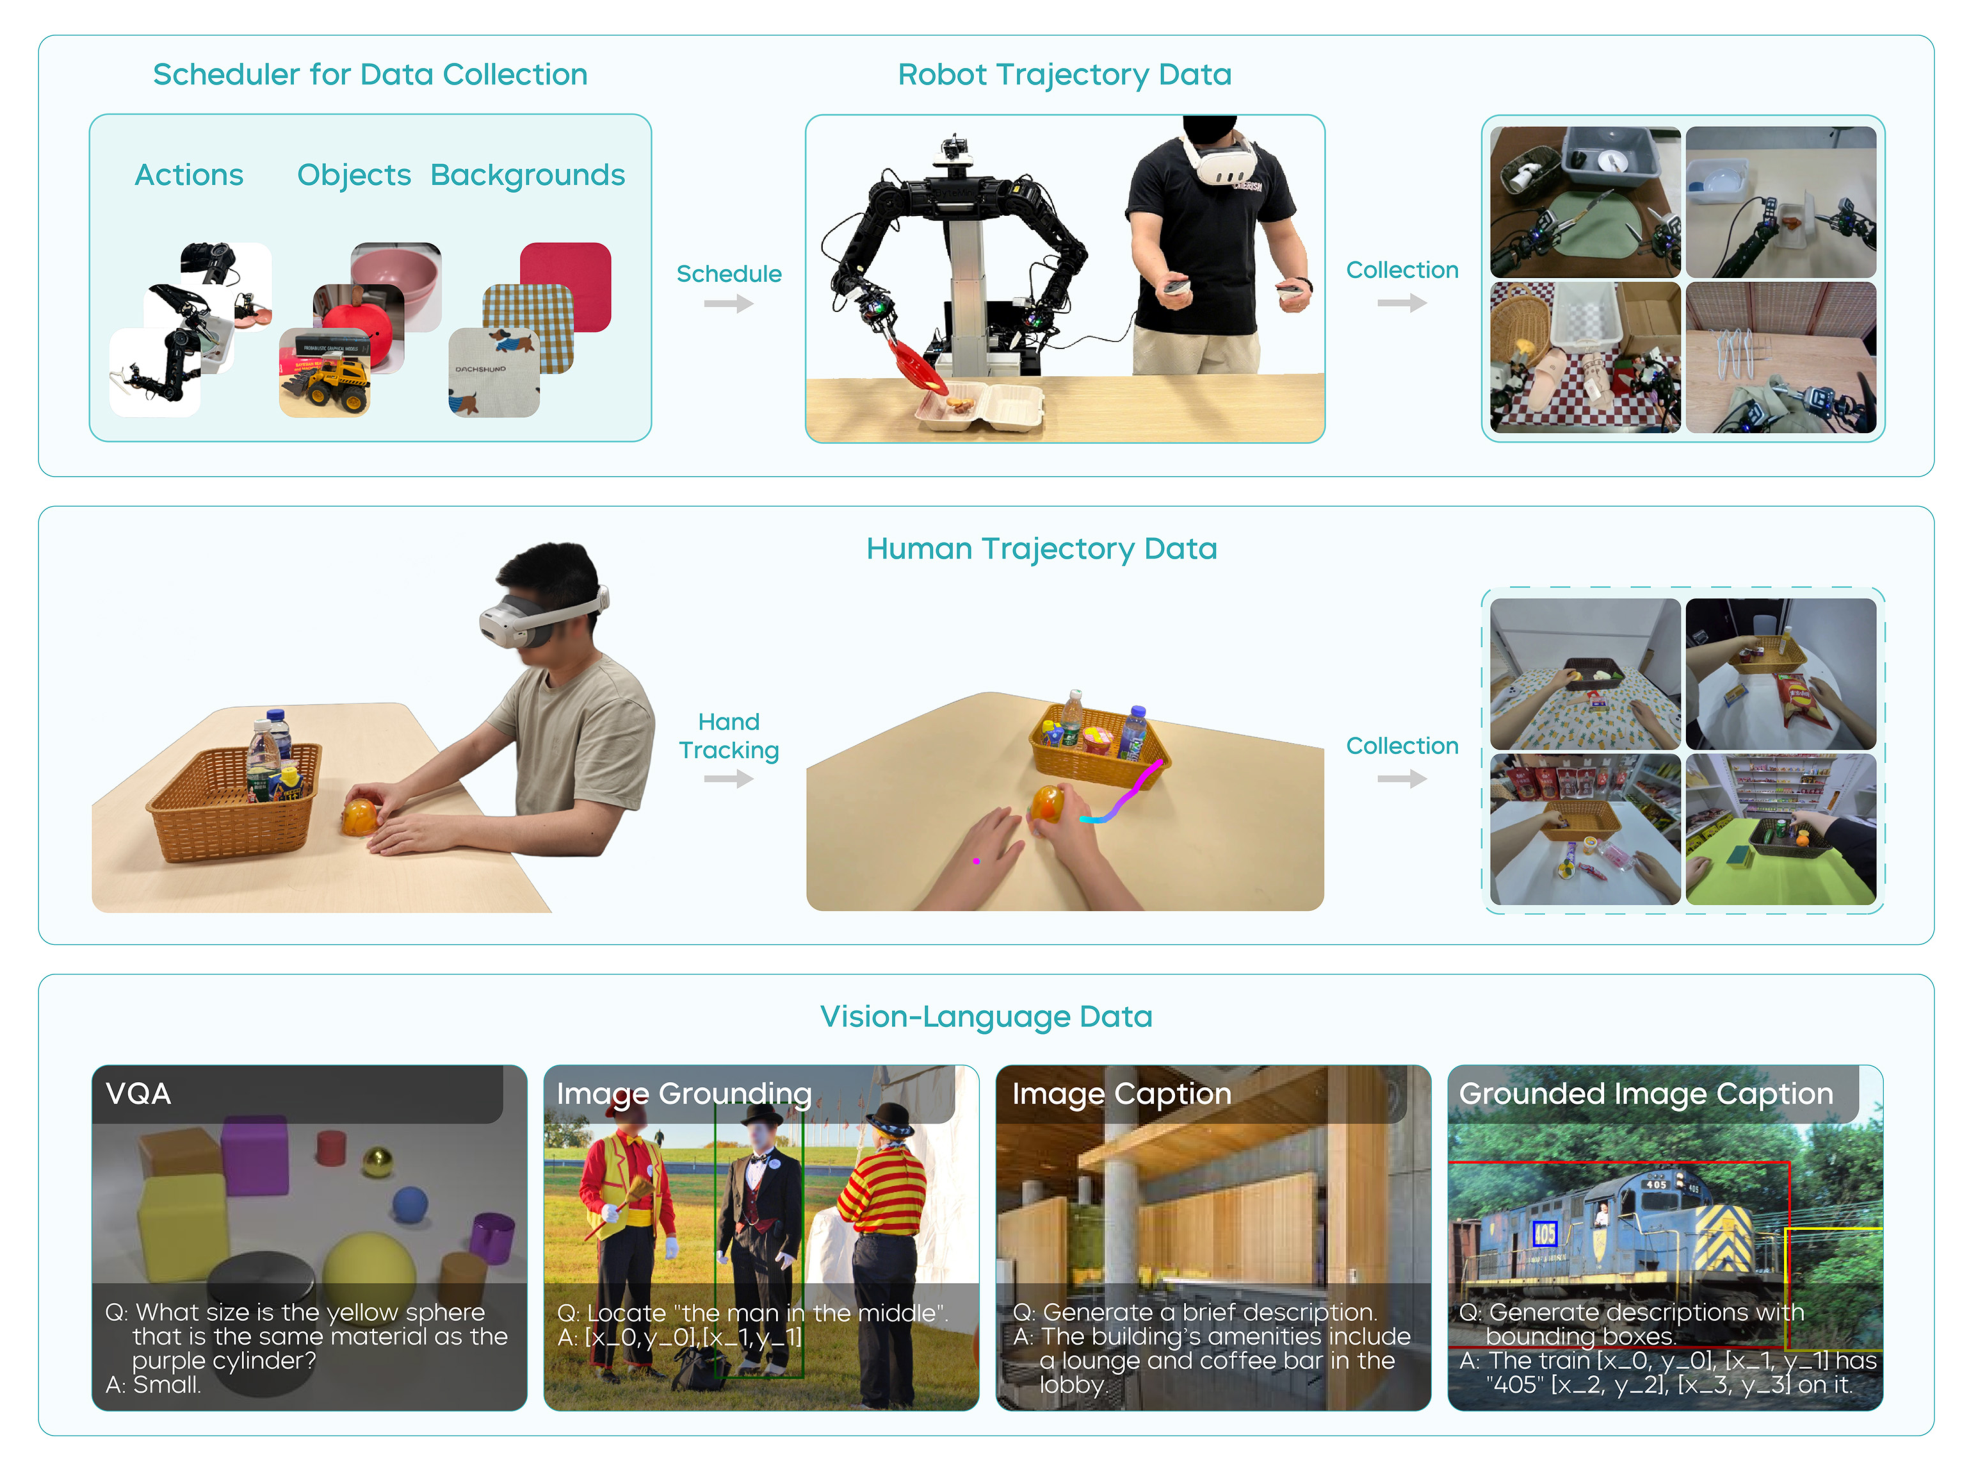
로봇 trajectory는 teleoperation으로 모은다. 데이터 분포를 통제하고 다양성을 높이기 위해 수집 스케줄러를 두는데, 스케줄러는 매 trajectory 시작 시 조작자에게 세 가지를 지정한다.
- 수행할 action
- 물체 조합
- 배경 설정
조작자는 지정된 구성대로 환경을 배치한 뒤 수집한다. 이 방식은 전체 데이터 분포를 관리하면서 수집 데이터를 철저히 무작위화해 데이터셋의 풍부함과 변동성을 높인다. 수집 후에는 품질 검사로 무효 데이터와 저품질 데이터를 걸러낸다.
task status 보조 예측
task status는 policy가 지시문을 무시하는 문제에 대한 대응이다. 선행 연구는 policy가 언어 조건을 제대로 참조하는 대신 여러 카메라 시점 사이의 가짜 상관에 기대어 action을 예측할 수 있음을 보였다. 예를 들어 손목 카메라에 물체가 보이면 지시문과 무관하게 그 물체를 집는 식이다.
GR-3는 action의 보조 차원으로 task status를 추가하고 세 값 중 하나를 예측하게 한다.
| 값 | 의미 |
|---|---|
| Ongoing (0) | 과제 수행 중 |
| Terminated (1) | 과제를 성공적으로 마쳤다 |
| Invalid (-1) | 현재 observation에서 지시문이 유효하지 않다. 예를 들어 식탁에 칼이 없는데 "칼을 바구니에 넣어라"는 무효다 |
학습 중 지시문을 무작위로 무효 지시문으로 바꾼다. 이때는 action chunk의 다른 차원에는 지도 신호를 주지 않고 Invalid 상태만 예측하게 한다. 따라서 action DiT는 지시문을 읽지 않으면 task status를 맞힐 수 없고, 이 압력이 지시문 준수 능력을 크게 올린다.
vision-language 데이터와의 co-training
out-of-distribution 지시문 준수를 위해 로봇 trajectory와 vision-language 데이터를 함께 학습한다. 두 데이터는 서로 다른 목표와 서로 다른 학습 범위를 가진다.
| 데이터 | 학습 목표 | 학습되는 부분 |
|---|---|---|
| 로봇 trajectory | flow matching | VLM backbone과 action DiT |
| vision-language 데이터 | next-token prediction | VLM backbone만 |
두 데이터는 mini-batch 단위로 같은 가중치로 동적으로 섞이며, 전체 목표는 두 손실의 합이다. 이 단순한 혼합만으로 GR-3는 unseen 물체와 복잡한 개념의 새 의미에 zero-shot으로 일반화한다.
vision-language 데이터셋은 여러 공개 출처를 모아 큐레이션했으며 네 종류의 과제를 담는다.
- image captioning
- visual question answering
- image grounding
- interleaved grounded image captioning
품질을 위해 필터링과 재주석 파이프라인도 만들었다. co-training의 역할은 두 가지다. pre-training된 VLM의 vision-language 능력을 로봇 학습 중에도 유지시키고, action DiT가 그 능력을 action 예측에 활용하게 해 downstream manipulation의 일반화를 높인다.
사람 trajectory 데이터로 few-shot 적응
실제 로봇 trajectory 수집은 시간과 비용이 크다. GR-3는 새 설정에 대해 VR 기기 PICO 4 Ultra Enterprise로 소량의 사람 trajectory를 모아 fine-tuning한다. 사람 trajectory는 egocentric(1인칭) 영상과 손 trajectory로 구성되며, 로봇 trajectory와 같은 파이프라인으로 언어 라벨을 붙인다.
| 항목 | 로봇 trajectory | 사람 trajectory |
|---|---|---|
| 수집 도구 | ByteMini teleoperation | VR 헤드셋 hand tracking |
| 수집 속도 | 시간당 약 250개 | 시간당 약 450개 |
| 시점 | 머리와 양 손목 카메라 | egocentric 1개 |
| 상태 정보 | 팔 관절 상태, 그리퍼 상태 | 없음 |
| action | 로봇 action chunk | 손 trajectory |
학습은 두 단계다. vision-language 데이터와 로봇 trajectory로 1단계 학습을 마친 뒤, 사람 trajectory를 더해 세 데이터를 함께 co-training한다. 사람 trajectory에는 손목 시점이 없으므로 빈 이미지로 채우고, 팔 관절이나 그리퍼 상태가 없으므로 손 trajectory만으로 학습한다. 즉 embodiment가 다른 데이터를 입력 형식만 맞춰 같은 모델에 넣는다.
ByteMini 로봇
ByteMini는 데이터 수집과 policy rollout에 쓰는 22-DoF 양팔 이동 로봇이다. 설계 목표는 유연한 manipulation, 높은 신뢰성, 사용 편의성 세 가지다.
| 구성 | 사양 |
|---|---|
| 머리 | 2-DoF, 머리 카메라 |
| 팔 | 7-DoF unbiased 팔 2개, sphere wrist joint |
| 그리퍼 | 1-DoF 2개, 각 손목에 카메라 |
| 리프트 | 1-DoF |
| 이동 베이스 | 3-DoF omni |
| 컴퓨팅 | NUC, 휴대용 화면 |
| 전원 | 3.88kWh 이중 리튬 배터리, 10시간 이상 |
| 안전 | 무선 E-stop |
| 카메라 | 머리와 양 손목에 RGBD |
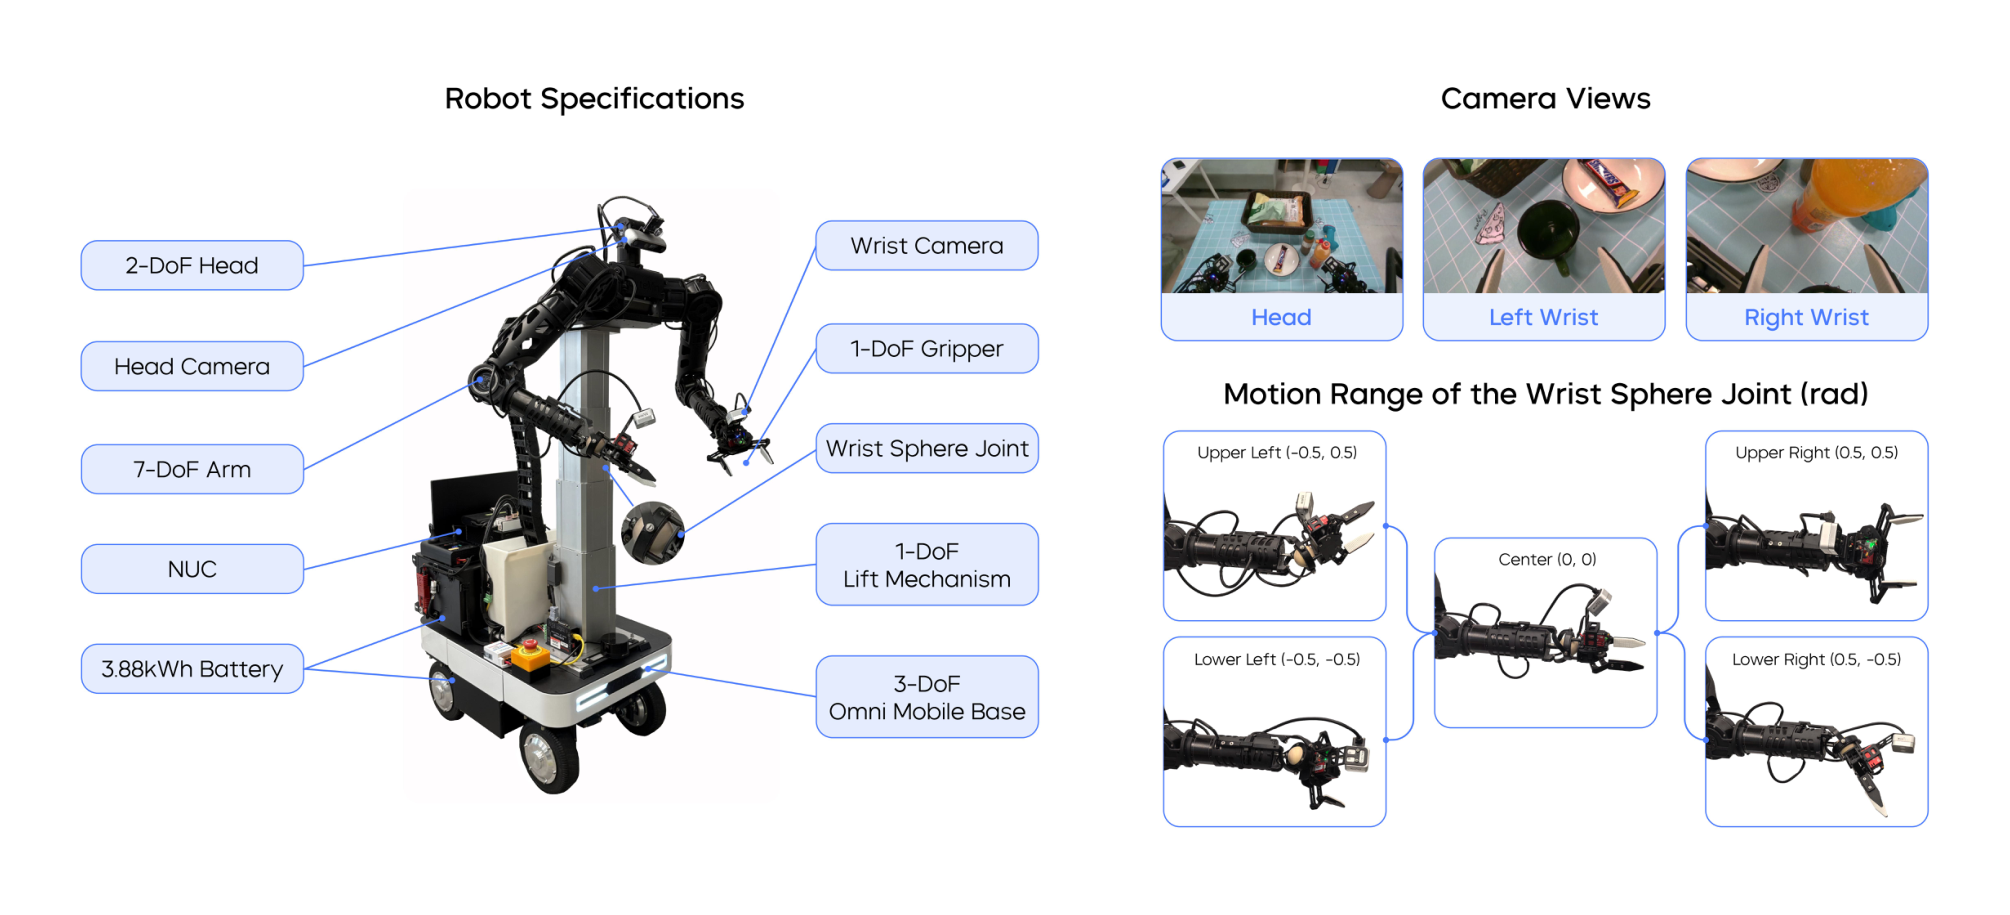
유연한 manipulation은 sphere wrist joint 구성의 7-DoF 팔이 담당한다. 기존 SRS 구성 팔은 손목 치수가 커서 좁은 공간에서 움직임이 제한되는데, 콤팩트한 sphere wrist가 이 한계를 풀어 사람에 가까운 dexterity를 낸다. 팔꿈치는 2.53rad까지 안쪽으로 접혀 두 팔이 로봇 가슴 앞 영역에서 정밀 작업을 할 수 있다.
신뢰성은 두 요소가 맡는다. omni 이동 플랫폼에 리프트 기구를 통합해 수평 이동과 수직 높이 조절을 안정적으로 수행하고, 팔 액추에이터를 QDD 원리로 설계해 안정성과 투명성을 확보한다. QDD는 감속비를 낮춰 backdrivability와 투명성을 높인 구동 방식이다. 사용 편의성은 휴대용 화면과 NUC, 10시간 이상 가는 이중 배터리, 무선 E-stop이 담당한다.
시스템과 제어
ByteMini의 소프트웨어 스택은 수집용과 rollout용으로 나뉜다.
| 구성 요소 | 용도 | 내용 |
|---|---|---|
| whole-body compliance control | 수집 | 전체 자유도를 하나의 구조로 다루어 임의의 teleoperation 동작을 실행 가능한 로봇 동작으로 retargeting한다. manipulability 최적화, 특이점 회피, 관절 한계를 실시간 최적 제어 문제 하나에서 함께 처리한다 |
| whole-body teleoperation | 수집 | Meta VR Quest로 사람 동작을 로봇 end-effector에 직접 대응시킨다. 조작자는 팔, 리프트, 그리퍼, 이동 베이스를 동시에 제어한다 |
| trajectory 최적화 | rollout | 예측된 action chunk로 19 DoF(리프트와 머리의 3 DoF 제외)를 제어한다. pure pursuit와 trajectory 최적화를 결합해 jerk를 최소화하고 waypoint 사이와 trajectory 사이의 전환을 매끄럽게 만든다 |
whole-body control은 팔, 몸통, 베이스 같은 여러 부위의 자유도를 따로 제어하지 않고 하나의 최적화 문제로 함께 푸는 방식이다. compliant force controller가 동적인 동작과 환경과의 물리적 접촉을 안전하게 만들어 데이터 수집의 안전과 효율을 함께 높인다.
결과
실험은 네 질문에 답하도록 설계됐다.
- GR-3는 학습에 없던 지시문까지 엄격히 따르는가
- 새 물체, 환경, 지시문 같은 out-of-distribution 설정에 일반화하는가
- 사람 trajectory에서 few-shot으로 배워 로봇 embodiment로 옮기는가
- long-horizon과 dexterous 과제에서 안정적인 policy를 배우는가
모든 과제에서 baseline은 π0다. Physical Intelligence의 공개 저장소 openpi의 지침대로 대규모 로봇 데이터로 pre-training된 base 모델을 과제별로 각각 fine-tuning했다.
| 과제 | 로봇 trajectory 데이터 | 평가 지표 |
|---|---|---|
| generalizable pick-and-place | 3만 5천 개, 101종 물체, 69시간 | IF rate, 성공률 |
| long-horizon table bussing | 약 101시간 | 평균 task progress (Flat), 평균 subtask 성공률 (IF) |
| dexterous cloth manipulation | 116시간 | 평균 task progress |
generalizable pick-and-place
"put A into B" 지시문으로 주석한 데이터로 학습한다. A는 물체 범주, B는 용기다. 학습 중 사진 측정 augmentation을 적용해 환경 변화에 대한 강건성을 높였다. 비교 대상은 π0, 로봇 trajectory만으로 학습한 GR-3 w/o Co-Training, 그리고 GR-3다.
| 설정 | 내용 |
|---|---|
| Basic | 학습 환경에서 seen 물체 54종. 6종씩 9개 mini-batch로 나누어 매 rollout마다 여섯 물체 중 하나를 고르게 한다 |
| Unseen Environments | 같은 물체를 계산대, 회의실, 책상, 휴게실 네 unseen 환경에서 평가한다. 물체 배치는 Basic과 같다 |
| Unseen Instructions | "스프라이트 옆의 콜라를 상자에", "가장 큰 물체를 상자에", "바다 동물을 상자에"처럼 크기, 공간 관계, 상식 추론이 필요한 지시문 |
| Unseen Objects | 로봇 trajectory에 없던 물체 45종. 5종씩 9개 mini-batch. 45종 중 70% 이상이 학습에 없던 범주 |
지표는 둘이다. IF rate는 지시문이 가리킨 물체에 로봇이 올바르게 접근한 rollout의 비율이고, 성공률은 그 물체를 용기에 넣은 비율이다. 물체 배치는 미리 찍은 마스크에 맞춰 모델 간 비교 가능성을 확보했다.
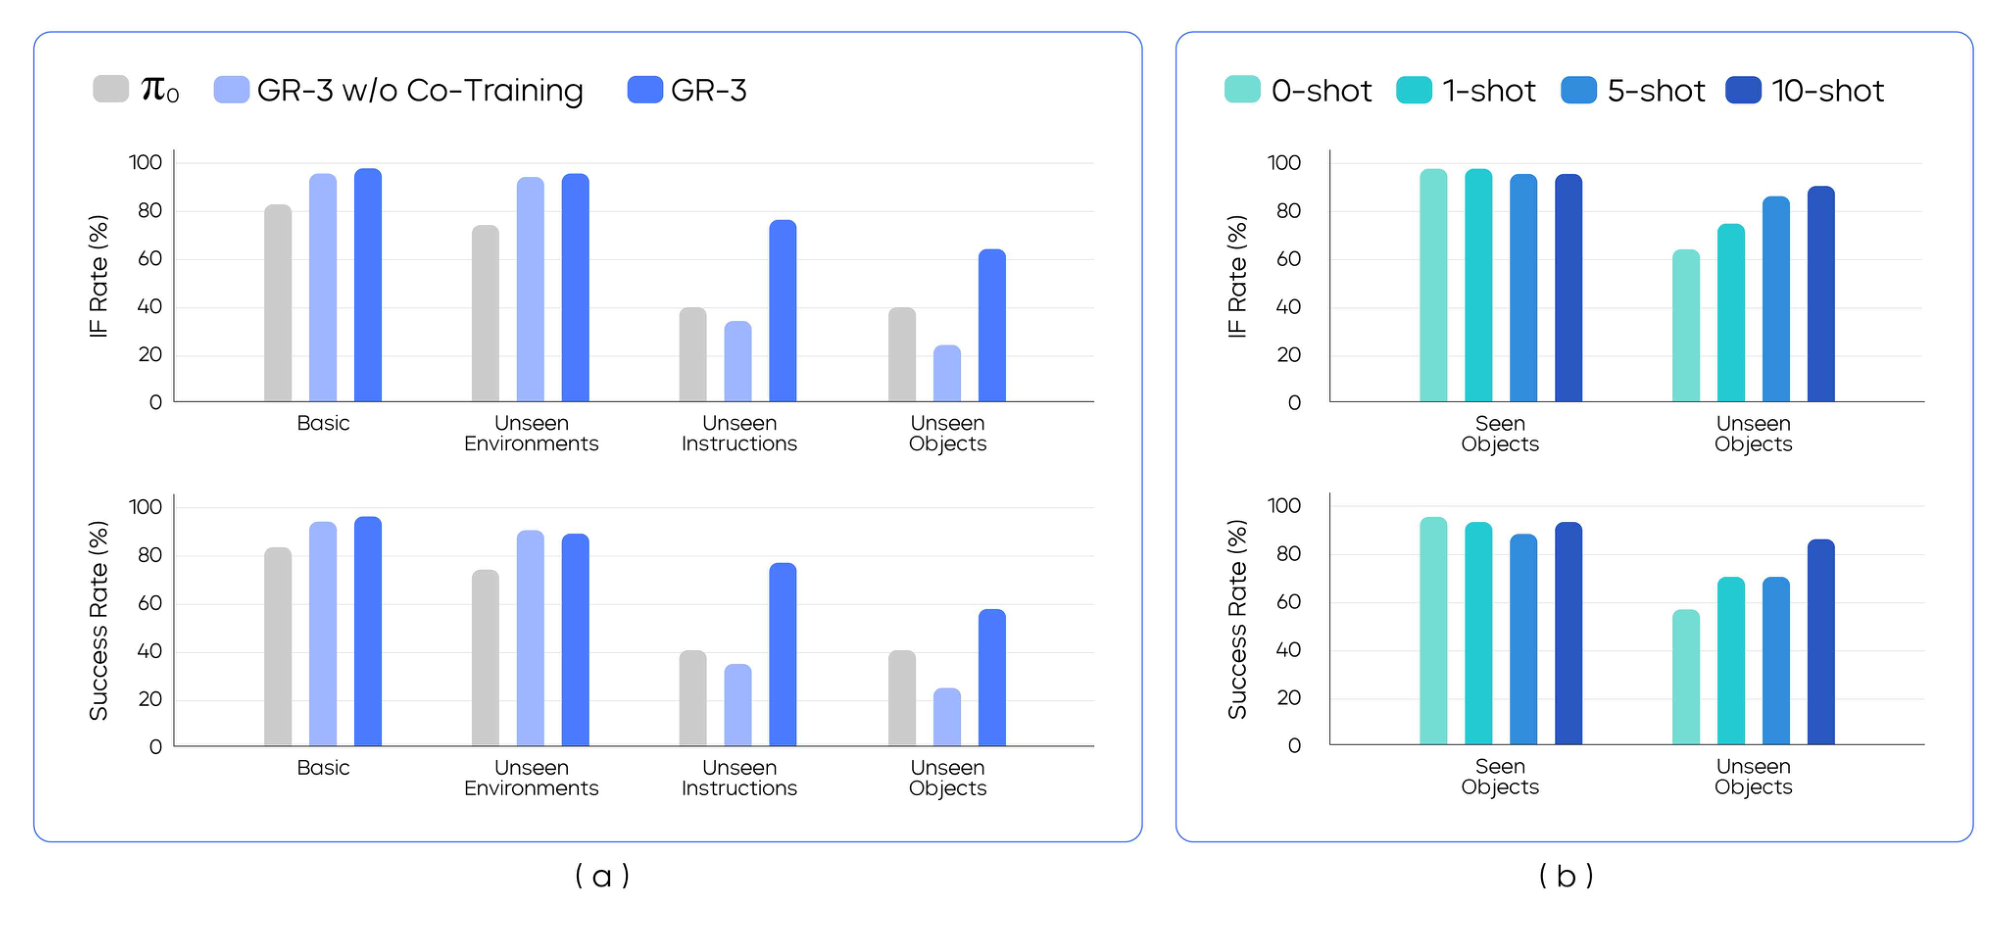
본문이 명시한 수치는 Unseen Instructions와 Unseen Objects의 성공률이고, 나머지는 Fig. 7(a) 막대에서 읽은 근사값이다.
| 설정 | 지표 | π0 | GR-3 w/o Co-Training | GR-3 |
|---|---|---|---|---|
| Basic | IF rate | 약 82% | 약 95% | 약 97% |
| Basic | 성공률 | 약 83% | 약 93% | 약 96% |
| Unseen Environments | IF rate | 약 73% | 약 93% | 약 95% |
| Unseen Environments | 성공률 | 약 73% | 약 90% | 약 88% |
| Unseen Instructions | IF rate | 약 39% | 약 33% | 약 76% |
| Unseen Instructions | 성공률 | 40% | 약 34% | 77.1% |
| Unseen Objects | IF rate | 약 39% | 약 23% | 약 63% |
| Unseen Objects | 성공률 | 40% | 약 24% | 57.8% |
Basic과 Unseen Environments에서 GR-3는 π0를 IF rate와 성공률 모두에서 앞선다. 두 설정 사이의 성능 저하가 작아 환경 변화에 강건하며, 이 두 설정에서는 co-training 유무에 따른 차이가 없다. 즉 co-training은 seen 물체 성능을 해치지 않는다.
Unseen Instructions와 Unseen Objects에서는 그림이 달라진다. GR-3는 π0를 큰 차이로 앞서 성공률을 Unseen Instructions에서 40%에서 77.1%로, Unseen Objects에서 40%에서 57.8%로 올린다. GR-3 w/o Co-Training보다도 크게 높으므로 vision-language co-training이 일반화의 원천이다. 반면 로봇 trajectory만으로 학습한 GR-3는 이 두 설정에서 π0보다 낮은데, 저자들은 π0의 대규모 cross-embodiment pre-training이 그 차이를 만든다고 추정한다.
사람 trajectory few-shot 적응
few-shot 적응은 두 가지 이유로 어렵다. 사람과 로봇이라는 서로 다른 embodiment의 데이터에서 배워야 하고, 데이터가 적다. 실험은 Unseen Objects의 45종 물체에 대해 물체당 최대 10개의 사람 trajectory를 모았다. 450개 trajectory의 총 길이는 약 30분이다.
로봇 trajectory와 VL 데이터로 학습한 체크포인트에서 출발해 사람 trajectory를 더한 세 데이터로 2만 스텝을 추가 co-training했다. 평가는 0-shot, 1-shot, 5-shot, 10-shot에서 seen 물체와 unseen 물체 모두에 대해 수행했다.
| 설정 | unseen 물체 성공률 |
|---|---|
| 0-shot (base 모델) | 57.8% |
| 10-shot | 86.7% |
사람 trajectory가 늘수록 unseen 물체의 IF rate와 성공률이 계속 오르고, seen 물체에서는 뚜렷한 저하가 없다 (Fig. 7(b)). 물체당 10개, 총 30분 분량의 사람 데이터로 성공률이 28.9%p 오른 것이므로, 사람 trajectory는 pre-training된 VLA를 새 설정에 맞추는 저비용 수단이 된다.
long-horizon table bussing
식기, 음식, 포장 용기, 플라스틱 정리함이 어지럽게 놓인 식탁을 치우는 과제다. 로봇은 세 subtask를 모두 수행해야 한다.
- 음식을 포장 용기에 담는다
- 식기를 모두 정리함에 넣는다
- 쓰레기를 모두 쓰레기통에 버린다
작업 공간이 넓어 포장 용기와 정리함 사이를 이동 베이스로 오가야 하므로 manipulation과 이동이 함께 필요하다. 평가는 두 설정으로 나뉜다.
| 설정 | 지시문 | 지표 |
|---|---|---|
| Flat | "clean up the dining table" 한 번으로 전체를 한 번에 수행한다 | 완료한 subtask 수를 전체 subtask 수로 나눈 평균 task progress. 다섯 가지 물체 집합으로 평가 |
| IF | "종이컵을 쓰레기통에 넣어라" 같은 subtask 지시문을 연달아 주고 각 subtask를 home 위치에서 시작한다 | 평균 subtask 성공률 |
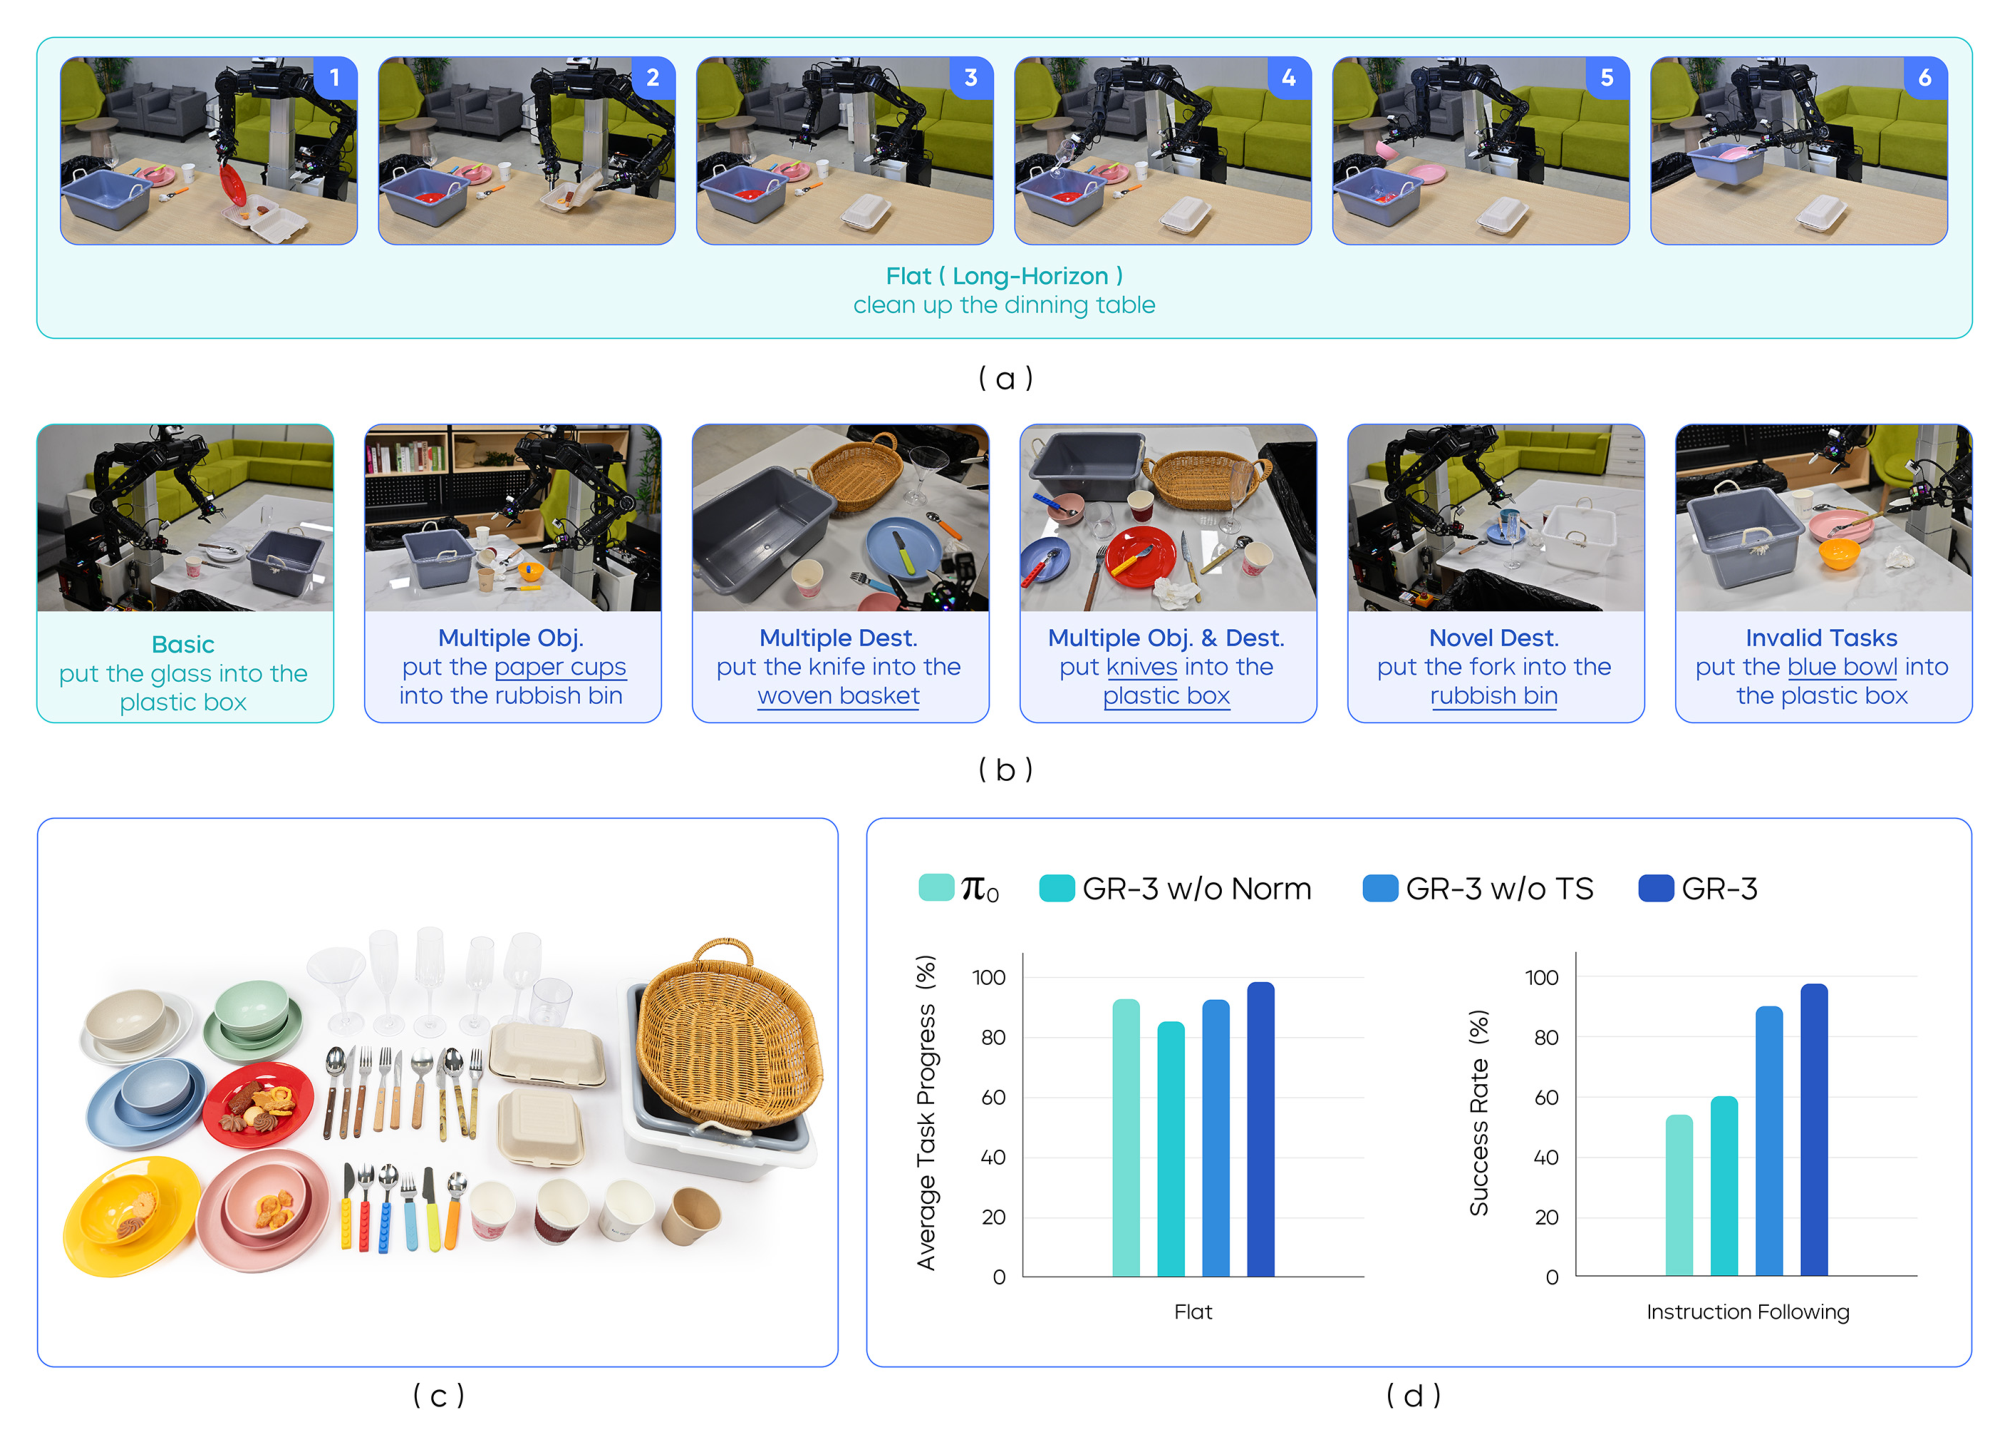
IF 설정은 여섯 가지 지시문 집합으로 구성된다.
| 집합 | 내용 |
|---|---|
| Basic | 물체 배치가 학습 데이터와 비슷하다 |
| Multiple Objects | 일부 범주의 물체를 여러 개 두고 그 범주 전부를 정리함이나 쓰레기통에 넣게 한다 |
| Multiple Destinations | 바구니를 추가하고 식기를 바구니나 정리함 중 지정된 곳에 넣게 한다 |
| Multiple Objects & Destinations | 위 둘을 결합해 한 범주의 모든 물체를 두 목적지 중 하나로 옮긴다 |
| Novel Destinations | 학습 데이터에서 그 물체와 함께 나타난 적 없는 목적지로 옮긴다. 예를 들어 "포크를 쓰레기통에" |
| Invalid Tasks | 현재 observation으로는 수행할 수 없는 지시문을 준다. 예를 들어 파란 그릇이 없는데 "파란 그릇을 상자에". 10초 안에 어떤 물체도 조작하지 않아야 성공 |
Invalid Tasks는 실제 배치 환경을 겨냥한 설정이다. 사람이 주는 지시문 중에는 현재 장면에서 수행할 수 없는 것이 섞여 있고, 그때 policy는 엉뚱한 유효 과제를 대신 수행하지 말고 거부해야 한다.
비교 대상은 π0, RMSNorm을 뺀 GR-3 w/o Norm, task status를 뺀 GR-3 w/o TS, GR-3다. 모든 방법에 대해 Flat용과 IF용 모델을 따로 학습했다. Flat 모델은 전체 과제 지시문과 subtask 지시문을 무작위로 섞어 학습하고, IF 모델은 subtask 지시문만으로 학습한다.
| 설정 | 지표 | π0 | GR-3 w/o Norm | GR-3 w/o TS | GR-3 |
|---|---|---|---|---|---|
| Flat | 평균 task progress | 약 92% | 약 85% | 약 92% | 약 98% |
| IF | 성공률 | 53.8% | 약 60% | 약 90% | 97.5% |
본문이 명시한 수치는 IF 설정의 π0 53.8%와 GR-3 97.5%이고, 나머지는 Fig. 8(d)에서 읽은 근사값이다.
π0는 long-horizon 과제 자체는 수행하지만 지시문 준수, 특히 out-of-distribution 상황에서 약하다. 포크와 숟가락을 구분하지 못하고, Novel Destinations에서는 지시문 대신 학습 데이터에서 그 물체와 함께 나타난 용기에 넣는다. 반면 GR-3는 여섯 집합 모두에서 지시문을 엄격히 따르며, 여러 물체와 목적지에 일반화하고 Invalid Tasks에서는 조작을 거부한다.
ablation은 두 설계 선택의 역할을 분리해 보여 준다.
| 변형 | 영향 |
|---|---|
| GR-3 w/o Norm | 두 설정 모두 하락하며 특히 IF에서 크다. 지시문을 잘 따르지 못하고 새 목적지에 일반화하지 못한다 |
| GR-3 w/o TS | IF 능력이 떨어진다. task status가 VLA의 지시문 준수를 돕는다는 근거다 |
dexterous cloth manipulation
옷걸이로 옷을 건조대에 거는 과제다. 로봇은 옷걸이를 집고, 옷을 옷걸이에 걸고, 이동 베이스를 식탁에서 건조대 쪽으로 회전시켜 옷을 건다. 변형 물체를 다루는 dexterous manipulation과 이동이 함께 필요하다. π0는 로봇 trajectory로만, GR-3는 로봇 trajectory와 VL 데이터로 co-training했다.
| 설정 | 내용 |
|---|---|
| Basic | seen 의류 6점, 학습 때와 비슷한 배치 |
| Position | 옷을 회전시키고 구겨 놓아 어려운 배치에 대한 강건성을 본다 |
| Unseen Instances | unseen 의류 4점. 학습 데이터는 전부 긴팔인데 테스트 4점 중 2점은 반팔 |
평균 task progress는 네 milestone에 부분 점수를 주어 계산하며 완전 성공이 1.0이다.
- 옷걸이 집기
- 오른쪽 어깨를 옷걸이에 걸기
- 왼쪽 어깨를 옷걸이에 걸기
- 건조대에 걸기
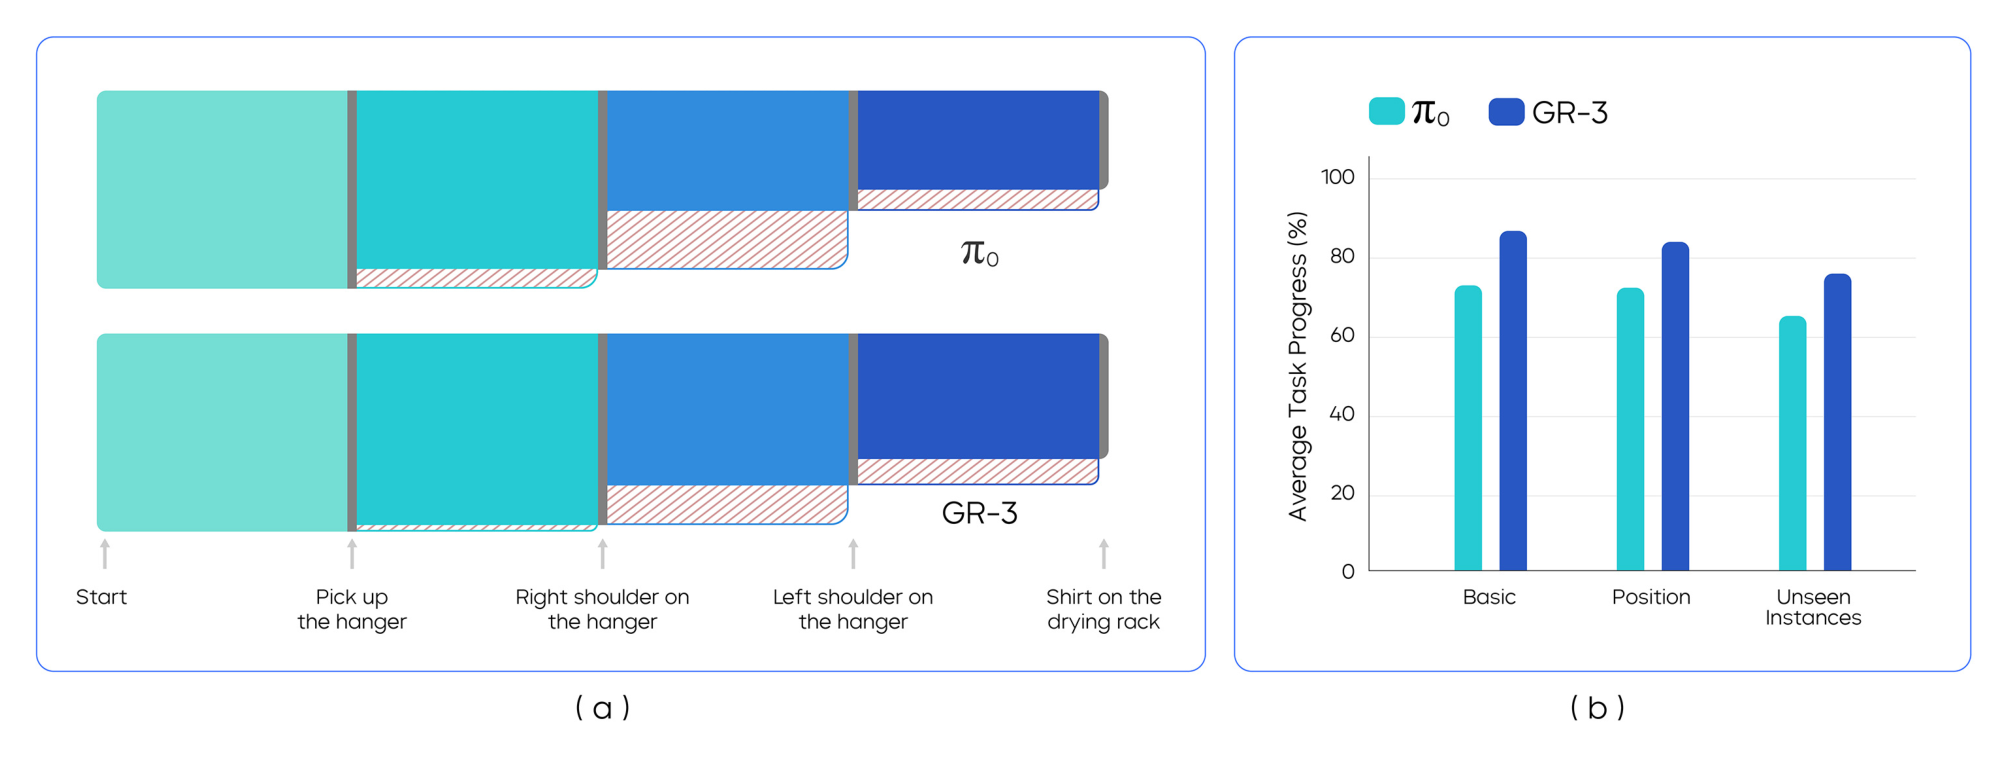
| 설정 | π0 | GR-3 |
|---|---|---|
| Basic | 약 73% | 86.7% |
| Position | 약 72% | 83.9% |
| Unseen Instances | 약 65% | 75.8% |
GR-3 수치는 본문 명시이고 π0 수치는 Fig. 10(b)에서 읽은 근사값이다. GR-3는 세 설정 모두에서 π0를 앞선다. Basic과 Position의 차이가 2.8%p에 그쳐 옷 배치 변화에 강건하며, 무늬와 소매 길이가 다른 unseen 옷에도 75.8%로 일반화한다.
Sankey 다이어그램은 실패가 어디서 생기는지 보여 준다. 두 모델 모두 가장 어려운 단계는 오른쪽 어깨를 건 뒤 왼쪽 어깨를 거는 것이다. 옷걸이를 든 채로 옷걸이 뒤에 접힌 왼쪽 깃을 꺼내 잡아야 하기 때문이다. 다른 실패 유형은 왼쪽 어깨를 거는 도중 옷걸이가 그리퍼에서 미끄러져 마지막 단계에서 실패하는 경우다.
한계
저자가 명시한 한계는 두 가지다.
- 일반화의 한계. 새 개념과 물체가 든 unseen 지시문을 따를 때 여전히 실수하고, 형태가 낯선 물체의 grasping에 어려움을 겪는다. 모델과 학습 데이터를 확장해 대응할 계획이다.
- imitation learning의 한계. 모든 imitation learning 방법과 마찬가지로 rollout 중 out-of-distribution 상태에 빠지면 실패에서 회복하지 못한다. 강화학습을 도입해 복잡한 dexterous 과제의 강건성을 높이는 것이 향후 과제다.
자료에 기술이 없어 확인할 수 없는 것은 다음과 같다.
- action chunk 길이 k, control frequency, 추론 지연 같은 실행 시점 수치
- vision-language 데이터셋의 구체적 규모와 출처별 구성, 필터링과 재주석 기준
- 로봇 trajectory pre-training의 전체 규모. 과제별 데이터 시간(69시간, 약 101시간, 116시간)만 있다
- 코드와 가중치 공개 여부
- Fig. 7(a), Fig. 8(d), Fig. 10(b) 막대의 정확한 수치. 본문에 일부만 적혀 있어 이 페이지의 근사값은 그래프에서 읽은 것이다
핵심 용어
| 용어 | 뜻 |
|---|---|
| GR-3 | Qwen2.5-VL-3B VLM backbone에 flow matching action DiT를 결합한 4B VLA. 로봇 trajectory, vision-language 데이터, 사람 trajectory 세 종류로 학습한다 |
| ByteMini | GR-3의 데이터 수집과 rollout에 쓰는 22-DoF 양팔 이동 로봇. sphere wrist joint를 가진 7-DoF 팔 2개, 리프트, 3-DoF omni 베이스로 구성된다 |
| task status | action chunk에 덧붙인 보조 차원. Ongoing(0), Terminated(1), Invalid(-1) 중 하나를 예측해 지시문이 현재 observation에서 유효한지 판단하게 한다 |
| IF rate | instruction following rate. 지시문이 가리킨 물체에 로봇이 올바르게 접근한 rollout의 비율 |
| Flat 설정 | table bussing에서 한 번의 지시문으로 전체 과제를 수행하는 평가 설정. 지표는 평균 task progress |
| 데이터 수집 스케줄러 | 매 trajectory 시작 시 action, 물체 조합, 배경을 조작자에게 지정해 데이터 분포를 통제하는 시스템 |
관련 페이지
- π0: A Vision-Language-Action Flow Model for General Robot Control: 이 보고서의 baseline π0. VLM과 flow matching action expert 구성의 원형이며 GR-3와 구조적으로 가장 가깝다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 이질적 데이터 co-training으로 open-world 일반화를 보인 π0.5. GR-3의 co-training 전략이 참조하는 선행 사례
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 로봇 데이터와 vision-language 데이터의 co-fine-tuning이 일반화를 올린다는 것을 처음 보인 RT-2
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: 같은 ByteDance 계열의 GR-1. 사람 영상으로 video generative pre-training을 한 선행 모델
- GR-1: Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: GR-1 공식 저장소
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): π0 baseline을 fine-tuning할 때 따른 공개 저장소
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 서베이. GR-3를 암묵적 world model 계열로 분류한다
- Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere: 같은 Qwen2.5-VL-3B backbone에서 출발한 4B VLA. co-training 설계의 비교 대상
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: action chunking을 도입한 ACT. GR-3의 action chunk 출력 단위가 이어받은 개념
- Flow Matching for Generative Modeling: GR-3의 action 생성 목표인 flow matching의 원 논문
- Scalable Diffusion Models with Transformers: action DiT의 원형인 DiT 논문