LLMs · PAPER · 2022
Flow Matching for Generative Modeling
요약
Flow Matching(FM)은 continuous normalizing flow(CNF)를 ODE 시뮬레이션 없이 학습하는 방법이다. CNF는 신경망이 정의한 vector field를 따라 noise를 데이터로 연속적으로 옮기는 생성 모델이며, vector field는 각 시점과 위치에서 입자가 어느 방향으로 얼마나 빠르게 움직이는지를 지정하는 함수를 말한다. 기존 CNF는 maximum likelihood로 학습하려면 학습 step마다 값비싼 ODE 시뮬레이션이 필요해 고차원 이미지로 확장하지 못했다.
FM은 목표 probability path를 생성하는 vector field에 신경망을 직접 회귀시키는 단순한 손실로 이 문제를 푼다. 목표 field 자체는 닫힌 형태로 알 수 없지만, 데이터 샘플 하나에 조건부인 field만 회귀하는 Conditional Flow Matching(CFM)이 원래 목표와 같은 gradient를 준다는 정리 덕분에 샘플 단위로 편향 없이 학습할 수 있다. 이 구성은 기존 diffusion 경로를 특수 사례로 포함하며, diffusion 경로에 FM을 써도 score matching보다 학습이 안정적이다.
논문의 두 번째 핵심 요소는 optimal transport(OT) 경로다. 평균과 표준편차를 시간에 선형으로 두면 conditional flow가 두 Gaussian 사이의 OT displacement map이 되어 입자가 직선을 등속으로 움직인다. 이 경로로 학습한 모델은 CIFAR-10과 ImageNet 32/64/128에서 DDPM, score matching, ScoreFlow보다 likelihood와 FID가 모두 좋고, 같은 수치 오차에 이르는 NFE는 diffusion 모델의 약 60%다. 이 wiki의 physical-ai 페이지들이 다루는 π0, SmolVLA, GR00T N1의 action 생성부가 이 논문의 학습 목표를 쓴다.
배경
diffusion 모델의 성과와 제약
2022년 시점의 이미지 생성 성과(Ramesh et al. 2022; Rombach et al. 2022)는 대부분 diffusion 모델의 확장 가능하고 비교적 안정적인 학습(Ho et al. 2020; Song et al. 2020b) 덕분이었다. 그러나 diffusion 과정이라는 단순한 확률 과정에 묶여 있어 샘플링 probability path의 선택지가 좁고, 그 결과 학습 시간이 매우 길며 효율적 샘플링을 위해 DDIM(Song et al. 2020a)이나 exponential integrator(Zhang & Chen 2022) 같은 별도 기법이 필요했다.
continuous normalizing flow와 학습 비용
논문은 diffusion보다 일반적이고 결정론적인 틀인 CNF(Chen et al. 2018)에서 출발한다. CNF는 임의의 probability path를 모델링할 수 있고 diffusion 과정이 만드는 path도 포함한다(Song et al. 2021). 문제는 학습이다. denoising score matching(Vincent 2011)으로 효율적으로 학습되는 diffusion을 빼면 확장 가능한 CNF 학습 알고리즘이 없었다.
| 학습 방식 | 대표 연구 | 문제 |
|---|---|---|
| maximum likelihood | Grathwohl et al. 2018 (FFJORD) | forward와 backward 모두 순차적 ODE 시뮬레이션이 필요해 비용이 크다 |
| ODE 정규화 | Dupont et al. 2019, Finlay et al. 2020, Onken et al. 2021, Kelly et al. 2020 등 | ODE를 풀기 쉽게 만들 뿐 학습 알고리즘 자체는 그대로다 |
| simulation-free, 선형 보간 경로 | Rozen et al. 2021 | 고차원에서 추정하기 어려운 적분이 들어간다 |
| simulation-free, 일반 경로 | Ben-Hamu et al. 2022 | 미니배치 환경에서 gradient가 편향된다 |
| diffusion 과정으로 경로를 간접 정의 | Sohl-Dickstein et al. 2015, Ho et al. 2020, Song et al. 2020b | 단순 diffusion 과정이 만드는 경로 밖으로 나갈 수 없다 |
FM의 목표는 이 표의 빈자리, 즉 편향 없는 gradient로 고차원까지 확장되면서 diffusion 밖의 일반적 경로까지 쓸 수 있는 simulation-free 학습법을 만드는 것이다. 논문은 diffusion 과정을 거쳐 경로를 유도하는 단계를 건너뛰고 probability path를 직접 다루는 관점을 택한다.
핵심 개념
probability path는 시간 의존 확률밀도 , 즉 마다 인 밀도들의 궤적이다. 에서는 표준 정규분포 같은 단순 분포이고 에서는 데이터 분포 와 거의 같아지도록 설계한다.
flow는 vector field 가 정의하는 ODE , 의 해 이며, 시간에 따라 변하는 diffeomorphism이다. flow는 push-forward 식 로 밀도를 옮기고, 그 식은 다. 이 관계가 성립할 때 vector field 가 probability path 를 생성한다고 말한다.
continuity equation 은 vector field가 path를 생성하는지 판정하는 필요충분조건 PDE다(Villani 2009). Theorem 1과 부록 D의 Lemma 1은 이 식을 직접 검사하는 방식으로 증명된다.
conditional path 는 데이터 샘플 하나에 조건부인 path이고, marginal path 는 conditional path를 데이터 분포 로 평균낸 path다. vector field에도 같은 구분이 있다. FM의 핵심은 알 수 없는 marginal 대상을 샘플 단위로 정의되는 conditional 대상의 집계로 바꾸는 데 있다.
| 기호 | 뜻 |
|---|---|
| 알 수 없는 데이터 분포. 샘플만 얻을 수 있다 | |
| , | marginal probability path와 그것을 생성하는 marginal vector field |
| , | 샘플 에 조건부인 conditional path와 conditional vector field |
| 학습 대상 신경망 vector field | |
| , | marginal flow와 conditional flow |
| , | Gaussian conditional path의 시간 의존 평균과 스칼라 표준편차 |
| NFE | ODE solver가 샘플 하나를 만들며 vector field를 호출한 횟수. 생성 비용의 척도 |
| BPD | bits per dimension. 차원당 음의 로그가능도를 2진 단위로 잰 밀도 추정 지표 |
방법
Flow Matching 목표
목표 path 와 그것을 생성하는 vector field 가 주어졌다고 하면 FM 손실은 다음과 같다.
, ,
즉 신경망 로 를 회귀하는 단순한 최소제곱 문제이며, 손실이 0에 이르면 학습된 CNF가 를 생성한다. 그러나 이 손실은 그대로 쓸 수 없다. 를 만족하는 path는 무수히 많고, 원하는 path를 생성하는 의 닫힌 형태를 일반적으로 알 수 없기 때문이다.
conditional 경로의 집계
논문의 첫 번째 관찰은 목표 path와 field를 샘플 단위 대상의 혼합으로 만들 수 있다는 것이다. 데이터 샘플 마다 conditional path 를 두고, 에서 , 에서 주변에 집중된 분포(예: , 충분히 작은 )가 되도록 설계한다. 이를 로 marginalize하면 marginal path가 된다.
, 특히
conditional vector field도 같은 방식으로 집계한다. 가 를 생성한다고 할 때 marginal field는 다음과 같이 정의한다( 가정).
Theorem 1은 이렇게 가중 평균한 marginal field가 marginal path를 정확히 생성함을 continuity equation으로 보인다. 즉 알 수 없는 marginal field를 샘플 하나에만 의존하는 단순한 conditional field들로 분해할 수 있다. 저자들은 이 정리가 Peluchetti(2021)의 Diffusion Mixture Representation Theorem에서도 유도된다고 적는다.
Conditional Flow Matching
marginal path와 field의 정의에는 intractable한 적분이 들어 있으므로 FM 손실의 편향 없는 추정량을 그대로 만들 수는 없다. 대신 conditional field를 회귀 목표로 삼는 CFM 손실을 쓴다.
, , ,
에서 샘플링하고 를 계산하는 일은 샘플 단위로 정의되어 있어 쉽다. Theorem 2는 일 때 두 손실이 와 무관한 상수만큼만 다르며 따라서 임을 보인다. 증명은 2-norm을 전개한 뒤 가 와 무관하다는 점을 쓰고 Fubini 정리로 적분 순서를 바꾸는 것이다(부록 A). 결과적으로 marginal path나 marginal field에 한 번도 접근하지 않고 CNF를 학습할 수 있으며, 남는 일은 적절한 conditional path와 field를 설계하는 것뿐이다.
| 항목 | FM 목표 | CFM 목표 |
|---|---|---|
| 회귀 대상 | marginal field | conditional field |
| 샘플링 분포 | 과 | |
| 계산 가능성 | 닫힌 형태를 모른다 | 샘플 단위로 즉시 계산된다 |
| gradient | 같다 (Theorem 2) | 같다 (Theorem 2) |
| 착안점 | 없음 | denoising score matching이 score matching을 대체하는 논리 |
Gaussian conditional 경로
conditional path의 일반 족으로 논문은 Gaussian 를 다룬다. 평균 와 스칼라 표준편차 는 임의의 미분 가능 함수이고, 경계 조건으로 , (모든 conditional path가 에서 같은 표준 Gaussian noise로 수렴), , (에 집중된 Gaussian)을 건다.
한 path를 생성하는 vector field는 무한히 많다. continuity equation에 divergence-free 성분을 더해도 같은 path가 나오기 때문인데, 회전 대칭 분포의 회전 성분처럼 대부분은 분포를 바꾸지 않으면서 계산만 늘린다. 따라서 저자들은 Gaussian의 canonical 변환에 대응하는 가장 단순한 field를 고른다. 표준 Gaussian 를 평균 , 표준편차 의 Gaussian으로 보내는 affine 변환이 conditional flow다.
이 flow가 conditional path를 생성하므로 이고, 가 가역 affine map이라 를 닫힌 형태로 풀 수 있다. Theorem 3에 따라 를 정의하는 유일한 vector field는 다음과 같다.
로 reparameterize하면 CFM 손실은 가 된다. 학습은 noise 와 데이터 을 뽑고, 시간 에서 위치의 신경망 출력이 의 시간 미분과 같아지도록 회귀하는 것으로 요약된다.
diffusion 경로의 재현
diffusion 모델은 데이터에 noise를 조금씩 더해 순수 noise에 가깝게 만드는 확률 과정이며, 임의의 시점에서 닫힌 형태를 얻으려면 엄격한 조건이 붙는다. 그 결과가 특정 평균과 표준편차를 갖는 Gaussian conditional path이므로, 이 틀에서 와 만 맞추면 diffusion 경로가 재현된다. 시간 방향은 논문 관례(t=0이 noise, t=1이 데이터)에 맞게 뒤집는다.
| 경로 | conditional vector field | 정의 구간 | ||
|---|---|---|---|---|
| VE (variance exploding) | (는 증가 함수, , ) | 유한 시간에 진짜 noise에 도달하지 못한다 | ||
| VP (variance preserving) | , , | 위와 같다 | ||
| OT | $1 - (1 - \sigma_{min})t$ | 모든 |
이렇게 얻은 diffusion conditional field는 Song et al.(2020b)의 probability flow ODE(그 논문 식 13)를 conditional diffusion 과정에 제한한 것과 일치한다. 부록 D는 SDE 의 Fokker-Planck 식을 continuity equation 꼴로 고쳐 라는 vector field를 얻고, 시간을 뒤집는 Lemma 1()을 적용해 VE와 VP 모두에서 Theorem 3의 식과 같아짐을 보인다.
같은 경로라도 학습 목표가 다르면 결과가 다르다. diffusion conditional field를 FM 목표와 결합하면 기존 score matching보다 학습이 더 안정적이고 견고하며, 실험에서도 성능이 높았다. 또한 diffusion 경로는 diffusion 과정의 해로 유도된 탓에 유한 시간 안에 진짜 noise 분포에 도달하지 못하고, 실무에서는 샘플링과 likelihood 평가용 를 적당한 Gaussian으로 근사한다. FM 구성은 와 를 직접 정하므로 이런 제약 없이 경로를 완전히 통제한다.
optimal transport 경로
diffusion 과정을 거치지 않고 경로를 직접 정할 수 있다면 평균과 표준편차를 시간에 선형으로 두는 것이 가장 자연스럽다. , 로 두면 Theorem 3의 field는 이고, conditional flow는 이다. CFM 손실은 다음과 같이 단순해진다.
즉 회귀 목표가 라는 시간과 무관한 방향 벡터다. 이 선택은 직관적일 뿐 아니라 최적이기도 하다. 는 두 Gaussian 과 사이의 OT displacement map이며, McCann(1997)의 OT interpolant 에서 첫 분포가 표준 Gaussian일 때 displacement map이 정확히 이 affine 꼴이 된다(같은 논문 Example 1.7).
OT displacement map 아래에서 입자는 항상 직선을 등속으로 움직인다. 반면 diffusion 경로의 샘플링 궤적은 최종 샘플을 지나쳤다가 되돌아오는 overshoot이 생겨 불필요한 되돌림이 발생하는데, OT 경로는 직선을 유지한다(Figure 3). 회귀 난이도에도 차이가 있다. OT field는 꼴로 쓸 수 있어 시간에 대해 방향이 일정한 반면, diffusion의 conditional score function은 시간에 따라 방향이 바뀐다.
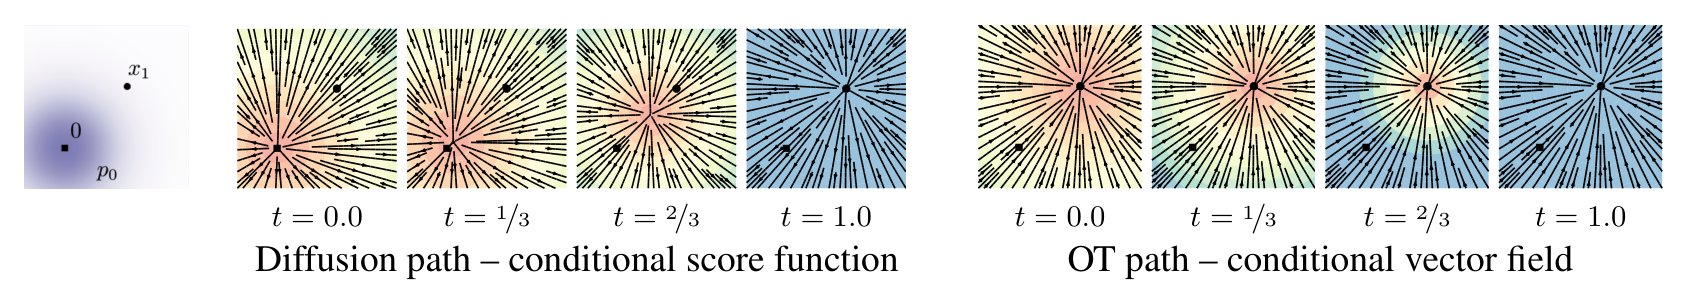
| 성질 | diffusion 경로 (VE, VP) | OT 경로 |
|---|---|---|
| 입자 궤적 | 굽어 있고 overshoot이 생길 수 있다 | 직선, 등속 |
| conditional field의 방향 | 시간에 따라 바뀐다 | 시간에 대해 일정 ( 꼴) |
| 정의 구간 | 유한 시간에 진짜 noise에 도달하지 못한다 | 모든 에서 정의 |
| 경로의 출처 | diffusion 과정의 해 | 두 Gaussian 사이 OT displacement interpolant |
| 회귀 목표 (reparameterize 후) | 의 일반 꼴 |
한 가지 주의점이 있다. conditional flow가 OT라고 해서 marginal vector field까지 OT 해가 되는 것은 아니다. 저자들은 marginal field가 비교적 단순하게 유지될 것으로 기대한다고만 적는다.
학습과 샘플링 절차
OT 경로 기준으로 학습 한 step은 다음 다섯 단계로 정리된다. 각 단계는 식 20부터 23까지에서 그대로 읽어낼 수 있으며, ODE를 푸는 단계가 학습 루프 어디에도 없다는 점이 simulation-free의 뜻이다.
| 단계 | 연산 | 비고 |
|---|---|---|
| 1. 샘플 추출 | , , | 데이터 미니배치와 noise, 시간을 독립적으로 뽑는다 |
| 2. 중간 위치 계산 | noise와 데이터의 선형 보간 | |
| 3. 회귀 목표 계산 | 시간과 무관한 방향 벡터 | |
| 4. 손실 계산 | 신경망을 한 번만 forward한다 | |
| 5. 파라미터 갱신 | 손실의 gradient로 갱신 | Theorem 2에 의해 FM 목표의 gradient와 같다 |
diffusion 경로를 쓸 때는 2단계와 3단계의 와 만 VP 경로의 평균과 표준편차로 바꾸면 되고 나머지는 같다. 즉 경로 선택은 학습 코드에서 보간 식 두 줄의 차이다.
샘플링은 학습과 분리된 단계다. 를 뽑고 학습된 를 ODE solver에 넘겨 에서 까지 적분하면 가 샘플이다. solver는 학습과 무관하게 고를 수 있으며, 논문은 적응형 dopri5로 품질과 likelihood를 재고 고정 스텝 Euler, midpoint, RK4로 저비용 샘플링을 비교한다. 이때 solver가 를 호출한 횟수가 NFE이고, 적응형 solver의 NFE는 vector field가 얼마나 매끄러운지에 따라 달라진다.
샘플링과 likelihood 계산
샘플링은 noise 를 뽑고 학습된 로 flow ODE를 에서 풀어 를 얻는 것이다. diffusion 모델은 SDE로도 샘플링할 수 있지만 매우 비효율적이며, DDIM이나 exponential integrator 같은 빠른 sampler도 ODE 관점을 직접 쓴다. ODE solver는 비슷한 계산 비용에서 오차가 낮고(Kloeden et al. 2012) Euler, midpoint, RK4, 적응형 dopri5 등 선택지가 많다.
likelihood 계산은 부록 C가 다룬다. continuity equation과 flow ODE에서 instantaneous change of variables 이 나오므로, 임의의 데이터 점 에서 ODE를 시간 역방향으로 풀며 divergence를 함께 적분하면 으로 모델 확률을 얻는다. 차원 divergence 계산은 비싸므로 인 확률 벡터 로 를 쓰는 Hutchinson trace estimator(Grathwohl et al. 2018)로 대체하며, 이 추정량은 편향이 없다.
이미지에는 픽셀값을 에서 으로 옮기는 변환 이 들어가므로 log-likelihood에 가 더해지고, bits per dimension은 이 된다.
baseline 손실의 정의
논문은 같은 Gaussian 경로 위에서 세 diffusion baseline을 정의한다(부록 E.1). score matching 손실은 이고, Gaussian path에서 다. 가 학습 대상 score function이다.
| baseline | 손실 | 출처 |
|---|---|---|
| Score Matching (SM) | 인 score matching | Song & Ermon 2019 |
| ScoreFlow (SF) | 인 score matching. NLL 상한에서 유도 | Song et al. 2021 |
| DDPM (noise matching) | . 가 학습 대상 noise 함수 | Ho et al. 2020 |
diffusion 경로는 표준 VP를 쓰고 , , 이다. 시간은 , 에서 샘플링한다. score matching 모델의 샘플은 vector field 로 ODE를 풀어 만들고, DDPM은 로 두고 같은 식을 쓴다.
결과
실험 설정
실험은 CIFAR-10과 ImageNet 32, 64, 128에서 수행했다. 이미지 모델은 Dhariwal & Nichol(2021)의 U-Net을 최소 변경으로 쓰고, 2D checkerboard 예제는 512 뉴런 5층 MLP를 쓴다. FM-OT, FM-Diffusion, SM-Diffusion 세 방법은 항상 같은 아키텍처, 같은 hyper-parameter, 같은 epoch 수로 학습하되 baseline에는 수렴을 위해 더 많은 iteration을 허용했다. 모든 모델은 unconditional이다.
- 평가 solver: dopri5, 절대와 상대 tolerance 1e-5, torchdiffeq 라이브러리
- 지표: NLL은 bits per dimension, 샘플 품질은 FID(Heusel et al. 2017), 생성 비용은 적응형 solver가 tolerance에 도달할 때까지 vector field를 호출한 평균 횟수 NFE(5만 개 샘플 평균)
- NLL 보고: uniform dequantization과 개 noise의 importance-weighted 추정 ,
- 정밀도: CIFAR-10과 ImageNet-32는 32비트, ImageNet-64/128/256은 16비트 mixed precision
- optimizer: Adam(, , weight decay 0, ). polynomial decay 스케줄은 warm-up 동안 $10^{-8}에서 peak까지 선형으로 올린 뒤 마지막 step까지 $10^{-8}으로 선형 감소
- FID 계산: CIFAR-10과 ImageNet-32/64는 TensorFlow GAN 라이브러리, ImageNet-128은 Dhariwal & Nichol(2021)의 공개 평가 스크립트
| 항목 | CIFAR-10 | ImageNet-32 | ImageNet-64 | ImageNet-128 |
|---|---|---|---|---|
| Channels | 256 | 256 | 192 | 256 |
| Depth | 2 | 3 | 3 | 3 |
| Channels multiple | 1,2,2,2 | 1,2,2,2 | 1,2,3,4 | 1,1,2,3,4 |
| Heads | 4 | 4 | 4 | 4 |
| Heads Channels | 64 | 64 | 64 | 64 |
| Attention resolution | 16 | 16,8 | 32,16,8 | 32,16,8 |
| Dropout | 0.0 | 0.0 | 0.0 | 0.0 |
| Effective Batch size | 256 | 1024 | 2048 | 1536 |
| GPUs | 2 | 4 | 16 | 32 |
| Epochs | 1000 | 200 | 250 | 571 |
| Iterations | 391,000 | 250,000 | 157,000 | 500,000 |
| Learning Rate | 5e-4 | 1e-4 | 1e-4 | 1e-4 |
| Learning Rate Scheduler | Polynomial Decay | Polynomial Decay | Constant | Polynomial Decay |
| Warmup Steps | 45,000 | 20,000 | 없음 | 20,000 |
Table 3: 데이터셋별 학습 hyper-parameter (Lipman 2022, p.20)
likelihood와 샘플 품질
Table 1의 왼쪽은 같은 U-Net을 DDPM, Score Matching, ScoreFlow, FM-Diffusion, FM-OT 손실로 학습한 결과다. FM-OT는 CIFAR-10과 ImageNet 32, 64의 NLL, FID, NFE 모두에서 가장 좋다. 예를 들어 ImageNet 64×64에서 FM-OT는 FID 14.45를 NFE 138로 얻는데, DDPM은 FID 17.36에 NFE 264, ScoreFlow는 FID 24.95에 NFE 601이 든다. 같은 diffusion 경로에서도 FM 손실(FM w/ Diffusion)이 Score Matching보다 FID와 NFE가 좋고, OT 경로로 바꾸면 세 지표가 다시 개선된다.
| 모델 | CIFAR-10 NLL | FID | NFE | ImageNet 32 NLL | FID | NFE | ImageNet 64 NLL | FID | NFE |
|---|---|---|---|---|---|---|---|---|---|
| DDPM | 3.12 | 7.48 | 274 | 3.54 | 6.99 | 262 | 3.32 | 17.36 | 264 |
| Score Matching | 3.16 | 19.94 | 242 | 3.56 | 5.68 | 178 | 3.40 | 19.74 | 441 |
| ScoreFlow | 3.09 | 20.78 | 428 | 3.55 | 14.14 | 195 | 3.36 | 24.95 | 601 |
| FM w/ Diffusion | 3.10 | 8.06 | 183 | 3.54 | 6.37 | 193 | 3.33 | 16.88 | 187 |
| FM w/ OT | 2.99 | 6.35 | 142 | 3.53 | 5.02 | 122 | 3.31 | 14.45 | 138 |
Table 1 왼쪽: 같은 모델을 다른 방법으로 학습했을 때의 likelihood(BPD), 샘플 품질(FID), 평가 비용(NFE). 낮을수록 좋다 (Lipman 2022, p.8)
CIFAR-10 FID는 기존 연구(Ho et al. 2020; Song et al. 2020b, 2021)가 보고한 값보다 전반적으로 높다. 저자들은 사용한 아키텍처가 CIFAR-10에 최적화되지 않은 탓일 수 있다고 본다. ImageNet 128×128에서는 FM-OT만 학습해 GAN 계열과 비교했다.
| 모델 | NLL | FID |
|---|---|---|
| MGAN (Hoang et al. 2018) | 없음 | 58.9 |
| PacGAN2 (Lin et al. 2018) | 없음 | 57.5 |
| Logo-GAN-AE (Sage et al. 2018) | 없음 | 50.9 |
| Self-cond. GAN (Lučić et al. 2019) | 없음 | 41.7 |
| Uncond. BigGAN (Lučić et al. 2019) | 없음 | 25.3 |
| PGMGAN (Armandpour et al. 2021) | 없음 | 21.7 |
| FM w/ OT | 2.90 | 20.9 |
Table 1 오른쪽: ImageNet 128×128 unconditional 생성의 FID 비교 (Lipman 2022, p.8)
FM-OT의 FID 20.9는 PGMGAN(21.7)과 unconditional BigGAN(25.3)을 앞선다. 저자들은 이 값이 self-supervised ResNet50 조건부를 쓰는 IC-GAN(Casanova et al. 2021)을 제외하면 state-of-the-art라고 적고, IC-GAN은 조건부 방식이 달라 표에서 뺐다. 부록 Figure 11, 12, 13은 세 해상도의 선별하지 않은 샘플 그리드다.
부록 Table 4는 dequantization noise 개수 에 따른 NLL 변화를 보여 준다. 를 늘릴수록 모든 방법의 NLL이 조금씩 내려가고, 순위는 바뀌지 않는다.
| 모델 | CIFAR-10 K=1 | K=20 | K=50 | ImageNet 32 K=1 | K=5 | K=15 | ImageNet 64 K=1 | K=5 | K=10 |
|---|---|---|---|---|---|---|---|---|---|
| DDPM | 3.24 | 3.14 | 3.12 | 3.62 | 3.57 | 3.54 | 3.36 | 3.33 | 3.32 |
| Score Matching | 3.28 | 3.18 | 3.16 | 3.65 | 3.59 | 3.57 | 3.43 | 3.41 | 3.40 |
| ScoreFlow | 3.21 | 3.11 | 3.09 | 3.63 | 3.57 | 3.55 | 3.39 | 3.37 | 3.36 |
| FM w/ Diffusion | 3.23 | 3.13 | 3.10 | 3.64 | 3.58 | 3.56 | 3.37 | 3.34 | 3.33 |
| FM w/ OT | 3.11 | 3.01 | 2.99 | 3.62 | 3.56 | 3.53 | 3.35 | 3.33 | 3.31 |
Table 4: uniform dequantization에서 K별 test set NLL(bits per dimension) (Lipman 2022, p.21)
CIFAR-10(K=50)과 ImageNet 64(K=10) 열은 Table 1과 일치한다. 반면 ImageNet 32는 Score Matching(Table 1 3.56, Table 4 K=15 3.57)과 FM w/ Diffusion(3.54 대 3.56)이 두 표에서 다르며, 논문은 Table 1이 어떤 K를 썼는지 명시하지 않는다.
학습 속도
기존 diffusion 모델은 매우 많은 iteration을 학습한다. 예를 들어 ScoreFlow는 130만, VDM은 1,000만 iteration을 보고했다. FM은 훨씬 빨리 수렴한다. ImageNet 64×64의 학습 중 FID 곡선(Figure 5)에서 FM-OT가 다른 모든 방법보다 빠르게, 그리고 더 낮은 값까지 FID를 내린다.
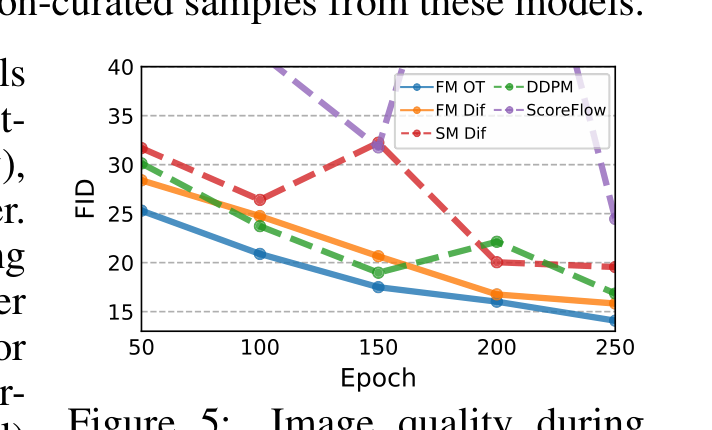
ImageNet-128의 학습량을 Dhariwal & Nichol(2021)과 비교하면 차이가 분명하다. 두 값을 곱한 image throughput 기준으로 FM이 33% 적다.
| 항목 | Dhariwal & Nichol 2021 | FM (이 논문) |
|---|---|---|
| iteration | 436만 | 50만 |
| batch size | 256 | 1,536 |
| 모델 크기 | 기준 | 25% 더 크다 |
| image throughput | 기준 | 33% 적다 |
학습 중 샘플링 비용도 다르다. score matching으로 학습하면 적응형 solver가 필요로 하는 NFE가 학습 과정에서 크게 변하지만, FM으로 학습하면 샘플링 비용이 일정하게 유지된다(Figure 10, CIFAR-10).
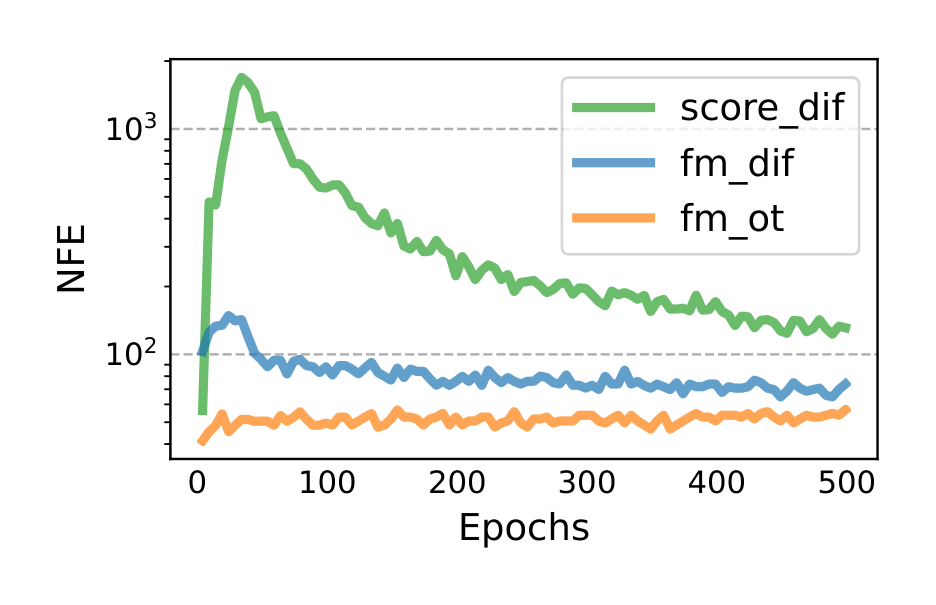
샘플링 효율
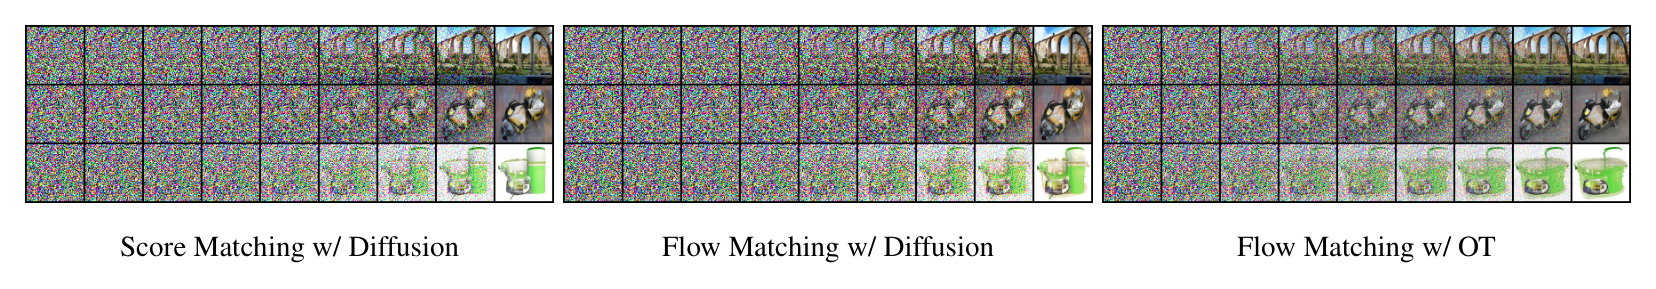
ablation 모델끼리 비교하면 FM-OT는 ODE solver 종류와 무관하게 항상 가장 효율적인 sampler였다. 먼저 샘플링 경로를 정성적으로 보면, 같은 random seed로 ImageNet-64 모델들을 비교했을 때 OT 경로 모델은 이미지를 더 일찍 만들기 시작하고 diffusion 경로 모델은 마지막 시점까지 noise가 이미지를 지배한다.
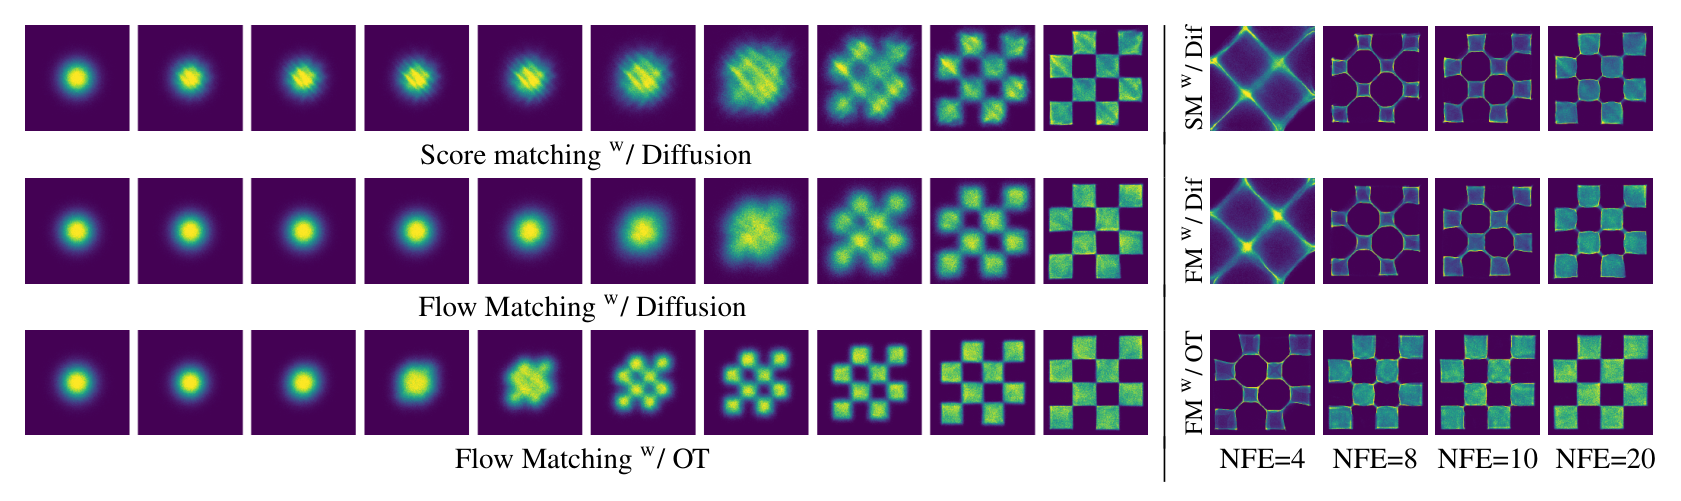
2D checkerboard 실험도 같은 경향을 보인다. OT 경로는 체커보드 패턴을 훨씬 일찍 만들고, FM은 score matching보다 학습이 안정적이다. 오른쪽 패널은 midpoint solver로 NFE 4, 8, 10, 20에서 만든 샘플인데 FM-OT가 가장 적은 스텝으로 패턴을 복원한다. 부록 Figure 9는 ScoreFlow와 DDPM 손실로 같은 실험을 한 궤적을 보여 준다.
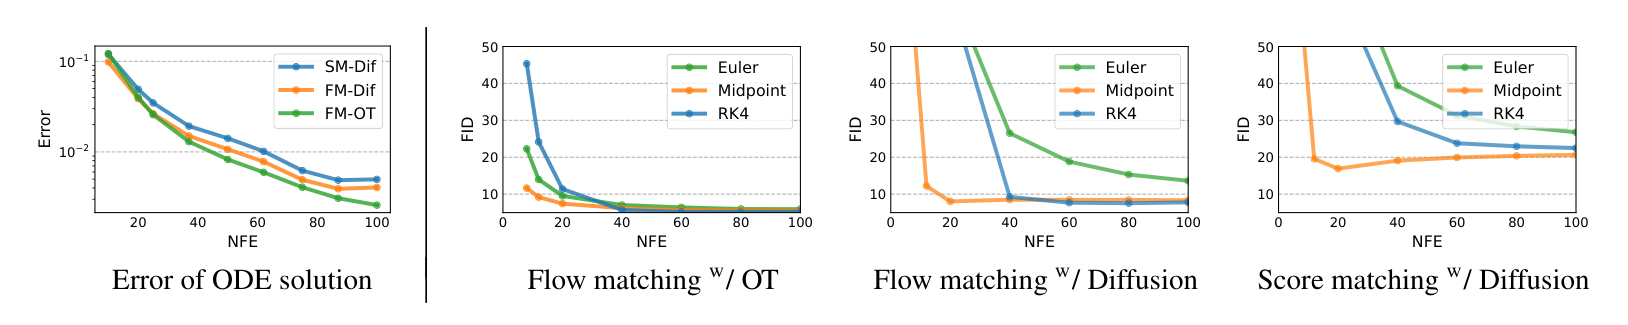
저비용 샘플링은 고정 스텝 solver로 측정했다. Table 1의 ImageNet-32 모델로 100 이하 NFE 샘플을 만들고, 1,000 NFE로 푼 해와 픽셀당 MSE를 256개 noise seed에서 비교한 것이 Figure 7 왼쪽이다. FM-OT 모델은 같은 오차 문턱에 도달하는 데 diffusion 모델의 약 60% NFE만 필요하다. Figure 7 오른쪽은 solver별 FID인데, FM-OT는 매우 낮은 NFE에서도 준수한 FID를 내 품질 대 비용 trade-off가 ablation 모델 가운데 가장 좋다.
부록 Figure 16과 17은 ImageNet-128과 ImageNet 256×256 FM-OT 모델에서 같은 초기 noise로 NFE만 바꿔 만든 샘플을 나열한다(128 모델은 10, 20, 40, 100, 256 모델은 10, 20, 40, 60, 100). 크롭 이미지로 보면 NFE 10과 20에서는 40 이상과 내용이 다르거나 흐릿한 행이 있고, 40 이상에서는 100과 거의 같은 이미지가 나온다.
super-resolution
conditional 생성 실험으로 ImageNet 64×64 이미지를 256×256으로 upsampling했다. 평가는 SR3(Saharia et al. 2022)의 절차를 따라 validation 이미지를 업샘플링한 결과의 FID를 재고, reference(원본 validation set의 FID)와 regression을 baseline으로 둔다.
| 모델 | FID | IS | PSNR | SSIM |
|---|---|---|---|---|
| Reference | 1.9 | 240.8 | 없음 | 없음 |
| Regression | 15.2 | 121.1 | 27.9 | 0.801 |
| SR3 (Saharia et al. 2022) | 5.2 | 180.1 | 26.4 | 0.762 |
| FM w/ OT | 3.4 | 200.8 | 24.7 | 0.747 |
Table 2: ImageNet validation set 64×64에서 256×256 super-resolution 비교. FID는 낮을수록, IS, PSNR, SSIM은 높을수록 좋다 (Lipman 2022, p.9)
FM-OT는 SR3보다 FID를 5.2에서 3.4로, IS를 180.1에서 200.8로 크게 개선하면서 PSNR(24.7 대 26.4)과 SSIM(0.747 대 0.762)은 비슷한 수준을 유지한다. regression은 PSNR과 SSIM이 가장 높지만 FID가 15.2로 가장 나쁜데, Saharia et al.은 FID와 IS가 생성 품질을 더 잘 나타내는 지표라고 주장한다. 부록 Figure 14와 15에 업샘플링 예시가 있다.
한계
| 구분 | 내용 |
|---|---|
| 저자 명시 | conditional flow가 OT라고 해서 marginal vector field가 OT 해인 것은 아니다. 저자들은 marginal field가 비교적 단순할 것으로 기대한다고만 밝힌다 |
| 저자 명시 | CIFAR-10 FID가 기존 연구보다 높다. 아키텍처가 CIFAR-10에 최적화되지 않은 탓으로 추정한다 |
| 저자 명시 | ImageNet-128 비교에서 IC-GAN은 self-supervised ResNet50 조건부를 써서 제외했다. 이를 포함하면 FM-OT가 state-of-the-art가 아니다 |
| 저자 명시 | 향후 과제로 non-isotropic Gaussian이나 더 일반적인 kernel 기반 probability path를 든다 |
| 저자 명시 (사회적 책임 절) | 이미지 생성의 악용 가능성과 대형 모델 학습의 에너지 수요를 언급하고, 적은 gradient update와 image throughput으로 학습되는 방법이 시간과 에너지를 아낀다고 적는다 |
| 자료에 없어 확인 불가 | 실험이 이미지 도메인에 한정된다. 다른 도메인에서의 성능은 이 논문으로 알 수 없다 |
| 자료에 없어 확인 불가 | Table 3에 ImageNet-256 모델과 super-resolution 모델의 hyper-parameter가 없다. Figure 17과 부록 E.2가 256 모델을 언급하지만 설정은 기술되지 않았다 |
| 자료에 없어 확인 불가 | 샘플링 비용은 NFE로만 보고하며 wall-clock 시간은 없다 |
| 자료 내적 불일치 | ImageNet 32 NLL이 Table 1과 Table 4에서 다르다. Score Matching은 3.56 대 3.57(K=15), FM w/ Diffusion은 3.54 대 3.56(K=15)이고 Table 1의 K는 명시되지 않았다 |
| 자료 내적 불일치 | 부록 E.1의 시간 샘플링 문장이 "ε = 10⁻⁵ for training and likelihood and ε = 10⁻⁵ for sampling"으로 같은 값을 두 번 적는다. 서로 다른 값을 적으려던 오기일 가능성이 있으나 raw로는 판정할 수 없다 |
관련 연구
논문 5절은 선행 연구를 CNF 학습, simulation-free 학습, diffusion과 score matching, 동시대 연구로 나누어 FM과의 관계를 밝힌다. 배경 절의 표가 학습 비용 문제를 정리했다면, 아래 표는 FM이 각 계열에서 무엇을 이어받고 무엇을 바꿨는지를 정리한다.
| 계열 | 연구 | FM과의 관계 |
|---|---|---|
| CNF 원류 | Chen et al. 2018 (neural ODE), Grathwohl et al. 2018 (FFJORD) | normalizing flow의 연속 시간 버전. maximum likelihood 학습의 ODE 시뮬레이션 비용이 출발점 |
| ODE 정규화 | Dupont et al. 2019 (augmentation), Yang & Karniadakis 2019, Finlay et al. 2020, Onken et al. 2021, Tong et al. 2020, Kelly et al. 2020 (정규화 항), Du et al. 2022 (적분 구간 확률 샘플링) | ODE를 풀기 쉽게 만들 뿐 학습 알고리즘은 그대로다 |
| simulation-free CNF | Rozen et al. 2021 (prior와 target 사이 선형 보간), Ben-Hamu et al. 2022 (일반 경로) | 각각 고차원 적분 추정 곤란, 미니배치 편향 gradient. FM은 편향 없는 gradient로 고차원까지 확장한다 |
| diffusion과 score matching | Sohl-Dickstein et al. 2015, Ho et al. 2020, Song & Ermon 2019, Song et al. 2020b (denoising score matching, Vincent 2011) | CFM의 착안점. denoising score matching이 score matching에 대해 편향 없는 gradient를 주는 conditional 목표라는 결과를 vector field 회귀로 일반화한다 |
| diffusion 개선 | Song et al. 2021 (loss rescaling), Dhariwal & Nichol 2021 (classifier guidance, 아키텍처), Nichol & Dhariwal 2021, Kingma et al. 2021 (noise schedule 학습) | 뒤의 둘은 단일 파라미터 diffusion 과정이 정의하는 Gaussian 경로만 다루므로 conditional OT 경로를 포함하지 않는다 |
| diffusion bridge | De Bortoli et al. 2021, Wang et al. 2021, Peluchetti 2021 | 무한 시간 denoising 구성의 근사 오차를 유한 시간 diffusion 구성으로 해소한다. FM은 diffusion 구성 자체를 건너뛴다 |
| diffusion과 CNF의 연결 | Maoutsa et al. 2020b, Song et al. 2020b, 2021 | 같은 probability path를 공유하는 diffusion 과정과 CNF의 대응. FM은 그 대응을 diffusion 밖의 경로로 넓힌다 |
| 동시대 | Liu et al. 2022 (rectified flow), Albergo & Vanden-Eijnden 2022 (stochastic interpolants), Neklyudov et al. 2023 (action matching) | 앞의 둘은 유사한 conditional 목표에 독립적으로 도달했다. 뒤는 가 gradient field라고 가정할 때의 implicit 목표다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| Flow Matching (FM) | 목표 probability path를 생성하는 vector field에 신경망을 회귀시켜 CNF를 시뮬레이션 없이 학습하는 목표 |
| Conditional Flow Matching (CFM) | 데이터 샘플 하나에 조건부인 vector field를 회귀 목표로 삼는 tractable 버전. FM과 gradient가 같다 |
| continuous normalizing flow (CNF) | 신경망 vector field로 정의된 ODE의 flow를 따라 noise를 데이터로 변형하는 생성 모델 |
| continuity equation | vector field가 probability path를 생성하는지 판정하는 필요충분조건 PDE. Theorem 1과 Lemma 1의 증명 도구 |
| OT displacement map | 두 분포 사이 OT map 에 대한 . 표준 Gaussian과 다른 Gaussian 사이에서는 평균과 표준편차가 선형으로 변하는 affine map |
| NFE | ODE solver가 샘플 하나를 만들며 vector field를 호출한 횟수. 논문이 생성 비용을 재는 단위 |
관련 페이지
- High-Resolution Image Synthesis with Latent Diffusion Models: 논문 서론이 diffusion 기반 이미지 생성 성과의 예로 인용한 latent diffusion. FM은 그 diffusion을 특수 사례로 포함하는 일반 틀이다
- Scalable Diffusion Models with Transformers: diffusion backbone을 U-Net에서 Transformer로 바꾼 DiT. GR00T N1은 DiT를 flow matching으로 학습해 action head로 쓴다
- π0: A Vision-Language-Action Flow Model for General Robot Control: VLA의 action 출력부를 이산 토큰에서 flow matching으로 바꿔 최대 50Hz control frequency를 얻은 π0. 이 논문의 conditional flow matching loss를 쓴다
- π0.5: a Vision-Language-Action Model with Open-World Generalization: π0의 후속. pre-training은 이산 토큰으로, post-training과 추론은 flow matching action expert로 처리한다
- SmolVLA: A vision-language-action model for affordable and efficient robotics: π0의 "VLM backbone에 flow matching action expert" 구도를 450M 규모로 줄인 모델
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: flow matching으로 학습한 Diffusion Transformer가 120Hz로 모터 action을 생성하는 dual-system VLA. 추론은 forward Euler K=4 step
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: GR00T N1 한국어 입문 해설. flow matching 손실과 추론을 저자 자작 시각화로 설명한다
- Wall-OSS-0.5 Technical Report: Pretrain Once, Act Anywhere: 이산 action 토큰의 cross-entropy와 flow matching을 함께 쓰는 gradient-bridged co-training
- Igniting VLMs toward the Embodied Space: WALL-OSS의 Integration 단계에서 이산 action 예측을 flow matching 기반 연속 action 모델링으로 교체한다
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: VLA action head를 autoregressive, flow, diffusion, hybrid로 분류한 서베이. flow head가 이 논문 계열이다
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 서베이. diffusion과 flow matching으로 continuous action을 생성하는 계열(Octo, RDT-1B, π0)을 짚는다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 허브. 학습 경로에서 π0를 flow matching으로 연속 action을 내는 전환점으로 둔다