Physical AI · PAPER · 2025
Generative Physical AI in Vision: A Survey
요약
이 서베이는 컴퓨터 비전의 생성 모델이 시각적으로 그럴듯한 결과를 넘어 물리 법칙까지 지키게 만드는 연구를 physics-aware generation이라는 하나의 이름으로 묶는다. 저자들은 명시적 물리 시뮬레이터를 쓰는지 여부를 기준으로 이 분야 전체를 PAG-E와 PAG-I 두 부류로 나누고, PAG-E는 다시 생성과 시뮬레이션의 결합 방식에 따라 여섯 패러다임으로 세분한다. arXiv 2501.10928, IEEE 저널 투고 형식 19쪽, 인용 문헌 233편이다.
서베이가 잡은 문제의식은 명확하다. 현재 모델은 픽셀 공간의 시각적 사실성에 맞춰 최적화돼 있을 뿐 개체나 개념 공간의 물리적 타당성에는 맞춰져 있지 않다. 따라서 로봇, 자율주행, 과학 시뮬레이션처럼 물리 법칙 준수가 필수인 응용에서는 화질이 아무리 좋아도 쓸 수 없다는 것이 저자들의 진단이다.
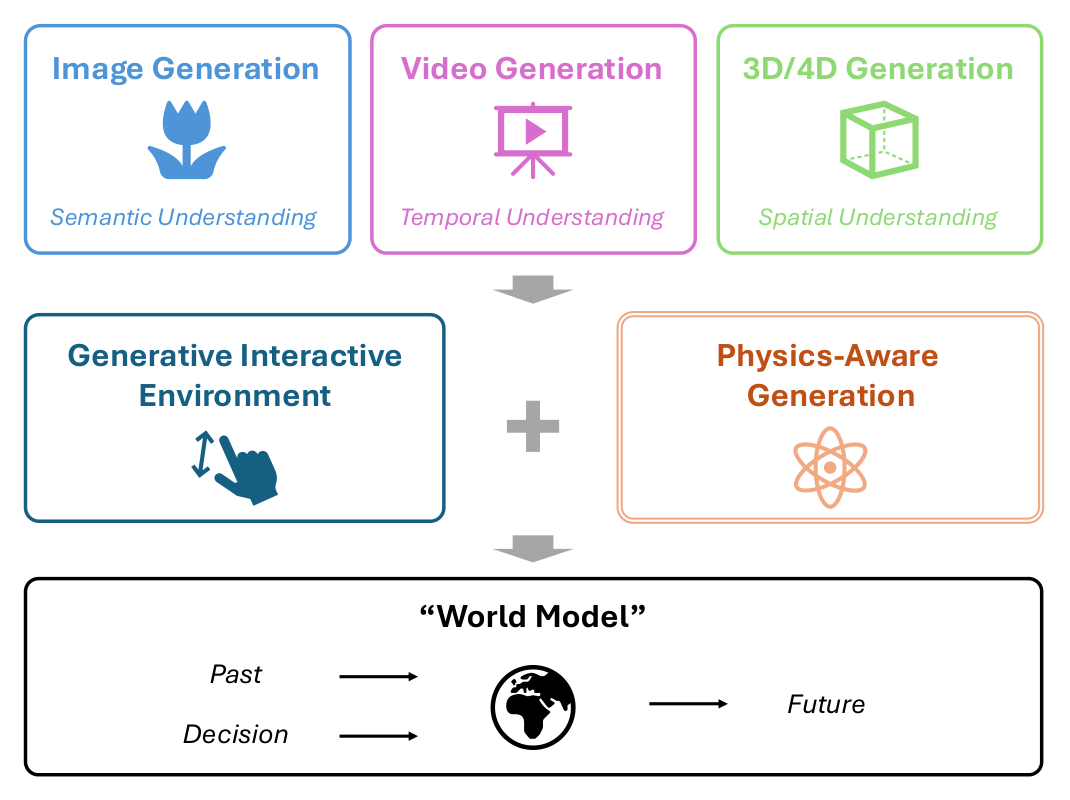
world model은 환경의 동역학을 학습해 미래를 예측하는 모델을 말한다. 생성 모델이 물리적 사실성과 동적 시뮬레이션까지 흡수하면 world simulator로 기능할 여지가 커진다는 것이 서베이의 큰 그림이다.
배경
생성 모델의 계보와 영상 생성의 부상
컴퓨터 비전의 생성 학습은 지난 10년 동안 여섯 계열의 모델을 차례로 통과했다. Variational Autoencoder, Generative Adversarial Network, Diffusion Model, Neural Radiance Field, Gaussian Splatting, Visual Autoregressive Model이 그 목록이다. 이 가운데 diffusion model은 무작위 noise를 반복 denoising으로 다듬어 고품질 출력을 내는 방식이라 최근 연구의 기본 도구 자리를 차지했다.
생성 대상 자체도 이미지의 의미 이해에서 영상의 시간 이해로, 다시 3D의 공간 이해와 4D의 시공간 이해로 넓어졌다. 그중 영상 생성은 프레임 하나 안의 공간 구조뿐 아니라 여러 프레임에 걸친 시간 일관성까지 요구하기 때문에 대형 생성 모델을 고차원 데이터로 확장하는 가장 어려운 시험대가 된다. Sora, Veo2, Hunyuan, Kling, Cosmos 같은 대형 영상 모델이 이 흐름을 대표한다.
영상이 이 논의의 중심에 놓인 이유는 데이터의 성격에 있다. 저자들이 보기에 인터넷에 쌓인 방대한 영상은 실세계에 관한 정보를 담은 저장고이고, 따라서 세계의 암묵적 물리 모델로 볼 수 있다. 즉 영상은 디지털 영역과 물리 영역을 잇는 통로이며 자율주행, 과학 시뮬레이션, 로봇을 포함한 embodied intelligence로 이어지는 하위 과제의 기반이 된다.
상호작용 제어와 world model로 가는 길
생성 과정이 world model이 되려면 사람이나 다른 시스템의 외부 제어를 받아들일 수 있어야 한다. 이 상호작용성이 있어야 결과를 보고 다음 입력을 정하는 의사결정이 가능해지고, 그렇게 만들어진 것을 서베이는 generative interactive environment라고 부른다.
영상 생성에 결합된 제어 신호는 이미 여러 종류가 나와 있다.
- motion vector와 trajectory
- 손 마스크
- latent action
- 로봇 조작 명령
- 카메라 운동
- 시연 데이터(demonstration)
- 자연어 설명
시각적 사실성과 물리적 타당성의 간극
생성에서 견고한 world modeling으로 넘어가려면 실세계 물리를 충실히 이해하고 재현해야 하는데, 여기에 결정적인 간극이 남아 있다. 현재 모델은 픽셀 공간의 시각적 사실성만 최적화 대상으로 삼기 때문에, 물리적으로 불가능한 장면도 화질만 보면 정상 결과와 구분되지 않는다.
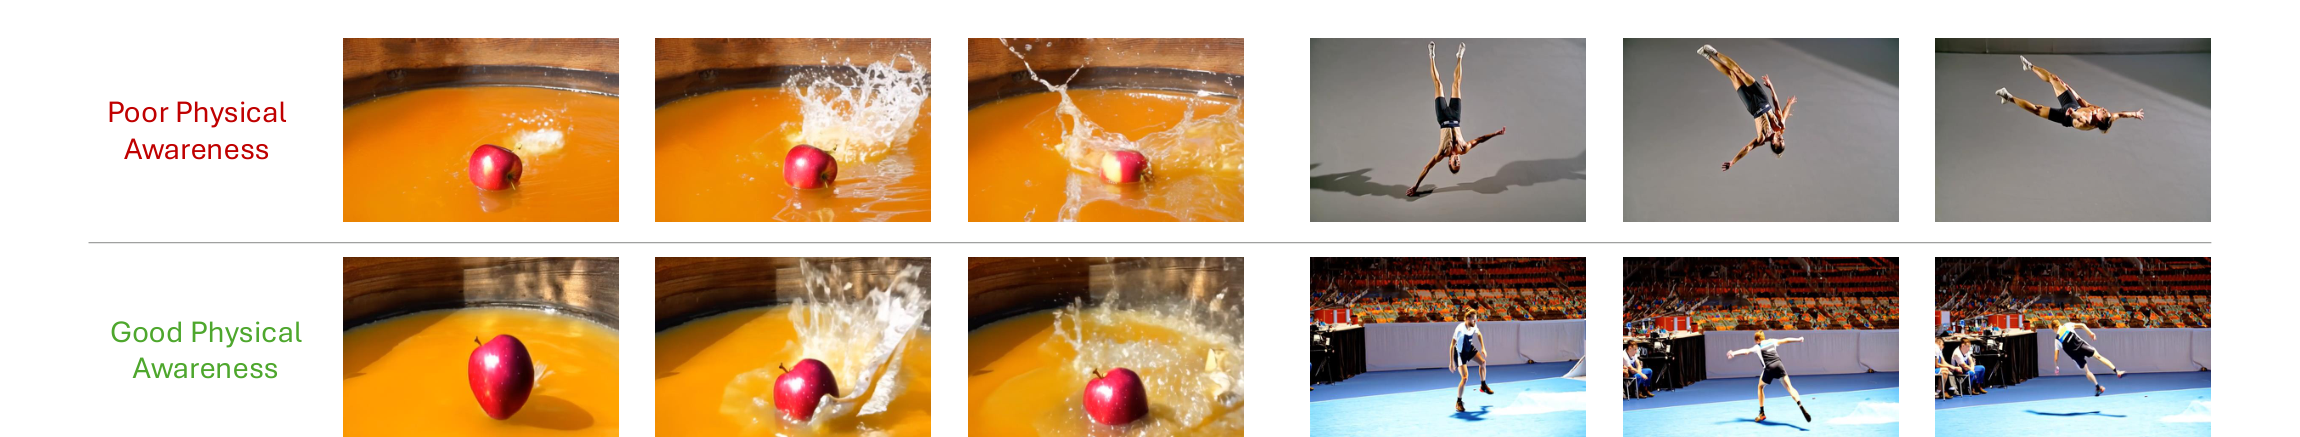
생성 모델이 물리 세계의 시뮬레이터로 쓰이려면 동역학, 인과관계, 재료 속성 같은 물리 법칙을 깊이 이해해야 한다. 그런데 이 분야는 빠르게 커지는 동시에 과제가 제각각이고 정의와 평가 규약이 표준화되지 않은 상태라, 저자들은 흩어진 연구를 한 구조 안에 정리할 서베이가 필요하다고 판단했다.
서베이가 다루는 범위
범위에서 제외한 것도 분명히 적혀 있다. 관심사는 출력물의 물리적 사실성 하나이며, 물리를 모델이나 신경망 구조의 귀납 편향으로 반영하는 접근은 생성 과제와 관련이 있더라도 다루지 않는다.
| 제외 대상 | 제외 이유 |
|---|---|
| Physics-Informed Neural Network 계열 | 물리를 모델 설계의 사전 지식이나 귀납 편향으로 반영하는 접근이라 출력물의 물리적 사실성과 관심사가 다르다 |
| 디블러링, 디헤이징, 화질 개선 | 생성 과제가 아니라 이미지 처리 과제다 |
| 순수 그래픽스의 물리 시뮬레이션 | 서베이를 컴퓨터 비전에 한정하기 위해 뺐다 |
기존 서베이와의 관계도 같은 기준으로 정리된다. physics-informed 머신러닝과 physics-informed 컴퓨터 비전 서베이는 물리 사전 지식을 쓰는 모델 설계 쪽을 강조하므로 이 서베이와 직교한다. 생성 모델 일반, diffusion model, 영상 diffusion model, diffusion 기반 영상 편집을 다룬 서베이들과도 범위가 다르고, 사람 영상이나 동작 생성처럼 특정 도메인에 한정된 서베이와도 구분된다.
핵심 개념
세 가지 기본 연산
서베이는 물리 모델을 , 생성 모델을 , observation을 로 두고 세 연산을 정의한다. observation은 이미지나 영상처럼 모델이 받아들이는 관찰 데이터를 뜻한다.
- physical simulation (PS): . 물리 모델이 입력 observation을 다음 시점의 observation으로 전개한다. 와 는 서로 다른 시뮬레이션 timestep에서 나온 것일 수 있다.
- physical understanding (PU): . 영상 같은 observation에서 그 밑에 깔린 물리 모델을 역으로 추정한다. 물리 모델 를 미리 정해 두고 파라미터 만 추정하는 경우도 여기 든다.
- generation (G): . 조건 로부터 새 콘텐츠를 만든다. 입력과 출력의 modality는 과제에 따라 달라진다.
generation이 범용이라 물리 세계에 대한 강한 이해를 요구하지 않는 경우를 physics-unaware generation(PUG)이라고 부른다.
physics-aware generation의 정의
physics-aware generation(PAG)은 실세계 물리에 대한 강한 이해를 동반한 생성이다. 서베이는 이를 다시 두 부류로 나누는데, 기준은 생성 모델이 물리 인지를 높이려고 물리 시뮬레이션 모델을 명시적으로 쓰는지 여부 하나다.
- PAG-E: 명시적 물리 시뮬레이션을 쓰는 physics-aware generation
- PAG-I: 명시적 시뮬레이션 없이 암묵적 학습만으로 물리 인지를 얻는 physics-aware generation
여섯 개념의 비교
여섯 개념의 관계는 입출력 구성과 명시적 물리 모델 유무로 정리된다.
| 항목 | PS | PU | G | PUG | PAG-E | PAG-I |
|---|---|---|---|---|---|---|
| 입력 (observation) | 예 | 예 | 선택 | 선택 | 선택 | 선택 |
| 입력 (물리) | 예 | 선택 | 선택 | 아니오 | 선택 | 선택 |
| 출력 (observation) | 예 | 선택 | 예 | 예 | 예 | 예 |
| 출력 (물리) | 선택 | 예 | 선택 | 아니오 | 선택 | 선택 |
| 명시적 물리 모델 | 예 | 예 | 선택 | 아니오 | 예 | 아니오 |
| 물리 세계 이해 | 예 | 예 | 선택 | 선택 | 예 | 예 |
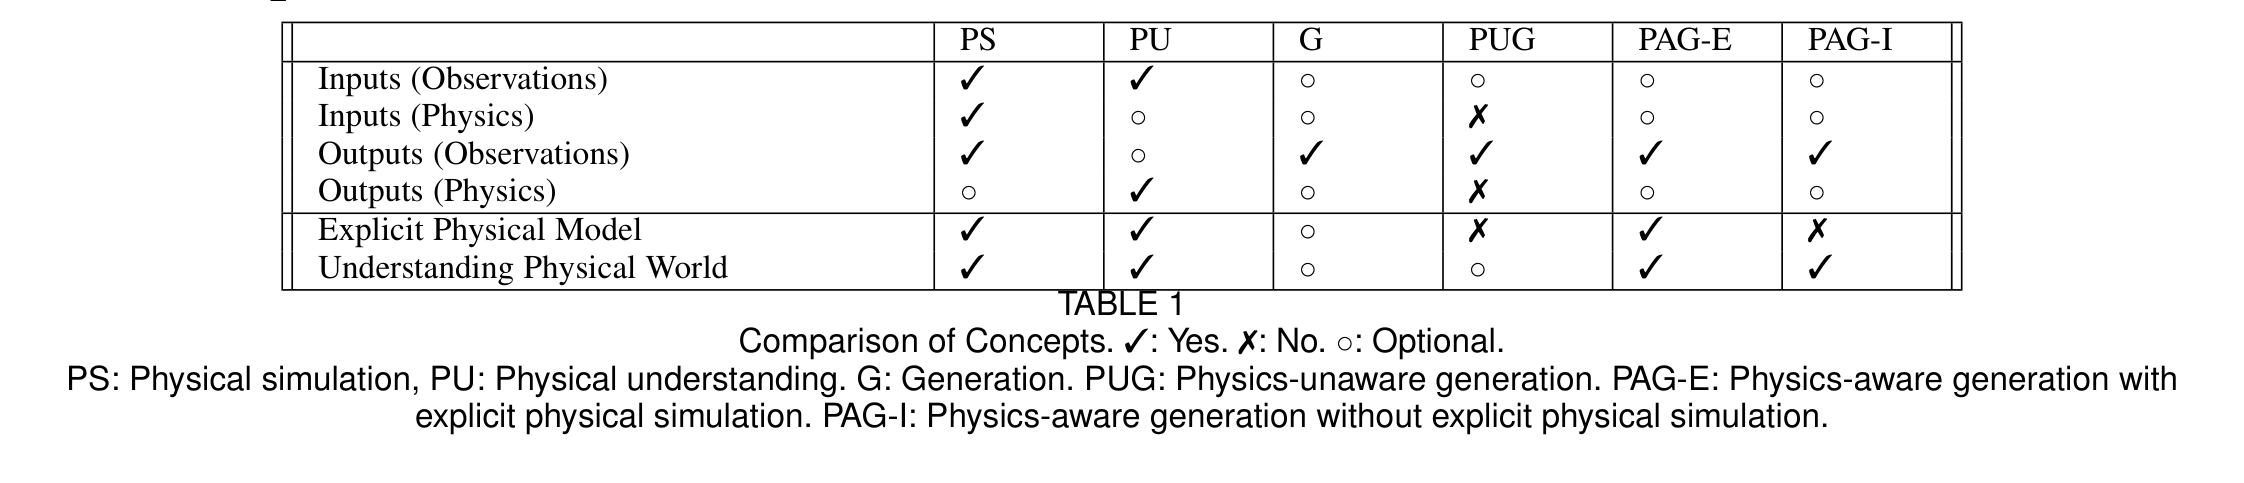
이 표에서 PAG-E와 PAG-I는 "명시적 물리 모델" 한 행에서만 갈린다. 반면 "물리 세계 이해" 행은 둘 다 예이며, 이 점이 두 부류를 PUG와 구분 짓는 기준이다. PUG는 물리 입출력도 명시적 모델도 없고 물리 이해 여부만 선택 사항으로 남는다.
physical understanding 자체는 이 서베이의 주된 관심에서 벗어난다. 저자들은 물리 추론과 모델 발견 연구가 방대하지만 physics-aware 생성 모델링과 대체로 직교한다고 보고, 시뮬레이션을 구동할 물리 파라미터를 얻는 세 경로만 남겨 뒤에서 짧게 다룬다.
생성 모델의 토대
PAG 연구가 실제로 쓰는 생성 모델은 네 계열이다. NeRF와 Gaussian Splatting은 원래 렌더링이나 복원 프레임워크로 분류되지만, 이 서베이는 넓은 의미의 생성 모델로 함께 다룬다.
| 계열 | 표현 방식 | 특징 | 후속 발전 |
|---|---|---|---|
| GAN | generator와 discriminator의 minimax 경쟁 | diffusion model 이전의 주류. latent code에서 고품질 샘플을 한 번에 낸다 | StyleGAN이 고수준 속성을 비지도로 분리했고 후속 버전이 고해상도 결함을 고쳤다 |
| Diffusion Model | 정방향으로 Gaussian noise를 더하고 역방향으로 신경망이 단계별 denoising | GAN보다 학습이 안정적이지만 샘플링 효율이 낮다 | DDIM과 DPM-Solver가 샘플링을 가속하고 latent diffusion이 계산을 latent space로 옮겼다 |
| NeRF | MLP가 3D 좌표와 시선 방향을 색과 밀도로 사상하는 암묵적 표현 | 카메라 광선을 따라 질의하고 volume rendering으로 이미지를 합성한다 | PixelNeRF는 단일 이미지, MIP-NeRF는 앨리어싱 저감, DNeRF는 동적 물체로 확장했다 |
| Gaussian Splatting | 평균, 공분산, 불투명도, 시점 의존 색을 가진 3차원 가우시안 무리 | 격자나 암묵적 신경장이 아닌 명시적 radiance field 표현이라 렌더링이 빠르다 | 4D-GS는 동적 장면, SplatterImage는 단일 뷰 복원, LGM은 3D 생성으로 확장했다 |
diffusion model에는 제어 수단도 함께 정리돼 있다. 정방향 과정은 매 단계 스케줄 파라미터에 따라 noise를 더하고, 역방향 과정은 신경망이 평균과 분산을 예측해 복원한다. 이때 예측 대상은 평균, noise, 깨끗한 데이터 중 하나로 파라미터화할 수 있으며, classifier guidance와 classifier-free guidance가 controllability와 품질을 함께 높인다. controllability는 조건 입력으로 생성 결과를 얼마나 원하는 대로 몰아갈 수 있는지를 뜻한다. score 기반 모델은 미분방정식 관점에서 같은 형식화를 다르게 적은 것이다.
Gaussian Splatting이 뒤에서 자주 등장하는 이유는 표현 방식 자체에 있다. 장면을 입자 무리로 나타내므로 입자 기반 물리 시뮬레이션과 그대로 이어 붙일 수 있다.
물리 시뮬레이션의 구성 요소
재료 12종과 그 속성
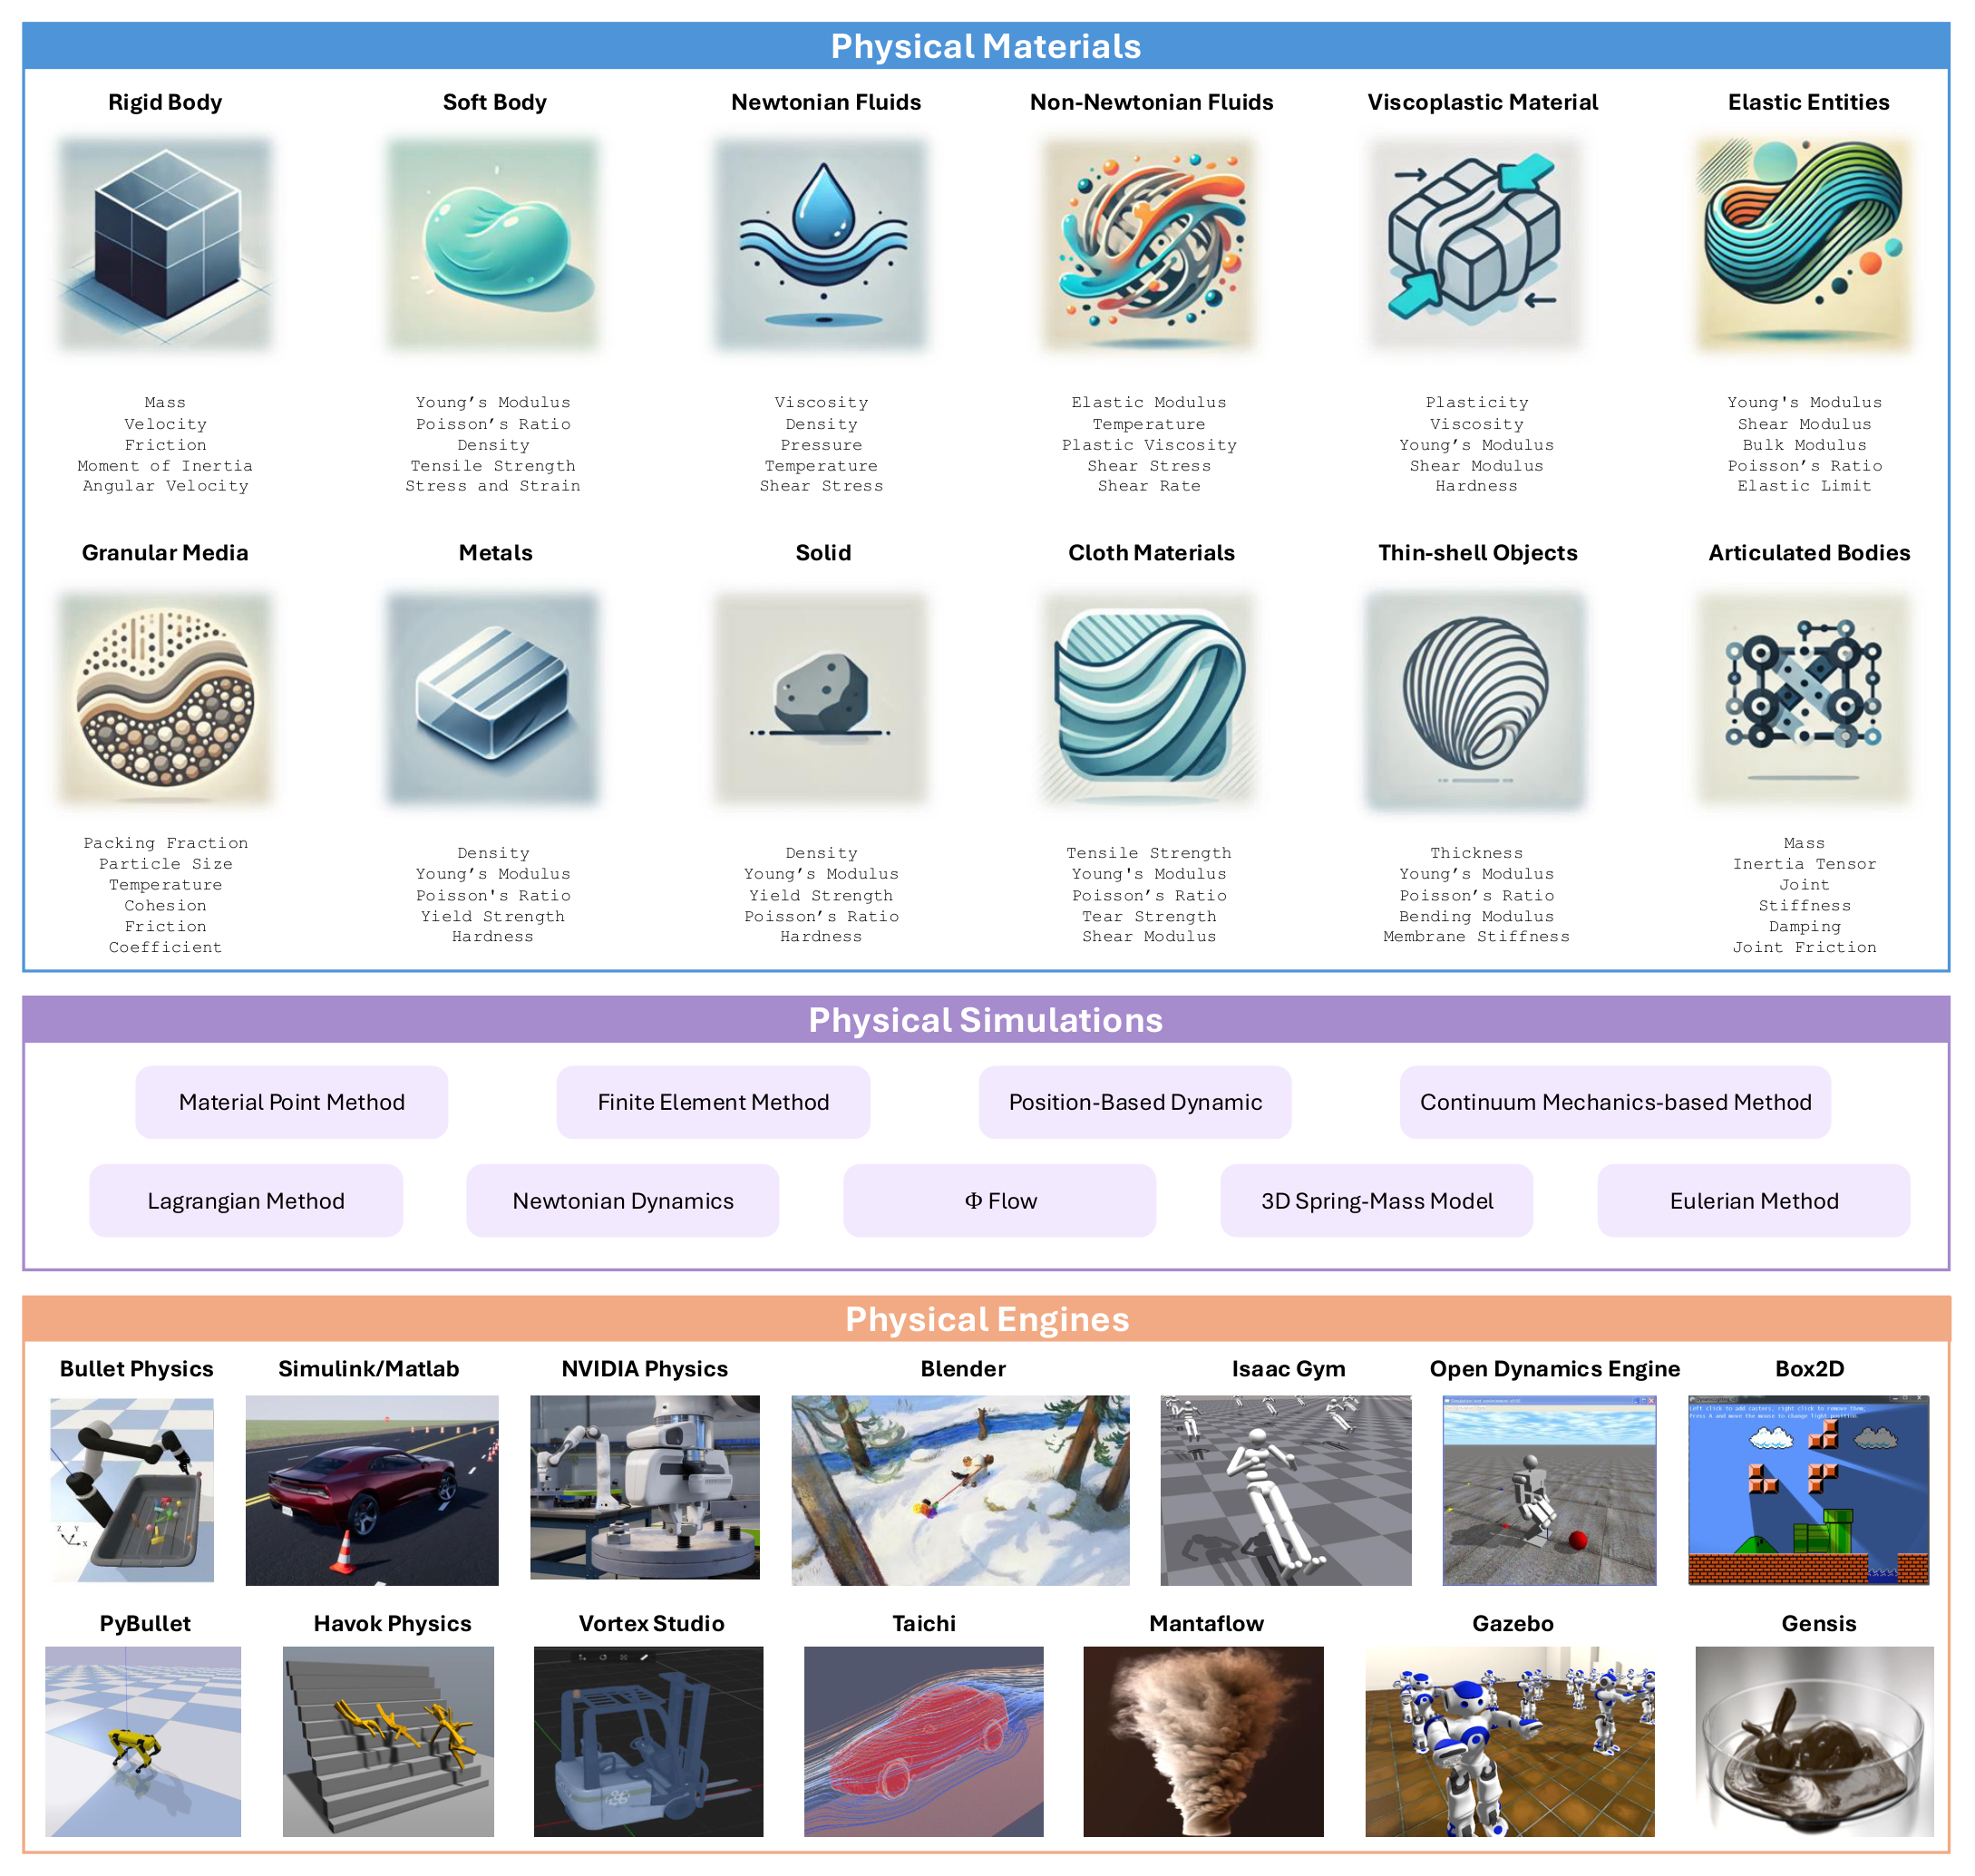
물리 시뮬레이션에서 재료는 모델링 대상 개체가 어떤 가정과 제약을 따르는지를 정한다. 서베이가 정리한 12종은 각각 다른 속성 집합으로 기술된다.
| 재료 | 대표 속성 |
|---|---|
| 강체 (rigid body) | 질량, 속도, 마찰, 관성 모멘트, 각속도 |
| 연체 (soft body) | 영률, 포아송 비, 밀도, 인장 강도, 응력과 변형 |
| 뉴턴 유체 | 점성, 밀도, 압력, 온도, 전단 응력 |
| 비뉴턴 유체 | 탄성 계수, 온도, 소성 점성, 전단 응력, 전단 속도 |
| 점소성 재료 | 소성, 점성, 영률, 전단 탄성계수, 경도 |
| 탄성체 | 영률, 전단 탄성계수, 체적 탄성계수, 포아송 비, 탄성 한계 |
| 입상 매질 | 충전율, 입자 크기, 온도, 응집력, 마찰 계수 |
| 금속 | 밀도, 영률, 포아송 비, 항복 강도, 경도 |
| 고체 | 밀도, 영률, 항복 강도, 포아송 비, 경도 |
| 천 | 인장 강도, 영률, 포아송 비, 인열 강도, 전단 탄성계수 |
| 박막 | 두께, 영률, 포아송 비, 굽힘 계수, 막 강성 |
| 관절체 (articulated body) | 질량, 관성 텐서, 관절 강성, 감쇠, 관절 마찰 |
수치 기법과 기성 엔진
수치 기법 9종은 위 재료의 동역학을 물리 법칙 아래 계산하는 도구다. Material Point Method, 유한요소법, Position-Based Dynamics, 연속체 역학 기반 기법, 뉴턴 동역학, 라그랑주 방법, 오일러 방법, 3D 스프링-질량 모델, Φ-Flow가 여기 든다. 이 가운데 Material Point Method는 입자와 격자를 오가며 연속체 변형을 푸는 기법으로, 장면을 입자로 나타내는 Gaussian Splatting과 결합이 특히 잦다.
기성 물리 엔진 14종은 이 기법들을 곧바로 쓸 수 있게 구현해 둔 플랫폼이다.
- 범용 강체와 다물체: Bullet Physics, PyBullet, Havok Physics, NVIDIA Physics, Open Dynamics Engine, Box2D, Vortex Studio
- 로봇과 병렬 시뮬레이션: Isaac Gym, Gazebo, Genesis
- 유체와 특수 목적: Mantaflow, Taichi, Simulink/Matlab
- 콘텐츠 제작 도구: Blender
물리 파라미터를 얻는 세 경로
시뮬레이션에 사용할 물리 파라미터를 어디서 가져오느냐에 따라 방법이 갈린다. 물리적으로 그럴듯한 출력을 얻으려면 이 값이 정확해야 하므로, 세 경로는 서베이가 physical understanding에서 유일하게 자세히 다루는 부분이다.
| 경로 | 방식 | 장점 | 한계 |
|---|---|---|---|
| 전문가 지정 | 도메인 전문가가 질량, 마찰, 탄성 같은 재료 속성과 중력 같은 환경 조건, 초기 배치를 직접 정한다 | 실용적이고 널리 쓰인다 | 복잡하거나 다양한 장면으로 확장하기 어렵다 |
| 데이터 기반 추정 | 시각 observation에서 파라미터를 자동으로 추정한다. 별도 단계로 두거나 생성 모델 파라미터와 함께 최적화한다 | 고정된 사전 정의값의 경직성을 피한다 | 관찰 품질과 최적화 난이도에 성능이 좌우된다 |
| LLM 추론 | multimodal LLM에 물체 설명을 주고 재료와 그럴듯한 구성을 추론시킨다 | 문맥 지식과 상식 추론을 활용하며 최근 빠르게 는다 | 추론 결과의 물리적 정확성을 보장하지 못한다 |
명시적 시뮬레이션을 쓰는 방법
여섯 패러다임의 정의
PAG-E는 생성 과정 와 시뮬레이션 를 어떻게 결합하느냐에 따라 여섯으로 나뉜다. 한 논문이 여러 패러다임에 걸치면 가장 가까운 하나로 분류한다.
| 패러다임 | 형식화 | 결합 방식 |
|---|---|---|
| Gen-to-Sim (GtS) | 생성이 끝난 뒤 시뮬레이션이 이어지는 순차 구성 | |
| Sim-in-Gen (SiG) | 시뮬레이션 모델이 생성 모델의 부품이나 하위 모듈로 들어간다 | |
| Gen-and-Sim (GnS) | 공유 모델 하나가 생성과 시뮬레이션을 동시에 맡는다 | |
| Sim-Constrained Gen (ScG) | subject to | 시뮬레이션이 생성 모델에 제약이나 지식을 공급한다 |
| Gen-Constrained Sim (GcS) | subject to | 방향이 반대로, 생성 모델이 시뮬레이션에 제약이나 지식을 공급한다 |
| Sim-evaluated Gen (SeG) | 형식화 없음 | 시뮬레이션이 생성 모델을 평가하거나, 생성물이 시뮬레이션 환경 배포를 전제로 만들어진다 |
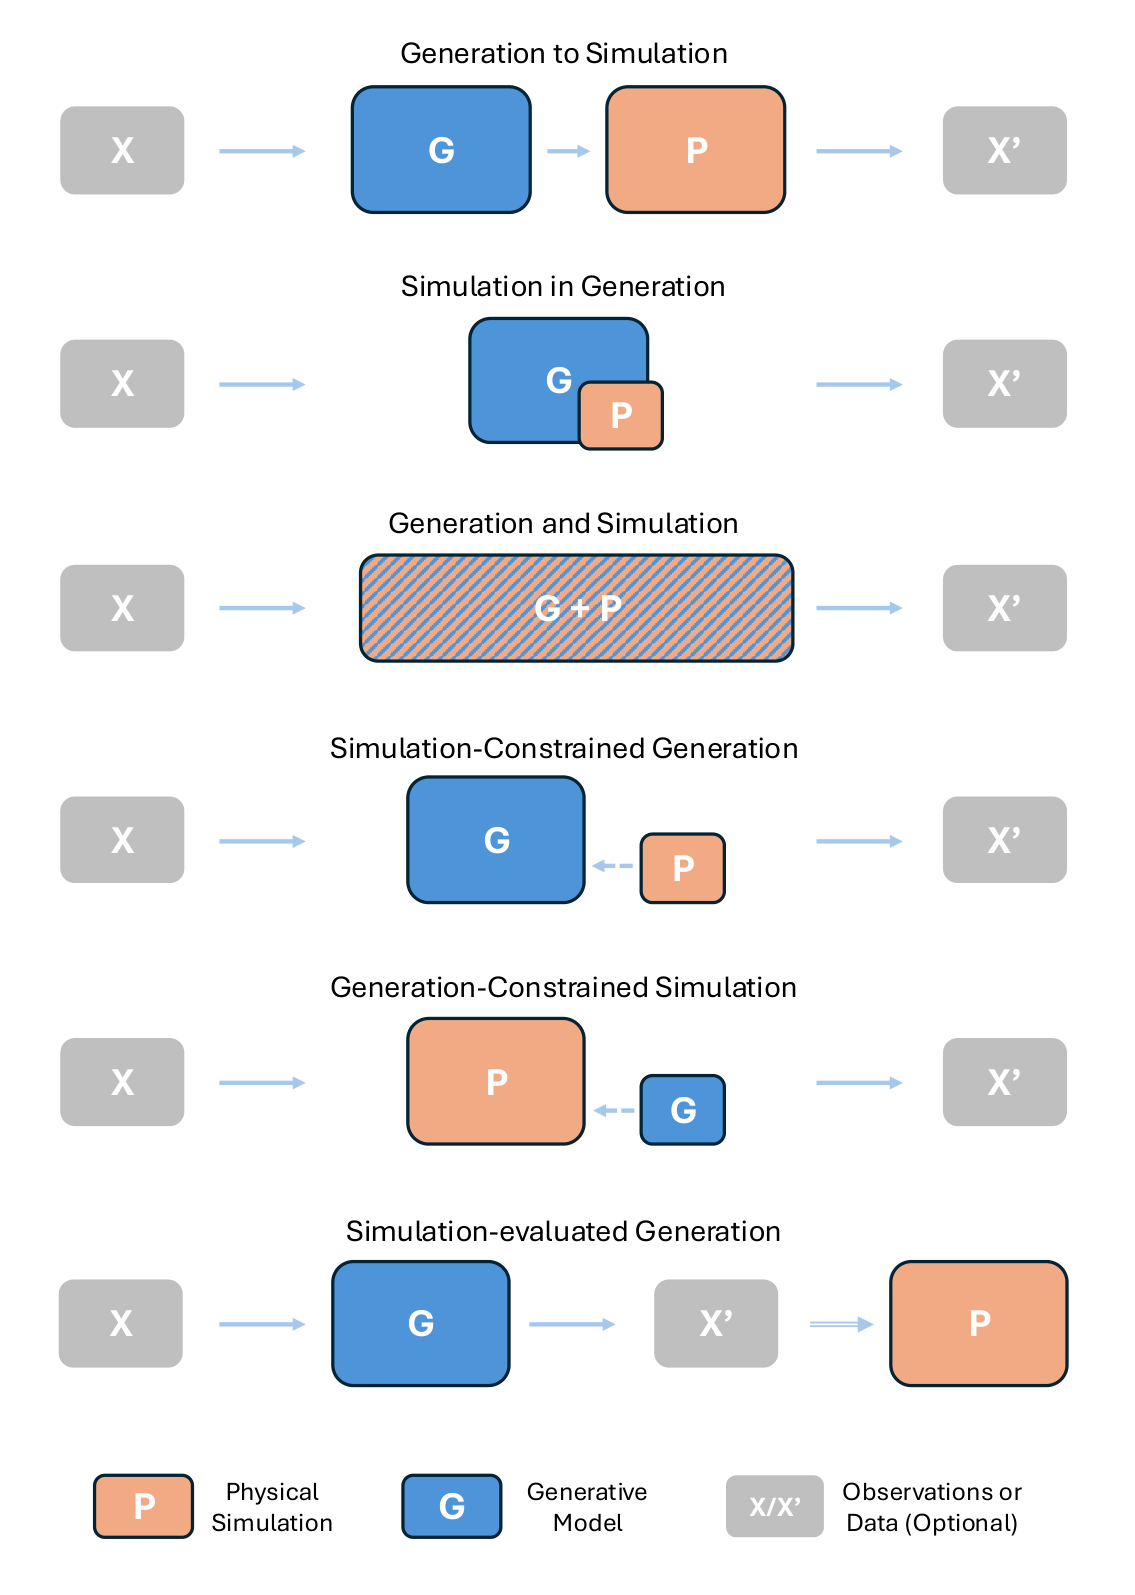
Gen-to-Sim 패러다임
Gen-to-Sim은 생성된 표현에 물리 속성을 사후에 붙여 시뮬레이션과 상호작용이 가능하게 만드는 방식이며, 서베이가 정리한 38편 중 13편이 여기 속해 가장 규모가 크다. 하위 아이디어는 네 가지로 나뉘는데, 어떤 표현 위에 물리를 결합하느냐가 그 기준이다.
NeRF 위의 시뮬레이션 요소. PIE-NeRF는 NeRF 밀도장에 포아송 디스크 샘플링으로 입자를 뿌리고 보로노이 그룹으로 묶어 시뮬레이션 요소를 만든 뒤, Q-GMLS 전략과 라그랑주 동역학을 적용해 사용자가 외력으로 장면을 건드릴 수 있게 한다. Video2Game은 실세계 영상 한 편을 상호작용 가능한 가상 환경으로 자동 변환하는데, NeRF로 복원한 장면을 물체 단위로 분할한 뒤 각 물체에 질량, 마찰, 충돌 형상을 부여하고 WebGL 게임 엔진에서 강체로 실시간 시뮬레이션한다.
가우시안을 시뮬레이션 입자로 쓰는 방법. PhysGaussian은 이방성 정규화로 Gaussian Splatting을 먼저 만든 다음, 가우시안 커널을 Material Point Method의 이산 입자 구름으로 취급해 연속체 역학으로 전개하고 응력과 변형을 추적한다. GASP는 가우시안을 삼각 메시로 변환해 그 위에서 MPM을 적용한 뒤 결과를 다시 가우시안으로 되돌려 렌더링한다. Spring-Gau는 정적 가우시안을 복원한 뒤 앵커 점을 뽑아 스프링으로 연결하고, 미분 가능한 시뮬레이션으로 강성과 감쇠를 영상에서 학습한다. Phy124는 이미지 한 장에서 diffusion prior로 3D 가우시안을 만들고 MPM 시뮬레이터를 붙여 물리 법칙을 따르는 4D 콘텐츠를 만든다. DecoupledGS는 장면 복원 단계에서 물체와 접촉면을 분리해 외력 적용, 장면 충돌, 물체 파괴 같은 상호작용의 사실성을 높인다.
물리 특징장. Feature Splatting은 vision-language model에서 뽑은 의미 특징을 가우시안에 심어 정적 3D 표현과 동적 물리 거동 사이를 잇고, 물리 엔진은 가우시안 중심을 자연어 의미로 지정된 재료 속성이 붙은 입자로 취급해 상호작용을 계산한다. Phys4DGen은 Segment Anything과 LLM으로 장면 안 부위별 재료 구성과 물리 속성을 추론한다. SimAnything은 multimodal LLM으로 물체 수준의 평균 물리 속성을 예측하고, 이 값으로 MPM 시뮬레이션에 쓸 입자 수준 속성 분포를 추정한다.
VR과 로보틱스 응용. VR-GS는 XPBD 물리 시뮬레이션과 3D Gaussian Splatting을 결합해 가상현실에서 3D 콘텐츠를 실시간으로 물리적으로 조작하게 한다. LIVE-GS는 여기에 GPT-4를 결합해 이미지에서 물리 속성을 바로 추론함으로써 VR-GS의 수동 튜닝을 없앤다. DreMa는 장면 복원과 물리 기반 시뮬레이션을 묶어 로봇용 객체 중심 world model을 구성하고, 로봇이 새로운 물체 배치를 상상하고 자기 action의 결과를 예측하게 한다.
Sim-in-Gen 패러다임
Sim-in-Gen은 물리 시뮬레이션을 생성 모델 안의 핵심 하위 모듈로 결합하는 방식이며 38편 중 7편이 여기 속한다. 하위 아이디어는 시뮬레이션 결과를 어디에 쓰느냐로 나뉜다.
시뮬레이션에서 조건을 뽑는 방법. GPT4Motion에서는 GPT-4가 사용자 프롬프트를 Blender 물리 엔진을 제어하는 파이썬 스크립트로 옮기고, Blender가 렌더링한 엣지 맵과 깊이 맵이 ControlNet으로 변형한 Stable Diffusion의 조건으로 들어간다. MotionCraft는 물리 시뮬레이션에서 얻은 광학 흐름으로 noise latent space를 왜곡해 pre-training된 이미지 diffusion 모델에 운동을 부여하며, 유체 동역학과 강체 운동, 다중 개체 상호작용에 맞는 시간 일관 프레임을 만든다. PhysGen은 입력 이미지와 사용자가 지정한 힘, 토크를 뉴턴 법칙 기반 강체 동역학으로 풀고 그 운동으로 이미지를 왜곡해 영상을 만드는데, 이때 물리 파라미터는 대형 foundation model이 추론한다. PhysAnimator는 메시 복원과 시뮬레이션으로 스케치 이미지를 왜곡해 변형체 동역학까지 확장하고, 왜곡된 스케치를 ControlNet에 입력해 영상 diffusion 모델을 유도한다.
시뮬레이션을 최적화기로 쓰는 방법. PhyCAGE는 MPM 시뮬레이션을 물리 인지 최적화기로 취급한다. 손실 함수의 gradient를 3D 가우시안에서 유도한 입자의 초기 속도로 해석하고, 이 속도를 MPM 시뮬레이션에 넘겨 매 gradient 하강 단계 전에 하위 스텝으로 계를 최적화한다. PhysDiff는 diffusion 샘플링 과정 자체에 물리 제약을 결합한다. 매 denoising 단계마다 중간 동작을 물리 시뮬레이터에 통과시켜 보정하고, 보정된 동작을 샘플링에 되먹여 이후 단계를 물리적으로 타당한 방향으로 유도한다. 사람 동작이 바닥을 뚫거나 미끄러지는 결함이 이 방식으로 줄어든다.
시뮬레이션용 프로그램 생성. AutoVFX는 자연어 지시로 사실적이고 물리적으로 타당한 영상 편집을 수행한다. 사용자 지시를 실행 가능한 코드로 바꿔 물체 삽입, 재료 변경, 동적 상호작용, 입자 효과 같은 편집을 만들고, 그 코드를 Blender에서 실행해 조명과 재료까지 반영한 결과를 렌더링한다.
Gen-and-Sim 패러다임
Gen-and-Sim은 생성과 시뮬레이션을 긴밀히 묶어 동시에 또는 번갈아 진행하는 방식이며 38편 중 3편으로 가장 작다.
PAC-NeRF는 다중 시점 영상만으로 기하 파라미터와 물리 파라미터를 함께 추정하는 문제를 오일러와 라그랑주 혼합 표현으로 푼다. 오일러 격자 표현은 NeRF가 기하를 학습하는 데 쓰고, 라그랑주 입자 표현은 시뮬레이션이 물리 파라미터를 학습하는 데 쓴다. iPAC-NeRF는 여기에 라그랑주 입자 최적화를 더해 입자의 위치와 특징을 라그랑주 공간에서 직접 최적화하고, 물리 제약을 지키면서 영상 전체 구간에 걸쳐 기하 구조를 동적으로 다듬는다.
PhysMotion은 생성, 시뮬레이션, 재생성을 순서대로 거치는 image-to-video 방법이다. 먼저 입력 이미지의 전경 물체를 거친 3D Gaussian Splatting 표현으로 바꾸고, MPM으로 힘에 대한 거동을 시뮬레이션해 물리 기반 동역학을 담은 거친 영상을 얻은 다음, diffusion 기반 영상 향상으로 시각적 사실성을 보완한다.
Sim-Constrained Gen 패러다임
Sim-Constrained Gen은 시뮬레이션이 생성 모델의 학습에 제약이나 지도를 거는 방식이며 38편 중 8편이 속한다. 네 가지 하위 아이디어가 있다.
시뮬레이션에서 유도한 손실 함수. PhysComp은 이미지 한 장에서 3D 모델을 만들되 정적 평형 제약이라는 시뮬레이션 기반 물리 모델로 제약해 생성 형상이 물리력 아래에서 사실적으로 거동하게 한다. PhyRecon은 미분 가능한 입자 기반 시뮬레이터를 손실로 통합해 신경 암묵 표면 표현에 직접 영향을 주고 안정성과 물리적 불확실성을 함께 다룬다. Atlas3D는 스스로 서 있는 3D 모델을 만들기 위해 회전 불안정성에 벌점을 주는 standability 손실과 작은 perturbation에도 견디게 하는 안정 평형 손실을 함께 쓴다. Mezghanni 등은 생성 형상이 하나의 연결 요소가 되게 하는 연결성 손실과 중력 아래 안정성을 높이는 안정성 손실이라는 미분 가능한 물리 손실 두 개를 제안했다.
데이터 필터링용 시뮬레이션. DiffuseBot은 임베딩 최적화 단계에서 시뮬레이션을 필터로 쓴다. diffusion 모델이 만든 3D 로봇 설계를 미분 가능한 물리 시뮬레이션으로 평가해 과제별 지표로 성능을 재고, 상위 설계만 남기는 필터링으로 생성 모델의 샘플링 분포를 성공적인 설계 쪽으로 서서히 옮긴다.
물리 피드백 기반 post-training. Furuta 등은 text-to-video 모델에서 사실적인 동적 물체 상호작용을 만드는 문제를 vision-language model의 외부 피드백을 쓴 강화학습 fine-tuning으로 접근한다. VLM 기반 피드백이 물리적 사실성에 대한 시뮬레이션이나 평가 역할을 하며 생성을 제약한다. DSO는 기본 image-to-3D 모델로 3D 자산을 만들고 물리 기반 시뮬레이션으로 자립 안정성을 라벨링한 뒤, 그 데이터셋으로 Direct Preference Optimization 또는 Direct Reward Optimization을 써 기본 모델을 fine-tuning한다.
시뮬레이션 데이터로 학습한 참조 모델. Zhao 등은 주 생성 모델과 나란히 두는 참조 모델을 도입하되 이 참조 모델만 시뮬레이션 엔진의 합성 데이터로 학습시킨다. SimDrop이라 부르는 전략에서는 참조 모델이 합성 데이터 고유의 결함을 줄이도록 주 모델을 유도하면서 물리적 충실도는 유지하게 하고, 추론 시점에 두 모델의 출력을 diffusion의 classifier-free guidance와 비슷한 방식으로 가중 결합한다.
Gen-Constrained Sim 패러다임
Gen-Constrained Sim은 방향이 반대로, 생성 모델이 시뮬레이션의 사전 지식이나 지도 역할을 하는 방식이며 38편 중 4편이 속한다. 이 네 편은 모두 Gaussian Splatting과 diffusion model을 함께 쓰고 물리 모델로 MPM을 쓴다는 공통점이 있다.
score distillation sampling 계열. Physics3D는 탄소성과 점탄성 MPM을 영상 diffusion 모델과 결합하고, 물리 파라미터 최적화에 score distillation sampling을 쓴다. score distillation sampling은 pre-training된 diffusion 모델의 점수 함수를 손실 삼아 다른 표현을 최적화하는 기법으로, 영상 데이터에서 배운 사전 지식이 재료 속성을 수동으로 지정하지 않고도 시뮬레이션을 물리적으로 타당한 방향으로 이끈다. DreamPhysics는 운동에 특화한 motion distillation sampling을 제안해 운동 고유의 사전 지식을 더 잘 잡고 최적화 과정의 색 편향을 줄인다. PhysFlow는 광학 흐름 손실로 영상 diffusion 모델의 지식을 distillation해, multimodal foundation model이 초기화한 재료 속성을 다듬는다.
생성 데이터에서 물리 파라미터를 배우는 방법. PhysDreamer는 score distillation sampling과 다른 길을 택해 생성된 영상 자체에서 사전 지식을 배운다. 먼저 pre-training된 image-to-video 모델로 정적 물체가 그럴듯하게 움직이는 참조 영상을 만들고, 그다음 MPM 시뮬레이션 렌더링과 이 참조 영상의 시각적 유사도를 최대화해 영률 같은 물리 파라미터를 최적화한다.
Sim-evaluated Gen 패러다임
Sim-evaluated Gen은 생성물이 시뮬레이션 환경 배포를 전제로 만들어지고 그 환경에서의 유용성으로 평가되는 방식이며 38편 중 3편이 속한다.
Liu 등은 제한된 데이터에서 물리적으로 타당한 관절형 3D 자산을 만든다. 관통에 벌점을 주는 보조 항과 충돌 기반 형상 최적화로, 시뮬레이션에서 올바르게 거동하는 관절 메시를 얻는다. PhysPart는 정확히 맞물리고 매끄럽게 움직이는 3D 교체 부품을 생성하는데, 3D 프린팅이나 로봇 manipulation처럼 실제로 끼워지는지가 중요한 응용을 겨냥한다. 방법은 classifier-free guidance로 기하 조건을 걸고 샘플링 과정에서 안정성 손실과 가동성 손실로 물리 제약을 강제하는 것이다. PhyScene은 embodied AI용 고품질 상호작용 3D 장면을 만든다. 조건부 diffusion 모델이 장면 배치를 잡고 물리 기반 유도 함수가 장면이 물리적으로 기능하며 embodied agent의 상호작용에 적합하도록 보장한다.
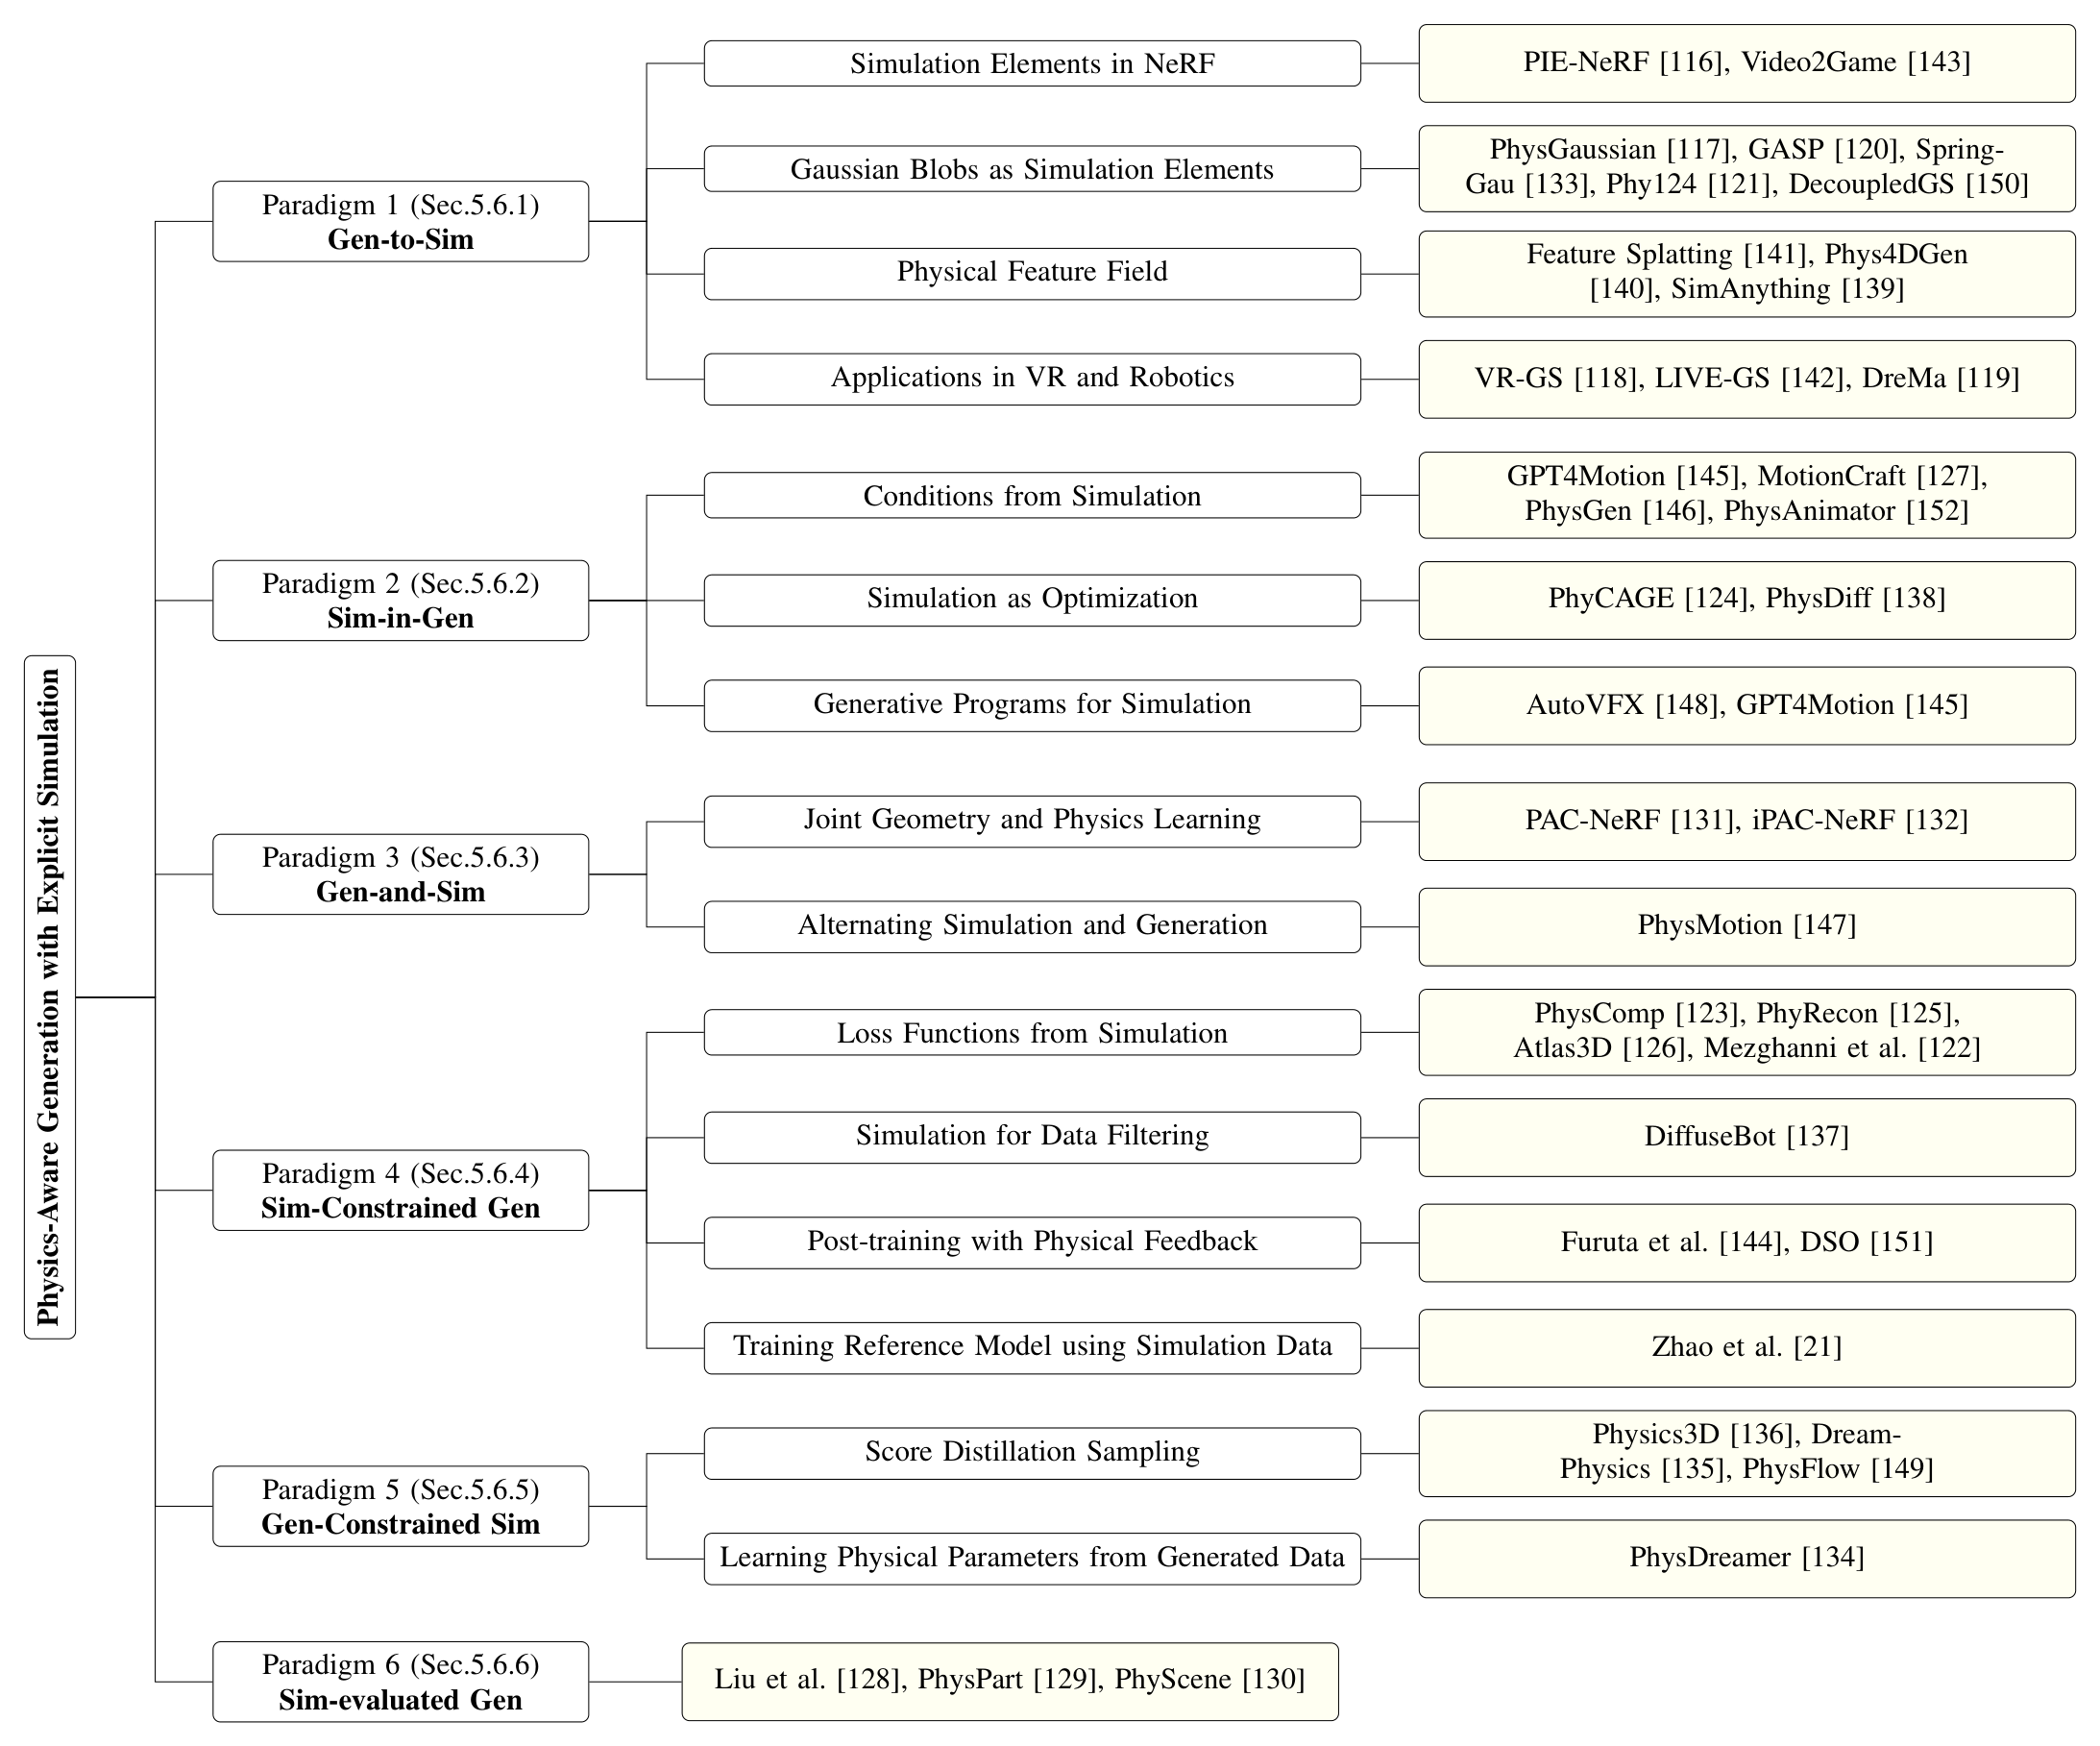
38편 전수 정리표
서베이의 Table 2는 PAG-E 논문 38편을 여섯 항목으로 정리한다. 생성 모델(G-Mo)은 사용한 생성 모델 계열, 생성 modality(G-Md)는 입출력 형태, 물리 모델(P-Mo)은 쓰인 시뮬레이션 기법이나 엔진, 파라미터 취득은 물리 파라미터를 얻은 경로, 물리 주입 단계는 생성 모델의 어느 단계에서 물리를 결합했는지를 가리킨다.
| 방법 | 발표 | 패러다임 | 생성 모델 | 생성 modality | 물리 모델 | 파라미터 취득 | 물리 주입 단계 |
|---|---|---|---|---|---|---|---|
| PAC-NeRF | ICLR'23 | GnS | NeRF | Interactive NVS | MPM | 데이터 기반 | 학습과 추론 |
| iPAC-NeRF | CVPR'24 | GnS | NeRF | Interactive NVS | MPM | 데이터 기반 | 학습과 추론 |
| PIE-NeRF | CVPR'24 | GtS | NeRF | Interactive NVS | Q-GMLS/Taichi | 전문가 지정 | 추론 |
| PhysGaussian | CVPR'24 | GtS | GS | Interactive NVS | MPM | 전문가 지정 | 추론 |
| Spring-Gau | ECCV'24 | GtS | GS | Interactive NVS | 3D Spring-Mass | 데이터 기반 | 추론 |
| VR-GS | SIGGRAPH'24 | GtS | GS | Interactive NVS | XPBD | 전문가 지정 | 추론 |
| PhysDreamer | ECCV'24 | GcS | GS, DM | Interactive NVS | MPM | 데이터 기반 | 추론 |
| DreamPhysics | arXiv'24 | GcS | GS, DM | Interactive NVS | MPM | 데이터 기반 | 추론 |
| Physics3D | arXiv'24 | GcS | GS, DM | Interactive NVS | MPM | 데이터 기반 | 추론 |
| PhysFlow | CVPR'25 | GcS | GS, DM | Interactive NVS | MPM | 데이터 기반 | 추론 |
| DreMa | arXiv'24 | GtS | GS | Interactive NVS | PyBullet | 전문가 지정 | 추론 |
| SimAnything | arXiv'24 | GtS | GS | Interactive NVS | MPM | LLM 추론 | 추론 |
| GASP | arXiv'24 | GtS | GS | Interactive NVS | MPM/Taichi | 전문가 지정 | 추론 |
| Phy124 | arXiv'24 | GtS | GS | Interactive NVS | MPM | 전문가 지정 | 추론 |
| Phys4DGen | arXiv'24 | GtS | GS, DM | Interactive NVS | MPM | LLM 추론 | 추론 |
| Feature Splatting | ECCV'24 | GtS | GS | Interactive NVS | MPM/Taichi | LLM 추론 | 추론 |
| LIVE-GS | arXiv'24 | GtS | GS | Interactive NVS | LLM/Unity/PBD | LLM 추론 | 추론 |
| Video2Game | arXiv'24 | GtS | NeRF | Interactive NVS | cannon.js/Blender/Unreal | LLM 추론 | 추론 |
| DecoupledGS | CVPR'25 | GtS | GS | Interactive NVS | MLS-MPM | 전문가 지정 | 추론 |
| Mezghanni 등 | CVPR'21 | ScG | GAN | 3D Generation | Bullet | 전문가 지정 | 학습 |
| DiffuseBot | NeurIPS'23 | ScG | DM | 3D Generation | MPM/SoftZoo | 데이터 기반 | 학습과 추론 |
| PhysComp | arXiv'24 | ScG | 기타 | Image-to-3D | FEM | 전문가 지정 | 학습 |
| PhyCAGE | arXiv'24 | SiG | GS, DM | Image-to-3D | MPM | 전문가 지정 | 추론 |
| PhyRecon | NeurIPS'24 | ScG | 기타 | Image-to-3D | Isaac Gym/DiffTaichi | 전문가 지정 | 학습과 추론 |
| Atlas3D | arXiv'24 | ScG | DM | Text-to-3D | Euler/Warp | 전문가 지정 | 학습 |
| Furuta 등 | arXiv'24 | ScG | DM | Text-to-Video | VLM | LLM 추론 | 학습 |
| Zhao 등 | arXiv'25 | ScG | DM | Text-to-Video | Unreal/Blender | 전문가 지정 | 추론 |
| DSO | arXiv'25 | ScG | DM | Image-to-3D | MuJoCo | 전문가 지정 | 학습 |
| GPT4Motion | CVPRW'24 | SiG | DM | Text-to-Video | Blender/LLM | LLM 추론 | 추론 |
| MotionCraft | NeurIPS'24 | SiG | DM | Text-to-Video | Φ-Flow | 전문가 지정 | 추론 |
| PhysGen | ECCV'24 | SiG | DM | Image-to-Video | Pymunk | LLM 추론 | 추론 |
| PhysAnimator | CVPR'25 | SiG | DM | Image-to-Video | Taichi | 전문가 지정 | 추론 |
| PhysMotion | arXiv'24 | GnS | GS, DM | Image-to-Video | MPM | LLM 추론 | 추론 |
| AutoVFX | arXiv'24 | SiG | GS | Video-to-Video | Blender | LLM 추론 | 추론 |
| PhysDiff | ICCV'23 | SiG | DM | Text-to-Motion | Isaac Gym | 데이터 기반 | 추론 |
| Liu 등 | ICCV'23 | SeG | 기타 | Interactive 3D | 자체 구현 | 전문가 지정 | 평가와 배포 |
| PhysPart | arXiv'24 | SeG | DM | Interactive 3D | Isaac Gym | 전문가 지정 | 평가와 배포 |
| PhyScene | CVPR'24 | SeG | DM | Interactive 3D Scenes | Omniverse Isaac Sim | 전문가 지정 | 평가와 배포 |
정리표에서 드러나는 분포
38편을 항목별로 세어 보면 이 분야의 현재 무게 중심이 드러난다.
| 분류 기준 | 분포 |
|---|---|
| 패러다임 | GtS 13편, ScG 8편, SiG 7편, GcS 4편, GnS 3편, SeG 3편 |
| 생성 모델 | DM 12편, GS 11편, GS와 DM 병용 7편, NeRF 4편, 기타 3편, GAN 1편 |
| 생성 modality | Interactive NVS 19편, Image-to-3D 4편, Text-to-Video 4편, Image-to-Video 3편, Interactive 3D 계열 3편, 나머지 5편 |
| 물리 파라미터 취득 | 전문가 지정 19편, LLM 추론 10편, 데이터 기반 추정 9편 |
| 물리 주입 단계 | 추론 26편, 학습 5편, 학습과 추론 4편, 평가와 배포 3편 |
| 발표 연도 | 2024년 이후 33편, 2021년부터 2023년까지 5편 |
이 분포는 세 가지를 말해 준다. 첫째, Interactive NVS가 19편으로 절반을 차지하고 Gaussian Splatting 계열이 생성 모델의 다수를 이루는데, 장면을 입자 무리로 다루는 표현이 입자 기반 시뮬레이션과 붙이기 쉽기 때문이다. 실제로 MPM 계열을 물리 모델로 쓴 논문이 38편 중 17편으로 가장 많다.
둘째, 물리를 학습이 아니라 추론 시점에 결합한 연구가 26편으로 압도적이다. 즉 대부분의 방법은 생성 모델을 다시 학습시키지 않고 이미 만들어진 표현이나 샘플링 과정에 시뮬레이션을 붙이는 쪽을 택했다.
셋째, 물리 파라미터를 전문가가 직접 지정하는 방식이 19편으로 여전히 절반이다. 다만 LLM 추론이 10편으로 데이터 기반 추정 9편을 이미 넘어섰고, 이 10편이 전부 2024년 이후 논문이라는 점에서 최근 경로 전환이 진행 중임을 보여 준다.
명시적 시뮬레이션 없이 학습하는 방법
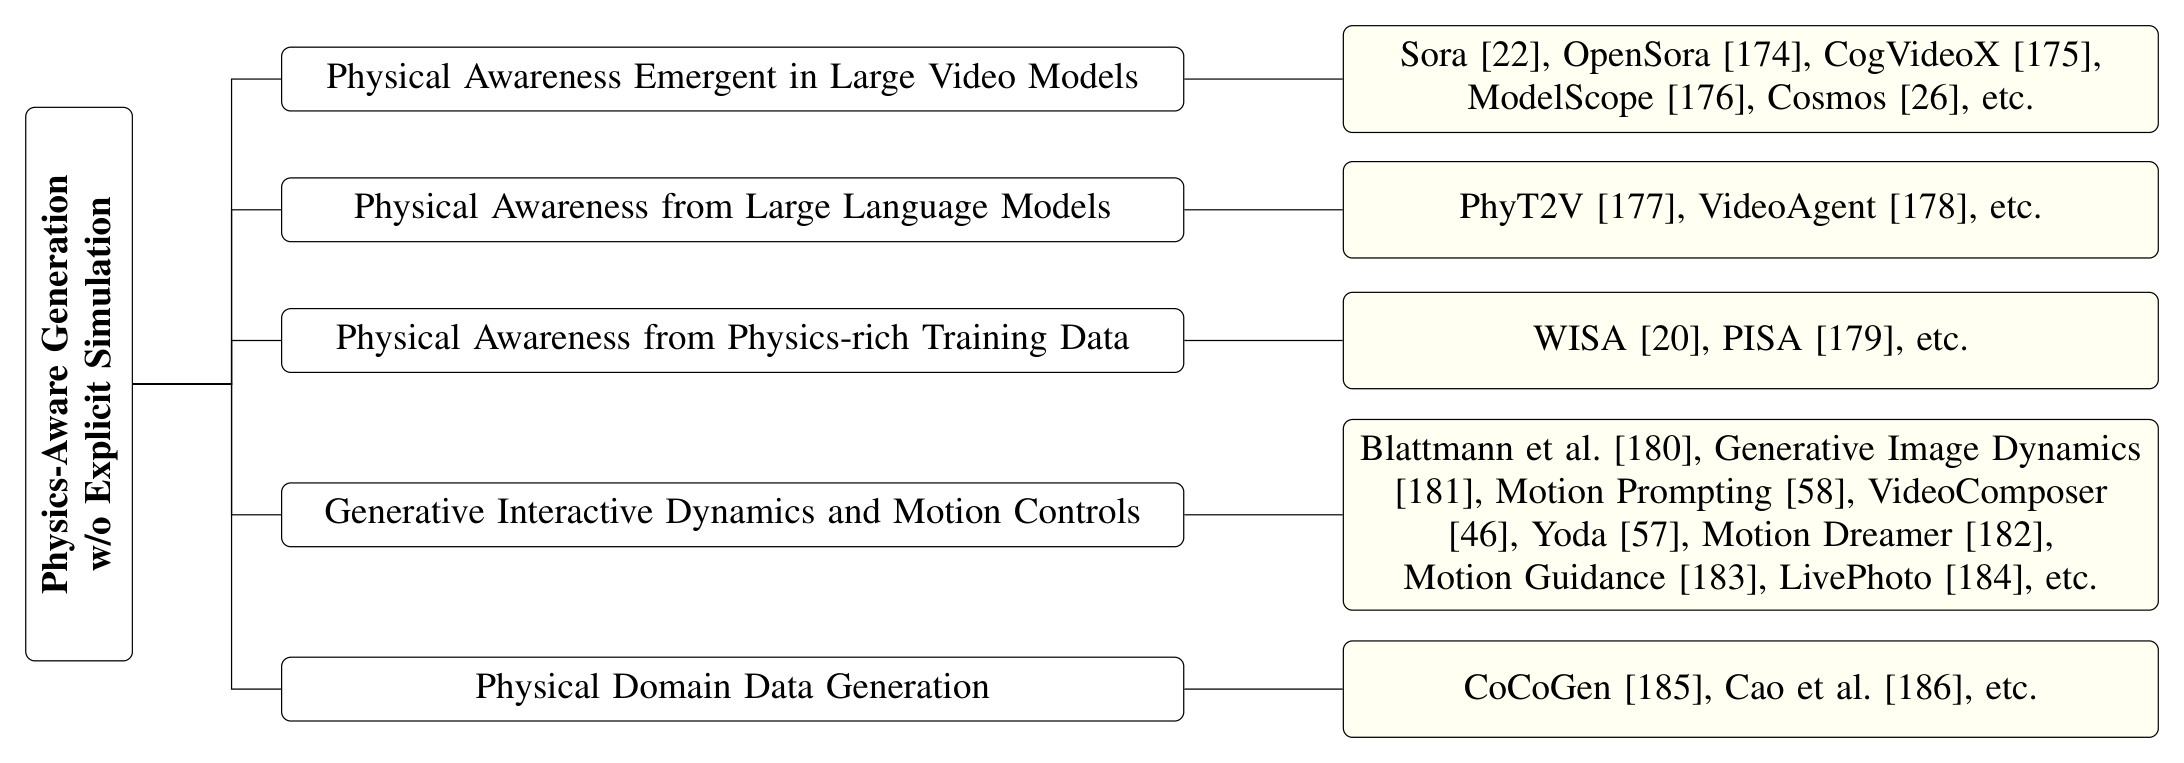
PAG-I는 물리 시뮬레이션에 명시적으로 기대지 않고도 어느 정도 물리 인지를 보이는 생성 학습을 다루며 다섯 유형으로 나뉜다.
대형 영상 모델의 emergent capability
인터넷 규모 영상으로 학습한 대형 영상 생성 모델은 물리 추론 능력을 학습 목표에 없이도 보인다. Sora, OpenSora, CogVideoX, VideoCrafter, LaVie, ModelScope, Cosmos 계열이 그 예이며, 이들은 일관된 물체 상호작용과 사실적인 운동, 그럴듯한 시간적 동역학을 만들어낸다. 명시적으로 프로그래밍된 물리 엔진이 없는데도 다양한 물리 현상을 모델링하는 범용 시뮬레이터의 후보로 거론되는 이유가 여기 있다.
다만 저자들은 이 암묵적 물리 추론이 아직 초기 단계이며 체계적 평가도 미해결 영역이라고 못 박는다. PhyGenBench는 이 모델들이 인상적인 시각 생성 능력에도 불구하고 기본 물리 법칙조차 정확히 표현하지 못한다고 보고했다.
Kang 등의 결과는 더 구체적인 진단을 준다. 대형 영상 생성 모델이 시각 데이터만으로 물리 법칙을 스스로 배우고 일반화할 수 있는지 조사한 결과, 모델 크기와 데이터셋 크기를 키우는 것만으로는 분포 밖 물리 일반화가 개선되지 않았다. 즉 현재 모델은 일반 물리 규칙을 추상화하기보다 아주 비슷한 학습 예시가 있는지에 의존한다. 데이터를 더 늘린다고 물리 이해가 따라오지 않는다는 뜻이므로, 저자들은 물리 인지를 겨냥한 별도 방법이 필요하다고 정리한다.
Cosmos 플랫폼
NVIDIA의 Cosmos는 영상 데이터 파이프라인, 영상 토크나이저, pre-training 모델, post-training 모델을 묶은 오픈소스 도구 모음이다. 대규모 영상 데이터셋으로 학습한 world foundation model을 제공하며, 그 뼈대는 Transformer 기반 diffusion 모델과 Transformer 기반 자기회귀 모델 두 종류다. world foundation model은 여러 하위 환경으로 fine-tuning될 것을 전제로 학습한 범용 world model을 뜻하며, Cosmos의 경우 로봇 manipulation, 카메라 제어, 자율주행처럼 물리 인지가 필요한 과제로 fine-tuning할 수 있다.
플랫폼에는 목적이 다른 동반 모델이 둘 더 있다.
| 구성 | 역할 |
|---|---|
| Cosmos world foundation model | 대규모 영상으로 pre-training한 diffusion 계열과 자기회귀 계열의 기반 모델 |
| Cosmos-Reason1 | embodied 의사결정용 multimodal LLM. 물리 상식, 직관 물리, embodied 추론을 대상으로 supervised fine-tuning과 강화학습을 결합해 학습한다 |
| Cosmos-Transfer1 | 분할, 깊이, 엣지 맵 같은 공간 입력으로 world 생성을 제어하는 ControlNet류 구조로 적응형 멀티모달 제어를 제공한다 |
LLM이 공급하는 물리 지식
대형 언어 모델은 시각 데이터 생성을 개선할 물리 지식의 공급원으로도 쓰인다. PhyT2V는 text-to-video 모델의 물리적 사실성 부족을 LLM 기반 프롬프트 반복 정제로 다룬다. 먼저 초기 프롬프트에서 물체와 관련 물리 규칙을 뽑고, 영상 캡셔닝 모델로 생성 영상의 의미 설명을 만들어 원래 프롬프트와 대조해 불일치를 찾은 뒤, 뽑아 둔 물리 속성을 근거로 프롬프트를 고쳐 다시 생성한다. VideoAgent는 로봇 시스템을 유도할 시각 계획을 만들고, 자기 조건화 일관성과 pre-training된 vision-language model의 피드백으로 생성된 영상 계획을 다듬으며, 환경에서 얻은 지속적 피드백으로 영상 생성을 계속 개선한다.
물리가 풍부한 학습 데이터
물리 정보가 풍부한 데이터셋을 의도적으로 모으면 그 자체가 물리 원리를 배우는 자원이 된다. WISA는 동역학, 열역학, 광학 세 도메인에 걸친 17가지 물리 현상을 담은 영상 약 3만 2천 편으로 WISA-32K를 수집했다. 각 영상에는 원리를 설명하는 텍스트 서술, 현상 유형을 가리키는 정성 범주, 밀도와 온도, 시간 구간 같은 정량 속성이 붙어 있다. 이 데이터로 학습하는 영상 생성 모델에는 물리 속성 임베딩, mixture-of-physical-experts attention, 물리 분류기가 함께 결합된다.
PISA는 다양한 환경에서 물체가 낙하하는 실세계 영상 361편과 합성 영상 60편을 모아 post-training에 쓴다. supervised fine-tuning과 함께 분할, 광학 흐름, 깊이 맵의 일치를 유도하는 object reward optimization을 적용해 영상 생성의 물리적 정확도를 높인다.
생성형 상호작용 동역학과 운동 제어
이 유형은 명시적 물리 시뮬레이션 없이 물체의 자연스러운 동역학을 모델링하며 물리 관계와 상호작용을 암묵적으로 배운다.
- Blattmann 등: 이미지 안 국소 사용자 상호작용에 대한 물체 동역학을 image-to-video 형식으로 예측한 초기 시도
- Generative Image Dynamics: latent diffusion 모델이 조밀한 장기 픽셀 trajectory를 나타내는 스펙트럼 볼륨을 예측해 이미지 한 장에서 사실적인 장면 운동을 만든다
- Motion Prompting: 운동 trajectory를 조건 신호로 써 국소 운동과 전역 운동을 정밀하게 제어한다
- VideoComposer와 Yoda: motion vector를 명시적 시간 제어 신호로 써 프레임 사이 동역학과 패턴을 정확히 잡는다
- Motion Dreamer: 광학 흐름, 인스턴스 분할 맵, 깊이 맵 같은 중간 운동 표현을 두어 운동 추론을 고품질 영상 생성에서 분리한다
- Motion Guidance: 광학 흐름 추정기에서 유도한 gradient로 diffusion 생성을 제어해 모델 재학습 없이 세밀한 운동 편집을 가능하게 한다
물리 도메인 데이터 생성
CoCoGen은 다르시 흐름이나 버거스 방정식처럼 물리 도메인에 특화된 데이터를 score 기반 생성 모델로 만든다. 이산화한 편미분방정식 정보를 score 기반 모델의 샘플링 과정에 직접 주입해 물리 일관성을 강제하는 방식이다. Cao 등은 유체 시뮬레이션이나 태풍 현상처럼 높은 물리 정확도가 필요한 영상을 만들기 위해 영상 diffusion 모델에 latent 물리 지식을 결합한다. 물리 현상 데이터로 masked autoencoder를 pre-training해 latent 물리 지식을 확보한 뒤, 이를 사원수 공간에 투영해 유사 언어 프롬프트를 구성하고 그것으로 영상 diffusion 모델을 유도한다.
평가
기존 지표의 한계
관행적으로 쓰이는 생성 평가 지표는 물리 위반을 잡아내지 못한다. FID, CLIP Similarity, CLIP-FID, Inception Score는 시각 내용과 텍스트 의미의 일치 쪽으로 치우쳐 있어서, 영상 생성에서 더 중요한 물리 법칙 위반 패턴을 효과적으로 검출하지 못한다.
FVD에는 다른 문제가 있다. 비교 기준이 될 참조 영상 데이터셋을 요구하는데, 새로 생성한 장면에 대응하는 참조 영상을 구하기 어렵다. vision-language model을 범용 평가자로 쓰는 시도도 나왔지만 대부분 공간 관계 평가에 머물러 물리적 정확성으로 일반화되지 않는다.
텍스트 조건부 벤치마크
텍스트 조건부 벤치마크는 프롬프트가 묘사한 물리 현상을 생성 결과가 지키는지 본다.
| 벤치마크 | 대상 | 규모 | 자동 평가자 |
|---|---|---|---|
| PhyBench | text-to-image | 프롬프트 700개, 물리 시나리오 31개, 역학과 광학, 열, 물질 속성 4유형 | PhyEvaler (GPT-4o) |
| PhyGenBench | text-to-video | 프롬프트 160개, 물리 법칙 27개, PhyBench와 같은 4개 도메인 | PhyGenEval (VLM과 GPT-4o 결합) |
| VideoPhy | text-to-video | 캡션 688개, 고체와 고체, 고체와 유체, 유체와 유체 3범주 | VideoCon-Physics |
| VideoPhy2 | text-to-video | 프롬프트 3,940개, 실세계 행동 197종, 5점 리커트 척도 | VideoPhy2-AutoEval |
| WISA-32K | 학습 데이터셋 | 영상 약 3만 2천 편, 물리 현상 17종, 동역학과 열역학, 광학 | 해당 없음 |
PhyBench는 프롬프트를 변형해 확장하는 방식으로 만들어졌다. 예를 들어 압력 주제에서 "바다 밑바닥의 빈 플라스틱 병"이라는 프롬프트를 설계한 뒤 "빈 플라스틱 병"을 다른 물체로, "바다 밑바닥"을 다른 상황으로 바꿔 다른 주제까지 덮는다.
PhyGenBench는 다섯 단계로 구축됐다. 네 유형에서 핵심 물리 상식을 고르는 개념화, 그 현상을 묘사하는 초기 프롬프트 작성, 세부를 더하는 프롬프트 증강, GPT-4o로 물체를 치환하는 다양성 확대, 프롬프트와 물리 법칙의 정확성을 검토하는 품질 관리 순서다.
VideoPhy는 상호작용 유형을 세 범주로 나눈다. "병이 탁자에서 넘어진다"는 고체와 고체, "물이 원형 배수구로 흘러내린다"는 고체와 유체, "비가 연못에 튄다"는 유체와 유체다. 이 정의로 캡션 688개를 만든 뒤 CogVideoX와 OpenSora 같은 공개 모델과 Pika, Gen-2 같은 비공개 모델을 합쳐 12종을 사람 평가로 비교했고, 대부분의 text-to-video 모델이 물리적으로 일관된 결과를 내지 못한다고 보고했다.
VideoPhy2는 평가의 무게 중심을 행동 쪽으로 옮겼다. 스포츠, 신체 활동, 물체 조작을 포함한 실세계 행동 197종을 프롬프트 3,940개로 덮고, 프롬프트를 더 길고 서술적으로 만들면서 중력, 질량 보존, 운동량처럼 구체적인 물리 규칙 주석을 세밀하게 붙였다.
WISA-32K의 주석은 GPT-4o mini와 Qwen2-VL로 자동 생성됐고, 데이터셋 구축은 영상 수집, 장면 검출, 미적 필터링, 구조화 주석 순서로 진행됐다. WISA-32K로 학습한 모델이 일반 데이터셋으로 학습한 모델보다 실세계 물리 법칙에 더 부합하는 영상을 만든다는 실험 결과가 함께 보고됐다.
시각 조건부 벤치마크
시각 조건부 벤치마크는 텍스트 설명이 아니라 다음 프레임 예측으로 물리 이해를 잰다.
| 벤치마크 | 과제 | 데이터 | 지표 |
|---|---|---|---|
| Physics-IQ | 조건 구간을 주고 이어지는 5초를 예측 | 통제 조건에서 촬영한 실세계 고해상도 영상 396편. 고체 역학, 유체 동역학, 열역학, 광학, 자기 | 공간, 시간, 픽셀 기반 지표. Spatial IoU, Spatiotemporal IoU, Weighted Spatial IoU, MSE |
| PisaBench | 공중의 물체 이미지 한 장에서 자유 낙하와 충돌을 예측 | 실세계 슬로모션 영상 361편과 Kubric 엔진 합성 영상 | trajectory L2로 운동, Chamfer Distance로 형태, IoU로 공간 일관성 |
| PhyCoBench | 프롬프트가 지정한 물리 현상의 일관성을 평가 | 프롬프트 120개. 중력, 충돌, 진동, 마찰, 유체 동역학, 포물선 운동, 회전 7범주 | PhyCoPredictor가 광학 흐름과 프레임 복원 오차로 자동 채점 |
Physics-IQ가 재는 것은 운동이 어디서 언제 일어나는지에 그치지 않는다. 운동량이 얼마나 되는지, 그리고 그것이 실제 장면의 물리적 trajectory와 얼마나 일치하는지까지 평가한다.
PhyCoBench의 프롬프트는 물리 교과서와 행동 인식 데이터셋에서 착안해 관찰 가능한 운동 상황을 폭넓게 덮도록 설계됐다. 저자들은 최신 모델 네 종을 사람 순위 평가로 비교했고, 자동 평가를 위해 첫 프레임과 프롬프트로 운동과 프레임을 예측하는 광학 흐름 기반 모델 PhyCoPredictor를 함께 내놓았다.
물리 상식 ontology
평가의 주된 어려움 중 하나는 물리 상식의 정의가 연구마다 다르다는 점이다. 정의가 다르면 모델 사이 벤치마크 비교 자체가 어려워지므로, 저자들은 이 문제를 커뮤니티가 우선 다뤄야 할 핵심 질문으로 든다.
Cosmos-Reason1이 제안한 ontology가 현재로선 가장 구체적인 답이다. 3개 대분류 아래 16개 세부 범주를 둔다.
| 대분류 | 세부 범주 |
|---|---|
| 공간 (Space) | 관계, 타당성, affordance, 환경 |
| 시간 (Time) | 행동, 순서, 인과성, 카메라, 계획 |
| 기초 물리 (Fundamental Physics) | 속성, 상태, 물체 영속성, 역학, 전자기, 열역학, 반물리 |
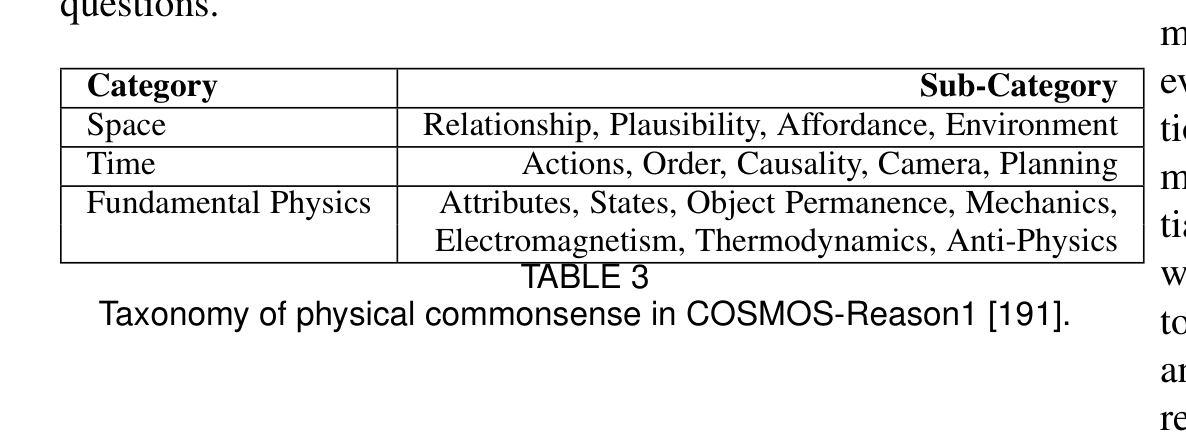
Cosmos-Reason1은 이 ontology 위에서 문항 5,737개를 모았다. 이진 문항 2,828개와 객관식 문항 2,909개로 구성되며, 그중 604개를 영상 426편과 연결해 물리 상식 벤치마크로 따로 골라냈다. 이 604개는 이진 336개와 객관식 268개로 나뉜다.
평가 지표의 세 부류
물리 인지 평가 지표는 세 부류로 나뉘며 신뢰도와 확장성이 서로 맞바꿔진다.
| 부류 | 방식 | 강점 | 약점 |
|---|---|---|---|
| 사람 평가 | 사람 주석자가 정해진 기준으로 물리 법칙 준수, 프롬프트 부합, 동역학 일관성을 판정한다. 이진, 3점, 5점 척도나 모델 간 순위를 쓴다 | 가장 직접적이고 신뢰할 만하다. 신뢰할 정답 기준을 세우는 데 필수다 | 비용과 시간이 크게 든다 |
| VLM 기반 평가 | 대형 멀티모달 모델을 프롬프트하거나 fine-tuning해 언어 유도 추론으로 물리적 타당성을 판정한다 | 확장 가능하고 비용 효율이 높다 | 프롬프트나 fine-tuning 품질에 성능이 좌우되고, 평가자 자신의 물리 이해가 아직 미해결 문제다 |
| 자동 정량 평가 | 운동, 형태, 물리 일관성을 저수준 또는 구조화된 계산 지표로 잰다 | 정밀하고 재현 가능해 벤치마킹에 적합하다 | 대개 짝지어진 실세계 정답 영상을 요구한다 |
부류별 실제 사례도 정리돼 있다. 사람 평가에서는 PhyCoBench가 프롬프트마다 text-to-video 모델 출력의 물리적 사실성을 순위로 매기고, PhyGenBench는 의미 일치와 물리 상식 일치를 나눠 수동 평가하며, VideoPhy와 VideoPhy2는 의미 준수와 물리 상식, 물리 규칙 근거에 주석을 붙인다. VLM 기반 평가에서는 PhyBench의 PhyEvaler가 GPT-4o로 장면 정확성과 물리 상식을 항목별로 판정하고, PhyGenBench의 PhyGenEval은 VLM이 핵심 물리 사건을 검출하고 시간 순서를 확인한 뒤 유도 질문과 프레임 비교로 사실성을 평가하는 다단계 구조를 쓴다. 자동 정량 평가에서는 PhyCoPredictor가 광학 흐름 예측으로 물리 이상을 검출하고, PISA가 trajectory L2와 Chamfer Distance, IoU로 낙하 예측을 평가하며, Physics-IQ가 운동의 위치와 시점, 크기를 실세계 참조와 대조한다.
물리 인지와 이웃 개념의 구분
물리 인지는 의미 인지, 기하 인지와 각각 다른 것을 본다. 세 인지가 무엇을 대상으로 삼고 어떤 질문에 답하는지를 나란히 놓으면 물리 인지가 별도의 연구 대상이 되는 근거가 드러난다.
| 구분 | 대상 | 질문 | 성격 |
|---|---|---|---|
| 의미 인지 | 시각 데이터 안의 개념과 물체 | 무엇이 어디에 있는가 | 픽셀에서 latent feature로 가는 정적 지식 사상 |
| 기하 인지 | 물체와 장면의 외재적 구조 | 모양, 크기, 자세, 깊이, 위치가 어떠한가 | 구조를 지각하고 모델링하는 능력 |
| 물리 인지 | 물체와 환경의 내재적 속성과 거동 | 운동, 충돌, 힘, 재료 거동이 어떻게 그리고 왜 일어나는가 | 동적이고 예측적이며 인과와 상호작용을 모델링한다 |
물리 인지가 동적이고 예측적인 성질을 갖는다는 점이 영상의 시간 모델링이 이 분야에서 특히 중요한 이유다. physics-aware generation의 목표는 의미 인지와 물리 인지를 결합해 의미도 통하고 물리도 정확한 콘텐츠를 만드는 것이다.
기하 인지와의 관계는 다르게 정리된다. 지각에 그치지 않고 물리 세계를 이해하며 상호작용까지 하는 embodied 모델을 만들려면 기하와 물리를 함께 통합해야 한다고 저자들은 결론짓는다.
향후 방향
저자들이 제시하는 방향은 여섯이다.
평가 개선. 물리 인지에 맞춘 표준 벤치마크가 최근 나오기는 했지만 평가는 여전히 임시방편이거나 수작업에 크게 의존한다. 대안으로는 생성물을 실제 물리 엔진과 시뮬레이션 플랫폼에 올려 타당성을 재는 방법, 로봇 manipulation이나 자율주행의 환경 모델링처럼 하위 과제 성능으로 간접 평가하는 방법, 시뮬레이션과 실세계에서 각각 실행한 embodied agent의 행동 유사도를 척도로 쓰는 방법이 제안된다.
물리 인지를 통한 설명 가능성. 명시적 물리 법칙을 생성 모델에 결합하면 입력에서 출력까지의 경로를 힘과 제약, 상호작용으로 되짚을 수 있어 해석 가능한 경로가 생긴다. 모델의 결정을 잘 이해된 물리 원리에 대응시키면 생성 과정이 더 투명해지고 사람의 직관과도 맞아떨어진다. saliency map이나 특징 귀인 같은 기존 해석 기법과 결합할 여지도 있으며, 물리 파라미터가 출력의 어느 영역에 영향을 주는지 시각화하는 것이 그 예다.
물리 증강 foundation model. 대형 foundation model에 물리 이해를 더해 physics-aware generation에 쓰는 길이다. 여러 인식 foundation model을 통합해 물리 세계를 폭넓게 이해하게 하는 접근, 3D 지식과 물리 지식으로 LLM의 추론을 보강하는 접근, 대규모 합성 데이터와 미분 가능한 물리를 활용한 물리 유도 pre-training과 표현 학습, 물리 법칙 발견을 유도하는 자기지도 목표 설계가 여기 든다.
신경과 상징의 하이브리드. 상징 체계는 구조화된 물리와 인과 지식을 바탕으로 엄밀한 추론을 제공한다. 미분 가능한 시간 논리 같은 상징적 물리 제약을 심으면 생성 모델이 물리적으로 타당하고 시간적으로 일관된 출력을 내도록 유도할 수 있다. 상징 표현은 복합적 추론에도 강해서, 상징 그래프나 ontology를 결합하면 복잡한 개체와 관계를 조합하는 생성이 가능해진다.
생성형 시뮬레이션 엔진. 텍스트나 의미 프롬프트에서 물리 시뮬레이션을 직접 만들어내는 방향이며 Genesis가 후보 사례다. 예를 들어 "폭우 뒤 가파른 산의 산사태를 시뮬레이션하라"는 명령이 적절한 토양과 유체 동역학으로 모델링된 사실적인 3D 지형 생성과 물리 solver 기반 산사태 시뮬레이션을 촉발하는 식이다. 이런 엔진은 물리 시뮬레이션 설계를 자동화하고 가속하며 더 큰 시스템의 부품으로도 쓰일 수 있는데, 현재 가장 큰 걸림돌은 다양한 텍스트 프롬프트와 장면에 대한 일반화 범위가 좁다는 점이다.
로봇과 embodied AI. physics-aware generation을 world model이나 시뮬레이터로 삼아 로봇과 embodied agent를 학습시키는 것이 자연스러운 응용이다. 실세계 동역학을 정확히 반영하는 물리적으로 사실적인 합성 데이터를 만들면 시뮬레이션 학습의 효율이 오르고 실세계 운용으로의 전이가 매끄러워진다. VLA 모델에 물리 추론 능력을 명시적으로 주입해 복잡하고 낯선 환경에서 action과 결과를 더 잘 예측하게 하는 방향도 함께 제시된다. 응용은 시뮬레이션의 충실도와 해상도, 규모를 높이는 기후 모델링과, 조직의 물리 성질을 정확히 재현하는 수술 훈련과 계획으로도 뻗는다.
한계
서베이 자체의 범위 한계는 앞서 정리한 제외 기준에서 온다. PINN 계열과 이미지 복원, 순수 그래픽스가 빠져 있고, physical understanding은 이 서베이와 대체로 직교한다는 이유로 물리 파라미터 취득 경로 세 가지만 짧게 다룬다.
구조의 균형도 고르지 않다. PAG-E는 여섯 패러다임이라는 형식화된 분류와 38편 전수 정리표를 갖춘 반면, PAG-I는 다섯 유형의 방법 나열에 가깝고 분류 기준이 PAG-E만큼 선명하지 않다.
서베이가 짚는 분야 자체의 미해결 문제는 세 가지다.
- 물리 상식의 정의가 연구마다 달라 모델 간 벤치마크 비교가 어렵다. Cosmos-Reason1의 ontology가 가장 구체적인 제안이지만 아직 표준은 아니다.
- 대형 영상 모델의 물리 추론은 초기 단계이며, 모델과 데이터를 키우는 것만으로는 분포 밖 물리 일반화가 개선되지 않는다.
- 평가는 여전히 임시방편이거나 수작업에 의존하고, 자동 정량 평가는 짝지어진 실세계 정답 영상을 요구해 새로 생성한 장면에 쓰기 어렵다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| physics-aware generation (PAG) | 실세계 물리에 대한 강한 이해를 동반한 생성. 이 서베이의 뼈대 개념이다 |
| PAG-E / PAG-I | 명시적 물리 시뮬레이션을 쓰는 PAG와 암묵적 학습만으로 물리 인지를 얻는 PAG |
| PUG | physics-unaware generation. 물리 이해를 요구하지 않는 범용 생성 |
| physical plausibility | 출력물이 물리 법칙에 어긋나지 않는 정도. 픽셀 품질을 재는 visual fidelity와 구분되는 평가 대상이다 |
| Material Point Method (MPM) | 입자와 격자를 오가며 연속체 변형을 푸는 수치 기법. 38편 중 17편이 이 계열을 물리 모델로 쓴다 |
| Gaussian Splatting (GS) | 장면을 평균, 공분산, 불투명도를 가진 3차원 가우시안 무리로 나타내는 명시적 radiance field 표현 |
| score distillation sampling (SDS) | pre-training된 diffusion 모델의 점수 함수를 손실 삼아 다른 표현을 최적화하는 기법 |
| physical commonsense | 중력, 충돌, 상태 변화처럼 사람이 당연하게 아는 물리 지식. 벤치마크의 채점 대상이다 |
관련 페이지
- Physical AI 연구 한 번에 살펴보기 2편: 물리를 이해하는 생성 모델과 월드 시뮬레이터: 이 논문의 한국어 해설. 개념을 먼저 익히려면 해설이 진입로이고, 여섯 패러다임의 전수 정리표와 벤치마크 수치를 확인할 때는 1차 출처인 이 페이지가 정본이다.
- Cosmos World Foundation Model Platform for Physical AI: 이 서베이가 PAG-I의 대표 사례로 든 Cosmos 플랫폼의 원 논문. world foundation model과 물리 평가를 훨씬 자세히 다룬다.
- A Comprehensive Survey on World Models for Embodied AI: embodied AI의 world model 서베이. 기능과 시간, 공간 세 기준으로 로봇과 자율주행 쪽을 깊이 다룬다. li-2025가 예측에 초점을 둔다면 이 서베이는 생성 쪽을 본다.
- World Model for Robot Learning: A Comprehensive Survey: 로봇 학습에서 world model과 policy를 결합하는 방식을 5분류로 정리한 서베이.
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: LLM의 world knowledge에서 출발해 grounding과 action, world modeling, embodied 배포로 이어지는 로드맵을 그린 Physical AI 서베이. 이 서베이는 그 로드맵의 예측과 시뮬레이션 부분을 생성 모델 관점에서 확대한 것이다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA 해부 서베이. 저자들이 향후 방향으로 든 "VLA에 물리 추론 주입"이 겨냥하는 대상 쪽 지도다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.
- 용어집: Physical AI (Terminology Glossary): 용어 표기 SSOT.