Physical AI · ARTICLE · 2025
Helix: Figure AI가 공개한 범용 휴머노이드 제어를 위한 시각-언어-행동(VLA) 모델
요약
PyTorch 한국 사용자 모임 운영자 9bow가 Figure AI의 Helix 발표를 한국어로 옮긴 소개 글이다. 원문이 공개된 2025년 2월 20일에서 사흘 뒤에 올라왔고, 원문 링크와 데모 영상 5편을 함께 싣는다.
내용은 원문 요약이라 새로운 수치나 해석을 더하지 않는다. 그런데도 이 자료를 따로 수집한 이유는 Helix의 System 1과 System 2 구조도 때문이다. 원문 페이지에서는 이 도식이 iframe 안에 들어 있어 자동 수집에 잡히지 않는데, 이 글에는 일반 이미지로 들어 있다. 따라서 이 페이지는 구조도를 읽는 데 필요한 만큼을 설명하고, 원문 대비 무엇이 남고 무엇이 빠졌는지를 함께 정리한다.
배경
글은 Helix를 Figure AI의 이전 발표와 이어 놓는 데서 시작한다. Figure AI는 2024년 초 OpenAI와 협업해 humanoid Figure 01을 공개했던 회사이고, Helix는 그 다음 발표에 해당한다.
문제 설정은 기존 로봇의 학습 비용이다. 새로운 작업 하나를 배우려면 막대한 양의 시뮬레이션과 데이터 수집이 필요했다는 점을 글은 출발점으로 삼는다. 반면 Helix는 하나의 신경망으로 여러 로봇 행동을 학습하고 처음 보는 물체도 즉시 다룬다고 소개한다.
목표 무대는 가정 환경이다. 글이 드는 예는 냉장고 문을 열어 물건을 넣고 닫기, 서랍을 열어 새 물체를 정리하기, 여러 개의 새 물체를 구별해 원하는 위치에 놓기, 다른 로봇과 협력해 가사 작업을 수행하기다. 이 작업들을 별도 프로그래밍 없이 "이 물건을 정리해줘" 같은 지시문(instruction) 한 문장으로 수행한다는 점을 차별점으로 든다.
핵심 개념
VLA는 vision-language-action model의 약어다. 카메라로 본 시각 정보와 사람이 준 지시문을 함께 받아 로봇 제어 명령을 내는 모델을 가리킨다. 원저자는 VLAM(Vision-Language-Action Model)이라는 표기를 쓰지만 원문과 이 wiki의 다른 페이지는 VLA로 적으므로, 이 페이지도 VLA로 통일한다.
action은 policy가 출력하는 제어 명령이고, policy는 현재 입력을 받아 다음 action을 정하는 함수를 말한다. Helix에서 action은 손목과 개별 손가락, 몸통, 머리를 함께 움직이는 상반신 제어 명령이다.
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. 이 글에는 초당 7회에서 9회, 그리고 초당 200회라는 두 값이 나오는데 둘 다 control frequency이고, 값이 서로 다르다는 사실 자체가 구조의 핵심이다.
dual-system VLA는 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 VLA 구조를 가리킨다. Helix의 System 2와 System 1이 이 구성에 해당한다. 다만 글은 이 이름을 쓰지 않고 "두 개의 주요 시스템"이라고만 부른다.
방법
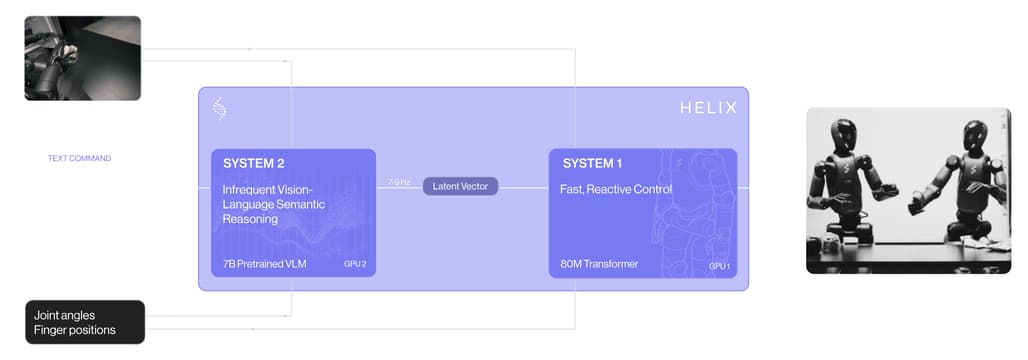
Helix는 역할과 갱신 주기가 다른 두 시스템으로 나뉜다. 구조도가 입력에서 출력까지의 경로를 한 장에 담고 있다.
| 구성 | 구조도와 본문의 서술 |
|---|---|
| 입력 | 카메라 이미지, 텍스트 지시문, 관절 각도와 손가락 위치 |
| System 2 | 7B pretrained VLM, GPU 2에 배치, 초당 7회에서 9회 갱신 |
| 연결 | latent 벡터 |
| System 1 | 80M Transformer, GPU 1에 배치, 초당 200회 갱신 |
| 출력 | 로봇 두 대의 상반신 제어 |
System 2
System 2는 장면 이해와 자연어 처리를 담당한다. 인터넷 데이터로 pre-training된 VLM을 그대로 활용해 주어진 지시문과 환경을 해석한다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계를 말하며, 이 단계 덕분에 로봇 데이터에 없던 개념도 언어로 다룰 수 있다.
규모는 7B, 즉 70억 개 파라미터다. 갱신 주기는 초당 7회에서 9회이므로 한 번의 판단 사이에 100밀리초가 넘는 간격이 생긴다. 이 속도로는 실시간 제어를 직접 맡을 수 없다는 점이 System 1이 따로 필요한 이유다.
System 1
System 1은 로봇의 물리적 행동을 결정한다. System 2가 만든 의미 표현을 받아 실시간으로 움직임을 조정하며, 갱신 주기는 초당 200회다. 즉 5밀리초마다 새 제어 명령을 낸다.
규모는 80M, 즉 8천만 개 파라미터로 System 2의 100분의 1 수준이다. 두 시스템을 잇는 것은 latent 벡터다. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리키며, 구조도에서 두 상자 사이 화살표에 붙은 Latent Vector가 그것이다.
분업 구조
System 2가 고수준 목표를 정하고 System 1이 실시간 동작을 수행하는 분업 덕분에 정확한 로봇 행동을 빠르게 만들 수 있다는 것이 글의 설명이다. 느린 이해와 빠른 반응을 한 모델에 함께 담지 않고 주기를 나눈 구성이다.
구조도는 두 시스템이 서로 다른 GPU에 배치된 것으로 표기한다. System 2가 GPU 2, System 1이 GPU 1이다. 하드웨어 배치까지 분리했다는 점이 도식에서 확인되는 세부다.
주요 특징
글은 Helix의 특징을 다섯 가지로 나누고 각각에 데모 영상을 붙인다.
| 특징 | 글이 드는 근거 |
|---|---|
| 상반신 전체 제어 | 손목, 개별 손가락, 몸통, 머리까지 제어하는 최초의 VLA 모델. 손가락으로 물체를 섬세하게 집고 몸통과 머리를 움직여 시야와 접근성을 확보한다 |
| 다중 로봇 협업 | 로봇 두 대가 동시에 협력한다. 한 대가 봉지에서 물건을 꺼내 건네면 다른 한 대가 적절한 위치에 놓는다 |
| 범용 물체 조작 | 학습 데이터에 없던 물체 수천 개를 즉시 인식하고 다룬다 |
| 단일 신경망 | 하나의 신경망이 모든 행동을 학습하며 과제별 fine-tuning이 필요 없다 |
| 상업적 활용 가능 | 저전력 임베디드 GPU에서 실행되도록 최적화되어 제품에 바로 쓸 수 있는 최초의 VLA 모델 |
범용 물체 조작을 설명하는 대목이 가장 구체적이다. "선인장을 집어줘"라고 지시하면 Helix가 선인장이 무엇인지 개념적으로 이해하고 주변에서 그 형태의 물체를 찾아 적절한 방식으로 집는다는 설명이다. 즉 물체 목록을 외워 둔 것이 아니라 언어로 표현된 개념과 눈앞의 형태를 잇는다는 주장이다.
단일 신경망 항목은 generalist policy에 해당한다. generalist policy는 과제별 fine-tuning 없이 하나의 모델로 여러 과제를 푸는 policy를 말한다. 기존 로봇 시스템이 작업마다 따로 학습해야 했다는 서술과 짝을 이룬다.
원문 대비 수록 범위
이 글은 원문의 다섯 가지 특징과 두 시스템의 역할 분담까지를 옮기고, 학습 방법과 데이터에 관한 서술은 담지 않는다.
| 구분 | 항목 |
|---|---|
| 이 글에 있음 | 다섯 가지 특징, System 1과 System 2의 역할 분담과 갱신 주기, 구조도, 선인장 사례, 데모 영상 5편 |
| 이 글에 없음 | 약 500시간이라는 데이터 규모, 파라미터를 7B와 80M으로 나눈 근거, 35-DoF action space, hindsight instruction 기반 자동 라벨링, 학습 시점에 넣은 시간 오프셋, 과제 완료 비율을 예측하는 합성 action 차원, latent 벡터를 통한 그래디언트 역전파, 1,000배 스케일업 계획 |
7B와 80M이라는 숫자는 구조도에만 표기되어 있고 본문 서술에는 나오지 않는다. 따라서 구조를 실제로 파악하려면 원문을 정리한 Helix: A Vision-Language-Action Model for Generalist Humanoid Control을 함께 읽어야 한다.
한계
이 자료의 한계는 내용의 깊이보다 신뢰도 쪽에 있다.
- 정량 결과가 없다. 원문과 마찬가지로 성공률이나 벤치마크 수치를 제시하지 않고 특징 나열로 끝난다.
- 한 대목이 원문보다 강하게 서술되어 있다. 상용 준비를 설명하며 "추가적인 하드웨어 비용 없이 바로 상업적 배포가 가능합니다"라고 쓰는데, 원문은 저전력 임베디드 GPU에서 온보드로 동작한다는 사실과 그래서 상용 배치 준비가 됐다는 서술까지만 하고 하드웨어 비용은 언급하지 않는다.
- 글 끝에 저자가 "GPT 모델로 정리한 글을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다"라고 밝혀 두었다. 위의 하드웨어 비용 대목이 그 위험이 실제로 드러난 지점으로 보인다.
- 표기가 원문과 다르다. 글은 VLA를 VLAM으로 적는다. 인용할 일이 있으면 원문 쪽 표기와 수치를 쓴다.
- 향후 과제에 해당하는 서술이 사실상 없다. 원문의 1,000배 스케일업 언급이 빠져 있기 때문이다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| VLA | vision-language-action model의 약어. 시각 입력과 지시문을 함께 받아 로봇 제어 명령을 내는 모델. 이 글은 VLAM으로 적는다 |
| dual-system VLA | 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 VLA 구조. Helix의 System 2와 System 1이 이 구성이다 |
| control frequency | 로봇이 1초에 몇 번 새로운 action을 갱신하는지. Helix는 System 2가 초당 7회에서 9회, System 1이 초당 200회다 |
| latent | 모델 내부의 표현 공간. Helix에서는 System 2의 해석 결과를 System 1로 넘기는 벡터가 이 형태다 |
| generalist policy | 과제별 fine-tuning 없이 하나의 모델로 여러 과제를 푸는 policy. 글의 단일 신경망 항목이 이에 해당한다 |
| hindsight instruction | 이미 수집된 영상을 보고 그 동작을 시킬 만한 지시문을 사후에 붙인 자연어 라벨. 원문에는 있으나 이 글에는 없다 |
관련 페이지
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: 이 글이 옮긴 원문. 데이터 규모, 파라미터 분할, 학습 방식은 그 페이지에만 있다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 구조를 정리한 서베이. Helix의 두 시스템 분업이 어떤 계보에 놓이는지 확인할 수 있다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 한 달 뒤 공개된 오픈 foundation model. 느린 추론 모듈과 빠른 action 모듈을 나눈 구성이 Helix와 비슷하다.
- Physical AI 연구 한 번에 살펴보기 2편: 물리를 이해하는 생성 모델과 월드 시뮬레이터: 같은 저자가 정리한 Physical AI 서베이 소개 글.
- 용어집: Physical AI (Terminology Glossary): 이 페이지의 전문 용어 canonical 표기.