Physical AI · ARTICLE · 2026
World Action Model의 부상: 비디오 백본으로 로봇 정책을 학습하는 두 번째 레시피 (feat. NVIDIA)
요약
PyTorch KR 운영자 박정환이 NVIDIA Technical Blog의 World-Action Model 지형도를 한국어로 옮긴 글이다. 원문은 NVIDIA Seattle Robotics Lab의 Moritz Reuss가 2026년 6월 15일에 발표했고 한국어판은 사흘 뒤인 6월 18일에 올라왔다. 원문 자체는 이 wiki에 별도 페이지로 들어와 있으므로, 방법과 수치를 끝까지 따라가야 하는 독서는 원문 페이지가 담당한다.
WAM은 world-action model의 약자다. 웹 규모 video로 pre-training한 backbone에서 출발해 장면이 앞으로 어떻게 변할지 예측하면서 거기에 맞는 action까지 내놓는 policy 계열을 가리킨다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 글의 중심 주장은 WAM이 VLM 기반 VLA와 나란한 두 번째 레시피가 된다는 것이며, 저자는 다음 세대의 유력한 형태로 두 계열의 hybrid를 꼽는다.
한국어판이 원문에 더하는 것은 세 가지다. 본문 앞에 로보틱스 용어 열 개를 미리 풀어 주는 상자를 두고, 원문 도식 23장을 하나도 빠뜨리지 않고 재게시하며, 글 끝에 국내 독자용 관련 글 일곱 편을 붙인다. 이 가운데 도식 아카이브는 실제로 원문 페이지보다 낫다. 원문은 도식 상당수가 inline SVG로 삽입돼 있어 자동 수집에서 11장만 잡히는데, 한국어판에서는 23장이 전부 이미지 파일로 잡힌다.
배경
이 글의 성격
번역과 재구성을 겸한 글이다. 원문의 절 구성과 수치를 그대로 따르고 요약하거나 잘라내지 않는다. 반면 원문의 각주와 Acknowledgements, Sources 목록은 옮기지 않았고, 마지막 절의 "원문 블로그" 항목은 링크 카드로만 남아 본문 텍스트가 비어 있다.
글 끝에는 GPT 모델로 정리한 글을 바탕으로 했다는 고지가 붙어 있다. 따라서 인용 계보를 따라가거나 저자의 원래 표현이 필요한 작업에서는 원문을 함께 봐야 한다.
VLA가 부딪히는 문제
지난 몇 년간 로봇 foundation model 연구의 중심에는 VLA가 있었다. 인터넷 규모 이미지와 텍스트로 pre-training한 VLM을 가져와 그 위에 action을 내는 헤드를 붙여 fine-tuning하는 방식이다. Pi-0가 세우고 Pi-0.5가 다듬은 이 레시피는 NVIDIA GR00T를 비롯한 수많은 후속 연구로 이어졌다.
이 레시피가 부딪히는 벽이 grounding이다. grounding은 지시문(instruction)에 나오는 기호를 그 말을 실제로 만족시키는 지각 대상과 운동 대상에 잇는 일을 말한다. "빨간 머그컵을 집어라"라는 문장을 그 일을 실제로 해내는 모터 명령으로 바꾸는 과정이 여기 해당하며, 결국 제한된 로봇 데이터 안에서 배울 수밖에 없다.
WAM은 출발점을 바꿔 이 문제를 우회한다. 현대의 video 생성 모델은 텍스트 설명에서 video를 만들도록 학습되고, 그렇게 학습에 쓰인 video 안에는 손이 뻗고 도구가 움직이고 물체가 다뤄지는 의도적 동작이 이미 가득하다. 따라서 backbone은 로봇 action을 한 번도 보기 전에 언어와 시각적 변화와 그럴듯한 물체 상호작용 사이의 연결을 이미 부호화하고 있다. 남은 video에서 action으로의 간극이 언어에서 action으로의 간극보다 작으리라는 것이 이 계열의 베팅이다.
WAM에 거는 세 가지 가설
저자는 아래 세 항목을 결론이 아니라 가설로 다루라고 명시한다. 여러 논문과 동료 논의에서 반복되는 주장이지만 아직 통제된 비교로 검증된 것은 아니다.
- 미래 변화 예측은 그에 필요한 action 생성과 상관관계가 있다. 원하는 결과가 이미 주어지면 그 결과를 만든 action을 되짚는 편이, 지시문과 현재 observation에서 action을 곧바로 예측하는 것보다 대체로 쉽다. Pi-0.7이 원하는 미래 이미지를 policy에 줬을 때 action 예측이 더 직접적이 되고 학습이 빨리 수렴했다고 보고한 것도 같은 방향의 신호다.
- video pre-training이 언어와 물리적 변화 사이의 grounding을 대신 제공한다. video 모델은 텍스트 설명을 시각적 결과로 옮기도록 학습되므로, 이 능력이 로보틱스로 전이되면 시연 데이터(demonstration)만으로 배워야 할 grounding의 양이 줄어든다.
- 웹 규모 video가 로봇 policy를 정규화한다. 로봇 데이터셋은 웹 규모 video에 비해 매우 작으므로, video로 먼저 pre-training하거나 로봇 데이터와 함께 co-training하면 넓은 시각 사전 지식이 과적합을 줄일 수 있다. DreamZero와 Fast-WAM은 로봇 fine-tuning 구간에서 action 학습을 video 예측 목적과 함께 co-training할 때 성능이 가장 좋았다고 보고한다.
핵심 개념
한국어판은 본문에 들어가기 전에 용어 열 개를 풀어 주는 상자를 둔다. 원문에도 같은 상자가 있지만 한국어 독자에게는 이 배치가 진입 문턱을 크게 낮춘다. 아래 표는 그 열 개를 이 wiki의 canonical 표기로 옮긴 것이다.
| 용어 | 뜻 |
|---|---|
| VLA | pre-training된 VLM backbone에서 출발해 시각 observation과 지시문으로부터 action을 생성하도록 적응시킨 로봇 policy |
| WAM | pre-training된 world model이나 video backbone에서 출발해 장면이 시간에 따라 어떻게 변하는지를 표현하고 예측하며 대응 action을 내놓는 policy |
| VLM | 이미지와 텍스트로 pre-training되어 시각 입력에 근거한 언어 출력을 내는 모델 |
| world model | 현재 상태와 action 추상화를 조건으로 미래 세계 상태를 예측하는 모델 |
| grounding | 언어 명령 같은 기호를 그것을 실제로 만족시키는 지각 대상과 운동 대상에 잇는 일 |
| inverse dynamics | 현재 observation과 k스텝 뒤 observation이 주어졌을 때 그 전이를 만든 action을 추론하는 문제 |
| joint prediction | 하나의 policy가 미래 observation과 action을 함께 예측하도록 학습하는 방식 |
| action chunk | policy 호출 한 번에 예측하는 짧은 구간의 action 묶음 |
| MoT | video와 action처럼 모달리티마다 Transformer를 따로 두되 attention은 공유하는 구조 |
| DiT | diffusion과 flow matching 모델 안에서 이미지와 video와 action 토큰을 여러 단계로 denoising하는 Transformer backbone |
하나를 덧붙이면 본문 읽기가 수월해진다. video backbone은 웹 규모 video로 pre-training되어 로봇 policy 안에서 중심 표현이나 생성기로 재사용되는 모델을 말한다. Wan과 Cosmos 계열이 현대 WAM의 표준 출발점이다.
방법
설계 공간의 세 가지 기준
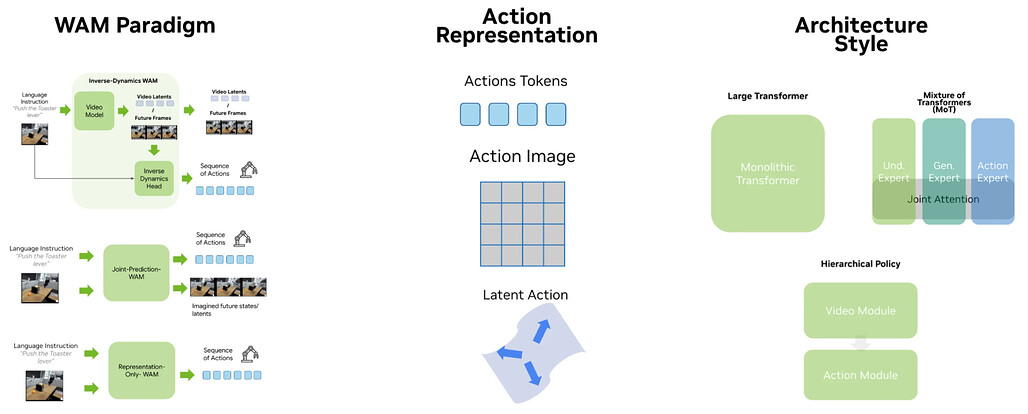
VLM 기반 VLA는 학습 레시피가 VLM co-training과 flow matching 기반 action 생성 조합으로 대체로 수렴했다. 반면 WAM은 아직 여러 형태로 갈라져 있고, 저자는 그 상태 자체가 이 분야를 흥미롭게 만든다고 본다. 설계 공간은 세 가지 기준으로 정리되며 기준끼리 완전히 독립은 아니다.
| 기준 | 묻는 질문 | 선택지 |
|---|---|---|
| paradigm | 모델이 무엇을 예측하고 예측된 video를 어떻게 action으로 바꾸는가 | inverse dynamics, joint prediction, representation-only |
| action integration | action이 실제로 모델에 어떻게 들어가는가 | 기본 action 토큰, action-as-image, latent plan과 latent action |
| architecture | 구성 요소를 어떻게 묶는가 | hierarchical, monolithic Transformer, Mixture-of-Transformers |
예측 대상에 따른 세 계열
세 계열은 추론 경계에서 갈린다. inverse dynamics 계열은 미래 video를 먼저 만들고 거기서 action을 뽑는다. joint prediction 계열은 video와 action을 한 번에 낸다. representation-only 계열은 추론 시점의 video 생성을 아예 건너뛴다.
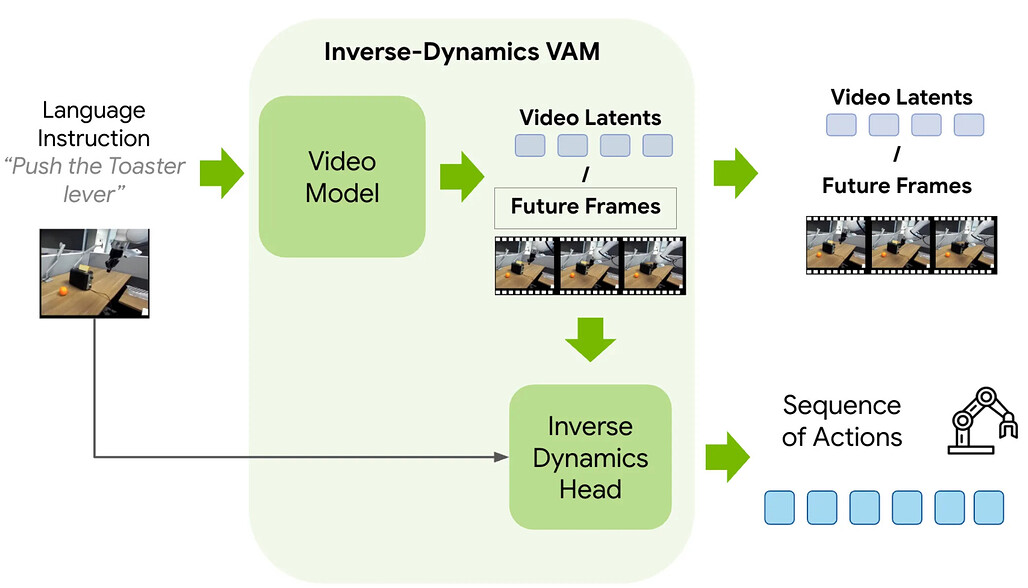
inverse dynamics 계열의 선구적 사례는 2023년의 UniPi다. video diffusion을 고수준 계획으로 쓰고 그 계획에서 저수준 제어를 복원하는 구성을 처음으로 명확히 실행했다. 동시에 UniPi는 WAM이 주류가 되기까지 몇 년이 더 걸린 이유도 보여준다. Imagen Video 시대의 CNN 기반 video diffusion 스택을 처음부터 학습해야 했고, 저자의 거친 추정으로 그 pre-training은 약 167 ZFLOP이라 대부분의 로보틱스 연구실 예산을 크게 벗어났다.
같은 계열의 현대판이 Ant Group의 LingBot-VA다. 1만 6,000시간 규모의 cross-embodiment pre-training으로 Wan 2.2-5B를 로봇 video-action 모델로 바꾼다. UniPi와의 차이는 규모만이 아니다. LingBot-VA는 causal 구조이며 open-loop video 생성이 아니라 closed-loop rollout을 위해 긴 시각 이력으로 학습된다. 또한 video와 action에 각각 전문가를 두고 층마다 공유 self-attention으로 묶는 MoT 구조를 쓴다.
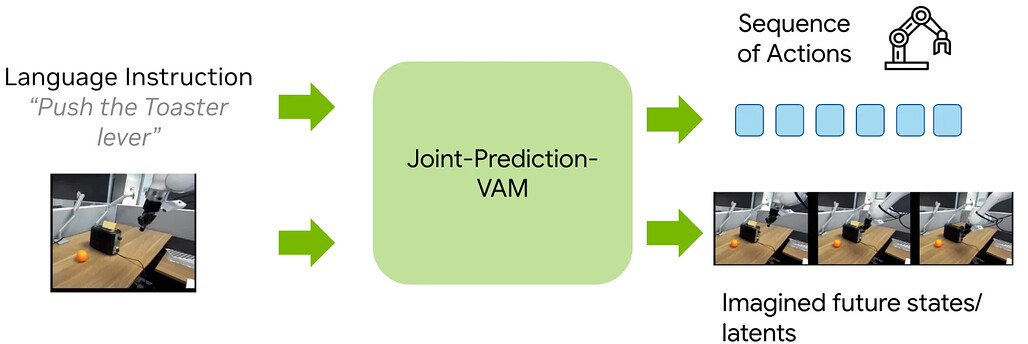
joint prediction 계열의 기반 논문은 GR-1이다. GPT-2 형태의 Transformer policy를 인터넷 video 예측으로 먼저 학습시킨 뒤, 미래 프레임과 action chunk를 함께 맞히는 목적으로 로봇 데이터에 fine-tuning했다. R3M과 Voltron 같은 앞선 연구가 이미 video와 언어가 로보틱스 표현 학습에 도움이 된다는 것을 보였지만, GR-1은 video를 이미지 수준의 시각 표현이 아니라 더 나은 policy 표현을 얻는 데 썼다는 점에서 전환점이 됐다.
이 아이디어의 현대적 대규모 버전이 NVIDIA의 DreamZero다. video 예측 헤드를 덧붙인 작은 policy를 학습하는 대신, Wan 2.1-I2V-14B-480P에서 출발해 video diffusion backbone 자체를 world-action model로 바꾼다. 하나의 monolithic DiT 안에서 video 토큰과 action 토큰을 함께 denoising하므로 별도의 inverse dynamics 모듈이 없고, action은 같은 denoising 과정 안의 또 다른 생성 모달리티가 된다.
세 번째 선택지인 representation-only는 video backbone을 표현으로만 쓰고 추론 시점의 video 생성을 건너뛴다. Fast-WAM이 대표 사례로, LingBot-VA와 비슷한 Wan 기반 MoT 구성을 쓰면서 1만 6,000시간 규모의 로봇 pre-training 없이도 시뮬레이션 벤치마크에서 그 성능에 근접한다. 다만 저자는 이것이 표현 전용 가설을 뒷받침하는 몇 안 되는 공개 증거이고 지금은 시뮬레이션 증거뿐이라 확신하기 이르다고 단서를 단다.
action을 모델에 넣는 세 가지 방법
두 번째 기준이 중요한 이유는 모달리티 불일치 때문이다. pre-training된 backbone은 시각 토큰을 denoising하는 법은 알지만 연속값인 로봇 action은 모른다.
| 방식 | 하는 일 | 사례 | 위험과 이점 |
|---|---|---|---|
| 기본 action 토큰 | 연속 또는 이산 action 토큰과 헤드를 더해 action을 video와 나란한 모달리티로 다룬다 | UniPi, GR-1, DreamZero, LingBot-VA, VPP, mimic-video, Fast-WAM | 가장 단순하지만 모달리티 불일치가 남아 fine-tuning 중 표현을 다시 맞춰야 한다 |
| action-as-image | action을 video 모델이 이미 아는 시각적 목표로 바꿔 같은 생성 인터페이스 안에 넣는다 | GENIMA, Cosmos Policy | pre-training된 video 표현을 흔들지 않는다 |
| latent plan과 latent action | action을 압축한 latent 표현에 policy를 조건화한다 | Play-LMP, Genie, LAPA, Being-H0.7, DreamDojo | 전체 video 예측이 비싸고 대부분의 픽셀이 제어에 불필요하다는 점을 파고든다 |
GENIMA는 Stable Diffusion을 fine-tuning해 RGB 이미지 위에 관절 목표를 그리고 컨트롤러가 그 시각적 목표를 관절 위치 action으로 옮긴다. Cosmos Policy는 같은 발상을 latent 층위로 올려, action과 proprioception과 value 목표를 video 모델 자신의 denoising 인터페이스 안의 합성 프레임으로 부호화하고 추론 시 예측된 action 이미지를 공간 차원으로 평균해 action 벡터로 디코딩한다.
latent 쪽 계보는 2019년 Play-LMP가 열었다. posterior 네트워크가 짧은 trajectory 창을 latent plan으로 압축하고, prior 네트워크가 현재 observation과 목표 이미지로부터 그 plan을 예측하며, 저수준 policy가 샘플된 plan을 action으로 디코딩한다. Being-H0.7은 같은 논리를 foundation model 규모로 실행한다. posterior 분기가 동결된 V-JEPA 2.1 시각 인코더와 Perceiver 리샘플러로 미래 observation을 K개 임베딩으로 압축하고, prior 분기가 학습 가능한 질의로 그 정보를 문맥에서 맞춘다. 테스트 시점에는 posterior 분기를 떼어내 전체 video를 다시 생성할 필요를 없앤다. 학습 데이터는 1인칭 인간 video 20만 시간과 로봇 시연 데이터 1만 5,000시간이다.
inverse dynamics와 latent action의 차이는 감독 경로에 있다. inverse dynamics 계열은 시각적 전이가 어떻게 모터 명령으로 이어지는지 배우려고 짝지어진 video와 action 데이터를 요구한다. 반면 latent action 계열은 video 자체에서 action 추상화를 먼저 배운 뒤 그 추상화를 나중에 로봇 action에 연결한다.
구성 요소를 묶는 세 가지 방법
세 번째 기준은 앞의 두 기준과 대체로 직교한다. inverse dynamics가 hierarchical일 수도 MoT 형태일 수도 있고, joint prediction이 monolithic일 수도 전문가 기반일 수도 있다.
| 구성 | 결합 강도 | 이점 | 한계 | 사례 |
|---|---|---|---|---|
| hierarchical | 약함, 정보가 한 방향으로만 흐른다 | action 헤드가 완전한 모듈이라 단순 CNN 회귀기부터 완전한 VLA 스택까지 바꿔 끼울 수 있다 | video와 action이 서로 강하게 영향을 줘야 하는 상황에 부적합 | UniPi, VPP, mimic-video, Pi-0.7 |
| monolithic Transformer | 강함, 한 스택에서 video와 action을 함께 denoising한다 | 두 흐름의 결합이 강하고 action-as-image 구성과 잘 맞는다 | 같은 가중치가 조밀한 시각 토큰과 훨씬 희소한 action 목표를 함께 감당해야 한다 | DreamZero, Cosmos Policy |
| Mixture-of-Transformers | 중간, 가중치는 나누고 attention은 공유한다 | 모듈성과 결합 사이의 실용적 절충 | 전문가별 가중치만큼 파라미터가 늘어난다 | Pi-0, Pi-0.5, LingBot-VA, Fast-WAM |
MoT는 현대 VLA와 최근 WAM 양쪽에서 이미 기본값이다. 저자는 같은 실용적 절충을 이유로 WAM 쪽에서도 MoT 계열이 지배적 구조가 되리라 추측한다.
WAM이 지금 부상한 이유
아이디어 자체는 새롭지 않았고 필요한 도구가 늦게 따라왔다는 것이 저자의 답이다. UniPi와 GR-1과 Play-LMP는 각각 inverse dynamics와 joint prediction과 latent 추상화의 방향을 이미 갖고 있었지만, backbone이 작았고 video 데이터가 약했으며 공개된 video foundation model이 없었고 스텝별 action 헤드가 현대 action chunk policy에 비해 잘 동작하지 않았다.
세 가지가 바뀌었다.
- video backbone이 훨씬 강해졌다. Wan과 Cosmos 같은 DiT 기반 모델이 더 나은 시간 압축과 flow matching 목적과 잘 정제된 웹 규모 video 데이터를 들고 이전 CNN 스택을 대체했다.
- 그 backbone이 공개됐다. 연구자가 pre-training 비용을 직접 치르는 대신 강력한 모델을 fine-tuning할 수 있게 됐다.
- action 쪽도 따라왔다. 작은 스텝별 MLP 헤드 대신 Transformer나 flow matching 헤드로 action chunk를 예측하는 방식이 표준이 됐다.
결과
Veo 3.1 정성 점검
action 헤드를 붙이기 전에 프런티어 video 모델이 이미 무엇을 아는지 확인하려고 저자 팀은 간단한 실험을 했다. DROID 셋업의 토스터 과제에서 컨텍스트 프레임 한 장을 뽑아 Google의 Veo 3.1에 주고, 토스터 레버를 누른 다음 왼쪽에 놓인 오렌지를 집으라고 프롬프트했다. 앞쪽은 원본 DROID 시연 데이터와 일치하는 참조 과제이고 뒤쪽은 시연 데이터 밖의 합성 확장이다.
결과는 로봇 policy로 명시적으로 학습되지 않은 모델치고 상당히 좋았다. 움직임이 부드럽고 배경이 일관되며 두 목표 물체를 향한 궤도가 그럴듯했고, 레버를 마친 뒤 오렌지로 이동하는 순서까지 지켜졌다. 한계도 분명했다. 모델은 레버를 끝까지 누르지 못하고 때로 반대 방향으로 당기는 듯한 동작을 보이며, 원본 DROID 셋업의 핀치 그리퍼가 네 손가락 손으로 변형된다.
이 점검은 통제된 실험이 아니라 사전 지식에 대한 정성적 확인이다. 프롬프트 최적화 없는 원샷 시도였고 Veo의 학습 데이터를 직접 확인할 수 없기 때문이다. 그럼에도 backbone이 로봇과 물체의 상호작용이 어떻게 보여야 하는지에 대한 사전 지식을 이미 갖고 있음을 보여준다. WAM fine-tuning은 이 상상을 신뢰할 수 있는 제어로 바꾸려는 시도다.
실세계와 시뮬레이션 평가
WAM 쪽의 가장 중요한 실세계 신호는 RoboArena 점수다. 대부분의 논문이 여전히 LIBERO 같은 시뮬레이션 벤치마크에 기대는 가운데 RoboArena는 몇 안 되는 공개 실세계 개방형 평가다.
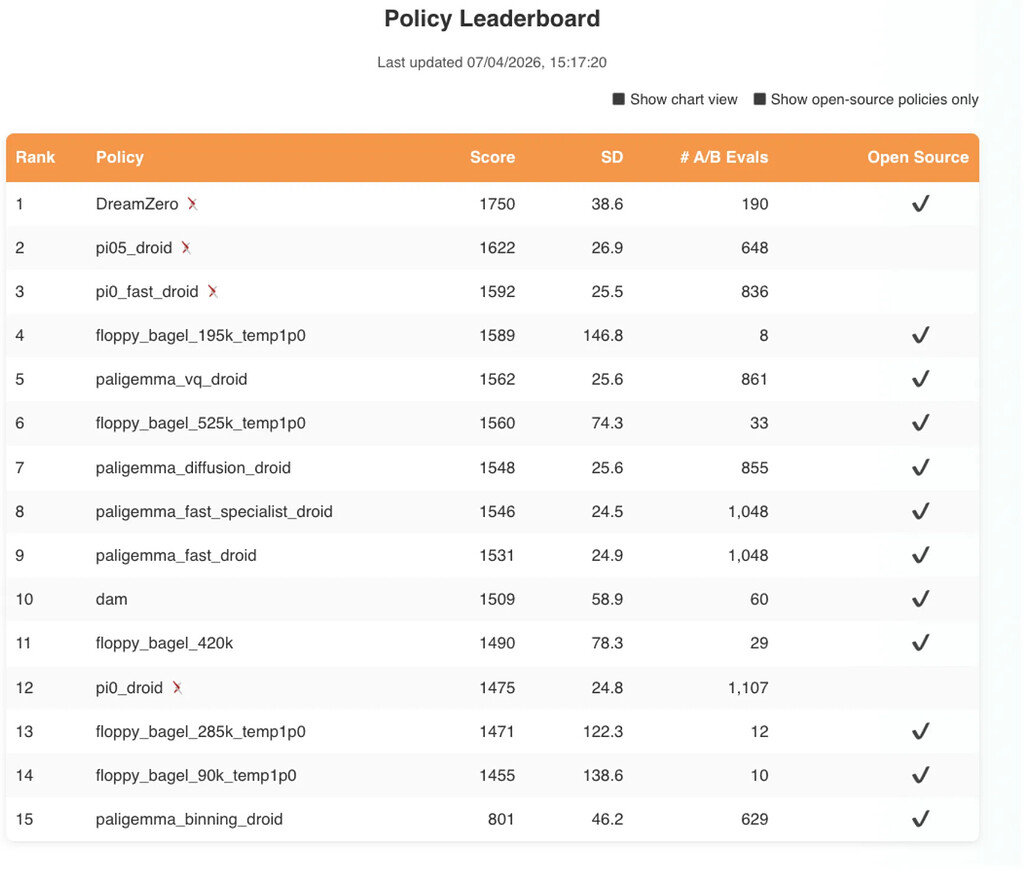
| 모델 | 2026년 4월 점수 | 비고 |
|---|---|---|
| DreamZero | 1750점 | 추가 cross-embodiment 학습 없이 DROID만으로 학습했다 |
| Pi-0.5 | 1622점 | VLM 데이터와 로봇 데이터를 co-training하고 그래디언트를 분리한다 |
| Pi-FAST | 1592점 | Pi-0-DROID와 같은 backbone에 flow 요소 없이 이산 FAST 토큰만 쓴다 |
| Pi-0 | 1475점 | flow 기반 구성 |
Pi-FAST와 Pi-0의 117점 차이는 이산 action 레시피가 pre-training으로 얻은 능력을 더 잘 보존한다는 견해를 뒷받침한다. 두 모델은 backbone이 같고 둘 다 DROID에 fine-tuning됐기 때문이다. DreamZero가 그 위에 1750점을 기록했다는 사실은 video와 이미지 목표의 사전 지식이 grounding 문제에 도움이 될 수 있다는 또 하나의 논거다.
시뮬레이션 쪽 역사적 참조점은 CALVIN이다. 더 어려운 ABC에서 D로의 분할에서 GR-1 표에 실린 기존 방법들은 평균 완료 subtask 수가 1.0개 아래에 머물렀는데, GR-1은 5개 중 3.06개에 도달했다. 2026년 기준으로 이 수치는 낡았지만 미래 시각 상태 예측이 더 나은 시각 인코더가 아니라 더 나은 policy 표현을 만든다는 것을 보였다는 점에서 의미가 있다.
교란을 맞춘 첫 비교는 Zhang et al.이 내놓았다. LingBot-VA와 Cosmos Policy와 Pi-0.5를 LIBERO-Plus와 RoboTwin 2.0-Plus에서 재어, WAM이 VLA 기준선의 넓은 학습 데이터 혼합 없이도 강한 견고성에 도달할 수 있음을 보였다. 다만 이 비교는 시뮬레이션에 한정되며 실세계 일반화는 다루지 않는다.
학습 연산량
저자는 VLA와 WAM의 비용을 같은 잣대에 올리려고 조밀 Transformer의 하한 추정을 쓴다. 학습 연산량을 파라미터 수와 처리 토큰 수의 곱에 6을 곱한 값으로 잡고 결과를 ZFLOP 단위로 보고한다. 1 ZFLOP은 10의 21제곱 FLOP이며 대략 936 H100-시간에 해당한다.
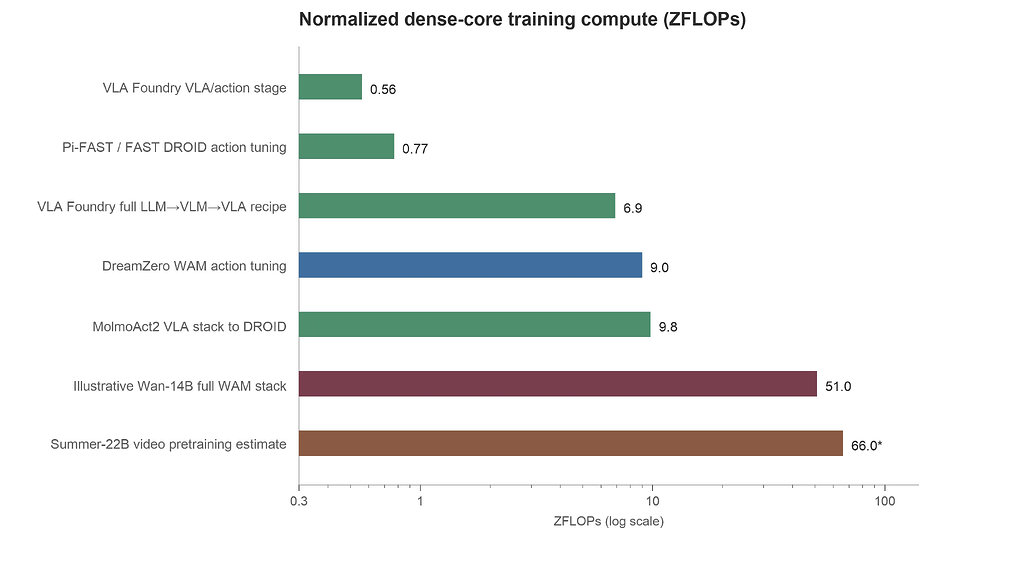
| 비교 항목 | 무엇을 세는가 | 추정 연산량 |
|---|---|---|
| VLA Foundry 소형 레시피 | 언어 pre-training과 VLM 학습과 action 학습 전체 | 약 6.9 ZFLOP |
| DreamZero의 action 튜닝 | pre-training된 Wan-14B의 downstream 적응만 | 약 8.6에서 9.0 ZFLOP |
| MolmoAct2 VLA 스택 | MolmoAct2에서 DROID 체크포인트까지 보고된 전체 | 약 9.8 ZFLOP |
| Wan-14B 규모 전체 스택 | video pre-training과 DreamZero식 action 튜닝의 합 | 약 51 ZFLOP |
| Summer-22B video pre-training | 22B 모델을 약 5,000억 개 video 토큰으로 처음부터 학습 | 약 66 ZFLOP |
| UniPi의 video pre-training | Imagen Video 시대 CNN video diffusion을 처음부터 학습 | 약 167 ZFLOP |
이 표의 핵심은 무엇을 비용에 넣느냐에 따라 결론이 갈린다는 점이다. DreamZero의 action 튜닝만 보면 약 9 ZFLOP, 즉 약 8,400 H100-시간으로 VLA 레시피와 큰 차이가 없다. 그러나 이것은 Wan backbone을 만드는 비용이 아니라 그 위에 action을 입히는 downstream 적응 비용일 뿐이다. video backbone까지 직접 학습해야 하는 전체 스택은 약 51 ZFLOP이고, 효율적인 VLA Foundry 레시피의 약 6.9 ZFLOP과 비교하면 약 7.4배 차이가 난다.
비용이 이렇게 벌어지는 이유는 시퀀스 길이다. VLA는 이미지 한두 장과 텍스트를 부호화한 뒤 텍스트나 짧은 action 토큰을 예측한다. 반면 WAM은 video latent 토큰 시퀀스에 action 토큰을 더해 예측하는데, video 토큰 시퀀스는 VLA 시퀀스보다 흔히 약 10배 길다.
총 FLOP 외에 하드웨어와 엔지니어링 장벽도 있다. 약 8,000 토큰짜리 action 튜닝 시퀀스를 다루는 14B 모델은 충분한 GPU 메모리와 고속 인터커넥트를 갖춘 다중 노드 구성을 요구한다. 데이터 필터링과 캡셔닝, video 디코딩, latent 전처리, 분산 입출력, 긴 시퀀스 DiT 인프라도 함께 필요하다. DreamZero가 더 강한 video 생성이 더 강한 policy 성능으로 이어진다고 주장하므로, video 데이터 품질 관리까지 policy 레시피의 일부가 된다.
추론 속도
추론 시점의 video 생성은 실시간 제어의 걸림돌이다. Fast-WAM이 제시한 대표값으로, video 생성을 동반하는 두 가지 일반적 WAM 추론 방식은 action chunk 하나당 590ms에서 800ms가 걸린다. 같은 조건에서 Pi-0.5는 약 190ms다. 즉 추론이 3배에서 4배 느려진다.
DreamZero 논문이 보인 방법이나 Fast-WAM처럼 video 생성을 건너뛰는 구성으로 속도를 높일 수 있지만, 대형 GPU 없이 이 모델들을 로컬에서 구동하는 것은 여전히 어렵다.
수렴 전망
저자는 두 경로가 장기적으로 구분된 채 남을지를 열린 질문으로 둔다. 일부 최근 VLA는 더 나은 목표 따르기를 위해 이미 world model 형태의 구성 요소를 쓰고, 많은 최근 WAM은 action expert를 위해 VLA의 MoT 레시피를 빌려 온다.
수렴의 초기 신호는 네 가지로 나타난다.
- Motus와 BagelVLA는 언어와 video 중 무엇이 로보틱스의 주 표현이어야 하는지 정하는 대신 모두 하나의 모델로 학습한다. 이해 담당 구성 요소와 video 생성 구성 요소와 action expert가 각각 특화된 가중치를 갖고 공유 self-attention으로 정보를 주고받는다.
- Pi-0.7은 같은 hybrid의 hierarchical 버전이다. high-level policy가 subtask 명령을 내면 BAGEL 기반 world model이 그 명령을 subgoal image로 바꾸고, action expert가 현재 observation과 그 이미지에 조건화되어 실행한다. 보고된 ablation은 world model이 만든 subgoal image를 더하면 복잡한 참조 과제에서 지시 따르기가 개선되고, 데이터셋 편향을 깨야 하는 과제에는 필수적임을 보여준다.
- Sereact의 Cortex 2.0은 산업 쪽 신호다. 시각 latent 공간에서 후보 미래 trajectory를 생성하고 예상 진행도와 위험과 효율로 점수를 매긴 뒤 가장 높은 rollout에 실행을 조건화한다. WAM 형태의 예측이 배치된 manipulation 시스템 안의 계획 층이 되고 있다는 뜻이다.
- Being-H0.7은 foundation model 규모 hybrid의 가장 좋은 예다. pre-training된 VLA인 Being-H0.5 위에 세운 latent plan 형태의 구성이며 InternVL3.5를 이해 전문가로, Qwen3를 action expert로, V-JEPA 2 시각 인코더를 쓴다.
네 번째 가능성으로 로보틱스 우선 foundation model도 제시된다. 웹 VLM이나 video 생성기에서 출발해 나중에 action을 붙이는 대신, embodiment와 action과 접촉이 잦은 상호작용을 중심에 놓고 설계한 대형 Transformer다. 저자가 드는 가장 깔끔한 사례는 Generalist AI의 GEN-1으로, UMI 형태의 웨어러블 데이터 50만 시간으로 pre-training됐다. 이 경로의 문제는 접근성이다. 대규모 오픈소스 로보틱스 데이터가 나오기 전까지는 자금이 넉넉한 조직 밖에서 따라가기 어렵다.
직교하는 방향으로는 V-JEPA 2 같은 latent world model이 있다. pre-training된 latent 공간 안에서 video로부터 직접 dynamics를 배워, diffusion 기반 video 생성보다 저렴한 rollout과 빠른 추론을 노린다. 이 방향의 첫 WAM인 VLA-JEPA와 Being-H0.7이 유망한 성능을 보고하고 있다.
한국어판이 더하는 것
도식 아카이브
이 자료의 실질적 값은 도식 아카이브에 있다. 원문 페이지는 도식 상당수가 inline SVG라 자동 수집에서 11장만 내려받히는데, 한국어판은 Discourse에 일반 이미지로 재게시돼 있어 23장이 모두 잡힌다. 해상도는 Discourse가 가로 1,028px로 최적화한 사본이라 원문 원본의 최대 1,975px보다 낮다.
이 차이 때문에 원문 페이지도 이 아카이브에 의존한다. 설계 공간 도식과 두 계열의 추상 구조와 RoboArena 리더보드와 연산량 비교와 수렴 도식은 원문 페이지에서도 여기 파일을 가져다 쓰고 있다. 페이지 전체 스크린샷 한 장과 요소 단위 크롭 21장도 같은 폴더에 함께 있다.
번역 표기와 이 wiki의 canonical 표기
번역 선택 몇 가지는 이 wiki의 용어 규약과 다르다. 한국어판을 읽다가 이 wiki에 옮겨 적을 때는 아래 대응으로 바꾼다. 왼쪽 열은 한국어판의 표기이고 오른쪽이 용어집이 정한 canonical 표기다.
| 한국어판 표기 | 이 wiki의 canonical 표기 |
|---|---|
정책 |
policy |
행동, 행동 청크 |
action, action chunk |
관측 |
observation |
월드 모델 |
world model |
비디오 백본 |
video backbone |
역동역학 |
inverse dynamics |
공동 예측 |
joint prediction |
공동 학습 |
co-training |
그라운딩 |
grounding |
잠재 계획, 잠재 행동 |
latent plan, latent action |
사전학습, 미세조정 |
pre-training, fine-tuning |
파국적 망각 |
catastrophic forgetting |
트랜스포머, 어텐션 |
Transformer, attention |
고유수용성 |
proprioception |
궤적 |
trajectory |
시각운동 정책 |
visuomotor policy |
국내 독자용 관련 글
글 끝에는 PyTorch KR의 관련 글 일곱 편이 붙는다. NVIDIA Cosmos 3, Isaac GR00T, Gemini Robotics, SmolVLA, Helix, Gemini Robotics ER 1.6, gWorld를 다룬 글들이다. 이 가운데 Helix 소개는 이 wiki에 별도 페이지로 이미 들어와 있고, 나머지 여섯 편은 아직 없다. 같은 저자의 다른 해설로는 물리를 이해하는 생성 모델이 들어와 있다.
한계
- 이 글은 원문의 요약이 아니라 전문 번역에 가깝지만, GPT 모델로 정리했다는 고지가 붙어 있어 표현 단위의 정확성은 보장되지 않는다. 인용할 문장은 원문에서 확인한다.
- 원문 게시 사흘 뒤에 올라온 글이라 이후의 상황 변화는 반영돼 있지 않다. RoboArena 리더보드는 2026년 4월 스냅샷이다.
- 각주와 Acknowledgements, Sources 목록이 옮겨지지 않아 인용 계보를 따라가려면 원문을 봐야 한다. "원문 블로그" 절은 링크 카드만 남고 본문이 비어 있다.
- 원문이 스스로 밝힌 한계도 그대로 이어진다. WAM 논문끼리 backbone과 pre-training 양과 평가 구성이 제각각이라 깨끗하게 통제된 비교가 거의 불가능하고, 세 가지 가설도 아직 검증되지 않은 주장이다.
- 도식 해상도가 원문 원본보다 낮다. 세부 글자를 읽어야 하는 도식은 원문 페이지 쪽을 확인하는 편이 낫다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| WAM (world-action model) | video backbone에서 출발해 미래 장면 변화와 action을 함께 다루는 policy 계열 |
| video backbone | 웹 규모 video로 pre-training한 생성 모델. Wan과 Cosmos 계열이 현대 WAM의 출발점이다 |
| inverse dynamics | 현재 observation과 미래 observation 사이를 만든 action을 되짚는 문제 |
| joint prediction | 하나의 policy가 미래 observation과 action을 같은 예측 단계에서 함께 내놓는 방식 |
| action-as-image | action을 video 모델이 이미 다루는 시각적 목표나 합성 latent 프레임으로 부호화하는 통합 방식 |
| ZFLOP | 10의 21제곱 FLOP. VLA와 WAM의 학습 비용을 같은 잣대에 올릴 때 쓰며 약 936 H100-시간에 해당한다 |
관련 페이지
- Pretrained to Imagine, Fine-Tuned to Act: The Rise of World-Action Models: 이 글의 원문. 같은 내용을 더 깊이 다루므로 방법과 수치를 끝까지 따라가려면 원문 페이지를 본다.
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation: 이 글이 joint prediction 계열의 출발점으로 드는 GR-1 논문. 구현은 공식 저장소에 있다.
- World Model for Robot Learning: A Comprehensive Survey: 저자가 본문에서 가리키는 NTU 서베이. 로보틱스 world model 전반을 넓게 조망한다.
- A Comprehensive Survey on World Models for Embodied AI: embodied AI world model 서베이. WAM을 world model 계보 안에 놓고 볼 때의 배경이다.
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: 본문이 hybrid의 hierarchical 사례로 드는 Pi-0.7. world model이 만든 subgoal image에 action expert를 조건화한다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: RoboArena에서 DreamZero의 상대이자 VLA 쪽 기준선.
- π0: A Vision-Language-Action Flow Model for General Robot Control: MoT와 flow matching action expert 레시피의 출처. WAM 쪽이 그대로 빌려 쓴다.
- Cosmos World Foundation Model Platform for Physical AI: Cosmos 계열 video backbone의 1차 자료.
- Physical AI 연구 한 번에 살펴보기 2편: 물리를 이해하는 생성 모델과 월드 시뮬레이터: 같은 저자의 다른 PyTorch KR 해설.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.