Physical AI · ARTICLE · 2025
Helix: A Vision-Language-Action Model for Generalist Humanoid Control
요약
Helix는 Figure AI가 2025년 2월에 공개한 humanoid 상체 제어용 VLA다. 손목과 손가락, 몸통, 머리를 포함한 상체 전체를 자연어 명령으로 제어하고, 두 대의 로봇에서 같은 가중치로 동시에 실행되며, 과제별 fine-tuning 없이 하나의 가중치 묶음으로 물건 집기부터 냉장고 조작까지 처리한다고 밝힌다.
이 자료는 논문이 아니라 회사 블로그 발표문이다. 대응하는 arXiv 공개가 없고 성공률 표도, 기존 VLA와의 벤치마크 대조도, ablation도 실려 있지 않다. ablation은 구성 요소를 하나씩 빼거나 바꿔 성능 기여를 확인하는 실험을 말한다. 따라서 이 페이지는 결과 검증보다 설계 선택을 읽는 자료로 다룬다.
Helix의 설계는 dual-system VLA에 속한다. dual-system VLA는 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 실행하는 VLA 구조다. 같은 분업이 한 달 뒤 GR00T N1에서 논문과 오픈 가중치로 공개되므로, 두 자료를 나란히 두면 2025년 상반기 humanoid VLA가 어디로 수렴하고 있었는지를 확인할 수 있다.
배경
Figure AI가 문제로 잡는 것은 성능이 아니라 새 동작 하나를 얻는 비용이다. 가정 환경은 통제된 산업 현장과 달리 깨지기 쉬운 유리 제품, 구겨진 옷가지, 흩어진 장난감처럼 모양과 크기와 색과 질감을 예측할 수 없는 물건으로 가득하다. 따라서 가정에서 쓸모 있으려면 로봇이 처음 보는 물체에 대해서도 새 동작을 즉석에서 만들어낼 수 있어야 한다.
기존 방식으로는 이 요구를 감당할 수 없다는 것이 발표문의 진단이다. 지금까지 로봇에 동작 하나를 가르치려면 박사급 인력의 수작업 프로그래밍 몇 시간이 들거나 시연 데이터(demonstration) 수천 건이 필요했다. 시연 데이터는 사람이 만들어준 모범 실행 데이터를 말한다. 가정이라는 문제 공간의 크기를 생각하면 두 방식 모두 비용을 감당할 수 없다.
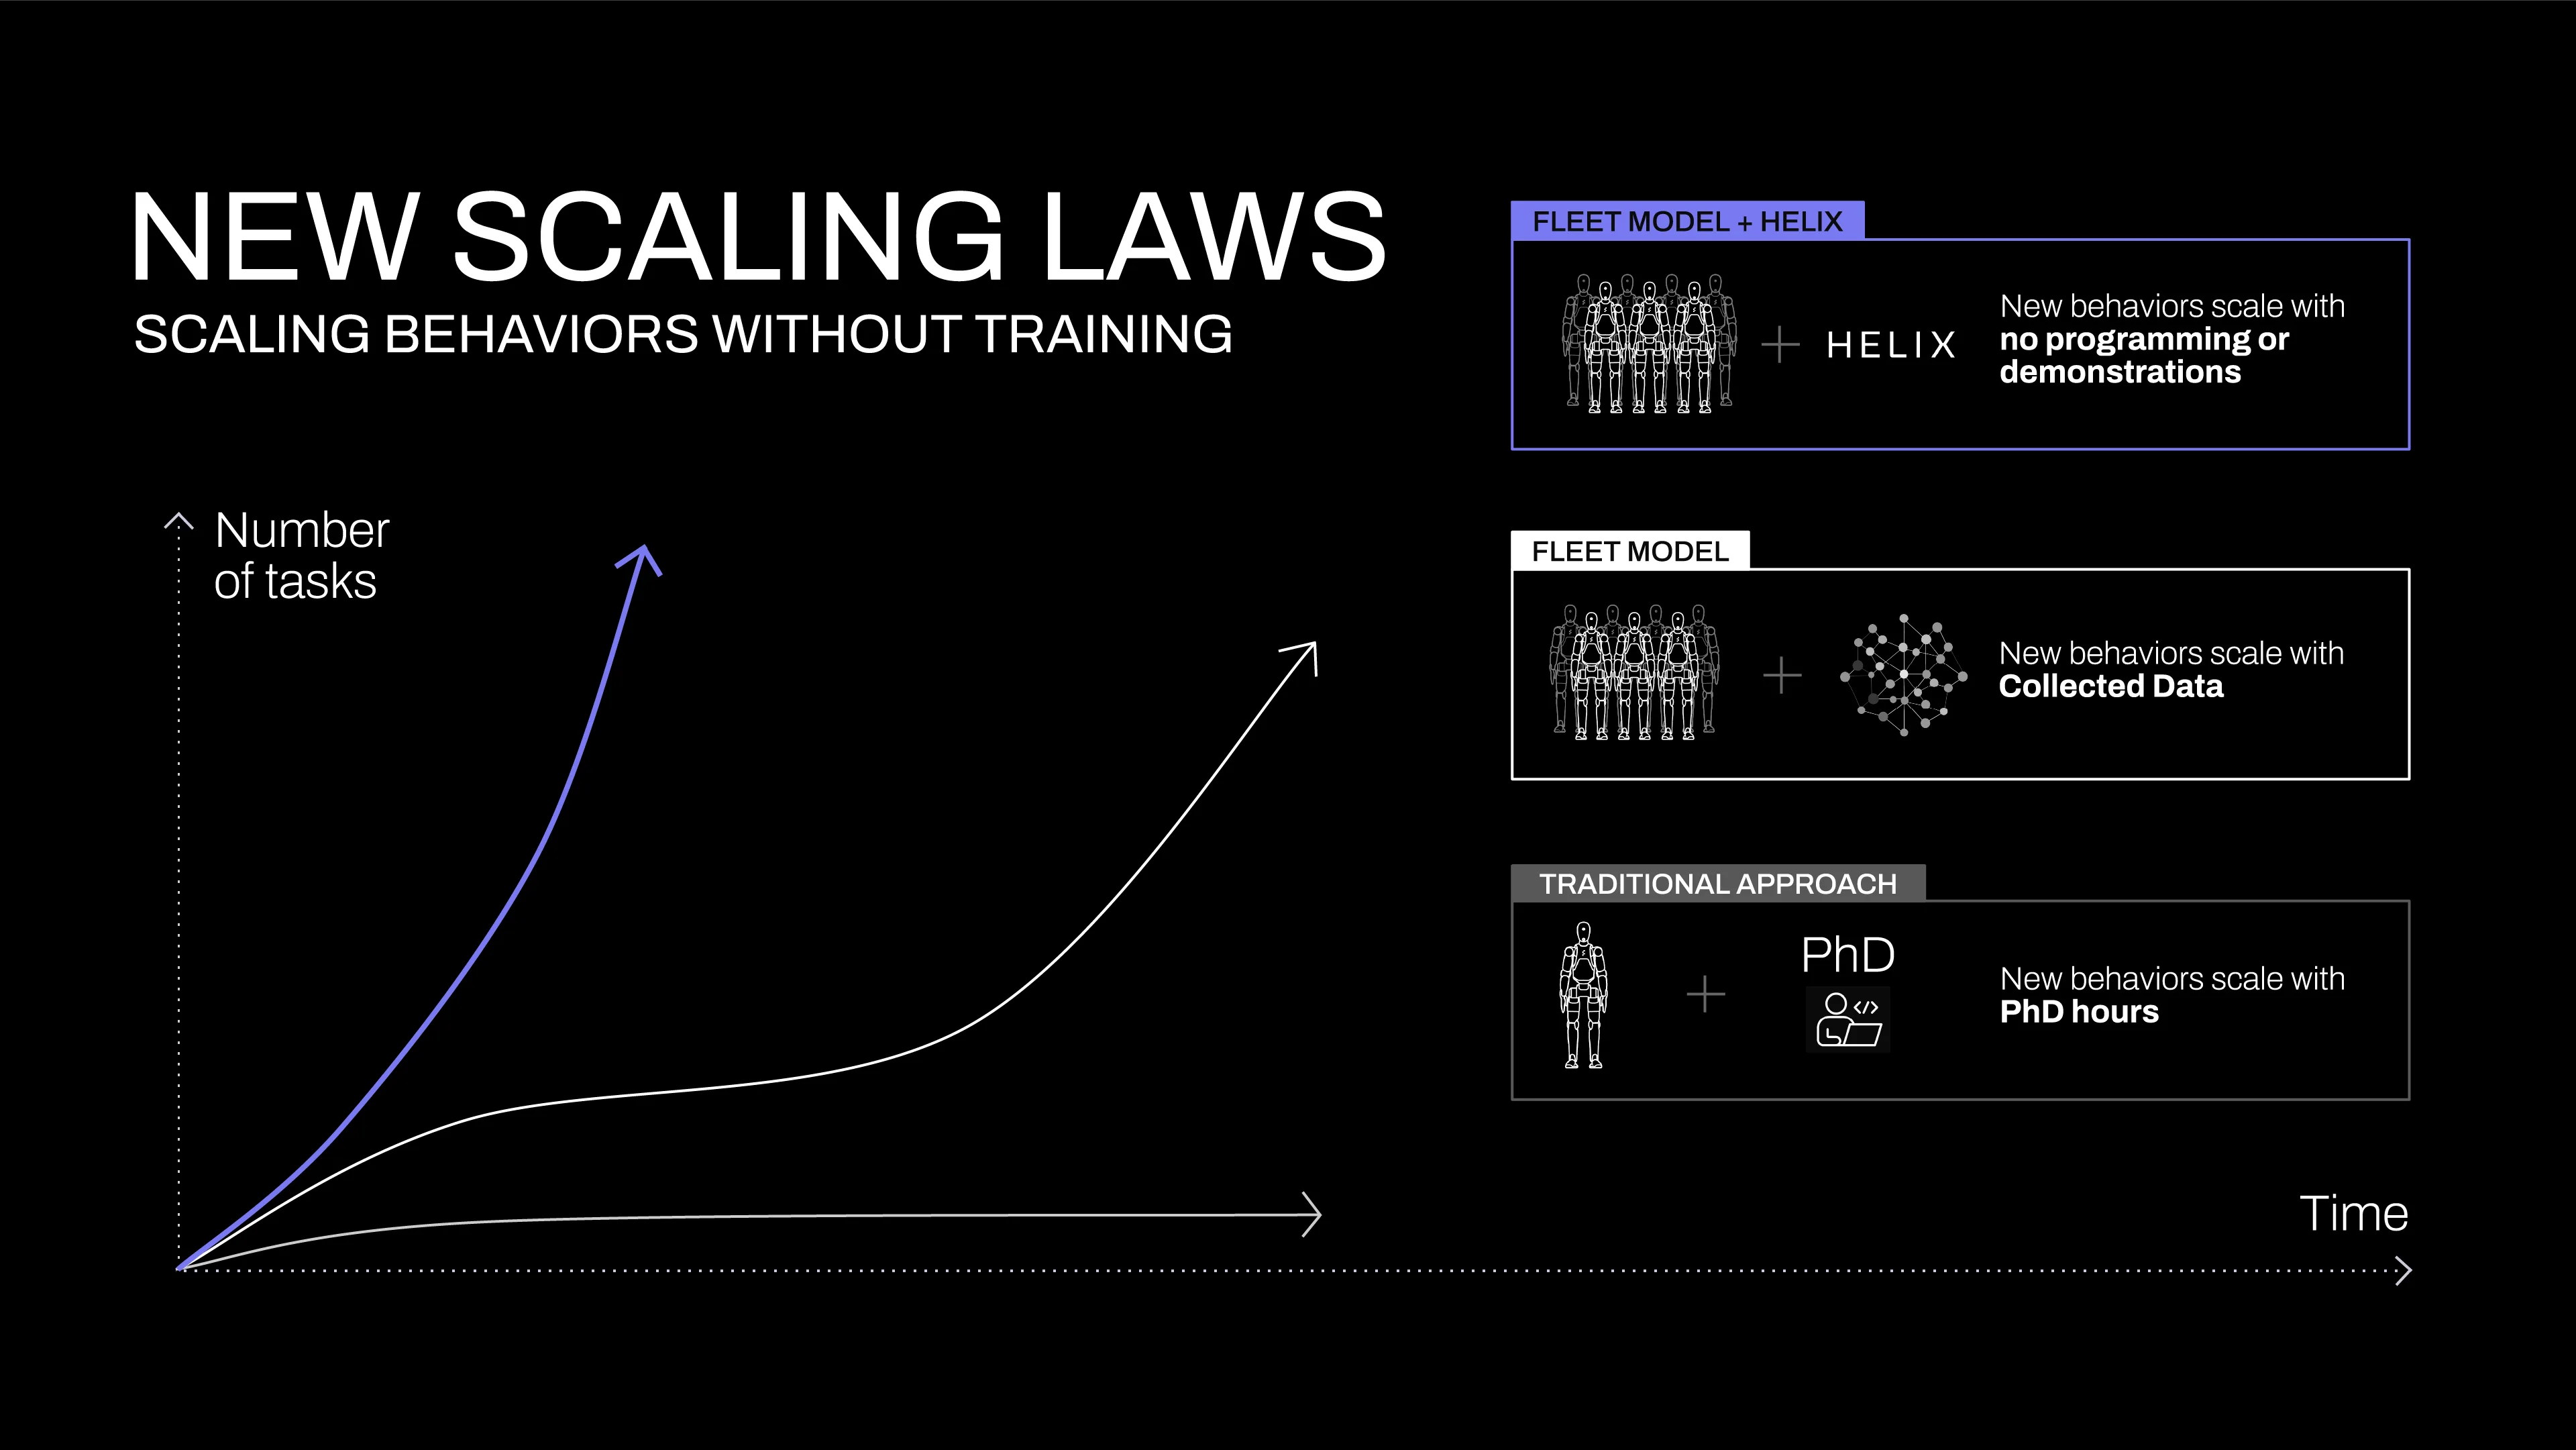
발표문이 내놓는 대안은 다른 AI 분야가 이미 확보한 즉각적 일반화를 로봇으로 옮기는 것이다. VLM이 웹 규모 데이터에서 얻은 상식을 로봇의 action으로 바로 번역할 수 있다면, 수백 건의 시연 데이터가 필요하던 새 기술을 자연어 한 문장으로 지정할 수 있다는 논리다. action은 policy가 출력하는 제어 명령이고, policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
발표문은 Helix를 다섯 가지 최초의 묶음으로 소개한다.
| 항목 | 주장 내용 |
|---|---|
| 상체 전체 제어 | 손목, 몸통, 머리, 개별 손가락을 포함한 humanoid 상체 전체에 고빈도 연속 제어를 출력한 첫 VLA |
| 다중 로봇 협업 | 두 대의 로봇에서 동시에 실행되며 처음 보는 물건으로 long-horizon manipulation 과제를 함께 푼 첫 VLA |
| 임의 물체 집기 | 자연어 지시문만으로 처음 보는 것을 포함해 거의 모든 소형 가정용품을 집는다 |
| 단일 신경망 | 물건 집고 놓기, 서랍과 냉장고 조작, 로봇 간 인계를 과제별 fine-tuning 없이 하나의 가중치 묶음으로 처리한다 |
| 상용 배치 준비 | 저전력 임베디드 GPU에서 전부 온보드로 실행되는 첫 VLA |
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 지시문(instruction)은 로봇에게 과제를 지정하는 자연어 문장이다.
핵심 개념
속도와 일반성의 상충
기존 접근이 부딪히는 근본 문제는 속도와 일반성을 한 모델이 함께 갖기 어렵다는 점이다. VLM backbone은 범용이지만 빠르지 않고, 로봇 visuomotor policy는 빠르지만 범용이 아니다. visuomotor policy는 이미지를 직접 받아 모터 명령을 내는 policy를 말한다.
Helix는 이 상충을 한 모델 안에서 풀지 않고 서로 보완하는 두 모듈로 나눠 푼다. 두 모듈은 서로 통신하도록 end-to-end로 함께 학습되며, 각자에게 맞는 시간 척도에서 실행된다.
System 1과 System 2의 분업
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. Helix는 두 모듈에 서로 다른 control frequency를 준다.
| 구분 | System 2 (S2) | System 1 (S1) |
|---|---|---|
| 역할 | 장면 이해와 언어 이해, 고수준 의도 결정 | 저수준 제어와 실시간 반응 |
| 모델 | 인터넷 규모로 pre-training된 7B 오픈웨이트 VLM | 80M 파라미터 cross-attention 인코더 디코더 Transformer |
| 동작 주기 | 7~9Hz | 200Hz |
| 입력 | 단안 카메라 이미지, 로봇 상태, 자연어 명령 | 같은 이미지와 로봇 상태, S2가 넘긴 latent 벡터 |
| 출력 | 연속값 latent 벡터 하나 | 상체 전체의 연속 제어 명령 |
S2는 고수준 목표를 두고 느리게 생각하고 S1은 실행과 조정을 빠르게 처리한다. 예를 들어 두 로봇이 협업하는 동안 S1은 상대 로봇의 움직임 변화에 빠르게 적응하면서도 S2가 정한 의미 수준의 목표는 유지한다.
latent 통신
두 모듈을 잇는 유일한 인터페이스는 연속값 latent 벡터 하나다. latent는 겉으로 드러나지 않는 모델 내부의 표현 공간을 가리킨다. S2가 과제에 필요한 의미 정보를 이 벡터 하나로 압축하면 S1이 받아 저수준 action의 조건으로 쓴다.
이 벡터는 통신 경로이면서 동시에 그래디언트가 흐르는 통로다. 따라서 두 모듈이 공통의 observation 공간이나 action 표현을 억지로 맞출 필요 없이 각각 따로 개선될 수 있다. observation은 매 timestep에 policy가 받는 센서 입력이다.
방법
데이터와 지시문 라벨링
학습 데이터는 teleoperation으로 모은 약 500시간이 전부다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. 여러 대의 로봇과 여러 조작자에게서 다양한 동작을 수집했다고 밝힌다.
자연어 조건을 붙이는 방식은 hindsight instruction이다. hindsight instruction은 이미 수집된 영상을 보고 그 동작을 시킬 만한 지시문을 되물어 사후에 붙인 자연어 라벨이다. auto-labeling VLM에 로봇 카메라 영상을 잘라 넣고 "이 영상에 보이는 동작을 얻으려면 로봇에게 어떤 지시를 내렸겠는가"를 물어 라벨을 만든다.
평가 오염을 막는 조치도 함께 밝힌다. 학습 중 다룬 물건은 평가에서 전부 제외했다.
S2 구조
S2는 인터넷 규모 데이터로 pre-training된 7B 파라미터 오픈소스 오픈웨이트 VLM 위에 세워진다. 단안 카메라 이미지와 로봇 상태를 vision-language 임베딩 공간으로 투영해 받는데, 여기서 로봇 상태는 손목 pose와 손가락 위치로 구성된다.
여기에 원하는 동작을 지정하는 자연어 명령을 결합해, 과제에 필요한 의미 정보 전부를 하나의 연속값 latent 벡터로 압축한다. 다만 발표문은 이 VLM이 어떤 모델인지 밝히지 않는다.
S1 구조
S1은 80M 파라미터 cross-attention 인코더 디코더 Transformer로 저수준 제어를 담당한다. 시각 처리는 fully convolutional 다중 스케일 backbone이 맡고, 이 backbone은 전적으로 시뮬레이션에서만 진행한 pre-training 가중치로 초기화된다.
과제 조건은 이어 붙이기로 걸린다. S2가 넘긴 latent 벡터를 S1의 토큰 공간으로 투영한 다음 S1 자신의 시각 backbone이 낸 시각 특징과 시퀀스 차원에서 이어 붙인다. S1은 S2와 같은 이미지와 상태를 받지만 더 높은 빈도로 처리해 closed-loop 반응성을 높인다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다.
출력은 상체 전체의 제어 목표다. 손목 pose 목표, 손가락 굽힘과 벌림 제어, 몸통과 머리 방향 목표가 200Hz로 나온다.
여기에 합성 차원 하나가 더 붙는다. "과제 완료 비율"이라는 차원을 action space에 추가해 Helix가 자기 종료 조건을 스스로 예측하게 했고, 그 덕분에 학습된 동작 여러 개를 이어 붙이기 쉬워졌다는 설명이다.
학습
학습은 원본 픽셀과 텍스트 명령에서 연속 action으로 가는 경로를 표준 회귀 손실 하나로 end-to-end로 진행한다. S1을 조건 짓는 latent 통신 벡터를 통해 S1에서 S2로 그래디언트가 역전파되므로 두 모듈이 함께 최적화된다.
과제별 적응 단계는 두지 않는다. 학습 단계가 하나뿐이고 가중치 묶음도 하나이며 별도의 action head나 과제별 fine-tuning 단계가 없다.
시간 오프셋 처리가 눈에 띄는 세부다. 학습 시점에 S1과 S2의 입력 사이에 간격을 넣는데, 이 값을 배포 환경에서 두 모듈의 추론 지연 차이에 맞춰 보정했다. 즉 실시간 제어 조건을 학습 분포 안에 미리 반영해 둔 것이다.
추론과 배포
배포 구성은 학습 설계와 같은 모양이다. 로봇마다 저전력 임베디드 GPU 두 장을 싣고, 고수준 latent 계획을 맡는 S2와 저수준 제어를 맡는 S1을 각각 전용 GPU에 올린다.
- S2는 비동기 백그라운드 프로세스로 실행되며 최신 observation과 자연어 명령을 소비해 공유 메모리의 latent 벡터를 계속 갱신한다. 이 벡터가 고수준 행동 의도를 담는다.
- S1은 별도의 실시간 프로세스로 200Hz 제어 루프를 유지하며 최신 observation과 가장 최근의 S2 latent 벡터를 함께 받는다.
- 두 모듈의 추론 속도 차이가 자연히 S1 쪽에 더 촘촘한 observation 해상도를 주어 반응 제어의 피드백 루프가 조밀해진다.
이 배포 방식이 학습에서 넣은 시간 오프셋을 그대로 재현하므로 학습과 추론 사이의 분포 간극이 줄어든다. 발표문은 이 비동기 실행 덕분에 Helix를 가장 빠른 단일 과제 imitation learning policy만큼 빠르게 실행할 수 있다고 말한다. imitation learning은 시연 데이터를 흉내 내 policy를 학습하는 방법이다.
설계 이점
발표문이 기존 접근 대비 이점으로 드는 항목은 네 가지다.
| 이점 | 내용 |
|---|---|
| 속도와 일반화 | 특정 과제 전용 behavioral cloning policy 수준의 속도를 내면서 처음 보는 물체 수천 개로 zero-shot 일반화한다 |
| 확장성 | 고차원 action space에 연속 제어를 직접 출력해 기존 VLA의 복잡한 action tokenization을 피한다 |
| 구조의 단순함 | S2는 오픈소스 오픈웨이트 VLM, S1은 평범한 Transformer 기반 visuomotor policy로 표준 구조만 쓴다 |
| 관심사 분리 | 공통 observation 공간이나 action 표현을 찾아야 하는 제약 없이 두 모듈을 따로 개선할 수 있다 |
behavioral cloning은 시연 데이터의 observation과 action 쌍을 지도학습으로 흉내 내는 방법이다. action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다. 발표문은 action tokenization이 이진 개폐 그리퍼 같은 저차원 제어에서는 성과를 냈지만 고차원 humanoid 제어로 확장할 때 어려움을 겪는다고 본다.
결과
정량 결과는 사실상 하나뿐이다. 35자유도(DoF) action space를 200Hz로 조율한다는 수치이며, 나머지는 영상과 정성 서술로 제시된다. 성공률과 시행 횟수, 비교 대상은 나오지 않는다.
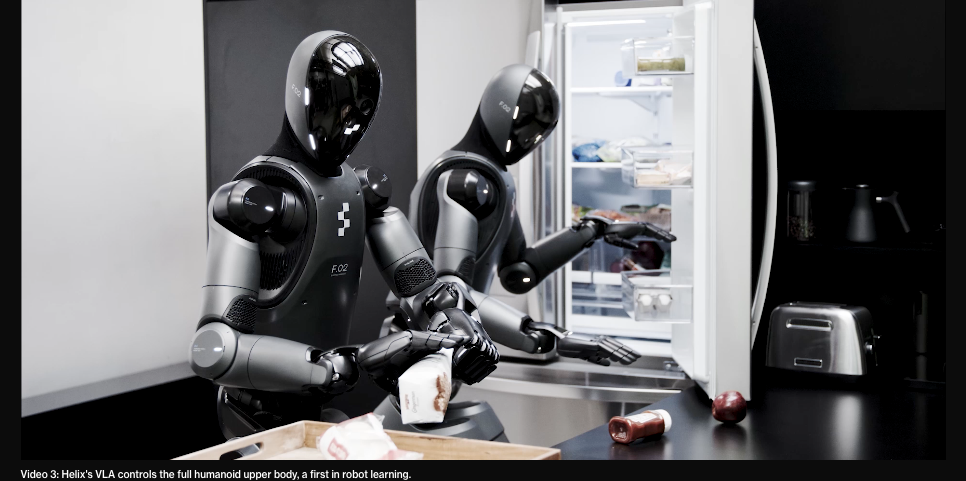
상체 전체 제어
Helix는 개별 손가락 움직임부터 end-effector의 이동 경로, 머리 시선, 몸통 자세까지 하나의 action space에서 함께 다룬다. end-effector는 로봇 팔 끝에서 물체와 접촉하는 부분이다.
머리와 몸통 제어가 특히 어려운 이유를 발표문이 짚는다. 둘이 움직이면 로봇이 닿을 수 있는 범위와 볼 수 있는 범위가 동시에 바뀌어 피드백 루프가 생기고 이것이 역사적으로 불안정성의 원인이었다는 설명이다.
시연에서는 이 조율이 동시에 일어난다. 로봇이 머리로 자기 손을 부드럽게 따라보면서 팔이 잘 닿도록 몸통 자세를 조정하고 그러는 동안 grasping에 필요한 정밀한 손가락 제어를 유지한다. grasping은 물체를 안정적으로 쥐는 동작이다. 발표문은 이만한 실시간 조율을 과제와 물체를 넘나드는 일반화 능력과 함께 보인 VLA가 이전에 없었다고 주장한다.
다중 로봇 협업
다중 로봇 협업은 Figure 로봇 두 대가 처음 보는 식료품을 함께 정리하는 zero-shot 시나리오다. 발표문은 여기서 두 가지가 동시에 성립한다고 밝힌다. 하나는 학습 중 만난 적 없는 식료품을 다루면서도 모양과 크기와 재질이 달라지는 상황에서 일반화가 유지된다는 것이고, 다른 하나는 두 로봇이 동일한 Helix 가중치로 실행되어 로봇별 학습이나 명시적 역할 지정이 필요 없다는 것이다.
협조는 자연어 지시문으로 이뤄진다. "쿠키 봉지를 오른쪽 로봇에게 건네라"나 "왼쪽 로봇에게서 쿠키 봉지를 받아 열린 서랍에 넣어라" 같은 문장이 그대로 조율 수단이 된다.
임의 물체 집기
발표문은 "pick up anything"을 emergent capability로 보고한다. emergent capability는 학습 데이터에 없던 조합을 모델이 실행해내는 성질을 말한다. "Pick up the [X]" 한 문장으로 유리 제품과 장난감과 공구와 의류를 포함해 어질러진 환경의 새 물건 수천 개를 다뤘고, 사전 시연 데이터나 별도 프로그래밍은 쓰지 않았다고 한다.
대표 사례가 장난감 선인장이다. "사막에 있는 물건을 집어라"라는 지시문을 받으면 Helix가 장난감 선인장이 그 추상적 개념에 맞는다는 것을 알아보고, 더 가까운 쪽 손을 고른 뒤 안정적으로 쥐는 데 필요한 정밀한 모터 명령까지 낸다. 웹 규모 언어 이해와 정밀한 로봇 제어 사이의 간극을 이 사례가 보여준다는 설명이다.
학습 효율과 단일 가중치
발표문이 강조하는 또 하나는 데이터 효율이다. 약 500시간의 지도 데이터는 기존에 수집된 VLA 데이터셋의 5% 미만이며, 여러 embodiment에 걸친 수집이나 여러 단계의 학습에 의존하지 않는다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다.
이 규모는 현대의 단일 과제 imitation learning 데이터셋에 가깝다. 그런데도 상체 전체 제어라는 훨씬 어려운 action space를 고빈도 고차원 출력으로 다룬다는 것이 발표문의 주장이다.
가중치 하나로 처리하는 과제 범위도 함께 제시한다. 7B의 S2와 80M의 S1로 이뤄진 한 묶음이 여러 용기에 물건을 집어넣고 서랍과 냉장고를 조작하며 로봇 간 인계를 조율하고 처음 보는 물체 수천 개를 다룬다.
한계
발표문이 스스로 밝히는 한계는 짧다. 초기 결과이고 가능한 것의 표면만 확인했다는 것, 그리고 Helix를 1,000배 이상으로 키웠을 때 무슨 일이 벌어질지 궁금하다는 것 정도다.
자료로서의 빈틈이 더 크다. 검증에 필요한 정보가 여러 항목에서 비어 있다.
| 비어 있는 정보 | 영향 |
|---|---|
| 성공률, 시행 횟수, 비교 대상 | "처음 보는 물건 수천 개"의 신뢰도를 가늠할 수 없다 |
| S2로 쓴 7B 오픈웨이트 VLM의 이름 | 성능의 어느 부분이 backbone에서 왔는지 분리할 수 없다 |
| S1 시각 backbone의 시뮬레이션 pre-training 세부 | sim2real 조건을 재현할 수 없다 |
| 저전력 임베디드 GPU의 사양 | 온보드 실행 주장을 검증할 수 없다 |
| 약 500시간 데이터의 과제 구성 | 일반화 범위가 데이터 구성에서 왔는지 판단할 수 없다 |
| "기존 VLA 데이터셋의 5% 미만"에서 비교 대상 데이터셋의 정체 | 5%라는 비율의 기준을 알 수 없다 |
sim2real은 시뮬레이션에서 학습한 policy를 실제 기기로 옮기는 문제다.
인용도 없다. 이름을 대는 선행 연구가 하나도 없고 "prior VLA approaches"나 "conventional robot imitation learning" 같은 범주 표현으로만 지칭한다. 따라서 비교 위치를 잡으려면 wiki 안의 다른 페이지를 참고해야 한다.
배치 실적 수치는 이후의 다른 자료에서 나온다. Chef Robotics의 bimanual manipulation 서베이가 BMW 라인의 Figure 02와 Helix 배치를 1,250시간 이상, 부품 9만 개, 차량 3만 대로 기록하며 가장 VLA에 가까운 산업 배치로 분류한다. 반면 같은 서베이는 배치 규모가 가장 큰 시스템일수록 VLA 성격이 옅어진다는 반비례 관계도 함께 지적한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| System 1 / System 2 | Kahneman의 이중 과정 은유를 그대로 쓴 모듈 이름. S2는 느리게 생각하는 의미 추론을, S1은 빠르게 반응하는 visuomotor policy를 맡는다 |
| hindsight instruction | 이미 수집된 영상을 보고 그 동작을 시킬 만한 지시문을 되물어 사후에 붙인 자연어 라벨. auto-labeling VLM이 생성한다 |
| percentage task completion | S1의 action 벡터에 덧붙인 합성 차원. 과제 진행 비율을 출력해 Helix가 스스로 종료 시점을 판단하게 한다 |
| latent 통신 | S2가 압축한 연속값 벡터 하나를 공유 메모리에 두고 S1이 읽어 가는 방식. 두 모듈 사이의 유일한 인터페이스이자 그래디언트가 흐르는 통로다 |
| control frequency | 초당 action 갱신 횟수. Helix는 S2가 7~9Hz, S1이 200Hz다 |
| dual-system VLA | 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 실행하는 VLA 구조. Helix가 그 대표 사례다 |
관련 페이지
- Helix: Figure AI가 공개한 범용 휴머노이드 제어를 위한 시각-언어-행동(VLA) 모델: 같은 발표의 한국어 소개. 원문 페이지에서 iframe 안에 있어 수집되지 않은 System 1과 System 2 구조도가 그 페이지에 실려 있다.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: Helix를 오픈소스로 재현하려는 dual-system VLA 서베이 겸 모델. System 1이 실시간 perception 입력을 직접 받는지를 판정 기준으로 삼아, S1이 이미지를 직접 받는 Helix는 이 기준을 통과하고 π0와 GR00T N1은 제외된다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 한 달 뒤 공개된 NVIDIA의 dual-system VLA. Eagle-2 VLM 10Hz에 flow matching 기반 DiT 120Hz로 같은 분업을 논문과 오픈 가중치로 냈다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: Helix가 피했다고 말하는 action tokenization 계열의 원형.
- OpenVLA: An Open-Source Vision-Language-Action Model: 같은 action tokenization 계열의 오픈소스 구현.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 연속 action 출력이라는 같은 선택을 flow matching으로 푼 모델.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: Figure 02와 Helix의 BMW 배치 실적을 기록한 서베이.
- Vision Language Action Models (VLA) & Policies for Robots: 이 발표문을 인용한 영어 튜토리얼. 초기 Figure 로봇의 GPT-4o 구동과 OpenAI 협업 종료라는 배경을 덧붙인다.
- 용어집: Physical AI (Terminology Glossary): 이 페이지의 전문 용어 canonical 표기.