Physical AI · REPO · 2026
EVA-Client: A Unified Framework for Deployment, Evaluation, and Data Collection on Real Robots
요약
EVA-Client는 실제 로봇 한 대를 놓고 policy 배포와 평가와 데이터 수집을 하나의 브라우저 콘솔에서 처리하는 오픈소스 스택이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 라이선스는 Apache-2.0이고 2026년 7월 3일에 공개됐으며, 기술 리포트는 arXiv 2607.02646으로 나와 있다.
핵심 설계는 파이썬 설정 파일 하나가 통신 계층과 모델 서버와 추론 방식을 모두 지정한다는 점이다. 명령 한 번이면 observation에서 제어까지 이어지는 closed-loop이 올라온다. closed-loop은 로봇의 현재 상태를 다시 입력으로 받아 다음 명령을 만드는 제어 구조를 뜻한다.
저장소가 내세우는 문구는 "One policy, any robot"이다. 하나의 policy를 여러 embodiment에 그대로 올리고, 디버깅과 기록과 평가와 시각화를 전부 브라우저에서 수행한다는 뜻이다. 2026년 9월 기준 여덟 종 로봇, 네 종 transport, 여섯 종 policy backend를 지원한다.
배경
VLA 계열 policy를 실제 로봇에서 돌려 보려면 서로 다른 세 가지 작업을 각각 다른 도구로 처리해야 했다. 시연 데이터(demonstration)를 모으는 수집 도구, 체크포인트를 서빙하는 추론 서버, 성공률을 재는 평가 스크립트가 별개로 존재했고, 로봇 하드웨어마다 통신 방식과 action space가 달라 매번 배선을 다시 만들어야 했다.
세 작업이 갈라져 있으면 기록 형식도 갈라진다. teleoperation으로 모은 데이터와 모델이 만든 rollout 기록이 다른 형식으로 쌓이면, 학습에 쓴 데이터와 평가 결과를 같은 도구로 비교할 수 없다. teleoperation은 사람이 조작 장치로 로봇을 직접 움직이는 방식을 말한다.
EVA-Client는 이 셋을 한 프로세스와 한 저장 형식으로 합치는 것을 목표로 삼는다. 수집과 rollout이 같은 on-disk 레이아웃을 공유하고, 로봇 교체와 policy backend 교체와 추론 전략 교체가 모두 설정 파일의 값 변경으로 끝난다.
핵심 개념
transport
transport는 observation과 제어 명령이 오가는 통신 계층이다. 로봇 쪽 소프트웨어가 무엇으로 만들어졌는지에 따라 달라지며, EVA-Client는 네 가지를 지원한다.
ROS 1과 ROS 2는 로봇 소프트웨어의 표준 미들웨어이고, ZeroMQ는 그보다 가벼운 메시지 소켓 라이브러리다. 네 번째인 오프라인 데이터셋은 실제 로봇 대신 이미 기록된 LeRobot v2.x 데이터를 흘려보내는 경로다. 하드웨어가 없는 상태에서도 파이프라인 전체를 점검할 수 있다.
policy backend
policy backend는 observation을 받아 action을 돌려주는 모델 서버다. EVA-Client는 모델을 직접 품지 않고 외부 서버에 요청을 보내는 구조를 택했다. 그래서 GPU가 달린 장비와 로봇이 물리적으로 떨어져 있어도 SSH 포트 포워딩으로 연결할 수 있다.
추론 전략
추론 전략은 policy가 한 번에 내놓은 action chunk를 실제 제어 주기에 맞춰 내보내는 방식을 정한다. action chunk는 policy가 한 번의 추론으로 예측하는 여러 timestep 분량의 action 묶음이다.
모델 추론에는 시간이 걸리므로, 추론이 끝날 때까지 로봇을 세워 두면 동작이 끊긴다. 반대로 예측해 둔 chunk를 끝까지 실행한 뒤 다음 추론 결과로 전환하면 경계에서 동작이 튄다. 추론 전략은 이 두 문제를 다루는 방법이다.
action space
action space는 로봇이 낼 수 있는 action의 집합이다. EVA-Client는 두 가지 표현을 지원한다.
| action space | 지정 대상 | 관절 값 계산 |
|---|---|---|
| joint-space | 각 관절의 각도를 직접 지정 | 계산 없음 |
| EEF-space | end-effector의 위치와 자세를 지정 | PyRoki 역기구학으로 관절 값을 푼다 |
end-effector는 팔 끝에 달린 그리퍼나 도구를 뜻한다. 두 표현의 전환은 실행 중에 DEBUG 탭에서 이뤄진다.
episode와 rollout
episode는 시작부터 종료까지 이어지는 한 번의 시도 기록이다. 사람이 teleoperation으로 만든 episode가 시연 데이터가 되고, 모델이 스스로 수행한 episode가 rollout이 된다. EVA-Client는 둘을 같은 형식으로 저장한다.
방법
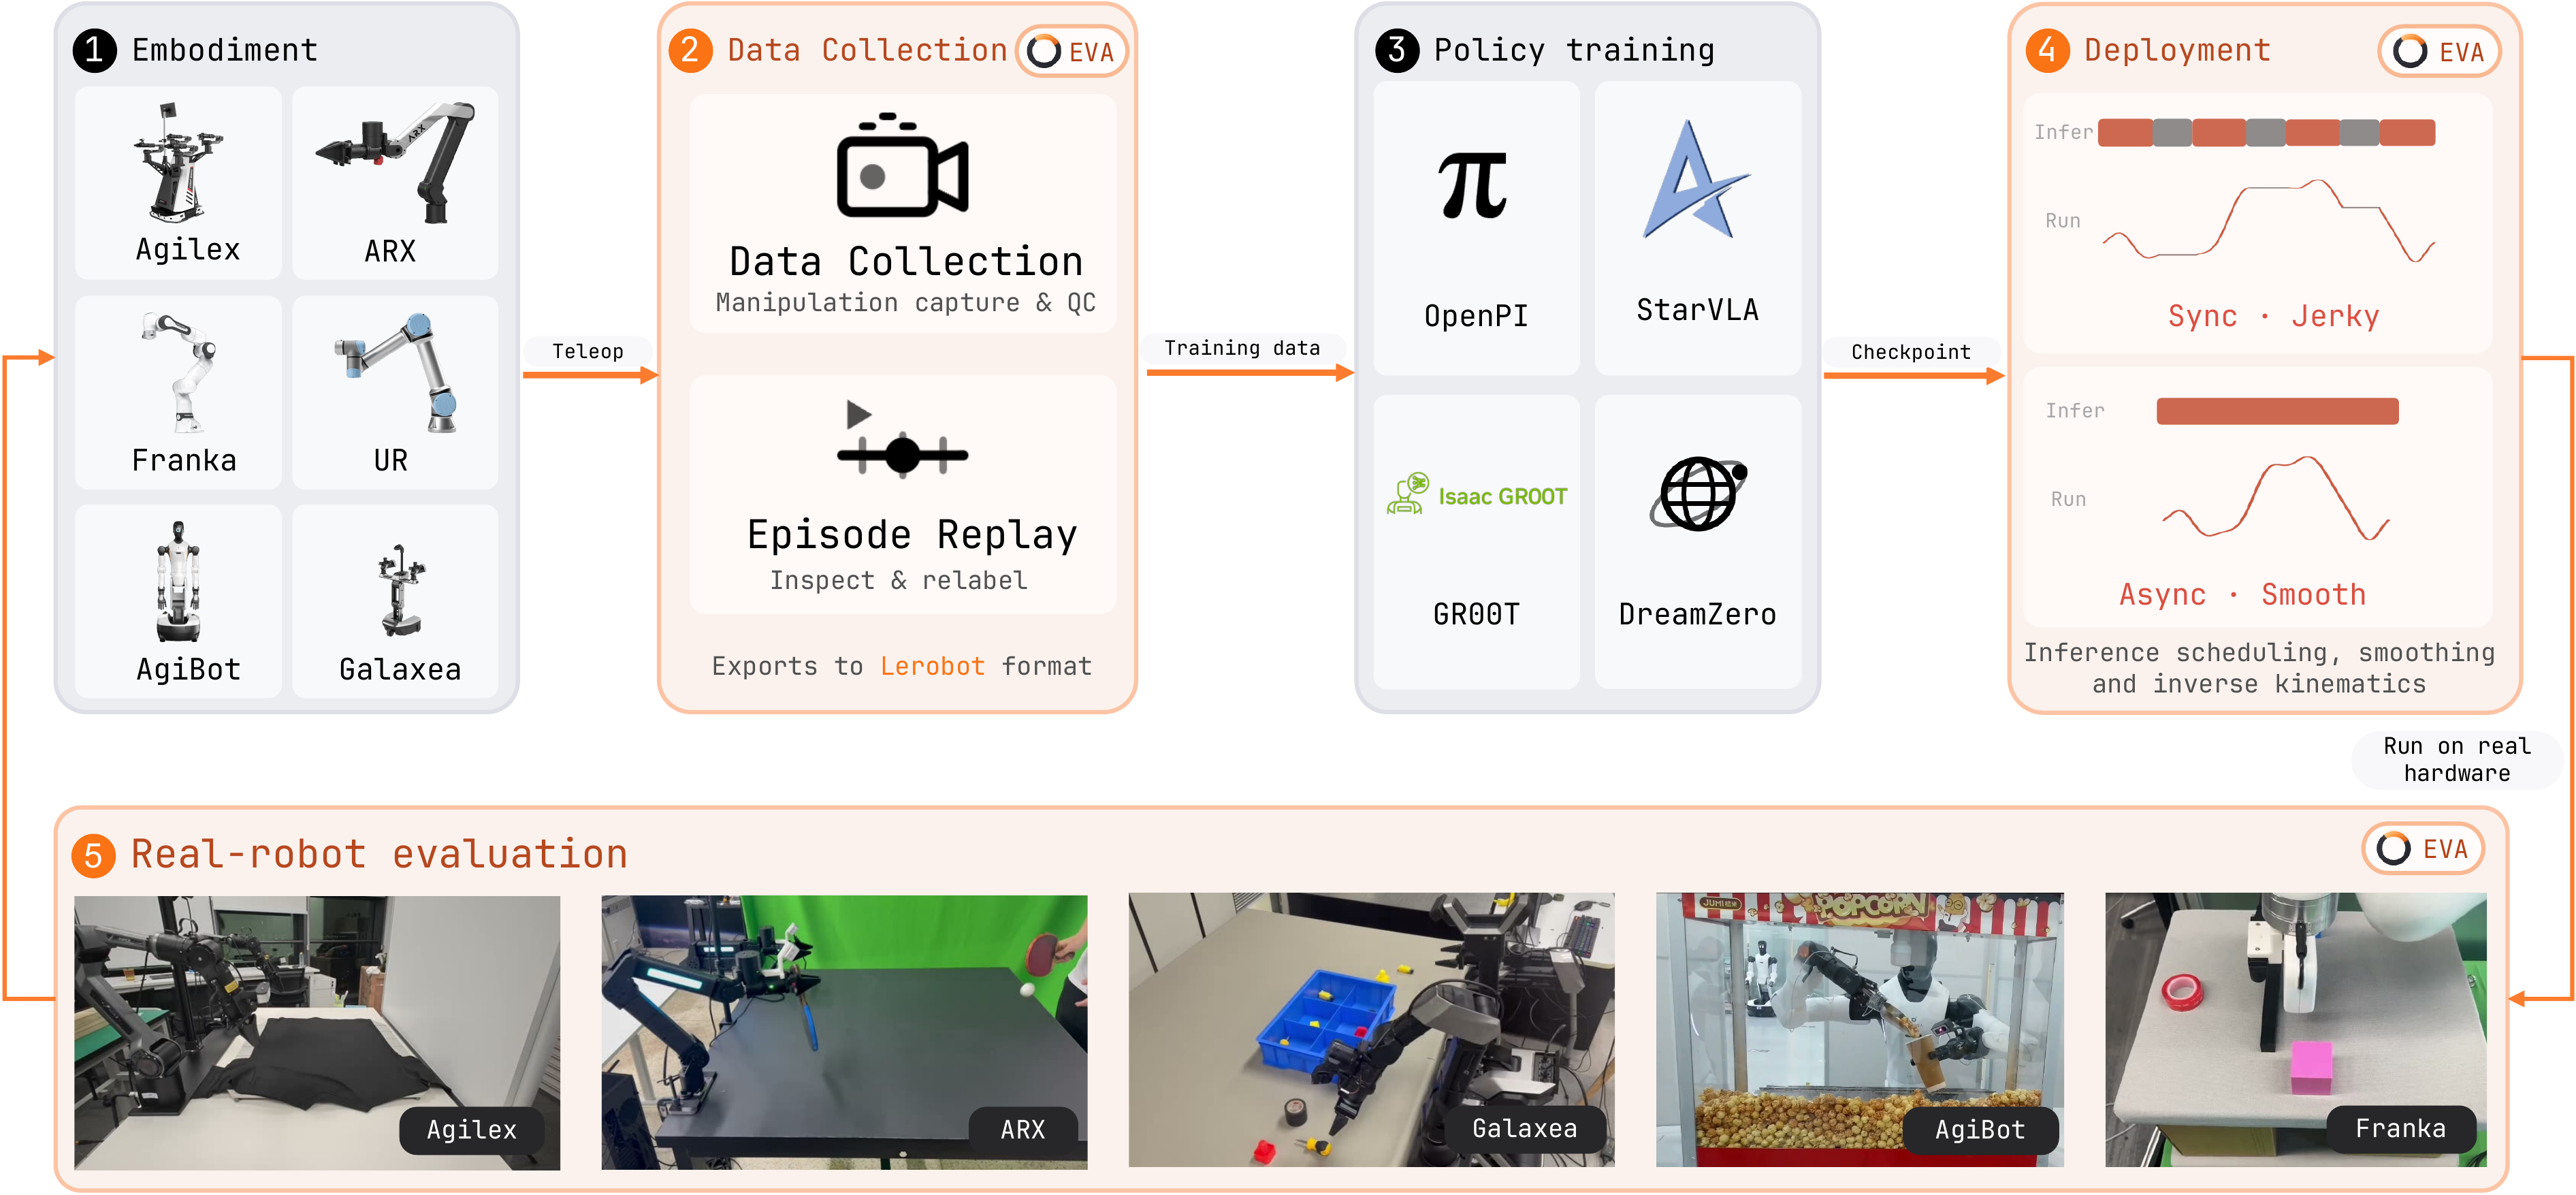
도식의 다섯 단계 중 EVA-Client가 직접 담당하는 것은 데이터 수집과 배포와 실제 로봇 평가 세 곳이다. policy 학습 단계는 외부 프레임워크에 맡기고, 학습이 끝난 체크포인트를 받아 배포로 잇는다. 배포 단계의 두 그래프는 sync가 추론 구간마다 정지를 만드는 반면 async는 추론과 실행을 겹쳐 연속적인 동작을 만든다는 차이를 나타낸다.
도식의 policy 학습 칸에는 OpenPI, StarVLA, GR00T와 함께 DreamZero가 적혀 있다. DreamZero는 README의 policy backend 표에는 없다. 학습 단계에서 쓰는 프레임워크와 배포 시 붙이는 서빙 backend의 목록이 서로 다르다는 뜻으로 읽는다.
배포 파이프라인
배포 경로는 네 단계를 직렬로 잇는다.
.py 설정 파일 → transport → policy backend → 추론 전략 → 로봇
설정 파일 하나에 네 단계의 선택이 모두 들어가므로, 로봇을 바꾸거나 모델을 바꾸는 작업이 코드 수정이 아니라 값 변경이 된다. 지연 보정은 실행 중 실시간으로 적용된다.
transport 계층
| transport | 프로토콜 | 용도 |
|---|---|---|
| ROS 1 | ROS 1 스택 | 기존 ROS 1 기반 로봇 |
| ROS 2 | ROS 2 스택 | 기존 ROS 2 기반 로봇 |
| ZeroMQ | ZeroMQ 실행 노드 | 경량 소켓 통신 |
| 오프라인 데이터셋 | LeRobot v2.x 재생 | 하드웨어 없이 루프 점검 |
policy backend 여섯 종
| policy backend | 프로토콜과 직렬화 | 비고 |
|---|---|---|
| OpenPI | WebSocket과 msgpack | 상태를 유지하지 않는 stateless 호출 |
| OpenPI-RTC | WebSocket과 msgpack | real-time action chunking 계열 |
| StarVLA | WebSocket과 msgpack | 타입이 정해진 envelope 형식 |
| GR00T | ZeroMQ REQ/REP와 msgpack-numpy | Isaac-GR00T 서버 |
| Mock | 로컬 실행 | 부드럽게 변하는 무작위 action 생성 |
| Replay | 로컬 실행 | 기록된 trajectory 재생 |
여섯 종 중 실제 모델을 부르는 것은 앞의 네 가지다. Mock과 Replay는 모델 없이 배선만 검증하는 용도다. 실제 체크포인트를 붙이기 전에 transport와 로봇 제어가 제대로 연결됐는지 확인할 수 있고, 하드웨어 문제와 모델 문제를 분리해 진단할 수 있다.
직렬화 방식이 네 backend 모두 msgpack 계열이라는 점이 중요하다. WebSocket이나 ZeroMQ 위에 msgpack을 얹지 않는 서빙 방식을 쓰는 policy는 별도 어댑터를 만들어야 붙는다.
추론 전략 다섯 종
| 추론 전략 | 동작 방식 |
|---|---|
| sync | 추론이 끝날 때까지 기다린 뒤 실행한다 |
| async | 이전 chunk를 실행하는 동안 다음 추론을 겹쳐 수행해 정지 구간을 없앤다 |
| naive | README가 이름만 제시하고 동작을 설명하지 않았다 |
| ACT-ensemble | 겹치는 시점의 여러 action 예측을 평균하는 temporal ensembling 계열이다 |
| RTC | real-time action chunking으로 chunk 경계의 불연속을 줄인다 |
sync는 구현이 단순한 대신 추론 시간만큼 로봇이 멈춘다. async는 그 정지 구간을 없애지만 실행 중인 chunk와 새로 도착한 chunk가 어긋날 수 있다. ACT-ensemble과 RTC는 그 어긋남을 다루는 두 가지 방법이다. ACT-ensemble은 여러 예측을 평균해 부드럽게 만들고, RTC는 chunk를 만들 때부터 이전 chunk의 남은 부분을 고려한다.
다섯 전략은 실행 중 DEBUG 탭에서 바꿀 수 있다. 같은 체크포인트를 같은 로봇에서 전략만 바꿔 비교하는 실험이 가능하다는 뜻이다.
브라우저 콘솔의 일곱 개 탭
| 탭 | 역할 |
|---|---|
| MANUAL | 로봇을 직접 조작한다 |
| COLLECT | teleoperation 시연 데이터를 기록한다 |
| REPLAY | 기록한 episode를 재생한다 |
| DEBUG | 로봇, action space, 추론 전략을 실행 중에 바꾼다 |
| RL | rollout 중 사람이 개입하고 value 곡선을 본다 |
| EVAL | 여러 체크포인트를 한 번에 평가한다 |
| RESULT | 평가 기록을 동기화 재생으로 열람한다 |
일곱 개 탭이 한 브라우저 화면에 들어 있으므로, 데이터를 모으고 학습한 policy를 배포하고 평가하는 과정에서 도구를 바꿀 일이 없다.
데이터 수집
COLLECT 탭은 teleoperation 조작을 그대로 LeRobot v2.1 episode로 기록한다. 구성 요소는 네 가지다.
| 구성 요소 | 역할 |
|---|---|
| 백그라운드 저장기 | 기록 중 저장 작업을 분리해 조작 지연을 막는다 |
| 탭 내부 품질 검사 재생 | 방금 모은 episode를 그 자리에서 재생하고 PASS와 FAIL을 판정한다 |
| 카메라 스트림 인코딩 | 카메라 영상을 mp4로 인코딩해 저장한다 |
| 프레임 단위 품질 플래그 | 프레임마다 녹색과 적색으로 품질을 표시한다 |
품질 판정을 수집 직후 같은 탭에서 처리하는 구성이 특징이다. 실패한 episode를 나중에 골라내지 않고 그 자리에서 걸러내므로, 데이터셋에 쓸모없는 기록이 쌓이지 않는다.
0.2.0에서 입력 장치가 늘었다. WebXR 기반 VR 컨트롤러로 조작할 수 있고, 듀얼 YAM 구성에서는 사람이 leader 팔을 움직이면 follower 팔이 따라오는 leader-follower 방식으로 모은다. leader-follower는 조작자가 실제 팔 모형을 손으로 움직여 원격 팔을 제어하는 방식으로, 컨트롤러 조작보다 사람의 손동작을 그대로 옮기기 쉽다.
내보내기 형식도 넓어졌다. 기준 형식은 LeRobot v2.1이고 LeRobot v3.0과 MCAP과 HDF5로 내보낼 수 있다.
평가
평가는 여러 체크포인트를 한 번에 쓸어 보는 sweep 형태로 진행된다. rollout 하나마다 네 가지 기록이 dataset metadata에 저장된다.
- 카메라 영상
- URDF 기반 3D 장면
- 차원별 상태 그래프
- 지시문(instruction)마다 매긴 마일스톤 점수
마일스톤 점수는 과제를 성공과 실패의 두 값으로만 재지 않고 중간 달성 단계를 나눠 매기는 방식이다. 서랍을 열고 물건을 넣고 닫는 과제라면 각 단계를 따로 채점한다.
저장된 기록은 RESULT 탭에서 동기화된 상태로 다시 재생된다. 영상과 3D 장면과 상태 그래프가 같은 시각 축에서 함께 움직이므로, 실패한 순간에 어떤 관절이 어떻게 움직였는지 한 화면에서 확인할 수 있다.
두 가지 실험 편의 기능이 기본으로 들어 있다. 지시문 순서를 섞는 prompt shuffling은 순서 효과를 배제하기 위한 것이고, SSH 포트 포워딩을 통한 원격 policy 서버 연결은 GPU 장비와 로봇이 떨어져 있는 환경을 전제한 것이다.
강화학습과 사람의 개입
RL 탭은 policy rollout 도중 사람이 조작을 넘겨받는 human-in-the-loop 방식을 지원한다. 사람이 개입한 구간이 기록으로 남고, value 곡선이 실시간으로 그려진다. value function은 현재 상태에서 앞으로 받을 reward의 기댓값을 추정하는 함수다.
개입 데이터를 다시 학습에 쓰는 경로는 로드맵에서 완료 항목으로 표시돼 있다. 개입을 선호와 교정 데이터로 기록하고, DAgger 방식 재라벨링과 reward 모델 신호를 LeRobot episode 형식으로 되돌려 온라인 강화학습 fine-tuning에 쓴다는 구상이다.
브라우저 없이 구동하기
2026년 7월 18일 릴리스에서 headless CLI가 추가됐다. 파이썬 설정 파일 하나로 배포와 평가와 강화학습과 수집 루프를 브라우저 없이 실행할 수 있다.
같은 릴리스에서 ZMQ 제어 채널이 들어왔다. 콘솔의 모든 버튼이 ZMQ 소켓 명령으로 대응되며, human-in-the-loop 개입 명령도 소켓으로 전달된다. 자동화 스크립트나 외부 실험 관리 도구가 EVA-Client를 제어하는 경로다.
설정 시스템
설정은 MMEngine에서 가져온 방식을 저장소 안에 포함해 쓴다. _base_ 상속과 깊은 병합을 지원하므로, 공통 설정을 상위 파일에 두고 로봇별 차이만 하위 파일에서 덮어쓰는 구성이 가능하다. 여덟 종 로봇을 지원하면서 설정 파일이 중복으로 불어나지 않게 하는 장치다.
coding agent 연동
0.2.0은 coding agent용 스킬을 함께 제공한다. 로봇 추가, 카메라 캘리브레이션, 로봇 SDK 디버깅 세 가지 작업을 돕는 스킬이다.
여기에 더해 EVA-MHS라는 프리뷰 기능이 dev/mcp_preview 브랜치에 올라와 있다. Anthropic의 Model Hardware Standard 연구 프리뷰에서 착안한 것으로, agent와 하드웨어 사이 인터페이스를 로봇 영역에서 시험한다. MCP 서비스를 통해 coding agent가 런타임 상태를 조회하고 policy 모델을 호출하고 로봇을 직접 제어할 수 있다.
결과
README는 정확도 수치나 벤치마크 표를 싣지 않는다. 도구 저장소이므로 성과는 지원 범위로 제시된다.
지원 로봇
| 로봇 | 형태 | 상태 |
|---|---|---|
| AgileX Piper | 6자유도 양팔과 그리퍼 | 지원 |
| ARX R5 | 6자유도 양팔과 그리퍼 | 지원 |
| ARX X5 | 6자유도 양팔과 그리퍼 | 지원 |
| Dual Franka Panda | 7자유도 양팔과 그리퍼 | 지원 |
| Galaxea R1 Lite | 몸통에 붙은 6자유도 양팔 | 지원 |
| Universal Robots UR5e | 6자유도 단일 팔과 그리퍼 | 지원 |
| AgiBot G2 | 24자유도 양팔 humanoid | 지원 |
| YAM | 양팔 follower와 leader | 지원 |
| AgiBot G2 (이동 베이스) | 이동 섀시 위의 humanoid | 개발 중 |
| Tianji | 양팔 manipulator | 개발 중 |
| Unitree H1 / G1 | humanoid | 개발 중 |
| Fourier GR-1 | humanoid | 추가 예정 |
| Booster T1 | humanoid | 추가 예정 |
| Mobile ALOHA | 이동형 양팔 | 추가 예정 |
지원이 확정된 것은 여덟 종이고 개발 중이 세 종, 추가 예정이 세 종이다. 확정 목록은 양팔 manipulation 플랫폼에 몰려 있으며 humanoid는 AgiBot G2 한 종만 들어 있다. 이동 플랫폼은 아직 확정 목록에 없다.
계량 요약
| 항목 | 수 |
|---|---|
| 지원 로봇 | 8종 |
| transport | 4종 |
| policy backend | 6종 |
| 추론 전략 | 5종 |
| 콘솔 탭 | 7개 |
| 문서 가이드 | 7편 |
문서 구성
| 가이드 | 내용 |
|---|---|
| Installation | 요구 사항, uv 설정, 하드웨어 부가 패키지, 설치 확인 |
| Quick start | 두 프로세스 기동, 지원 transport, 배포와 평가와 재생 프리셋 |
| Web console | 일곱 개 탭 설명 |
| Core concepts | transport, policy backend, 추론 전략, 로봇, action space |
| Configuration | _base_ 상속, 깊은 병합, 기동 파이프라인 |
| Recording | LeRobot v2.1 on-disk 레이아웃, 품질 플래그, 평가 시도 |
| Development | 테스트, lint, 타입 검사, 로봇 쪽을 가짜로 대체하는 방법 |
Development 문서가 로봇 쪽을 가짜로 대체하는 방법을 별도로 다룬다는 점은 Mock과 Replay backend의 설계 의도와 이어진다. 하드웨어 없이 개발과 테스트를 진행할 수 있게 만든 것이다.
릴리스 연혁
| 날짜 | 내용 |
|---|---|
| 2026-07-03 | 오픈소스 공개. 기술 리포트와 문서와 프로젝트 페이지 동시 공개 |
| 2026-07-18 | headless CLI와 ZMQ 제어 채널 |
| 2026-07-22 | RL 워크스페이스. human-in-the-loop 개입과 실시간 value 곡선 |
| 2026-08-28 | 0.2.0. VR 컨트롤러 teleoperation, ARX X5, 듀얼 YAM 수집, 내보내기 형식 확대, coding agent용 스킬 |
| 2026-08-28 | EVA-MHS 프리뷰 (dev/mcp_preview 브랜치) |
공개에서 0.2.0까지 두 달이 채 걸리지 않았다. 그동안 브라우저 없는 구동 경로, 강화학습 워크스페이스, agent 연동이 차례로 들어왔다.
한계
- embodiment 범위가 양팔 manipulation에 치우쳐 있다. 지원이 확정된 여덟 종 중 일곱 종이 양팔이나 단일 팔 manipulator다. humanoid와 이동 플랫폼과 사족 로봇은 개발 중이거나 추가 예정 상태다. locomotion이 필요한 과제에는 아직 적용하기 어렵다.
- policy backend가 특정 서빙 방식을 전제한다. 실제 모델을 부르는 네 backend가 모두 WebSocket이나 ZeroMQ 위의 msgpack 직렬화를 쓴다. 다른 방식으로 서빙되는 policy는 어댑터를 새로 만들어야 한다.
- MCP 인터페이스가 정식 릴리스가 아니다. EVA-MHS는
dev/mcp_preview브랜치에만 있고, 향후 업데이트에서 정식 공개한다고만 밝혔다. - 데이터셋 형식이 LeRobot에 묶여 있다. 기준 형식이 LeRobot v2.1이고 v3.0과 MCAP과 HDF5는 내보내기 경로로만 제공된다. 다른 형식을 기본 저장 형식으로 쓰는 구성은 상정하지 않았다.
- 정량 평가 결과가 README에 없다. 지연 시간, 제어 주기 유지, 추론 전략별 성공률 차이 같은 수치는 기술 리포트를 봐야 한다. 이 페이지는 README 범위만 다룬다.
후속 방향
| 항목 | 상태 | 내용 |
|---|---|---|
| 로봇 확대 | 진행 | 양팔 manipulator, humanoid, 이동과 바퀴 플랫폼, 사족 로봇과 팔 조합으로 embodiment를 넓힌다 |
| 강화학습용 human-in-the-loop 수집 | 완료 | 개입을 선호와 교정 데이터로 기록하고, DAgger 방식 재라벨링과 reward 모델 신호를 LeRobot episode 형식으로 되돌려 온라인 강화학습 fine-tuning에 쓴다 |
| embodied agent | 진행 | 배포와 평가 루프를 언어 기반 planner로 감싸 long-horizon 과제를 분해하고 실행하고 검증하고 다시 계획한다. planner는 VLM 또는 VLA에 tool use를 결합한 형태를 상정한다 |
| 데이터 주석 | 진행 | COLLECT 모드에 과제와 subtask 단위 주석 기능을 더해, long-horizon episode를 라벨이 붙은 subtask 단위와 마일스톤으로 분할한다. 같은 LeRobot 데이터셋 안에서 manipulation 단계별 재사용이 가능해진다 |
네 항목 중 완료된 것은 human-in-the-loop 수집 하나다. 나머지 셋은 로봇 확대, agent 계층 추가, 주석 기능으로 방향이 나뉜다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| transport | observation과 제어 명령이 오가는 통신 계층. ROS 1, ROS 2, ZeroMQ, 오프라인 데이터셋 재생 |
| policy backend | observation을 받아 action을 돌려주는 모델 서버 |
| 추론 전략 | policy가 낸 action chunk를 제어 주기에 맞춰 내보내는 방식 |
| ACT-ensemble | 겹치는 시점의 여러 action 예측을 평균하는 temporal ensembling 계열 전략 |
| RTC | real-time action chunking. chunk 경계의 불연속을 줄이는 추론 전략 |
| EEF-space | end-effector의 위치와 자세를 지정하고 역기구학으로 관절 값을 푸는 action space |
| 마일스톤 점수 | 지시문마다 과제 달성 단계를 나눠 매긴 평가 점수 |
| EVA-MHS | coding agent와 로봇 하드웨어 사이 인터페이스를 MCP 서비스로 노출하는 프리뷰 기능 |
관련 페이지
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: EVA-Client가 기준 데이터 형식으로 채택한 LeRobot. episode 레이아웃과 v2.1에서 v3.0으로의 변화를 다룬다.
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): OpenPI와 OpenPI-RTC policy backend의 원 저장소. EVA-Client가 붙이는 모델 서버 쪽 구현이다.
- NVIDIA Isaac GR00T (N1.7): GR00T policy backend의 원 저장소. ZeroMQ REQ/REP 서버 형태로 연결된다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 대표 데모에서 배포한 π0 체크포인트의 원 논문.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT-ensemble 전략의 근거가 되는 ACT 원 논문. temporal ensembling의 정의가 여기 있다.
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: ACT의 action chunking과 temporal ensembling을 해설한 입문 페이지.
- Nav2 (ROS 2 Navigation Stack): ROS 2 transport 쪽 생태계. 같은 미들웨어 위에 놓인 항법 스택이다.
- RoboCasa: 공식 구현 저장소 (RoboCasa365 v1.0.1): 시뮬레이터에서 데이터를 만드는 반대편 접근. EVA-Client는 실제 로봇 수집에 집중한다.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: 로봇 데이터 형식 통일의 선행 사례.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.