Physical AI · PAPER · 2023
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
요약
이 논문은 하드웨어 ALOHA와 알고리즘 ACT를 한 편에 함께 내놓은 시스템 논문이다. ALOHA는 시중에서 구할 수 있는 로봇 팔과 3D 프린팅 부품만으로 2만 달러 미만에 만드는 양팔 teleoperation 장치이고, ACT는 그 장치로 모은 시연 데이터(demonstration)를 학습하는 imitation learning 알고리즘이다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식을 말하고, imitation learning은 그 시연 데이터를 흉내 내 policy를 학습하는 방법을 말한다.
두 부분이 맞물려 반투명 조미료 컵 뚜껑 열기나 리모컨 슬롯에 배터리 삽입하기처럼 밀리미터 단위 정밀도를 요구하는 스킬 6개를 실세계에서 직접 학습한다. 과제당 필요한 데이터는 시연 50개, 시간으로는 10분 남짓이고 성공률은 80~90%다.
이 논문의 파급력은 action chunking이라는 발상에서 나온다. action chunking은 미래 여러 스텝의 action을 한 묶음으로 한 번에 예측하는 방식이며, 저가 하드웨어 기반 imitation learning 연구와 이후 VLA의 chunk 단위 action 예측이 모두 여기서 출발한다.
배경
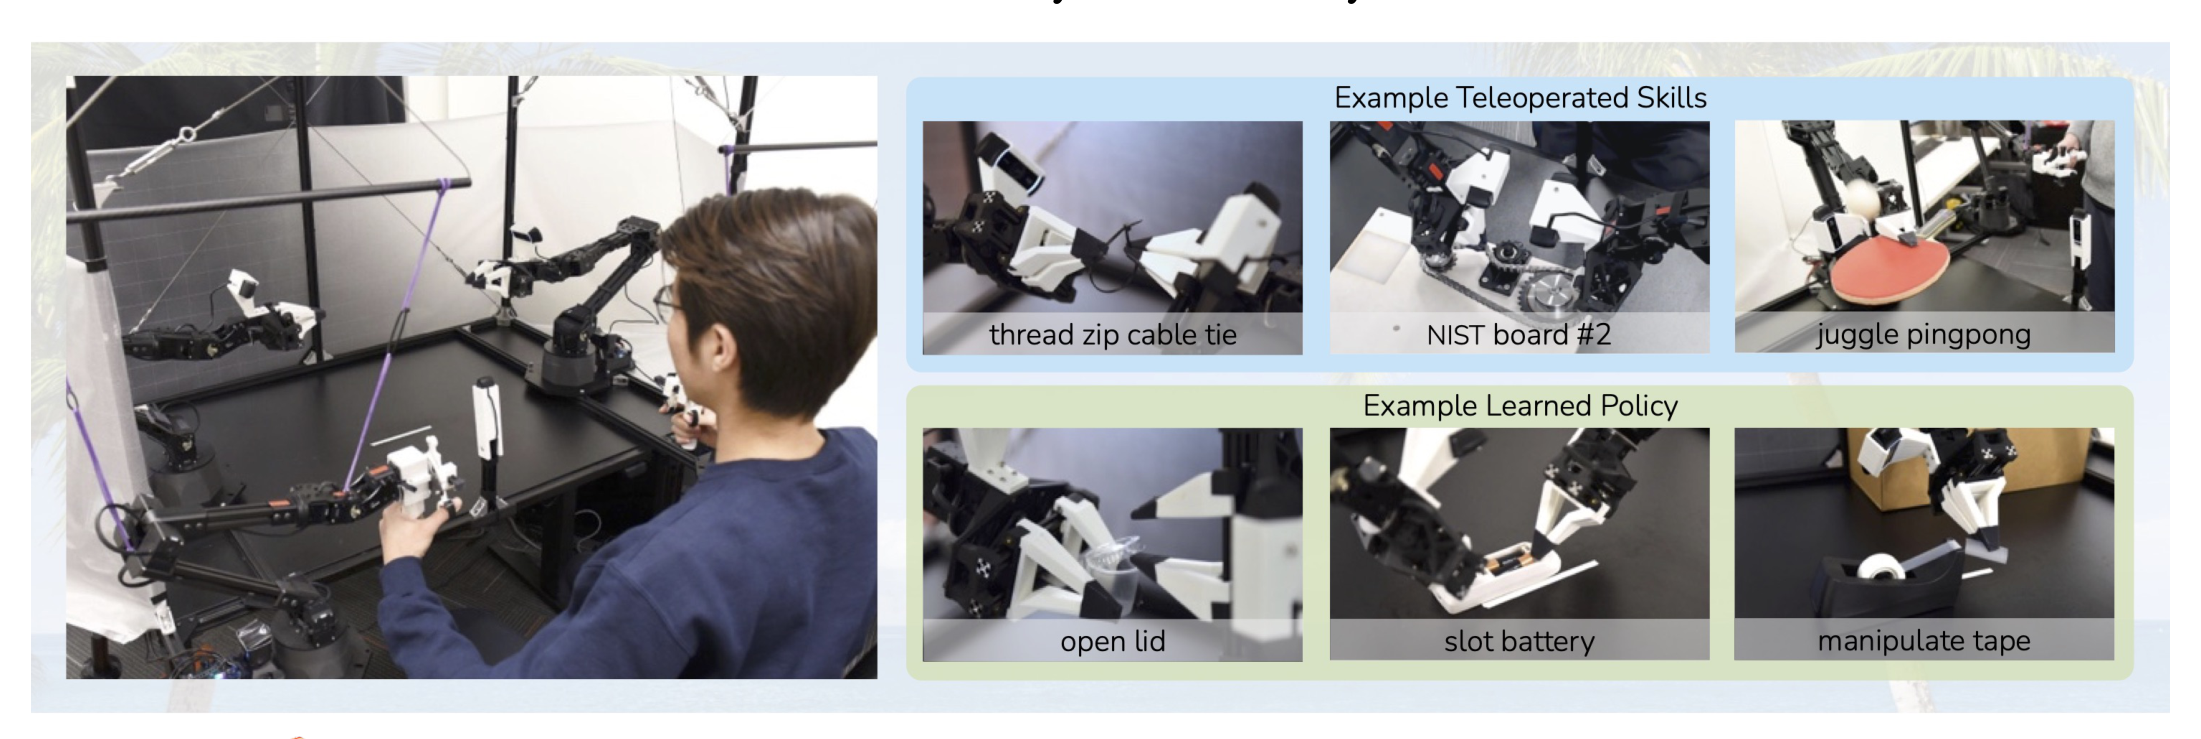
fine manipulation은 밀리미터 단위 정밀도와 접촉력 조절, closed-loop 시각 피드백을 동시에 요구하는 과제를 말한다. closed-loop 제어는 매 timestep 새 observation을 받아 action을 다시 정하는 방식이다. 케이블 타이 꿰기나 배터리 삽입이 대표 사례이며, 집어서 옮기는 큰 동작보다 꼬집기와 비틀어 열기, 찢기 같은 섬세한 조작이 중심이다. 조미료 컵 뚜껑 열기만 해도 오른쪽 그리퍼로 컵을 넘어뜨려 왼쪽 그리퍼에 밀어 넣고, 왼쪽이 부드럽게 들어 올린 뒤 오른쪽 손가락이 아래에서 뚜껑을 젖히는 네 단계가 필요하며 단계마다 몇 밀리미터 오차가 실패로 이어진다.
기존 시스템은 이런 과제를 고가 로봇과 정밀 센서, 세심한 calibration으로 풀었다. 그만큼 비싸고 재현하기 어렵다. 이 논문은 반대 방향을 택해 값싸고 부정확한 하드웨어를 쓰되 그 부정확함을 학습으로 보완한다.
근거는 사람이다. 사람도 산업용 수준의 proprioception을 갖고 있지 않다. proprioception은 관절 각도 같은 로봇 자신의 상태 감각 입력을 말한다. 그런데도 사람은 시각 피드백에 의존해 오차를 능동적으로 보정하며 섬세한 작업을 해낸다. 따라서 저자들은 일반 웹캠의 RGB 이미지를 곧바로 action으로 잇는 pixel-to-action policy를 학습한다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다.
이 선택이 fine manipulation에 잘 맞는 이유는 모델링 난이도의 비대칭에 있다. 컵을 밀 때의 접촉이나 뚜껑을 젖힐 때의 변형은 자유도가 많고 물리가 복잡해 계획에 쓸 만큼 정확한 모델을 만들기 어려운 반면, 컵과 뚜껑의 위치에 반응하는 policy 자체는 훨씬 단순하다.
남는 문제는 imitation learning 쪽에 있다. 고품질 시연 데이터를 확보하더라도 학습된 policy는 실행 중에 점점 어긋나며, 이 문제를 다루는 것이 ACT의 설계 목표다.
핵심 개념
compounding error는 policy의 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상이다. 오차가 실린 action이 다음 상태를 학습 분포 밖으로 밀어내고, 익숙하지 않은 상태에서 낸 action이 다시 더 큰 오차를 만든다. fine manipulation은 몇 밀리미터 차이가 접촉 상태를 바꾸므로 영향이 특히 크다.
action chunking은 policy가 다음 한 스텝이 아니라 앞으로 k 스텝의 action을 한 번에 예측하는 방식이다. 여러 동작이 하나의 덩어리로 묶여 한 단위로 저장되고 실행된다는 신경과학 개념에서 이름을 따왔다. 논문은 사탕 포장의 한쪽 모서리를 잡는 동작이나 배터리를 슬롯에 넣는 동작 하나가 각각 한 chunk에 해당한다고 설명한다.
effective horizon은 과제를 끝내기까지 policy가 연달아 성공시켜야 하는 의사결정 횟수를 뜻한다. action chunking이 이 값을 k배로 줄이는 것이 compounding error 완화의 직접적 근거다.
temporal ensembling은 서로 겹치는 여러 action chunk의 같은 시점 예측을 가중 평균해 실행하는 기법이다. chunk를 k 스텝마다 통째로 교체하면 동작이 끊기는데, 이를 매 timestep 질의와 평균으로 해소한다.
CVAE는 conditional variational autoencoder의 약어로, 조건이 주어졌을 때 데이터의 분포를 학습하는 생성 모델이다. ACT는 사람 시연의 변동을 style variable z에 담기 위해 policy 전체를 CVAE로 학습한다.
방법
하드웨어 구성
ALOHA의 설계는 다섯 원칙을 따른다. 저렴할 것, 여러 fine manipulation 과제에 두루 쓰일 것, 직관적이고 안정적일 것, 연구자가 직접 고칠 것, 구하기 쉬운 재료로 빠르게 조립할 것이다. 가격과 유지보수 부담 때문에 dexterous hand 대신 parallel-jaw 형태의 그리퍼를 골랐다.
| 구성 요소 | 사양 | 대당 가격 |
|---|---|---|
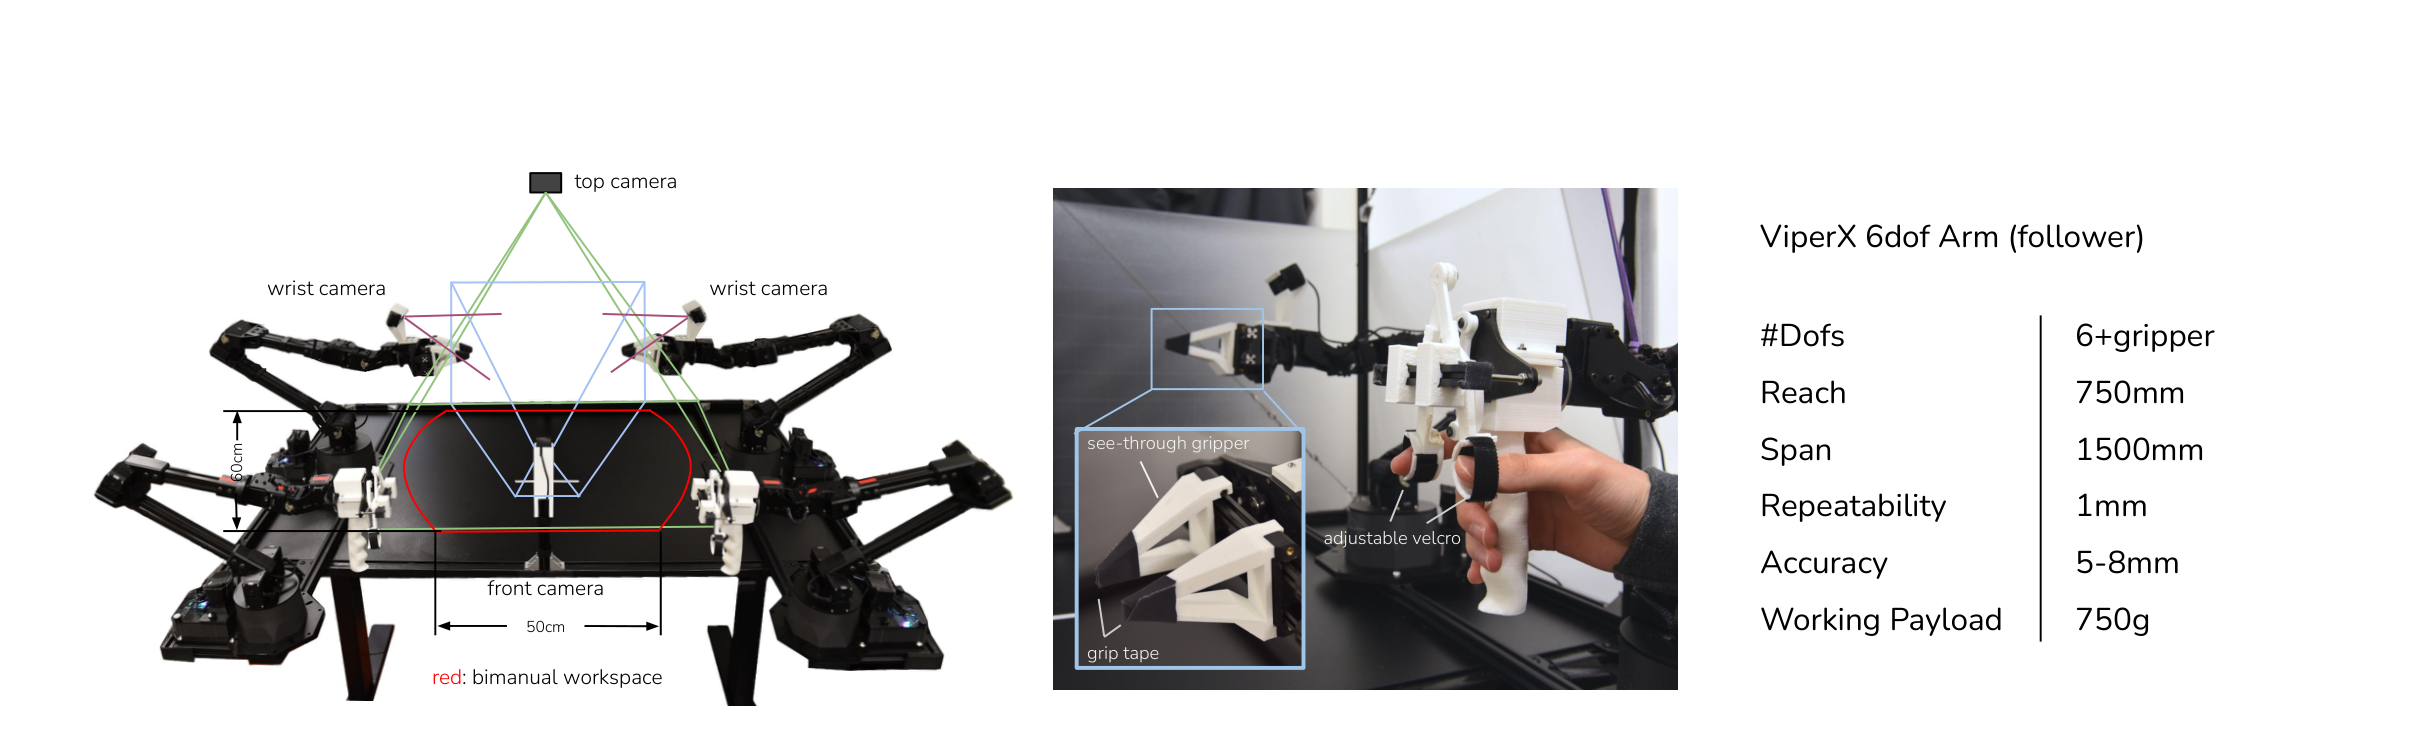
| ViperX 6-DoF 팔 (follower) 2대 | reach 750mm, span 1,500mm, 반복 정밀도 1mm, 정확도 5~8mm, 가반 하중 750g | 약 5,600달러 |
| WidowX 팔 (leader) 2대 | 같은 제조사의 축소판, 사람이 손으로 밀어 조종 | 약 3,300달러 |
| Logitech C922x 웹캠 4대 | 480×640, 30fps, 초점 고정에 자동 노출 | 시스템 옵션 |
| 로봇 케이지 | 20×20mm 알루미늄 프로파일에 강선 보강 | 시스템 옵션 |
모터는 저가 Dynamixel 제품이라 고장 시 부품 단위로 교체된다. 하드웨어와 소프트웨어 전체가 open-source이고 조립 튜토리얼이 공개되어 있어 비전문가도 2시간 안에 조립할 수 있다. 카메라 4대 중 2대는 follower 팔의 손목에 달려 그리퍼 근접 시야를 담당하고 나머지 2대는 위와 앞에 고정되며, 앞쪽 카메라는 90도 회전시켜 수직 방향을 더 담는다. teleoperation과 데이터 기록은 모두 50Hz다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
OEM 그리퍼는 fine manipulation에 부적합해서 저자들이 설계한 부품 세 가지로 대체했다.
- see-through 손가락: 3D 프린팅으로 만들고 gripping tape를 붙였다. 섬세한 조작 중에도 시야를 확보하고 얇은 비닐도 안정적으로 잡는다.
- handle and scissor 기구: leader 팔에 덧붙여 backdrive에 드는 힘을 줄이고, 그리퍼를 열림과 닫힘의 두 상태가 아니라 연속적으로 조절하게 한다.
- 고무줄 load balancing: leader 쪽 중력을 부분적으로 상쇄해 30분 이상의 긴 teleoperation 세션을 가능하게 한다.
teleoperation 방식
ALOHA는 task-space가 아니라 joint-space mapping으로 조종한다. 사람이 작은 leader 팔을 손으로 밀면(backdrive) 그 관절 각도가 큰 follower 팔로 그대로 동기화된다. VR 컨트롤러로 손 포즈를 잡아 end-effector 목표로 옮기고 역기구학으로 푸는 방식은 쓰지 않았다.
근거는 두 가지다. 첫째, fine manipulation은 로봇의 singularity 근처에서 작업할 때가 많은데 여유 자유도가 없는 6-DoF 구성에서는 시중의 inverse kinematics 풀이가 자주 실패한다. joint-space mapping은 관절 한계 안에서 high-bandwidth 제어를 보장하고 계산량과 지연도 줄인다. 둘째, leader 팔의 무게 자체가 조작자의 과속을 막고 잔진동을 감쇠시킨다. 저자들은 VR 컨트롤러를 쥐었을 때보다 정밀 과제 성적이 더 좋았다고 보고한다.
이 구성으로 조종해낸 스킬은 세 종류다. 케이블 타이 꿰기와 지갑에서 신용카드 빼기 같은 정밀 과제, 288핀 RAM 삽입과 NIST board #2 조립 같은 접촉이 많은 과제, 탁구공 저글링과 비닐봉지 펼치기 같은 동적 과제다.
학습 데이터의 입출력 정의
학습에서 action으로 쓰는 값은 follower가 아니라 leader의 관절 위치다. 실제로 가해지는 힘이 leader와 follower의 관절 차이로부터 저수준 PID controller를 통해 암묵적으로 정해지기 때문이다. observation은 follower의 현재 관절 위치와 카메라 4대 이미지로 이뤄진다.
action space는 두 팔의 절대 관절 위치를 담은 14차원 벡터다. 팔 하나당 6자유도에 그리퍼 1개를 더해 7차원이므로 두 팔이면 14차원이 된다. action chunking을 적용하면 policy 출력은 k×14 크기의 텐서가 되고, 이 목표 관절 위치는 Dynamixel 모터 내부의 고주파 PID controller가 추종한다.
action chunking
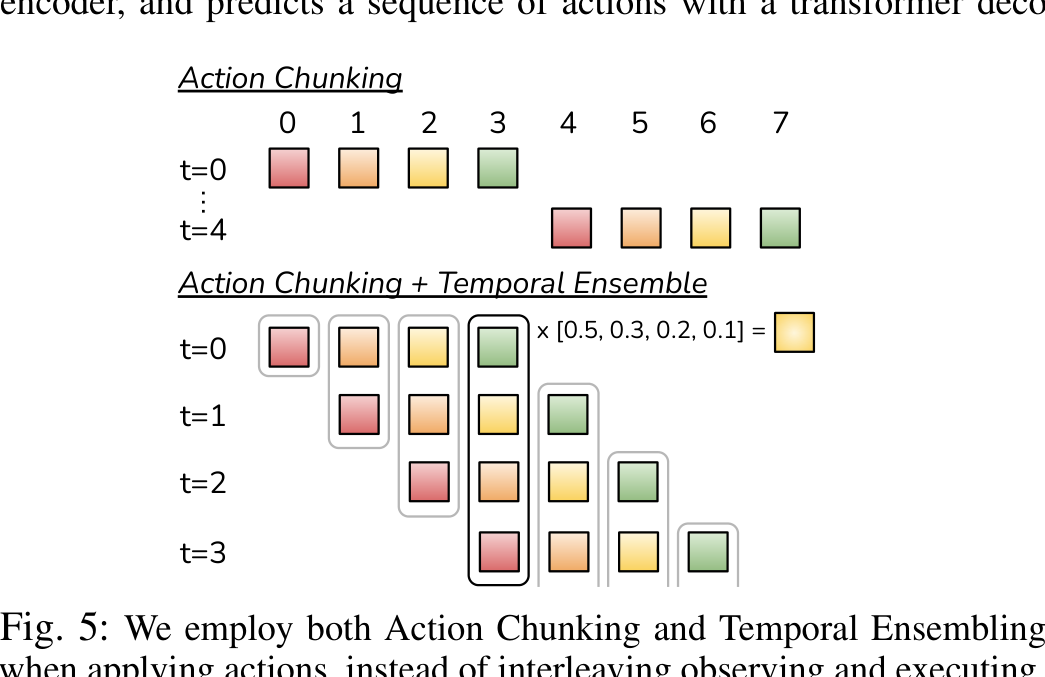
action chunking은 πθ(at|st) 대신 πθ(at:t+k|st)를 모델링한다. k 스텝마다 observation을 한 번 받고 다음 k개 action을 생성해 순서대로 실행하므로 과제의 effective horizon이 k배로 줄어든다. 논문의 기본 설정은 k=100이며 50Hz 기준으로 2초 분량의 동작에 해당한다.
부수 효과도 있다. 사람 시연에는 중간에 잠시 멈추는 것처럼 현재 상태만으로는 설명되지 않는 non-Markovian 행동이 섞여 있다. 한 스텝 policy는 같은 상태에서 멈춤과 진행 중 무엇을 낼지 결정하지 못하지만, 멈춤이 chunk 안에 들어가면 chunk 전체를 하나의 패턴으로 학습할 수 있다. 히스토리를 입력으로 받는 policy가 겪는 causal confusion 문제도 피한다.
temporal ensembling
action chunking을 그대로 구현하면 k 스텝마다 새 observation이 갑자기 반영되어 동작이 끊긴다. temporal ensembling은 이를 매 timestep 질의로 해소한다. 매 timestep policy를 새로 호출하면 서로 다른 시점에서 나온 chunk들이 시간축에서 겹치고, 한 timestep에 대해 여러 개의 예측이 쌓인다.
최종 action은 그 예측들의 지수 가중 평균이다. 가중치는 w_i = exp(-m * i)이고 가장 오래된 예측에 w_0가 붙는다. m이 작을수록 새 observation이 빨리 반영되며, 논문의 도식은 [0.5, 0.3, 0.2, 0.1] 같은 가중치 배열을 예로 든다.
이 방식은 흔한 smoothing과 다르다. 인접한 timestep의 action을 섞는 smoothing은 값을 원래 의도에서 밀어내는 bias를 만드는 반면, temporal ensembling은 같은 timestep을 겨냥한 예측만 모으므로 그런 bias가 없다. 추가 학습 비용도 없고 추론 시 연산만 늘어난다.
CVAE로 사람 시연 모델링
사람 시연은 같은 observation에서도 매번 다른 경로를 그리며, 정밀도가 덜 중요한 구간일수록 편차가 커진다. 예를 들어 테이프 조각을 공중에서 건네주는 동작은 시연마다 건네는 위치가 달라지는데, 조작자에게 같은 위치를 재현할 시각 기준이나 촉각 기준이 없기 때문이다. 이런 데이터를 하나의 정답이 있는 것처럼 학습하면 policy는 여러 경로의 평균을 내놓고, 정밀 과제에서는 그 평균이 곧 실패다. 따라서 ACT는 policy를 CVAE로 학습해 변동 자체를 모델에 담는다.
| 구성 요소 | 쓰이는 시점 | 입력 | 출력 |
|---|---|---|---|
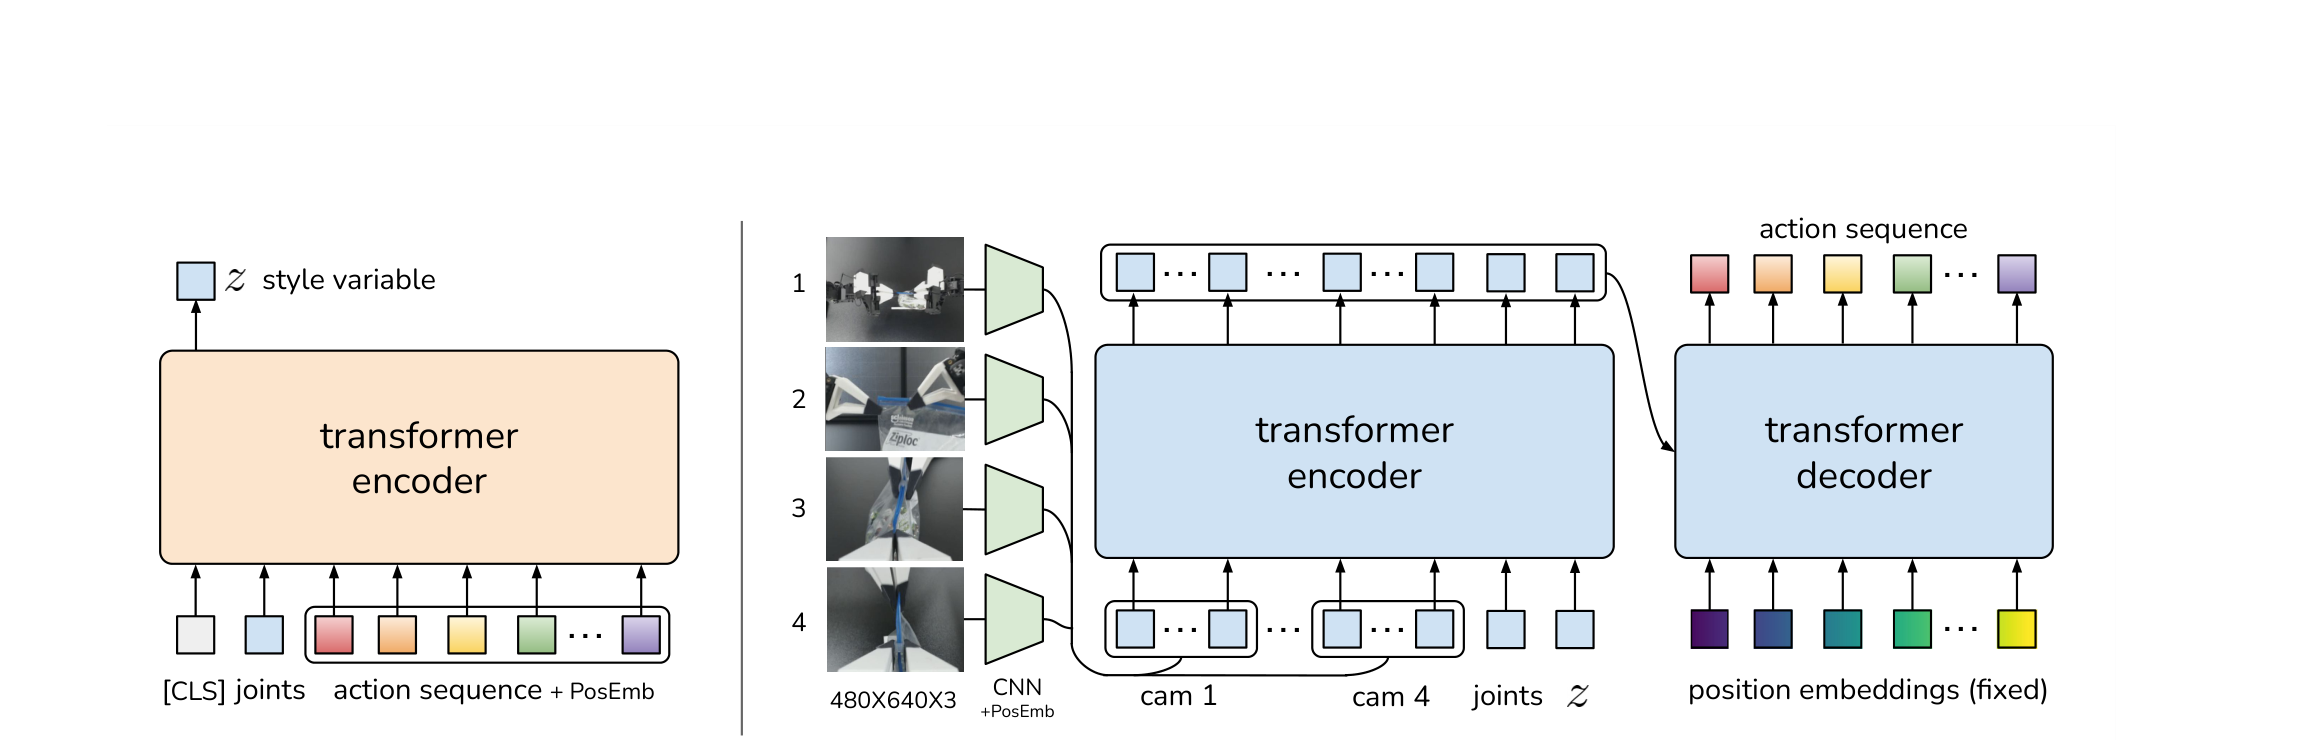
| CVAE encoder | 학습 때만 | [CLS] 토큰, 현재 관절 위치, 시연 action sequence | style variable z의 평균과 분산 |
| CVAE decoder (policy) | 학습과 실행 모두 | 카메라 4대 이미지, 현재 관절 위치, z | 다음 k 스텝의 목표 관절 위치 |
CVAE encoder는 BERT 계열의 Transformer encoder로 구현한다. 입력은 학습 속도를 위해 이미지를 빼고 proprioception과 action sequence만 넣으며 길이는 k+2다. [CLS] 위치의 출력이 선형층을 거쳐 32차원 z 분포의 평균과 분산이 되고, 재파라미터화로 z를 뽑아 encoder와 decoder를 함께 최적화한다.
실행 시에는 미래의 정답 action sequence를 알 수 없으므로 encoder를 폐기하고 z를 prior의 평균인 0으로 고정한다. 따라서 같은 observation에는 항상 같은 chunk가 나오며 policy 평가가 결정론적이 된다. 손실은 표준 VAE 목적함수와 같이 복원 항과 KL 정규화 항의 합이고 KL 항에 β=10을 곱한다. β가 클수록 z에 실리는 정보량이 줄어든다.
네트워크 구현
CVAE decoder는 ResNet18 이미지 인코더와 Transformer encoder, Transformer decoder를 이어 붙인 구조다. 이미지 처리 경로는 다음 순서로 진행된다.
- 480×640×3 이미지 한 장이 ResNet18을 지나 15×20×512 feature map이 된다.
- 공간축으로 flatten해 300×512 시퀀스가 되고 2D sinusoidal position embedding을 더한다.
- 카메라 4대분을 이어 붙이면 1,200×512가 된다.
- 현재 관절 위치와 z를 각각 선형층으로 512차원에 사영해 붙이면 Transformer encoder 입력이 1,202×512가 된다.
Transformer decoder는 encoder 출력을 key와 value로 삼는 cross-attention으로 참조하고, 고정된 sinusoidal position embedding을 query로 써서 k×512를 낸다. 마지막으로 MLP가 이를 k×14로 사영해 두 팔의 다음 k 스텝 목표 관절 위치를 만든다. 세부 설계에서는 두 선택이 성능에 영향을 줬다. 복원 항에 흔히 쓰는 L2 loss 대신 L1 loss를 쓸 때 action sequence가 더 정밀하게 모델링됐고, action으로 관절 위치의 변화량 대신 절대 관절 위치를 쓸 때 성능이 더 좋았다.
| hyperparameter | 값 |
|---|---|
| learning rate | 1e-5 |
| batch size | 8 |
| Transformer encoder layer 수 | 4 |
| Transformer decoder layer 수 | 7 |
| hidden dimension | 512 |
| feedforward dimension | 3,200 |
| head 수 | 8 |
| chunk size k | 100 |
| β | 10 |
| dropout | 0.1 |
모델은 약 8,000만 개(80M) 파라미터이고 과제마다 처음부터 학습한다. 학습에는 11GB RTX 2080 Ti 한 장으로 약 5시간이 걸리고 추론은 약 0.01초다. 즉 50Hz 제어 주기인 0.02초 안에 한 번의 질의가 끝나므로, 매 timestep 질의를 전제하는 temporal ensembling이 실행 가능하다.
실험 설계
과제
평가 과제는 실세계 6개와 MuJoCo 시뮬레이션 2개, 합계 8개다. 모두 양팔 협응과 밀리미터 단위 정밀도를 요구한다.
| 과제 | 환경 | 핵심 난점 |
|---|---|---|
| Slide Ziploc | 실세계 | 왼팔이 봉투 몸통을 고정한 상태에서 오른팔이 슬라이더를 집어 열어야 한다 |
| Slot Battery | 실세계 | 삽입 중 슬롯 스프링이 리모컨을 밀어내므로 왼팔이 눌러 고정한다 |
| Open Cup | 실세계 | 컵을 넘어뜨려 반대편 그리퍼로 밀어 넣고 아래에서 뚜껑을 젖힌다 |
| Thread Velcro | 실세계 | 3mm×25mm 고리에 2mm 두께 케이블 타이 끝을 공중에서 꿴다 |
| Prep Tape | 실세계 | 테이프를 잘라 공중에서 건네고 상자 모서리에 붙인다 |
| Put On Shoe | 실세계 | 마네킹 발에 신발을 신기고 벨크로 스트랩을 고정한다 |
| Transfer Cube | 시뮬레이션 | 큐브와 반대편 그리퍼 사이 여유가 약 1cm뿐이다 |
| Bimanual Insertion | 시뮬레이션 | 공중에서 페그를 소켓에 넣으며 여유가 약 5mm다 |
물체의 초기 위치는 실세계 과제에서 15cm 흰 선을 따라, 시뮬레이션 과제에서는 2차원 영역 안에서 무작위로 바뀐다. 각 과제는 3~4개의 subtask로 나뉘어 단계별 성공률이 보고된다.
지각 난이도도 설계에 들어가 있다. ziploc 봉투는 대부분 투명하고 얇은 파란 밀봉선만 보이며, 봉투 주름과 안에 든 반사성 사탕 포장이 무작위로 바뀌어 인식을 방해한다. 테이프와 조미료 컵도 반투명이라 깊이 카메라로 다루기 어렵고, 검은 탁자 상판은 검은 케이블 타이나 검은 테이프 디스펜서와 대비가 낮다.
데이터 수집
과제당 시연 50개를 모았고 Thread Velcro만 100개다. episode 하나는 과제 복잡도에 따라 814초이며 50Hz 기준으로 400700 timestep에 해당한다. 따라서 과제당 데이터는 1020분 분량이고, 초기화와 조작자 실수를 포함한 실제 소요 시간은 3060분이다.
시뮬레이션 과제는 두 종류의 데이터를 각각 50개씩 수집했다. 하나는 규칙으로 생성한 scripted 데이터이고 다른 하나는 ALOHA의 leader 팔로 화면 속 로봇을 조종해 만든 사람 시연 데이터다. 이 대비가 뒤의 CVAE ablation에서 결정적 역할을 한다.
baseline
baseline 4종은 모두 같은 데이터로 학습하고 Transfer Cube 과제에서 hyperparameter를 조정했다.
| 방법 | 구조 | ACT와의 차이 |
|---|---|---|
| BC-ConvMLP | CNN으로 현재 이미지를 처리하고 관절 위치와 이어 붙여 action 하나를 낸다 | 가장 단순한 behavioral cloning 구현이며 chunking이 없다 |
| BeT | Transformer로 observation 히스토리에서 action 하나를 낸다 | chunking이 없고 시각 인코더가 별도 학습된 뒤 고정된다. action은 이산 구간에 연속 오프셋을 더해 표현한다 |
| RT-1 | Transformer로 고정 길이 히스토리에서 action 하나를 낸다 | chunking이 없고 action을 256개 구간으로 이산화한다 |
| VINN | 시각 feature가 가장 비슷한 시연을 찾아 가중 kNN으로 action을 낸다 | 비모수 방법이라 실행 시점에 시연 데이터가 필요하다 |
behavioral cloning은 시연의 observation과 action 쌍을 지도학습으로 흉내 내는 방법이다. BeT는 원 논문의 히스토리 길이 10을 100으로 늘렸을 때 성능이 크게 좋아졌고, VINN과 BeT의 시각 feature 추출기로는 BYOL로 학습한 ResNet을 썼다.
결과
평가 횟수는 시뮬레이션 과제가 3개 seed에 seed당 50회, 실세계 과제가 1개 seed에 25회다. 아래 표는 각 과제의 최종 subtask 성공률이며 시뮬레이션 항목은 scripted 데이터와 사람 시연 데이터 결과를 나란히 적었다.
| 방법 | Transfer Cube (scripted / human) | Bimanual Insertion (scripted / human) | Slide Ziploc | Slot Battery |
|---|---|---|---|---|
| BC-ConvMLP | 1% / 0% | 1% / 0% | 0% | 0% |
| BeT | 27% / 1% | 3% / 0% | 0% | 0% |
| RT-1 | 2% / 0% | 1% / 0% | 0% | 0% |
| VINN | 3% / 0% | 1% / 0% | 0% | 0% |
| ACT | 86% / 50% | 32% / 20% | 88% | 96% |
ACT는 네 항목 모두에서 두 번째로 높은 방법을 각각 59%p, 49%p, 29%p, 20%p 앞선다. baseline들은 첫 한두 개 subtask까지는 진행하지만 최종 성공률이 30% 아래에 머문다. 실세계 두 과제에서는 격차가 더 크며 ACT를 뺀 모든 방법이 첫 단계 이후 전진하지 못한다.
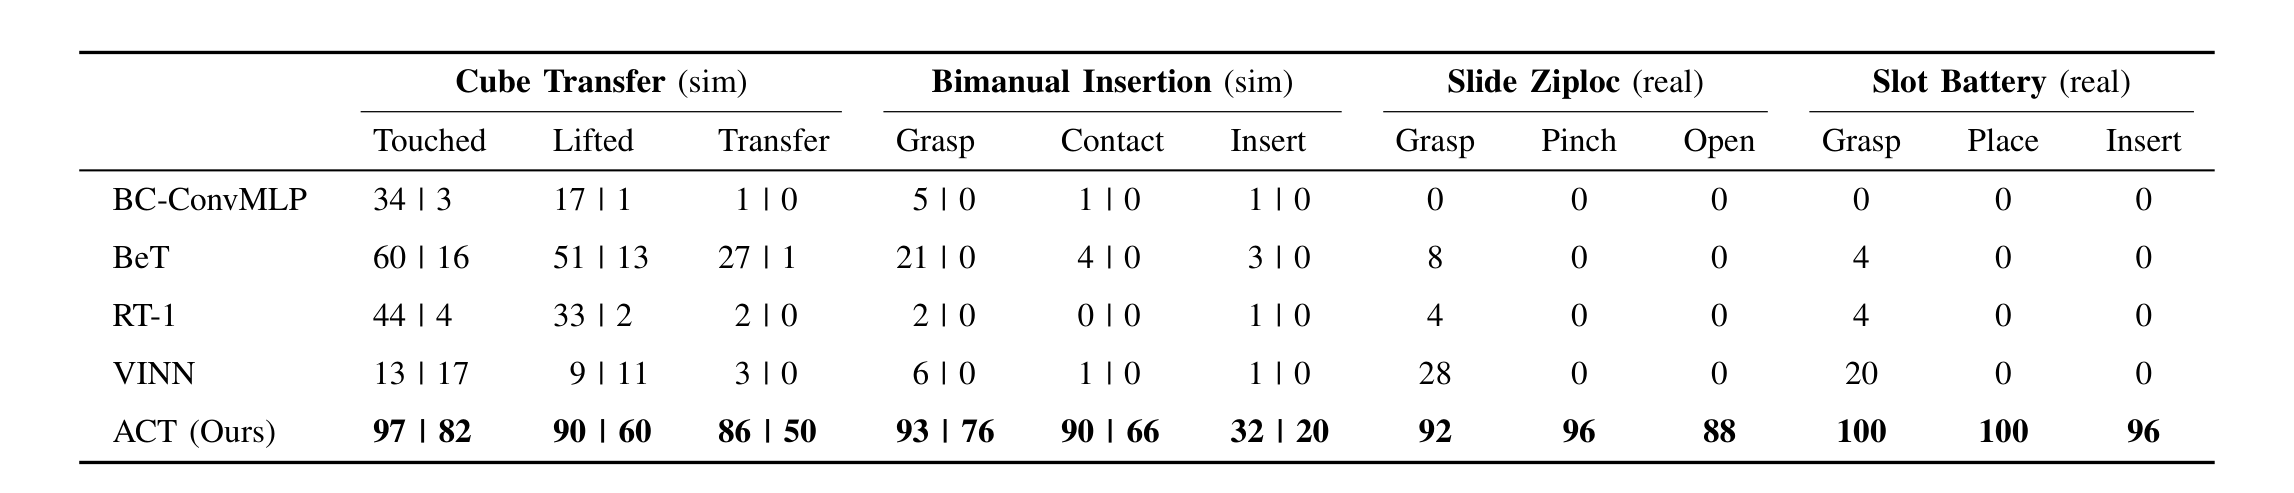
나머지 실세계 4개 과제는 성적이 가장 좋았던 baseline인 BeT와만 비교한다.
| 과제 | ACT 최종 성공률 | BeT 최종 성공률 |
|---|---|---|
| Open Cup | 84% | 0% |
| Thread Velcro | 20% | 0% |
| Prep Tape | 64% | 0% |
| Put On Shoe | 92% | 0% |
BeT는 네 과제 모두 최종 단계에서 0%이고 첫 단계 성공률도 8~24%에 그친다. 반면 ACT는 Thread Velcro를 제외하면 모두 64% 이상이다.
Thread Velcro의 20%는 단계별 감소가 뚜렷하다. 첫 단계인 케이블 타이 들어 올리기는 92%지만 공중에서 꼬리를 잡는 두 번째 단계에서 40%로, 고리에 삽입하는 마지막 단계에서 20%로 내려간다. 관찰된 실패 유형은 오른팔이 그리퍼를 너무 일찍 닫아 꼬리를 놓치는 경우와 삽입 정밀도가 부족해 고리를 빗나가는 경우 두 가지다. 원인은 지각에 있다. 검은 케이블 타이는 배경과 대비가 낮고 이미지에서 차지하는 면적도 작아 위치를 정확히 추정하기 어렵다. 게다가 처음 잡을 때 몇 밀리미터 어긋나면 공중에서 다시 잡는 단계를 거치며 삽입 시점에는 10mm 넘는 편차가 된다.
baseline의 부진에 대해 저자들은 두 원인을 든다. compounding error 때문에 episode 후반으로 갈수록 동작 품질이 크게 하락하고, non-Markovian 행동 때문에 특정 상태에서 로봇이 무한정 멈춘다. 시뮬레이션에서 scripted 데이터를 사람 시연 데이터로 바꾸면 모든 방법의 성적이 떨어진다는 점도 함께 보고된다. 사람 시연의 확률성과 multi-modality가 imitation learning을 훨씬 어렵게 만들기 때문이다.
ablation
ablation은 구성 요소를 하나씩 빼거나 바꿔 그 요소의 기여를 확인하는 실험이다. 여기서는 시뮬레이션 2개 과제에 scripted 데이터와 사람 시연 데이터를 조합한 4개 설정의 평균으로 측정한다.
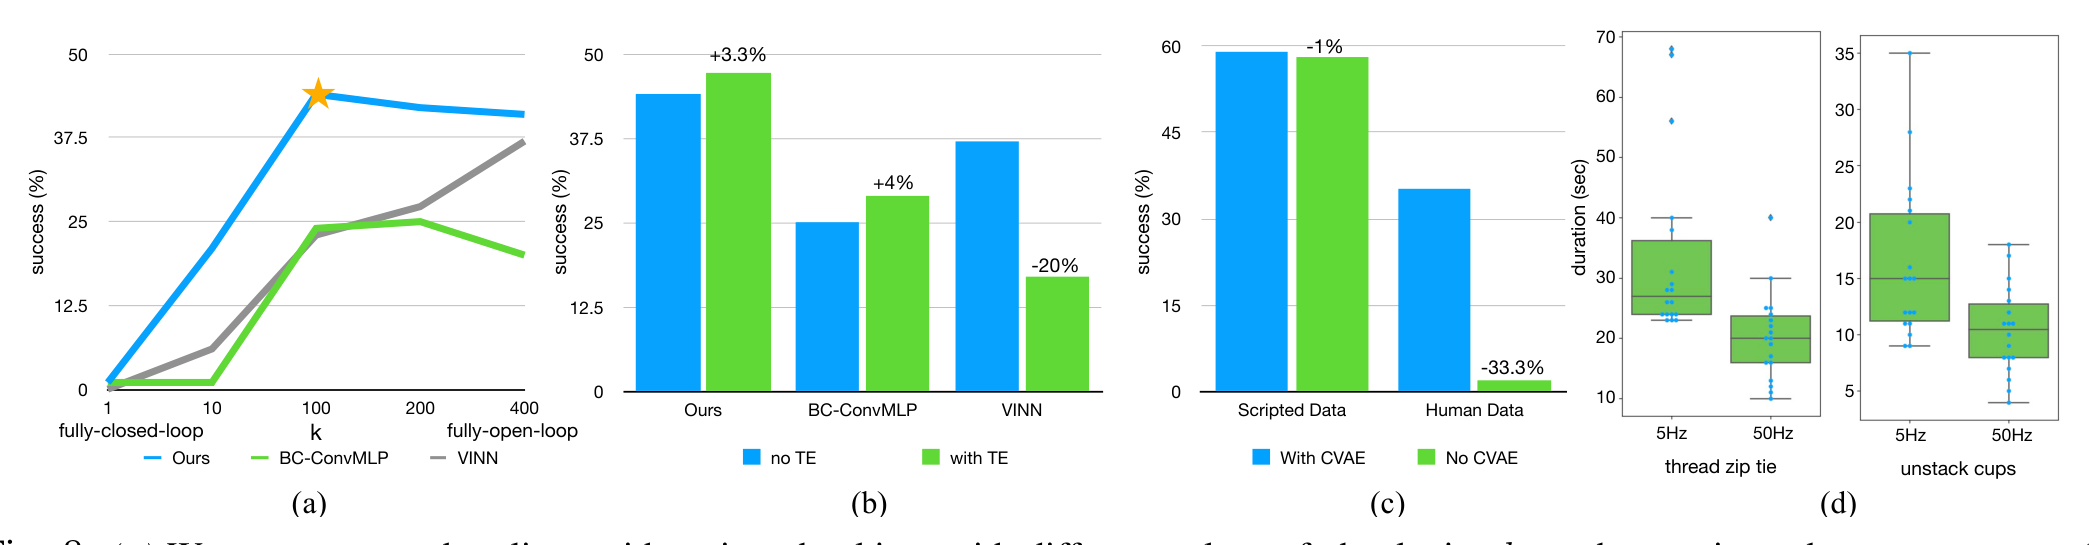
첫째, chunk size k의 효과가 가장 뚜렷하다. temporal ensembling을 끈 상태에서 k=1일 때 평균 성공률이 1%인 반면 k=100에서는 44%로 43%p 오른다. k=200과 k=400에서는 조금 내려가는데, 이 구간은 사실상 open-loop 실행에 해당한다. open-loop 실행은 한 번 계산한 action 묶음을 중간 피드백 없이 끝까지 내보내는 방식이며, 반응성이 사라지고 긴 action sequence 자체를 모델링하기도 어려워진다. 같은 chunking을 BC-ConvMLP와 VINN에 붙여도 성능이 오르므로 이 기법은 ACT 전용 장치가 아니라 imitation learning 전반에 유용하다.
둘째, temporal ensembling의 효과는 방법의 성격에 따라 갈린다.
| 방법 | temporal ensembling 없음 | 있음 | 차이 |
|---|---|---|---|
| ACT | 44% | 47.3% | +3.3%p |
| BC-ConvMLP | 25% | 29% | +4%p |
| VINN | 37% | 17% | −20%p |
parametric 방법인 ACT와 BC-ConvMLP는 이득을 보지만 비모수 방법인 VINN은 20%p 하락한다. 저자들의 해석은 temporal ensembling이 모델의 예측 오차를 매끄럽게 다듬는 장치라는 것이다. VINN은 데이터셋에서 실제 action을 그대로 꺼내 오므로 다듬을 오차가 없고, 평균이 오히려 원래 action을 왜곡한다.
셋째, CVAE의 효과는 데이터 종류에 따라 완전히 갈린다.
| 데이터 종류 | CVAE 사용 | CVAE 제거 | 차이 |
|---|---|---|---|
| scripted 데이터 | 59% | 58% | −1%p |
| 사람 시연 데이터 | 35.3% | 2% | −33.3%p |
규칙으로 생성한 scripted 데이터는 결정론적이라 CVAE가 있으나 없으나 차이가 없다. 반면 사람 시연 데이터에서는 CVAE를 빼면 성공률이 35.3%에서 2%로 크게 하락한다. 따라서 CVAE는 선택 사항이 아니라 사람 시연을 학습하기 위한 필수 요소다.
넷째, 50Hz라는 control frequency의 필요성은 6명이 참가한 user study로 확인한다. 참가자는 컴퓨터과학 대학원생 남성 4명과 여성 2명이고 연령은 22~25세이며, 절반은 VR 컨트롤러 teleoperation 경험이 있었고 ALOHA를 써 본 사람은 없었다. 과제와 주파수 순서를 무작위로 배정한 뒤 2분 연습을 거쳐 3회씩 시간을 측정했다.
| 과제 | 5Hz 소요 시간 | 50Hz 소요 시간 |
|---|---|---|
| 케이블 타이 꿰기 | 33초 | 20초 |
| 플라스틱 컵 분리 | 16초 | 10초 |
주파수를 50Hz에서 5Hz로 낮추면 teleoperation 시간이 평균 62% 늘어나며, 반복측정 설계로 검정한 유의확률은 0.001 미만이다. 5Hz는 고용량 신경망을 쓰는 당시 imitation learning 연구들이 사용하던 대역이므로, 이 실험은 저주파 제어가 fine manipulation 데이터 수집 자체를 어렵게 만든다는 근거가 된다.
비용과 성능 비교
부록 A는 ALOHA를 기존 teleoperation 시스템과 비용 측면에서 비교한다.
| 시스템 | 구성 | 대략 비용 |
|---|---|---|
| Shadow Teleoperation System | 양팔에 dexterous hand 2개 | 최소 40만 달러 |
| DexPilot | 팔 1개에 dexterous hand 1개, 보정된 depth 카메라 4대 | 약 10만 달러 |
| Robotic Telekinesis | 팔 1개에 dexterous hand 1개, RGB 카메라 1대 | 약 1만 8천 달러 |
| ALOHA | 양팔에 parallel-jaw 그리퍼 | 1만 8천 달러, 카메라 등 추가 시 2만 달러 |
성능은 가장 유능한 Shadow Teleoperation System을 기준으로 비교한다. 저자들은 공개 시연 영상에서 15개 사용 사례를 뽑아 ALOHA로 재현을 시도했고 비슷한 물체와 소요 시간으로 14개를 재현했다. 재현하지 못한 하나는 바오딩 볼을 손안에서 회전시키는 과제이며 ALOHA에 손이 없기 때문이다. 즉 10배 이상 비싼 시스템과 비교해도 dexterous hand가 필요한 과제를 빼면 대등하다.
한계
하드웨어 한계는 저가 모터의 토크와 그리퍼 형태에서 나온다.
- 큰 힘이 필요한 과제를 수행하지 못한다. 무거운 물체 들기, 밀봉된 물병 비틀어 열기, 꽉 눌러 닫힌 마커 뚜껑 열기가 사례다.
- 양손의 여러 손가락을 함께 써야 하는 과제를 수행하지 못한다. 누름 탭이 있는 child-proof 약병은 한 손이 병을 잡고 탭을 누르는 동안 다른 손이 뚜껑을 돌려야 한다.
- 손톱이 필요한 동작이 어렵다. 그리퍼 가장자리를 얇게 설계했지만 자기 위에 붙은 포장 테이프의 끝을 들추거나 알루미늄 캔을 따지 못한다.
policy 학습 한계로는 ACT가 학습에 실패한 두 과제를 그대로 보고한다.
사탕 포장 벗기기는 시연 50개로 학습한 뒤 10회 평가에서 사탕 집기 10회, 양끝 당기기 8회에 성공했지만 포장을 벗기는 데는 한 번도 성공하지 못했다. 원인은 지각 난이도와 데이터 부족이다. 양끝을 당긴 뒤 포장의 봉합선이 사탕 주위 어디에 나타날지 예측할 수 없고, 시연 수집 단계에서 사람조차 포장에 인쇄된 그림의 불연속을 보고 판단해야 한다. 사탕 5개에 각각 10회씩 기회를 주는 다른 방식으로 평가하면 5개 중 3개는 벗겨낸다.
탁자에 눕혀진 작은 ziploc 봉투 열기도 실패한다. 시연 50개로 학습한 policy는 봉투를 집는 데까지는 안정적이지만 이후 공중에서 이뤄지는 세 단계를 수행하지 못한다. 저자들의 가설은 봉투 자체가 지각하기 어렵고, 집는 위치의 작은 차이가 봉투 변형에 크게 반영되어 당길 부위의 최종 위치가 크게 달라진다는 것이다.
저자들이 유망하다고 든 후속 방향은 pre-training과 더 많은 데이터, 더 나은 perception이다. 본문은 셔츠 단추 잠그기처럼 로봇과 학습 알고리즘 어느 쪽으로도 아직 닿지 않는 과제가 남아 있다고 덧붙인다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| ALOHA | A Low-cost Open-source Hardware System for Bimanual Teleoperation. ViperX follower 2대와 WidowX leader 2대, 카메라 4대로 이뤄진 2만 달러 미만 구성 |
| ACT | Action Chunking with Transformers. 이 논문의 imitation learning 알고리즘으로, action chunk를 Transformer 기반 CVAE decoder로 생성한다 |
| action chunking | 한 스텝이 아니라 앞으로 k 스텝의 action을 한 번에 예측하고 실행해 effective horizon을 k배 줄이는 기법 |
| temporal ensembling | 매 timestep 질의로 겹쳐진 chunk들의 같은 시점 예측을 지수 가중 평균해 동작을 매끄럽게 만드는 추론 기법 |
| compounding error | policy의 작은 예측 오차가 다음 입력을 어긋나게 만들어 시간이 갈수록 커지는 현상 |
| effective horizon | 과제를 끝내기까지 policy가 연달아 성공시켜야 하는 의사결정 횟수. chunking이 이를 k배 줄인다 |
| joint-space mapping | leader의 관절 각도를 follower로 직접 동기화하는 teleoperation 방식. task-space 목표와 역기구학 계산을 쓰지 않는다 |
관련 페이지
- 03-05. ACT - 모두의 로보틱스 - VLA 입문: 이 논문의 한국어 입문 해설. 기초 개념이 낯설면 먼저 읽고 이 페이지로 넘어오는 순서를 권한다.
- RT-1: Robotics Transformer for Real-World Control at Scale: 이 논문의 baseline 중 하나. RT-1은 한 스텝 action을 256개 구간의 이산 토큰으로 내는 반면 ACT는 연속 action을 chunk 단위로 예측한다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: action chunk를 flow matching으로 생성하는 VLA. ACT가 세운 chunk 단위 예측을 대형 모델로 옮긴 사례이며 chunk size는 50이다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: action chunk를 flow matching DiT로 생성하는 VLA foundation model. ACT의 chunk 기반 예측을 여러 embodiment로 확장했다.
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: ACT 구현과 데이터 형식을 제공하는 오픈소스 라이브러리. ALOHA 계열 하드웨어도 지원한다.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: 양팔 VLA 서베이. ALOHA와 ACT를 저가 양팔 imitation learning의 기준점으로 다룬다.
- Physical AI 핵심 논문 14편 리뷰 | 2025년까지의 기술 흐름 총정리: action chunking을 생성 모델 종류와 무관한 제어 전략으로 짚는 한국어 리뷰. 이 논문이 그 개념의 출처다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.