Physical AI · ARTICLE · 2025
Accelerate Generalist Humanoid Robot Development with NVIDIA Isaac GR00T N1
요약
NVIDIA가 GTC 2025에서 Isaac GR00T N1을 공개하며 함께 낸 기술 블로그 글이다. 모델 소개에 그치지 않고, 개발자가 그 모델을 받아 자기 로봇에 붙이기까지 필요한 자산과 절차를 한자리에 모아 정리했다는 점이 이 글의 성격을 결정한다.
따라서 이 페이지는 발표가 실제로 공개한 범위를 중심으로 읽는다. GR00T-N1-2B 체크포인트, 학습 데이터의 일부, 샘플 데이터셋과 PyTorch 스크립트, SimReady 데이터와 시뮬레이션 프레임워크가 각각 어디에 있는지, 데이터 준비부터 평가까지 다섯 단계가 무엇인지, post-training과 추론에 어떤 GPU가 필요한지가 원문에 이름과 수치로 적혀 있다.
모델 자체의 기술 정본은 같은 날 arXiv에 올라온 논문이다. 아키텍처와 학습 레시피의 세부는 GR00T N1: An Open Foundation Model for Generalist Humanoid Robots이 담고, 같은 모델의 한국어 해설은 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문가 담는다. 수치와 방법을 인용할 일이 생기면 논문 페이지로 가는 것이 맞다.
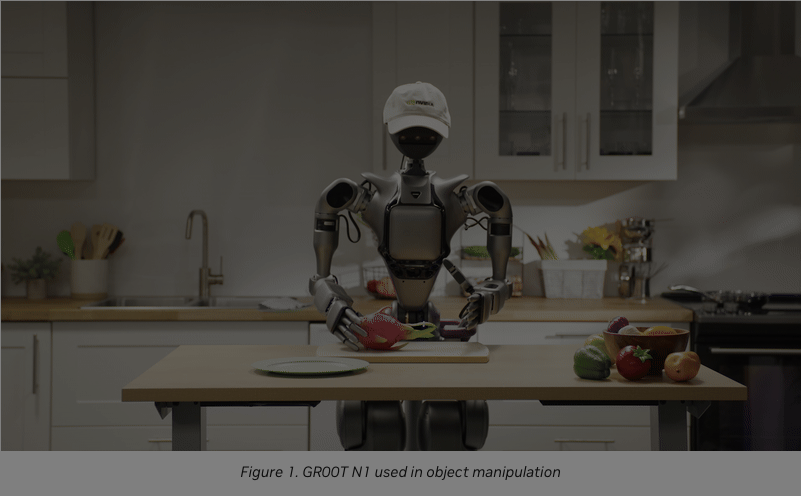
배경
humanoid 로봇은 사람이 쓰도록 만들어진 작업 공간에 그대로 들어가 반복적이거나 힘든 일을 맡도록 설계된다. 그러나 예측하기 어려운 실세계 환경에서 범용으로 동작하는 humanoid를 만드는 일은 여전히 어렵다.
원문이 지목하는 걸림돌은 개발 방식 자체다. 지금까지는 과제 하나마다 전용 AI 모델을 따로 두는 것이 일반적이었고, 새 과제와 새 환경이 생길 때마다 모델을 처음부터 학습시켜야 했다. 이 방식에는 세 가지 비용이 함께 붙는다.
- 과제마다 대량의 전용 데이터를 새로 수집해야 한다.
- 학습 연산 비용이 과제 수만큼 늘어난다.
- 그렇게 얻은 모델의 일반화 범위가 좁다.
NVIDIA Isaac GR00T는 이 세 가지를 한 번에 줄이려는 접근이다. 즉 과제마다 모델을 새로 만드는 대신, 이미 pre-training된 모델을 받아 자기 로봇과 과제에 맞게 추가 학습하는 경로를 제공한다. pre-training은 대규모 일반 데이터로 모델의 기반 능력을 먼저 학습하는 단계를 말한다.
핵심 개념
foundation model은 여러 하위 과제의 기반이 되는 대규모 범용 모델이다. 원문은 GR00T N1을 humanoid의 추론과 기술을 함께 다루는 최초의 open foundation model로 소개한다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. GR00T N1은 cross-embodiment 모델로 소개되는데, 하나의 가중치가 형상이 서로 다른 여러 로봇에서 동작한다는 뜻이다.
post-training은 pre-training된 모델을 특정 embodiment와 과제, 환경에 맞게 추가로 학습시키는 단계다. 이 글이 제시하는 실무 절차 전체가 이 단계를 중심에 둔다.
long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 원문은 GR00T N1이 문맥을 유지하며 서로 다른 기술을 엮어야 하는 이런 과제도 수행한다고 적고, 그 응용으로 물류 처리와 포장, 검사를 든다.
공개 자산
발표가 공개한 것은 모델 하나가 아니라 스택 전체다. 원문은 Isaac GR00T를 SimReady 데이터, 시뮬레이션 프레임워크, 합성 데이터 blueprint, pre-training된 foundation model의 묶음으로 소개한다.
| 자산 | 내용 | 배포 위치 |
|---|---|---|
| GR00T N1 2B 모델 | pre-training된 체크포인트. 앞으로 공개할 커스터마이즈 가능 모델 시리즈의 첫 번째 | Hugging Face |
| 샘플 데이터셋과 PyTorch 스크립트 | fine-tuning과 추론, 평가에 쓰는 코드 | NVIDIA/Isaac-GR00T GitHub repo |
| NVIDIA physical AI dataset | GR00T N1 학습에 쓴 데이터의 일부를 오픈소스로 공개한 컬렉션 | Hugging Face |
| SimReady 데이터 | Isaac Sim에서 물리 속성이 붙은 채로 바로 쓸 수 있는 3D 에셋 | 오픈소스 |
| Isaac Sim, Isaac Lab | 학습과 평가에 쓰는 시뮬레이션 프레임워크 | NVIDIA 개발자 사이트 |
| Isaac GR00T Blueprint | 합성 조작 데이터를 대량 생성하는 참조 워크플로 | NVIDIA build 플랫폼 |
fine-tuning은 pre-training된 모델을 특정 과제 데이터로 더 학습시키는 단계를 말한다. 위 표에서 코드와 데이터가 나뉘어 있다는 점이 중요한데, 모델 가중치는 Hugging Face에서, 그 가중치를 다루는 스크립트는 GitHub에서 받는 구성이기 때문이다.
검증된 로봇
원문은 GR00T N1이 하나의 모델과 하나의 가중치로 조작 동작을 낸 humanoid를 이름으로 밝힌다. 다만 공개 자산과 달리 이 부분은 성능 주장이므로, 실제 측정이 이루어진 범위와 구분해서 읽어야 한다.
| 로봇 | 제조사 | 원문이 밝힌 범위 |
|---|---|---|
| GR-1 | Fourier | 하나의 가중치로 조작 동작 수행. 실제 기기 벤치마크의 측정 대상 |
| Neo | 1X | 같은 가중치로 조작 동작 수행 |
수행 가능하다고 적은 동작은 세 가지다. 한 팔 또는 양팔로 물체를 잡고 다루는 동작, 한 팔에서 다른 팔로 물체를 옮기는 동작, 그리고 여러 기술을 이어야 하는 다단계 동작이다. grasping은 물체를 안정적으로 쥐는 동작을 말하며, 원문이 baseline 대비 개선을 가장 분명하게 주장하는 항목이기도 하다.
모델 구조
GR00T N1은 사람의 인지를 본뜬 dual-system 구조다. 느리지만 신중하게 판단하는 계층과 빠르게 움직임을 만들어내는 계층을 나눠 두고 둘을 함께 쓴다.
| 계층 | 구성 | 역할 |
|---|---|---|
| System 2 | NVIDIA-Eagle에 SmolLM-1.7B를 결합한 VLM | 이미지와 지시문(instruction)으로 환경을 해석하고 무엇을 할지 계획한다 |
| System 1 | Diffusion Transformer | System 2가 세운 계획을 연속적인 제어 명령으로 바꾼다 |
두 계층은 느슨하게 이어 붙인 구성이 아니다. 원문은 둘이 tightly coupled 상태이며 post-training 단계에서 함께 최적화된다고 명시한다.
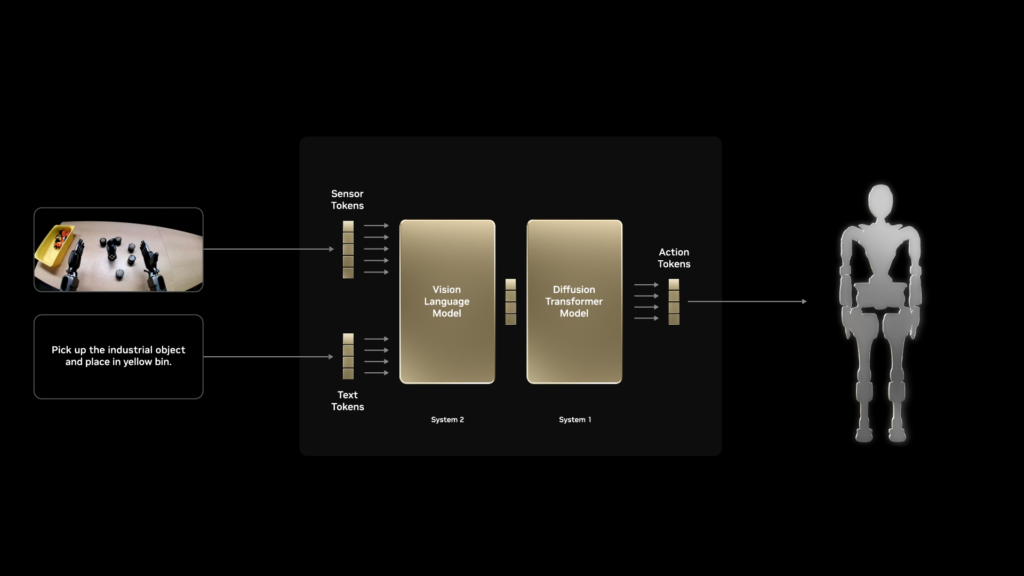
블로그와 논문의 표기가 한 곳에서 어긋난다. 블로그는 backbone을 "NVIDIA-Eagle with SmolLM-1.7B"라고만 적은 반면, 논문은 SmolLM2와 SigLIP-2에서 fine-tuning한 Eagle-2로 명시한다. 따라서 backbone 구성을 인용할 때는 논문 표기를 따른다.
학습 데이터 전략
GR00T N1의 학습 데이터는 data pyramid로 구성된다. data pyramid는 웹 데이터, 합성 데이터, 실제 로봇 데이터를 양이 많은 순으로 쌓아 함께 학습에 쓰는 데이터 전략이다. 아래에서 위로 갈수록 데이터 양은 줄고 embodiment 특수성은 커진다.
| 층 | 데이터 | 얻는 것 | 부족한 것 |
|---|---|---|---|
| 아래 | 인터넷 규모 웹 데이터와 사람 영상 | 사람과 물체의 상호작용 패턴, 자연스러운 동작, 과제의 의미 구조 | 로봇에 줄 모터 제어 신호가 없다 |
| 중간 | Omniverse가 생성한 합성 데이터 | GPU 가속으로 실시간에 사실상 무제한 생성 | sim2real 간극이 남는다 |
| 위 | teleoperation으로 모은 실제 로봇 데이터 | 로봇이 실제로 무엇을 할 수 있는지에 대한 정확한 정보 | 비용과 시간이 많이 든다 |
sim2real은 시뮬레이션에서 학습한 policy를 실제 기기로 옮기는 문제를 말한다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이다. 세 층은 서로의 빈틈을 메우는 관계이며, 맨 위의 실제 로봇 데이터가 중간층이 남긴 sim2real 간극을 실제로 좁힌다.
아래 두 층에는 action 라벨이 없다. 원문은 이 문제의 해법으로 latent action training을 언급한다. latent action은 두 프레임 사이의 시각적 변화를 action 라벨 없이 부호화한 벡터이며, latent action training은 라벨이 없는 대규모 사람 영상에서 감독 신호 없이 학습하게 하는 기법이다. 다만 구현 세부는 적지 않고 논문으로 넘긴다.
합성 데이터의 기여
이 전략을 Isaac GR00T Blueprint로 실행한 결과가 이 글에서 가장 자주 인용되는 수치다.
| 항목 | 값 |
|---|---|
| 생성 소요 시간 | 11시간 |
| 생성한 synthetic trajectory | 75만 개 이상 |
| 사람 시연 데이터(demonstration)로 환산 | 6,500시간, 쉬지 않고 9개월 분량 |
| 합성 데이터를 더했을 때 성능 변화 | 실제 데이터만 썼을 때보다 40% 향상 |
11시간과 9개월의 대비가 이 표의 핵심이다. 즉 사람이 9개월 동안 쉬지 않고 모아야 할 분량을 시뮬레이션이 반나절 만에 만들어냈다는 뜻이다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록을 말한다.
논문 쪽 수치와는 작은 차이가 있다. 논문은 pre-training과 post-training을 합쳐 78만 개로 적는데, 블로그가 "over 750K"로 내림해 적은 것이라 서로 어긋난 값은 아니다. 인용할 때는 논문 숫자를 쓰는 편이 낫다.
개발 워크플로
원문은 GR00T N1을 자기 로봇에 적용하는 절차를 다섯 단계로 제시한다. 각 단계마다 어떤 스크립트를 쓰는지가 함께 적혀 있어, 이 글이 릴리스 공지인 동시에 진입 안내서 역할을 한다.
| 단계 | 하는 일 | 도구 |
|---|---|---|
| 데이터 준비 | 로봇 시연 데이터를 영상, 상태, action 세 쌍으로 묶어 GR00T 데이터셋 형식으로 만든다. 이 형식은 Hugging Face LeRobot 형식과 호환된다 | 사용자 데이터 |
| 데이터 검증 | 만든 데이터가 형식을 지켰는지 확인한다 | 검증 스크립트 |
| post-training | pre-training된 GR00T N1을 자기 데이터셋으로 fine-tuning한다 | PyTorch 스크립트 |
| 추론 | 추론 스크립트를 로봇 컨트롤러나 시뮬레이션 환경에 연결해 대상 하드웨어에서 action을 실행한다 | 추론 스크립트 |
| 평가 | 과제 성공률을 측정한다 | 평가 스크립트 |
첫 단계가 LeRobot 형식과의 호환을 명시한 점이 실무에서 특히 중요하다. 이미 LeRobot 형식으로 데이터를 모아 둔 팀이라면 형식 변환 작업을 크게 줄일 수 있기 때문이다. 관련 내용은 LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch에 정리돼 있다.
하드웨어 요구사항
원문은 필요한 GPU 구성을 용도별로 나눠 밝힌다. NVIDIA 자료 중 이 정도로 구체적인 사양을 적은 사례는 많지 않다.
| 용도 | 구성 |
|---|---|
| post-training 최소 | RTX A6000 1장 또는 GeForce RTX 4090 1장 |
| post-training 권장 (요구가 큰 경우) | DGX Spark 또는 DGX H100 |
| 추론 | RTX A6000 또는 Jetson AGX Orin |
추론 항목에 Jetson AGX Orin이 들어간 점은 배포 형태와 직결된다. 즉 학습은 데이터센터급 장비에서 하더라도, 학습을 마친 모델은 로봇에 실을 수 있는 엣지 모듈에서 실행하는 구성을 전제한다는 뜻이다.
결과
평가는 시뮬레이션과 실제 기기 두 종류로 나뉜다. 시뮬레이션 실험은 벤치마크 세 종을 썼고, 실제 기기 실험은 GR-1 humanoid의 탁상 조작 과제에 집중했다.
시뮬레이션 벤치마크
벤치마크 세 종은 기존 연구가 공개한 오픈소스 둘에 실제 탁상 조작 과제를 본뜬 신규 스위트 하나를 더한 구성이다. 서로 다른 embodiment와 다양한 조작 과제를 함께 재려고 이렇게 골랐다고 원문은 밝힌다. 과제당 시연 데이터는 100개씩 썼다.
| 모델 | RoboCasa | DexMG | GR-1 | 평균 |
|---|---|---|---|---|
| BC Transformer | 26.3% | 53.9% | 16.1% | 26.4% |
| Diffusion Policy | 25.6% | 56.1% | 32.7% | 33.4% |
| NVIDIA Isaac GR00T N1 2B | 32.1% | 66.5% | 50.0% | 45.0% |
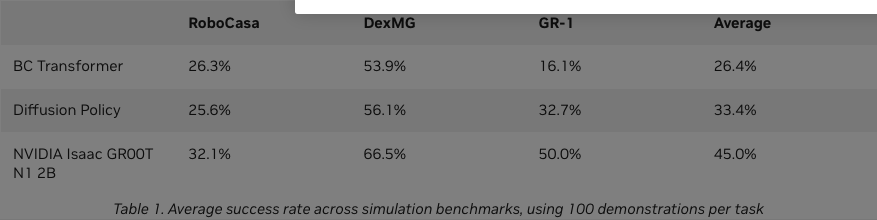
GR00T N1 2B의 평균 45.0%는 두 번째로 높은 Diffusion Policy의 33.4%를 11.6%p 앞선다. 항목별로 보면 격차가 고르지 않은데, GR-1에서 50.0% 대 32.7%로 17.3%p 벌어져 가장 크고 RoboCasa에서 32.1% 대 25.6%로 6.5%p 차이로 가장 작다. RoboCasa 벤치마크 자체는 RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots에 정리돼 있다.
실제 기기 벤치마크
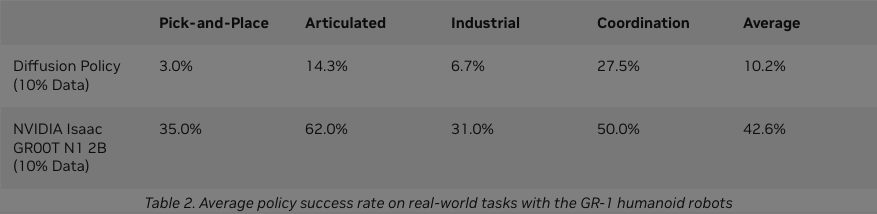
실제 기기 평가는 GR-1 humanoid의 탁상 조작 과제 네 묶음으로 이루어진다. 정밀한 물체 취급, 양손 협응 동작, 공간 인식이 함께 필요한 과제로 골랐다.
| 모델 | Pick-and-Place | Articulated | Industrial | Coordination | 평균 |
|---|---|---|---|---|---|
| Diffusion Policy (데이터 10%) | 3.0% | 14.3% | 6.7% | 27.5% | 10.2% |
| NVIDIA Isaac GR00T N1 2B (데이터 10%) | 35.0% | 62.0% | 31.0% | 50.0% | 42.6% |
| 모델 | Pick-and-Place | Articulated | Industrial | Coordination | 평균 |
|---|---|---|---|---|---|
| Diffusion Policy (전체 데이터) | 36.0% | 38.6% | 61.0% | 62.5% | 46.4% |
| NVIDIA Isaac GR00T N1 2B (전체 데이터) | 82.0% | 70.9% | 70.0% | 82.5% | 76.8% |
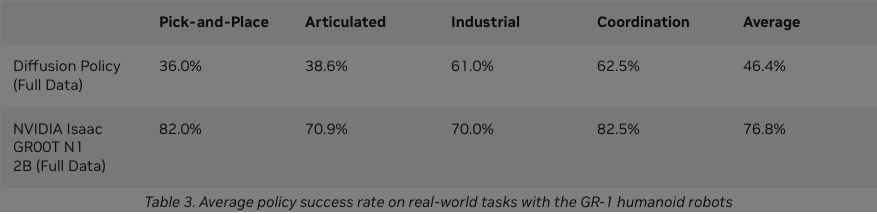
두 표를 겹쳐 보면 데이터 효율의 차이가 드러난다. 학습 데이터를 10%만 준 GR00T N1의 평균 42.6%가 전체 데이터를 쓴 Diffusion Policy의 46.4%에 3.8%p 차이까지 접근한다. 반면 같은 10% 조건의 Diffusion Policy는 평균 10.2%에 머물러 32.4%p 뒤진다. 전체 데이터 조건에서는 76.8% 대 46.4%로 30.4%p 차이가 난다.
정성적 평가도 함께 적혀 있다. 저자들은 Diffusion Policy baseline과 비교해 GR00T N1의 동작이 더 매끄럽고 연속적이며, 특히 작은 post-training 데이터셋으로 fine-tuning했을 때 grasping 정확도의 개선이 두드러진다고 밝힌다. 새 과제를 더 효율적으로 학습하고 지시문을 따르는 정확도도 baseline보다 높다고 덧붙인다.
한계
이 글의 한계는 대부분 자료 유형에서 온다. 연구 논문이 아니라 GTC 2025 발표에 맞춘 릴리스 공지이기 때문이다.
- 실험 설정과 ablation이 없어 표에 적힌 수치가 어떤 조건에서 측정됐는지 이 글만으로는 확인할 수 없다.
- 가장 널리 인용되는 "합성 데이터로 40% 향상"도 어느 과제, 어느 데이터 비율에서 잰 값인지 밝히지 않는다.
- 시뮬레이션 벤치마크 세 종 중 어느 둘이 기존 오픈소스이고 어느 하나가 신규 스위트인지 이름으로 짚지 않는다.
- baseline을 왜 그렇게 골랐는지, 어떤 과제에서 실패했는지를 다루지 않는다.
- backbone 표기와 trajectory 개수가 논문과 조금씩 다르다.
따라서 GR00T N1을 실제로 쓰려는 독자에게 이 글은 진입점으로만 쓰고, 수치와 방법은 논문에서 확인하는 순서가 맞다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Isaac GR00T Blueprint | 합성 조작 데이터를 대량 생성하는 NVIDIA의 참조 워크플로. 11시간에 trajectory 75만 개 이상을 만든 근거 |
| NVIDIA-Eagle | System 2가 쓰는 NVIDIA의 VLM 계열. 이 글은 SmolLM-1.7B를 결합했다고만 적었고 논문은 Eagle-2로 명시한다 |
| SimReady | Isaac Sim에서 물리 속성이 붙은 채로 바로 쓸 수 있게 준비된 3D 에셋 |
| Fourier GR-1, 1X Neo | GR00T N1이 하나의 가중치로 동작을 낸 humanoid 두 종. 실제 기기 벤치마크는 GR-1로 측정한다 |
| Jetson AGX Orin | 추론 배포 대상으로 지목된 엣지 모듈. 학습이 아니라 실행에 쓴다 |
| DGX Spark | 대규모 post-training 권장 구성으로 함께 언급된 데스크사이드 시스템 |
관련 페이지
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 같은 날 공개된 논문이자 이 페이지의 기술 정본. 아키텍처와 데이터 전략의 세부가 전부 여기 있다.
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: 같은 모델을 처음 읽는 사람 눈높이로 풀어 쓴 한국어 해설.
- NVIDIA Isaac GR00T (N1.7): 이 글이 가리키는
NVIDIA/Isaac-GR00Trepo. 이후 N1.7까지 이어지며 backbone과 action space가 바뀌었다. - LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: 다섯 단계 절차의 첫 단계가 요구하는 데이터 형식의 출처.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 시뮬레이션 벤치마크 표의 RoboCasa 항목이 쓰는 환경.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA의 판정 기준을 세운 서베이. 그 기준으로는 GR00T N1이 dual-system에서 빠진다.
- 🤖 [실리콘밸리 RFM 기술 및 현황] 2편 VLM & VLA란 무엇이며, 어떤 구조로 변화해 왔는가: Single Model과 Dual System 두 구조를 대비하며 GR00T N1을 후자의 사례로 든 해설.