Physical AI · ARTICLE · 2025
Vision Language Action Models (VLA) & Policies for Robots
요약
LearnOpenCV가 2025년 4월에 게재한 VLA 튜토리얼이다. RT-2부터 Gemini Robotics까지 아홉 개 모델을 계보 순으로 소개하고, 그중 Octo와 OpenVLA, π0, GR00T N1은 공개 체크포인트를 불러 실제로 실행하는 코드까지 붙였다.
서베이 논문이 아니라 튜토리얼 블로그다. 따라서 이 페이지의 가치는 개별 모델의 아키텍처 근거나 ablation이 아니라 두 가지에 있다. 하나는 글쓴이가 VLA를 정리한 방식, 즉 다섯 유형 분류와 System 1 / System 2 프레임이다. 다른 하나는 네 모델을 실제로 실행해 본 코드 walkthrough이며, 여기서 논문 본문에는 잘 드러나지 않는 입출력 형태와 설정값이 노출된다. 개별 모델의 세부는 저장소에 원논문 페이지가 따로 있으므로 이 페이지는 링크로 넘긴다.
이 글은 LearnOpenCV 로보틱스 시리즈의 7편이다. 앞선 여섯 편은 ROS 2와 Carla 연동, PID 제어, Visual SLAM, LiDAR SLAM을 다뤘고, 이 편에서 처음으로 학습 기반 제어를 꺼낸다.
배경
과제별 policy의 한계
로봇 제어의 전통적 경로는 저수준 과제마다 policy를 따로 만드는 방식이었다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 글쓴이는 이 policy를 두 가지로 나눈다.
- deterministic policy: 환경의 각 상태에 action 하나를 확정해 대응시킨다.
- stochastic policy: 각 상태에 대해 가능한 모든 action 위의 확률 분포를 낸다.
로봇은 목표에 따라 하나 또는 여러 개의 episode를 거친다. episode는 초기 상태에서 종료 상태까지의 한 실행 단위이고, 그 안에서 상태(s), action(a), reward(r), 다음 상태(s')가 이어진다. 이런 agent는 보통 강화학습으로 episode 전체의 reward를 최대화하도록 학습하며, 시행착오에서 최적 행동을 찾는다.
강화학습 대신 imitation learning을 쓰는 경로도 있다. behavioral cloning은 시연 데이터(demonstration)의 observation과 action 쌍을 지도학습으로 흉내 내 올바른 action을 예측하게 만든다.
두 경로 모두 같은 비용 문제를 안는다. 저수준 과제마다, 그리고 하드웨어 구성마다 policy나 heuristic을 따로 만들어야 하므로 데이터와 시간이 많이 든다. 글쓴이는 여기서 LLM의 일반화 능력을 가져와 이 반복을 없애자는 방향을 제시한다.
언어 모델만으로 부족한 부분
LLM은 텍스트 과제에서는 강하지만 로봇이 놓인 물리적 제약을 이해하지 못한다. 그래서 실행 불가능한 subtask를 내놓는다. subtask는 high-level 추론이 텍스트로 내놓는 중간 단계 명령을 말한다.
텍스트만으로는 최종 목표를 온전히 기술하기 어렵고, 섬세한 저수준 동작은 말로 다 적을 수도 없다. 반면 이미지나 영상은 세밀한 policy와 행동을 만들어낼 수 있다. 글쓴이는 이 대목에서 "An image is worth 1000 words"라는 Fred R. Barnard의 문구를 인용한다.
VLM은 이미지와 영상으로 대규모 학습해 일반화가 좋지만 action 데이터가 빠져 있다. 따라서 VLA는 VLM에 두 종류의 토큰을 추가한다.
- 상태 토큰: 센서값, 그리퍼 위치, 관절 각도처럼 로봇 자신의 상태를 담는 단일 토큰이다.
- action 토큰: trajectory를 정밀하게 따라가기 위한 모터 명령 시퀀스를 담는다.
핵심 개념
generalist policy
generalist policy는 과제별 fine-tuning 없이 하나의 모델로 여러 downstream 과제를 푸는 policy를 말한다. 글쓴이는 이를 GRP(Generalist Robot Policy)로 줄여 부르며 RT-2와 π0, GR00T N1을 예로 든다.
기존 policy가 subtask마다 또는 플랫폼마다 학습이 필요했던 것과 달리, generalist policy는 미학습 과제와 새로운 상황, 심지어 다른 하드웨어 구성에서도 동작하는 성질을 목표로 삼는다. 즉 사전에 프로그래밍된 명령에 묶이지 않고 관찰과 이해, 행동의 순환으로 중간 목표를 스스로 밟아 간다는 것이 글쓴이의 설명이다.
emergent capability
emergent capability는 학습 데이터에 없던 조합을 모델이 실행해내는 성질을 말한다. 글쓴이는 이 성질을 generalist policy의 핵심 근거로 삼고, RT-2에서 관찰된 인물 인식과 기호 이해, 추론을 사례로 든다.
그리고 이 성질의 원인을 웹 스케일 pre-training에서 찾는다. 로봇 데이터만으로는 나올 수 없고 인터넷 규모의 vision-language 데이터가 함께 있어야 나온다는 관점이다.
System 1과 System 2
글쓴이는 2025년 4월 시점의 SOTA VLA를 Daniel Kahneman의 dual-process theory에 빗대 정렬한다. dual-process theory는 인지를 빠르고 자동적인 System 1과 느리고 숙고적인 System 2로 나눠 보는 심리학 이론이다. 이 프레임이 글 전체의 배열 기준이다.
| 구분 | 담당 모델 | 역할 | 대표 사례 |
|---|---|---|---|
| System 2 ("thinking slow") | VLM | vision과 텍스트를 문맥으로 받아 복잡한 상황을 판단하고 목표를 여러 subtask로 나눈다. 상위 계획자 역할이다 | GR00T N1의 VLM, Helix의 S2 |
| System 1 ("thinking fast") | Transformer decoder 또는 diffusion | 저수준 제어와 정교한 동작을 담당한다. 상위가 넘긴 경로를 실행해 민첩한 모터 action을 낸다 | GR00T N1의 DiT, Helix의 S1 |
이 두 구조의 대안으로 글쓴이는 Physical Intelligence의 π0을 든다. π0은 단계를 나누지 않은 단일 generalist policy 계열이며, dual-system과 대비되는 계열로 배치된다.
다섯 유형 분류
글쓴이는 VLA를 다섯 유형으로 나눈다. 다른 자료에서 잘 보이지 않는 분류이므로 이 글 고유의 기여로 기록해 둘 만하다. 분류 기준은 high-level 계획을 무엇이 맡고 저수준 실행을 무엇이 맡느냐다.
| 유형 | 구성 | 예시 |
|---|---|---|
| Type-1 | VLM 또는 LLM이 high-level 계획을 맡고 저수준 제어는 개별 policy가 처리한다 | SayCan, PaLM-E |
| Type-2 | 이미지 또는 영상 생성 모델이 high-level 계획을 맡는다 | SuSIE (UC Berkeley) |
| Type-3 | Type-1과 Type-2를 결합해 중간 단계를 계획한다 | HybridVLA |
| Type-4 | 단일 VLM이 perception과 계획, 제어를 end-to-end로 처리한다 | 원문에 예시 없음 |
| Type-5 | VLM이 high-level 계획을 맡고 diffusion이 실행한다 | GR00T N1, Octo |
모델 계보
RT-2
RT-2는 Google DeepMind Robotics가 만든 비공개 모델이며, 글쓴이에 따르면 VLA라는 용어 자체가 이 논문에서 나왔다. backbone은 vision 쪽 PaLI-X 55B와 embodied 쪽 PaLM-E 12B 두 개다. 여기에 vision 데이터와 가중치를 높인 로봇 action 데이터를 함께 학습시킨다.
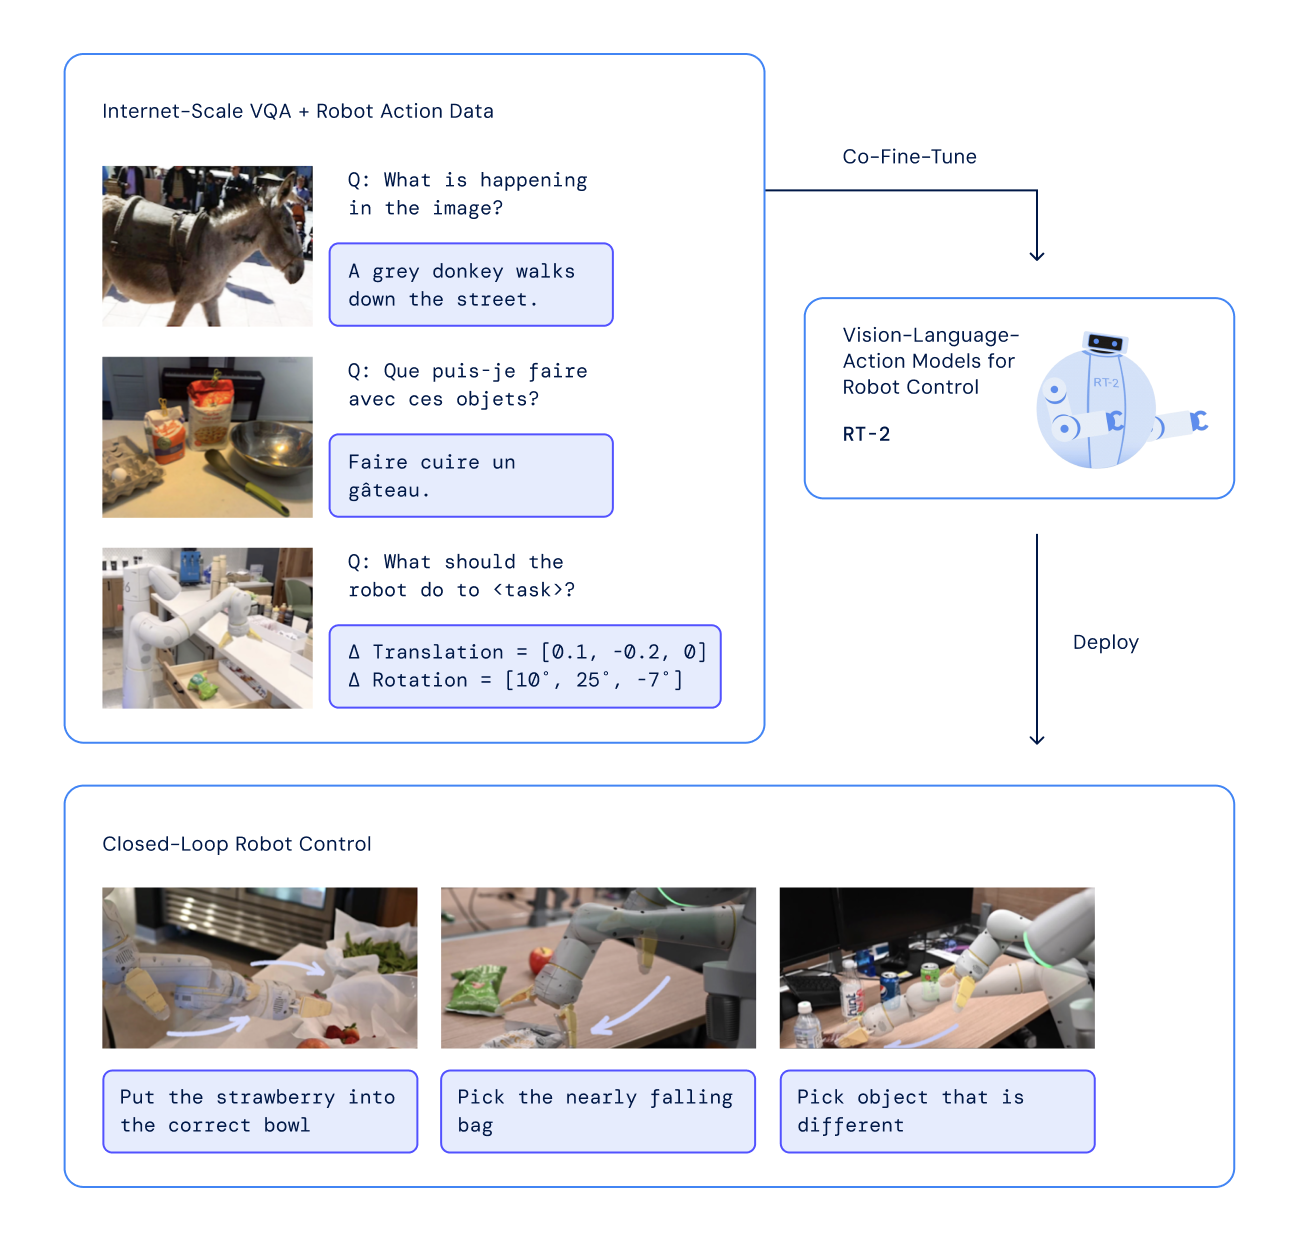
co-fine-tuning은 로봇 데이터와 웹 데이터를 한 배치에 섞어 함께 fine-tuning하는 레시피다. Figure 2의 왼쪽 상자가 그 배치를 그대로 보여준다. "What is happening in the image?"에 "A grey donkey walks down the street."로 답하는 일반 VQA, 프랑스어 질의에 프랑스어로 답하는 다국어 VQA, 그리고 "What should the robot do to <task>?"에 ΔTranslation = [0.1, -0.2, 0]과 ΔRotation = [10°, 25°, -7°]로 답하는 로봇 질의가 한 묶음에 들어간다. 학습이 끝나면 아래쪽 closed-loop 제어로 배포되어 "Put the strawberry into the correct bowl" 같은 지시문(instruction)을 수행한다.
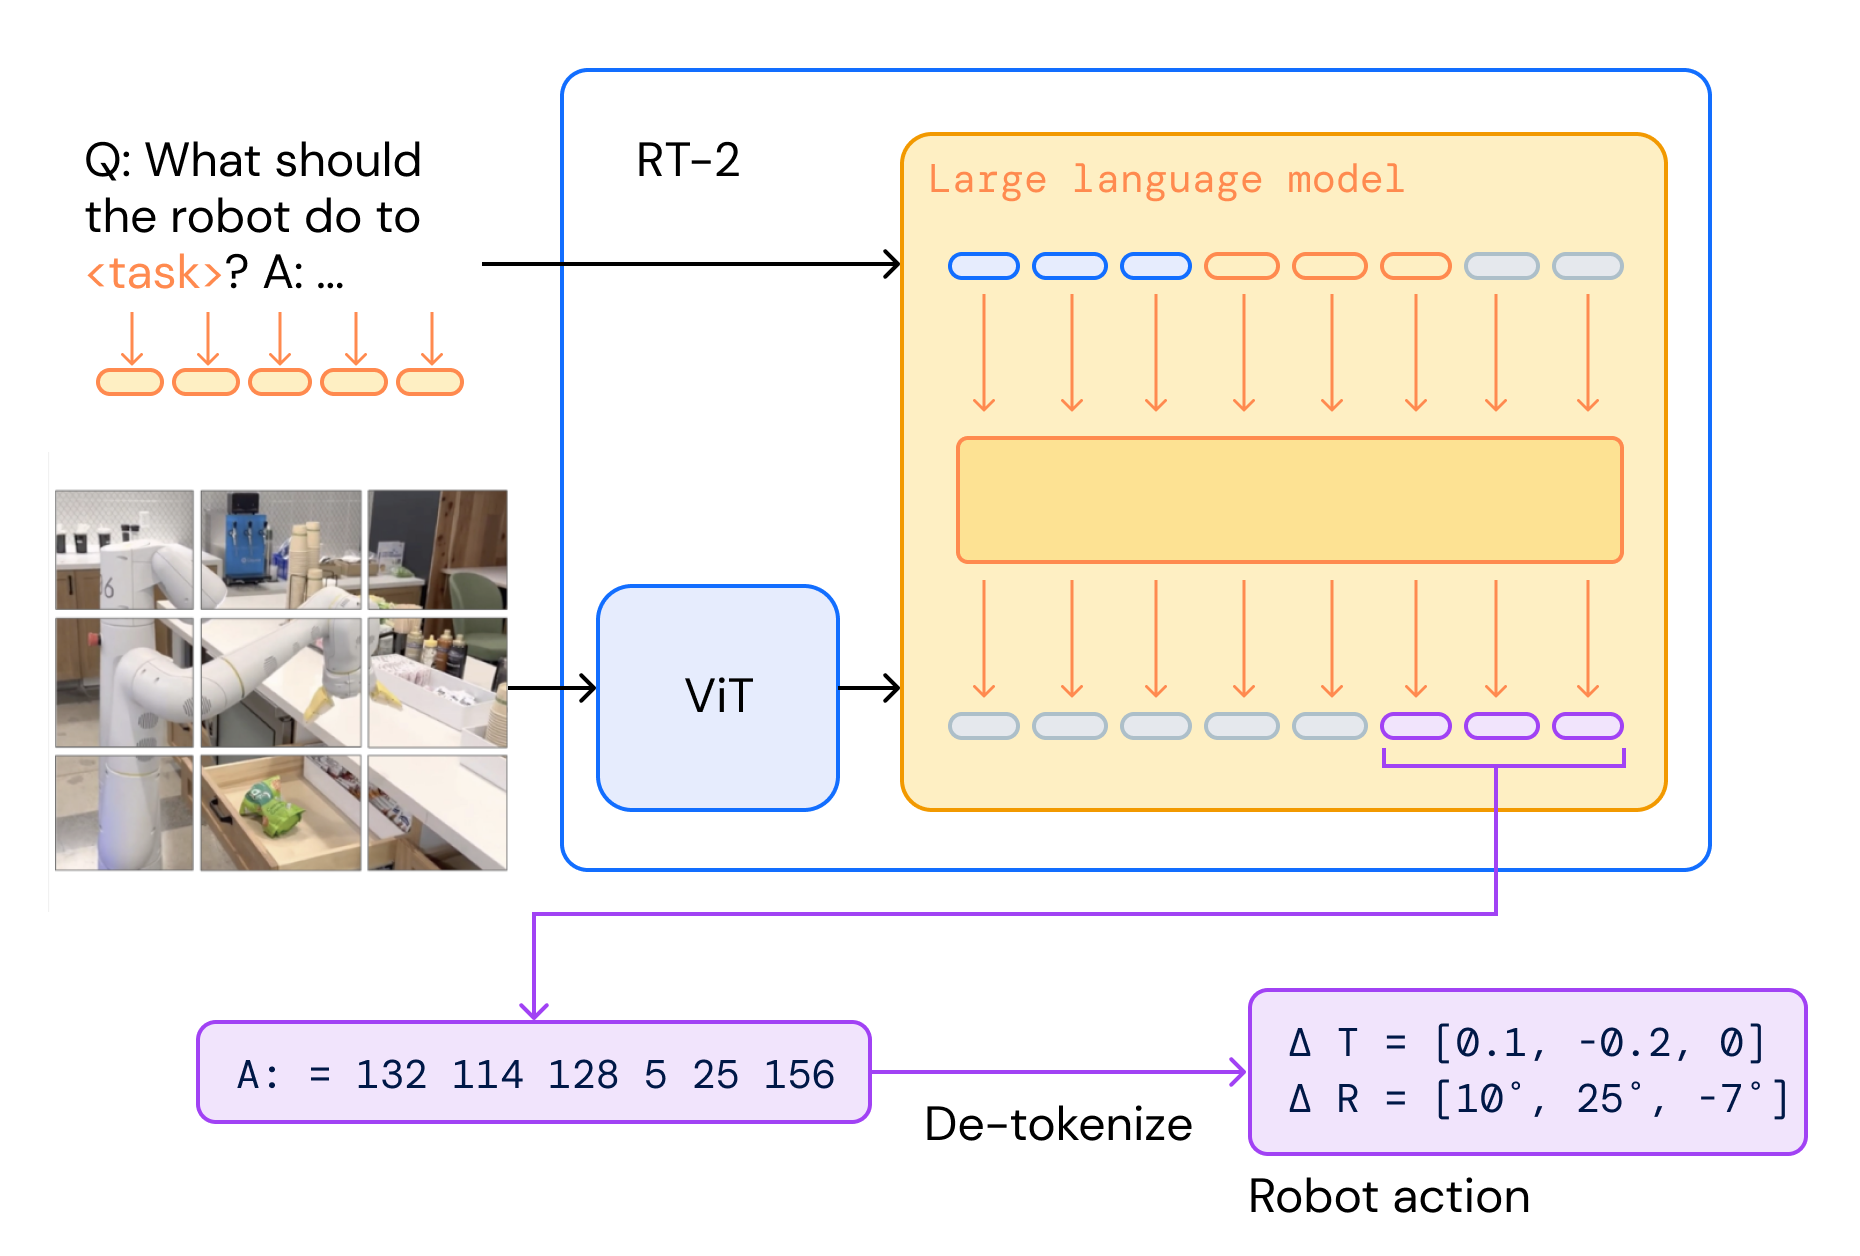
내부 동작은 세 단계다. 카메라 이미지가 패치로 나뉘어 ViT를 통과하고, "What should the robot do to <task>? A:" 형태의 질의가 토큰화되어 함께 LLM에 들어간다. LLM이 내놓은 출력은 "A: = 132 114 128 5 25 156" 같은 숫자열이며, 이를 de-tokenize하면 end-effector의 병진 변화량과 회전 변화량이 된다. 즉 LLM이 텍스트를 내놓듯 로봇 제어 명령을 그대로 생성한다.
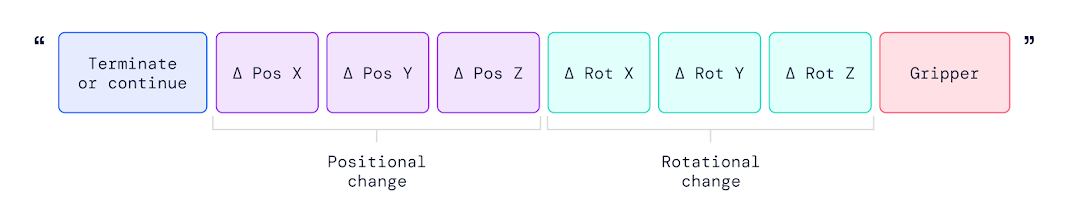
출력 문자열의 구조는 8개 슬롯이다. 첫 슬롯이 종료 여부를 정하고, 다음 세 슬롯이 위치 변화(ΔPos X, Y, Z), 그다음 세 슬롯이 회전 변화(ΔRot X, Y, Z), 마지막 슬롯이 그리퍼 개폐를 담는다.
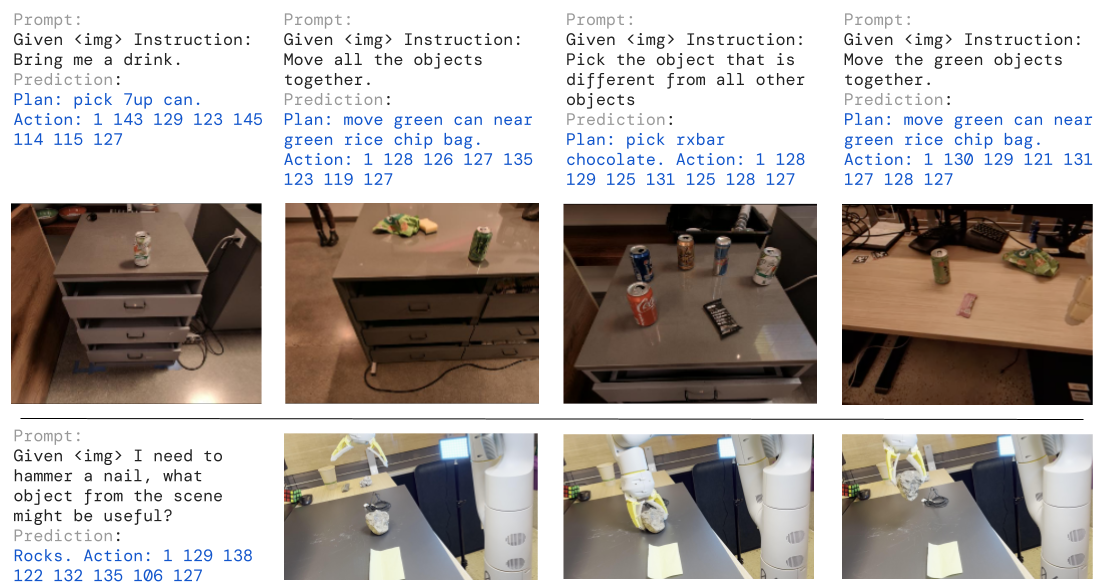
RT-2는 단순 암기가 아니라 chain-of-thought 추론을 거쳐 학습한 개념을 새 상황에 적용한다는 것이 글쓴이의 설명이다. Figure 5가 그 형태를 보여준다. "Bring me a drink."에는 "Plan: pick 7up can."을 먼저 내놓고 뒤에 "Action: 1 143 129 123 145 114 115 127"을 붙인다. "I need to hammer a nail, what object from the scene might be useful?"에는 장면에 망치가 없자 "Rocks."로 답하고 그에 맞는 action을 낸다.
RT-2에서는 학습에 없던 과제를 푸는 emergent capability가 관찰됐다. 글쓴이는 인물 인식과 기호 이해, 추론을 예로 들고 그 원인을 웹 스케일 학습에서 찾는다. 과제별 policy를 제거한 채 실행 가능한 행위를 직접 내놓은 첫 사례라는 것이 글의 평가다.
세부는 RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control에 정리돼 있다.
Octo
Octo는 UC Berkeley가 공개한 93M 규모의 Transformer 기반 generalist policy다. 학습 데이터는 Open X-Embodiment의 로봇 시연 데이터 80만 건이다. 글쓴이는 이 모델이 RT-2 55B급 모델과 대등한 성능을 낸다고 적는다.
처리 경로는 두 가지 입력이 하나의 Transformer로 합쳐지는 형태다.
- 지시문은 language encoder를 거쳐 task 토큰이 된다.
- 이미지는 패치로 나뉘어 CNN encoder를 거쳐 observation 토큰이 된다.
- Transformer 출력 임베딩을 diffusion head가 action 토큰으로 디코딩한다.
저자들은 이산 action 토큰보다 diffusion 기반 decoder가 더 낫다고 보고했다. 손목 카메라와 3인칭 카메라 어느 쪽 입력도 받는 유연성이 Octo의 특징이며, 새 로봇 구성이나 새 action space에 붙이려면 작은 시연 데이터셋으로 fine-tuning하면 된다. 변종은 Octo-Tiny, Octo-Small, Octo-Base 세 가지이고 Base가 약 93M이다.
OpenVLA
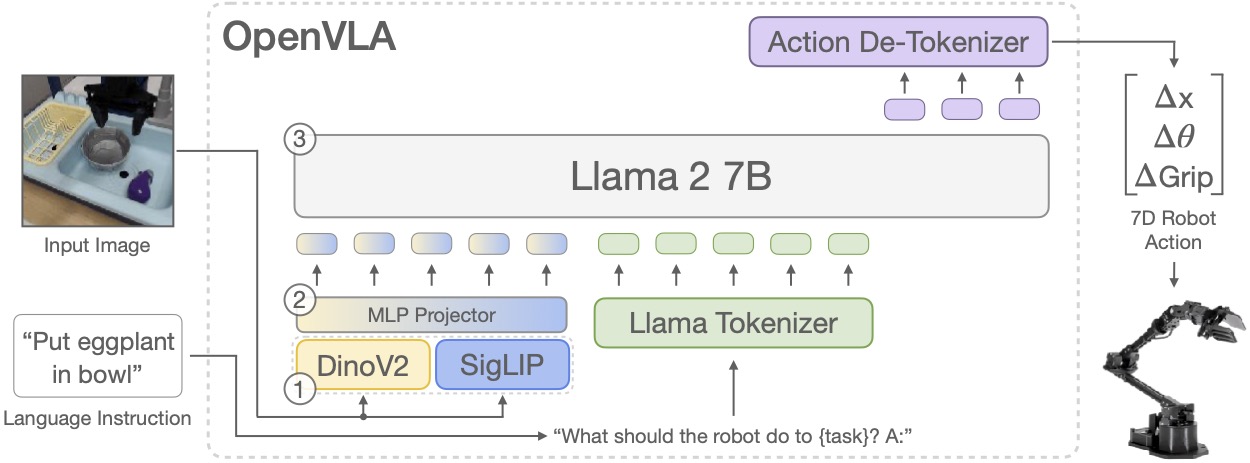
OpenVLA는 Open X-Embodiment의 97만 episode로 학습한 7B 오픈소스 모델이다. 구성 요소는 셋이다.
| 구성 요소 | 내용 | 역할 |
|---|---|---|
| vision encoder | DINOv2 약 300M + SigLIP 약 400M | 이미지를 패치 임베딩으로 만든다. DINOv2는 공간 관계에, SigLIP은 언어 정렬에 강하다 |
| projector | MLP | vision 임베딩을 LLM의 공유 임베딩 공간으로 옮긴다 |
| LLM | Llama 2 7B | 토큰화된 지시문과 vision 임베딩을 한 시퀀스로 받아 Δx, Δθ, ΔGrip을 낸다 |
Figure 6에서 확인되듯 프롬프트 형식은 RT-2와 같은 "What should the robot do to {task}? A:"이고, 언어 입력은 "Put eggplant in bowl" 같은 지시문이다. 출력 토큰은 action de-tokenizer를 거쳐 7차원 제어값이 된다.
글쓴이가 특히 강조하는 대목은 vision encoder를 얼리지 말라는 것이다. action 예측이라는 새로운 과제에 맞추려면 vision encoder 층까지 함께 학습해야 한다는 조언이다.
평가 플랫폼은 Franka Emika Panda 7자유도 팔이고 control frequency는 5Hz다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하므로, 5Hz는 1초에 5번 새 action을 낸다는 의미다. LoRA 같은 PEFT로 fine-tuning한 모델도 원본과 대등했다는 실험 결과가 함께 실려 있다.
글쓴이가 흥미롭게 짚는 저자들의 제안은 VLA도 LLM과 똑같이 next-token prediction과 cross-entropy loss로 학습하면 된다는 점이다. 로봇의 action space 전체를 덮는 데 255개 action 토큰이면 충분하다. 성능은 파라미터가 7분의 1인데도 RT-2-X 55B를 앞섰다. 다만 웹 데이터로 학습하지 않은 탓에 분포 밖 입력에서는 RT-2보다 약하고, 그 경우 미학습 분포로 fine-tuning하면 빠르게 적응한다.
세부는 OpenVLA: An Open-Source Vision-Language-Action Model에 있다.
QUAR-VLA
QUAR-VLA는 MiLAB이 사족 보행 로봇을 겨냥해 만든 VLA다. 다리 여럿을 조율하고 gait를 관리해야 하는 locomotion 문제를 다룬다. locomotion은 다리로 이동하는 과제 영역을 말한다.
학습 데이터는 복잡한 지형에서의 주행과 locomotion을 담았고 실제 데이터와 합성 데이터를 함께 쓴다. 파생 모델 QUART-2는 observation 이미지 묶음과 사용자 지시문을 받아 토큰화한 뒤 pre-training된 VLM에 넣어 2Hz로 이산 action 토큰을 낸다. 연속 action space는 255개 구간으로 나눠 학습과 실행에 쓴다.
ALOHA
ALOHA는 모델이 아니라 하드웨어다. 정식 명칭은 A Low-cost Open-source Hardware System for Bimanual Teleoperation이고, 약 2만 달러로 만들 수 있는 양팔 teleoperation 플랫폼이다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식을 말한다.
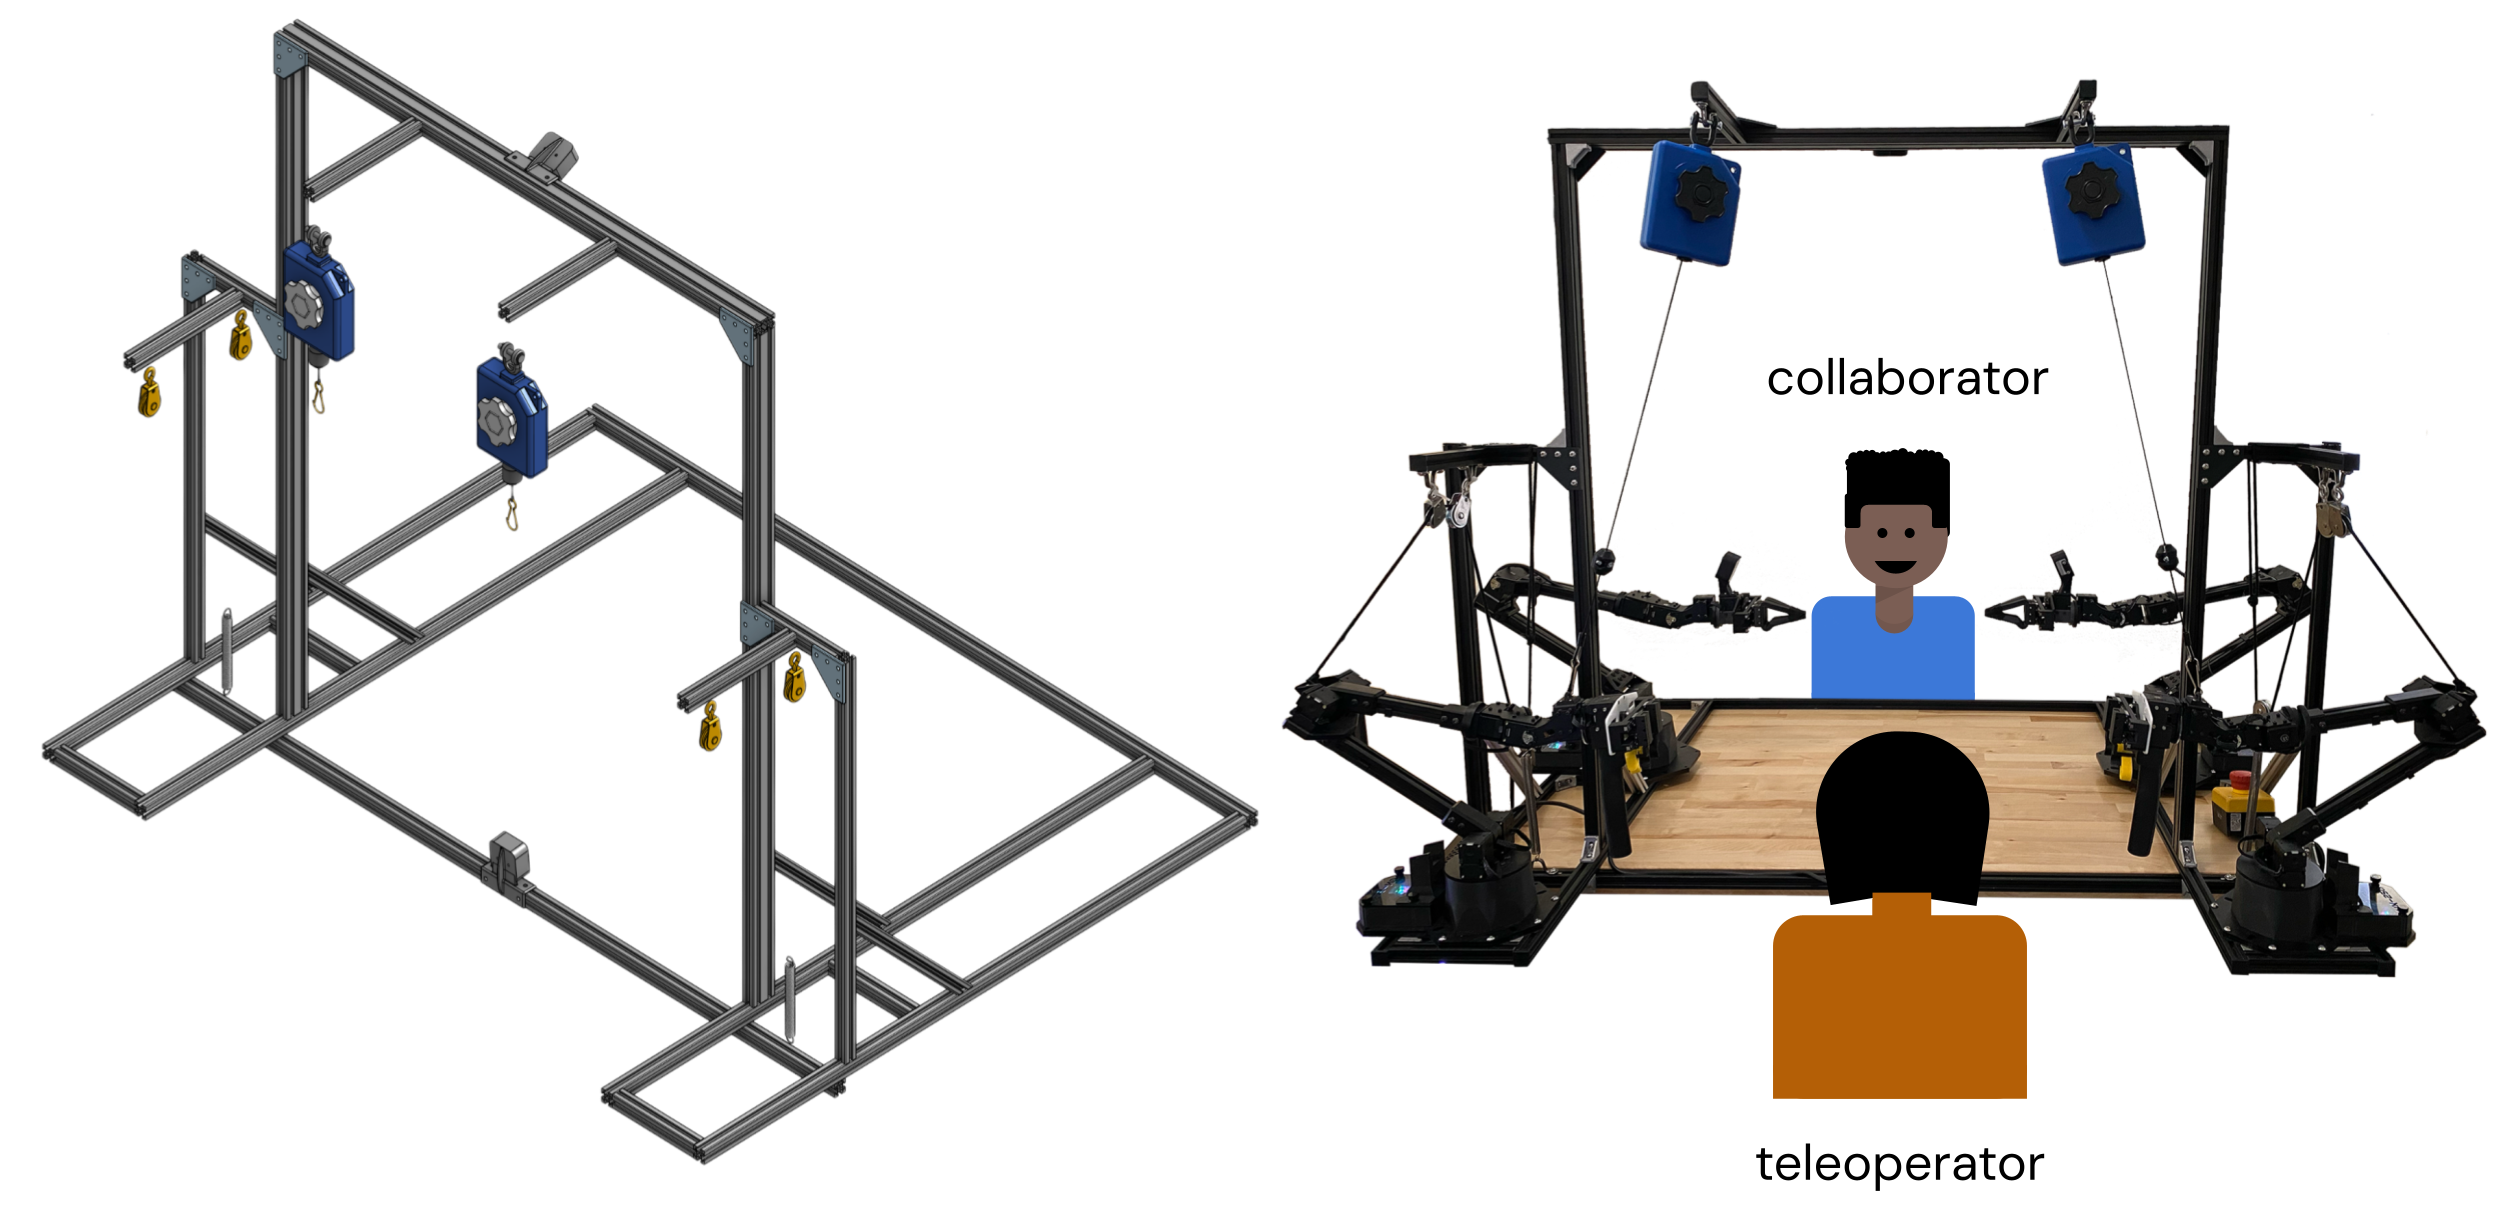
ALOHA 팀은 하드웨어 설계도와 3D 프린팅 지침까지 전부 공개해 누구나 복제본을 만들 수 있게 했다. 원래 ALOHA 자체에는 VLA가 들어 있지 않다. 그러나 연구 커뮤니티가 양팔 manipulation 평가대로 이 플랫폼을 쓰면서 사실상 공용 테스트베드가 됐고, Mobile ALOHA와 OpenVLA-OFT, π0, RDT-1B가 대표 사례다. 글쓴이는 LeRobot의 act_aloha_sim_insertion_human 데이터셋을 rerun.io로 시각화한 화면도 함께 싣는다.
플랫폼과 ACT의 세부는 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware에 있다.
π0과 π0-FAST
π0은 Physical Intelligence의 Vision-Language-Action Flow Model이며 π0과 π0-FAST 두 변종이 있다. backbone은 pre-training된 PaliGemma 3B이고 여기에 300M 규모의 action expert가 붙는다. 학습 데이터는 π Cross-Embodiment Robot 데이터셋이다.
두 부분의 역할 분담이 이 모델의 설계 핵심이다.
| 구성 요소 | 내부 구성 | 무엇을 보는가 |
|---|---|---|
| VLM | SigLIP 이미지 encoder + Gemma 언어 모델 | 미래의 상태 토큰과 action 토큰은 보지 못한다. 사전 지식으로 시각 정보를 해석하는 역할에 머문다 |
| action expert | 별도 300M 가중치 | vision, 언어, 상태 토큰 전부를 참조해 장면 전체에 맞는 action을 만든다 |
출력 방식은 이산 토큰 하나가 아니라 연속 시퀀스다. π0은 conditional flow matching으로 H=50 길이의 연속 action 시퀀스를 낸다. flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다. 이미지 생성 diffusion처럼 무작위 noise에서 출발해 New_Action = Old_Action + step_size × v_θ 형태의 갱신을 반복하며 매끄러운 모터 명령에 수렴한다.
이 선택의 이유는 제어 주기다. 기존 VLA가 쓰던 autoregressive 이산 토큰화는 π0이 목표로 하는 50Hz급 실시간 제어에 비효율적이다.
π0-FAST는 반대 방향을 택한다. autoregressive 방식으로 돌아가되 토큰화를 바꿔 FAST(Frequency-space Action Sequence Tokenization)를 도입한다. FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이며, action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음을 말한다.
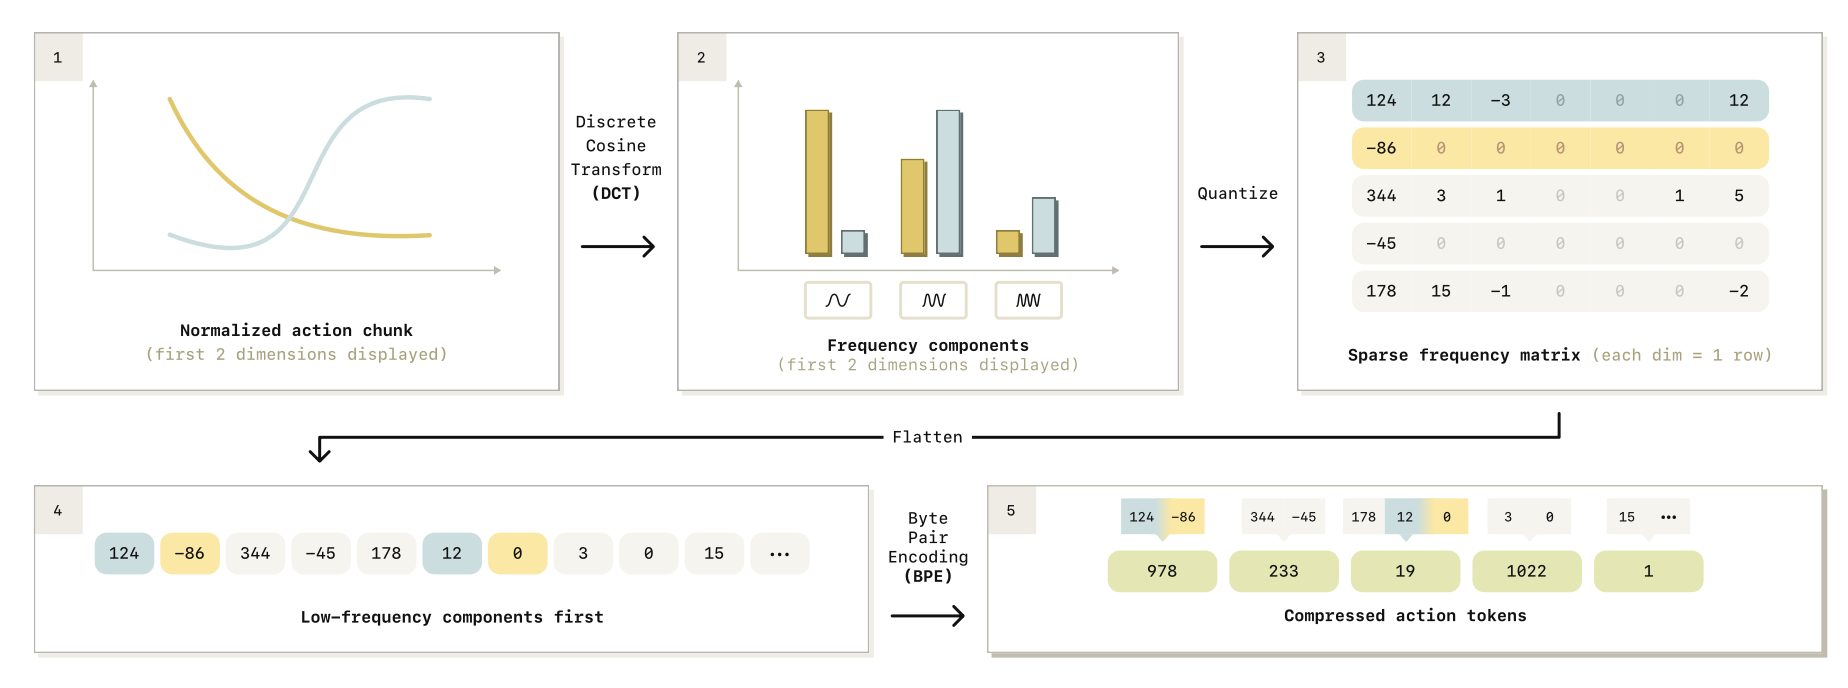
| 단계 | 처리 | 산출물 |
|---|---|---|
| 1 | 정규화 | normalized action chunk |
| 2 | Discrete Cosine Transform | 주파수 성분 |
| 3 | 양자화 | 희소 주파수 행렬 (차원 하나가 한 행) |
| 4 | flatten | 저주파 성분이 앞에 오는 1차원 수열 |
| 5 | Byte Pair Encoding | 압축된 action 토큰 |
DCT가 시간 영역을 주파수 영역으로 옮기면 저주파와 고주파 계수 목록이 나온다. 저주파는 느리고 매끄러운 변화에, 고주파는 빠르고 급격한 변화에 대응한다. 실제 장면에서는 대개 저주파 성분에 의미 있는 정보가 담기므로 고주파는 무시하거나 더 압축할 수 있고, 그만큼 중복이 줄어 효율과 action 충실도가 함께 올라간다.
세부는 π0: A Vision-Language-Action Flow Model for General Robot Control에 있다.
Helix
Helix는 Figure AI가 humanoid 제어를 겨냥해 만든 비공개 generalist VLA다. 약 500시간 분량의 고품질 멀티로봇 데이터를 지도학습으로 사용했고, GR00T N1과 유사한 분리형 dual-system 구조를 제안한다.
| 구성 | 규모 | 입력 | 출력과 주기 |
|---|---|---|---|
| S2 | 인터넷 규모로 pre-training된 7B 오픈웨이트 VLM | 단안 카메라 이미지, 손목 자세와 손가락 위치를 담은 로봇 상태, 자연어 명령 | 과제 관련 의미 정보를 하나의 연속 latent 벡터로 압축한다 |
| S1 | 80M cross-attention encoder-decoder Transformer | S2와 같은 이미지와 상태를 더 높은 주기로 처리 | 200Hz closed-loop 제어 |
S1의 vision backbone은 완전 convolution 기반의 다중 스케일 구조이며 전부 시뮬레이션 안에서 수행한 pre-training으로 초기화했다. 과제 조건 부여는 S2가 넘긴 latent 벡터를 S1의 토큰 공간으로 투영한 뒤 S1의 vision feature와 시퀀스 차원에서 이어붙이는 방식이다. 학습은 raw 픽셀과 텍스트 명령을 연속 action으로 잇는 표준 회귀 손실로 이뤄진다.
글쓴이가 꼽는 Helix의 특징은 넷이다.
- 여러 로봇이 실시간으로 협업하며 정교한 동작을 조율할 수 있다.
- 머리 시선과 손목, 상체 자세, 개별 손가락까지 humanoid 상반신 전체를 높은 주기로 제어한 첫 VLA다.
- 과제별 fine-tuning 없이도 분포 밖 상황에서 잘 동작한다.
- 전부 로봇 위에서 실행되어 전력 소모가 적고 BMW 공장에 상용 배치됐다.
배경 설명도 붙는다. 초기 Figure 로봇은 GPT-4o로 구동됐으나 그런 대형 모델을 실행하는 것은 현실적이지 않아 OpenAI와의 협업을 끝내고 자체 VLA를 만들었다는 것이다.
세부는 Helix: A Vision-Language-Action Model for Generalist Humanoid Control에 있다.
GR00T N1
GR00T N1은 Helix와 같은 설계 원칙을 따르는 NVIDIA의 오픈 foundation model이다. 2B 규모이고 backbone 이름은 eagle2_hg_model이다. 학습 데이터는 Omniverse와 Cosmos에서 만든 합성 데이터와 실제 humanoid 데이터를 합친 것이며, pre-training된 policy를 다른 embodiment로 옮겨 쓸 수 있다.
observation과 지시문, 로봇 상태가 토큰으로 인코딩되어 System 2와 System 1을 차례로 통과한다. System 2인 VLM이 vision과 언어로 물리 세계를 해석해 적절한 action을 계획하면, System 1인 Diffusion Transformer가 그 지시를 받아 denoising으로 120Hz의 매끄럽고 정밀한 모터 action을 만든다.
세부는 GR00T N1: An Open Foundation Model for Generalist Humanoid Robots에 있다.
Gemini Robotics
Gemini Robotics는 Google DeepMind가 Gemini 2.0 멀티모달 위에 올린 계열이며 20Hz의 고주파 모터 제어를 낸다. 두 모델로 구성된다.
| 모델 | action 데이터 fine-tuning | 근거 |
|---|---|---|
| Gemini Robotics-ER | 하지 않는다 | Gemini 2.0의 공간 관계 이해와 인터넷 pre-training 지식만으로 동작한다 |
| Gemini Robotics | 한다 | ER을 확장해 직접 제어까지 담당한다. perception, 추론, action 생성을 별도 diffusion 없이 한 모델로 처리한다 |
글쓴이는 이 계열의 요점을 파이프라인 대비로 설명한다. 전통적 경로가 장면 이해에서 과제 계획, 동작 계획, 제어로 이어지는 네 단계였다면, Gemini Robotics는 perception과 추론, action을 하나의 모델이 처리한다.
배치는 두 곳으로 나눈다. high-level 추론과 perception을 맡는 distillation 버전은 클라우드에 두고, 네트워크 지연을 메우기 위해 저수준 action 시퀀스를 만드는 action decoder는 로봇의 온보드 컴퓨터에서 실행한다.
코드 walkthrough
이 글이 원논문 해설과 구분되는 지점이 코드 walkthrough다. 네 모델을 공개 체크포인트로 실행해 입출력 형태를 그대로 노출한다. 전체 코드는 회원 등록 게이트 뒤에 있고 본문에는 스니펫만 열려 있다.
| 대상 | 체크포인트 | 프레임워크 | 실행 내용 |
|---|---|---|---|
| Octo | hf://rail-berkeley/octo-small |
Octo 저장소, JAX | bridge 데이터셋 trajectory에 추론을 실행해 예측 action과 정답 action을 차원별로 비교한다 |
| OpenVLA | openvla/openvla-7b |
Hugging Face Transformers | 카메라 이미지와 프롬프트로 7자유도 action을 한 번 예측한다 |
| π0 | lerobot/pi0 |
LeRobot | pusht와 aloha 환경에서 평가하고 커스텀 데이터셋으로 fine-tuning한다 |
| GR00T N1 | nvidia/GR00T-N1-2B |
Isaac-GR00T | 시뮬레이터 데이터셋으로 modality 구성과 action 출력 형태를 확인한다 |
Octo 추론 노트북
글쓴이는 Octo 원본 예제 노트북에 오류가 많아 직접 고쳤다고 밝힌다. 실제로 스니펫에 scipy==1.11.0 고정과 jaxlib 버전 불일치 대응 주석이 남아 있다.
체크포인트를 불러오면 모델 사양이 그대로 출력된다. window size는 2이고 7차원 action을 미래 4스텝까지 예측한다. observation은 image_primary가 256×256×3, image_wrist가 128×128×3이며, task에는 길이 16의 attention_mask와 input_ids로 표현된 language_instruction이 들어간다.
평가는 Open X-Embodiment의 bridge 데이터셋 trajectory 하나로 진행한다. 지시문은 "Place the can to the left of the pot."이고, action 차원 레이블은 x, y, z, yaw, pitch, roll, grasp 일곱 개다. model.sample_actions()가 돌려주는 값은 정규화된 action이므로 데이터셋 통계의 평균과 표준편차로 역정규화해야 실제 제어값이 된다.
OpenVLA 최소 추론 경로
OpenVLA는 Hugging Face AutoModelForVision2Seq로 그대로 불러 쓴다. torch_dtype=torch.bfloat16과 low_cpu_mem_usage=True, trust_remote_code=True를 지정하고 GPU에 올린다.
프롬프트는 "In: What action should the robot take to {<INSTRUCTION>}?\nOut:" 형식이고, vla.predict_action(**inputs, unnorm_key="bridge_orig", do_sample=False) 한 줄이 7자유도 action을 낸다. unnorm_key가 역정규화에 쓸 데이터셋 통계를 고르는 자리다.
π0 평가와 fine-tuning
π0 부분은 LeRobot 저장소를 clone한 뒤 pip install -e ".[pi0]"와 ".[aloha, pusht]"로 의존성을 설치한다. backbone인 PaliGemma가 접근 제한 저장소이므로 huggingface-cli login이 필요하다.
평가는 lerobot/scripts/eval.py에 --policy.path=lerobot/pi0 --env.type=pusht --eval.batch_size=10 --eval.n_episodes=10을 넘겨 실행한다. 출력 로그에 policy 설정이 그대로 찍히는데, 논문 본문보다 구체적인 값이 여기서 드러난다.
| 설정 키 | 값 | 뜻 |
|---|---|---|
chunk_size, n_action_steps |
50 | 한 번에 예측하고 실행하는 action chunk 길이. 논문의 H=50과 일치한다 |
n_obs_steps |
1 | policy가 참조하는 observation 개수. 히스토리를 쌓지 않는다 |
max_state_dim, max_action_dim |
32 | 서로 다른 로봇의 상태와 action 벡터를 같은 크기로 채워 넣는 상한 |
freeze_vision_encoder |
True | vision encoder 가중치를 고정한 채 평가한다 |
resize_imgs_with_padding |
(224, 224) | 입력 이미지를 224×224로 맞춘다 |
num_steps |
10 | flow matching 적분 스텝 수 |
tokenizer_max_length |
48 | 지시문 토큰 길이 상한 |
optimizer_lr |
2.5e-05 | fine-tuning 학습률. 30,000스텝 뒤 2.5e-06으로 감쇠한다 |
평가 환경 쪽 값도 함께 찍힌다. pusht는 episode 길이 300, 초당 10프레임이며 action이 2차원, 입력 이미지가 384×384×3이다.
fine-tuning은 lerobot/scripts/train.py에 --policy.path=lerobot/pi0 --dataset.repo_id=danaaubakirova/koch_test를 넘기는 한 줄로 끝난다. 실행 프레임워크의 세부는 LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch에 있다.
여기서 눈에 띄는 대비가 하나 있다. OpenVLA 절에서 글쓴이는 vision encoder를 얼리지 말라고 강조했지만, LeRobot의 π0 기본 설정은 freeze_vision_encoder=True다. 글은 이 차이를 언급하지 않는다.
GR00T N1 추론과 action 출력
GR00T N1은 Isaac-GR00T 저장소를 clone하고 Python 3.10 환경에 flash-attn==2.7.1.post4까지 설치한 뒤 Gr00tPolicy로 불러온다. embodiment tag는 gr1, 데이터 구성은 gr1_arms_only, 데이터셋은 저장소가 제공하는 demo_data/robot_sim.PickNPlace다. embodiment tag는 어떤 로봇의 데이터인지 가리키는 문자열 키이며, 상태와 action 배열을 해석할 modality 구성을 고른다.
print(policy.model)이 찍는 구조가 이 walkthrough의 가장 큰 소득이다. 본문 설명에는 "2B 모델"과 "Diffusion Transformer"만 적혀 있지만 출력은 층 단위까지 보여준다.
| 구성 요소 | 코드상 구현 | 규모 |
|---|---|---|
| vision encoder | SiglipVisionModel |
27층, hidden 1152, 패치 14×14 |
| language model | LlamaForCausalLM |
12층, hidden 2048, vocabulary 49,164 |
| projector | mlp1 (LayerNorm, Linear, GELU, Linear) |
4608 → 2048 → 2048, 이어서 2048 → 1536 |
| action head | FlowmatchingActionHead 안의 DiT |
BasicTransformerBlock 16개, hidden 1536, dropout 0.2 |
| 상태와 action 인코딩 | CategorySpecificMLP, MultiEmbodimentActionEncoder |
embodiment별로 다른 층을 고르는 구조 |
action head 이름이 FlowmatchingActionHead라는 점은 본문 서술과 어긋난다. 본문은 System 1을 diffusion으로 설명하지만 코드는 flow matching이다. DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조이므로 backbone 계열은 같지만 학습 목표가 다르다.
modality 구성도 그대로 찍힌다. video는 video.ego_view 하나, 상태는 좌우 팔과 좌우 손 네 개, 언어는 annotation.human.action.task_description이다. action의 delta_indices는 0부터 15까지이며, 이것이 예측 지평 16스텝에 대응한다.
| 부위 | 출력 키 | 모양 | 자유도 구성 |
|---|---|---|---|
| 팔 (좌, 우) | action.left_arm, action.right_arm |
(16, 7) | 어깨 pitch, roll, yaw / 팔꿈치 pitch / 손목 yaw, roll, pitch |
| 손 (좌, 우) | action.left_hand, action.right_hand |
(16, 6) | 새끼, 약지, 중지, 검지 손가락과 엄지 회전, 엄지 굽힘 |
| 허리 | 문서상 기재 | (16, 3) | torso waist yaw, pitch, roll |
모양 (16, N)에서 16은 예측 지평으로 timestep t부터 t+15까지를 뜻하고 N은 해당 부위의 자유도다. 상태 쪽은 state.left_arm이 (1, 7), state.left_hand가 (1, 6)으로 현재 시점 하나만 들어온다. 즉 현재 상태 한 장을 보고 미래 16스텝을 한 번에 내놓는 action chunk 구조다. 허리 3자유도는 문서 설명에는 있으나 gr1_arms_only 구성의 출력에는 나타나지 않는다.
예제 데이터셋의 과제 설명은 "pick the squash from the counter and place it in the plate"이고, 시각화 코드는 150스텝 동안 오른팔 7관절의 상태값과 정답 action을 겹쳐 그린다.
결과
원문에는 정리된 벤치마크 표가 없다. 아래 표는 본문 곳곳에 흩어진 수치를 한자리에 모은 것이다.
| 모델 | 규모와 구성 | control frequency | 학습 데이터 | 비고 |
|---|---|---|---|---|
| RT-2 | PaLI-X 55B + PaLM-E 12B | 기재 없음 | 웹 VQA + 가중치를 높인 로봇 action | 비공개 |
| Octo | 93M (Base) | 기재 없음 | OXE 시연 데이터 80만 건 | Tiny, Small, Base 세 변종 |
| OpenVLA | 7B (DINOv2 300M + SigLIP 400M + Llama 2 7B) | 5Hz (Franka Panda 7자유도) | OXE 97만 episode | action 토큰 255개, RT-2-X 55B 상회 |
| QUART-2 | 기재 없음 | 2Hz | 실제 + 합성 지형 주행 | action space를 255구간으로 이산화 |
| ALOHA | 하드웨어 약 2만 달러 | 해당 없음 | 해당 없음 | 설계도와 3D 프린팅 지침 전면 공개 |
| π0 | PaliGemma 3B + action expert 300M | 50Hz | π Cross-Embodiment 데이터셋 | flow matching, H=50 |
| Helix | S2 7B VLM + S1 80M Transformer | S1 200Hz | 멀티로봇 약 500시간 | 온보드 실행, BMW 공장 배치 |
| GR00T N1 | 2B (eagle2_hg_model) |
S1 120Hz | Omniverse와 Cosmos 합성 + 실제 humanoid | 예측 지평 16스텝 |
| Gemini Robotics | Gemini 2.0 기반 | 20Hz | 기재 없음 | ER 변종은 action 데이터를 쓰지 않는다 |
수치를 담은 그림은 π0 계열 비교 하나뿐이다.
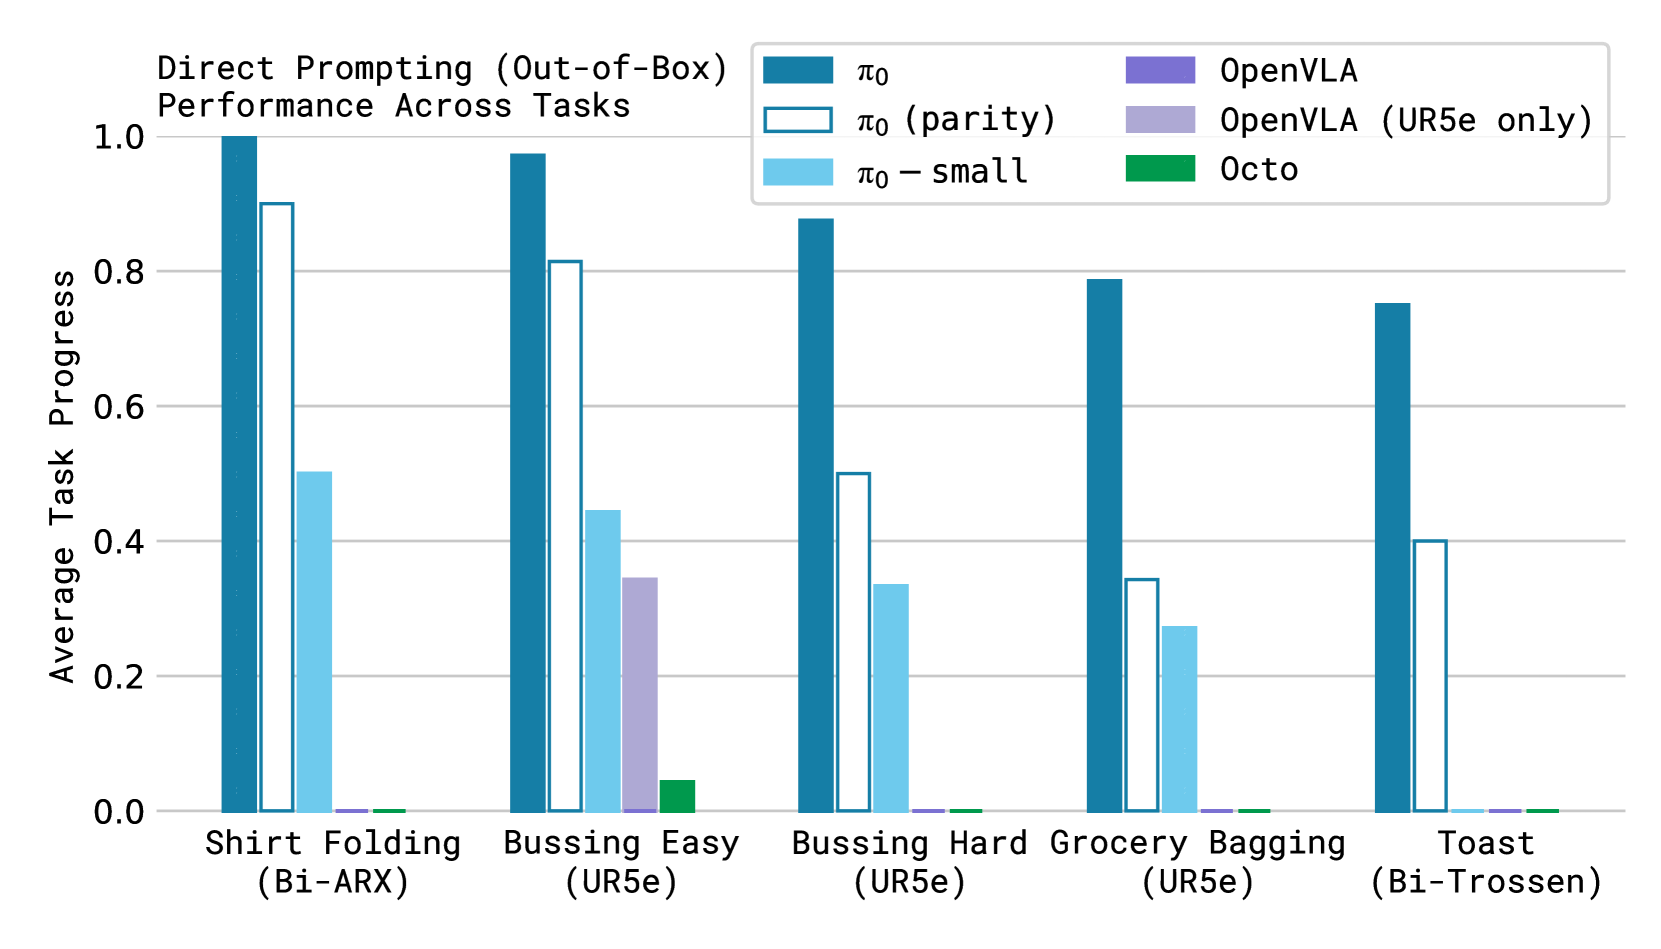
세로축은 평균 과제 진행률(Average Task Progress)이고 0에서 1 사이 값이다. 아래 수치는 막대 높이에서 읽은 근삿값이다.
| 과제 | π0 | π0 (parity) | π0-small | OpenVLA | OpenVLA (UR5e 전용) | Octo |
|---|---|---|---|---|---|---|
| Shirt Folding (Bi-ARX) | 1.00 | 0.90 | 0.50 | 0.00 | 해당 없음 | 0.00 |
| Bussing Easy (UR5e) | 0.97 | 0.81 | 0.44 | 0.00 | 0.34 | 0.04 |
| Bussing Hard (UR5e) | 0.88 | 0.50 | 0.33 | 0.00 | 해당 없음 | 0.00 |
| Grocery Bagging (UR5e) | 0.79 | 0.34 | 0.27 | 0.00 | 해당 없음 | 0.00 |
| Toast (Bi-Trossen) | 0.75 | 0.40 | 0.00 | 0.00 | 해당 없음 | 0.00 |
이 비교는 fine-tuning 없이 프롬프트만 주는 out-of-box 조건에서 측정한 값이다. π0은 다섯 과제 모두에서 0.75 이상을 기록한 반면, OpenVLA와 Octo는 UR5e 전용으로 fine-tuning한 OpenVLA 하나를 빼면 사실상 0에 머문다. π0을 축소한 π0-small조차 네 과제에서 두 모델을 크게 앞선다.
과제 난이도에 따른 격차도 읽힌다. 셔츠 개기와 쉬운 식기 정리에서는 π0이 1.00과 0.97로 거의 완주하지만, 장보기 봉투 담기와 토스트에서는 0.79와 0.75로 떨어진다. 여러 단계를 이어야 하는 long-horizon 과제일수록 진행률이 낮아진다는 뜻이다.
한계
원문에는 검토가 필요한 서술이 몇 군데 있다.
System 1을 설명하면서 "system 1's guided path or instructions를 실행한다"고 적었는데 문맥상 System 2가 맞다. 앞뒤 문단이 일관되게 System 2를 상위 계획자로 두고 있으므로 단순 오기로 읽힌다.
Type-5에 Octo를 넣은 분류도 검토가 필요하다. Type-5의 정의는 VLM이 high-level 계획을 맡고 diffusion이 실행하는 구조인데, Octo에는 VLM backbone이 없다. Octo는 language encoder와 CNN encoder를 붙인 93M Transformer에 diffusion head를 단 구성이므로 "VLM이 계획한다"는 조건에 맞지 않는다. diffusion decoder를 쓴다는 공통점 하나로 묶인 것으로 보인다.
Octo가 RT-2 55B와 대등한 성능이라는 서술에도 근거가 붙어 있지 않다. 원논문의 비교 대상은 OXE 위에서 학습한 RT-1-X와 RT-2-X다. 파라미터 규모가 600배 가까이 차이 나는 두 모델을 성능 동등으로 요약하려면 어떤 과제 집합에서인지가 명시돼야 한다.
GR00T N1의 System 1을 diffusion으로 설명한 부분도 코드 출력과 어긋난다. 같은 글 안에서 FlowmatchingActionHead가 출력되는데 본문은 이를 짚지 않는다.
자료 자체의 범위 한계도 분명하다.
- 각 모델을 한두 문단으로 소개하고 넘어가므로 아키텍처 선택의 근거나 ablation은 담기지 않는다. Gemini Robotics 절이 특히 짧다.
- 인용된 벤치마크 그림 두 장은 캡션만 있고 본문 해설이 없다. Gemini Robotics의 2D pointing 벤치마크 그림이 그 예다.
- 본문 스니펫만으로는 재현이 되지 않는다. 전체 코드가 회원 등록 게이트 뒤에 있기 때문이다.
- 기준 시점이 2025년 4월이라 그 뒤에 나온 π0.5와 GR00T N1.5, SmolVLA는 빠져 있다. LearnOpenCV 자신이 뒤에 SmolVLA 후속 튜토리얼 링크를 본문에 추가했다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Type-1 ~ Type-5 | 이 글이 제시한 VLA 5분류. high-level 계획과 저수준 실행을 각각 무엇이 맡는지로 나눈다. 다른 자료에서는 잘 쓰이지 않는 기준이다 |
| generalist policy | 과제별 fine-tuning 없이 하나의 모델로 여러 downstream 과제를 푸는 policy. 글쓴이는 GRP로 줄여 부른다 |
| Octo | UC Berkeley의 93M 오픈소스 generalist policy. language encoder와 CNN encoder, Transformer, diffusion head로 구성된다 |
| QUAR-VLA / QUART-2 | MiLAB의 사족 보행 로봇용 VLA. 2Hz로 동작하고 action space를 255구간으로 이산화한다 |
| ALOHA | A Low-cost Open-source Hardware System for Bimanual Teleoperation. 약 2만 달러짜리 양팔 teleoperation 하드웨어이자 양팔 manipulation 공용 평가대다 |
| Gemini Robotics-ER | Gemini 2.0의 공간 추론만으로 동작하는 embodied reasoning 변종. 로봇 action 데이터로 fine-tuning하지 않는다 |
eagle2_hg_model |
GR00T N1의 backbone 이름. 코드에서 확인되는 구성은 SigLIP vision encoder 27층과 Llama decoder 12층이다 |
| PEFT | parameter-efficient fine-tuning. OpenVLA 절에서 LoRA를 가리키는 상위 범주로 쓰인다 |
관련 페이지
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 이 글이 VLA 용어의 출처로 지목한 원논문. co-fine-tuning과 emergent capability 서술이 대응한다.
- OpenVLA: An Open-Source Vision-Language-Action Model: dual vision encoder와 255개 action 토큰, LoRA 결과의 원출처.
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching과 action expert의 원논문. Figure 9의 비교 실험도 여기에서 왔다.
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: 글이 통째로 인용한 Figure AI 발표문. S1과 S2의 파라미터와 주기 수치의 출처다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: GR00T N1 원논문. 이 글에 없는 data pyramid와 latent action 학습을 다룬다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: ACT와 ALOHA 플랫폼의 원논문.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: Octo와 OpenVLA가 공유하는 학습 데이터.
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch: π0 walkthrough가 사용하는 프레임워크.
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA를 실험으로 분석한 서베이. 이 글의 System 1과 System 2 서술보다 판정 기준이 엄밀하다.
- An Anatomy of Vision-Language-Action Models: From Modules to Milestones and Challenges: VLA를 구성 요소 단위로 분해한 서베이. 이 글의 다섯 유형 분류와 비교해 읽을 만하다.
- Physical AI 핵심 논문 14편 리뷰 | 2025년까지의 기술 흐름 총정리: 같은 계보를 한국어로 훑은 영상. 다루는 논문이 상당 부분 겹치고 온디바이스 최적화 항목이 추가돼 있다.
- SmolVLA: A vision-language-action model for affordable and efficient robotics: 이 글 이후 나온 경량 VLA. 원문이 후속 링크로 가리키는 대상이다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리의 분류 뼈대와 학습 경로 허브.
- 용어집: Physical AI (Terminology Glossary): generalist policy와 action tokenization 등 이 페이지가 쓰는 canonical 표기.
이 글에 등장하지만 저장소에 원본이 없는 자료는 Octo, QUAR-VLA와 QUART-2, SayCan, PaLM-E, SuSIE, HybridVLA, RDT-1B, OpenVLA-OFT다. ingest 후보로 남겨 둔다. Gemini Robotics는 Gemini Robotics: Bringing AI into the Physical World로 들어왔다.