Physical AI · PAPER · 2024
RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots
요약
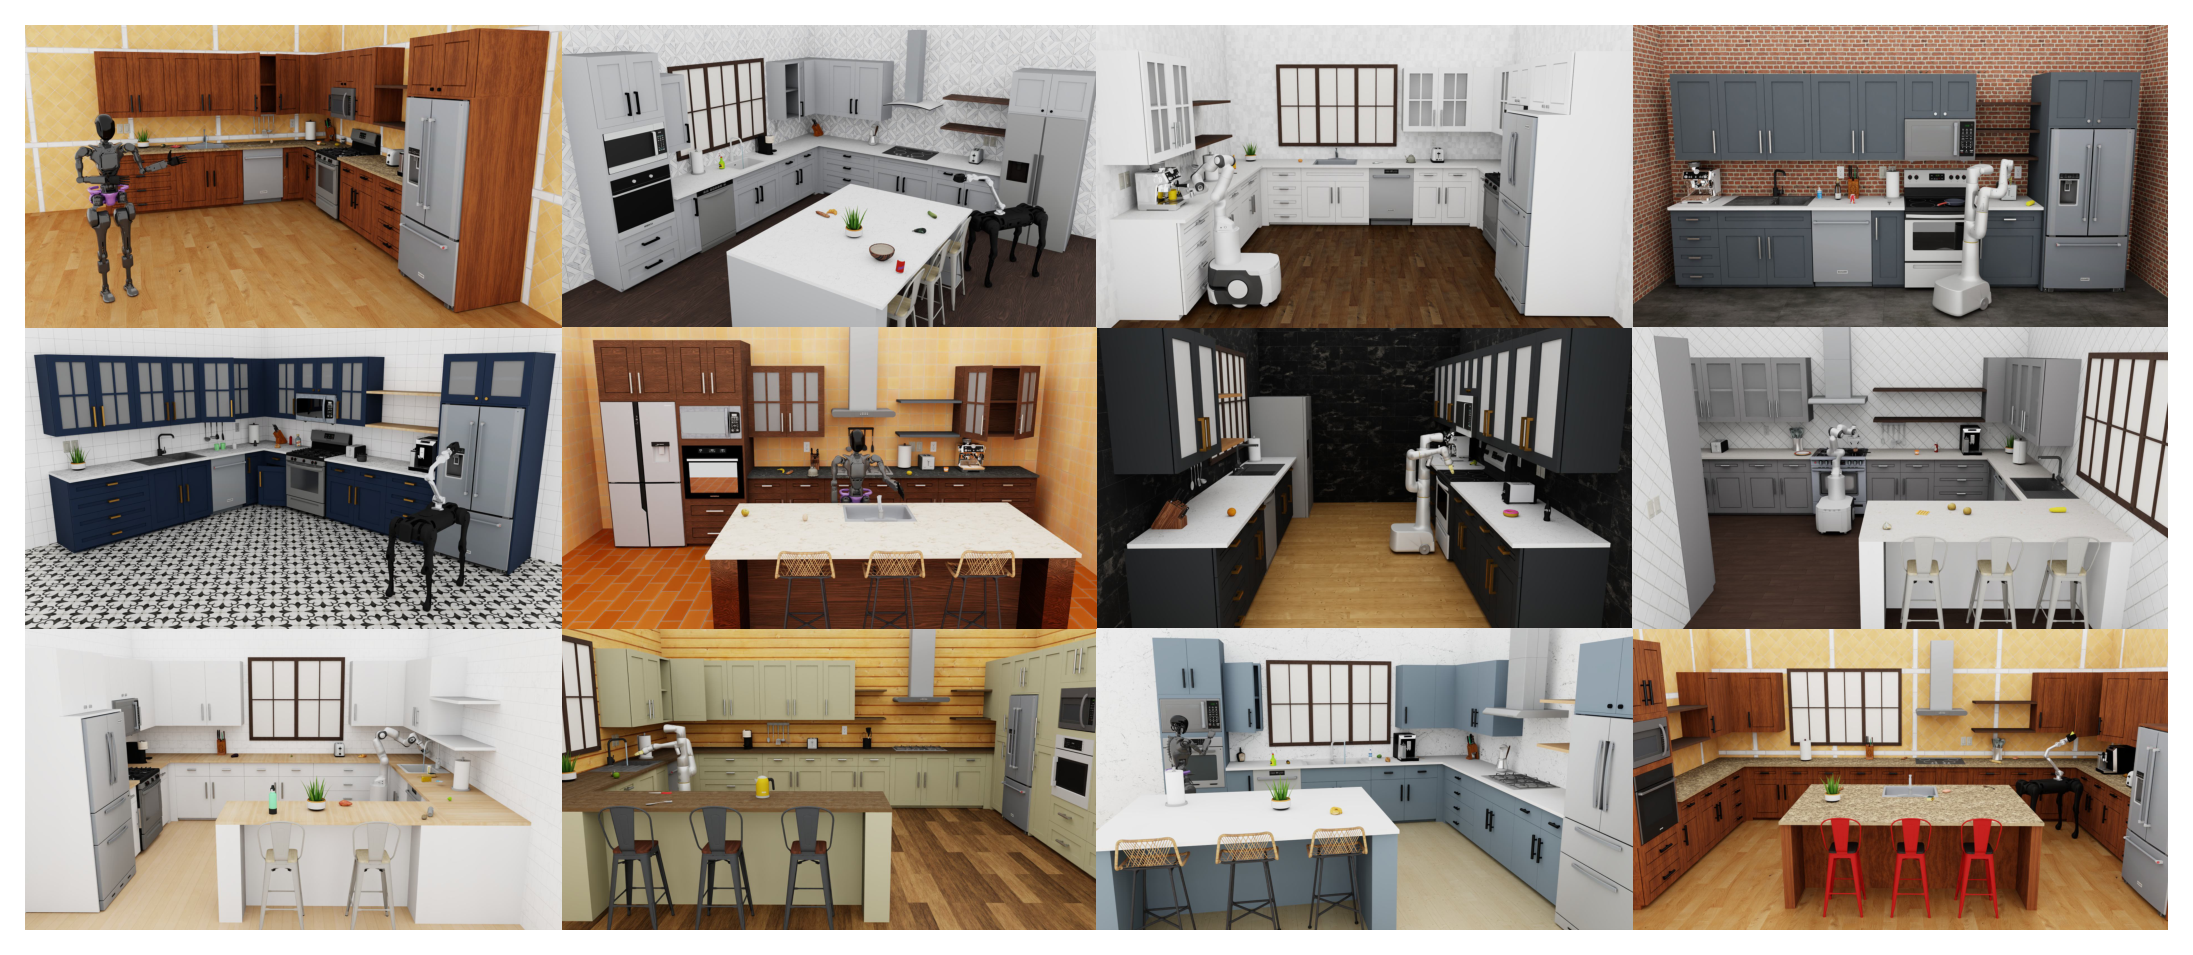
RoboCasa는 주방을 무대로 삼은 대규모 로봇 시뮬레이션 프레임워크다. UT Austin과 NVIDIA Research가 RSS 2024에서 발표했다. 주방 장면 120개와 153개 범주에 걸친 3D 물체 2,509개, 과제 100종, trajectory 10만 개 이상을 하나의 패키지로 묶었다. trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다.
이 논문의 문제의식은 로봇 학습의 데이터 부족이다. 실세계에서 데이터를 계속 키우려면 비현실적인 자본과 노동이 필요하므로, 저자들은 사실적인 물리 시뮬레이션을 환경과 과제, 데이터셋을 함께 확장하는 수단으로 제안한다. 생성형 AI가 그 확장의 도구로 들어간다. 물체는 text-to-3D로 만들고 텍스처는 text-to-image로 만들며 과제 목록은 LLM에게 받는다.
배경
로봇 학습이 vision이나 자연어 처리처럼 규모로 성장하지 못한 이유는 데이터다. 이미지와 텍스트는 인터넷에 이미 대량으로 존재하지만 로봇 데이터는 실제 로봇을 움직여야만 나온다. Open X-Embodiment나 BridgeData, DROID 같은 대규모 수집 시도가 좁은 영역의 일반화를 끌어올리기는 했으나, 실제 환경에 믿고 배치할 수 있는 범용 로봇까지는 거리가 남아 있다는 것이 저자들의 진단이다.
저자들이 시뮬레이션을 대안으로 드는 근거는 세 가지다.
- 기능이 풍부하고 사실성이 높은 시뮬레이터를 한 번 만들어 두면 그 뒤로는 로봇 데이터를 저비용으로 대량 생산할 수 있다. MimicGen이나 OPTIMUS처럼 시뮬레이터의 특권 정보를 활용하는 자동 데이터 생성 방법이 그 예다.
- 생성형 AI가 사실적인 시뮬레이션 제작을 쉽게 만들었다. 이미지 생성과 3D asset 합성, 소스 코드 작성이 모두 도구로 제공되므로 장면을 절차적으로 대량 생성하고 새로운 물체 범주를 들여오며 과제와 reward function을 프로그램으로 짜는 일이 가능해졌다.
- 시뮬레이션은 로봇 학습 연구를 누구나 접근할 수 있게 만들고 아이디어의 빠른 시제품화와 재현 가능한 연구를 돕는다.
다만 저자들은 시뮬레이션이 실제로 쓸모 있으려면 세 조건을 동시에 만족해야 한다고 규정한다. 첫째, 물리와 렌더링과 기반 모델이 현실적이어야 실세계로 전이된다. 둘째, 장면과 asset과 과제가 다양해야 한다. 셋째, 시뮬레이터만으로는 부족하고 그 다양성을 담아낸 대규모 로봇 데이터셋이 함께 있어야 한다. 기존 프레임워크는 이 중 일부만 채웠고, RoboCasa는 셋을 함께 채우려는 시도다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 이 논문에서 학습 대상은 카메라 이미지와 로봇 자신의 상태를 받아 제어 명령을 내는 policy 하나다.
시연 데이터(demonstration)는 사람이 만들어준 모범 실행 데이터다. RoboCasa는 이 시연 데이터를 teleoperation으로 모은다. teleoperation은 사람이 로봇을 원격으로 움직여 시연을 만드는 방식이고, 여기서는 3D SpaceMouse가 그 입력 장치다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. RoboCasa는 single-arm 모바일 플랫폼과 humanoid, 팔 달린 4족 로봇을 함께 지원하므로 하나의 장면에서 서로 다른 embodiment를 바꿔 끼우는 cross-embodiment 실험이 가능하다.
과제는 두 층으로 나뉜다. atomic task는 skill 하나로 끝나는 짧은 과제이고 composite task는 여러 skill을 순서대로 엮어야 끝나는 long-horizon 과제다. long-horizon 과제는 여러 단계를 이어야 완료되는 긴 과제를 말하며, 단계 사이의 전환이 실패 지점이 된다.
domain randomization은 시뮬레이션 파라미터를 흔들어 sim2real 간극을 줄이는 기법이다. sim2real은 시뮬레이션에서 학습한 policy를 실제 기기로 옮기는 문제를 가리킨다. RoboCasa에서는 AI로 만든 텍스처를 매번 다르게 갈아 끼우는 것이 domain randomization의 역할을 맡는다.
방법
기반 플랫폼
RoboCasa는 MuJoCo 기반의 RoboSuite를 코어 플랫폼으로 채택했다. 물리적 사실성과 속도, 모듈형 설계가 선택 이유이며 환경 모델 형식과 로봇 컨트롤러를 그대로 물려받는다. 방 규모 환경을 지원하기 위해 RoboSuite를 확장해 바퀴 베이스 위의 로봇과 humanoid, 팔 달린 4족 로봇을 수용했고, 로봇 모델은 RoboSuite와 MuJoCo Menagerie를 포함한 여러 저장소에서 가져와 변환했다. 렌더링에 NVIDIA Omniverse를 쓰면 photorealistic 이미지를 얻는다.
시뮬레이터 속도는 PickPlaceCounterToCab 과제를 10 episode 실행해 측정했다. 매 episode를 무작위 장면에 생성했고 NVIDIA RTX A5000 GPU로 MuJoCo 네이티브 렌더링을 켠 조건이며 물리 계산은 AMD EPYC 7543 32코어 CPU가 맡았다.
| 조건 | 장면 리셋 평균 | env.step 속도 |
|---|---|---|
| 렌더링 켬 | 9.50초 | 25.2 fps |
| 렌더링 끔 | 9.46초 | 31.9 fps |
렌더링을 켠 상태의 25.2 fps는 거의 실시간 속도에 해당한다. 시뮬레이터의 한 timestep이 실세계 0.04초, 즉 25 fps에 대응하기 때문이다. 반면 장면 리셋에 9.5초가 걸린다는 점은 대량 데이터 생성 시 무시할 수 없는 고정 비용이다.
주방 장면 구성
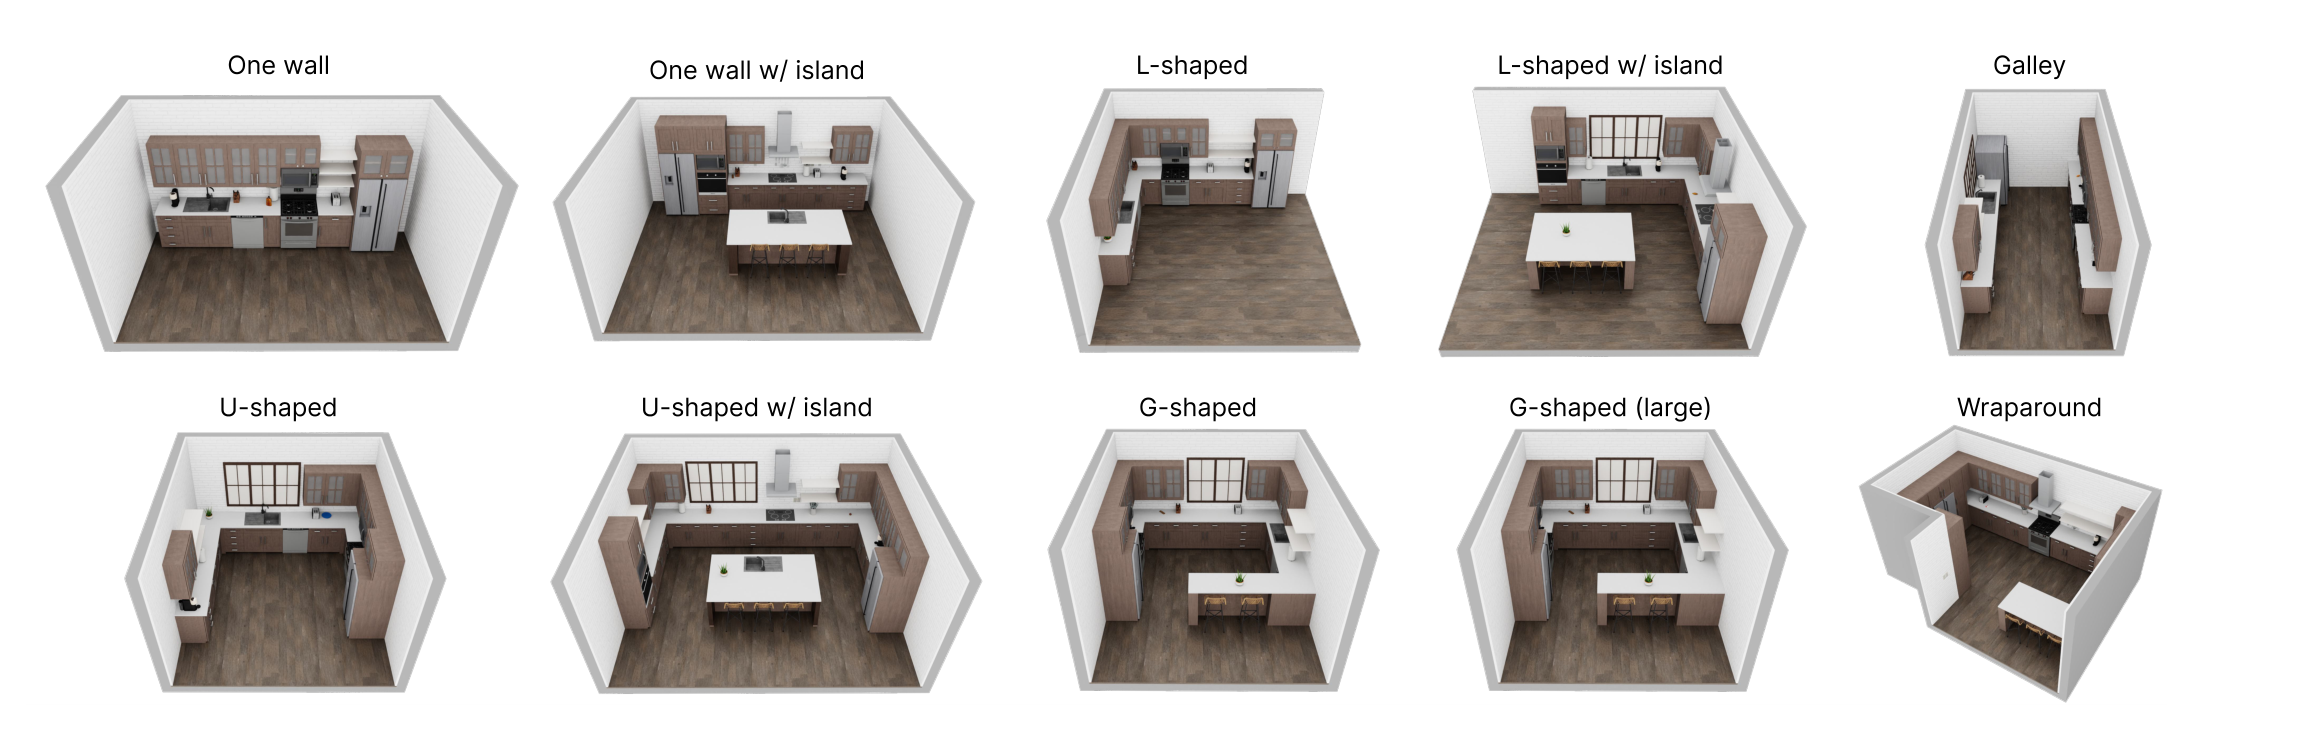
주방을 통째로 하나씩 만드는 대신 layout과 style을 분리해 조합한다. layout은 floor plan을 정하고 style은 가구와 가전, 텍스처 선택을 정한다. 저자들은 건축과 인테리어 잡지를 참고해 실제 주택에서 흔한 배치를 추린 뒤 표준 치수와 공간 규격에 맞춰 모델링했다.
floor plan은 10종이다. One wall, One wall w/ island, L-shaped, L-shaped w/ island, Galley, U-shaped, U-shaped w/ island, G-shaped, G-shaped (large), Wraparound로 아파트에서 흔한 기본형부터 고급 주택의 복잡한 배치까지 포함한다.
style은 12종이며 Industrial, Scandinavian, Coastal, Modern, Traditional, Mediterranean, Rustic 등이 들어간다. style마다 텍스처와 가전 선택, 수납장 패널과 손잡이 조합이 다르다. 예를 들어 Scandinavian은 밝고 대비가 낮은 텍스처에 단순하고 매끈한 수납장 패널을 쓰는 반면 Mediterranean은 장식적인 가전과 유리 패널 수납장, 색이 강한 텍스처를 쓴다. layout 10종과 style 12종의 조합으로 120개 장면이 나온다.
여기에 MidJourney로 만든 텍스처를 덧입힐 수 있다. 벽 100장, 바닥 100장, 조리대 100장, 수납장 패널 100장으로 총 400장이다. 학습 데이터는 무작위로 뽑은 AI 생성 텍스처로 렌더링하고 평가는 사람이 고른 텍스처 장면에서 하는 식으로 시각적 일반화를 시험한다.
가전과 물체 라이브러리
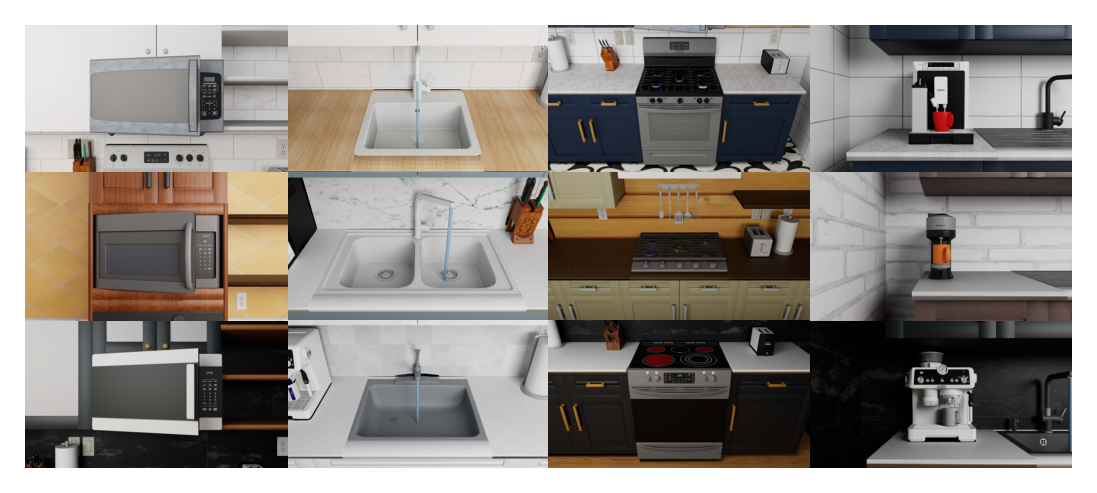
가전은 정적인 3D 모델이 아니라 관절이 붙은 객체다. 온라인 3D 모델 저장소에서 받은 asset을 MuJoCo MJCF 형식으로 변환하면서 전자레인지 문이나 가스레인지 손잡이 같은 부분을 관절 객체로 분리하는 후처리를 거쳤다. 그 결과 전자레인지 문을 여닫거나 가스레인지 손잡이를 비트는 상호작용을 표현할 수 있다.
상태 변화까지 따라온다는 점이 중요하다. 가스레인지 손잡이를 켜는 위치로 돌리면 해당 화구가 켜져 열을 시뮬레이션한다. 즉 물체의 자세만이 아니라 기기의 논리적 상태가 함께 바뀌므로 "전자레인지를 켠다" 같은 과제의 성공 판정이 가능해진다.
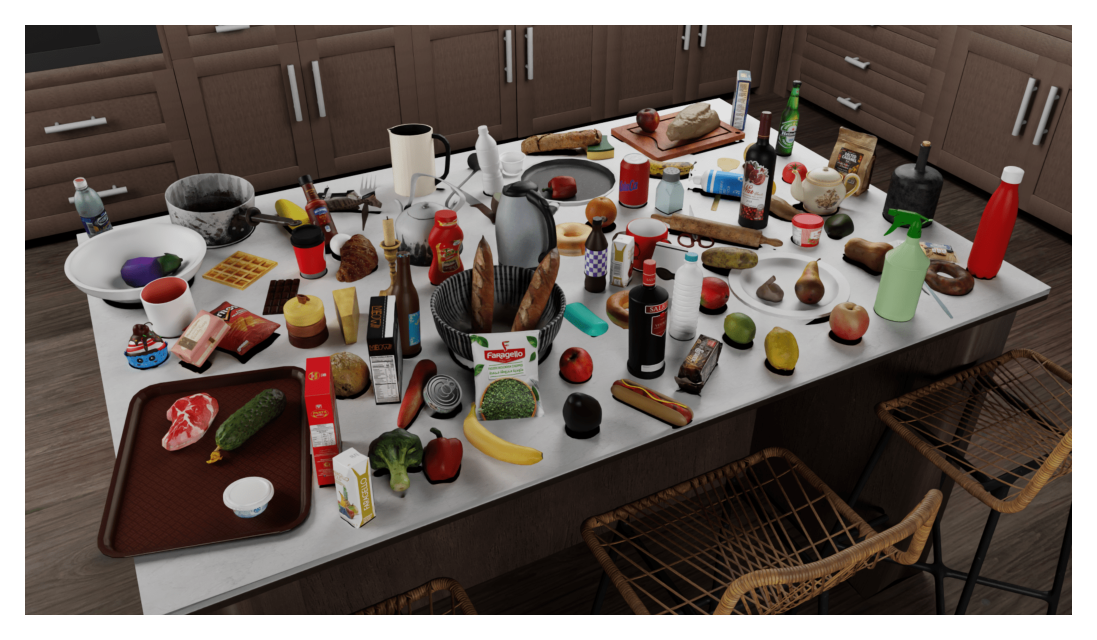
물체 라이브러리는 Objaverse 1.0과 Luma AI 같은 text-to-3D 서비스 두 곳에서 왔다. 후보를 대량으로 수집한 뒤 결함이 있거나 품질이 낮은 것을 걸러 153개 범주에 걸친 2,509개를 남겼고, 이 중 다수인 1,592개가 Luma AI 출처다. 범주는 과일과 채소, 유제품, 가금류, 음료, 그릇류, 도구 등 주방에서 흔한 물건을 포괄한다.
atomic task와 task variant
atomic task 25종은 여덟 가지 기본 skill에서 파생된다. 저자들은 이 여덟 가지가 가정 내 활동 대부분의 기반이 된다고 본다.
| skill | 대표 과제 |
|---|---|
| pick-and-place | PickPlaceCounterToSink, PickPlaceCabToCounter 등 8종 |
| 문 여닫기 | OpenSingleDoor, CloseDoubleDoor 등 4종 |
| 서랍 여닫기 | OpenDrawer, CloseDrawer |
| 손잡이 비틀기 | TurnOnStove, TurnOffStove |
| 레버 돌리기 | TurnOnSinkFaucet, TurnOffSinkFaucet, TurnSinkSpout |
| 버튼 누르기 | CoffeePressButton, TurnOnMicrowave, TurnOffMicrowave |
| 삽입 | CoffeeSetupMug, CoffeeServeMug |
| 주방 내 이동 | NavigateKitchen |
각 과제는 다시 여러 task variant로 나뉜다. task variant는 같은 과제를 언어로 구분되는 여러 목표로 쪼갠 것이다. pick-and-place는 다루는 물체 범주마다 variant가 있어 잡동사니 속에서 대상을 지목할 수 있고, 가스레인지 켜기와 끄기는 화구마다 variant가 있으며, 주방 내 이동은 목적지 가전마다 variant가 있다. 저자들은 이 여덟 가지가 전부는 아니며 변형 가능한 물체를 다루는 skill 등은 향후 확장 대상이라고 밝힌다.
LLM으로 만드는 composite task
composite task 75종은 프롬프트를 두 번 보내 만든다. 첫 단계인 activity prompting에서는 ChatGPT(GPT-4)에게 "간단한 일상 주방 활동 30가지를 알려달라, 각 활동은 서로 달라야 한다"고 묻고 받은 후보 가운데 20개를 사람이 골랐다.
확정된 활동 20종은 커피나 차 내리기, 설거지, 주방 용품 채우기, 재료 썰기, 토스트 만들기, 해동, 물 끓이기, 육류 손질, 상 차리기, 상 치우기, 살균, 간식 준비, 수납장과 서랍 정리, 과일과 채소 씻기, 튀기기, 음식 데우기, 섞고 갈기, 굽기, 음식 담아내기, 채소 찌기다.
둘째 단계인 task prompting에서는 활동마다 GPT-4나 Gemini 1.5에게 로봇이 수행할 만한 과제 15가지를 제안받는다. 이 프롬프트는 첫 단계보다 훨씬 정교하다.
- 사용 가능한 로봇 skill과 관련 물체 범주, 고정물 목록을 나열한다.
- 잡을 수 없는 작은 물체나 변형 가능한 물체 지원이 제한적이라는 시뮬레이션 제약을 명시한다.
- 예시 과제 청사진을 few-shot으로 보여준다.
각 제안에는 과제 이름과 목표, 필요한 물체와 가전, 필요한 skill 순서가 들어 있다.
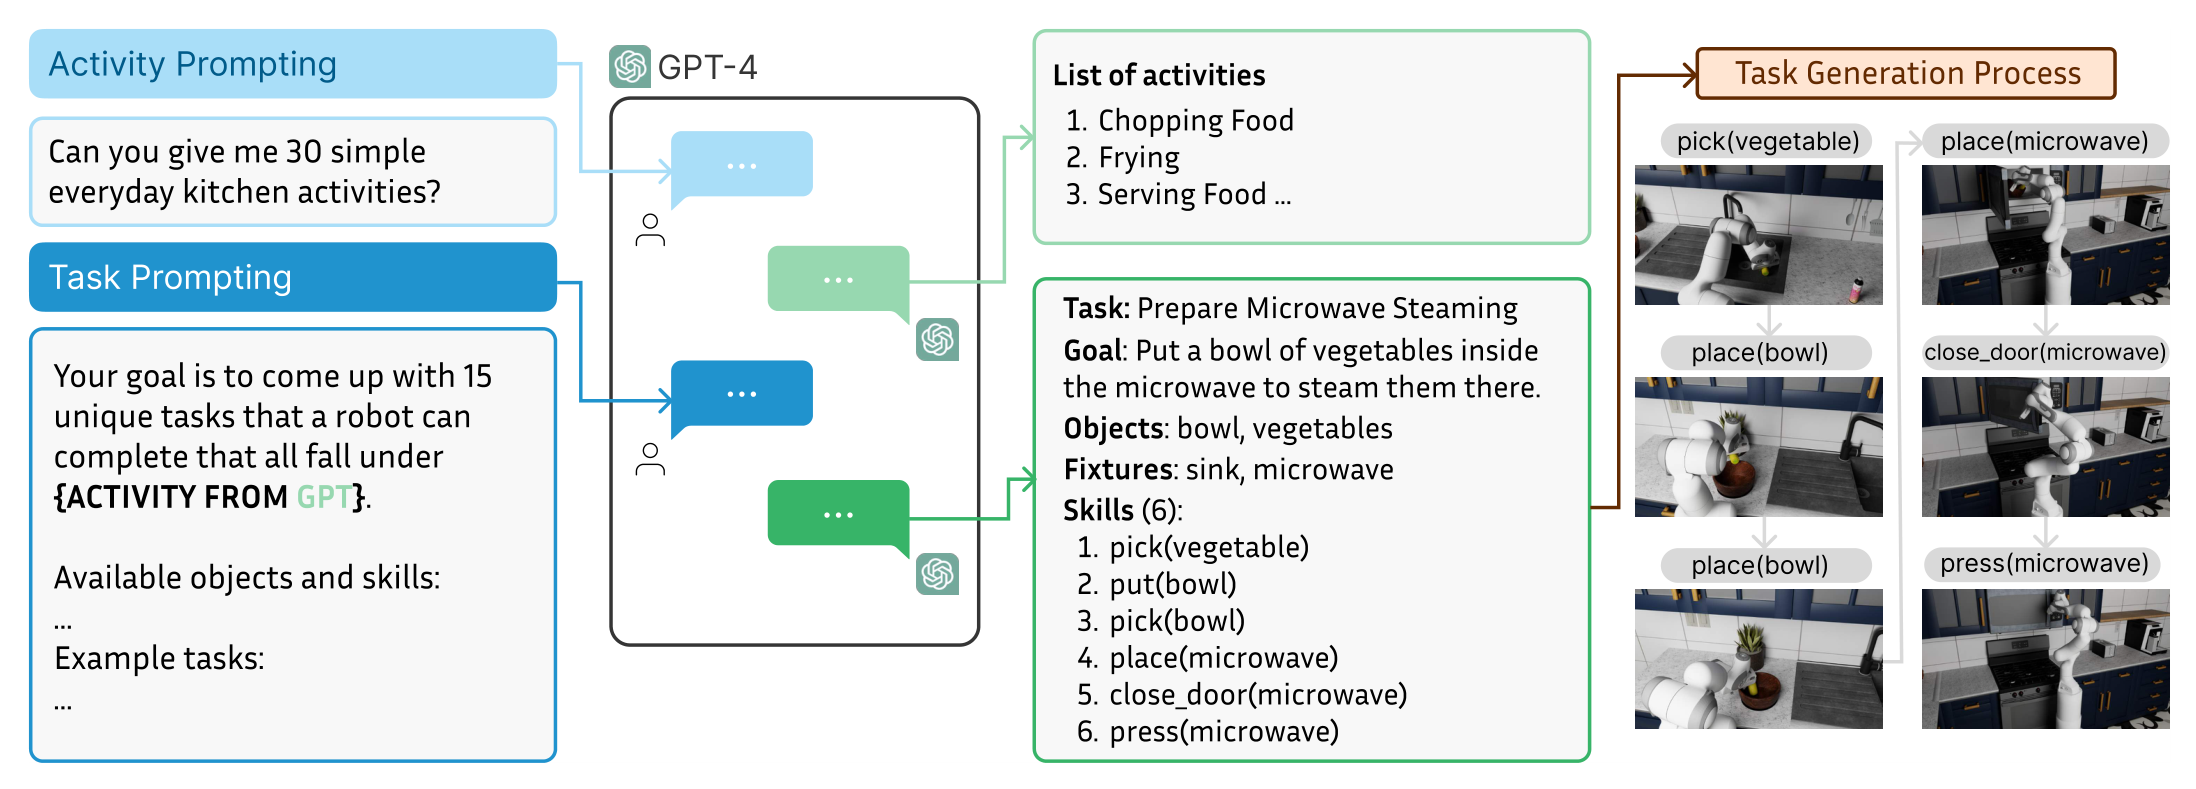
LLM 출력에 논리적 결함이 섞이는 경우가 있어 사람이 걸러내거나 고친 뒤 75개 청사진을 코드로 옮겼다. 논문이 부록에 든 결함 사례는 세 가지 유형이다.
| 결함 유형 | 사례 |
|---|---|
| 존재하지 않는 물체 사용 | "Set Up Blending Station"이 시뮬레이터에 없는 블렌더를 고정물로 요구했다 |
| skill의 부적절한 사용 | "Wine Selection for Cooking"이 코르크 따개 동작을 흉내 낸다며 커피 머신 버튼 누르기 skill을 넣었다 |
| 잡으면 안 되는 물체를 집기 | "Retrieve Baking Utensils"가 숟가락과 국자 같은 조리 도구를 집으라고 지시했다 |
LLM에게 과제를 묻는 근거는 LLM이 인간 중심 인터넷 콘텐츠로 학습돼 사람 행동의 생태적 통계를 어느 정도 담고 있다는 가정이다. 무엇이 그럴듯한 집안일인지를 사람이 일일이 열거하는 대신 모델에게 물어 규모를 얻는 접근이다. 특정 환경을 전제로 설계한 일부 과제를 빼면 나머지는 어느 주방 장면에서도 실행할 수 있다.
사람 시연을 합성 데이터로 확장
사람 시연은 네 명의 조작자가 3D SpaceMouse로 atomic task마다 50개씩 모아 총 1,250개다. 시연마다 무작위 주방 장면에서 수집했으며 floor plan과 style, AI 생성 텍스처를 모두 무작위로 뽑았다. 그럼에도 이 규모만으로는 대부분의 과제가 풀리지 않았다. 과제와 장면의 범위와 다양성이 워낙 커서다.
그래서 MimicGen을 결합한다. MimicGen은 사람 시연을 물체 중심 구간으로 쪼갠 뒤, 새 장면에서 해당 물체의 현재 pose에 맞춰 각 구간을 변환하고 이어 붙여 로봇이 그 새 trajectory를 따라가게 해 새 시연을 만드는 도구다. 성공한 시도만 남기는 rejection sampling을 쓰므로 생성 결과의 품질이 어느 정도 보장된다. RoboCasa는 여러 시뮬레이션 프로세스에 걸쳐 생성을 병렬화해 속도를 높였다.
MimicGen을 붙이려면 두 전제를 만족해야 한다.
- 과제가 알려진 물체 중심 하위 단계의 순서로 표현되고 그 순서가 새 과제마다 지정돼야 한다.
- 사람 시연마다 그 단계 경계가 표시돼 있어야 한다.
RoboCasa의 atomic task는 여덟 skill에서 파생되므로 이 지점에서 유리하다. 같은 skill에 속한 과제들은 하위 단계 순서가 같거나 비슷하고 기준 물체의 정체만 다르기 때문이다. 예를 들어 pick-and-place는 첫 단계가 기준 물체 하나에 대한 pick, 둘째 단계가 다른 물체에 대한 place로 고정된다. 따라서 skill마다 한 번씩만 단계 순서와 종료 판정 함수를 짜두면 전체 시연에 재사용되고 사람 손이 거의 들지 않는다.
결과
논문이 세운 연구 질문은 세 가지다. MimicGen이 만든 trajectory가 multi-task policy 학습에서 사람 시연에 비해 얼마나 효과적인가, 학습 데이터 규모를 늘리면 일반화 성능이 어떻게 변하는가, 대규모 시뮬레이션 데이터가 시뮬레이션 내 downstream 과제와 실세계 과제로 지식을 전이해 주는가다.
학습 설정
학습에는 RoboMimic의 BC-Transformer를 쓴다. behavioral cloning은 시연의 observation에서 action으로 가는 쌍을 지도학습으로 흉내 내는 방법이다. 구현 세부는 부록에 정리돼 있다.
| 항목 | 설정 |
|---|---|
| 입력 | 과거 observation 10개와 언어 목표 |
| 출력 | 다음 action 10개. 첫 action 실행 후 다시 계획 |
| 언어 인코딩 | CLIP sentence encoder |
| proprioception | end-effector pose와 mobile base pose |
| 카메라 | eye-in-hand 1대와 좌우 workspace 2대 |
| 시각 인코더 | 카메라별 전용 ResNet-18 stack, FiLM layer로 융합 |
| backbone | 6층 Transformer, 학습 파라미터 약 20M |
| 학습 | gradient step 50만 회, learning rate 1e-4에 warmup |
로봇은 Omron 모바일 베이스 위의 Franka Panda로 고정했다. Omni-Frankie 로봇에 대응하는 구성이다. 학습 데이터셋 이미지는 데이터 용량과 시간 제약 때문에 경량 MuJoCo 렌더러로 렌더링했고, 공개 시에는 Omniverse 렌더러로 다시 렌더링하는 선택지를 제공한다.
atomic task 규모 실험
네 가지 데이터 설정을 비교했다. Generated 계열은 24개 atomic task만 대상으로 하는데, MimicGen이 아직 mobile manipulation trajectory를 생성하지 못해 주방 내 이동 과제를 제외했기 때문이다.
| 설정 | 과제당 시연 수 | trajectory 총계 | 전체 성공률 |
|---|---|---|---|
| Human-50 | 사람 시연 50개 | 1,250 | 28.8% |
| Generated-100 | 합성 100개 | 2,400 | 26.3% |
| Generated-300 | 합성 300개 | 7,200 | 35.0% |
| Generated-3000 | 합성 3,000개 | 72,000 | 47.6% |
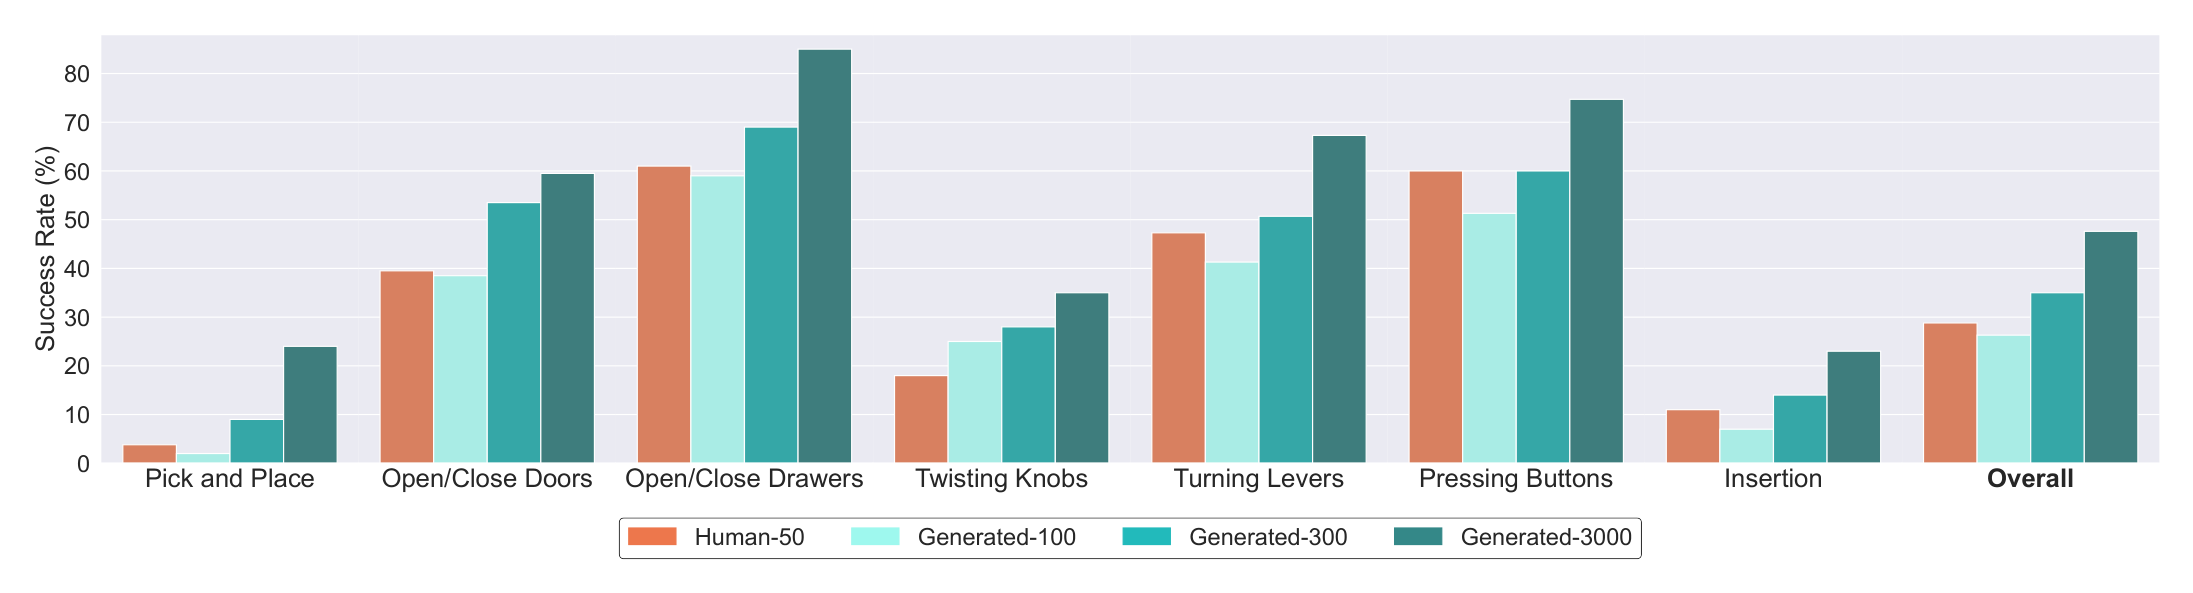
평가는 과제당 50회, floor plan과 style이 서로 다른 다섯 고정 장면에서 진행했다. 그중 둘은 학습에서 본 적 없는 style이고 물체는 전부 미학습 인스턴스다. 학습 이미지는 AI 생성 텍스처로 렌더링한 반면 평가 장면은 사람이 고른 텍스처를 쓴다. 즉 텍스처와 style, 물체 인스턴스가 모두 바뀐 조건에서 재는 수치다.
합성 데이터를 30배로 늘리는 동안 성공률이 계속 올랐다는 것이 이 논문의 핵심 결과다. 다만 최소 규모인 Generated-100(26.3%)은 사람 시연 Human-50(28.8%)보다 2.5%p 낮다. 따라서 합성 데이터가 사람 데이터를 넘어서려면 일정 규모 이상이 필요하며, 규모가 작을 때는 사람 시연의 품질이 여전히 앞선다고 읽는 것이 맞다.
Generated-3000의 72,000개는 Objaverse 물체를 쓴 실험용 데이터다. 여기에 AI 생성 물체를 쓴 trajectory 28,000개를 추가로 공개해 전체 10만 개 데이터셋을 이룬다. Generated-300과 Generated-100은 전체 생성 데이터셋에서 각각 1/10과 1/30을 무작위로 뽑은 부분집합이다.
skill별로 난이도가 크게 갈린다. 서랍과 문 여닫기는 쉽고 pick-and-place와 삽입이 어렵다. 저자들은 두 가지 요인을 든다. 첫째, 다양성이 높은 과제가 훨씬 어렵다. pick-and-place는 affordance가 제각각인 수십 개 물체 범주를 다루는 반면 문 여닫기는 문 인스턴스가 여섯 종뿐이다. affordance는 물체가 허용하는 상호작용 가능성을 뜻한다. 둘째, 삽입처럼 높은 정밀도를 요구하는 과제가 어렵다.
과제별 전체 결과는 부록에 있다. 성공률은 0에서 1 사이 비율 표기다.
| 과제 | Human-50 | Generated-100 | Generated-300 | Generated-3000 |
|---|---|---|---|---|
| PickPlaceCabToCounter | 0.02 | 0.04 | 0.10 | 0.18 |
| PickPlaceCounterToCab | 0.06 | 0.08 | 0.16 | 0.28 |
| PickPlaceCounterToMicrowave | 0.02 | 0 | 0 | 0.18 |
| PickPlaceCounterToSink | 0.02 | 0.02 | 0.16 | 0.44 |
| PickPlaceCounterToStove | 0.02 | 0 | 0 | 0.06 |
| PickPlaceMicrowaveToCounter | 0.02 | 0 | 0.12 | 0.08 |
| PickPlaceSinkToCounter | 0.08 | 0.02 | 0.14 | 0.42 |
| PickPlaceStoveToCounter | 0.06 | 0 | 0.04 | 0.28 |
| OpenSingleDoor | 0.46 | 0.42 | 0.44 | 0.50 |
| OpenDoubleDoor | 0.28 | 0.12 | 0.22 | 0.48 |
| CloseDoubleDoor | 0.28 | 0.18 | 0.62 | 0.46 |
| CloseSingleDoor | 0.56 | 0.82 | 0.86 | 0.94 |
| OpenDrawer | 0.42 | 0.26 | 0.40 | 0.74 |
| CloseDrawer | 0.80 | 0.92 | 0.98 | 0.96 |
| TurnOnStove | 0.32 | 0.42 | 0.44 | 0.46 |
| TurnOffStove | 0.04 | 0.08 | 0.12 | 0.24 |
| TurnOnSinkFaucet | 0.38 | 0.26 | 0.48 | 0.34 |
| TurnOffSinkFaucet | 0.50 | 0.48 | 0.46 | 0.72 |
| TurnSinkSpout | 0.54 | 0.50 | 0.58 | 0.96 |
| CoffeePressButton | 0.48 | 0.48 | 0.42 | 0.74 |
| TurnOnMicrowave | 0.62 | 0.36 | 0.76 | 0.90 |
| TurnOffMicrowave | 0.70 | 0.70 | 0.62 | 0.60 |
| CoffeeServeMug | 0.22 | 0.12 | 0.24 | 0.34 |
| CoffeeSetupMug | 0 | 0.02 | 0.04 | 0.12 |
| 평균 | 0.288 | 0.263 | 0.350 | 0.476 |
이 표는 전체 평균이 감추는 편차를 드러낸다. 문 닫기(CloseSingleDoor 94%)나 서랍 닫기(CloseDrawer 96%)는 이미 포화에 가까운 반면 PickPlaceCounterToStove는 최대 규모에서도 6%에 그친다. 또한 데이터를 늘려도 오르지 않는 과제가 존재한다. TurnOffMicrowave는 Human-50의 70%가 Generated-3000에서 60%로 오히려 낮아지고 TurnOnSinkFaucet도 38%에서 34%로 낮아진다. 즉 데이터 규모 효과는 전체 평균 수준에서 성립하는 경향이며 모든 과제에 균일하게 적용되지는 않는다.
Diffusion Policy 비교
저자들은 Diffusion Policy도 함께 검토했다. 공정한 비교를 위해 RoboMimic 안에 구현했고 observation encoder는 BC-Transformer와 동일하게 ResNet과 FiLM 조건화를 썼다. 하이퍼파라미터는 원 구현의 권장값을 따라 observation history 2 timestep, prediction horizon 16 step, action horizon 8 step으로 두고 DDIM을 학습 100 timestep에 추론 10 timestep으로 설정했다.
| 방법 | PickPlaceCounterToSink 성공률 |
|---|---|
| BC-Transformer | 56% |
| Diffusion Policy | 12% |
BC-Transformer가 44%p 앞섰다. 저자들이 든 설명은 observation history 길이 차이다. BC-Transformer는 10 timestep을 보는 반면 Diffusion Policy는 원 구현 기본값인 2 timestep만 본다. 따라서 RoboCasa 과제에는 긴 observation history가 중요할 수 있다는 해석이다.
composite task 학습
composite task는 여러 skill을 요구해 과제의 horizon이 길어지고 새로운 난점이 생긴다. 난이도와 multi-task 학습의 어려움을 고려해 과제당 단일 policy로 학습했다. 사람 시연 50개만으로 scratch 학습하는 경우와, atomic task 전체 MimicGen 생성 데이터로 pre-training한 뒤 그 50개로 fine-tuning하는 경우를 비교했다.
실험 대상 5종은 서로 다른 활동에서 하나씩 뽑았다.
| 과제 | 소속 활동 | 내용 |
|---|---|---|
| ArrangeVegetables | 재료 썰기 | 싱크의 채소 두 개를 조리대의 도마 위로 옮긴다 |
| MicrowaveThawing | 해동 | 조리대의 냉동식품을 전자레인지에 넣고 전자레인지를 켠다 |
| RestockPantry | 주방 용품 채우기 | 조리대의 캔 여러 개를 수납장으로 옮기되, 수납장에 이미 있는 캔이 좌우 어느 쪽인지 찾아 그 옆에 놓는다 |
| PreSoakPan | 설거지 | 팬과 스펀지를 싱크에 넣고 수도꼭지를 틀어 팬을 불린다 |
| PrepareCoffee | 커피나 차 내리기 | 수납장에서 머그를 꺼내 커피 머신 아래 놓고 버튼을 눌러 커피를 받는다 |
| 과제 | Scratch | Fine-tuning |
|---|---|---|
| ArrangeVegetables | 2.0% | 12.0% |
| MicrowaveThawing | 0% | 2.0% |
| RestockPantry | 0% | 6.0% |
| PreSoakPan | 0% | 4.0% |
| PrepareCoffee | 0% | 0% |
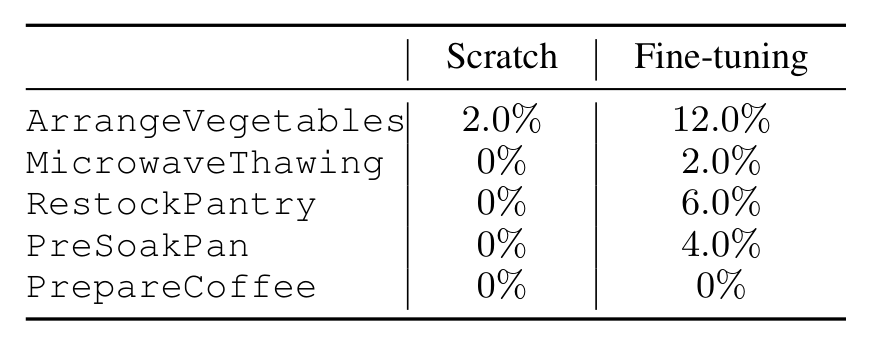
scratch는 다섯 과제 중 넷에서 성공률이 0이다. fine-tuning이 넷에서 0을 벗어나지만 최고가 ArrangeVegetables의 12%이고 PrepareCoffee는 어느 쪽도 0이다. 저자들이 꼽는 주된 실패 원인은 정밀 조작의 어려움과 다음 단계로의 전환 실패다.
수치가 낮은데도 저자들이 pre-training의 가치를 인정하는 근거는 정성적 관찰이다. fine-tuning 모델이 특히 집고 놓는 동작에서 더 안정적인 전략을 보였고 그 원인으로 atomic task 대규모 pre-training 데이터를 든다. 벤치마크로서 개선 여지를 크게 남겨둔 셈이며, policy 구조와 학습 알고리즘, fine-tuning 전략의 선택이 성능을 좌우할 수 있어 후속 연구가 필요하다는 것이 저자들의 결론이다.
실제 기기 전이
DROID 하드웨어 위의 Franka Emika Panda로 실세계 주방에서 세 과제를 시험했다. 조리대에서 싱크로, 싱크에서 조리대로, 조리대에서 수납장으로 물체를 옮기는 과제로 RoboCasa의 단일 단계 과제에 대응한다. 각 과제에 실세계 시연 50개를 서로 다른 물체 범주 다섯 종에 걸쳐 모았다.
두 환경의 조건은 여러 곳에서 어긋난다. 이 격차를 확인해 두어야 전이 결과의 의미가 분명해진다.
- 양쪽 다 workspace end-effector 제어를 쓰지만 시뮬레이터는 Operational Space Control을 쓰고 DROID 기반 실제 로봇은 쓰지 않는다.
- control frequency가 시뮬레이터 20Hz, 실제 로봇 15Hz로 다르다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
- 카메라 캘리브레이션과 조명, 장면에 대한 로봇 베이스의 위치가 다르다.
결과는 seed 3개 평균이고 괄호 안은 표준편차다. seed마다 학습에서 본 물체 범주 다섯 종과 실세계 시연 기준 미학습 물체 범주 세 종에서 평가했다.
| 조건 | 과제 | 실세계만 | 실세계 + 시뮬레이션 |
|---|---|---|---|
| 학습에서 본 물체 | 조리대에서 싱크로 | 12.7 (±2.5) | 22.0 (±2.8) |
| 학습에서 본 물체 | 싱크에서 조리대로 | 20.0 (±5.9) | 29.3 (±4.1) |
| 학습에서 본 물체 | 조리대에서 수납장으로 | 8.0 (±1.6) | 22.0 (±5.8) |
| 학습에서 본 물체 | 평균 | 13.6 | 24.4 |
| 미학습 물체 | 조리대에서 싱크로 | 3.3 (±4.7) | 8.9 (±7.9) |
| 미학습 물체 | 싱크에서 조리대로 | 1.1 (±1.6) | 7.8 (±4.2) |
| 미학습 물체 | 조리대에서 수납장으로 | 3.3 (±4.7) | 11.1 (±11.0) |
| 미학습 물체 | 평균 | 2.6 | 9.3 |
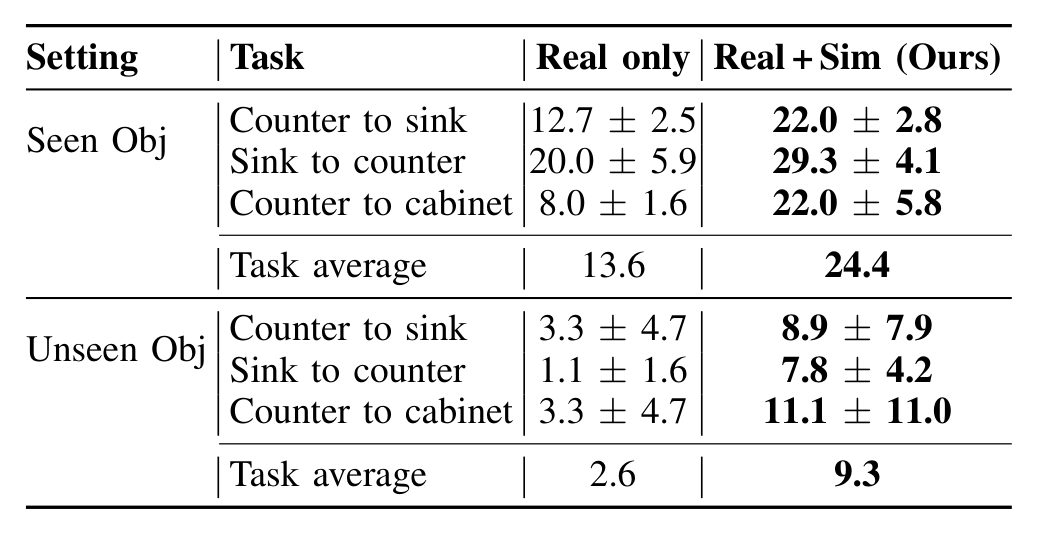
학습에서 본 물체 기준 13.6%에서 24.4%로 10.8%p 올랐고 상대 개선폭은 79%다. 미학습 물체는 2.6%에서 9.3%로 절대 수치가 낮지만 배수로는 더 크게 벌어진다. 다만 표준편차가 큰 편이라 개별 과제 수치는 신중히 읽어야 한다. 조리대에서 수납장으로 옮기는 미학습 물체 조건은 평균 11.1%에 표준편차 11.0으로 seed 사이 변동이 평균만큼 크다. 저자들은 시뮬레이터의 풍부한 다양성과 시각적, 물리적 사실성을 이 이득의 근거로 든다.
기존 프레임워크와의 비교
논문은 로봇 학습에서 널리 쓰이는 시뮬레이션 프레임워크 11종을 한 표로 비교한다.
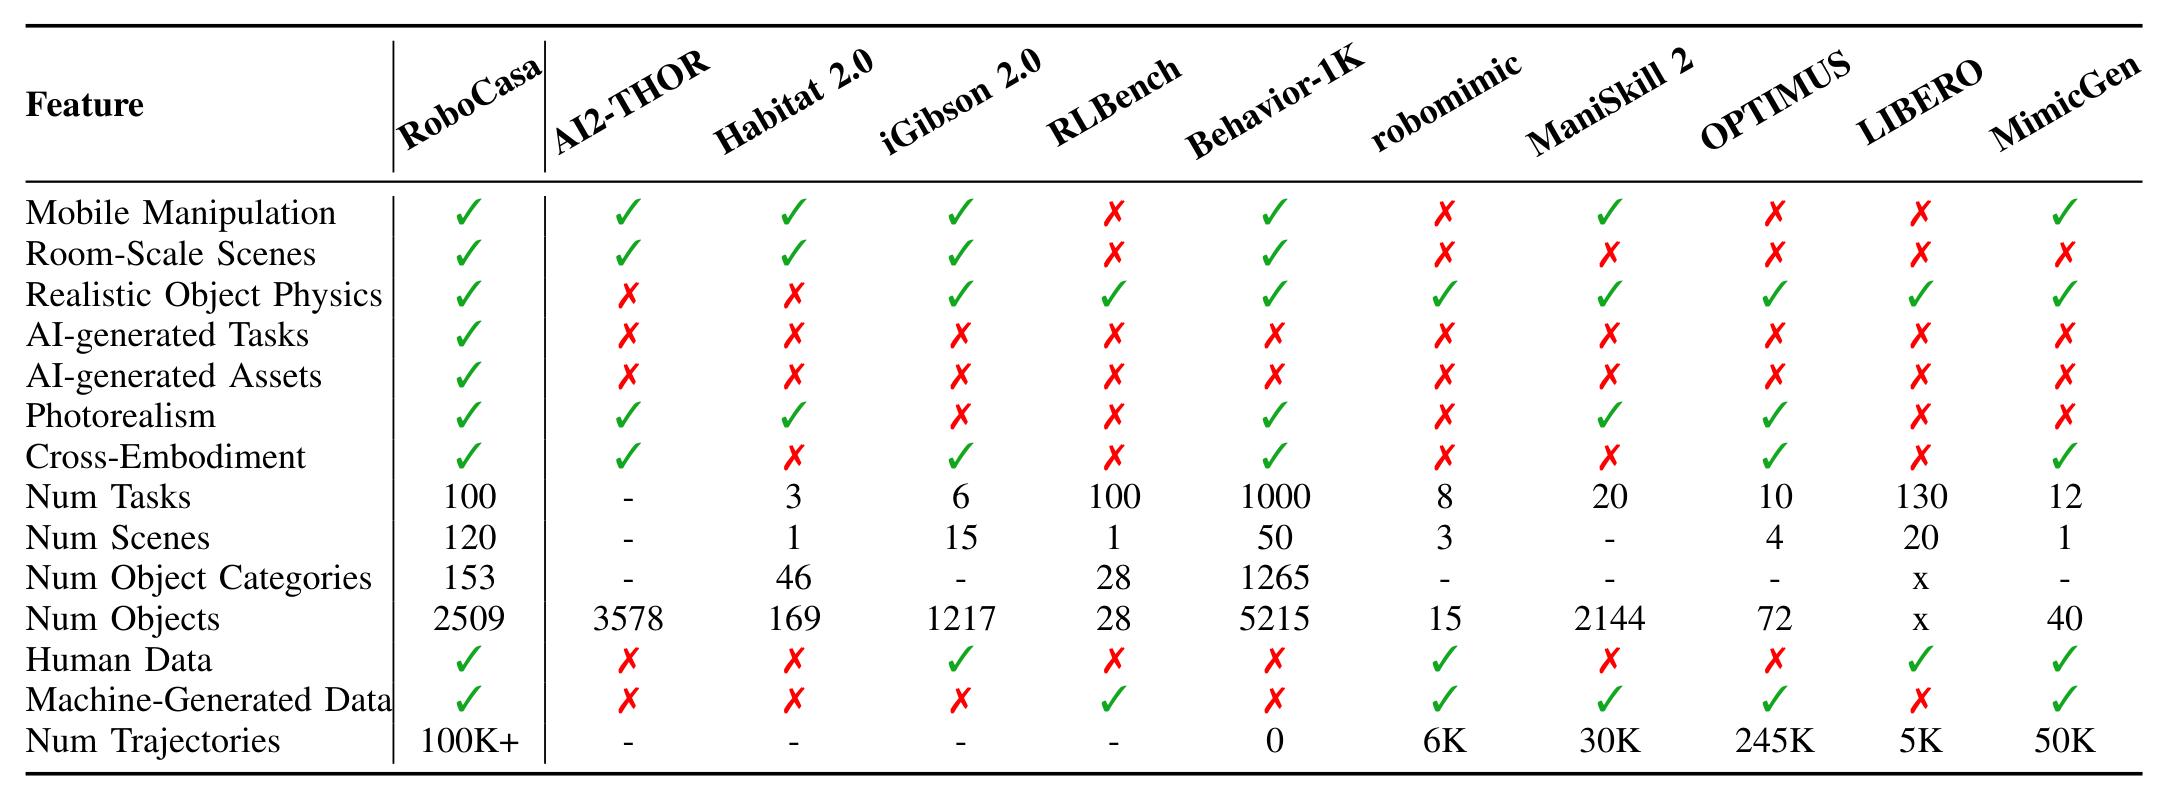
규모 항목만 옮기면 다음과 같다. 하이픈은 원표에서 값이 비어 있는 항목이다.
| 프레임워크 | 과제 수 | 장면 수 | 물체 범주 | 물체 수 | trajectory 수 |
|---|---|---|---|---|---|
| RoboCasa | 100 | 120 | 153 | 2,509 | 10만 개 이상 |
| AI2-THOR | - | - | - | 3,578 | - |
| Habitat 2.0 | 3 | 1 | 46 | 169 | - |
| iGibson 2.0 | 6 | 15 | - | 1,217 | - |
| RLBench | 100 | 1 | 28 | 28 | - |
| Behavior-1K | 1,000 | 50 | 1,265 | 5,215 | 0 |
| robomimic | 8 | 3 | - | 15 | 6,000 |
| ManiSkill 2 | 20 | - | - | 2,144 | 3만 개 |
| OPTIMUS | 10 | 4 | - | 72 | 24만 5천 개 |
| LIBERO | 130 | 20 | 미기재 | 미기재 | 5,000 |
| MimicGen | 12 | 1 | - | 40 | 5만 개 |
과제 수만 보면 Behavior-1K가 1,000종, LIBERO가 130종으로 RoboCasa의 100종보다 많다. 그러나 Behavior-1K는 trajectory가 0이고 LIBERO는 5,000개에 그친다. 반대로 trajectory 수가 24만 5천 개로 가장 많은 OPTIMUS는 과제 10종에 장면 4개로 범위가 좁다. RoboCasa의 주장은 규모 항목 하나를 최고로 만드는 것이 아니라 과제와 장면, 물체, 데이터의 규모를 동시에 확보하는 데 있다.
기능 항목에서는 세 가지가 RoboCasa의 차별점으로 제시된다.
- AI 생성 과제와 AI 생성 asset을 갖춘 프레임워크는 비교 대상 11종 중 RoboCasa뿐이다.
- 방 규모 장면과 mobile manipulation을 함께 지원하면서 물체 grasping과 배치를 포함한 모든 상호작용에 사실적 물리를 적용한다. AI2-THOR와 Habitat 2.0은 mobile manipulation을 지원하지만 사실적 물체 물리는 적용하지 않는다.
- 사람 데이터와 기계 생성 데이터를 모두 제공한다. Behavior-1K는 두 가지 모두 제공하지 않는다.
한계
composite task의 fine-tuning 성능이 낮다는 점을 저자들이 가장 먼저 꼽는다. 더 강한 policy 구조와 학습 알고리즘, 그리고 합성 데이터 품질 개선이 필요하다고 본다. MimicGen이 만든 trajectory는 성공 판정을 통과했더라도 급격한 움직임이나 충돌을 포함하는 경우가 많은데, 시뮬레이션 상태와 trajectory를 검사해 그런 동작을 자동으로 걸러낼 수 있다고 제안한다.
LLM으로 과제를 만들었다지만 구현 코드는 결국 사람이 짰다. 앞으로는 LLM이 수천 개의 새 장면과 과제를 제안하고 그것을 구현하는 코드까지 사람 개입을 최소화한 채 쓰게 하려 한다. 주방 밖 환경과 과제로 범위를 넓히는 일도 남은 과제다.
데이터셋의 성격에도 제약이 있다. 지금 데이터는 중요한 거친 조작 동작을 담고 있지만 고난도 dexterity가 필요한 skill이나 변형 가능한 물체 조작, 양팔 조작 과제는 포함하지 않는다. atomic task를 이루는 여덟 skill 목록 자체도 전부가 아니다.
MimicGen 자체의 제약도 남아 있다. mobile manipulation trajectory를 생성하지 못해 주방 내 이동 과제가 대규모 생성 데이터에서 빠졌고, 그 결과 Generated 계열 실험은 25종이 아니라 24종을 대상으로 한다.
실제 기기 실험의 범위도 좁다. pick-and-place 계열 세 과제, embodiment 하나에 그치므로 전이 주장의 일반성은 제한적이다. 저자들은 마지막으로 자체 시뮬레이션과 다른 시뮬레이터, 인터넷 영상, 실제 로봇 데이터를 함께 쓰는 학습을 다음 방향으로 제시한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| atomic task | skill 하나로 끝나는 짧은 과제. RoboCasa에 25종이 있고 여덟 가지 기본 skill에서 파생된다 |
| composite task | 여러 skill을 순서대로 엮어야 하는 long-horizon 과제. LLM이 제안한 청사진을 사람이 코드로 옮겨 75종을 만들었다 |
| task variant | 같은 과제를 언어로 구분되는 여러 목표로 나눈 변형. pick-and-place는 물체 범주마다, 가스레인지 조작은 화구마다 variant를 둔다 |
| activity prompting / task prompting | composite task 생성의 두 단계 프롬프트. 앞 단계에서 주방 활동 목록을 받고 뒤 단계에서 활동마다 과제 청사진을 받는다 |
| MimicGen | 사람 시연을 물체 중심 구간으로 쪼개 새 장면에 맞춰 변환하고 재조합하는 자동 trajectory 생성 도구 (Mandlekar 2023). RoboCasa 데이터 확장의 핵심 |
| layout / style | 주방 장면을 정의하는 두 항목. layout은 floor plan 10종, style은 가구와 가전, 텍스처 선택 12종을 정하며 조합으로 120개 장면이 나온다 |
| BC-Transformer | RoboMimic이 공개한 Transformer 기반 visuomotor policy 구현. 약 20M 파라미터의 6층 Transformer이며 이 논문의 학습 baseline이다 |
이 저장소 안에서의 위치
이 저장소의 physical-ai 페이지 대부분은 policy나 모델을 다룬다. RoboCasa는 그 policy들이 평가받는 무대에 해당한다. GR00T 계열 페이지들이 RoboCasa를 벤치마크 이름으로 계속 인용해 왔는데 그 이름의 출처가 이 논문이다.
GR00T N1은 RoboCasa Kitchen 24개 과제를 DexMimicGen, GR-1 Tabletop과 나란히 세 벤치마크 중 하나로 쓴다. neural trajectory co-training 실험도 RoboCasa의 30/100/300 데이터 구간에서 잰다. GR00T N1.5가 보고한 "RoboCasa 과제당 시연 30개에서 17.4에서 47.5로"라는 수치도 여기서 정의된 환경 위의 값이다. 저데이터 구간에서 차이가 벌어진다는 GR00T N1.5의 주장은 RoboCasa가 과제와 장면을 얼마나 다양하게 흔드는지를 전제로 성립한다.
MimicGen이라는 항목도 이 저장소에서 반복된다. GR00T N1의 neural trajectory든 GR-1 이후의 영상 기반 데이터 확장이든 답하려는 질문은 "사람 시연을 어떻게 불릴 것인가" 하나로 같다. RoboCasa는 그중 시뮬레이터의 특권 정보를 쓰는 경로에 해당한다.
후속작은 RoboCasa365다. 같은 저자들이 장면 120개를 2,500개로, 과제 100종을 365종으로 키우고 벤치마크 성격을 전면에 내세웠다. 이 페이지는 그 토대가 어떻게 짜였는지를 담는다.
관련 페이지
- RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots: 직접 후속작. 장면 2,500개와 과제 365종, 데이터 2,200시간으로 확장하고 multi-task, foundation model, lifelong learning 세 벤치마크를 붙였다.
- RoboCasa: 공식 구현 저장소 (RoboCasa365 v1.0.1): 공식 구현 저장소. 설치와 gym wrapper, 데모 스크립트를 다룬다.
- RoboCasa 프로젝트 페이지 (RoboCasa365 공식 홈): 프로젝트 홈페이지. 두 논문을 함께 소개한다.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: RoboCasa Kitchen 24개 과제를 주요 벤치마크로 쓰고 neural trajectory co-training도 여기서 잰다.
- GR00T N1.5: RoboCasa 저데이터 구간에서 17.4에서 47.5로의 개선을 보고한다. 이 환경 정의 위의 수치다.
- RT-1: Robotics Transformer for Real-World Control at Scale: 실세계 시연 13만 개를 직접 모은 반대편 경로. RoboCasa가 우회하려는 수집 비용 문제를 정면으로 감당한 사례다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 사람 시연으로 policy를 학습하는 또 다른 경로. 시뮬레이션 없이 실제 기기 teleoperation에 기댄다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 분류 기준과 학습 경로 허브.