Overviews · OVERVIEW · 2026
VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics
요약
이 페이지는 VLA가 어떤 전환을 거쳐 지금의 형태에 이르렀는지를 정리하고, 현재 가장 많이 인용되는 세 계열인 NVIDIA GR00T, Physical Intelligence π, Google DeepMind Gemini Robotics를 세대별로 나란히 놓고 비교한다. VLA는 vision-language-action model의 약어로, 카메라 이미지와 지시문(instruction)을 받아 로봇 제어 명령을 직접 내놓는 모델을 가리킨다. 저장소가 보유한 논문, 기술 보고서, 공식 블로그, 저장소 README, 한국어 해설 35편을 근거로 삼았고 그 밖의 정보는 채우지 않았다.
세 계열은 같은 문제에서 출발한다. 웹 규모로 학습한 VLM의 상식과 언어 이해를 유지하면서, 로봇이 1초에 수십 번 이상 부드러운 연속 action을 내게 만드는 문제다. 세 계열 모두 이산 action token을 버리고 연속 action 생성으로 옮겨 갔고, 느린 이해 모듈과 빠른 제어 모듈을 나누는 방향으로 수렴했다. 반면 무엇을 더 키워 일반화를 얻는지는 서로 다르다. GR00T는 합성 데이터와 오픈 생태계를, π는 학습 레시피와 데이터 활용 방식을, Gemini Robotics는 frontier 모델의 embodied reasoning을 앞세운다.
배경
VLA 이전의 출발점
RT-1은 이미지와 언어를 토큰으로 바꿔 Transformer에 넣고, action도 256개 구간으로 나눈 이산 토큰으로 출력했다. 파라미터는 3,500만 개였고 3Hz로 동작했다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻하며, 3Hz는 1초에 세 번 명령을 바꾼다는 의미다.
RT-2는 같은 구도를 거대한 pre-trained VLM 위로 옮기면서 VLA라는 범주를 만들었다. 로봇 데이터만이 아니라 웹 VQA 데이터를 배치에 계속 섞는 co-fine-tuning이 핵심 레시피였다. 이어 Open X-Embodiment가 여러 기관의 로봇 데이터를 한 형식으로 묶으면서 관심사가 "한 모델 여러 과제"에서 "한 모델 여러 로봇"으로 넘어갔다.
OpenVLA는 이 계보의 첫 완전 오픈소스 재현이다. 7B 모델이 55B RT-2-X를 앞서면서 action tokenization이 사실상 표준이 됐다. action tokenization은 연속값인 제어 명령을 정해진 구간으로 나눠 이산 토큰으로 바꾸는 기법이다.
이산 토큰 방식의 한계
이산 토큰 방식은 VLM의 다음 토큰 예측을 그대로 쓸 수 있다는 장점이 있지만, 제어 품질에서 두 가지 한계가 드러났다.
- 토큰을 하나씩 자기회귀로 생성하므로 control frequency를 높이기 어렵다.
- 연속값을 구간으로 자르면 정밀한 dexterous manipulation에 필요한 해상도가 부족해진다.
같은 시기에 다른 가지가 자라고 있었다. ACT와 ALOHA는 VLM 없이 action chunking을 도입했다. action chunking은 미래 여러 스텝의 action을 한 묶음으로 한 번에 예측하는 방식이다. 이 발상은 이후 세 계열이 모두 채택하는 action chunk 출력의 출처가 된다.
발전 과정의 네 가지 전환
세 계열을 비교하려면 먼저 비교 기준을 정해야 한다. 2024년 이후 VLA 설계는 아래 네 가지 측면에서 크게 바뀌었고, 세 계열의 차이도 대부분 이 네 측면 중 어디에 무게를 두었는지로 설명된다.
| 측면 | 이전 | 이후 | 대표 사례 |
|---|---|---|---|
| action 출력 | 이산 토큰, 자기회귀 | flow matching이나 DiT로 연속 action chunk 생성 | π0, GR00T N1 |
| 모델 구조 | VLM 하나가 전부 처리 | 느린 이해 모듈과 빠른 제어 모듈 분리 | Helix, GR00T N1, Gemini Robotics |
| 데이터 | 단일 로봇 teleoperation | cross-embodiment, 웹, 합성 영상, 사람 영상 co-training | GR00T data pyramid, π0.5 |
| 학습 신호 | imitation learning만 사용 | 배치 후 experience, 강화학습, 조건부 prompt | π*0.6, π0.7 |
action 출력의 전환
flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다. π0가 PaliGemma 3B에 300M 규모의 action expert를 결합하고 flow matching으로 50 스텝 action chunk를 생성하면서 control frequency를 최대 50Hz로 올렸다. GR00T N1도 같은 flow matching을 쓰되 action 생성 신경망을 DiT로 구현했다. DiT는 diffusion 모델의 denoising 신경망을 Transformer로 구현한 구조다.
VLA 서베이는 이 변화를 backbone과 action head 조합으로 분류한다. VLM에 flow matching action head를 붙인 조합에 π0를, VLM에 diffusion transformer를 붙인 조합에 GR00T N1을 놓는다.
모델 구조의 전환
dual-system VLA는 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 VLA 구조다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. Figure AI의 Helix가 2025년 2월 7B VLM과 80M policy, 200Hz라는 수치로 이 분업을 공개했고, 한 달 뒤 GR00T N1이 같은 분업을 논문과 오픈 가중치로 내놓았다.
다만 dual-system이라는 이름의 범위는 자료마다 다르다. OpenHelix 서베이는 System 1이 실시간 perception 입력을 직접 받는지를 판정 기준으로 세우고, 이 기준으로 π0와 GR00T N1을 dual-system에서 제외한다. 두 모델의 제어 모듈은 이미지를 직접 보지 않고 VLM이 만든 표현만 받기 때문이다. 이 페이지는 비교를 위해 "이해 모듈과 제어 모듈의 분리"라는 넓은 의미로 쓰되, 엄밀한 분류는 OpenHelix 기준을 따른다는 점을 밝혀 둔다.
데이터와 학습 신호의 전환
로봇 데이터는 웹 텍스트와 달리 인터넷에 쌓여 있지 않고, 로봇마다 센서와 자유도가 달라 서로 호환되지 않는다. 세 계열은 이 부족을 서로 다른 원천으로 메운다. GR00T는 시뮬레이션과 영상 생성 모델로 만든 합성 데이터를, π는 성격이 다른 여러 원천의 co-training을, Gemini Robotics는 Gemini가 이미 가진 웹 지식과 embodied reasoning을 주로 끌어온다. co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 포함하는 방식이다.
2025년 하반기부터는 무엇을 학습 데이터로 쓸지에서 어떻게 학습 신호를 만들지로 관심이 이동한다. π*0.6은 배치된 로봇의 성공과 실패를 강화학습 신호로 바꾸고, π0.7은 품질이 낮은 데이터를 버리지 않고 prompt에 품질 라벨을 적어 함께 학습한다.
GR00T 계열
GR00T는 NVIDIA가 humanoid를 주 대상으로 내놓은 VLA 계열이다. 세대마다 가중치와 학습 코드를 공개해 왔고, Isaac 시뮬레이터와 Cosmos world model을 포함한 NVIDIA 자체 생태계와 결합되어 있다는 점이 가장 큰 특징이다.
GR00T N1
GR00T N1은 2025년 3월 18일 GTC 2025에서 논문, 블로그, GR00T-N1-2B 체크포인트와 함께 공개됐다. 전체 파라미터는 2.2B이고 그중 vision-language 부분이 1.34B다.
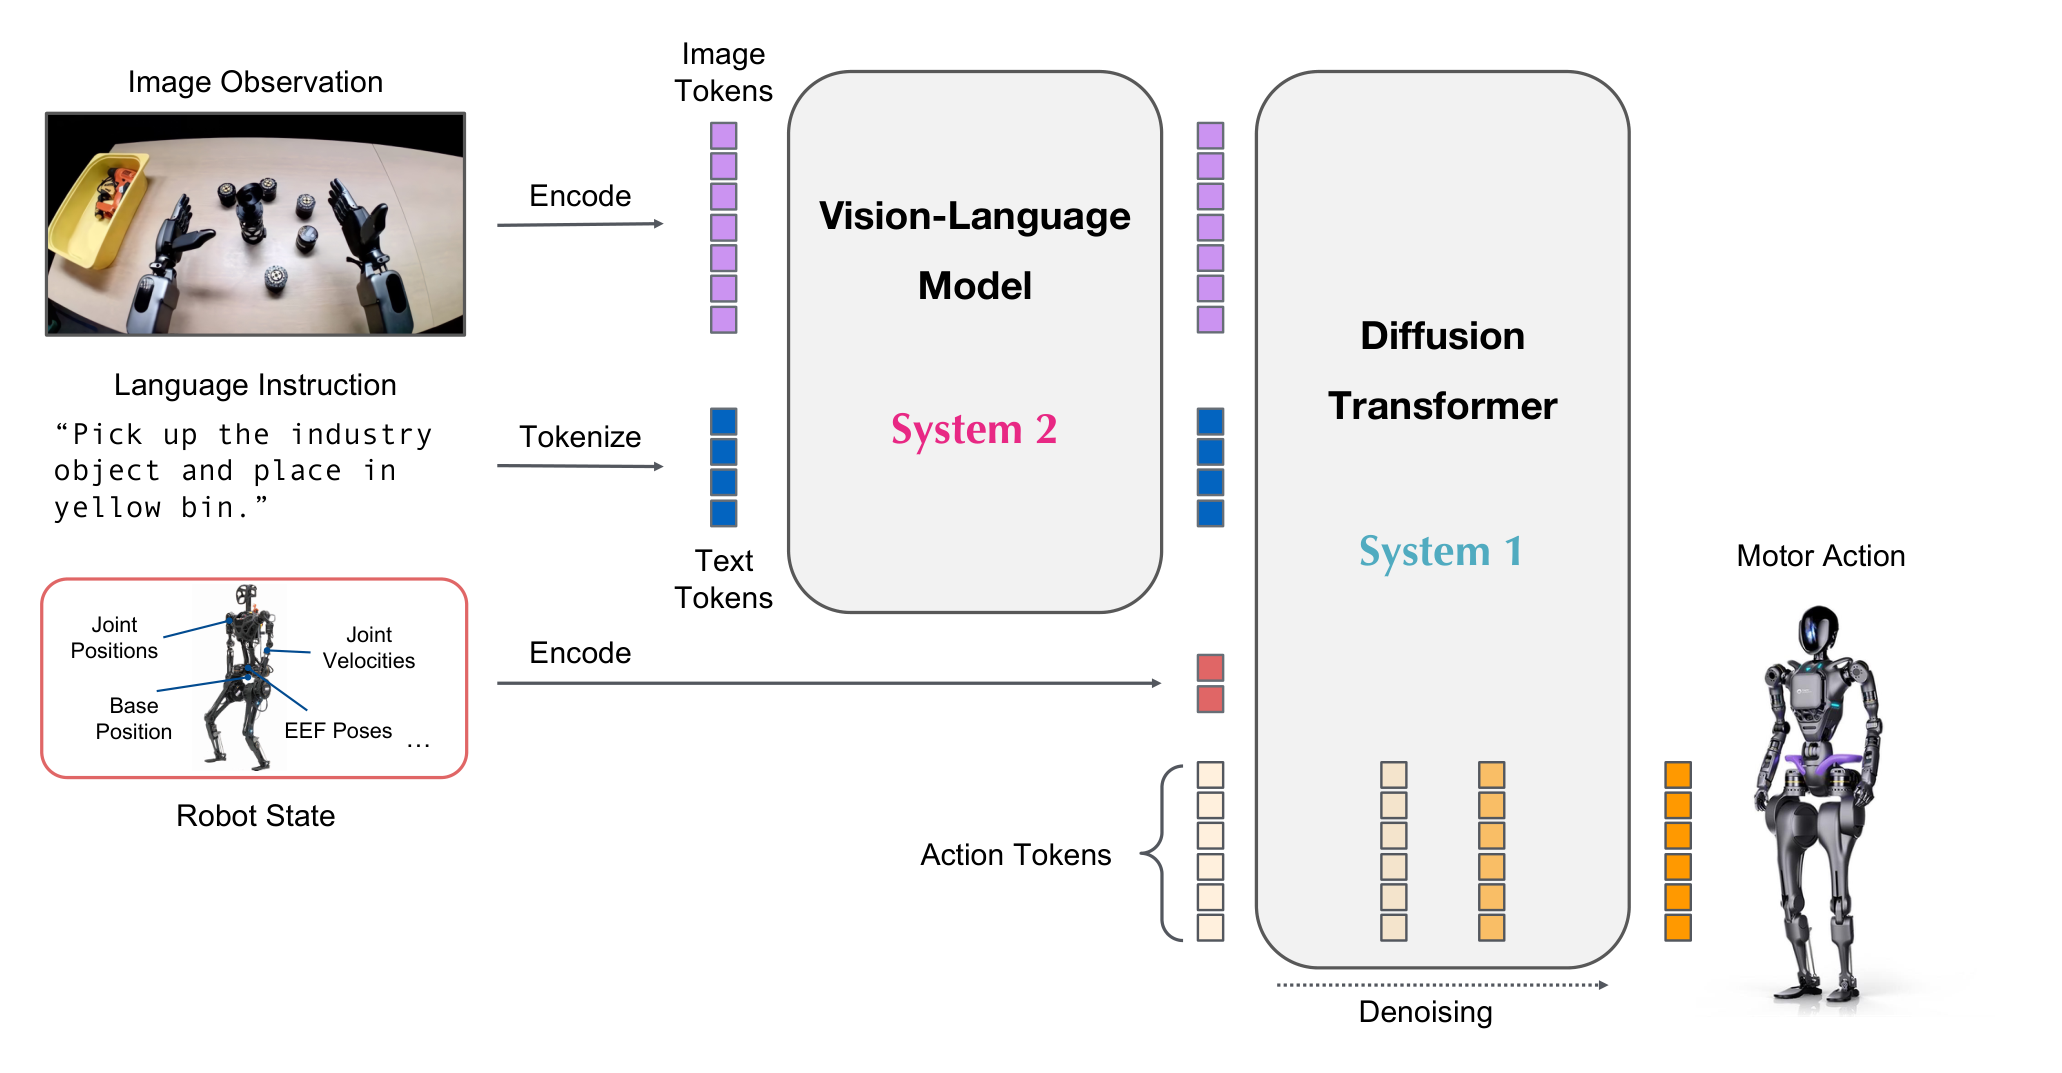
구조는 두 모듈로 나뉜다.
| 모듈 | 구성 | 주기 | 역할 |
|---|---|---|---|
| System 2 | Eagle-2 VLM (SmolLM2와 SigLIP-2), 224×224 입력, 12번째 layer 임베딩 사용 | 10Hz | 장면과 지시문 해석 |
| System 1 | flow matching으로 학습한 DiT, cross-attention으로 VLM 토큰 참조 | 120Hz | 모터 action chunk 생성 (H=16) |
두 모듈은 따로 학습해 이어붙인 파이프라인이 아니라 학습 중 함께 최적화되는 하나의 모델이다. 논문은 π0와의 차이도 명시한다. π0는 VLM과 action expert를 mixture-of-experts로 묶어 self-attention을 공유하지만, GR00T N1은 단순한 cross-attention으로 연결해 양쪽 구조를 자유롭게 고를 수 있게 했다. 로봇마다 다른 state와 action은 embodiment별 MLP encoder와 decoder가 처리한다. embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다.
N1의 실질적 기여는 데이터 전략이다. data pyramid는 웹 데이터와 사람 영상, 합성 데이터, 실제 로봇 데이터를 양이 많은 순으로 쌓아 함께 학습에 쓰는 데이터 전략이다. pre-training 코퍼스는 모두 8,375.7시간이다.
| 원천 | 프레임 | 시간 |
|---|---|---|
| 실제 로봇 | 2억 6,230만 | 3,288.8시간 |
| 사람 영상 | 1억 8,130만 | 2,517.0시간 |
| 시뮬레이션 | 1억 2,550만 | 1,742.6시간 |
| neural trajectory | 2,380만 | 827.3시간 |
neural trajectory는 video world model이 만들어낸 합성 trajectory 데이터다. N1은 GR-1 teleoperation 88시간을 영상 생성 모델로 827시간까지 약 10배 늘렸다. action 라벨이 없는 영상에는 latent action이나 Inverse Dynamics Model로 pseudo-action을 붙였다. 시뮬레이션 쪽에서는 DexMimicGen이 11시간 만에 사람 시연 약 9개월 분량인 6,500시간어치 시연 데이터(demonstration)를 생성했다.
결과는 시뮬레이션과 실제 로봇 모두에서 Diffusion Policy를 앞섰다. 과제당 시연 100개 조건에서 세 시뮬레이션 벤치마크 평균이 45.0%로 Diffusion Policy의 33.4%보다 11.6%p 높았고, 실제 GR-1 로봇 전체 데이터 조건에서는 평균 76.8%로 46.4%를 30.4%p 앞섰다. 추론은 L40 GPU에서 action 16개 묶음에 63.9ms가 걸린다.
GR00T N1.5
N1.5는 논문 없이 프로젝트 페이지로 공개된 개선 버전이다. 공개 시점은 페이지에 적혀 있지 않지만, Eagle 저장소 기록상 Eagle 2.5가 N1.5의 backbone이 된 것은 2025년 6월이다. 바뀐 지점은 네 가지다.
- VLM을 pre-training과 fine-tuning 모두에서 고정하고 adapter를 단순화했다.
- backbone을 grounding과 물리 이해에 맞춰 다시 튜닝한 Eagle 2.5로 교체했다.
- flow matching 손실에 FLARE 손실(계수 0.2)을 추가했다. FLARE는 미래 observation의 임베딩과 모델 내부 표현을 맞추는 손실이라 action 라벨 없는 사람 영상으로도 학습할 수 있다.
- DreamGen이 만든 합성 데이터를 pre-training mixture의 9.1%로 포함했다.
| 평가 | N1 | N1.5 |
|---|---|---|
| 실제 GR-1 지시 추종 비율 | 46.6% | 93.3% |
| 실제 GR-1 전체 성공률 | 43.3% | 83.0% |
| Unitree G1 과일 집기 post-training | 44.0% | 98.8% |
| DreamGen으로 학습한 새 동사 12종 | 13.1% | 38.3% |
post-training은 pre-training을 마친 모델을 특정 embodiment나 과제 데이터로 이어서 학습시키는 단계다. 다만 N1.5 페이지는 변경 항목별 ablation과 시행 횟수를 싣지 않았으므로, 네 변경 중 어느 것이 개선을 만들었는지는 자료로 확인할 수 없다.
GR00T N1.6과 N1.7
N1.6과 N1.7에는 논문이 없고, 공식 저장소 README와 이를 쓴 제3자 논문에서 정보를 모아야 한다. 저장소 기록으로 확인되는 변화는 다음과 같다.
| 항목 | N1.6 | N1.7 |
|---|---|---|
| 공개 | 2025년 12월 무렵 (Eagle 저장소 기록) | 2026년, Isaac-GR00T GA 릴리스 |
| 규모 | 3.29B (GR00T-N1.6-3B) |
3B (GR00T-N1.7-3B) |
| backbone | Eagle 계열 native resolution 변형 (Eagle-Block2A-2B-v2) |
Cosmos-Reason2-2B (Qwen3-VL 계열), 완전 고정 |
| action head | DiT 32 layer | DiT 16 layer, denoising 4 스텝 |
| action chunk | 16 | 40 |
| whole-body control 제어기 | Decoupled WBC (하체 RL, 상체 IK) | GEAR-SONIC (전신 단일 policy, 50Hz) |
N1.7에서 두 가지 변화가 두드러진다. 첫째, backbone이 Eagle에서 NVIDIA의 world model 계열인 Cosmos-Reason2로 바뀌면서 N1부터 이어진 Eagle 계보가 끊겼다. 둘째, relative EEF action space를 사람 데이터와 로봇 데이터에 공통으로 적용하고 EgoScale 사람 영상 2만 시간을 pre-training에 포함했다. relative EEF action space는 action을 절대 목표 pose가 아니라 현재 pose로부터의 변화량으로 적는 표현이다.
GR00T는 whole-body control을 VLA 안에서 풀지 않고 별도 제어기에 맡긴다. whole-body control은 균형과 이동을 포함해 몸 전체를 함께 제어하는 문제다. GR00T VLA가 manipulation 수준의 목표를 내면, N1.7에서는 UNITREE_G1_SONIC embodiment tag를 통해 latent action token을 내고 SONIC이 이를 전신 관절 명령으로 바꾼다.
GR00T 계열의 성격
- 주 대상이 humanoid다. 평가 로봇이 Fourier GR-1과 Unitree G1이고, 탁상 팔은 벤치마크 체크포인트로 지원한다.
- 공개 범위가 가장 넓다. 코드는 Apache-2.0, 가중치는 상업 이용이 가능한 NVIDIA Open Model License로 공개되고 LeRobot에서도
grootpolicy로 쓸 수 있다. - 데이터 부족을 시뮬레이션과 영상 생성으로 메운다. Isaac Sim과 Isaac Lab, DexMimicGen, DreamGen, Cosmos가 모두 같은 회사의 자산이다.
- 온보드 추론을 전제로 한다. N1.7은 16GB 이상 GPU를 요구하고, TensorRT 변환 후 RTX 5090에서 31ms, Jetson AGX Thor에서 92ms, Orin에서 173ms가 걸린다.
π 계열
π는 Physical Intelligence가 내놓은 VLA 계열이다. 모델 구조는 세대가 바뀌어도 VLM backbone과 action expert의 결합이라는 틀을 유지하고, 대신 학습 레시피를 세대마다 바꿔 왔다는 점이 특징이다. 세대별 관심사는 아키텍처에서 데이터 구성으로, 다시 학습 신호와 prompt로 옮겨 갔다.
π0
π0는 2024년 10월 31일 공개됐다. PaliGemma 3B(SigLIP 400M과 Gemma 2.6B)에 무작위 초기화한 300M action expert를 결합한 3.3B 모델이다. action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음으로, VLM과 self-attention에서만 상호작용한다.
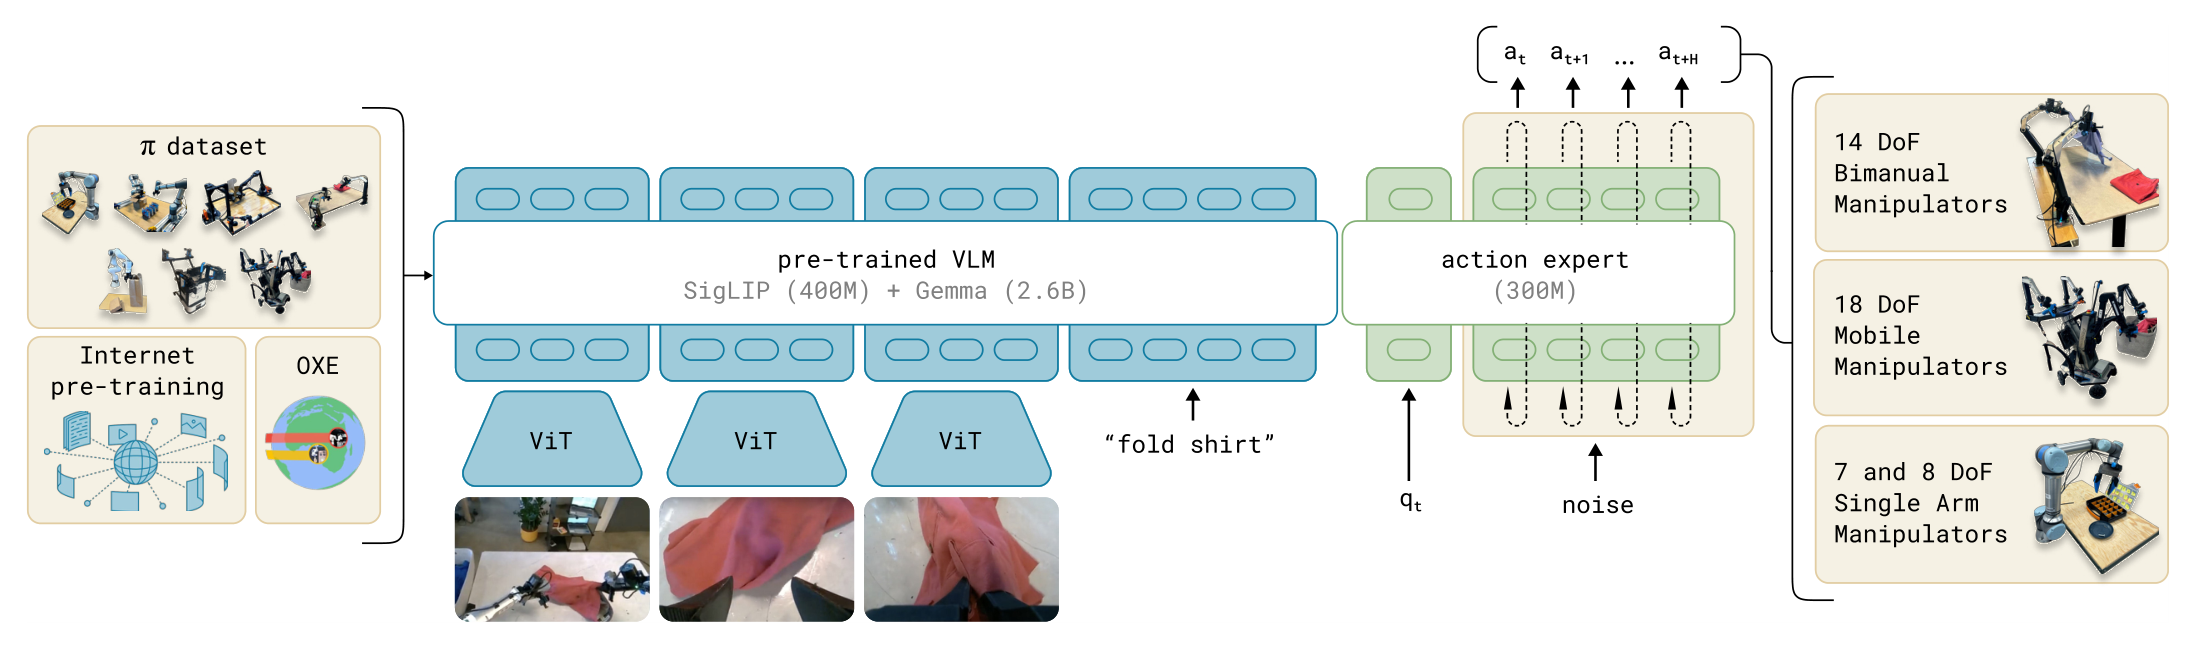
action은 flow matching으로 H=50 chunk를 10 스텝에 걸쳐 생성한다. RTX 4090에서 추론 한 번에 온보드 73ms, 오프보드 86ms가 걸리고, 로봇에 따라 20Hz 또는 50Hz로 동작한다. 학습 데이터는 7종 로봇 구성과 68개 과제에서 모은 1만 시간 이상의 로봇 데이터이며, OXE 같은 공개 데이터는 mixture의 9.1%다.
π0의 두 번째 기여는 LLM의 pre-training과 post-training 분리를 로봇에 옮긴 레시피다. 넓은 데이터로 pre-training한 뒤 과제별 정제 데이터로 post-training하면 건조기에서 빨래를 꺼내 개어 쌓는 20분짜리 과제까지 수행한다. zero-shot 비교에서 셔츠 개기 1.000, 식탁 치우기(쉬움) 0.971의 점수로 OpenVLA와 Octo를 크게 앞섰다.
π0-FAST와 π0.5
π0-FAST는 flow matching 대신 FAST tokenizer로 action chunk를 압축해 이산 토큰으로 학습하는 변형이다. FAST tokenizer는 action chunk를 압축해 이산 토큰으로 적는 방식이다. 학습은 약 5배 빨라지지만 자기회귀 디코딩이라 실시간 제어에는 불리하다. VLA 서베이는 RTX 4090 기준 지연을 약 750ms로 기록한다.
π0.5는 2025년 4월 22일 공개됐다. 모델 규모는 π0와 같고, 바뀐 것은 학습 데이터 구성과 두 단계 레시피다.
| 단계 | 스텝 | action 표현 | 추가 요소 |
|---|---|---|---|
| pre-training | 28만 | FAST 토큰, 다음 토큰 예측만 사용 | 이질 데이터 전부 |
| post-training | 8만 | flow matching action expert 추가 | 성공 episode만 유지, verbal instruction 추가 |
pre-training mixture는 다섯 가지 원천으로 구성된다. 약 100개 가정의 mobile manipulator 데이터(약 400시간), 가정의 고정 팔 데이터, 실험실 cross-embodiment 데이터와 OXE, subtask 라벨과 bounding box 데이터, 웹 데이터다. 평가 대상인 mobile manipulator 데이터는 첫 단계 전체의 2.4%에 불과하다. 즉 나머지 97.6%가 다른 로봇이나 웹에서 온 데이터인데도 모델은 학습에 한 번도 등장하지 않은 실제 가정집 세 곳에서 10~15분짜리 정리 과제를 수행했다.
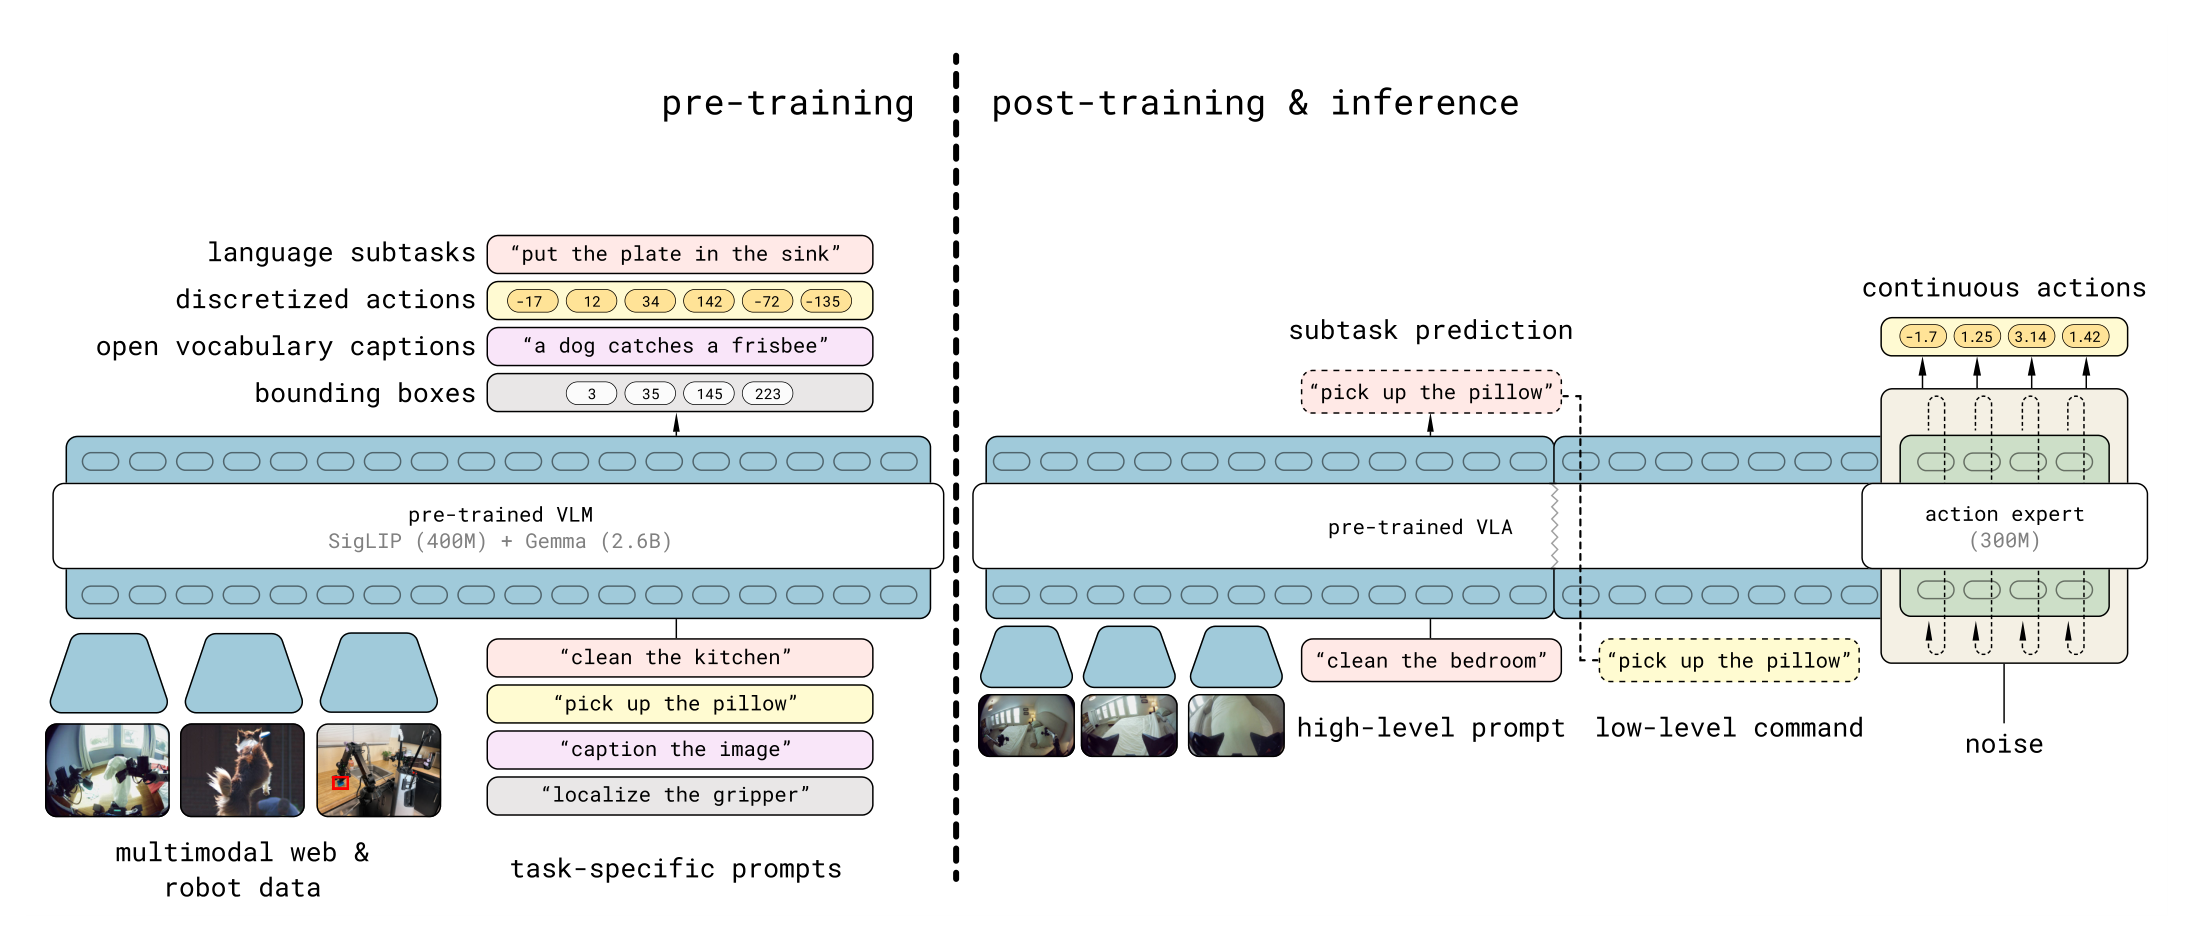
π0.5의 계층 구조는 모델 하나 안에 있다. 같은 가중치가 먼저 "접시를 집어라" 같은 subtask 문장을 예측하고, 그 문장을 조건으로 action을 생성한다. 이 구조에서 high-level 추론을 제거하면 성공률이 79%에서 62%로 하락하고, GPT-4를 high-level 모듈로 쓰면 58%로 더 낮았다. ablation에서는 cross-embodiment 데이터를 빼면 평균이 79%에서 51%로, 가정 고정 팔 데이터를 빼면 54%로 하락했다. 데이터 원천 하나하나가 일반화에 기여한다는 뜻이다.
π0.6과 π*0.6
π0.6은 2025년 11월 17일 π*0.6 논문과 함께 공개됐다. backbone을 Gemma 3 4B로 키우고 action expert를 860M으로 늘렸으며 pre-training에 로봇 플랫폼을 더 추가했다. 별도 논문은 없고 세부는 모델 카드로 넘긴다.
π*0.6은 새 아키텍처가 아니라 새 학습 레시피인 RECAP의 결과다. RECAP은 세 단계를 반복한다.
- 배치된 로봇이 자율 실행하며 experience를 쌓고, 전문가가 실시간으로 교정한다.
- 670M 규모의 value function이 각 시점에서 과제 종료까지 남은 스텝 수를 예측하도록 학습한다.
- 각 action의 advantage가 기준보다 높은지를 "Advantage: positive" 같은 텍스트로 prompt에 추가해 VLA를 다시 학습한다. 추론 시에는 항상 positive로 고정한다.
advantage는 어떤 action이 평균보다 얼마나 나은지를 나타내는 값이다. 이 방식은 flow matching 모델에서 log-likelihood를 계산하기 어려워 PPO 같은 표준 강화학습을 적용하기 힘들다는 문제를 우회한다. 결과로 가장 어려운 과제에서 throughput이 두 배 넘게 오르고 실패율이 절반 수준으로 내려갔다. 에스프레소 과제 성공률은 40%에서 93%로 올랐고, 실제 사무실에서 13시간 연속 동작했다.
π0.7
π0.7은 2026년 4월 16일 공개된 5B 모델이다. 구조는 Gemma 3 4B backbone과 860M action expert로 π0.6과 비슷하다. 달라진 것은 prompt에 담는 정보다.
| prompt 요소 | 담는 내용 | 추론 시 설정 |
|---|---|---|
| subtask | 단계 수준 지시문 | high-level policy나 사람 코칭이 제공 |
| subgoal image | 다음 단계가 끝난 장면을 그린 이미지 | 14B world model(BAGEL)이 생성 |
| episode metadata | 속도, 품질 1~5점, 실수 여부 | 빠른 속도, 품질 5, 실수 없음 |
| control mode | joint 또는 ee |
로봇에 맞춰 지정 |
이 문맥 덕분에 통상 걸러내던 실패 episode와 품질이 낮은 rollout도 라벨을 붙여 모두 학습에 쓸 수 있다. rollout은 policy를 실행해 trajectory를 만들어내는 과정이다. metadata ablation에서 데이터를 100% 쓸 때 metadata가 있으면 시간당 throughput이 22.8, 없으면 9.3이었다. 즉 metadata 없이 품질이 섞인 데이터를 전부 쓰면 오히려 성능이 떨어지고, metadata가 있어야 데이터 양이 성능으로 이어진다.
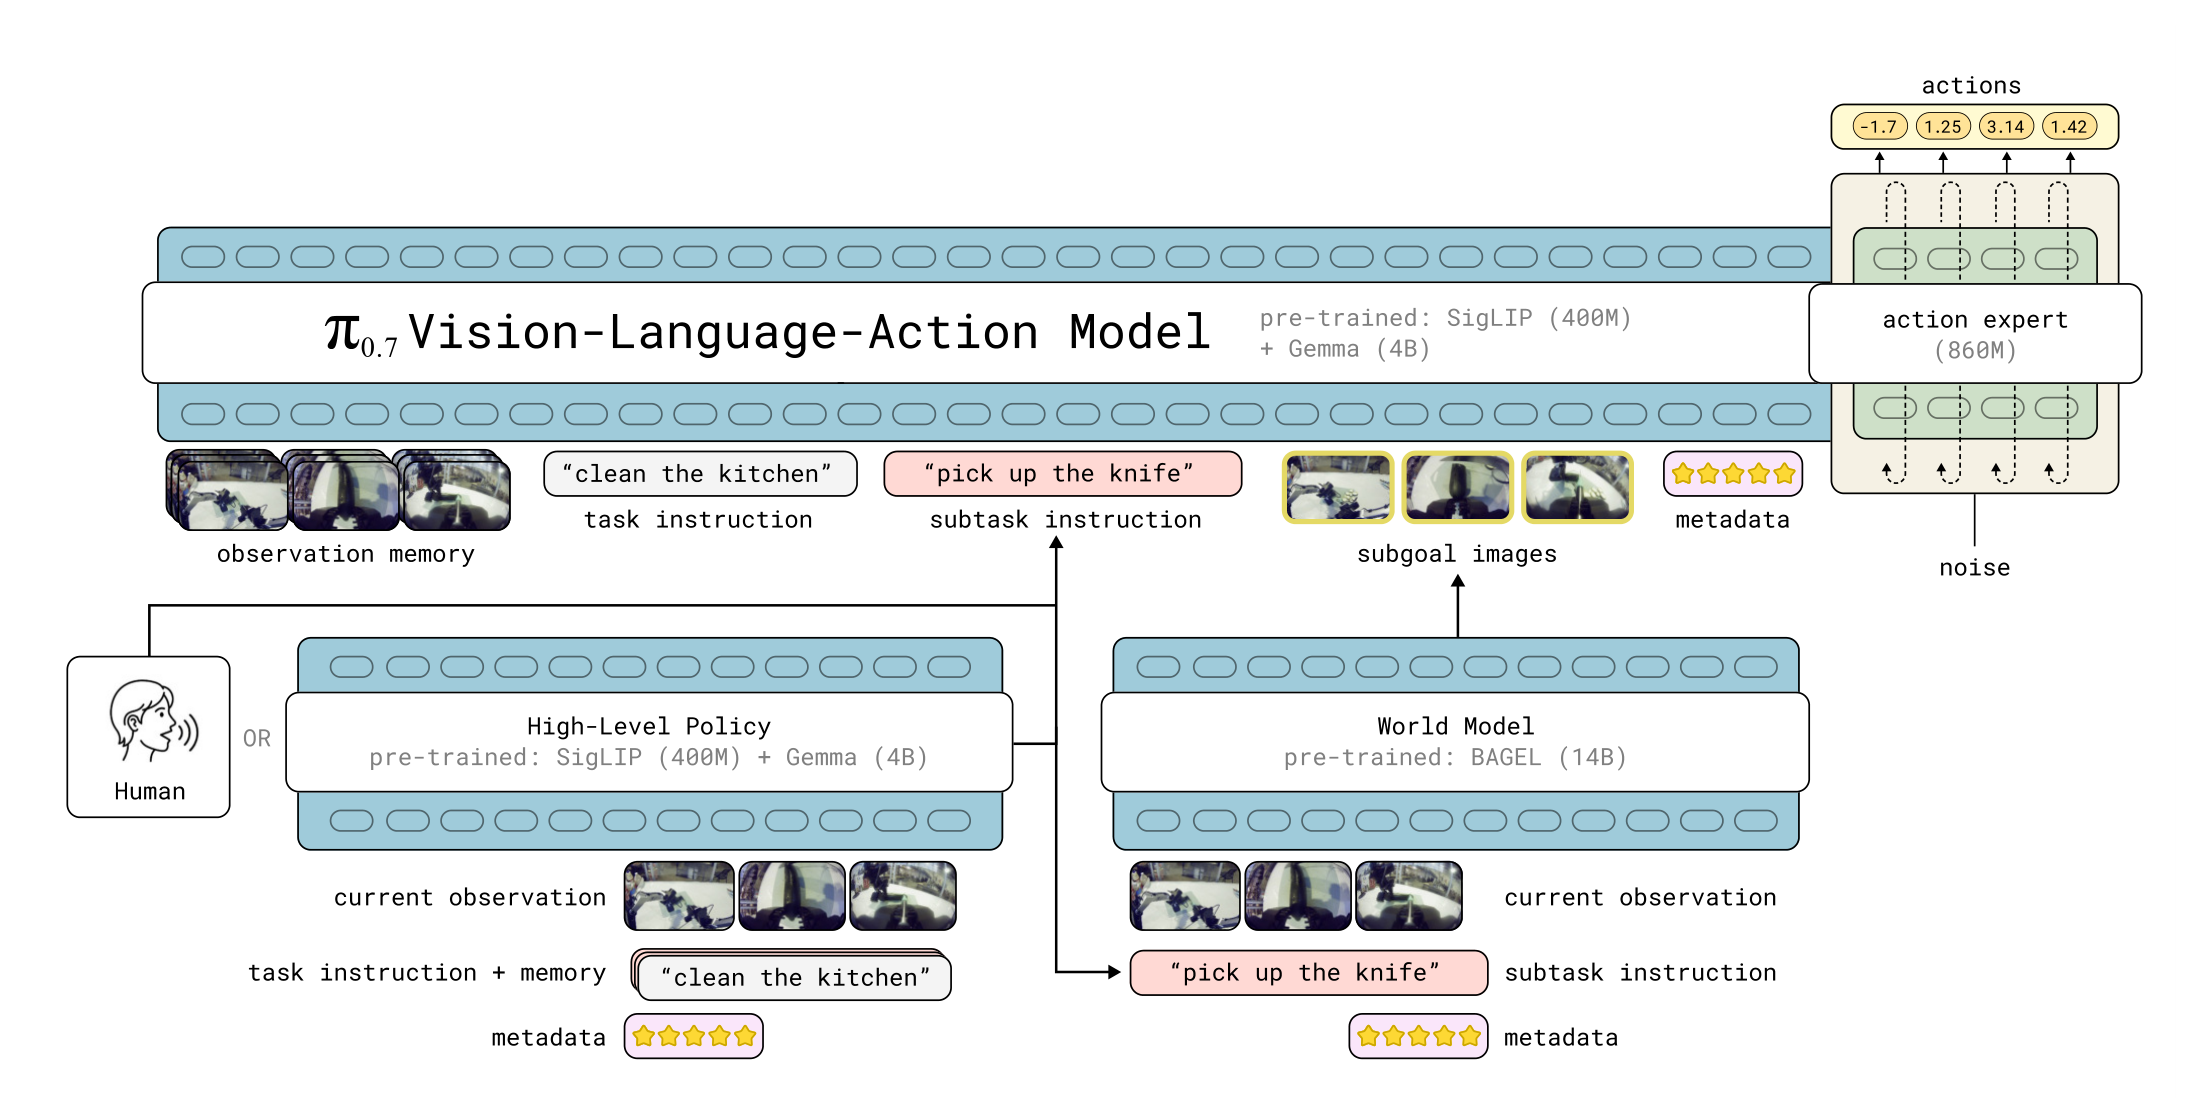
π0.7은 π*0.6 강화학습 전문 모델과 성공률이 같고 throughput은 1.4~1.5배였다. cross-embodiment 전이에서는 UR5e 빨래 데이터를 한 줄도 보지 않은 상태로 UR5e에서 셔츠를 개어 성공률 80.0%를 기록했고, 숙련 운영자 10명의 80.6%와 비슷했다. cross-embodiment는 한 로봇에서 학습한 능력을 형상이 다른 로봇으로 옮기는 것을 말한다.
π 계열의 성격
- 구조는 VLM과 action expert의 결합으로 고정하고, 세대마다 레시피를 바꾼다.
- 주 대상은 가정과 사무실의 bimanual 로봇과 mobile manipulator다. humanoid 결과는 자료에 없다.
- 공개는 부분적이다. openpi 저장소가 π0, π0-FAST, π0.5 가중치와 코드를 Apache-2.0으로 공개하지만 π0.6, π*0.6, π0.7은 공개하지 않았다.
- 모델 규모가 작아 개인 GPU에서 다룰 수 있다. openpi 기준 추론은 8GB, LoRA fine-tuning은 22.5GB로 RTX 4090 한 장에서 실행된다.
Gemini Robotics 계열
Gemini Robotics는 Google DeepMind가 Gemini 모델 위에 만든 로봇 모델 계열이다. 처음부터 embodied reasoning 모델과 VLA를 한 가족으로 묶어 내놓았고, frontier 범용 모델의 추론 능력을 로봇으로 끌어오는 것을 핵심 전략으로 삼는다. 대신 가중치와 아키텍처 세부는 세 세대 모두 공개하지 않았다.
Gemini Robotics 1.0
기술 보고서는 2025년 3월 공개됐고 두 모델을 함께 내놓았다.
| 모델 | 정체 | 역할 |
|---|---|---|
| Gemini Robotics-ER | Gemini 2.0 Flash에 embodied reasoning을 강화한 VLM | 2D 검출, pointing, trajectory와 grasp 예측, 3D box 검출 |
| Gemini Robotics | ER을 distillation한 backbone에 로봇 action을 통합한 VLA | 로봇 직접 제어 |
embodied reasoning은 물리 세계의 기하, 공간 관계, 시간 변화를 이해하는 능력을 가리킨다. 보고서는 이를 재는 객관식 400문항 벤치마크 ERQA도 함께 공개했다. action 데이터로 학습하지 않은 ER만으로도 코드 생성을 통해 ALOHA 2 시뮬레이션에서 zero-shot 평균 53%, 시연 10개를 보여 주는 in-context learning으로 65%를 기록했다.
VLA는 클라우드와 로봇에 나뉘어 동작한다. backbone은 클라우드에서 실행되며 응답 지연을 수 초에서 160ms 미만으로 줄였고, 로봇 온보드 컴퓨터의 local action decoder가 이 지연을 보정한다. 카메라 입력부터 action chunk 출력까지 약 250ms가 걸리지만 chunk 하나에 여러 action이 담기므로 유효 control frequency는 50Hz다. 보고서는 GR00T N1과 Helix가 두 모듈을 모두 로봇에서 실행하는 것과 달리, 느린 모듈을 클라우드에 둔다는 점을 차이로 든다.
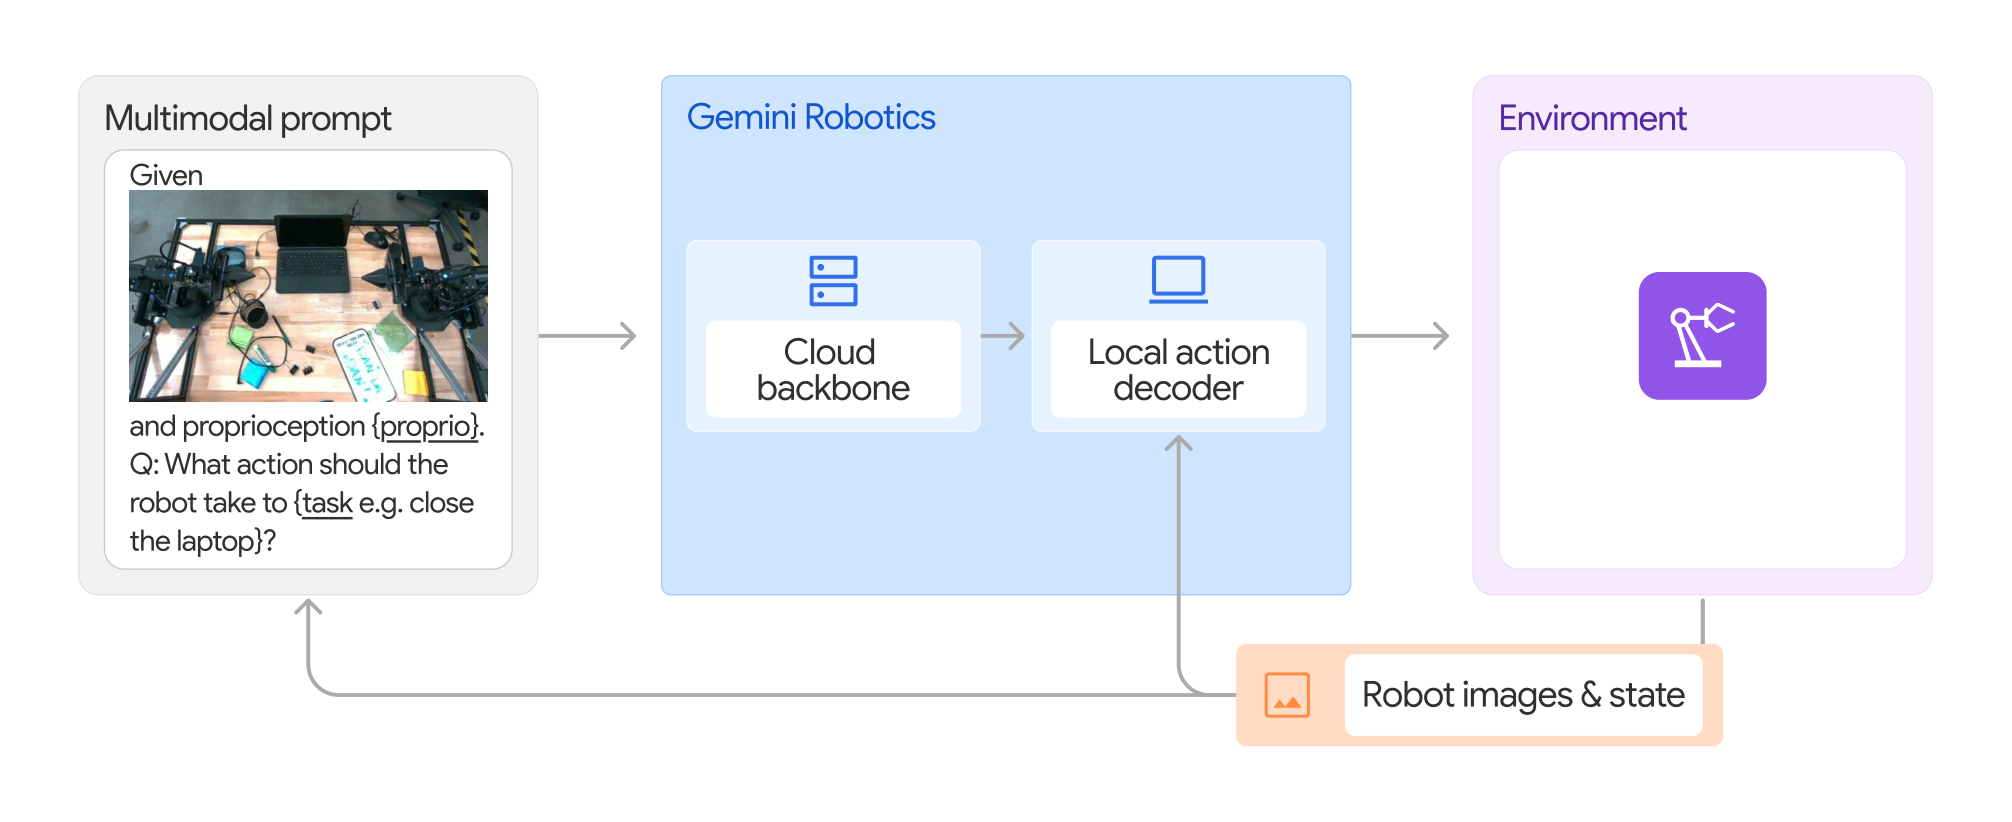
학습 데이터는 ALOHA 2 로봇 fleet에서 12개월간 수집한 수천 시간의 teleoperation 데이터와 웹 문서, 코드, 이미지, 영상, embodied reasoning 데이터다. 같은 데이터로 학습한 π0 재구현과 비교한 결과는 세 계열 사이의 유일한 직접 비교라 중요하다.
| 일반화 유형 (progress score) | Gemini Robotics | π0 재구현 | multi-task diffusion |
|---|---|---|---|
| 지시문 변형 평균 | 0.65 | 0.32 | 0.34 |
| 시각 변형 평균 | 0.75 | 0.36 | 0.34 |
| action 변형 평균 | 0.60 | 0.11 | 0.26 |
| 새 언어(스페인어) 지시문 | 0.68 | 0.04 | 0.12 |
다만 이 비교에는 조건이 붙는다. π0는 공개 체크포인트가 아니라 Google DeepMind가 재구현한 버전이고, 기준 모델은 RTX 4090 워크스테이션에서, Gemini Robotics는 클라우드에서 실행되어 실행 환경이 같지 않았다. 과제별 특화 학습에서는 도시락 싸기처럼 2분이 넘는 long-horizon 과제에서 1.00을 기록했고, 새 과제 8개 중 7개에서 시연 100개 이하로 70% 이상에 도달했다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다.
Gemini Robotics 1.5
1.5는 2025년 9월 25일 공개됐고 Gemini 2.5 계열 위에 만들어졌다. 보고서가 내세우는 혁신은 세 가지다.
| 혁신 | 내용 | 대표 수치 |
|---|---|---|
| Motion Transfer | 서로 다른 로봇의 데이터에서 동작의 통합된 이해를 학습하는 구조와 레시피 | 한 로봇에서만 모은 skill을 다른 로봇으로 zero-shot 전이. ALOHA, Franka, humanoid progress 0.66, 0.65, 0.63 |
| Thinking VLA | action을 내기 전에 자연어 thinking trace를 생성 | ALOHA multi-step progress 0.26에서 0.55로 상승 |
| ER 1.5 | embodied reasoning 벤치마크 15종 종합 | ER Score 59.6. GPT-5 51.1, Gemini 2.5 Pro 51.7 |
1.5의 VLA는 checkpoint 하나로 ALOHA 2, Bi-arm Franka, Apptronik Apollo humanoid 세 로봇을 post-training 없이 제어한다. 1.0에서는 Franka와 Apollo가 각각 post-training한 전문 모델이었던 것과 대비된다. 다만 Motion Transfer의 구체적인 구조는 공개되지 않았고 ablation 결과로만 효과가 제시된다.
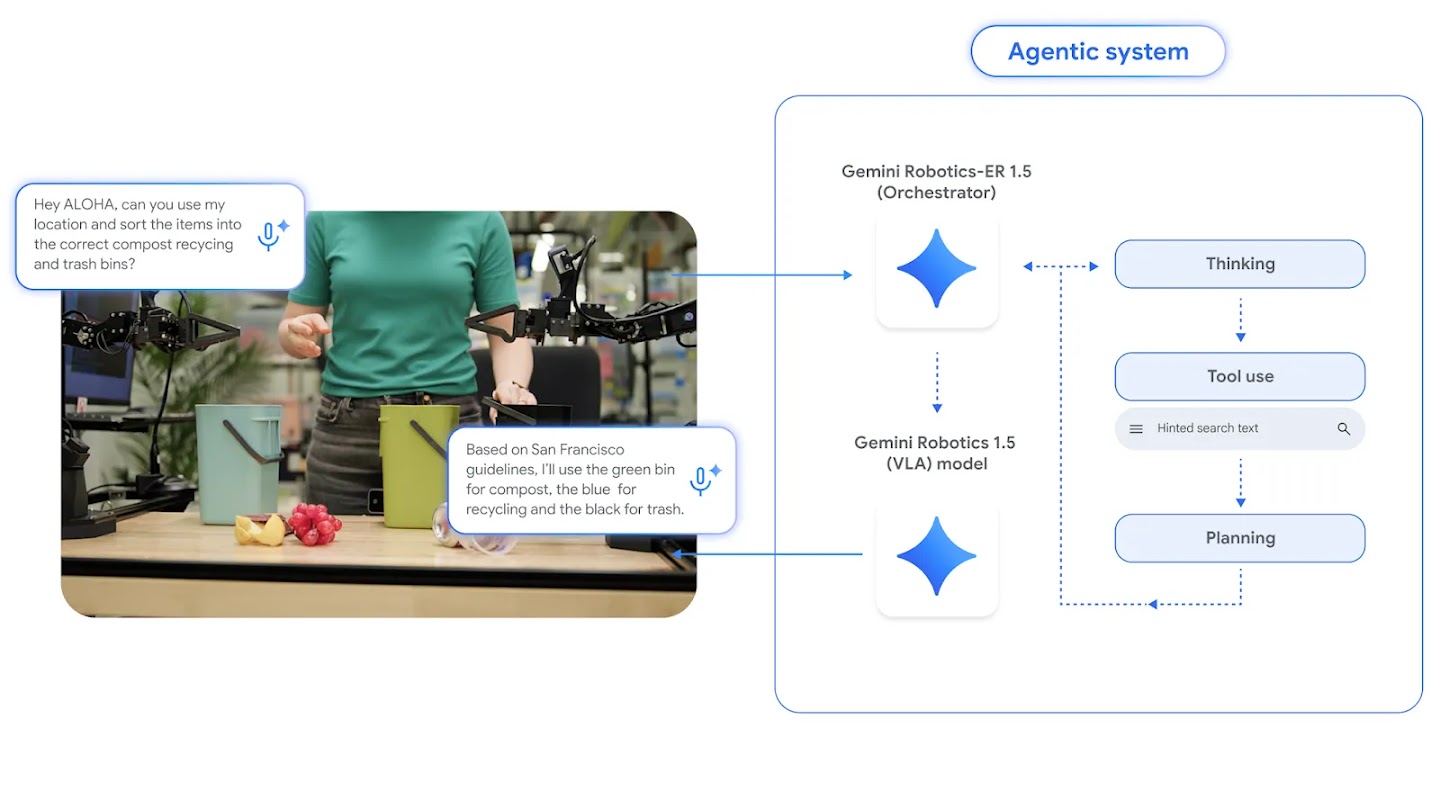
두 모델을 묶으면 agentic system이 된다. ER 1.5가 orchestrator로서 계획을 세우고 Google Search 같은 도구를 부르며 성공 여부를 판정하고, VLA 1.5는 orchestrator가 부르는 도구 하나로 동작한다. 즉 orchestrator 입장에서 VLA 실행도 하나의 tool call이며, tool call은 모델이 외부 도구에 인자를 넘겨 실행을 요청하는 동작을 말한다. 오케스트레이션은 여러 에이전트와 도구의 실행을 조율하는 층이다. 이 구조에서 8개 long-horizon 과제의 progress는 약 0.8에 이르렀고, Thinking VLA 단독의 최고값 0.44보다 높았다.
Gemini Robotics 2
Gemini Robotics 2는 2026년 7월 30일 발표됐다. 역할이 다른 세 모델의 묶음이다.
- Gemini Robotics 2: humanoid의 발끝부터 손끝까지 whole-body control을 수행하는 VLA
- Gemini Robotics ER 2: 수 분짜리 과제를 계획하고 진행을 추적하며 다중 로봇 협업을 조율하는 embodied reasoning 모델
- Gemini Robotics On-Device 2: 로봇에서 로컬로 실행되는 효율형 VLA. 새 bimanual 로봇에 보통 200개 미만의 예시와 몇 시간의 학습으로 적응한다
발표문은 같은 체크포인트로 세 embodiment를 제어한 성공률을 공개했다. Apollo 2 humanoid whole-body 과제는 탁자 68.4%, 바닥 45.7%, 선반 76.3%였고, Franka FR3 Duo gripper 과제는 정밀 삽입 89.6%였다. 반면 다섯 손가락 손 과제는 전구 끼우기 36%, 쓰레받기 32%로 아직 낮다. 이 자료는 제품 발표문이라 모델 크기, 아키텍처, 학습 데이터, control frequency가 나오지 않고 시행 횟수도 적혀 있지 않다.
Gemini Robotics 계열의 성격
- frontier 범용 모델의 embodied reasoning을 앞세운다. 세대마다 ER 모델을 따로 두고 VLA 위에 계획과 판단을 맡긴다.
- 느린 모듈을 클라우드에 둘 수 있게 설계했다. 대신 네트워크 지연과 비용이 따르며, 이를 보완하는 On-Device 변형을 따로 둔다.
- 주 대상은 ALOHA 2에서 출발해 Franka와 Apollo humanoid로 넓어졌고, 2세대 이후 humanoid 전신까지 다룬다.
- 공개 범위가 가장 좁다. 가중치는 전부 비공개이고, ER 모델만 Gemini API로 제공하며 VLA는 선별된 파트너에게만 제공한다. 공개된 것은 ERQA와 ASIMOV 계열 안전 벤치마크다.
- 안전을 별도 층으로 다룬다. 1.0부터 ASIMOV 데이터셋을 공개했고, 2세대는 위험한 VLA tool call을 거부하는지를 재는 ASIMOV-Agentic을 추가했다.
세 계열 비교
세대별 연표
| 시점 | GR00T | π | Gemini Robotics |
|---|---|---|---|
| 2024년 10월 | π0: flow matching과 action expert, 50Hz | ||
| 2025년 3월 | N1: dual-system, data pyramid, 오픈 가중치 | 1.0: ER과 VLA 분리, 클라우드 backbone | |
| 2025년 4월 | π0.5: 이질 데이터 co-training, 한 모델 계층 구조 | ||
| 2025년 6월 무렵 | N1.5: VLM 고정, FLARE, DreamGen | ||
| 2025년 9월 | 1.5: Motion Transfer, Thinking VLA, agentic system | ||
| 2025년 11월 | π0.6과 π*0.6: 4B backbone, RECAP | ||
| 2025년 12월 무렵 | N1.6: Eagle native resolution 변형, 3.29B | ||
| 2026년 4월 | π0.7: steerable prompt, 5B | ||
| 2026년 | N1.7: Cosmos-Reason2 backbone, SONIC 결합 | ||
| 2026년 7월 | 2: whole-body control, 다중 로봇 협업 |
설계 비교
아래 표는 각 계열의 최신 세대를 중심으로 적되, 계열 안에서 바뀐 값은 화살표로 적었다. 자료에 없는 값은 "자료 미기재"로 적고 추정하지 않았다.
| 항목 | GR00T | π | Gemini Robotics |
|---|---|---|---|
| backbone VLM | Eagle-2 → Eagle 2.5 → Eagle 변형 → Cosmos-Reason2-2B | PaliGemma 3B → Gemma 3 4B | Gemini 2.0 → Gemini 2.5 계열 → 자료 미기재 |
| 전체 규모 | 2.2B → 3.29B → 3B | 3.3B → 5B | 자료 미기재 |
| action 생성 | cross-attention DiT, flow matching 4 스텝 | action expert, flow matching (π0 10 스텝, π0.7 5 스텝) | 온보드 local action decoder, 세부 자료 미기재 |
| action chunk | 16 → 40 | 50 | chunk 출력은 명시, 길이 자료 미기재 |
| control frequency | System 1 120Hz (N1) | 20Hz 또는 50Hz | 유효 50Hz (1.0) |
| 계층 구조 | 한 모델 안의 System 2와 System 1 | 한 모델이 subtask 문장과 action을 함께 생성 (π0.5 이후) | ER 모델과 VLA를 별도 모델로 분리 |
| 추론 위치 | 로봇 온보드 (Jetson AGX Thor, Orin) | 온보드 또는 오프보드 GPU (π0.7 world model은 H100 4장) | 클라우드 backbone과 온보드 decoder, 별도 On-Device 변형 |
| 주 대상 | humanoid (GR-1, Unitree G1) | bimanual 로봇, mobile manipulator | ALOHA 2, Franka, Apollo humanoid |
| 공개 범위 | 코드 Apache-2.0, 가중치 NVIDIA Open Model License | π0, π0-FAST, π0.5만 Apache-2.0 공개 | 가중치 비공개, ER은 API 제공 |
일반화 전략 비교
세 계열이 처음 보는 로봇, 처음 보는 환경, 긴 과제에 대응하는 방식은 서로 다르다.
| 문제 | GR00T | π | Gemini Robotics |
|---|---|---|---|
| 로봇 사이 전이 | embodiment별 encoder와 decoder, latent action, relative EEF action space | 18차원으로 맞춘 action과 다양한 로봇 데이터 co-training, π0.7의 control mode prompt | Motion Transfer로 한 checkpoint가 세 로봇을 제어 |
| 데이터 부족 | 시뮬레이션, neural trajectory, 사람 영상 | 이질 데이터 co-training, 배치 후 experience | Gemini의 웹 지식과 embodied reasoning 데이터 |
| long-horizon 과제 | 논문이 한계로 인정한 영역. 전신 이동은 SONIC에 위임 | 같은 모델의 subtask 예측, π0.7의 subgoal image | ER orchestrator와 Thinking VLA |
| 새 과제 적응 | 과제당 시연 30~300개 post-training | 과제별 post-training, π0.7은 사람 코칭으로 적응 | 시연 100개 이하 적응, On-Device 2는 200개 미만 |
수렴하는 지점
세 계열은 출발점이 달랐지만 세 가지 설계에서 같은 답에 도달했다.
- 연속 action을 chunk 단위로 생성한다. GR00T와 π는 flow matching을 공유하고, Gemini Robotics도 action chunk를 출력한다.
- 느린 이해와 빠른 제어를 나눈다. 나누는 위치는 한 모델 안(GR00T, π)이거나 별도 모델과 별도 장치(Gemini Robotics)로 다르다.
- 로봇 데이터만 쓰지 않는다. 세 계열 모두 웹 데이터, 사람 영상, 합성 데이터 중 하나 이상을 로봇 데이터와 함께 학습한다.
갈라지는 지점
반면 무엇에 투자해 일반화를 얻는지는 뚜렷이 다르다.
- GR00T는 데이터를 생성한다. 시뮬레이션과 world model로 로봇 데이터를 늘리고, 생태계 전체를 오픈으로 풀어 외부 연구의 기준점이 되는 전략이다.
- π는 데이터를 활용하는 방식을 바꾼다. 같은 구조 위에서 co-training, 강화학습, 품질 라벨 prompt로 이미 모은 데이터와 배치 후 데이터를 더 많이 학습 신호로 바꾼다.
- Gemini Robotics는 추론을 키운다. VLA 위에 frontier 수준의 embodied reasoning 모델을 두고 계획, tool call, 성공 판정을 맡긴다.
공개 전략의 차이도 이 선택과 이어진다. GR00T는 하드웨어와 시뮬레이터를 파는 회사의 모델이라 모델 자체를 널리 퍼뜨리는 쪽이 유리하고, Gemini Robotics는 Gemini API라는 기존 판매 경로 위에서 ER 모델만 먼저 연다.
제3자 논문의 비교
세 계열을 같은 조건에서 비교한 자료는 드물다. 저장소가 보유한 제3자 논문 중 두 계열 이상을 함께 평가한 사례는 아래와 같다.
| 자료 | 조건 | 결과 |
|---|---|---|
| HuRo | ALLEX 실제 로봇, 전체 성공률 | GR00T N1.6 52.0%, π0.5 48.2% |
| ω-0 | 11개 과제 평가 | GR00T N1.7 22.7%, π0.5 27.3% |
| VLA-Arena 평가 | VLA-Arena 평균 | GR00T N1.6 27.8, π0-FAST 25.6 |
세 결과 모두 두 계열이 비슷한 수준이며 과제와 로봇에 따라 순위가 바뀐다. Gemini Robotics는 가중치가 비공개라 제3자 비교에 등장하지 않는다.
자료 간 차이와 근거 등급
세 계열의 자료는 성격이 다르므로 같은 무게로 읽으면 안 된다.
| 등급 | 자료 | 해당 세대 |
|---|---|---|
| 논문, 기술 보고서 (정량, ablation 있음) | arXiv 논문과 기술 보고서 | GR00T N1, π0, π0.5, π*0.6, π0.7, Gemini Robotics 1.0과 1.5 |
| 프로젝트 페이지, 저장소 (수치 일부, ablation 없음) | 릴리스 노트, README | GR00T N1.5, N1.6, N1.7, openpi |
| 발표문 (정성, 차트 일부) | 공식 블로그 | Gemini Robotics 2, π 계열 블로그, GR00T N1 블로그 |
| 해설 (한국어 primer) | 교육용 재구성 | GR00T N1과 N1.5, π0.6, Gemini Robotics 1.0과 1.5 |
세 가지 주의점이 있다. 첫째, 계열마다 평가 로봇과 벤치마크가 달라 성공률 수치를 계열 사이에서 직접 비교할 수 없다. 둘째, 계열 사이의 유일한 직접 비교인 Gemini Robotics 1.0 대 π0는 재구현 모델과 다른 실행 환경을 쓴 비교다. 셋째, 자료 사이에 수치가 어긋나는 경우가 있다. 예를 들어 π0.6의 규모를 블로그는 약 5B로, 논문은 Gemma 3 4B와 860M action expert로 적고, VLA 서베이 표는 π*0.6을 3B로 적는다. 이 페이지는 논문 값을 따랐다.
학습 경로
기본 트랙은 공개 시점 순서다. 세 계열을 번갈아 읽으면 한 계열의 선택이 다른 계열의 다음 세대에 어떻게 반영되는지 확인할 수 있다. 아래 12단계는 frontmatter의 study_path와 같은 순서다.
- 1RT-2 (Google DeepMind)
VLA라는 범주가 생긴 자리. 세 계열이 모두 이 구도(pre-trained VLM에서 출발한 제어 모델) 위에 서 있다.
- 2OpenVLA (Stanford, Berkeley, TRI)
이산 action token 방식의 오픈 재현. 세 계열이 버리고 떠난 출발점을 확인한다.
- 3π0 (Physical Intelligence)
flow matching과 action expert로 연속 action 50Hz를 연 기준점. GR00T와 Gemini Robotics 논문이 모두 비교 대상으로 삼는다.
- 4GR00T N1 (NVIDIA)
System 2 VLM 10Hz와 System 1 DiT 120Hz, data pyramid. humanoid와 오픈 가중치 노선의 원점.
- 5Gemini Robotics (Google DeepMind)
클라우드 backbone과 온보드 decoder 분리, ER 모델 분리. π0 재구현과의 직접 비교 수치가 있다.
- 6π0.5 (Physical Intelligence)
한 모델이 subtask 문장과 action을 함께 내고, 이질 데이터 co-training으로 처음 보는 집에서 동작한다.
- 7GR00T N1.5 (NVIDIA GEAR Lab)
VLM 고정, FLARE, DreamGen. 합성 데이터 노선이 수치로 확인되는 버전.
- 8Gemini Robotics 1.5 (Google DeepMind)
Motion Transfer와 Thinking VLA, ER 1.5 orchestrator. reasoning 중심 노선이 agentic system으로 확장된다.
- 9π*0.6 / RECAP (Physical Intelligence)
학습 신호를 배치된 로봇의 experience로 옮긴 RECAP. π 계열이 데이터에서 학습 신호로 관심을 옮기는 지점.
- 10Isaac GR00T (N1.7, repo)
N1.7 GA 릴리스. backbone이 Cosmos-Reason2-2B로 바뀌고 SONIC과 결합하는 현재 형태.
- 11π0.7 (Physical Intelligence)
prompt에 episode metadata와 subgoal image를 적어 품질이 섞인 데이터를 전부 쓰는 5B 모델.
- 12Gemini Robotics 2
whole-body control과 다중 로봇 협업을 내건 3세대. 발표문이라 기술 세부가 없다는 점까지 확인한다.
한국어 해설 트랙
논문을 바로 읽기 부담스러우면 한국어 primer로 먼저 어휘와 구조를 잡은 뒤 위 기본 트랙으로 넘어간다.
- RT-2 primer
- OpenVLA primer
- GR00T N1 primer
- Gemini Robotics 1.0 primer
- GR00T N1.5 primer
- Gemini Robotics 1.5 primer
- π0.6 primer
한계
이 페이지는 세 계열에 범위를 한정했다. 아래 계열과 주제는 다루지 않으며 각각의 페이지와 Physical AI 카테고리 지도와 학습 경로가 담당한다.
- 다른 VLA 계열: Helix, SmolVLA, Wall-OSS, GEN-1.5 등
- world model에서 출발하는 WAM 계열. WAM은 world-action model의 약자로, 미래 장면 예측과 action 생성을 한 모델 안에서 함께 수행하는 policy 계열이다
- 고전 로보틱스 스택(odometry, 내비게이션)
자료 공백도 있다.
- GR00T N1.5, N1.6, N1.7은 논문이 없어 변경 항목별 효과와 N1.7 성능 수치를 확인할 수 없다.
- π0.6은 모델 카드가 저장소에 없어 π*0.6 논문이 적은 범위만 반영했다.
- Gemini Robotics 2는 발표문뿐이라 모델 크기, 구조, 데이터, 지연이 모두 비어 있다. 첫 Gemini Robotics On-Device의 공개 시점과 규모도 자료에 없다.
- 세 계열을 같은 벤치마크, 같은 로봇에서 비교한 자료가 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| dual-system VLA | 느린 대형 모델과 빠른 경량 policy를 서로 다른 주기로 함께 구동하는 VLA 구조. OpenHelix 기준으로는 π0와 GR00T N1이 제외된다 |
| action expert | π 계열에서 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음 |
| flow matching | noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법. GR00T와 π가 action 생성에 공유한다 |
| embodied reasoning | 물리 세계의 기하, 공간 관계, 시간 변화를 이해하는 능력. Gemini Robotics가 별도 ER 모델로 강화한다 |
| data pyramid | 웹 데이터와 사람 영상, 합성 데이터, 실제 로봇 데이터를 양이 많은 순으로 쌓아 함께 학습하는 GR00T의 데이터 전략 |
| Motion Transfer | 서로 다른 로봇의 데이터에서 동작의 통합된 이해를 학습해 skill을 로봇 사이로 전이하는 Gemini Robotics 1.5의 구조와 레시피 |
관련 페이지
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 전체 지도. 이 페이지는 그 A 트랙 VLA 계보 중 세 계열을 확대한 비교판이다
- 용어집: Physical AI (Terminology Glossary): 이 페이지가 따른 전문 용어 표기 SSOT
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: backbone과 action head 조합 7분류로 세 계열의 위치를 잡아 주는 서베이
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: GR00T N1.7과 π 계열, Gemini Robotics 2를 한 표에 놓은 bimanual VLA 서베이
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system 판정 기준의 출처
- Helix: A Vision-Language-Action Model for Generalist Humanoid Control: GR00T N1보다 한 달 앞서 dual-system을 공개한 Figure AI 모델
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 세 계열이 공유하는 action chunking의 출처
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: 세 계열이 모두 일부 활용하는 cross-embodiment 데이터
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): GR00T VLA와 결합하는 whole-body control 제어기 SONIC과 Decoupled WBC
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): π0, π0-FAST, π0.5 공개 저장소
- Gemini Robotics 1.5 brings AI agents into the physical world: Gemini Robotics 1.5 공식 발표문
- Accelerate Generalist Humanoid Robot Development with NVIDIA Isaac GR00T N1: GR00T N1 공개 블로그와 개발 절차