Physical AI · PAPER · 2026
Technical Report: One-Step Drifting Action Heads for GR00T N1.7
요약
이 technical report는 GR00T N1.7의 action head를 반복 평가형에서 단발 평가형으로 바꾼 결과를 보고한다. action head는 VLM backbone이 만든 표현을 받아 실제 로봇 action 수치로 바꾸는 출력 모듈이다. GR00T N1.7은 여기에 DiT를 쓰는데, DiT는 잡음에서 출발해 여러 번 네트워크를 평가하며 결과를 다듬는 구조라서 한 번의 action chunk를 만드는 데 비용이 크다. 저자는 이 자리를 Implicit Drifting Policy의 목적함수로 학습한 결정적 Transformer로 교체해, zero action seed에서 단 한 번의 평가로 chunk 전체를 내게 했다.
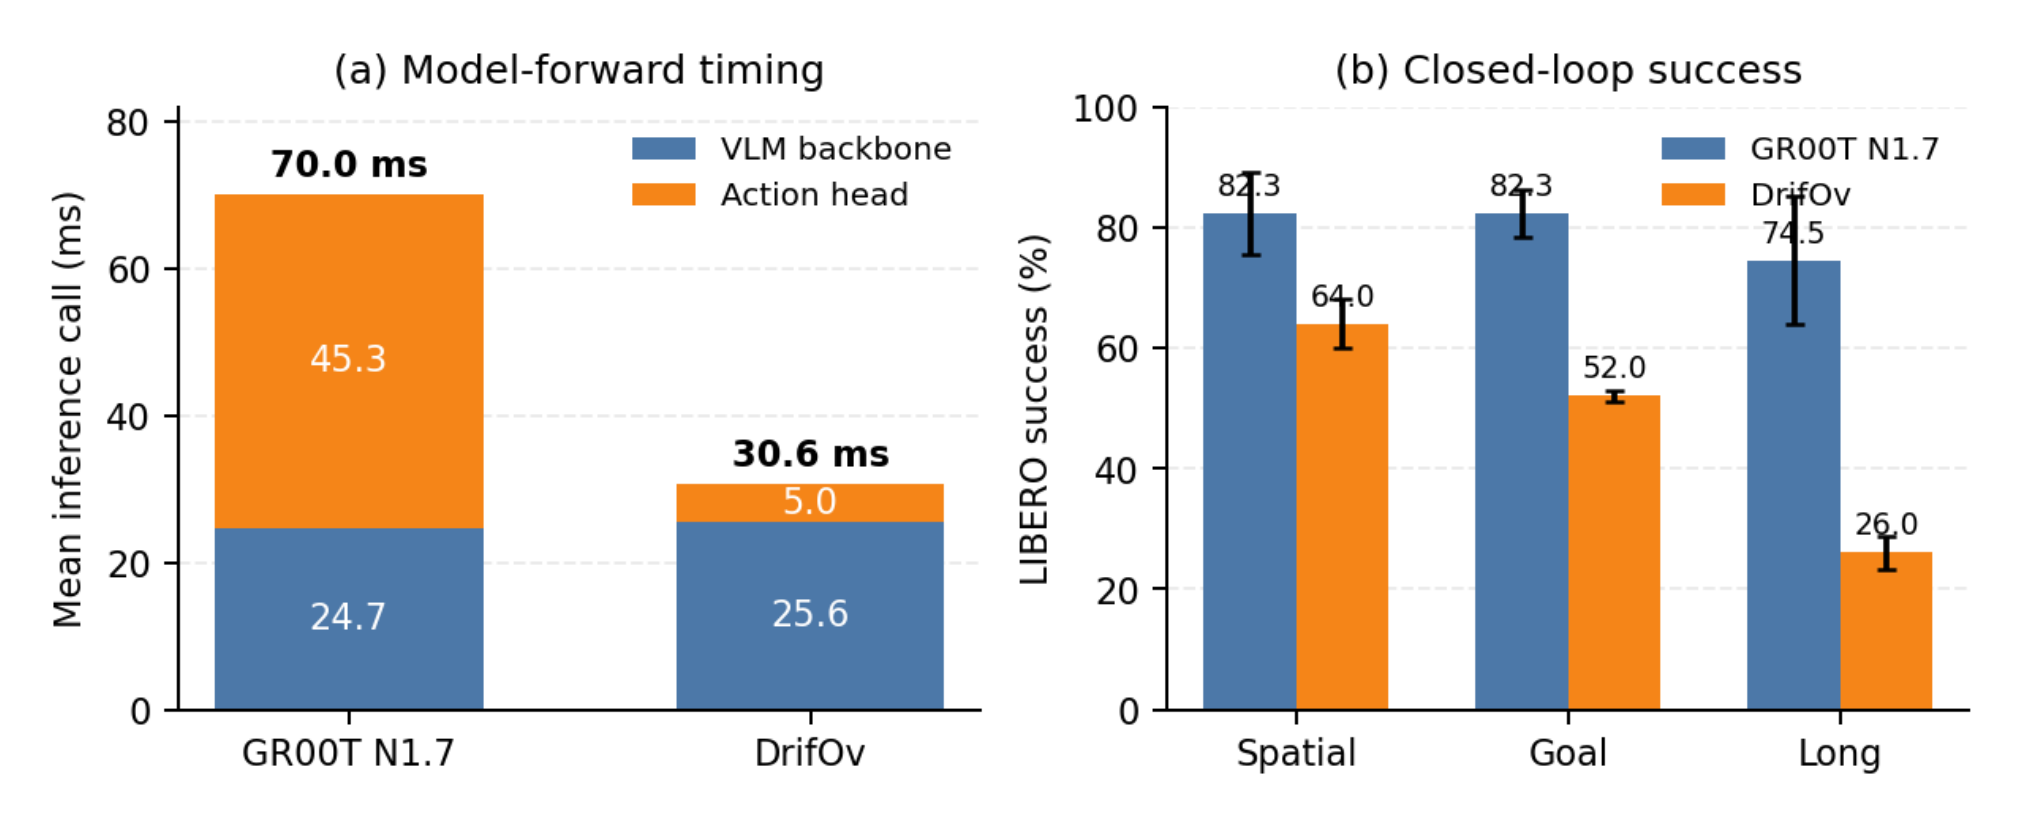
결과는 긍정과 부정이 함께 나왔다. action head 시간은 45.3 ms에서 5.0 ms로 약 9배 줄었고 backbone까지 합한 model-forward 경로는 70.0 ms에서 30.6 ms로 줄었다. 그러나 LIBERO 성공률은 세 suite 모두에서 떨어졌다. Spatial 64.0 ± 4.0%, Goal 52.0 ± 1.0%, Long 26.0 ± 2.6%로, 같은 조건의 GR00T 기준선보다 각각 18.3%p, 30.3%p, 48.5%p 낮다.
저자가 이 보고서를 개선 주장이 아니라 교환 관계 보고로 규정하는 근거는 seed 사이의 낮은 분산이다. drifting seed 3회의 표준편차가 모두 4%p 이하이므로 하락이 한 번의 불운한 초기화에서 온 잡음이 아니다. 동시에 실험은 어느 변경이 하락을 일으켰는지 분리하지 못했고, 저자는 원인 후보 다섯 가지와 각각을 검증할 실험을 함께 제시한다.
배경
VLA 모델의 추론 비용은 실시간 로봇 플랫폼 배치를 제약하는 요인이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하는데, VLA policy는 이 함수를 대형 vision-language 모델 위에 올리기 때문에 한 번의 호출이 수십 밀리초를 넘는다.
기존 효율화 연구는 파이프라인의 서로 다른 부분을 겨냥해 왔다. 모델 수준 접근은 빠른 경로와 느린 경로를 나누는 구조, 경량 backbone, 토큰 캐싱, 적응형 조기 종료 추론을 쓴다. 시스템 수준 접근은 양자화와 그래프 최적화, 커스텀 연산자를 쓴다.
그런데 이 방법들이 줄이지 못하는 비용이 하나 남는다. diffusion이나 flow matching으로 action을 만드는 head는 action chunk 하나마다 네트워크를 여러 번 평가해야 한다. 따라서 반복 평가형 action 생성 자체가 지연 시간의 독립적인 원천이 된다. 이 보고서의 질문은 그 반복을 한 번으로 줄일 수 있는지다.
두 번째 문제는 asynchronous action prefetch에서 나타난다. 현재 chunk를 실행하는 중에 다음 chunk를 미리 만들면, 새 예측이 이미 컨트롤러로 전달된 명령을 고려하지 못할 수 있다. 이 구간의 불일치는 실제 로봇에서 동작 끊김으로 이어진다. real-time action chunking은 추론이 진행되는 동안 실행될 미실행 action과 새 chunk가 일관되도록 제약해 이 문제를 다뤘다. 이 보고서는 같은 문제를 추론 시점의 guidance가 아니라 학습된 조건부 입력으로 다루는 DrifOv를 제시한다.
핵심 개념
action head와 one-step generation. action head는 backbone의 표현을 로봇 action으로 바꾸는 마지막 단계다. one-step generation은 반복 denoising 없이 네트워크를 한 번만 평가해 action chunk 전체를 내는 방식을 말한다. GR00T N1.7의 기본 head는 여러 번 평가하지만 이 보고서의 head는 추론 step 수가 1로 고정된다.
drifting 목적함수. Implicit Drifting Policy가 제안한 학습 방식이다. 명시적인 연속 drifting field를 회귀하는 대신, expert action 주변에 potential이라 부르는 에너지 함수를 두고 그 값을 낮추도록 학습한다. 배치 시점에는 zero action seed가 완전한 action chunk로 곧바로 사상된다. 이 보고서는 목적함수를 그대로 상속했을 뿐 새 생성 목적함수를 주장하지 않는다고 명시한다.
geometry 가중. potential이 좌표마다 같은 세기로 벌점을 주지 않게 하는 장치다. minibatch 안 이웃 표본들의 action이 크게 흩어진 좌표는 예측이 어렵다고 보고 가중을 달리한다. 이 가중을 담은 대각 행렬을 geometry 행렬이라 부르며, detach되어 gradient를 전달하지 않고 학습 potential의 가중에만 쓰인다.
action prefix와 overlap. action prefix는 이미 컨트롤러로 전달돼 확정된 action 행들을 말한다. overlap 길이는 새 chunk에서 이 prefix가 차지하는 행 수다. DrifOv는 확정된 좌표를 디코딩 후 그대로 복사해 학습된 head가 덮어쓰지 못하게 하고, 미지의 suffix만 생성한다.
모드 평균화. 유효한 action 후보가 여럿일 때 결정적 생성기가 그 후보들의 평균 근처를 내놓는 현상이다. 평균 지점에는 시연된 trajectory가 없을 수 있어서, 이 현상은 성공률 하락의 후보 원인 중 하나로 지목된다.
방법
전체 구조와 교체 범위
구현은 GR00T N1.7에서 바꾸는 부분과 그대로 두는 부분을 분명히 나눈다. 전처리 스택과 Cosmos-Reason2/Qwen3 vision-language backbone은 유지하고 action 생성기만 교체한다.
| 구성 요소 | 처리 |
|---|---|
| 전처리 스택 | GR00T N1.7 그대로 유지 |
| vision-language backbone | Cosmos-Reason2/Qwen3 유지, layer 16의 hidden feature를 action head 차원으로 투영 |
| 로봇 상태 인코더 | embodiment별 MLP |
| action 인코더 | embodiment별 action encoder |
| action 생성기 | 반복 평가형 flow matching head를 결정적 Transformer로 교체 |
교체된 action head는 12블록 Transformer다. 모델 차원 1024, attention head 16개, feed-forward 차원 4096, dropout 0.1이다. 각 블록은 세 부분으로 이루어진다.
- action 토큰과 상태 토큰에 대한 self-attention
- vision-language 메모리에 대한 cross-attention
- feed-forward 네트워크
cross-attention은 블록을 지나며 이미지 토큰과 텍스트 토큰을 번갈아 참조한다. 기본 action chunk 길이는 H = 40이고, 상태와 action의 최대 차원은 모두 132, 상태 이력 길이는 1이다.
drifting 목적함수
학습은 expert action 주변에 potential을 두고 그 값을 낮추는 방식으로 진행된다. observation과 action 쌍 (o_i, a*_i)에 대해 M_i를 detach된 대각 geometry 행렬이라 할 때 potential은 다음과 같다.
E_i(a) = 0.5 (a - a*_i)^T (I + M_i) (a - a*_i)
이 식은 예측 a가 expert action a*에서 멀어질수록 커지는 2차 형식이다. 대응하는 보정항 -∇_a E_i(a) = (I + M_i)(a*_i - a)는 예측을 expert action 쪽으로 미는 방향을 가리킨다.
학습은 네트워크를 서로 다른 두 지점에서 평가한다. 두 지점을 함께 쓰는 이유는 배치 시점의 입력 조건과 expert 근방의 국소 거동을 모두 학습에 반영하기 위해서다.
| 평가 지점 | 정의 | 역할 |
|---|---|---|
| proposal prediction | y_i = f_θ(o_i, 0, 0) | zero action seed와 시각 0에서 출발. 배치 시점의 추론 경로와 입력이 같다 |
| proximal prediction | ã_i = a*_i + (1 - t*) ε_i, ε_i ~ N(0, I), z_i = f_θ(o_i, ã_i, t*) | expert action에 잡음을 섞은 근방에서 출발. 보고된 구성에서 t* = 0.9다 |
최종 목적함수는 두 지점의 potential을 더한 형태다.
L_IDP = E_i(y_i) + λ_prox E_i(z_i)
보고된 구현에서 λ_prox = 81.0이다. proximal 항의 가중이 proposal 항보다 훨씬 크다는 점이 이 구성의 특징이다.
geometry 가중
geometry 행렬은 minibatch 안에서 계산된다. 절차는 네 단계다.
- 정규화한 observation feature를 내적으로 비교해 표본 사이 유사도를 구한다.
- 유사도를 행 단위로 표준화한 뒤 softmax로 이웃 가중치 w_ij를 만든다.
- action 좌표 d의 조건부 분산을 이웃 가중 평균으로 추정한다.
v_cond_i,d = Σ_j w_ij (a*_j,d - a*_i,d)^2 - 같은 minibatch에서 계산한 참조 분산 v_ref_d와 비교해 대각 초과분을 만든다.
m_i,d = ReLU( s_cond_i,d / (s_ref_d + ε) - 1 ), M_i = Diag(m_i)
s_cond와 s_ref는 정규화된 정밀도 척도다. ReLU가 붙어 있어 조건부 분산이 참조 분산보다 작은 좌표에서만 추가 벌점이 생긴다.
저자는 이 구현에 실험 해석과 직결되는 세부 두 가지가 있다고 짚는다. 첫째, 참조 분산을 현재 minibatch 안에서 추정하므로 추정 품질이 배치 크기와 배치 구성에 의존한다. 둘째, 현재 구현은 이웃 집합에 질의 표본 자신을 포함하는데 IDP 수식은 j = i를 제외한다. 두 선택 모두 검증된 설계가 아니라 한계로 취급된다고 밝힌다.
overlap 조건부 suffix 생성
DrifOv는 one-step head에 명시적 action prefix 인터페이스를 더한 확장이다. h가 action chunk 위치, j가 action 좌표, L이 확정된 prefix 행 수, ν가 유효 action 마스크일 때 마스크는 다음과 같다.
m_h,j = I[h < L] ν_h,j
즉 위치 h가 prefix 길이 안에 들고 해당 좌표가 유효할 때만 마스크가 1이 된다. prefix 행 p_0:L-1은 prefix 유효성 마스크, overlap 길이 L, 실행 offset과 함께 head에 전달된다.
출력 위치 h의 action query는 다섯 요소를 합쳐 만든다.
| 요소 | 담는 정보 |
|---|---|
| 인코딩된 마스킹 prefix | 확정된 action 값 자체 |
| prefix 마스크 임베딩 | 어느 좌표가 확정됐는지 |
| overlap 길이 임베딩 | prefix가 몇 행인지 |
| 실행 offset 임베딩 | 추론 중 실행이 얼마나 진행됐는지에 대한 추정값 |
| 위치 임베딩 | chunk 안에서의 시간 위치 |
디코더는 H개 action query를 한꺼번에 처리하면서 vision-language 토큰과 상태 조건 토큰에 cross-attention한다. 디코딩이 끝나면 유효한 prefix 좌표는 공급된 값으로 대체된다.
Â_h,j = m_h,j p_h,j + (1 - m_h,j) Ã_θ,h,j
이 대체 규칙 덕분에 확정된 action은 학습된 head가 다시 쓸 수 없다. 그러면서도 prefix는 self-attention을 통해 suffix 생성에 영향을 준다. 모델이 학습하는 대상은 미지의 suffix뿐이다.
overlap 인지 학습
학습 시점에는 실제 배치 상황을 흉내 내는 prefix를 만들어 넣는다. action chunk마다 overlap 길이를 0부터 H - 1 사이에서 샘플링하고, 확률 0.2로는 overlap이 0인 예제도 함께 뽑는다.
| 항목 | 설정 |
|---|---|
| overlap 길이 | 0부터 H - 1 사이에서 샘플링 |
| overlap 0 예제 | 확률 0.2로 추가 샘플링 |
| prefix 출처 | expert action chunk에서 복사 |
| prefix 교란 | 확률 0.5로 표준편차 0.02의 가우시안 잡음, [-0.05, 0.05]로 클리핑 |
| 실행 offset | 0과 선택된 overlap 길이 사이에서 샘플링 |
| 무조건부 baseline | prefix 조건부 입력을 비활성화해 사용 |
생성 손실은 상속한 potential을 suffix 좌표에서만 평가한다. 모델이 책임지는 좌표를 ω_h,j = ν_h,j (1 - m_h,j)로 고르면 suffix 손실은 가중 평균 형태가 된다.
L_gen = Σ_h,j ω_h,j E_i(Â_h,j) / Σ_h,j ω_h,j
같은 목적함수를 proximal prediction에도 적용하되, 손실을 계산하기 전에 prefix 좌표를 공급된 prefix로 대체한다.
구현은 첫 생성 suffix action에 경계 항을 선택적으로 더한다. 보고된 구성의 가중치는 경계 action 오차가 1.0, 유한차분 속도 오차가 0.1이며 가속도 가중치는 0이다. 이 항들은 고정된 prefix와 생성된 suffix 사이의 연속성을 유도하는 보조 정칙화이지 새 생성 모델을 만드는 장치가 아니라고 저자는 선을 긋는다.
한 번의 평가로 끝나는 추론
추론 경로는 동기식과 asynchronous 두 가지로 나뉘며, 이번 LIBERO 실험이 측정한 것은 앞의 하나다.
동기식 LIBERO 평가에서는 action prefix를 공급하지 않는다. 빈 prefix와 빈 마스크, overlap 길이 0을 쓰고 action seed와 시간 입력이 모두 0이다.
 = f_θ(o, s, 0, 0)
모델은 한 번의 action head 평가로 완전한 chunk 하나를 낸다. 이 경로는 무조건부 one-step head를 검증할 뿐 overlap 조건부 기능은 건드리지 않는다.
asynchronous 배치에서는 런타임이 남은 정규화 action 행, 패딩 전 실제 길이, 추정 추론 지연을 공급한다. 확정된 행은 그대로 반환되고 미지의 suffix만 생성된다. 추정 지연이 가용 prefix를 넘어서면 만료된 prefix를 조건으로 suffix를 실행하는 대신 요청 자체를 거부한다.
초기 설계 노트는 인과적 history memory 분기와, 추론 중 실행된 action으로 latent 상태를 갱신하는 delay propagator를 제안했다. 그 형식은 이 보고서에서 구현되지도 평가되지도 않았다. 따라서 아래 실험은 history latent 모델의 이점을 입증하지 않는다.
결과
실험 설정
LIBERO 실험은 LIBERO 벤치마크와 lerobot/libero 데이터셋, LeRobot 학습 및 평가 스택을 쓴다. 모든 다중 seed drifting checkpoint가 같은 하드웨어와 레시피로 학습됐다는 점이 이 보고서가 강조하는 통제 조건이다.
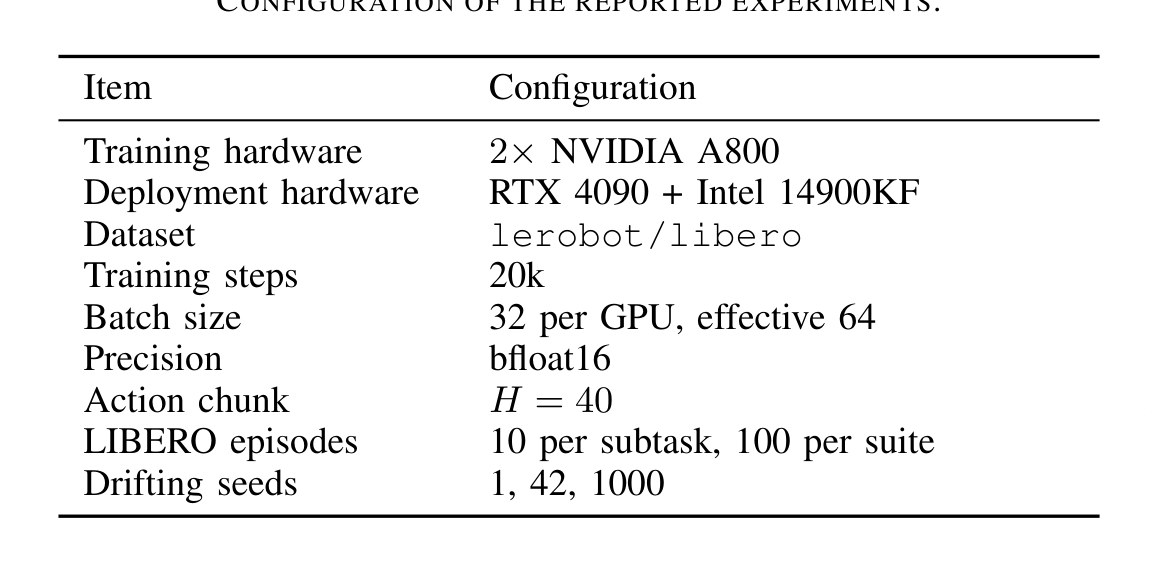
학습은 NVIDIA A800 2장에서 GPU당 배치 32, 실효 배치 64, 2만 step, bfloat16으로 수행했다. 배치 하드웨어는 RTX 4090과 Intel 14900KF다. LIBERO 평가는 subtask당 10 episode를 돌려 suite당 100 rollout을 얻는다. drifting seed는 1, 42, 1000이다.
GR00T와의 주 비교는 보관된 seed 비교 디렉토리의 seed 1과 seed 42 실행을 쓴다. seed 1000 GR00T checkpoint는 더 오래된 보관 평가에서 왔으므로 참고 지점으로만 보고한다.
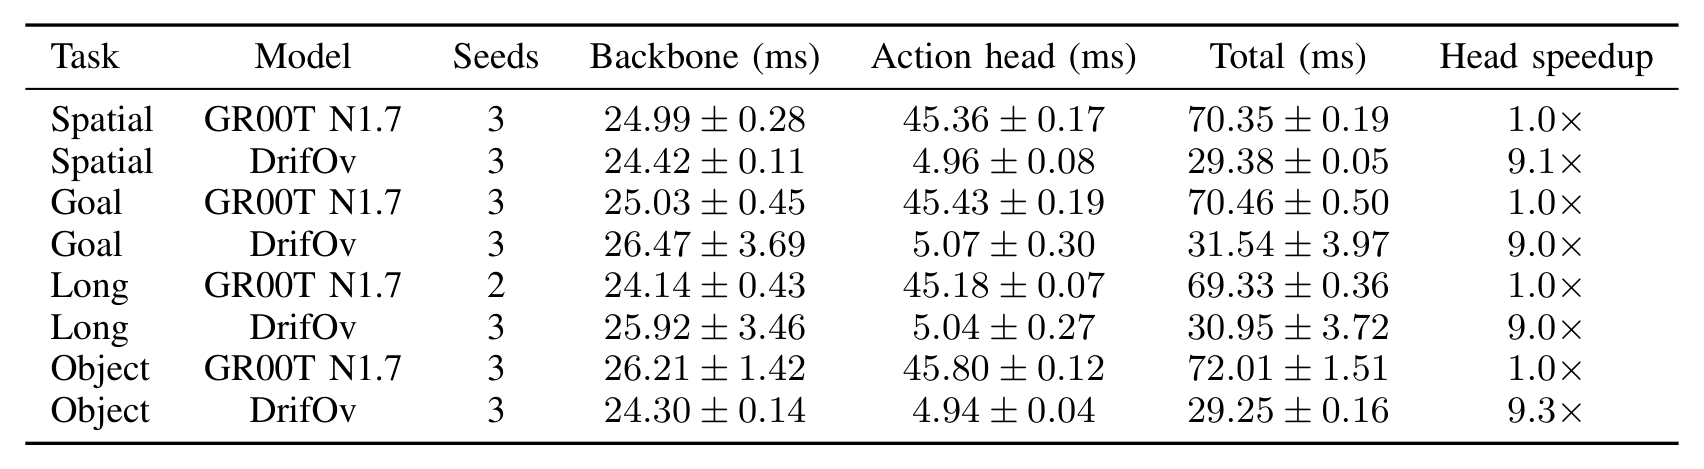
지연 시간은 backbone과 action head 주변의 타이밍 훅으로 기록하고, 각 훅은 측정 구간 전후에 CUDA 동기화를 수행한다. 보고값은 suite 내 모든 추론 호출의 평균이다. 여기서 중요한 제약은 측정 범위다. 전처리, 후처리, 네트워킹, action 전송, 저수준 제어가 모두 빠져 있으므로 이 수치는 종단 간 배치 지연 시간이 아니다.
지연 시간
| Task | Model | Backbone (ms) | Action head (ms) | Total (ms) | Head 가속 |
|---|---|---|---|---|---|
| Spatial | GR00T N1.7 | 24.99 ± 0.28 | 45.36 ± 0.17 | 70.35 ± 0.19 | 1.0배 |
| Spatial | DrifOv | 24.42 ± 0.11 | 4.96 ± 0.08 | 29.38 ± 0.05 | 9.1배 |
| Goal | GR00T N1.7 | 25.03 ± 0.45 | 45.43 ± 0.19 | 70.46 ± 0.50 | 1.0배 |
| Goal | DrifOv | 26.47 ± 3.69 | 5.07 ± 0.30 | 31.54 ± 3.97 | 9.0배 |
| Long | GR00T N1.7 | 24.14 ± 0.43 | 45.18 ± 0.07 | 69.33 ± 0.36 | 1.0배 |
| Long | DrifOv | 25.92 ± 3.46 | 5.04 ± 0.27 | 30.95 ± 3.72 | 9.0배 |
| Object | GR00T N1.7 | 26.21 ± 1.42 | 45.80 ± 0.12 | 72.01 ± 1.51 | 1.0배 |
| Object | DrifOv | 24.30 ± 0.14 | 4.94 ± 0.04 | 29.25 ± 0.16 | 9.3배 |
action head는 네 suite 모두에서 약 9배 빨라졌고 표준편차가 0.3 ms 이하로 작다. 가속의 안정성은 seed와 suite에 걸쳐 유지된다.
backbone 시간은 25 ms 안팎으로 거의 변하지 않는다. 이 사실이 결과 해석의 핵심이다. action head를 5 ms까지 줄인 뒤에도 model-forward 시간을 지배하는 쪽은 여전히 VLM backbone이므로, action head만 줄여서는 전체 파이프라인을 실시간으로 만들 수 없다. 전체 경로의 가속은 약 2.2배에서 2.4배에 그친다.
성공률
| Task | Model | Seeds | 성공률 (%) | seed별 성공률 (%) | Coverage |
|---|---|---|---|---|---|
| Spatial | GR00T N1.7 | 3 | 82.3 ± 6.8 | 77, 90, 80 | 3/3 |
| Spatial | DrifOv | 3 | 64.0 ± 4.0 | 60, 64, 68 | 3/3 |
| Goal | GR00T N1.7 | 3 | 82.3 ± 4.0 | 80, 87, 80 | 3/3 |
| Goal | DrifOv | 3 | 52.0 ± 1.0 | 52, 51, 53 | 3/3 |
| Long | GR00T N1.7 | 2 | 74.5 ± 10.6 | 67, 82 | 2/2 |
| Long | DrifOv | 3 | 26.0 ± 2.6 | 28, 27, 23 | 3/3 |
| Object | GR00T N1.7 | 1 | 88.0 | 88 | 1/3 |
| Object | DrifOv | 0 | N/A | N/A | 0/3 |
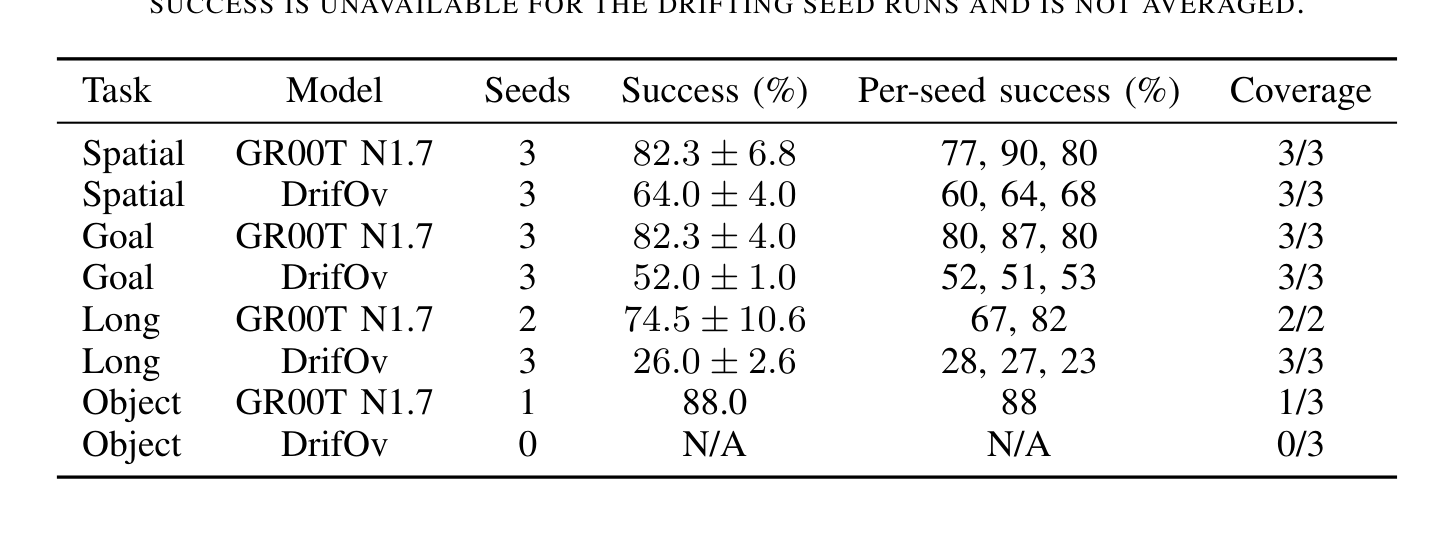
세 drifting seed는 suite 안에서 서로 비슷한 값을 낸다. Spatial은 60%, 64%, 68%, Goal은 52%, 51%, 53%, Long은 28%, 27%, 23%다. 표준편차가 4%p 이하라는 점이 이 표의 가장 중요한 정보다. 하락이 초기화 난수의 변동이 아니라 방법이나 학습 조건에서 오는 일관된 현상이라는 뜻이다.
지연 시간이 suite와 무관하게 거의 일정한 것과 달리 성공률 손실은 과제 horizon이 길어질수록 커진다. GR00T 기준선 대비 격차는 Spatial에서 18.3%p, Goal에서 30.3%p, Long에서 48.5%p다. 성능 저하가 가장 큰 LIBERO-Long은 policy가 더 긴 action chunk 연쇄에 걸쳐 진행을 유지해야 하는 과제다.
Object suite는 지연 시간만 있고 drifting 성공률이 없다. 저자는 빠진 값을 legacy 실행이나 다른 suite의 평균으로 채우지 않고 N/A로 남겼다.
메모리 관찰
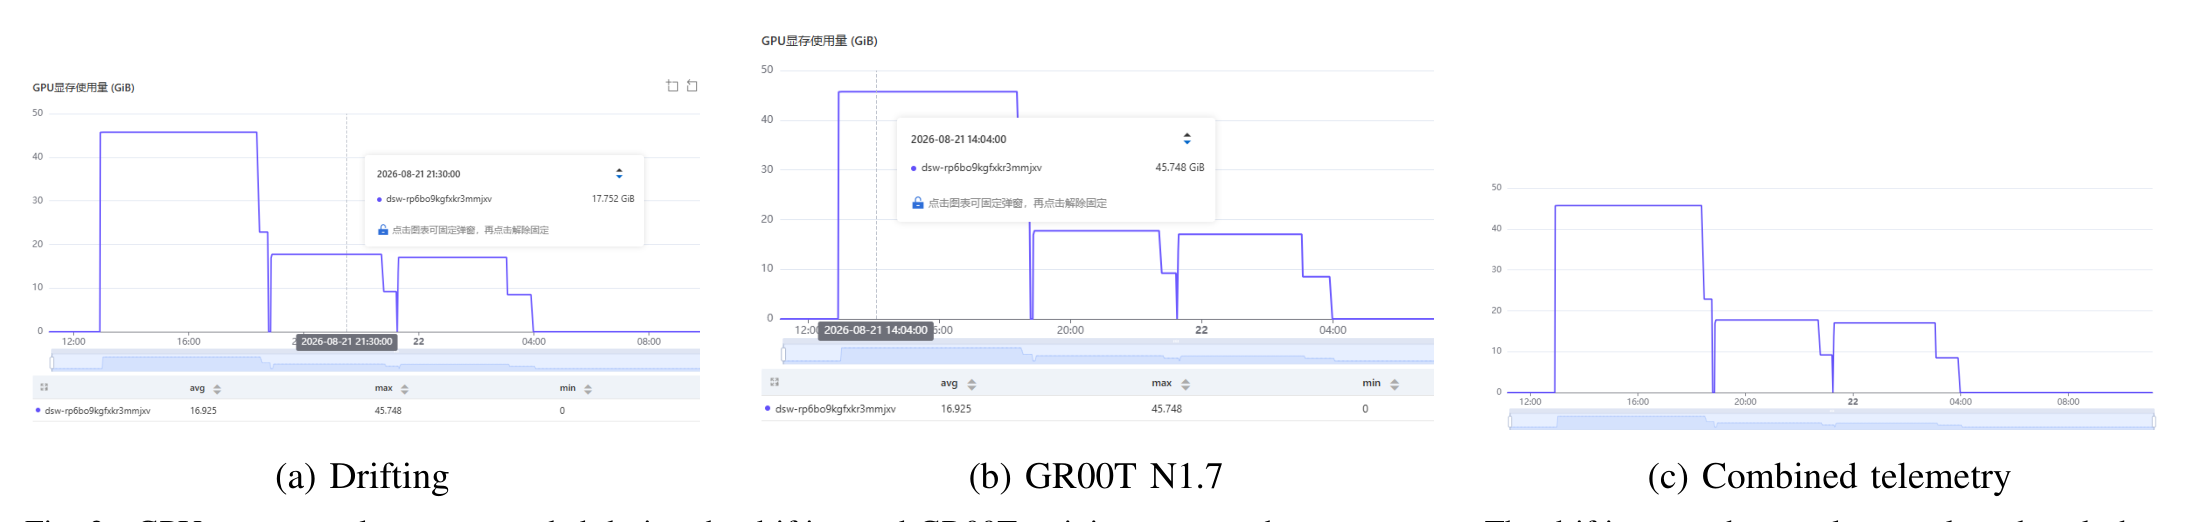
같은 서버에서 GR00T와 drifting 학습 작업을 실행하며 기록한 GPU 메모리 추이다. 선택된 peak는 GR00T 실행이 45.748 GiB, drifting 실행이 17.752 GiB다.
저자는 이 관찰의 지위를 분명히 제한한다. 텔레메트리에 다른 작업과 유휴 구간이 섞여 있어 통제된 메모리 벤치마크가 아니다. 따라서 차이를 action head 하나로 귀속시키지 않고, 자원이 제한된 학습 환경에서의 잠재적 실용 이점으로만 기록한다.
실제 로봇 배치
policy 스택은 RTX 4090과 Intel 14900KF 워크스테이션을 갖춘 LimX Tron2 로봇에 배치했다. manipulation 설정 세 가지에서 데이터를 수집하고 주석을 달았다.
| 과제 | 내용 | 규모와 성격 |
|---|---|---|
| 과제 1 | 장난감과 필기구를 지정한 바구니에 담기 | 성공과 실패 레이블을 데이터 큐레이션용으로 기록. 고정된 policy 평가 프로토콜 아래 수집한 레이블이 아니다 |
| 과제 2 | 포장된 산업용 부자재를 목표 트레이에 담기 | 주석 rollout trajectory 2,562개. LIBERO 탐색 seed 실행보다 규모가 크지만 대응되는 policy 비교는 완료되지 않았다 |
| 과제 3 | 천 접기 | 성공 시연 데이터(demonstration), 실패 시도, 사람이 이어받은 구간을 함께 수집. 변형체 manipulation 연구용이며 통제된 성공률 비교는 없다 |
세 과제 모두 시스템 통합과 데이터 수집을 보여줄 뿐 통제된 policy 비교가 아니라고 저자는 반복해 밝힌다.
주 비교에서 제외한 측정
이 보고서는 무엇을 뺐는지도 함께 기록한다. 제외 기준은 측정 자체의 신뢰성과 프로토콜 일치 여부다.
| 제외 대상 | 사유 |
|---|---|
| pi0.5 평가 | 보관된 타이밍 디렉토리에서 모든 LIBERO suite 성공률이 0.0%였다. 모든 suite에 걸친 0은 policy 결과보다 평가 실패나 action 매핑 실패에 더 부합한다. 타이밍 CSV와 요약 JSON도 여러 과제에서 서로 어긋난다 |
legacy drif_ov_libero0809 |
A800 4장, GPU당 배치 256, 1만 5천 step으로 학습해 다중 seed checkpoint의 A800 2장 2만 step 레시피와 다르다. 보고된 성공률도 단일 탐색 실행에서 나왔다 |
| legacy LIBERO-Long 프로파일 | checkpoint와 학습 방식이 다른 초기 단일 실행이다. 개발 이력 기록용으로만 남긴다 |
한계
성능 저하의 후보 원인
실험은 어느 변경이 성능 저하를 일으켰는지 분리하지 못한다. 저자는 다섯 가지를 결론이 아니라 대안 가설로 제시하고, 각각에 대해 어떤 실험이 필요한지 명시한다.
| 가설 | 내용 | 제안된 검증 |
|---|---|---|
| 결정적 one-step 모드 평균화 | 상속한 목적함수는 등방성 오차에 좌표별 geometry 벌점을 더한 회귀 목표다. 유효한 모드가 여럿인 observation에서 결정적 one-step 생성기는 모드들의 조건부 평균 근처를 예측할 수 있는데, 그 평균 근처에는 시연된 trajectory가 없을 수 있다. 다단계 생성기는 trajectory를 따라 모드 사이를 이동할 수 있지만 one-step 모델은 즉시 한 위치를 확정해야 한다 | observation 근처 expert 모드 수에 따른 one-step 예측 오차 비교, latent 또는 이산 모드 변수가 오차를 줄이는지 평가 |
| 배치 의존 geometry 추정 | geometry 행렬을 현재 minibatch에서 추정하고 로컬 배치는 32 표본이다. 이웃 가중치와 조건부 분산, 참조 분산이 배치 구성에 따라 달라지므로, 배치 크기를 바꾸면 목적함수와 데이터가 같아도 실효 geometry 목적함수가 달라진다. 이웃 집합에 질의 표본을 포함하는 점도 softmax 이웃을 더 집중시켜 분산 추정을 바꿀 수 있다 | 두 선택 모두 ablation 필요. 검색 기반이나 데이터셋 수준 geometry 추정으로 minibatch 크기 의존을 제거 |
| open-loop chunk 실행 | policy는 action 40개를 예측하고 기본 평가는 다음 요청 전에 chunk를 모두 실행한다. action head가 빨라져도 이 open-loop 구간은 자동으로 줄지 않으므로 long-horizon 오차가 그대로 쌓인다 | 재계획 전 실행 action 수를 1, 2, 5, 10, 20, 40으로 변화. execution horizon이 짧아질수록 성공률이 오르면 지연 시간 이점을 더 잦은 closed-loop 피드백으로 전환할 수 있다 |
| 검증되지 않은 overlap 경로 | 학습과 추론 코드는 확정 prefix를 지원하지만 동기식 LIBERO 평가는 빈 prefix를 공급한다. 측정된 성공률은 무조건부 one-step 경로만 평가한다. 게다가 학습 prefix는 expert chunk에서 샘플링해 제한된 잡음으로 교란한 것인 반면, 배치 시점의 prefix는 policy 자신이 만든다 | 물리적으로 일관된 도착 상태를 갖는 모델 생성 prefix로 asynchronous rollout에서 평가 |
| 학습과 아키텍처 교란 | backbone과 전처리 스택은 같지만 action head 아키텍처, 초기화, 학습 목적함수가 모두 다르다. 직접 MSE head, geometry 항 ablation, one-step consistency distillation head와의 비교가 빠져 있다. pre-training된 GR00T action head를 초기화로 쓰지도 않아 이 비교는 fine-tuning 비교가 아니라 처음부터 학습한 action head 비교다 | 최적화 난이도, 아키텍처 불일치, action 정규화 문제, one-step 목적함수를 각각 분리하는 ablation |
타당성 위협
저자가 직접 나열한 제약은 여섯 가지다.
- seed 1000의 GR00T 기준 checkpoint가 더 오래된 보관 평가에서 왔고 seed 비교 실행과 동일한 프로토콜이 아닐 수 있다.
- drifting seed의 Object suite 성공률이 없어서 object 지연 시간 행에 대응되는 통제된 성공률 비교가 없다.
- pi0.5 결과는 보관된 평가가 모든 suite에서 0을 냈고 요약 파일이 서로 어긋나 제외했다.
- 타이밍이 backbone과 action head만 포함하고 전처리, 네트워킹, 컨트롤러 실행, 스케줄링을 제외한다.
- 실제 로봇 절은 데이터 수집과 시스템 통합 기록이며 통제된 성공률 비교가 아니다.
- 메모리 관찰이 공유 서버 텔레메트리에서 나왔고 다른 작업의 영향을 받는다.
후속 방향
저자가 제시하는 다음 단계는 홍보성 실험이 아니라 통제된 실험이다. 목록은 다섯 가지다.
- 모든 baseline의 학습과 평가 프로토콜을 일치시킨다.
- geometry 추정의 minibatch 의존을 제거한다.
- 이웃 집합에서 질의 표본을 제외해야 하는지 검증한다.
- chunk당 실행하는 action 수를 줄인다.
- asynchronous rollout에서 overlap 경로를 평가한다.
배치 관점의 제안은 느린 VLM backbone과 빠른 action head를 결합하는 구성이다. backbone을 낮은 빈도로 갱신하면서 action head는 캐시된 시각 feature와 최신 로봇 상태로 다시 계산한다. 이 설계는 지연 augmentation과 도착 상태 일관성 학습을 요구하며 이번 보고서에서 평가하지 않았다.
보고서의 마지막 주장은 평가 기준에 관한 것이다. one-step policy는 action head 지연 시간만으로 판단해서는 안 되며, 속도와 성공률이 이루는 경계면으로, 그리고 줄어든 지연 시간이 실제로 더 잦은 closed-loop 피드백을 가능하게 하는지로 판단해야 한다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| action head | VLM backbone이 만든 표현을 받아 실제 로봇 action 수치로 바꾸는 출력 모듈 |
| one-step generation | 반복 denoising 없이 네트워크를 한 번만 평가해 action chunk 전체를 내는 방식 |
| drifting 목적함수 | expert action 주변에 geometry 가중 potential을 두고 그 값을 낮추는 Implicit Drifting Policy의 학습 목적함수 |
| geometry 행렬 | minibatch 안 이웃 표본의 action 분산에서 계산하는 대각 가중 행렬. detach되어 학습 potential의 가중에만 쓰인다 |
| DrifOv | one-step drifting head에 overlap 조건부 인터페이스를 더한 이 보고서의 구현체 이름 |
| action prefix | 이미 컨트롤러로 전달돼 확정된 action 행들. 디코딩 후 그대로 복사되어 덮어쓰이지 않는다 |
| 모드 평균화 | 유효한 action 후보가 여럿일 때 결정적 생성기가 그 평균 근처를 내놓는 현상 |
관련 페이지
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 이 보고서가 action head를 교체한 대상인 GR00T 계열의 출발점. dual-system VLA 구조와 data pyramid 학습 전략을 제시한다
- GR00T N1.5: N1.7의 직전 버전. VLM backbone을 고정하고 action head 쪽 구성을 바꾼 개선 내역을 다룬다
- 03-14. Groot N1.5 - 모두의 로보틱스 - VLA 입문: GR00T N1.5를 한국어로 해설한 입문 페이지. 반복 평가형 action head의 동작을 먼저 이해하는 데 쓴다
- π0: A Vision-Language-Action Flow Model for General Robot Control: flow matching action head로 action chunk를 만드는 대표 모델. 이 보고서가 대체하려는 반복 평가 구조의 원형이다
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: real-time action chunking을 실제 배치에 쓴 사례. DrifOv의 overlap 조건부가 겨냥한 문제와 같은 문제를 다룬다
- OpenVLA: An Open-Source Vision-Language-Action Model: LIBERO 네 suite를 VLA 평가 기준으로 쓰는 관행을 정착시킨 오픈소스 모델
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: LIBERO 성공률 하나로 policy를 판단할 때 놓치는 것을 다룬 연구. 이 보고서의 성공률 해석과 함께 읽을 만하다
- SmolVLA: A vision-language-action model for affordable and efficient robotics: 경량 backbone과 asynchronous 추론으로 VLA 비용을 줄인 사례. backbone 쪽 비용을 줄이는 상보적 접근이다