Physical AI · REPO · 2026
GR00T N1.7 3B 체크포인트와 LeRobot 통합: 모델 카드 규격, 플랫폼별 추론 지연, fine-tuning과 rollout 레시피
요약
이 페이지는 GR00T N1.7 베이스 체크포인트 nvidia/GR00T-N1.7-3B를 두 자료로 함께 다룬다. 첫째는 NVIDIA가 Hugging Face에 올린 모델 카드와 같은 저장소의 설정 파일이고, 둘째는 LeRobot 저장소의 GR00T policy 문서(docs/source/groot.mdx)다. 모델 카드는 "이 모델이 무엇이고 어떤 하드웨어에서 얼마나 빠른가"를, LeRobot 문서는 "이 모델을 내 데이터와 내 로봇에 어떻게 붙이는가"를 답한다.
GR00T N1.7은 humanoid를 포함한 여러 로봇에 공통으로 쓰는 3B parameter 규모의 cross-embodiment VLA다. Cosmos-Reason2-2B VLM backbone이 이미지와 지시문(instruction)을 해석하고, flow matching 방식의 DiT action head가 로봇 상태를 조건으로 연속 action을 생성한다. 모델 카드는 13개 데이터셋, 2,160만 data point로 학습했고 GB200 GPU 256개로 120시간이 걸렸다고 밝힌다.
두 자료가 주는 핵심 수치는 다음과 같다.
| 항목 | 값 | 출처 |
|---|---|---|
| parameter 수 | 30억 개 | 모델 카드 |
| action horizon | 40 | config.json |
| 최대 state와 action 차원 | 132 | config.json |
| 추론 denoising step | 4 | config.json, 지연 시간 표 조건 |
| 최고 추론 속도 | 35.9 Hz (H100, RTX Pro 6000 Blackwell, TensorRT) | 모델 카드 |
| edge 최저 추론 속도 | 4.6 Hz (Jetson Orin) | 모델 카드 |
| 학습 전력량 | 41,288 kWh | 모델 카드 |
| LIBERO 평균 성공률 | 96.5% (LeRobot 통합 구현) | LeRobot 문서 |
GitHub 공식 구현(NVIDIA Isaac GR00T (N1.7))이 설치 절차와 embodiment tag 체계, N1.6 대비 변경점을 다룬다면, 이 페이지는 체크포인트 자체의 규격과 LeRobot 경로의 사용법에 집중한다. 두 페이지를 함께 읽으면 N1.7을 받아서 실제 로봇에 올리기까지의 정보가 대부분 채워진다.
배경
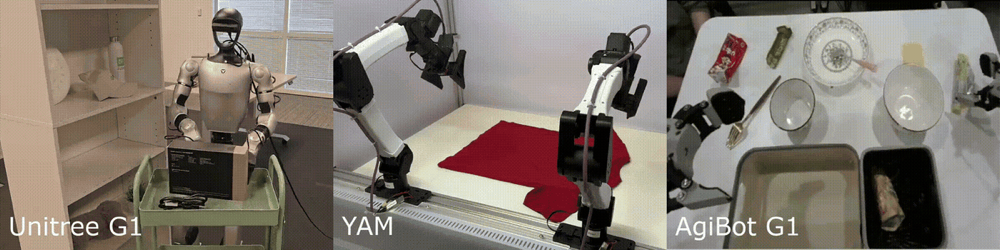
GR00T는 NVIDIA가 2025년 N1부터 공개해 온 humanoid용 foundation model 계열이다. N1 논문(GR00T N1: An Open Foundation Model for Generalist Humanoid Robots)은 VLM이 느린 주기로 장면을 해석하고 DiT가 빠른 주기로 action을 내는 dual-system 구조를 제시했다. 이후 N1.5(GR00T N1.5), N1.6을 거쳐 N1.7에서 backbone이 Cosmos-Reason2-2B로 교체됐다.
모델이 세대를 거듭하면서 배포 경로도 둘로 나뉘었다. NVIDIA의 Isaac-GR00T 저장소는 자체 CLI와 server-client 추론 구조를 제공하고, Hugging Face의 LeRobot은 여러 policy가 같은 데이터 형식과 학습 CLI를 공유하는 프레임워크 안에 GR00T를 하나의 policy type으로 넣었다. 즉 같은 체크포인트를 두 생태계 중 어디서 다룰지 고를 수 있다.
Hugging Face 모델 카드는 두 경로가 공통으로 내려받는 가중치의 정본이다. NVIDIA 모델 카드는 정해진 양식(설명, 라이선스, 아키텍처, 입출력, 소프트웨어 통합, 학습 데이터, 평가, 윤리)을 따르므로 성능 서술은 짧은 대신 규격과 비용 정보가 구조화되어 있다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. GR00T N1.7은 이미지, 지시문, 로봇 상태를 observation으로 받아 여러 timestep의 action을 한 번에 출력하는 policy다.
embodiment는 특정 형태와 센서, 액추에이터 구성을 가진 로봇 본체를 뜻한다. cross-embodiment 모델은 한 가중치로 팔 하나짜리 로봇부터 humanoid까지 여러 embodiment를 다룬다. 로봇마다 관절 수가 다르므로 GR00T는 state와 action을 최대 132차원까지 padding하고, embodiment마다 별도의 입출력 MLP를 둔다.
embodiment tag는 데이터가 어떤 로봇에서 왔는지 가리키는 문자열 키다. 모델은 이 tag로 어느 MLP 슬롯을 쓸지 정한다. LeRobot에서는 --policy.embodiment_tag로 지정하며, pre-training에 없던 로봇은 new_embodiment를 쓴다.
proprioception은 관절 위치와 속도, end-effector 자세처럼 로봇이 자기 몸 상태를 재는 센서 신호를 말한다. 모델 카드는 이를 State 입력으로 부른다.
action chunk는 한 번의 추론으로 출력하는 연속된 여러 timestep의 action 묶음이다. N1.7 체크포인트의 action horizon은 40이지만, LeRobot fine-tuning 예시는 chunk 크기 16을 쓰고 실제 기기 rollout에서는 그중 8개만 실행한다.
flow matching은 noise에서 데이터로 향하는 vector field를 학습해 샘플을 만드는 생성 기법이다. DiT는 diffusion transformer의 약자로, 이 생성 과정을 Transformer로 구현한 모델이다. GR00T의 action head는 noise가 섞인 action 토큰을 4 step에 걸쳐 정제해 최종 action을 만든다.
real-time action chunking은 로봇이 이전 action chunk를 실행하는 동안 다음 chunk를 비동기로 계산하고, 두 chunk가 매끄럽게 이어지도록 보정하는 추론 방식이다. execution horizon은 예측한 chunk 중 다음 추론 전까지 실제로 실행하는 action 개수를 뜻한다. LeRobot rollout 예시는 둘을 함께 켠다.
모델 구조
전체 흐름
GR00T N1.7은 pre-training된 vision encoder와 language encoder 위에 flow matching action transformer를 결합한 구조다. 모델 카드는 이를 GR00T 계열의 "medium-sized version"이라 부르고, 세부 설계는 N1 White Paper(arXiv 2503.14734)에 맡긴다.
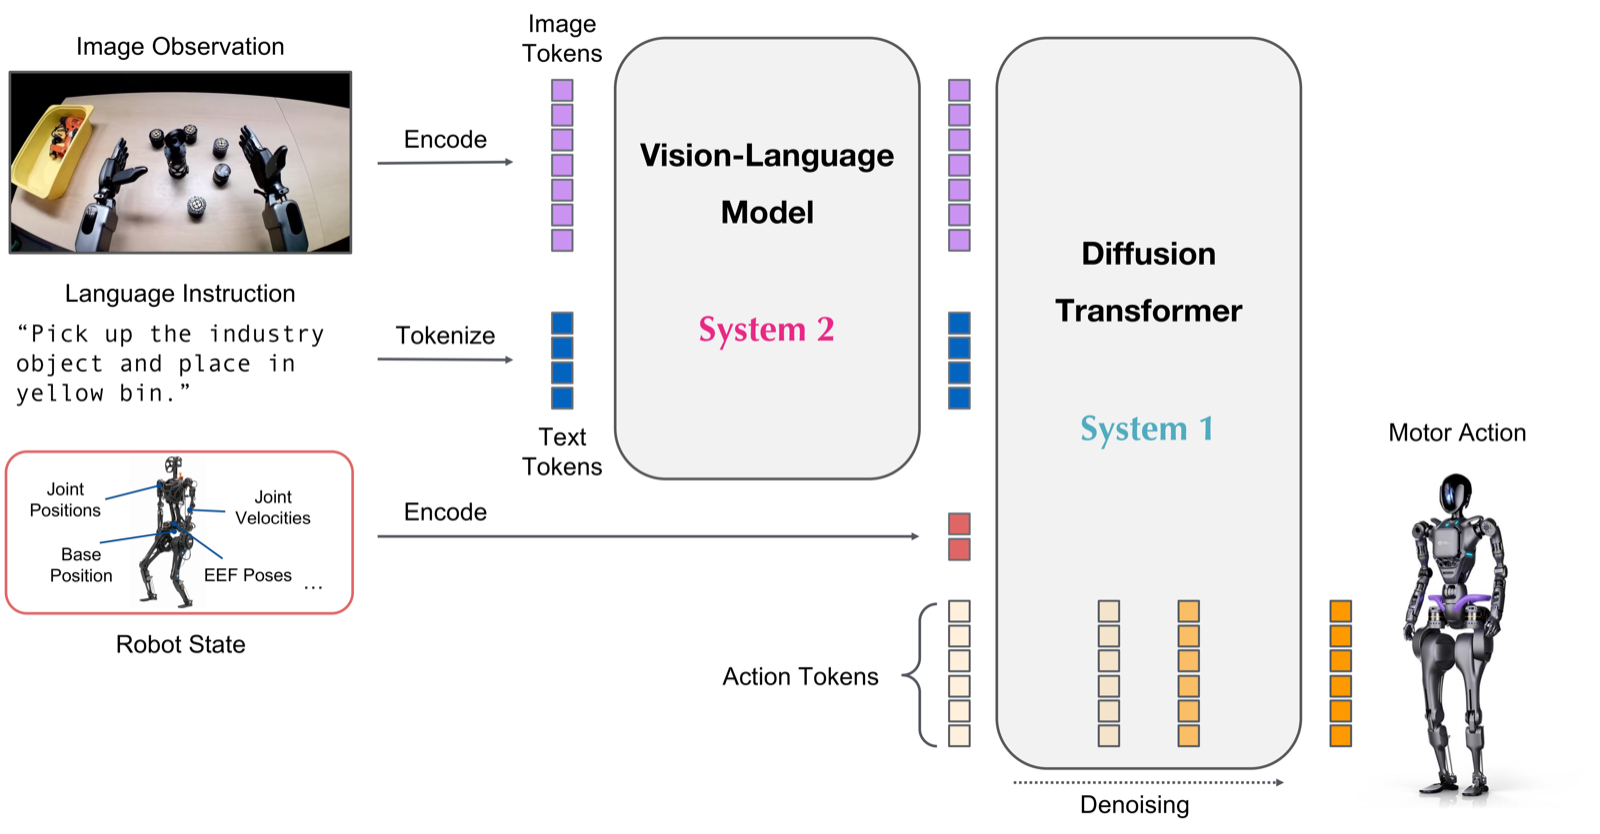
구조도는 왼쪽에서 오른쪽으로 읽는다. 카메라 이미지는 encode되어 image 토큰이 되고, "Pick up the industry object and place in yellow bin." 같은 지시문은 tokenize되어 text 토큰이 된다. 두 토큰 묶음은 VLM(System 2)을 통과한다. 관절 위치, 관절 속도, base 위치, end-effector 자세로 이루어진 robot state는 VLM을 거치지 않고 별도로 encode되어 DiT(System 1)로 직접 들어간다. DiT는 VLM 출력, state 인코딩, noise가 섞인 action 토큰을 함께 받아 denoising을 반복하고, 최종 action 토큰이 humanoid의 motor action이 된다.
이 그림은 N1 논문의 Model Overview 그림과 같은 도식이다. LeRobot 문서도 같은 그림을 캡션과 함께 싣는다. 따라서 그림 자체는 N1.7 고유의 변경(backbone 교체, action 차원 확대)을 보여 주지 않고 GR00T 계열 공통 골격을 보여 준다.
구성 요소
모델 카드의 Network Architecture 절은 다섯 구성 요소를 다음과 같이 서술한다.
| 구성 요소 | 처리 방식 |
|---|---|
| RGB 카메라 프레임 | pre-training된 vision transformer(SigLip2)로 처리 |
| 텍스트 | pre-training된 transformer(T5)로 인코딩 |
| robot proprioception | embodiment ID별로 따로 두는 MLP로 인코딩. 차원이 로봇마다 다르므로 설정 가능한 최대 길이까지 padding한 뒤 MLP에 넣는다 |
| action 인코딩과 velocity 예측 디코딩 | embodiment마다 하나씩 두는 MLP |
| flow matching transformer | DiT로 구현. diffusion step 조건은 AdaLN(adaptive layernorm)으로 주입 |
AdaLN은 diffusion step 같은 조건 정보로 layer normalization의 scale과 shift를 조절하는 방식이다. DiT가 지금 몇 번째 denoising step인지를 이 경로로 알게 된다. velocity 예측은 flow matching에서 현재 noisy action이 정답 action 쪽으로 이동해야 할 방향과 크기를 예측하는 것을 말한다.
표의 SigLip2와 T5 서술은 카드 상단의 "VLM backbone is now Cosmos-Reason2-2B" 문구와 맞지 않는다. Cosmos-Reason2-2B는 Qwen3-VL 계열 VLM이며, LeRobot 문서와 GitHub README 모두 N1.7 backbone을 Cosmos-Reason2/Qwen3-VL로 적는다. 따라서 표의 encoder 서술은 이전 세대 카드 문구가 남은 것으로 보고, backbone은 Cosmos-Reason2-2B로 이해하는 것이 맞다. 카드의 Cosmos-Reason2-2B 링크가 실제로는 nvidia/Cosmos-Reason2-8B 페이지를 가리킨다는 점도 함께 확인해 둔다.
입력과 출력 규격
모델 카드는 입출력을 유형, 형식, 차원 세 가지로 정의한다.
| 구분 | 유형 | 형식 | 차원 |
|---|---|---|---|
| Vision 입력 | 이미지 프레임 | 로봇 카메라에서 온 가변 개수의 uint8 프레임 | 2D RGB |
| State 입력 | robot proprioception | 부동소수점 | 1D 실수 벡터 |
| Language 입력 | 지시문 | 문자열 | 1D 문자열 |
| Embodiment ID 입력 | 정수 | 학습에 쓰인 embodiment 중 어느 것인지 가리키는 정수 | 1D 정수 |
| 출력 | action | 연속값 벡터 | 2D |
입력 쪽에서 눈여겨볼 점은 카메라 수가 고정되지 않았다는 것이다. 손목 카메라 하나만 있는 로봇도, 여러 대를 단 humanoid도 같은 모델을 쓴다. 출력은 시간(chunk 길이)과 action 차원을 함께 갖는 2D 배열이며, 각 값은 로봇의 모터 제어 값에 대응한다. 실제로 의미 있는 차원 수는 해당 embodiment의 자유도에 따라 달라진다.
config.json의 하이퍼파라미터
모델 카드 본문에는 하이퍼파라미터가 없지만, 같은 저장소의 config.json이 실제 값을 담고 있다.
| 키 | 값 | 의미 |
|---|---|---|
model_name |
nvidia/Cosmos-Reason2-2B |
VLM backbone |
architectures |
Gr00tN1d7 |
모델 클래스 |
action_horizon |
40 | 한 번에 예측하는 action 개수 |
max_state_dim, max_action_dim |
132, 132 | padding 기준 최대 차원 |
max_num_embodiments |
32 | embodiment별 MLP 슬롯 수 |
num_inference_timesteps |
4 | 추론 시 denoising step 수 |
diffusion_model_cfg.num_layers |
32 | DiT 층 수 |
num_attention_heads, attention_head_dim (DiT) |
32, 48 | DiT attention 구성 |
norm_type (DiT) |
ada_norm |
AdaLN 사용 |
vl_self_attention_cfg.num_layers |
4 | VLM 출력 뒤 self-attention 층 수 |
backbone_embedding_dim, hidden_size |
2048, 1024 | backbone 출력 차원과 action head hidden 차원 |
select_layer |
16 | backbone에서 특징을 꺼내는 층 |
tune_llm, tune_visual, tune_diffusion_model |
true | 해당 모듈 학습 여부 |
tune_top_llm_layers |
0 | |
state_dropout_prob |
0.2 | 학습 중 state 입력 dropout 확률 |
image_target_size, image_crop_size |
256, 230 | 이미지 전처리 크기 |
rtc_ramp_rate |
6.0 | real-time action chunking 관련 설정 |
dtype, load_bf16 |
bfloat16, true | 가중치 정밀도 |
transformers_version |
4.57.1 |
select_layer 16은 backbone의 마지막 층이 아니라 16번째 층의 hidden state를 action head에 넘긴다는 뜻이다. N1 논문은 최종 층 대신 중간 층 임베딩을 쓰면 추론이 빨라지고 downstream 성공률도 높았다고 보고했고(N1은 12번째 층 사용), N1.7도 같은 방식을 유지한다. VLM 출력과 DiT 사이에는 4층 self-attention이 더 있어 VLM 특징을 action 생성에 맞게 한 번 더 가공한다.
state_dropout_prob 0.2는 학습 중 state 입력을 20% 확률로 지워 proprioception에 과도하게 기대지 않게 하는 정규화다. 이미지 쪽에는 color jitter(밝기 0.3, 대비 0.4, 채도 0.5, 색상 0.08)와 crop 비율 0.95가 기본 augmentation으로 설정되어 있다.
이 값 일부는 GitHub README가 적은 N1.7 설정과 다르다.
| 항목 | GitHub README (GA) | Hugging Face config.json |
|---|---|---|
| DiT 층 수 | 16 | 32 |
select_layer |
12 | 16 |
load_bf16 |
false | true |
| transformers 버전 | 4.57.3 | 4.57.1 |
| 버전 표기 | GA | EA (모델 카드 본문) |
EA는 Early Access, GA는 General Availability를 뜻한다. Hugging Face 저장소의 최종 수정일이 2026-04-23이고 카드가 EA를 표기한다는 점을 함께 보면, 체크포인트의 config.json과 GitHub GA 코드의 기본 설정이 서로 다른 시점의 값일 가능성이 있다. 두 값이 충돌할 때는 실제로 로드하는 체크포인트의 config.json이 모델 구조를 결정한다.
embodiment ID 매핑
embodiment_id.json은 embodiment tag 문자열을 MLP 슬롯 번호(0~29)에 대응시킨다. 이 파일을 보면 N1.7이 어떤 데이터로 학습했는지 간접적으로 확인할 수 있다.
| 묶음 | tag 예시 | 슬롯 |
|---|---|---|
| 벤치마크 post-training | simpler_env_google, simpler_env_widowx, libero_sim, droid_sim |
0, 1, 2, 3 |
| Open X-Embodiment | oxe_droid, oxe_fractal, oxe_language_table, oxe_bridge |
17, 18, 19, 20 |
| 시뮬레이션 | robocasa_panda_omron, sim_behavior_r1_pro |
13, 23 |
| 실제 humanoid와 양팔 로봇 | agibot, unitree_g1_full_body_with_waist_height_nav_cmd, real_g1_*, real_r1_pro_sharpa_*, xdof* |
24~29 |
| 사람 데이터 변형 | real_r1_pro_sharpa_relative_eef_human, _egodex, _maxinsights, _mecka |
26 |
같은 로봇 안에서도 action 표현에 따라 tag가 갈린다. real_r1_pro_sharpa 하나에 relative_eef, delta_eef, absolute_eef, relative_joint, meanstd 변형이 붙어 있다. 이는 GitHub README가 N1.7의 핵심 변경으로 꼽은 relative EEF action space 실험의 흔적으로 읽힌다. relative EEF action space는 action을 절대 목표 자세가 아니라 현재 end-effector 자세로부터의 변화량으로 적는 표현이다.
슬롯은 로봇 하나에 하나씩이 아니라 state와 action 배열 구조가 같은 데이터 묶음 단위로 배정된 것으로 보인다. real_r1_pro_sharpa_relative_eef_human과 agibot이 모두 26번이고, gr1_unified와 oxe_bridge가 같은 20번을 공유한다. 32개 슬롯 중 실제로 쓰인 번호는 03, 13, 1729이므로, 자기 로봇을 붙일 때 쓸 수 있는 빈 슬롯이 남아 있다.
학습 데이터와 비용
데이터 구성
모델 카드는 학습과 평가 데이터를 합쳐 2,160만 data point, 데이터셋 13개라고 밝힌다. 학습 데이터의 이름은 GR00T Pretraining Data이며, 수집 방식은 사람, 로봇, 시뮬레이션 혼합이고 라벨링은 사람과 자동 혼합이다. 센서는 RGB 카메라, proprioception, 액추에이터 데이터다.
LeRobot 문서는 같은 데이터를 출처 기준으로 세 가지로 나눈다.
| 데이터 종류 | 내용 |
|---|---|
| 실제 로봇 데이터 | 로봇에서 직접 수집한 데이터 |
| 합성 데이터 | NVIDIA Isaac GR00T Blueprint로 생성한 데이터 |
| 인터넷 규모 영상 | 웹 영상 데이터 |
LeRobot 문서는 GR00T의 성능이 이렇게 넓고 다양한 humanoid 데이터에서 나온다고 설명하고, 그 결과 post-training으로 특정 embodiment, 과제, 환경에 쉽게 적응한다고 적는다.
학습 비용
모델 카드는 학습 비용을 계산식과 함께 공개한다.
| 항목 | 값 |
|---|---|
| 하드웨어 | GB200 64노드, 노드당 GPU 4개 (GPU 256개) |
| GPU 전력 가정 | 1,200 W |
| 학습 시간 | 120시간 (GPU 시간 30,720시간) |
| 계산식 | 64 × 4 × 1200 W × 0.001 × 0.8 × 120 h × 1.4 |
| 총 전력량 | 41,288 kWh |
| 배출 계수 | 410.5 (단위 미기재) |
| 배출량 | 16.949 tCO2e |
계산식의 0.8은 평균 전력 사용률, 1.4는 냉각 같은 데이터센터 부대 설비를 반영한 계수로 보이지만 카드는 계수의 의미를 설명하지 않는다. 3B 규모 모델을 GB200 256개로 5일간 학습한 셈이며, 이 규모는 개인이나 소규모 연구실이 처음부터 재현하기 어렵다. 따라서 이 체크포인트를 받아 post-training하는 것이 일반적인 사용 방식이다.
모델 패밀리와 평가
post-training 체크포인트 4종
모델 카드는 베이스 모델 외에 벤치마크 데이터로 post-training한 4개 모델을 소개한다.
| 모델 | post-training 데이터 | 데이터 규모 |
|---|---|---|
| GR00T N1.7 SimplerEnv Bridge | IPEC-COMMUNITY/bridge_orig_lerobot (BridgeData V2의 LeRobot 형식 변환) |
trajectory 60,096개, 환경 24곳 |
| GR00T N1.7 SimplerEnv Fractal | 카드상 Bridge와 같은 링크와 설명 | 카드상 Bridge와 동일 |
| GR00T N1.7 DROID | DROID | 시연 trajectory 약 76,000개(약 350시간), 52개 건물의 장면 564곳, 과제 86종 |
| GR00T N1.7 LIBERO | LIBERO | 언어 조건 manipulation 과제 130종, 사람 teleoperation 시연 데이터(demonstration) |
trajectory는 한 episode 동안 기록된 observation과 action의 시간 순서열을 말한다. DROID는 실험실 밖 실제 환경에서 수집한 대규모 manipulation 데이터셋이고, LIBERO는 과제를 순차적으로 배우며 지식 전이와 지속 학습을 평가하는 lifelong robot learning 벤치마크다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 말한다.
Fractal 항목은 데이터 링크와 요약이 Bridge 항목을 그대로 복제한 상태다. Fractal은 Google 로봇 데이터를 가리키는 이름이므로 이는 카드의 편집 오류로 보인다. embodiment_id.json에서도 Bridge(simpler_env_widowx)와 Fractal(simpler_env_google)은 서로 다른 슬롯을 쓴다.
평가 항목
모델 카드는 평가를 White Paper 정의에 따른다고 적고 항목만 나열한다.
| 구분 | 평가 항목 |
|---|---|
| 시뮬레이션 | 상체 제어 벤치마크, DexMG White Paper 과제 9종, RoboCasa 모바일 manipulator 과제 24종, Digital Cousin GR-1 humanoid manipulation 과제 24종. 성공률은 자동 측정 |
| 실제 로봇 | 장보기 물품 포장, 학습에 없던 새 물체, 인계를 포함한 산업용 다중 로봇 협업. 연구실 관찰자가 판정 |
이 목록은 N1 White Paper의 평가 구성과 같고, 카드에는 성공률 수치가 없다. N1.7의 정량 성능은 다음 절의 LeRobot LIBERO 결과가 이 두 자료에서 확인할 수 있는 유일한 수치다.
LeRobot 통합 구현의 LIBERO 결과
LeRobot 문서는 LeRobot 통합 구현(GR00T-LeRobot)으로 얻은 LIBERO 예비 결과를 공개한다. suite마다 episode 50회 이상으로 평가했다. episode는 과제 시작부터 종료까지의 한 실행 단위다.
| Suite | 성공률 | 체크포인트 |
|---|---|---|
| LIBERO Spatial | 95% | nvidia/gr00t17-lerobot-libero_spatial-640 |
| LIBERO Object | 100% | nvidia/gr00t17-lerobot-libero_object-640 |
| LIBERO Goal | 98% | nvidia/gr00t17-lerobot-libero_goal-640 |
| LIBERO 10 (Long) | 93% | nvidia/gr00t17-lerobot-libero_10-640 |
| 평균 | 96.5% |
GR00T N1.7은 물체 종류를 바꾸는 Object suite에서 100%를 기록했고, 여러 하위 과제를 이어서 수행하는 LIBERO 10에서 93%로 가장 낮았다. 두 suite의 차이는 7%p다. 즉 과제 길이가 길어질수록 성공률이 내려가는 경향이 있지만, 가장 어려운 suite에서도 90%를 넘는다.
문서는 이 수치를 "preliminary"로 표기하고, 성공률을 보고할 때 suite당 episode 50회 이상을 쓰라고 권고한다. 체크포인트 이름의 640이 무엇을 뜻하는지는 문서에 설명이 없다.
추론 성능
플랫폼별 지연 시간
모델 카드는 denoising 4 step, 카메라 1대 조건에서 9개 플랫폼의 추론 지연 시간을 세 가지 실행 모드로 측정한 표를 싣는다. E2E는 데이터 처리부터 action 출력까지의 전체 지연 시간이고, Frequency는 그 역수로 계산한 초당 추론 횟수다.
| 장치 | 모드 | 데이터 처리 | Backbone | Action Head | E2E | Frequency | 가속비 |
|---|---|---|---|---|---|---|---|
| H100 80GB HBM3 | PyTorch Eager | 6.2 ms | 31.3 ms | 48.2 ms | 85.8 ms | 11.7 Hz | 1.00x |
| torch.compile | 6.2 ms | 30.4 ms | 12.0 ms | 48.6 ms | 20.6 Hz | 1.77x | |
| TensorRT (Full Pipeline) | 6.2 ms | 8.8 ms | 12.3 ms | 27.9 ms | 35.9 Hz | 3.08x | |
| H20 96GB HBM3 | PyTorch Eager | 5.33 ms | 30.8 ms | 47.3 ms | 83.4 ms | 12.0 Hz | 1.00x |
| torch.compile | 5.33 ms | 31.1 ms | 13.3 ms | 49.7 ms | 20.1 Hz | 1.68x | |
| TensorRT (Full Pipeline) | 5.33 ms | 14.2 ms | 14.5 ms | 34.0 ms | 29.4 Hz | 2.45x | |
| RTX Pro 6000 Blackwell | PyTorch Eager | 4.8 ms | 29.3 ms | 44.0 ms | 78.4 ms | 12.8 Hz | 1.00x |
| torch.compile | 4.8 ms | 29.4 ms | 16.5 ms | 50.7 ms | 19.7 Hz | 1.55x | |
| TensorRT (Full Pipeline) | 4.8 ms | 9.9 ms | 13.2 ms | 27.9 ms | 35.9 Hz | 2.81x | |
| RTX Pro 5000 72GB | PyTorch Eager | 8.85 ms | 54.01 ms | 63.19 ms | 126.4 ms | 7.9 Hz | 1.00x |
| torch.compile | 8.85 ms | 55.74 ms | 20.38 ms | 84.9 ms | 11.8 Hz | 1.49x | |
| TensorRT (Full Pipeline) | 8.85 ms | 14.37 ms | 17.33 ms | 40.5 ms | 24.7 Hz | 3.13x | |
| L40 | PyTorch Eager | 6.6 ms | 42.8 ms | 78.9 ms | 128.3 ms | 7.8 Hz | 1.00x |
| torch.compile | 6.6 ms | 42.7 ms | 19.8 ms | 69.0 ms | 14.5 Hz | 1.86x | |
| TensorRT (Full Pipeline) | 6.6 ms | 13.1 ms | 18.8 ms | 38.4 ms | 26.0 Hz | 3.34x | |
| L20 | PyTorch Eager | 5.7 ms | 47.58 ms | 86.92 ms | 140.3 ms | 7.1 Hz | 1.00x |
| torch.compile | 5.7 ms | 47.2 ms | 20.18 ms | 73.1 ms | 13.7 Hz | 1.92x | |
| TensorRT (Full Pipeline) | 5.7 ms | 17.27 ms | 19.79 ms | 42.8 ms | 23.3 Hz | 3.28x | |
| DGX Spark | PyTorch Eager | 13.14 ms | 38.22 ms | 74.94 ms | 126.4 ms | 7.9 Hz | 1.00x |
| torch.compile | 13.14 ms | 39.23 ms | 56.49 ms | 108.8 ms | 9.2 Hz | 1.16x | |
| TensorRT (Full Pipeline) | 13.14 ms | 33.43 ms | 52.37 ms | 98.6 ms | 10.1 Hz | 1.28x | |
| AGX Thor | PyTorch Eager | 8.21 ms | 55.26 ms | 81.65 ms | 144.9 ms | 6.9 Hz | 1.00x |
| torch.compile | 8.21 ms | 55.59 ms | 64.66 ms | 128.4 ms | 7.8 Hz | 1.13x | |
| TensorRT (Full Pipeline) | 8.21 ms | 28.89 ms | 56.64 ms | 93.8 ms | 10.7 Hz | 1.54x | |
| Orin | PyTorch Eager | 9.45 ms | 127.6 ms | 205.39 ms | 342.8 ms | 2.9 Hz | 1.00x |
| torch.compile | 9.45 ms | 128.59 ms | 78.94 ms | 217.0 ms | 4.6 Hz | 1.58x | |
| TensorRT (DiT-only) | 9.45 ms | 128.38 ms | 78.6 ms | 216.5 ms | 4.6 Hz | 1.58x |
Orin은 TensorRT 10.3이 backbone engine을 지원하지 않아 DiT만 TensorRT로 실행한다(--inference-mode tensorrt). 나머지 플랫폼은 backbone과 action head를 모두 TensorRT로 실행한다(--inference-mode trt_full_pipeline). 카드의 Inference 절은 별도로 테스트 하드웨어를 A6000이라고 적지만, A6000은 위 표에 없다.
표의 해석
PyTorch Eager에서는 action head가 가장 느린 단계다. H100 기준 action head가 48.2 ms로 backbone 31.3 ms보다 길다. backbone은 한 번만 실행되지만 DiT는 denoising step 4번마다 다시 실행되기 때문이다.
실행 모드마다 줄어드는 단계가 다르다.
| 모드 | H100 backbone | H100 action head | 해석 |
|---|---|---|---|
| PyTorch Eager | 31.3 ms | 48.2 ms | 기준 |
| torch.compile | 30.4 ms | 12.0 ms | 반복 실행되는 action head의 kernel 실행 비용을 주로 줄인다 |
| TensorRT (Full Pipeline) | 8.8 ms | 12.3 ms | backbone까지 engine으로 바꿔 전체를 줄인다 |
즉 torch.compile만으로도 E2E가 85.8 ms에서 48.6 ms로 줄고, backbone까지 TensorRT로 바꾸면 27.9 ms까지 내려간다. 데이터 처리 6.2 ms는 어떤 모드에서도 변하지 않으므로, TensorRT 모드에서는 E2E의 약 22%를 차지한다.
edge 플랫폼의 가속 폭은 데이터센터 GPU보다 작다. 데이터센터 GPU의 TensorRT 가속비가 2.45x~3.34x인 반면 DGX Spark는 1.28x, AGX Thor는 1.54x, Orin은 1.58x다. 특히 Orin은 backbone을 TensorRT로 바꿀 수 없어 backbone만 128 ms가 걸리고, 최대 4.6 Hz에 그친다.
이 수치를 control frequency와 연결해 읽어야 한다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. GR00T는 한 번 추론에 action 여러 개를 내므로, 추론이 4.6 Hz여도 chunk의 action을 차례로 실행하면 로봇의 control frequency는 그보다 높게 유지된다. 다만 추론 간격이 길수록 새 observation이 반영되기까지의 지연이 커지므로, LeRobot rollout처럼 real-time action chunking으로 다음 chunk를 미리 계산하는 방식이 edge 배포에서 특히 중요하다.
지원 환경
| 항목 | 내용 |
|---|---|
| runtime engine | PyTorch |
| 지원 GPU 마이크로아키텍처 | Ampere, Blackwell, Jetson, Hopper, Lovelace |
| 운영체제 | Linux |
| 배포 지역 | 전 세계 |
| 대상 사용자 | 연구자와 오픈소스 커뮤니티(로보틱스 연구와 알고리즘 개발), 개발자(로봇 응용 통합과 커스터마이즈), 스타트업과 기업(개발 가속과 학습 비용 절감) |
LeRobot에서 사용하기
통합 방식과 지원 버전
LeRobot은 GR00T N1.7을 groot policy type으로 통합한다. LeRobot은 여러 policy가 같은 데이터 형식과 학습 CLI를 공유하는 프레임워크이므로(LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch), ACT나 π0 계열을 학습하던 명령에서 --policy.type만 바꾸면 GR00T를 쓸 수 있다.
현재 LeRobot 릴리스는 N1.7만 지원한다. N1.5 지원은 제거되었고, N1.5 체크포인트와 config는 migration 안내와 함께 거부된다. N1.5 체크포인트를 계속 쓰려면 N1.5를 지원한 마지막 릴리스인 lerobot==0.5.1로 버전을 고정해야 한다. LeRobot 저장소 이력에서 N1.7 policy는 2026-07-03에 추가됐고, LIBERO 결과와 체크포인트는 같은 달 5일과 8일에 갱신됐다.
설치
GR00T는 NVIDIA GPU 가속 시스템을 전제로 한다. 단계별로 필요한 extra가 다르다.
| 상황 | 명령 |
|---|---|
| 패키지 설치 | pip install "lerobot[groot]" |
| 소스 체크아웃 | pip install -e ".[groot]" |
| 학습 추가 의존성 | pip install "lerobot[training]" |
| 실제 기기 rollout 추가 의존성 | pip install "lerobot[feetech,viz]" |
rollout용 extra는 SO-101 팔의 모터 제어(feetech)와 실행 중 데이터 시각화(viz)에 필요한 의존성을 묶은 것으로 보인다.
자기 데이터셋 fine-tuning
LeRobot 문서의 기본 예시는 SO-101 로봇 팔로 수집한 데이터셋을 fine-tuning하는 명령이다. SO-101은 pre-training에 없던 로봇이므로 new_embodiment tag를 쓴다. 학습 전에 hf auth login과 wandb login으로 Hugging Face와 Weights & Biases에 로그인하고, 결과 모델 저장소 이름은 {데이터셋}_GR00T17로 정한다.
| 인자 | 값 | 의미 |
|---|---|---|
--policy.type |
groot |
GR00T policy 선택 |
--policy.base_model_path |
nvidia/GR00T-N1.7-3B |
베이스 체크포인트 |
--policy.embodiment_tag |
new_embodiment |
pre-training에 없던 로봇용 tag |
--policy.chunk_size |
16 | 한 번에 예측하는 action 개수 |
--policy.n_action_steps |
16 | 예측 chunk에서 실제 실행하는 action 개수 |
--policy.use_relative_actions |
true | action을 현재 상태 대비 변화량으로 표현 |
--policy.relative_exclude_joints |
["gripper"] |
그리퍼는 relative 변환에서 제외 |
--policy.use_bf16 |
true | bfloat16 학습 |
--dataset.image_transforms.enable |
true | 이미지 augmentation 사용 |
--batch_size |
64 | |
--steps |
20000 | 학습 step 수 |
--save_freq |
5000 | 체크포인트 저장 주기 |
--use_policy_training_preset |
true | policy 기본 학습 설정 사용 |
--env_eval_freq, --eval_steps |
0, 0 | 학습 중 시뮬레이션 평가 생략 |
--policy.push_to_hub |
true | 학습 결과를 Hugging Face Hub에 업로드 |
chunk 크기 16은 체크포인트 기본값 40보다 작다. 저가 팔의 짧은 과제에서는 긴 chunk가 필요하지 않으므로 학습과 추론 부담을 줄인 설정으로 볼 수 있다.
relative action 옵션은 GitHub README가 N1.7의 핵심 변경으로 꼽은 relative 표현을 LeRobot에서 켜는 스위치다. 그리퍼를 relative 변환에서 빼는 이유는 문서에 설명되어 있지 않다. 그리퍼는 열림과 닫힘이라는 절대 상태가 의미를 갖는 관절이어서 변화량 표현이 맞지 않기 때문으로 보인다.
LIBERO 학습 레시피
LIBERO 학습 예시는 NVIDIA Isaac-GR00T 저장소의 LIBERO 예제 레시피를 LeRobot 명령으로 옮긴 것이다. libero_spatial suite를 예로 들며, 자기 데이터셋 레시피와 비교하면 다음이 다르다.
| 항목 | 자기 데이터셋 | LIBERO |
|---|---|---|
| 데이터셋 | 사용자 데이터 | IPEC-COMMUNITY/libero_spatial_no_noops_1.0.0_lerobot |
| embodiment tag | new_embodiment |
libero_sim |
| relative action | true | false |
| batch size | 64 | 320 |
| 학습 step | 20000 | 20000 (--policy.max_steps=20000 병기) |
| 저장 주기 | 5000 | 2000 |
| 이미지 augmentation | 기본 설정 | ColorJitter 4종을 명시하고 최대 4개 적용 |
| 영상 backend | 기본값 | pyav |
| Hub 업로드 | true | false |
LIBERO 레시피의 ColorJitter 범위는 밝기 0.71.3, 대비 0.61.4, 채도 0.51.5, 색상 -0.080.08이다. 데이터 로딩에는 worker 4개, prefetch factor 2, persistent worker를 쓴다.
libero_sim tag는 embodiment_id.json의 2번 슬롯에 해당한다. 즉 LIBERO는 pre-training 단계에서 이미 슬롯이 배정된 embodiment라 new_embodiment 대신 전용 tag를 쓴다. relative action을 끈 것도 LIBERO 데이터와 공식 레시피가 절대 action 표현을 쓰기 때문으로 보인다.
학습 후 평가는 lerobot-eval에 --env.type=libero, --env.task=libero_spatial, --policy.embodiment_tag=libero_sim, --eval.n_episodes=50을 주어 실행한다. LIBERO 환경 설치는 LeRobot의 LIBERO 문서를 먼저 따라야 한다.
실제 기기 rollout
학습한 모델은 lerobot-rollout으로 실제 로봇에서 실행한다. 문서 예시는 SO-101 follower 팔에 손목 카메라와 정면 카메라를 연결하고 "place the vial in the rack" 과제를 60초 동안 실행한다. 두 카메라는 모두 640×480, 30 fps, MJPG 설정이며, 카메라 인덱스는 lerobot-find-cameras opencv로 확인한다.
| 인자 | 값 | 의미 |
|---|---|---|
--strategy.type |
base |
기본 rollout 전략 |
--policy.path |
학습한 모델 ID | fine-tuning 결과 |
--policy.base_model_path |
nvidia/GR00T-N1.7-3B |
베이스 체크포인트 |
--policy.n_action_steps |
8 | chunk당 실행 action 수 |
--robot.type |
so101_follower |
로봇 종류 |
--robot.port |
/dev/ttyACM0 |
로봇 시리얼 포트 |
--inference.type |
rtc |
real-time action chunking 추론 |
--inference.rtc.enabled |
True | 추론이 불안정하면 False로 끈다 |
--inference.rtc.execution_horizon |
8 | chunk에서 실행하는 구간 길이 |
--inference.queue_threshold |
0 | action queue 임계값. 안정적 추론을 위해 5를 넘기지 않는다 |
--duration |
60 | 실행 시간(초) |
--display_data |
true | 실행 중 데이터 시각화 |
학습 때 chunk 16개를 모두 실행하던 것과 달리 rollout은 8개만 실행한다. chunk 앞쪽 절반만 쓰고 다음 추론 결과로 넘어가면 새 observation이 더 자주 반영된다. real-time action chunking은 이 교체 시점에서 이전 chunk와 새 chunk가 끊기지 않도록 이어 붙이는 역할을 한다.
두 배포 경로 비교
같은 체크포인트를 NVIDIA 공식 저장소와 LeRobot 중 어디서 다룰지는 다음 기준으로 고른다.
| 기준 | Isaac-GR00T (NVIDIA) | LeRobot groot policy |
|---|---|---|
| 주요 문서 | NVIDIA Isaac GR00T (N1.7) | 이 페이지의 LeRobot 절 |
| 학습 명령 | launch_finetune.py |
lerobot-train --policy.type=groot |
| 실제 기기 추론 | ZMQ server-client, PolicyClient |
lerobot-rollout, real-time action chunking 내장 |
| embodiment 지정 | 대문자 tag (NEW_EMBODIMENT, LIBERO_PANDA 등) |
소문자 tag (new_embodiment, libero_sim) |
| 가속 배포 | ONNX와 TensorRT export 제공 | 문서에 언급 없음 |
| 공개 LIBERO 체크포인트 | nvidia/GR00T-N1.7-LIBERO |
suite별 nvidia/gr00t17-lerobot-libero_*-640 4종 |
| 적합한 사용자 | 모델 내부, 벤치마크별 예제, edge 가속이 필요한 경우 | LeRobot 데이터와 SO-101 같은 저가 팔을 이미 쓰는 경우 |
GitHub README도 같은 분업을 명시한다. LeRobot 원생 학습과 평가와 rollout 흐름은 LeRobot 문서를, 모델 내부 구현과 배포 도구와 벤치마크별 예제는 Isaac-GR00T 저장소를 참고하라는 것이다. 위 모델 카드의 TensorRT 지연 시간 표는 Isaac-GR00T의 --inference-mode 옵션 기준이므로, LeRobot 경로에서 같은 속도가 나온다고 가정할 수는 없다.
한계
모델 카드와 LeRobot 문서 양쪽에 확인해 둘 한계가 있다.
| 구분 | 한계 |
|---|---|
| 성능 근거 | 모델 카드에 성공률 수치가 없다. 이 두 자료에서 N1.7의 정량 성능은 LeRobot LIBERO 예비 결과가 전부이며, SimplerEnv와 DROID 결과는 없다 |
| 카드 내부 불일치 | encoder 서술(SigLip2, T5)이 Cosmos-Reason2-2B backbone 문구와 맞지 않고, Cosmos-Reason2-2B 링크가 8B 페이지를 가리키며, Fractal 모델 항목이 Bridge 항목을 복제했다 |
| 버전 차이 | 카드는 EA, GitHub README는 GA를 표기한다. config.json의 DiT 층 수와 select_layer도 README 설정과 다르다 |
| edge 추론 속도 | Orin에서 최대 4.6 Hz, AGX Thor에서 10.7 Hz로 데이터센터 GPU의 35.9 Hz와 차이가 크다. Orin은 backbone을 TensorRT로 바꿀 수 없다 |
| 학습 재현 비용 | GB200 GPU 256개로 120시간, 41,288 kWh가 든 학습이라 처음부터 재현하기 어렵다 |
| N1.5 호환 단절 | 현재 LeRobot은 N1.5 체크포인트를 거부하므로 N1.5 기반 작업은 lerobot==0.5.1에 고정해야 한다 |
| RTC 안정성 | LeRobot 문서는 real-time action chunking이 추론 불안정을 일으키면 끄라고 하고, queue 임계값을 5 이하로 두라고 권고한다 |
| 명령 예시 오류 | rollout 명령의 줄 연속 기호(\) 뒤에 주석이 붙어 있어 그대로 복사하면 셸에서 명령이 끊긴다. 주석을 지우고 실행해야 한다 |
모델 카드는 책임 있는 사용에 대한 안내도 붙인다. foundation model과 fine-tuning 모델을 시스템에 통합할 때는 use case별 데이터로 추가 시험이 필요하며, V-model 방법론에 따라 단위와 시스템 수준에서 반복 시험과 검증을 거쳐야 한다. V-model은 요구사항 정의부터 구현까지 내려간 뒤 단위 시험, 통합 시험, 시스템 시험으로 올라오며 각 단계를 대응시켜 검증하는 개발 방법론이다. 입력과 출력의 책임은 사용자에게 있고, 가드레일과 안전 장치는 배포 전에 직접 구현해야 한다. 세부 사항은 Explainability, Bias, Safety and Security, Privacy 하위 카드(Model Card++)로 넘긴다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| Cosmos-Reason2-2B | N1.7의 VLM backbone. Qwen3-VL 계열 NVIDIA 추론 VLM |
| embodiment ID | embodiment tag를 MLP 슬롯 번호에 대응시킨 정수. state 인코딩과 action 디코딩 MLP를 고른다. embodiment_id.json에 매핑이 있다 |
| GR00T N1.7 EA | 모델 카드가 표기한 버전명. EA는 Early Access, 즉 정식 출시 전 공개 단계 |
| TensorRT Full Pipeline | backbone과 action head를 모두 TensorRT engine으로 바꾼 추론 모드. Orin은 지원하지 않아 DiT-only 모드를 쓴다 |
groot policy type |
LeRobot에서 GR00T N1.7을 선택하는 policy 이름 |
new_embodiment |
pre-training에 없던 로봇(예: SO-101)을 LeRobot에서 fine-tuning할 때 쓰는 embodiment tag |
관련 페이지
- NVIDIA Isaac GR00T (N1.7): 같은 N1.7 모델의 NVIDIA 공식 구현. 설치 제약, embodiment tag 체계, N1.6 대비 변경표를 다룬다.
- LeRobot: State-of-the-art Machine Learning for Real-World Robotics in PyTorch:
grootpolicy type이 속한 프레임워크. 22종 policy가 같은 데이터 형식과 학습 CLI를 공유한다. - GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 모델 카드가 아키텍처 설명을 위임하는 GR00T N1 White Paper. 구조도의 원 출처다.
- GR00T N1.5: LeRobot에서 지원이 제거된 이전 세대 N1.5의 공식 페이지.
- 03-13. Groot N1 - 모두의 로보틱스 - VLA 입문: GR00T N1의 dual-system 구조와 flow matching을 풀어 쓴 한국어 입문 해설.
- Technical Report: One-Step Drifting Action Heads for GR00T N1.7: N1.7 action head를 단발 평가형으로 바꿔 action head 지연 시간을 줄인 후속 연구. 이 페이지의 지연 시간 표에서 action head가 가장 느린 단계라는 점과 연결된다.
- GR00T-WholeBodyControl (GEAR-SONIC / Decoupled WBC / MotionBricks): N1.7과
UNITREE_G1_SONICtag로 맞물리는 whole-body control 저장소. - VLA 발전 과정과 3대 계열 비교: GR00T, π, Gemini Robotics: GR00T 계열을 π, Gemini Robotics와 세대별로 비교하는 overview.