Physical AI · PAPER · 2026
τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation
요약
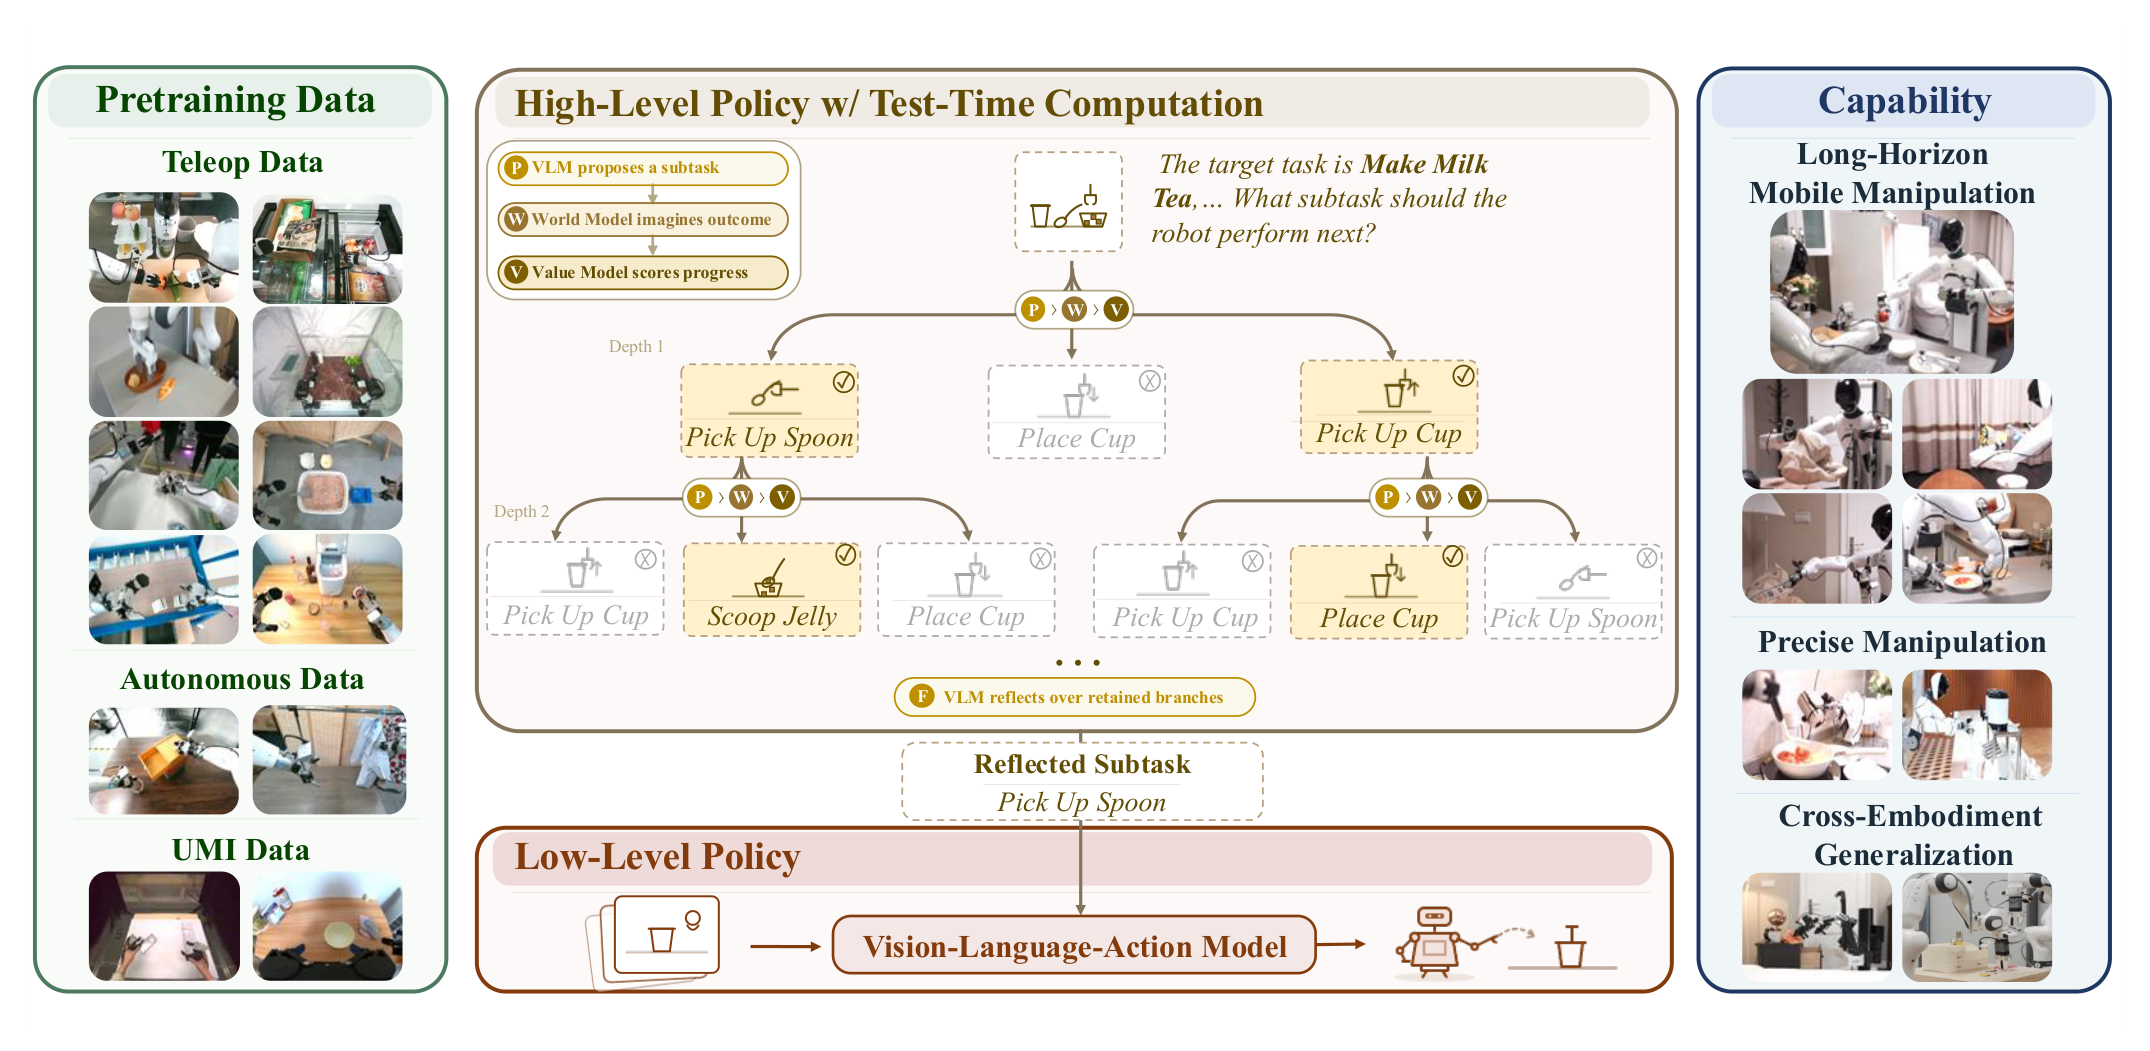
τ0-VLA는 Shanghai Innovation Institute와 Agibot Finch가 2026년에 공개한 hierarchical vision-language-action 모델이다. 계층 구조 자체는 새롭지 않다. 상위가 "숟가락을 집어라" 같은 subtask를 정하고 하위가 그것을 action으로 옮기는 구성은 RT-H 이후 여러 연구가 써 왔다. 이 논문이 바꾼 것은 상위 단계가 그 subtask를 어떻게 정하는가이다.
기존 hierarchical VLA는 상위 결정을 한 번의 forward pass로 끝낸다. 어려운 결정과 쉬운 결정에 같은 연산을 쓰고, 대안을 비교하지도 않는다. τ0-VLA는 이 결정을 언어 모델의 test-time computation처럼 다룬다. 확신이 낮을 때만 후보 subtask 여러 개를 제안하고, world model로 각 후보가 만들 장면을 그려 본 뒤, value model이 그 상상 이미지에 점수를 매겨 beam search로 유망한 분기만 남긴다. 마지막에 reflective model이 남은 분기를 근거로 실제 실행할 subtask를 생성한다.
효과는 두 층위에서 확인된다. 다음 subtask 예측 정확도는 네 평가 환경 모두에서 가장 높았고, 학습에 없던 배열을 다루는 Book Organization(OOD)에서는 50.0%에서 74.0%로 24%p 올랐다. 이 정확도 향상은 실제 로봇 성공률로도 이어져 Book Organization은 6/10에서 9/10이 되었다. 하위 실행 모델은 40,115시간의 이종 실제 로봇 데이터로 학습했고, 40차원 통합 인터페이스를 써서 바퀴형 humanoid, 양팔 고정 플랫폼, 이동형 양팔 로봇을 하나의 모델로 다룬다.
배경
과제가 길어지면 병목이 옮겨간다
밀크티 한 잔을 만드는 일은 13단계, 방을 치우는 일은 25단계다. 성공한 rollout 하나가 8분에서 10분씩 이어진다. rollout은 policy를 실행해 하나의 실행 기록을 만들어내는 과정을 말한다.
과제가 몇 초에서 몇 분으로 길어지면 실패의 원인이 바뀐다. 짧은 과제에서는 물체를 정확히 쥐는 능력이 성패를 갈랐지만, 긴 과제에서는 무엇을 끝냈는지 기억하고 다음에 무엇을 할지 고르는 능력이 더 중요해진다. 논문의 표현으로 long-horizon 과제는 긴 운동 명령의 나열이 아니라 결과가 남는 결정의 나열이다.
이 구분이 중요한 이유는 오류의 성격이 다르기 때문이다. 잘못 고른 subtask는 더 정밀한 제어로 만회되지 않는다. 로봇은 틀린 subtask를 완벽하게 수행할 수 있다. 소금을 이미 넣었는데 다시 넣는 동작은 실행 자체는 흠잡을 데 없어도 과제를 실패로 만든다.
한 번의 forward pass로 끝나는 상위 결정
hierarchical VLA는 언어로 표현한 subtask를 상위 추론과 하위 제어 사이의 인터페이스로 노출한다. 여기까지는 이미 확립된 설계다. 문제는 그 인터페이스를 쓰는 추론 절차 쪽에 있다.
대부분의 시스템은 현재 observation과 실행 이력을 다음 subtask로 곧장 매핑한다. observation은 매 timestep에 policy가 받는 센서 입력을 말한다. 이 방식에서는 모델이 대안 subtask를 서로 비교하지 않고, 각 대안이 만들어 낼 물리적 상태를 추정하지도 않는다. 따라서 잘못된 결정은 실행이 끝난 뒤에야 드러난다. 그 시점에는 환경이 이미 바뀌어 있어 다시 계획을 세울 수는 있어도 실패한 확정의 비용은 되돌릴 수 없다.
저자들의 진단은 여기서 나온다. long-horizon 실행의 병목은 계층적 action 인터페이스가 없어서가 아니라, 다음 subtask를 만들어 내는 추론 절차 자체에 있다.
subtask가 탐색 단위인 이유
연산을 더 쓴다면 어느 수준에서 탐색해야 하는지가 다음 질문이 된다. 논문은 세 후보를 비교한다.
| 탐색 수준 | 장점 | 한계 |
|---|---|---|
| action 수준 | 국소적 제어 모호함을 해소한다 | 드러나는 물리적 결과가 국소적이다 |
| 언어 추론만 | 더 긴 horizon을 다룬다 | 대안이 만들 물리적 상태에 grounding되지 않는다 |
| subtask 수준 | 결정 지점이 드물어 연산을 더 쓸 만하고, 시간적으로 충분히 길어 환경에 구별 가능한 변화를 만든다 | 후보 비교를 위해 각 후보가 만들 상태를 예측해야 한다 |
subtask 수준의 마지막 조건이 world model을 불러들인다. 미래 observation을 생성하는 모델이 있으면 후보 subtask를 실제로 실행하기 전에 그 결과로 평가할 수 있다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. τ0-VLA에는 두 개의 policy가 있고 시간 척도가 다르다. 상위는 subtask 경계에서만, 하위는 매 제어 주기마다 동작한다.
world model은 환경의 동역학을 학습해 미래를 예측하는 모델이다. 여기서는 head 카메라 이미지 한 장과 후보 subtask를 받아 그 subtask가 끝났을 때의 이미지를 그린다.
execution memory는 지금까지 무엇을 끝냈는지를 텍스트로 유지하는 기록이다. 매 결정 단계에서 현재 observation에 맞게 갱신되며, 논문의 핵심 주장 하나는 이 기록이 틀렸을 때 스스로 고칠 수 있어야 한다는 것이다.
test-time computation은 학습이 끝난 모델이 추론 시점에 연산을 더 써서 답의 품질을 올리는 절차를 가리킨다. 언어 모델에서 확립된 개념을 로봇의 subtask 선택에 옮긴 것이 이 논문의 출발점이다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이며, τ0-VLA는 30 timestep을 한 번에 낸다. 이 연속값 묶음은 flow matching으로 생성한다. flow matching은 noise에서 목표 분포로 향하는 속도장을 학습해 샘플을 만드는 생성 기법이다.
방법
두 단계의 역할 분담
지시문(instruction) ℓ이 주어지면 low-level policy는 다중 시점 observation, proprioceptive 상태, 언어 명령을 받아 action chunk를 낸다. proprioception은 관절 각도처럼 로봇이 자기 몸의 상태를 아는 감각 입력이다. 여기에 embodiment와 제어 모드와 whole-body control 사용 여부를 적은 텍스트 메타데이터가 함께 들어간다.
직접 실행 모드와 계층 모드의 차이는 언어 명령 자리에 무엇이 들어가느냐 하나다.
| 모드 | 언어 명령 | policy가 해야 하는 일 |
|---|---|---|
| 직접 실행 | 전체 지시문 ℓ이 에피소드 내내 그대로 | 지금이 과제의 어느 단계인지를 스스로 추론하면서 동시에 action을 만든다 |
| 계층 실행 | 상위가 고른 subtask z*_t | 경계가 정해진 한 단계만 수행한다 |
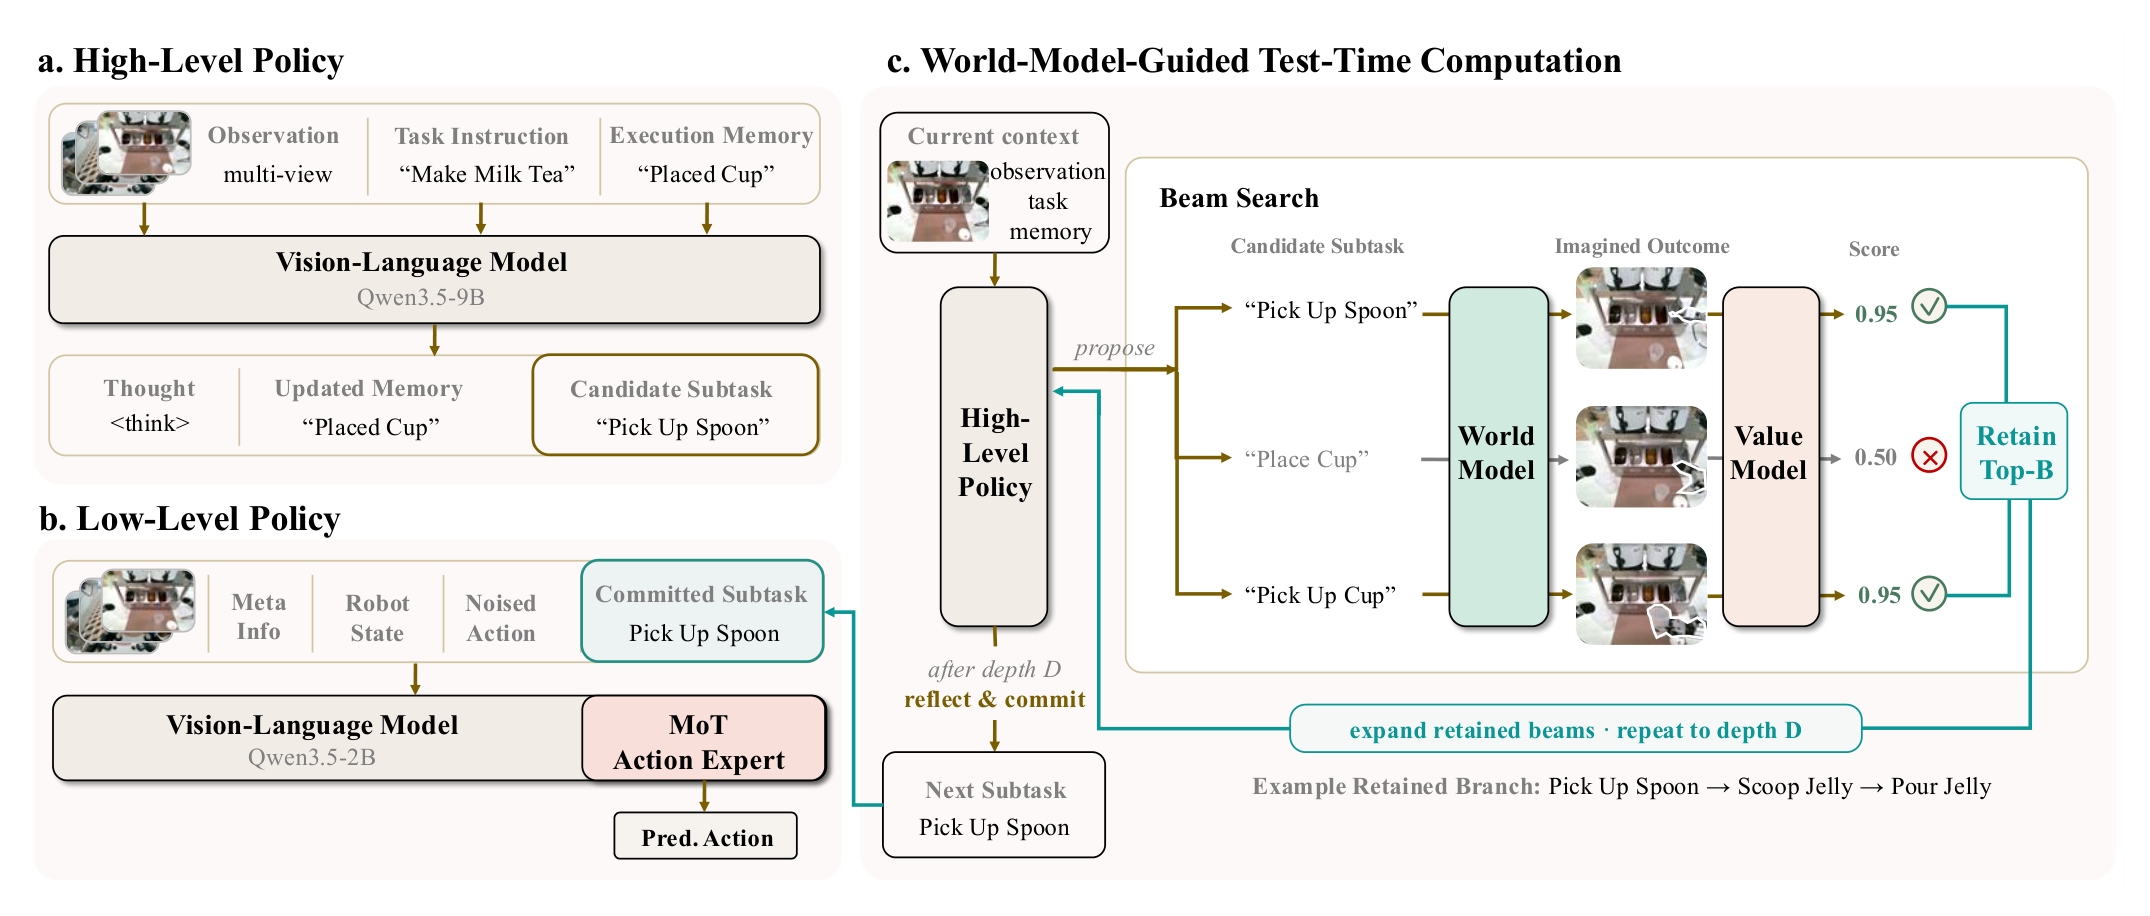
상위의 결정 컨텍스트는 네 조각으로 이뤄진다. 전체 지시문, 이월된 execution memory, 직전 단계에서 생성한 subtask, 그리고 현재 observation이다. 상위는 memory를 현재 observation에 맞게 갱신하면서 이번 subtask를 함께 만든다. 요약하면 상위는 지금 어떤 subtask가 적절한지를 정하고 하위는 그것을 어떻게 실행할지를 정한다.
상위를 이루는 네 모델
high-level policy는 하나의 모델이 아니라 역할이 다른 네 모델의 조합이다.
| 모델 | 입력 | 출력 | 초기화 |
|---|---|---|---|
| proposal model | 결정 컨텍스트 | 갱신된 memory와 직접 제안 subtask | Qwen3.5-9B 기반 로봇 pre-training 체크포인트 |
| world model | head 카메라 이미지와 후보 subtask | 그 subtask 완료 시점의 이미지 예측값 | Step1X-Edit |
| value model | 전체 지시문, 후보 subtask, 예측 이미지 | 후보 품질 점수 | 같은 Qwen3.5-9B 체크포인트 |
| reflective model | observation 정합 컨텍스트와 남은 분기 요약 | 최종 subtask | 같은 Qwen3.5-9B 체크포인트 |
value model은 회귀가 아니라 다지선다 VQA로 학습한다. clearly wrong부터 clearly correct까지 다섯 등급 중 하나를 고르게 하고, 그 등급을 0.05에서 0.95 사이의 스칼라로 옮긴다.
언제 더 생각할지 정하는 규칙
TTC를 항상 켜면 비용이 커진다. 그래서 τ0-VLA는 어려운 결정에만 켠다. 판단 근거를 proposal model이 이미 만들어 낸 토큰 확신 통계에서 가져오므로 추가 모델 호출이 필요 없다는 점이 이 설계의 실용적 이점이다.
- 생성한 토큰 전체의 평균 확률을 하나의 통계로 쓴다.
- memory 필드 안 토큰에서 최대 logit과 두 번째 logit의 차, 곧 logit margin의 평균을 다른 통계로 쓴다.
- 두 통계 중 어느 하나라도 임계값 아래로 내려가면 TTC 경로를 켠다.
통계와 규칙 자체는 과제 공통이고, 두 임계값만 과제마다 held-out 데이터에서 따로 보정한다. TTC를 켜지 않으면 직접 제안이 그대로 하위로 내려간다.
world model이 이끄는 beam search
TTC 경로는 분기 계수 N, beam 폭 B, 깊이 D로 정의되는 beam search다. 절차는 다음과 같다.
- 루트 분기는 현재 결정 컨텍스트를 갖고 빈 경로와 0점에서 시작한다.
- 깊이마다 남아 있는 분기 각각에 대해 proposal model을 N번 독립 호출해 후보 subtask를 뽑는다. 루트 분기만 실제 다중 시점 observation을 보고, 나머지 분기는 그 분기가 상상해 낸 head 카메라 이미지를 본다.
- 후보마다 world model이 완료 시점 이미지를 그리고 value model이 점수를 매긴다. 자식 분기의 누적 점수는 부모 점수에 이번 점수를 더한 값이다.
- 이번 깊이에서 생긴 자식 전체를 누적 점수로 전역 정렬해 상위 B개만 남긴다. 첫 확장은 N개, 이후 확장은 최대 BN개의 자식을 만든다.
- 깊이 D까지 반복하고, 남은 분기의 상상 경로와 종료 예측 이미지와 점수를 묶어 요약한다.
두 가지 격리 규칙이 붙는다. search 안에서 만들어진 memory는 모두 그 분기에만 속하며 영구 execution memory를 덮어쓰지 않는다. search 내부의 proposal 호출이 만들어 낸 routing 결정도 무시한다. 상상 안에서 다시 상상을 켜는 재귀를 막는 장치다.
마지막 단계는 반성이다. reflective model은 상상 분기의 요약과 실제 observation에 맞춘 컨텍스트를 함께 보고 최종 subtask를 생성한다. 이 출력은 남은 후보 중 하나와 같을 수 있지만 후보 집합에 갇히지 않는다. 즉 탐색이 만들어 낸 후보가 모두 부실하면 그 밖의 subtask를 새로 쓸 수 있다. reflective model도 영구 memory를 갱신하지 않는다.
스스로 고치는 execution memory
closed-loop가 신뢰를 유지하려면 memory가 실제 상태와 어긋났을 때 되돌릴 수 있어야 한다. grasping이 빈손으로 끝났는데 memory에 완료로 적히면 이후 결정이 모두 어긋난다.
논문은 이 능력을 별도 데이터 수집 없이 만든다. 기존 시연 데이터(demonstration)에서 memory를 뽑되 입력 쪽만 일부러 어긋나게 변형하고 정답은 원래 시연에서 읽는다. 그렇게 만든 다섯 계열이 배포에서 마주칠 실패 유형에 하나씩 대응한다.
| 계열 | 표본 위치 | 입력에서 정답으로의 memory 변화 | 겨냥한 실패 | 비율 |
|---|---|---|---|---|
| within-subtask | 구간 n 아무 곳 | 변화 없음 | 정상 진행 | 58% |
| transition | 구간 n의 끝 | 구간 n에서 n+1로 | 완료 후 새 subtask 시작 | 15% |
| catch-up | 구간 n의 시작 | 구간 n-1에서 n으로 | memory가 시각 상태보다 뒤처짐 | 10% |
| rollback | 구간 n의 후반 | 구간 n+1에서 n+3 사이에서 n으로 | memory가 앞서감 | 12% |
| error-think | 주석된 실패 프레임 | 실패 유형에 따라 다름 | 인지되지 않은 실행 실패 | 5% |
error-think 계열은 think 필드가 먼저 실패를 표시한 뒤 유형별로 처리를 나눈다. 빈 grasping처럼 회복 가능한 실패는 memory를 그대로 두고 재시도하고, 물체를 떨어뜨린 것처럼 진행이 되돌아간 실패는 직전 subtask로 rollback한다. rollback 인스턴스에 10~15%의 상한을 둔 이유는 비율이 높으면 모델이 올바른 memory까지 의심하도록 학습되기 때문이다.
하위 실행 모델과 40차원 통합 인터페이스
low-level policy는 vision-language backbone과 Mixture-of-Transformers action expert를 결합한다. full-attention 계층마다 action 토큰과 backbone 토큰이 joint attention으로 상호작용하되, 파라미터가 분리된 두 Transformer 스트림이 각자 처리한다. action expert는 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음이다.
서로 다른 로봇을 하나의 모델로 다루기 위해 상태와 action을 모두 40차원의 같은 자리에 매핑한다.
| 좌표 | 차원 | 내용 |
|---|---|---|
| 왼쪽 EEF 위치 | 1-3 | 미터 단위 직교 좌표 |
| 왼쪽 EEF 자세 | 4-9 | 회전 행렬의 Rot6D 표현 |
| 오른쪽 EEF 위치 | 10-12 | 미터 단위 직교 좌표 |
| 오른쪽 EEF 자세 | 13-18 | 회전 행렬의 Rot6D 표현 |
| 왼쪽 그리퍼 | 19 | 로봇 고유의 개폐 좌표 |
| 오른쪽 그리퍼 | 20 | 로봇 고유의 개폐 좌표 |
| 허리 | 21-22 | 고유 좌표 2개 |
| 평면 베이스 속도 | 23-24 | 고유 좌표 2개 |
| 왼쪽 팔 관절 | 25-32 | 라디안 단위 8개 |
| 오른쪽 팔 관절 | 33-40 | 라디안 단위 8개 |
action은 절대 목표가 아니라 현재 상태로부터의 변화량으로 적는다. end-effector action은 현재 자세로부터의 위치와 회전 델타이고, 위치 델타는 현재 end-effector 좌표계에서 표현한다. 관절 action은 현재 관절 구성으로부터의 각도 오프셋이다.
embodiment마다 쓰는 차원이 다르므로 대각 마스크 행렬을 flow 경로와 학습 목적함수 양쪽에 적용한다. 비활성 채널은 속도장을 평가하기 직전과 최종 출력 시점에 투영으로 제거하고, 팔 관절이 8개 미만인 로봇은 앞쪽 항목부터 채운 뒤 나머지를 마스킹한다. 이 구성 덕분에 embodiment별 출력 헤드를 따로 두지 않고도 고정형 manipulation과 양팔 협응과 이동형 whole-body control을 한 모델이 지원한다.
생성 설정은 action horizon 30, 균일 Euler 적분 10회다. flow 시각은 chunk 전체가 공유하며 Beta(1.5, 1) 분포에서 뽑아 0.001에서 1 사이로 옮긴다. 정규화된 표본별 손실은 100에서 상한을 두고 배치 평균한다.
학습 데이터와 3단계 학습
하위 학습 코퍼스는 40,115시간이다. 내부 수집이 약 2만 3,400시간, 공개 데이터가 1만 6,700시간을 차지한다.
| 원천 | 시간 |
|---|---|
| 내부 AGIBOT G1 | 2만 1,900시간 |
| 내부 AGIBOT G2 | 585시간 |
| 내부 ARX AC One | 578시간 |
| 내부 Franka | 347시간 |
| 공개 UMI 데이터 | 9,250시간 |
| 그 밖의 공개 데이터 | 약 7,450시간 |
여기에 지시문 따르기, 시각 grounding, 공간과 깊이 추론, 로봇 중심 인식용 멀티모달 데이터를 섞는 co-training을 적용한다. co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식으로, backbone이 가진 시각과 언어 능력이 action 학습 도중 훼손되는 것을 막는 장치다.
학습은 세 단계로 진행된다.
| 단계 | 이름 | 하는 일 |
|---|---|---|
| 1 | knowledge-isolated co-training | 멀티모달 데이터와 로봇 action 데이터를 함께 쓰되 action 손실의 그래디언트를 backbone 경계에서 차단한다. action expert가 제어에 필요한 표현을 익히는 동안 pre-training된 backbone을 이르게 흔들지 않는다 |
| 2 | end-to-end co-training | 차단을 풀고 전체를 함께 최적화한다. action 그래디언트가 backbone을 제어에 맞게 적응시키고 멀티모달 데이터는 보조 감독으로 남는다 |
| 3 | task-specific adaptation | 배포 과제마다 소량의 과제별 시연 데이터로 fine-tuning해 대상 embodiment, 카메라 시점, 물체 배치, 성공 기준에 맞춘다 |
상위 감독 데이터는 사람이 추가로 라벨링하지 않고 자동 생성한다. 과제와 단계와 실행 가능 subtask 주석을 각각 L1, L2, L3라 부르고, 여기에 분할된 다중 시점 시연 데이터를 결합한다. 파이프라인은 세 단계다. google/Gemma4-31B-it를 주석기로 써서 장면 상태와 진행과 제약과 실패를 요약한 think 필드, 완료 단계를 압축하고 활성 subtask만 상세히 남기는 memory 필드를 만든다. 그다음 subtask의 시간 구간을 따라 top_head, hand_left, hand_right 세 동기 시점을 ffmpeg로 뽑는다. 마지막으로 이들을 합쳐 구조화된 VQA 예제를 조립한다.
자동 주석의 품질 관리
주석기가 LLM이므로 환각이 문제가 된다. 실제로 발견된 가장 큰 실패 유형은 교차 과제 오염이었다. 과일 정리 과제 주석에 밀크티 과제의 제약이 등장하는 식이다.
대응은 두 단계로 이뤄졌다. 프롬프트 개발 중에는 고정 시드 계층 표본을 사람이 점검해 실패 유형을 찾았고, 모든 시각 프롬프트에 이미지에서 확인되지 않는 속성은 적지 말라는 검증 규칙을 심었다. 발견된 실패 유형은 각각 프로그램 필터로 굳혀 전량에 적용했다.
오염 필터의 조정 과정은 임계값 선택의 어려움을 보여준다.
| 기준 | 폐기율 | 결과 |
|---|---|---|
| 단순 배타 판정 | 0.33% | 잔존 오염이 남았다 |
| 과도한 비율 임계값 | 2.32% | 유효하지만 서술이 긴 제약을 다수 삭제했다 |
| 확장 불용어 목록을 갖춘 두 규칙 필터 | 0.42% | 326만 표본 검증셋에서 잔존 오염 0 |
구조적 오염 데이터 필터는 과제별 오염 비율에 따라 3단계로 나눈다. 90%를 넘는 과제는 통째로 제외하고, 10~90%는 에피소드 단위로 거르며, 10% 미만은 빈 subtask 표본만 제거한다. 이 과정에서 에피소드의 11.74%를 버리고 4,040만 개(88.26%)의 정상 표본을 남겼다.
배포 시 파이프라인
논리적으로 상위와 하위는 순차 실행이지만 실제 배포에서는 비동기로 파이프라인한다. 상위 결정 한 번이 하위 제어 주기보다 훨씬 느리기 때문이다.
백그라운드 워커가 활성 에피소드마다 다음 subtask를 계속 다시 계산해 에피소드별 캐시에 약 1초마다 게시하고, 제어 루프는 그 캐시만 읽는다. 매 tick마다 캐시에 있는 subtask를 언어 명령으로 삼아 즉시 action chunk를 낸다. 따라서 상위 결정이 느리거나 실패해도 명령 갱신이 늦어질 뿐이고 하위는 약 30Hz의 control frequency로 계속 실행한다. control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다.
결과
평가 설정
로봇 플랫폼은 세 종류이며 모두 다중 시점 RGB와 proprioceptive 상태를 제공하고 고유 제어 명령을 40차원 배치에 매핑한다.
| 플랫폼 | 구성 | 담당 과제 |
|---|---|---|
| AGIBOT G1 | 전방향 4륜 조향 베이스를 가진 바퀴형 humanoid, 7-DoF 양팔, 평행 그리퍼, head RGB-D와 어안 카메라, 손목 카메라 | long-horizon 네 과제 |
| ARX AC One | 6-DoF X5 양팔, 평행 그리퍼, 손목 카메라와 고정 중앙 카메라 | Book Organization, Collect Laundry |
| Franka Research 3 | 7-DoF 토크 제어 양팔, 3D 프린팅 그리퍼, RGB 카메라 3대 | Tidy Makeup Table |
과제 구성은 다음과 같다.
| 과제 | 단계 수 | 성공 rollout 소요 | 최대 허용 시간 |
|---|---|---|---|
| Clean Room | 25 | 약 8분 | 20분 |
| Prepare Ingredients | 14 | 약 4분 | 20분 |
| Tomato and Egg Stir Fry | 22 | 약 10분 | 20분 |
| Make Milk Tea | 13 | 약 3분 | 10분 |
| Collect Laundry | 5 | 약 1분 | 5분 |
| Book Organization | 3 | 약 1분 | 5분 |
| Tidy Makeup Table 세 그룹 | 2, 2, 4 | 합계 약 30초 | 그룹당 5분 |
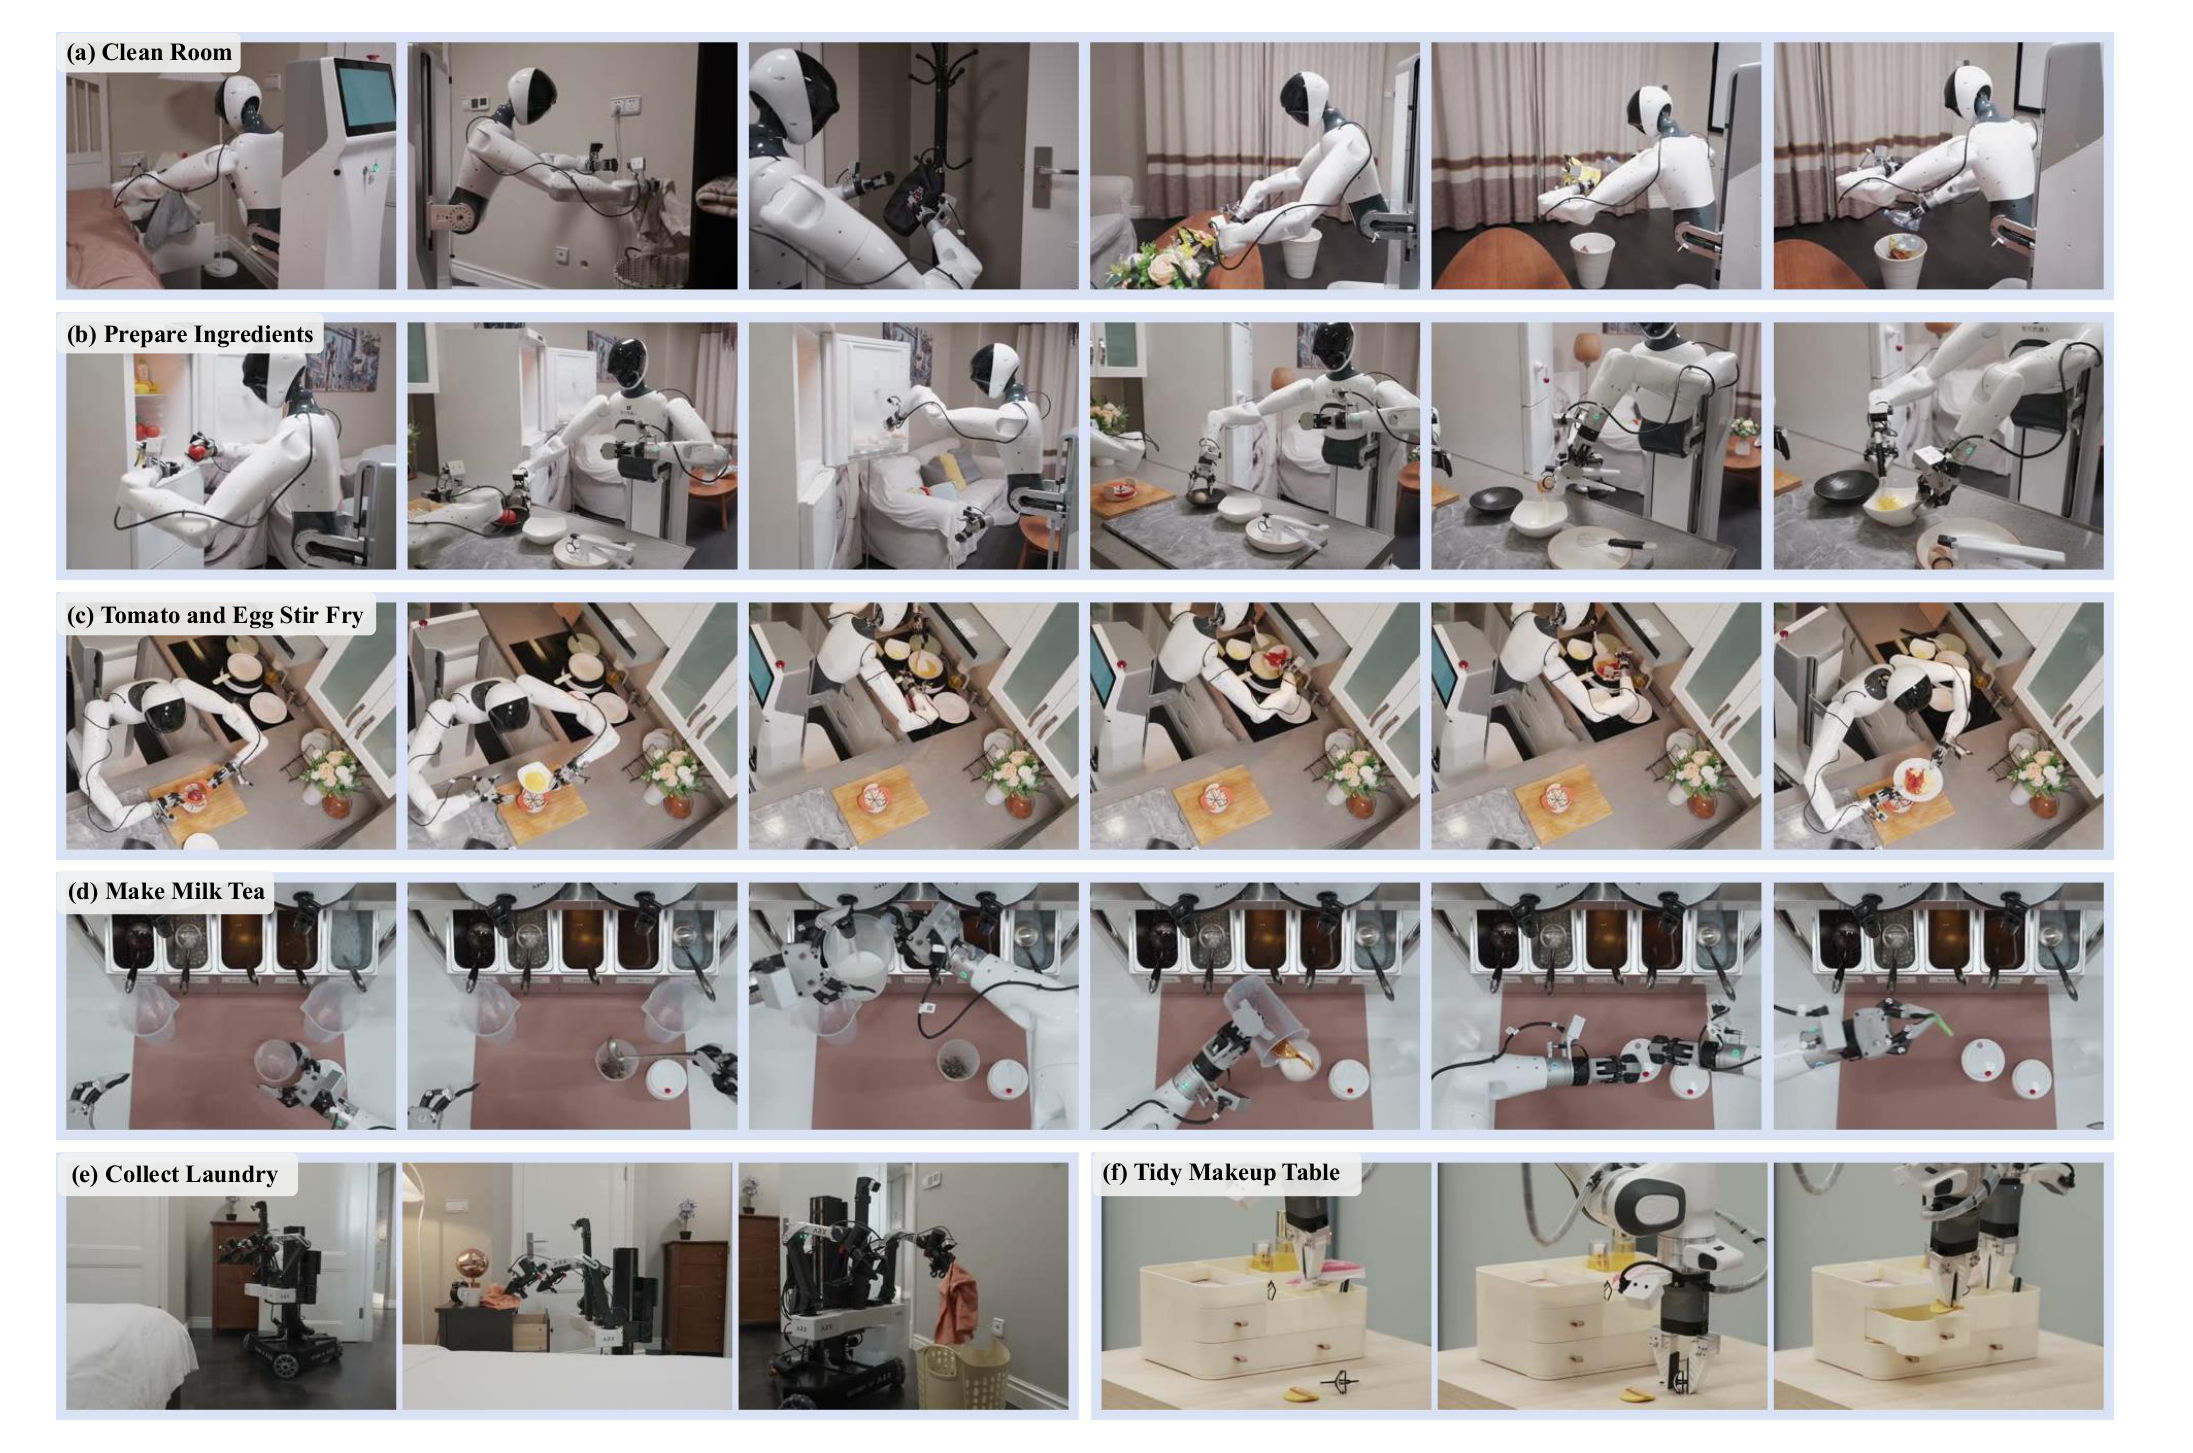
지표는 두 가지다. 성공률(SR)은 필수 milestone을 하나도 빠뜨리지 않고 종료 조건까지 만족한 시행의 비율이다. 자율 재시도 끝에 완료한 필수 subtask는 성공으로 인정하되 과제별 금지 행위가 발생하면 실패다. Progress는 milestone 완료도를 정규화한 점수인데, 선행 관계를 방향 비순환 그래프로 두고 선행 milestone이 모두 충족된 뒤에만 점수를 준다. 개별 점수는 첫 시도 완료 1점, 자율 재시도 후 완료나 과제별 부분 완료 0.5점, 그 외 0점이다.
상위 결정만 따로 재는 open-loop 평가는 subtask 경계에서 수집한 주석 표본으로 실행과 분리해 측정한다. 같은 subtask를 다른 문장으로 표현할 수 있어 문자열 일치로는 성능이 과소평가되므로 GPT-5.4를 의미 판정자로 쓴다. 판정 라벨은 equivalent, adjacent, wrong 세 가지이고 equivalent만 성공으로 센다. 표본마다 온도 0 호출을 두 번 받고 불일치하면 세 번째를, 세 라벨이 모두 다르면 네 번째를 받아 다수결한다.
long-horizon 네 과제
각 조합마다 실제 로봇 10회 시행이다. 마지막 행만 계층 구조이고 beam search는 켜지 않은 Plan Once 설정이다.
| 방법 | Clean Room SR | Progress | Prepare Ingredients SR | Progress | Stir Fry SR | Progress | Milk Tea SR | Progress | 평균 SR | 평균 Progress |
|---|---|---|---|---|---|---|---|---|---|---|
| GR00T N1.7 | 0/10 | 59.80% | 1/10 | 68.57% | 0/10 | 24.32% | 0/10 | 28.46% | 2.50% | 45.29% |
| LingBot-VLA | 0/10 | 66.60% | 0/10 | 35.00% | 0/10 | 12.27% | 0/10 | 63.85% | 0.00% | 44.43% |
| π0.5 | 4/10 | 86.20% | 2/10 | 73.93% | 0/10 | 49.77% | 3/10 | 82.31% | 22.50% | 73.05% |
| τ0-VLA (직접 실행) | 4/10 | 92.80% | 2/10 | 66.43% | 0/10 | 65.00% | 5/10 | 96.15% | 27.50% | 80.10% |
| τ0-VLA (계층 구조, Plan Once) | 5/10 | 94.80% | 4/10 | 82.86% | 4/10 | 81.82% | 5/10 | 91.92% | 45.00% | 87.85% |
같은 하위 모델을 쓰고 계층 구조만 얹었을 때 평균 SR이 27.50%에서 45.00%로 17.5%p 올랐다. 이 실험이 통제하는 것은 실행 능력이다. 두 설정의 low-level policy가 동일하므로 향상분은 무엇을 실행할지 정하는 방식에서 온다.
과제별 실패 양상은 계층 구조가 어디에 기여하는지를 보여준다.
- Clean Room: 명시적 memory의 효과가 뚜렷하다. 계층 구조는 방을 옮겨도 진행 상황을 유지하지만, memory가 없으면 핸드백 걸기와 이후 정리 단계에 실패가 몰린다.
- Prepare Ingredients: 실패 대부분이 달걀 집기, 깨기, 젓기에서 발생한다. 이 동작들이 이후 단계의 전제라 초기 오류 하나가 뒤쪽 진행을 통째로 막는다.
- Tomato and Egg Stir Fry: 병목은 간 맞추기다. 소금은 넣어도 눈에 띄는 변화가 거의 없어 현재 observation만으로는 완료 여부를 알 수 없다. 직접 실행 모델은 소금을 반복해 투입하거나 아예 건너뛰는데 둘 다 성공 기준을 위반한다. 규정상 반복 투입은 자율 재시도가 아니라 금지 행위여서 SR을 무효로 만들고 해당 subtask에 0.5점만 준다. 계층 구조는 간 맞추기 진행을 기록해 이 모호함을 해소하며, 0/10에서 4/10으로 가장 큰 폭으로 개선된 과제다.
- Make Milk Tea: 두 τ0-VLA 변형 모두 이미 SR 5/10과 91% 이상의 Progress를 낸다. 남은 실패는 뚜껑 부착과 빨대 삽입에 몰려 있어, 남은 병목이 상위 결정이 아니라 접촉이 많은 마지막 manipulation임을 보여준다.
embodiment 간 직접 실행
Collect Laundry와 Tidy Makeup Table은 단계가 2~5개로 짧아 과제 분해나 memory나 탐색 없이 전체 지시문을 그대로 실행한다. 하위 제어와 언어 grounding만 따로 재는 설정이다.
| 방법 | Collect Laundry SR | Progress | Cotton Pad SR | Progress | Eyelash Curler SR | Progress | Makeup Puff SR | Progress |
|---|---|---|---|---|---|---|---|---|
| GR00T N1.7 | 4/10 | 76.00% | 10/10 | 87.50% | 8/10 | 77.50% | 7/10 | 52.50% |
| LingBot-VLA | 2/10 | 35.00% | 9/10 | 67.50% | 3/10 | 22.50% | 3/10 | 33.75% |
| π0.5 | 9/10 | 88.00% | 9/10 | 85.00% | 8/10 | 85.00% | 7/10 | 73.75% |
| τ0-VLA | 10/10 | 97.00% | 10/10 | 95.00% | 9/10 | 92.50% | 10/10 | 95.00% |
Tidy Makeup Table은 시각 상태를 맞춰 놓고 지시문만 바꾸는 벤치마크다. 지시문이 대상 물체, 사용할 팔, 동작 순서, 목적지를 바꾸므로 observation만으로는 정답 동작이 정해지지 않는다. 저자들은 관찰된 실패를 두 종류로 구분한다. 대상을 잘못 고르거나 빠뜨리는 것은 언어 grounding 오류로 과제 완료 자체를 바꾸고, 놓았다 다시 잡거나 서랍을 머뭇거리며 닫는 것은 최종 상태에 도달해도 효율만 떨어뜨린다.
test-time computation의 효과
비교 대상 세 가지의 차이는 결정 시점에 무엇을 하느냐에 있다.
| 방법 | 후보 수 | 결과 예측 | 다단계 확장 | 반성 |
|---|---|---|---|---|
| Plan Once | 1 | 없음 | 없음 | 없음 |
| Best-of-N | N | 있음 (같은 world model) | 없음 (한 단계 선택) | 없음 |
| TTC | N씩 깊이 D까지 | 있음 | 있음 | 있음 |
Plan Once는 상위를 건너뛰는 직접 실행과 다르다. 상위 policy를 쓰되 탐색만 하지 않는 설정이다.
open-loop 다음 subtask 예측 정확도는 다음과 같다.
| 평가 환경 | Plan Once | Best-of-N | TTC | TTC 개선 폭 |
|---|---|---|---|---|
| Make Milk Tea | 64.7% | 70.0% | 87.3% | 22.6%p |
| Book Organization (in-domain) | 66.0% | 83.0% | 88.0% | 22.0%p |
| Book Organization (OOD) | 50.0% | 57.5% | 74.0% | 24.0%p |
| Clean Room | 72.0% | 74.0% | 87.0% | 15.0%p |
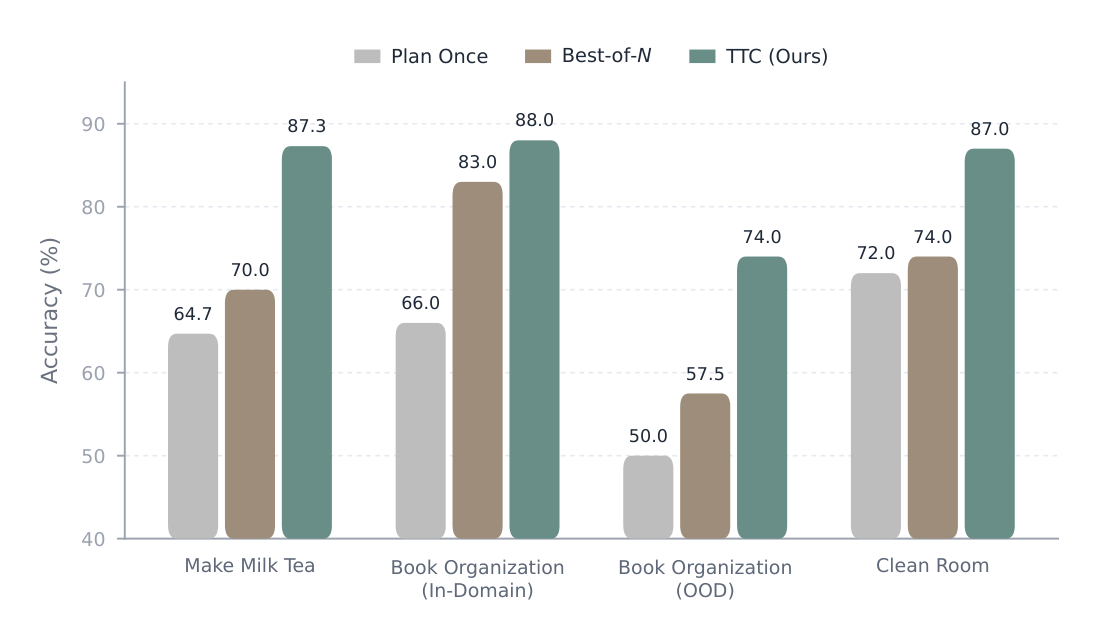
가장 눈여겨볼 곳은 Book Organization(OOD)이다. 이 설정에서 초기 책 배열은 학습 데이터에 없으므로 해당 observation이 상위 policy의 학습 분포 밖에 놓인다. 분포가 어긋나면 fine-tuning으로 익힌 패턴에 기대는 직접 예측은 오류가 늘어난다. TTC는 이 상황에서 학습된 패턴 대신 결정 시점의 증거를 쓴다. 후보 분기를 재귀적으로 확장하면서 world model이 미래 observation을 예측하고 value model이 상상된 분기를 채점하며, reflective model이 남은 분기를 컨텍스트로 삼아 현재 subtask를 만든다.
Best-of-N도 같은 world model과 value model을 쓰지만 이득이 일관되게 작다. 다단계 확장 없이 한 단계 선택만 하고 반성 단계가 없기 때문이다. 즉 결과 예측을 쓴다는 사실만으로는 부족하고 그것을 여러 단계에 걸쳐 쓰는 절차가 성능을 만든다.
closed-loop 실제 로봇 평가는 하위 모델을 고정한 채 TTC만 켜고 껐다. Book Organization은 섞인 초기 배열을 쓰며 in-domain과 OOD를 나누지 않고 보고한다.
| 방법 | Make Milk Tea SR | Progress | Book Organization SR | Progress | Clean Room SR | Progress |
|---|---|---|---|---|---|---|
| Plan Once | 5/10 | 91.92% | 6/10 | 66.67% | 5/10 | 94.80% |
| TTC | 7/10 | 95.38% | 9/10 | 93.33% | 7/10 | 97.60% |
세 과제 모두 SR과 Progress가 함께 올랐고, 폭이 가장 큰 곳은 Book Organization이다. 이 과제는 초기 배열이 매번 달라 고정된 실행 계획을 쓸 수 없으므로 결정 품질이 성패를 직접 좌우한다.
연산량과 정확도의 관계
마지막 실험은 추가 연산이 얼마나 오래 값을 하는지를 잰다. 각 점은 서로 다른 연산 예산에서 얻은 실험 결과이고, 주황 점선은 포화 지수 함수를 최소제곱으로 적합한 곡선이다.
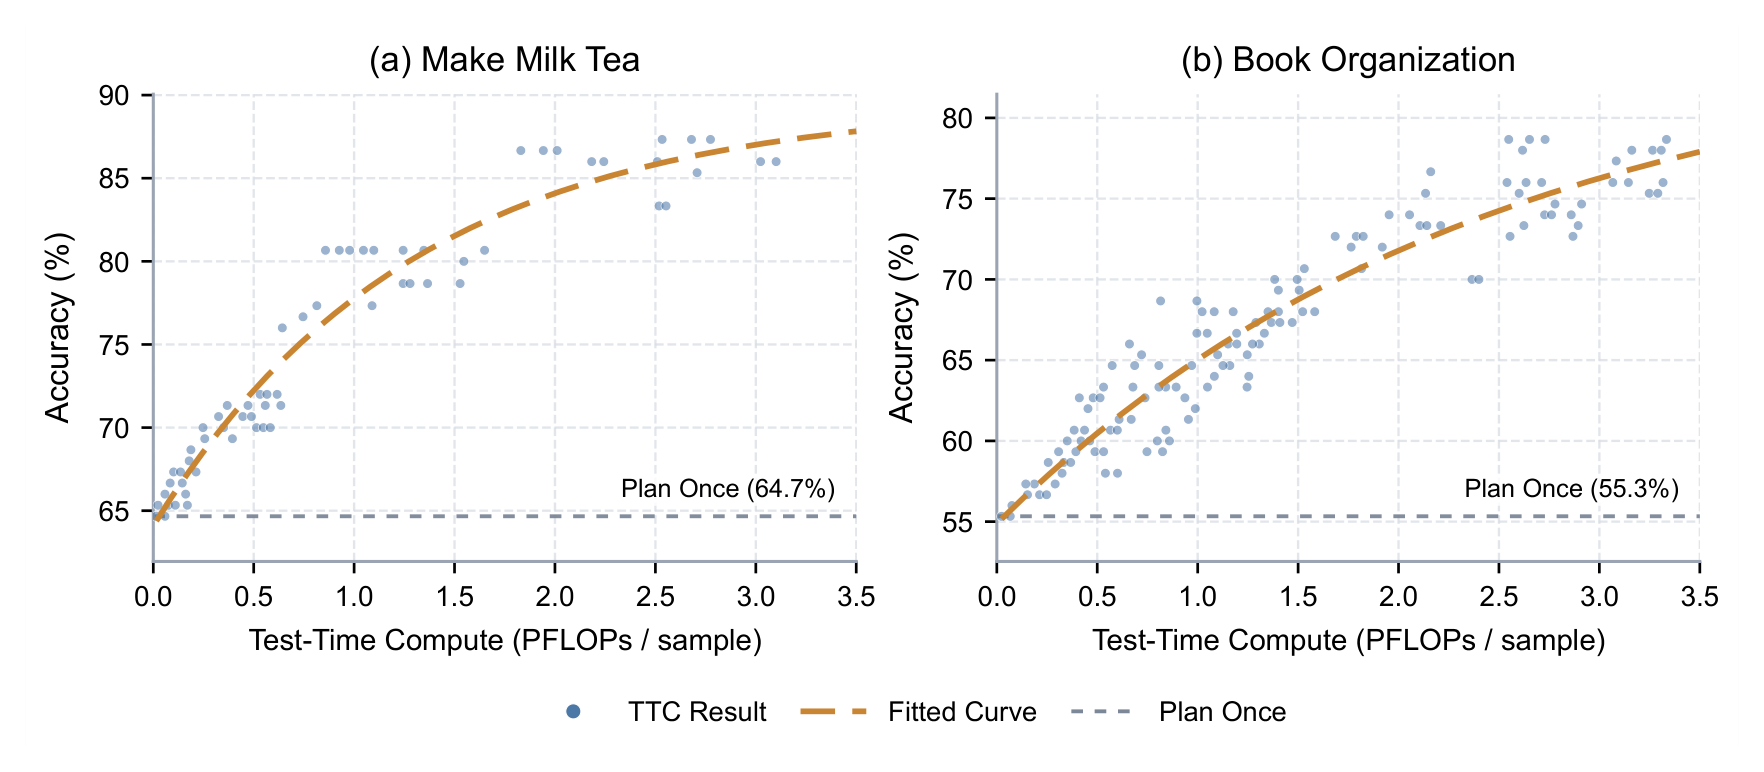
정확도는 작은 예산에서 빠르게 오르다가 한계 이득이 점차 줄어 곡선이 평탄해진다. 대략 3.5 PFLOPs/표본 구간에서 Make Milk Tea는 90% 부근, Book Organization은 80% 부근에 접근하며 각각의 Plan Once 기준선은 64.7%와 55.3%다. 저자들은 이를 중간 예산에서 연산 대비 정확도 균형이 유리하되 그 이득이 결국 포화한다는 뜻으로 읽는다. 확신 기반 라우팅이 필요한 이유도 여기 있다. 모든 결정에 최대 예산을 쓰는 것은 낭비다.
한계
논문에 별도 한계 절은 없다. 아래는 결론과 실험 서술에 흩어진 제약을 모은 것이다.
- 연산 대비 이득의 포화: Figure 5가 보여주듯 향상은 낮은 연산 구간에 집중되고 이후 평탄해진다. 예산을 계속 늘려도 얻는 것이 줄어든다.
- 접촉이 많은 마지막 단계: Make Milk Tea에서 두 변형 모두 91% 이상의 Progress를 내고도 뚜껑 부착과 빨대 삽입에서 실패한다. 남은 병목은 상위 결정이 아니라 하위 정밀도다.
- routing 임계값의 과제별 보정: 통계와 규칙은 과제 공통이지만 두 임계값은 과제마다 held-out 데이터로 따로 맞춘다. 새 과제로 옮길 때 보정 절차가 필요하다.
- 배포마다 별도 fine-tuning: 3단계 학습의 마지막이 과제별 적응이라 공유 pre-training foundation 위에 배포 설정마다 별도 fine-tuning을 추가한다.
- world model의 입력 제약: world model은 항상 head 카메라 이미지 한 장만 다룬다. 손목 시점이나 다중 시점 정보는 결과 예측에 쓰이지 않는다.
- 평가 규모: 조합마다 10회 시행이라 SR 한 칸의 차이가 10%p다. 표본이 적어 근소한 차이는 해석에 주의가 필요하다.
- Tomato and Egg Stir Fry의 낮은 절대 성능: 계층 구조로 0/10에서 4/10까지 올랐지만 여전히 절반 미만이다.
결론이 제시하는 방향은 이 closed-loop를 더 다양한 과제와 더 긴 배포로 확장하는 것이다. 로봇이 언제 숙고할지, 결과를 어떻게 검증할지, 작은 오류가 과제 수준 실패로 번지기 전에 계획을 언제 고칠지를 스스로 정하게 만드는 것이 목표다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| test-time computation (TTC) | 추론 시점에 연산을 더 써서 결정 품질을 올리는 절차. 여기서는 후보 subtask 제안, 결과 이미지 예측, 점수화, 반성으로 이뤄진 beam search를 가리킨다 |
| execution memory | 지금까지 무엇을 끝냈는지를 텍스트로 유지하는 기록. 매 결정 단계에서 현재 observation에 맞게 갱신된다 |
| reflective model | beam search가 남긴 분기 요약과 실제 observation 컨텍스트를 함께 보고 최종 subtask를 생성하는 모델. 후보 집합에 갇히지 않는다 |
| Plan Once | 결정 지점마다 한 번만 예측하는 상위 기준선. 상위를 아예 건너뛰는 직접 실행과 다르다 |
| Best-of-N | N개 후보를 뽑아 같은 world model과 value model로 채점한 뒤 최고점 하나를 고르는 한 단계 선택 기준선 |
| Progress | milestone 완료도를 정규화한 점수. 선행 관계 그래프를 만족한 milestone만 점수를 받고 첫 시도 완료 1점, 재시도 완료 0.5점을 준다 |
| knowledge isolation | action 손실의 그래디언트를 backbone 경계에서 차단해 pre-training된 backbone을 이르게 흔들지 않는 학습 단계 |
관련 페이지
- τ0-VLA: a Hierarchical Robot Foundation Model with World-Model-Guided Test-Time Computation: 같은 연구의 프로젝트 페이지. rollout 영상과 고해상도 구조도가 있고, 논문에 없는 execution memory 단독 개선 폭 11.0%p를 밝힌다.
- τ0-VLA (sii-research/tau-0-vla, GitHub repo): 공식 코드 저장소. low-level policy와 proposal model, world model을 공개하고 LIBERO 재현 레시피를 싣는다. value model과 reflective model은 미공개다.
- π0.5: a Vision-Language-Action Model with Open-World Generalization: long-horizon 표와 embodiment 표 양쪽에서 가장 강한 기준선인 π0.5의 원 논문. 계층 구조를 하나의 모델 안에 담는 대안적 설계를 보여준다.
- GR00T N1.5: 비교 기준선 GR00T 계열. τ0-VLA 실험에서는 후속 판인 GR00T N1.7이 쓰였다.
- World Model for Robot Learning: A Comprehensive Survey: world model을 로봇 학습에 쓰는 방식의 정리. τ0-VLA가 예측을 결정 이전으로 옮긴 선택의 좌표를 잡아 준다.
- A Comprehensive Survey on World Models for Embodied AI: world model 전반의 survey. 결과 예측 모델의 계보를 확인할 때 참고한다.
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System: 같은 해에 나온 또 다른 계층형 manipulation 시스템. subtask 문장에 bounding box를 더해 계획과 제어를 나눈다.
- Awesome-Dual-System-VLA: dual-system VLA 문헌 목록. 상위와 하위를 나누는 다른 구성들과 견줄 때 쓴다.
- Physical AI 카테고리 지도와 학습 경로: physical-ai 도메인 전체 지도.