Physical AI · PAPER · 2025
π0.5: a Vision-Language-Action Model with Open-World Generalization
요약
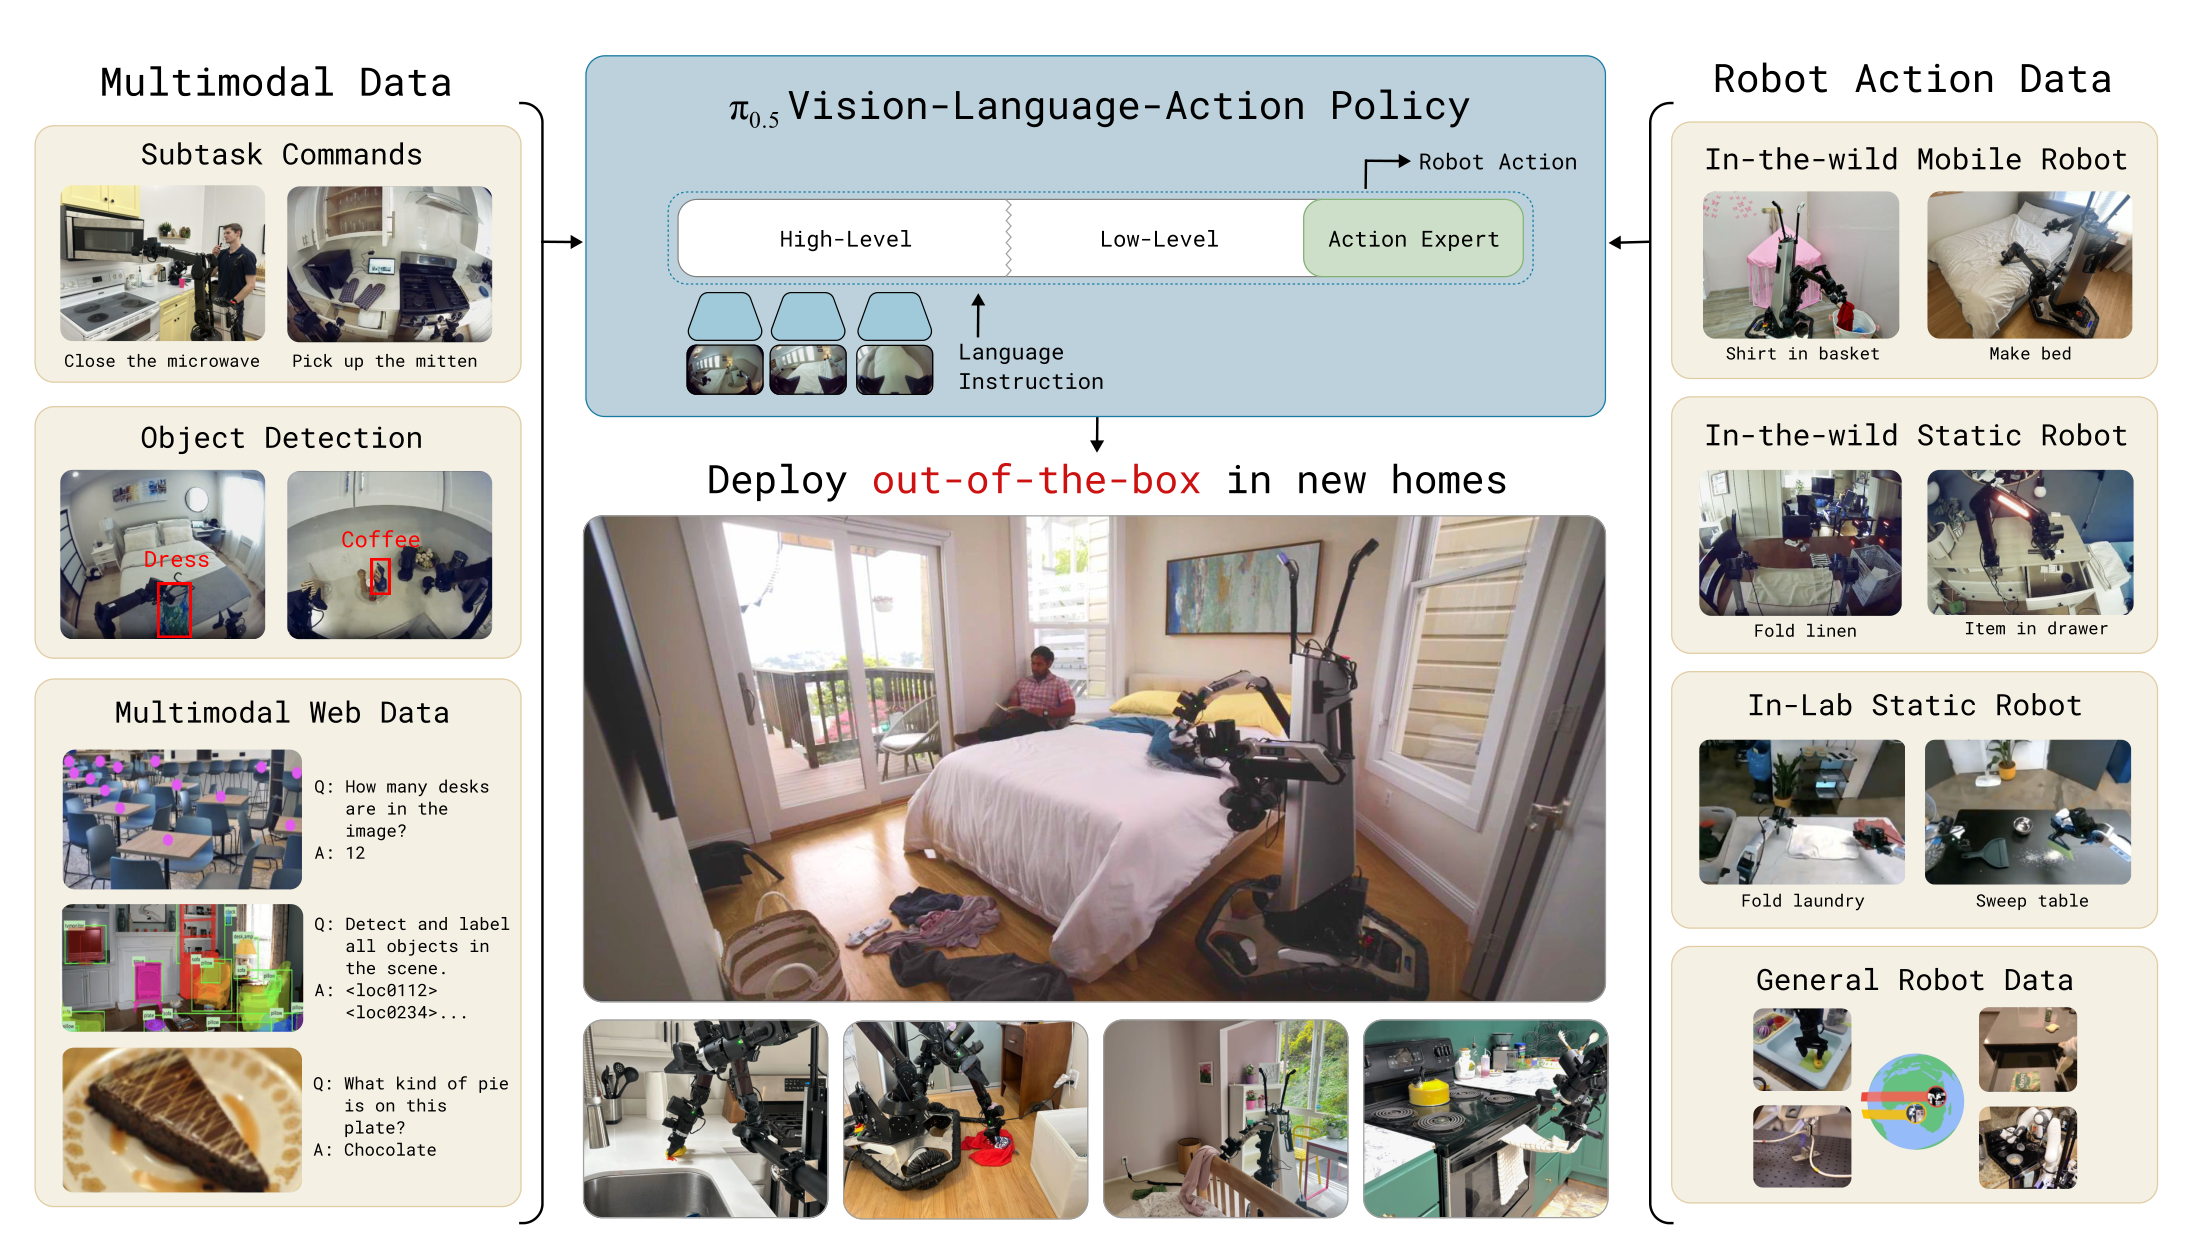
π0.5는 Physical Intelligence가 2025년 4월에 공개한 vision-language-action 모델로, π0의 후속이면서 모델 규모가 아니라 학습 데이터의 구성을 바꾼 버전이다. 로봇 action 데이터만 쓰지 않고 성격이 다른 여러 원천을 하나의 학습 mixture에 함께 넣는 co-training을 레시피의 중심에 둔다.
논문이 겨냥한 목표는 open-world generalization이다. VLA가 학습에서 본 적 없는 공간과 물체 앞에서도 과제를 끝내는 능력을 가리키는데, 그때까지 VLA 평가는 대부분 학습 데이터와 닮은 환경에서 이뤄졌다. 반면 π0.5는 학습에 한 번도 등장하지 않은 실제 가정집 세 곳에서 부엌과 침실을 치우게 했고, 한 과제가 10~15분씩 이어졌다.
이 논문의 성격은 데이터 비율 하나로 드러난다. 평가 대상인 mobile manipulator의 가정 데이터는 약 400시간으로 첫 학습 단계 전체의 2.4%에 지나지 않는다. 즉 나머지 97.6%는 다른 로봇이나 웹에서 온 데이터인데도 모델은 처음 보는 집에서 동작한다.
배경
로봇을 실험실 밖에서 쓰려면 데이터 규모만으로는 부족하다는 것이 저자들의 출발점이다. 처음 보는 부엌을 치우라는 지시 하나에도 서로 다른 수준의 일반화가 동시에 필요하기 때문이다.
- 데이터에 장면과 물체가 충분히 담겨 있으면 그대로 옮겨 가는 행동. 칼이나 접시를 집는 동작이 여기 속한다.
- 이미 가진 skill을 새로운 방식이나 새로운 순서로 바꿔 써야 하는 행동.
- 사전 지식으로 장면의 의미를 읽어야 하는 행동. 어느 서랍을 열지, 조리대 위 어느 물체가 건조대인지 판단하는 경우다.
설계 방향은 사람의 학습 방식에서 왔다. 사람의 경험은 직접 해 본 것만으로 이뤄지지 않고 남에게 들은 사실, 책에서 읽은 지식, 다른 맥락에서 얻은 통찰이 함께 쓰인다. 따라서 로봇 학습 시스템도 여러 종류의 정보 원천에서 지식을 옮겨 올 수 있어야 한다는 것이 논문의 가설이다.
선행 연구의 한계는 두 방향으로 갈린다. 물체 집기 같은 단순한 primitive에 grasp 예측이나 모델 기반 계획 같은 과제별 가정을 넣어 새 집까지 일반화한 사례는 generalist 로봇의 과제 전반으로 확장되지 않고, 대규모 데이터셋으로 end-to-end 일반화를 보인 연구들은 과제가 대체로 1분 미만으로 단순하고 성공률도 낮다. VLA 구조는 서로 다른 modality를 같은 시퀀스 모델링 문제로 옮기므로 이 간극을 메울 도구가 된다.
핵심 개념
policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. observation은 매 timestep에 policy가 받는 센서 입력으로, 여기서는 카메라 네 대의 이미지와 관절 각도, 그리퍼 자세, 리프트 위치, 베이스 속도가 들어간다.
action chunk는 policy가 한 번에 출력하는 여러 timestep 분량의 action 묶음이며, π0.5는 action horizon을 50으로 둔다. 이 연속값 묶음을 만드는 데 쓰이는 flow matching은 noise에서 목표 분포로 가는 연속 변환의 속도장을 학습하는 생성 기법이고, 로봇 상태와 action 토큰만 처리하도록 분리한 별도 가중치 묶음인 action expert가 그 계산을 맡는다.
co-training은 성격이 다른 여러 데이터 원천을 하나의 학습 mixture에 함께 넣는 방식이다. subtask는 그 mixture에 들어가는 중간 단계 명령으로, high-level 추론이 "pick up the plate" 같은 한 문장을 내놓으면 그것이 곧 low-level 추론의 조건 입력이 된다.
모델 구조
하나의 모델이 맡는 두 단계
π0.5가 학습하는 분포는 πθ(a_t:t+H, ℓ̂ | o_t, ℓ)이다. o_t는 카메라 이미지들과 로봇 configuration, ℓ은 "put away the dishes" 같은 전체 과제 프롬프트, ℓ̂은 모델이 내놓는 텍스트 출력으로 subtask 예측일 수도 웹 데이터 질의에 대한 답일 수도 있다. 이 분포를 두 조각으로 분해하는 것이 π0.5의 구조적 선택이다.
πθ(a, ℓ̂ | o, ℓ) = πθ(a | o, ℓ̂) · πθ(ℓ̂ | o, ℓ)
오른쪽 항이 high-level 추론이고 왼쪽 항이 low-level 추론이며, action 분포는 전체 프롬프트 ℓ이 아니라 모델이 스스로 만든 ℓ̂에만 의존한다. 두 단계를 서로 다른 모델이 아니라 같은 가중치가 표현한다는 점이 Hi Robot처럼 두 모델을 쌓는 선행 구성과 다르다. 저자들은 이 구성을 chain-of-thought에 빗대면서도, high-level 추론이 low-level 추론보다 낮은 주기로 실행된다는 점에서 embodied chain-of-thought 계열과는 구분한다.
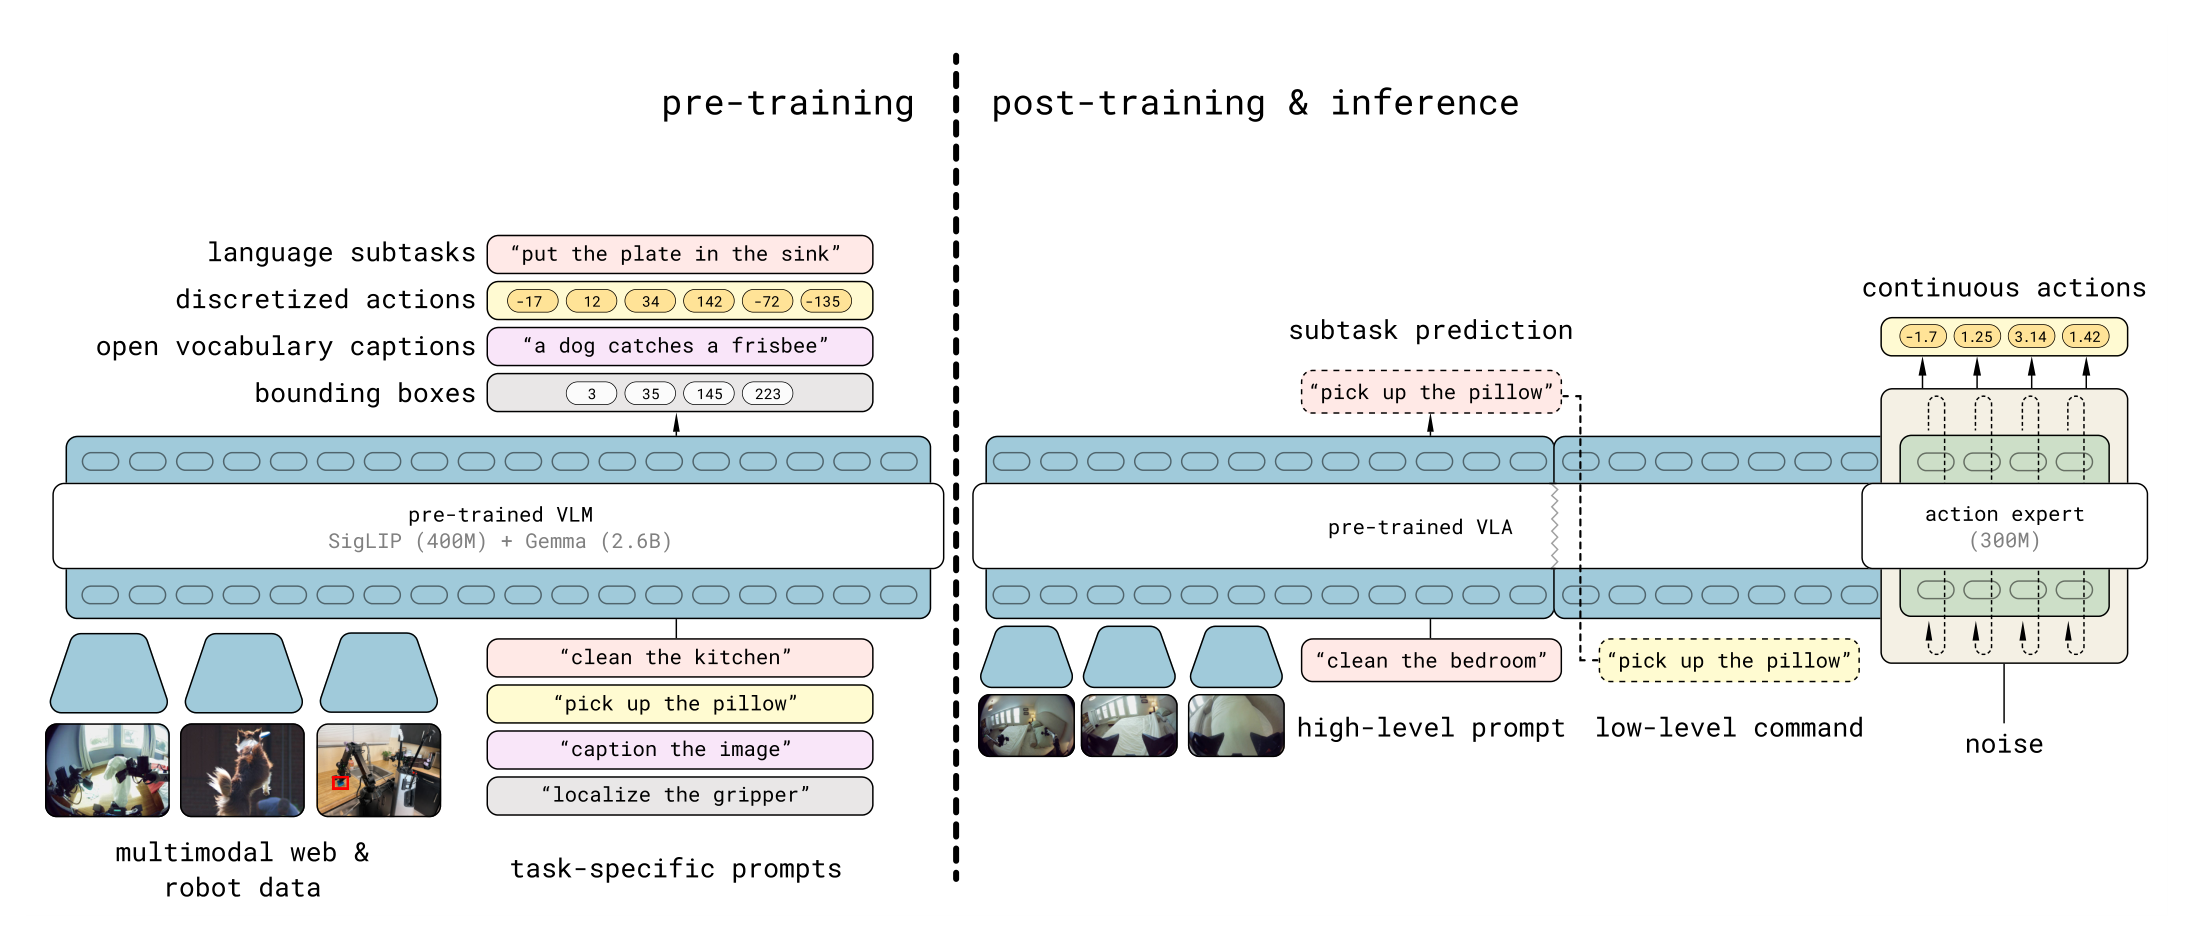
입력 토큰은 세 종류이고 종류마다 처리 경로가 갈린다. 텍스트 토큰은 임베딩 행렬을, 이미지 패치는 vision encoder를 지나며, flow matching의 중간 denoising 값인 연속 action 토큰은 선형 사영을 거쳐 별도 expert 가중치로 들어가는 mixture-of-experts 방식이다. attention도 표준 LLM과 달라서, 이미지 패치와 텍스트 프롬프트와 연속 action 토큰은 인과 마스크가 아니라 양방향 attention을 쓴다. 로봇의 proprioception, 곧 관절 위치 같은 자기 상태 입력은 이산화해 텍스트 토큰으로 넣는다.
이산 표현과 연속 표현의 결합
두 action 표현을 한 손실 안에 담은 것이 π0.5의 두 번째 설계다. 학습 목표는 텍스트 cross entropy와 flow matching 회귀를 계수 α로 섞은 합이며, FAST tokenizer로 인코딩한 action 토큰도 텍스트 쪽 cross entropy에 포함된다.
두 표현을 함께 쓰는 이유는 장단점이 서로 반대이기 때문이다. FAST처럼 action chunk를 압축해 이산 토큰으로 적으면 학습이 훨씬 빠르지만, 추론할 때 auto-regressive 디코딩이 필요해 실시간 제어에는 불리하다. 반면 flow matching은 연속값을 표현하면서 정해진 횟수의 적분만으로 action을 만들어 낸다.
계수 α가 두 학습 단계를 가른다.
| 단계 | α | 학습 대상 | 성격 |
|---|---|---|---|
| pre-training (28만 step) | 0 | backbone 전체 | action을 FAST 토큰으로 적어 표준 VLM처럼 next-token prediction만 수행 |
| post-training (8만 step) | 10.0 | backbone과 새로 붙인 action expert | 텍스트 예측을 유지하면서 flow matching으로 연속 action을 학습 |
action expert는 post-training 시작 시점에 무작위로 초기화한다. 추론할 때는 텍스트를 auto-regressive로 디코딩해 subtask ℓ̂을 얻고, 그 문장을 조건으로 10회의 denoising step을 밟아 연속 action을 만든다.
두 action 표현이 서로를 참조하면 정보가 새기 때문에 attention mask로 분리한다. FAST action 토큰은 prefix와 이전 action 토큰만 보고, action expert의 임베딩은 prefix와 자기들끼리만 보며 FAST 토큰은 보지 못한다. 따라서 정보는 VLM에서 action expert 방향으로만 흐른다.
세부 구성
| 항목 | 값 |
|---|---|
| backbone | PaliGemma VLM (SigLIP 400M vision encoder와 Gemma) |
| backbone 규모 | width 2048, depth 18, MLP 차원 16,384, head 18개, KV head 1개, head 차원 256 |
| action expert | 위와 같되 width 1024, MLP 차원 4096, 파라미터 300M |
| action horizon | 50 (H=49) |
| timestep 주입 | τ 전용 MLP 출력을 adaptive RMSNorm으로 action expert의 각 layer에 주입 |
| timestep 분포 | p(τ) = Beta((s-τ)/s; α=1.5, β=1), s=0.999로 최대 1,000회 적분 허용 |
| 이미지 증강 | 0.95 배율 random crop, resize, -5도에서 5도 회전, color jitter(밝기 0.3, 대비 0.4, 채도 0.5) |
timestep 처리가 π0와 갈리는 지점이다. π0는 timestep τ를 noisy action과 융합해 Transformer에 넣었지만, π0.5는 τ만 별도 MLP로 사영해 adaptive RMSNorm으로 각 layer에 주입하고 낮은 timestep을 강조하는 Beta 분포로 샘플링한다.
학습 레시피
pre-training mixture
pre-training은 로봇 데이터와 비로봇 데이터를 다섯 슬라이스로 나눠 함께 학습한다. 이 단계에서는 텍스트, 물체 위치, FAST로 인코딩한 action이 모두 next-token prediction 대상이다.
| 약칭 | 데이터 원천 | 규모와 성격 |
|---|---|---|
| MM | 약 100개 가정의 mobile manipulator 데이터 | 약 400시간. 평가 과제와 가장 가깝지만 첫 학습 단계 전체의 2.4% |
| ME | 여러 가정에 고정 설치한 팔 1~2개의 데이터 | 베이스가 없어 embodiment가 다르지만 운반이 쉬워 더 많은 집에서 수집 |
| CE | 실험실 tabletop의 cross-embodiment 데이터와 Open X-Embodiment | 식탁 치우기처럼 평가와 가까운 과제와 커피콩 갈기처럼 무관한 과제가 함께 들어간다 |
| HL | robot observation에 붙인 subtask 라벨과 bounding box | 여러 단계로 나뉘는 과제에 수동 주석. bounding box를 먼저, subtask를 나중에 예측 |
| WD | CapsFusion과 COCO(캡션), Cambrian-7M과 PixMo와 VQAv2(질의응답), object localization | 실내 장면과 가정용 물체의 bounding box 주석을 더해 확장 |
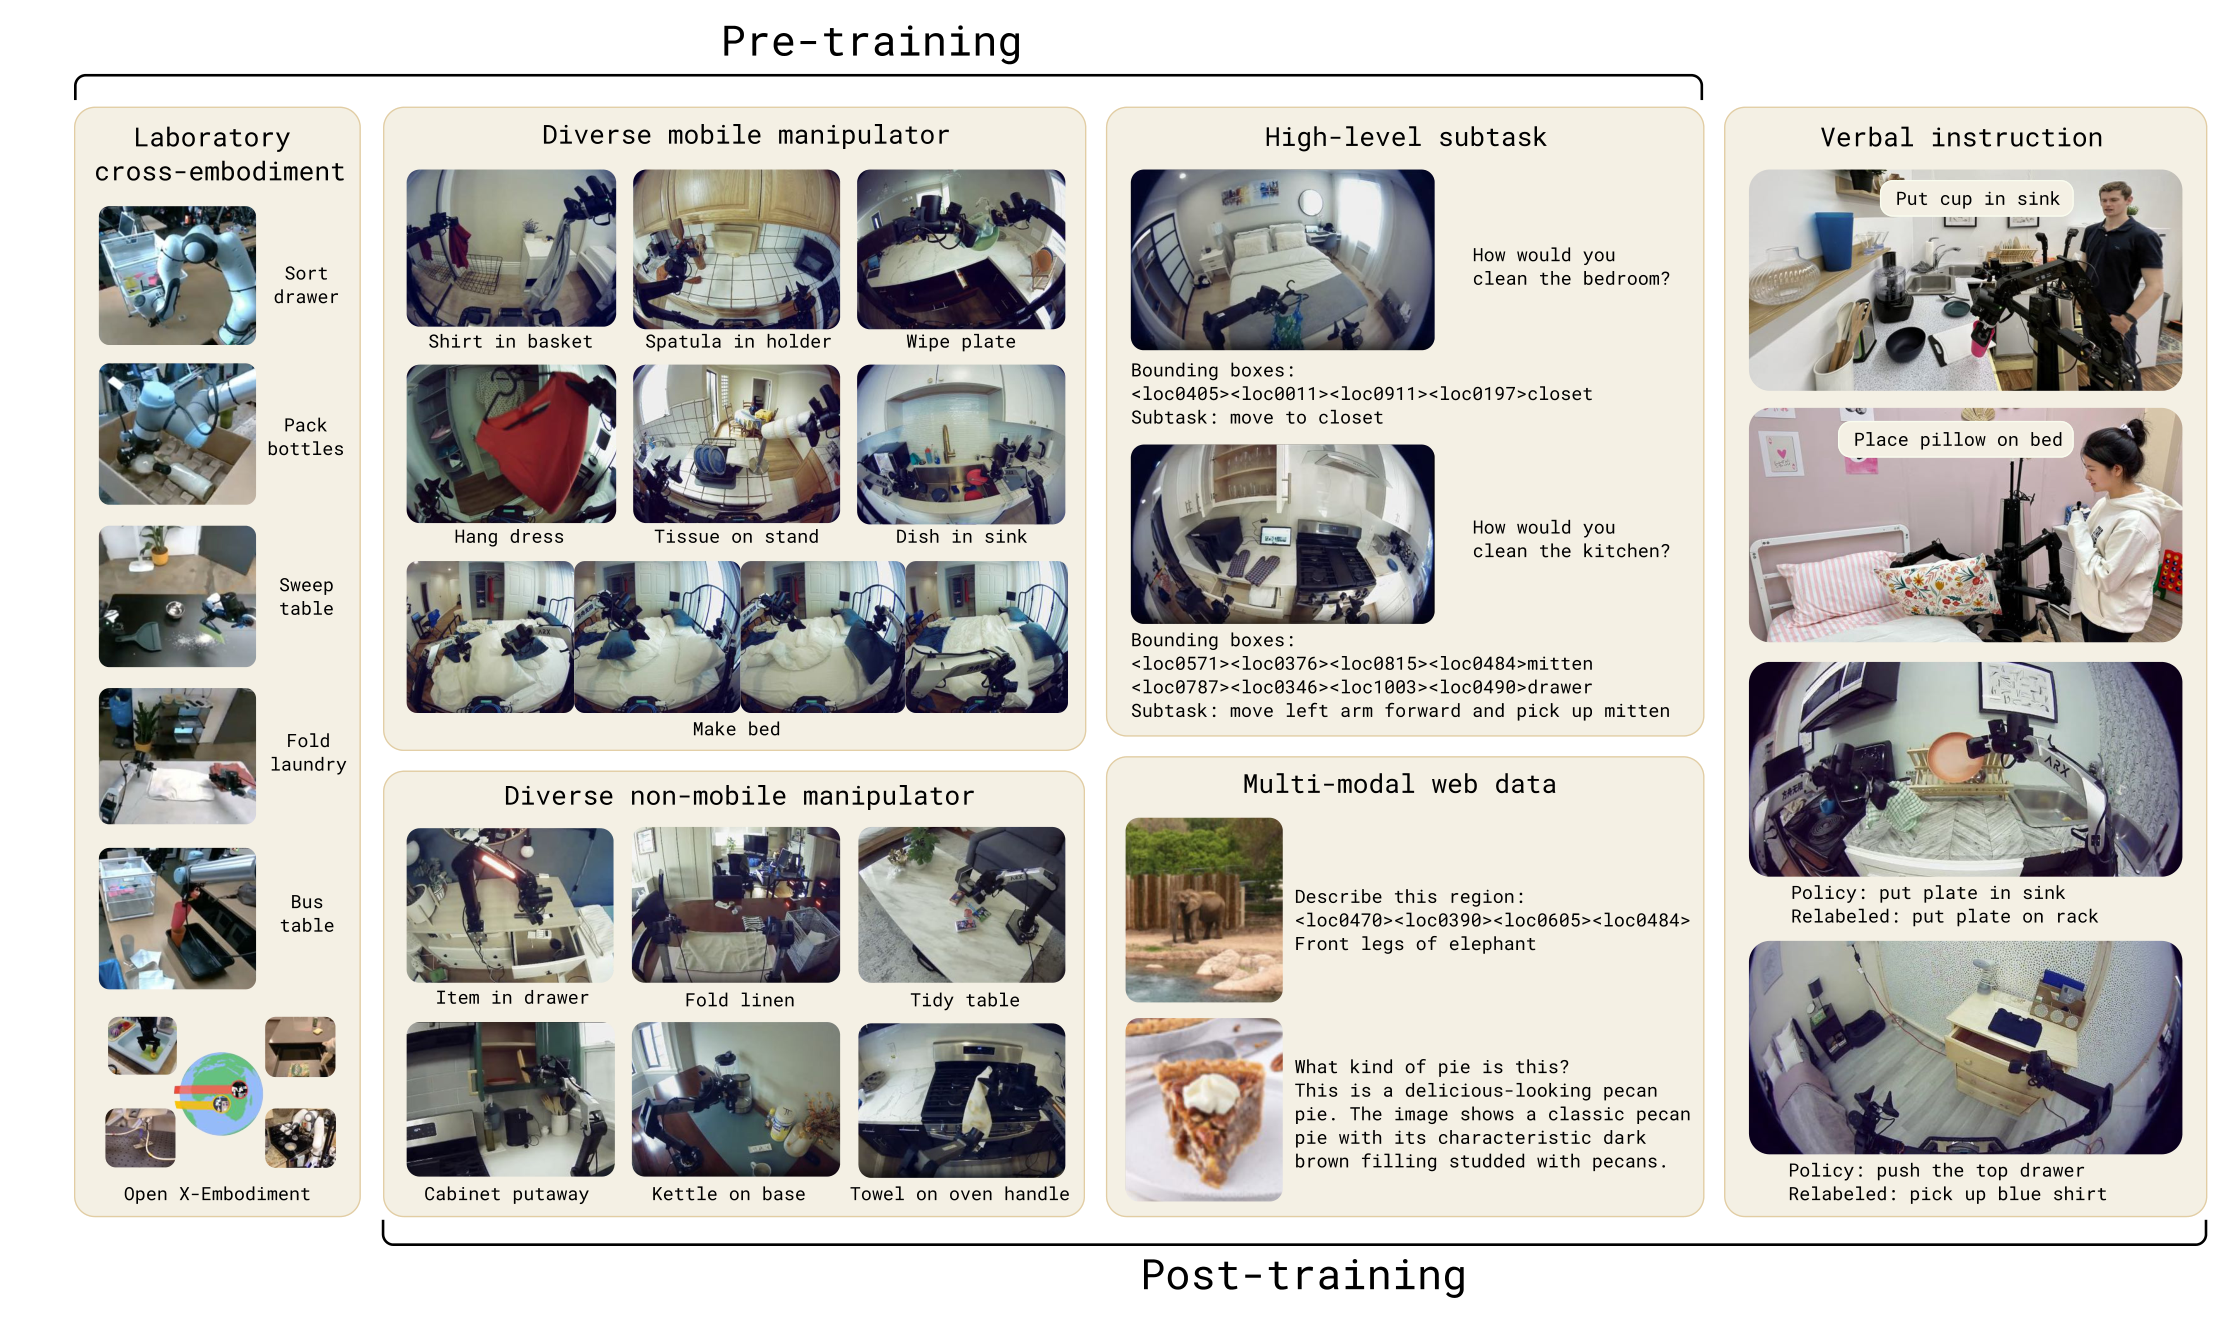
HL 슬라이스는 "clean the bedroom" 같은 상위 명령을 "adjust the blanket", "pick up pillow"처럼 짧은 subtask로 쪼갠 주석이다. 로봇 시점 이미지를 보고 다음에 수행할 subtask를 언어로 내놓게 하는 형식이며, 이 데이터 덕분에 하나의 모델이 subtask를 내놓는 high-level policy와 그것을 실행하는 low-level policy 양쪽으로 동작한다.
action 표현에는 규약이 따라붙는다. 모든 action 데이터에 대해 목표 관절각과 end-effector 자세를 함께 예측하도록 학습하고 둘을 구분하려고 프롬프트에 <control mode> joint/end effector <control mode> 표시를 넣는다. 값은 데이터셋마다 1%와 99% 분위수를 기준으로 [-1, 1]로 정규화하며, action 차원은 가장 큰 action space에 맞춰 고정하고 모자란 로봇은 0으로 패딩한다.
post-training
post-training은 모델을 가정 내 mobile manipulation에 특화시키고 action expert를 붙이는 단계이며, 데이터 구성도 함께 바뀐다. CE를 제외해 초점을 가정 환경으로 옮기고, MM과 ME 중 성공했고 길이가 일정 기준 이하인 episode만 남긴다. WD는 의미 능력과 시각 능력을 유지하려고 계속 섞고, 여러 환경 데이터에 대응하는 HL 슬라이스를 포함한다.
이 단계에서 verbal instruction(VI)이 새로 들어온다. 전문 사용자가 이미 학습된 저수준 policy에 실시간으로 말을 걸어 subtask를 하나씩 지시하며 과제를 끝내게 하고 그 기록을 모은 데이터로, 언어로 로봇을 teleoperation한 셈이며 좋은 high-level 출력이 무엇인지 보여 주는 시연 데이터(demonstration)에 해당한다. 규모는 high-level mobile manipulation 예시의 약 11%로 작다.
로봇 시스템과 제어 루프
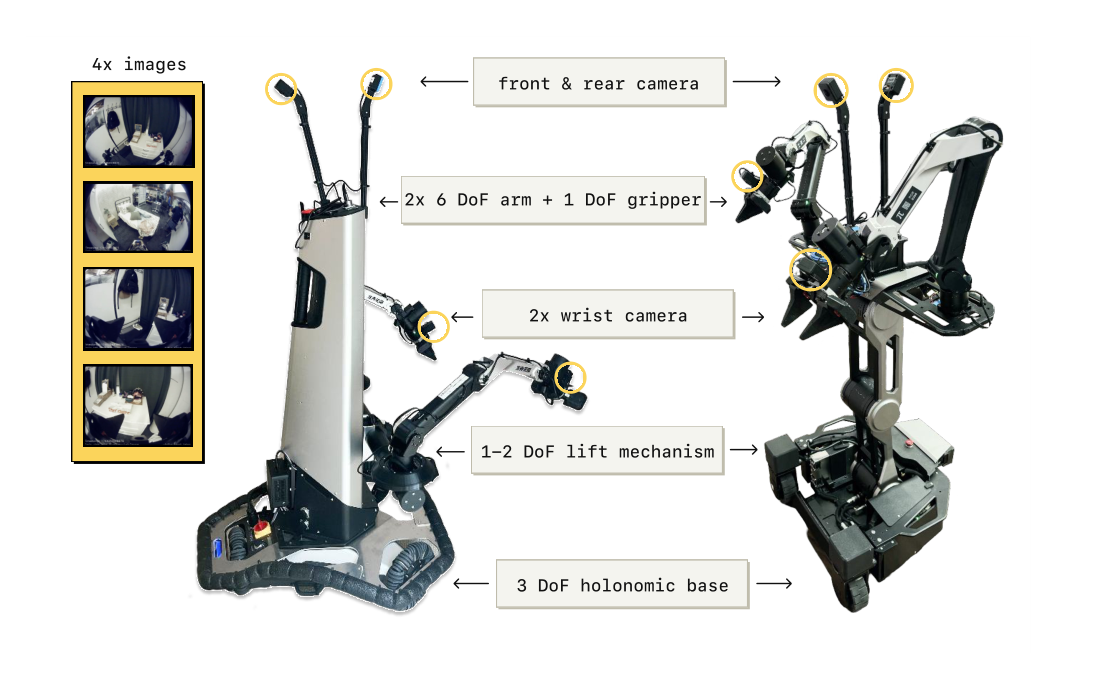
실험에 쓴 mobile manipulator 두 종은 평행 그리퍼가 달린 6 DoF 팔 두 개, 손목 단안 RGB 카메라, 홀로노믹 휠 베이스, 몸통 리프트를 공통으로 갖췄다. 베이스의 state와 action은 2차원 선속도와 1차원 각속도이고 리프트는 상하 1차원이거나 상하와 전후 2차원이며, 팔 사이의 전방과 후방 카메라를 합쳐 카메라는 네 대다. state와 action 차원의 합계는 플랫폼에 따라 18 또는 19이고, high-level 추론은 카메라 네 대를 모두 쓰는 반면 low-level 추론은 손목 두 대와 전방 한 대만 쓴다.
제어 계통은 매우 단순하다. 모델이 팔과 그리퍼와 리프트의 목표 자세, 그리고 베이스의 목표 속도를 50Hz로 내면 PD 제어기가 추종한다. 별도의 경로 계획이나 충돌 검사가 없으므로 manipulation과 이동이 모두 end-to-end로 처리된다.
평가 설계
모든 평가는 학습에 없던 환경에서만 진행한다. 통제되고 재현 가능한 비교에는 mock 부엌과 mock 침실을 쓰고 최종 평가에는 실제 집 세 곳을 쓰며, 두 종류를 합쳐 총 12개 위치다. 정량 평가 과제는 네 가지이고, 채점은 성공과 실패의 이분법이 아니라 과제의 몇 단계까지 갔는지를 세는 rubric이다.
| 과제 | 채점 항목 | 만점 |
|---|---|---|
| Dishes in Sink | 접시류 4개를 대상으로 물체를 집을 때마다 1점, 싱크에 넣을 때마다 1점 | 8점 |
| Items in Drawer | 물체 집기, 서랍 열기, 물체를 서랍에 넣기, 물체가 들어간 상태로 서랍 닫기 각 1점 | 4점 |
| Laundry in Basket | 옷 앞으로 이동해 집기, 바구니에 놓기, 옷이 완전히 안에 들어감 각 1점 | 3점 |
| Make the Bed | 담요로 시트 덮기, 베개 하나 배치, 나머지 베개 배치, 담요가 매우 깔끔함, 베개 둘 다 매우 깔끔함 각 1점 | 5점 |
측정 절차도 함께 규정한다. 별도 언급이 없으면 과제당 10회씩, 동일한 4개 위치에서 평가하므로 policy 하나당 총 40회가 된다. 환경 변화를 통제하려고 여러 policy를 번갈아 실행하며, 취소된 episode는 제외하고 유의성은 양측 t-test로 보고한다.
언어 지시 따르기는 다른 규약을 쓴다. 처음 보는 부엌 장면 두 곳에서 "put the scissors in the drawer"처럼 물체를 특정하는 명령을 주고, 물체 다섯 개 중 올바른 하나를 골라 지정된 위치에 놓는지를 본다. 목표 물체를 방해 물체보다 멀리 배치해 지름길 행동을 막았으므로 명령을 해석하지 못하는 policy는 약 20% 수준에 머문다. 지표는 명령이 가리킨 물체를 골랐는지 재는 follow rate와 그 물체를 지정된 위치에 놓았는지 재는 success rate 두 가지이며, 깔때기와 약통과 그릴 라이터와 라이터와 보안경으로 이뤄진 out-of-distribution 물체 세트로 미학습 범주 일반화도 함께 본다.
결과
실제 가정집 세 곳
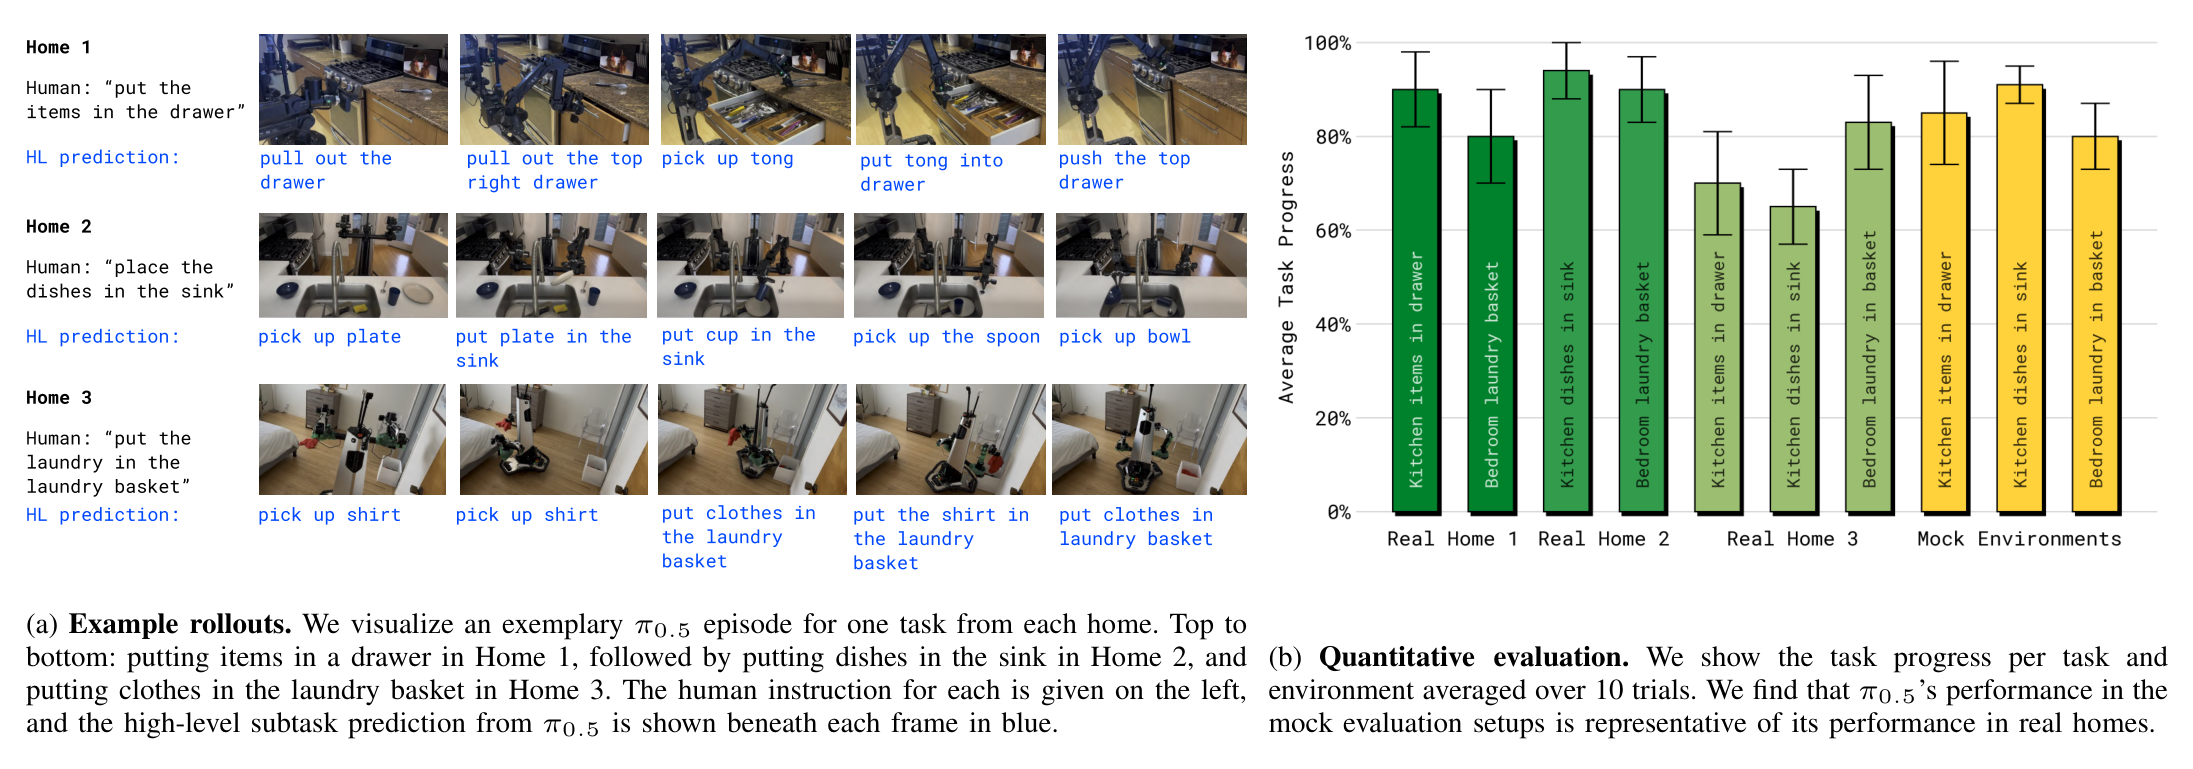
π0.5는 학습에 없던 집 세 곳의 부엌과 침실 청소 과제에서 일관되게 성공했다. 여러 물체를 옮기는 다단계 과제는 하나에 25분이 걸리고, 부엌이나 침실 전체를 치우는 긴 과제는 1015분까지 이어진다.
지시의 추상 수준이 이 실험의 요점이다. 모델은 "place the dishes in the sink" 정도의 상위 명령만 받고 "pick up the cup" 같은 중간 단계는 스스로 정한다. mock 환경 성적이 실제 집 성적을 잘 대표한다는 점도 함께 확인돼 이후 비교 실험의 근거가 된다.
학습 환경 수 확장
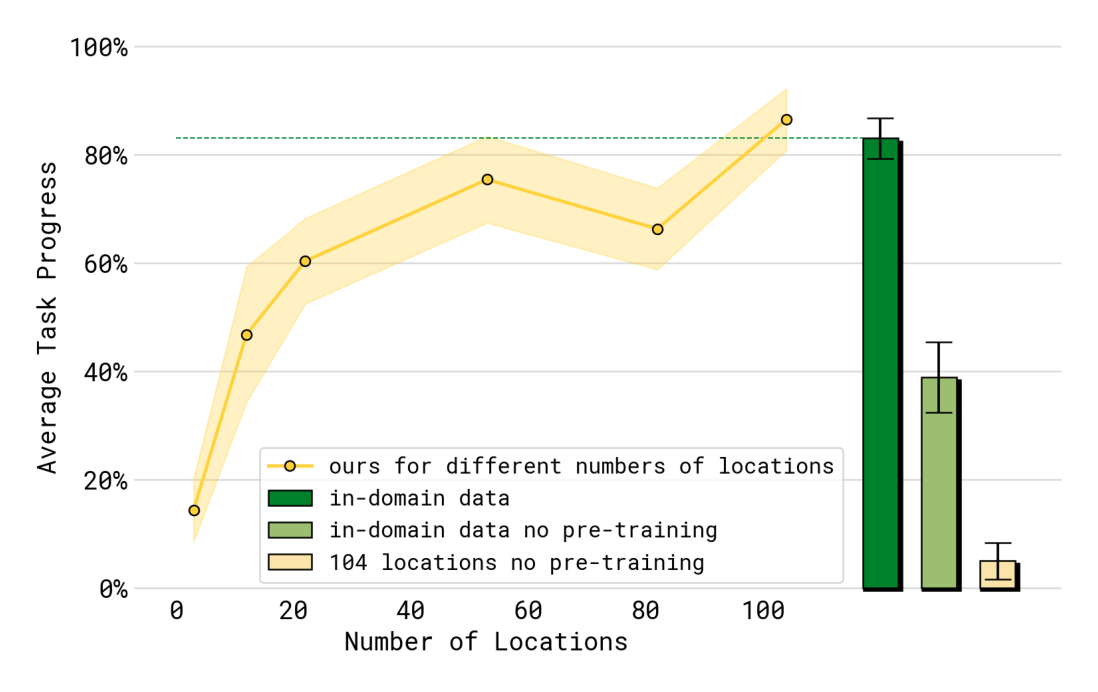
mobile manipulation 데이터의 환경 수를 3, 12, 22, 53, 82, 104개로 바꿔 가며 학습했다. 데이터 크기 자체의 효과를 배제하려고 step 수를 4만으로 맞춰 각 모델이 같은 수의 고유 샘플을 보게 했다.
성능은 환경 수를 따라 꾸준히 오르고 104개 지점에서는 테스트 집의 데이터를 학습에 직접 넣은 통제군과 비슷해진다. 즉 새 집으로 일반화하는 문제 자체를 없앤 모델과 대등해진다. 반면 pre-training의 다른 과제 없이 테스트 집 데이터만으로 학습한 baseline과 104개 위치의 mobile manipulation 데이터만으로 학습한 baseline은 모두 크게 낮았고, 테스트 집 데이터를 쓰지 않을 때 pre-training 유무의 격차가 가장 크게 벌어진다.
언어 지시 따르기도 같은 방향으로 오르지만, 학습에서 본 물체 범주 쪽이 못 본 범주보다 빠르게 개선된다. 환경이 늘 때마다 새로운 가정용 물체가 함께 들어오기 때문이다.
학습 mixture ablation
mock home 4과제에서 mixture의 조각을 하나씩 빼고 재학습했다. 기준이 되는 π0.5 전체는 79%다.
| 조건 | 평균 성적 | 전체 대비 | 유의성 |
|---|---|---|---|
| π0.5 (전체) | 79% | 기준 | 기준 |
| no CE (실험실 cross-embodiment 제외) | 51% | -28%p | p<0.001 |
| no ME (다른 환경의 고정형 로봇 제외) | 54% | -25%p | p<0.001 |
| no ME or CE (다른 로봇 데이터 전부 제외) | 40% | -39%p | p<0.001 |
| no WD (웹 데이터 제외) | 유의한 차이 없음 | 판정 불가 | p=0.385 |
다른 로봇에서 오는 데이터가 이 평가의 성능을 좌우한다. 다른 환경(ME)에서 오는 전이와 다른 과제(CE)에서 오는 전이가 각각 기여하고, 둘을 함께 빼면 하락 폭이 더 커진다. 반면 웹 데이터의 기여는 이 평가가 아니라 다음 평가에서 나타난다.
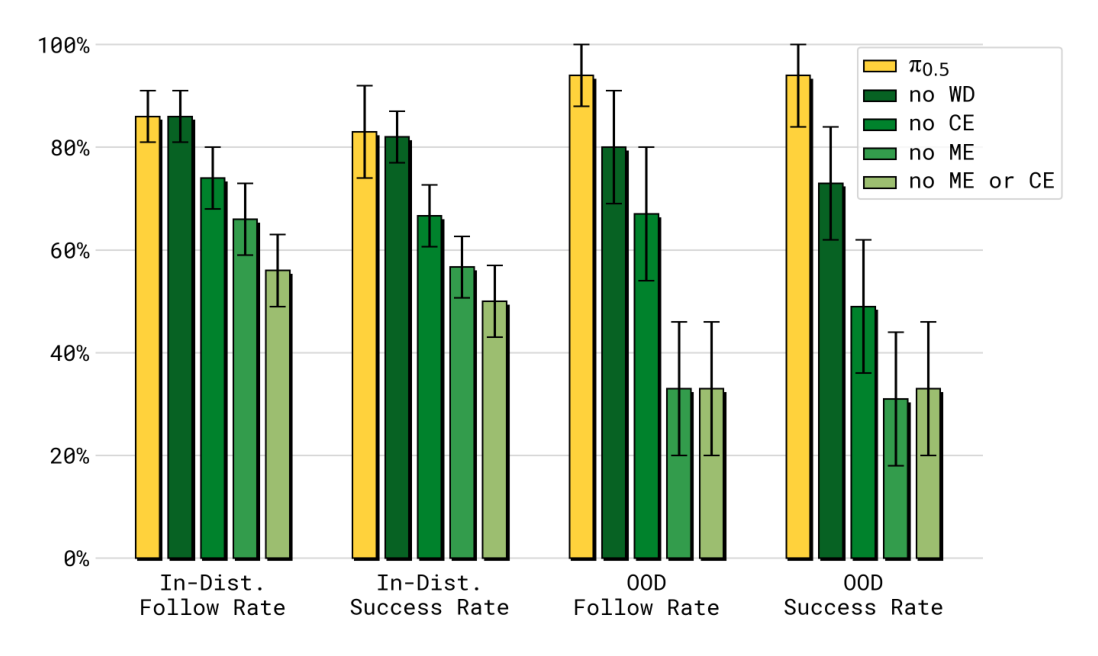
| 조건 | in-distribution follow | in-distribution success | OOD follow | OOD success |
|---|---|---|---|---|
| π0.5 | 86% | 83% | 94% | 94% |
| no WD | 86% | 82% | 80% | 74% |
| no CE | 74% | 67% | 67% | 49% |
| no ME | 66% | 57% | 33% | 31% |
웹 데이터를 뺀 조건은 학습에서 본 범주에서는 차이가 없지만, 학습에 없던 범주에서 follow rate가 94%에서 80%로, success rate가 94%에서 74%로 하락한다. 저자들은 웹 데이터에 담긴 폭넓은 물체 지식이 처음 보는 범주의 이름을 알아듣게 해 준다고 해석한다. 반면 ME나 CE를 빼면 양쪽 범주에서 모두 하락하며, ME를 뺀 조건의 OOD follow rate는 33%까지 내려간다.
π0와의 비교
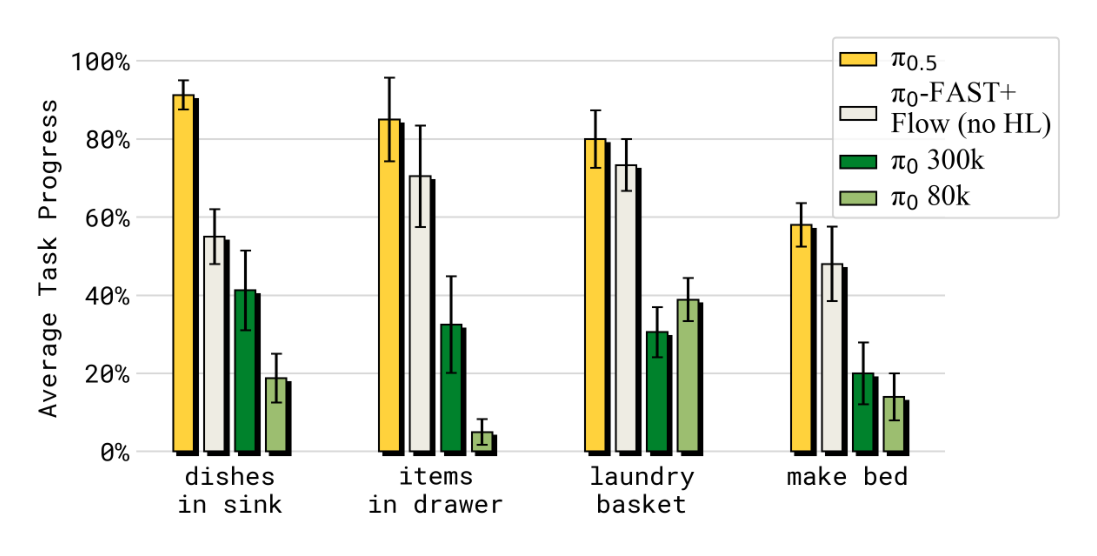
비교 대상은 원래 π0와, π0.5에 최대한 가깝게 맞춘 강한 baseline인 π0-FAST+Flow 두 가지다. 공정한 비교를 위해 세 모델 모두 같은 cross-embodiment 학습셋을 받고 비슷한 수의 step을 학습한다.
| 모델 | 학습 데이터 | action 표현 | high-level 추론 |
|---|---|---|---|
| π0 | action 데이터만 | 처음부터 flow matching action expert | 불가 |
| π0-FAST+Flow | action 데이터만 (HL과 WD 없음) | pre-training은 FAST 이산 토큰, post-training은 flow matching | 불가 |
| π0.5 | action 데이터에 HL, WD, VI를 더함 | 위와 같은 하이브리드 | 같은 가중치가 수행 |
mock home 4과제 전부에서 π0.5가 앞섰고, π0를 30만 step까지 더 학습해도 순위가 뒤집히지 않았다. 따라서 FAST 토큰으로 학습하는 편이 순수 diffusion 학습보다 연산 대비 효율이 낫다는 선행 결과가 여기서도 확인된다. 언어 지시 따르기에서도 순서는 같아서, π0.5가 π0-FAST+Flow를 근소하게 앞서고 π0는 큰 차이로 뒤진다.
high-level 추론의 기여
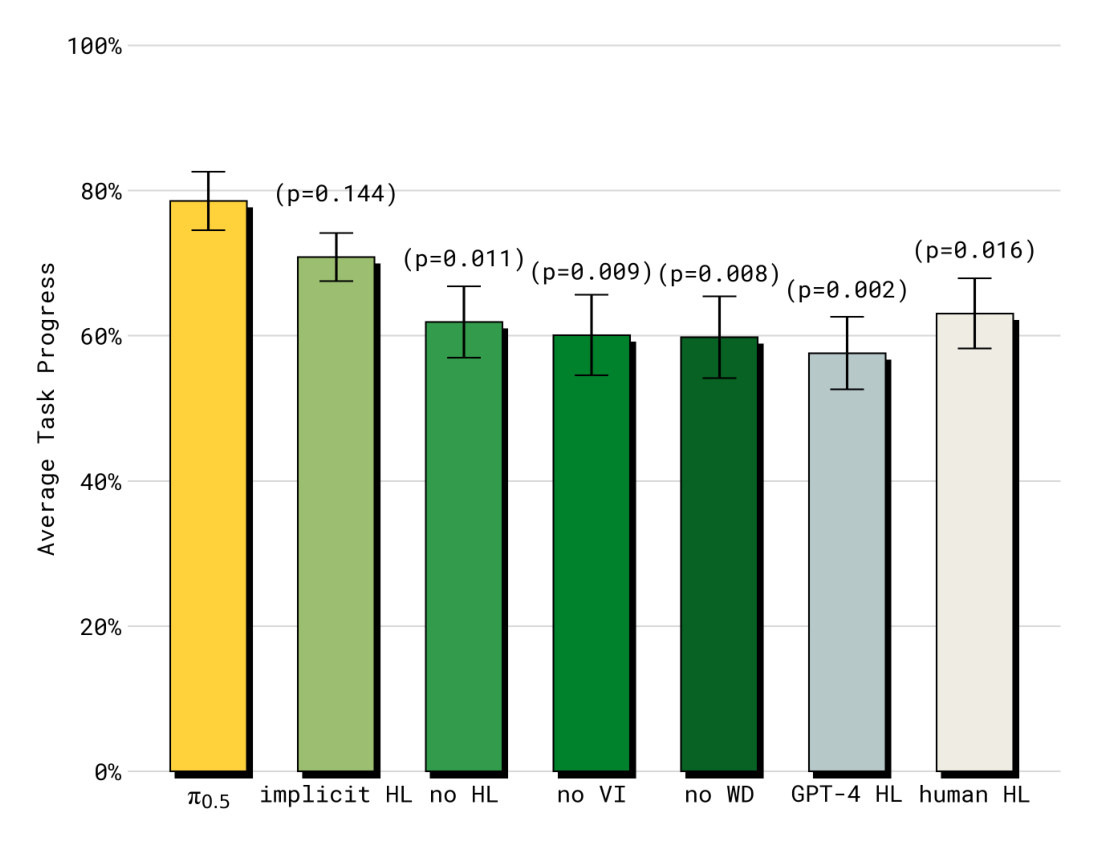
같은 low-level 추론을 그대로 두고 high-level 쪽만 일곱 가지로 바꿔 가며 측정했다.
| high-level 방식 | 평균 성적 |
|---|---|
| π0.5 (전체) | 79% |
| implicit HL (런타임 high-level 추론 없음, 학습에는 HL 포함) | 71% |
| human HL (사람 전문가가 subtask 지시) | 63% |
| no HL (학습에서도 HL 제외) | 62% |
| no VI (verbal instruction 제외) | 60% |
| no WD (웹 데이터 제외) | 60% |
| GPT-4 HL (GPT-4를 high-level policy로 사용) | 58% |
전체 π0.5가 가장 높고 사람 전문가가 subtask를 불러 주는 human HL보다도 높다. 두 번째로 높은 조건은 implicit HL로, 런타임에는 subtask를 뽑지 않지만 학습 mixture에 HL 데이터가 들어간 경우다. 즉 명시적 high-level 추론에 이득이 있으면서도, 그 이득의 상당 부분은 subtask 예측 데이터를 학습에 넣어 두는 것만으로 이미 확보된다.
작은 데이터 조각의 영향도 확인된다. VI는 high-level mobile manipulation 예시의 약 11%에 지나지 않지만 이를 뺀 조건은 60%로 유의하게 낮고, 웹 데이터를 뺀 조건도 같은 60%여서 웹 데이터의 이득 상당 부분이 high-level policy 개선에 있다는 해석이 따라온다. 가장 낮은 조건은 GPT-4를 high-level policy로 붙인 경우인데, 과제 설명과 라벨 목록을 프롬프트로 주어 도메인에 맞췄는데도 58%에 그쳤다. 따라서 VLM을 로봇 데이터로 적응시키는 과정이 필요하다는 것이 저자들의 결론이다.
과제별 분해
부록의 과제별 분해는 mixture의 어느 조각이 어느 과제에 필요한지를 보여 준다.
- Items in Drawer는 ME나 CE를 빼도, WD를 빼도 크게 하락하며 셋을 모두 제외할 때 하락 폭이 가장 크다. 넓은 범위의 일상 물체를 알아봐야 하는 과제라서 여러 원천의 지식이 함께 쓰인다.
- Dishes in Sink는 웹 데이터 제거에는 비교적 견고하지만 ME나 CE 제거에는 하락한다. 즉 이 과제에 필요한 것은 로봇 데이터에서 오는 일반 manipulation 전략이다.
- Laundry Basket과 Make Bed도 cross-embodiment 데이터를 빼면 하락하지만 mixture의 다른 변화에는 덜 민감하다.
high-level 추론 쪽 분해도 같은 방식으로 갈린다. Items in Drawer와 Dishes in Sink에서는 no HL 조건의 하락이 크고 두 과제 모두 π0.5가 GPT-4 HL을 앞선다. 반면 Laundry Basket은 horizon이 짧거나 세밀한 의미 추론이 덜 필요해 high-level policy 선택에 덜 민감하다.
한계
성능이 넓게 일반화되더라도 실패는 남는다. 논문이 드는 반복적인 실패 유형은 세 가지다.
- 처음 보는 서랍 손잡이나 로봇이 물리적으로 열기 어려운 수납장처럼 환경 자체가 지속적인 난점이 되는 경우.
- observation이 일부만 들어오는 문제. 예를 들어 닦아야 할 얼룩을 로봇 팔이 스스로 가린다.
- high-level subtask 추론이 산만해지는 경우. 물건을 넣는 동안 서랍을 여닫기만 반복하는 식이다.
기술적 제약도 저자들이 직접 짚는다. 첫째, 모델이 처리하는 프롬프트가 비교적 단순하며 받아들일 수 있는 지시의 복잡도는 결국 학습 데이터가 정한다. 더 복잡한 선호와 조건을 다루려면 사람 라벨러나 합성 방식으로 더 정교한 주석이 필요하다.
둘째, context가 짧다. 방 사이를 오가거나 물건을 어디에 뒀는지 기억해야 하는 과제처럼 observation이 장면의 일부만 담는 상황에서는 더 풍부한 문맥과 메모리가 필요하다.
셋째, 이 논문이 시험한 데이터 원천의 조합은 가능한 조합의 일부에 지나지 않는다. 특히 사람이 말로 지시하는 verbal instruction은 새로운 감독 방식이어서 후속 연구의 여지가 크다고 본다.
계보 안에서의 위치
π0와 π0.5는 손댄 지점이 다르다. π0는 action 표현을 바꿨고 π0.5는 학습 데이터의 구성을 바꿨다. π0 논문의 한계 절은 데이터 구성 원칙이 아직 없다는 문제 제기로 끝나는데 π0.5는 mixture ablation으로 바로 그 질문에 답하며, π0가 별도의 high-level VLM policy를 위에 두었던 계층 구조도 같은 가중치 안으로 통합했다.
VLA 계보에서 보면 이산 토큰과 연속 표현이 여기서 한 모델 안에 함께 들어간다. RT-2와 OpenVLA는 action을 이산 토큰으로 적었고 π0는 그 자리에 flow matching을 넣었으며, π0.5는 둘을 학습 단계로 나눠 쓴다.
평가 결과는 다른 설정과 나란히 볼 필요가 있다. ASPIRE는 LIBERO-Pro에서 π0.5를 baseline으로 놓고 종합 0.13이라는 낮은 점수를 보고하는데, 이 논문의 평가는 실제 기기와 가정 환경이고 ASPIRE 쪽은 시뮬레이터 벤치마크에 지시문 교란을 더한 설정이라 성격이 다르다.
구현은 openpi에 공개돼 있다. 다만 저장소 README는 π0.5의 flow matching head만 지원한다고 밝히고 학습 방식으로는 논문의 2단 레시피 대신 knowledge insulation을 들어, 논문과 공개 구현을 함께 읽는 편이 안전하다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| co-training | 로봇 action, 웹 질의응답, subtask 라벨 등 성격이 다른 데이터를 하나의 학습 mixture에 함께 넣는 방식 |
| high-level 추론 / low-level 추론 | 각각 subtask 문장을 뽑는 단계와 그 문장을 조건으로 action chunk를 뽑는 단계. π0.5는 같은 가중치가 둘을 모두 수행한다 |
| FAST tokenizer | action chunk를 압축해 이산 토큰으로 적는 방식. pre-training에서 action을 텍스트처럼 다루게 해 준다 |
| verbal instruction | 사람이 학습된 저수준 policy에 말로 subtask를 하나씩 불러 과제를 완수시키며 모은 데이터 |
| implicit HL | 런타임에는 subtask를 뽑지 않고 학습 mixture에만 HL 데이터를 넣은 조건. π0.5 다음으로 성적이 높다 |
| task progress | 과제의 몇 단계까지 갔는지를 비율로 매기는 채점 방식. 접시 절반을 옮겼으면 50% 정도가 된다 |
| follow rate / success rate | 명령이 가리킨 물체를 골랐는지와 그 물체를 지정된 위치에 놓았는지를 각각 재는 지표 |
관련 페이지
- π0.5: a VLA with Open-World Generalization: 같은 날 올라온 공식 블로그. 언어 ablation 수치와 무편집 데모 영상이 있다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 직전 세대. flow matching action expert의 출처다.
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities: 두 세대 뒤. subtask 지시문을 물려받아 subgoal image와 episode metadata까지 prompt를 넓힌다.
- π*0.6: a VLA That Learns From Experience: 같은 계보의 강화학습 기반 후속작.
- openpi: Open-source models and packages for robotics (π₀ / π₀-FAST / π₀.₅): 레퍼런스 구현. π0.5 base checkpoint와 fine-tuning 파이프라인을 공개한다.
- OpenVLA: An Open-Source Vision-Language-Action Model: 이산 토큰 계열 오픈소스 VLA.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 웹 데이터를 로봇 학습에 섞는 co-fine-tuning의 출처.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: action chunking의 출처.
- Flow Matching for Generative Modeling: action 출력부에 쓰인 생성 기법의 원 논문.
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models: CE 슬라이스에 들어간 공개 데이터셋.
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots: 같은 시기 다른 팀의 robot foundation model.
- ASPIRE: Agentic /Skills Discovery for Robotics: LIBERO-Pro에서 π0.5를 baseline으로 쓴 후속 연구.
- Vision-Language-Action (VLA) Models for Bimanual Manipulation and Their Real-World Deployment: A Comprehensive Survey: π 계열 전개를 정리한 서베이.
- Physical AI 카테고리 지도와 학습 경로: 도메인 허브.