Agents · PAPER · 2026
Are We Ready For An Agent-Native Memory System?
요약
이 논문은 LLM 에이전트의 메모리를 하나의 데이터 관리 시스템으로 보고, 표현과 저장, 추출, retrieval과 라우팅, 유지 네 모듈로 분해한 뒤 12개 대표 메모리 시스템을 5개 워크로드와 11개 데이터셋에서 통합 벤치마크한다. Shanghai Jiao Tong University와 Tsinghua University, MemTensor가 2026년 6월 arXiv에 공개했다.
결론은 모든 시나리오를 지배하는 단일 아키텍처가 없다는 것이다. 성능은 메모리 구조가 그 워크로드의 병목과 얼마나 맞물리는지에 달렸다. 여기에 두 가지 실무 결론이 붙는다. 고도로 구조화된 시스템은 인덱스 구축과 질의 지연이 수십에서 수백 배 크지만 그에 비례하는 정확도 향상을 일관되게 내지 못한다. 그리고 추상화 층을 하나 더 쌓을 때마다 정보가 조금씩 사라진다.
이 페이지는 논문의 taxonomy와 실험 수치를 모두 옮긴다. 개별 시스템(Mem0, Zep, MemOS 등)의 내부 설계보다 그 시스템들을 같은 기준으로 세워 놓고 비교하는 관점이 이 자료의 값이다.
배경
메모리 연구는 단순 retrieval-augmented 기법에서 출발해 지속 저장, retrieval, 갱신, 통합, 수명 관리까지 담당하는 데이터 관리 시스템으로 빠르게 커졌다. 반면 평가는 그 속도를 따라가지 못했다.
평가가 놓친 시스템 관심사
기존 벤치마크는 F1이나 BLEU 같은 end-to-end 태스크 성공률로 에이전트 메모리를 재고 그 아래의 시스템을 하나의 블랙박스로 둔다. 논문은 여기서 네 가지 빈틈을 짚는다.
| 빈틈 | 구체적 증상 |
|---|---|
| 아키텍처 커버리지 | MemoChat, MemTree, LightMem은 선행 평가에 포함된 적이 없다. 데이터베이스 커뮤니티의 시도도 LoCoMo와 LongMemEval 같은 chatbot 중심 데이터셋에 갇혀 복잡한 agentic 실행 시나리오를 놓쳤다 |
| 지표의 단면성 | 근거 수준의 retrieval 충실도, 모순 지식 아래의 갱신 강건성, 장기 지평 안정성을 분리해 재지 못한다 |
| 운영 비용 누락 | 프로덕션 배포에 결정적인 인덱스 구축 시간과 질의 지연을 거의 재지 않는다 |
| 블랙박스 취급 | 메모리를 분해 가능한 데이터 관리 모듈로 보지 않아 모듈 하나의 기여를 분리할 수 없다 |
인접 개념과의 경계
에이전트 메모리라는 말이 RAG나 context engineering과 뒤섞여 쓰이기 때문에, 논문은 먼저 세 개념의 경계를 긋는다.
| 개념 | 성격 | 수명과 쓰기 |
|---|---|---|
| RAG | 상태 없는 읽기 전용 retrieval 원시 연산. 질의가 오면 정적 코퍼스에서 구절을 가져와 생성 한 단계를 보강하고 끝난다 | 쓰기 없음 |
| context engineering | 추론 turn마다 유한한 context window에 무엇을 담을지 큐레이션하는 실무. 프롬프트, 도구 설명, 가져온 사실을 동적으로 고른다 | turn 단위, 지속 저장 없음 |
| 에이전트 메모리 시스템 | 시간에 걸쳐 에이전트 고유 상태를 관리하는 지속 갱신형 인프라. LLM의 가중치와 휘발성 context window에서 분리돼 있다 | long-term memory 수명 전체를 관장 |
경계가 중요한 이유는 실패 양상이 다르기 때문이다. 잘못 설계된 메모리 아키텍처를 쓰면 사실 모순, catastrophic forgetting, 감당하기 어려운 지연이 한 번의 생성이 아니라 지속 실행 도중에 발생한다.
핵심 개념
에이전트 메모리의 두 분류 기준
에이전트가 다루는 정보는 대화 이력, 도구 실행 로그, 정제된 사실, 사용자 선호 등으로 다양하다. 논문은 인지과학 틀을 빌려 이를 두 기준으로 정리한다.
| 기준 | 구분 | 내용 |
|---|---|---|
| temporal | short-term memory | 진행 중인 세션의 휘발성 상태 |
| temporal | long-term memory | 세션을 넘어 지속되는 상태 |
| functional | episodic memory | 개별 과거 사건. 언제 무슨 일이 있었는지를 사건 단위로 저장하는 층이다 |
| functional | semantic memory | 사건에서 추상화된 사실 지식 |
| functional | procedural memory | 재사용 가능한 행동 전략 |
| functional | 사용자 선호 | 개인화에 쓰이는 선호 항목 |
이 논문의 초점은 태스크 특화 에이전트 프레임워크에서 메모리가 보조 모듈로 붙는 경우가 아니라, 메모리 자체가 중심이 되는 시스템 수준 메모리다. Mem0, Letta, Zep, A-MEM 같은 외부 메모리 시스템이 여기 해당한다. 에이전트는 이들에 능동적으로 쓰고 갱신하고 인덱싱하며 관련 컨텍스트를 추론 루프로 되돌린다.
네 모듈 형식화
agent memory system은 추론 한 단계를 넘어 누적 상태를 유지하고 이후의 추론과 행동에서 접근 가능하게 만드는 지속 데이터 관리 인프라를 뜻한다. 논문은 이를 네 모듈의 튜플 로 형식화한다. 이 네 글자가 논문 전체의 골격이므로 먼저 정리해 둔다.
| 모듈 | 이름 | 담당 |
|---|---|---|
| R | Memory Representation and Storage | 논리 형식(이산 토큰, 연속 vector, knowledge graph, tree, 복합 토폴로지)과 물리 저장(휘발성 register, 단일 엔진 DB, 멀티 엔진 백엔드)을 정의하는 매핑 |
| S | Memory Extraction | 여러 turn 대화나 도구 로그 같은 이질적 입력 스트림을 논리 메모리 원시형으로 바꾸는 기제 |
| Q | Memory Retrieval and Routing | 질의 컨텍스트에 따라 관련 메모리 부분집합을 동적으로 찾고 인덱스를 순회하는 함수 |
| U | Memory Maintenance | 메모리 항목의 동적 수명을 관리하는 규칙. 충돌 해소와 버전 관리, 용량 관리, 의미 통합으로 나뉜다 |
전통 데이터베이스 워크로드와 다른 점
에이전트 메모리를 데이터 관리 시스템으로 본다면 기존 DBMS 기술을 그대로 쓰면 될 것 같지만, 논문은 워크로드 성질이 OLTP나 OLAP과 세 지점에서 다르다고 본다.
| 차이 | 전통 워크로드 | 에이전트 메모리 워크로드 |
|---|---|---|
| 접근 방식 | 고정 schema 위의 정확한 논리 술어 | 자연어, 부분 컨텍스트, 잠재 의도로 표현되는 의미 기반 접근. 근사 매칭과 질의 재작성, LLM이 이끄는 retrieval이 필요하다 |
| 갱신 성질 | 정해진 schema와 일관성 모델 아래 tuple 덮어쓰기 | 시간과 도구, 환경에 걸쳐 모인 불확실하고 부분적이며 때로 모순되는 정보를 수용해야 한다 |
| 이질성 | 접근 패턴과 단위가 비교적 균일 | 하나의 워크로드가 long-context 종합, episodic 회상, 구조화 사실 조회, temporal reasoning, 스트리밍 갱신을 함께 요구한다 |
세 번째 성질이 실무 시스템이 의미 retrieval과 구조화 필터링, 토폴로지 순회를 한 아키텍처 안에서 섞는 이유다. 뒤에 나오는 Multi-Paradigm Hybrid 계열이 그 결과물이다.
방법
네 아키텍처 계열
논문은 taxonomy를 제시하기 전에 기존 시스템이 실제로 어떤 실행 워크플로를 가지는지 네 가지로 보인다. 같은 "메모리"라는 이름 아래 서로 다른 실행 구조가 들어 있다는 점을 먼저 보이는 것이다.
| 계열 | 대표 시스템 | 실행 워크플로 |
|---|---|---|
| Stream-and-Reflection | MemoryBank | 경험을 timestamp가 붙은 메모리 스트림으로 쌓고 주기적으로 reflection을 만들어 스트림에 되쓴다. retrieval은 recency와 importance, relevance를 곱한 점수로 한다 |
| Hierarchical Tiered | MemGPT(Letta) | 용량과 접근 특성이 다른 여러 층으로 나누고 core memory와 archival storage 사이를 축출과 승격으로 명시 이동한다 |
| Knowledge Graph | Mem0_g, Zep | entity와 relation, 그 시간적 변화를 temporal knowledge graph로 표현하고 entity 동일성 판정과 충돌 해소를 함께 둔다 |
| Composite Hybrid | A-MEM | schema를 아는 메모리 객체를 여러 저장 기반으로 라우팅하고 KV cache 같은 런타임 상태와 vector, graph, 키워드 인덱스 같은 장기 저장을 분리한다 |
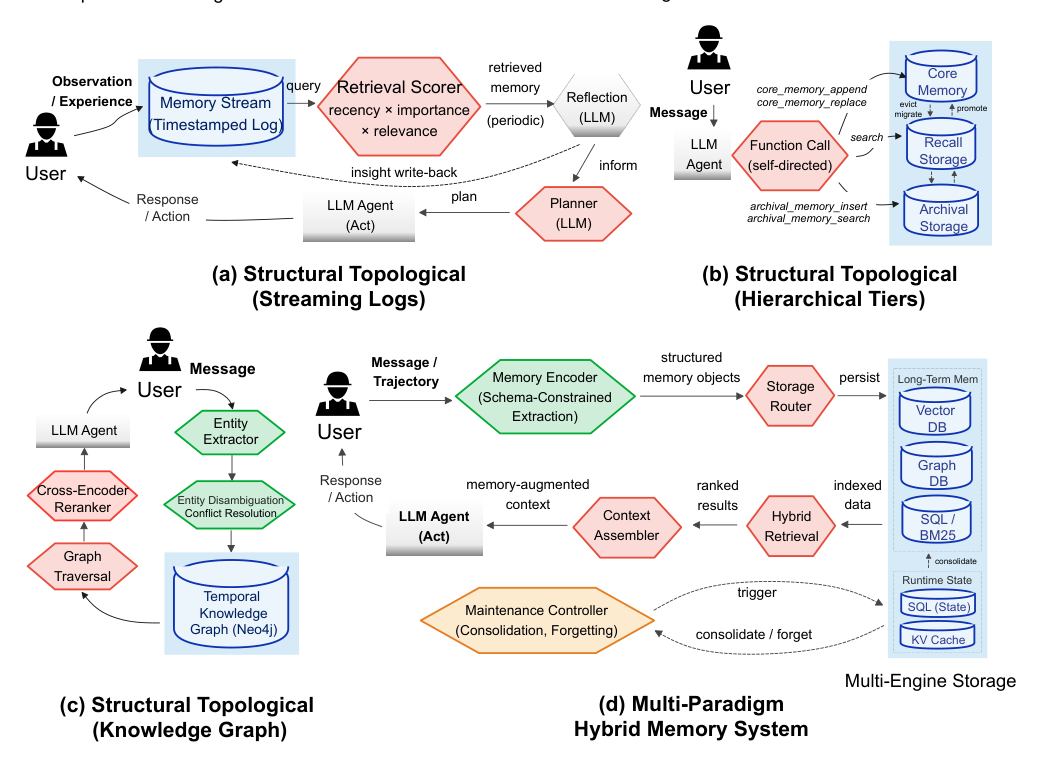
오른쪽 아래 패널이 네 모듈을 모두 명시적으로 가진 형태다. Memory Encoder가 S, Storage Router와 Multi-Engine Storage가 R, Hybrid Retrieval과 Cross-Encoder Reranker가 Q, Maintenance Controller가 U에 해당한다.
14개 시스템 taxonomy
Table 1이 논문의 핵심 기여다. 14개 대표 시스템을 세 계열로 묶고 네 모듈에서 각각 어떤 설계를 택했는지 한 표에 담았다.
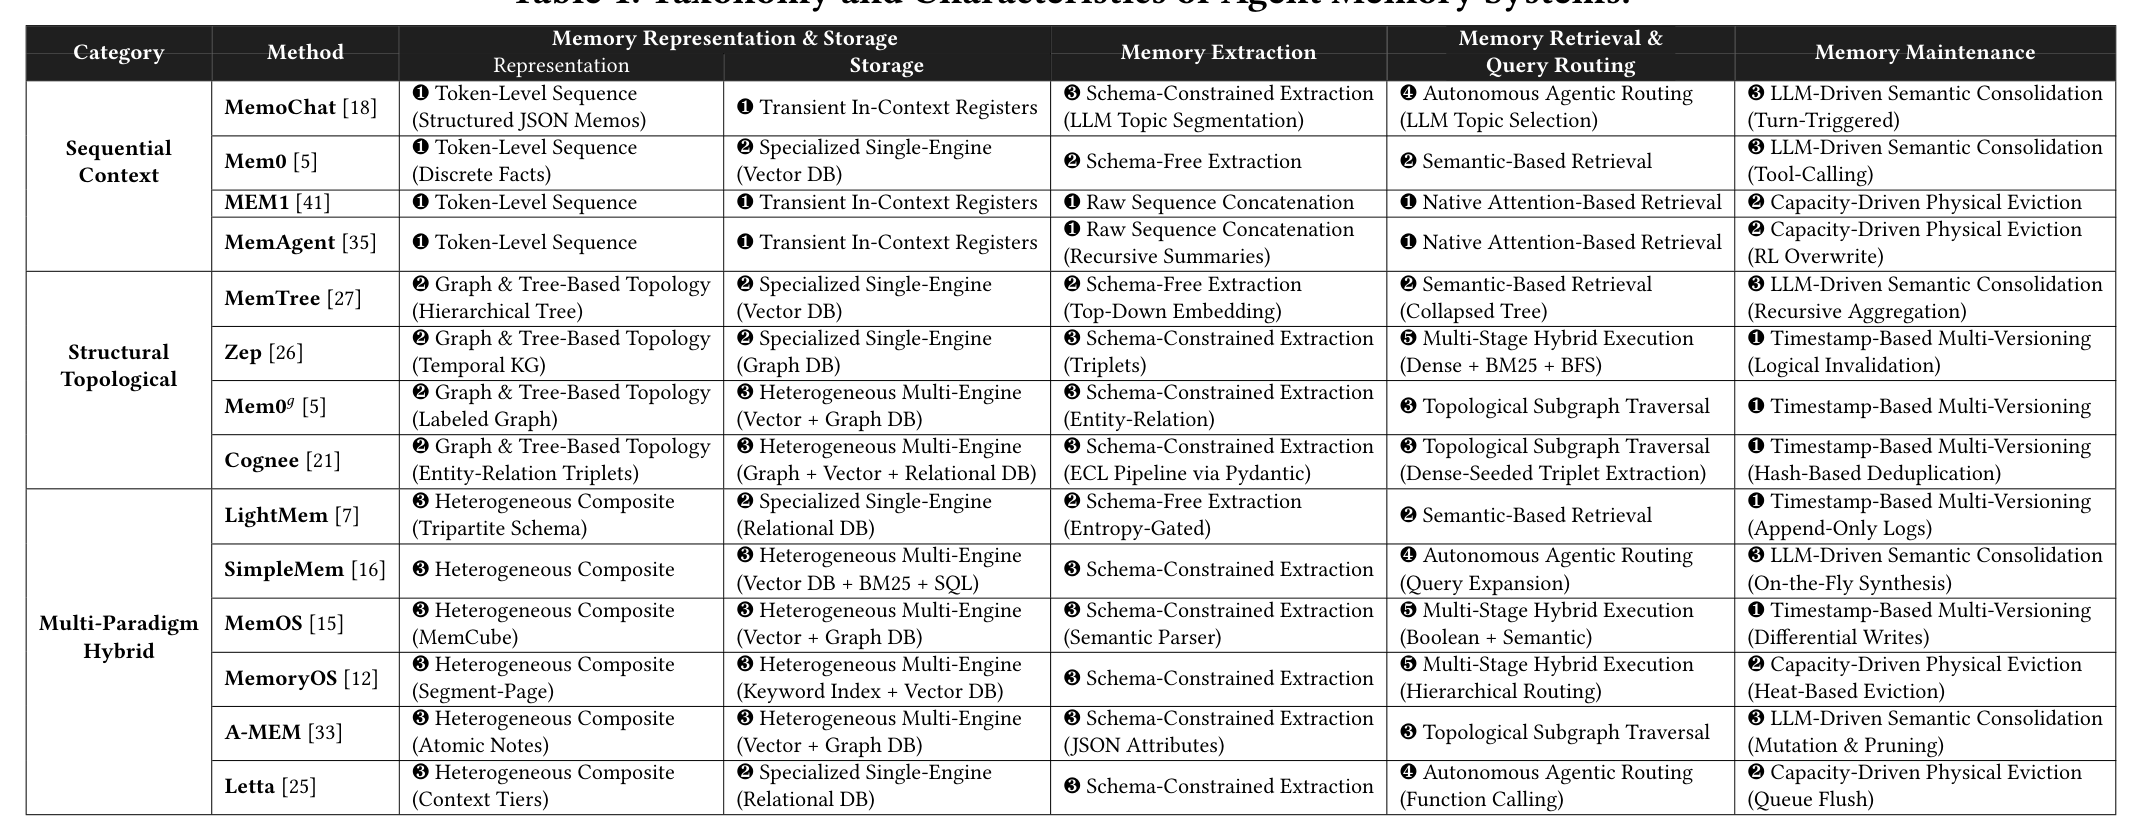
읽기 편하도록 계열별로 나눠 옮긴다. 먼저 Sequential Context 계열은 메모리를 구조 없는 시퀀스로 다룬다.
| 시스템 | 표현 | 저장 | 추출 | retrieval과 라우팅 | 유지 |
|---|---|---|---|---|---|
| MemoChat | Token-Level Sequence (구조화 JSON 메모) | Transient In-Context Register | Schema-Constrained (LLM topic 분할) | Autonomous Agentic (LLM topic 선택) | LLM 의미 통합 (turn 유발) |
| Mem0 | Token-Level Sequence (개별 사실) | Specialized Single-Engine (Vector DB) | Schema-Free | Semantic-Based | LLM 의미 통합 (tool-calling) |
| MEM1 | Token-Level Sequence | Transient In-Context Register | Raw Sequence Concatenation | Native Attention-Based | 용량 기반 물리 축출 |
| MemAgent | Token-Level Sequence | Transient In-Context Register | Raw Sequence Concatenation (재귀 요약) | Native Attention-Based | 용량 기반 물리 축출 (RL 덮어쓰기) |
Structural Topological 계열은 graph나 tree로 관계를 명시한다.
| 시스템 | 표현 | 저장 | 추출 | retrieval과 라우팅 | 유지 |
|---|---|---|---|---|---|
| MemTree | Graph and Tree (계층 tree) | Specialized Single-Engine (Vector DB) | Schema-Free (top-down 임베딩) | Semantic-Based (collapsed tree) | LLM 의미 통합 (재귀 집계) |
| Zep | Graph and Tree (temporal KG) | Specialized Single-Engine (Graph DB) | Schema-Constrained (triplet) | 다단 하이브리드 (dense + BM25 + BFS) | timestamp 다중 버전 (논리 무효화) |
| Mem0_g | Graph and Tree (라벨 그래프) | Heterogeneous Multi-Engine (Vector + Graph DB) | Schema-Constrained (entity-relation) | Topological Subgraph Traversal | timestamp 다중 버전 |
| Cognee | Graph and Tree (entity-relation triplet) | Heterogeneous Multi-Engine (Graph + Vector + Relational DB) | Schema-Constrained (Pydantic ECL 파이프라인) | Topological Subgraph Traversal (dense seed triplet 추출) | timestamp 다중 버전 (해시 중복 제거) |
Multi-Paradigm Hybrid 계열은 복합 객체와 여러 엔진을 함께 쓴다. 6개로 가장 많다.
| 시스템 | 표현 | 저장 | 추출 | retrieval과 라우팅 | 유지 |
|---|---|---|---|---|---|
| LightMem | Heterogeneous Composite (3분할 schema) | Specialized Single-Engine (Relational DB) | Schema-Free (entropy gate) | Semantic-Based | timestamp 다중 버전 (append-only 로그) |
| SimpleMem | Heterogeneous Composite | Heterogeneous Multi-Engine (Vector DB + BM25 + SQL) | Schema-Constrained | Autonomous Agentic (질의 확장) | LLM 의미 통합 (즉시 합성) |
| MemOS | Heterogeneous Composite (MemCube) | Heterogeneous Multi-Engine (Vector + Graph DB) | Schema-Constrained (의미 파서) | 다단 하이브리드 (Boolean + 의미) | timestamp 다중 버전 (차분 쓰기) |
| MemoryOS | Heterogeneous Composite (Segment-Page) | Heterogeneous Multi-Engine (키워드 인덱스 + Vector DB) | Schema-Constrained | 다단 하이브리드 (계층 라우팅) | 용량 기반 물리 축출 (Heat 기반) |
| A-MEM | Heterogeneous Composite (원자 노트) | Heterogeneous Multi-Engine (Vector + Graph DB) | Schema-Constrained (JSON 속성) | Topological Subgraph Traversal | LLM 의미 통합 (변형과 가지치기) |
| Letta | Heterogeneous Composite (컨텍스트 층) | Specialized Single-Engine (Relational DB) | Schema-Constrained | Autonomous Agentic (function calling) | 용량 기반 물리 축출 (큐 flush) |
이 표를 세로로 읽으면 계열 이름이 표현 방식에서 나왔음을 알 수 있다. Sequential Context는 전부 Token-Level Sequence이고 Structural Topological은 전부 Graph and Tree이며 Multi-Paradigm Hybrid는 전부 Heterogeneous Composite다. 반면 저장과 유지 선택은 계열 안에서도 갈린다. 같은 Structural Topological인데 Zep은 Graph DB 하나만 쓰고 Cognee는 세 엔진을 쓴다.
표현과 저장
논리 표현은 세 가지다.
| 표현 | 형태 | 사례와 세부 |
|---|---|---|
| Token-Level Sequence | 구조 추상 없는 1차원 시퀀스 | 이산 텍스트 토큰 쪽에서 Mem0는 이력에서 뽑은 개별 자연어 사실로 메모리를 분리하고 MemoChat은 여러 turn 대화를 topic, summary, raw turn을 담은 JSON 블록으로 구조화한다. MemAgent는 내부 belief 상태를 1,024 토큰 같은 상한 안의 텍스트로 제한하고 MEM1은 내부 상태 요약을 <IS> 같은 경계 태그로 감싼다. 잠재 vector 쪽에서는 Mem0가 사실을 dense 임베딩으로 두고 MemoRAG는 별도 초기화한 가중치 행렬로 raw 입력을 KV cache tensor로 압축한다 |
| Graph and Tree-Based Topology | 노드와 간선으로 관계를 명시 | Zep은 메모리를 episode, entity, community 하위 그래프로 나눈 temporal knowledge graph로 분할한다. Mem0_g는 정점이 entity이고 간선이 관계 triplet인 방향 라벨 그래프이며 entity 노드에 의미 타입과 dense 임베딩, 생성 timestamp를 덧붙여 temporal reasoning을 돕는다. MemTree는 텍스트 내용, dense 임베딩, 토폴로지 포인터, 깊이 스칼라를 담은 튜플을 노드로 하는 동적 방향 tree로, 깊은 leaf는 개별 사실을 조상 노드는 상위 요약을 유지하고 전용 root가 진입점이 된다 |
| Heterogeneous Composite | 비구조 텍스트와 구조화 metadata를 한 기능 단위로 묶는다 | MemOS의 MemCube가 plain-text, activation, parametric 세 payload와 ID 태그를 함께 담는 통합 데이터 객체다 |
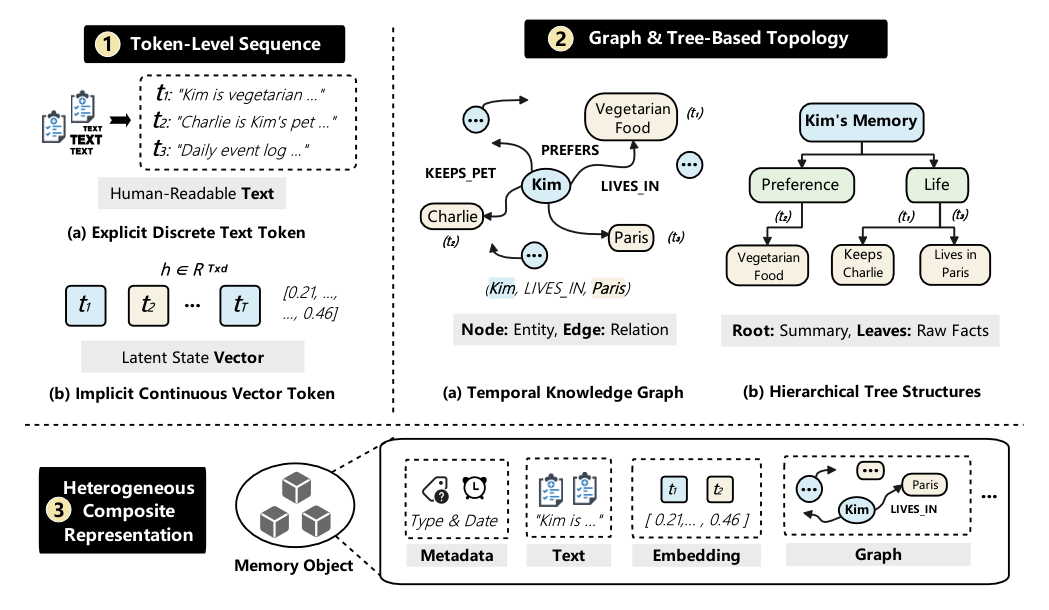
vector 토큰 표현의 교환 관계는 분명하다. 토큰화 부담을 줄이고 retrieval과 추론 파이프라인에 자연히 붙지만, 구조 해석 가능성을 잃고 술어 수준 필터링이나 특정 사실만 골라 갱신하는 세밀한 연산이 어렵다.
물리 저장도 세 가지로 갈린다.
| 저장 | 원리 | 사례 |
|---|---|---|
| Transient In-Context Register | 디스크 I/O와 외부 순회 지연을 없애려고 활성 하드웨어 상태 안에만 둔다 | MemoChat은 JSON 메모를 LLM 컨텍스트 입력에 유지하고, MemAgent는 요약 토큰을 dense 위치 임베딩으로 KV cache tensor에 직접 저장한다 |
| Specialized Single-Engine | 논리 구조에 맞춘 단일 백엔드에 넣는다 | Mem0와 MemTree는 vector store, Letta는 pgvector 확장을 붙인 PostgreSQL, Zep과 Mem0_g는 Cypher 질의로 Neo4j, LightMem은 관계형 엔진에 사실 스트림을 증분 append한다. raw 산출물을 파일이나 객체로 보존하는 방식도 같은 범주다 |
| Heterogeneous Multi-Engine | 여러 인덱스를 동시에 만들거나 이종 백엔드에 분산한다 | SimpleMem은 IVF-PQ를 쓰는 LanceDB에서 dense 임베딩, sparse BM25 인덱스, SQL 술어를 함께 유지한다. MemoryOS는 dense cosine 유사도와 이산 Jaccard 유사도를 융합한 인덱스를 쓰고, MemOS는 표준 adapter interface로 vector와 graph 데이터베이스를 묶는다 |
추출
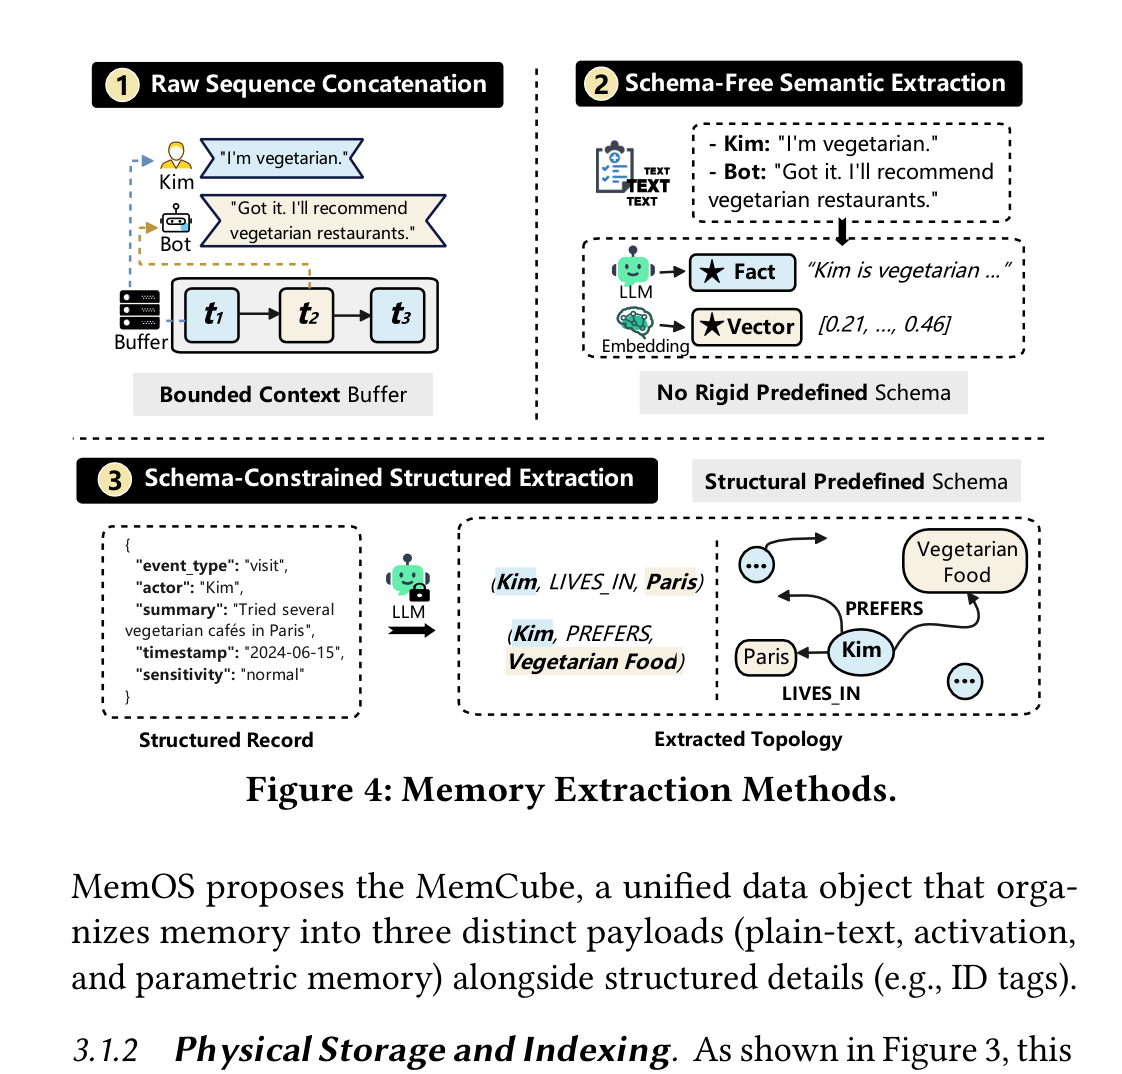
추출은 여러 turn 대화나 도구 실행 로그 같은 이질적 입력 스트림을 물리 저장 전에 논리 메모리 원시형으로 바꾸는 단계다.
| 방식 | 원리 | 사례 |
|---|---|---|
| Raw Sequence Concatenation | 추출 프롬프트를 건너뛰고 raw 토큰 연결이나 임시 상태 요약으로 만들어 계산 오버헤드를 최소화한다 | MEM1과 MemAgent가 2차 파싱 없이 활성 계산 상태 안에만 결과를 둔다 |
| Schema-Free Semantic Extraction | raw 입력을 독립적인 고가치 정보 단위로 추려내 자유 텍스트나 압축된 잠재 vector로 둔다 | Mem0가 상호작용을 파싱해 "사용자는 채식이고 유제품을 먹지 않는다" 같은 독립 사실 진술을 저장한다 |
| Schema-Constrained Structured Extraction | LLM에게 미리 정의한 구조 schema를 채우게 해 자유 텍스트가 아닌 엄격한 타입 데이터를 만든다 | Zep과 Mem0_g는 LIVES_IN, WORKS_AT 같은 타입 지정 방향 관계 간선을 뽑고, Zep은 reflection에서 착안한 검증 단계를 더해 환각 triplet을 억제한다. MemoChat은 대화를 엄격한 JSON schema로 분할해 데이터 예측 가능성을 확보한다 |
retrieval과 라우팅
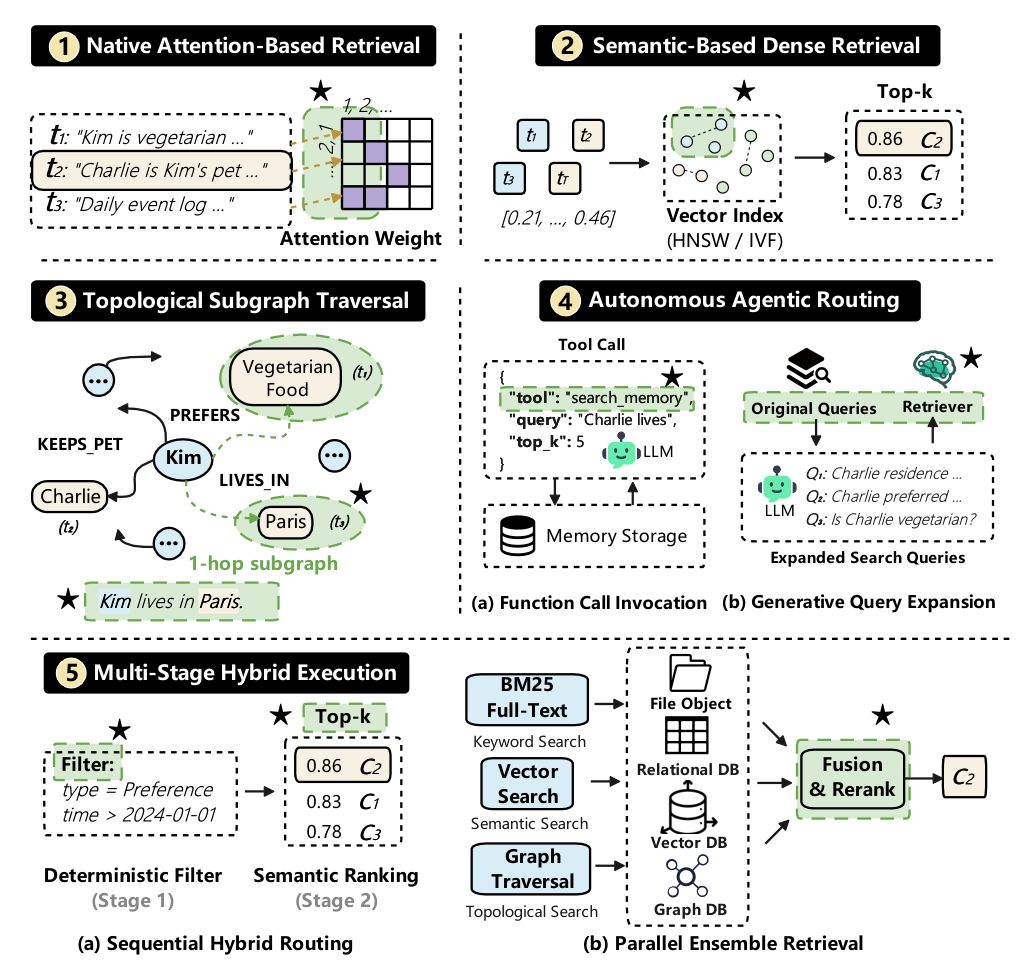
retrieval과 라우팅은 질의 컨텍스트에 맞는 메모리 부분집합을 골라 인덱스를 순회하는 함수다. 다섯 가지가 있고 이 모듈이 뒤에서 성능 차이를 가장 크게 만든다.
| 방식 | 원리 | 사례와 세부 |
|---|---|---|
| Native Attention-Based | 외부 DB I/O를 우회하고 Transformer의 계산 그래프 자체를 유일한 retrieval 엔진으로 쓴다 | MEM1은 현재 시퀀스 위에서 self-attention으로 암묵 retrieval을 수행하며 2차원 attention mask로 causal 일관성을 지킨다. MemAgent는 블록을 프롬프트 템플릿에 직접 이어 붙여 외부 cross-encoder reranking 없이 표준 attention 디코딩만으로 라우팅한다 |
| Semantic-Based Dense | 질의 tensor를 vector 인덱스에 맞춰 KNN 이웃을 뽑는다 | Mem0는 질의 임베딩으로 dense 유사도 탐색을 실행한다. LightMem은 반복 reranking을 생략하고 cosine 유사도 계산만 쓴다. MemTree는 계층을 수학적으로 펼치는 collapsed-tree 구조로 전체 후보에 대한 전역 cosine 유사도 분포를 계산한다 |
| Topological Subgraph Traversal | 관계 간선을 타고 knowledge graph에 구조적으로 근거한 의미 군집을 뽑는다 | Mem0_g는 entity 중심 heuristic으로 지역 하위 그래프를 재귀 순회하며 의미 triplet 평가를 동시에 진행한다. A-MEM은 dense KNN으로 후보 anchor를 고른 뒤 같은 개념 군집 안에서 지역 그래프 순회를 실행한다 |
| Autonomous Agentic Routing | retrieval을 LLM 자신에게 위임해 능동 질의 계획자로 쓴다 | Function Call Invocation 하위 형태는 명시적 함수 호출로 미리 정의한 DB 연산을 실행하며 Letta가 활성 컨텍스트를 평가해 archival_storage.search() 같은 호출을 스스로 생성한다. Generative Query Expansion 하위 형태는 자연어 생성으로 중간 단서를 합성하거나 복잡한 의도를 분해하며, SimpleMem의 Intent-Aware Retrieval Planning 모듈이 질의를 해부하고 적응적 탐색 깊이를 계산해 최적화된 질의 변형을 만든다 |
| Multi-Stage Hybrid Execution | 단일 패러다임의 recall 한계를 넘으려고 다중 엔진 파이프라인을 실행한다 | Sequential Hybrid Routing은 결정적 술어로 탐색 공간을 먼저 줄이고 세밀한 의미 추출을 뒤에 두며, MemoryOS가 거친 술어 평가 뒤 격리된 segment 안에서만 세밀한 의미 순위를 매기는 연합 라우팅을 실행한다. Parallel Ensemble Retrieval은 여러 인덱스에 질의를 동시에 보내고 후단에서 융합과 reranking을 하며, Zep이 cosine 의미 스캔과 Okapi BM25 전문 탐색, 토폴로지 BFS를 동시에 실행한 뒤 RRF와 MMR, cross-encoder로 정밀도를 높인다 |
유지
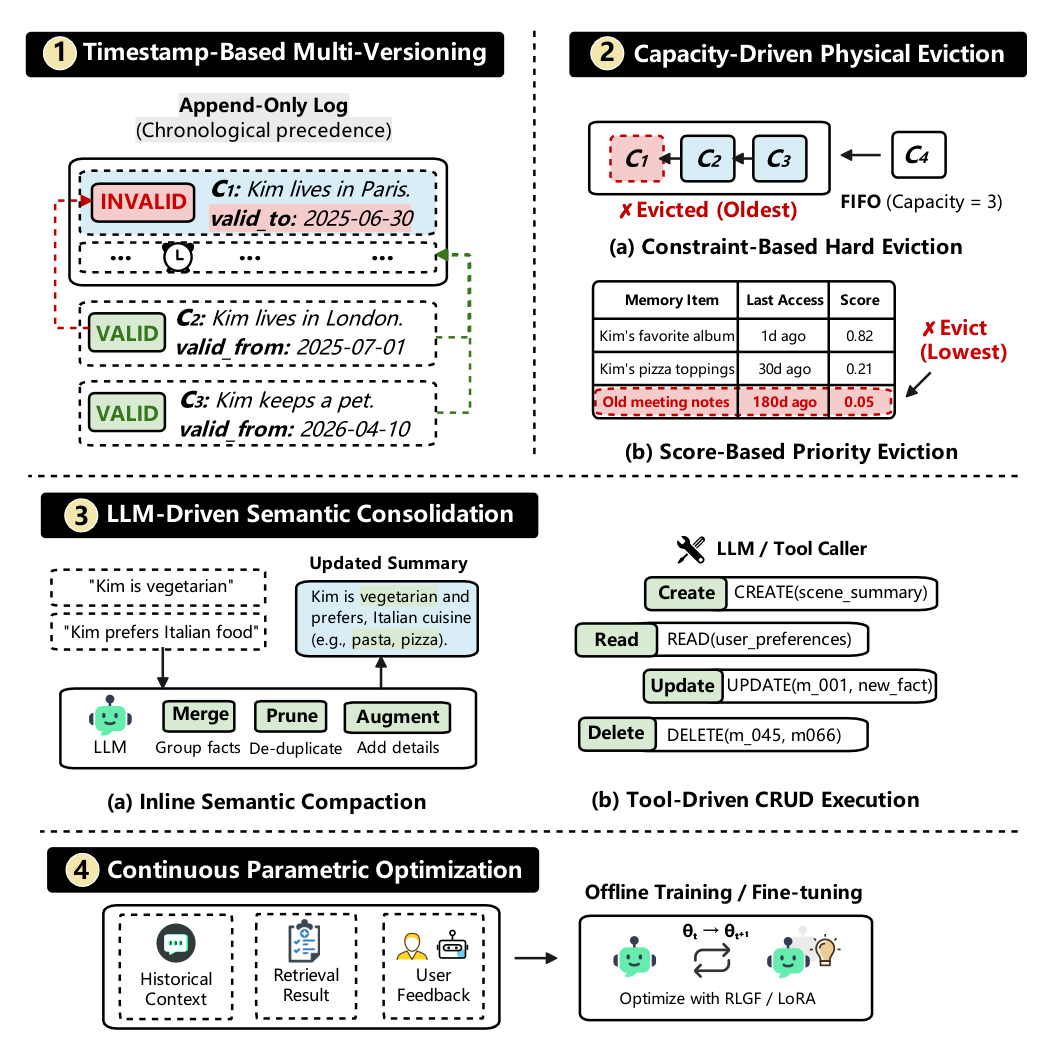
유지는 메모리 항목의 동적 수명을 관리하는 규칙이다. 2절의 정의는 충돌 해소와 버전 관리, 용량 관리, 의미 통합 세 하위 연산으로 쪼개지만, 3절 taxonomy는 방법 계열을 네 가지로 열거한다. 네 번째인 Continuous Parametric Optimization은 정의에는 없고 Figure 6과 taxonomy 서술에만 등장한다.
| 방식 | 원리 | 사례와 세부 |
|---|---|---|
| Timestamp-Based Multi-Versioning | 물리 행 삭제 대신 timestamp metadata와 append-only 로그로 만료 사실을 논리적으로 폐기한다. 옛 사실을 지우지 않고 유효 플래그와 timestamp로 지금은 맞지 않는다는 표시만 남겨 이력을 보존하는 방식이다 | Zep과 Mem0_g가 낡거나 모순되는 관계를 유효 플래그와 timestamp로 논리 무효 처리한다. LightMem은 timestamp가 붙은 사실 스트림을 증분 삽입하고, SimpleMem은 ISO-8601 timestamp의 시간 순서 우선으로 모순을 해소한다. MemOS는 구조화된 Update API로 차분 쓰기를 실행해 provenance ID를 갱신하며 다중 버전 체인을 만든다 |
| Capacity-Driven Physical Eviction | 무한 성장을 막으려고 데이터를 물리적으로 버리거나 무조건 덮어쓴다 | Constraint-Based Hard Eviction은 FIFO 큐나 고정 시퀀스 경계, 토큰 상한 같은 결정적 규칙을 쓴다. MemAgent는 고정 segment 경계마다 낡은 시퀀스를 새 요약 블록으로 대체하고, MEM1은 활성 컨텍스트 임계를 넘으면 자동 FIFO 정리로 낡은 태그를 축출하며, Letta는 OS에서 착안한 큐 관리자로 토큰 수가 종단 한계를 넘으면 flush로 낡은 메시지를 2차 recall 저장으로 내린다. Score-Based Priority Eviction 쪽에서는 MemoryOS가 retrieval 빈도와 지수 시간 감쇠를 저울질하는 Heat score로 segment 활력을 재고 점수가 가장 낮은 segment를 축출한다 |
| LLM-Driven Semantic Consolidation | LLM이 논리 충돌을 해소하고 중복 관찰을 dense 요약으로 추상화한다 | Inline Semantic Compaction은 쓰기 단계에서 트랜잭션 커밋 전에 중복 주장을 합치며, SimpleMem이 온라인 의미 합성을 실행하고 MemTree가 모든 부모 노드에 재귀 요약 프롬프트를 걸어 과거 상태와 새 payload를 융합한다. Tool-Driven CRUD Execution은 LLM이 도구 interface로 Create, Read, Update, Delete를 명시 실행하며 Mem0가 이 방식으로 UPDATE와 DELETE를 수행한다 |
| Continuous Parametric Optimization | 상태 갱신을 온라인 추론 지연과 분리하고 외부 DB schema가 아니라 모델 파라미터를 비동기 배경 작업으로 수정한다 | MemoRAG는 활성 추론 토큰을 읽기 전용으로 고정하고 오프라인 학습 단계에서만 Reinforcement Learning with Generation Feedback(RLGF)으로 추출 품질을 최적화한다 |
실험 설계
다섯 연구 질문
평가는 5개 워크로드와 11개 데이터셋에서 12개 대표 메모리 시스템과 reference baseline 2종(Long Context, Embedding RAG)을 대상으로 한다. 시간 오버헤드 추적까지 통일한 테스트베드를 썼다.
| RQ | 질문 | 벤치마크와 지표 | 대상 수 |
|---|---|---|---|
| RQ1 | 메모리 시스템이 워크로드 전반에서 end-to-end 태스크 성능을 실제로 올리는가 | LoCoMo(EM, Answer F1), LongMemEval(Substring EM, ROUGE-L F1, ROUGE-L Recall, LLM Judge Acc.), DB-Bench(EM, Task Success Rate) | 12개 시스템 |
| RQ2 | 질의가 요구하는 저장 근거를 얼마나 정확히 띄우는가 | LoCoMo Recall@1/@5/@10과 evidence distance gap 6구간 Recall@10 | 8개 시스템 |
| RQ3 | 수정된 사실을 흡수하고 갱신 후 올바른 시간 상태를 답하며 backbone이 바뀌어도 강건한가 | LongMemEval knowledge update와 temporal reasoning, LoCoMo temporal 구간, backbone 4종 ablation | 11개 시스템 |
| RQ4 | 유효 메모리 지평이 길어질 때 얼마나 안정적인가 | LongBench context 길이 3구간, LongMemEval 누적 세션 수 4구간, LoCoMo evidence distance 6구간 | 12개 시스템 |
| RQ5 | 효용과 지연의 교환 관계, 워크로드별 지연 비용은 얼마인가 | Avg. Operation Latency/Query, Normalized Utility, Outlier-Filtered Avg. Total Latency/Query | 8개 시스템 |
지표 몇 가지는 뜻을 짚어 둘 필요가 있다. LongMemEval의 LLM Judge Accuracy는 GPT-5.4를 심판으로 써 의미가 같은 답을 정답으로 인정한다. evidence distance gap은 질의가 속한 마지막 세션과 그 답을 뒷받침하는 가장 이른 근거 사이의 세션 거리이고 15부터 2631까지 6구간으로 나눈다. Normalized Utility는 LoCoMo와 LongMemEval의 답 품질 지표 6개를 min-max 정규화해 평균한 값이다. Avg. Operation Latency/Query는 메모리 구축 시간과 질의 시간을 더해 질의 하나당 상각 비용으로 해석한 값이다.
커버리지 차이
수치를 읽을 때 주의할 점이 있다. taxonomy에 오른 14개 시스템 가운데 MEM1과 Mem0_g는 4절 이후의 성능 그림에 등장하지 않는다. 실제로 성능이 보고된 시스템은 12개다. MemAgent도 LongMemEval 4개 지표에만 나오고 LoCoMo와 DB-Bench 패널에는 없다. RQ별 대상 수가 8개에서 12개로 다른 이유도 여기 있다.
결과
태스크 효과성
O1(Cross-Workload Effectiveness)은 모든 워크로드를 지배하는 단일 시스템은 없지만, 구조로 유도한 필터링으로 태스크에 결정적인 근거를 보존하는 방법이 전반에서 가장 경쟁력 있다고 정리한다.
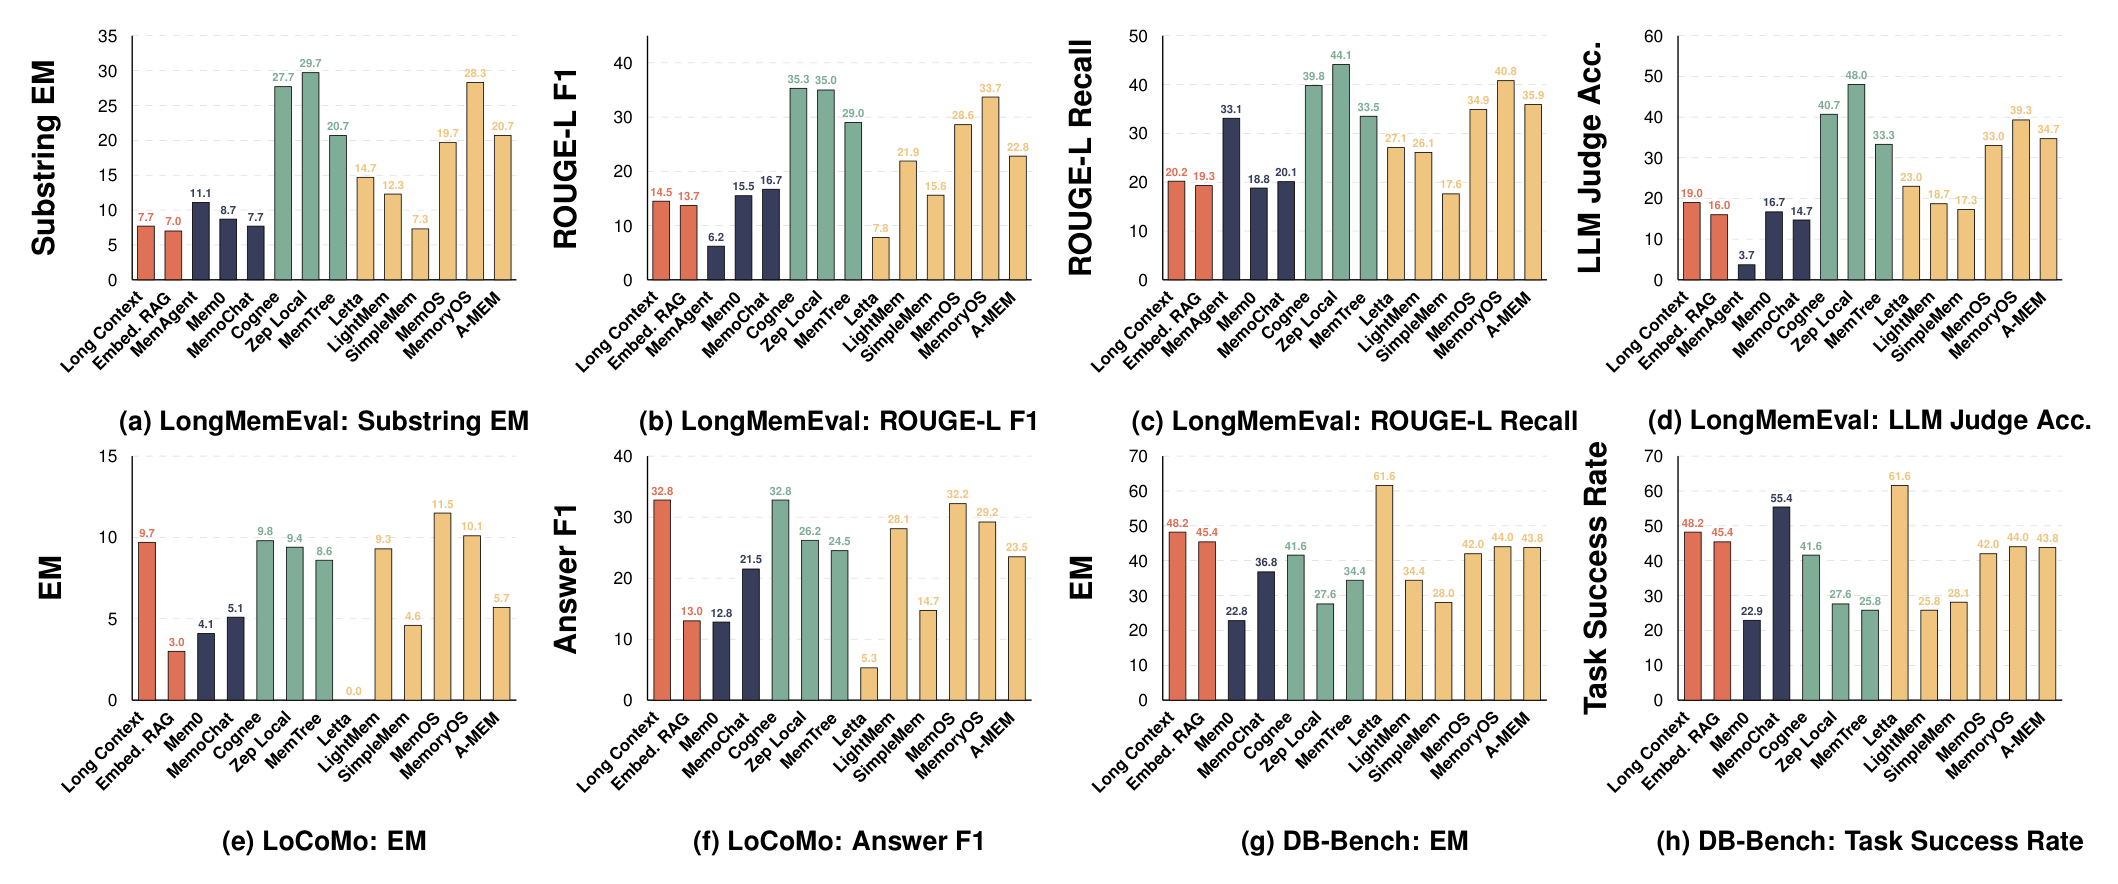
LongMemEval 4개 지표 전체를 옮기면 계열별 격차가 보인다.
| 시스템 | Substring EM | ROUGE-L F1 | ROUGE-L Recall | LLM Judge Acc. |
|---|---|---|---|---|
| Long Context (baseline) | 7.7 | 14.5 | 20.2 | 19.0 |
| Embedding RAG (baseline) | 7.0 | 13.7 | 19.3 | 16.0 |
| MemAgent | 11.1 | 6.2 | 33.1 | 3.7 |
| Mem0 | 8.7 | 15.5 | 18.8 | 16.7 |
| MemoChat | 7.7 | 16.7 | 20.1 | 14.7 |
| Cognee | 27.7 | 35.3 | 39.8 | 40.7 |
| Zep Local | 29.7 | 35.0 | 44.1 | 48.0 |
| MemTree | 20.7 | 29.0 | 33.5 | 33.3 |
| Letta | 14.7 | 7.8 | 27.1 | 23.0 |
| LightMem | 12.3 | 21.9 | 26.1 | 18.7 |
| SimpleMem | 7.3 | 15.6 | 17.6 | 17.3 |
| MemOS | 19.7 | 28.6 | 34.9 | 33.0 |
| MemoryOS | 28.3 | 33.7 | 40.8 | 39.3 |
| A-MEM | 20.7 | 22.8 | 35.9 | 34.7 |
Zep이 LLM Judge Accuracy 48.0%로 최고이고 Cognee가 ROUGE-L F1 35.3%로 최고다. 최저는 MemAgent로 LLM Judge Accuracy 3.7%에 그친다. MemAgent는 ROUGE-L Recall 33.1%로 중위권인데 F1과 Judge 정확도가 최저라는 조합이 나오는데, 긴 답을 내면서 정답 문구를 포함하기는 하지만 정밀도가 낮다는 뜻이다.
LoCoMo와 DB-Bench는 다른 시스템이 앞선다.
| 시스템 | LoCoMo EM | LoCoMo Answer F1 | DB-Bench EM | DB-Bench Task Success Rate |
|---|---|---|---|---|
| Long Context (baseline) | 9.7 | 32.8 | 48.2 | 48.2 |
| Embedding RAG (baseline) | 3.0 | 13.0 | 45.4 | 45.4 |
| Mem0 | 4.1 | 12.8 | 22.8 | 22.9 |
| MemoChat | 5.1 | 21.5 | 36.8 | 55.4 |
| Cognee | 9.8 | 32.8 | 41.6 | 41.6 |
| Zep Local | 9.4 | 26.2 | 27.6 | 27.6 |
| MemTree | 8.6 | 24.5 | 34.4 | 25.8 |
| Letta | 0.0 | 5.3 | 61.6 | 61.6 |
| LightMem | 9.3 | 28.1 | 34.4 | 25.8 |
| SimpleMem | 4.6 | 14.7 | 28.0 | 28.1 |
| MemOS | 11.5 | 32.2 | 42.0 | 42.0 |
| MemoryOS | 10.1 | 29.2 | 44.0 | 44.0 |
| A-MEM | 5.7 | 23.5 | 43.8 | 43.8 |
LoCoMo의 정확 일치에서는 하이브리드 필터링이 가장 강해 MemOS가 EM 11.5%로 최고다. DB-Bench에서는 실행 흔적을 보존하는 메모리가 가장 강해 Letta가 EM과 Task Success Rate 모두 61.6%로 최고이고, MemoChat이 Task Success Rate 55.4%로 두 번째다. Letta는 LongMemEval ROUGE-L F1 7.8%와 LoCoMo EM 0.0%로 대화형 QA에서는 매우 낮은데 DB-Bench에서만 최고라는 극단적 편차를 보인다. 워크로드 전체를 커버하는 방법 가운데는 MemoryOS와 MemOS가 종합 frontier에 가장 가깝다.
Finding 1(Workload-Aligned Memory)은 이를 세 지침으로 요약한다. 세션을 넘어 흩어진 추론에는 관계와 시간을 아는 retrieval이 가장 효과적이고(Zep, Cognee), 길지만 의미가 이어지는 대화에는 거친 단계에서 세밀한 단계로 내려가는 필터링이 정확한 grounding을 돕고(MemOS, MemoryOS), 상태를 다루는 실행에는 상호작용 흔적 보존이 정확한 어휘 일치보다 중요하다(Long Context).
EM 지표의 한계
O2(Beyond Exact Match)는 지표 선택 자체를 다룬다. EM은 답이 짧고 정형이며 지역적으로 검증되는 태스크에 여전히 유효하다. LoCoMo의 장소 이름이나 물건 속성처럼 짧게 근거를 짚는 질문이 그렇고, 실제로 MemOS가 그 지표에서 최고다.
반면 정답이 다른 표현으로 나오거나 실행 성공에 달린 태스크에서는 부족하다. LongMemEval에서는 ROUGE-L과 LLM Judge Accuracy를 함께 보면 강한 시스템이 더 분명히 갈린다. 세션을 넘는 추론이 하나의 정형 표면형으로 수렴하지 않기 때문이다. DB-Bench는 더 뚜렷하다. Long Context가 EM 48.2%로 최고지만 MemoChat이 Task Success Rate 55.4%로 훨씬 높다. 출력 문자열이 정확히 일치하는지가 메모리가 실행을 성공시켰는지를 다 담지 못한다는 뜻이다.
retrieval 충실도
RQ2는 답 생성과 분리해 근거 수준 retrieval만 잰다. LoCoMo가 질의별로 출처 수준 정답 근거를 제공하기 때문에 가능한 측정이다.
| 시스템 | Recall@1 | Recall@5 | Recall@10 |
|---|---|---|---|
| Embedding RAG (baseline) | 3.8 | 16.0 | 17.7 |
| Mem0 | 15.2 | 28.3 | 40.2 |
| Zep | 12.3 | 52.5 | 66.2 |
| MemTree | 24.8 | 59.7 | 80.5 |
| LightMem | 13.3 | 34.7 | 56.4 |
| SimpleMem | 39.0 | 64.6 | 75.1 |
| MemOS | 27.6 | 55.4 | 70.6 |
| MemoryOS | 23.6 | 46.9 | 61.3 |
| A-MEM | 31.3 | 69.5 | 85.9 |
SimpleMem이 Recall@1 39.0%로 가장 높다. 그런데 retrieval 예산이 커지면 순위가 바뀐다. A-MEM은 Recall@5 69.5%, Recall@10 85.9%로 두 지표 모두 최고이고 MemTree는 Recall@10 80.5%로 SimpleMem의 75.1%를 앞선다. 다만 Recall@5에서는 SimpleMem 64.6%가 MemTree 59.7%보다 여전히 높으므로 MemTree의 역전은 Recall@10 구간에서 일어난다.
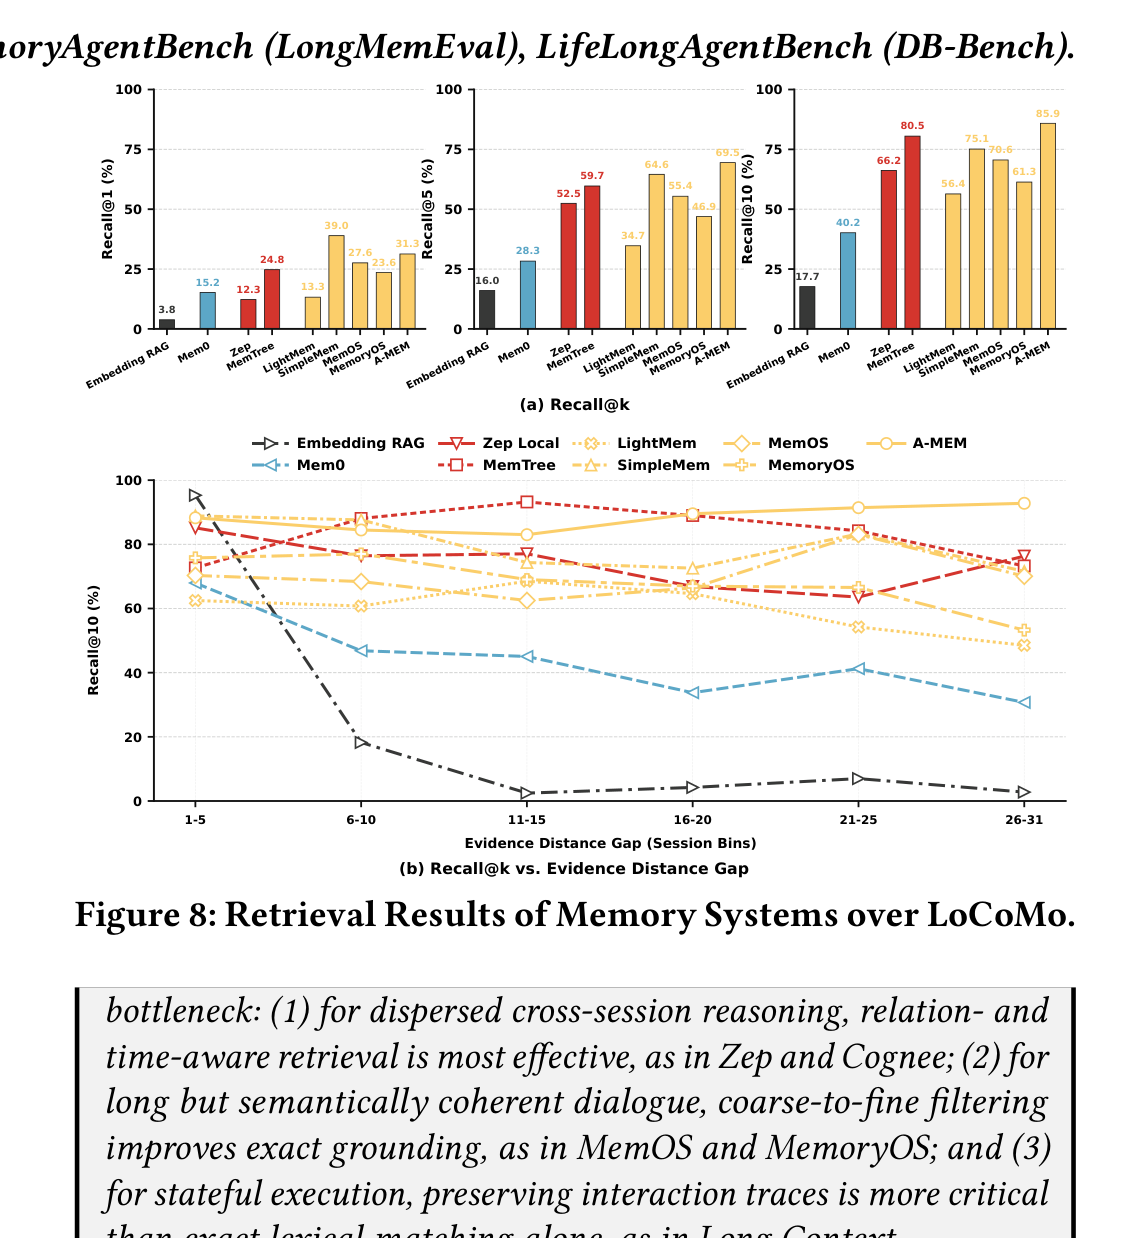
거리에 따른 변화가 더 중요하다. 아래 그래프에서 Embedding RAG는 가장 짧은 15 구간에서는 90%를 넘지만 610 구간에서 약 18%로 크게 하락하고 1115 구간 이후로는 10% 아래에 머문다. Mem0도 약 68%에서 약 31%까지 내려간다. 반면 A-MEM은 6구간 전체에서 80%대 이상을 유지하며 가장 먼 2631 구간에서 오히려 가장 높다.
논문은 이를 근거 완성 문제로 부른다. 필요한 근거가 낡거나 흩어져 있거나 여러 turn에 걸쳐 있을 수 있어서 top-1 순위 문제로 환원되지 않는다는 것이다. 세 가지 retrieval 행태가 갈린다.
- 압축 지향 메모리는 매우 관련도 높은 항목 하나를 일찍 띄우는 데 효과적이다. 두드러진 개인 정보 하나나 최근 대화 사실이 그 예다.
- 연결이나 계층 조직은 순위 결과 전반에서 서로 보완하는 근거를 모으는 데 낫다. 다른 세션에서 언급된 반려동물 이름과 날짜가 붙은 사건을 함께 모으는 경우다.
- 평평한 dense retrieval은 필요한 근거가 현재 컨텍스트와 가까울 때만 경쟁력이 있다.
Finding 2(Evidence-Centric Memory Organization)는 초기 위치 파악과 근거 조립을 별개 설계 목표로 다루라고 말한다. 연결이나 계층 같은 명시적 구조는 근거가 흩어져 있거나 시간적으로 멀 때 가장 값이 크다.
갱신 강건성
RQ3은 실험을 둘로 나눈다. 첫째는 사실 수정을 흡수하는지 보는 Update Robustness Comparison이고 둘째는 LLM backbone만 바꿔도 동작이 유지되는지 보는 Backbone Robustness Ablation이다.
| 시스템 | LoCoMo Temporal EM | LoCoMo Temporal Answer F1 | Knowledge Update Substring EM | Knowledge Update ROUGE-L F1 | Temporal Reasoning Substring EM | Temporal Reasoning ROUGE-L F1 |
|---|---|---|---|---|---|---|
| Long Context (baseline) | 8.1 | 26.9 | 20.0 | 18.0 | 12.0 | 24.0 |
| Embedding RAG (baseline) | 1.6 | 7.9 | 20.0 | 17.8 | 10.7 | 22.7 |
| Mem0 | 3.2 | 6.0 | 15.6 | 17.1 | 10.7 | 22.4 |
| MemoChat | 2.4 | 15.4 | 8.9 | 12.9 | 10.7 | 25.3 |
| Cognee | 4.0 | 28.1 | 37.8 | 34.0 | 18.7 | 35.8 |
| Zep | 4.8 | 18.1 | 44.4 | 36.8 | 13.3 | 30.5 |
| MemTree | 5.6 | 18.6 | 31.1 | 30.6 | 8.0 | 29.9 |
| Letta (MemGPT) | 0.0 | 7.1 | 17.8 | 5.7 | 12.0 | 8.8 |
| LightMem | 4.0 | 20.1 | 15.6 | 20.2 | 12.0 | 28.6 |
| SimpleMem | 4.4 | 8.1 | 6.7 | 7.4 | 8.0 | 22.6 |
| MemOS | 8.9 | 28.0 | 28.9 | 30.5 | 12.0 | 31.1 |
| MemoryOS | 3.2 | 22.7 | 35.6 | 32.2 | 16.0 | 31.6 |
| A-MEM | 4.8 | 17.7 | 26.7 | 22.8 | 8.0 | 22.5 |
O4(Temporal State Externalization)는 갱신 관련 구간에서도 지배자가 없다고 정리한다. 세 구간의 선두가 각기 다르다.
- 직접 사실 수정에는 그래프와 관계로 조직한 메모리가 가장 강하다. Zep이 knowledge update에서 Substring EM 44.4%, ROUGE-L F1 36.8%로 앞선다.
- 시간적으로 흩어진 근거에는 관계형 retrieval이 가장 강하다. Cognee가 temporal reasoning에서 Substring EM 18.7%, ROUGE-L F1 35.8%로 앞선다.
- 최신 상태의 정확한 grounding에는 하이브리드 필터가 강하다. MemOS가 LoCoMo temporal EM 8.9%로 최고이고 Cognee가 Answer F1 28.1%로 최고다.
구간 전체를 커버하는 방법 가운데는 Cognee와 MemOS, MemoryOS가 종합 frontier에 가장 가깝다. 수명 관리가 없는 시스템은 낡은 사실을 그대로 돌려주며 논문은 이를 "hallucinations of the past"로 부른다. SimpleMem의 knowledge update Substring EM 6.7%가 그 사례다. 시간 순서 우선 규칙만으로 모순을 해소하려 하면 표적 덮어쓰기에 약하다.
backbone 교체
두 번째 실험은 5개 설정을 LLM backbone 4종 아래에서 본다. Qwen3-8B, DeepSeek-Chat, GPT-5.4-mini, GPT-5.4다.
| 설정 | Qwen3-8B | DeepSeek-Chat | GPT-5.4-mini | GPT-5.4 |
|---|---|---|---|---|
| Embedding RAG | 13.0 | 17.9 | 20.1 | 19.2 |
| LightMem | 28.1 | 36.0 | 37.4 | 33.2 |
| MemOS | 32.2 | 41.2 | 38.6 | 41.2 |
| MemTree | 24.5 | 28.9 | 28.9 | 28.4 |
| A-MEM | 23.5 | 28.5 | 32.5 | 32.6 |
O5(Backbone Robustness)는 backbone 변경이 절대 답 품질은 바꾸지만 어느 파이프라인이 효과적인지는 거의 바꾸지 않는다고 본다. MemOS는 네 backbone 모두에서 메모리 기반 설정 가운데 최고다. 유일한 주목할 역전은 지역적이다. A-MEM이 GPT-5.4-mini와 GPT-5.4에서 각각 32.5%와 32.6%로 MemTree의 28.9%와 28.4%를 넘어선다. 날짜에 근거한 최신 상태 질의에서 MemOS는 네 backbone 모두에서 정답을 유지하고 Embedding RAG는 모두에서 틀린다.
같은 그림의 Recall 패널이 이유를 보여 준다. Embedding RAG는 backbone과 무관하게 17.7%로 고정이고 LightMem도 56.4%로 고정이다. 두 시스템의 retrieval에 LLM이 개입하지 않기 때문이다. 반면 MemOS는 70.6%에서 79.9%, 57.6%, 80.1%로 흔들려 LLM이 관여하는 라우팅이 backbone에 민감함을 보인다.
Finding 3(Temporal Update Fidelity)은 갱신 후 동작의 신뢰성이 모델 용량 문제가 아니라 파이프라인 설계 문제라고 결론한다. revisability를 표현 단계에 심어 나중 사실이 같은 entity나 event에 묶이게 하고, 질의 시 선택성을 워크로드 병목에 맞추고, LLM 스케일은 grounding이 성공한 뒤 답 표현을 다듬는 데 쓰라는 것이다.
장기 지평 안정성
RQ4는 유효 메모리 지평을 세 방식으로 늘려 본다. context 길이를 늘리고, 누적 세션 수를 늘리고, 근거까지의 거리를 늘린다.
| 관점 | 벤치마크와 구간 | 관찰된 변화 |
|---|---|---|
| context 길이 | LongBench Short, Medium, Long | SimpleMem은 Short에서 Medium으로 갈 때 Accuracy 35.2%에서 34.9%로 거의 변하지 않지만 Long Context는 42.6%에서 19.0%로 크게 하락한다 |
| 누적 세션 수 | LongMemEval 38 |
세션 사이 구조를 보존하는 방법이 긴 이력에서 같은 우위를 보인다 |
| 근거 거리 | LoCoMo evidence distance 6구간 | Embedding RAG는 Answer F1이 37.1%에서 7.4%로 내려가고 Cognee, MemOS, MemoryOS는 같은 구간에서 훨씬 높게 유지된다 |
O6(Long-Horizon Evidence Preservation)은 명시적 관계 연결이나 계층 통합으로 근거를 조직할 때 긴 지평에서 더 안정적이라고 본다. 프롬프트를 키우는 것만으로는 긴 입력에 distractor가 쌓이면 답 품질이 유지되지 않는다. LongBench에서 Long Context가 42.6%에서 19.0%로 내려가는 것이 그 증거다.
긴 지평의 어려움은 메모리 용량이 아니라 표현이 먼 사실을 답에 필요한 추상과 연결해 두는지에 있다. 그래프나 시간으로 조직한 메모리는 먼 사실의 entity와 event, time 관계를 보존한다. 여러 세션 전의 반복된 개인 사건을 되찾는 경우가 그렇다. 계층이나 요약 우선 조직은 세션 수준 구조를 보존해 관련 세션을 먼저 찾은 뒤 지역 세부를 해소하게 하며, 그 덕에 LLM이 최종 생성 전에 주의를 좁힐 수 있다. 순수 long-context 프롬프팅과 평평한 dense 메모리는 둘 중 어느 지지도 제공하지 못한다.
여기서 논문은 반직관적인 결과 하나를 덧붙인다. 시간 의존 질의에서는 raw long-context retrieval이 대다수 메모리 기반 접근을 앞선다. 표준 의미 통합이 결정적인 시간 순서 단서를 훼손하기 때문이다. 뒤에 나오는 유지 ablation에서 Long Context가 Substring EM 최고를 기록하는 것과 같은 현상이다.
Finding 4(Horizon-Structured Memory)는 지평이 길어질 때 과제가 더 많은 이력을 저장하는 문제에서 그 위의 올바른 추상을 고르는 문제로 옮겨간다고 정리한다. 다중 관점 필터링은 distractor가 많은 긴 입력에 도움이 되고(SimpleMem), 관계를 아는 인덱싱은 근거가 여러 turn이나 세션으로 떨어져 있을 때 도움이 되고(Cognee, Zep), 거친 단계에서 세밀한 단계로 내려가는 요약은 관련 세션을 먼저 찾아야 할 때 도움이 된다(MemOS, MemoryOS).
운영 비용
RQ5가 데이터베이스 관점의 기여가 가장 뚜렷한 절이다. 기존 평가가 재지 않던 지연을 통일 추적으로 잰다.
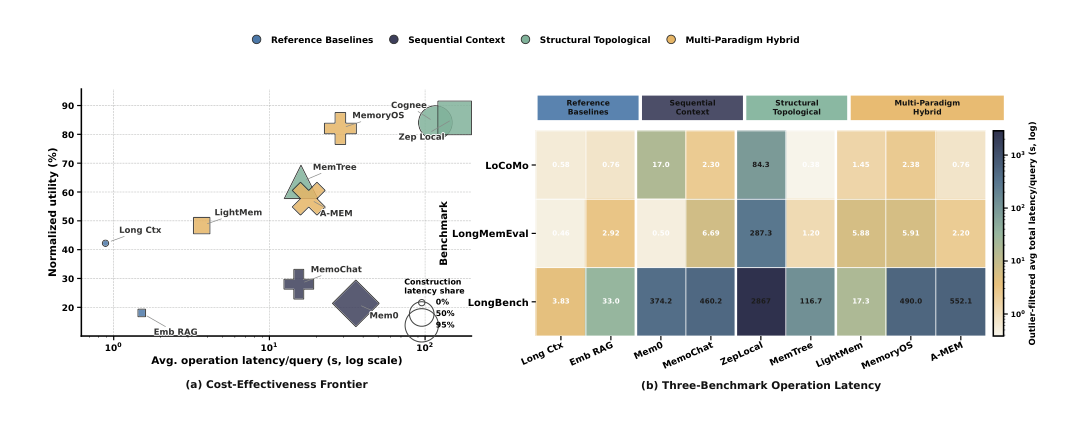
효용과 지연 frontier를 옮기면 다음과 같다.
| 시스템 | 질의당 평균 연산 지연 | Normalized Utility |
|---|---|---|
| LightMem | 3.67초 | 48.3% |
| MemoChat | 15.4초 | 28.0% |
| MemTree | 15.9초 | 63.5% |
| A-MEM | 17.9초 | 57.7% |
| MemoryOS | 28.6초 | 82.0% |
| Mem0 | 35.9초 | 21.4% |
| Cognee | 116.5초 | 84% 초과 |
| Zep | 155.1초 | 84% 초과 |
LightMem과 MemTree가 가장 강한 효율 frontier를 차지한다. 둘은 MemoChat과 Mem0, A-MEM보다 분명히 효율적이다. 효용이 더 높은 구조화 시스템은 비용 쪽으로 크게 이동한다. MemoryOS는 28.6초에서야 82.0%에 이르고 Cognee와 Zep은 각각 116.5초와 155.1초를 지나서야 84%를 넘는다.
워크로드별 지연을 보면 분리가 더 선명하다. 아래는 질의당 총 지연을 이상치 제거 후 평균한 값이다.
| 시스템 | LoCoMo | LongMemEval | LongBench |
|---|---|---|---|
| Long Context (baseline) | 0.58초 | 0.46초 | 3.83초 |
| Embedding RAG (baseline) | 0.76초 | 2.92초 | 33.0초 |
| Mem0 | 17.0초 | 0.50초 | 374.2초 |
| MemoChat | 2.30초 | 6.69초 | 460.2초 |
| Zep Local | 84.3초 | 287.3초 | 2,867초 |
| MemTree | 0.38초 | 1.20초 | 116.7초 |
| LightMem | 1.45초 | 5.88초 | 17.3초 |
| MemoryOS | 2.38초 | 5.91초 | 490.0초 |
| A-MEM | 0.76초 | 2.20초 | 552.1초 |
LongBench 열의 격차가 극단적이다. LightMem은 17.3초를 유지하고 MemTree는 116.7초인데 Mem0와 MemoChat, MemoryOS, A-MEM은 374.2초에서 552.1초로 올라가고 Zep Local은 질의당 2,867초에 이른다. 약 48분이 질의 하나에 들어가는 셈이다.
O7(Localized Maintenance)은 운영 효율을 정하는 것이 구조를 쓰는지 여부가 아니라 쓰기 한 번이 그 구조를 얼마나 넓게 전파하는지라고 본다. segment 압축과 제한된 하이브리드 retrieval이 LightMem을 저비용 영역에 두고, 경로에 국소적인 tree 집계가 MemTree가 전역 갱신 없이 효용을 상당히 지키게 한다. 반면 그래프 전역 통합과 다중 store 동기화, 메모리 전체 재작성은 조직력은 높이지만 메모리가 커질수록 가장 무거운 비용을 부과한다.
Finding 5(Operational Scaling Rule)는 효율이 구조 자체가 아니라 유지 범위에 좌우된다고 정리한다. 지역적 갱신과 탐색이 가장 좋은 비용 대 효용 균형을 주고, 풍부한 조직은 그 유지가 전역 재계산을 피할 때만 도움이 되며, long-context 워크로드에서는 메모리 전체 조정이 지배적 비용 요인이 된다.
모듈별 ablation
5절은 앞의 end-to-end 차이가 어느 모듈에서 나오는지 본다. 한 번에 한 모듈만 바꾼 통제 변형을 만들어 비교하는 방식이다.
표현과 저장
LightMem을 세 변형으로, MemTree를 두 설정으로, Mem0를 두 저장 방식으로 비교한다. LightMem의 User-Only Raw는 사용자 발화를 그대로 저장하고, User-Only Summary는 세션마다 LLM 추상 요약으로 다시 쓰고, User-Only Compressed는 원 표현과 사실 내용을 지키면서 채움말과 중복 토큰만 제거한다.
| 시스템 | 변형 | LoCoMo EM | LoCoMo Ans. F1 | LongMemEval Substr. EM | LongMemEval ROUGE-L F1 |
|---|---|---|---|---|---|
| LightMem | User-Only Raw | 24.2 | 38.9 | 26.0 | 31.4 |
| LightMem | User-Only Summary | 8.5 | 15.6 | 11.7 | 17.4 |
| LightMem | User-Only Compressed | 23.6 | 38.6 | 10.7 | 19.1 |
| MemTree | Flat-biased | 18.2 | 30.7 | 23.0 | 29.9 |
| MemTree | Deeper Tree | 18.7 | 31.2 | 23.3 | 30.9 |
| Mem0 | Default | 3.2 | 6.2 | 9.3 | 16.5 |
| Mem0 | Graph Store | 3.0 | 6.5 | 8.3 | 15.9 |
O8(Content Fidelity)은 원 대화 내용을 유지하는 것이 추상이나 계층을 더하는 것보다 중요하다고 결론한다. User-Only Raw가 네 지표 전부에서 최고다. 흥미로운 지점은 User-Only Compressed의 비대칭이다. LoCoMo에서는 Raw에 거의 붙지만(Answer F1 38.6% 대 38.9%, EM 23.6% 대 24.2%) LongMemEval Substring EM은 10.7%로 Raw의 26.0%에서 크게 내려간다. 가벼운 압축은 주된 의미가 남아 있어 조합 추론은 지지하지만 정확한 세부 일치에는 신뢰할 수 없다는 뜻이다. 두 이전 사건을 연결하는 일은 되어도 정확한 날짜나 이름을 되찾는 일은 안 된다.
Deeper Tree는 Flat-biased 대비 개선이 미미하다. 계층을 깊게 하면 조직은 나아지지만 표현 단계에서 제거된 정보를 되살리지는 못한다. 부모 노드가 관련 세션으로 안내해 주기는 해도 빠진 세부를 복구해 주지는 않는다. Mem0의 Graph Store 변형은 Default보다 오히려 낮다.
Finding 6(Representation Granularity)은 메모리를 더 압축하거나 더 구조화하는 것보다 쓸 수 있는 근거를 보존하는 것이 중요하다고 정리한다.
추출
MemoChat의 topic 분할 방식, MemOS의 memorize 세밀도, LightMem의 대화 turn 범위를 비교한다. LightMem의 Hybrid Raw는 사용자 turn만이 아니라 assistant turn까지 raw로 담는다.
| 시스템 | 변형 | LoCoMo EM | LoCoMo Ans. F1 | LongMemEval Substr. EM | LongMemEval ROUGE-L F1 |
|---|---|---|---|---|---|
| MemoChat | Heuristic Topic | 23.0 | 33.5 | 10.7 | 18.6 |
| MemoChat | LLM Topic | 22.5 | 34.4 | 7.3 | 15.9 |
| MemOS | Fast Memorize | 25.5 | 40.8 | 20.7 | 26.1 |
| MemOS | Fine Memorize | 2.5 | 5.0 | 22.3 | 30.2 |
| LightMem | User-Only Raw | 24.2 | 38.9 | 26.0 | 31.4 |
| LightMem | Hybrid Raw | 25.5 | 39.7 | 25.3 | 31.4 |
O9(Coverage-Preserving Extraction)는 커버리지를 보존하는 쓰기 시점 추출이 사실 retrieval과 후단 추론 사이에서 가장 안정적인 균형을 준다고 본다. MemOS의 두 변형 대비가 가장 극적이다. Fine Memorize는 LongMemEval Substring EM을 20.7%에서 22.3%로, ROUGE-L F1을 26.1%에서 30.2%로 올리지만 LoCoMo EM은 25.5%에서 2.5%로, Answer F1은 40.8%에서 5.0%로 내려간다. 세밀한 LLM 기반 추출이 어휘 수준 사실 retrieval에서 소폭 정밀도를 얻는 대가로 multi-hop 추론을 크게 떨어뜨린다는 것이다.
MemoChat에서는 규칙 기반 Heuristic Topic이 LLM Topic보다 LongMemEval에서 앞서고(Substring EM 10.7% 대 7.3%) LoCoMo는 거의 그대로다. LLM에 topic 분할을 맡기면 오히려 나빠진다. LightMem의 Hybrid Raw는 LoCoMo를 약간 올리고 LongMemEval은 거의 같게 유지한다.
세 결과가 같은 방향을 가리킨다. 보수적 topic 묶음은 이어지는 맥락을 쪼개거나 짧은 여담을 고립시킬 위험이 낮고, 가벼운 memorize는 나중에 조합해야 하는 세부를 남기며, user와 assistant turn을 함께 담으면 user만 볼 때 놓치는 날짜나 다듬어진 표현 같은 단서가 보존된다.
Finding 7(Late Filtering Principle)은 추출이 쓰기 시점에 세부를 공격적으로 걸러내지 말고 컨텍스트를 남겨야 한다고 정리한다. 필터링은 뒤로 미루는 편이 낫다는 뜻이다.
retrieval과 라우팅
A-MEM의 dense와 sparse 융합 비율, SimpleMem의 planning 단계 유무를 비교한다.
| 시스템 | 변형 | LoCoMo Ans. F1 | LoCoMo Recall | LongMemEval Substr. EM | LongMemEval ROUGE-L F1 |
|---|---|---|---|---|---|
| A-MEM | Hybrid-Balanced | 24.6 | 49.9 | 27.5 | 25.9 |
| A-MEM | Hybrid Sparse-Leaning | 23.0 | 44.3 | 24.3 | 22.8 |
| SimpleMem | No Planning | 18.7 | 86.4 | 17.0 | 22.9 |
| SimpleMem | Planning Only | 20.7 | 90.6 | 21.7 | 27.9 |
| SimpleMem | Planning + Reflect | 20.0 | 88.6 | 21.3 | 26.1 |
O10(Planning and Fusion)은 명시적 planning과 균형 잡힌 융합이 가장 크게 개선한다고 본다. A-MEM은 Hybrid-Balanced에서 네 지표 모두 최고이고 sparse 쪽으로 기울이면 모두 내려간다. 의미는 관련되지만 어휘가 다른 사실을 다루려면 중간 정도의 융합이 낫다.
SimpleMem에서는 Planning Only가 네 지표 모두 최고다. No Planning보다 낫고 Planning + Reflect보다도 낫다. planning 위에 reflection을 더해도 이득이 없고 오히려 라우팅 결정을 약화시킨다는 뜻이다. Recall이 90.6%에서 88.6%로, Answer F1이 20.7%에서 20.0%로 내려간다.
Finding 8(Retrieval Strategy Guidance)은 retrieval 품질이 복잡도를 더하는 것보다 겨냥한 구조를 더하는 데서 가장 크게 개선된다고 정리한다. 경로가 이미 정해진 뒤의 추가 숙고는 이득이 제한적이고 주로 오버헤드만 늘린다.
유지
MemoChat의 기본 다중 topic 통합 대 Topic1(창마다 단일 topic 요약 강제), MemoryOS의 기본 즉시 통합 대 Delayed-Flush(백엔드 쓰기 전 short-term 버퍼 확대) 대 Conservative-Merge(topic 유사도 임계 상향)를 비교한다.
| 설정 | LoCoMo Ans. F1 | LoCoMo Substring EM |
|---|---|---|
| Long Context (Default) | 21.3 | 23.7 |
| MemoryOS (Default) | 23.2 | 22.4 |
| MemoryOS (Conservative-Merge) | 23.5 | 22.8 |
| MemoryOS (Delayed-Flush) | 20.6 | 19.5 |
| MemoChat (Default) | 16.6 | 18.4 |
| MemoChat (Topic1) | 16.2 | 16.8 |
O11(Conservative Consolidation)은 보수적 통합이 지연 flush나 과도하게 거친 요약보다 답 관련 메모리를 잘 지킨다고 본다. topic 유사도 임계를 올려 합치기를 엄격하게 하면 MemoryOS의 Answer F1이 23.2%에서 23.5%로, Substring EM이 22.4%에서 22.8%로 소폭 오른다. 반면 flush를 미루면 같은 시스템이 20.6%와 19.5%로 내려간다. 질의 시점에 최근 근거가 아직 해소되지 않은 상태로 남기 때문이다. MemoChat에 단일 topic 요약을 강제하면 16.2%와 16.8%로 기본 설정의 16.6%와 18.4%보다 낮아진다.
Long Context가 Substring EM 23.7%로 이 그림에서 가장 높다는 점이 남는다. 유지 전략을 어떻게 다듬어도 raw 컨텍스트가 정확한 표현 보존에는 여전히 유리하다는 뜻이며, RQ4의 시간 의존 질의 결과와 같은 방향이다.
Finding 9(Maintenance Design Principle)는 균형 잡힌 갱신 체제를 권고한다. 보수적 통합은 turn 사이 연결을 지키고, 지연 flush는 질의 시점에 최근 근거를 조각난 상태로 남기고, 과도하게 거친 요약은 드물지만 유용한 단서를 가린다.
아홉 개 Finding 요약
논문은 관찰 11개를 Finding 9개로 묶는다. 실무 판단에 바로 쓸 수 있는 형태로 모으면 다음과 같다.
| Finding | 이름 | 요지 |
|---|---|---|
| 1 | Workload-Aligned Memory | 강한 메모리는 보편 표현이 아니라 지배적 워크로드 병목을 얼마나 잘 지지하는지로 정의된다 |
| 2 | Evidence-Centric Memory Organization | 초기 위치 파악과 근거 조립은 별개 설계 목표다. 명시적 구조는 근거가 흩어졌을 때 값이 크다 |
| 3 | Temporal Update Fidelity | 갱신 후 신뢰성은 모델 용량이 아니라 파이프라인 설계 문제다. revisability를 표현에 심어라 |
| 4 | Horizon-Structured Memory | 지평이 길어지면 더 저장하는 문제가 아니라 올바른 추상을 고르는 문제가 된다 |
| 5 | Operational Scaling Rule | 효율은 구조 자체가 아니라 유지 범위에 좌우된다. 지역적 갱신이 전역 재조직보다 낫다 |
| 6 | Representation Granularity | 더 압축하거나 더 구조화하는 것보다 쓸 수 있는 근거를 보존하는 것이 중요하다 |
| 7 | Late Filtering Principle | 추출은 쓰기 시점에 컨텍스트를 남기고 필터링을 뒤로 미뤄야 한다 |
| 8 | Retrieval Strategy Guidance | retrieval은 복잡도를 더하는 것보다 겨냥한 구조를 더할 때 개선된다 |
| 9 | Maintenance Design Principle | 보수적 통합이 기본값으로 가장 낫다. 지연 flush와 과도한 요약은 둘 다 해롭다 |
한계
논문 자체가 진단에 가깝고 한계는 agent-native 메모리 시스템이 아직 준비되지 않았다는 결론으로 수렴한다.
- 어떤 단일 메모리 형태도 만능이 아니다. 강건성은 보편 표현이 아니라 적절한 추상화 수준에서 올바른 근거를 보존하는 데서 온다.
- 구조화 비용이 정확도로 되돌아온다는 보장이 없다. Zep은 LongMemEval LLM Judge 48.0%로 최고이지만 LongBench 질의당 2,867초를 쓴다.
- 의미 통합은 시간 순서 단서를 훼손할 수 있다. 시간 의존 질의에서 raw long-context가 대다수 메모리 기반 접근을 앞서는 결과가 그 증거다.
- 추상화 층마다 정보 손실이 쌓인다. 압축, 요약, 사실 추출을 거칠수록 근거가 조금씩 사라진다.
평가 설계 자체의 한계도 있다. taxonomy에 오른 14개 시스템 가운데 MEM1과 Mem0_g는 end-to-end 성능이 보고되지 않고, MemAgent는 LongMemEval에만 등장해 커버리지가 부분적이다. RQ2와 RQ5는 8개 시스템, RQ3의 갱신 비교는 11개 시스템으로 범위가 각기 달라 절 사이 순위를 직접 비교하기 어렵다.
원문 안의 불일치
논문을 읽을 때 걸리는 표기 문제 셋을 기록해 둔다.
| 위치 | 내용 |
|---|---|
| 관찰 번호 | O3이 없고 O1이 두 번 쓰인다. RQ1의 Cross-Workload Effectiveness와 RQ2의 Structured Evidence Expansion이 모두 O1로 붙어 있다 |
| 유지 하위 연산 수 | 2절 정의는 세 하위 연산이라고 하지만 3절 taxonomy와 Figure 6은 Continuous Parametric Optimization을 더해 네 가지를 열거한다 |
| Figure 1 패널 라벨 | 본문은 네 계열을 Stream-and-Reflection, Hierarchical Tiered, Knowledge Graph, Composite Hybrid로 부르지만 Figure 1의 패널 라벨은 (a)(b)(c)를 모두 Structural Topological로 적는다. Table 1의 계열 구분과도 어긋난다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| agent memory system | 추론 한 단계를 넘어 누적 상태를 유지하고 이후 추론과 행동에서 접근 가능하게 만드는 지속 데이터 관리 시스템. 이 논문은 표현과 저장, 추출, retrieval과 라우팅, 유지 네 모듈의 튜플로 형식화한다 |
| evidence distance gap | 질의가 속한 마지막 세션과 그 답을 뒷받침하는 가장 이른 근거 사이의 세션 거리. 1 |
| multi-versioning | 옛 사실을 물리 삭제하지 않고 유효 플래그와 timestamp로 무효 표시해 이력을 보존하는 유지 방식 |
| semantic consolidation | LLM이 중복 주장을 합쳐 dense 요약으로 만드는 유지 연산. 시간 순서 단서를 훼손할 위험이 있다 |
| hallucinations of the past | 수명 관리가 없어 낡거나 무효가 된 사실을 그대로 돌려주는 오류를 논문이 부른 이름 |
| revisability | 나중에 들어온 사실이 같은 entity나 event에 묶여 이전 값을 수정할 수 있는 표현 속성. Finding 3의 핵심 설계 권고다 |
| Normalized Utility | LoCoMo와 LongMemEval의 답 품질 지표 6개를 min-max 정규화해 평균한 값. 비용 대 효용 frontier의 세로 기준이다 |
관련 페이지
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory: 이 벤치마크에서 LongMemEval LLM Judge 48.0%로 최고를 기록한 Zep의 원논문. temporal knowledge graph로 사실에 유효 기간을 붙이는 Structural Topological 계열의 대표이며, 이 논문의 지연 측정에서는 LongBench 질의당 2,867초로 가장 비싼 시스템이기도 하다
- getzep/graphiti: Zep의 temporal graph 엔진 오픈소스 구현체(graphiti-core). 위 원논문의 실제 코드 쪽 자료다
- Memory Intelligence Agent (MIA): 메모리를 non-parametric와 parametric로 나눠 Planner를 RL로 학습하는 MIA. 이 논문이 고정 파이프라인으로 다룬 추출과 유지를 학습 가능한 policy로 밀어붙인 사례다
- TaskMem: Task-Focused Memorization for Multimodal Agents: 무엇을 기억할지를 학습 가능한 memorization policy로 재정식화한 TaskMem. 이 논문의 Finding 7이 규칙으로 제시한 쓰기 시점 판단을 학습 대상으로 본다
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: RAG를 knowledge graph와 Personalized PageRank 기반 continual memory로 확장한 HippoRAG 2. 이 논문의 taxonomy에는 포함되지 않았지만 Structural Topological 계열과 같은 설계 계보에 있다
- Effective Context Engineering for AI Agents: 이 논문이 context engineering의 정의 근거로 직접 인용한 자료. 유한한 attention budget에 넣을 토큰을 고르는 관점이며, 메모리 시스템이 컨텍스트로 되돌리는 근거의 품질 문제와 이어진다