Agents · PAPER · 2025
Zep: A Temporal Knowledge Graph Architecture for Agent Memory
요약
이 논문은 AI 에이전트의 메모리를 시간 정보가 붙은 knowledge graph로 구현하고, 그 검색 성능을 두 개의 메모리 벤치마크로 측정한 결과를 보고한다. 제안 시스템 Zep은 상용 프로덕션 서비스이고, 그 밑에서 그래프를 짓고 질의하는 엔진이 Graphiti다.
knowledge graph는 entity를 노드로, entity 사이의 관계를 엣지로 표현한 데이터 구조를 말한다. Zep이 기존 graph 기반 RAG와 갈라지는 지점은 이 그래프에 시간 축을 하나 더 넣은 데 있다. 각 사실은 언제 참이 됐고 언제 뒤집혔는지를 유효 기간으로 함께 담으므로, 지금 참인 것과 과거 어느 시점에 참이었던 것을 모두 질의할 수 있다.
논문이 내세우는 주장은 여섯 가지로 정리된다.
| 주장 | 요지 |
|---|---|
| 정적 코퍼스 전제를 깬다 | 기존 RAG는 문서 내용이 거의 바뀌지 않는 코퍼스를 가정한다. Graphiti는 새 정보가 들어올 때마다 그래프를 non-lossy 방식으로 갱신한다 |
| bi-temporal 모델 | 사건이 일어난 시간 축 T와 데이터가 들어온 시간 축 T′를 분리해 추적한다. 저자들은 이를 LLM 기반 knowledge graph 구축의 새로운 진전으로 규정한다 |
| edge invalidation | 모순되는 새 사실이 오면 예전 엣지를 지우지 않고 유효 기간을 닫아 무효 처리한다 |
| 동적 community 탐지 | GraphRAG의 community 개념을 가져오되 Leiden 대신 label propagation을 써서 전체 재계산 없이 증분 확장한다 |
| DMR 우위 | MemGPT가 대표 지표로 삼은 DMR에서 94.8% 대 93.4%로 앞섰다 |
| LongMemEval의 정확도와 latency 동시 개선 | full-context 기준선 대비 정확도를 상대 최대 18.5% 높이면서 응답 시간을 약 90% 줄였다 |
이 여섯 가운데 마지막 두 항목은 비교 대상이 다르다. MemGPT와의 직접 비교는 DMR에서만 성립하고, LongMemEval에서는 MemGPT 실행이 실패해 비교 대상이 full-context 기준선뿐이다. 이 구분을 흐리면 "두 벤치마크에서 MemGPT를 앞섰다"는 잘못된 요약이 나온다.
이 페이지는 논문 쪽 사실, 곧 그래프 구축과 검색 방법론 그리고 두 벤치마크의 정량 결과를 다룬다. graphiti-core 설치와 그래프 백엔드 설정, LLM 제공자 교체 같은 구현과 운영 사항은 같은 엔진의 저장소 페이지 getzep/graphiti에 있다.
배경
논문의 출발점은 chat 기반 에이전트의 능력이 세 가지에 갇힌다는 관찰이다. LLM의 context window 크기, 그 context를 실제로 활용하는 정도, 그리고 pre-training으로 얻은 지식의 범위가 그 셋이다. 따라서 도메인 밖 지식을 공급하고 환각(hallucination)을 줄이려면 추가 context를 밖에서 넣어 줘야 한다.
세 제약은 서로 성격이 다르다. context window 크기는 한 번에 넣을 수 있는 토큰 수의 상한이고, context 활용도는 그 안에 답이 들어 있어도 모델이 찾아 쓰지 못하는 문제이며, pre-training 지식의 범위는 학습 시점 이후의 사실이나 특정 조직 내부 정보를 모른다는 문제다. 창을 키우는 것으로는 두 번째와 세 번째 제약이 해결되지 않는다.
RAG가 이 역할을 맡아 왔다. RAG는 정보 검색 분야가 지난 50년간 다듬은 기법을 써서 필요한 도메인 지식을 LLM에 공급한다. 문제는 그 기법들이 깔고 있는 전제다.
정적 코퍼스 전제와 에이전트 메모리의 요구
저자들은 현행 RAG 접근이 넓은 도메인 지식과 대체로 정적인 코퍼스에 초점을 맞춰 왔다고 정리한다. 정적이라는 말은 코퍼스에 넣은 문서 내용이 좀처럼 바뀌지 않는다는 뜻이다. 반면 에이전트가 일상의 문제를 자율적으로 풀려면 성격이 다른 데이터를 다뤄야 한다.
| 항목 | 기존 RAG의 전제 | 에이전트 메모리의 요구 |
|---|---|---|
| 데이터 성질 | 정적 문서 코퍼스 | 사용자 상호작용에서 끊임없이 늘어나는 데이터 |
| 데이터 종류 | 문서 하나의 유형 | 대화 같은 비정형 데이터와 업무용 정형 데이터가 섞인다 |
| 갱신 방식 | 문서 추가와 재인덱싱 | 사실이 뒤집히는 변화를 반영해야 한다 |
| 시간 정보 | 다루지 않는다 | 어떤 사실이 언제 참이었는지가 답을 바꾼다 |
| 규모 | context window에 요약해 넣을 수 있다 | 전체 대화 이력과 업무 데이터셋은 context window에 담기지 않는다 |
에이전트에 이런 넓고 동적인 메모리를 부여하는 것이 저자들이 보는 핵심 구성 요소다. 저자들은 에이전트가 사소한 문제부터 매우 복잡한 문제까지 자율적으로 풀며 일상에 스며드는 미래를 전제로 두고, 현행 RAG 접근이 그 미래에 적합하지 않다고 주장한다.
이 주장의 근거는 규모다. 전체 대화 이력과 업무 데이터셋, 그리고 도메인 고유 자료를 LLM context window 안에 효과적으로 담을 수 없으므로 에이전트 메모리에는 다른 접근이 필요하다는 것이다.
에이전트에 메모리를 붙이는 발상 자체는 새롭지 않고 MemGPT가 먼저 탐색했다. 최근에는 전통적 정보 검색 기법의 약점을 메우려고 knowledge graph를 RAG 아키텍처에 결합하는 연구도 늘었다. Zep은 이 흐름에 시간 축을 더한 제안이다.
Zep이 프로덕션 시스템이라는 점도 논문의 서술 방향을 정한다. 저자들은 메모리 검색 메커니즘의 정확도와 latency, 확장성에 무게를 두고 기존 벤치마크 두 개로 그 효능을 평가한다.
선행 연구와의 관계
Zep은 여러 선행 연구에서 부분을 가져와 조합한 시스템이다. 아래 표는 논문이 명시적으로 귀속시킨 관계만 담는다.
| 선행 연구 | Zep이 가져온 것 | Zep이 더한 것 |
|---|---|---|
| MemGPT | 에이전트에 메모리를 붙이는 문제 설정과 DMR 벤치마크 | 시간 축을 갖춘 그래프 구조. 주 비교 대상이기도 하다 |
| AriGraph | episodic 하위 그래프와 semantic 하위 그래프의 분리, 그래프 위 breadth-first search | bi-temporal 시간 축과 community 요약 층 |
| GraphRAG | community 노드 개념과 map-reduce 방식 요약 | 동적 갱신, 시간 축, 그리고 label propagation으로의 알고리즘 교체 |
| LightRAG | high-level key 검색과 병렬을 이루는 community 검색 방식(독자 개발), latency를 우선 보고하는 관행 | 두 접근의 결합은 후속 과제로 남겼다 |
| Reflexion | entity 추출의 reflection 단계 | 없음. 기법을 차용했다 |
| Distill-SynthKG | graph 기반 RAG의 breadth-first search 선례, 추출용 fine-tuning 모델의 효과 | 없음. fine-tuning은 후속 과제로 남겼다 |
| HiQA와 HIRO | 계층형 RAG 전략 | episode에서 fact, entity, community로 올라가는 네 층 위계 |
| Neo4j와 Apache Lucene | 코사인 유사도 검색과 BM25 full-text 검색의 실행 기반 | breadth-first search를 더한 3중 검색 |
| BGE-m3 | 임베딩 모델 겸 reranker | 없음. 실험 구성 요소로 채택했다 |
이 표에서 반복되는 형태가 하나 있다. 구조는 AriGraph에서, 조망 층은 GraphRAG에서, 추출 안정화는 Reflexion에서 가져오고, Zep이 새로 넣은 것은 대체로 시간과 동적 갱신에 관한 것이다. 저자들이 자기 기여로 특별히 내세우는 항목도 bi-temporal 모델과 edge invalidation이다.
핵심 개념
동적 knowledge graph의 형식 정의
Zep의 메모리는 G = (N, E, φ) 형태의 temporally-aware 동적 knowledge graph다. N은 노드 집합, E는 엣지 집합, φ : E → N × N은 각 엣지가 어느 노드 쌍에 걸리는지 정하는 incidence 함수다. 이 그래프는 세 층의 하위 그래프로 나뉜다.
| 하위 그래프 | 노드가 담는 것 | 엣지가 잇는 것 | 역할 |
|---|---|---|---|
| Episode subgraph (G_e) | 메시지, 텍스트, JSON 원본 | episode를 거기서 추출된 entity에 잇는다. E_e ⊆ φ*(N_e × N_s) | non-lossy 원본 저장소. entity와 관계의 추출 출처 |
| Semantic entity subgraph (G_s) | episode에서 추출하고 기존 entity와 대조해 해소한 entity | entity 사이 관계를 담은 semantic edge. E_s ⊆ φ*(N_s × N_s) | 사실 수준의 지식 표현 |
| Community subgraph (G_c) | 강하게 연결된 entity 군집의 고수준 요약 | community를 소속 entity에 잇는다. E_c ⊆ φ*(N_c × N_s) | 그래프 최상위 층. 도메인 전반의 조망 |
원본 episode와 거기서 파생된 semantic 정보를 함께 저장하는 이 이중 구조는 인간 기억을 다룬 심리학 모형을 본뜬 것이다. episodic memory는 개별 사건을 그대로 담는 기억 층이고, semantic memory는 개념 사이의 연관과 의미를 담는 기억 층이다. 두 층을 하위 그래프로 나누는 접근은 AriGraph가 먼저 보였고, community 노드로 도메인 개념을 조망하는 부분은 GraphRAG에서 가져왔다. 저자들은 episode에서 fact로, fact에서 entity로, entity에서 community로 올라가는 이 위계를 HiQA와 HIRO 같은 기존 계층형 RAG 전략의 확장으로 본다.
Episode
Episode는 Zep이 받아들이는 원본 데이터 단위다. 세 유형이 있고 유형마다 그래프 구축 절차가 다르다.
| 유형 | 담는 것 | 이 논문의 취급 |
|---|---|---|
| message | 짧은 텍스트와 그 발화를 한 화자 정보 | 실험이 대화 메모리를 대상으로 하므로 이 유형만 다룬다 |
| text | 일반 텍스트 | 구축 절차만 언급하고 실험에서는 쓰지 않는다 |
| JSON | 정형 업무 데이터 | 같다 |
여기서 message는 여러 개가 LLM context window에 함께 들어갈 만큼 짧은 텍스트를 뜻한다. 각 메시지에는 발화 시각을 가리키는 기준 시각 t_ref가 붙는다.
t_ref의 역할은 상대 날짜 해석이다. 이 시각이 있으면 Zep은 "다음 목요일", "2주 뒤", "지난여름" 같은 상대 표현과 부분 날짜를 정확한 날짜로 환산해 추출할 수 있다. 시각 정보가 없으면 이런 표현은 그대로 문자열로 남아 시간 질의(query)에 쓸 수 없다.
episodic 엣지는 episode를 거기서 추출된 entity 노드에 잇는다. episode와 파생된 semantic 엣지는 양방향 인덱스를 유지하므로 순방향과 역방향 순회가 모두 가능하다. semantic 산출물은 인용이나 출처 표기를 위해 원본 episode까지 거슬러 올라갈 수 있고, 반대로 episode는 자기와 관련된 entity와 fact를 빠르게 가져올 수 있다. 저자들은 이 양방향 연결이 Graphiti episodic 하위 그래프의 non-lossy 성질을 강화한다고 설명하면서, 이번 실험에서는 직접 검증하지 않았고 후속 연구 대상이라고 밝힌다.
Bi-temporal 시간 축
Zep은 시간 축을 하나가 아니라 둘로 둔다. T는 사건이 실제로 일어난 연대기적 순서이고, T′는 Zep이 데이터를 받아들인 트랜잭션 순서다.
두 시간 축의 용도가 다르다. T′는 전통적인 데이터베이스 감사 목적을 그대로 수행한다. 어떤 레코드가 언제 시스템에 들어왔고 언제 만료됐는지를 남기는 축이다. 반면 T는 대화와 메모리의 시간적 변화를 모델링하는 차원을 새로 더한다. 사용자가 3월에 한 말이 5월에 뒤집혔다면, 그 전환은 T 위에서 표현된다.
이 모델에 맞춰 시스템은 엣지마다 네 개의 시각을 저장한다.
| 시각 | 소속 축 | 뜻 |
|---|---|---|
| t′_created | T′ | 그 fact가 시스템 안에서 생성된 시점 |
| t′_expired | T′ | 그 fact가 시스템 안에서 무효화된 시점 |
| t_valid | T | 그 fact가 실제로 참이 된 시점 |
| t_invalid | T | 그 fact가 실제로 참이기를 멈춘 시점 |
네 값은 나머지 fact 정보와 함께 엣지에 저장된다. 저자들은 이 이중 시간 접근을 LLM 기반 knowledge graph 구축의 새로운 진전으로 평가하며, 기존 graph 기반 RAG 제안과 Zep을 구분하는 근거이자 Zep의 차별화된 능력 대부분의 출처로 본다.
Fact와 hyper-edge
fact는 두 entity 사이의 관계를 담은 semantic edge이며 그 관계의 핵심 술어를 포함한다. 부록의 fact 추출 프롬프트는 이 술어를 relation_type이라는 짧은 대문자 표기로 요구하고 LOVES, IS_FRIENDS_WITH, WORKS_FOR를 예로 든다.
같은 fact가 서로 다른 entity 사이에서 여러 번 추출될 수 있다. Graphiti는 이 상황을 hyper-edge 구현으로 처리해 세 개 이상의 entity가 걸린 복합 fact도 표현한다.
non-lossy 저장이 하는 일
논문은 episode를 non-lossy 데이터 저장소로 부르며 이 성질을 반복해서 강조한다. non-lossy는 원본을 요약이나 임베딩으로 대체하지 않고 들어온 그대로 보관한다는 뜻이다.
이 선택이 세 가지를 가능하게 한다.
| 효과 | 내용 |
|---|---|
| 출처 추적 | semantic 산출물을 만들어낸 원본 episode를 되짚을 수 있어 인용과 출처 표기가 가능하다 |
| 재추출 여지 | 추출 프롬프트나 모델이 개선되면 원본이 남아 있으므로 같은 데이터에서 다시 추출할 수 있다 |
| 손실 없는 갱신 | 새 정보가 기존 정보를 대체하지 않고 덧붙는 구조라 과거 상태가 보존된다 |
요약만 남기는 메모리 구조와 대비하면 차이가 분명하다. DMR 실험의 session summary 기준선은 대화를 요약으로 압축한 뒤 원본을 버리는 방식이고, gpt-4-turbo에서 78.6%로 full-conversation 94.4%보다 15.8%p 낮았다. 요약 과정에서 잃은 정보는 나중에 되찾을 수 없다.
그래프 구축 절차
entity 추출
entity 추출은 episode 처리의 첫 단계다. 시스템은 현재 메시지만 보지 않고 직전 n개 메시지를 함께 넣어 named entity recognition의 맥락으로 삼는다. 이 논문과 Zep의 일반 구현에서 n = 4이며, 대화 두 턴 분량에 해당한다.
추출은 다섯 단계를 거친다.
| 단계 | 하는 일 |
|---|---|
| 1. 맥락 구성 | 현재 메시지와 직전 4개 메시지를 함께 프롬프트에 담는다 |
| 2. 화자 추출 | 메시지 처리에 초점을 두므로 화자를 자동으로 entity로 추출한다 |
| 3. 1차 entity 추출 | 현재 메시지에서 명시적으로 또는 암묵적으로 언급된 entity를 뽑는다 |
| 4. reflection | reflexion에서 착안한 기법으로 누락을 줄이고 환각을 억제한다 |
| 5. 요약 추출 | 이어지는 entity 해소와 검색에 쓰려고 episode에서 entity 요약도 함께 뽑는다 |
reflection은 1차 출력을 다시 검토하게 해 놓친 entity를 보태고 근거 없는 entity를 걸러내는 단계다. 추출 범위를 넓히는 효과와 환각을 줄이는 효과를 동시에 노린다.
직전 4개 메시지를 함께 넣는 설계에도 이유가 있다. 대화에서는 "그 사람", "거기" 같은 지시 표현이 앞선 발화를 가리키므로, 현재 메시지만 보면 어떤 entity를 가리키는지 판정할 수 없다. n = 4는 대화 두 턴에 해당하므로 직전 질문과 답변 한 쌍이 맥락으로 들어간다.
중복 해소
추출한 entity는 이미 그래프에 있는 entity와 같은 대상일 수 있다. 시스템은 각 entity 이름을 1024차원 벡터 공간에 임베딩한 뒤 두 가지 검색으로 후보를 모은다. 하나는 기존 entity 노드를 대상으로 한 코사인 유사도 검색이고, 다른 하나는 기존 entity 이름과 요약을 대상으로 한 별도의 full-text 검색이다.
이 후보 노드들과 episode 맥락을 entity 해소 프롬프트에 담아 LLM에 넘긴다. 중복으로 판정되면 시스템은 갱신된 이름과 요약을 생성한다. 부록의 프롬프트는 이름만이 아니라 요약도 함께 보고 판정하라고 지시하며, 중복 노드가 서로 다른 이름을 가질 수 있다는 점을 근거로 든다.
fact 중복 해소도 절차는 비슷하지만 탐색 범위에 결정적인 제약이 하나 걸린다.
| 항목 | entity 중복 해소 | fact 중복 해소 |
|---|---|---|
| 임베딩 대상 | entity 이름 | fact 문장 |
| 후보 탐색 범위 | 그래프의 기존 entity 노드 전체 | 새 엣지와 같은 entity 쌍 사이에 이미 있는 엣지로 한정 |
| 판정 주체 | LLM 해소 프롬프트 | LLM 해소 프롬프트 |
| 판정 기준 | 같은 entity를 가리키는가 | 같은 사실 정보를 표현하는가. 문장이 완전히 같을 필요는 없다 |
| 제약의 효과 | 없음 | 다른 entity 사이의 유사 엣지가 잘못 합쳐지는 것을 막고 계산 복잡도를 크게 낮춘다 |
entity 쌍으로 탐색 공간을 좁히는 이 제약이 두 효과를 함께 낸다. 정확성 측면에서는 "A가 B를 좋아한다"와 "C가 D를 좋아한다"처럼 문장은 비슷하지만 주체가 다른 엣지가 병합되는 사고를 막는다. 효율 측면에서는 비교 대상을 해당 entity 쌍에 걸린 엣지 부분집합으로 줄여 중복 해소 비용을 낮춘다.
추출과 해소를 마친 데이터를 그래프에 반영할 때는 LLM이 생성한 데이터베이스 질의를 쓰지 않고 미리 정의한 Cypher 질의를 쓴다. 스키마 형식의 일관성을 지키고 환각 여지를 줄이려는 선택이다.
Temporal extraction과 edge invalidation
저자들은 Graphiti를 다른 knowledge graph 엔진과 구분하는 핵심 기능으로 temporal extraction과 edge invalidation을 통한 동적 정보 갱신을 든다. 시스템은 t_ref를 기준으로 episode 맥락에서 fact의 시간 정보를 추출한다.
이 방식은 두 종류의 시각 표현을 모두 처리한다. "Alan Turing was born on June 23, 1912" 같은 절대 시각은 그대로 datetime으로 옮기고, "I started my new job two weeks ago" 같은 상대 시각은 t_ref에서 역산해 datetime으로 만든다.
무효화 절차는 세 단계다.
| 단계 | 하는 일 |
|---|---|
| 1. 모순 후보 탐색 | LLM으로 새 엣지를 의미상 관련된 기존 엣지와 비교해 모순 가능성을 찾는다 |
| 2. 시간 겹침 판정 | 시간 구간이 겹치는 모순만 무효화 대상으로 인정한다 |
| 3. 유효 기간 닫기 | 대상 엣지의 t_invalid를 무효화를 유발한 엣지의 t_valid로 설정한다. 엣지 자체는 지우지 않는다 |
무효화 판정의 우선순위는 트랜잭션 시간 축 T′를 따른다. 곧 Graphiti는 언제나 새로 들어온 정보를 우선한다. 이 방식은 대화가 진행되는 동안 데이터를 계속 추가하면서도 현재 관계 상태와 관계 변화의 과거 기록을 함께 유지한다.
Community 탐지
episodic 하위 그래프와 semantic 하위 그래프를 세운 다음, 시스템은 community 탐지로 community 하위 그래프를 구축한다. 탐지 기법의 뼈대는 GraphRAG에서 가져왔지만 알고리즘 선택은 다르다.
| 항목 | GraphRAG | Zep |
|---|---|---|
| community 탐지 알고리즘 | Leiden | label propagation |
| 선택 이유 | 잘 연결된 community를 보장한다 | 동적 확장으로 넘어가기 쉽다 |
| 새 노드 처리 | 전체 재계산 | 단일 재귀 단계로 증분 확장 |
| 요약 생성 | map-reduce 방식 반복 요약 | 같다 |
| 검색 방식 | map-reduce 접근 | community 이름을 임베딩해 코사인 유사도 검색 |
label propagation을 택한 근거는 유지 비용이다. 새 데이터가 들어와도 정확한 community 표현을 더 오래 유지할 수 있고, 그만큼 전체 갱신 시점을 늦출 수 있다.
동적 확장은 label propagation의 단일 재귀 단계를 그대로 구현한 것이다. 새 entity 노드가 그래프에 들어오면 시스템은 이웃 노드들의 community를 조사한 뒤, 이웃 다수가 속한 community에 새 노드를 배정하고 community 요약과 그래프를 갱신한다.
이 근사에는 대가가 따른다. 증분 확장을 반복하면 그 결과는 label propagation을 처음부터 완전히 다시 수행한 결과에서 점점 멀어진다. 따라서 주기적인 전체 갱신은 여전히 필요하다. 저자들은 그럼에도 이 전략이 latency와 LLM 추론 비용을 크게 줄이는 실용적 heuristic이라고 규정한다.
community 노드의 요약은 GraphRAG와 마찬가지로 소속 노드를 map-reduce 방식으로 반복 요약해 만든다. 다만 검색 방식은 다르다. Zep은 community 요약에서 핵심 용어와 관련 주제를 뽑아 community 이름을 생성하고, 그 이름을 임베딩해 저장해 코사인 유사도 검색이 가능하게 한다.
부록의 그래프 구축 프롬프트
부록은 그래프 구축에 쓰는 프롬프트 다섯 개를 싣는다. 모두 PREVIOUS MESSAGES와 CURRENT MESSAGE를 태그로 감싸 넘기는 공통 구조를 쓴다.
| 프롬프트 | 입력 | 주요 지침 |
|---|---|---|
| Entity Extraction | 이전 메시지, 현재 메시지 | 화자를 항상 첫 노드로 추출한다. 관계나 행위는 노드로 만들지 않는다. 날짜, 시각, 연도 같은 시간 정보도 노드로 만들지 않고 나중에 엣지에 붙인다. 노드 이름은 전체 이름으로 최대한 명시적으로 적는다 |
| Entity Resolution | 이전 메시지, 현재 메시지, 기존 노드 목록, 새 노드 | 중복이면 is_duplicate: true와 기존 노드 uuid를 반환하고 가장 완전한 전체 이름을 제시한다. 이름과 요약을 함께 보고 판정한다 |
| Fact Extraction | 이전 메시지, 현재 메시지, entity 목록 | 제공된 entity 사이의 fact만 추출한다. 각 fact는 서로 다른 두 노드 사이의 명확한 관계여야 한다. relation_type은 짧은 대문자 표기로 적는다 |
| Fact Resolution | 기존 엣지 목록, 새 엣지 | 같은 사실 정보를 표현하면 중복으로 판정한다. 문장이 완전히 같아야 하는 것은 아니다 |
| Temporal Extraction | 이전 메시지, 현재 메시지, 기준 시각, fact | fact에 포함된 시간 정보만 추출한다. valid_at은 관계가 성립한 시점, invalid_at은 관계가 끝난 시점이다. ISO 8601 형식을 쓰고 상대 시각은 기준 시각으로 환산한다. 관련 사건에서 날짜를 추론하지 않는다. 날짜만 있으면 00:00:00, 연도만 있으면 1월 1일 00:00:00을 쓴다 |
프롬프트 지침에서 설계 의도가 드러나는 항목이 둘 있다. 하나는 시간 정보를 노드로 만들지 말라는 지시로, 시간은 entity가 아니라 관계의 속성이라는 모델을 강제한다. 다른 하나는 관련 사건에서 날짜를 추론하지 말라는 지시로, 관계의 성립이나 변경을 직접 진술한 날짜만 쓰게 해 시간 정보의 환각을 막는다.
메모리 검색
세 단계 함수의 합성
Zep의 그래프 검색 API는 텍스트 문자열 질의 α ∈ S를 받아 텍스트 문자열 context β ∈ S를 반환하는 함수 f : S → S로 정의된다. 출력 β는 LLM 에이전트가 α에 정확히 답하는 데 필요한 노드와 엣지 데이터를 정해진 형식으로 담는다.
f(α) → β는 세 단계로 나뉘고, 세 단계를 합성하면 f(α) = χ(ρ(ϕ(α))) = β가 된다.
| 단계 | 기호 | 형 | 하는 일 |
|---|---|---|---|
| Search | ϕ | S → E_s^n × N_s^n × N_c^n | 관련 정보를 담고 있을 후보 노드와 엣지를 찾아 semantic edge, entity 노드, community 노드 세 목록의 3-tuple로 만든다 |
| Reranker | ρ | ϕ(α), ... → E_s^n × N_s^n × N_c^n | 검색 결과 목록을 받아 순서를 바꾼 목록을 반환한다 |
| Constructor | χ | E_s^n × N_s^n × N_c^n → S | 노드와 엣지를 텍스트 context로 바꾼다 |
Search가 3-tuple로 반환하는 세 유형이 관련 텍스트 정보를 담은 그래프 유형 전부다. Constructor가 각 유형에서 꺼내는 필드는 다음과 같이 정해져 있다.
| 객체 유형 | Constructor가 꺼내는 필드 |
|---|---|
| semantic edge (E_s) | fact, t_valid, t_invalid |
| entity 노드 (N_s) | 이름, 요약 |
| community 노드 (N_c) | 요약 |
semantic edge에서만 시각 두 개를 함께 꺼낸다는 점이 이 설계의 핵심이다. 에이전트가 받는 context에는 사실만 있는 것이 아니라 그 사실이 언제까지 참이었는지가 함께 들어간다.
논문은 이렇게 만들어지는 context 문자열 템플릿도 싣는다.
FACTS and ENTITIES represent relevant context to the current conversation.

These are the most relevant facts and their valid date ranges. If the fact is
about an event, the event takes place during this time.
format: FACT (Date range: from - to)
<FACTS>
{facts}
</FACTS>

These are the most relevant entities
ENTITY_NAME: entity summary
<ENTITIES>
{entities}
</ENTITIES>
템플릿은 유효 기간을 그냥 붙이지 않고, 그 기간이 사건 발생 기간을 뜻한다고 명시한다. 시간 정보를 모델이 오해하지 않도록 해석 규칙을 함께 주는 방식이다.
세 가지 검색 함수
Zep은 성질이 다른 검색 함수 셋을 구현하고 그 결과를 합쳐 reranking 전 후보를 폭넓게 확보한다.
| 함수 | 기호 | 실행 기반 | 잡아내는 유사도 |
|---|---|---|---|
| 코사인 의미 유사도 검색 | ϕ_cos | Neo4j의 Lucene 구현 | 의미 유사도 |
| Okapi BM25 full-text 검색 | ϕ_bm25 | Neo4j의 Lucene 구현 | 단어 유사도 |
| breadth-first search | ϕ_bfs | 그래프 순회 | 맥락 유사도 |
맥락 유사도는 그래프에서 가까운 노드와 엣지가 더 비슷한 대화 맥락에 등장한다는 성질을 가리킨다. 저자들은 이렇게 세 방면에서 후보를 모으면 최적 context를 발견할 확률이 최대화된다고 설명한다.
세 함수를 나란히 두는 이유는 놓치는 경우가 서로 다르기 때문이다. 코사인 유사도는 표현이 달라도 뜻이 같은 문장을 잡지만 고유명사나 드문 용어를 놓칠 수 있고, BM25는 정확한 단어 일치에 강하지만 다른 말로 표현된 같은 사실을 놓친다. breadth-first search는 두 방식이 모두 놓치는 경우, 곧 질의와 표면적으로 닮지 않았으나 그래프상 인접해 함께 언급되던 정보를 가져온다.
이 분업이 파이프라인의 앞단을 recall 중심으로 만든다. 세 함수는 정밀도를 고려하지 않고 후보를 넓게 모으며, 정밀도는 다음 단계인 reranker가 담당한다.
검색 대상 필드는 객체 유형마다 다르다.
| 객체 유형 | 검색 대상 필드 |
|---|---|
| semantic edge (E_s) | fact 필드 |
| entity 노드 (N_s) | entity 이름 |
| community 노드 (N_c) | community 이름. 그 community가 다루는 핵심 키워드와 표현을 담은 값이다 |
community 이름을 검색 대상으로 삼는 이 방식에 대해 저자들은 독자적으로 개발했지만 LightRAG의 high-level key 검색 방법론과 병렬을 이룬다고 밝힌다. 그리고 LightRAG의 접근을 Graphiti 같은 graph 기반 시스템과 결합하는 것을 유망한 후속 방향으로 지목한다.
세 함수 가운데 breadth-first search가 이 논문에서 가장 특이한 항목이다. 코사인 유사도와 full-text 검색은 RAG에서 이미 정착했지만, knowledge graph 위의 breadth-first search는 RAG 분야에서 관심을 거의 받지 못했고 AriGraph와 Distill-SynthKG가 눈에 띄는 예외다.
Graphiti에서 이 함수는 두 가지 방식으로 쓰인다. 기본 용도는 n-hop 안의 추가 노드와 엣지를 찾아 1차 검색 결과를 보강하는 것이다. 여기에 ϕ_bfs는 노드를 파라미터로 받을 수 있어 검색 범위를 더 세밀하게 통제할 수 있다. 최근 episode를 seed로 주면 방금 언급된 entity와 관계를 검색 context에 끌어올 수 있어 대화형 메모리에서 특히 유용하다.
Reranker 다섯 종
1차 검색이 높은 recall을 노리는 반면, reranker는 가장 관련 있는 결과를 앞으로 보내 precision을 높이는 역할을 한다. reranking은 1차 검색이 뽑은 후보를 정밀 모델이나 별도 기준으로 다시 정렬하는 단계다.
| Reranker | 정렬 기준 | 성격 |
|---|---|---|
| Reciprocal Rank Fusion | 여러 검색 결과의 순위를 결합한 점수 | 기존 방식 |
| Maximal Marginal Relevance | 관련도와 다양성의 균형 | 기존 방식 |
| episode-mentions | 대화 안에서 entity나 fact가 언급된 빈도 | Zep 고유. 자주 참조된 정보가 더 쉽게 접근된다 |
| node distance | 지정한 중심 노드로부터의 그래프 거리 | Zep 고유. knowledge graph의 특정 영역에 국한된 context를 얻는다 |
| cross-encoder | 질의와 노드, 엣지를 cross-attention으로 함께 평가한 관련도 점수 | 가장 정교하지만 계산 비용이 가장 크다 |
앞의 두 방식은 RAG에서 널리 쓰이는 일반 기법이고, 가운데 두 방식이 그래프 구조를 활용하는 Zep 고유 항목이다. episode-mentions는 대화 이력의 빈도 정보를, node distance는 그래프 위치 정보를 순위에 반영한다. 둘 다 텍스트 유사도만으로는 얻을 수 없는 신호다.
cross-encoder는 성능과 비용이 정반대 방향으로 걸린 선택지다. 질의와 후보를 한 번에 넣어 attention으로 함께 평가하므로 관련도 판정은 가장 정확하지만, 후보마다 모델을 호출해야 하므로 비용이 가장 크다.
설계에서 반복되는 판단
논문 전체를 통해 같은 성격의 선택이 여러 자리에서 반복된다. LLM에 맡기는 범위를 좁히고 결정론적 규칙이나 값싼 알고리즘으로 대체하는 방향이다.
| 자리 | 열려 있던 선택 | 논문의 선택 | 근거 |
|---|---|---|---|
| 그래프 반영 질의 | LLM이 데이터베이스 질의를 생성 | 미리 정의한 Cypher 질의 | 스키마 형식의 일관성 확보와 환각 여지 축소 |
| fact 중복 해소 범위 | 그래프 전체 엣지와 비교 | 같은 entity 쌍의 엣지로 한정 | 오병합 방지와 계산 복잡도 축소 |
| community 탐지 | Leiden | label propagation | 동적 증분 확장이 쉬워 전체 갱신을 늦출 수 있다 |
| community 갱신 시점 | 매번 완전 재계산 | 단일 재귀 단계의 증분 확장과 주기적 전체 갱신 | latency와 LLM 추론 비용 축소 |
| 시간 정보 추출 | 관련 사건에서 날짜 추론 허용 | 관계의 성립이나 변경을 직접 진술한 날짜만 사용 | 시간 정보의 환각 방지 |
| reranking 실행 | cross-encoder | BGE-m3 | 기능으로는 cross-encoder를 제공하지만 실험에는 쓰지 않았다 |
근거의 성격은 두 종류로 나뉜다. Cypher 질의 고정, entity 쌍 제약, 날짜 추론 금지는 정확성과 비용을 함께 얻는 선택이다. 반면 community의 증분 확장은 결과 품질을 일부 내주고 latency와 비용을 얻는 교환이며, 저자들도 이를 실용적 heuristic으로 규정하면서 주기적 전체 갱신이 필요하다고 명시한다.
비용 절감의 대상이 두 곳으로 나뉜다는 점도 정리해 둘 만하다. community 증분 확장은 그래프 구축과 갱신 시점의 latency와 LLM 추론 비용을 줄이는 선택이고, 실험이 측정한 응답 latency 절감은 저자들의 설명대로 프롬프트 크기가 줄어든 결과다. 논문은 두 비용을 같은 자리에서 합산하지 않는다.
reranker 선택에서도 같은 방향이 확인된다. cross-encoder를 기능으로는 제공하지만 실험의 reranking은 BGE-m3로 수행했고, 가장 비싼 선택지는 쓰지 않았다.
실험 설계
두 벤치마크
저자들은 LLM 메모리 벤치마크 두 개로 검색 메커니즘을 평가한다. 첫 번째는 MemGPT 논문이 만든 Deep Memory Retrieval 과제이고, 두 번째는 LongMemEval 벤치마크의 LongMemEval_s 데이터셋이다.
| 항목 | DMR | LongMemEval_s |
|---|---|---|
| 출처 | MemGPT 논문 | LongMemEval 논문 |
| 원 데이터셋 | Multi-Session Chat 500대화 부분집합 | 실제 업무 활용을 반영한 장기 대화 |
| 대화 규모 | 5세션에 세션당 최대 12메시지, 곧 대화당 60메시지 | 평균 약 11만 5천 토큰 |
| 질문 구성 | 대화마다 질의응답 1쌍, 단일 턴 사실 검색 | 여섯 유형이며 유형별 분포는 균일하지 않다 |
| 질문 유형 | 단일 유형 | single-session-user, single-session-assistant, single-session-preference, multi-session, knowledge-update, temporal-reasoning |
| 비교 대상 | MemGPT, full-conversation, session summaries, recursive summarization | full-context 기준선 |
| 채점 | LLM judge가 golden answer와 대조 | GPT-4o에 원 논문의 질문별 프롬프트를 적용 |
LongMemEval의 채점 방식에는 근거가 붙어 있다. 원 논문이 제공한 질문별 프롬프트가 인간 평가자와 높은 상관을 보였기 때문에 그것을 그대로 썼다는 설명이다.
두 실험의 절차는 같다. Zep API로 대화 이력을 Zep knowledge graph에 통합한 뒤, 검색 기법으로 가장 관련 있는 엣지(fact)와 entity 노드(entity 요약)를 가져오고, 그 데이터를 Zep 메모리 API가 제공하는 것과 같은 형식의 context 문자열로 재구성한다.
저자들은 이 두 실험이 Graphiti의 핵심 검색 능력을 보여주지만 전체 검색 기능의 부분집합에 지나지 않는다고 명시한다. 이 범위를 좁게 잡은 이유는 기존 벤치마크와의 비교를 명확히 하기 위해서이고, 나머지 knowledge graph 기능의 탐색은 후속 과제로 남겼다.
모델 구성
모델은 역할별로 다르게 배정했다.
| 역할 | 모델 |
|---|---|
| 임베딩과 reranking | BAAI의 BGE-m3 |
| 그래프 구축 | gpt-4o-mini-2024-07-18 |
| 답변 생성 | gpt-4o-mini-2024-07-18과 gpt-4o-2024-11-20 |
| MemGPT와의 DMR 직접 비교 | gpt-4-turbo-2024-04-09 |
그래프 구축에 mini급 모델만 쓴 점이 눈에 띈다. 추출과 중복 해소를 저렴한 모델에 맡기고, 답변 생성 모델만 두 등급으로 바꿔 결과 차이를 관찰하는 구성이다. gpt-4-turbo는 MemGPT가 자기 결과를 보고한 모델이라 직접 비교를 성립시키기 위해 추가했다.
측정 환경
측정 조건도 밝혀져 있다. 실험은 2024년 12월부터 2025년 1월 사이에 수행했고, 매사추세츠주 보스턴의 주거지에서 소비자용 노트북으로 AWS us-west-2에 호스팅된 Zep 서비스에 접속했다.
이 분산 구조가 latency 수치에 영향을 준다. Zep 평가에는 네트워크 지연이 섞였지만 기준선 평가에는 그런 지연이 없었다. 따라서 보고된 Zep latency는 순수한 시스템 처리 시간보다 크게 나온 값이며, 저자들도 이 점을 명시한다.
DMR 결과
MemGPT는 gpt-4-turbo로 93.4%를 기록해 이 지표의 선두였다. 같은 논문이 보고한 recursive summarization 기준선 35.3%를 크게 앞선 값이다.
저자들은 비교 기준선으로 흔히 쓰이는 두 접근을 직접 구현했다. gpt-4-turbo에서 full-conversation 기준선은 94.4%로 MemGPT의 보고값을 근소하게 넘었고, session summary 기준선은 78.6%였다. gpt-4o-mini로 바꾸면 두 접근 모두 성능이 올라 full-conversation 98.0%, session summaries 88.0%를 기록했다.
MemGPT는 gpt-4o-mini로 재현하지 못했다. 저자들은 그 원인을 MemGPT 논문에 방법론 세부가 충분히 적혀 있지 않은 점으로 든다. 그래서 표의 gpt-4o-mini 구간에는 MemGPT 행이 없다.
Zep 평가는 대화를 그래프에 적재한 뒤 검색 함수로 가장 관련 있는 노드와 엣지 상위 10개를 가져오는 방식으로 진행했고, LLM judge가 에이전트 응답을 golden answer와 대조했다.
| Memory | Model | Score | Zep과의 차이 |
|---|---|---|---|
| Recursive Summarization | gpt-4-turbo | 35.3% | -59.5%p |
| Conversation Summaries | gpt-4-turbo | 78.6% | -16.2%p |
| MemGPT | gpt-4-turbo | 93.4% | -1.4%p |
| Full-conversation | gpt-4-turbo | 94.4% | -0.4%p |
| Zep | gpt-4-turbo | 94.8% | 기준 |
| Conversation Summaries | gpt-4o-mini | 88.0% | -10.2%p |
| Full-conversation | gpt-4o-mini | 98.0% | -0.2%p |
| Zep | gpt-4o-mini | 98.2% | 기준 |
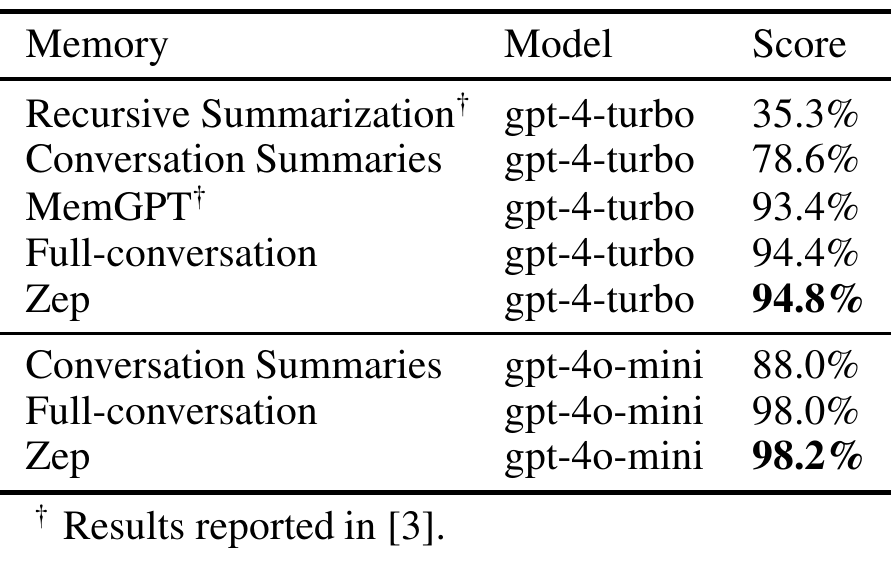
Recursive Summarization과 MemGPT 값은 MemGPT 논문이 보고한 수치이고 나머지 다섯 행은 이 논문이 직접 측정했다. Zep의 우위 폭은 두 모델 모두에서 1.4%p 이하로 좁다. gpt-4o-mini에서는 full-conversation과의 차이가 0.2%p에 그친다.
저자들이 붙인 단서
저자들은 이 결과를 그대로 받아들이면 안 된다고 단서를 붙인다. 벤치마크 자체의 약점을 네 가지로 정리한다.
| 약점 | 내용 |
|---|---|
| 규모가 작다 | 대화당 메시지가 60개뿐이라 현재 LLM의 context window에 통째로 들어간다 |
| 질문이 단순하다 | 평가가 단일 턴 사실 검색 질문에만 의존해 복잡한 메모리 이해를 재지 못한다 |
| 표현이 모호하다 | "favorite drink to relax with"나 "weird hobby"처럼 대화에서 그렇게 규정되지 않은 개념을 가리키는 질문이 다수 섞여 있다 |
| 기업 활용을 대표하지 못한다 | 저자들이 가장 중대한 문제로 꼽는 항목이다 |
네 약점은 하나의 결론으로 모인다. 현대 LLM의 단순 full-context 접근이 이미 98%대 점수를 낸다는 사실 자체가 이 벤치마크가 메모리 시스템을 판별하는 도구로 부적절하다는 증거라는 것이 저자들의 판단이다.
이 판단은 외부 관찰로도 뒷받침된다. LongMemEval 논문은 대화 길이가 늘어날수록 LLM 성능이 급격히 하락한다는 결과를 보였다. 곧 대화가 짧으면 메모리 시스템의 차이가 드러나지 않는다.
이 서술이 논문 구성에서 하는 역할은 두 번째 실험의 필요성을 세우는 것이다. 자기 시스템이 1위를 기록한 벤치마크의 판별력을 스스로 부정한 뒤, 더 긴 대화와 더 다양한 질문 유형을 갖춘 LongMemEval로 넘어간다는 전개다.
표 자체가 그 논거를 뒷받침한다. gpt-4-turbo에서 gpt-4o-mini로 모델만 바꿨을 때 full-conversation 기준선이 94.4%에서 98.0%로 올라간다. 메모리 구조를 전혀 바꾸지 않고 생성 모델만 교체해도 3.6%p가 오르는 벤치마크에서는 메모리 설계의 기여를 분리해 낼 수 없다.
LongMemEval 결과
벤치마크 선택 이유
LongMemEval_s는 LLM 에이전트의 실제 업무 활용을 대표하는 대화와 질문을 제공하며, 기존 LLM과 상용 메모리 솔루션에 상당한 난이도를 부과한다. 대화 길이가 평균 약 11만 5천 토큰이다.
논문의 표와 본문은 이 데이터셋을 아래 첨자가 붙은 LongMemEval_s로 표기한다. LongMemEval 벤치마크 전체가 아니라 그 안의 특정 부분집합을 썼다는 표시이므로, 다른 연구의 LongMemEval 수치와 비교할 때는 같은 부분집합인지 확인해야 한다.
이 길이가 실험 설계상 중요하다. 11만 5천 토큰은 상당한 규모이지만 최신 frontier 모델의 context window에는 여전히 들어간다. 그래서 저자들은 대화 전체를 그대로 넣는 full-context 기준선을 세워 의미 있는 비교를 할 수 있었다.
MemGPT 비교 실패
저자들은 MemGPT와의 비교도 시도했다. 현행 MemGPT 프레임워크가 기존 메시지 이력의 직접 적재를 지원하지 않아, 대화 메시지를 archival history에 추가하는 우회 방법을 구현했다.
이 방법으로는 질문에 대한 성공적인 응답을 얻지 못했다. 저자들은 다른 연구팀이 이 벤치마크로 평가해 주기를 기대한다고 밝히며, 비교 성능 데이터가 LLM 메모리 시스템 발전에 도움이 될 것이라고 덧붙인다. 따라서 이 벤치마크에서 Zep의 비교 대상은 full-context 기준선뿐이다.
정확도와 latency
Zep은 두 모델 모두에서 정확도와 latency를 함께 개선했다. 논문은 정확도 향상을 상대 비율로 보고하며 gpt-4o-mini에서 15.2%, gpt-4o에서 18.5%다. 프롬프트 크기가 줄어든 결과 latency 비용도 크게 낮아졌다.
| Memory | Model | Score | Latency | Latency IQR | Avg Context Tokens |
|---|---|---|---|---|---|
| Full-context | gpt-4o-mini | 55.4% | 31.3초 | 8.76초 | 11만 5천 |
| Zep | gpt-4o-mini | 63.8% | 3.20초 | 1.31초 | 1,600 |
| Full-context | gpt-4o | 60.2% | 28.9초 | 6.01초 | 11만 5천 |
| Zep | gpt-4o | 71.2% | 2.58초 | 0.684초 | 1,600 |
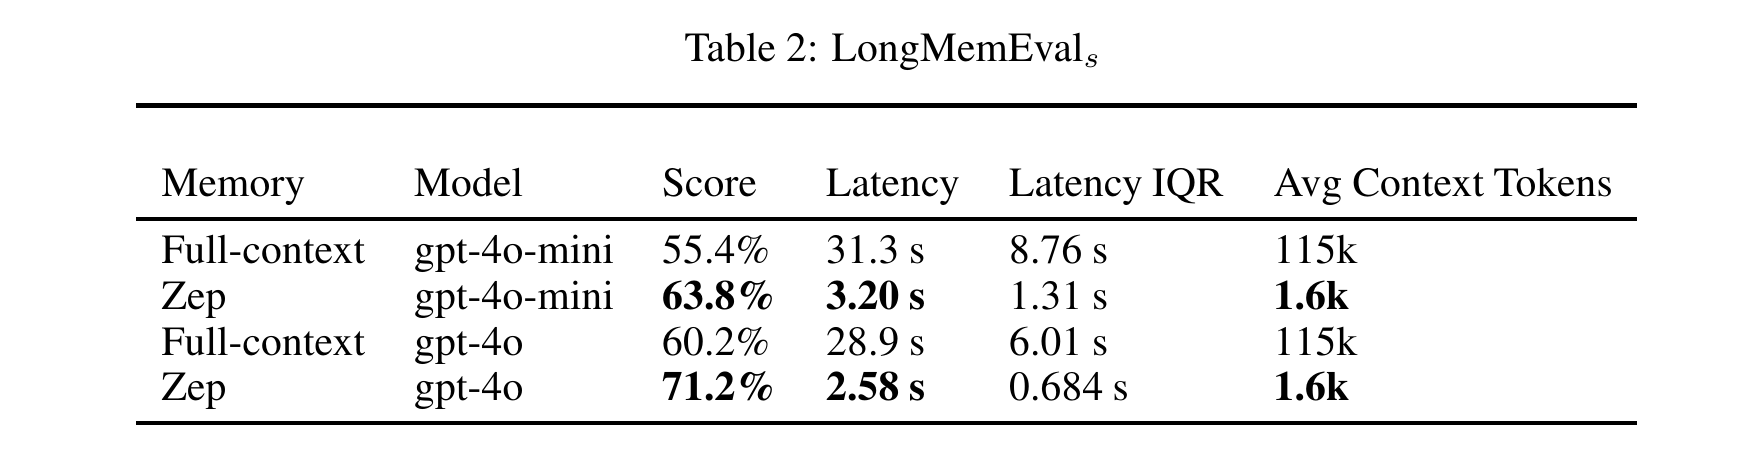
표에서 절대 변화를 계산하면 세 가지 개선이 동시에 일어났음이 드러난다.
| 지표 | gpt-4o-mini | gpt-4o |
|---|---|---|
| 정확도 | 55.4%에서 63.8%로 +8.4%p | 60.2%에서 71.2%로 +11.0%p |
| latency | 31.3초에서 3.20초로 89.8% 감소 | 28.9초에서 2.58초로 91.1% 감소 |
| latency IQR | 8.76초에서 1.31초로 85.0% 감소 | 6.01초에서 0.684초로 88.6% 감소 |
| 평균 context 토큰 | 11만 5천에서 1,600으로 약 98.6% 감소 | 같다 |
정확도와 속도가 함께 오른 것이 이 결과의 핵심이다. context를 줄이면 보통 정보가 잘려 정확도가 떨어지는데, 검색이 관련 있는 fact와 entity만 골라내면 오히려 정확도가 올라갔다. 11만 5천 토큰 안에 답이 들어 있어도 모델이 그것을 찾아 쓰지 못한다는 뜻이다.
latency IQR도 함께 줄었다. IQR은 응답 시간 분포의 사분위 범위이며, 이 값이 작아진 것은 응답 시간의 산포가 좁아져 예측 가능성이 높아졌다는 의미다. gpt-4o에서 Zep의 IQR 0.684초는 full-context의 6.01초보다 한 자릿수 작다.
context 축소 폭과 latency 축소 폭이 비례하지 않는 점도 눈에 띈다. 평균 context 토큰은 약 98.6% 줄었지만 latency는 약 90% 줄었다. 논문은 응답 시간을 구성 요소별로 분해하지 않으므로 남은 시간의 내역은 알 수 없고, 저자들이 밝힌 사실은 Zep 측정에 기준선에 없던 네트워크 지연이 섞였다는 점뿐이다.
두 모델을 비교하면 Zep 쪽 격차가 기준선 쪽 격차보다 크다. full-context에서 gpt-4o는 gpt-4o-mini보다 4.8%p 높았지만, Zep에서는 7.4%p 높았다. 같은 context를 받고도 더 유능한 모델이 시간 정보를 더 잘 쓴다는 뜻이며, 질문 유형별 분해에서도 같은 방향이 확인된다.
질문 유형별 분해
질문 유형별로 나눠 보면 이득이 복잡한 유형에 집중된다. Zep을 쓴 gpt-4o-mini는 여섯 유형 중 넷에서 향상됐고, 가장 큰 향상은 single-session-preference, multi-session, temporal-reasoning에서 나왔다. gpt-4o에서는 knowledge-update까지 개선돼 다섯 유형이 향상됐다.
| Question Type | Model | Full-context | Zep | Delta(논문) | %p 차이 |
|---|---|---|---|---|---|
| single-session-preference | gpt-4o-mini | 30.0% | 53.3% | 77.7% 상승 | +23.3%p |
| single-session-assistant | gpt-4o-mini | 81.8% | 75.0% | 9.06% 하락 | -6.8%p |
| temporal-reasoning | gpt-4o-mini | 36.5% | 54.1% | 48.2% 상승 | +17.6%p |
| multi-session | gpt-4o-mini | 40.6% | 47.4% | 16.7% 상승 | +6.8%p |
| knowledge-update | gpt-4o-mini | 76.9% | 74.4% | 3.36% 하락 | -2.5%p |
| single-session-user | gpt-4o-mini | 81.4% | 92.9% | 14.1% 상승 | +11.5%p |
| single-session-preference | gpt-4o | 20.0% | 56.7% | 184% 상승 | +36.7%p |
| single-session-assistant | gpt-4o | 94.6% | 80.4% | 17.7% 하락 | -14.2%p |
| temporal-reasoning | gpt-4o | 45.1% | 62.4% | 38.4% 상승 | +17.3%p |
| multi-session | gpt-4o | 44.3% | 57.9% | 30.7% 상승 | +13.6%p |
| knowledge-update | gpt-4o | 78.2% | 83.3% | 6.52% 상승 | +5.1%p |
| single-session-user | gpt-4o | 81.4% | 92.9% | 14.1% 상승 | +11.5%p |
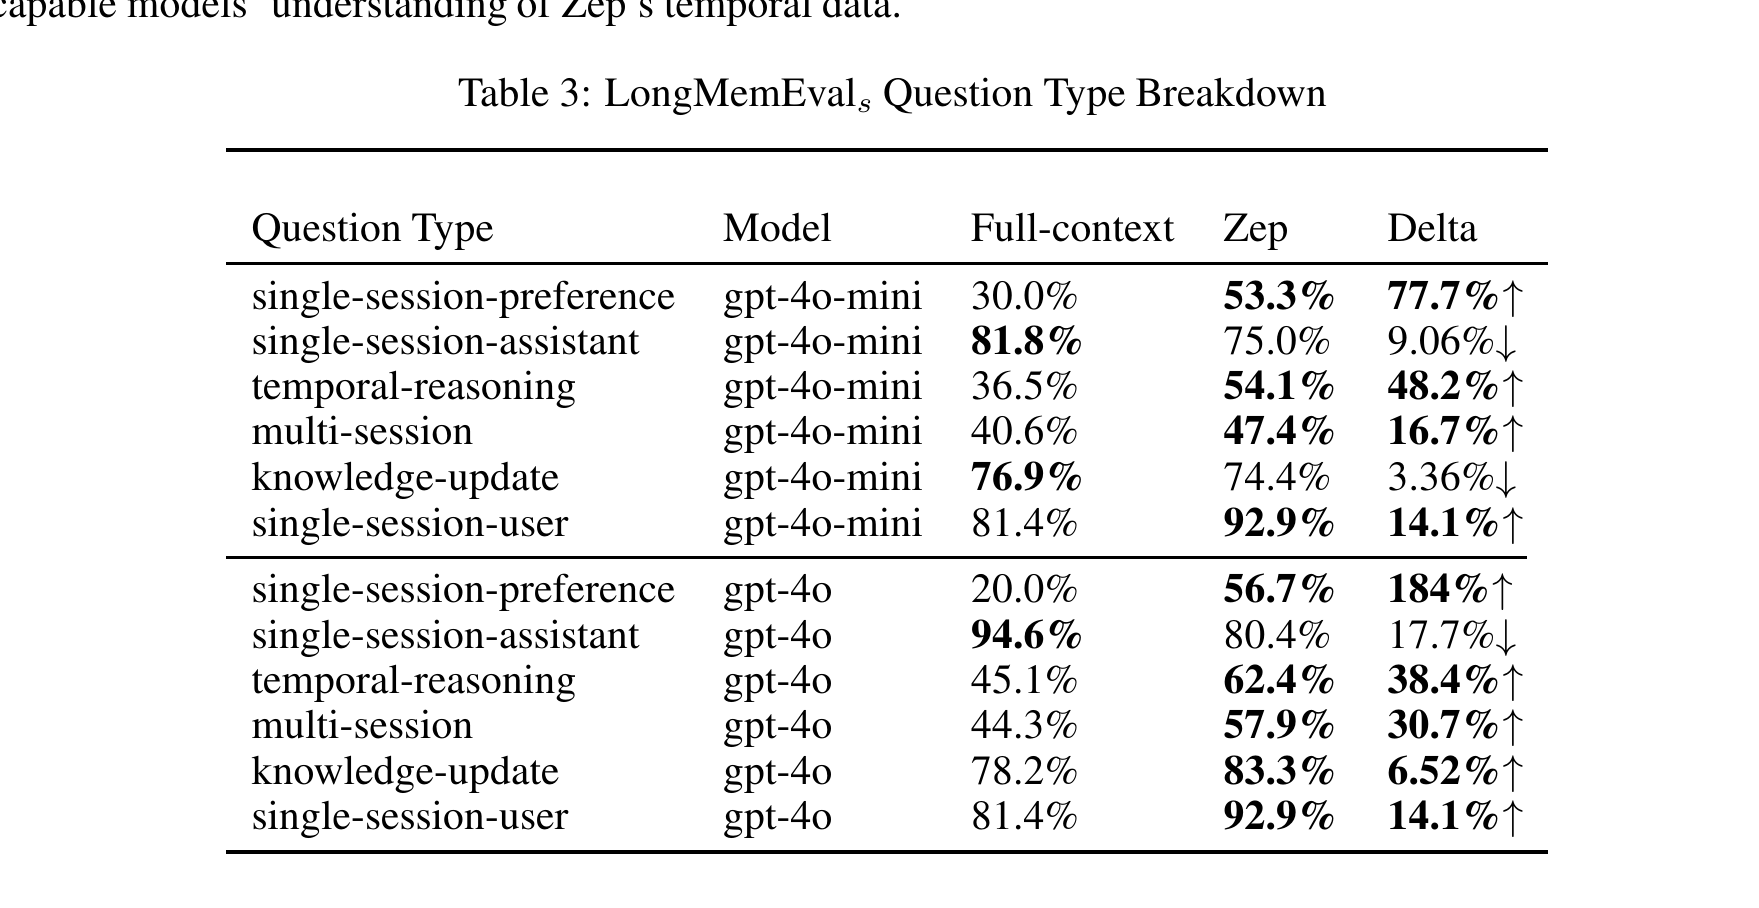
Delta 열은 논문이 표에 적은 상대 변화이고 %p 열은 같은 표의 두 점수 차이를 계산한 값이다. 두 열을 함께 두면 상대 비율이 과장돼 보이는 자리를 확인할 수 있다. gpt-4o의 single-session-preference는 상대 184% 상승이지만 절대 변화는 20.0%에서 56.7%로 36.7%p다. 기준선 값이 20.0%로 낮아 비율이 크게 나온 사례다.
향상 폭이 큰 세 유형에는 공통점이 있다. 다만 논문은 여섯 질문 유형의 정의와 데이터셋 내 분포를 직접 적지 않고 LongMemEval 원 논문으로 넘기므로, 아래 표의 "요구하는 능력" 열은 유형 이름과 Zep의 구조에서 읽어낸 해석이다.
| 유형 | 요구하는 능력 | Zep이 유리한 이유 |
|---|---|---|
| single-session-preference | 사용자의 선호를 세션 안에서 파악 | 선호가 fact로 추출돼 그래프에 남고 검색으로 직접 회수된다 |
| temporal-reasoning | 시점과 순서에 대한 추론 | fact마다 유효 기간이 붙어 있어 시간 정보가 context에 함께 들어간다 |
| multi-session | 여러 세션에 흩어진 정보의 종합 | 세션 경계와 무관하게 entity 단위로 통합되므로 흩어진 사실이 한자리에 모인다 |
| knowledge-update | 갱신된 지식과 낡은 지식의 구분 | edge invalidation이 낡은 사실의 유효 기간을 닫아 준다. 단 gpt-4o에서만 개선됐다 |
knowledge-update 유형은 모델에 따라 결과가 반대로 나온다. gpt-4o-mini에서는 2.5%p 하락하고 gpt-4o에서는 5.1%p 상승했다. 저자들은 더 유능한 모델과 짝지을 때 효과가 커진다고 서술하며, 반대로 덜 유능한 모델이 Zep의 시간 데이터를 이해하도록 하려면 추가 개발이 필요할 수 있다고 덧붙인다.
single-session-assistant 유형의 하락
single-session-assistant는 두 모델 모두에서 하락한 유일한 유형이다. 하락 폭은 gpt-4o에서 상대 17.7%(절대 -14.2%p), gpt-4o-mini에서 상대 9.06%(절대 -6.8%p)다.
저자들은 이 하락을 Zep의 일관된 향상 흐름에서 벗어난 주목할 예외로 명시하고 추가 연구와 엔지니어링이 필요하다고 밝힌다. 원인 분석은 논문에 없다. gpt-4o의 full-context 점수가 94.6%로 이미 매우 높았다는 사실만 표에서 확인할 수 있다.
한계
한계는 두 성격으로 나뉜다. 하나는 실험 설계와 측정 환경에서 온 것이고, 다른 하나는 시스템 자체의 미해결 지점이다. 저자들이 본문에 명시한 항목만 옮긴다.
- 검색 기능의 일부만 평가했다. 두 실험은 Graphiti 전체 검색 능력의 부분집합만 쓴다. community 검색과 episode에서 entity로 이어지는 양방향 순회는 이번 실험 밖이다.
- MemGPT와의 LongMemEval 직접 비교가 없다. MemGPT가 기존 메시지 이력의 직접 적재를 지원하지 않아 같은 조건 비교를 완주하지 못했다. 이 벤치마크에서 Zep의 우위는 full-context 기준선에 대한 우위로만 읽어야 한다.
- 덜 유능한 모델의 시간 추론이 약하다. gpt-4o-mini는 knowledge-update와 single-session-assistant에서 오히려 하락했다. bi-temporal 데이터를 충분히 활용하려면 추가 개발이 필요할 수 있다.
- single-session-assistant 하락의 원인이 규명되지 않았다. 두 모델 모두에서 하락했고 저자들도 원인을 밝히지 못한 채 후속 과제로 남겼다.
- latency에 네트워크 지연이 섞였다. Zep 평가는 보스턴의 노트북에서 AWS us-west-2의 호스팅 서비스에 접속해 진행돼 기준선에는 없던 지연이 포함됐다. 보고된 Zep latency는 보수적으로 읽어야 한다.
- community 갱신은 근사다. 동적 label propagation 확장은 완전 재계산 결과에서 점점 멀어지므로 주기적 전체 갱신이 필요하다. 저자들은 이를 latency와 비용을 줄이는 실용적 heuristic으로 규정한다.
- DMR 결과의 우위 폭이 좁다. gpt-4-turbo에서 1.4%p, gpt-4o-mini에서 0.2%p 차이이며, 저자들 스스로 벤치마크 자체가 메모리 시스템 판별에 부적절하다고 논증한다.
후속 방향
결론부는 후속 방향을 다섯 가지로 제시한다.
| 방향 | 내용 |
|---|---|
| 추출 전용 fine-tuning 모델 | GraphRAG 계열에서 entity와 엣지 추출에 fine-tuning 모델을 쓰면 정확도가 오르고 비용과 latency가 낮아진다는 연구가 이미 있다(Distill-SynthKG, Triplex). Graphiti 프롬프트에 맞춘 모델도 특히 복잡한 대화의 지식 추출을 개선할 수 있다 |
| 도메인 ontology 도입 | ontology는 도메인의 개체 종류와 관계 타입을 고정된 집합으로 정의한 구조를 말한다. LLM이 생성하는 knowledge graph 연구는 대체로 형식 ontology 없이 진행돼 왔고, LLM 이전 연구의 기반이었던 graph ontology를 Graphiti 안에서 더 탐색할 가치가 있다 |
| 메모리 벤치마크 확충 | 기존 벤치마크는 선택지가 적고 견고성과 복잡성이 부족해 단순한 바늘 찾기식 사실 검색 질문으로 흐르는 경우가 많았다. 고객 경험 과제처럼 실제 업무 활용을 반영하는 벤치마크가 더 필요하다 |
| 대화와 정형 데이터의 통합 평가 | 대화 이력과 정형 업무 데이터를 함께 처리하고 합성하는 Zep의 능력을 적절히 평가하는 기존 벤치마크가 없다 |
| 전통적 RAG 능력 평가 | Zep은 LLM 메모리에 초점을 두지만 전통적 RAG 능력도 LightRAG, FinanceBench, BEIR 같은 정착된 벤치마크로 평가해야 한다 |
여기에 GraphRAG의 다른 접근을 Zep 패러다임에 통합하는 경로와, LightRAG의 high-level key 검색을 Graphiti 같은 graph 기반 시스템과 결합하는 경로가 더해진다.
저자들 자신의 평가도 절제돼 있다. Graphiti와 Zep의 결과가 인상적이지만 graph 기반 메모리 시스템의 초기 진전에 지나지 않을 것이라고 결론부에 적는다.
원문 안의 불일치
논문을 다시 읽으면서 확인한 내부 불일치를 남긴다. 네 항목 모두 이 페이지가 추정한 것이 아니라 논문 본문과 표에 그대로 있는 값의 차이다.
| 항목 | 내용 | 이 페이지의 처리 |
|---|---|---|
| 검색 개수 | 4절은 "가장 관련 있는 엣지와 entity 노드 20개"를 검색했다고 적고, 4.2절은 같은 절차를 "상위 10개"로 적는다 | DMR 서술에는 4.2절의 10개를 쓰고 이 불일치를 여기에 기록한다 |
| Delta 열의 기준값 | Table 3의 상승 행은 full-context 점수를 분모로 삼지만 하락 행은 Zep 점수를 분모로 삼는다. single-session-assistant gpt-4o의 경우 (94.6-80.4)/80.4 = 17.7%이며, full-context를 분모로 삼으면 15.0%가 된다 | Delta 열은 논문 값을 그대로 옮기고 %p 열을 나란히 두었다 |
| 상대 향상 18.5% | Table 2의 반올림 값으로 다시 계산하면 71.2/60.2 - 1 = 18.3%다. gpt-4o-mini의 15.2%는 63.8/55.4 - 1 = 15.2%로 정확히 맞는다 | 논문 값 18.5%를 그대로 인용하고 %p 계산을 함께 제시한다 |
| single-session-user 행 | Table 3에서 gpt-4o-mini와 gpt-4o의 값이 81.4%에서 92.9%로 완전히 같고 Delta도 14.1%로 같다. 다른 다섯 유형은 모두 모델별로 값이 다르다 | 표에 논문 값을 그대로 옮겼다. 두 모델이 같은 값을 낼 수도 있으나 표기 오류 가능성도 있어 여기에 남긴다 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| episode | 메시지, 텍스트, JSON 원본을 그대로 담는 non-lossy 저장 단위. 여기서 entity와 fact가 파생되고 모든 파생 정보는 여기로 출처를 남긴다 |
| fact (semantic edge) | 두 entity 사이의 관계를 담은 엣지. 핵심 술어를 relation_type 대문자 표기로 갖고, 여러 entity가 걸린 복합 fact는 hyper-edge로 표현한다 |
| bi-temporal 모델 | 사건이 일어난 시간 축 T와 데이터가 처리된 시간 축 T′를 분리해 추적하는 모델. 엣지마다 t′_created, t′_expired, t_valid, t_invalid 네 시각을 저장한다 |
| edge invalidation | 모순되는 새 fact가 오면 예전 엣지를 지우지 않고 t_invalid를 새 엣지의 t_valid로 설정해 유효 기간을 닫는 갱신 방식 |
| label propagation | Zep이 Leiden 대신 택한 community 탐지 알고리즘. 새 노드를 이웃 다수의 community에 배정하는 단일 재귀 단계로 증분 확장한다 |
| DMR (Deep Memory Retrieval) | MemGPT 팀이 만든 메모리 검색 벤치마크. Multi-Session Chat의 500대화 부분집합이며 대화당 60메시지다 |
| LongMemEval_s | 평균 약 11만 5천 토큰짜리 장기 대화로 실제 업무 시나리오를 반영한 메모리 벤치마크의 부분집합. 여섯 질문 유형을 담는다 |
관련 페이지
- getzep/graphiti: 같은 엔진의 오픈소스 구현체. 이 페이지가 논문의 방법론과 벤치마크 결과를 담당하고, 설치와 그래프 백엔드 설정, LLM 제공자 교체 같은 구현과 운영은 그 페이지가 담당한다
- Memory Intelligence Agent (MIA): 에이전트 메모리를 별도 관점에서 다룬 자료
- From RAG to Memory: Non-Parametric Continual Learning for Large Language Models: HippoRAG 2. knowledge graph와 Personalized PageRank로 장기 메모리를 푸는 다른 접근
- GraphRAG: From Local to Global: GraphRAG 원논문. Zep이 community 개념과 map-reduce 요약을 빌려온 출처이며, community 탐지 알고리즘은 Leiden에서 label propagation으로 교체됐다
- LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025): LightRAG. Zep이 자기 community 검색의 병렬 사례로 지목하고 결합을 후속 과제로 제시한 연구이며, latency를 우선 보고하는 관행의 선례로도 인용된다