Agents · PAPER · 2026
TaskMem: Task-Focused Memorization for Multimodal Agents
요약
TaskMem은 multimodal agent가 무엇을 장기 메모리에 남길지를 사람이 정해 주는 대신 모델이 학습해서 정하게 만든 프레임워크다. ByteDance Seed와 Fudan University 연구진이 2026-05-29 arXiv에 공개했다. 기존 multimodal 메모리 연구가 메모리 생성을 프롬프트나 SFT로 고정한 하나의 단계로 다뤘던 것에 반해, 이 논문은 그 단계를 강화학습으로 최적화하는 policy로 다시 정의한다.
정의를 바꾼 데서 두 단계 학습이 따라 나온다. 배포 전 단계는 "어떻게 기억할지"를 배운다. GSPO와 네 항으로 이루어진 reward로 정확하고 중복이 없으며 내용이 풍부한 episodic memory를 만들게 학습한다. 배포 후 단계는 "무엇을 기억할지"를 배운다. 환경에서 실제로 들어온 최근 task 5개에서 10개의 feedback을 reward model로 증폭해 선호 데이터를 만들고, 단일 layer에 삽입한 2,048 파라미터 벡터만 DPO로 갱신한다.
Qwen3-VL-30B-A3B 위에서 VQA 벤치마크 세 개를 streaming 형태로 재구성해 평가했다. base 모델 대비 accuracy가 VideoMME에서 6.3%p, EgoLife에서 7.0%p, EgoTempo에서 5.3%p 올랐고, 두 벤치마크의 accuracy와 precision에서는 GPT-5.2와 Gemini-2.5-Pro를 포함한 모든 baseline을 앞섰다.
이 페이지가 다루는 값은 성능 수치보다 두 가지 관찰에 있다. 첫째, 프롬프트로 task 정보를 주는 것과 파라미터를 갱신하는 것이 다른 결과를 낸다. 둘째, 학습된 2,048차원 벡터는 task별 초점을 담고 있어서 다른 task로 가져가면 오히려 성능이 내려간다. 저자들은 이 벡터를 "parametric personalized memory"라고 부른다.
배경
무엇을 기억할지가 남는 문제
multimodal agent는 물리 환경이나 가상 환경에서 끊임없이 지각하고 추론하고 행동한다. 그 과정에서 시각과 청각과 공간 정보가 끝없이 흘러 들어온다. 장기 메모리는 이 흐름을 넘어 일관성을 유지하고 세계 지식을 쌓고 긴 horizon의 의사결정을 지원하는 데 필요하다.
그런데 메모리 모듈을 잘 설계하고 정확성과 충실성 같은 기본 요건을 채워도 문제가 하나 남는다. 무한한 관찰 중 무엇을 남길지 정하는 문제다. 저자들은 이를 AI Frame Problem [48]과 연결한다. AI Frame Problem은 가능성의 조합 폭발에 압도되지 않으면서 문맥상 관련 있는 정보를 식별하는 문제를 말한다.
논문이 이 문제를 확장하는 지점이 핵심이다. agent는 지금 무엇이 관련 있는지만 정해서는 부족하고, 앞으로 무엇이 쓸모 있을지까지 정해야 한다. 따라서 메모리 선택은 agent가 환경에서 맡은 역할과 받는 task에 따라 동적으로 적응해야 한다.
저자들이 드는 예시가 이 주장을 구체화한다. 주로 집안일을 맡은 로봇이라면 집 구조에 관한 메모리를 만들어야 한다. 반면 사용자와 관련된 지시를 자주 받는 로봇이라면 사용자의 선호와 습관과 감정 같은 사용자 중심 메모리를 우선해야 한다. 같은 영상을 보더라도 남겨야 할 것이 달라진다.
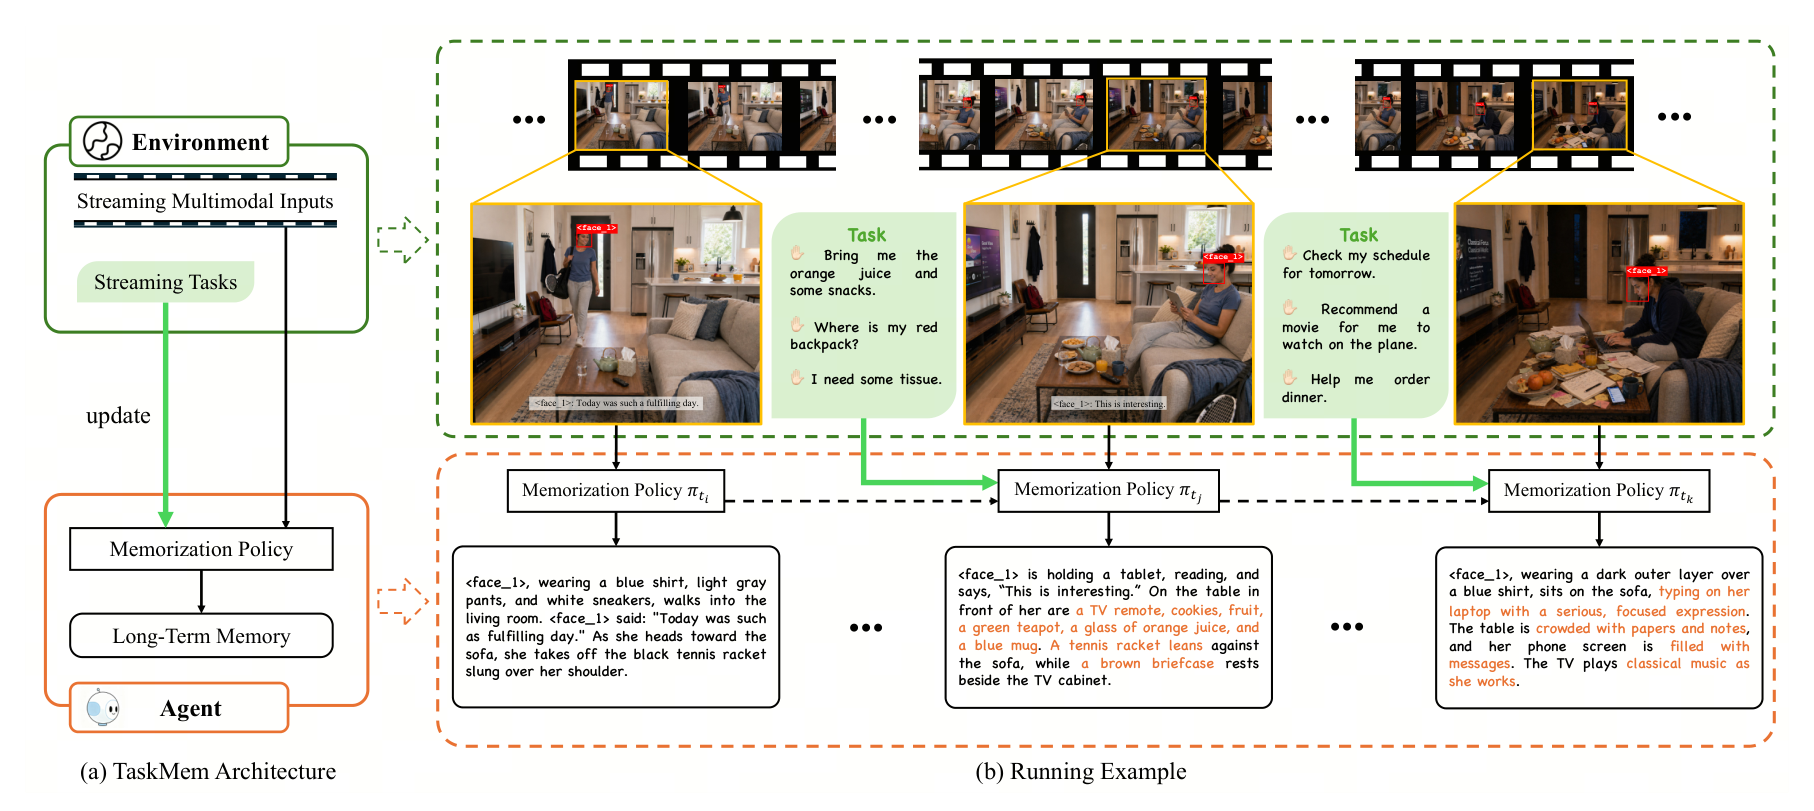
Figure 1의 오른쪽이 그 변화를 보여준다. 처음에는 인물의 옷차림과 동작만 남지만, "오렌지 주스와 간식을 가져다 달라" 같은 task가 들어온 뒤에는 탁자 위의 TV 리모컨과 쿠키와 과일과 녹색 찻주전자와 오렌지 주스 잔과 파란 컵이 메모리에 들어온다. "내일 일정을 확인해 달라"는 task 뒤에는 서류와 메모가 널린 탁자와 메시지가 찬 휴대전화 화면이 들어온다.
기존 메모리 프레임워크의 공통 한계
논문이 진단하는 선행 연구의 지형은 네 묶음이다.
| 묶음 | 내용 | 인용 |
|---|---|---|
| memory bank와 희소 메모리 표현 | 장편 영상 이해를 위한 메모리 저장 구조 | [23, 50] |
| 구조화된 이질 메모리 | 텍스트, 객체 중심, episodic, semantic, visual 표현을 함께 쓴다 | [16, 37, 63] |
| 지속적 통합과 구조적 retrieval | neuro-symbolic 추론을 결합한 진전된 시스템 | [7, 32, 36] |
| 개인화와 검증 가능성 | 벤치마크 설정까지 포함한 최근 확장 | [5, 10, 18] |
이 연구들은 대부분 메모리 구축을 task 수행과 나란히 도는 독립 과정으로 다룬다. MLLM이 메모리 내용을 만들고, 그 옆에 저장 [16, 23, 50]과 통합 [7, 36]과 오류 수정 [10]을 담당하는 시스템 수준 장치가 붙는다.
문제는 메모리 내용 생성 자체가 여전히 heuristic이라는 것이다. 프롬프트 엔지니어링에 기대거나 [7, 16, 32] 미리 정한 템플릿으로 post-training한다 [36, 37]. 어느 쪽도 어떤 정보를 기억해야 하는지를 명시적으로 최적화하지 않는다. 결과적으로 메모리의 형성이 실제 환경의 task 요구와 잘 맞지 않을 수 있다.
시간이 흐르며 multimodal 관찰이 쌓이면 메모리 품질 유지가 점점 어려워지고, 이는 하위 retrieval과 추론에 부정적 영향을 준다 [38, 45, 58]. 이 문헌 지형이 TaskMem의 출발점이다.
test-time training 계보와의 관계
논문은 Phase Two를 test-time training(TTT) 계보에도 놓는다. TTT는 추론 도중 현재 test 인스턴스와 관련된 데이터로 모델 파라미터를 적응시켜 현재 task 분포에 맞추는 접근이며, 뿌리는 local learning 연구 [6]까지 올라간다. LLM에서는 학습 코퍼스에서 검색한 nearest neighbor로 적응하는 방식 [22]과 적응에 쓸 데이터를 능동적으로 고르는 개선 [30]이 있었다. continual learning [8, 14, 31, 33]과 밀접하며 공통 난점은 catastrophic forgetting [19, 26, 33]이다.
저자들이 자기 설정을 구분하는 지점이 중요하다. 기존 TTT는 task 입력이나 test 인스턴스에서 유도한 자기지도 목표처럼 직접적인 적응 신호에 기댄다 [1, 22, 26]. 반면 배포된 multimodal agent는 메모리 품질을 반영하는 신호를 직접 관찰할 수 없다. agent가 볼 수 있는 것은 환경의 task와의 상호작용뿐이다. 관찰 가능한 경험과 메모리 최적화 목표 사이에 간극이 생기며, 뒤에 나오는 feedback augmentation이 이 간극을 메우는 장치다.
핵심 개념
memorization policy는 streaming 입력을 받아 무엇을 메모리로 남길지 정하는 함수를 말한다. 이 논문의 가장 큰 이동이 여기 있다. 메모리 생성이 고정된 요약 절차가 아니라 학습으로 바뀌는 policy 가 된다.
episodic memory는 시간 순서가 붙은 사건 중심 경험을 담는 메모리 층이다. agent가 무엇이 언제 어디서 일어났는지를 기록한다. 논문은 이 층을 대표 사례로 다루되 같은 정식화가 semantic memory와 visual memory로 확장된다고 밝힌다.
GSPO는 group 안에서 정규화한 advantage와 sequence 수준 importance ratio로 강화학습을 수행하는 알고리즘이다 [65, 66]. 메모리 생성은 열린 형태의 긴 글 생성이라 토큰 단위 신호보다 sequence 전체에 붙는 reward가 자연스럽다.
DPO는 pairwise 선호 데이터로 policy를 직접 최적화하는 알고리즘이다 [44]. 별도의 reward model을 학습해 강화학습을 도는 절차 없이 선호 쌍만으로 정렬한다.
adapter는 특정 layer의 출력에 더해지는 학습 가능한 벡터를 말한다. 이 논문에서는 2,048차원 벡터 하나이며 backbone은 얼린 채 이것만 갱신한다.
reward hacking은 policy가 목표 자체를 달성하지 않고 reward 지표만 높이는 방향으로 학습되는 현상이다. 이 논문에서는 짧고 내용 없는 메모리로 quality 점수를 얻는 형태로 나타나며, richness reward가 그것을 막는 장치다.
Coverage와 Precision은 메모리 평가의 두 기준이 되는 지표다. Coverage는 메모리가 답에 필요한 정보를 담은 질문의 비율이고, Precision은 메모리가 충분하다고 판정된 질문 중 정답 비율이다. 둘의 관계를 알면 결과 해석이 달라진다. Coverage가 낮고 Precision이 높으면 메모리가 적게 담되 담은 것은 맞다는 뜻이다.
방법
문제 정식화
각 step 에서 agent는 새 video segment 를 관찰하고 지금까지 만든 메모리를 유지한다. policy가 참조하는 것은 전체 이력이 아니라 sliding window다. 최근 개 segment와 그중 앞 개에 대해 만든 메모리로 컨텍스트를 짓는다.
이 컨텍스트에서 policy 가 에 대한 메모리 를 정한다. 강화학습 용어로 전체 trajectory는 이고, trajectory 수준 reward 는 마지막 토큰 하나에서 주어진다. 목표는 기대 return을 최대화하는 것이다.
논문은 이후 표기를 단순화해 절대 시간 인덱스를 떼고 , 로 다시 적는다. 실험에서 이고 clip 하나가 10초이므로 policy가 한 번에 보는 범위는 50초 분량이다.
좋은 episodic memory의 요건 네 가지가 뒤의 reward 설계를 그대로 예고한다.
| 요건 | 뜻 | 대응하는 장치 |
|---|---|---|
| faithful | 현재 video segment의 내용에 충실하다 | quality reward의 시각 충실성 판정 |
| coherent | 앞서 만든 메모리와 서술이 이어진다 | quality reward의 문맥 일관성 판정 |
| non-redundant | 이미 저장된 정보를 되풀이하지 않는다 | quality reward의 비중복 판정 |
| useful for future tasks | 앞으로 들어올 task를 푸는 데 쓸모가 있다 | Phase Two 전체 |
앞의 세 요건은 현재 입력만 보고 판정할 수 있다. 마지막 요건은 환경의 task를 봐야 판정할 수 있다. 이 차이가 두 단계로 나뉘는 근거다.
강화학습을 택한 이유
선행 연구는 주로 SFT를 썼다 [37, 60]. 논문이 지적하는 한계가 두 가지다. 성능이 합성 학습 데이터를 만든 모델의 품질에 갇히고, maximum likelihood 목표가 전역 수준의 목표를 명시적으로 강제하지 못한다.
반대로 큰 모델은 생성보다 평가에 강하다 [4, 46]. 영상과의 사실 정합을 판정하거나 중복을 찾아내는 일은 정확하고 중복 없는 글을 직접 쓰는 일보다 쉽다. 이 비대칭을 reward 신호로 활용하면 두 가지를 얻는다. 큐레이션한 SFT 데이터가 필요 없어 raw video만으로 학습할 수 있고, 판정자의 강점을 그대로 학습 신호로 쓸 수 있다.
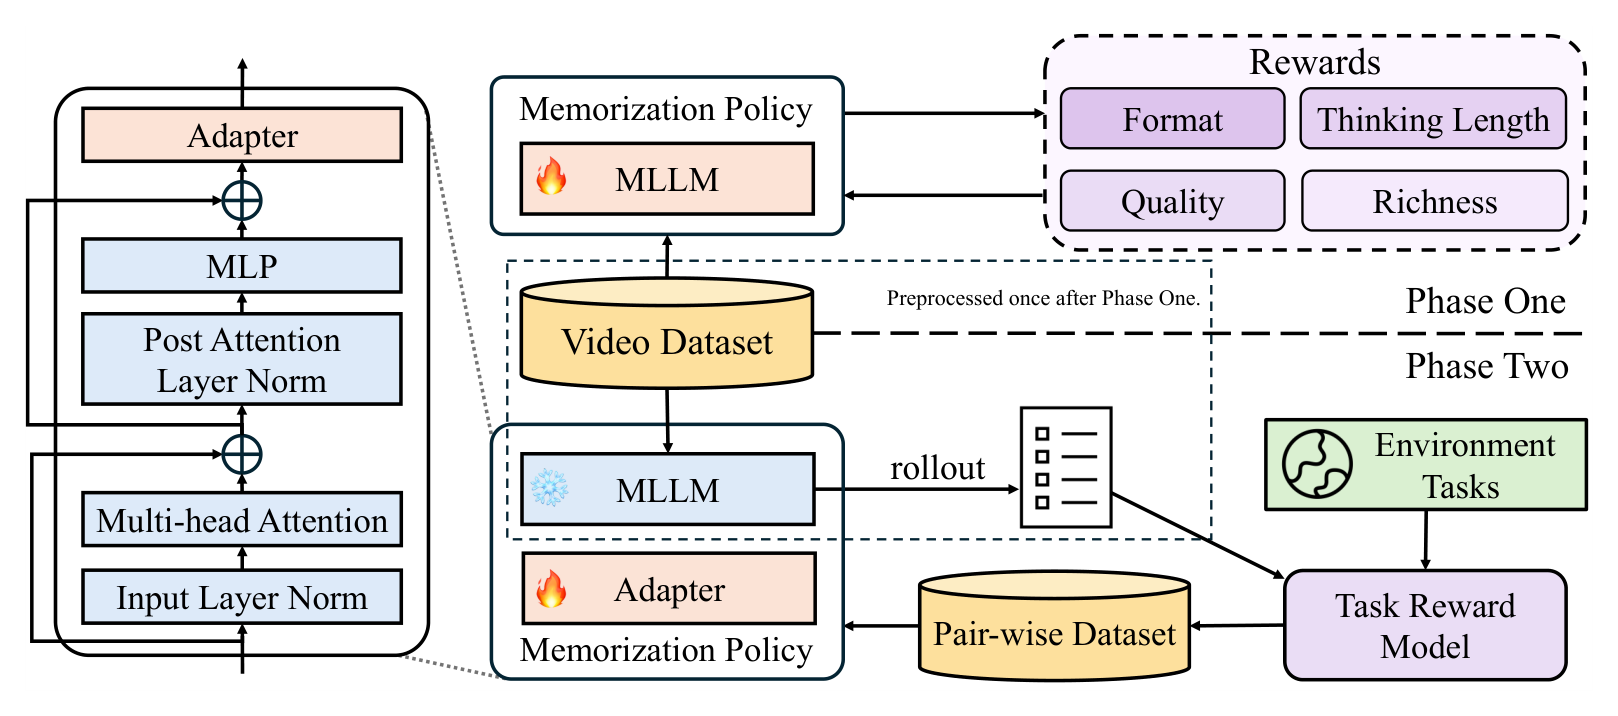
Phase One의 최적화 알고리즘
Phase One은 GSPO를 쓴다. 입력 마다 policy가 개 trajectory를 rollout하고, group 안에서 reward를 정규화해 advantage를 얻는다.
importance ratio는 토큰 길이로 정규화한 sequence 수준 비율이다. 지수 $1/|m_{k,i}|$가 길이 정규화를 담당한다.
목적함수는 clipped surrogate 형태다.
group 정규화가 뒤에 나오는 NSR 문제의 원인이 되므로 여기서 짚어 둘 필요가 있다. advantage는 절대 품질이 아니라 group 안의 상대 위치를 재는 값이다. group 전체가 잘한 경우에도 그중 하위 절반에는 음의 advantage가 붙는다.
4중 reward의 구성
trajectory 수준 reward는 네 항의 합이다.
부록 B가 각 항을 상수까지 정의한다. 계산 구조가 단순한 합이 아니라 format을 관문으로 삼는 계층이라는 점이 중요하다. 형식을 어긴 출력은 format 페널티만 받고 나머지 항이 모두 0으로 처리된다. 형식이 깨진 출력은 신뢰할 수 있게 파싱하거나 평가할 수 없기 때문이다.
| 항 | 값 | 산출 방식 |
|---|---|---|
| 유효 0, 위반 | 규칙 기반. 중간 추론이 지정 태그 안에 있고 최종 메모리가 지정 JSON 스키마를 따르는지 검사한다 | |
| 아래 식 | 규칙 기반. , 토큰 | |
| 전 기준 통과 , 아니면 | Gemini-2.5-Flash가 시각 충실성과 문맥 일관성을, GPT-4o가 문장 유효성과 비중복을 판정한다. 토큰 예산 준수는 규칙 검사 | |
| , | GPT-4o가 유효 후보를 풍부함으로 순위 매김한다. 유효 후보가 2개 이상일 때만 적용 |
thinking length reward는 세 구간의 조각별 함수다. 임계값 이하는 벌점이 없고, 임계값과 그 두 배 사이에서 선형으로 벌점이 커지며, 두 배를 넘으면 최대 벌점에서 멈춘다.
richness의 정규화 점수는 group 안 순위를 0에서 1 사이 값으로 바꾼 것이다. 1위가 1점, 최하위가 0점이다.
quality 유효 임계값은 이다. 상수를 모아 보면 설계 의도가 드러난다. reward의 이론적 최대는 $0.5 + 0.05 = 0.55-1.5$다. 즉 richness가 기여할 수 있는 폭은 quality의 10분의 1에 불과하고 format 위반의 벌점은 quality 만점의 3배다. richness는 주 신호가 아니라 우수 후보 사이의 순위를 가리는 보조 신호로 설계됐다. Figure 3의 학습 곡선이 0.4 근처에 머무는 것도 이 범위와 맞는다.
모든 평가 프롬프트는 실험 전체에서 고정되고 reward 질의는 deterministic decoding으로 수행한다. 판정 결과가 실행마다 흔들리지 않게 하려는 조치다.
richness reward가 막는 우회
quality reward만 최적화하면 policy가 목표를 우회한다. 정확하기는 하지만 실질 내용이 없는 출력을 내는 방향으로 학습된다. 짧게 쓰면 틀릴 여지도 중복될 여지도 줄어드니 quality 판정을 통과하기 쉬워진다.
richness reward는 group 안에서 상대적으로 정의된다. 절대 기준으로 "얼마나 풍부한가"를 매기는 대신, 같은 입력에서 나온 유효 후보들을 서로 견줘 순위를 매긴다. 이 상대성이 중요하다. 절대 기준을 쓰면 길게 쓰기만 하면 점수를 받는 새 우회가 열리는데, group 상대 순위는 같은 입력에서 낼 수 있는 최선과 비교하므로 그 우회가 닫힌다.
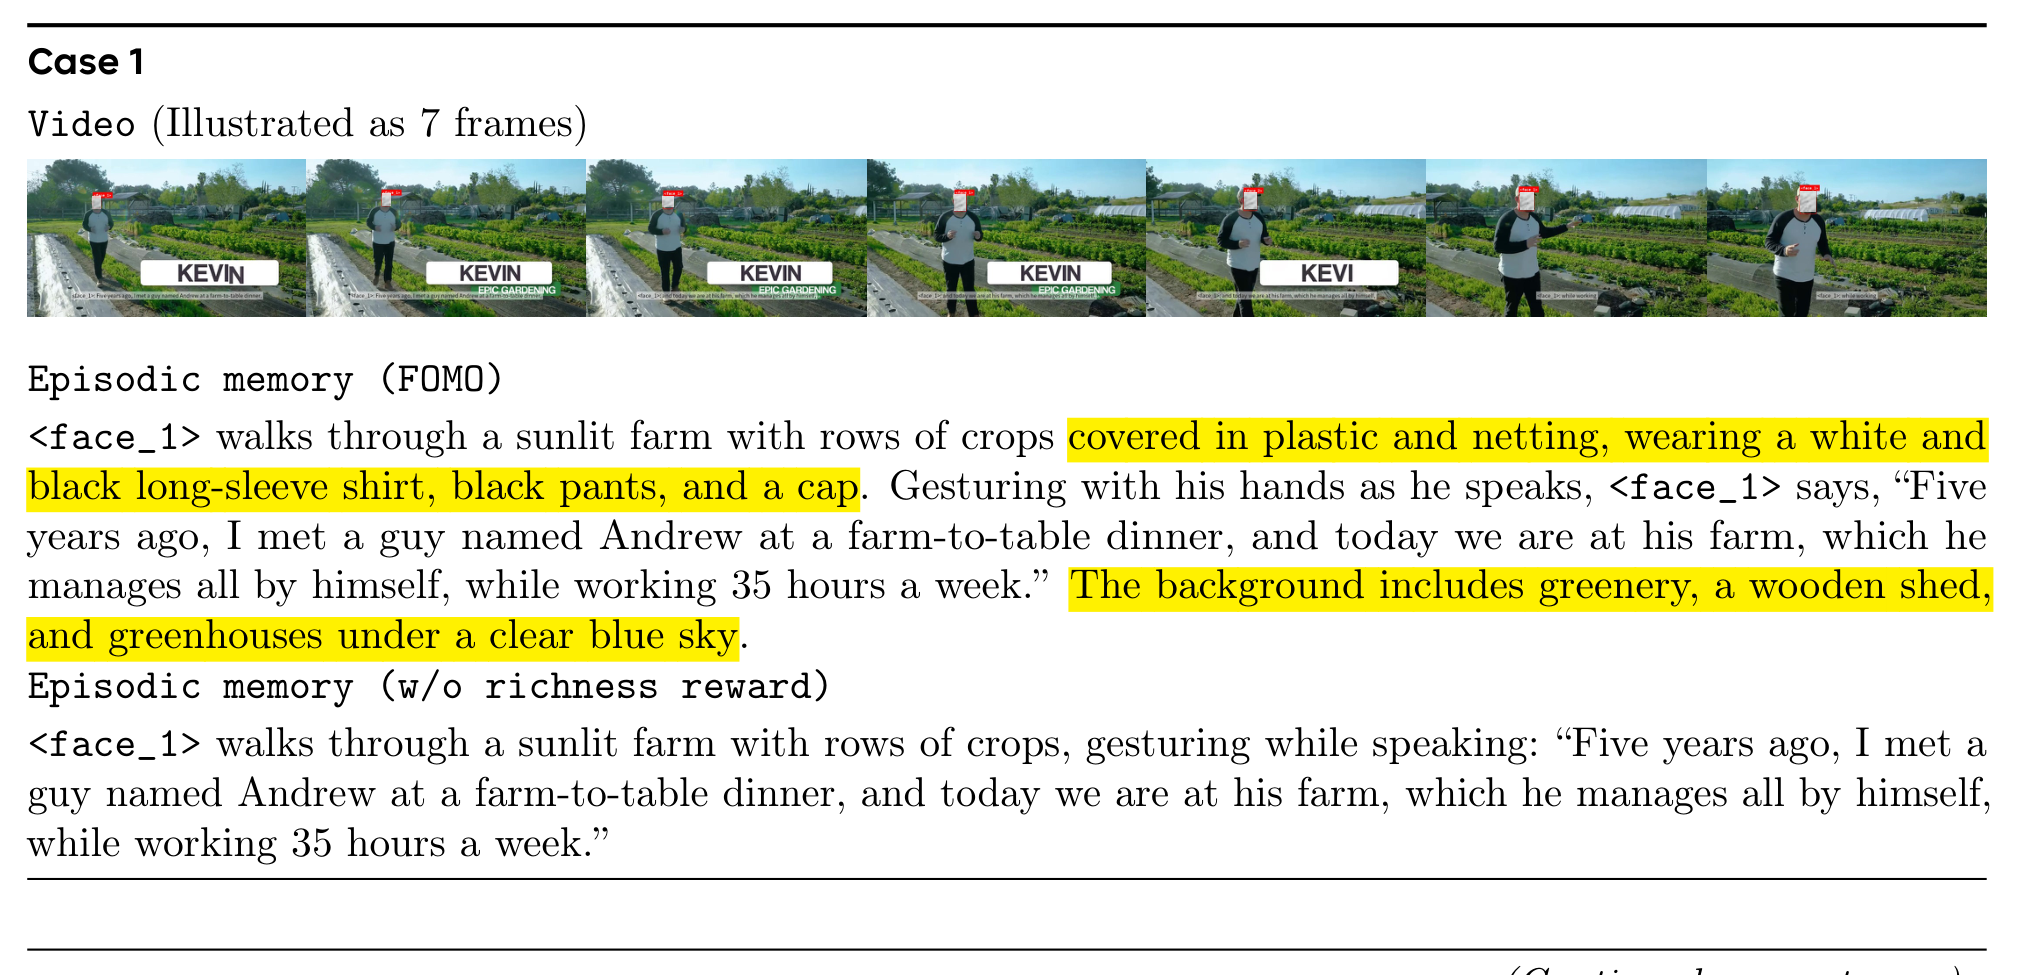
Table 15의 첫 사례가 차이를 보여준다. 농장 영상에서 본 모델은 작물이 비닐과 그물로 덮여 있다는 사실, 인물의 흰색과 검정 긴팔 셔츠와 검정 바지와 모자, 배경의 녹지와 목조 창고와 온실과 맑은 하늘까지 남긴다. richness reward를 뺀 쪽은 같은 영상에서 인물이 작물 사이를 걸으며 말한다는 사실과 발화 인용만 남기고 시각 세부를 모두 버린다. 3개 사례가 같은 패턴을 보인다.
이 표에서 identity overlay도 함께 확인된다. 프레임마다 인물 얼굴에 붙은 빨간 라벨이 face ID이고 아래쪽 띠가 화자 태그가 붙은 자막이다.
NSR gating과 후반 학습 안정성
저자들은 학습 신호를 두 항으로 분해한다. PSR은 advantage가 양수인 응답을 강화하고, NSR은 음수인 응답에 벌점을 준다.
관찰된 현상은 policy의 평균 reward가 비교적 높은 수준에 이르면 NSR이 불안정을 일으킨다는 것이다. 원인은 group 정규화의 성질에 있다. 모든 후보가 좋은 메모리를 낸 group에서도 상대적으로 뒤처진 절반에는 음의 advantage가 붙는다. 그 샘플까지 벌점을 주면 실제로는 좋은 출력을 억제하게 된다.
해결책은 reward 자체가 음수인 샘플에만 NSR을 적용하는 gate다.
지시함수는 if 이고 그 밖에는 0이다. 두 조건이 겹칠 때만 벌점이 간다. advantage가 음수이고(group 안에서 뒤처졌고) reward도 음수여야(절대 기준으로도 나빠야) 한다. 앞의 reward 상수와 함께 읽으면 이 gate가 실제로 걸러내는 것은 format을 어겼거나 quality 판정을 통과하지 못한 출력이다.
이 기법은 PSR과 NSR을 나눠 안정성을 분석한 선행 연구 [67]를 다중 reward 설정으로 확장한 것이다.
history를 만드는 두 단계
policy가 참조하는 history 을 누가 만드는지가 Phase One을 두 sub-stage로 나눈다.
| 단계 | history 출처 | 목적 |
|---|---|---|
| off-policy history | Gemini-2.5-Pro가 합성 (프롬프트는 Table 19) | 현재 policy로 history를 뽑는 비용을 피하고 만 최적화한다 |
| on-policy history | 현재 policy가 직접 생성 | 학습 시점과 배포 시점의 history 분포 차이를 없앤다 |
첫 단계가 남기는 문제가 두 번째 단계의 이유다. 배포 시점에는 모든 history 메모리가 policy 자신에게서 나오는데, off-policy 단계에서는 다른 모델에서 나온다. 이 분포 차이를 닫으려고 현재 policy가 만든 history로 GSPO를 이어 간다.
on-policy 단계의 절차가 Algorithm 1이다. 초기화 때 배치 크기 만큼 영상을 뽑고 각 영상에서 무작위 시작점의 10초 clip 하나를 초기 입력으로 삼는다. 각 인스턴스는 같은 장편 영상에서 소비한 clip 수를 세는 counter 를 든다.
매 학습 step은 두 국면으로 이루어진다. 먼저 배치 원소마다 후보 메모리 group을 뽑아 reward model로 채점하고 GSPO로 policy를 갱신한다. 이어서 배치를 재구성해 영상 다양성과 컨텍스트 길이 분포를 함께 유지한다.
| 조건 | 처리 | 의도 |
|---|---|---|
| 무조건 Extend | 긴 컨텍스트에 충분히 노출시킨다 | |
| 무조건 Resample | 한 영상에 오래 머물지 않게 한다 | |
| 그 사이 | 확률 로 Extend, 아니면 Resample | 두 목적을 확률로 절충한다 |
Extend는 뽑힌 메모리 후보 하나를 골라 history에 붙이고 다음 clip을 추가한다. window가 를 넘으면 앞쪽을 밀어내 컨텍스트를 clip 5개 이내로 유지한다. Resample은 새 영상과 새 시작점을 뽑아 counter를 1로 되돌린다. 과 의 구체적 값은 논문에 적히지 않았다.
학습 데이터는 사내 장편 영상 데이터셋의 영상 326편, 영상당 평균 25.15개 clip이다. 영상 수가 적은 것은 이 설정이 정답 레이블이 아니라 판정자 reward로 학습하기 때문이다.
Phase Two가 풀어야 하는 세 제약
Phase Two는 배포된 환경에서 도는 온라인 학습이다. 사람이 과거 경험으로 행동을 다듬는 방식을 모사한다는 것이 저자들의 직관이다. agent는 최근 task로 앞으로 들어올 task의 분포를 추정하고 그에 맞춰 메모리 초점을 조정한다. 각 갱신 창에서 최근 개 task를 쓴다.
배포 시점에 학습을 돈다는 설정이 세 제약을 만든다.
| 제약 | 내용 | 대응 |
|---|---|---|
| sparse feedback | 최근 task 소수(예: 질문 10개)만으로 갱신해야 해서 학습 신호가 적다 | reward model로 pairwise preference를 만들어 신호를 증폭한다 |
| catastrophic forgetting | 파라미터 갱신이 Phase One에서 얻은 능력을 덮어쓰거나 훼손한다 | backbone을 얼리고 2,048 파라미터 adapter만 학습한다 |
| computational efficiency | 배포 시점 갱신이 서빙에 영향을 주면 안 된다 | rollout 캐시를 미리 만들고 adapter만 짧게 학습한다 |
세 제약이 서로를 강화한다는 점이 설계를 이해하는 열쇠다. 학습 데이터가 적으면 큰 파라미터 집합은 과적합하고 잊는다. 반대로 파라미터가 적으면 적은 데이터로도 학습할 수 있고 학습 시간도 짧다. adapter라는 선택 하나가 세 제약을 함께 눌러 준다.
rollout 캐시와 상대 선호 판정
Phase One policy 이 고정되면 Phase Two용 rollout 캐시를 한 번 미리 계산한다. 각 streaming 컨텍스트 에 대해(history 메모리는 이 생성) 현재 clip용 후보 메모리 개를 에서 뽑아 로 저장한다. 캐시는 Phase Two 동안 고정되며, task 환경에 적응할 때 후보를 다시 샘플링하지 않고 정답도 쓰지 않는다.
미리 계산이 세 번째 제약을 푸는 방식이 여기서 드러난다. 배포 시점에 남는 계산은 캐시된 후보에 대한 선호 판정과 adapter 학습뿐이고, 값비싼 영상 rollout은 이미 끝나 있다.
task reward model은 절대 점수를 내는 채점기가 아니라 상대 선호 판정기다. 최근 질문 묶음 와 같은 컨텍스트에서 나온 후보 두 개 를 받아 세 값 중 하나를 낸다.
모델은 먼저 예시 task들의 숨은 의도를 추정하고, 그 다음 어느 메모리가 해당 환경에 더 관련 있는지 또는 둘이 비슷하게 관련 있는지를 판정한다. 구현은 GPT-4o 프롬프트(Table 24)이며 정답 답변은 주지 않는다.
판정자를 쓰면서 편향을 억제하는 장치가 두 겹 들어간다.
| 장치 | 절차 | 막는 것 |
|---|---|---|
| 순서 교체 이중 평가 | 후보 쌍마다 순서를 바꿔 두 번 평가하고 두 결과가 일치하며 무승부가 아닐 때만 선호로 남긴다 | 앞에 놓인 후보를 선호하는 제시 순서 편향 |
| 순환 제거 | 남은 선호를 후보 위의 유향 그래프로 모으고, 이행적이지 않아 생기는 순환에 얽힌 비교를 제거해 DAG만 남긴다 | 판정이 서로 모순되는 쌍이 학습 신호로 들어가는 것 |
이 그래프에서 경로 길이가 관련성 격차의 대리 지표가 된다. 에서 로 가는 경로가 길면 두 메모리의 task 관련성 차이가 크다는 뜻이다.
학습 쌍 선별 규칙
DPO 쌍 은 컨텍스트마다 하나씩 만든다. 조건이 두 가지다. 두 메모리가 최근 task 집합 아래에서 관련성 차이가 분명해야 하고, 동시에 기본 메모리 품질에서는 큰 차이가 없어야 한다.
두 번째 조건이 왜 필요한지가 이 절의 핵심이다. 품질 차이가 큰 쌍을 학습에 쓰면 선호가 task 관련성 대신 일반 품질 차이를 반영하게 된다. 그러면 Phase Two가 Phase One이 이미 한 일을 되풀이하는 셈이 되고, 무엇을 기억할지를 배우는 목표에서 벗어난다.
| 규칙 | 내용 |
|---|---|
| 선호 방향 | 가 보다 선호되어야 한다 |
| 품질 하한 | 선호된 메모리의 기본 품질이 낮지 않아야 한다. 즉 |
| 양쪽 저품질 배제 | 두 메모리가 모두 저품질이면 안 된다 |
| 1순위 선택 기준 | 유효 쌍 중 DAG 경로 거리가 가장 큰 쌍 |
| 동점 처리 | 거리가 같으면 메모리 길이 차이가 작은 쌍 |
마지막 규칙도 같은 취지다. 길이 차이가 작은 쌍을 고르면 선호가 "더 길게 쓴 쪽"을 뜻하지 않게 된다.
구현 수치가 함께 공개됐다. 컨텍스트마다 후보 개를 뽑았고, 위 필터를 지나 **유효 선호 쌍이 나온 컨텍스트는 29.17%**였다. 즉 열 중 일곱은 순서 불일치나 무승부, 순환, 품질 조건 위반으로 버려진다. Phase Two 학습에 실제로 쓰인 영상은 약 100편이다.
adapter 구조와 삽입 위치
adapter는 선택한 transformer layer 한 곳의 출력에 학습 가능한 벡터를 더하는 형태다.
Figure 2의 왼쪽 확대도가 자리를 정확히 보여준다. Input Layer Norm에서 Multi-head Attention과 잔차 합산, Post Attention Layer Norm, MLP와 잔차 합산까지 지난 layer 출력에 adapter가 더해진다. 즉 block 내부가 아니라 block이 다음 layer로 넘기는 표현에 바로 작용한다. 실험에서는 layer 22를 쓴다.
학습은 DPO다.
는 Phase One에서 얻은 policy다. 기준을 Phase One policy로 두면 DPO의 KL 정규화가 Phase One 능력에서 멀어지지 않게 붙들어 준다. 여기에 backbone 동결이 겹쳐 catastrophic forgetting을 두 겹으로 막는 구조다.
adapter를 고른 세 근거
첫째는 파라미터 효율이다. 학습 파라미터가 2,048개다. Table 1에서 adapter와 full-parameter 학습이 win ratio는 비슷한데, adapter는 accuracy와 non-redundancy를 원 모델 수준으로 지키고 full-parameter는 둘 다 떨어뜨린다.
둘째는 배포 효율이다. 학습된 adapter는 추론 시점에만 불러오는 파라미터 묶음으로 볼 수 있다. 배포된 모델의 가중치는 그대로이므로 추가 서빙 비용이 없다. 저자들은 이 관점에서 adapter를 "parametric personalized memory"의 한 형태로 해석할 수 있다고 적는다.
셋째는 이론적 정합이다. LLM 행동은 layer activation에 벡터를 더해 추론 시점에 조향할 수 있다는 선행 결과가 있다 [2, 9, 40, 53]. 이것이 가능한 이유는 고차 행동이 activation 공간의 선형 방향으로 근사 인코딩되기 때문이다 [15, 42].
세 번째 근거의 차이가 이 방법의 위치를 정한다. 기존 activation steering은 그 방향을 추출한다. 대조 예시로 방향을 계산해 뽑아내는 방식이다. TaskMem은 그 방향을 직접 학습한다. 그 결과 벡터가 각 목표 task의 activation 공간 표현을 담는다.
학습 하이퍼파라미터
| 항목 | Phase One (GSPO, Table 9) | Phase Two (DPO, Table 10) |
|---|---|---|
| Batch Size | 32 | 64 |
| Mini Batch Size | 8 | 64 |
| 80GB GPU 대수 | 32 | 32 |
| group 크기 | 8 | 해당 없음 |
| Learning Rate | 1e-6 | 1e-3 |
두 설정의 차이가 학습 대상의 차이를 반영한다. Phase Two는 mini batch가 batch와 같아 매 step이 full-batch 갱신이다. learning rate는 Phase One의 1000배다. 학습 대상이 2,048차원 벡터 하나이고 총 step이 40 이하라, 큰 보폭으로 소수의 step만 밟는 설정이다.
identity를 입력에 새겨 넣는 처리
video segment를 넘나들며 같은 인물을 추적하려면 각 clip의 얼굴과 목소리를 앞서 본 개인과 연결해야 한다 [24]. TaskMem은 이 문제를 영상 입력 자체에 identity를 주석으로 그려 넣어 해결한다.
| 단계 | 처리 |
|---|---|
| 얼굴 인식 | 선행 연구 [37]를 따라 bounding box를 얻고 저품질 얼굴을 걸러낸다. 영상의 1초 clip마다 중간 프레임을 골라 검출된 모든 얼굴에 box를 그리고, 각 box를 시간축 앞뒤로 0.5초씩 늘린다. face ID는 각 box의 왼쪽 위 모서리에 적는다 |
| 음성 인식 | Gemini-2.5-Pro가 오디오 구간을 뽑고 화자를 식별한다. 화자 식별은 현재 clip을 기준으로 한다. 화자를 정할 수 없는 구간은 전역 메모리에서 비슷한 목소리를 찾아 해당 face ID를 붙인다. 발화 내용과 화자 face ID는 영상 아래쪽 자막으로 표시한다 |
선행 연구 [37]는 도구 출력 텍스트를 별도 컨텍스트로 앞에 붙여 컨텍스트가 길어졌다. 이 설계는 identity 추론 정확도를 희생하지 않고 컨텍스트를 짧게 유지한다는 것이 저자들의 주장이다. 정보가 텍스트가 아니라 픽셀로 들어가므로 컨텍스트 예산을 쓰지 않는다는 논리다.
다만 두 프롬프트(Table 7, Table 8)에는 정보 손실 지점이 있다. 발화를 문장 단위로 끊으라고 지시하고, 알아듣기 어렵거나 아주 짧은 발화는 건너뛰라고 지시한다. 화자를 확정할 수 없으면 unknown을 넣는다.
평가 설계
벤치마크 세 개
| 벤치마크 | 성격 | 규모 | task 유형 수 |
|---|---|---|---|
| VideoMME [20] | YouTube 출처, 다양한 영상 종류 | short와 medium subset만, 영상 600편과 QA 1,800쌍 | 12 |
| EgoLife [60] | 1인칭 시점, 일상 활동 | VQA 500개 | 5 |
| EgoTempo [43] | 1인칭 시점, 시간 이해 중심 | VQA 500개 | 10 |
EgoLife의 다섯 유형은 event recall, relation map, entity log, habit insight, task master다. EgoTempo의 열 유형에는 물체 위치 찾기, 공간 관계, 미래 행동 예측 등이 들어간다.
VideoMME의 long subset을 뺀 이유가 명시돼 있다. 장편 영상의 메모리 길이가 GPT-4o의 최대 토큰 한도를 넘길 수 있어서다. 이 제약이 평가 설계의 구조적 약점을 만든다. 장기 메모리가 가장 필요한 구간이 답변 생성 모델의 컨텍스트 한계 때문에 평가에서 빠졌다.
streaming 재구성과 온라인 갱신
VQA 벤치마크를 순차 task stream으로 바꾸는 절차가 이 논문의 평가 기여다.
| 요소 | 규칙 |
|---|---|
| task 구성 | video와 question 쌍을 질문 유형으로 묶고 각 묶음을 하나의 task, 하나의 환경으로 본다 |
| 관찰 순서 | task 안에서 영상을 하나씩 순차 관찰하며 각 영상의 episodic memory를 만든다 |
| 질문 공개 시점 | 각 질문은 해당 영상을 다 본 뒤에만 제시된다 |
| 답변 근거 | 원본 영상 접근 없이 생성된 메모리만으로 답한다 |
| 온라인 갱신 | 각 task의 처음 질문 5개는 Phase One 메모리로 답한다. 그 feedback으로 Phase Two 학습을 수행하고 남은 질문은 갱신된 policy의 메모리로 답한다 |
| 답변 생성 모델 | GPT-4o. 먼저 추론한 뒤 근거가 부족하면 "insufficient information"을 반환한다 (프롬프트는 Table 25) |
질문을 영상 관찰 뒤에 공개하는 규칙이 이 프로토콜의 핵심 장치다. 질문을 미리 알면 policy는 메모리를 만들 필요 없이 답에 필요한 것만 골라내면 된다. 관찰 시점에 질문을 모르게 하면 "앞으로 무엇이 쓸모 있을지"를 정하는 문제가 실제로 생긴다.
메모리만으로 답하게 하는 규칙은 평가 대상을 격리한다. 원본 영상을 함께 주면 성능이 메모리 품질인지 답변 모델의 영상 이해력인지 구분되지 않는다.
baseline MLLM에도 같은 streaming 생성 프로토콜을 적용한다. 각 step에서 최근 10초 clip 4개와 그 메모리, 그리고 새로 들어온 10초 clip 하나를 준다. baseline도 창을 쓴다.
baseline은 두 묶음이다. base MLLM은 Gemini-1.5-Pro [51], Gemini-2.5-Pro [12], GPT-5.2 [39], Qwen3-VL-30B-A3B [3]이고, 메모리 프레임워크는 EgoGPT [60], HippoMM [35], M3-Agent [37]다. 프레임워크는 각자 생성한 episodic memory를 그대로 쓴다.
세 지표의 관계
| 지표 | 정의 | 재는 것 |
|---|---|---|
| Accuracy | 전체 질문 중 정답 비율 | 메모리의 종합 유용성 |
| Coverage | 전체 질문 중 메모리가 답에 필요한 정보를 담은 비율 | 메모리의 포괄성 |
| Precision | 메모리가 충분하다고 판정된 질문 중 정답 비율 | 메모리의 충실성 |
세 지표가 서로 묶여 있다는 점을 알아야 결과를 제대로 읽을 수 있다. Accuracy는 대략 Coverage와 Precision의 곱에 해당한다. 답변 모델이 근거가 있다고 판정한 질문에서만 답을 내기 때문이다. 따라서 Coverage가 낮고 Precision이 높은 메모리는 적게 담되 담은 것은 맞는 메모리이고, 그 반대는 넓게 담되 틀린 것도 섞인 메모리다.
결과
주 결과
| Method | VideoMME Acc | Cov | Prec | EgoLife Acc | Cov | Prec | EgoTempo Acc | Cov | Prec |
|---|---|---|---|---|---|---|---|---|---|
| EgoGPT | 44.3 | 58.7 | 75.5 | 19.2 | 28.2 | 68.1 | 15.0 | 33.5 | 44.9 |
| HippoMM | 48.9 | 66.6 | 73.5 | 30.4 | 43.4 | 70.0 | 15.8 | 30.8 | 51.1 |
| M3-Agent | 62.5 | 77.7 | 80.4 | 21.8 | 30.8 | 70.8 | 16.0 | 36.3 | 44.2 |
| Gemini-1.5-Pro | 55.3 | 65.9 | 83.9 | 39.4 | 51.6 | 76.4 | 19.7 | 34.3 | 57.4 |
| Gemini-2.5-Pro | 63.2 | 74.8 | 84.4 | 43.8 | 56.6 | 77.4 | 25.8 | 42.3 | 61.0 |
| GPT-5.2 | 67.3 | 80.8 | 83.3 | 34.8 | 48.2 | 72.2 | 32.1 | 51.4 | 62.4 |
| Qwen3-VL-30B-A3B (base) | 61.6 | 74.7 | 82.5 | 38.4 | 52.4 | 73.3 | 22.3 | 38.9 | 57.2 |
| TaskMem | 67.9 | 79.3 | 85.6 | 45.4 | 56.4 | 80.5 | 27.6 | 43.7 | 63.2 |
base 대비 향상 폭을 지표별로 모으면 다음과 같다.
| 벤치마크 | Accuracy | Coverage | Precision |
|---|---|---|---|
| VideoMME | +6.3%p | +4.6%p | +3.1%p |
| EgoLife | +7.0%p | +4.0%p | +7.2%p |
| EgoTempo | +5.3%p | +4.8%p | +6.0%p |
세 지표가 모두 오른다는 점이 중요하다. 메모리를 좁혀 Precision만 올린 것도 아니고 넓혀 Coverage만 올린 것도 아니다. abstract와 본문은 accuracy 향상을 "6.3%, 7.0%, 5.3%"로 적지만 부록 E.1은 같은 값을 "6.3 points"로 적는다. 백분율 값의 차이이므로 %p가 정확한 표기다.
baseline과의 비교는 지표에 따라 다르게 읽어야 한다.
| 지표 | TaskMem의 위치 |
|---|---|
| Accuracy | VideoMME와 EgoLife에서 최고. EgoTempo에서 GPT-5.2의 32.1에 못 미치는 27.6으로 2위 |
| Precision | 세 벤치마크 모두 최고 |
| Coverage | 최고인 벤치마크가 없다. VideoMME에서 GPT-5.2 80.8이 79.3보다 높고, EgoLife에서 Gemini-2.5-Pro 56.6이 56.4보다 미세하게 높고, EgoTempo에서 GPT-5.2 51.4가 43.7을 7.7%p 앞선다 |
즉 "모든 baseline을 앞선다"는 서술은 Accuracy와 Precision에 한정된다. Coverage에서는 GPT-5.2가 세 벤치마크 모두에서 TaskMem보다 넓게 담는다. TaskMem이 Accuracy에서 이기는 방식은 더 넓게 담는 것이 아니라 담은 것을 더 정확하게 만드는 것이다.
EgoTempo Accuracy 격차는 4.5%p다. 저자들은 주된 원인을 GPT-5.2가 세밀한 활동을 서술하는 기본 영상 이해 능력에서 앞선다는 점으로 설명한다. EgoTempo 질문의 상당수가 그 능력을 요구한다는 것이다. 그럼에도 Precision은 TaskMem 63.2가 GPT-5.2 62.4보다 높아, 학습이 환각이 적은 메모리를 만든다는 근거로 제시된다.
메모리 프레임워크 baseline의 성적이 벤치마크마다 크게 흔들리는 것도 눈에 띈다. M3-Agent는 VideoMME에서 62.5로 Gemini-1.5-Pro를 앞서지만 EgoLife에서 21.8로 최하위권이다. 1인칭 일상 영상이 프레임워크의 설계 가정과 맞지 않았을 가능성을 시사하되 논문이 이 차이를 분석하지는 않는다.
단계별 ablation
| Method | VideoMME Acc | Cov | Prec | EgoLife Acc | Cov | Prec | EgoTempo Acc | Cov | Prec |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-VL-30B-A3B | 61.6 | 74.7 | 82.5 | 38.4 | 52.4 | 73.3 | 22.3 | 38.9 | 57.2 |
| + Task Prompt | 64.2 | 77.3 | 83.0 | 40.0 | 51.0 | 78.4 | 24.5 | 42.9 | 57.1 |
| TaskMem Phase One | 64.4 | 75.4 | 85.3 | 39.6 | 51.0 | 77.6 | 23.7 | 37.5 | 63.3 |
| TaskMem (두 단계) | 67.9 | 79.3 | 85.6 | 45.4 | 56.4 | 80.5 | 27.6 | 43.7 | 63.2 |
논문이 이 표에서 주장하는 것은 두 가지다. 프롬프트만으로도 base보다 오르지만 두 단계를 다 거친 TaskMem에는 못 미치므로 파라미터 갱신이 프롬프트보다 효과적이라는 것, 그리고 Phase One이 base보다 Accuracy와 Precision을 함께 올려 더 신뢰할 만한 메모리를 학습한다는 것이다.
표를 자세히 읽으면 논문이 언급하지 않은 세 가지가 나온다.
첫째, Task Prompt와 Phase One의 우열이 벤치마크마다 뒤집힌다. Accuracy 기준으로 VideoMME에서는 Phase One 64.4가 Task Prompt 64.2보다 0.2%p 높지만, EgoLife에서는 Task Prompt 40.0이 Phase One 39.6보다 높고 EgoTempo에서도 24.5가 23.7보다 높다. Precision도 EgoLife에서 Task Prompt 78.4가 Phase One 77.6보다 높다. 표의 2위 밑줄이 두 벤치마크 Accuracy에서 Task Prompt에 붙어 있는 것이 이를 확인해 준다.
따라서 "프롬프트보다 Phase One이 낫다"는 순서는 성립하지 않는다. 성립하는 것은 "프롬프트보다 두 단계 TaskMem이 낫다"뿐이며, 논문 본문의 비교도 그 범위에 머문다. 이유는 두 방법이 다른 것을 개선하기 때문으로 보인다. Task Prompt는 task 정보를 주지만 메모리 품질은 base 그대로다. Phase One은 품질을 올리지만 task 정보가 없다. 두 효과가 합쳐지는 것은 두 단계를 다 거친 뒤다.
둘째, Phase One은 Coverage를 낮춘다. EgoLife에서 52.4가 51.0으로, EgoTempo에서 38.9가 37.5로 내려간다. 같은 조건에서 Precision은 73.3이 77.6으로, 57.2가 63.3으로 올랐다. Phase One이 메모리를 좁게 다듬어 충실성을 얻는 대신 포괄성을 조금 내주는 셈이다. Coverage를 되돌려 base 위로 올리는 것은 Phase Two다. 이는 richness reward가 하는 일과도 맞물린다. Phase One의 quality 압력이 메모리를 좁히는 방향으로 밀고, richness가 그것을 어느 정도 되밀지만 완전히 상쇄하지는 못한다.
셋째, EgoTempo Precision의 최고값은 두 단계가 아니라 Phase One이다. 63.3 대 63.2로 격차는 0.1%p이며 표의 굵은 표시가 Phase One에 붙어 있다. Phase Two가 Accuracy를 23.7에서 27.6으로 크게 올리는 대가로 Precision을 아주 조금 내준 것으로 읽힌다.
프롬프트 대 파라미터 갱신
Task Prompt baseline의 설계를 짚어 둘 필요가 있다. test 시점에 같은 최근 task를 Qwen3-VL-30B-A3B에 주고 task 관련 메모리를 만들라고 지시한다(프롬프트는 Table 20). 즉 Phase Two와 정확히 같은 정보를 프롬프트로 받는다. 차이는 그 정보가 프롬프트로 들어가는지 파라미터로 들어가는지뿐이다.
두 단계 TaskMem이 Task Prompt를 앞서는 폭은 Accuracy 기준으로 VideoMME 3.7%p, EgoLife 5.4%p, EgoTempo 3.1%p다. 같은 정보를 주고도 파라미터에 넣은 쪽이 더 낫다는 결과이며, 이 논문이 학습을 정당화하는 주된 근거다.
cross-task adapter transfer
Phase Two가 무엇을 학습했는지 가리는 실험이다. 평가 task를 object recognition VQA로 고정하고 adapter만 다른 task의 것으로 교체한다. 가설 검정 구조가 명확하다. Phase Two가 단순히 더 좋은 adapter를 만든다면 모든 변형이 향상되어야 하고, task별 초점을 학습한다면 짝이 맞는 adapter만 도움이 되어야 한다.
| Method | Acc | Cov | Prec |
|---|---|---|---|
| TaskMem Phase One | 65.7 | 74.7 | 87.9 |
| + Counting adapter | 65.0 | 74.0 | 87.8 |
| + OCR adapter | 65.0 | 75.7 | 85.9 |
| + Attribute adapter | 65.0 | 74.3 | 87.4 |
| + Object adapter | 69.7 | 78.7 | 88.6 |
짝이 맞지 않는 adapter 세 개가 모두 Accuracy를 65.7에서 65.0으로 0.7%p 낮췄고, 짝이 맞는 object adapter만 4.0%p 올렸다. 결론은 Phase Two가 여러 task에 두루 통하는 일반 능력이 아니라 task별 초점을 얻는다는 것이다.
표에서 두 가지가 더 보인다. 세 변형의 Accuracy가 65.0으로 완전히 같은데 논문은 이를 따로 언급하지 않는다. 그리고 OCR adapter는 Coverage를 74.7에서 75.7로 올리면서 Precision을 87.9에서 85.9로 낮춘다. 메모리를 넓게 쓰되 정확도가 떨어지는 방향으로 밀었다는 해석이 가능하다.
이 결과의 양면성이 뒤의 한계와 이어진다. task별 초점은 방법이 실제로 작동한다는 증거이면서, 새 task마다 별도 adapter를 학습해야 한다는 비용이다.
adapter 대 full-parameter
이 표의 지표는 벤치마크 지표와 다르다. 부록 D.4가 정의한 검증 집합 지표다. 검증 집합은 학습 집합과 겹치지 않는 clip으로 만들고 history 메모리는 Phase One policy 이 생성한다.
| 지표 | 구현 |
|---|---|
| Accuracy | Gemini-2.5-Flash가 현재 clip의 영상 내용과 자막에 충실한지 판정하고, 규칙 기반 길이 검사가 토큰 예산 준수를 확인한다. 둘 다 통과해야 정답으로 센다 |
| Non-redundancy rate | GPT-4o가 생성 메모리를 history 메모리와 견줘 새 정보를 담았는지 판정한다. 문장 형태와 문체 일관성도 함께 본다 |
| Relevance win/tie/loss | GPT-4o가 task reward model과 같은 프롬프트로 현재 policy의 메모리와 기준 policy 의 메모리를 견준다 |
세 지표의 역할 분담이 명확하다. 앞의 두 지표는 Phase One 능력이 유지되는지를 보고(catastrophic forgetting 검사), 세 번째 지표는 task 관련성이 실제로 개선되는지를 본다.
| Method | Accuracy | Non-redundancy | Loss Ratio | Tie Ratio | Win Ratio |
|---|---|---|---|---|---|
| TaskMem Phase One | 92.39 ± 0.47 | 83.59 ± 0.43 | 13.82 ± 1.15 | 72.80 ± 0.83 | 13.38 ± 0.37 |
| + full-parameter tuning | 91.29 | 78.21 | 2.00 | 58.00 | 40.00 |
| + 40-step adapter | 92.93 | 81.74 | 3.06 | 61.72 | 35.22 |
| + scaled adapter (10-step에 1.5배) | 91.54 | 80.96 | 3.17 | 58.52 | 38.31 |
Phase One 행만 3회 실행의 평균과 표준편차로 보고된다. 나머지 세 행은 단일 수치이므로 작은 차이는 실행 간 변동 안에 있을 수 있다.
Phase One 행의 win ratio 13.38%는 자기 자신과 비교한 값이다. 같은 policy로 두 번 뽑은 메모리를 견줬으니 무승부가 72.80%로 크고 승패가 대칭에 가깝다.
full-parameter 학습은 win ratio 40.00%로 가장 높다. 그런데 Accuracy가 92.39에서 91.29로, Non-redundancy가 83.59에서 78.21로 함께 내려간다. Non-redundancy의 5.38%p 하락은 표의 어떤 변화보다 크고, 이것이 catastrophic forgetting의 지표로 제시된다. task 관련성을 얻는 대가로 "이미 저장한 것을 되풀이하지 않는" 능력을 잃었다는 뜻이다.
40-step adapter는 Accuracy를 92.93으로 오히려 올리면서 win ratio 35.22%를 얻는다. Non-redundancy는 81.74로 1.85%p 내려가되 full-parameter의 하락 폭보다 훨씬 작다. scaled adapter는 win ratio 38.31%로 full-parameter에 더 가까우나 Accuracy는 91.54로 낮다.
세 방식의 trade-off는 다음과 같다.
| 방식 | task 관련성 | 품질 보존 | 학습 비용 |
|---|---|---|---|
| full-parameter | 가장 높다 | 가장 나쁘다 | 전체 파라미터 갱신 |
| 40-step adapter | 중간 | 가장 좋다 | 2,048 파라미터, 40 step |
| scaled 10-step adapter | 높다 | 중간 | 2,048 파라미터, 10 step |
adapter 위치
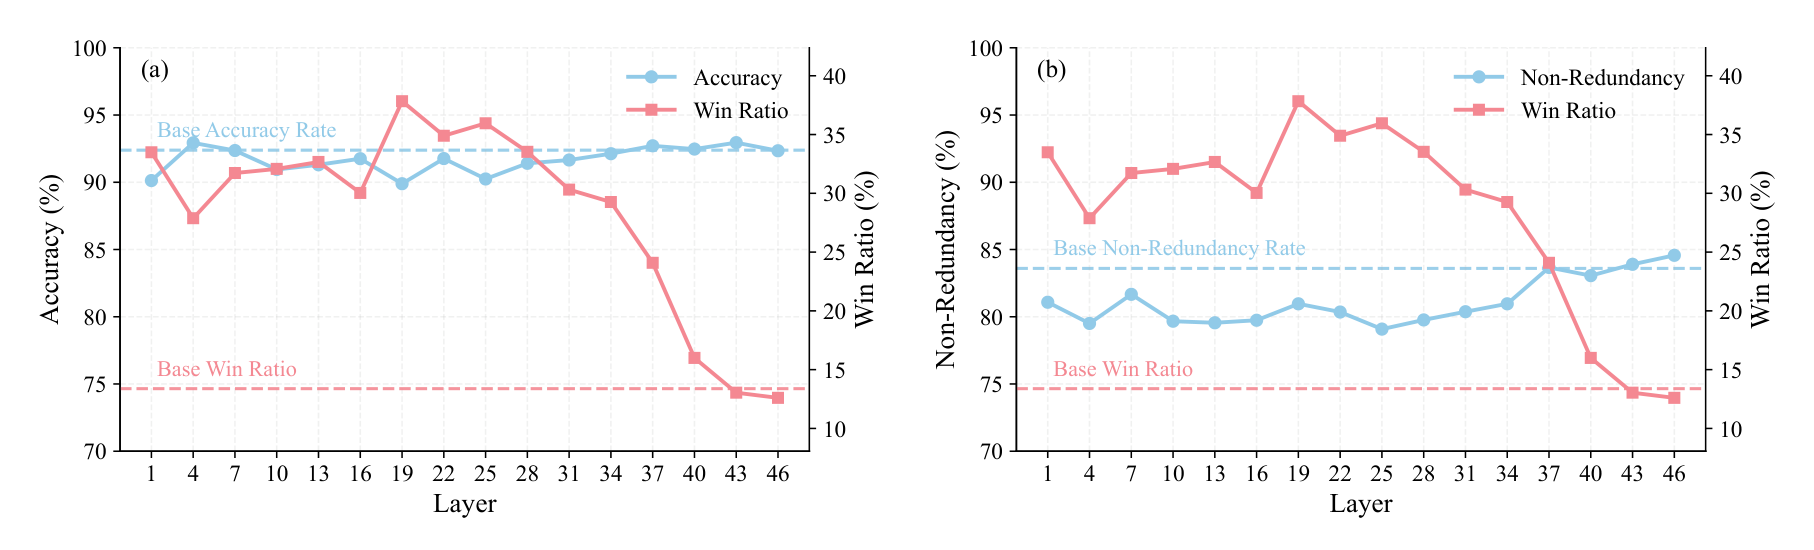
Figure 5는 layer 1번에서 46번까지 3칸 간격으로 adapter 위치를 바꾼 결과를 그린다. 기준선 세 개가 점선으로 함께 표시되며 Table 1의 Phase One 값과 맞는다. accuracy 92.4 근처, non-redundancy 83.6 근처, win ratio 13.4 근처다.
| layer 구간 | win ratio 개략값 (%) | 특징 |
|---|---|---|
| 1에서 16 | 27에서 34 | 진동하되 base 13.4보다 훨씬 높다 |
| 19 | 38 근처 | 그림상 최고점 |
| 22에서 28 | 33에서 36 | 논문이 채택한 구간 |
| 31에서 37 | 24에서 31 | 하강 시작 |
| 40에서 46 | 13에서 16 | base 수준까지 내려온다 |
논문의 결론은 "얕은 layer와 중간 layer가 깊은 layer보다 효과적이며 모든 실험에서 layer 22를 쓴다"까지다.
그림에는 논문이 설명하지 않는 세부가 있다. win ratio 최고점은 layer 19인데 그 지점의 accuracy가 89.9 근처로 base 92.4보다 아래로 내려간다. layer 22는 accuracy가 91.8 근처로 base에 더 가깝다. 따라서 layer 22는 win ratio 단독 최고점이 아니라 win ratio와 품질 보존의 균형점으로 보인다. 논문이 그렇게 서술하지는 않았으므로 이는 그림 판독에 근거한 해석이다.
깊은 layer에서 효과가 사라지는 경향은 activation steering 문헌의 관찰과 방향이 같다. 다만 이 논문이 그 연결을 명시하지는 않는다. x축이 46번까지 있어 base 모델의 layer 수를 짐작할 수 있고, layer 22는 대략 중간 깊이에 해당한다.
richness와 NSR control 제거
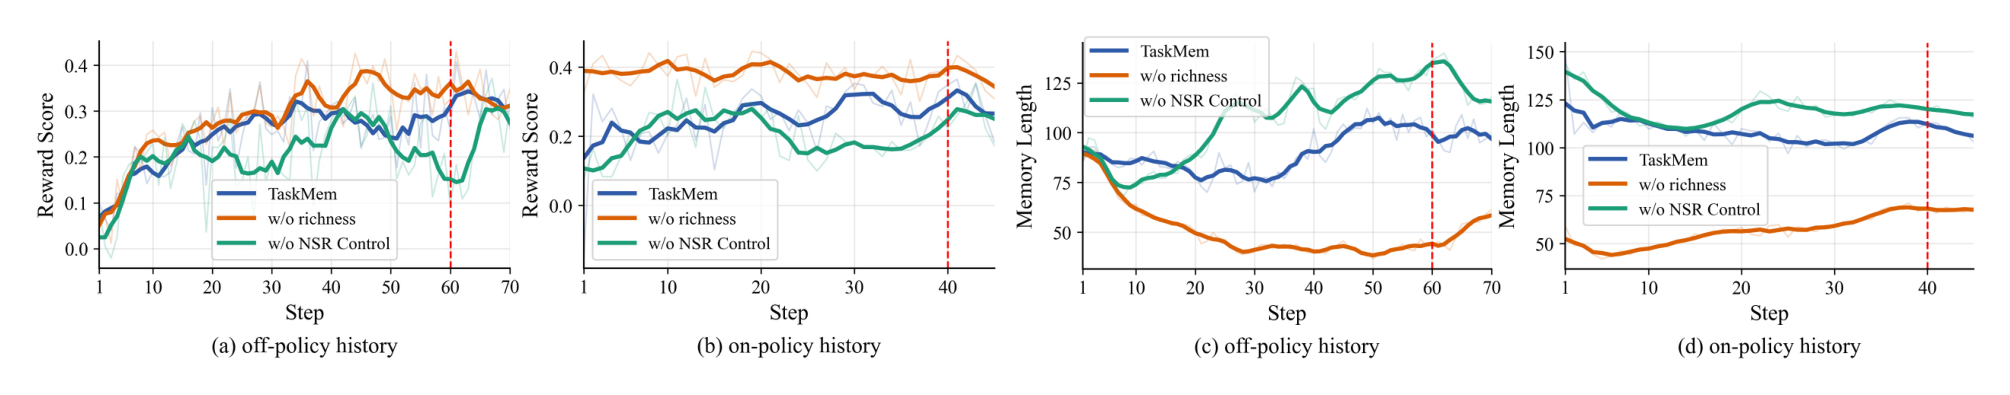
Figure 3은 TaskMem, richness reward 제거, NSR control 제거 세 조건을 네 폭으로 비교한다. 붉은 세로 점선이 각 단계의 학습 종료 지점(off-policy 60 step, on-policy 40 step)을 표시한다.
| 조건 | reward 곡선 (그림 판독) | 메모리 길이 (그림 판독) |
|---|---|---|
| TaskMem | off-policy 0.08 근처에서 0.32 근처로 상승, on-policy 0.15 근처에서 0.33 근처로 상승 | off-policy 90 근처에서 100을 넘어 상승, on-policy 100에서 115 사이 유지 |
| richness 제거 | 세 조건 중 가장 높고 안정적. on-policy 구간에서 0.39 근처를 거의 평평하게 유지 | off-policy 90 근처에서 40 근처까지 급격히 하락한 뒤 60 근처까지 부분 회복, on-policy 50에서 68 사이 |
| NSR control 제거 | off-policy 후반에 0.15 근처까지 하락한 뒤 회복하는 불안정한 궤적 | 세 조건 중 가장 길다. off-policy에서 137 근처까지 상승 |
reward 곡선만 보면 richness를 뺀 쪽이 더 좋아 보인다. 학습이 더 안정적이고 도달하는 reward도 높다. 저자들의 해석은 그것이 더 좋은 policy가 아니라 policy가 reward를 우회한 결과라는 것이고, 근거는 메모리 길이가 빠르게 줄어드는 것이다. 더 짧은 메모리로 quality 점수를 높게 받는 방향으로 학습됐다는 진단이다.
수치로 보면 우회의 규모가 뚜렷하다. richness를 뺀 policy의 메모리 길이는 TaskMem의 절반 이하다. off-policy 구간에서 90 근처에서 40 근처로 내려가고, on-policy 구간에서도 50에서 68 사이에 머문다. 같은 구간의 TaskMem은 100을 넘는다. 메모리 길이 축의 단위는 그림에 적히지 않았으나 reward 정의의 토큰 예산 서술과 함께 보면 토큰 수로 읽는 것이 자연스럽다.
NSR control 제거 조건은 반대 방향의 실패를 보인다. 메모리 길이는 가장 긴데 reward는 불안정하다. off-policy 후반에서 0.15 근처까지 떨어졌다가 회복한다. group 안에서 상대적으로 뒤처진 좋은 출력까지 벌점을 받으면 학습이 흔들린다는 진단과 맞는 궤적이다.
두 ablation을 함께 읽으면 Phase One 설계의 구조가 보인다. quality reward가 메모리를 좁히는 압력을 만들고 richness reward가 그것을 되밀며, NSR gating이 그 균형을 학습 후반까지 유지시킨다.
학습 가속
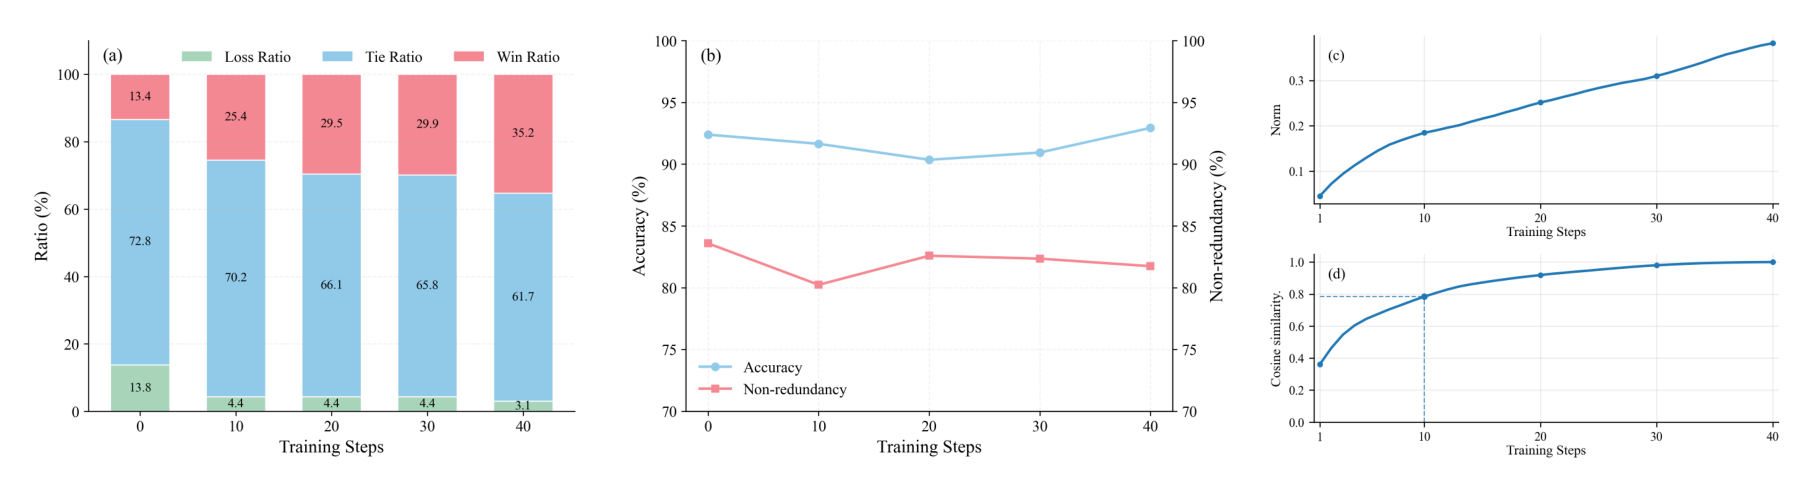
Figure 4가 질문 5개를 환경 feedback으로 쓴 Phase Two 학습 추이를 네 폭으로 보여준다.
| step | win ratio (%) | tie ratio (%) | loss ratio (%) | adapter norm (그림 판독) | step-40과의 코사인 (그림 판독) |
|---|---|---|---|---|---|
| 0 (Phase One) | 13.4 | 72.8 | 13.8 | 해당 없음 | 해당 없음 |
| 1 | 기록 없음 | 기록 없음 | 기록 없음 | 0.04 근처 | 0.36 근처 |
| 10 | 25.4 | 70.2 | 4.4 | 0.19 근처 | 0.8 |
| 20 | 29.5 | 66.1 | 4.4 | 0.25 근처 | 0.92 근처 |
| 30 | 29.9 | 65.8 | 4.4 | 0.31 근처 | 0.98 근처 |
| 40 | 35.2 | 61.7 | 3.1 | 0.37 근처 | 1.0 |
승패 비율의 궤적에서 두 국면이 나뉜다. loss ratio는 step 10에서 이미 13.8%에서 4.4%로 떨어진 뒤 step 30까지 그대로 머문다. 반면 win ratio는 40 step까지 계속 오른다. 초반 학습은 "지는 경우를 없애는" 효과가 크고 후반 학습은 "이기는 경우를 늘리는" 효과가 크다는 뜻이다. tie ratio가 72.8%에서 61.7%로 줄어드는 것이 그 변화를 반영한다.
품질 지표는 학습 내내 안정적이다. accuracy는 90%대 초반에서 유지되고 step 40에서 다시 92.9로 올라간다. non-redundancy도 80%대에서 크게 벗어나지 않는다. 즉 관련성이 오르는 동안 기본 품질이 크게 하락하지 않았다.
가속 기법의 근거는 (c)와 (d)의 대비에 있다. norm은 step 1의 0.04 근처에서 step 40의 0.37 근처까지 계속 커진다. 반면 코사인 유사도는 step 10에서 이미 0.8에 이르고 step 20에서 0.92 근처, step 30에서 0.98 근처로 1에 붙는다. 방향은 일찍 정해지고 이후 학습은 주로 크기를 키운다.
여기서 나온 기법은 step-10 adapter를 목표 norm 0.3으로 곧바로 scaling하는 것이다. Table 1의 caption은 같은 조작을 "가중치에 1.5를 곱한 10-step adapter"로 적는다. step-10 norm이 0.19 근처이므로 1.5배가 0.3 근처가 되어 두 서술이 맞는다. 목표 norm 0.3은 step-40의 0.37이 아니라 step 20과 30 사이 값이라는 점은 그림에서 확인된다.
이 조작으로 학습 데이터와 시간을 약 75% 줄인다. Table 1에서 scaled adapter가 win ratio 38.31%로 40-step adapter의 35.22%보다 오히려 높은데, 이 차이가 실행 변동 안에 있는지는 단일 실행 수치라 판단할 수 없다.
저자들은 방향이 왜 그렇게 빨리 수렴하는지는 분석하지 않는다.
답변 생성 모델 교체
GPT-4o는 파이프라인의 두 곳에 쓰인다. Phase Two의 task 관련성 선호 데이터를 만드는 곳과 평가 시점에 메모리로 답을 내는 곳이다. 학습된 선호 신호가 평가 모델과 결합되면 결과가 과대평가될 수 있다. 이를 확인하려고 생성된 메모리를 고정한 채 답변 생성 모델만 바꿨다.
| 답변 생성 모델 | Model | Acc | Cov | Prec |
|---|---|---|---|---|
| GPT-4o | Qwen3-VL-30B-A3B | 61.6 | 74.7 | 82.5 |
| GPT-4o | TaskMem | 67.9 | 79.3 | 85.6 |
| Gemini-2.5-Pro | Qwen3-VL-30B-A3B | 68.9 | 81.7 | 84.4 |
| Gemini-2.5-Pro | TaskMem | 74.5 | 85.8 | 86.9 |
base 대비 Accuracy 향상은 GPT-4o에서 6.3%p, Gemini-2.5-Pro에서 5.6%p다. Coverage와 Precision도 두 모델 모두에서 오른다. 향상 폭이 조금 줄되 방향과 크기가 유지되므로 이득이 특정 QA 모델에 묶인 것은 아니라는 근거가 된다.
절대 점수가 Gemini-2.5-Pro에서 높은 이유는 주로 Coverage 차이다. 같은 메모리를 주면 Gemini-2.5-Pro가 근거가 충분하다고 판정해 답을 시도하는 빈도가 더 높다. base 모델 메모리에서 Coverage가 74.7에서 81.7로 7.0%p 오른다. Precision이 82.5에서 84.4로 함께 유지되므로 무분별하게 답을 낸 결과는 아니라는 해석이 붙는다.
메모리가 고정된 비교이므로 이 차이는 메모리 품질 변화가 아니라 답변 생성 모델의 행동을 반영한다. 뒤집어 보면 이 표는 평가 수치가 답변 모델의 판정 성향에 상당히 민감하다는 뜻이기도 하다. 같은 메모리로 Accuracy가 61.6에서 68.9까지 달라진다.
task별 세부
VideoMME 12개 유형의 base 대비 Accuracy 변화다.
| 질문 유형 | base | TaskMem | 차이 (%p) |
|---|---|---|---|
| Attribute Perception | 54.4 | 65.6 | +11.2 |
| Spatial Perception | 54.9 | 64.7 | +9.8 |
| Action Reasoning | 61.0 | 69.5 | +8.5 |
| Temporal Perception | 73.5 | 81.6 | +8.1 |
| Counting Problem | 34.5 | 42.3 | +7.8 |
| Object Recognition | 62.0 | 69.7 | +7.7 |
| Object Reasoning | 68.7 | 74.3 | +5.6 |
| OCR Problems | 69.6 | 75.2 | +5.6 |
| Spatial Reasoning | 86.7 | 91.1 | +4.4 |
| Information Synopsis | 90.0 | 93.1 | +3.1 |
| Action Recognition | 54.0 | 56.8 | +2.8 |
| Temporal Reasoning | 70.9 | 72.1 | +1.2 |
12개 유형이 모두 올랐다. 향상 폭과 base 값 사이에 느슨한 반비례가 보인다. base가 이미 높은 Information Synopsis(90.0)와 Spatial Reasoning(86.7)에서 폭이 작다. Counting Problem은 base 34.5로 가장 낮고 TaskMem 값 42.3도 12개 중 가장 낮아, 개체 수를 정확히 세는 일이 메모리 기반 QA에서 가장 어려운 유형으로 남는다.
| EgoLife task | base | TaskMem | 차이 (%p) |
|---|---|---|---|
| TaskMaster | 58.7 | 71.4 | +12.7 |
| RelationMap | 30.4 | 37.6 | +7.2 |
| EventRecall | 42.9 | 50.0 | +7.1 |
| HabitInsight | 54.1 | 60.7 | +6.6 |
| EntityLog | 24.0 | 28.0 | +4.0 |
EgoLife 5개 task도 모두 올랐다. EntityLog는 base 24.0으로 가장 낮고 향상 폭도 가장 작다.
| EgoTempo task | base | TaskMem | 차이 (%p) |
|---|---|---|---|
| Action Sequence | 37.9 | 53.1 | +15.2 |
| Locating Object | 11.6 | 20.4 | +8.8 |
| Future Action Prediction | 28.4 | 36.8 | +8.4 |
| Counting Objects | 12.8 | 21.2 | +8.4 |
| Counting Actions | 16.7 | 22.9 | +6.2 |
| Object-Specific Action | 18.8 | 24.8 | +6.0 |
| Object Sequence | 31.6 | 37.2 | +5.6 |
| Spatial Relationship | 6.4 | 8.0 | +1.6 |
| Action-Specific Object | 29.2 | 30.0 | +0.8 |
| Temporal Event Ordering | 29.8 | 29.4 | -0.4 |
EgoTempo는 결과가 고르지 않다. Temporal Event Ordering만 하락한다. 벤치마크 단위로 세 곳 모두 올랐다는 논문 서술은 맞지만 task 단위로 내려간 곳이 하나 있다. 사건의 시간 순서를 묻는 유형이라, clip 단위로 잘라 만드는 메모리가 clip 사이의 순서 관계를 잘 보존하지 못한다는 신호로 읽을 수 있다. 뒤에 나오는 실패 유형 세 번째와 맞물리는 관찰이다.
Spatial Relationship은 절대값이 base 6.4, TaskMem 8.0으로 매우 낮고 GPT-5.2의 22.0에 크게 뒤진다. 같은 task의 Coverage가 TaskMem 10.0, GPT-5.2 30.0이라 메모리에 공간 관계 정보가 거의 남지 않는다는 뜻이다.
반대 방향의 사례도 있다. Counting Actions의 Precision은 TaskMem 70.0으로 GPT-5.2의 58.9를 11.1%p 앞선다. 다만 Counting Objects의 Precision은 TaskMem 55.8이 GPT-5.2 65.5보다 낮다.
정성 변화
Phase One policy는 정확하지만 일반적인 사건 서술 문체로 메모리를 만든다. object recognition 질문으로 Phase Two 학습을 거치면 문체가 세밀한 사물 세부를 담는 방향으로 옮겨간다. 논문은 task 4종에서 같은 패턴을 확인한다.
| Case | task | Phase Two 이후 추가된 세부 |
|---|---|---|
| Case 1 | Object Recognition | 침구의 색(흰색과 분홍색), 목재 가구와 큰 창, 세면대 위 세면도구와 수건, 인물의 모자와 배낭 |
| Case 2 | Object Reasoning | 인물의 긴 붉은 머리, 흰 손목시계, 붉은 드레스, 샌드위치 속 재료(brisket과 jalapeno sausage) |
| Case 3 | Attribute Perception | 작업장의 기계 설비, 어두운 셔츠와 카키 바지, 흰 머리와 하늘색 셔츠와 회색 조끼, 집중한 표정과 손동작 |
| Case 4 | Counting Problem | 동물 종의 정정(beaver에서 water vole로)과 추가(hedgehog), 염소 두 마리의 색(검정과 흰색), 물속 다른 물고기들 |
Case 4가 특히 시사적이다. Phase One은 물에서 나오는 동물을 beaver로 적었는데 Phase Two는 water vole로 적고 hedgehog 한 장면을 추가로 담았다. counting task는 개체 수를 세야 하므로 종을 구분하고 빠짐없이 열거하는 쪽으로 policy가 밀린 결과로 읽힌다. 단순히 문장을 길게 쓴 것이 아니라 무엇을 구분해서 볼지가 바뀌었다는 증거다.
Case 2도 같은 성격이다. Phase One은 "붉은 드레스를 입은 사람"이라고만 적었는데 Phase Two는 머리 색과 길이, 손목시계, 샌드위치 속 재료까지 남긴다. object reasoning 질문이 인물의 역할이나 사물의 정체를 묻기 때문에 식별 단서를 남기는 방향으로 옮겨간 것이다.
별개 사례로 Table 6은 5분 영상 하나의 메모리 전문을 싣는다. 세 가지를 보이려는 예시다.
| 주장 | 근거 |
|---|---|
| 세밀하면서 환각이 적다 | 5분 영상에 대해 4,620 토큰 분량의 상세하고 정확한 서술을 만들었다 |
| streaming 생성이 이어진다 | clip 경계를 넘어 서술 흐름이 매끄럽다 |
| task 관련성이 있다 | counting task 아래에서 생성돼 각 clip의 국소 개체 수를 기록하고, 그 덕에 전역 counting 문제를 맞혔다 |
이 사례에서 메모리 형식이 구체적으로 드러난다. 00:00:00--00:00:10 같은 10초 구간 타임스탬프마다 한 문단이 붙고, 인물은 [face_1]처럼 대괄호 토큰으로 참조하며 그 토큰이 영상 전체에서 같은 인물을 가리킨다. 질문은 "How many persons does Superman fight versus?"이고 정답과 예측이 모두 C(5명)다. 원본은 VideoMME의 YouTube 영상이다.
전역 counting 문제를 clip 단위 메모리로 푸는 방식이 여기서 보인다. 각 구간에서 등장 인물을 face ID로 열거해 두면, 답변 모델이 전체 메모리를 읽어 서로 다른 ID의 수를 세면 된다.
실패 사례
무작위로 뽑은 오답 50개의 메모리를 사람이 직접 검토했다. 각 사례마다 세 가지를 확인했다. 답에 필요한 근거가 메모리에 남았는지, 남은 근거가 사실에 맞는지, 근거가 있는데도 QA 모델이 틀렸는지다.
| 유형 | 내용 | 사례 |
|---|---|---|
| 세밀한 시각 근거 누락 | 답에 필요한 미세 정보가 메모리에 없다 | Table 16 |
| 부정확하거나 오해를 낳는 시각 서술 | 근거는 남았으나 서술 자체가 틀렸다 | Table 17 |
| 관계와 시간 구조 통합 부족 | 국소 단서는 잡았으나 그 사이의 관계와 순서를 엮지 못했다 | Table 18 |
첫 유형의 사례가 구체적이다. 화장품 영상에서 "그가 처음 사용한 립스틱의 번호는 무엇인가"를 물었다. 정답은 656번인데 예측은 선택지에 없는 E였다. 생성된 메모리는 인물이 볼 터치를 마치고 "립스틱에 집착한다"고 말하며 립스틱 단계로 넘어간다는 사실까지 적었지만, 제품에 보이는 번호나 색상 라벨은 남기지 않았다.
이 사례가 방법의 구조적 한계를 드러낸다. Phase Two는 최근 task에서 추정한 초점에 맞춰 세부를 남긴다. 그런데 "제품 번호"처럼 매우 좁은 단서는 초점이 정확히 그 단서를 향하지 않으면 남지 않는다. 초점을 좁히면 그 밖의 것을 잃고 넓히면 세부를 잃는다.
세 번째 유형은 앞서 본 Temporal Event Ordering의 하락과 이어진다. clip 하나하나의 서술은 맞는데 clip 사이의 순서와 관계가 메모리에 남지 않는다.
저자들이 이 분석에서 끌어낸 후속 방향은 메모리에 더 풍부한 시각 정보를 담는 것이다. 열린 질문 세 가지를 든다. visual memory를 어떻게 구조화하고 조직할지, 어떤 시각 세부를 남길 가치가 있는지 판정할지, 여러 modality에서 온 공간과 관계와 시간 단서를 어떻게 보존할지다.
한계
논문은 별도의 한계 절을 두지 않는다. 아래는 본문과 부록의 서술, 그리고 표에서 확인되는 사실을 정리한 것이다.
| 한계 | 근거 |
|---|---|
| base MLLM의 영상 이해 능력이 상한이다 | EgoTempo Accuracy에서 4.5%p 뒤진 원인을 저자들이 base 모델의 세밀한 활동 서술 능력 차이로 설명한다. policy는 지각하지 못한 것을 기억할 수 없다 |
| task마다 adapter가 필요하다 | cross-task transfer가 도움이 되지 않는다는 결과는 방법이 작동한다는 증거이면서 비용이다. 새 task마다 질문 5개에서 10개와 학습이 요구되고, 여러 task를 함께 다루는 방법은 다루지 않았다 |
| reward model 의존이 크다 | quality reward는 Gemini-2.5-Flash와 GPT-4o, richness reward와 Phase Two 선호 판정은 GPT-4o에 기댄다. API 비용과 재현성, judge 편향이 걸린다. 순서 교체 이중 평가와 순환 제거는 편향 억제 장치이되 판정자를 대체하지 않는다 |
| 평가가 답변 생성 모델의 컨텍스트에 묶여 있다 | VideoMME long subset을 뺀 이유가 메모리 길이가 GPT-4o 토큰 한도를 넘길 수 있다는 것이다. 장기 메모리가 가장 필요한 구간이 평가에서 빠졌다 |
| 평가 수치가 답변 모델에 민감하다 | 메모리를 고정한 채 답변 모델만 바꿨을 때 Accuracy가 61.6에서 68.9로 달라진다. 향상 폭은 유지되지만 절대값 비교는 답변 모델을 고정해야 의미가 있다 |
| streaming 프로토콜의 현실성이 미검증이다 | 같은 질문 유형을 묶어 task stream을 만드는 가정이 실제 배포 환경의 task 분포와 맞는지는 다루지 않았다. task 안에서 질문 유형이 고정돼 있어 환경 추정이 실제보다 쉬울 수 있다 |
| sliding window가 5개 clip으로 짧다 | 는 10초 clip 기준 50초 분량이다. 시간이나 일 단위 horizon에서 메모리를 어떻게 압축하고 잊을지는 범위 밖이다 |
| Coverage가 baseline을 넘지 못한다 | 세 벤치마크 모두 Coverage 최고값이 다른 모델의 것이다. Phase One 단계에서는 base보다 Coverage가 내려가기도 한다 |
| Temporal Event Ordering은 하락한다 | EgoTempo 10개 task 중 하나가 base 29.8에서 29.4로 내려갔다. 시간 순서가 clip 단위 메모리에 잘 보존되지 않는다는 신호이며 실패 유형 세 번째와 맞물린다 |
| adapter 방향의 조기 수렴이 설명되지 않았다 | step 10에서 코사인 0.8에 이르는 현상을 관찰하고 가속에 활용하지만 왜 그런지는 분석하지 않았다 |
| identity overlay가 도구 한계를 그대로 흡수한다 | face 검출과 ASR, 화자 식별의 오류가 입력 픽셀에 새겨져 들어간다. 프롬프트가 짧거나 알아듣기 어려운 발화를 건너뛰게 지시하는 것도 정보 손실 지점이다 |
| Phase Two 데이터 수확률이 낮다 | 컨텍스트 중 29.17%만 유효 선호 쌍을 낸다. 판정 일관성과 품질 조건을 통과하는 쌍이 셋 중 하나꼴이라, 데이터가 더 희소한 환경에서는 갱신이 어려울 수 있다 |
논문 자체의 표기 불일치도 짚어 둘 만하다. 부록 Table 15는 제안 방법을 TaskMem이 아니라 FOMO로 적는다. 투고 과정에서 이름이 바뀌며 부록 한 곳이 갱신되지 않은 것으로 보인다. baseline 설명이 메모리 프레임워크 하나를 HippoMem으로 적는 것도 같은 성격이다. Table 2와 참고문헌은 HippoMM이다.
후속 방향
저자들이 결론에서 밝힌 방향은 두 가지다. 첫째, episodic memory를 넘어 semantic memory와 visual memory로 TaskMem을 확장하는 것이다. 문제 정식화가 이미 그 확장을 염두에 두고 서술돼 있다. 둘째, 상호작용이 더 많은 embodied 환경에서 적응적 memorization을 탐구하는 것이다.
실패 사례 분석에서 나온 방향은 더 구체적이다. visual memory의 구조화, 남길 시각 세부의 판정 기준, 여러 modality에서 온 공간과 관계와 시간 단서의 보존이다.
표에서 읽히는 열린 문제도 있다. cross-task transfer가 작동하지 않으므로 여러 task를 함께 다루는 adapter나 task에 맞는 adapter를 골라 주는 장치가 필요하다. adapter 방향이 왜 그렇게 빨리 수렴하는지에 대한 설명도 남아 있다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| memorization policy | streaming multimodal 입력을 받아 무엇을 메모리로 남길지 정하는 학습 가능한 policy. 이 논문의 핵심 추상화다 |
| episodic memory | 시간 순서가 붙은 사건 중심 경험을 담는 메모리 층. 무엇이 언제 어디서 일어났는지를 기록한다 |
| richness reward | group 안 상대 순위를 0에서 1로 정규화해 0.05를 곱한 보조 reward. quality만 최적화할 때 나타나는 "짧고 빈약한 출력" 우회를 막는다 |
| NSR gating | advantage가 음수이고 reward 자체도 음수인 샘플에만 벌점을 주는 기법. group 정규화가 만드는 후반 학습 불안정을 없앤다 |
| feedback augmentation | 최근 task의 sparse한 feedback을 reward model로 pairwise preference로 바꿔 학습 신호를 늘리는 절차 |
| adapter vector | 단일 layer 출력에 더해지는 2,048차원 학습 벡터. layer 22에 삽입하고 backbone은 얼린다 |
| parametric personalized memory | adapter를 메모리로 해석한 저자들의 표현. task별 초점이 파라미터에 담긴다는 관점이다 |
| Coverage와 Precision | 메모리가 답에 필요한 정보를 담은 질문의 비율과, 충분 판정된 질문 중 정답 비율. 둘의 관계가 Accuracy를 설명한다 |
관련 페이지
- Memory Intelligence Agent (MIA): 가장 가까운 비교 대상이다. 두 자료가 공유하는 것은 메모리 일부를 파라미터에 넣는다는 설계다. 해당 페이지에 따르면 MIA는 trajectory를 텍스트 non-parametric memory와 Planner 가중치 parametric memory로 나눠 보관하고 GRPO 기반 강화학습을 두 단계로 교대한다. TaskMem은 그 parametric 쪽을 perception 단계의 memorization policy에 두고 단일 MLLM으로 단순화한 형태로 볼 수 있다. 두 자료 모두 프롬프트만 쓰는 baseline 대비 우위를 보고한다.
- Are We Ready For An Agent-Native Memory System?: 메모리 시스템 12개를 같은 기준으로 벤치마크한 자료다. 해당 페이지가 정리한 결론 중 "모든 시나리오를 지배하는 단일 아키텍처가 없고 성능은 메모리 구조가 workload의 병목과 맞물리는 정도에 달렸다"는 관찰은 TaskMem의 cross-task transfer 결과와 방향이 같다. 다만 그 자료는 검색과 저장 구조를 비교하고 이 논문은 생성 단계를 학습으로 바꾸므로 다루는 층이 다르다.
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory: 같은 장기 메모리 문제를 반대 방향으로 푼다. 해당 페이지에 따르면 Zep은 시간 정보가 붙은 knowledge graph에 사실의 유효 기간을 담아 지금 참인 것과 과거에 참이었던 것을 함께 질의한다. 즉 저장 구조를 설계하는 접근이고, TaskMem은 저장할 내용을 학습하는 접근이다. 두 자료를 나란히 두면 메모리 개선의 지점이 구조와 내용으로 나뉜다는 것이 보인다.
- getzep/graphiti: Zep의 그래프 엔진 오픈소스 구현이다. 해당 페이지는 설치와 API 표면과 라이선스를 다룬다. TaskMem에는 대응하는 공개 구현이 없고 프로젝트 페이지만 있다.
- Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents: 에이전트 스스로 harness를 갱신하는 self-evolution을 두 능력으로 분리해 측정한 논문이다. 이 논문의 Phase Two도 배포 후 스스로 갱신하는 구조이므로 같은 질문에 놓인다. 해당 자료가 프롬프트와 도구와 스킬 수준의 갱신을 다루는 데 반해 이 논문은 파라미터 수준 갱신을 다룬다.
- Compiling Agentic Workflows into LLM Weights: 프레임워크 수준의 orchestration을 fine-tuning으로 모델 가중치에 컴파일하는 접근이다. TaskMem과 겹치는 발상은 프롬프트나 프레임워크 층에서 해결되지 않는 것을 파라미터로 옮긴다는 것이다. 대상이 orchestration인지 메모리 선택인지에서 갈린다.
- Harness Engineering (Team Attention, 2026): 에이전트 성능의 레버가 프롬프트가 아니라 작업 환경 설계에 있다는 관점을 정리한 발표다. 메모리 생성 단계를 학습 대상으로 만든 이 논문은 그 관점에서 harness 구성 요소 하나를 학습 가능하게 바꾼 사례로 읽을 수 있다.
- 용어집: Agents (Terminology Glossary): memory, episodic memory, policy 등 이 페이지가 쓰는 용어의 canonical 표기가 정의된 용어집이다.