Database · PAPER · 2025
LightRAG: Simple and Fast Retrieval-Augmented Generation (EMNLP 2025)
요약
LightRAG는 지식 그래프를 검색 인덱스로 쓰되 GraphRAG의 community 처리를 걷어낸 graph-based RAG이다. 홍콩대와 베이징우전대 공동 연구로 2024년 10월 arXiv에 올라왔고 EMNLP 2025 Findings에 실렸다.
설계 의도는 이름 그대로다. 그래프가 주는 관계 표현력은 가져오되, 그래프를 쓰기 위해 치러야 했던 인덱싱 비용과 검색 비용은 줄인다. 이를 위해 두 장치를 쓴다. 첫째, entity와 relation을 key-value 쌍으로 직렬화해 그래프 순회 대신 평범한 벡터 검색으로 접근한다. 둘째, 질의에서 구체적인 키워드와 추상적인 키워드를 동시에 뽑아 각각 entity 인덱스와 relation 인덱스에 던지는 dual-level retrieval을 쓴다.
효과는 비용 쪽에서 가장 뚜렷하다. Legal 데이터셋에서 GraphRAG는 검색 한 번에 61만 토큰과 수백 회의 API 호출을 쓰는데, LightRAG는 100 토큰 미만과 1회 호출로 끝낸다. 문서 하나를 새로 넣을 때 GraphRAG는 community 구조를 해체하고 report를 전부 다시 만들어야 하지만, LightRAG는 새 그래프를 기존 그래프에 합집합으로 합치면 된다. 최종 저장 공간도 39.5MB 대 286.7MB로 차이가 크다.
품질 쪽 결과는 조건부다. UltraDomain 4개 도메인에서 NaiveRAG와 RQ-RAG와 HyDE를 상대로는 큰 폭으로 앞서지만, GraphRAG를 상대로는 Agriculture와 CS와 Legal에서만 앞서고 가장 작은 Mix 데이터셋에서는 근소하게 뒤진다.
배경
기존 RAG가 놓치는 것
RAG는 외부 지식을 검색해 LLM 입력에 붙이는 구조다. 이때 코퍼스를 chunk로 쪼개 vector database에 넣고 질의와 가장 가까운 chunk 상위 몇 개를 가져오는 방식이 표준이었다. 논문은 이 방식의 한계를 두 가지로 정리한다.
| 한계 | 내용 |
|---|---|
| 평면적 데이터 표현 | chunk가 서로 독립적으로 저장되어 entity 사이의 복잡한 관계를 이해하거나 그 관계를 근거로 검색할 수 없다 |
| 컨텍스트 인식 부족 | 여러 entity와 그 상호관계를 가로지르는 일관성을 유지하지 못해 질의를 온전히 다루지 못한다 |
논문이 든 예시가 문제를 잘 보여준다. "전기차 확산이 도시 대기질과 교통 인프라에 어떤 영향을 주는가"라는 질의에 대해 기존 RAG는 전기차 문서, 대기오염 문서, 교통 문제 문서를 각각 가져온다. 그러나 전기차 보급이 대기질을 개선하고 그 개선이 다시 대중교통 계획에 영향을 준다는 연결 고리는 만들어내지 못한다. 답변은 조각난 채로 남는다.
그래프를 쓰되 비용을 낮춘다
관계를 표현하려면 그래프가 자연스러운 선택이다. 이 방향을 처음 체계화한 것이 GraphRAG: From Local to Global의 GraphRAG다. GraphRAG는 코퍼스에서 entity와 relation을 뽑아 지식 그래프를 만들고, node를 community로 묶은 뒤 community마다 요약 report를 생성해 둔다. 넓은 질의가 들어오면 community를 순회하며 종합적인 정보를 모은다.
LightRAG 논문은 이 방식에 두 가지 문제를 제기한다.
- 동적 갱신이 어렵다. 지식 그래프를 새 정보로 확장하는 경로가 마련되어 있지 않다.
- 검색이 비싸다. 생성된 community마다 완전 탐색에 가까운 순회를 해야 해서 질의량이 많아지면 감당하기 어렵다.
여기서 문제 정의가 나온다. 논문은 목표를 세 가지로 잡는데, 서론과 2절에서 이름을 다르게 적는다.
| 목표 | 서론의 표현 | 2절의 표현 |
|---|---|---|
| 포괄성 | Comprehensive Information Retrieval | Comprehensive Information Retrieval |
| 효율 | Enhanced Retrieval Efficiency | Efficient and Low-Cost Retrieval |
| 갱신 | Rapid Adaptation to New Data | Fast Adaptation to Data Changes |
그래프와 LLM을 잇는 기존 접근
논문은 관련 연구에서 그래프와 LLM을 결합하는 흐름을 세 가지로 분류한다. LightRAG가 이 분류의 어디에도 속하지 않는다는 점을 밝히기 위한 정리다.
| 분류 | 방식 | 예시 |
|---|---|---|
| GNNs as Prefix | GNN이 구조를 반영한 토큰을 만들어 LLM 입력 앞에 붙인다 | GraphGPT (Tang et al., 2024), LLaGA (Chen et al., 2024) |
| LLMs as Prefix | LLM이 그래프에 붙은 텍스트를 처리해 임베딩이나 레이블을 만들고 이것으로 GNN 학습을 다듬는다 | GALM (Xie et al., 2023), OFA (Liu et al., 2024) |
| LLMs-Graphs Integration | 융합 학습, GNN 정렬, LLM 기반 에이전트로 그래프를 직접 다룬다 | Grenade (Li et al., 2023), Congrat (Brannon et al., 2023) |
세 분류의 공통점은 GNN이 어딘가에 등장한다는 것이다. LightRAG는 GNN을 쓰지 않는다. 그래프를 학습 대상으로 보지 않고 LLM이 만들고 LLM이 조회하는 인덱스 자료구조로만 쓴다. 이 선택 덕분에 별도 학습 없이 범용 LLM만으로 파이프라인이 완성된다.
GraphRAG의 검색 모드에 관한 주의
LightRAG 논문이 baseline으로 삼은 GraphRAG는 community 요약과 community 순회 한 가지 방식이다. 논문 전체에 "local search"나 "global search"라는 표현은 한 번도 나오지 않으며, 비교 대상이 어떤 검색 모드였는지 구분하는 서술도 없다.
흔히 GraphRAG를 local search와 global search 두 모드로 설명하는데, 그 이원 구성은 Microsoft의 공식 구현체 microsoft/graphrag가 도입한 것이지 GraphRAG: From Local to Global 원논문의 것이 아니다. 원논문은 community summary와 map-reduce 방식의 단일 질의 경로만 다룬다. LightRAG 자신의 low-level과 high-level은 이와 무관한 별개의 구분이므로 두 이름을 겹쳐 읽지 않아야 한다.
핵심 개념
Graph-based text indexing은 코퍼스를 chunk 벡터가 아니라 지식 그래프로 인덱싱하는 방식이다. LLM이 chunk마다 entity와 relation을 뽑아내고, 이 결과를 모아 코퍼스 전체를 아우르는 그래프 하나를 만든다.
key-value 인덱싱은 그래프의 node와 edge를 (key, value) 쌍 문자열로 바꿔 두는 것이다. key는 검색에 쓰는 단어나 짧은 구이고, value는 생성에 넣을 요약 문단이다. 그래프를 순회하지 않고 key만 벡터로 비교하면 되므로 검색이 단순해진다.
dual-level retrieval은 질의에서 두 종류의 키워드를 동시에 뽑아 서로 다른 인덱스에 던지는 검색 방식이다. 구체적인 키워드는 entity를 찾고 추상적인 키워드는 relation을 찾는다. 질의를 미리 분류하지 않는다는 점이 핵심이다.
specific query와 abstract query는 논문이 나눈 질의 유형이다. specific query는 그래프의 특정 node나 edge를 지목하는 세부 지향 질의이고, abstract query는 넓은 주제나 요약을 묻는 개념 지향 질의다.
| 유형 | 성격 | 논문의 예시 | 담당 층 |
|---|---|---|---|
| Specific Query | 특정 entity와 그 속성을 정확히 찾아야 한다 | "Who wrote 'Pride and Prejudice'?" | Low-Level Retrieval |
| Abstract Query | 여러 entity에 걸친 상위 개념과 요약이 필요하다 | "How does artificial intelligence influence modern education?" | High-Level Retrieval |
incremental update는 새 문서가 들어왔을 때 전체 인덱스를 다시 만들지 않고 새로 만든 부분 그래프를 기존 그래프에 합치는 절차다.
gleaning parameter는 entity와 relation 추출을 몇 번 더 반복해 놓친 것을 다시 줍는지 정하는 값이다. 이 실험에서는 GraphRAG와 LightRAG 모두 1로 고정했다.
방법
설계 목표와 장치의 대응
앞에서 정리한 세 목표에 각각 어떤 장치가 대응하는지 먼저 보면 전체 그림이 잡힌다.
| 목표 | 대응 장치 | 그 장치가 목표를 달성하는 방식 |
|---|---|---|
| 포괄적 검색 | graph-based text indexing과 1-hop 확장 | 여러 chunk에 흩어진 정보를 entity와 relation으로 묶어 multi-hop subgraph에서 한 번에 꺼낸다 |
| 저비용 검색 | key-value 인덱스와 dual-level retrieval | community 순회 대신 key 임베딩 비교만 하므로 LLM 호출이 키워드 추출 1회로 끝난다 |
| 빠른 갱신 | incremental update | 새 부분 그래프를 합집합으로 붙이므로 기존 인덱스를 다시 만들지 않는다 |
세 장치는 서로를 전제한다. key-value 인덱스가 있어야 그래프 순회 없이 검색할 수 있고, 순회가 사라져야 community 같은 전역 구조가 필요 없어지며, 전역 구조가 없어야 합집합만으로 갱신이 끝난다. 비용 우위가 한 곳에서 나오지 않고 설계 전체에서 나오는 이유다.
전체 구조
LightRAG는 두 부분으로 나뉜다. 왼쪽 절반이 인덱싱이고 오른쪽 절반이 검색이다.
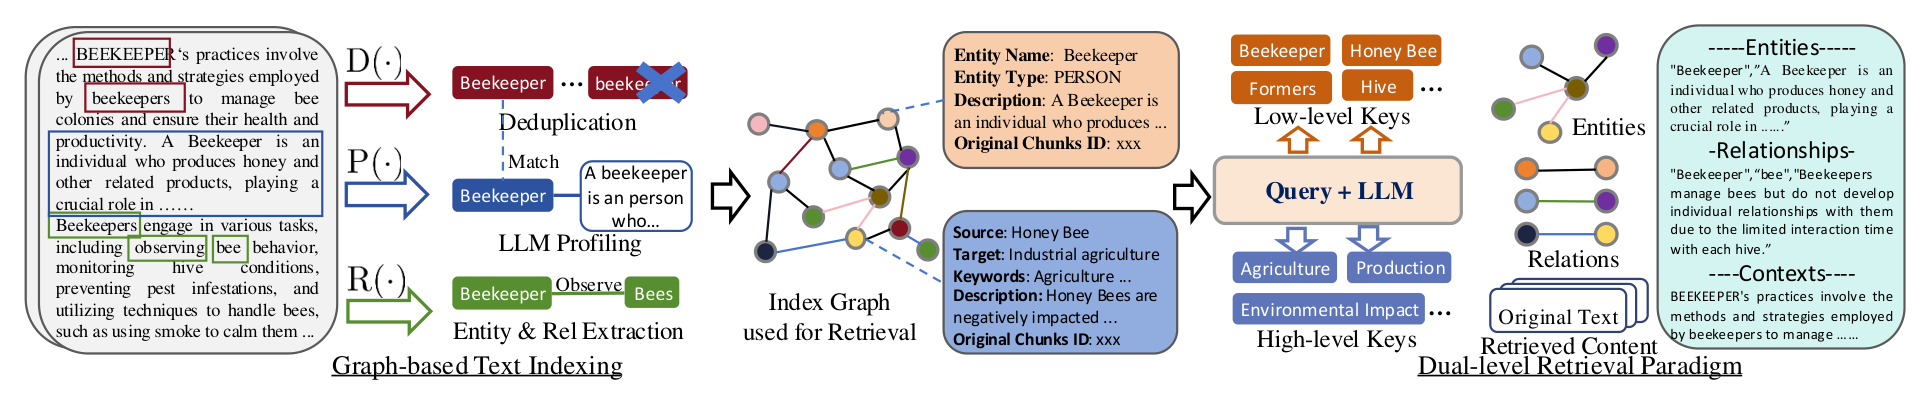
논문이 쓰는 형식화는 다음과 같다.
| 기호 | 이름 | 역할 |
|---|---|---|
| data indexer | 외부 DB 로부터 인덱스 구조 를 만든다 | |
| data retriever | 질의 를 인덱스와 대조해 관련 정보를 얻는다 | |
| generation module | 질의와 검색 결과를 받아 답변을 만든다 |
LightRAG가 손대는 부분은 와 다. 는 fine-tuning 없이 범용 LLM을 그대로 쓴다.
그래프 인덱싱의 세 단계
인덱싱은 세 함수의 합성으로 표현된다.
| 순서 | 함수 | 하는 일 |
|---|---|---|
| 1 | chunk 마다 LLM 프롬프트로 entity(node)와 relation(edge)을 뽑는다 | |
| 2 | 각 entity와 relation에 (key, value) 쌍을 만든다. LLM profiling이라 부른다 | |
| 3 | 서로 다른 chunk에서 나온 동일 entity와 relation을 병합해 그래프 크기를 줄인다 |
논문은 본문 불릿에서 같은 함수를 , , 로 짧게 쓰기도 한다. 수식과 본문의 표기가 다를 뿐 같은 세 단계다.
추출 예시는 이렇다. "Cardiologists assess symptoms to identify potential heart issues."라는 문장에서 entity로 Cardiologists와 Heart Disease를 뽑고, 둘 사이에 "Cardiologists diagnose Heart Disease"라는 relation을 만든다. 원문에 diagnose라는 단어가 없어도 LLM이 의미를 읽어 관계를 명시한다는 점이 chunk 검색과 다른 지점이다.
이 인덱싱이 주는 이점을 논문은 두 가지로 든다. 하나는 Comprehensive Information Understanding으로, multi-hop subgraph를 따라가면 여러 chunk에 흩어진 정보를 하나로 모을 수 있다. 다른 하나는 Enhanced Retrieval Performance로, key-value 구조가 부정확한 임베딩 매칭이나 비효율적인 chunk 순회보다 빠르고 정확하다는 것이다.
key와 value를 붙이는 규칙
인덱싱의 핵심은 entity와 relation에 key를 다르게 붙인다는 데 있다.
| 대상 | key | value | key 개수 |
|---|---|---|---|
| Entity | entity 이름 | 속성과 활동을 요약한 description | 1개. 논문 표현으로 sole index key |
| Relation | 연결된 두 entity에서 LLM이 합성한 상위 테마 키워드 | 관계를 설명하는 description | 여러 개 가능 |
이 비대칭이 dual-level retrieval을 성립시킨다. entity의 key는 고유명사에 가깝기 때문에 구체적인 질의어와 잘 맞고, relation의 key는 개념어에 가깝기 때문에 추상적인 질의어와 잘 맞는다. 결국 어느 인덱스에 질의어를 던지느냐로 검색의 추상 수준을 조절한다.
relation의 key가 실제로 어떻게 만들어지는지는 그래프 구축 프롬프트에서 확인된다.
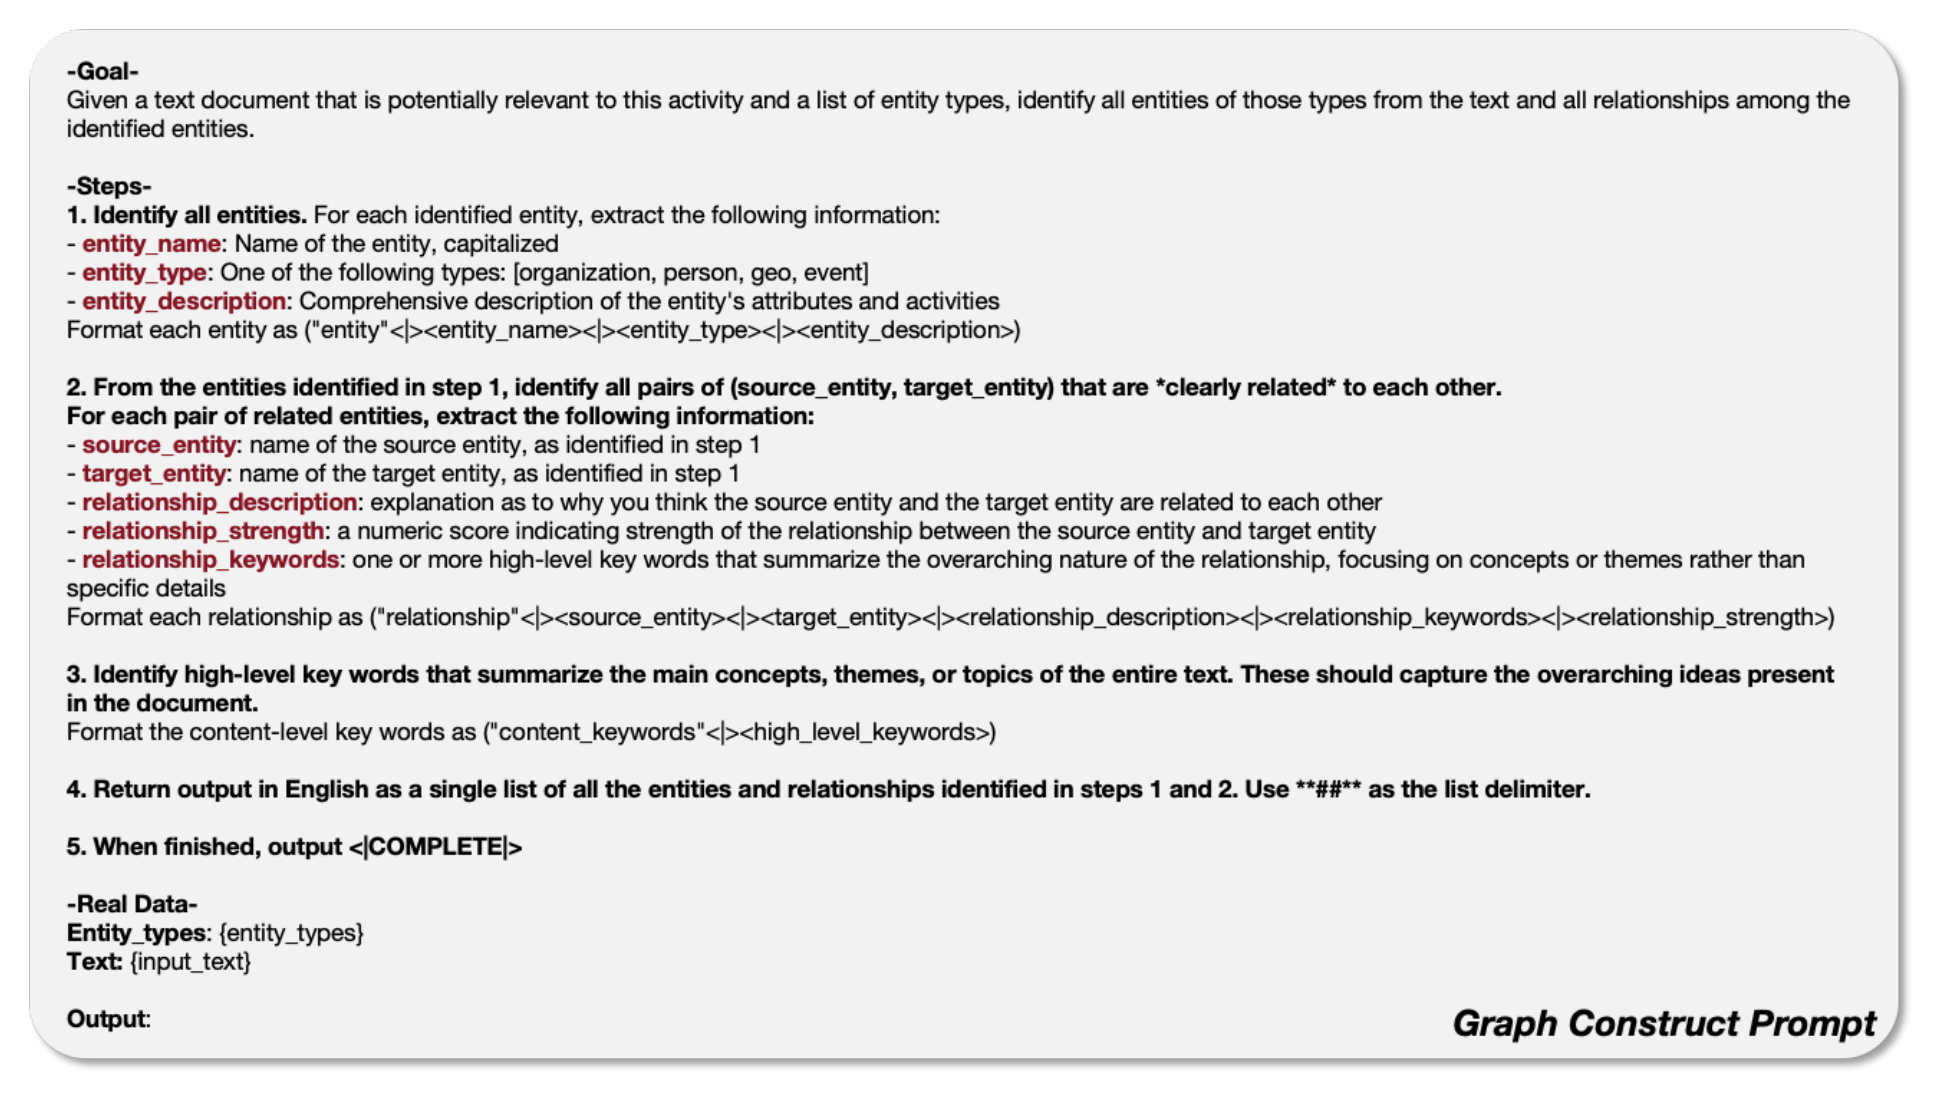
프롬프트는 세 단계 지시로 짜여 있다.
| 단계 | 추출 항목 |
|---|---|
| 1 | entity_name, entity_type(organization, person, geo, event 중 하나), entity_description |
| 2 | source_entity, target_entity, relationship_description, relationship_strength(관계 강도 점수), relationship_keywords(관계의 성격을 요약한 상위 키워드) |
| 3 | content_keywords(문서 전체를 관통하는 개념과 테마) |
2단계의 relationship_keywords가 relation의 검색 key다. 프롬프트는 이 키워드를 "구체적 세부가 아니라 개념이나 테마에 초점을 맞추라"고 명시한다.
dual-level retrieval
검색은 세 단계다.
| 순서 | 단계 | 내용 |
|---|---|---|
| 1 | Query Keyword Extraction | 질의 에서 local 키워드 와 global 키워드 를 LLM이 한 번에 뽑는다 |
| 2 | Keyword Matching | vector database에서 은 후보 entity와, 는 global key가 붙은 relation과 매칭한다 |
| 3 | Incorporating High-Order Relatedness | 검색된 node 와 edge 의 1-hop neighbor까지 모아 subgraph를 넓힌다 |
3단계의 집합은 로 쓴다. 와 는 각각 검색된 node와 edge의 1-hop 이웃 node 집합이다. 즉 직접 맞은 것만 쓰지 않고 그 한 칸 옆까지 컨텍스트로 끌어온다.
1단계의 키워드 추출은 별도 학습 없이 프롬프트로 처리한다.
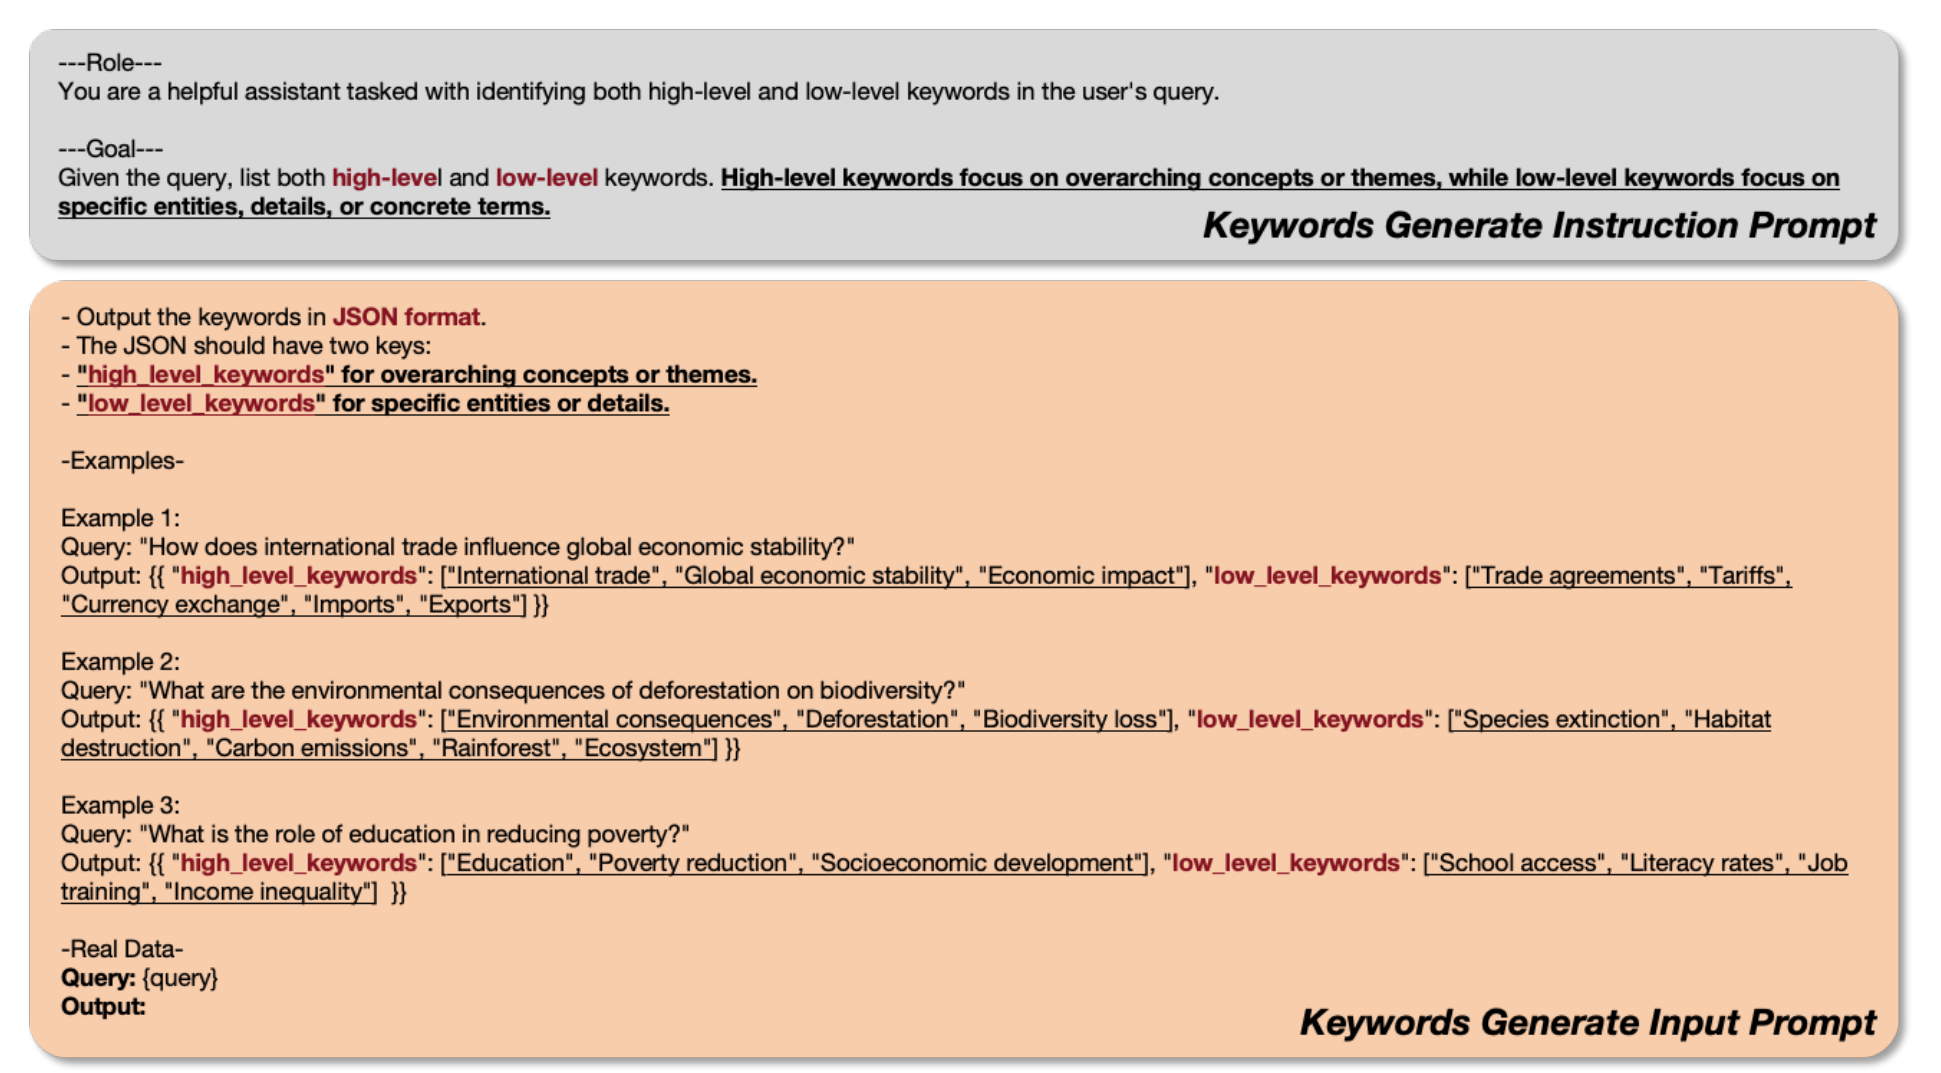
프롬프트가 준 예시를 보면 두 층의 성격이 분명하다.
| 질의 | high_level_keywords | low_level_keywords |
|---|---|---|
| "How does international trade influence global economic stability?" | International trade, Global economic stability, Economic impact | Trade agreements, Tariffs, Currency exchange, Imports, Exports |
| "What are the environmental consequences of deforestation on biodiversity?" | Environmental consequences, Deforestation, Biodiversity loss | Species extinction, Habitat destruction, Carbon emissions, Rainforest, Ecosystem |
| "What is the role of education in reducing poverty?" | Education, Poverty reduction, Socioeconomic development | School access, Literacy rates, Job training, Income inequality |
high-level 쪽은 질의의 주제 그 자체이고, low-level 쪽은 그 주제를 이루는 구체적 항목이다. 질의 하나가 두 층으로 동시에 펼쳐지므로 specific query든 abstract query든 한 경로로 처리된다.
증분 갱신
새 문서 가 들어오면 같은 인덱싱 를 적용해 를 얻고, 기존 그래프와 합집합을 취한다.
논문이 든 목표는 두 가지다. Seamless Integration of New Data는 기존 그래프 구조를 흔들지 않고 새 데이터를 합쳐 기존 연결의 무결성과 과거 데이터 접근성을 지키는 것이다. Reducing Computational Overhead는 전체 인덱스 그래프를 다시 만들 필요를 없애 새 데이터 흡수를 빠르게 하는 것이다.
이 단순한 합집합 연산이 GraphRAG 대비 비용 우위의 대부분을 만든다. community 구조는 전역적으로 계산되므로 node가 추가되면 소속이 바뀔 수 있고 report도 다시 써야 한다. 반면 합집합은 국소적이다.
답변 생성
검색된 subgraph에서 entity와 relation의 value를 이어 붙이고, 여기에 이름과 description, 그리고 원문 발췌를 더해 LLM에 컨텍스트로 넘긴다. 별도 fine-tuning은 없다.
전 과정이 하나의 예시로 정리되어 있다.
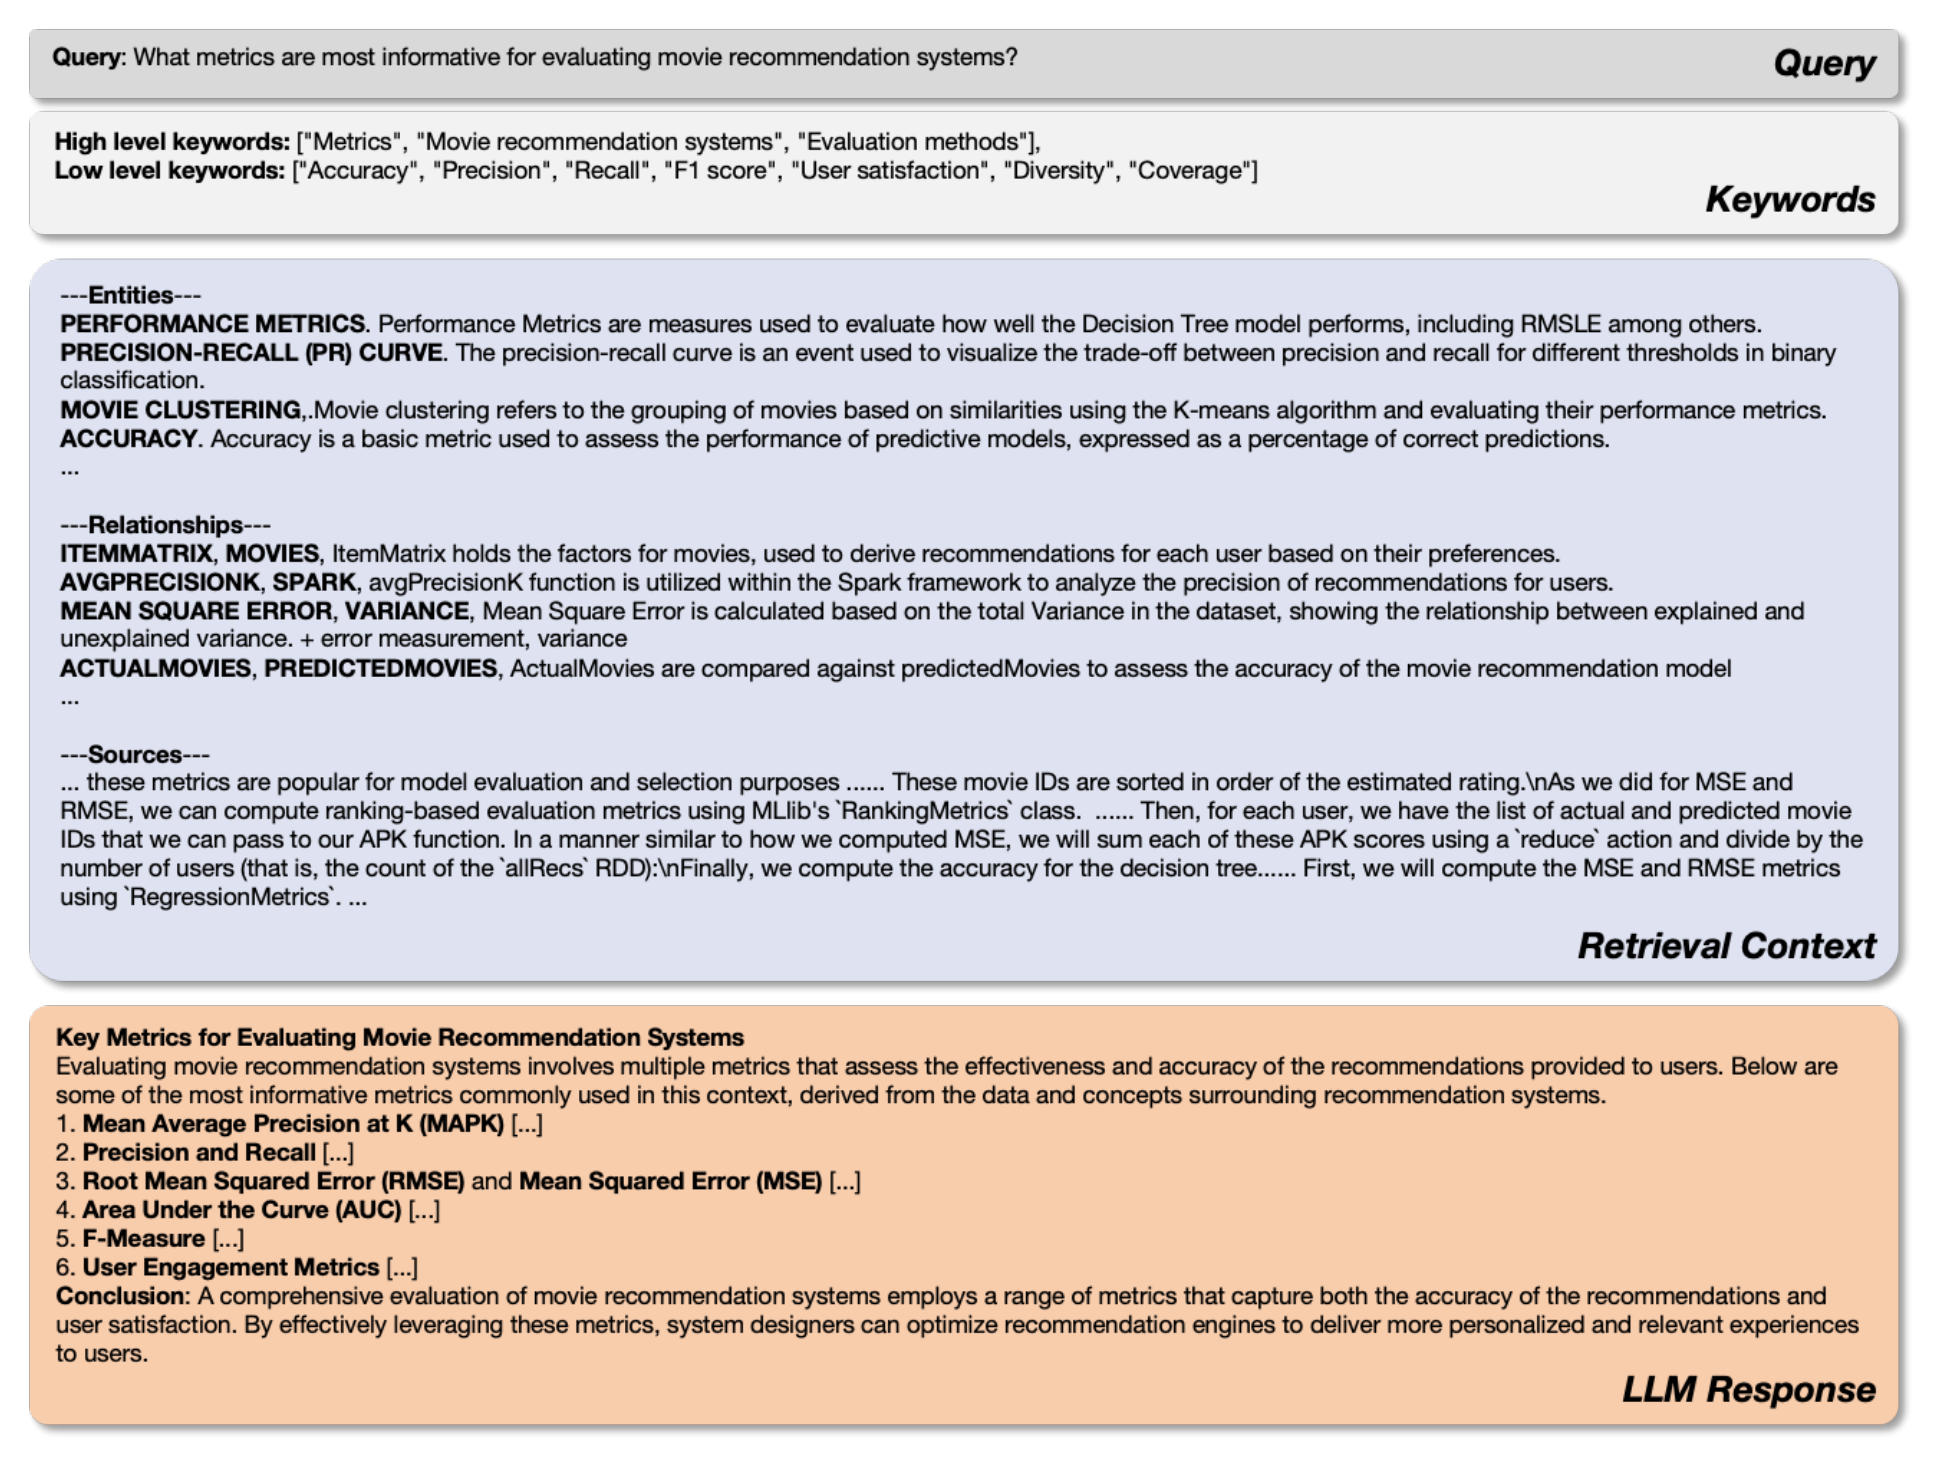
"What metrics are most informative for evaluating movie recommendation systems?"라는 질의에서 high-level 키워드로 Metrics, Movie recommendation systems, Evaluation methods를 뽑고 low-level 키워드로 Accuracy, Precision, Recall, F1 score, User satisfaction, Diversity, Coverage를 뽑는다. 검색 결과는 Entities, Relationships, Sources 세 묶음으로 정리되어 LLM에 들어가고, 최종 답변은 MAPK와 AUC까지 포함한 여섯 지표를 제시한다.
계산량
| 단계 | LLM 호출 수 | 설명 |
|---|---|---|
| Index | 전체 토큰 수를 chunk size로 나눈 값 | chunk마다 entity와 relation 추출 1회다. 추가 오버헤드가 없다 |
| Retrieval | 1회 | 키워드 생성에만 LLM을 쓰고 나머지는 벡터 검색이다 |
검색 단계에서 chunk가 아니라 entity와 relation을 가져온다는 점이 GraphRAG와 다르다. GraphRAG는 community 기반 순회를 하므로 오버헤드가 훨씬 크다.
평가 설계
데이터셋
UltraDomain benchmark에서 4개 도메인을 골랐다. UltraDomain은 대학 교재 428권에서 뽑은 18개 도메인 코퍼스다.
| 통계 | Agriculture | CS | Legal | Mix |
|---|---|---|---|---|
| 문서 수 | 12 | 10 | 94 | 61 |
| 토큰 수 | 2,017,886 | 2,306,535 | 5,081,069 | 619,009 |
Legal이 508만 토큰으로 가장 크고 Mix가 62만 토큰으로 가장 작다. 문서 수와 토큰 수가 비례하지 않는다는 점도 눈에 띈다. Agriculture는 문서 12개로 201만 토큰이고 Mix는 문서 61개로 62만 토큰이라, 문서 한 건의 평균 길이가 도메인마다 크게 다르다. 이 크기 차이가 뒤의 결과 해석에서 중요하게 쓰인다.
| 도메인 | 다루는 내용 |
|---|---|
| Agriculture | 양봉, 벌통 관리, 작물 생산, 병해 예방 등 농업 실무 |
| CS | 데이터 사이언스와 소프트웨어 공학. 추천 시스템, 분류 알고리즘, Spark 실시간 분석 |
| Legal | 기업 구조조정, 법률 계약, 규제 준수, 지배구조 등 기업 법무 |
| Mixed | 문학과 전기와 철학 텍스트를 포함한 문화, 역사, 철학 전반 |
비교 대상
| Baseline | 방식 | 성격 |
|---|---|---|
| Naive RAG (Gao et al., 2023) | 원문을 chunk로 나눠 임베딩으로 저장하고 유사도 상위 chunk를 그대로 가져온다 | chunk 기반 |
| RQ-RAG (Chan et al., 2024) | LLM이 질의를 재작성, 분해, 모호성 해소를 거쳐 여러 sub-query로 쪼갠다 | chunk 기반 |
| HyDE (Gao et al., 2022) | LLM이 가상의 문서를 만들고 그 문서로 관련 chunk를 검색한다 | chunk 기반 |
| GraphRAG (Edge et al., 2024) | entity와 relation을 node와 edge로 만들고 node를 community로 묶어 report를 생성한 뒤 community를 순회한다 | graph 기반 |
구현 파라미터
| 항목 | 값 |
|---|---|
| 벡터 저장소 | nano vector database |
| 모든 LLM 연산 | GPT-4o-mini |
| chunk size | 1200 (전 데이터셋 공통) |
| gleaning parameter | 1 (GraphRAG와 LightRAG 동일) |
| judge 모델 | GPT-4o-mini |
| 임베딩 모델 | 논문 본문에 명시 없음 |
임베딩 모델을 밝히지 않은 것은 재현 관점에서 빈틈이다. graph-based RAG의 검색은 결국 key 임베딩의 유사도로 결정되므로 어떤 임베딩을 썼는지가 결과를 좌우한다.
질문 생성과 판정
정답을 정의하기 어려운 개방형 질의를 다루므로 GraphRAG가 쓴 방식을 그대로 따른다. 데이터셋 전체 텍스트를 컨텍스트로 주고 LLM에 가상의 사용자 5명을 만들게 하고, 사용자마다 과제 5개, (사용자, 과제) 쌍마다 질문 5개를 만들게 한다. 결과는 데이터셋당 125문항이다.
채점은 GPT-4o-mini judge의 pairwise 비교다.
| 항목 | 정의 |
|---|---|
| Comprehensiveness | 질문의 모든 측면과 세부를 얼마나 철저히 다루는가 |
| Diversity | 관점과 통찰이 얼마나 다양하고 풍부한가 |
| Empowerment | 독자가 주제를 이해하고 판단하도록 얼마나 잘 돕는가 |
| Overall | 앞 세 항목을 종합한 판정 |
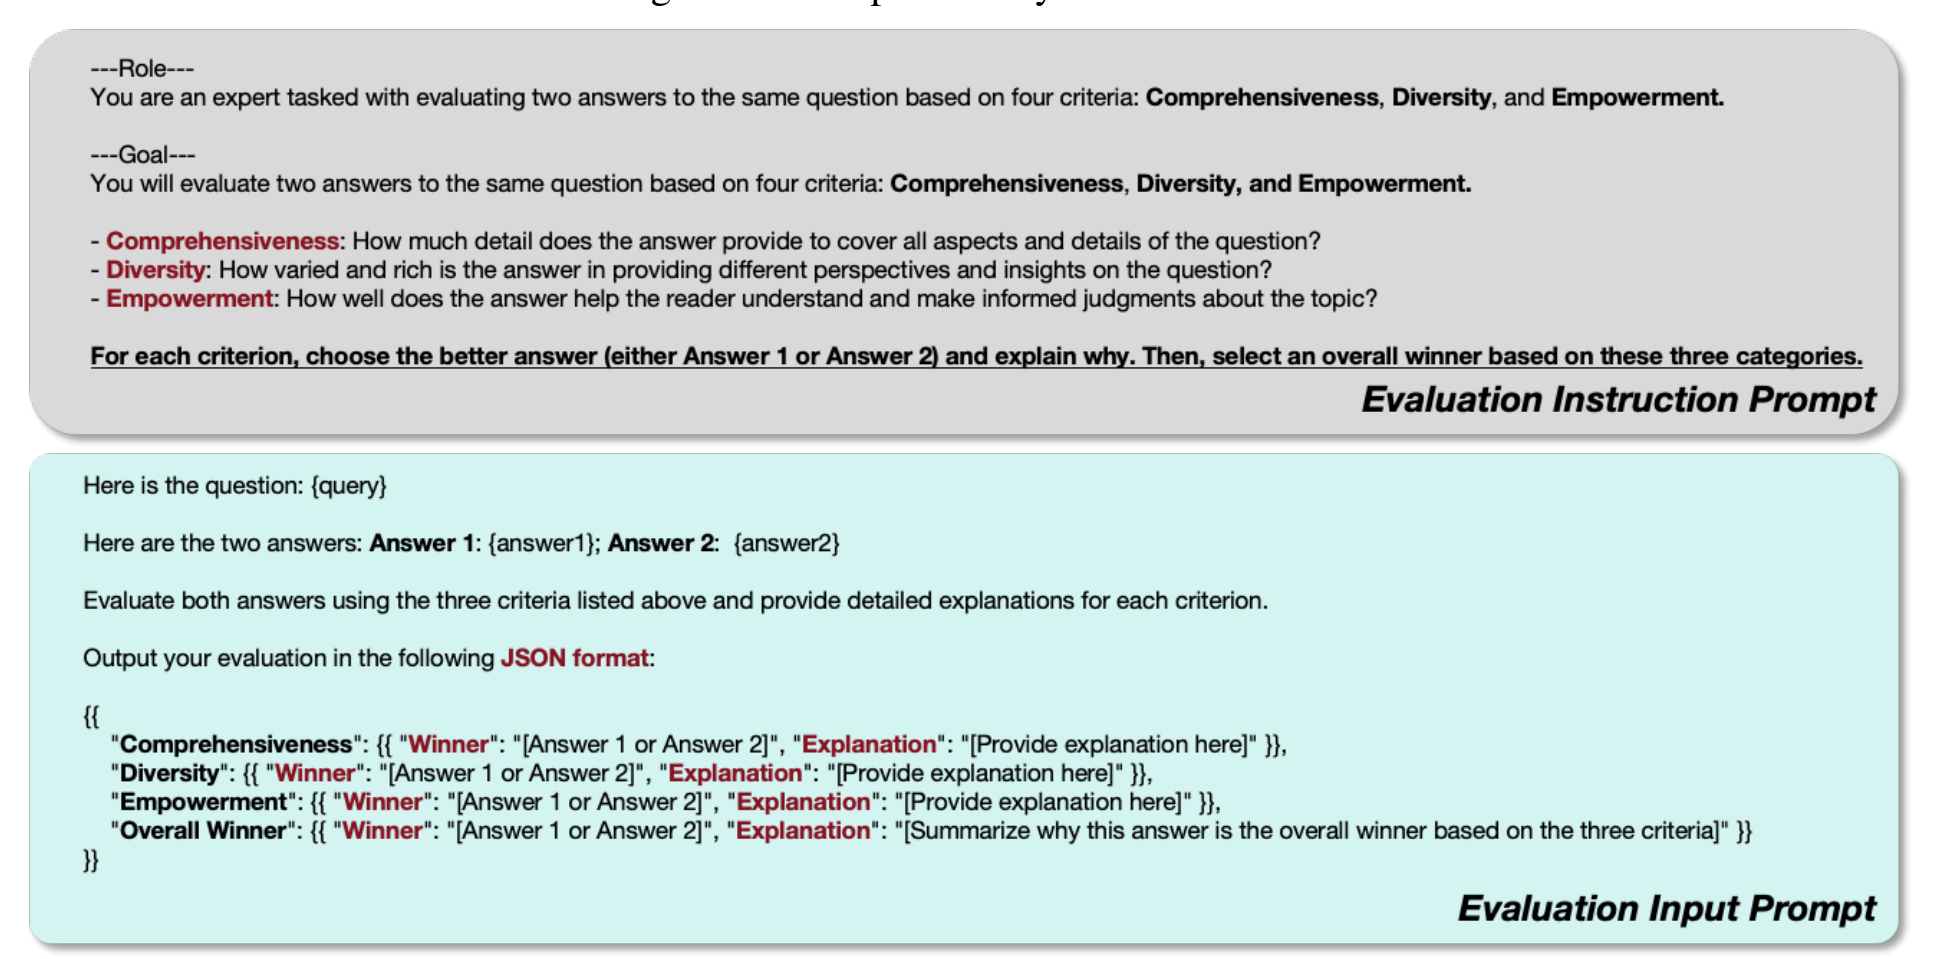
제시 순서에서 오는 편향을 줄이려고 두 답변의 위치를 번갈아 바꿔 측정한 뒤 승률을 계산한다. 다만 답변 생성과 판정에 같은 GPT-4o-mini를 쓰기 때문에 모델이 자기 계열 출력을 선호할 여지는 통제되지 않는다.
결과
baseline 대비 승률
Table 1의 전체 수치다. 각 칸은 (baseline 승률, LightRAG 승률)이고 단위는 %다.
| 항목 | Agriculture | CS | Legal | Mix |
|---|---|---|---|---|
| vs NaiveRAG | ||||
| Comprehensiveness | 32.4 / 67.6 | 38.4 / 61.6 | 16.4 / 83.6 | 38.8 / 61.2 |
| Diversity | 23.6 / 76.4 | 38.0 / 62.0 | 13.6 / 86.4 | 32.4 / 67.6 |
| Empowerment | 32.4 / 67.6 | 38.8 / 61.2 | 16.4 / 83.6 | 42.8 / 57.2 |
| Overall | 32.4 / 67.6 | 38.8 / 61.2 | 15.2 / 84.8 | 40.0 / 60.0 |
| vs RQ-RAG | ||||
| Comprehensiveness | 31.6 / 68.4 | 38.8 / 61.2 | 15.2 / 84.8 | 39.2 / 60.8 |
| Diversity | 29.2 / 70.8 | 39.2 / 60.8 | 11.6 / 88.4 | 30.8 / 69.2 |
| Empowerment | 31.6 / 68.4 | 36.4 / 63.6 | 15.2 / 84.8 | 42.4 / 57.6 |
| Overall | 32.4 / 67.6 | 38.0 / 62.0 | 14.4 / 85.6 | 40.0 / 60.0 |
| vs HyDE | ||||
| Comprehensiveness | 26.0 / 74.0 | 41.6 / 58.4 | 26.8 / 73.2 | 40.4 / 59.6 |
| Diversity | 24.0 / 76.0 | 38.8 / 61.2 | 20.0 / 80.0 | 32.4 / 67.6 |
| Empowerment | 25.2 / 74.8 | 40.8 / 59.2 | 26.0 / 74.0 | 46.0 / 54.0 |
| Overall | 24.8 / 75.2 | 41.6 / 58.4 | 26.4 / 73.6 | 42.4 / 57.6 |
| vs GraphRAG | ||||
| Comprehensiveness | 45.6 / 54.4 | 48.4 / 51.6 | 48.4 / 51.6 | 50.4 / 49.6 |
| Diversity | 22.8 / 77.2 | 40.8 / 59.2 | 26.4 / 73.6 | 36.0 / 64.0 |
| Empowerment | 41.2 / 58.8 | 45.2 / 54.8 | 43.6 / 56.4 | 50.8 / 49.2 |
| Overall | 45.2 / 54.8 | 48.0 / 52.0 | 47.2 / 52.8 | 50.4 / 49.6 |
chunk 기반 baseline 셋과의 격차는 코퍼스가 커질수록 벌어진다. 가장 큰 Legal에서 NaiveRAG는 Overall 15.2%, RQ-RAG는 14.4%까지 내려간다. 논문은 이를 두고 "baseline이 20% 수준의 승률에 그친다"고 서술하는데, 같은 Legal에서 HyDE는 Overall 26.4%로 이 서술보다 높다. 저자의 요약이 실제 표보다 다소 강하게 쓰인 대목이다.
Diversity 항목의 우위가 가장 크다. 예를 들어 Legal에서 RQ-RAG 대비 88.4%, NaiveRAG 대비 86.4%다. 저자는 dual-level retrieval이 low-level과 high-level 양쪽에서 정보를 모으기 때문으로 해석한다.
GraphRAG 대비 결과
같은 graph 기반끼리의 비교는 훨씬 접전이다.
| 데이터셋 | 토큰 수 | Comprehensiveness | Diversity | Empowerment | Overall |
|---|---|---|---|---|---|
| Agriculture | 201만 | 54.4 | 77.2 | 58.8 | 54.8 |
| CS | 230만 | 51.6 | 59.2 | 54.8 | 52.0 |
| Legal | 508만 | 51.6 | 73.6 | 56.4 | 52.8 |
| Mix | 62만 | 49.6 | 64.0 | 49.2 | 49.6 |
Agriculture와 CS와 Legal에서는 네 항목 모두 50%를 넘는다. Mix에서는 Comprehensiveness 49.6%, Empowerment 49.2%, Overall 49.6%로 GraphRAG가 근소하게 앞서고 Diversity만 64.0%로 LightRAG가 앞선다.
Mix가 가장 작은 데이터셋이라는 점이 단서다. 코퍼스가 작으면 community 수가 적어 GraphRAG의 순회 비용 부담이 줄고, 반대로 LightRAG가 그래프에서 뽑아낼 관계의 밀도도 낮아진다. 어느 항목에서도 Diversity만은 LightRAG가 앞선다는 사실은 high-level retrieval의 효과가 데이터셋 크기와 무관하게 유지된다는 뜻으로 읽힌다.
Ablation
Table 2는 NaiveRAG를 기준선으로 두고 각 변형의 승률을 잰다. 아래 표는 LightRAG 쪽 승률만 옮긴 것으로 단위는 %다.
| 항목 | 전체 | -High | -Low | -Origin |
|---|---|---|---|---|
| Agriculture | ||||
| Comprehensiveness | 67.6 | 65.2 | 64.0 | 75.2 |
| Diversity | 76.4 | 72.8 | 72.0 | 73.6 |
| Empowerment | 67.6 | 64.0 | 65.2 | 68.0 |
| Overall | 67.6 | 64.8 | 65.2 | 74.4 |
| CS | ||||
| Comprehensiveness | 61.6 | 57.2 | 56.8 | 60.8 |
| Diversity | 62.0 | 63.2 | 60.4 | 55.2 |
| Empowerment | 61.2 | 57.6 | 57.2 | 56.8 |
| Overall | 61.2 | 56.0 | 56.4 | 60.8 |
| Legal | ||||
| Comprehensiveness | 83.6 | 76.4 | 80.8 | 83.6 |
| Diversity | 86.4 | 83.2 | 86.4 | 85.6 |
| Empowerment | 83.6 | 77.2 | 83.6 | 82.8 |
| Overall | 84.8 | 78.0 | 81.2 | 84.4 |
| Mix | ||||
| Comprehensiveness | 61.2 | 59.6 | 64.0 | 55.6 |
| Diversity | 67.6 | 64.0 | 66.8 | 74.4 |
| Empowerment | 57.2 | 52.4 | 64.8 | 54.8 |
| Overall | 60.0 | 57.6 | 64.8 | 55.6 |
세 변형의 정의와 Overall 변화는 다음과 같다.
| 변형 | 정의 | Agriculture | CS | Legal | Mix |
|---|---|---|---|---|---|
| -High | high-level retrieval 제거. low-level만 쓴다 | -2.8%p | -5.2%p | -6.8%p | -2.4%p |
| -Low | low-level retrieval 제거. high-level만 쓴다 | -2.4%p | -4.8%p | -3.6%p | +4.8%p |
| -Origin | 검색 결과에서 원문 passage 제거 | +6.8%p | -0.4%p | -0.4%p | -4.4%p |
Overall 기준으로 -High의 하락이 네 데이터셋 모두에서 -Low보다 크거나 같다. 특히 Legal에서 -6.8%p 대 -3.6%p로 차이가 뚜렷하다. 저자는 low-level만 남기면 entity와 그 직접 이웃에 지나치게 집중해 종합적 통찰이 필요한 질의에서 정보를 모으지 못한다고 해석한다.
-Low는 entity 사이 관계로 넓은 범위를 담아 comprehensiveness에서 유리하다는 것이 저자의 서술이다. 다만 표를 보면 Legal과 Mix에서만 그렇고 Agriculture와 CS의 Comprehensiveness는 오히려 -High보다 낮다. Mix에서 -Low가 Overall 64.8%로 전체 LightRAG의 60.0%를 넘는 점도 특이하다. 이 데이터셋에서는 low-level retrieval이 오히려 방해가 되었다는 뜻이다.
-Origin은 검색 컨텍스트에서 원문 chunk를 빼고 그래프에서 뽑은 description만 남긴 변형이다. 저자는 "성능이 크게 떨어지지 않고 일부(Agriculture, Mix)에서는 오히려 올랐다"고 적으며, 그래프 인덱싱이 이미 핵심 정보를 충분히 뽑았고 원문에는 노이즈가 될 무관한 정보가 섞여 있다고 해석한다. 그러나 Overall 기준 실제 상승은 Agriculture 한 곳뿐이다. Mix는 60.0%에서 55.6%로 내려가며 Diversity 한 항목만 67.6%에서 74.4%로 오른다. 본문의 요약과 표가 어긋난다.
비용
Legal 데이터셋 기준 비교다. 는 entity와 relation 추출의 토큰 오버헤드, 는 API 호출당 허용 토큰 상한, 는 추출에 필요한 API 호출 수다.
| 단계 | 지표 | GraphRAG | LightRAG |
|---|---|---|---|
| Retrieval | 토큰 | 610 × 1,000, 즉 61만 | 100 미만 |
| Retrieval | API 호출 | (610 × 1,000) / , 본문 표현으로 수백 회 | 1회 |
| Incremental Text Update | 토큰 | 1,399 × 2 × 5,000 + , 즉 약 1,399만 | |
| Incremental Text Update | API 호출 | 1,399 × 2 + |
수치가 어디서 왔는지 따라가면 구조가 보인다. GraphRAG는 Legal 코퍼스에서 community를 1,399개 만들고, 이 실험에서는 그중 level-2 community 610개를 검색에 실제로 쓴다. community report 하나가 평균 1,000 토큰이라 610개면 61만 토큰이다. 게다가 community를 하나씩 순회해야 해서 호출이 수백 회로 늘어난다. LightRAG는 키워드 생성과 검색에 100 토큰 미만을 쓰고 전 과정에 호출이 1회다.
증분 갱신에서는 추출 오버헤드가 두 방법 모두 비슷하다. 차이는 그 다음 단계다. GraphRAG는 새 entity와 relation을 넣으려고 기존 community 구조를 해체한 뒤 원래 report와 새 report를 전부 다시 만들어야 한다. 이때 report 하나가 약 5,000 토큰이므로 community 1,399개 기준 1,399 × 2 × 5,000 토큰이 든다. LightRAG는 재구축 없이 합집합으로 합치므로 추출 오버헤드만 남는다.
여기서 논문 내부의 수치 불일치가 하나 보인다. 같은 community report를 검색 분석에서는 평균 1,000 토큰으로, 증분 갱신 분석에서는 약 5,000 토큰으로 적는다. 전자는 사용 시점의 report 길이이고 후자는 생성 시점의 비용으로 읽을 수 있으나 논문은 둘을 구분해 설명하지 않는다.
시간과 저장 공간
토큰 수 41,224에서 73,989 사이의 문서 5개를 지식 베이스에 추가하며 잰 결과다.
| 번호 | 토큰 수 | LightRAG (초) | GraphRAG (초) |
|---|---|---|---|
| 1 | 59,870 | 486 | 642 |
| 2 | 41,224 | 418 | 700 |
| 3 | 73,989 | 561 | 953 |
| 4 | 47,502 | 513 | 741 |
| 5 | 48,353 | 453 | 926 |
LightRAG의 삽입 시간은 418초에서 561초 범위이고 토큰 수에 거의 비례해 늘어난다. GraphRAG는 642초에서 953초 범위로 더 크고 토큰 수와의 관계도 덜 규칙적이다. 예를 들어 4만 1천 토큰 문서에 700초가 걸리는 반면 4만 8천 토큰 문서에 926초가 걸린다. 저자는 community detection이 무거운 원인이라고 본다.
| 지표 | LightRAG | GraphRAG | 비율 |
|---|---|---|---|
| 평균 질의 시간 | 11.2초 | 23.6초 | 약 0.47배 |
| 최종 저장 공간 | 39.5MB | 286.7MB | 약 0.14배 |
평균 질의 시간이 절반 이하다. 저장 공간 차이가 특히 큰데, GraphRAG가 community report를 별도 텍스트로 보관하는 반면 LightRAG는 entity와 relation의 description만 들고 있기 때문이다.
정성 사례
부록에 두 건의 비교 사례가 있다.
| 비교 대상 | 질의 | 판정 |
|---|---|---|
| NaiveRAG (Table 8) | 캐나다와 호주에서 원주민의 소유권과 협업 관점이 기업 합병에 미치는 영향 | 네 항목 모두 LightRAG |
| GraphRAG (Table 9) | 표에 적힌 질의는 머신러닝의 feature 정규화 방법 | 네 항목 모두 LightRAG |
Table 8에서 LightRAG는 토지 소유의 문화적 의미, 협업의 역할, 법률과 규제 프레임워크로 절을 나눠 답한다. judge는 NaiveRAG의 답이 정보는 주지만 차원별 깊이가 부족하다고 판정한다.
Table 9는 질의와 답변이 어긋나 있다. Query 칸은 "Which methods can normalize the feature values for effective machine learning?"인데 GraphRAG와 LightRAG의 답변은 모두 영화 추천 시스템 평가 지표를 다룬다. 부록 본문도 이 사례를 "machine learning question"이라고만 부르고 넘어간다. 표 작성 과정의 오류로 보이며, 이 사례로는 두 방법의 우열을 판단할 수 없다.
측정 항목별 종합
논문이 잰 항목을 한자리에 모으면 LightRAG의 강점이 어디에 몰려 있는지 드러난다.
| 측정 항목 | GraphRAG 대비 결과 | 근거 |
|---|---|---|
| Comprehensiveness | 4개 중 3개 데이터셋에서 우세 | Table 1 |
| Diversity | 4개 데이터셋 모두 우세. 최대 77.2% | Table 1 |
| Empowerment | 4개 중 3개 데이터셋에서 우세 | Table 1 |
| Overall | 4개 중 3개 데이터셋에서 우세 | Table 1 |
| 검색 토큰 | 61만에서 100 미만으로 감소 | Table 3 |
| 검색 API 호출 | 수백 회에서 1회로 감소 | Table 3 |
| 증분 갱신 토큰 | 약 1,399만에서 추출 오버헤드만으로 감소 | Table 3 |
| 문서 삽입 시간 | 문서 5개 모두에서 짧다 | Table 5 |
| 평균 질의 시간 | 23.6초에서 11.2초로 감소 | Table 6 |
| 최종 저장 공간 | 286.7MB에서 39.5MB로 감소 | Table 7 |
품질 항목은 근소한 우세이고 비용 항목은 자릿수 단위의 차이다. LightRAG의 기여를 "GraphRAG보다 잘 답한다"로 읽기보다 "비슷하거나 조금 나은 품질을 훨씬 싸게 낸다"로 읽는 편이 표에 부합한다. Diversity 한 항목만 예외적으로 큰 폭의 우세를 보이는데, 이는 relation 인덱스를 별도로 두고 상위 테마 키워드로 조회하는 high-level retrieval에서 온 것으로 저자는 해석한다.
한계
논문의 Limitations 절은 한계를 적는 자리인데 실제로는 확장 방향 두 가지를 서술한다. 텍스트와 이미지와 오디오를 함께 다루는 멀티모달 확장, 그리고 변화하는 사건을 반영하는 time-awareness 도입이다. 둘 다 앞으로 하면 좋을 일이지 현재 방법의 약점이 아니다.
raw에서 직접 확인되는 한계는 다음과 같다.
| 항목 | 내용 |
|---|---|
| Mix 데이터셋 열세 | GraphRAG 대비 Comprehensiveness 49.6%, Empowerment 49.2%, Overall 49.6%로 근소하게 뒤진다 |
| -Origin 해석과 표의 불일치 | 본문은 Agriculture와 Mix에서 개선이라고 적지만 Table 2의 Mix Overall은 60.0%에서 55.6%로 하락한다 |
| community report 토큰 수의 이중 표기 | 검색 분석에서는 평균 1,000 토큰, 증분 갱신 분석에서는 약 5,000 토큰으로 같은 대상을 다르게 적는다 |
| Table 9의 질의와 답변 불일치 | 질의는 feature 정규화를 묻는데 답변은 추천 시스템 평가 지표다 |
| 평가 프롬프트의 항목 수 불일치 | Figure 6의 지시문이 "four criteria"라고 적고 세 가지만 나열한다 |
| 임베딩 모델 미명시 | 본문은 nano vector database와 GPT-4o-mini만 밝히고 임베딩 모델을 적지 않는다 |
| judge와 generator가 같은 모델 | 둘 다 GPT-4o-mini다. 순서 편향만 통제하고 모델 자기선호는 다루지 않는다 |
| GraphRAG 설정의 특정성 | 비용 비교가 community 1,399개 중 level-2 610개를 쓴 특정 설정에 기댄다. 다른 level 선택에서 같은 비율이 나오는지는 다루지 않는다 |
| baseline 승률 서술의 과장 | Legal에서 "baseline이 20% 수준"이라고 적지만 HyDE는 Overall 26.4%다 |
wiki 내 다른 자료가 제기한 한계는 근거가 본 논문이 아니므로 출처를 함께 적는다.
| 항목 | 내용 | 근거 |
|---|---|---|
| 논문과 코드의 간극 | low-level 키워드 매칭 대상이 논문에서는 entity name인데 공식 코드는 name과 description 양쪽을 쓴다 | Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026) |
| 임베딩 모델 실태 | 공식 코드에 BGE-M3와 OpenAI text-embedding-3-large가 섞여 있다 | 같은 세미나 자료 |
| 계층 구조 부재 | 계층을 도입한 HiRAG와 LeanRAG가 정밀도에서 앞선다 | LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26) |
| 원문 제거 효과의 상반된 재현 | LeanRAG 실험에서는 원문을 빼면 모든 데이터셋에서 성능이 내려간다 | 같은 LeanRAG 페이지 |
핵심 용어
| 용어 | 뜻 |
|---|---|
| Key-Value Indexing | entity와 relation을 (key, value) 쌍 문자열로 직렬화하는 인덱싱. key는 검색용 단어나 짧은 구, value는 생성에 쓸 요약 문단이다. Entity는 이름 하나가 key이고 relation은 상위 테마에서 온 key를 여러 개 가질 수 있다 |
| Dual-level Retrieval | 질의를 분류하지 않고 low-level 키워드와 high-level 키워드를 동시에 뽑아 각각 entity 인덱스와 relation 인덱스에 매칭하는 검색 방식 |
| LLM Profiling | LLM이 entity와 relation의 description과 상위 키워드를 합성해 key-value 쌍을 만드는 단계. 논문 표기로 이다 |
| Incremental Update | 새 데이터로 만든 부분 그래프를 기존 그래프에 합집합으로 합치는 갱신 방식. GraphRAG의 community 재구축 비용을 없앤다 |
| gleaning parameter | entity와 relation 추출을 몇 번 더 반복해 놓친 것을 다시 줍는지 정하는 값. 이 실험에서는 GraphRAG와 LightRAG 모두 1이다 |
| UltraDomain | 대학 교재 428권에서 뽑은 18개 도메인 코퍼스. graph-based RAG 평가에 널리 쓰인다 |
관련 페이지
- GraphRAG: From Local to Global: 본 논문이 주 비교 대상으로 삼은 GraphRAG 원논문. community detection과 community report라는 비용 구조가 LightRAG의 출발점이다. 이 페이지에서 local search와 global search가 원논문이 아니라 공식 구현체의 것이라는 구분도 확인할 수 있다.
- HKUDS/RAG-Anything: 같은 HKUDS 연구실이 LightRAG 위에 얹은 멀티모달 RAG 구현체. 본 논문의 Limitations 절이 말한 멀티모달 확장을 실제로 수행한 후속 작업에 해당한다.
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): 계층 지식 그래프와 LCA 기반 검색으로 LightRAG의 평면 구조를 보완한 후속 연구. LightRAG를 baseline으로 쓰며 원문 제거 ablation에서 정반대 결과를 보고한다.
- Graph-based RAG 세미나: LightRAG와 LeanRAG (DSBA, 2026): 본 논문과 LeanRAG를 함께 다룬 세미나. 논문과 코드의 간극을 포함해 이 페이지가 인용한 외부 비판의 1차 출처다.
- RAG-Anything: All-in-One RAG Framework: RAG-Anything 논문. LightRAG의 그래프 인덱스에 modality를 더하는 방향의 확장이다.
- Graph-based RAG 계보: GraphRAG 트렁크와 LightRAG, LeanRAG, RAG-Anything: GraphRAG부터 LightRAG와 RAG-Anything과 LeanRAG까지 묶은 계열 overview. 데이터셋과 judge 설정이 다른 실험 결과를 나란히 읽을 때 주의할 점이 정리되어 있다.