Agents · PAPER · 2026
Memory Intelligence Agent (MIA)
요약
Memory Intelligence Agent(MIA)는 deep research agent가 과거 실행 경험을 재사용하도록 설계한 메모리 프레임워크다. East China Normal University와 Shanghai Innovation Institute를 포함한 5개 기관 연구진과 무소속 연구자가 2026-04-19 arXiv에 공개했다. 핵심 주장은 메모리를 정보 보관소가 아니라 계획 수립의 참고 자료로 써야 한다는 것이다.
구조는 역할이 다른 세 에이전트로 나뉜다. Memory Manager가 과거 trajectory를 압축해 보관하고, Planner가 그 참고 자료를 읽어 계획을 세우고, Executor가 계획대로 도구를 호출한다. trajectory는 agent 한 세션의 실행 기록 전체를 뜻한다. MIA는 이 기록을 두 형태로 나눠 보관한다. 텍스트로 남기는 non-parametric memory와 Planner 가중치에 녹여 넣는 parametric memory다.
학습은 GRPO 기반 강화학습을 두 단계로 교대해 진행하고, 추론 시점에도 Planner 파라미터를 계속 갱신한다. 정답이 없는 환경에서는 학회 심사를 모사한 4개 심사 에이전트가 정답 대신 품질 판정을 내린다.
Qwen2.5-VL-7B를 Executor로 쓴 MIA는 멀티모달 7개 데이터셋 평균 53.6%를 기록해 memory baseline 최고값인 Memento의 48.1%를 5.5%p 앞섰다. 텍스트 전용 4개 데이터셋에서는 평균 53.5%로 Memento의 46.0%를 7.5%p 앞섰다. 다만 direct answer 방식의 Gemini-3-Flash가 멀티모달 7개 열 중 4개에서 여전히 최고값이므로, 폐쇄형 대형 모델 전반을 넘어섰다고 읽을 수는 없다.
배경
deep research agent는 LLM의 추론과 검색 엔진 같은 외부 도구를 결합해 여러 번의 검색과 추론을 번갈아 수행하는 agent다. 상호작용이 길어질수록 메모리가 중요해진다. 메모리가 있으면 매 task를 처음부터 다시 풀지 않고 축적한 경험으로 검색 전략을 다듬을 수 있다.
기존 연구는 대부분 긴 context에 검색 경험의 흔적을 그대로 담는 long-context memory였다. 이 방식은 여러 agentic 응용에서 성과를 보였으나 deep research agent에서는 사정이 다르다.
long-context memory의 네 가지 한계
MIA 논문은 이 방식이 deep research에서 네 가지 한계를 드러낸다고 진단한다.
| 한계 | 내용 |
|---|---|
| attention dilution | context가 길어지면 attention이 흩어져 현재 문제 자체의 이해가 떨어진다 |
| noise | 메모리에 섞인 무관하거나 약하게 관련된 내용이 추론 능력을 떨어뜨린다 |
| 저장 부담 | 계속 자라는 context 이력을 유지하는 비용이 크다. 장기간 연속 운영하는 agent에서 특히 문제가 된다 |
| 검색 비용 | 방대한 메모리를 훑는 연산량이 늘어 시간 효율이 나빠진다 |
네 항목의 원인은 하나로 모인다. 메모리를 텍스트 그대로 쌓아 두는 설계에서는 메모리가 커질수록 얻는 것보다 잃는 것이 많아진다.
결과 중심 메모리와 과정 중심 메모리
논문은 메모리를 담는 내용의 성격으로도 구분한다. long-context memory가 주로 담는 것은 결과가 무엇인지를 서술하는 지식이다. deep research가 실제로 필요한 것은 결과가 어떻게 얻어졌는지를 서술하는 과정 지식이다.
| 구분 | 담는 내용 | 예시 |
|---|---|---|
| 결과 중심 메모리 | 사실과 속성 자체 | 사용자 속성, 역사적 사실, 검색해 온 문서 |
| 과정 중심 메모리 | 결과에 이르는 절차 | 검색 경로, 실패한 시도, 성공한 추론 전략 |
메모리를 두는 목적이 지식 보관이 아니라 앞으로의 planning과 전략 재사용을 돕는 것이라면, 저장 대상은 문서가 아니라 절차여야 한다. MIA가 trajectory를 workflow 요약으로 압축하는 이유가 여기에 있다.
기존 planner 기반 메모리의 세 가지 문제
long-context memory의 한계를 피하려고 pre-trained 모델을 planner로 세워 chain-of-thought 프롬프트로 검색 경로를 짜게 하는 접근도 이미 있었다. chain-of-thought는 답 전에 중간 추론을 텍스트로 펼치게 하는 기법이다. Memento가 대표 사례다. 논문은 이 계열에서 세 가지 문제를 짚는다.
| 문제 | 내용 |
|---|---|
| 학습되지 않은 Planner | task 특화 학습 없이 planning을 수행해 계획 품질이 최적에 못 미친다 |
| 관련성만 보는 예시 선택 | few-shot 예시를 유사도만으로 뽑아 품질과 사용 빈도 같은 다른 기준을 무시한다 |
| 준비되지 않은 Executor | Executor도 task 특화 학습이 없어 planning 지시를 제대로 해석하고 따르지 못한다 |
논문은 선행 연구의 실질을 한 문장으로 요약한다. 무능한 Planner가 비대한 메모리에서 자료를 꺼내 불완전한 in-context 프롬프트로 준비되지 않은 Executor를 지휘하는 구성이다. 세 지점이 모두 약하기 때문에 메모리를 도입해도 개선폭이 작다.
MIA는 세 지점을 각각 겨냥한다. Planner와 Executor를 강화학습으로 학습시키고, 메모리 검색에 품질과 빈도 기준을 추가하고, 메모리 자체를 압축 workflow로 바꾼다.
핵심 개념
두 종류의 메모리
MIA의 설계를 이해하는 출발점은 메모리를 두 형태로 나눈 결정이다. 논문은 이를 hippocampus를 모사한 brain-inspired 설계로 소개한다. episodic memory는 개별 경험 단위로 저장되는 메모리 층을 말한다.
| 구분 | non-parametric memory | parametric memory |
|---|---|---|
| 저장 위치 | Memory Manager의 memory buffer | Planner의 가중치 |
| 형태 | 텍스트 workflow 요약과 이미지 캡션 | 잠재 지식 표현 |
| 쓰이는 방식 | in-context 대조 학습 재료로 Planner 프롬프트에 들어간다 | Planner가 계획을 생성할 때 그대로 발현된다 |
| 장점 | 개별 항목을 지목해 꺼내고 교체할 수 있다 | 저장 용량이 늘지 않고 검색 비용이 없다 |
| 약점 | 계속 쌓이면 저장과 검색 비용이 늘어난다 | 개별 경험을 지목해 확인하거나 삭제할 수 없다 |
두 형태는 한쪽을 고르는 관계가 아니라 순환하는 관계다. trajectory가 먼저 non-parametric memory로 들어가고, 그 batch로 Planner를 재학습하면 같은 내용이 parametric memory가 되고, 그 뒤 memory buffer의 해당 단위를 선택적으로 비운다. 논문은 이 순환을 양방향 변환 루프라고 부른다. 메모리가 무한히 자라는 문제를 압축 단계와 내재화 단계에서 두 번 막는 구조다.
도구 환경
MIA의 Executor가 쓰는 도구는 두 개뿐이다. tool use는 모델이 외부 도구를 호출해 행동 범위를 넓히는 능력이고, tool call은 그 능력의 개별 실행 한 번을 가리킨다.
| 도구 | 반환 | 제약 |
|---|---|---|
search |
학습 시 로컬 wiki25 코퍼스에서 top-3 passage, 평가 시 Serper 온라인 검색에서 top-5 결과 | 질의는 이미지를 지칭하지 않는 완결된 문장이어야 한다 |
web_image_to_image_search |
유사 이미지 top-3 | 한 task에서 1회만 호출할 수 있다. Planner 프롬프트가 위반 시 강한 감점을 명시한다 |
도구가 단순하다는 점은 논문의 논거로 쓰인다. 코드 실행기나 브라우저 조작 없이 검색 도구 둘만으로 더 복잡한 agentic 시스템을 앞섰으므로, 성능이 도구가 아니라 메모리 활용에서 나왔다는 주장이다.
GRPO와 test-time learning
GRPO는 group 안의 reward를 평균과 표준편차로 정규화해 advantage를 계산하는 강화학습 알고리즘이다. 별도 value 모델이 필요 없어 agent 학습에 널리 쓰인다. MIA는 Planner와 Executor 학습, 그리고 추론 시점 갱신 모두에 GRPO를 쓴다.
test-time learning은 추론 batch를 처리하면서 동시에 파라미터를 갱신하는 방식을 말한다. 통상적인 offline 강화학습은 데이터를 미리 모아 두고 같은 데이터로 여러 epoch를 학습한다. MIA의 TTL은 두 전제를 모두 버린다. 미리 모아둔 memory context가 없고 epoch도 1회다. 그 대신 batch가 도착할 때마다 탐색, 메모리 저장, 파라미터 갱신을 한 번에 처리한다.
방법
세 에이전트의 역할 분담
| 에이전트 | backbone | 학습 여부 | 역할 |
|---|---|---|---|
| Memory Manager | Qwen3-32B + memory buffer | 학습하지 않는다 | 이미지 캡션 생성, trajectory를 workflow로 압축, 메모리 검색과 갱신 |
| Planner | Qwen3-8B | Stage 2와 TTL에서 학습 | 검색된 trajectory를 읽어 step-by-step 계획 생성, reflection 여부 판정 |
| Executor | Qwen2.5-VL-7B | Stage 1에서만 학습 | 계획에 따라 ReAct loop로 도구를 호출하고 최종 답을 만든다 |
Memory Manager의 LLM은 얼려 둔 상태로 프롬프트만 갈아 쓴다. Router도 별도 모델이 아니라 Memory Manager와 같은 LLM을 다른 프롬프트로 호출한 것이다. 학습 비용이 드는 부분은 Planner와 Executor 둘로 한정된다.
ReAct loop는 추론과 행동을 번갈아 수행하는 패러다임이다. Executor는 <think>로 생각을 적고 <tool_call>로 도구를 부르고 도구 응답을 다시 받는 순환을 반복한다.
agent loop 세 단계
질문 하나가 들어오면 메모리 검색, 협업 추론, 경험 통합 세 단계를 차례로 지난다.
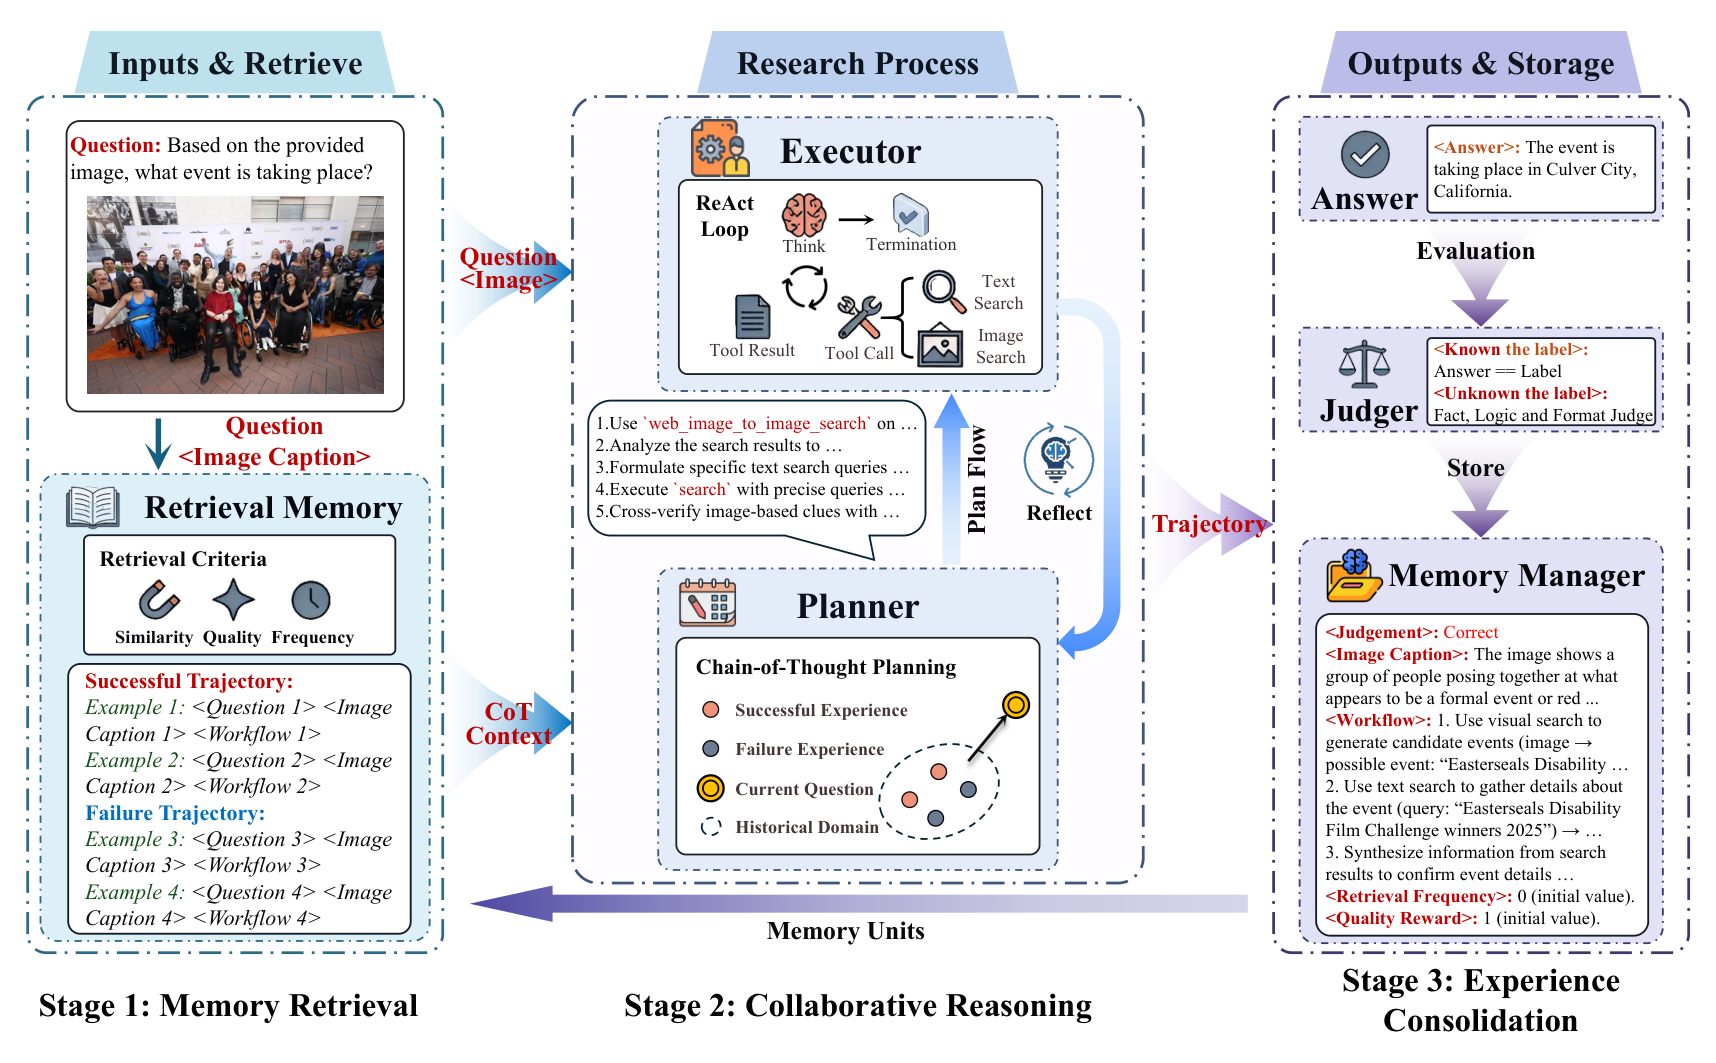
| 단계 | 주체 | 입력 | 출력 |
|---|---|---|---|
| 1. 메모리 검색 | Memory Manager | 질문과 이미지 | 유사도, 품질, 빈도로 뽑은 성공과 실패 trajectory |
| 2. 협업 추론 | Planner, Executor | 질문과 검색된 trajectory | 계획, tool call 기록, 후보 답 |
| 3. 경험 통합 | LLM Judger, Memory Manager | 최종 trajectory | 정답 판정, 압축 workflow, 갱신된 메모리 단위 |
Memory Manager가 비어 있는 초기에는 1단계를 건너뛴다. trajectory가 충분히 쌓인 뒤부터 검색이 작동한다.
메모리 검색 점수 계산
멀티모달 질의를 텍스트 기준으로 다루기 위해 Memory Manager가 먼저 이미지를 50단어 이내 캡션으로 바꾼다. 임베딩은 sup-simcse-bert-base-uncased의 마지막 hidden state를 mean pooling하고 L2 정규화해 얻는다. 임베딩은 텍스트나 이미지를 고정 차원 벡터로 바꾼 표현이다.
점수는 세 항목의 가중합이다.
| 항목 | 수식 | 의도 |
|---|---|---|
| Semantic Similarity | Sim_i = 0.8 * sim(question) + 0.2 * sim(caption) |
질문 유사도를 캡션 유사도보다 4배 무겁게 본다. 캡션이 없으면 질문 유사도만 쓴다 |
| Value Reward | Val_i = s_i / (u_i + 1) |
성공 횟수를 사용 횟수로 나눈 경험적 성공률. 실적이 좋은 메모리를 우대한다 |
| Frequency Reward | Freq_i = 1 / (u_i + 1) |
사용이 적은 메모리에 가점을 준다. long-tail 지식 탐색을 유도한다 |
| 최종 점수 | Score = 0.7 * Sim_norm + 0.3 * Val + 0.3 * Freq |
Sim은 현재 메모리 버킷 안에서 min-max 정규화한 값을 쓴다 |
가중치 세 개의 합이 1.3이라는 점에 유의한다. 논문은 정규화하지 않은 채 0.7, 0.3, 0.3을 그대로 쓴다고 명시한다.
검색 대상에는 성공 trajectory와 실패 trajectory가 함께 들어간다. 성공은 따라야 할 본보기(positive paradigm)로, 실패는 피해야 할 제약(negative constraint)으로 Planner 프롬프트에 실린다. 유사한 것만 뽑는 통상적인 retrieval과 달라지는 지점이다.
메모리 단위의 구성
메모리 단위는 modality와 질문 범주로 나뉜 버킷에서 관리된다. 각 단위가 담는 항목은 다음과 같다.
| 항목 | 내용 |
|---|---|
| 질문 | 원래 입력 질문 텍스트 |
| 이미지 캡션 | 50단어 이내로 줄인 시각 정보 요약 |
| judgment label | correct 또는 incorrect |
| workflow | trajectory를 번호 붙은 추상 단계로 압축한 요약 |
| 사용 횟수 u_i | 이 단위가 검색된 누적 횟수. 삽입 시 0 |
| 성공 횟수 s_i | 이 단위를 참고해 성공한 누적 횟수. 삽입 시 0 |
Figure 3의 메모리 단위 예시는 이 항목들을 <Judgement>, <Image Caption>, <Workflow>, <Retrieval Frequency>, <Quality Reward> 태그로 표시한다. 본문이 Value Reward라 부르는 항목이 그림에서는 Quality Reward로 적혀 있다.
Planner와 Executor의 협업
Planner는 검색된 trajectory를 few-shot 예시로 삼아 복합 질문을 실행 가능한 하위 목표로 쪼갠다. Executor는 그 계획을 받아 ReAct loop를 실행한다.
Executor가 최종 답을 낸 뒤 실행 상태를 Planner에 보고하면 Planner가 Reflect-Replan을 판정한다. Planner 프롬프트는 replan을 발동할 조건 네 가지를 명시한다.
- 도구 지원이 없거나 불분명한 경우
- 추론에 공백이나 가정이 있는 경우
- 답이 질문을 온전히 다루지 못한 경우
- 정확성이나 명료성에 의심이 남는 경우
추론 시간을 줄이기 위해 replan은 한 task에서 1회만 발동한다. 반복 reflection으로 시간이 늘어나거나 순환에 빠지는 상황을 구조적으로 막은 선택이다.
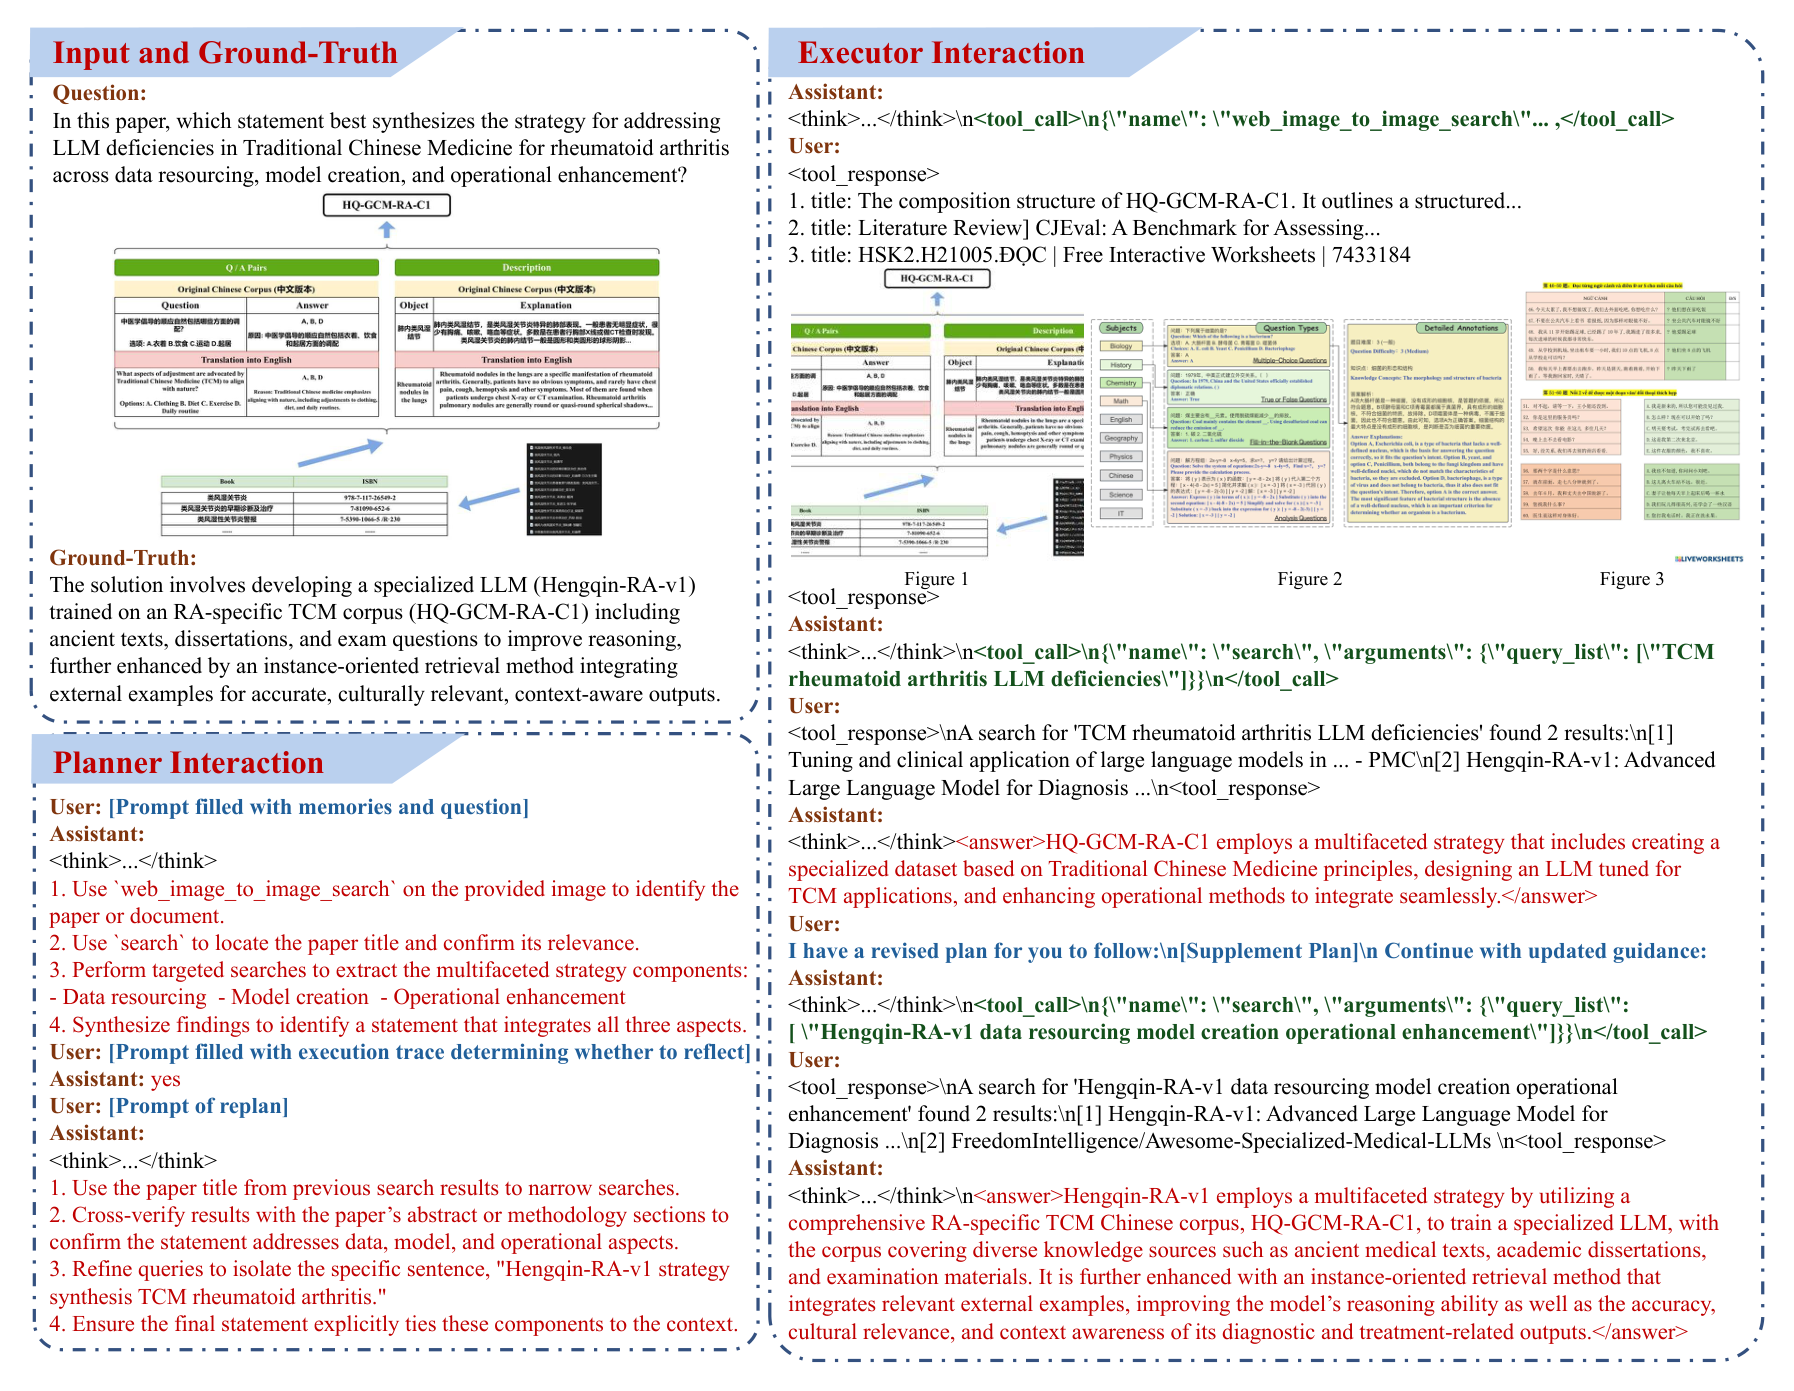
Figure 2의 예시는 전통 한의학 논문 이미지를 보고 그 논문의 전략을 종합한 문장을 찾는 질문이다. Planner는 먼저 이미지 검색으로 문서를 특정하고 텍스트 검색으로 제목을 확인한 뒤 데이터, 모델, 운영 세 측면을 각각 검색하라는 4단계 계획을 낸다. Executor는 계획대로 web_image_to_image_search를 부르고 search로 후속 질의를 던져 첫 답을 만든다. Planner는 그 첫 답이 세 측면을 충분히 담지 못했다고 보고 yes를 출력해 replan을 발동한다. 두 번째 계획은 확보한 논문 제목으로 질의를 좁히고 초록과 방법 절로 교차 확인하라고 지시하며, Executor가 그 계획으로 세 측면을 모두 담은 답을 완성한다.
경험 통합과 양방향 변환 루프
LLM Judger가 최종 결과를 평가하면 Memory Manager가 메모리 갱신에 들어간다. 압축은 두 방향으로 이루어진다. 이미지는 캡션으로 줄이고, 장황한 trajectory는 구조화 workflow 요약으로 줄인다.
workflow 요약은 "action purpose (input → output)" 형식의 번호 붙은 단계로 쓰인다. 논문이 프롬프트에 넣은 예시는 다음과 같다.
1. Use visual search to generate candidate locations
   (image -> possible locations: "Palace of the Lost City").
2. Use text search to narrow hypothesis
   (possible locations -> likely country: South Africa).
3. Use text search to verify with specific query
   ("Sun City South Africa Palace of Lost City") -> confirmed factual answer.
이 형식이 중요한 이유는 재사용 단위가 사실이 아니라 절차라는 점이다. 남는 것은 어느 나라가 답이었는지가 아니라 이미지 검색으로 후보를 만들고 텍스트 검색으로 좁힌 뒤 특정 질의로 확인했다는 순서다. 다른 질문에도 그대로 적용할 수 있는 형태다.
압축한 메모리는 다음 규칙으로 buffer에 들어간다.
| 조건 | 처리 |
|---|---|
| 기존 단위와 semantic similarity가 높다 | 그 단위를 새 메모리로 교체한다 |
| 유사한 단위가 없다 | 새 단위로 저장한다 |
| 두 경우 모두 | 관련 단위의 value reward와 frequency count를 갱신한다 |
마지막으로 현재 batch의 질문, trajectory, 결과로 Planner를 재학습해 episodic memory를 parametric memory로 내재화한다. 학습이 끝나면 메모리 단위를 선택적으로 비운다. 논문은 이 삭제가 메모리 폭발을 막으면서 핵심 정보는 남긴다고 서술한다. 다만 어떤 기준으로 어떤 단위를 비우는지는 명시하지 않는다.
2단계 교대 강화학습
Planner와 Executor를 동시에 학습시키면 reward를 누구의 공로로 돌릴지 모호해진다. MIA는 한쪽을 얼려 서비스로 띄운 채 다른 쪽만 학습시키는 방식을 두 번 반복한다.
| 구분 | Stage 1 | Stage 2 |
|---|---|---|
| 학습 대상 | Executor | Planner |
| 얼려 둔 쪽 | Planner | Stage 1에서 학습된 Executor |
| 학습 목표 | 계획 이해와 수행, tool calling, replan 지시 파싱 | 메모리 흡수, 계획 생성, feedback 기반 reflection |
| 목적함수 | Eq.(1). memory context가 조건에 없다 | Eq.(3). 검색된 memory context m이 조건에 들어간다 |
| 준비 작업 | 없음 | Stage 1 종료 후 학습된 Executor로 memory context가 담긴 학습 데이터를 수집한다 |
순서에 이유가 있다. Executor가 먼저 계획을 읽고 따르는 능력을 갖춰야, Planner의 계획 품질이 최종 정답률에 제대로 반영된다. Executor가 계획을 무시하는 상태에서 Planner를 학습시키면 reward 신호가 계획 품질과 무관해진다.
두 목적함수는 모두 token loss masking I(y_i,t)를 쓴다. policy가 생성한 token은 1, 도구나 상대 에이전트가 생성한 token은 0이 되어 손실 계산에서 빠진다. 도구 응답이나 상대 에이전트의 계획 텍스트를 자기 출력처럼 학습하는 오염을 막는 장치다. KL 정규화 항 βD_KL[π_θ||π_ref]가 수식에 있지만 실험에서는 KL 계수를 0.0으로 두어 사실상 끈다.
reward 설계
| 학습 대상 | reward 구성 | 항목별 정의 |
|---|---|---|
| Executor | 0.7 * r_correct + 0.2 * r_tool + 0.1 * r_format |
r_correct는 LLM Judger가 최종 답을 정답으로 보면 1, r_tool은 표준 형식의 tool call이 성공하면 1, r_format은 출력 형식이 규격을 지키면 1 |
| Planner | 0.7 * r_correct(final) + 0.2 * r_correct(intermediate) + 0.05 * r_reflect + 0.05 * r_format |
r_correct(intermediate)는 reflection 이전의 중간 답에 대한 정답 여부. reflection이 없으면 두 답이 같다 |
Planner reward의 r_reflect가 이 설계에서 가장 눈여겨볼 항목이다. 값은 다음 표와 같이 결정된다.
| 첫 응답 | reflection 발동 | r_reflect |
|---|---|---|
| 정답 | 발동하지 않음 | 1 |
| 정답 | 발동함 | 0 |
| 오답 | 발동함 | 1 |
| 오답 | 발동하지 않음 | 0 |
즉 필요할 때만 reflect하도록 유도한다. 이미 맞은 답에 대해 습관적으로 replan을 부르면 감점을 받는다. reflection을 무조건 켜면 정답률이 오르는 대신 추론 시간이 배로 늘기 때문에, 발동 판정 자체를 학습 대상으로 만든 것이다.
rollout 절차 두 가지
Stage 1과 Stage 2의 rollout은 replan 발동을 누가 정하는지가 다르다.
Executor 학습 rollout(Table 1, Algorithm 1)은 다음과 같다.
| 단계 | 동작 |
|---|---|
| 1 | 질문을 Planner에 주고 초기 계획을 받는다 |
| 2 | 질문, 이미지, 초기 계획을 policy 모델에 입력한다 |
| 3 | 현재 상태로 <think>와 action(<tool_call> 또는 <answer>)을 생성한다 |
| 4 | 도구를 실행하고 관측을 이어 붙인 뒤 3단계로 돌아온다 |
| 5 | LLM Judger가 후보 답을 평가한다. 정답이면 7단계로 간다 |
| 6 | 상호작용 이력을 Planner에 주고 수정 계획을 받아 3단계로 간다. 최대 1회만 발동한다 |
| 7 | 최종 응답을 출력한다 |
Planner 학습 rollout(Table 2, Algorithm 2)은 다음과 같다.
| 단계 | 동작 |
|---|---|
| 1 | memory context, 질문, 프롬프트 템플릿을 policy 모델에 입력한다 |
| 2 | chain-of-thought로 초기 계획을 rollout한다 |
| 3 | Executor가 질문, 이미지, 도구, 초기 계획으로 환경과 상호작용해 후보 trajectory와 결과를 만든다 |
| 4 | Planner가 후보 trajectory를 분석해 종료할지 정한다. 종료면 7단계로 간다 |
| 5 | chain-of-thought reflection과 수정 계획을 rollout한다 |
| 6 | Executor가 기존 trajectory와 수정 계획으로 상호작용을 이어 최종 trajectory와 결과를 만든다 |
| 7 | 최종 응답을 출력한다 |
차이는 4단계다. Executor 학습에서는 LLM Judger가 정답 여부로 replan을 촉발하지만, Planner 학습에서는 Planner가 스스로 trajectory를 보고 판정한다. 판정 능력 자체가 Planner의 학습 대상이므로 정답 정보를 판정에 쓰지 않는다.
test-time learning의 한 batch
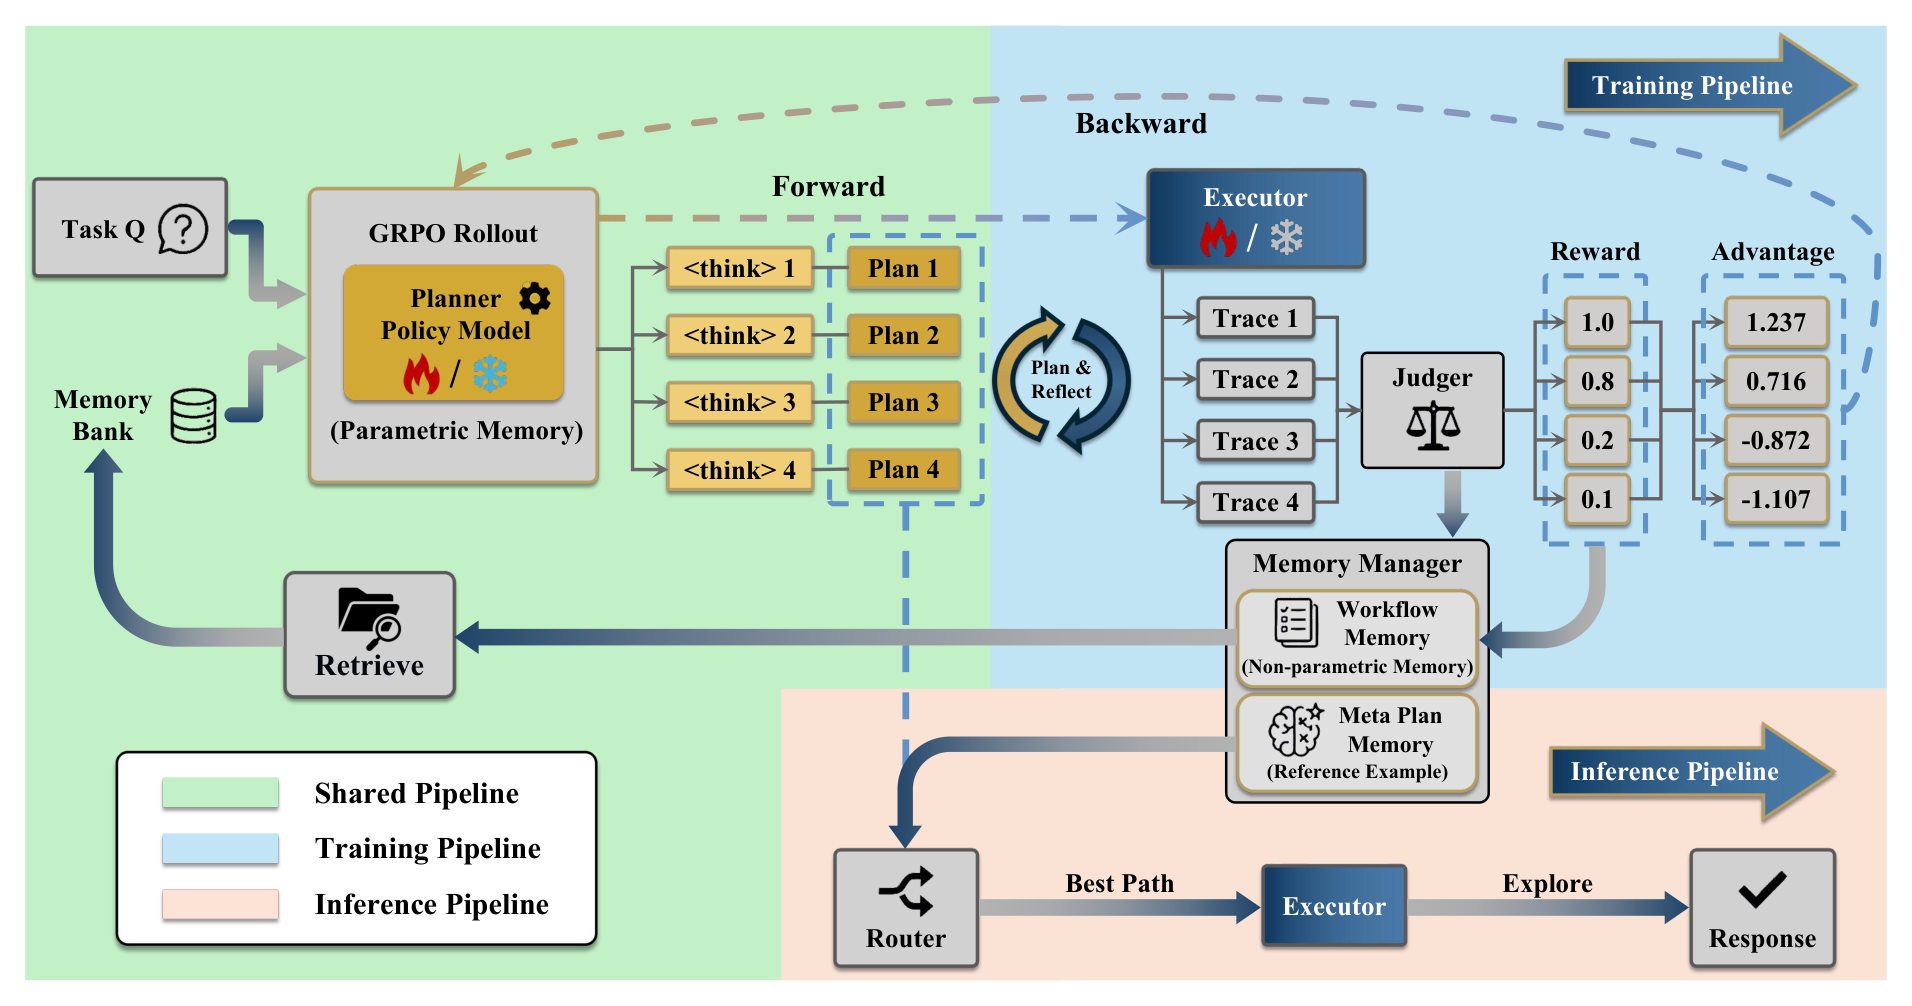
TTL은 batch 하나마다 다음 순환을 수행한다.
| 순서 | 동작 |
|---|---|
| 1 | Planner가 memory context와 질문으로 G개 후보 계획을 rollout한다 |
| 2 | Router가 Meta Plan Memory의 예시를 참조해 최적 계획 하나를 골라 환경과 상호작용시킨다. 이 결과가 사용자에게 나가는 최종 응답이다 |
| 3 | 남은 계획들도 각각 Executor로 실행해 trajectory를 모은다 |
| 4 | LLM Judger가 각 결과를 평가해 성공 집합과 실패 집합으로 나눈다 |
| 5 | 각 계획과 trajectory 쌍의 reward를 Eq.(4)로 계산하고 group 내 advantage를 구한다 |
| 6 | 성공 집합에서 최단 trajectory, 실패 집합에서 무작위 하나를 골라 workflow로 압축해 저장한다 |
| 7 | 성공과 실패가 모두 있으면 그 계획 쌍을 Meta Plan Memory에 대조 쌍으로 저장한다 |
| 8 | Eq.(3)으로 Planner 파라미터를 갱신한다 |
두 종류의 추출 규칙에 의도가 담겨 있다. 성공 쪽에서 최단 경로를 고르는 것은 추론 효율을 장려하려는 선택이다. 실패 쪽에서 무작위로 뽑는 것은 다양한 오류 패턴을 담아 같은 실수를 반복하지 않게 하려는 선택이다.
advantage는 Â_i = (R_i - μ_R) / (σ_R + ε)로 계산한다. μ_R과 σ_R은 그 group의 reward 평균과 표준편차이고 ε는 0으로 나누는 것을 막는 작은 상수다. Figure 5가 든 예시는 다음과 같다.
| rollout | reward | advantage |
|---|---|---|
| Plan 1 | 1.0 | 1.237 |
| Plan 2 | 0.8 | 0.716 |
| Plan 3 | 0.2 | -0.872 |
| Plan 4 | 0.1 | -1.107 |
reward 평균이 0.525이므로 0.525를 넘는 두 계획은 양의 advantage를, 밑도는 두 계획은 음의 advantage를 받는다. 성공한 추론 전략을 강화하고 결함 있는 논리를 억제하는 방향으로 가중치가 움직인다.
핵심은 6단계와 8단계가 동시에 진행된다는 점이다. non-parametric memory 추출과 파라미터 갱신을 순차로 나누지 않으므로, 탐색을 멈추고 학습을 기다리는 구간이 없다. 논문은 이를 탐색 과정을 끊지 않는 online learning paradigm이라고 부른다. 추론 능력이 좋아지면 더 좋은 참고 예시가 생기고, 좋은 예시가 다시 추론 능력을 올리는 양의 순환이 생긴다는 설명이다.
Meta Plan Memory와 Router
Meta Plan Memory는 Workflow Memory와 별개로 둔 저장소다. 담는 것은 workflow 요약이 아니라 계획 자체의 대조 쌍이다. 같은 질문에 대해 성공한 계획과 실패한 계획을 나란히 두면, Router가 다음 batch에서 어떤 계획이 좋은 계획인지 in-context로 참조할 수 있다.
Router의 역할이 label leakage 관점에서 미묘하다. G개 rollout 중 최종 응답으로 낼 하나를 고르는데, 이 선택에 정답 정보를 쓰면 평가가 부풀려진다. 논문은 Router가 Meta Plan Memory의 과거 예시만 참조하며 정답을 보지 않는다고 명시한다.
비지도 자기 진화 구조
TTL의 자기 진화 흐름은 탐색, 환경 feedback 획득, non-parametric memory 추출, parametric memory 갱신 순이다. 이 흐름은 ground truth가 있을 때 온전히 작동한다. 정답이 workflow에 positive와 negative label을 붙이고 Planner 학습의 reward 신호를 준다. 개방 환경의 사용자는 매번 정답을 제공하지 않으므로 두 신호가 모두 사라진다.
통상의 LLM-as-a-Judge는 단일 프롬프트로 복잡한 trajectory를 판정한다. 논문은 이 방식이 "hallucinated objectivity"에 빠진다고 지적한다. 심사자가 미묘한 논리 오류를 놓치거나 사실 정확성 대신 문체의 유창함을 보는 현상이다. 환각은 모델이 근거 없는 내용을 사실처럼 만들어내는 문제를 말한다.
대안은 학회 심사를 모사한 4-agent 구조다. 네 인스턴스 모두 Qwen3-32B이고 프롬프트만 다르다.
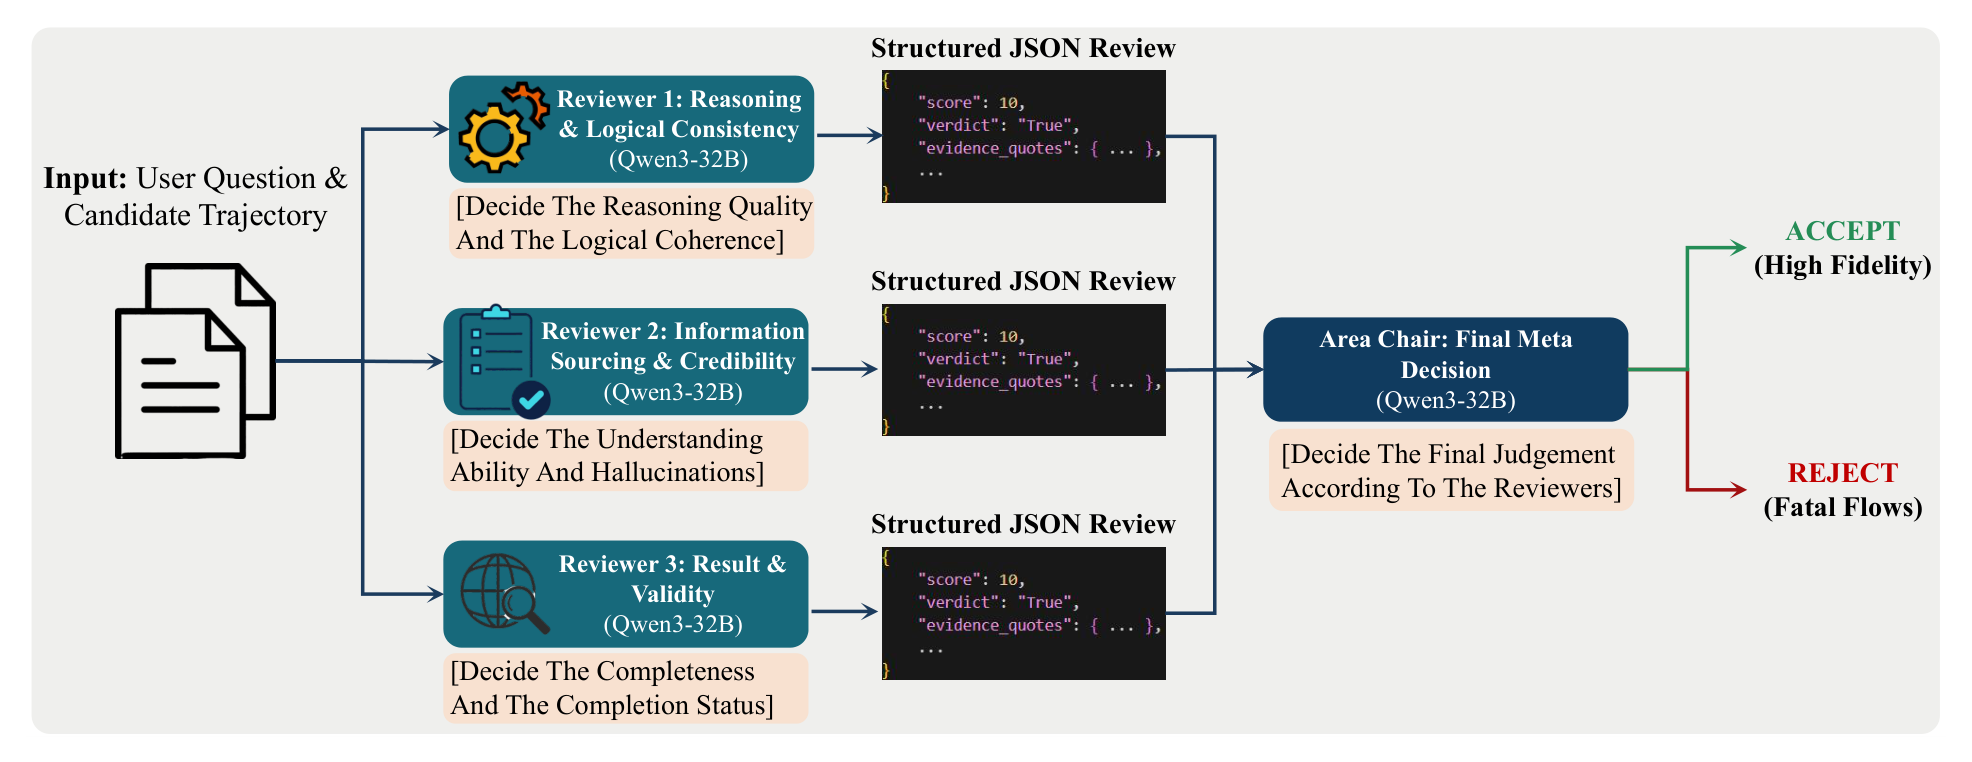
| 심사자 | 판정 대상 | importance weight |
|---|---|---|
| R_L (Reasoning and Logical Consistency) | 전제에서 결론까지의 인과 사슬. 잘못된 추론과 명시되지 않은 가정을 표시한다 | 0.5 |
| R_C (Information Sourcing and Credibility) | 검색해 온 내용의 오해와 사실 환각. 불확실한 claim을 Area Chair 판단용으로 표시한다 | 0.3 |
| R_V (Result Validity) | 최종 응답의 완전성과 실제 완료 상태 | 0.2 |
| Area Chair | 세 심사의 구조화 JSON을 meta-analysis한다. 출력은 단일 글자 "A"(correct) 또는 "B"(incorrect)다 | 해당 없음 |
importance weight는 Area Chair 프롬프트에 각 심사 의견의 중요도로 적히는 값이다. 세 값을 곱해 더하는 수식이 아니라 프롬프트 텍스트에 명시되는 가중치라는 점에 유의한다.
논문이 드는 이점은 세 가지다.
| 이점 | 내용 |
|---|---|
| Dimensional Orthogonality | 판정 차원을 분리해 error bleeding을 막는다. 형식 오류가 논리 건전성 평가를 부당하게 끌어내리는 현상을 방지한다 |
| Evidence-Based Accountability | 각 심사자가 evidence quote나 atomic requirement를 제출해야 한다. 블랙박스 평점이 감사 가능한 기록으로 바뀐다 |
| Conflict Resolution via Meta-Decision | Area Chair가 점수를 단순 평균하지 않고 fatal flaw를 찾아 치명적 실패 모드를 우선한다. 사실 환각 하나가 사소한 흠결 여러 개보다 무겁게 취급된다 |
Dimensional Orthogonality를 설명하는 문장이 분리 대상 차원을 Logic, Format, Factuality로 적는다. 실제 배치된 심사자 세 명의 담당은 Logic, Credibility, Validity이므로 이름이 어긋난다. 인용할 때 주의가 필요한 지점이다.
Area Chair 프롬프트가 정답으로 인정하는 조건은 세 가지다. 사용자 질문에 직접 답하는 실질적 응답인지, 최종 출력의 정보가 trajectory에서 검색한 내용으로 온전히 뒷받침되는지, trajectory 근거에서 최종 결론으로 가는 연역이 논리적으로 건전하고 모순이 없는지다.
학습과 평가 설정
| 항목 | Executor | Planner | TTL |
|---|---|---|---|
| 초기화 | Qwen2.5-VL-7B-Instruct | Qwen3-8B | supervised는 학습된 Planner, unsupervised는 Qwen3-8B |
| 학습 데이터 | FVQA-train | FVQA-train(이미지 제거) + MATPO | 평가 batch 자체 |
| GPU | 8장 | 4장 | 기재 없음 |
| learning rate | 1e-6 | 1e-6 | 1e-6 |
| batch size | 128 | 128 | 기재 없음 |
| rollout 수 | 질의당 8 | 질의당 8 | 샘플당 4 |
| epoch | 8 | 4 | 1 |
| 최대 prompt 길이 | 16,384토큰 | 24,576토큰 | 기재 없음 |
| 최대 response 길이 | 16,384토큰 | 8,192토큰 | 기재 없음 |
| tool use | 최대 assistant 10턴, user 10턴, 도구 응답 4,096토큰 | tool-free | 평가 도구 설정 사용 |
Planner의 학습 데이터를 FVQA-train과 MATPO의 혼합으로 둔 이유가 있다. 텍스트 전용 환경과 멀티모달 환경의 도구 구성이 달라 계획이 어긋나는 문제를 완화하려는 조치다. FVQA-train에서 이미지를 제거하는 것도 Planner가 tool-free로 학습되기 때문이다.
학습 프레임워크는 veRL이고 rollout은 SGLang 비동기, 추론은 vLLM에 temperature 0이다. 검증 데이터는 두 단계 모두 FVQA-test다.
| 도구 백엔드 | 학습 시 | 평가 시 |
|---|---|---|
| 텍스트 검색 | wiki25 코퍼스를 E5-base-v2 임베딩과 FAISS 인덱스로 인덱싱한 오프라인 retriever, top-3 | 벤치마크에 따라 wiki25 또는 Serper 온라인 검색, Serper는 top-5 |
| 이미지 검색 | ImgBB로 공개 URL을 만든 뒤 Serper image search API를 부르고 결과를 로컬 캐시, top-3 | 모든 멀티모달 데이터셋에서 Serper |
메모리 검색용 임베딩(sup-simcse-bert-base-uncased)과 검색 도구용 임베딩(E5-base-v2)이 서로 다른 모델이라는 점에 유의한다. 앞은 메모리 단위 유사도, 뒤는 문서 검색에 쓰인다.
baseline을 공정하게 비교하기 위해 Executor를 세 가지 프롬프트 변형으로 각각 학습시키고 같은 변형으로 학습한 checkpoint를 평가에 썼다.
| 프롬프트 변형 | 프롬프트 형태 | 적용 방법 |
|---|---|---|
| no extra prompt | 추가 입력 없음 | No Memory |
| long-context memory prompt | Here are some memories for your reference:\n{memory context}\n |
RAG, Mem0, A-Mem |
| guideline prompt | Here is a guide for your reference:\n{plan}\nBegin your answer:\n |
ReasoningBank, ExpeL, Memento, MIA |
부록 C는 두 번째 변형을 long-context memory prompt로 부르고 본문 4.1절은 workflow memory prompt로 부른다. 세 번째도 부록에서는 guideline prompt, 본문에서는 plan prompt다. 같은 대상의 명칭이 두 곳에서 다르다.
결과
평가는 멀티모달 7종과 텍스트 전용 4종, 모두 11개 벤치마크에서 이루어졌다. 정확도 판정은 전부 Qwen3-32B LLM Judger가 맡는다.
평가 데이터셋
| Dataset | Modality | 예시 수 | 출처 | 용도 |
|---|---|---|---|---|
| FVQA-train | image-text | 4,856 | MMSearch-R1 | 학습 |
| FVQA-test | image-text | 1,800 | MMSearch-R1 | 평가 |
| InfoSeek | image-text | 2,000 | MMSearch-R1 | 평가 |
| LiveVQA | image-text | 2,384 | 공개판 | 평가 |
| SimpleVQA | image-text | 1,013 | MMSearch-R1 | 평가 |
| MMSearch | image-text | 171 | MMSearch-R1 | 평가 |
| In-house 1 | image-text | 295 | 자체 구축 | 평가 |
| In-house 2 | image-text | 505 | 자체 구축 | 평가 |
| MATPO | text-only | 6,175 | MATPO | Planner 학습 |
| 2Wiki | text-only | 12,576 | 공개판 | 평가 |
| HotpotQA | text-only | 7,405 | 공개판 | 평가 |
| SimpleQA | text-only | 4,327 | 공개판 | 평가 |
| GAIA-Text | text-only | 103 | MATPO | 평가 |
학습에 쓴 것은 FVQA-train과 MATPO 둘뿐이다. 그래서 Table 3에서 in-domain으로 분류된 열은 FVQA-test 하나이고 나머지 여섯은 out-of-domain이다. 텍스트 전용 4종도 모두 out-of-domain이다. 학습 데이터가 좁다는 점이 일반화 주장의 근거가 된다.
두 In-house 데이터셋은 저자들이 직접 만들었다.
| Dataset | 구축 방식 | 도메인 |
|---|---|---|
| In-house 1 (295개) | 초기 웹사이트에서 텍스트를 수집해 정보성 진술을 뽑고, LLM으로 관련 개념과 키워드를 반복 생성해 추가 문서를 모은 뒤 cross-source 근거로 QA를 합성한다. 그중 시각화 가능한 개체를 가진 항목의 개체명으로 이미지를 검색해 붙인다 | 물리, 화학, 생물 |
| In-house 2 (505개) | CNN 같은 실시간 뉴스에서 image-text 코퍼스를 모으고, Qwen2.5-VL-72B-Instruct로 핵심 시각 개체(주요 사건이나 인물)를 추론 기점으로 지정한 뒤 세 단계 의존 사슬로 복합 질문을 만든다 | 스포츠, 엔터테인먼트, 사회 사건 |
두 데이터셋이 다른 벤치마크보다 어렵다. Table 3에서 In-house 1의 최고값이 52.5%, In-house 2의 최고값이 37.7%로, 다른 열의 60%대와 크게 다르다.
멀티모달 벤치마크
| Model | FVQA-test | InfoSeek | SimpleVQA | LiveVQA | MMSearch | In-house 1 | In-house 2 | 평균 |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 (direct) | 50.8 | 43.6 | 55.5 | 21.5 | 44.4 | 45.1 | 23.0 | 40.6 |
| Gemini-3-Flash (direct) | 69.3 | 69.0 | 73.7 | 26.0 | 69.0 | 52.5 | 25.5 | 55.0 |
| GPT-4o (direct) | 41.7 | 42.7 | 46.6 | 26.9 | 22.2 | 25.6 | 17.2 | 31.8 |
| Gemini-2.5-Pro (direct) | 37.2 | 37.0 | 53.4 | 27.7 | 26.9 | 30.8 | 19.6 | 33.2 |
| Qwen2.5-VL-7B+ReACT | 34.2 | 28.3 | 35.8 | 10.7 | 21.1 | 9.5 | 17.8 | 22.5 |
| Qwen2.5-VL-32B+ReACT | 51.3 | 38.0 | 48.5 | 24.8 | 27.3 | 28.8 | 26.5 | 35.0 |
| MMSearch-R1 | 58.0 | 49.0 | 55.3 | 28.3 | 43.9 | 13.6 | 21.8 | 38.6 |
| Deepeyes2 | 60.6 | 51.1 | 59.4 | 없음 | 63.7 | 없음 | 없음 | 산출 불가 |
| No Memory | 61.4 | 56.8 | 63.0 | 33.0 | 55.6 | 15.9 | 26.9 | 44.7 |
| RAG | 60.5 | 55.9 | 60.5 | 31.7 | 54.4 | 12.5 | 25.5 | 43.0 |
| Mem0 | 55.6 | 48.2 | 56.7 | 24.5 | 43.3 | 12.5 | 23.2 | 37.7 |
| A-Mem | 38.5 | 36.0 | 51.6 | 22.6 | 40.9 | 12.5 | 24.2 | 32.3 |
| ReasoningBank | 64.7 | 59.5 | 60.4 | 34.2 | 57.3 | 18.6 | 29.3 | 46.3 |
| ExpeL | 64.2 | 58.6 | 62.5 | 34.1 | 61.4 | 19.7 | 28.3 | 47.0 |
| Memento | 66.3 | 57.3 | 61.9 | 36.7 | 61.4 | 22.7 | 30.7 | 48.1 |
| Unsupervised MIA | 65.1 | 64.3 | 63.3 | 40.1 | 60.2 | 29.8 | 31.1 | 50.6 |
| MIA | 69.6 | 65.5 | 64.9 | 43.1 | 62.6 | 31.8 | 37.7 | 53.6 |
굵게 표시한 값이 각 열의 최고값이다. 평균 열은 논문에 없고 본 페이지에서 7개 값으로 계산한 것이다.
memory baseline 사이의 비교가 이 표의 첫 번째 관찰 지점이다. MIA의 53.6%는 최고 memory baseline인 Memento의 48.1%보다 5.5%p 높다. 데이터셋별 격차는 FVQA-test +3.3%p, LiveVQA +6.4%p, In-house 1 +9.1%p로, 어려운 데이터셋에서 더 벌어진다.
두 번째 관찰 지점은 long-context memory 계열의 성적이다. RAG(43.0%), Mem0(37.7%), A-Mem(32.3%)이 모두 No Memory(44.7%)보다 낮다. 메모리를 붙였는데 붙이지 않은 것보다 못한 결과다. 논문은 이를 긴 memory context가 noise를 들여온다는 가설의 실증으로 읽는다. 반면 메모리를 고차원 지침으로 추상화하는 ReasoningBank(46.3%), ExpeL(47.0%), Memento(48.1%)는 No Memory를 앞선다. 압축 여부가 메모리의 효용을 갈라놓는다.
세 번째 관찰 지점은 폐쇄형 대형 모델과의 비교다. 열 단위로 보면 MIA가 최고값을 차지한 열은 FVQA-test, LiveVQA, In-house 2 셋이다. Gemini-3-Flash가 InfoSeek, SimpleVQA, MMSearch, In-house 1 넷에서 최고값이고 평균도 55.0%로 MIA의 53.6%보다 높다. 논문 본문도 MIA가 Gemini-3-Flash를 넘었다고 쓰지 않고 "performance close to that of Gemini-3-Flash"라고 적는다.
GPT-5.4와의 비교는 결과가 다르다. MIA가 7개 중 6개에서 앞선다. 유일한 예외는 In-house 1로, GPT-5.4가 45.1%, MIA가 31.8%다. 과학 도메인 지식을 요구하는 이 데이터셋에서는 대형 모델의 내부 지식이 검색보다 유리했던 것으로 보인다.
초록의 두 수치는 단위를 확인해 읽어야 한다.
| 초록 표현 | 실제 계산 | 단위 |
|---|---|---|
| "average improvement of 31%" | MIA 53.6% 대 Qwen2.5-VL-7B+ReACT 22.5%, 차이 31.1 | %p |
| "outperforming Qwen2.5-VL-32B by a margin of 18%" | MIA 53.6% 대 Qwen2.5-VL-32B+ReACT 35.0%, 차이 18.6 | %p |
| "boosts GPT-5.4 performance by up to 9% and 6%" | LiveVQA 51.13%에서 60.03%, HotpotQA 69.06%에서 75.49% | %p |
세 값 모두 상대 비율이 아니라 정확도 차이다. 상대 비율로 계산하면 첫 값은 138%가 되므로 %p로 읽는 것이 맞다.
텍스트 전용 벤치마크
| Model | SimpleQA | 2Wiki | HotpotQA | GAIA | 평균 |
|---|---|---|---|---|---|
| No Memory | 40.7 | 61.2 | 51.0 | 11.7 | 41.2 |
| RAG | 38.3 | 56.3 | 47.5 | 14.6 | 39.2 |
| Mem0 | 38.1 | 54.9 | 49.0 | 16.5 | 39.6 |
| A-Mem | 38.8 | 56.2 | 47.5 | 12.6 | 38.8 |
| ReasoningBank | 42.4 | 61.0 | 52.7 | 14.6 | 42.7 |
| ExpeL | 43.0 | 63.4 | 55.5 | 20.4 | 45.6 |
| Memento | 42.4 | 64.2 | 55.2 | 22.3 | 46.0 |
| Unsupervised MIA | 46.6 | 71.6 | 61.7 | 30.1 | 52.5 |
| MIA | 47.7 | 71.8 | 63.5 | 31.1 | 53.5 |
MIA는 4개 열 모두에서 최고값이다. Memento 대비 평균 격차는 7.5%p로 멀티모달의 5.5%p보다 크다. 가장 큰 격차는 2Wiki의 +7.6%p와 GAIA의 +8.8%p다. GAIA는 103개 문항의 소규모 평가 부분집합이므로 격차의 절대 크기를 해석할 때 표본 수를 함께 봐야 한다.
Unsupervised MIA의 성적이 이 표에서 특히 눈에 띈다. 정답 없이 학습한 설정이 4개 열 전부에서 supervised baseline 전체를 앞서고, supervised MIA에만 밀린다. 논문은 이 결과를 비지도 평가 구조가 작동한다는 근거로 제시한다.
long-context memory 계열이 No Memory보다 낮은 양상은 텍스트 전용에서도 되풀이된다. RAG(39.2%), Mem0(39.6%), A-Mem(38.8%)이 모두 No Memory(41.2%)를 밑돈다.
폐쇄형 Executor로의 일반화
Executor를 폐쇄형 API 모델로 바꿔도 MIA가 작동하는지 확인한 실험이다. 파라미터에 접근할 수 없으므로 Planner만 TTL 방식으로 학습하고, non-parametric memory는 계속 갱신해 Executor의 실행 trajectory를 쌓았다.
| Executor | LiveVQA ReAct | LiveVQA MIA | 차이 | HotpotQA ReAct | HotpotQA MIA | 차이 |
|---|---|---|---|---|---|---|
| GPT-5.4 | 51.13 | 60.03 | +8.9%p | 69.06 | 75.49 | +6.4%p |
| Gemini-3-Flash | 52.7 | 55.8 | +3.1%p | 78.6 | 81.2 | +2.6%p |
| Claude-Sonnet-4.6 | 59.8 | 61.6 | +1.8%p | 80.1 | 81.8 | +1.7%p |
세 모델 모두 두 벤치마크에서 개선을 보인다. 개선폭의 순서가 base 정확도의 역순이라는 점이 논문의 관찰이다. LiveVQA에서 base가 가장 낮은 GPT-5.4가 +8.9%p로 가장 크게 오르고, base가 가장 높은 Claude-Sonnet-4.6이 +1.8%p로 가장 적게 오른다. 메모리와 계획 보완이 이미 잘하는 모델에게는 덜 필요하다는 해석이 가능하다.
이 실험은 Planner를 독립 부품으로 쓸 수 있다는 뜻도 담는다. Executor를 학습시키지 못하는 상황에서도 Planner와 메모리만으로 개선을 얻는다.
구성 요소별 ablation
Base에서 시작해 구성 요소를 하나씩 더하는 방식으로 각 부품의 기여를 분리했다. 멀티모달 7종은 다음과 같다.
| 설정 | FVQA-test | InfoSeek | SimpleVQA | LiveVQA | MMSearch | In-house 1 | In-house 2 | 평균 |
|---|---|---|---|---|---|---|---|---|
| Base | 61.4 | 56.8 | 63.0 | 33.0 | 55.6 | 15.9 | 26.9 | 44.66 |
| Only Memory | 62.8 | 56.8 | 61.2 | 37.8 | 56.1 | 12.2 | 28.5 | 45.06 |
| Only Plan | 64.9 | 58.6 | 62.6 | 35.4 | 56.7 | 21.0 | 31.3 | 47.21 |
| Memory for Planner | 67.9 | 60.7 | 61.8 | 36.0 | 59.0 | 17.0 | 34.7 | 48.16 |
| + Reflect | 66.2 | 60.1 | 63.0 | 37.9 | 58.5 | 23.1 | 31.3 | 48.59 |
| Trained Planner | 67.6 | 63.8 | 63.8 | 40.1 | 60.8 | 26.1 | 34.5 | 50.96 |
| + TTL (MIA) | 69.6 | 65.5 | 64.9 | 43.1 | 62.6 | 31.8 | 37.7 | 53.60 |
텍스트 전용 4종은 다음과 같다.
| 설정 | SimpleQA | 2Wiki | HotpotQA | GAIA | 평균 |
|---|---|---|---|---|---|
| Base | 40.7 | 61.2 | 51.0 | 11.7 | 41.15 |
| Only Memory | 37.7 | 61.3 | 50.3 | 12.6 | 40.48 |
| Only Plan | 42.1 | 62.8 | 54.9 | 18.5 | 44.58 |
| Memory for Planner | 42.4 | 64.6 | 54.8 | 19.4 | 45.30 |
| + Reflect | 43.9 | 66.6 | 57.6 | 26.2 | 48.58 |
| Trained Planner | 44.6 | 69.1 | 59.3 | 28.2 | 50.30 |
| + TTL (MIA) | 47.7 | 71.8 | 63.5 | 31.1 | 53.53 |
각 설정의 뜻과 Base 대비 누적 개선폭을 정리한 표가 아래와 같다.
| 설정 | 뜻 | 멀티모달 누적 | 텍스트 누적 |
|---|---|---|---|
| Base | 메모리도 계획도 없이 Executor만 쓴다 | 기준 | 기준 |
| Only Memory | non-parametric memory를 Executor 프롬프트에 직접 넣는다 | +0.40%p | -0.68%p |
| Only Plan | 메모리 없이 Planner의 계획만 붙인다 | +2.56%p | +3.43%p |
| Memory for Planner | 메모리를 Planner에게 주고 Planner가 계획을 만든다 | +3.50%p | +4.15%p |
| + Reflect | 위 구성에 Reflect-Replan을 켠다 | +3.93%p | +7.43%p |
| Trained Planner | Qwen3-32B Planner를 교대 강화학습한 Qwen3-8B로 교체한다 | +6.30%p | +9.15%p |
| + TTL (MIA) | 추론 시점 파라미터 갱신을 켠다 | +8.94%p | +12.38%p |
직전 설정 대비 증분으로 보면 각 부품의 기여가 더 뚜렷하다.
| 추가한 부품 | 멀티모달 증분 | 텍스트 증분 |
|---|---|---|
| Reflect-Replan | +0.43%p | +3.28%p |
| 교대 강화학습으로 학습한 Planner | +2.37%p | +1.72%p |
| TTL | +2.64%p | +3.23%p |
논문이 강조하는 발견은 메모리를 어디에 주입하느냐가 결과를 가른다는 점이다. Only Memory처럼 Executor 프롬프트에 직접 넣으면 이득이 거의 없고, Memory for Planner처럼 Planner의 참고 자료로 주면 멀티모달 +3.50%p, 텍스트 +4.15%p가 오른다. Table 3에서 RAG와 Mem0가 No Memory보다 낮았던 이유를 같은 논리로 설명할 수 있다. 그 세 방법 모두 메모리를 Executor 프롬프트에 넣는 계열이다.
Trained Planner 행에는 별도 조건이 하나 붙는다. 앞선 설정들은 모두 Qwen3-32B를 Planner로 쓰지만 Trained Planner부터는 훨씬 작은 Qwen3-8B를 쓴다. 즉 파라미터를 4분의 1로 줄이면서 정확도를 올린 결과다. 교대 강화학습의 효과가 모델 크기 차이를 상쇄했다고 읽을 수 있다.
Reflect-Replan의 효과 크기가 modality에 따라 크게 다르다. 텍스트 전용에서 +3.28%p인 반면 멀티모달에서는 +0.43%p다. 논문은 이 차이의 원인을 설명하지 않는다. 멀티모달에서는 web_image_to_image_search를 1회만 부를 수 있어 replan이 쓸 수 있는 수단이 좁다는 점이 후보 설명이 될 수 있다.
비지도 자기 진화
정답 없이 학습하는 설정에서 구성 요소를 더하고 epoch를 늘린 결과다.
| 설정 | FVQA-test | LiveVQA | 2Wiki | HotpotQA | 평균 |
|---|---|---|---|---|---|
| Base | 61.4 | 33.0 | 61.2 | 51.0 | 51.65 |
| Plan and Reflect (메모리 없음) | 59.6 | 36.5 | 64.2 | 56.4 | 54.18 |
| Unsupervised Memory for Planner | 57.6 | 28.5 | 66.9 | 56.4 | 52.35 |
| Unsupervised MIA (epoch-1) | 65.1 | 40.1 | 71.6 | 61.7 | 59.63 |
| Unsupervised MIA (epoch-2) | 66.4 | 41.4 | 73.4 | 63.1 | 61.08 |
| Unsupervised MIA (epoch-3) | 67.1 | 41.8 | 74.7 | 63.2 | 61.70 |
비지도 non-parametric memory만 켠 설정이 불안정하다. Unsupervised Memory for Planner는 텍스트 전용에서 2Wiki 61.2%에서 66.9%로 오르지만, 멀티모달에서는 FVQA-test가 61.4%에서 57.6%로, LiveVQA가 33.0%에서 28.5%로 내려간다. 정답 없이 뽑은 workflow에 잘못된 positive label이 섞이면 그 workflow가 다음 계획을 잘못된 방향으로 끌기 때문으로 보인다. 논문은 원인을 특정하지 않고 불안정하다는 사실만 보고한다.
TTL을 함께 켜면 네 데이터셋 모두 Base를 앞선다. epoch를 늘릴 때 평균이 59.63%, 61.08%, 61.70%로 단조 증가한다.
| epoch 구간 | 평균 증분 |
|---|---|
| epoch-1에서 epoch-2 | +1.45%p |
| epoch-2에서 epoch-3 | +0.62%p |
논문 본문이 자기 진화 사례로 든 "59.6 → 61.1 → 61.7"은 특정 데이터셋 값이 아니라 이 4개 데이터셋 평균이다. 같은 데이터셋을 두 번, 세 번 다시 만나도 성능이 오른다는 것이 논문의 주장이고, 이전에 못 풀던 문제를 점차 푼다는 해석을 붙인다. 증분이 절반 이하로 줄어드는 양상에 대해서는 논문이 별도 해석을 달지 않는다.
tool call 분포
TTL에서 표집한 task의 tool call 횟수를 방법별로 겹쳐 그린 그림이다. 점 하나가 task 실행 하나이고, 회색이 실패, 색이 있는 점이 성공이다. 색이 진할수록 정확도가 높다.
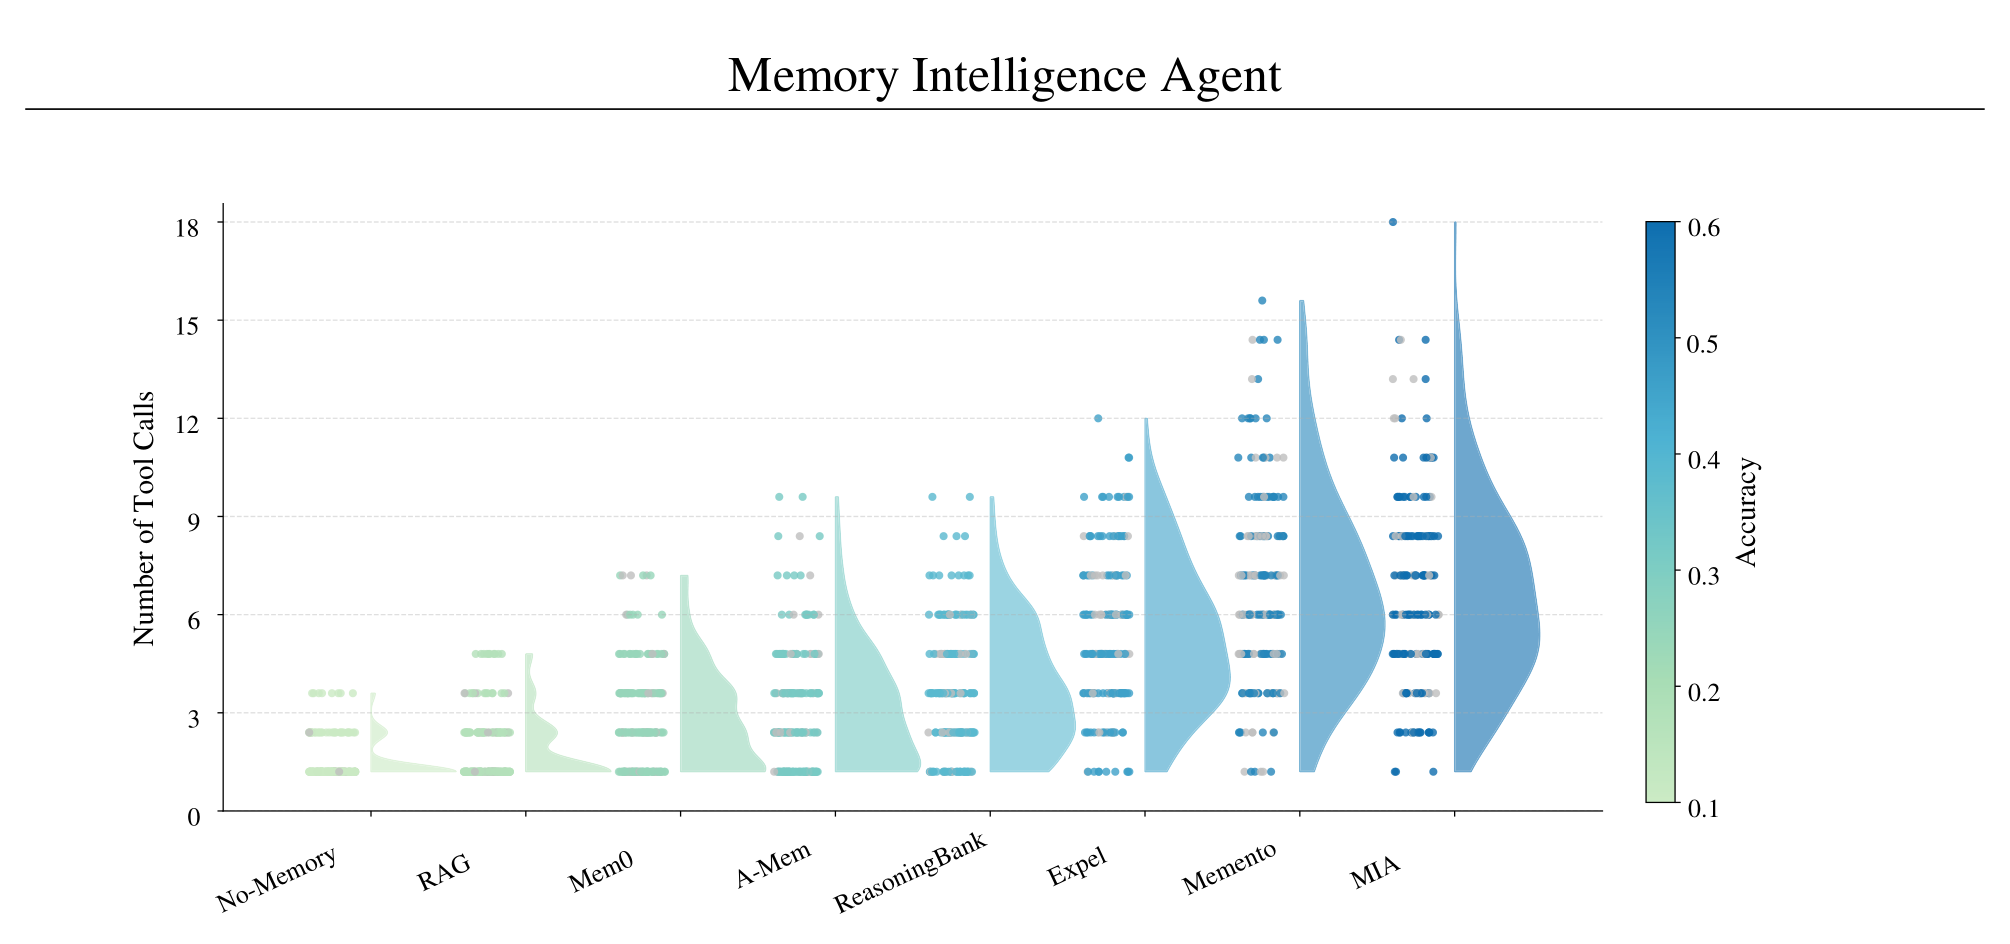
| 방법 | tool call 분포가 뻗는 상한 |
|---|---|
| No-Memory | 약 4회 |
| RAG | 약 5회 |
| Mem0 | 약 7회 |
| A-Mem, ReasoningBank | 약 10회 |
| ExpeL | 약 12회 |
| Memento | 약 16회 |
| MIA | 약 18회 |
논문은 이 그림에서 세 결론을 끌어낸다. 첫째, 메모리가 필수적이다. 메모리 장치가 없는 No-Memory는 tool 사용이 매우 낮고 정확도도 가장 낮다. 제한된 tool call 안에서 추론을 마치려 하기 때문이고, 메모리가 없으면 multi-turn 추론 중 이전 tool 상호작용을 회상하지 못하기 때문이다. 둘째, 현재 질의에 대한 planning이 과거 경험에만 의존하는 방식보다 효과적이다. long-context memory 계열(RAG, Mem0, A-Mem)과 메타 지침 메모리 계열(ReasoningBank, ExpeL)이 모두 Memento와 MIA보다 약하다. 두 방법은 메타 지침 메모리 위에 명시적 planner를 두는 구조를 공유한다. 셋째, 이종 메모리와 test-time 지속 학습을 결합한 MIA가 memory 기반 시스템 중 가장 강하다.
tool call 횟수와 정확도가 함께 오르는 양상이므로, 메모리의 효용이 "도구를 더 오래 쓸 수 있게 만드는 것"으로 나타난다고 읽을 수 있다.
학습 곡선
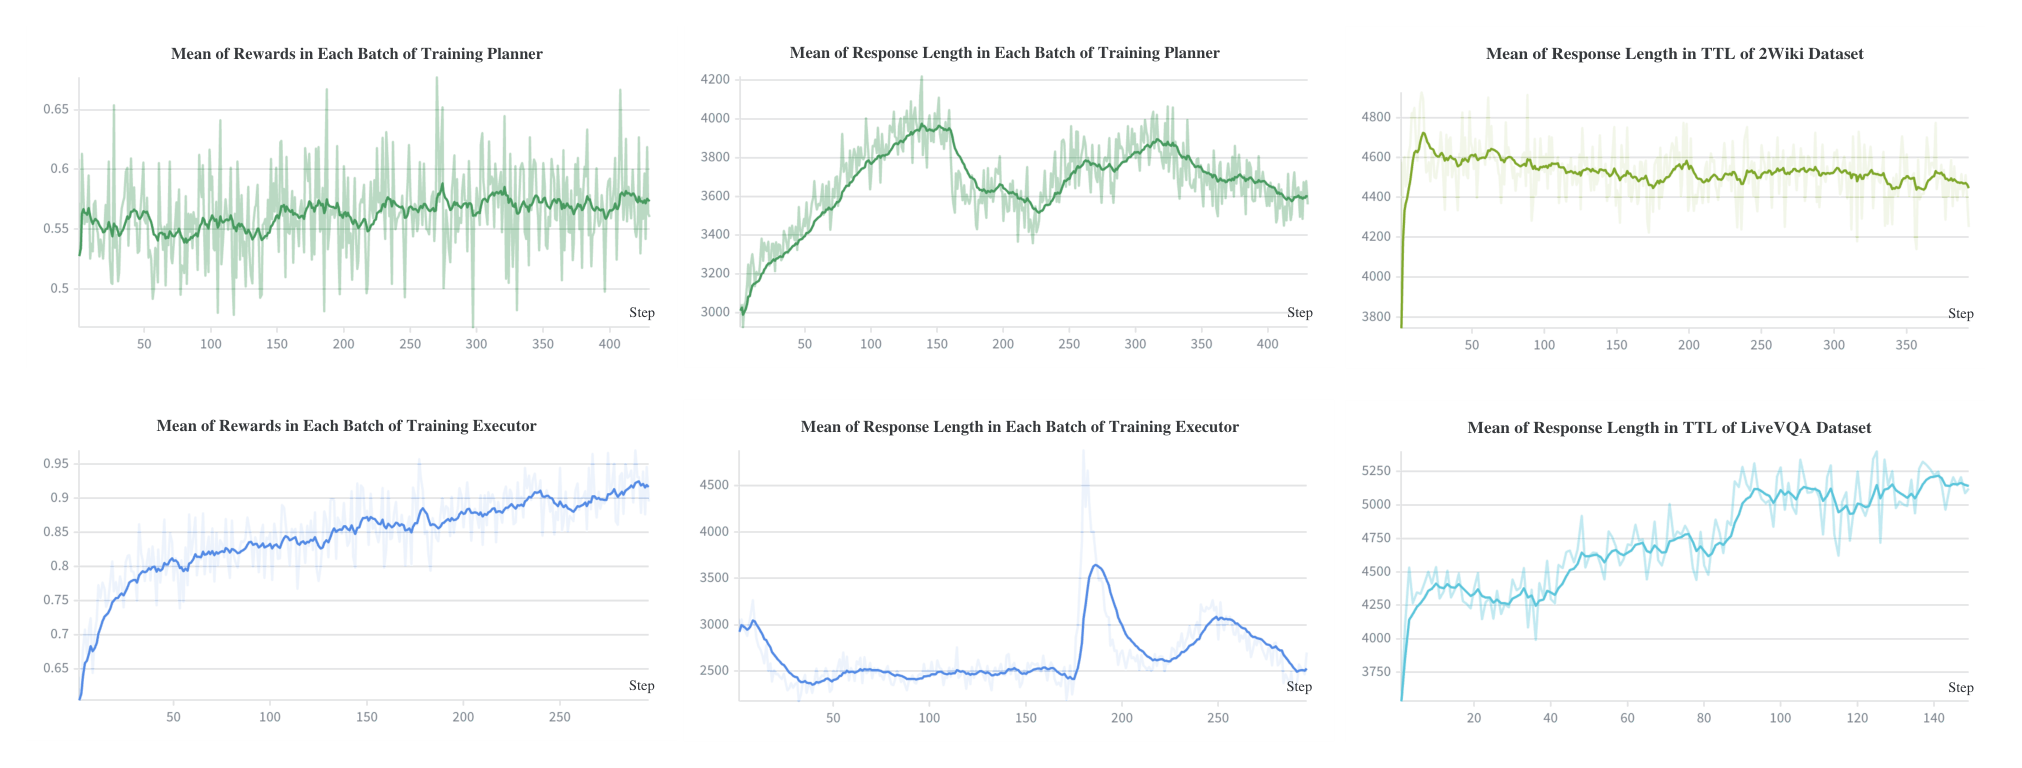
| 관측 대상 | 양상 |
|---|---|
| Executor reward | 약 290 step에 걸쳐 0.62에서 0.92까지 꾸준히 오른다 |
| Planner reward | 약 430 step 동안 0.55에서 0.58 사이를 오가고 변동폭이 크다 |
| Executor 응답 길이 | 약 3,000토큰에서 2,400토큰으로 빠르게 수렴한다. step 185 부근에서 3,600토큰까지 일시적으로 상승하는 구간이 있다 |
| Planner 응답 길이 | 3,000토큰에서 3,950토큰까지 오른 뒤 3,400토큰에서 3,900토큰 사이를 오간다 |
| TTL의 2Wiki 응답 길이 | 약 4,700토큰에서 4,470토큰으로 짧아진다 |
| TTL의 LiveVQA 응답 길이 | 약 4,200토큰에서 5,150토큰으로 길어진다 |
Planner와 Executor의 곡선이 갈리는 이유를 논문은 reward 신호의 거리에서 찾는다. Executor의 reward는 자신의 action에 직접 붙어 상대적으로 직접적이고 안정적이다. Planner의 reward는 Executor가 낸 결과를 거쳐 오므로 간접적이고 불안정하다. 그래서 Planner의 reward 곡선과 응답 길이가 모두 늦게 수렴한다.
TTL 단계에서 응답 길이가 데이터셋에 따라 반대 방향으로 움직이는 것이 논문의 주된 관찰이다. 2Wiki는 짧은 응답 패턴을 가진 데이터셋이고 LiveVQA는 긴 응답 패턴을 가진 데이터셋인데, 학습 step이 늘수록 Planner의 응답 길이가 각 데이터셋의 패턴 쪽으로 이동한다. 논문은 이를 강화학습이 데이터셋 특성을 포착한 증거로 해석한다.
논문 내부의 수치 불일치
원 논문의 본문 서술과 표 값이 어긋나는 지점이 두 곳 있다. 인용할 때 표 값을 기준으로 삼는 것이 안전하다.
| 항목 | 논문 본문 | 표에서 계산한 값 | 판단 |
|---|---|---|---|
| Only Memory의 멀티모달 평균 변화 | "leads to a performance drop in the average accuracy of multimodal tasks (-0.4)" | Table 5의 7개 데이터셋 평균이 44.66%에서 45.06%로 +0.40%p | 부호가 반대다. 실제로 하락한 쪽은 텍스트 전용(41.15%에서 40.48%, -0.68%p)이다 |
| TTL 증분 | "further increasing the average accuracy by 3.23 (multimodal) and 2.64 (text-only)" | 멀티모달 50.96%에서 53.60%로 +2.64%p, 텍스트 50.30%에서 53.53%로 +3.23%p | 두 값이 서로 바뀌어 실렸다 |
첫 항목은 논문의 핵심 주장 하나와 직접 연결되므로 특히 주의가 필요하다. 논문은 Only Memory가 하락한다는 것을 메모리를 Executor에 직접 주입해서는 안 된다는 근거로 쓴다. Table 5를 그대로 계산하면 멀티모달에서는 소폭 상승이고, Table 6의 텍스트 전용에서만 하락한다. 주장의 방향 자체가 무효가 되는 것은 아니다. Memory for Planner가 두 modality 모두에서 Only Memory보다 3%p 이상 높으므로, "Planner에 주는 것이 Executor에 주는 것보다 낫다"는 비교는 표로도 성립한다. 무효가 되는 것은 "Executor에 직접 주면 오히려 떨어진다"는 강한 형태의 주장이다.
그 밖에 명칭이 어긋나는 곳도 두 군데다.
| 항목 | 어긋난 지점 |
|---|---|
| 심사 차원 이름 | Dimensional Orthogonality 설명은 Logic, Format, Factuality를 분리한다고 적지만 실제 심사자 셋의 담당은 Logic, Credibility, Validity다 |
| baseline 프롬프트 변형 이름 | 부록 C는 long-context memory prompt와 guideline prompt로 부르고 본문 4.1절은 workflow memory prompt와 plan prompt로 부른다 |
한계
- Reflect-Replan이 1회로 제한된다. 추론 시간을 줄이려는 선택이다. 여러 단계에 걸친 반복 reflection은 다루지 않는다.
- 도구가 2개뿐이다.
search와web_image_to_image_search만 쓴다. 코드 실행기, 브라우저 조작, 파일 입출력 같은 도구 환경으로의 확장은 검증되지 않았다. 논문 결론도 더 복잡하고 동적인 환경으로 확장할 계획을 향후 과제로 남긴다. - 비지도 판정의 추론 비용이 높다. Reviewer-Area Chair는 판정 한 번에 Qwen3-32B 인스턴스 4개를 호출한다. 논문은 이 비용을 정량화하지 않는다.
- TTL이 single epoch online learning이다. epoch를 1로 두므로 데이터 분포 변화에 취약할 수 있다. catastrophic forgetting을 명시적으로 다루지 않고 메모리 단위의 선택적 삭제 정책만 그 역할을 대신한다. catastrophic forgetting은 새 학습이 기존 능력을 지워버리는 현상이다.
- 메모리 삭제 기준이 명시되지 않는다. 학습 후 메모리 단위를 선택적으로 비운다고만 서술하고 어떤 기준으로 어느 단위를 남기는지는 적지 않는다.
- Memento 비교가 부분적이다. Memento의 parametric retrieval optimization을 멀티모달 입력에 적용하기 어려워 non-parametric 버전만 비교했다고 저자가 밝힌다.
- LiveVQA 버전이 다르다. MMSearch-R1이 보고한 3,602개 버전은 접근할 수 없어 공개 2,384개 버전으로 평가했다. MMSearch-R1 보고값과 직접 비교할 때 주의가 필요하다.
- 평가 지표가 LLM Judger 단일 판정이다. 모든 정확도가 Qwen3-32B의 정답 여부 판정에 의존한다. 사람 평가나 다른 judger와의 일치도는 보고되지 않는다.
- 본문과 표의 수치가 두 곳에서 어긋난다. 앞 절에 정리했다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| non-parametric memory | memory buffer에 텍스트로 저장된 명시적 trajectory와 workflow. in-context 대조 학습 재료로 쓰인다 |
| parametric memory | Planner 가중치에 내재화된 잠재 지식. 저장 용량이 늘지 않는 대신 개별 항목을 지목해 꺼낼 수 없다 |
| workflow summary | trajectory를 "action purpose (input → output)" 형식의 추상 단계로 압축한 표현. 재사용 단위가 사실이 아니라 절차다 |
| Reflect-Replan | Executor 결과를 보고 Planner가 수정 계획을 1회 만드는 reflection 장치 |
| TTL (Test-Time Learning) | 추론 batch를 처리하면서 동시에 파라미터를 갱신하는 online 학습 방식. epoch가 1이고 미리 모은 context가 없다 |
| Reviewer-Area Chair | 학회 심사를 모사한 비지도 판정 구조. R_L(logic), R_C(credibility), R_V(validity) 세 심사자와 Area Chair로 구성된다 |
관련 페이지
- Are We Ready For An Agent-Native Memory System?: agent memory를 표현, 추출, 검색, 유지 네 모듈로 분해해 12개 시스템을 벤치마크한 조사 연구. MIA를 그 분류 안에 놓으면 추출은 workflow 압축, 검색은 유사도와 품질과 빈도의 가중합, 유지는 parametric 내재화 후 선택적 삭제에 해당한다
- TaskMem: Task-Focused Memorization for Multimodal Agents: multimodal agent의 memory 생성 자체를 학습 대상으로 삼은 TaskMem. 두 논문 모두 memory 생성을 고정 단계에서 학습 가능한 단계로 옮기지만, TaskMem은 memorization 쪽을 학습시키고 MIA는 memory를 소비하는 Planner 쪽을 학습시킨다
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory: 대화와 업무 데이터를 시간에 따라 변하는 knowledge graph로 합성하는 agent memory 계층. MIA는 그래프 구조 대신 trajectory의 절차 압축을 택했다는 점에서 대조군이다
- getzep/graphiti: Zep의 그래프 엔진 오픈소스 구현. 구조화된 메모리 표현을 어떤 인프라로 운영하는지 보려면 함께 참고한다
- RAG, LLM Wiki, or GBrain? 에이전트 메모리 결정 프레임워크 (Liu): retrieve, compile, act 세 가지로 agent 지식 접근 방식을 나눈 글. MIA의 non-parametric memory는 retrieve에, Planner 재학습은 compile에 대응한다
- garrytan/gbrain: git과 Markdown으로 agent memory를 수동 큐레이션하는 실무 접근. MIA가 강화학습으로 자동화한 압축과 선별을 사람이 직접 하는 방식이다
- Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction: 임베딩과 인덱스 없이 agent가 직접 코퍼스를 탐색하는 DCI 제안. 두 논문 모두 semantic similarity 단독으로는 부족하다는 입장을 공유하고, MIA는 그 보완책으로 품질과 빈도 항목을 더했다
- LeanRAG: Knowledge-Graph-Based Generation with Semantic Aggregation and Hierarchical Retrieval (AAAI-26): 계층 knowledge graph와 최소 공통 조상 검색을 결합한 RAG. 추상 층을 만들어 검색 대상을 줄이는 발상이 MIA의 workflow 압축과 겹친다
- 용어집: Agents (Terminology Glossary): 이 페이지가 따르는 agents 도메인 용어 표기 기준