Physical AI · PAPER · 2024
LLM-as-BT-Planner: Leveraging LLMs for Behavior Tree Generation in Robot Task Planning
요약
이 논문은 로봇 조립 과제의 계획을 LLM이 곧바로 실행 가능한 Behavior Tree로 내놓게 하는 프레임워크를 제안한다. Behavior Tree는 로봇의 의사결정을 트리 구조의 노드 조합으로 관리하는 제어 구조이고, 약어로 BT라 쓴다. 모듈성과 반응성 덕분에 로봇 과제 계획의 표현으로 널리 쓰이지만 사람이 손으로 만드는 비용이 크다는 것이 출발점의 문제의식이다.
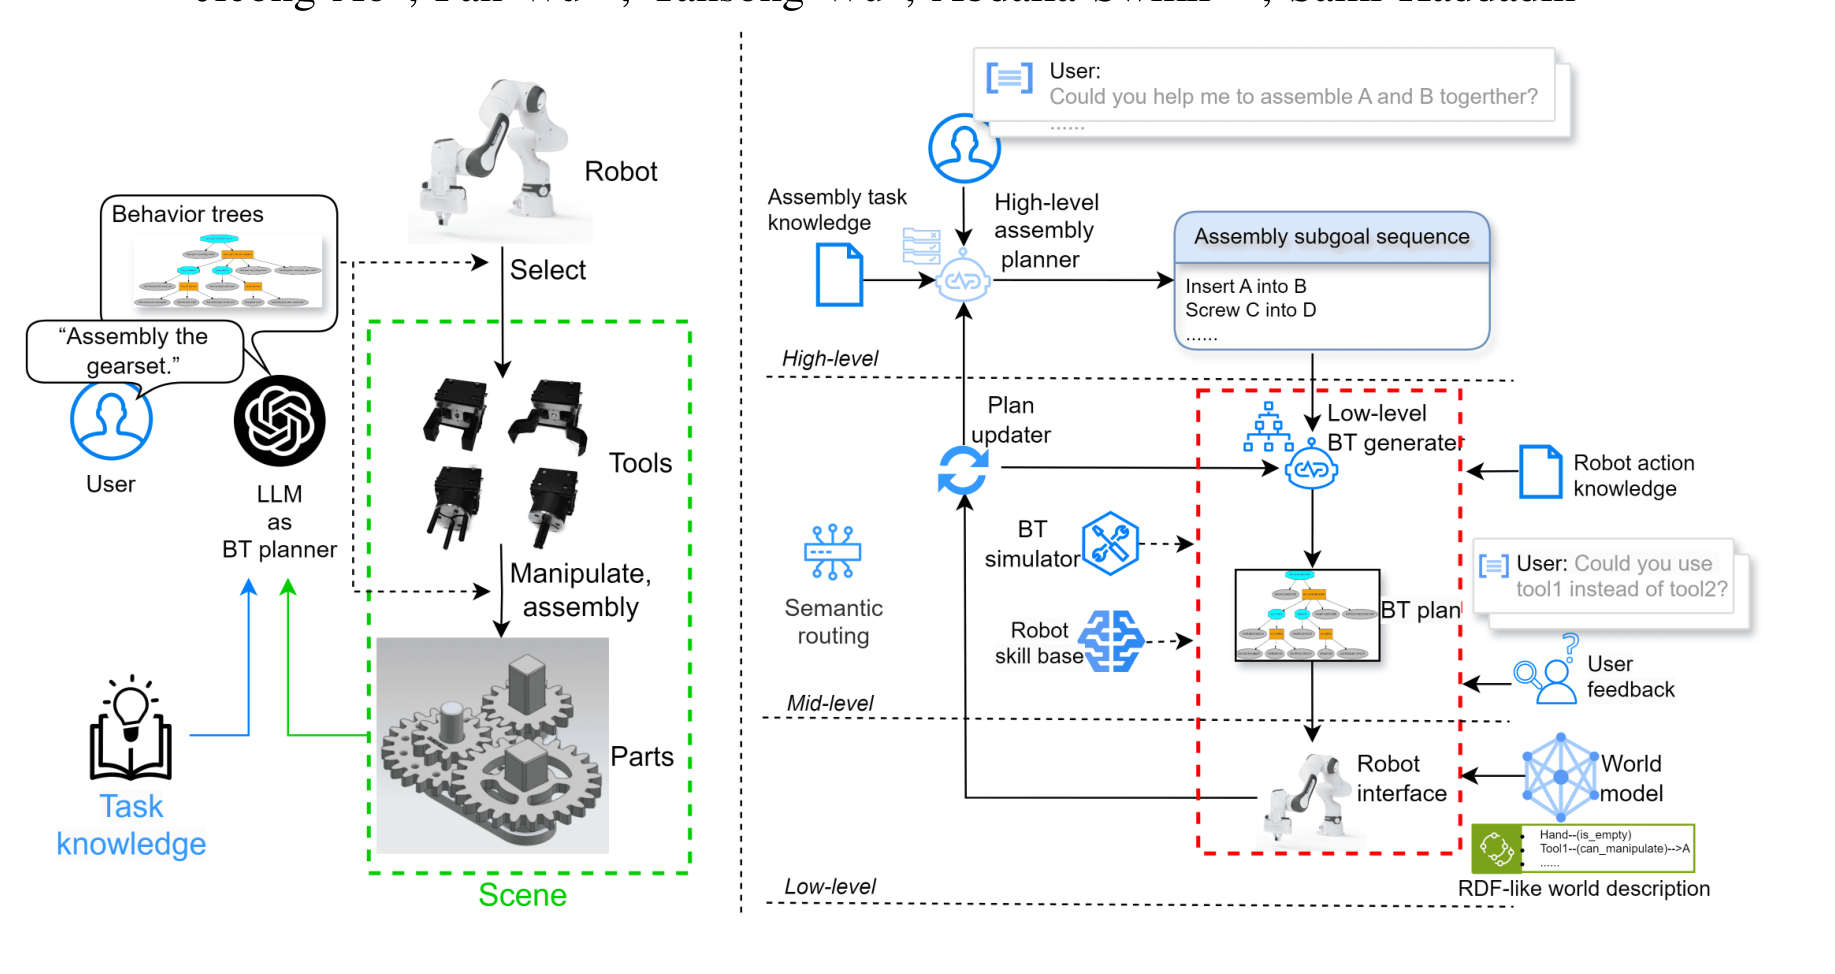
프레임워크의 이름은 LLM-as-BT-Planner이며 계층은 세 개다. 사용자 지시문(instruction)을 받아 조립 과제를 subgoal 시퀀스로 분해하는 high-level, 각 subgoal에 대해 BT를 만드는 mid-level, 만들어진 BT를 실제 로봇에서 실행하는 low-level이다.
핵심 기여는 mid-level의 BT 생성 방식을 네 가지로 설계하고 같은 지표로 비교한 데 있다. 한 번에 만드는 one-step, 시뮬레이션 피드백으로 고치는 iterative, 사람의 피드백을 받는 human-in-the-loop, 알고리즘이 재귀적으로 확장하는 recursive다. GPT-4로 실험한 결과 human-in-the-loop이 17개 과제 중 16개를 성공해 가장 앞섰다.
여기에 더해 Mistral-7B와 Llama2-13B-chat 같은 소형 오픈소스 모델을 fine-tuning해 GPT-4를 대체할 수 있는지 조사했다. 결론은 절반의 성공이다. fine-tuning은 BT의 형식을 지키는 능력을 크게 높였지만, action 사이의 의존 관계를 추론해야 하는 어려운 과제에서는 성공률을 거의 끌어올리지 못했다.
배경
조립 과제가 어려운 이유
로봇 조립은 두 가지 성질 때문에 여전히 열린 문제다. 하나는 long-horizon이라는 점이다. long-horizon 과제는 여러 단계를 이어야 끝나는 긴 과제를 말한다. 다른 하나는 부품 사이의 관계가 복잡하다는 점이다. 어떤 부품을 먼저 조립하느냐에 따라 이후에 가능한 동작이 달라진다.
여기에 조립 과제만의 부담이 하나 더 있다. 물건을 집어 옮기는 pick-and-place 과제는 로봇과 물체의 단순한 상호작용만 요구하지만, 조립 과제는 부품마다 알맞은 도구를 골라 바꿔 끼워야 한다. 이 논문의 실험도 도구 교체 기구를 갖춘 로봇 팔 하나로 진행되는데, 다양한 형상의 부품을 안정적으로 쥐려면 필요한 구성이기 때문이다.
고전적 계획에서 Behavior Tree로
과제 계획의 고전적 접근은 기호 형식주의에 기댄다. 대표적인 것이 PDDL이며, 닫힌 세계 가정 아래 초기 상태에서 목표 상태로 가는 경로를 탐색한다. 그러나 상태 공간의 복잡도가 지수적으로 늘어 대규모 적용이 어렵고, 방대한 도메인 지식이 필요하며, 생성된 plan이 open-loop이라 long-horizon 과제에서 성능이 떨어진다. open-loop 실행은 한 번 계산한 계획을 중간 피드백 없이 끝까지 내보내는 방식이다.
실무에서 task plan은 흔히 Finite State Machine으로 프로그래밍된다. Finite State Machine은 상태와 transition으로 제어 흐름을 표현하는 구조이며 약어로 FSM이라 쓴다. 문제는 확장성이다. 그래서 상태를 겉으로 드러내지 않고 계층적 트리로 표현하는 BT가 복잡한 과제 계획에서 인기를 얻었다. 모듈성, 재사용성, 반응성이 long-horizon manipulation 과제에 더 알맞기 때문이다. manipulation은 팔과 손으로 물체를 다루는 과제 영역을 가리킨다.
자동 생성 시도의 한계
BT가 FSM보다 만들고 유지하기 쉽다고 해도 손으로 프로그래밍하는 부담은 여전히 크다. 그래서 BT 기반 task plan을 자동 생성하려는 시도가 세 가지로 이어졌다.
| 접근 | 내용 | 남는 한계 |
|---|---|---|
| 기호 계획 | PDDL 등 형식 언어로 BT 구조를 유도한다 | 기본 구조나 사용 가능한 subtree를 사람이 설계해야 한다 |
| 시연 데이터 학습 | 시연 데이터(demonstration)에서 BT를 학습한다 | 같은 이유로 사전 설계 의존이 남는다 |
| 강화학습 | peg-in-hole 같은 과제에서 동작 시퀀스를 학습한다 | 같은 이유로 사전 설계 의존이 남는다 |
세 방법 모두 BT의 뼈대나 재료를 사람이 미리 만들어 둬야 한다는 공통 한계를 갖는다.
LLM이 들어올 자리
LLM과 VLM의 발전으로 로봇 과제 계획에 새로운 접근이 등장했다. ProgPrompt와 PaLM-E가 대표적이며, LLM의 의미 이해 능력을 활용하고 추론 능력을 in-context learning으로 끌어올리는 방식이다. in-context learning은 가중치 갱신 없이 프롬프트 안의 예시만으로 과제를 배우는 능력을 뜻한다.
BT 생성에 LLM을 쓰려는 시도도 있었지만 역할이 제한적이었다. 선행 연구에서 LLM은 주로 사람의 지시문을 task specification으로 옮기고 BT 확장 알고리즘을 초기화하는 데 쓰였다. 즉 BT를 만드는 주체는 여전히 알고리즘이었다. 이 논문은 그 자리를 바꿔 LLM이 복잡한 BT를 직접 생성하게 한다.
핵심 개념
과제 계획 문제의 정식화
논문은 과제 계획 문제를 튜플 (O, P, C, R, A, T, I, G, t)로 정의한다. 각 기호가 맡는 역할은 다음과 같다.
| 기호 | 뜻 | 성질 |
|---|---|---|
| O | 환경에 있는 모든 물체의 집합 | |
| P | 물체의 property | 물체의 affordance와 가용성을 알려준다 |
| C | 물체 사이의 constraint | A의 action으로 바뀌지 않는다 |
| R | 물체 사이의 relation | action이 바꿀 수 있다 |
| A | 실행 가능한 action의 집합 | 환경 상태를 바꾼다 |
| T | transition 모델 T: S × A → S | |
| I, G | 초기 상태와 목표 상태 | |
| t | 자연어로 된 high-level 과제 서술 | agent가 실제로 받는 입력 |
affordance는 물체가 허용하는 상호작용 가능성을 뜻한다. 상태 s는 모든 property, constraint, relation에 값을 지정한 것이고, S는 그 모든 조합의 집합이다.
정식화에서 중요한 지점은 agent가 목표 상태 g를 직접 받지 않는다는 것이다. agent가 받는 것은 자연어 서술 t뿐이다. O, P, C, R, A, I를 아는 상태에서 실행하면 상태를 I에서 G로 옮기는 BT를 만드는 것이 과제다. 자연어를 실행 가능한 트리로 옮기는 일이 곧 이 논문이 푸는 문제다.
Behavior Tree를 쓰는 이유
BT의 노드는 tick이라는 실행 신호를 받는다. tick은 루트에서 잎으로 흘러 각 노드를 실행시키는 신호를 뜻한다. 잎 노드는 두 종류다. action node는 실제 동작을 수행하는 쪽이고, condition node는 상태 성립 여부만 확인하는 쪽이다.
이 구조가 조립 과제에 알맞은 이유는 precondition을 트리 구조 자체로 표현할 수 있기 때문이다. "그리퍼가 비어 있어야 물건을 집을 수 있다"는 제약이 별도 검사 코드가 아니라 트리의 한 가지로 들어간다. 실행 중 조건이 깨지면 그 가지가 다시 평가되므로 반응성도 함께 얻는다.
논문은 BT 정의와 subtree 구조를 Colledanchise 2019의 방식을 따른다. 비동기 BT를 구성하는 데 효과적이라는 이유에서다.
지식과 상태의 표현 형식
LLM이 BT를 만들려면 두 종류의 정보를 읽어야 한다. 하나는 로봇이 할 수 있는 action과 세계를 서술하는 predicate의 정의이고, 다른 하나는 지금 세계가 어떤 상태인지다.
| 정보 | 표현 형식 | 비고 |
|---|---|---|
| robot action과 world predicate | PDDL과 비슷한 형식에 자연어 설명을 덧붙임 | 기호 정의와 자연어 설명을 함께 둬 LLM이 읽게 한다 |
| world state | RDF와 비슷한 형식 | ProgPrompt 계열이 쓰는 방식을 따랐다 |
| task knowledge | 자연어 | high-level 과제 분해에 쓰인다 |
형식을 순수 기호로 두지 않고 자연어 설명을 함께 둔 것이 설계의 요점이다. LLM은 기호 정의만으로도 형식을 흉내 낼 수 있지만, 그 기호가 물리적으로 무엇을 뜻하는지는 자연어 설명에서 얻는다.
방법
3계층 프레임워크
프레임워크는 사용자의 지시문에서 로봇 동작까지를 세 계층으로 잇는다.
| 계층 | 담당 모듈 | 입력 | 출력 |
|---|---|---|---|
| high-level | LLM 기반 assembly planner | 사용자 지시문, task knowledge | subgoal 시퀀스 |
| mid-level | LLM 기반 BT generator | subgoal, world state, action과 predicate 지식 | 실행 가능한 BT |
| low-level | robot interface, world model, skill library | 생성된 BT | 로봇 동작 |
low-level의 world model은 world state와 물체의 공간 정보를 제공한다. world state는 어떤 물체가 무엇을 쥐고 있고 어디에 삽입되어 있는지 같은 관계를 담은 현재 세계의 기술이다. skill library는 실행기에 다양한 로봇 action을 제공해 조립 실행의 정확성과 적응성을 보장한다.
계층 사이에는 두 종류의 피드백 경로가 있다. 사람의 피드백은 BT 생성과 실행 사이에 들어가 실행 중 재계획을 가능하게 하고, 시뮬레이션 피드백은 실행 전에 BT를 미리 고쳐 실행 위험을 낮춘다.
워크플로의 분기는 semantic router가 정한다. semantic router는 사용자 입력과 미리 준비한 예시 입력 사이의 임베딩 거리를 계산해 어느 경로로 갈지 고르는 장치다. 사용자가 새 과제를 지시했는지, 생성된 BT에 대한 피드백을 준 것인지를 문장의 의미로 구분한다.
네 가지 in-context learning 방법
mid-level의 BT 생성 방식이 이 논문의 핵심 설계 공간이다. 네 방법은 모두 같은 프레임워크 안에서 Figure 1의 빨간 점선 부분을 대체한다.
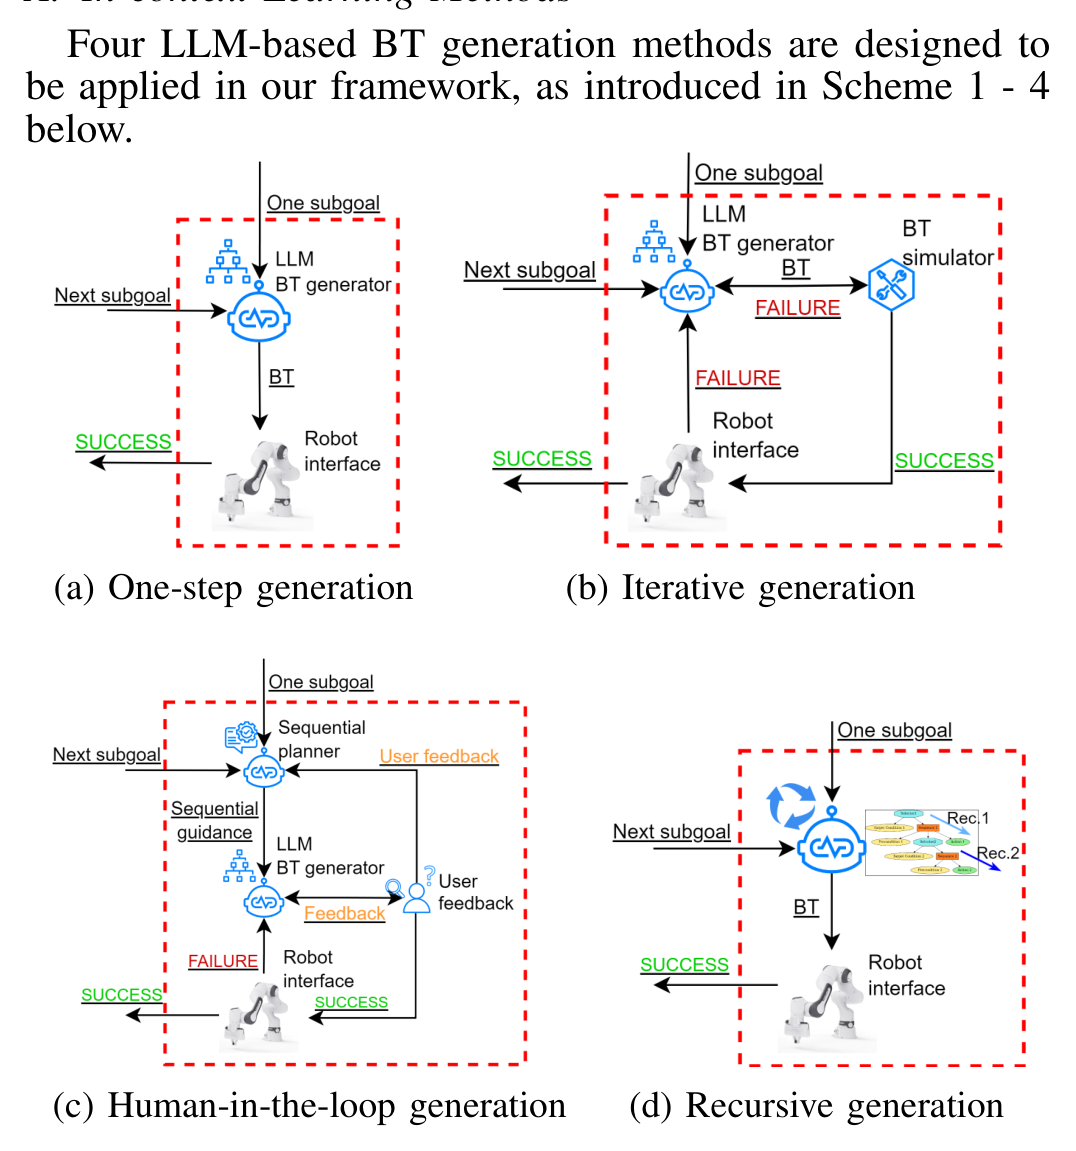
one-step generation
가장 단순한 기준선이다. 상류 모듈에서 온 조립 subgoal 하나에 대해 LLM 기반 BT generator가 BT 전체를 한 번에 만든다. 입력은 초기 상태, subgoal, 그리고 action과 BT에 대한 지식이다.
생성된 BT는 곧바로 robot executor로 넘어가고 실행 결과가 상류의 plan updater로 돌아온다. 실행이 실패하면 FAILURE 신호가 전달되어 plan 갱신을 막고, 직전 조립 단계를 다시 계획하게 한다. 나머지 세 방법은 이 기준선을 개선한 것이다.
iterative generation
BT 시뮬레이션 결과를 활용해 BT를 고쳐 다시 만든다. BT 전체를 만드는 과정 자체는 one-step과 같고, 만들어진 BT를 시뮬레이터가 한 번 실행해 본다는 점이 다르다. 시뮬레이터는 모든 action node가 최종적으로 SUCCESS를 반환한다고 가정한 채 구조만 검사한다.
FAILURE가 나오면 시뮬레이터가 미리 정의된 실패 사유를 제공하고 generator가 그것을 참고해 새 BT를 만든다. 실패의 원인은 주로 구조 오류나 논리 불일치다. 즉 이 방법은 LLM의 추론 능력을 자동 피드백과 결합하려는 시도다.
human-in-the-loop generation
사람의 피드백 단계를 두어 BT 수정에 구체적인 제안을 투입한다. 절차는 세 단계로 늘어난다. 먼저 sequential planner가 상류 action 단계에 대해 자연어 설명이 붙은 bullet plan을 만든다. 그 계획이 BT 생성 모듈로 넘어가 생성을 안내한다. BT 생성 이후에 사용자 피드백 단계가 한 번 있고, BT 실행 이후에도 같은 단계가 한 번 더 있어 사용자가 계획과 실행 과정에 유연하게 개입할 수 있다.
이 방법에는 성능 향상 말고도 부수적 이점이 있다. 사용자 피드백을 통해 자연어로 된 새 지식을 계획 도중에 투입할 수 있다는 점이다. 예를 들어 도구와 물체의 호환 관계가 바뀌었다고 알려주면, LLM은 강력한 자연어 처리 능력으로 그 새 입력을 오래된 지식보다 우선해 BT를 만든다. 결과적으로 knowledge base를 고치지 않고도 효율적인 재계획이 가능하다.
recursive generation
알고리즘이 BT 생성 과정을 안내한다. 전체 생성을 세 가지 LLM 호출 단계로 나누고 이들을 재귀적으로 불러 완전한 BT를 만든다.
| 단계 | 하는 일 |
|---|---|
| MakePlan | 현재 만족되지 않은 조건을 채울 action sequence를 만든다 |
| MakeTree | 그 action sequence의 첫 action에 대한 subtree를 만들어 만족되지 않은 condition node를 대체한다 |
| PredictState | 새 subtree 실행 이후의 world state를 예측해 다음 계획을 위해 갱신한다 |
논문의 Algorithm 1이 이 확장 과정을 적는다. node list의 각 node에 대해 목표를 얻고, 직전 상태에서 그 목표까지의 plan을 만든다. plan이 비어 있지 않으면 상태를 예측해 갱신하고, plan의 마지막 action으로 subtree를 만든 뒤, 그 subtree의 condition 자식들을 새 node list로 삼아 재귀 호출한다. plan이 비어 있으면 상태를 그대로 다음으로 넘긴다.
과정을 쪼개고 알고리즘으로 안내한 만큼 정확성과 견고성이 올라가리라는 것이 설계 의도다. 대신 LLM 호출 횟수가 늘어나므로 자원 소비도 함께 커진다.
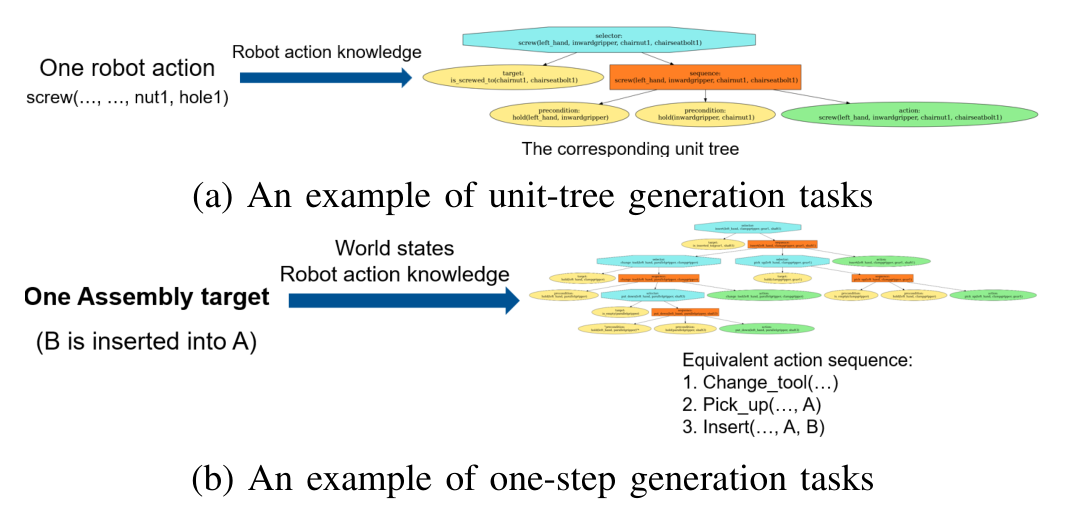
fine-tuning 평가용 과제 두 유형
소형 LLM의 fine-tuning 효과를 서로 다른 측면에서 보려고 과제 유형을 두 가지로 나눴다.
| 과제 유형 | 입력 | 요구 산출물 | 평가하는 능력 |
|---|---|---|---|
| unit-tree generation | action 하나, 전체 action 정의, BT 구조 요구사항 | 대응하는 precondition과 action node를 갖춘 unit BT | 구조적 출력 능력, in-context learning 능력 |
| one-step generation | 초기 상태, 목표 서술, 필요한 지식 | 실행 후 목표 상태에 도달하는 BT 전체 | 위의 두 가지에 더해 추론 능력 |
unit-tree generation 과제는 recursive generation 방법의 하위 과제를 떼어 낸 것이고, one-step generation 과제는 one-step generation 방법 그 자체다. 두 과제의 난이도 차이는 명확하다. unit tree는 action 하나를 정해진 형식으로 옮기면 되지만, one-step은 sub-BT로 표현된 action들 사이의 의존 관계와 중첩 관계를 함께 다뤄야 한다.
실험 구성
로봇과 소프트웨어
7자유도 Franka Emika Panda 로봇 팔 하나에 operation space control을 적용했다. 토크는 Cartesian adaptive force-impedance controller가 계산하고 Franka Control Interface(FCI)로 전달한다.
| 구성 요소 | 구현 |
|---|---|
| 제어 | operation space control, Cartesian adaptive force-impedance controller |
| 하드웨어 인터페이스 | Franka Control Interface(FCI) |
| action 실행 | skill base가 action 컨텍스트를 미리 정의된 skill로 대응시킨다 |
| BT 실행 | PyTrees와 WebSocket으로 비동기 BT를 구현 |
| world model | 자체 구현 relation graph와 Neo4j로 world state 관리와 시각화 |
BT의 action node는 동작 자체를 담지 않고 skill base를 통해 미리 정의된 skill을 부른다. 계획과 제어를 분리한 구성이라, LLM이 만든 BT가 곧바로 로봇 동작으로 이어질 수 있다.
조립 과제
주 use case는 Siemens Robotic Assembly Challenge의 기어세트다. gear base 하나, shaft 세 개, gear 세 개로 이뤄져 있고, shaft를 gearbase에 조립한 뒤 각 gear를 대응하는 shaft에 삽입해 맞물리게 하는 것이 목표다. gearbase에 고정되는 두 번째 shaft는 나사 결합이 필요하도록 변형했다. 로봇이 써야 하는 skill 종류를 늘리기 위한 조치다.
도구 큐브는 손끝 형상에 따라 parallelgripper, clampgripper, outwardgripper, inwardgripper 네 가지로 나뉜다. 부품마다 알맞은 도구가 다르므로 로봇은 조립 중 도구를 바꿔야 한다.
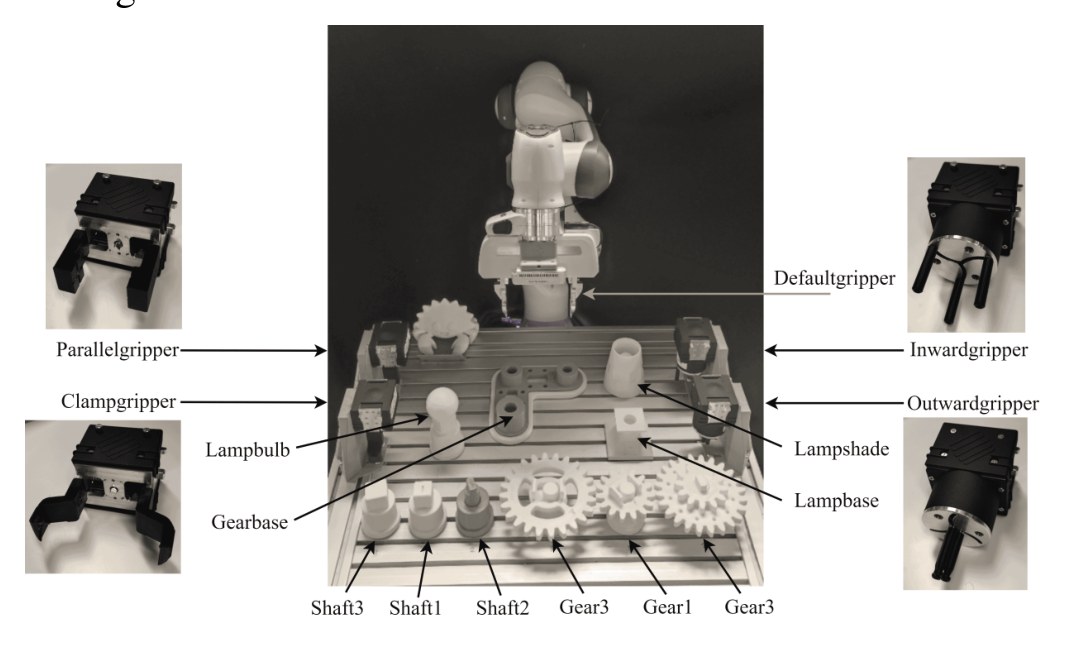
실제 실험에서 쓴 상태 표현의 항목은 다음과 같다.
| 집합 | 항목 |
|---|---|
| property P | isEmpty |
| constraint C | canManipulate, isInsertable |
| relation R | isInsertedTo, Hold |
| object O | left_hand, shaft1 |
| action A | insert, screw, place, put_down, change_tool, pick_up |
일반화를 확인하려고 Furniture Assembly Benchmark의 의자와 램프 use case에서도 실험했다. lamp_base, lamp_bulb, chair_leg, chair_seat 같은 물체로 의자와 램프를 조립하는 과제다.
평가 지표
지표는 정확도 세 가지와 자원 소비 두 가지로 나뉜다.
| 약어 | 지표 | 무엇을 보는가 |
|---|---|---|
| SR | Success Rate | 생성된 BT가 실행 가능하고 논리적으로 일관되며 목표 상태에 도달할 때만 성공으로 센다 |
| LC | Logical Coherence | BT 내부의 실행 순서가 precondition 위반 없이 대응 action sequence와 일치하는지 본다. LLM의 추론 능력을 나타낸다 |
| Exec | Executability | BT가 규정된 형식을 따라 실행될 수 있는지 본다. 구조화된 출력을 만드는 능력을 나타낸다 |
| GD | Generation Duration | BT 하나를 만드는 데 걸린 시간(초) |
| TC | Token Consumption | BT 하나를 만드는 데 쓴 토큰 수 |
세 정확도 지표가 포함 관계를 이룬다는 점이 중요하다. 성공은 실행 가능성과 논리 일관성을 모두 만족해야 하므로, 세 값을 나란히 보면 실패가 형식 문제인지 추론 문제인지 구분할 수 있다.
결과
네 방법의 비교
GPT-4로 과제 17개를 실행한 결과다.
| 방법 | SR | LC | Exec | GD(초) | TC |
|---|---|---|---|---|---|
| One-step | 12/17 | 12/17 | 17/17 | 49.11 | 5074.96 |
| Iterative | 12/17 | 12/17 | 17/17 | 48.52 | 7770.13 |
| Human-in-the-loop | 16/17 | 16/17 | 17/17 | 85.02 | 7483.34 |
| Recursive | 13/17 | 17/17 | 13/17 | 231.04 | 50229.96 |
GPT-4는 네 방법 모두에서 BT 생성에 필요한 in-context learning 능력과 구조적 출력 능력을 보인다. 실행 가능성은 recursive에서 13/17, 나머지 세 방법에서 17/17이다. 논리 일관성과 성공률도 최저값이 12/17로 절반을 넘는다. one-step은 실행 가능성이 완벽하고 성공률은 12/17인데, 실패 사례 대부분은 트리 깊이가 부족하거나 잘 정의된 action이 없어서 생긴 것이다.
구체적이지 않은 시뮬레이션 피드백은 성능 개선으로 이어지지 않았다. iterative는 one-step 대비 이점을 보이지 않았는데, 테스트 사례에서 두 방법이 만든 BT가 모두 실행 가능해 미리 정의된 비구체적 실패 사유를 활용할 여지가 없었기 때문이다. 토큰 소비만 5074.96에서 7770.13으로 약 53% 늘었다.
반면 구체적이고 방향이 분명한 사용자 피드백은 성능을 크게 끌어올린다. human-in-the-loop은 논리 일관성이 16/17로 one-step의 12/17보다 4개 많고, 실행 가능성도 17/17로 recursive의 13/17보다 높다. 대가는 시간과 토큰이다. 평균 생성 시간이 49.11초에서 85.02초로, 토큰 소비가 5074.96에서 7483.34로 늘었다.
recursive는 성격이 다르다. 논리 일관성 17/17로 네 방법 중 유일하게 만점이지만, 실행 가능성은 13/17로 가장 낮다. 재귀 호출이 LLM 생성 능력의 불안정성을 증폭시키기 때문이다. 자원 소비도 가장 크다. 생성 시간 231.04초는 one-step의 약 4.7배이고, 토큰 소비 50229.96은 약 9.9배다.
저자들은 human-in-the-loop이 성공률과 효율의 균형에서 앞선다고 본다. 다만 recursive에도 쓸모가 남아 있다고 덧붙인다. 논리적으로 일관된 BT를 만드는 능력이 뛰어나므로, GPT-4 대신 Llama-2-13B 같은 소형 fine-tuning 모델을 로컬에 두고 쓸 때 더 유용할 수 있다는 것이다.
소형 모델 fine-tuning
fine-tuning 대상은 Mistral-7B와 Llama2-13B-chat 두 오픈소스 모델이며, 파라미터 규모가 더 큰 경우를 보이려고 GPT-3.5도 함께 fine-tuning했다. 학습 데이터는 과제 유형별로 다른 곳에서 모았다. unit-tree 과제는 recursive generation 방법의 roll-out 기록에서, one-step 과제는 one-step generation 방법의 기록에서 가져왔다. 두 오픈소스 모델은 Llama-factory 프레임워크로 학습했다.
| 과제 유형 | 모델 | epoch | learning rate |
|---|---|---|---|
| unit tree | Mistral-7B, Llama2-13B-chat | 10 | 1 × 10⁻⁴ |
| one-step | Mistral-7B, Llama2-13B-chat | 15 | 5 × 10⁻⁵ |
| unit tree | GPT-3.5 | 3 | learning rate multiplier 0.05 |
| one-step | GPT-3.5 | 10 | learning rate multiplier 0.05 |
학습 후 성능은 furniture assembly benchmark의 의자와 램프 use case 데이터로 검증했다. 학습에 쓴 기어세트와 다른 과제에서 재는 구성이라, 측정값은 학습 과제의 재현이 아니라 전이 성능을 나타낸다.
| 과제 유형 | 모델 | fine-tuning | SR | LC | Exec | GD(초) | TC |
|---|---|---|---|---|---|---|---|
| Unit tree | GPT-4 | No | - | 10/10 | 10/10 | 14.45 | 2229.00 |
| Unit tree | GPT-3.5 | No | - | 10/10 | 10/10 | 6.07 | 2220.20 |
| Unit tree | GPT-3.5 | Yes | - | 10/10 | 10/10 | 6.17 | 2214.00 |
| Unit tree | Mistral-7B | No | - | 3/10 | 7/10 | 14.64 | 1993.00 |
| Unit tree | Mistral-7B | Yes | - | 9/10 | 10/10 | 14.35 | 1920.30 |
| Unit tree | Llama-13B-chat | No | - | 5/10 | 6/10 | 16.30 | 2142.80 |
| Unit tree | Llama-13B-chat | Yes | - | 9/10 | 10/10 | 17.56 | 1964.60 |
| One-step | GPT-4 | No | 9/10 | 10/10 | 10/10 | 45.48 | 4515.00 |
| One-step | GPT-3.5 | No | 1/10 | 1/10 | 2/10 | 11.30 | 4352.00 |
| One-step | GPT-3.5 | Yes | 1/10 | 1/10 | 9/10 | 10.79 | 4184.00 |
| One-step | Mistral-7B | No | 0/10 | 0/10 | 0/10 | 25.54 | 4139.40 |
| One-step | Mistral-7B | Yes | 0/10 | 0/10 | 8/10 | 24.60 | 4157.80 |
| One-step | Llama-13B-chat | No | 0/10 | 0/10 | 5/10 | 26.45 | 4227.30 |
| One-step | Llama-13B-chat | Yes | 1/10 | 1/10 | 9/10 | 25.72 | 4168.30 |
unit tree 과제의 성공률은 비워 뒀다. unit tree 생성 과제가 상태와 무관해 단독으로 평가할 수 없기 때문이다.
첫째, pre-training된 대형 모델이 복잡한 과제에서 소형 모델을 앞선다. GPT-4는 두 과제 유형의 모든 지표에서 우수하다. 반면 GPT-3.5, Llama-13B-chat, Mistral-7B는 unit tree 과제에서 좋은 결과를 내면서도 one-step 과제에서 크게 뒤진다. fine-tuning 전 GPT-3.5는 논리 일관성 1/10, 실행 가능성 2/10으로 GPT-4의 10/10과 차이가 크다. fine-tuning 전 Llama-13B-chat은 실행 가능성 5/10으로 Mistral-7B의 0/10보다 낫다.
둘째, fine-tuning은 구조적 출력 생성과 in-context learning 성능을 크게 높인다. unit tree 과제에서 Llama2-13B-chat과 Mistral-7B의 논리 일관성이 각각 5/10과 3/10에서 둘 다 9/10으로 올라갔고, 실행 가능성은 6/10과 7/10에서 둘 다 10/10이 됐다. one-step 과제에서도 실행 가능성이 각각 5/10에서 9/10으로, 0/10에서 8/10으로 올라갔다.
셋째, fine-tuning을 해도 소형 LLM은 추론이 필요한 복잡한 BT 생성 과제에서 부진하다. one-step 과제에서 Llama2-13B-chat, Mistral-7B, GPT-3.5는 fine-tuning 이후에도 논리 일관성이 0/10 또는 1/10에 머물렀다. 실행 가능성만 오르고 논리 일관성이 그대로라는 것은, 모델이 BT의 형식은 배웠지만 action 사이의 의존 관계는 여전히 못 푼다는 뜻이다. 저자들은 fine-tuning을 하지 않은 GPT-4가 모든 정확도 지표에서 거의 완벽했던 점을 근거로, 파라미터 규모의 한계와 one-step 과제 학습 데이터의 부족을 이유로 든다.
실제 로봇 검증
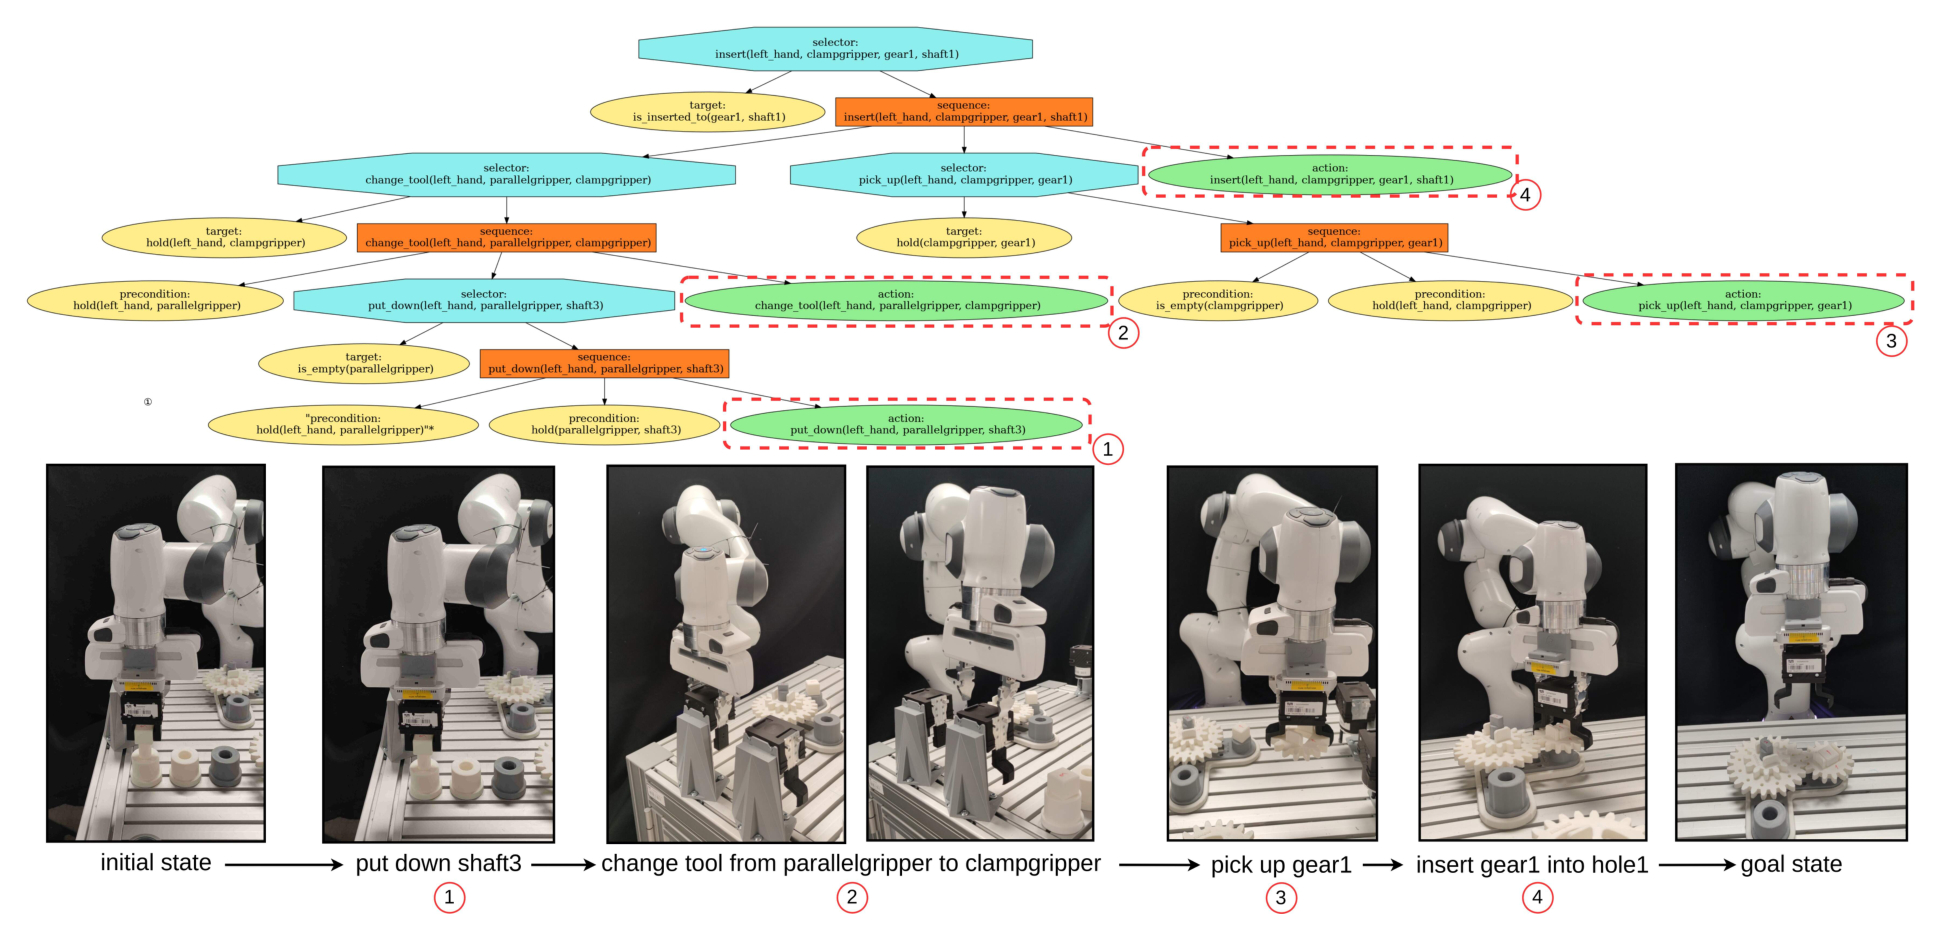
검증에는 human-in-the-loop 방법을 썼다. 성능이 가장 좋고 사람 피드백 덕분에 실험 진행이 수월하다는 이유다. 상류 subgoal은 insert gear1 into shaft1이며, 네 방법 어느 것으로도 BT를 만들 수 있다. 생성된 BT는 다음 action sequence와 같은 의미를 갖는다.
put_down(left_hand, parallelgripper, shaft3)change_tool(left_hand, parallelgripper, clampgripper)pick_up(left_hand, clampgripper, gear1)insert(left_hand, clampgripper, gear1, shaft1)
실행 순서는 precondition의 연쇄로 결정된다. 초기 상태에서 left_hand는 parallelgripper를 들고 있고 그 그리퍼가 shaft3을 쥐고 있다. precondition이 만족되어 action (1)이 먼저 실행되며 조건 is_empty(parallelgripper)를 만족시킨다. 이어서 action (2)가 도구를 parallelgripper에서 clampgripper로 바꿔 조건 hold(left_hand, clampgripper)를 만족시키고, 그 결과로 action (3)이 시작된다. 마지막으로 action (4)의 precondition인 hold(left_hand, clampgripper)와 hold(clampgripper, gear1)가 모두 만족되어 실행이 끝나면 계획 목표 is_inserted_to(gear1, shaft1)가 달성되고 BT가 SUCCESS를 반환한다.
즉 BT는 동작 순서를 직접 나열하지 않는다. 각 action에 precondition을 붙여 두면 실행 순서가 조건 충족 관계에서 저절로 결정된다. 이것이 BT를 계획 표현으로 쓰는 실질적 이점이다.
한계
논문이 밝힌 한계는 세 가지다.
첫째, recursive generation 방법은 자원 소비가 커서 추가 개선이 필요하다. 토큰 소비 50229.96은 one-step의 약 9.9배이고, 그 대가로 얻은 성공률은 13/17로 12/17보다 하나 많을 뿐이다.
둘째, fine-tuning은 파라미터가 적은 LLM의 BT 생성 추론 능력을 높이는 데 효과가 제한적이었다. 가능한 이유로 모델 파라미터 수의 한계와 학습 데이터 부족을 든다. 두 요인 중 어느 쪽이 지배적인지는 논문에서 분리하지 못했다.
셋째, 단계 수가 많은 task plan을 BT로 표현하는 것 자체가 어렵다. 깊게 중첩된 단계가 이어지면 node 사이에 충돌이 생길 수 있다는 점이 선행 연구에서 지적됐다. 저자들의 high-level 과제 분해가 subgoal마다 포함되는 단계 수를 줄여 이 문제를 어느 정도 완화했지만, 프레임워크를 더 넓게 적용하려면 추가 연구가 필요하다.
관련 연구의 위치
논문은 세 흐름 위에 자신을 놓는다.
| 흐름 | 대표 연구 | 남긴 한계 |
|---|---|---|
| 고전적 계획 | PDDL(McDermott 1998), Fast Downward(Helmert 2006), PDDLStream(Garrett 2020) | 상태 공간 복잡도의 지수적 증가, 도메인 지식 요구, open-loop plan |
| 로봇 분야의 Behavior Tree | blended reactive planning(Colledanchise 2019), BT 서베이(Iovino 2022), 유전 프로그래밍 기반 생성 | 사전 정의와 사전 프로그래밍 의존, 명시적으로 정의된 상황에만 반응 |
| LLM 기반 과제 계획 | ProgPrompt(Singh 2023), PaLM-E(Driess 2023), LLM-BT(Zhou 2024) | 생성물이 대부분 action sequence이며 BT 직접 생성 프레임워크가 없었다 |
프롬프트 기법 쪽으로는 chain-of-thought(Wei), Tree of Thoughts(Yao 2023), Skeleton-of-Thought(Ning 2024), Self-Instruct(Wang 2023)를 in-context learning의 근거로 인용한다. chain-of-thought는 답 전에 중간 추론을 텍스트로 펼치게 하는 기법이며, human-in-the-loop 방법의 bullet plan 단계가 이 계열의 발상을 따른다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| LLM-as-BT-Planner | 이 논문이 제안한 프레임워크. LLM을 BT 생성기로 두고 조립 과제 계획을 세운다 |
| unit tree | action 하나에 대응하는 최소 단위 BT. precondition condition node와 action node로 이뤄진다 |
| MakePlan / MakeTree / PredictState | recursive generation의 세 단계. 각각 action sequence 생성, subtree 생성, 실행 후 상태 예측을 맡는다 |
| bullet plan | human-in-the-loop 방법에서 sequential planner가 만드는 자연어 설명이 붙은 단계 목록 |
| semantic router | 사용자 입력과 예시 입력의 임베딩 거리로 워크플로 분기를 정하는 장치 |
| Logical Coherence (LC) | BT 내부 실행 순서가 precondition 위반 없이 대응 action sequence와 일치하는 정도 |
| Executability (Exec) | 생성된 BT가 규정 형식을 따라 실행될 수 있는 정도 |
관련 페이지
- Comparison between Behavior Trees and Finite State Machines: BT와 FSM을 mobile manipulation 과제에서 비교한 논문. 이 페이지가 전제로 삼는 "BT가 왜 계획 표현으로 알맞은가"를 정량적으로 다룬다
- From Dialogue to Execution: Mixture-of-Agents Assisted Interactive Planning for Behavior Tree-Based Long-Horizon Robot Execution: 대화에서 실행까지를 여러 agent로 잇는 로봇 시스템. 사람의 개입 지점을 설계 요소로 다룬다는 점이 human-in-the-loop 방법과 겹친다
- ASPIRE: Agentic /Skills Discovery for Robotics: 로봇 policy를 코딩 에이전트가 고쳐 쓰는 프로그램으로 두는 시스템. LLM이 실행 가능한 산출물을 직접 만든다는 발상이 같다
- 용어집: Physical AI (Terminology Glossary): Behavior Tree, action node, tick 등 이 페이지가 쓰는 용어의 canonical 표기