Physical AI · PAPER · 2026
ASPIRE: Agentic /Skills Discovery for Robotics
요약
ASPIRE는 코딩 에이전트가 로봇 제어 프로그램을 직접 작성하고 수정하면서, 검증을 통과한 수정을 skill library에 축적해 다음 과제로 넘기는 지속학습 시스템이다. NVIDIA GEAR가 UMich, UIUC, UC Berkeley, CMU와 함께 2026년 6월에 발표했다.
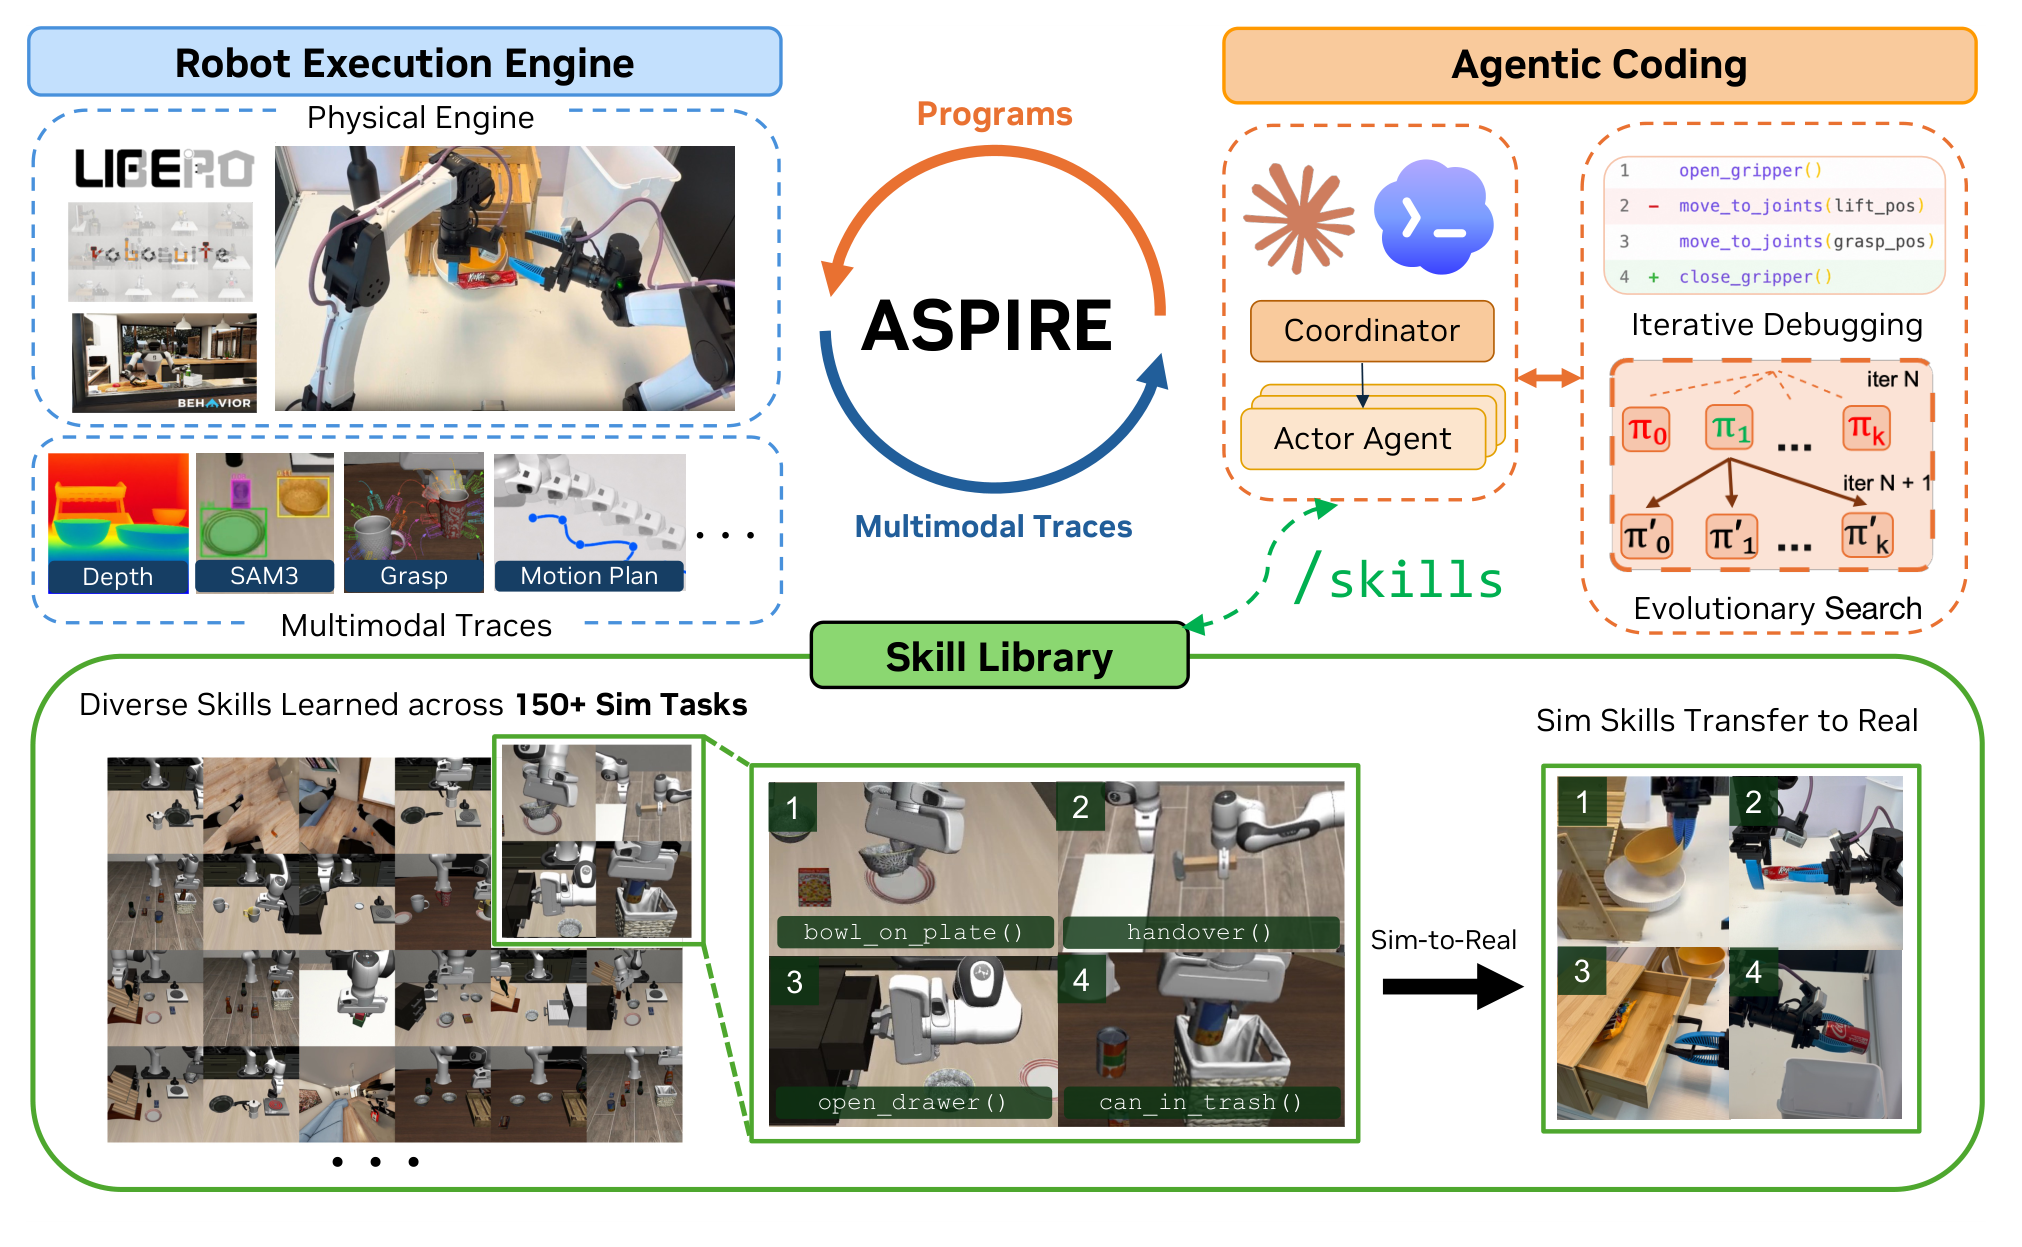
시스템은 세 가지 구성 요소로 이루어진다. 실행 엔진은 로봇 API 호출 하나하나에 대해 multimodal trace를 기록하고, skill library는 재사용 가능한 수정만 등재하며, evolutionary search는 한 회차에 여러 후보 프로그램을 병렬로 실행한다.
성능은 세 벤치마크 전부에서 이전 최고를 넘는다. LIBERO-Pro 종합 성공률은 72%로 이전 코딩 에이전트(18%)와 VLA(13% 이하)를 크게 앞선다. LIBERO-90에서 축적한 라이브러리만으로 미학습 long-horizon 과제에 31% zero-shot 성공하는데, 같은 조건에서 이전 방식은 4%에 그친다.
ASPIRE의 위치는 로봇 policy를 end-to-end로 학습시키는 VLA 노선의 정반대편이다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말하는데, ASPIRE는 그 policy를 신경망 가중치가 아니라 사람이 읽고 수정할 수 있는 Python 프로그램으로 표현한다. 따라서 학습 데이터를 늘리는 대신 디버깅 경험을 축적하는 방향으로 성능을 올린다.
배경
code-as-policy 계보의 미해결 문제
code-as-policy는 언어 모델이 perception, planning, control API를 조합해 실행 가능한 로봇 프로그램을 작성하게 하는 제어 방식이다. Code as Policies, ProgPrompt, VoxPoser, SayCan으로 이어지는 계보가 이미 형성돼 있다. 로봇의 행동이 프로그램으로 명시되므로 원리상 검사하고 편집하고 디버깅할 수 있다는 것이 이 노선의 장점이다.
논문이 지적하는 것은 그 장점이 실제로는 발휘되지 않는다는 점이다. 원인은 실행 환경이 과제 수준의 거친 피드백만 제공하기 때문이다.
피드백의 해상도가 낮으면 실패 원인을 좁힐 수 없다. rollout은 policy를 실행해 trajectory를 만들어내는 과정이고, trajectory는 observation과 action이 시간순으로 이어진 실행 기록이다. 실패한 rollout은 "과제를 완수하지 못했다"만 알려줄 뿐, perception이 틀렸는지 grasping이 불안정했는지 planning이 실패했는지 그 뒤의 복구가 무너졌는지를 구분해 주지 않는다. 즉 무엇을 들여다봐야 할지 모르는 에이전트는 수리 전략도 고를 수 없다.
경험이 과제 사이에 축적되지 않는 것이 두 번째 문제다. 과제 하나가 끝나면 그 과정에서 발견한 수정과 복구 전략이 폐기된다. 논문의 표현으로는 백 번째 과제를 푸는 에이전트가 첫 번째를 푸는 에이전트보다 조금도 더 유능하지 않다.
사람 엔지니어의 작업 방식
사람 로봇 엔지니어는 반대 방식으로 일한다. 프로그램이 실패하면 실행을 되감아 재생하고, perception 출력과 trajectory를 검사하며, 실패한 하위 시스템을 좁힌 다음 구현을 수정한다.
그 경험은 시간이 지나면서 이전 가능한 지식으로 굳는다. grasping 복구 요령, navigation 전략, 프롬프트 작성 레시피, 절차적 수정 패턴이 여기 해당한다. 논문은 사람 프로그래머가 시간이 갈수록 유능해지는 핵심 이유를 이 축적에서 찾고, 같은 축적을 에이전트에게 부여하는 것을 목표로 삼는다.
핵심 개념
primitive는 로봇 API가 노출하는 최소 실행 단위를 가리킨다. ASPIRE에서는 get_observation(), segment_text_prompt(rgb, text), plan_grasp(...), solve_ik(...), navigate_to_pose(...) 같은 perception과 planning과 control 함수 하나하나가 primitive다.
multimodal trace는 primitive 호출마다 남기는 실행 기록 묶음이다. 호출한 API 이름, 입력과 출력, 반환 상태에 더해 RGB 키프레임, 오버레이, grasping 후보, 물체 pose, motion planning 결과 같은 시각 증거가 함께 저장된다.
skill은 검증을 통과한 수정 지식 하나를 가리키는 단위다. 특정 과제의 완성된 프로그램이 아니라 "어떤 실패 신호가 보이면 어떤 수정을 적용하라"는 조건부 지식이며, 다음 과제의 에이전트에게 in-context guidance로 주입된다.
embodiment는 로봇의 물리적 형상과 그에 딸린 제어 API 구성을 뜻한다. 시뮬레이션의 Franka 단팔과 실제 기기의 양팔 YAM은 형상도 API도 다르므로, 둘 사이의 지식 이전이 cross-embodiment 전이다.
long-horizon 과제는 여러 단계를 순서대로 이어야 끝나는 긴 과제를 말한다. BEHAVIOR-1K의 "이동한 뒤 라디오 집기"나 LIBERO-Pro Long의 조합 과제가 여기 속한다.
방법
coordinator와 actor 구조
ASPIRE는 중앙의 coordinator 하나와 과제별 actor 여러 개로 구성된다. coordinator는 공유 skill library를 관리하면서 과제마다 actor 코딩 에이전트를 하나씩 배정하고, actor는 자기 과제 안에서 프로그램을 작성하고 실행하고 진단하고 수정한다.
actor끼리는 대화 기록이나 원본 rollout trajectory를 주고받지 않는다. 이전 가능한 경험은 오직 skill library를 거쳐 흐른다. 따라서 각 actor는 과제 명세와 현재 프로그램, 지금 실패와 관련된 trace에만 context window를 사용한다. context window는 모델이 한 번에 받아들일 수 있는 토큰 길이 한도를 뜻한다.
세 구성 요소가 맡는 역할은 다음과 같이 나뉜다.
| 구성 요소 | 역할 | 해결하는 문제 |
|---|---|---|
| robot execution engine | primitive 호출마다 multimodal trace를 기록하고, 에이전트가 작성한 수정을 closed-loop로 재실행해 검증한다 | 과제 수준의 거친 피드백 |
| skill library | 검증을 통과한 수정만 실패 시그니처와 적용 조건과 수정 전략 형태로 축적해 다음 actor에게 제공한다 | 과제 사이 경험 소실 |
| evolutionary search | 회차마다 서로 다른 가설을 담은 후보 프로그램 K개를 동시에 실행하고, 성적 좋은 후보와 남은 실패 trace로 다음 회차를 조건짓는다 | 국소 수리 루프 고착 |
robot execution engine
기존 방식은 사람이 미리 설계한 인터페이스로 실행 증거를 노출했다. 장면 요약을 손으로 큐레이션하거나 observation 집합을 고정해 두는 방식이 대표적이다.
이 설계에는 트레이드오프가 있다. 증거가 너무 적으면 실패한 primitive가 가려지고, 반대로 원본 영상을 통째로 제공하면 실패를 만든 인과의 사슬에서 주의가 흩어진다.
ASPIRE는 이 고정 피드백 채널을 열린 디버깅 환경으로 바꾼다. 실행 엔진은 primitive 호출마다 trace를 기록해 두고 에이전트가 필요한 부분만 골라 읽게 한다. 전체 프레임을 넘기지는 않으며, 호출 직전과 직후 프레임을 대응 오버레이와 반환값에 묶어 보관해 문제 되는 호출 주변만 검사할 수 있게 한다.
trace는 JSON 레코드로 남고 한 레코드에 호출 순번(step), 함수명, 인자, 소요 시간(duration_ms), 결과 요약, 키프레임 저장 여부가 들어간다. 예를 들어 segment_text_prompt 호출 결과에는 검출된 mask 개수와 최상위 mask의 점수, 경계 상자, 면적 비율이 기록된다.
에이전트가 trace를 읽는 방법은 부록 E.3에 규칙으로 정리돼 있다. 수치 신호를 실패 원인으로 옮기는 해석 규칙이 함께 제공된다.
| trace 신호 | 해석 |
|---|---|
| 그리퍼 폐합 후 폭이 크다 | 물체를 제대로 잡았을 가능성이 높다 |
| 그리퍼 폐합 후 폭이 중간이다 | 불안정한 grasping이다 |
| 그리퍼 폐합 후 폭이 작다 | 허공을 잡았을 가능성이 높다 |
| mask 개수가 0이다 | perception prompt가 부적절하거나 물체가 가려졌다 |
| IK 해가 없다 | 목표가 도달 가능한 작업공간 바깥이다 |
| 초기 단계에서 중단됐다 | 표준 출력과 오류 로그 요약을 먼저 확인한다 |
trace 기반 디버깅 사례
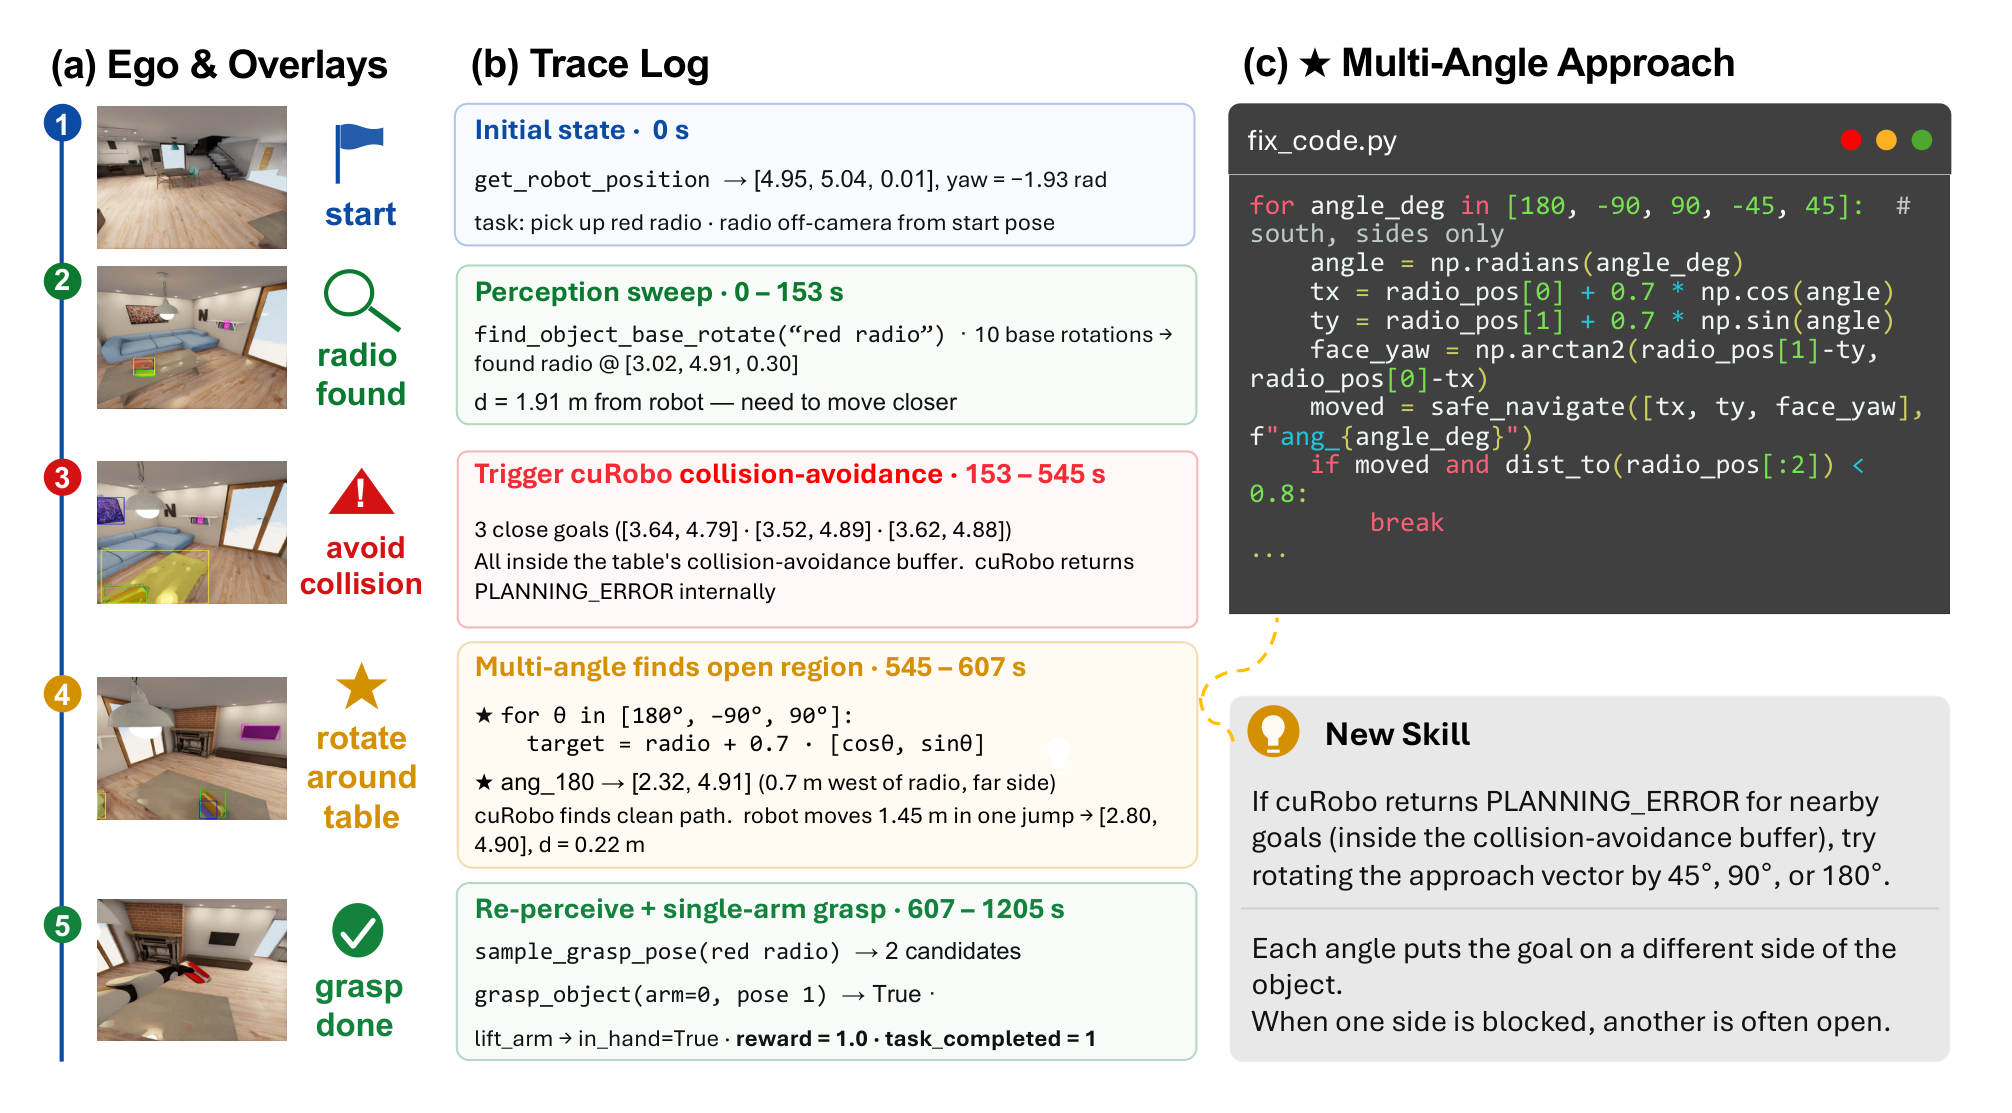
BEHAVIOR-1K의 라디오 집기 과제가 이 구조의 쓰임새를 보여준다. ego-view 키프레임을 보면 로봇이 라디오를 찾은 뒤 접근을 반복해서 실패하다가 방향을 바꾸고 나서야 성공한다.
trace는 원인을 정확히 지목한다. perception은 성공해 라디오 pose를 반환하는데 navigate_to_pose 호출이 계속 PLANNING_ERROR를 낸다. 반환값과 로그를 검토한 에이전트는 생성된 navigation 목표가 테이블 경계에서 약 20cm 안쪽이라 충돌 회피가 발동한다는 사실을 찾아낸다.
즉 실패 원인은 perception도 grasping도 아니고, 목표 pose 자체가 테이블의 충돌 제약 아래에서 실현 불가능했다는 데 있다. 수정은 진단에서 곧바로 따라 나온다. 에이전트는 라디오 주변에 대안 navigation 목표를 뿌리고 충돌 버퍼를 벗어나는 접근 방향을 고르는 루틴을 작성한다.
skill library
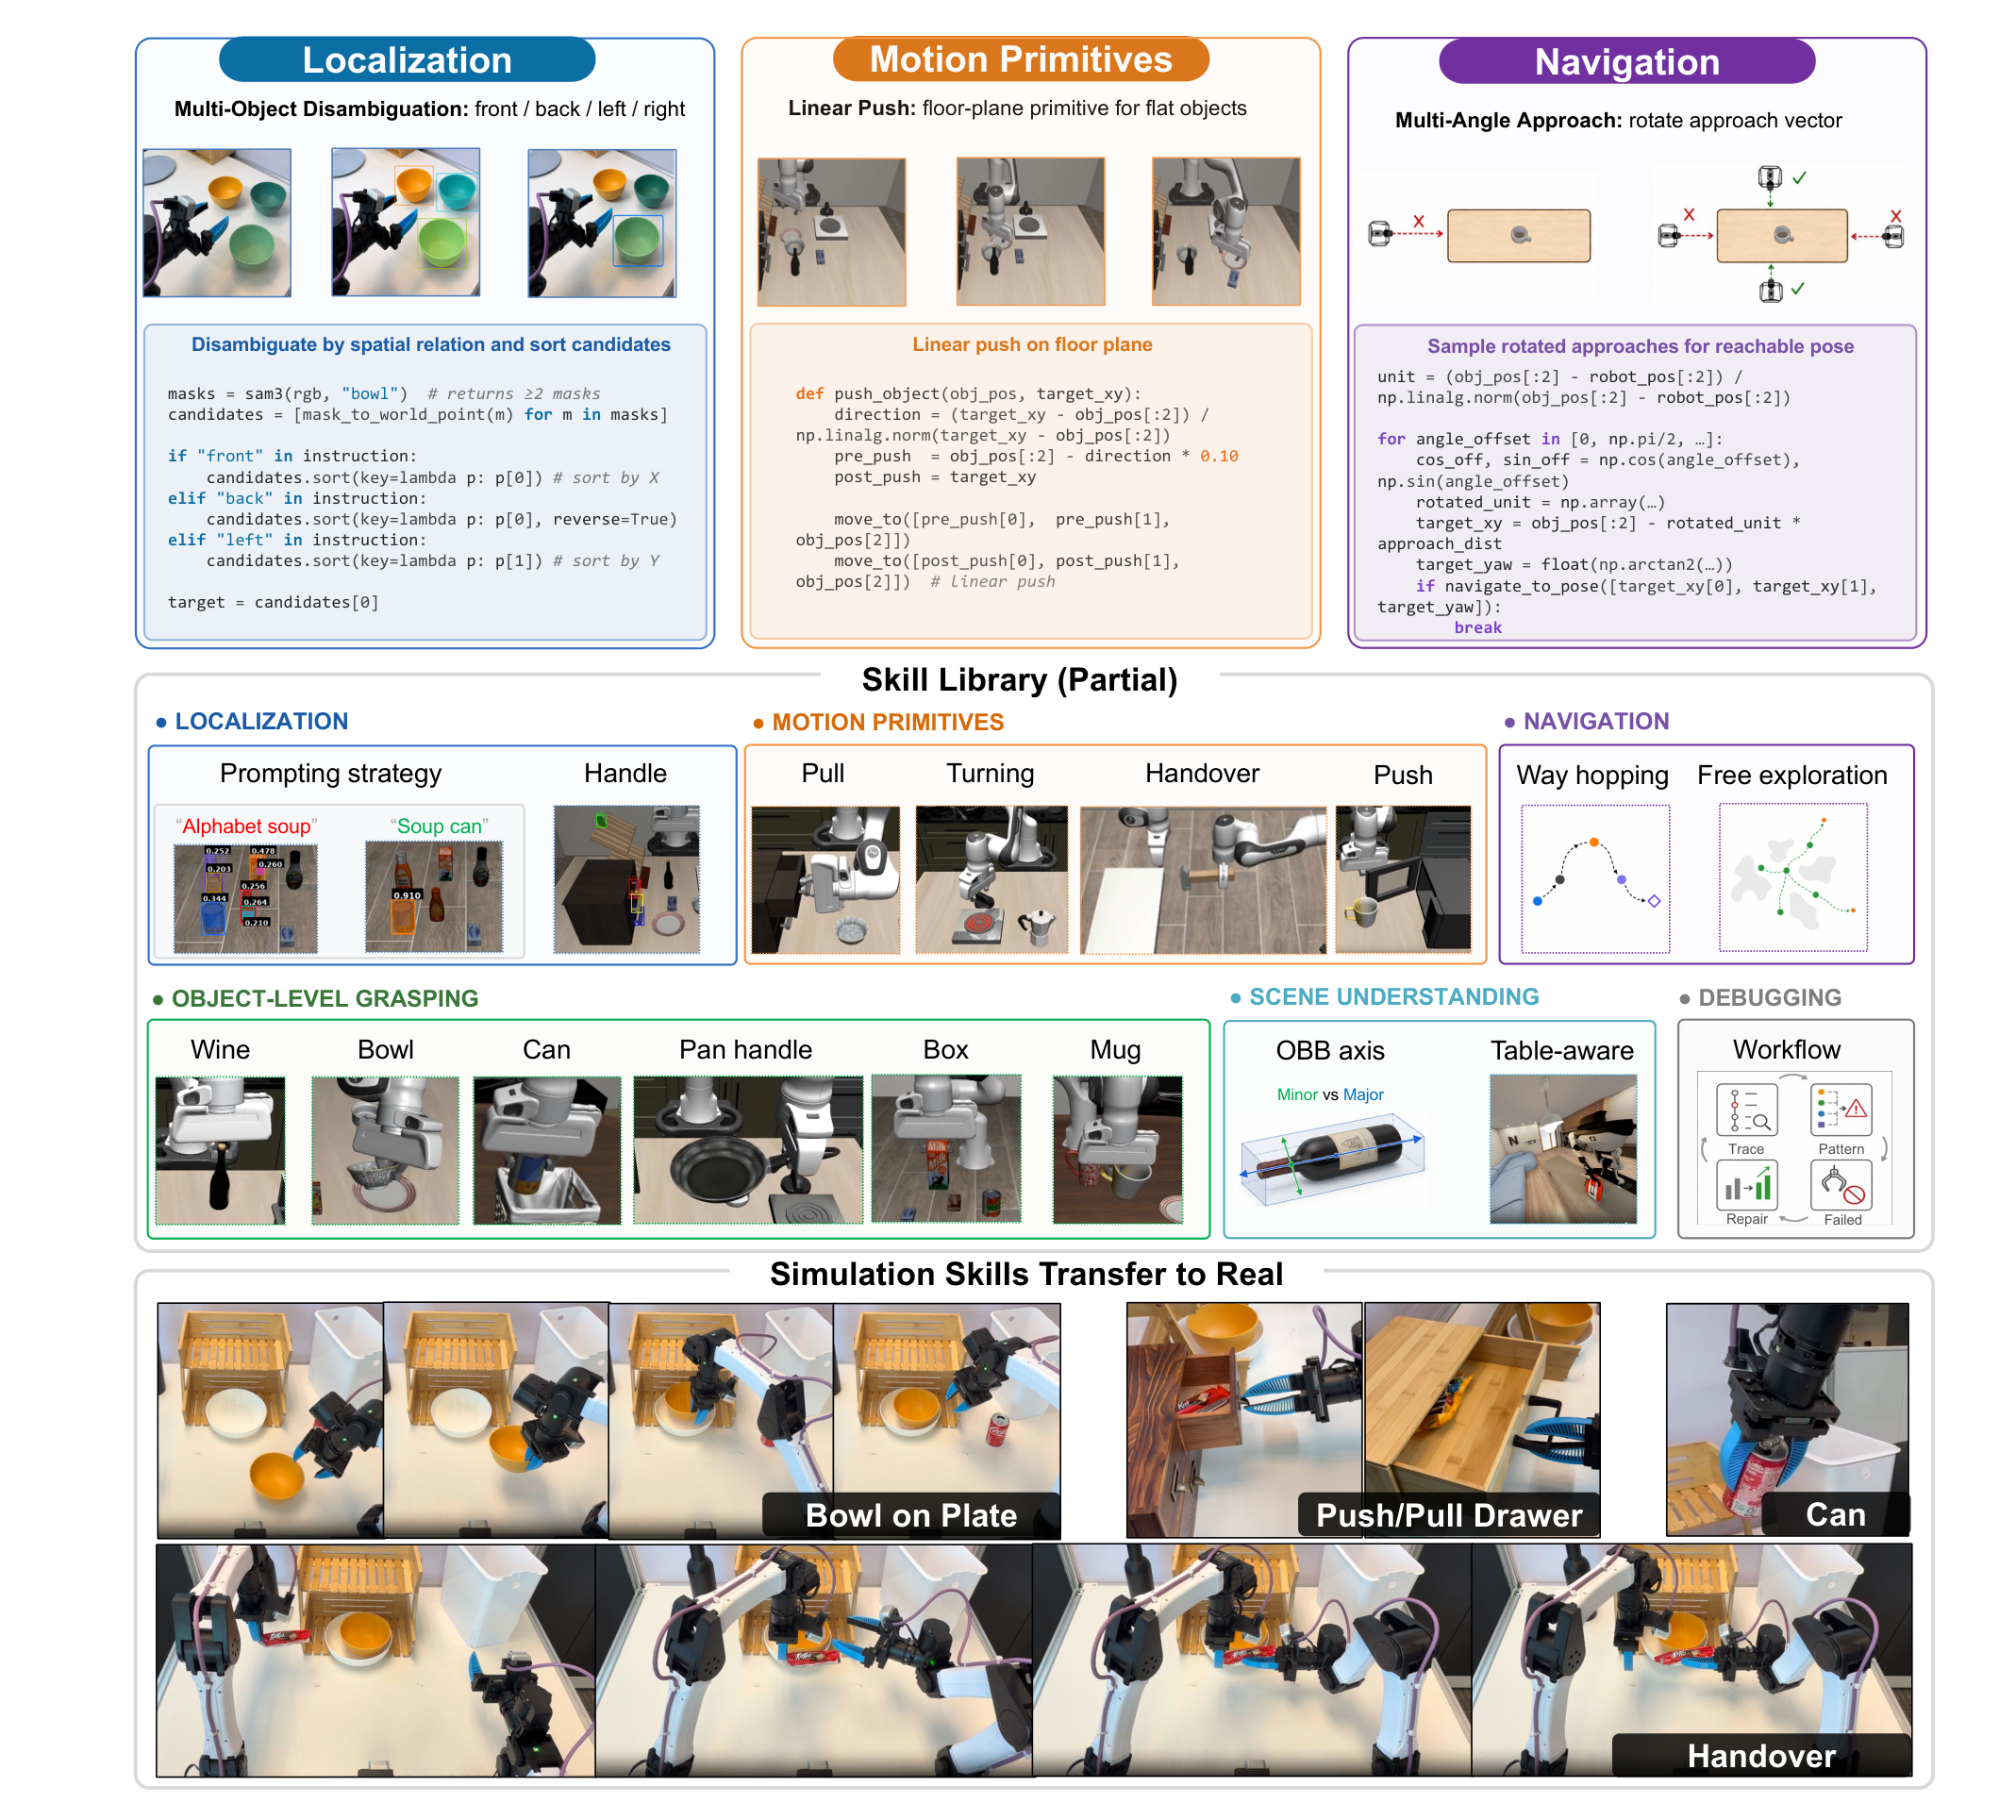
과제 사이에서 되풀이되는 것은 프로그램 전체가 아니라 그 안의 수정 패턴이다. 따라서 라이브러리에 저장되는 것도 완성된 과제 프로그램이 아니라 조건부 수정 지식이다.
앞의 라디오 과제에서 등재된 항목도 "라디오 집기 프로그램"이 아니라 navigation 복구 패턴이다. 장애물 경계 근처에서 planner 오류가 반복되면 표본 pose가 충돌 버퍼 안에 들어갔을 수 있으니, perception과 grasping을 다시 시도하기 전에 물체 주위의 대안 접근 방향부터 확인하라는 내용이다. 이 정도로 추상화해 두어야 zero-shot 전이와 cross-embodiment 전이가 둘 다 가능해진다.
항목 하나는 네 부분으로 구성된다.
| 구성 | 내용 |
|---|---|
| problem | 등재를 촉발한 실패 trace에서 추출한 문제 서술 |
| when-to-apply | 언제 이 항목을 꺼내 쓸지 정하는 상황 조건 |
| repair | 검증을 통과한 수정 전략과 대표 코드 스케치 |
| origin task | 이 항목을 만들어낸 원 과제 |
범주는 미리 정해두지 않았고 검증된 수정에서 귀납된다. 결과적으로 여섯 범주가 형성됐으며, 부록 A가 각 범주의 대표 항목을 공개한다.
| 범주 | 대표 항목 | 문제 | 수정 전략 |
|---|---|---|---|
| debugging | Failure Pattern | 한 번의 실패는 잡음이라 단일 시행에 과적합된 수정이 나온다 | 시행들을 (증상, 적용 조건) 쌍으로 묶고 2회 이상 반복된 쌍만 등재 후보로 올린다 |
| localization | Multi-Object Disambiguation | SAM3는 "front bowl" 같은 공간 수식어를 이해하지 못하고 그릇을 전부 반환한다 | 수식어가 가리키는 축으로 후보를 정렬한다. front와 back은 X축, left와 right는 Y축 기준이다 |
| navigation | Multi-Angle Approach | 직선 접근이 PLANNING_ERROR를 내고 planner가 먼 waypoint로 되돌아간다 | 접근 벡터를 직진, ±90도, ±45도의 5개 방향으로 돌려 첫 성공을 채택한다 |
| grasping | Bottle | 와인병처럼 세로로 긴 원통은 그리퍼 yaw가 임의면 폐합 중 넘어진다 | OBB 장축에 yaw를 맞춰 지름 방향으로 물고, 50%와 70%의 2단 폐합 뒤 천천히 들어 올린다 |
| motion primitive | Linear Push | 높이 2cm 미만 납작한 물체는 그리퍼가 아래로 들어가지 못한다 | 집는 대신 바닥면을 따라 미는 2차원 이동으로 바꾼다 |
| scene reasoning | OBB Axis Semantics | 길쭉한 물체는 잘못된 축으로 잡으면 기울거나 떨어진다 | OBB를 계산해 원통형은 장축, 납작한 물체는 단축에 yaw를 맞춘다 |
등재 심사는 coordinator가 맡는다. actor는 실패 모드, 검증된 수정, 이전 가능성이 있는 패턴, 과제 고유의 특이점, 디버그 설정에서 낸 성공률을 findings.md라는 구조화된 형식으로 보고한다.
coordinator는 이 보고를 감사해 허용 API 규정을 지켰는지 확인하고, 디버그 검증을 통과한 재사용 가능 수정만 공유 라이브러리에 올린다. 라이브러리 쓰기를 coordinator가 직렬화하므로 병렬 actor끼리 충돌하지 않는다.
evolutionary search
trace 기반 디버깅만으로는 국소 수리 루프에 빠질 수 있다. 근본적으로 다른 접근을 찾는 대신 같은 실패 전략을 계속 땜질하는 상태를 말한다.
evolutionary search는 회차마다 코딩 에이전트가 skill library를 참조해 후보 프로그램 K개를 제안하게 한다. 조건으로 주어지는 것은 직전까지 성적이 가장 좋았던 프로그램 3개와 그 실패 trace다.
각 후보를 실행 엔진에 태우면 과제 결과와 새 진단 trace가 나온다. 다음 회차는 최고 성적 프로그램과 거기 남은 실패 모드를 함께 조건으로 받는다. 따라서 같은 해법을 반복해 다듬는 대신 구별되는 전략을 탐색하게 된다.
Algorithm 1이 규정하는 절차는 다음과 같다.
| 단계 | 내용 |
|---|---|
| 입력 | 과제 τ, 초기 프로그램 P0, 디버그 seed 집합과 검증 seed 집합, skill library, 에이전트, 예산 (K, T), 임계값 θ |
| 회차 반복 | 상위 3개 프로그램과 라이브러리와 이력을 조건으로 후보 K개 생성 후 디버그 seed에서 각각 실행 |
| 갱신 | 최고 점수 후보가 기존 최고를 넘으면 교체하고, 최고 점수가 θ 이상이면 즉시 종료 |
| 종료 | 후보 하나가 디버그 설정을 해결하거나 탐색 예산 T가 소진되면 끝난다 |
| 사후 처리 | 확정된 최고 프로그램을 검증 seed에서 한 번 실행하고, 일반화된 수정 패턴만 추출해 라이브러리에 등재한다 |
후보 작성에는 다양성 제약이 걸린다. 각 후보는 서로 다른 가설을 시험해야 하고, 두 후보가 같은 단계에서 같은 이유로 실패해서는 안 된다. 후보 코드의 docstring에는 어떤 가설을 시험하는지, 앞선 후보와 무엇이 다른지, 가설이 틀렸을 때 예상되는 실패 모드가 무엇인지를 적는다.
과적합 방지 규칙도 명시돼 있다. 디버그 seed의 실패에 맞춰 임계값이나 이미지 영역 mask나 오프셋을 하드코딩하지 말고, 원리로 설명되는 전략을 우선하라는 내용이다. 디버그 seed는 표본이 작아 대표성이 부족할 수 있고 실제 채점은 미학습 seed에서 이뤄지기 때문이다.
회차를 잇는 지속 문서
회차 사이를 잇는 것은 task_analysis.md라는 지속 문서다. 부록 E.4에 따르면 이 문서는 세 부분으로 이루어진다.
- 과제별 장면 기술. 초기 스냅샷에서 한 번 채우며 물체 형상, 목표 기하, 장애물, 막힌 접근 방향이 들어간다.
- 진행 중인 가설과 그 가설을 시험하는 후보의 메타데이터.
- 배제된 방향의 대장. 테스트로 걸러낸 방향과 작업공간 제약 탓에 시도조차 못 한 방향을 나눠 적는다.
배제 사유를 둘로 나눈 것이 이 문서의 핵심 설계다. 테스트로 걸러낸 방향은 다시 들추지 않지만, 작업공간 제약으로 막혀 있던 방향은 손목 회전 같은 새 기법이 생기면 재시도할 수 있기 때문이다.
에이전트 스캐폴딩과 실험 규약
부록 E는 ASPIRE가 사용한 에이전트 설정을 거의 그대로 공개한다. Claude Code 기반이며 CLAUDE.md를 프로젝트 헌법으로, .claude/memory/MEMORY.md를 세션 시작 시 읽는 메모리로, .claude/skills/<name>/SKILL.md를 자동 발견되는 스킬로 둔다.
가장 두드러진 규약은 금지 API 목록이다. 판단 기준은 단순한데, 카메라를 단 실제 로봇이 할 수 있으면 허용하고 물리 엔진 내부 상태를 읽으면 금지한다.
| 구분 | 대상 | 사유 |
|---|---|---|
| 금지 | 시뮬레이터 객체 접근(env.handle.env.sim), 물체 위치 정답값(sim.data.body_xpos) |
실제 로봇에서 얻을 수 없는 정보다 |
| 금지 | 자산 파일(.bddl, .xml, .urdf) 읽기로 기하나 성공 조건 추론 |
같은 이유로 전이되지 않는다 |
| 허용 | get_observation(), segment_text_prompt, plan_grasp, solve_ik, 모션 실행과 기하 유틸리티 |
observation에서 유도되는 정보다 |
논문은 이 규약을 어기면 벤치마크 결과 자체가 무효라고 명시한다.
평가 seed 격리도 같은 성격의 규약이다. Stage 1 디버깅은 디버그 seed만 재생하고, held-out 검증 seed는 수정 프로그램(fix_code.py)이 확정된 뒤 Stage 2에서 정확히 한 번만 실행한다. seed당 재생 시도는 3회로 제한하며 초과하면 BLOCKED.md를 기록하고 넘어간다.
병렬 실행 규약은 자원 단위로 정해져 있다. 과제 하나에 서브에이전트 하나와 연산 장치 하나를 배정하고, coordinator는 직접 디버깅하지 않고 배정한 뒤 대기하며, 완료 알림이 오면 비워진 장치에 다음 과제를 배정한다.
결과
실험 설정
시뮬레이션 벤치마크 전부에서 코딩 에이전트는 Claude Code에 Claude Opus 4.6을 결합한 구성이고 context window는 1M 토큰이다. 에이전트가 작성하는 프로그램은 CaP-X 위에서 실행되는 Python 코드다. CaP-X는 MuJoCo Playground를 토대로 한 오픈소스 code-as-policy 프레임워크이며 perception, 기하, motion planning API가 딸려 있다. 에이전트와 환경과 API 집합은 전 실험에서 고정했다.
실제 로봇 전이 실험만 구성이 다르다. OpenAI Codex GPT-5.5를 reasoning-xhigh 모드로 쓰고 양팔 YAM 조작 스테이션에서 실행한다. Franka 기반 시뮬레이션에서 ASPIRE가 발견한 3개 skill을 in-context guidance로 제공하는데, 캔 집기와 그릇을 접시에 놓기와 서랍 밀고 당기기다.
벤치마크 세 종류는 서로 다른 능력을 잰다.
| 벤치마크 | 측정 대상 | 학습 seed | 평가 seed |
|---|---|---|---|
| LIBERO-Pro | 물체와 목표와 공간 교란에 대한 단기 강건성 | 51~65 | 1~50 (suite와 교란 조건마다 10개 과제) |
| Robosuite | 접촉이 많은 단팔과 양팔 manipulation | 101~125 | 1~100 (과제당 100회) |
| BEHAVIOR-1K | 절차적으로 생성한 배치에서의 long-horizon 가사 이동 manipulation | 26~35 | 1~25 |
주 베이스라인은 CaP-X에 딸린 코딩 에이전트 CaP-Agent0이고, end-to-end VLA로는 OpenVLA와 π₀와 π₀.₅를 함께 비교한다.
두 방식의 평가 규약은 대칭이 아니다. ASPIRE는 과제당 프로그램 하나를 생성해 held-out seed 전체에 그대로 실행하는 반면, CaP-Agent0는 seed마다 프로그램을 새로 만들고 실행 시점 추론과 재시도까지 쓴다. 따라서 ASPIRE 쪽이 더 불리한 조건에서 측정된 수치다.
LIBERO-Pro
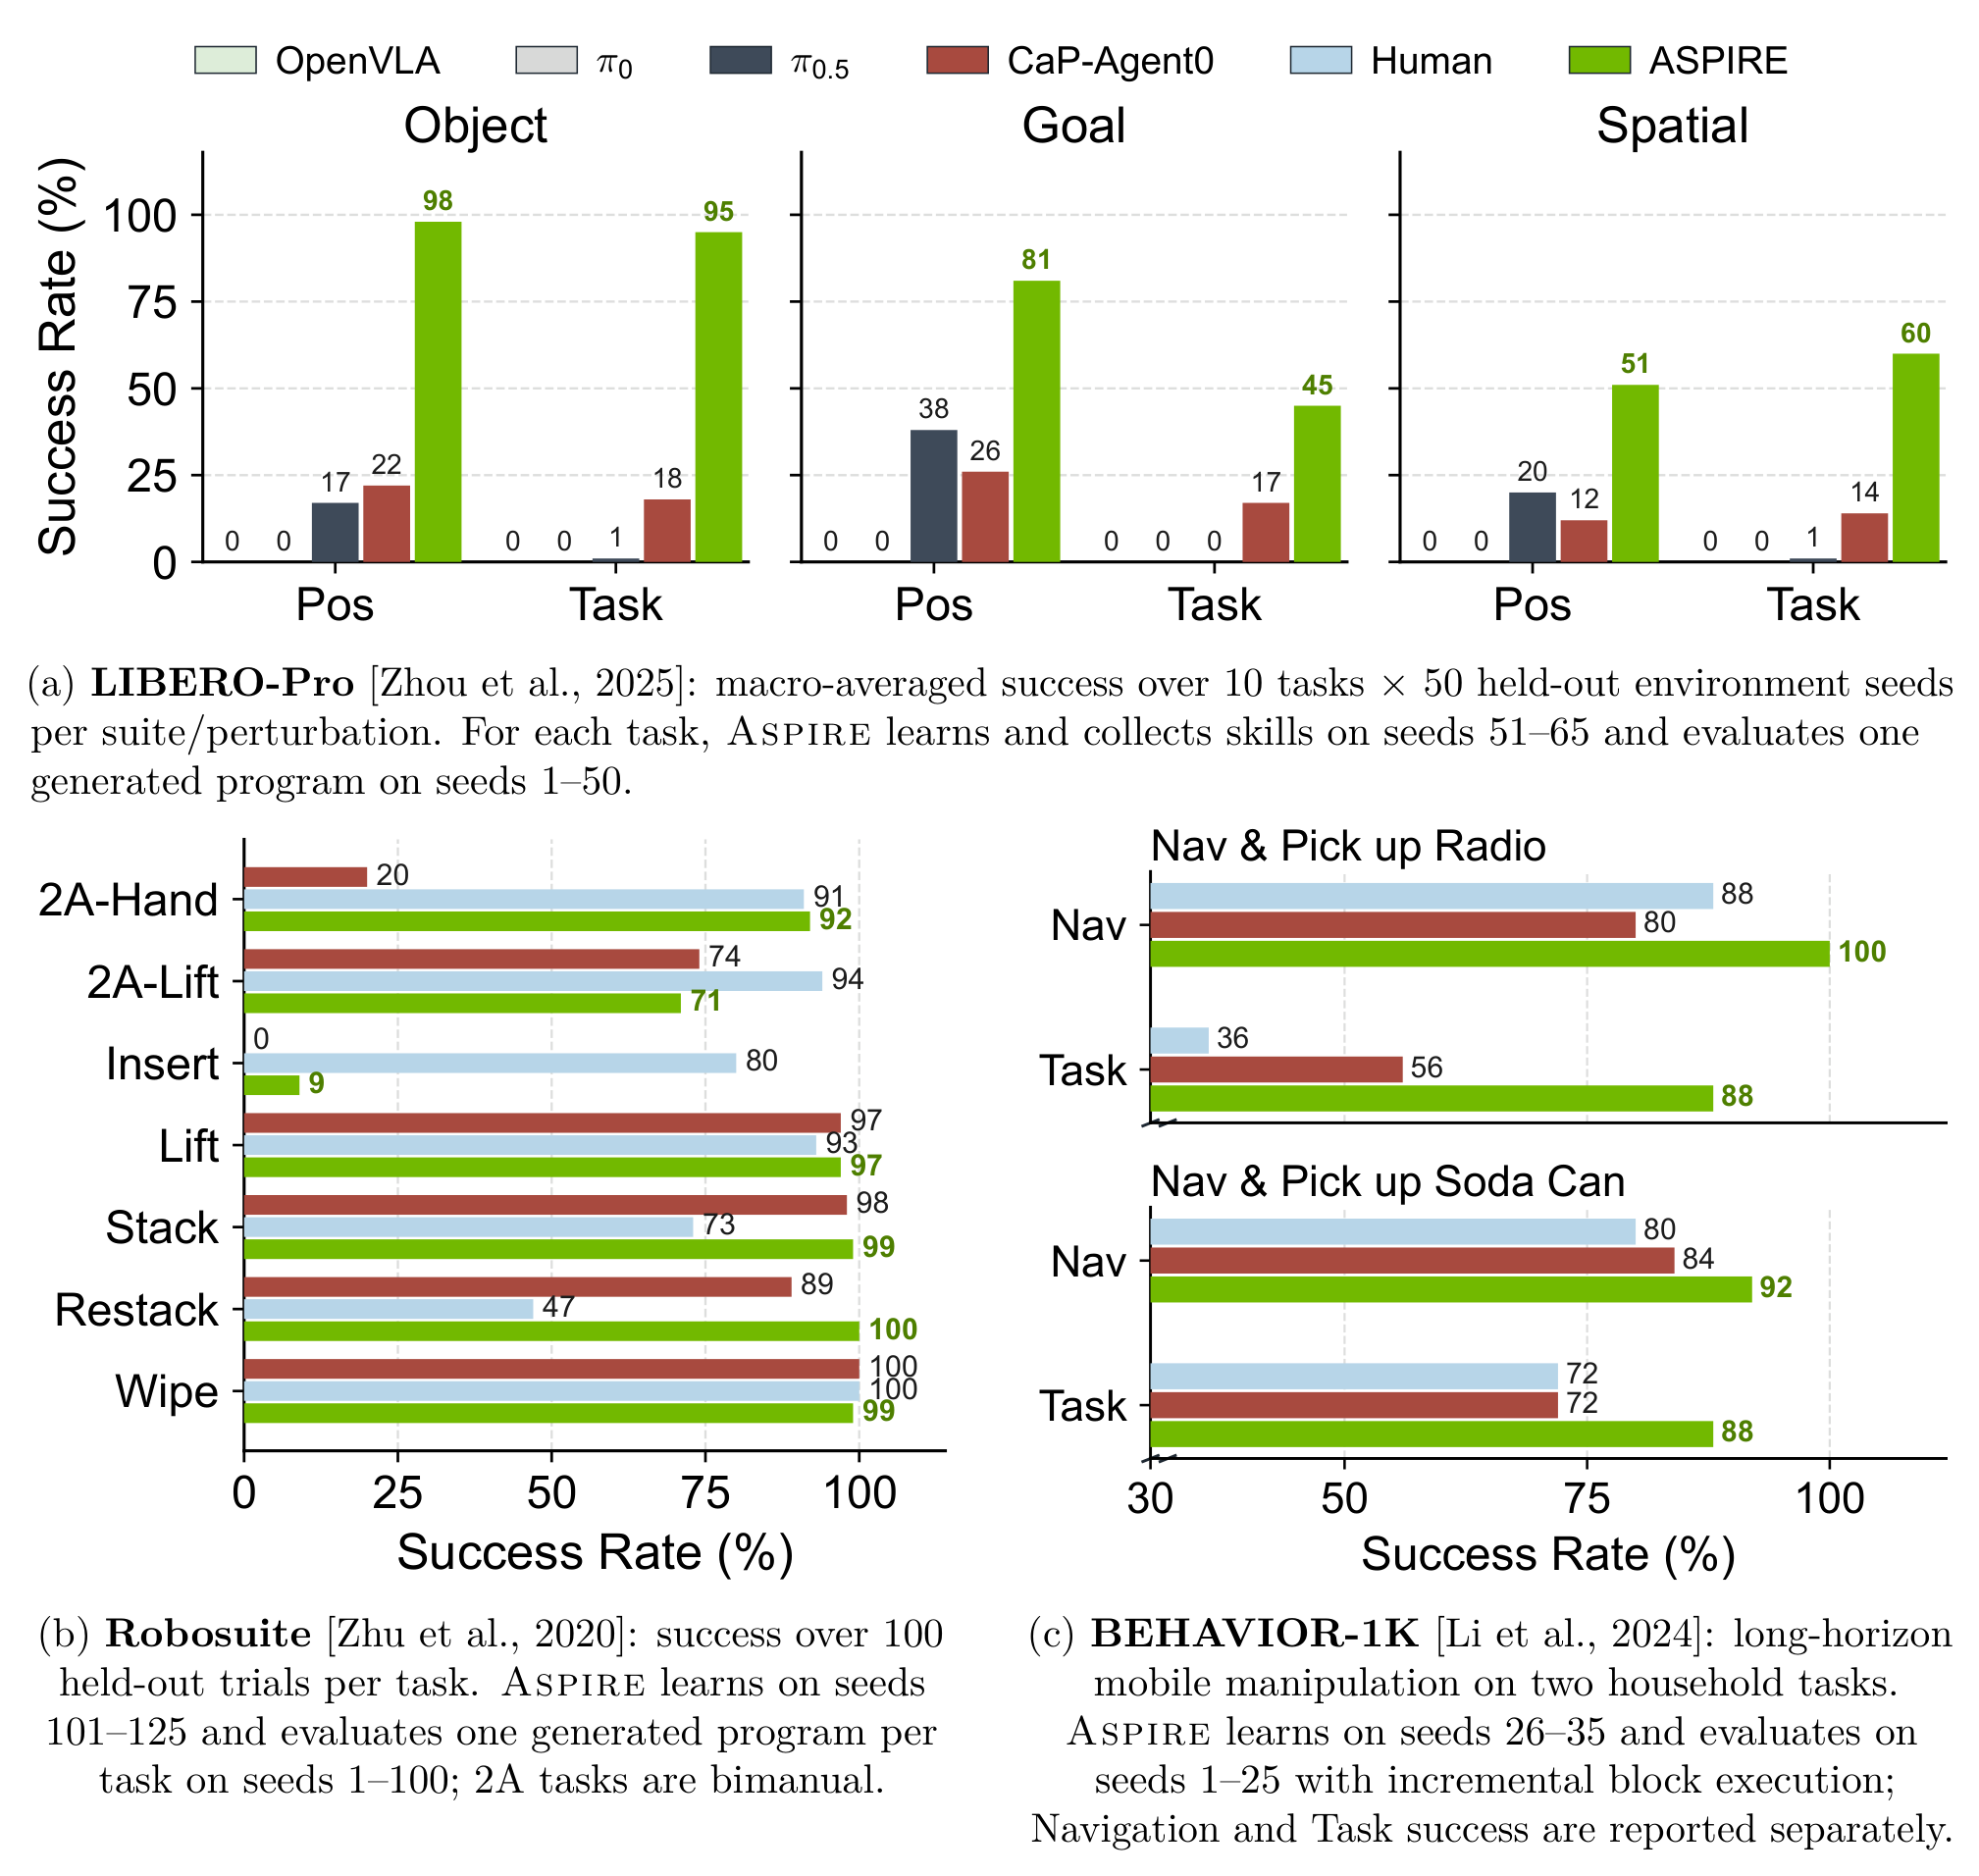
LIBERO-Pro는 LIBERO를 물체, 목표, 공간, 지시문 교란으로 확장해 암기가 아닌 강건성을 재는 벤치마크다. Pos는 초기 위치를 흔든 조건, Task는 지시문(instruction)을 바꿔 쓴 조건이다.
| 방법 | object Pos | object Task | goal Pos | goal Task | spatial Pos | spatial Task | 종합 Pos | 종합 Task | 전체 |
|---|---|---|---|---|---|---|---|---|---|
| OpenVLA | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% |
| π₀ | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% |
| π₀.₅ | 17% | 1% | 38% | 0% | 20% | 1% | 25% | 1% | 13% |
| CaP-Agent0 | 22% | 18% | 26% | 17% | 12% | 14% | 20% | 16% | 18% |
| ASPIRE | 98% | 95% | 81% | 45% | 51% | 60% | 77% | 67% | 72% |
ASPIRE는 세 suite 전부에서 모든 베이스라인을 앞선다. Pos와 Task를 평균하면 각 suite에서 가장 강한 베이스라인 대비 object 77%p, goal 41.5%p, spatial 42.5%p를 더 올린다.
end-to-end VLA의 성적이 특히 낮다. OpenVLA와 π₀는 전 항목 0%인데, 이는 학습 시점의 배치를 벗어나면 실행 자체가 성립하지 않는다는 뜻이다. π₀.₅는 일부 위치 교란에서 두 모델보다 낫지만 지시문을 바꿔 쓰면 1%까지 하락한다.
suite별 난이도 차이도 뚜렷하다. object suite에서는 ASPIRE가 두 조건 모두 95% 이상인 반면 spatial suite에서는 51%와 60%에 머문다. 공간 관계를 정확히 해석해야 하는 과제가 여전히 어렵다는 뜻이다.
Robosuite
Robosuite에서는 평균 성공률이 68%에서 81%로 오른다. 다만 과제별로 보면 개선이 균등하지 않다.
| 과제 | CaP-Agent0 | ASPIRE | 변화 |
|---|---|---|---|
| cube_lift | 97% | 97% | 유지 |
| cube_stack | 98% | 99% | +1%p |
| cube_restack | 89% | 100% | +11%p |
| spill_wipe | 100% | 99% | -1%p |
| two_arm_handover | 20% | 92% | +72%p |
| two_arm_lift | 74% | 71% | -3%p |
| nut_assembly | 0% | 9% | +9%p |
| 평균 | 68% | 81% | +13%p |
개선폭의 대부분은 양팔 handover 하나에서 나온다. 20%에서 92%로 72%p 올라 이 벤치마크에서 가장 큰 상승을 기록한다.
이미 포화 상태인 과제에서는 유지에 가깝고 일부는 미세하게 내려간다. two_arm_lift가 74%에서 71%로, spill_wipe가 100%에서 99%로 하락한다. nut_assembly는 0%에서 9%로 올랐지만 여전히 낮아 정밀 삽입 계열이 남은 난제임을 보여준다.
BEHAVIOR-1K
BEHAVIOR-1K는 1,000개 일상 활동을 담은 체화 AI 벤치마크이고, 이 논문은 그중 이동 후 캔 집기와 이동 후 라디오 집기 두 과제를 쓴다. navigation 성공률과 과제 성공률을 따로 보고한다.
| 과제 | Human Nav | Human Task | CaP-Agent0 Nav | CaP-Agent0 Task | ASPIRE Nav | ASPIRE Task |
|---|---|---|---|---|---|---|
| 캔 집기 | 80% | 72% | 84% | 72% | 92% | 88% |
| 라디오 집기 | 88% | 36% | 80% | 56% | 100% | 88% |
ASPIRE는 사람이 작성한 프로그램과 CaP-Agent0를 navigation과 과제 성공 양쪽에서 모두 넘는다. 가장 큰 개선은 라디오 집기의 과제 성공률로 CaP-Agent0의 56%에서 88%로 32%p 오른다.
라디오 집기의 사람 성적은 36%로 세 방식 중 가장 낮다. 이 과제는 테이블 경계의 충돌 버퍼 때문에 직선 접근이 실패하는 구조인데, 앞서 본 Multi-Angle Approach가 정확히 그 문제를 겨냥한 수정이다.
미학습 과제 zero-shot 전이
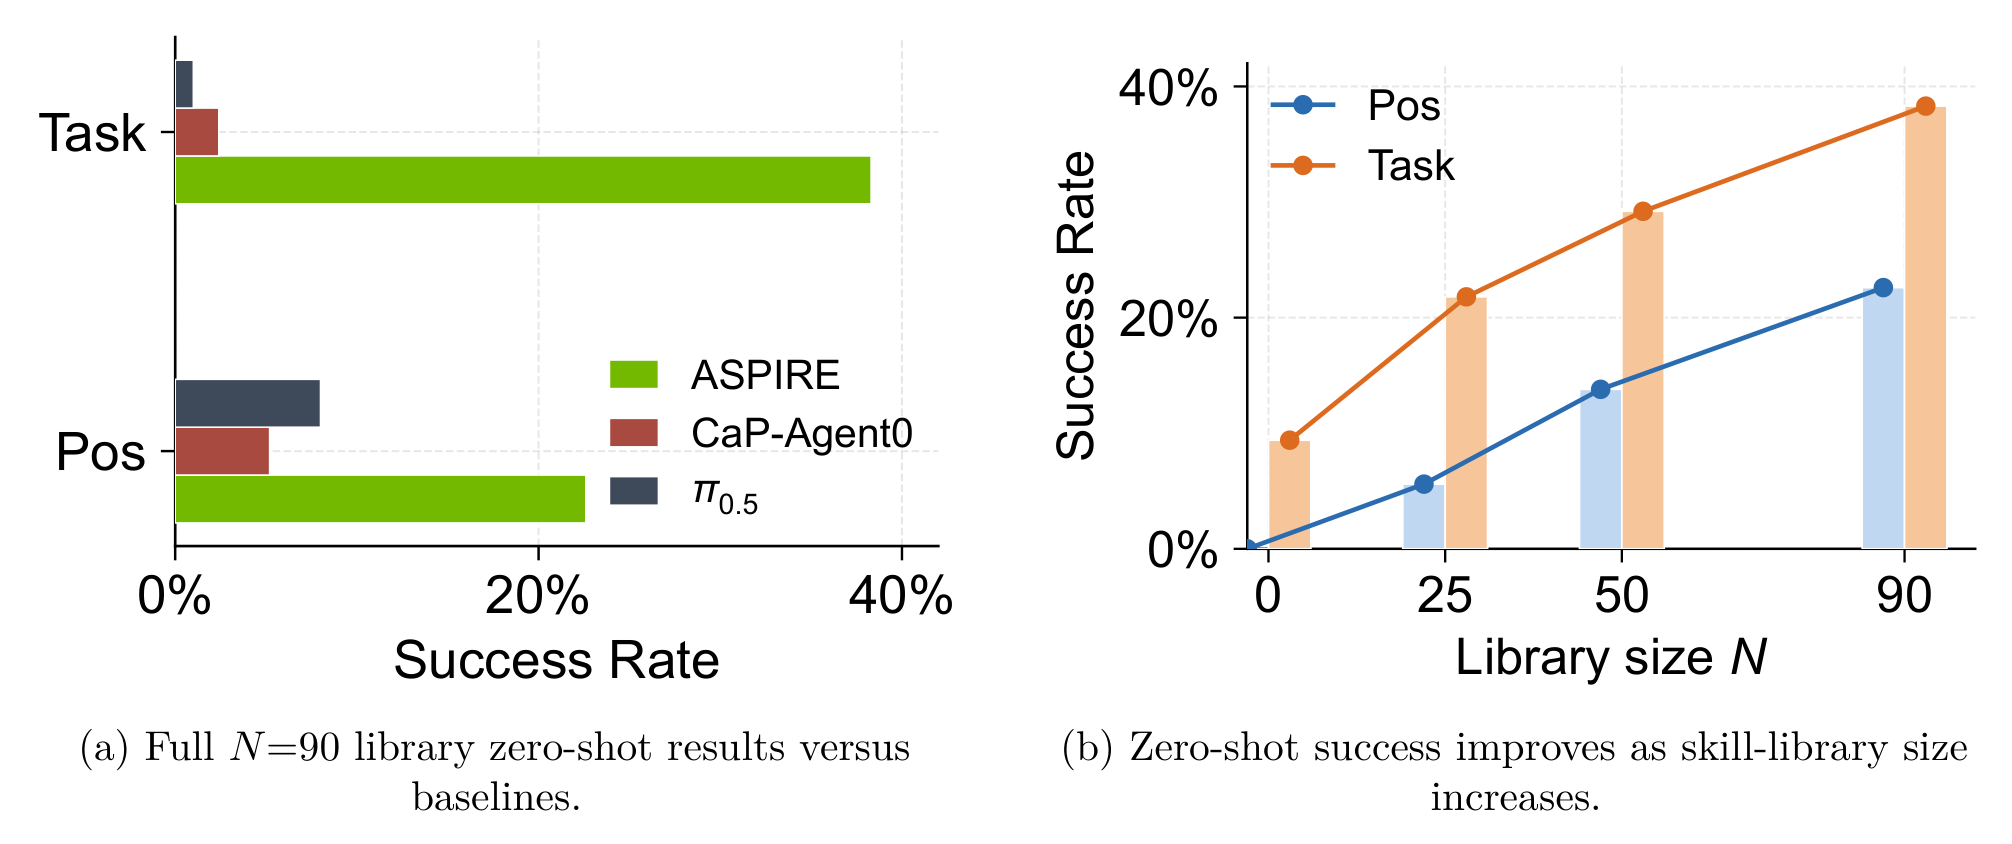
이 실험은 LIBERO-90에서 축적한 수정 skill이 held-out LIBERO-Pro Long 과제에도 통하는지를 본다. 라이브러리 스냅샷을 N이 0, 25, 50, 90인 네 크기로 만들고, 각 held-out 과제에 프로그램을 하나 생성해 추가 디버깅과 재시도와 과제별 라이브러리 갱신 없이 평가한다.
| 방법 | Pos | Task | 종합 |
|---|---|---|---|
| OpenVLA | 0% | 0% | 0% |
| π₀ | 0% | 0% | 0% |
| π₀.₅ | 8% | 1% | 5% |
| CaP-Agent0 | 5.2% | 2.4% | 3.8% |
| ASPIRE (N=0) | 0% | 9.4% | 4.7% |
| ASPIRE (N=25) | 5.6% | 21.8% | 13.7% |
| ASPIRE (N=50) | 13.8% | 29.2% | 21.5% |
| ASPIRE (N=90) | 22.6% | 38.3% | 30.5% |
라이브러리 크기와 성공률이 함께 오른다. 라이브러리가 비어 있는 N=0에서는 종합 4.7%로 CaP-Agent0(3.8%)와 큰 차이가 없다가, 25와 50과 90으로 키우면 13.7%, 21.5%, 30.5%로 상승한다. 즉 성능 차이를 만드는 것은 에이전트 자체가 아니라 축적된 라이브러리다.
단기 과제에서 검증된 수정이 long-horizon 조합 과제에도 재사용 가능한 지식이 된다는 점이 이 실험의 결론이다. LIBERO-90의 과제는 단일 단계이고 LIBERO-Pro Long의 과제는 여러 단계를 잇는 구성이라 과제 구조 자체가 다르다.
과제별로 분해하면 증가가 단조롭지 않다. 부록 C.2의 10개 과제 수치를 보면 라이브러리를 키울수록 오히려 성공률이 내려가는 항목이 섞여 있다.
| 과제 | Pos N=0 | N=25 | N=50 | N=90 | Task N=0 | N=25 | N=50 | N=90 |
|---|---|---|---|---|---|---|---|---|
| Stove + moka pot | 0% | 30% | 84% | 100% | 0% | 2% | 68% | 26% |
| Bowl in drawer | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% |
| Mug in microwave | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% |
| Both mokas on stove | 0% | 0% | 0% | 0% | 0% | 0% | 84% | 100% |
| Soup + cream cheese | 0% | 12% | 2% | 0% | 0% | 68% | 60% | 70% |
| Soup + tomato sauce | 0% | 14% | 20% | 0% | 78% | 68% | 2% | 70% |
| Cream cheese + butter | 0% | 0% | 6% | 94% | 0% | 0% | 34% | 86% |
| Mug on two plates | 0% | 0% | 16% | 32% | 16% | 28% | 8% | 0% |
| Mug + pudding | 0% | 0% | 6% | 0% | 0% | 0% | 8% | 4% |
| Book in caddy | 0% | 0% | 4% | 0% | 0% | 52% | 28% | 26% |
| 평균 | 0% | 6% | 14% | 23% | 9% | 22% | 29% | 38% |
역전 사례가 여럿이다. "Stove + moka pot"의 Task 조건은 N=50에서 68%였다가 N=90에서 26%로 내려가고, "Mug on two plates"의 Task 조건은 N=25의 28%에서 N=90의 0%로 사라진다. "Soup + tomato sauce"의 Task 조건은 라이브러리가 비어 있을 때 78%였다가 N=50에서 2%까지 떨어진 뒤 N=90에서 70%로 회복한다.
전혀 풀리지 않는 과제도 있다. "Bowl in drawer"와 "Mug in microwave"는 어떤 라이브러리 크기에서도 두 조건 모두 0%다. 논문은 이 비단조 추세를 라이브러리 관리 문제로 진단한다.
실제 로봇 cross-embodiment 전이
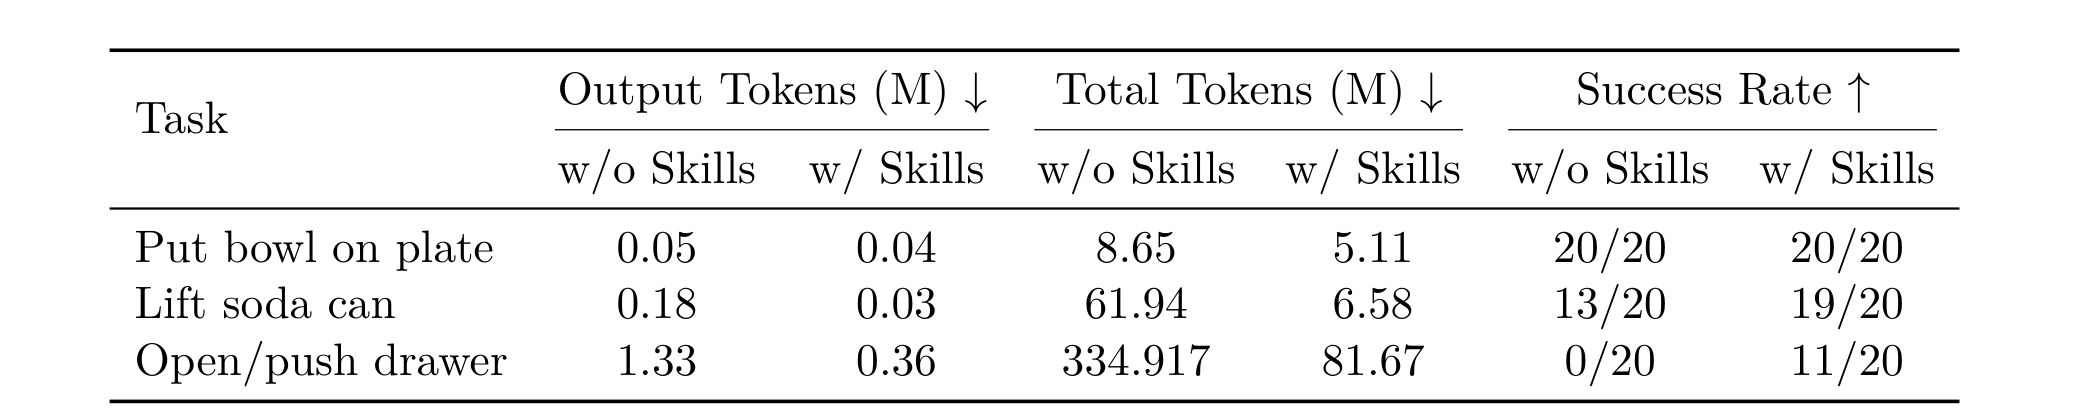
이 실험이 측정하는 것은 policy를 그대로 옮겨 싣는 배포가 아니다. 실제 로봇은 자기 perception과 캘리브레이션과 제어 스택을 쓰고, 코딩 에이전트는 실세계 실행 피드백으로 프로그램을 다시 맞춰야 한다. 따라서 이 실험이 측정하는 값은 시뮬레이션에서 발견한 skill을 제공했을 때 줄어드는 실세계 디버깅 분량이다.
| 과제 | 출력 토큰 (skill 없음) | 출력 토큰 (skill 있음) | 총 토큰 (skill 없음) | 총 토큰 (skill 있음) | 성공률 (skill 없음) | 성공률 (skill 있음) |
|---|---|---|---|---|---|---|
| 그릇을 접시에 놓기 | 5만 개 | 4만 개 | 865만 개 | 511만 개 | 20/20 | 20/20 |
| 캔 들기 | 18만 개 | 3만 개 | 6,194만 개 | 658만 개 | 13/20 | 19/20 |
| 서랍 밀고 당기기 | 133만 개 | 36만 개 | 3억 3,492만 개 | 8,167만 개 | 0/20 | 11/20 |
세 과제 모두에서 디버깅 비용이 줄었고 최종 성공률 개선은 과제에 따라 갈렸다. 토큰 수는 첫 성공 프로그램에 도달할 때까지, 또는 성공하지 못한 실행에서는 디버깅 예산이 소진될 때까지 측정한 값이다.
그릇 놓기는 skill 유무와 무관하게 20/20을 유지하면서 총 토큰만 865만 개에서 511만 개로 41% 줄어든다. 캔 들기는 성공률이 13/20에서 19/20으로 오르면서 총 토큰이 6,194만 개에서 658만 개로 거의 10분의 1이 된다.
대비가 가장 큰 것은 서랍 조작이다. skill을 제공한 쪽은 8,167만 개 토큰으로 11/20을 내는데, 제공하지 않은 쪽은 3억 3,492만 개를 소모하고도 성공하는 평가 프로그램을 끝내 만들지 못한다. 즉 skill 전이가 비용 절감을 넘어 성공과 실패를 가른 사례다.
구성 요소별 ablation
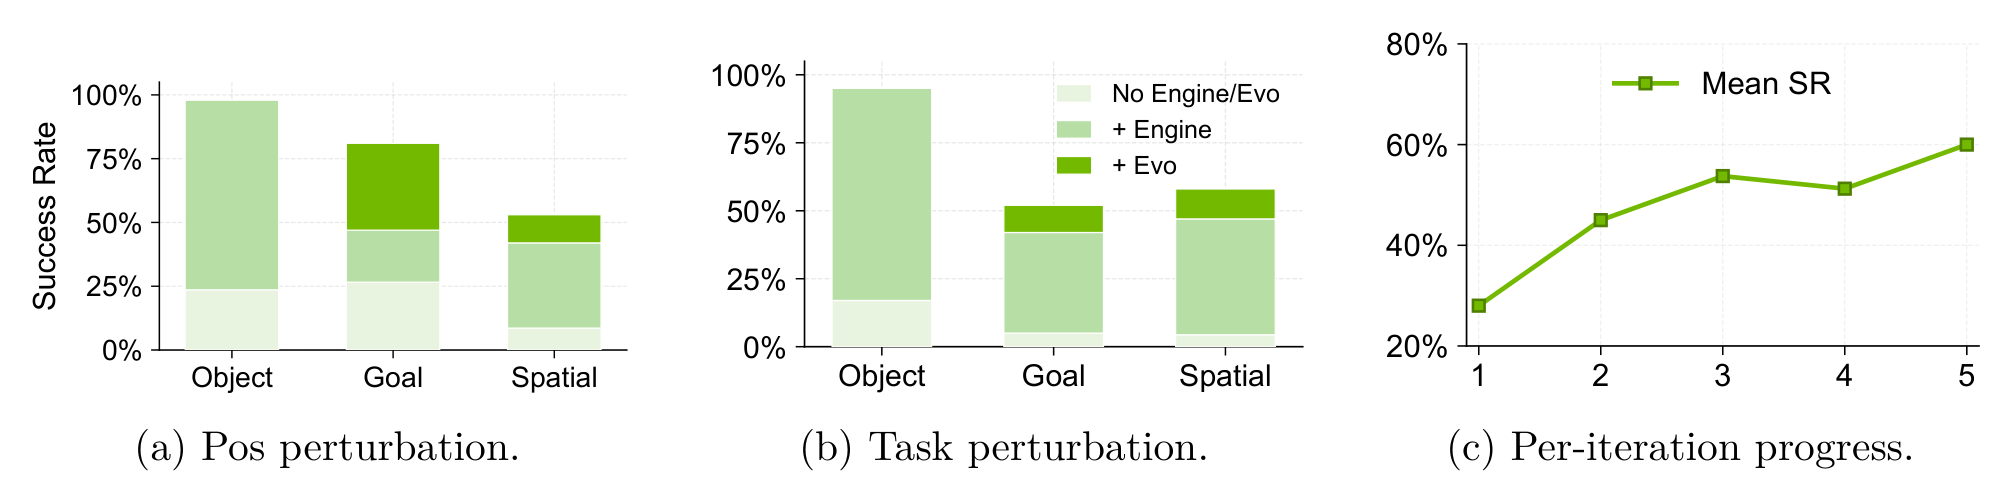
execution engine과 evolutionary search를 각각 떼어내 기여를 잰다. 둘 다 없는 기본 시스템은 15개 예시 프로그램만 제공한 zero-shot Claude Opus 4.6이다.
| 구성 | Pos 종합 | Task 종합 | 매크로 평균 |
|---|---|---|---|
| engine과 evolutionary search 모두 없음 | 20% | 9% | 14% |
| engine만 추가 | 62% | 61% | 62% |
| evolutionary search 단독 결과 | 68% (18개 과제) | 59% (19개 과제) | 참고값 |
| 최종 ASPIRE | 77% | 67% | 72% |
기여의 대부분은 실행 엔진 쪽이다. 14%에서 62%로 48%p 올라가므로, trace를 세분화해 실패 지점을 좁혀준 것만으로 성능의 큰 부분이 설명된다.
evolutionary search는 남은 어려운 과제에서 추가분을 낸다. 62%에서 72%로 10%p를 더한다. 다만 evolutionary search 단독 결과가 항상 더 좋지는 않아서, Task 교란에서는 59%로 engine만 쓴 61%보다 낮다.
최종 수치가 두 값보다 높은 이유는 선택 방식에 있다. ASPIRE는 과제마다 별도 검증 seed(66~80)에서 수정 프로그램과 evolutionary search 결과 중 나은 쪽을 고른다. 즉 최종 성능은 두 경로를 병렬로 두고 과제별로 승자를 뽑아 얻은 결과다.
suite별로 보면 기여 비중이 다르다. libero-object의 Pos 조건은 기본 24%에서 engine만으로 98%까지 올라 evolutionary search를 실행할 필요가 없었고, libero-spatial의 Pos 조건은 기본 9%에서 engine으로 42%, 최종 51%로 단계마다 이득이 나뉜다.
evolutionary search 회차별 진행
회차별 평균을 보면 초반 몇 회차에서 빠르게 오르다가 이후 완만해진다. 여러 수정 가설을 동시에 시험하면 단일 회차 디버깅이 놓친 대안을 빠르게 찾아내지만, 회차가 늘수록 수익은 체감한다.
과제별 진행은 단조롭지 않다. 부록 D.3의 8개 과제 기록에서 성능이 중간에 하락했다가 회복하는 사례가 여럿 나온다.
| suite | 과제 | 0회차 | 1회차 | 2회차 | 3회차 | 4회차 |
|---|---|---|---|---|---|---|
| goal_swap | Bowl → plate | 62% | 60% | 60% | 18% | 86% |
| goal_swap | Wine bottle → rack | 40% | 76% | 74% | ||
| goal_swap | Bowl → stove | 62% | 82% | |||
| goal_task | Push plate → stove | 0% | 80% | |||
| spatial_swap | Bowl on cabinet → plate | 16% | 38% | 38% | 46% | 30% |
| spatial_swap | Bowl next to cookie → plate | 16% | 20% | 4% | 4% | 40% |
| spatial_task | Bowl on cookie → plate | 26% | 4% | 70% | ||
| spatial_task | Bowl on ramekin → plate | 2% | 0% | 22% | 36% | 18% |
"Bowl → plate"는 62%에서 시작해 3회차에 18%까지 내려갔다가 4회차에 86%로 끝난다. "Bowl on cookie → plate"도 1회차에 26%에서 4%로 떨어진 뒤 2회차에 70%가 된다. 각 후보가 서로 다른 가설을 시험하도록 설계했으므로, 중간 회차의 하락은 탐색이 새 전략 계열로 이동한 결과다.
반대로 마지막 회차가 최고가 아닌 과제도 있다. "Bowl on cabinet → plate"는 3회차 46%가 최고고 4회차에 30%로 내려간다. 이 때문에 최종 프로그램은 마지막 회차가 아니라 별도 검증 seed에서 고른 최고 후보다.
한계
논문이 직접 꼽는 한계는 다섯 가지다.
완전 자율 실세계 평생학습에는 이르지 못했다. 시뮬레이션에서는 성공 판정과 장면 리셋이 저렴하고 프로그램으로 처리되지만, 실세계 배포에는 견고한 성공 감지와 안전한 리셋과 안전 모니터링과 캘리브레이션 유지가 추가로 필요하다. 후속 과제는 이 평가와 리셋 루프를 닫는 것이다.
동결된 프론티어 LLM에 의존한다. multimodal trace를 해석하고 수정을 작성하고 탐색 후보를 제안하는 일을 Claude Opus 4.6에 1M 토큰 context window를 결합한 구성이 감당한다. 더 작거나 약한 모델이 같은 디버깅 루프를 유지할 수 있는지는 검증하지 않았다.
미리 정의된 API가 표현 가능한 행동의 상한을 정한다. 이 제약 덕분에 디버깅이 다루기 쉽고 안전해지지만, 노출된 primitive 바깥의 감지나 제어나 상호작용이 필요한 과제에서는 에이전트가 비효율적으로 근사하거나 사람이 API를 확장해줄 때까지 막힌다. 에이전트가 새 primitive를 안전하게 제안하고 검증하고 편입하는 방법이 남은 과제다.
skill library의 장기 메모리 관리가 미해결이다. 라이브러리가 커지면 오래돼 맞지 않는 항목, 지나치게 특정 상황에 묶인 항목, 중복 항목이 쌓이고, 새 과제에서는 오히려 방향을 흐리는 항목도 나온다. 앞서 본 zero-shot 전이의 비단조 추세가 이 문제로 설명된다는 것이 논문의 진단이며, 검색과 정리와 순위 매기기와 재검증 기제가 더 필요하다.
디버그와 탐색 루프의 연산 비용이 크다. 과제 하나에 LLM 호출과 시뮬레이터 또는 로봇 rollout이 여러 번 든다. 실제 로봇 서랍 조작 하나에 3억 3,492만 개 토큰이 들었다는 수치가 이 비용을 보여준다. 추론 비용을 낮추거나 표본 효율이 높은 탐색을 쓰거나 이전 수정을 더 잘 재사용하지 못하면 과제 묶음을 크게 키울 수 없다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| ASPIRE | Agentic Skill Programming through Iterative Robot Exploration. 이 논문의 시스템 이름 |
| multimodal trace | primitive 호출마다 기록되는 API명, 입출력, 반환 상태와 RGB 키프레임, 오버레이, grasping 후보, 물체 pose 묶음 |
| skill library | 검증을 통과한 수정 지식을 실패 시그니처와 적용 조건과 수정 전략과 코드 스케치 형태로 모아둔 저장소. 다음 actor에게 in-context guidance로 주입된다 |
| coordinator와 actor | coordinator는 라이브러리를 관리하고 과제를 배분하는 중앙 에이전트, actor는 과제 하나를 맡아 프로그램을 작성하고 수정하는 코딩 에이전트 |
| evolutionary search | 회차마다 서로 다른 가설을 담은 후보 프로그램 K개를 만들어 실행하고, 성적 좋은 것과 남은 실패 trace로 다음 회차를 조건짓는 탐색 절차 |
| CaP-X | MuJoCo Playground 위에서 실행되는 오픈소스 code-as-policy 프레임워크. 이 논문의 실행 기반이다 |
| LIBERO-Pro | LIBERO를 물체, 목표, 공간, 지시문 교란으로 확장해 암기가 아닌 강건성을 재는 벤치마크. Pos는 초기 위치 교란, Task는 지시문 교란 조건 |
| Stage 1과 Stage 2 | 디버그 seed에서 수정 프로그램을 만드는 단계와, 확정된 프로그램을 held-out seed에서 정확히 한 번만 검증하는 단계 |
관련 페이지
- π0.5: a Vision-Language-Action Model with Open-World Generalization: LIBERO-Pro 베이스라인 π₀.₅의 원 논문. 실제 가정 환경에서는 강하지만 이 벤치마크의 지시문 교란 조건에서는 1%까지 하락한다.
- OpenVLA: An Open-Source Vision-Language-Action Model: 베이스라인으로 쓴 오픈소스 end-to-end VLA. LIBERO-Pro 교란 조건에서 전 항목 0%를 기록해, 학습된 policy와 생성된 프로그램의 강건성 격차를 보여주는 대조군이다.
- π0: A Vision-Language-Action Flow Model for General Robot Control: 함께 비교된 flow matching 기반 VLA. π₀.₅의 직전 버전이다.
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: VLA 노선의 원형. ASPIRE는 같은 과제를 가중치가 아니라 코드로 푼다는 점에서 정반대 접근이다.
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: VLA 종합 서베이. ASPIRE가 대비 대상으로 삼는 계보 전체를 정리한다.
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 양팔 manipulation의 학습 기반 접근. ASPIRE가 가장 크게 개선한 two_arm_handover와 같은 문제 영역이다.
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots: 가사 과제 시뮬레이터 계보. BEHAVIOR-1K와 함께 long-horizon 평가 환경의 다른 선택지다.
- 용어집: Physical AI (Terminology Glossary): code-as-policy, primitive, embodiment 등 이 페이지 용어의 canonical 표기.