Physical AI · PAPER · 2026
Safe Embodied AI for Long-horizon Tasks: A Cross-layer Analysis of Robotic Manipulation
요약
이 서베이는 long-horizon robotic manipulation의 안전 문헌을 두 기준으로 재배치한다. 첫 번째는 intervention locus로, 안전 기법이 파이프라인의 어느 시점에 개입하는지를 planning-time, policy-time, execution-time 셋으로 나눈다. 두 번째는 evidence boundary로, 보고된 결과가 실제로 무엇을 뒷받침하는지를 formal guarantee, statistical safety, empirical safety 셋으로 나눈다.
핵심 주장은 안전이 하나의 모듈이 가진 속성이 아니라 시스템 전체에서 나타나는 성질이라는 것이다. 한 계층에서 안전을 개선해도 전체 시스템의 안전이 따라오지 않는다. 따라서 저자들은 "무엇을 개선했는가"와 "무엇을 보장하는가"를 논문마다 분리해서 읽자고 제안한다. 서베이의 문헌 수집 범위는 2026년 4월까지이며, 서울대와 UNIST와 LG전자 소속 연구자 7인이 작성했다.
배경
실패가 지연되고 누적되는 구조
embodied 시스템의 출력은 예측이나 텍스트가 아니라 하드웨어의 움직임이다. 그래서 실패가 사람과 물체와 작업장에 직접 영향을 준다. 이 점에서 안전은 사후에 덧붙이는 제약이 아니라 시스템의 핵심 속성으로 다뤄야 한다.
더 어려운 부분은 로봇이 실패할 수 있다는 사실 자체가 아니라, long-horizon 시스템이 지연되고 누적되며 부분적으로만 보이는 방식으로 실패한다는 점이다. 오류는 의미 수준의 misgrounding이나 시각 환각에서 시작해 불충분한 planning 목표나 policy 수준의 어긋남을 거쳐 전파되고, 로봇이 한참 뒤의 contact 구간에 도달했을 때야 드러난다. 시스템이 국소적으로는 유능해 보이면서도 숨은 위험을 계속 쌓아 갈 수 있다는 뜻이다.
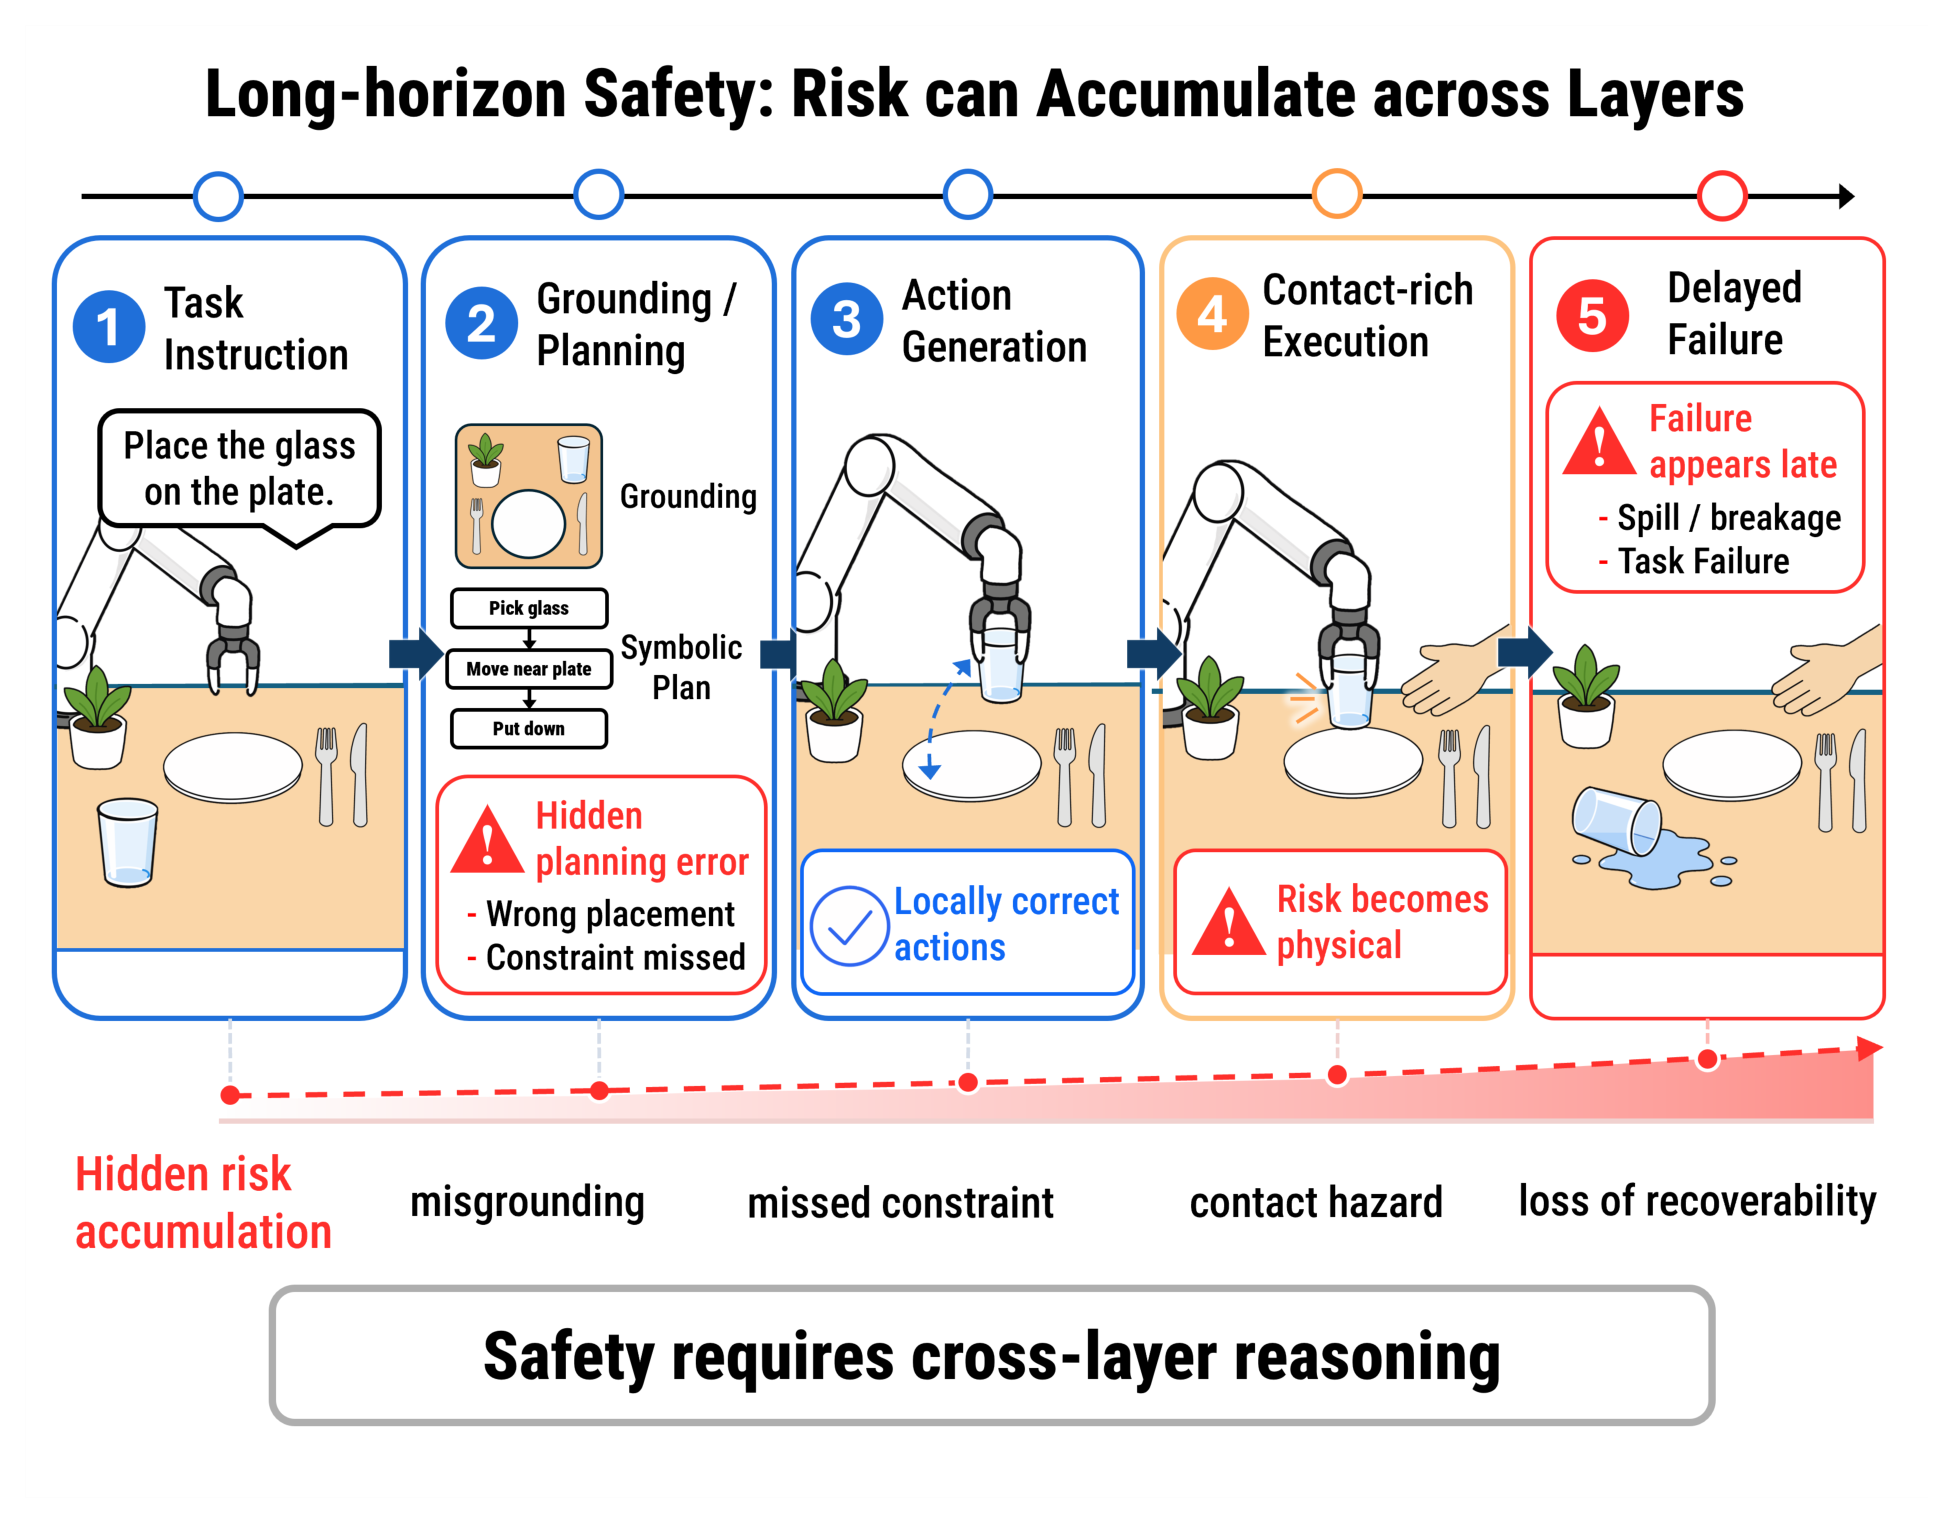
Figure 1의 예시는 "유리잔을 접시 위에 놓아라"라는 지시문(instruction)이다. grounding과 planning 단계에서 놓을 위치가 잘못 잡히고 제약이 누락되지만 이 오류는 드러나지 않는다. action 생성 단계의 각 action은 국소적으로 올바르다. contact 구간에 들어서야 위험이 물리적으로 나타나고, 마지막에 가서 내용물이 쏟아지는 실패로 확정된다. 저자들이 강조하는 것은 마지막 단계의 제어 실패가 아니라 첫 단계에서 시작된 오류가 회복 가능성이 사라질 때까지 살아남는다는 점이다.
manipulation을 anchor domain으로 고른 이유
이 서베이는 embodied AI 안전 전반을 망라하지 않고 long-horizon robotic manipulation 하나에 집중한다. manipulation이 다른 도메인의 대리 표본이어서가 아니라, 다른 도메인에서는 분리되어 나타나는 안전 압력들이 한곳에 모이기 때문이다.
| 도메인 | horizon 의존 | 의미 명세 | contact | 숨은 위험 | 계층 결합 |
|---|---|---|---|---|---|
| navigation | 중심 | 변형 의존 | 통상 부재 | 변형 의존 | 변형 의존 |
| locomotion | 변형 의존 | 통상 부재 | 중심 | 변형 의존 | 변형 의존 |
| manipulation | 중심 | 중심 | 중심 | 중심 | 중심 |
manipulation만 다섯 요인이 모두 중심이자 반복적으로 나타난다. 숨은 위험은 과제가 명목상 성공했는데도 남아 있는 위험한 행위를 뜻하고, 계층 결합은 planning과 policy 생성과 실행이 서로를 제약하는 정도를 뜻한다.
저자들은 과제 도메인과 로봇 플랫폼을 구분해야 한다는 점도 짚는다. navigation, locomotion, manipulation은 도메인이고 humanoid, 모바일 매니퓰레이터, 서비스 로봇, 자율주행차는 플랫폼이다. 하나의 배포 시스템이 여러 도메인을 결합할 수 있으므로 안전 분석의 단위는 플랫폼이 아니라 도메인이어야 한다.
기존 서베이와의 차이
embodied AI와 foundation model과 VLA를 다룬 기존 서베이들은 생태계를 잘 정리했고 안전한 실제 배포의 필요성도 언급한다. 하지만 안전을 추상적 개념으로 두거나 모듈형 기법으로 다룬다. 안전 개입이 lifecycle의 어디에서 들어오는지로 문헌을 조직하지도 않고, 그 결과로 나온 주장이 어느 수준의 근거를 갖는지도 비판적으로 평가하지 않는다.
| 서베이 | 주된 범위와 강조점 | 이 논문이 메우려는 빈틈 |
|---|---|---|
| Liu et al. (2025c) | 포괄적 embodied AI. perception, 상호작용, sim2real 적응 | manipulation 고유의 안전 근거 |
| Firoozi et al. (2025) | 로보틱스용 foundation model. 응용, uncertainty, 안전 평가 | 안전을 lifecycle 수준 조직 기준으로 삼기 |
| Kawaharazuka et al. (2025) | 로보틱스용 VLA. 아키텍처, 데이터셋, 벤치마크, 평가 | 성능 지표를 넘어선 안전 |
| Zheng et al. (2025) | 물체 중심 manipulation. perception, 과제 모델링, policy 학습 | 안전 근거를 1차 분석 기준으로 삼기 |
| Tsuji et al. (2025) | contact 구간 imitation learning. 시연, 감지, 표현, 학습 | manipulation의 long-horizon 안전 근거 |
| Zhang et al. (2025b) | 안전한 contact 구간 학습. 안전 탐색, shielding, 실행 안전 | planning과 policy와 평가 수준 근거의 통합 |
| Gu et al. (2024) | safe RL. 제약, 이론, 벤치마크 | policy 학습 정식화를 넘어선 안전 |
| Tan et al. (2025) | 신뢰 가능한 embodied AI. 성숙도 수준, 신뢰성 원칙 | manipulation으로 도메인을 고정한 심층 분석 |
| Kojima et al. (2025) | 물리적 risk 통제. 배포 전, 사고 전, 사고 후 | 과제와 policy와 실행 수준 근거 사이의 경계 |
가장 가까운 두 편은 Tan et al. (2025)과 Kojima et al. (2025)이다. 각각 embodied AI의 광범위한 안전 위험과 foundation model 기반 로보틱스의 물리적 risk 통제를 다룬다.
핵심 개념
안전의 네 범주
이 서베이에서 safety는 long-horizon 과제 수행 중 사람에 대한 위해, 물체 손상, 명시된 제약 위반, 복구 불가능한 상태로 이어질 수 있는 실패를 예방하고 탐지하고 완화하는 것을 뜻한다. 즉각적인 충돌 회피나 힘 한계 위반보다 넓은 정의다.
| 범주 | 대상 |
|---|---|
| physical safety | 사람, 로봇, 조작 대상 물체, 환경에 대한 물리적 위해 |
| procedural safety | 과제 순서, precondition, 제약, 회복 가능 상태를 rollout 전체에 걸쳐 유지하는 것 |
| operational safety | 자율 실행을 계속하는 것이 더 이상 정당화되지 않는 상태를 피하는 것 |
| semantic safety | 위험한 지시문, 잘못 grounding된 목표, 환각된 affordance, 누락된 제약 |
여기서 precondition은 어떤 subtask를 시작하기 전에 성립해 있어야 하는 조건을 말한다. affordance는 현재 장면에서 로봇이 실제로 취할 수 있는 조작 가능성을 뜻한다.
범주의 경계도 명시된다. reliability와 robustness와 alignment는 그 자체로 안전 근거가 아니다. hazard 감소나 위험 상태 회피나 실패 전파 완화와 명시적으로 연결될 때만 안전 근거로 인정한다. 반대로 adversarial attack, data poisoning, prompt injection, jailbreak, 모델 유출, 로봇 사이버보안은 functional safety가 아니라 보안 경계 문제로 보아 독립 범위에서 제외한다.
첫 번째 기준: intervention locus
첫 번째 조직 기준은 안전 기법이 행위를 조형하거나 제한하거나 교정하는 시점이다.
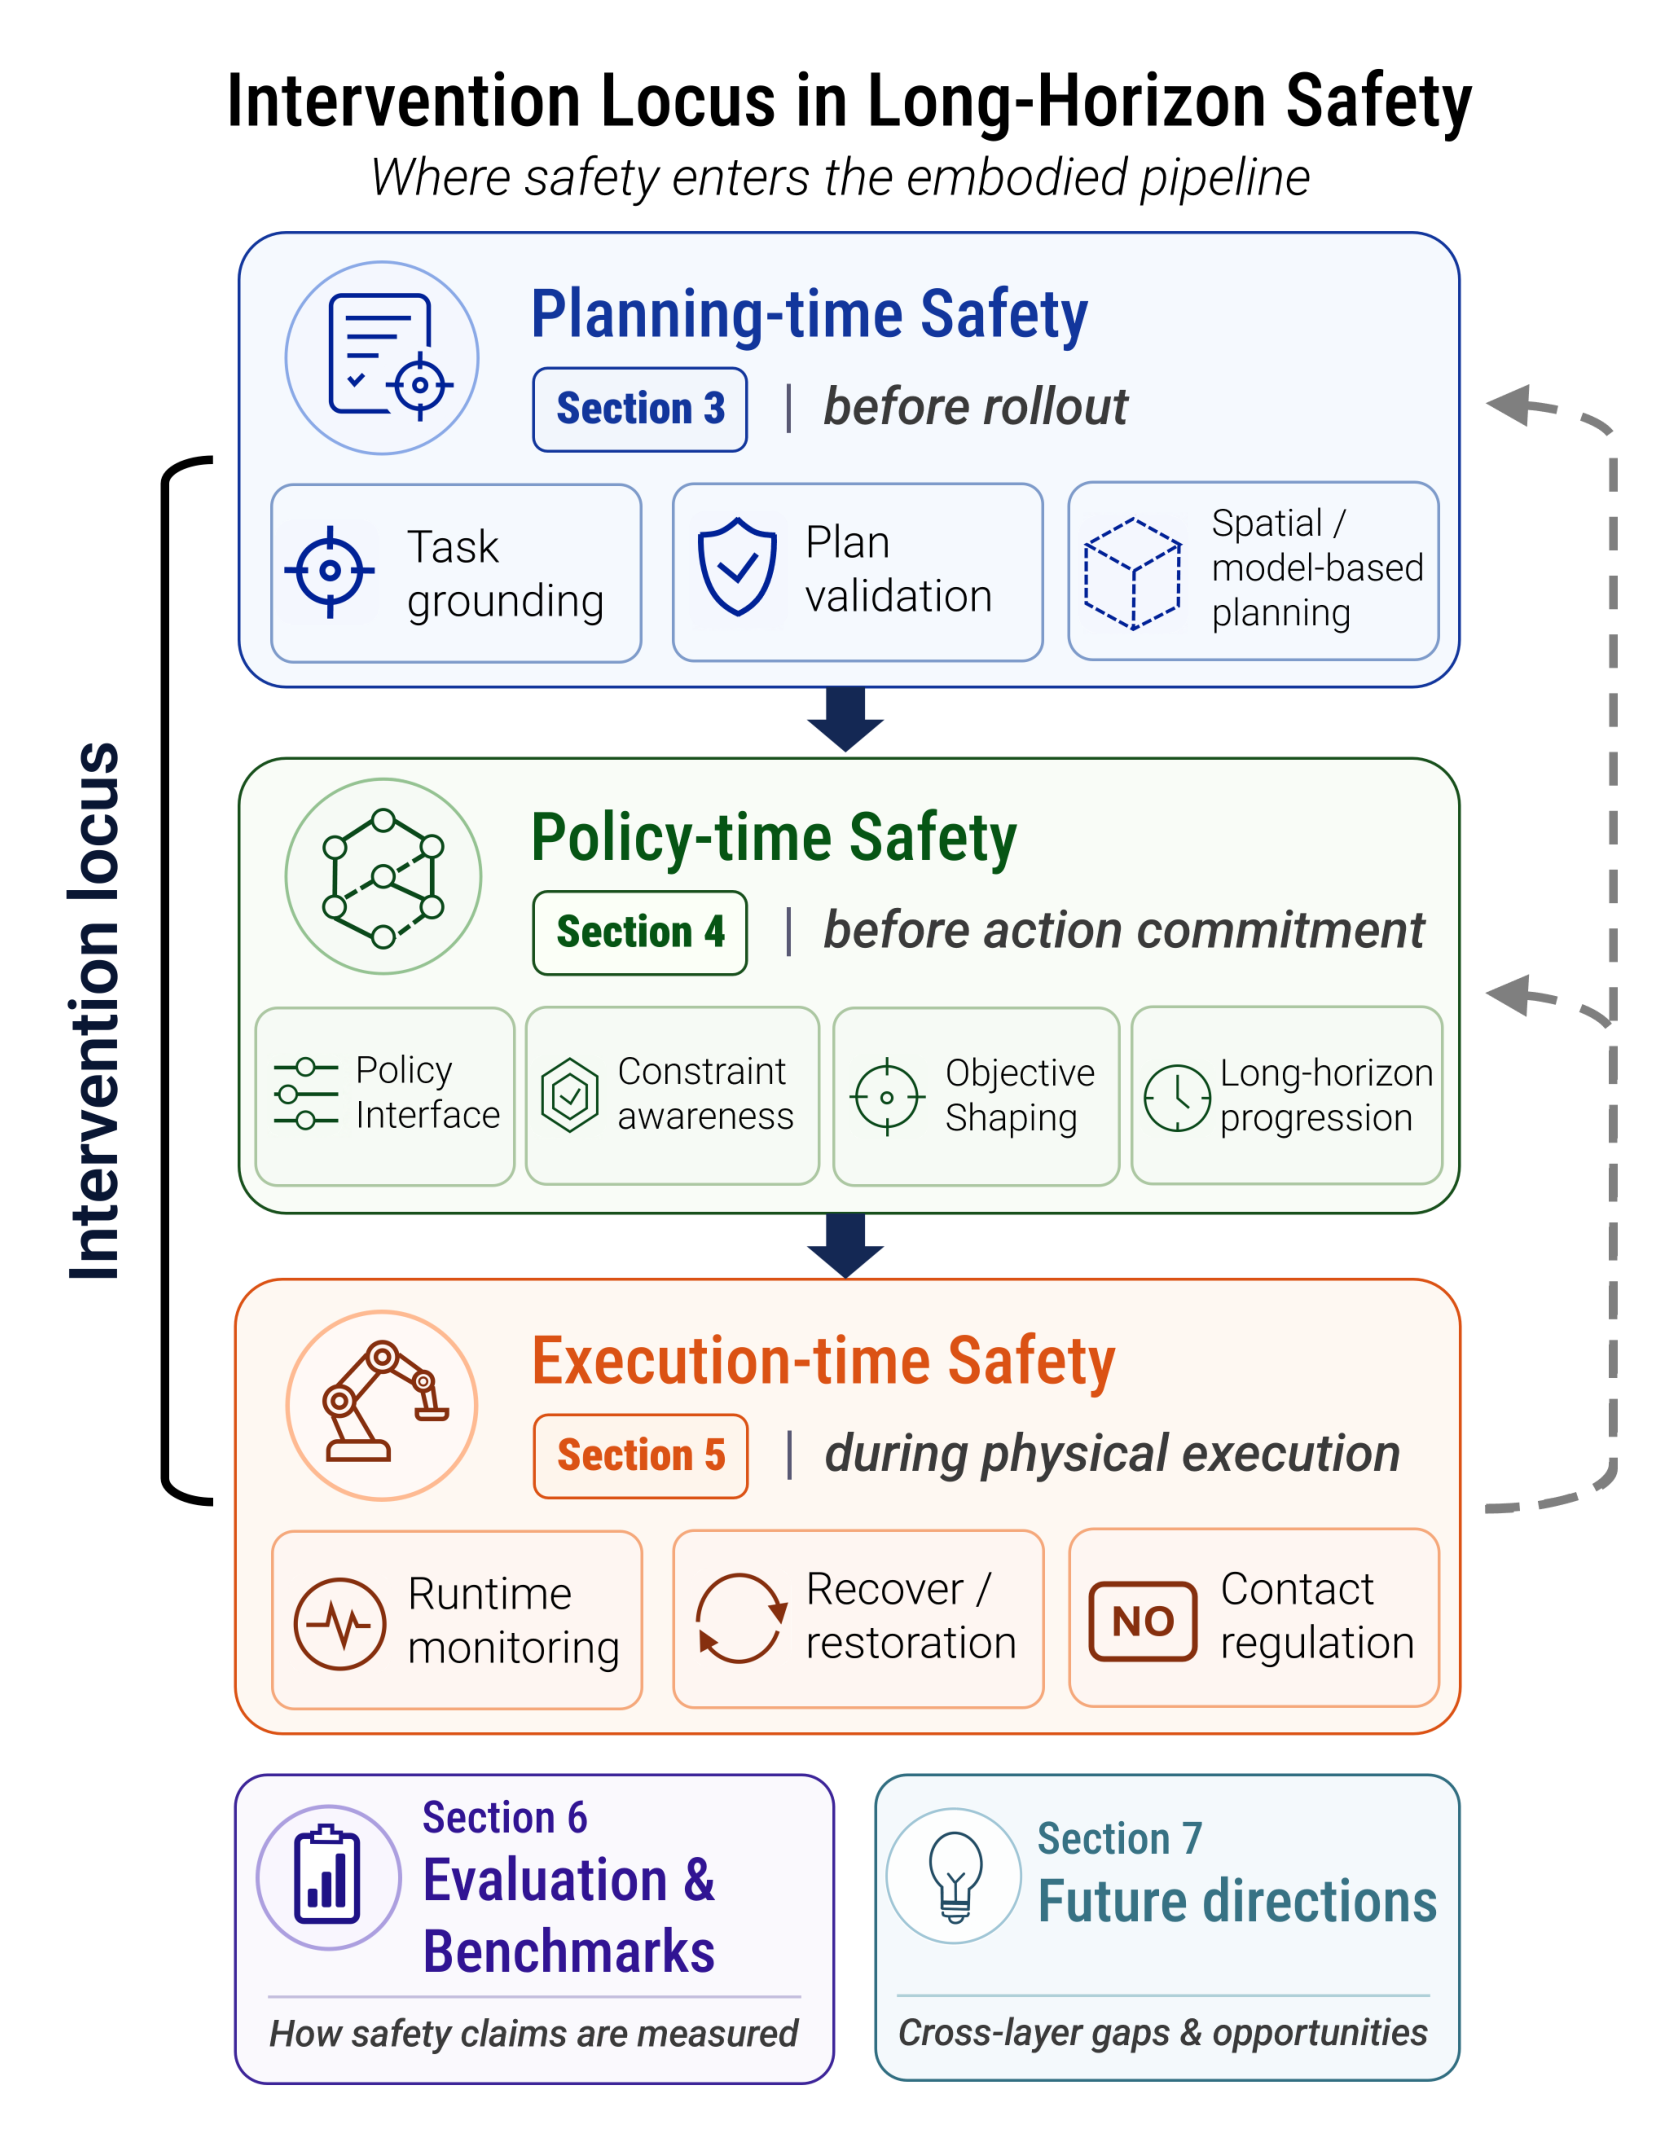
| 계층 | 개입 시점 | 주된 대상 | 세부 기법 |
|---|---|---|---|
| planning-time | rollout 이전 | 과제 표현, grounding, 제약, 분해 구조 | 과제 grounding, plan 검증, 공간과 model 기반 planning |
| policy-time | action이 환경에 확정되기 전 | action 생성 기구, 목적함수, 정합 | policy interface, 제약 인식, objective shaping, long-horizon 진행 |
| execution-time | 물리 실행 중 | runtime 감시, 이상 탐지, 개입, contact | runtime monitoring, 복원, contact 조절 |
여기서 rollout은 policy를 실제 환경에서 한 회 끝까지 실행하는 것을 뜻한다. 세 계층은 분석 단위로만 독립적이고 실제로는 하나의 closed-loop 안에서 맞물린다. planning-time 제약은 policy interface로 번역될 수 있어야 하고, policy-time의 uncertainty 신호는 execution-time 감시기가 해석할 수 있어야 한다. 그래서 Figure 2는 고정된 아키텍처가 아니라 서베이의 지도로 읽어야 한다.
두 번째 기준: evidence boundary
두 번째 조직 기준은 안전 주장의 엄밀성이다. 각 논문은 분석이나 검증이 직접 뒷받침하는 가장 강한 주장 하나를 기준으로 배정된다.
| 근거 범주 | 뒷받침하는 것 | 예시 | 주장의 경계 |
|---|---|---|---|
| formal guarantee | 명시된 모델과 제약 집합 안에서 증명된 안전성 | CBF와 reachability filter, temporal logic 기반 planning | 명시된 가정 밖에서는 무효이고 실제 세계와의 abstraction gap이 남는다 |
| statistical safety | 명시된 가정 아래 한정된 실패 확률이나 risk 민감 근거 | uncertainty bound, 신뢰도 기반 개입 | 가정이나 모델링된 데이터 영역을 벗어나면 무효다 |
| empirical safety | 특정 벤치마크나 평가 시나리오에서 측정된 안전 지표 | safety cost 감소, contact 실패 감소 | 일반화 보장이 없고 long-tail 상황을 포괄하지 못한다 |
CBF는 control barrier function의 약자로, 안전한 상태 집합을 벗어나지 않도록 제어 입력에 부등식 제약을 거는 방법이다. reachability filter는 앞으로 도달 가능한 상태 집합을 계산해 위험 영역에 들어갈 수 있는 action을 미리 거른다.
일반적인 robustness는 이 세 범주와 구분한다. 잡음이나 분포 변화에 견디는 성질은 성능이나 일반화 주장을 뒷받침할 뿐이며, 그 perturbation이나 지표가 충돌이나 힘 과부하나 복원 실패 같은 hazard와 명시적으로 연결될 때에만 안전 근거가 된다.
근거의 대상
엄밀성과 별개로 근거가 무엇을 대상으로 삼는지도 구분한다.
| 근거 대상 | 확인하는 것 | 확인하지 못하는 것 |
|---|---|---|
| plan-level | 과제 명세가 유효하거나 시뮬레이터에서 실행 가능함 | perception과 policy drift 아래의 안전한 물리 실행 |
| trajectory-level | safe success rate, 누적 cost 같은 사후 요약 | hazard의 발생 시점, 개입 타이밍의 정확도 |
| runtime과 contact-level | 실패 탐지와 힘 조절 같은 능동적 위험 완화 | 특정 embodiment와 센서 구성을 벗어난 일반화 |
따라서 안전 근거는 계층 사이에 호환되지 않는다. 형식적으로 검증된 plan이 안전한 contact를 함의하지 않고, 제약된 policy가 보정된 runtime 개입을 보장하지 않는다.
위험 압력 여섯 가지
기법과 그것이 겨냥하는 hazard를 잇기 위해 서술 어휘로 risk pressure 여섯 가지를 쓴다.
- task specification and grounding risk: 목표 해석과 장면 grounding의 오류, 안전 관련 제약의 누락
- sequence and transition risk: 잘못된 분해나 위험한 subtask 순서로 precondition이 충족되지 않은 채 진행하는 경우
- spatial and motion-feasibility risk: 충돌 없는 trajectory, 도달 가능한 자세, 안정적인 grasping 지점 같은 기하학적 확정이 빠진 추상 plan
- policy generation and objective risk: 어긋난 목적함수, 제약 없는 action interface, long-horizon 컨텍스트 상실에서 오는 위험한 action 제안
- runtime drift and uncertainty risk: perception 오류, 분포 변화, 보정되지 않은 신뢰도로 planning 가정에서 벗어나는 경우
- contact and physical-interaction risk: 힘, 마찰, jamming에서 오는 물체 손상과 사람에 대한 위해
이 압력들은 cascading failure와 recoverability 상실로 서로 연결된다. 작은 명세 오류나 contact 교란이 계층을 넘어 전파되어 결국 위해를 막거나 복구를 보장할 수 없는 상태에 이른다. 복원 기법이 겨냥하는 것이 바로 이 recoverability 상실이다.
방법
planning-time safety
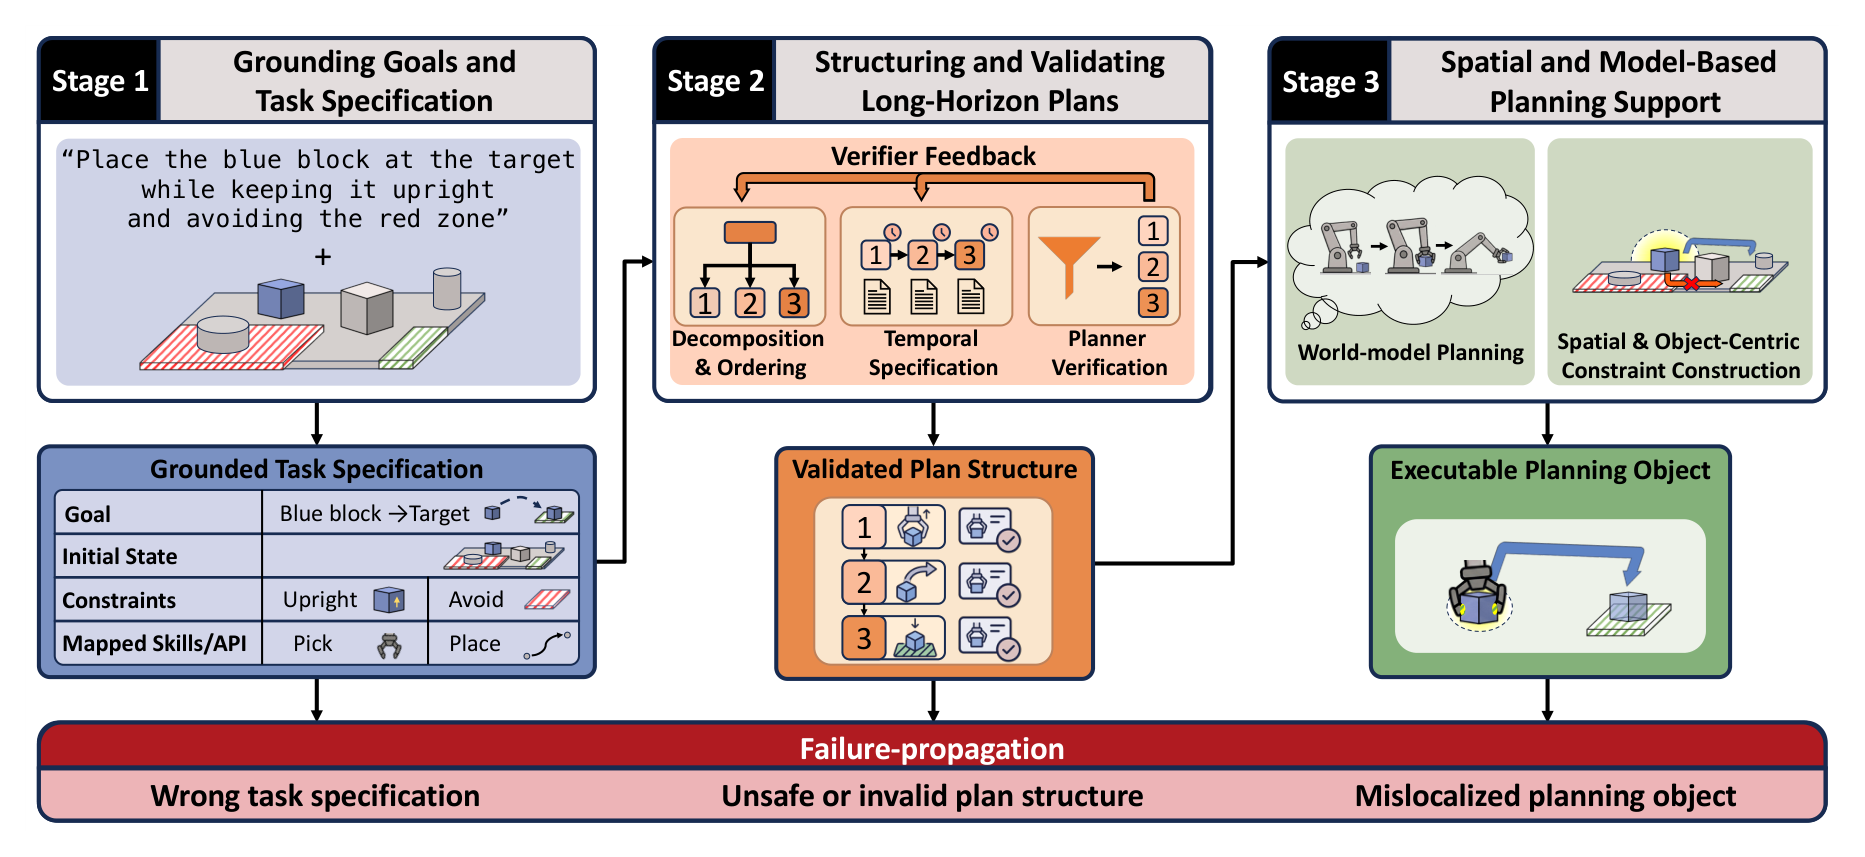
planning-time safety는 행위가 실행되기 전에 시작되는 실패를 다룬다. 이 단계에서 시스템은 무엇을 요구받았는지, 어떤 제약이 그 과제를 정의하는지, 그리고 만들어진 plan 구조가 실행할 가치가 있을 만큼 일관된지를 정한다.
목표와 과제 명세의 grounding
첫 단계는 목표와 초기 상태와 관련 제약을 downstream planning 모듈이 실제로 쓸 수 있는 과제 명세로 grounding하는 일이다. 여기서 잘못 grounding되면 이후의 검증과 runtime 안전 기구가 처음부터 틀린 대상 위에서 작동한다.
대표 기법은 두 가지다. 암묵적 affordance 점수화는 스킬의 의미적 유용성과 상태 조건부 feasibility 확률을 함께 저울질한다. 명시적 심볼 구조화는 언어와 장면 observation을 물체 집합과 초기 조건을 담은 형식 문제 정의로 옮긴다. 여기에 환경의 텍스트 feedback을 closed-loop으로 받아 해석을 갱신하는 확장이 붙는다.
이 묶음의 근거 경계는 이산적 결정 지점에서의 의미 호환성과 심볼 일관성까지다. 열린 빈틈은 이산 의미 추상화가 환경의 연속적 feasibility를 손실 없이 담는다는 가정이다. 복잡한 기하학적 차단이나 물체 혼잡이 도달 가능이라는 이진 predicate로 단순화되면 planner는 의미상 완벽하지만 motion planner가 반복해서 거부하는 시퀀스를 만든다. 그 결과 물리 rollout이 시작되기도 전에 무한한 심볼 재planning 루프나 교착에 빠진다.
제약 해석 단계는 자연어 제한을 planner가 쓸 수 있는 표현으로 번역한다. 조밀한 기하 value map, 구조화된 심볼 문제 기술, 상위 plan 선별용 금지 기준 세 가지 표현 방식이 쓰인다. 여기서의 상충은 논리 표현력과 solver tractability와 의미 정합 사이에 있다. 과대 제약이면 여러 정성적 안전 규칙이 서로 배타적인 논리식으로 번역되어 solver가 해를 찾지 못한다. 과소 제약이면 번역 과정이 암묵적 안전 불변식을 놓쳐서, 좁은 명세는 수학적으로 만족하면서 사용자의 실제 안전 의도를 위반하는 시퀀스가 나온다.
실행 가능한 interface로의 grounding은 추상 plan 단계를 실제 스킬, API 호출, 제어 primitive에 대응시킨다. 텍스트 유사도로 자유 형식 제안을 허용된 action 집합에 매핑하는 방식과, 로봇의 API와 물체 목록과 상태 검사 구문을 생성 프롬프트 안에 직접 노출하는 프로그램식 방식이 있다. 근거 경계는 구문 준수와 API 호환성까지이고, 정적 함수 정의 뒤에 숨은 문맥 의존 precondition은 평가하지 못한다.
long-horizon plan의 구조화와 검증
과제가 올바르게 grounding되어도 subgoal이 일관되게 배열되지 않거나 시간 요구가 불충분하게 명세되면 구조적 실패로 이어진다. 이 단계는 분해와 순서화, 시간 명세, 사전 실행 검증 순으로 진행한다.
분해와 순서화에는 세 가지 기구가 쓰인다. chain-of-thought 추론기로 생성 중에 불변식과 precondition과 postcondition을 평가해 결함 있는 구조를 거르는 방식, 자연어 제약을 Linear Temporal Logic 명세로 옮겨 허용되지 않는 action을 후보에서 가지치기하는 automata 방식, scene graph와 과제 기술을 PDDL 도메인과 문제 파일로 바꿔 자동 planner가 subgoal을 차례로 푸는 심볼 방식이다. 근거 경계는 가정된 심볼 도메인 모델 안의 인과 일관성까지다. predicate 완전성과 정적 인과 불변성이라는 가정이 깨지는 예가 두 가지 제시된다. scene graph에서는 접근 가능해 보이는 캐비닛이 실제로는 걸려 있는 경우, 그리고 물체 무게가 선택된 스킬 primitive의 암묵적 한계를 넘는 경우다.
시간 명세에서는 LTL과 Signal Temporal Logic이 표준 수단이다. 언어 기반 파이프라인에서는 번역 자체가 병목이 되므로, 잘못된 형식 명세로 옮기면 planner는 틀린 과제를 충실히 최적화한다. 이를 줄이기 위해 세 가지 안전장치가 쓰인다.
| 안전장치 | 방법 | 한계 |
|---|---|---|
| 구문 유효성 | 문장과 trajectory 쌍의 약한 지도나 코드 생성 프롬프트로 LTL 수식의 구문 정확도를 높인다 | 구문이 맞아도 의도한 과제를 담는다는 보장은 없다 |
| 보정된 의미 신뢰도 | 번역을 불확실한 결정 과정으로 보고 conformal prediction으로 충분히 믿을 만할 때만 진행하며 아니면 도움을 요청한다 | 보정 집합을 벗어나면 신뢰도가 흔들린다 |
| 기하 구조 | 지시문을 물체 중심 기하 관계를 담은 계층적 spatio-temporal 논리 구조로 옮긴다 | 표현이 복잡해질수록 계산 부담이 커진다 |
남는 실패 유형 두 가지도 명시된다. 하나는 vacuous satisfaction으로, 함의형 요구의 전제가 아예 발생하지 않아 의도한 대응 없이도 명세가 형식상 만족되는 경우다. 로봇 관점에서는 환경 가정이나 물체 가용성이나 촉발 조건이 어긋나면 형식적으로 유효한 plan이 사용자의 안전 의미를 놓칠 수 있다는 뜻이다. 다른 하나는 계산 복잡도로, LTL 추론은 일반적 정식화에서 이미 PSPACE-complete이고 기하 추상화와 long-horizon 조합이 더해지면 부담이 커진다.
planner verification은 사후 선별에서 디코딩 제약으로, 다시 closed-loop 교정으로 발전했다. 기본형은 사전 실행 선별 계층으로 불변식과 precondition과 postcondition 검사를 써서 구조적으로 무효한 plan을 거부한다. 더 밀착된 방식은 LTL에서 유도한 제약으로 자기회귀 생성 중에 허용되지 않는 plan 연속을 가지치기한다. 위반이 발생하면 모델 검사 진단과 반례 정보를 planning 프롬프트로 되돌려 plan 수리와 프롬프트 개선에 쓴다. 반복적인 형식 검증의 비용을 줄이기 위해 검증 출력을 경량 신경망 surrogate verifier로 distillation하는 최적화도 있는데, 동등한 보장을 주는 것이 아니라 보증을 학습 데이터 범위와 근사 품질에 의존하게 만든다. 그 아래에는 2차 언어 모델을 정성적 안전 판정자로 쓰거나 시뮬레이터와 사람 개입과 구문 오류 로그로 Behavior Tree를 고치는 낮은 보증 수준의 비평 루프가 있다.
이 검증 묶음의 근거 경계는 specification 상대적이다. verifier가 확인하고 형식화할 수 있는 범위 안에서만 plan이 규칙과 일관됨을 높인다. 중심 빈틈은 명세 상대적 정확성과 embodied 안전이 같지 않다는 점이다. 불완전한 predicate, 낡은 perception, 빠진 contact 가정, 실현 불가능한 기하 전이 위에서도 plan은 검증을 통과할 수 있다.
공간과 model 기반 planning 지원
마지막 단계는 논리적으로 검증된 시퀀스를 장면에 grounding되고 motion feasibility를 갖춘 명세로 바꾼다.
world model과 foresight는 미래 상태 예측을 planning 루프에 결합한다. 예측 rollout으로 단계별 논리와 시각 결과를 추적해 상태 연속성을 평가하고, 상상된 미래 상태를 교정 신호로 써서 실행 전에 action 시퀀스를 고치며, 다중 시점 world model과 stage 인식 구조로 transition 일관성을 높인다. 근거는 예측 상대적 empirical 수준이다. horizon이 길어질수록 예측된 미래는 환각과 분포 변화와 compounding error에 취약해지고, 시각 foresight는 가림이나 예상 밖 물체 동역학 아래의 물리적 feasibility를 담지 못한다. 미래가 어떻게 보일지를 예측하는 것과 로봇이 어디로 움직여야 하는지를 기하학적으로 확정하는 것은 다른 문제다.
공간과 물체 중심 제약 구성이 그 다음을 맡는다. 같은 subtask 이름이라도 물체의 어느 부분을 잡고 어떤 상대 자세를 목표로 하느냐에 따라 도달 가능성과 contact 안정성과 배치 결과가 크게 달라진다. 과제 의도를 3D 영역과 keypoint와 물체 부위로 옮기는 기법이 이를 담당하며, relational keypoint constraint로 상호작용 대상과 공간 경계를 지정하거나 부위 수준 기하 구조를 planning 변수로 다루거나 정밀한 시각 의미를 다듬을 수 있는 3D 공간 제약으로 바꾼다. 벤치마크 근거는 명시적 공간 grounding을 빼면 long-horizon plan의 실행 가능성이 크게 낮아진다고 보고한다. 근거 경계는 empirical spatial grounding까지이고, 충돌 없고 기구학적으로 가능하며 contact가 안정적인 trajectory의 존재까지 보장하지는 않는다.
integrated Task and Motion Planning은 심볼 구조와 연속 기하 제약을 하나의 표현으로 묶는다. 역기구학과 물체 자세와 충돌 없는 trajectory 같은 연속 변수를 블랙박스 샘플러로 심볼 planner에 연결해 물리 feasibility 조건을 심볼 탐색 중에 쓸 수 있게 만드는 것이 형식적 기준선이다. 최근에는 지시문과 observation을 도메인 전용 명세로 바꿔 기하 제약 추론을 지원하거나, 열린 세계의 언어 grounding을 이산과 연속 제약으로 바꿔 표준 TAMP solver에 통합한다. 여기에 motion planning 실패를 상위 추론으로 되돌리는 feedback 루프가 마지막 사전 rollout 정제 수단으로 붙는다.
policy-time safety
policy-time safety는 다음 action이 환경에 확정되기 전에 policy를 어떻게 조형하는지를 다룬다. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. 3장이 추상적 과제 정식화의 위험을 다뤘다면, 4장은 후보 action과 subtask 전이와 학습된 선호가 결정 시점에 어떻게 형성되는지를 본다.
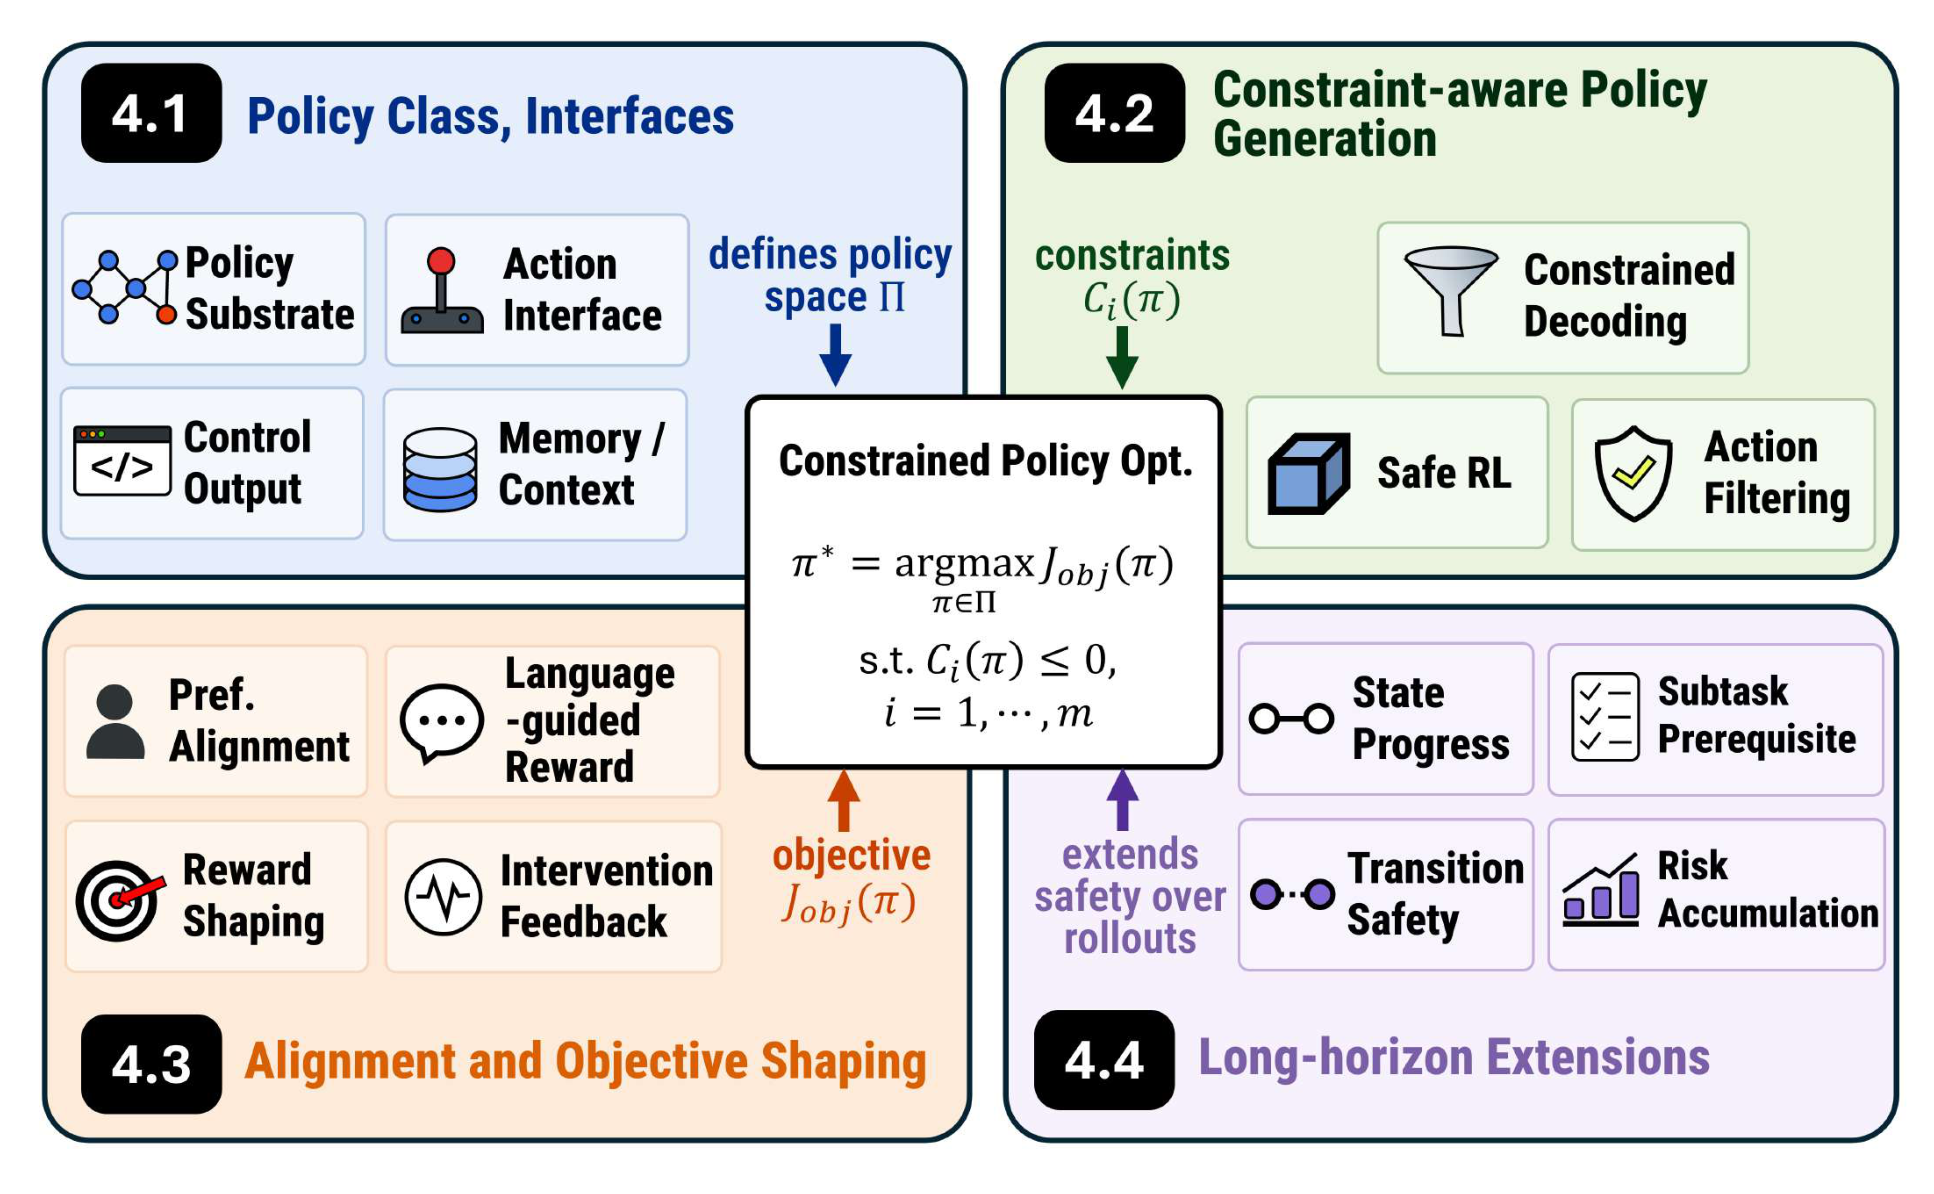
서베이는 policy 생성을 제약 있는 최적화로 정식화한다. 목적함수를 최대화하되 제약 함수들이 0 이하가 되도록 policy 공간에서 policy를 고르는 형태다. 모든 기법이 문자 그대로 이 식을 쓰는 것은 아니지만 4장 전체를 묶는 추상으로 삼는다.
policy class와 개입 표면
안전 개입은 모든 policy 기반에 똑같이 적용되지 않는다. backbone이 노출하는 표현이 무엇을 제약할 수 있는지를 결정한다.
| policy 표현 | 개입 표면 | 가능한 조형 | 대표 연구 |
|---|---|---|---|
| tokenized VLA | action 어휘 | 위험한 토큰 차단, 가중치 조정, 제약 디코딩 | RT-2, OpenVLA |
| 연속 또는 chunked action | trajectory 수준 분포 | 투영, 재샘플링, 연속 안전 필터 | Diffusion Policy, Octo |
| 프로그램과 스킬 interface | 코드 줄과 API 호출 | 실행 전 검사, 상태 조건부 스킬 공간 제한 | Code as Policies, SayPlan |
long-horizon 컨텍스트 처리 방식도 안전과 직결된다. 긴 rollout 동안 낡은 observation과 진행 상황 혼동과 subtask drift가 쌓이기 때문이다. 계층적 언어 조건부 policy는 상위 latent plan과 하위 visuomotor policy로 나누고, 메모리 증강 backbone은 과거 observation과 action의 정보를 유지하며, interleaved 언어 planning이나 시각 예측이나 시각 chain-of-thought로 중간 진행 변수를 드러내는 계열도 있다.
제약 인식 policy 생성
제약 주입은 명세된 제약을 실행 전에 강제하는 가장 직접적인 방법이다. 학습 분포에만 기대지 않고 action space를 능동적으로 제한한다. policy interface에 따라 STL 제약 아래 토큰 연속을 마스킹하거나 가중치를 낮추는 방식, 생성된 프로그램 줄을 API와 상태 검사 구문에 대조하는 방식, 안전 layer와 투영과 미분 가능 최적화 모듈로 연속 action을 수정하는 방식으로 나뉜다. 안전 범위는 모델링된 규칙의 정확도와 시스템 interface와 명세 품질에 묶여 있다.
shielding은 학습 기반 설정에서 가장 가까운 고전적 대응물이다. shielding은 전용 안전 layer가 학습기의 제안을 감시해 선택지를 제한하거나 명시적 temporal 명세에 맞게 위험한 action을 교정하는 기법을 말한다. policy를 다시 학습시키지 않고 작동한다는 것이 특징이다. 최근 연구는 이 개입을 자기회귀 action 생성 안으로 옮겨 디코딩 중에 허용되지 않는 후보를 마스킹한다. 이때 주장은 좁지만 강하다. 명세와 시스템 모델이 명시적일 때 위험한 action 제안을 실행 전에 차단하거나 수정할 수 있다는 것이며, 보장은 인코딩된 제약과 interface에 상대적이다.
제약 있는 학습은 안전을 policy 최적화 과정 자체에 내재화한다.
| 계열 | 정식화 | 보장의 성격 |
|---|---|---|
| CMDP 기반 safe RL | 기대 reward를 최대화하면서 기대 safety cost 한도를 지킨다. trust region 갱신과 적응적 Lagrangian 승수가 대표 알고리즘이다 | 기대값 기반이라 학습 중 일시적이거나 상태별 위반을 허용할 수 있다 |
| hard-constrained RL | 등식 제약을 축소된 policy 최적화로 다루거나 아핀 상태 제약을 강제한다 | 각자의 구조적 가정 아래에서는 더 강하지만 언어 유도 long-horizon manipulation을 직접 풀지는 않는다 |
| VLA 안전 정합 | 위험 시나리오를 끌어내 VLA policy를 fine-tuning해 고위험 행위를 줄인다 | 통계적 최적화와 시나리오 포괄 범위에 의존하는 empirical 근거다 |
certificate 기반 안전 학습은 일반적 안전 reward 대신 명시적 safe set과 certificate와 filter로 학습과 탐색을 조형한다. Hamilton-Jacobi reachability 기반 safe set과 predictive safety filter, CBF와 학습된 certificate, 안전 manifold와 호환되는 방향으로만 탐색하도록 action space를 변환하는 constraint manifold 방식이 여기에 속한다. 고차원 manipulation에서는 두 가지 병목이 있다. 복잡한 기구학과 contact 동역학에 대한 certificate를 해석적으로 유도하기 어렵고, 정확한 reachability 계산은 차원의 저주를 겪는다. 신경망 certificate는 확장성을 노리지만 연속 상태 공간에서 부등식을 인증하려면 추가 검증 기구가 필요하고, 학습된 safety filter는 학습 범위가 불완전하면 분포 변화와 OOD 위험에 취약하다.
정합과 objective shaping
명시적 제약은 위험한 후보를 막을 뿐 목적함수가 어떤 행위에 reward를 주는지는 정하지 않는다. policy-time 위험은 즉각적 충돌에 그치지 않고 의미적 어긋남과 사람을 향한 위험한 행위와 목적함수 오설정까지 포함하므로, 무엇을 우대하도록 학습시키는지가 따로 다뤄진다.
선호와 reward model 정합은 학습 목적함수를 사람의 판단에 맞춘다. trajectory 수준 사람 선호로 로봇 policy를 정합해 충돌률을 실증적으로 낮춘 사례가 있고, 변형 가능 물체 조작에 선호 정합 diffusion model을 적용해 개인화와 사람 지시 준수를 함께 개선한 사례가 있다. 대규모 선호 데이터 수집 비용을 줄이기 위해 적은 라벨로도 효과를 유지하거나 과제 사이에 전이하거나 품질이 섞인 데이터에서 학습하는 framework도 나왔다. 다만 안전 주장은 제한적이다. 선호 정합은 policy를 기피 행위에서 멀어지게 편향시킬 뿐 위험한 후보를 구성적으로 배제하거나 형식적 보증을 주지 않는다.
언어와 개입 기반 reward shaping은 feedback 채널을 넓힌다. long-horizon 실패는 희소한 성공 라벨만으로는 원인을 알기 어렵기 때문이다. 언어 조건부 reward model은 기술적 데이터나 시연 데이터(demonstration)로 미지의 과제 변형에 적은 표본으로 적응한다. LLM이 조밀한 프로그램식 reward 루틴을 만들고 사람의 텍스트 feedback으로 다듬는 방식은 언어를 편집 가능한 reward 설계 interface로 쓴다. 영상 언어 critic은 여러 embodiment의 영상 데이터에서 reward 함수를 학습하고, 사람의 물리적 개입 흔적은 도움이 필요한 영역을 표시하는 잔차 reward로 바뀐다. 근거 경계는 목적함수 상대적 empirical 수준이다. 이 채널들은 학습 시점이나 배포 전 목적함수를 조형할 뿐 인증된 runtime 감시기가 아니다.
long-horizon 확장
long-horizon manipulation은 policy-time이 다뤄야 할 실패 구조를 바꾼다. 위반이 이른 stage 전이, 건너뛴 전제 단계, 긴 rollout에 걸친 잠복 위험 누적으로 나타나기 때문이다.
구조 측면에서는 재사용 가능한 스킬과 프로그램식 action 루틴 같은 상위 interface를 노출해 subtask 진행을 검사 가능하게 만든다. 여기에 과거 observation을 압축하거나 다중 규모 메모리를 유지하는 컨텍스트 보존 기구를 더해 낡은 상태 오류를 줄이고, foresight model로 후보 미래를 평가하거나 policy가 말한 추론과 제안한 action의 정합을 검사하는 추론 시점 steering을 붙인다. 근거 경계는 형식적이 아니라 구조적이고 추론 시점에 한정된다. 진행을 더 잘 보이게 만들고 일부 컨텍스트 상실이나 순서 오류를 줄이지만 rollout 전체가 절차적으로 안전함을 증명하지는 않는다.
목적함수 측면에서는 stage 인식 reward 모델링이 상위 과제 stage와 stage 내 진행을 분리해 절차적 drift를 직접 벌점화한다. reward 유도 latent planning과 대규모 post-training으로 long-horizon 일관성을 높이는 방향도 있다. 다만 이 정합 채널들은 잡음이 섞이거나 오염된 사람 feedback에 취약하고, policy 수준 절차 안전에 대한 보정된 수학적 한계를 주지 못한다. 남는 빈틈은 policy가 가진 진행과 메모리와 stage 단위 reward의 표현이 과제의 실제 절차적 의존 관계에 충실한지를 보장하는 방법이다. 그렇지 않으면 policy는 잘 조직된 것처럼 보이면서도 숨은 전제 단계를 건너뛰거나 stage reward를 악용할 수 있다.
execution-time safety
execution-time safety는 action이 이미 물리 세계에 확정된 뒤를 다룬다. 이 시점의 시스템은 이상적인 plan이나 정적 제약이나 조형된 목적함수 위에서 추론하지 않고 observation 잡음과 장면 변화와 contact 불확실성을 직접 상대한다. 추상적 안전 주장이 운영 현실이 되는 계층이다.
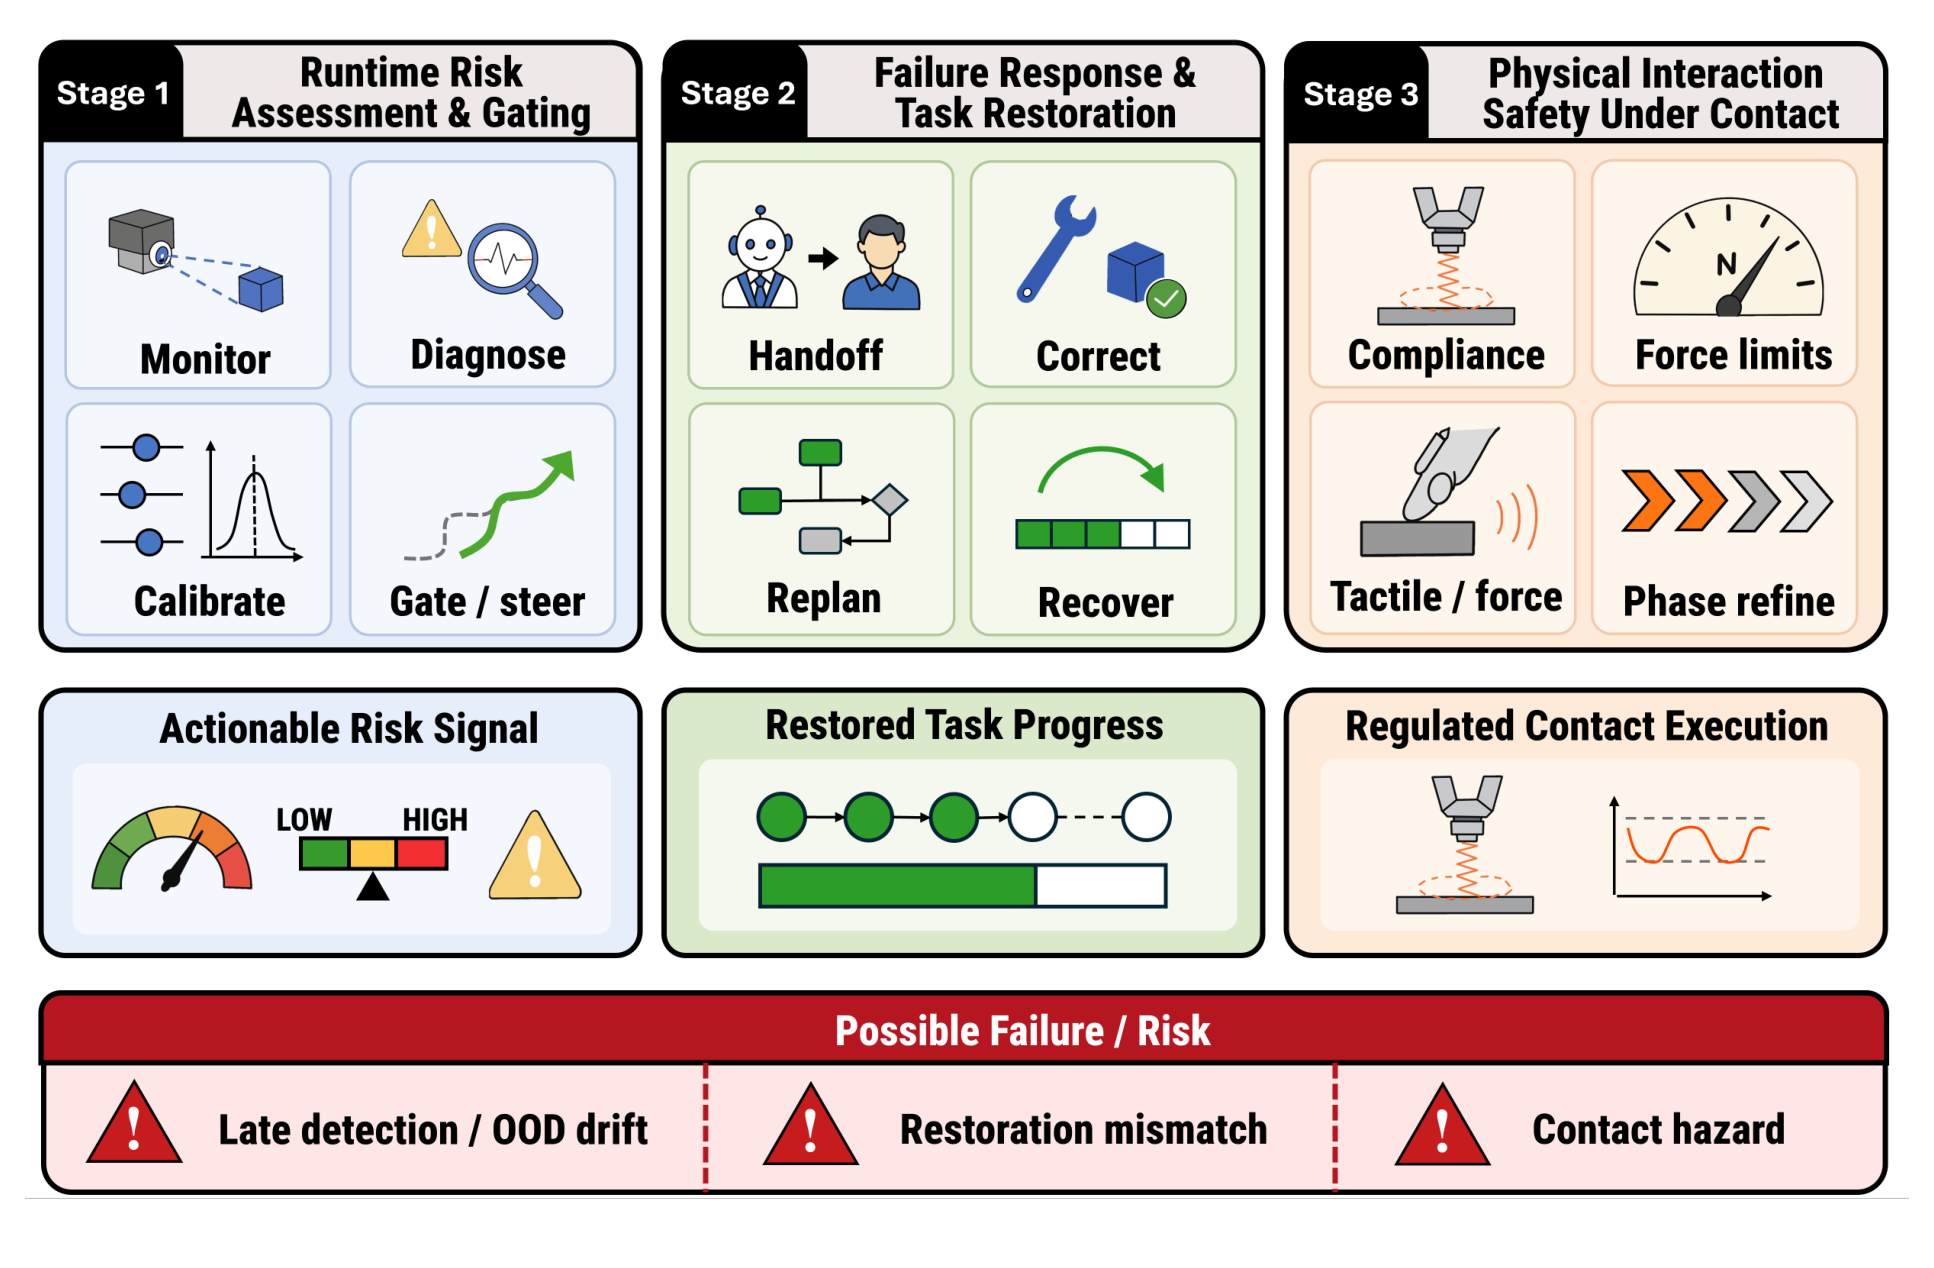
runtime 위험 평가
핵심 질문은 실패가 확대되기 전에 위험한 rollout을 충분히 일찍 탐지할 수 있는가다. long-horizon manipulation에서 위험은 단일 파국 사건이 아니라 분포 변화와 놓친 precondition과 의미적 어긋남과 점진적 환경 변화로 쌓인다.
runtime monitoring은 사후 성공 분류가 아니라 조기 편차 탐지로 이해해야 한다. 상태 수준 이상 점수화에서는 로봇 조건부 normalizing flow로 선제 이상 탐지를 하거나 latent dynamics model로 OOD 상태를 미리 예상한다. 생성형 policy와 foundation model 기반 policy에서는 연속 잡음 공간의 편차를 재거나 entropy 기반 점수로 action 의도의 불확실성을 감시하거나 VLA 내부 표현으로 다중 과제 실패를 탐지한다. 이 원점수를 실행 가능한 결정으로 바꾸는 장치가 conformal prediction으로, 통계적으로 보정된 경보 임계값을 제공한다. 단일 스칼라 점수는 취약하므로 RGB와 depth와 오디오를 융합하거나 다중 시점 카메라와 명시적 3D 공간 feature로 가림 상황의 실패 인식을 개선한다. 공통 과제는 파국적 실패를 일관되게 막을 만큼 빠르면서 일반화 범위는 넓고 오경보율은 낮게 유지하는 것이다.
순간적 이상 탐지를 넘어서면 과제의 시간적 전개와 의미 의도를 추적해야 한다. VLM이 생성한 코드로 spatio-temporal 제약을 연속 검사하는 방식이 명시적 runtime 의미론에 가장 가깝다. 로봇이 물리적으로는 안정적인데 과제 의도와의 의미 정합을 잃는 진행 실패도 대상이 되며, 생성형 policy에서 시간적 비일관성과 task progress 실패를 분리해 다루거나 의미적 어긋남 자체를 탐지 대상으로 삼는 연구가 있다.
실패 진단은 편차가 있다는 사실을 넘어 원인을 밝힌다. 의미 grounding 오류와 실행 drift와 contact 교란은 같은 실패 신호를 내더라도 전혀 다른 대응을 요구하기 때문이다. 구조적 진단은 수작업 실패 분류나 심볼 predicate에 국소화하고, 인과 네트워크나 의미 scene graph 같은 관계 모델로 근본 원인을 찾는다. 대규모 실행 데이터에서 실패 유형을 비지도로 발견하거나 재발 실패를 유도하는 환경 조건을 능동 탐색으로 찾는 연구도 있다. 생성형 진단은 고정된 분류 체계 대신 LLM으로 요약된 다중 모달 감각 데이터를 추론하고, manipulation 고유의 실패 탐지에 자연어 설명을 결합한다.
runtime shielding은 이 신호들을 action 수준 개입으로 바꾼다. 제어 이론 기반 shielding은 명시적 모델 가정 아래 safe set의 forward invariance를 인증하고 추가 최적화 layer로 제약을 강제한다. policy에 무관한 plug-and-play 안전장치라는 점이 구조적 장점이다. 로봇 grasping과 시각 기반 제어의 가림 회피에 적용됐고, long-horizon에서는 안전 개입이 과제 feasibility를 영구히 파괴하지 않아야 한다는 task-consistency 요건이 강조된다. 명시적 dynamics model이 없는 개방 어휘 환경에서는 학습과 latent와 의미 기반 shielding이 쓰인다. diffusion policy 제안을 집합 기반 reachability로 검증해 원래 분포를 무너뜨리지 않으면서 안전을 확보하거나, 시각 제약 명세에서 latent safety filter를 온라인으로 적응시키거나, 보정된 epistemic uncertainty로 latent 상태 공간을 늘려 알려진 hazard와 OOD 상태 진입을 함께 막는다. 개방 어휘 장면 이해에서 보호 장치를 만들거나 VLM으로 CBF를 구성해 pre-training된 VLA에 결합하는 방식도 있다.
runtime policy steering은 최악의 위반을 막는 shielding과 달리 실패가 완전히 드러나기 전에 더 위험이 낮은 후보를 고른다. action 제안을 미리 전개하고 VLM verifier로 의미 plan과 가장 일관된 trajectory를 고르는 방식, latent world model로 미래 상태를 투영하고 VLM이 그 표현 위에서 추론해 선택을 유도하는 방식, policy rollout으로 학습한 보조 verifier로 실행을 성공 쪽으로 편향시키는 방식이 있다. 여러 rollout을 평가하면 지연이 생기므로 verifier 없는 steering도 나왔다. diffusion model의 denoising 루프에 충돌 회피 gradient를 직접 주입하거나, VLA의 latent 공간에서 희소 feature 방향을 조작해 신중한 행위 쪽으로 이끈다.
runtime 적응과 과제 복원
action 수준 조정으로 감당되지 않는 경우, 즉 현재 subtask 자체가 구조적으로 실행 불가능해진 경우에는 상위 plan을 바꿔야 한다. 서베이는 사람 의존도 순서로 네 단계를 배열한다.
| 단계 | 개입 방식 | 촉발 신호와 기법 | 근거 경계 |
|---|---|---|---|
| 사람 개입과 제어 이양 | 자율 실행을 멈추고 사람에게 넘긴다 | 토큰 수준 entropy, 장면 affordance 기반 신뢰도 보정, novelty 탐지, 학습된 정밀도 제약 | 가장 확실하지만 자율성을 가장 적게 남긴다 |
| 상호작용 교정 | 로봇이 루프에 남은 채 국소 실패를 고친다 | 환경 불일치 선제 수정, 충족되지 않은 precondition 해소, 언어로 제약과 subgoal 주입, latent 제어 공간 조작, VR 자세 미세 보정 | 전체 과제 구조가 여전히 유효하다는 가정 |
| 선제와 반응적 replanning | 활성 시퀀스와 제약 명세를 바꾼다 | 참조 scene graph와 어긋나면 subtask 경계에서 수정, 제약 위반 시 제어 루프를 벗어나 즉시 replanning, 점유된 수납 공간 같은 불일치의 재해석 | continuation feasibility까지이고 자율 복원은 아니다 |
| 자율 복원 | 회복 가능한 상태를 복원한다 | milestone 기반 rollback, 의미 검증된 중간 상태로의 state respawning, episodic memory 회수, 실패와 교정 쌍 자동 생성 학습, 생성 world model 기반 반사실 실패 합성 | rollback은 checkpoint 상대적이다 |
자율 복원에서 특히 중요한 관찰은 long-horizon 실패가 경로 의존적이라는 점이다. precondition이 더 이상 성립하지 않거나 물체가 크게 잘못 놓이면 다음 action을 바꾸는 것으로는 부족하고 전체 과제 구조를 복원해야 한다. 학습 기반 복원은 정상 시연 데이터가 복원이 필요한 상태를 거의 보여 주지 않는다는 문제에서 출발한다. 실패 상태와 실행 가능한 교정 action 쌍을 자동 생성해 VLA에 복원 지침을 주는 방식, 오류 원인과 필요한 공간 교정과 기대 결과를 기술하는 풍부한 교정 언어를 쓰는 방식, 실제 실패 데이터 수집이 위험하거나 비쌀 때 성공 시연을 생성 world model로 변형해 실패와 교정 쌍을 만들고 물리적으로 타당한 것만 남기는 방식이 제시된다.
구조화된 복원 framework도 별도로 정리된다. foundation model이 열린 형태의 복원 추론을 가능하게 하지만 명시적 실행 골격이 없으면 그럴듯한 우회책을 찾으면서 precondition과 재시도 구조와 남은 과제의 논리적 일관성을 놓치기 쉽기 때문이다. Behavior Tree 기반 접근은 precondition 검사와 postcondition 감시와 동적 트리 확장으로 빠진 단계를 실행 가능한 구조에 삽입한다. neuro-symbolic 복원은 ontology와 논리 규칙으로 생성된 복원 plan이 과제 제약과 일관되는지 검사한다. predicate 기반 안전 논리는 최근 trajectory와 예상 위험을 실행 가능한 안전 predicate로 바꿔 완화나 replanning을 촉발한다.
contact 구간 물리 상호작용 안전
물리적 contact가 개입하면 질문이 바뀐다. 올바른 심볼 plan을 따르고 있는가가 아니라, 실행된 움직임이 힘 한계와 마찰과 미끄러짐의 모델링 불확실성과 복잡한 기하에 대해 안전하게 조절되는가다. 되돌릴 수 없는 실패의 상당수가 이 contact 병목에서 발생한다. 겉보기에 올바른 action이 삽입을 걸리게 하거나 grasping에 과부하를 주거나 짧은 조절 실패로 과제를 불안정하게 만든다.
adaptive compliance는 가장 덜 제한적인 방식이다. impedance control과 operational space formulation이 뿌리이며, 강체적 위치 추종 대신 외력에 대한 동적 응답을 조절한다. 최근 연구는 상태 의존 compliance 프로파일을 학습해 큰 힘을 피하거나, proprioception 이력에서 외력을 추정해 위치와 힘 제어를 함께 모델링하거나, 여러 embodiment에 일반화되는 plug-and-play admittance layer를 제공한다. proprioception은 로봇이 자기 관절 각도와 토크 같은 내부 상태를 감지하는 것을 말한다. 능동적 힘 적응 쪽은 힘과 촉각 신호를 policy 학습에 직접 통합하거나 미래 contact 예측과 반응적 힘 제어를 융합한다. foundation model 쪽은 세 가지 전략으로 나뉜다.
| 전략 | 방법 |
|---|---|
| 표현 학습 | 6축 wrench, 관절 토크, 고차원 촉각 observation을 토큰화해 VLA embedding 공간에 융합한다 |
| force distillation | 전용 하드웨어 없이 시각과 상태 전이에서 물리적 상호작용 단서를 암묵적으로 추론한다 |
| 상위 추론과 하위 실행의 연결 | VLM 추론으로 impedance 파라미터를 조절하거나 계층적 force-aware 프롬프트로 closed-loop 하이브리드 힘 위치 제어를 수행한다 |
formal constraints는 compliance만으로 부족할 때 개입한다. 일반화된 contact model 위에 force-constrained CBF를 세워 힘 한계를 강제하는 것이 가장 명확한 형식적 범주다. contact 기반 능동 탐색, 사람과 로봇의 물리적 협업, 소프트 액추에이터의 contact force bounding으로 확장됐다. 보수적인 안전 필터가 과제를 멈춰 세우지 않도록 operational space 안에서 안전 한계를 정식화하거나, 혼잡 환경에서 안전한 밀기를 허용하도록 엄격한 충돌 회피를 완화하는 방향도 있다. 이 기법들은 조건부 형식 보장을 주지만 복잡한 contact 동역학을 모델링하기 어렵다는 한계가 있어 단순화된 해석 모델이나 uncertainty observer에 기댄다. 그래서 데이터 기반 안전 필터링이 보완으로 등장한다. 액체 취급이나 변형체 조작처럼 해석적으로 다루기 힘든 경우에 reachability 방식을 학습된 latent 공간으로 확장하고, pre-training된 vision model로 고차원 시각 영역까지 확장한다. latent filter가 과제를 끊는 제어 불연속을 만들 수 있으므로 매끄러움을 명시적으로 최적화하는 연구도 있다.
hierarchical refinement는 느린 의미 추론과 빠른 물리 동역학 사이의 시간 규모 불일치를 구조로 푼다. 명목 policy가 자유 공간에서 거친 의미 진행을 맡고, contact가 시작되면 반응적인 2차 기구가 국소 기하와 힘과 정렬 drift를 안정화하는 분리 구조다.
| 구성 | 느린 계층 | 빠른 계층 |
|---|---|---|
| 비마르코프 구조와 촉각 융합 | 1~2Hz로 과제 구조를 모델링한다 | 20Hz 이상의 비대칭 빠른 policy가 촉각 feedback을 닫는다 |
| 명목과 잔차 분리 | chunked behavior cloning policy가 거친 planner 역할을 한다 | 한 자릿수 더 빠른 학습된 잔차 policy가 분포 변화를 흡수한다 |
| multi-rate 계층 | 느린 master 유도가 과제 진행을 이끈다 | 고주파 미세 교정이 실시간 wrench를 보정한다 |
| 동결 기반과 병렬 경로 | 명목 policy를 동결해 둔다 | 병렬 잔차 경로가 재학습 없이 고속 교정을 제공한다 |
phase 기반 구조는 과제를 접근, 탐색, 복원, 삽입, 완료 같은 국면으로 나누고 contact 인식 phase 예측기로 언제 고주파 잔차 교정이 지배해야 하는지를 정한다. contact subgoal을 이산 milestone으로 써서 의미 planning에서 반응적 안정화로 넘어가는 시점을 표시하기도 하고, 최근 VLA는 stage 인식 힘 개념을 backbone에 내장해 조립 국면에 따라 힘과 위치 목표를 적응적으로 배합한다.
결과
서베이이므로 결과는 새 실험이 아니라 근거 지형의 정리다. 핵심은 명목 성공과 안전한 실행이 같지 않다는 판정이다. 로봇은 불안정한 grasping과 과도한 contact force와 아차 사고와 지연된 개입을 거치면서도 long-horizon 과제를 완료한 것으로 평가될 수 있다. 반대로 위험을 일찍 탐지해 위해를 피하고 회복 가능한 상태를 유지한 채 실패했다면 그것은 안전한 실패다.
성능 벤치마크와 안전 벤치마크의 간극
manipulation 벤치마킹의 주류는 여전히 결과 중심이다. CALVIN과 LIBERO와 FurnitureBench는 다단계 또는 long-horizon 성능을 성공률이나 완료율로 평가한다. 재현성에는 필수지만 근거 대상이 rollout의 안전 이력이 아니라 최종 결과다.
진단형 벤치마크는 해상도를 높였다. VLABench는 이진 성공에 progress score를 더하는데, 완료된 subtask 수를 전체 subtask 수로 나눈 값이다. RoboEval은 stage별 진행과 공간 근접도와 충돌 사건을 보고하고, 안전의 대리 지표로 자주 쓰이는 motion smoothness를 평균 Cartesian jerk와 평균 관절 jerk로 근사하며, 환경 충돌과 자기 충돌과 물체 미끄러짐 횟수를 센다. 이 지표들은 안전과 관련되지만 위험이 처음 나타난 시점이나 위해 이전에 개입이 있었는지를 정의하지 못한다. 저자들은 이를 성능 평가와 안전 평가를 잇는 다리로 본다.
계층별 근거와 지표
안전 평가는 근거 대상에 따라 네 계층으로 나뉜다. 어느 벤치마크가 한 계층에만 속한다는 뜻이 아니라 안전 주장의 1차 대상이 무엇인지를 가리킨다.
| 계층 | 평가 대상 | 대표 지표 | 주장의 경계 |
|---|---|---|---|
| plan-level | 과제 프롬프트, 생성된 plan, 제약 집합, 형식 명세 | 결함 탐지율, 거부율, recall, F1, 안전 실행률, 실행 가능 planning 비율, 명세 만족 비율 | 위험한 의도를 거부하고 제약을 만족했음까지이며 물리 실행 안전은 아니다 |
| policy-level | 확정 전 개입이 만든 행위 결과 | 누적 safety cost, 장애물 회피율, STL 만족도와 robustness 점수, 최대 제약 위반 | 사후 요약이라 위험의 발생 시점과 심각도를 짚지 못한다 |
| runtime-level | 실행 중 탐지와 개입과 복원 | TPR, TNR, FPR, AUROC, 경보 시각, 개입률, 개입 조건부 성공률, 복원 성공률 | 운영 대리 지표이며 물리적 위해가 제한됐음을 직접 보이지는 않는다 |
| contact-level | 힘과 압력과 접촉 지속 같은 물리량 | 평균 상호작용 힘, 평균 contact 수직력, 힘 제약 성공률, 과압과 저압 시간 비율, 시행 지속 시간 | 물리적으로 가장 가깝지만 임계값 선택과 센서 품질에 의존한다 |
plan-level 평가는 세 계열로 나뉜다. 위험 선별과 안전한 replanning은 생성된 plan을 안전과 위험으로 분류하거나 안전 제약 아래 수정한다. 제약 만족은 공간과 기하와 시간과 논리 제약을 명세하고 planner가 그것을 지키는지를 본다. 다만 빨래 개기처럼 열린 과제에서는 keypoint와 제약이 적절히 정식화됐는지를 사람이 직접 평가해야 하는 경우가 생긴다. 명세 정확성은 자연어 지시문이 형식 명세나 통계적으로 신뢰할 만한 명세로 옮겨졌는지를 평가 대상으로 삼으며, 번역 성공률과 사람 개입 요청 빈도를 보고한다.
policy-level 평가는 세 측면으로 나뉜다. 제약 조건부 행위는 성공률과 도메인별 안전 지표를 함께 보고하며 누적 safety cost는 에피소드마다 단계별 cost를 합한 뒤 에피소드 수로 평균한 값이다. 정합 조건부 행위는 사람의 선호나 개입이나 문맥적 기대와 얼마나 맞는지를 보며, 선호 정합 VLA가 성공률 개선과 충돌 빈도 감소를 함께 보고한 사례가 있다. 위험 스트레스 행위는 perturbation과 의미적 위험과 적대적 시나리오 아래에서도 안전 기구가 유효한지를 본다. 안전한 장면과 위험한 장면을 짝지은 twin scenario로 최종 성공률이 낮을 때도 policy가 hazard 쪽으로 진행하는지를 드러내거나, 물리적 red teaming으로 위험을 품은 장면을 합성해 평범한 평가에서 드러나지 않는 행위를 노출한다.
runtime-level 평가는 네 측면으로 나뉜다. 실패 중심 데이터셋은 편차를 볼 수 있게 만든다. 성공 시연을 변형해 실패 trajectory를 만들거나, 시뮬레이션과 실제 환경에서 planning과 실행 실패를 합성하거나, 탐지와 국소화와 교정을 위한 구조화된 질의응답 지도를 제공한다. 실패 탐지와 조기 경보는 실패를 양성 클래스로 두고 TPR과 TNR과 FPR을 보고하며, 임계값에 무관한 순위 성능으로 AUROC를 쓴다. 경보 시각은 실패 점수가 임계를 처음 넘는 시각으로 정의하고 실패한 rollout들에 대해 평균을 낸다. 개입과 결정 유보는 개입 빈도와 그 조건에서의 성공률을 함께 본다. 과제 성공을 최대화하는 것과 불필요한 사람 부담을 최소화하는 것 사이의 상충이 이 지표의 핵심이며, 탐지기 명세와 보정 집합을 함께 보고해야 한다. 복원과 replanning은 교정 개입 이후 목표 상태에 도달한 시행의 비율을 본다. 다만 이진 복원 성공률은 복원 과정의 품질과 안전 비용을 가린다. 복원에 걸린 시간과 제어 노력이 과도하거나 중간 행위가 2차 실패에 가까울 수 있기 때문이다. 그래서 복원 효율과 복원 중 2차 위반율과 replanning 중 trajectory 매끄러움을 함께 보고하자고 제안한다.
contact-level 평가는 세 측면으로 나뉜다. contact 정렬 데이터셋은 시각 observation과 proprioception 상태와 action에 더해 힘과 토크와 촉각 observation과 contact 국면 라벨을 시간 동기화해 제공한다. 힘 조절 근거는 에피소드 평균 상호작용 힘이나 접촉 중에만 가중한 평균 수직력을 본다. 하드 임계 방식도 쓰이는데, 한 사례는 30N을 임계로 두고 연속 3스텝 위반이면 실패로 종료한다. 지속 시간 민감 근거는 과압과 저압 시간 비율로 활성 contact 시간 중 안전하거나 기능적인 힘 범위를 벗어난 비율을 재고, 조립에서는 완료 후 불필요한 지연이 contact 노출을 늘려 걸림이나 하드웨어 손상으로 이어지므로 시행 지속 시간과 조기 종료 판정의 precision과 recall을 함께 본다.
안전 벤치마크의 분포
서베이가 정리한 대표 벤치마크와 평가 프로토콜 25종을 근거 대상 기준으로 묶으면 편중이 뚜렷하다.
| 근거 대상 | 해당 벤치마크와 프로토콜 |
|---|---|
| plan-level | SafePlan, Safety-as-Policy, EARBench, SAFEL, SafeAgentBench, VestaBench, EAsafetyBench |
| plan과 rollout 혼합 | AgentSAFE, SafeMindBench |
| cross-layer | SafeMindBench, IS-Bench |
| execution-level | SafeLIBERO |
| rollout 수준 제어와 강화학습 | Safe-control-gym, Safety-gymnasium, Hasard |
| 성능 중심 | CALVIN, LIBERO, LoHoRavens, FurnitureBench, RoboCerebra |
| 진단형 | VLABench, RoboEval, Term-Bench |
plan-level이 가장 많고 execution-level은 한 종이다. manipulation의 contact 구간 안전을 직접 겨냥한 재사용 가능한 벤치마크가 사실상 없다는 것이 이 표가 보여 주는 지형이다.
핵심 판정
계층별 지표는 서로 대체할 수 없다. 안전한 상위 plan이 안전한 실행을 보장하지 않고, 누적 safety cost가 낮은 policy도 순간적으로 위험한 contact를 만들 수 있으며, 복원에 성공해도 중간 과정이 위험했을 수 있다. 현재의 근거 지형은 제한된 계층별 주장들의 모음이지 end-to-end 안전 논증이 아니다.
한계
논문이 지목한 네 가지 빈틈
| 빈틈 | 내용 |
|---|---|
| policy-time 안전 근거의 부족 | 제약 주입과 정합은 empirical이고 분포 의존적이다. long-horizon VLA manipulation에 대한 결정론적 또는 형식적 보장은 열려 있다 |
| contact 구간 long-horizon의 약한 형식 근거 | 해석적 contact model이 단순화에 기대거나 uncertainty observer로 불일치를 보정하는 수준이다 |
| uncertainty 기반 개입의 미성숙 | 보정된 신호를 어떤 개입 의미로 연결할지에 대한 원칙이 없다. 약한 의미 불확실성은 확인 요청을 정당화할 뿐 즉각적 물리 shielding까지는 아니고, 보정된 실패 경보는 정지와 되감기와 이양 중 무엇을 택할지를 특정하지 못한다 |
| manipulation 전용 안전 벤치마크의 부족 | 안전 평가가 plan 선별, rollout 수준 안전 성공, runtime 탐지, 복원, contact 품질로 흩어져 있다 |
서베이 자체의 한계
정량 메타분석이나 재현 실험은 수행하지 않았다. 문헌 배정 규칙이 각 논문의 가장 강한 안전 관련 주장 하나를 기준으로 삼기 때문에 여러 계층에 걸친 연구는 한 계층으로 단순화된다. 저자들은 이런 중첩이 분류 오류가 아니라 long-horizon manipulation 안전의 본질적 성질이라고 설명하지만, 독자가 표만 보고 각 연구의 범위를 좁게 이해할 위험은 남는다. 또한 corpus에는 아카이브 상태와 실증 성숙도가 바뀔 수 있는 최신 preprint가 다수 포함되어 있다.
향후 방향
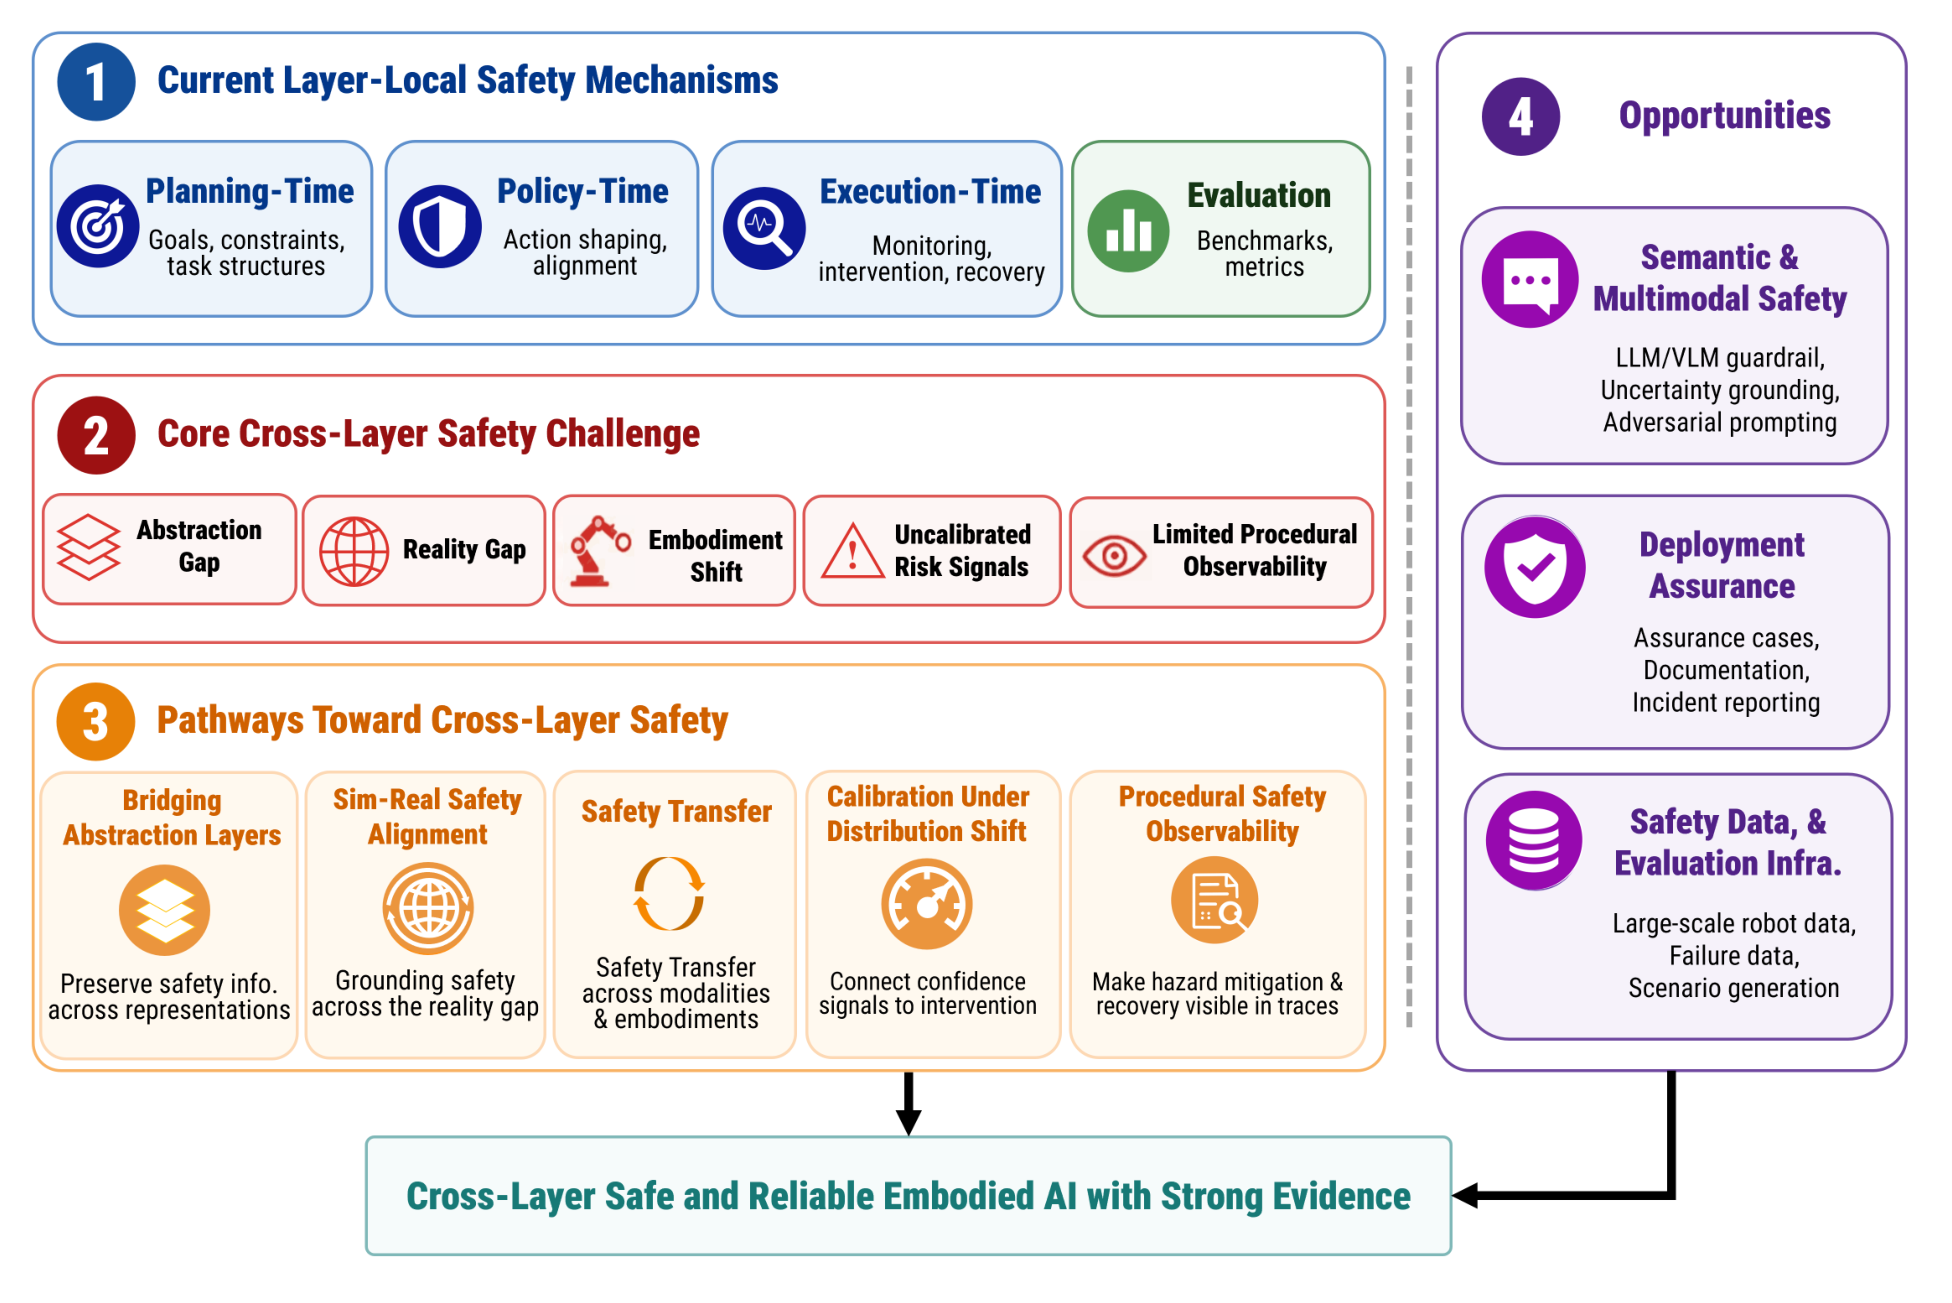
cross-layer 경로 다섯
- 추상화 계층 연결. 제약이 planning 계층에서 도입될 때 그것이 의미인지 기하인지 시간인지 물리인지를 이후 계층이 알 수 있을 만큼의 메타데이터를 보존해야 한다. "붉은 영역을 피하라"는 심볼 영역 이름과 기하 여유와 trajectory 배제를 모두 요구하고, "부드럽게 삽입하라"는 contact 국면 인식과 힘 한계와 compliance 파라미터를 요구한다. 어느 표현이 보편적으로 더 안전한가가 아니라 각 표현이 어떤 안전 변수를 보존하는가가 질문이다.
- 현실 격차를 건너는 안전 grounding. sim2real을 성능 전이가 아니라 안전 근거 문제로 다룬다. domain randomization과 적응적 시뮬레이션 randomization과 사람 온라인 교정 같은 기존 도구가 있지만, 과제 성공이 전이되어도 잘못된 안전 가정이 함께 전이될 수 있다. 물체 배치 정확도를 유지하면서 힘 한계를 위반하거나, 충돌 회피는 지키면서 복원 여유를 잃거나, 명목 성공은 유지하면서 실제 하드웨어에서 개입이 너무 늦을 수 있다.
- embodiment와 policy model 사이의 안전 전이. 성능 전이와 안전 전이를 분리한다. 사람을 피하거나 깨지기 쉬운 물체를 조심스럽게 다루는 의미 사전 지식은 비교적 잘 전이되지만, 공간 제약은 대상 로봇의 기하와 센서 보정과 기구학과 적재량에 맞춰 다시 grounding해야 한다. contact 관련 주장은 그리퍼 compliance와 촉각 감지와 액추에이터 한계에 묶여 있어 embodiment 의존성이 가장 크다. policy를 fine-tuning하거나 distillation하거나 정합하거나 post-training할 때마다 재검증 경계를 명시해야 한다.
- 개입 선택을 위한 보정된 위험 해석. 형식적으로 검사된 제약 위반, 통계적으로 보정된 실패 탐지기, 사람의 교정 신호는 같은 근거가 아니다. 높은 과제 성공률이 성공 가능성에 대한 신뢰할 만한 자기 추정을 뜻하지 않는다는 보정 연구가 이 문제의 한 단면을 보여 준다. 빠진 연결 고리는 보정된 근거를 개입 의미로 옮기는 체계적 대응이며, 분포 변화가 이 대응의 취약성을 키운다.
- procedural safety observability. 최종 결과만이 아니라 rollout의 안전 이력을 남겨야 한다. 안전한 성공, 안전한 실패, 위험한 성공, 위험한 실패를 구분하려면 hazard의 발생, 안전 여유가 깨지기 전의 완화 효과, contact 한계 유지, 개입의 적시성을 기록하는 cross-layer 안전 기록이 필요하다. 목표는 지표를 더 붙이는 것이 아니라 어떤 위험이 예상됐고 어떤 것이 실제로 나타났으며 어느 계층이 반응했고 그 반응이 위반 없는 계속 진행으로 이어졌는지를 검사 가능하게 만드는 것이다.
인접 분야 기회 셋
- semantic과 multimodal safety. RLHF식 지시문 튜닝, Constitutional AI, Llama Guard 같은 가드레일 모델, MM-SafetyBench 같은 다중 모달 벤치마크를 상위 의미 안전 기구로 재해석한다. VLM의 물체 환각 연구가 특히 관련되는데, 환각된 물체가 조작 대상 선택이나 affordance 추론이나 precondition 정의에 쓰이면 안전 문제로 바뀐다. 제안 방향은 두 가지다. 정적 텍스트와 이미지 필터링에서 물리적 hazard와 물체 취약성과 시공간 이상을 담는 동적 long-horizon 위험 taxonomy로 확장하는 것, 그리고 수동적 거부 필터가 아니라 스스로 문맥 불확실성을 정량화해 상위 지시문에 안전 명세가 없을 때 사용자에게 먼저 묻는 능동적 유도다.
- 배포 보증과 사고 학습. Goal Structuring Notation과 UL 4600과 AMLAS 같은 보증 공학 관행은 안전 근거가 벤치마크 성능이 아니라 명시적 주장 중심으로 구조화되어야 한다고 강조한다. model card와 datasheets for datasets를 본떠 policy card나 로봇 데이터 datasheet로 어떤 embodiment와 센서와 과제와 hazard와 contact 영역과 실패 사례와 복원 시나리오가 학습과 평가에 포함됐는지 기록하자고 제안한다. 사고 학습 쪽은 파국적 실패뿐 아니라 아차 사고, 위험한 성공, 불필요한 사람 개입, 지연된 이양, contact 이상, 과제는 완료했지만 암묵적 제약을 위반한 사례까지 기록하자고 제안한다.
- 대규모 데이터와 시뮬레이션과 평가 인프라. RoboNet과 BridgeData V2와 Open X-Embodiment와 DROID와 RH20T와 AgiBot World가 경험의 규모와 다양성을 늘렸다. 하지만 성능 데이터가 곧 안전 데이터는 아니다. 성공한 전문가 시연 데이터만으로 학습하면 멈추거나 되묻거나 실패에서 복원하거나 잠복한 물리적 위험을 피하는 능력을 배우지 못한다. LLM의 safety pre-training 연구가 같은 관찰을 하는데, 안전한 행위는 규모만으로 나타나지 않고 안전을 의식한 데이터 구성과 구조화된 거부와 명시적 위해 주석이 필요하다는 것이다. 로보틱스의 대응물은 hazard와 아차 사고와 실패 시도와 contact 측정과 위험한 성공을 포착하는 데이터 인프라다. 자율주행의 CARLA와 확률적 시나리오 언어 Scenic이 드문 long-tail 사건을 배포 전에 시험하는 모델로 제시된다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| intervention locus | 안전 기법이 embodied 파이프라인의 어느 시점에 개입하는지를 가리키는 첫 번째 조직 기준. planning-time, policy-time, execution-time 셋으로 나눈다 |
| evidence boundary | 보고된 안전 결과가 실제로 무엇을 뒷받침하고 무엇을 증명하지 않는지를 구분하는 두 번째 조직 기준 |
| procedural safety | 과제 순서와 precondition과 제약과 회복 가능 상태를 rollout 전체에 걸쳐 유지하는 안전 |
| shielding | 전용 안전 layer가 policy의 제안을 감시해 선택지를 제한하거나 명시적 명세에 맞게 교정하는 기법. policy 재학습 없이 작동한다 |
| recoverability | 안전한 계속 진행이나 정상적 종료가 여전히 가능한 상태인지를 가리키는 성질 |
| procedural safety observability | rollout의 최종 결과가 아니라 위험의 발생과 전파와 탐지와 완화 이력을 기록해 안전 주장을 뒷받침할 수 있게 만드는 평가 요건 |
| vacuous satisfaction | 함의형 요구의 전제가 발생하지 않아 의도한 대응 없이도 명세가 형식상 만족되는 상태 |
관련 페이지
- Vision-Language-Action Models for Robotics: A Review Towards Real-World Applications: Table 2에서 비교 대상으로 든 VLA 리뷰. 이 서베이는 그 아키텍처와 벤치마크 정리 위에 안전 근거 기준을 더한다
- LIBERO-Recover: Beyond Task Success Towards Failure Recovery in Robotic Manipulation Models: 5.2의 자율 복원과 6.2.3의 복원 근거를 벤치마크로 구현한 사례
- ReAcTree: Hierarchical LLM Agent Trees with Control Flow for Long-Horizon Task Planning: 3.2의 분해와 순서화, 5.2의 구조화된 복원과 맞닿는 계층적 과제 planning
- LLM-as-BT-Planner: Leveraging LLMs for Behavior Tree Generation in Robot Task Planning: 5.2에서 복원 골격으로 언급한 Behavior Tree 생성 계열
- A Comprehensive Survey on World Models for Embodied AI: 3.3의 world model과 foresight 기반 planning의 배경
- Chain Of Interaction Benchmark (COIN): When Reasoning meets Embodied Interaction: 6장이 지적한 성능 중심 평가와 절차 근거의 간극을 다른 각도에서 다룬 벤치마크
- A Survey of Physical AI: A History from ChatGPT to World Models and Embodied Agents: physical AI 전반의 로드맵 서베이. 이 페이지는 그 로드맵 중 안전 측면을 깊게 파고든다
- Physical AI 카테고리 지도와 학습 경로: physical-ai 카테고리 전체 허브
- 용어집: Physical AI (Terminology Glossary): 본문 전문 용어의 canonical 표기 기준