Physical AI · PAPER · 2026
HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System
요약
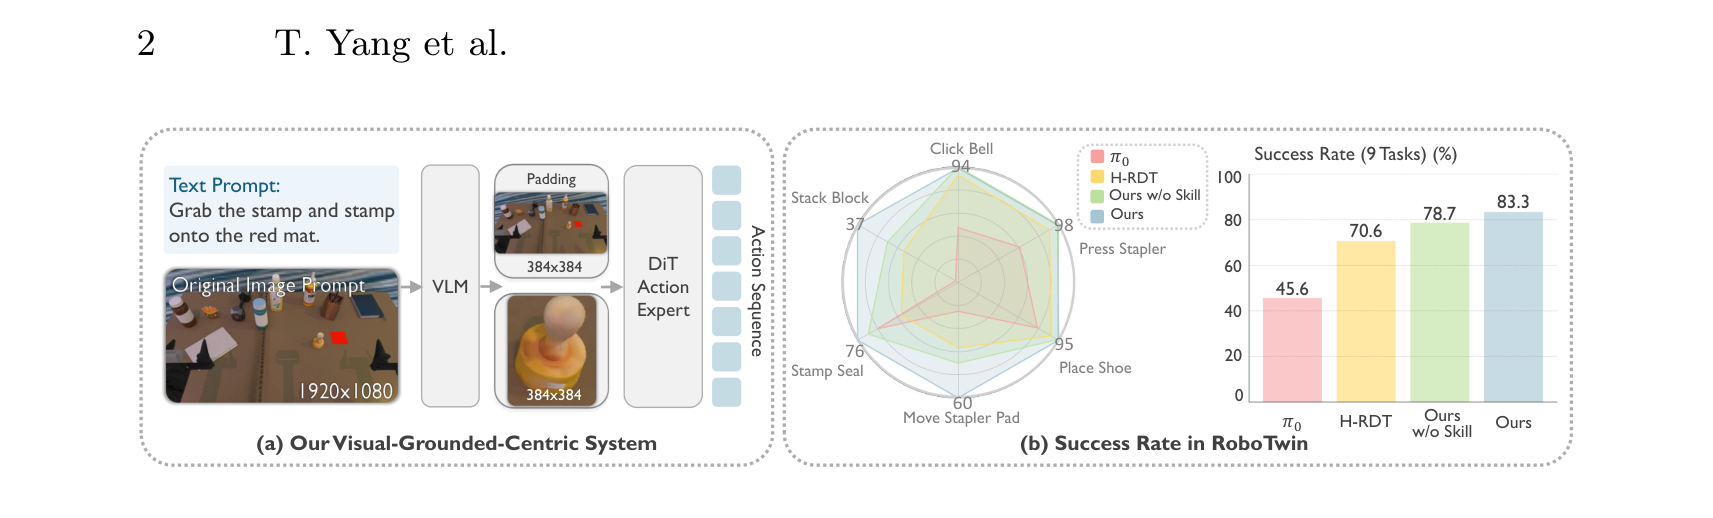
HiVLA는 상위 VLM과 하위 제어 모델을 명시적으로 분리하고, 둘 사이를 subtask 문장 하나와 대상 물체의 bounding box 하나로 잇는 manipulation 시스템이다. VLM은 계획만 담당하고 제어 데이터로 fine-tuning되지 않으므로 웹 규모 학습에서 얻은 추론 능력이 유지된다.
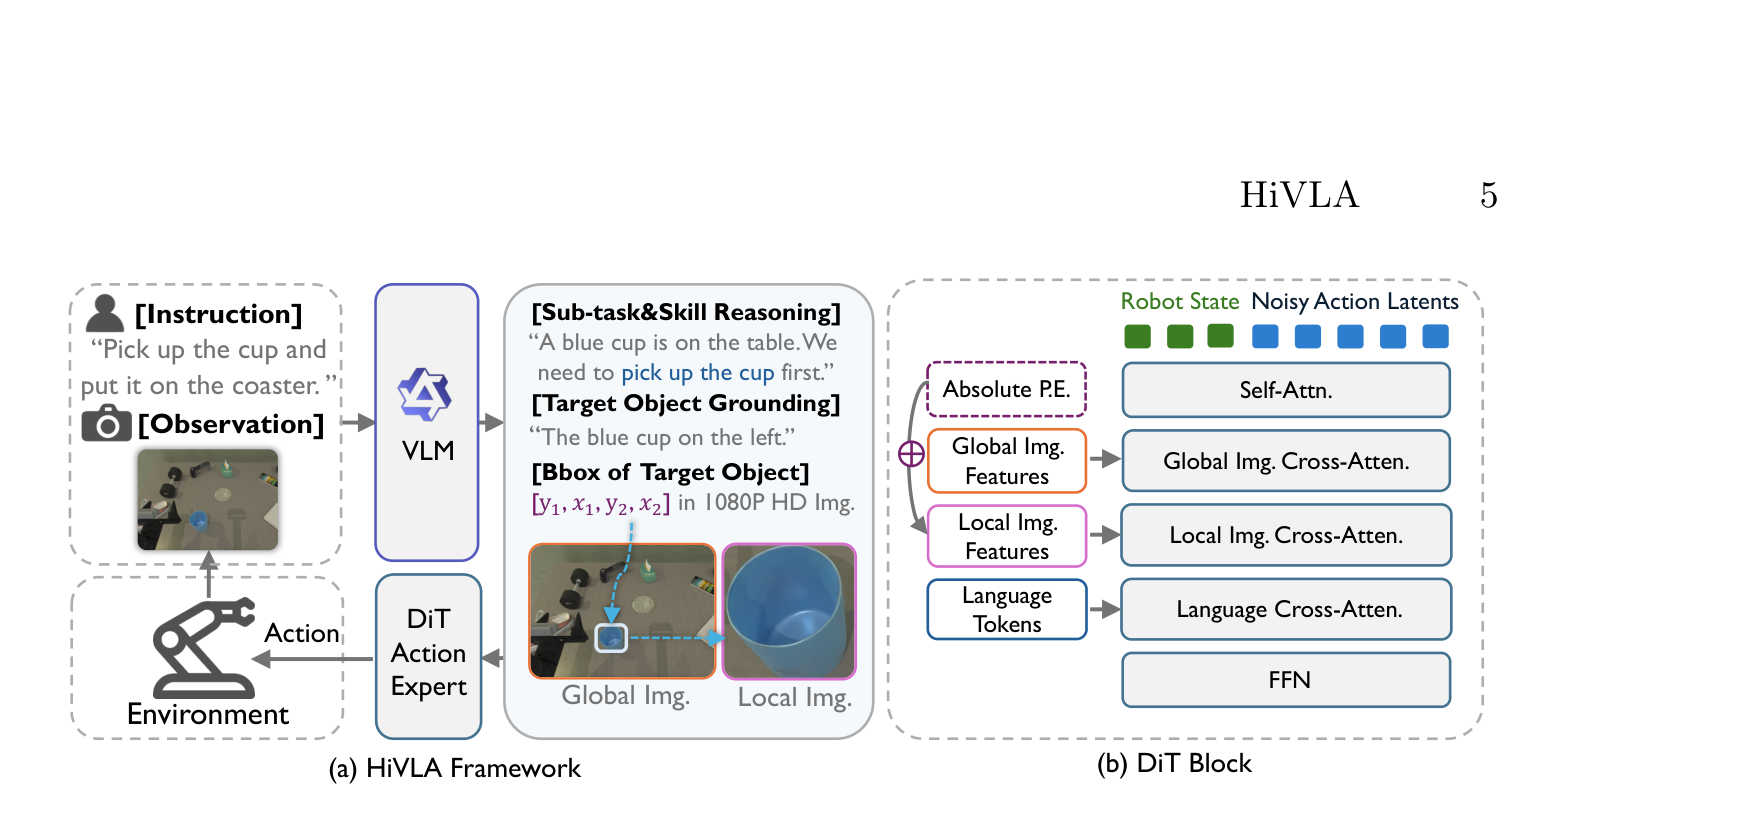
핵심 설계는 하위 모델 안에 있다. DiT action expert의 각 블록이 global 시각 문맥, 고해상도 국소 크롭, subtask 언어를 하나의 cross-attention에 합쳐 받지 않고 세 개의 층으로 나눠 순서대로 받는다. 논문은 이 구조를 cascaded cross-attention이라 부른다.
RoboTwin 2.0 시뮬레이터의 9개 과제에서 전체 평균 성공률 83.3%를 기록했다. 같은 데이터로 fine-tuning한 π0의 45.6%보다 37.7%p, 전역 이미지 특징만 쓰는 H-RDT의 70.6%보다 12.7%p 높다. 실제 로봇에서는 동일한 모양의 물체가 여러 개 놓인 조건에서 baseline이 30회 중 0회 성공하는 반면 HiVLA는 6회에서 7회 성공했다.
배경
end-to-end VLA가 안고 있는 절충
VLA는 웹 규모로 pre-training된 VLM의 인지 능력을 로봇 제어에 옮기려는 모델군이다. 현재 주류는 end-to-end 구조이며 크게 두 계열로 나뉜다.
| 계열 | 대표 모델 | 동작 방식 |
|---|---|---|
| 단일 시스템 | RT-2, OpenVLA | 하나의 네트워크가 감각 입력에서 action 토큰을 자기회귀로 디코딩한다 |
| dual-system VLA | π0, GR00T-N1.5 | VLM backbone이 공동 최적화된 특징 공간을 통해 action expert를 암묵적으로 유도한다 |
두 계열 모두 시각 추론과 저수준 action 생성을 한 모델 안에서 묶는다. 이 구조에는 구조적 병목이 있다. VLM을 상대적으로 희소하고 도메인에 한정된 manipulation 데이터로 fine-tuning하면 원래의 추론 능력이 손상된다. catastrophic forgetting은 새 학습이 기존 능력을 지워버리는 현상을 말하며, VLA 문맥에서는 가장 앞선 VLM의 인지 능력을 끝까지 활용하지 못하게 만드는 원인이 된다.
계층형 구조와 중간 표현의 선택
계층형 시스템은 이 절충을 우회하는 대안이다. VLM을 순수한 상위 계획기로만 쓰면 저수준 fine-tuning을 피할 수 있고, 실행은 전담 action expert가 맡는다. action expert는 상위 모델이 넘긴 계획을 받아 연속 제어 명령을 생성하는 하위 모델을 가리킨다.
이 설계의 성패는 두 모듈을 잇는 중간 표현이 결정한다. 유력한 후보가 visual grounding이다. grounding은 모델 출력을 외부 근거나 물리 세계에 붙들어 매는 것을 뜻하며, VLM 에이전트 문헌의 thinking with images 관점에서 온 발상이다. 복잡한 추론에 들어가기 전에 고해상도 이미지에서 관련 영역을 먼저 명시적으로 지정하는 방식이다.
문제는 지정한 정보를 물리 action으로 옮기는 단계다. 논문은 기존 설계가 공간 문맥과 시각 충실도 사이에서 한쪽을 포기한다고 정리한다.
| 접근 | 대표 | 잃는 것 |
|---|---|---|
| 국소 이미지 크롭만 사용 | InterleaveVLA | 크롭이 원본 좌표계를 벗어나 절대 공간 정보가 사라진다 |
| 축소된 전역 이미지에 마스크 적용 | DexGraspVLA | 정밀 조작에 필요한 미세한 시각 세부가 사라진다 |
| 분할 마스크를 중간 표현으로 사용 | RoboGround | 마스크 생성이 표준 VLM의 기본 능력이 아니라 외부 전문 모델이 필요하다 |
따라서 논문이 세우는 설계 목표는 세 가지를 동시에 확보하는 policy다. 고해상도 국소 외형, 정확한 전역 공간 인식, 그리고 명시적인 skill 수준 지시문이다.
핵심 개념
policy. policy는 현재 observation을 받아 다음 action을 정하는 함수를 말한다. HiVLA에서 policy는 하나의 신경망이 아니라 VLM planner와 DiT action expert 두 모듈이 직렬로 연결된 시스템 전체를 가리킨다.
visual grounding. 지시문이 가리키는 대상을 이미지 안의 구체적인 영역에 대응시키는 작업이다. HiVLA는 이 대응 결과를 정규화 bounding box 하나로 표현하고, 그것을 상위와 하위를 잇는 인터페이스로 삼는다.
subtask. 전체 지시문을 실행 가능한 단위로 쪼갠 중간 명령이다. HiVLA의 subtask는 pick이나 place 같은 primitive skill 하나와 대상 물체 하나를 짝지은 형태를 기본으로 한다. primitive는 로봇이 실행할 수 있는 최소 동작 단위를 가리킨다.
DiT. Diffusion Transformer의 약어로, 확산 과정의 잡음 제거 신경망을 Transformer로 구현한 구조다. HiVLA는 DiT를 action expert의 본체로 쓴다.
flow matching. 단순한 잡음 분포에서 목표 데이터 분포로 향하는 벡터장을 직접 학습하는 생성 모델 계열이다. diffusion model의 여러 단계 잡음 제거 대신 결정론적인 상미분방정식 적분으로 표본을 얻는다.
action chunk. 한 번의 추론으로 한꺼번에 예측하는 연속 action의 묶음이다. HiVLA는 16스텝을 한 묶음으로 낸다.
catastrophic forgetting. 새 학습이 기존 능력을 지워버리는 현상이다. VLA 문맥에서는 좁은 로봇 데이터로 VLM을 fine-tuning할 때 웹 규모 추론 능력이 손상되는 문제를 가리킨다.
방법
문제 설정
논문은 언어 유도 manipulation을 조건부 시퀀스 생성 문제로 세운다. 매 시점 t마다 시스템은 여러 시점의 시각 입력과 로봇의 자기 상태를 받는다.
| 입력 | 내용 |
|---|---|
| 시각 observation | K대의 카메라에서 오는 이미지 집합. 원본 해상도는 1920×1080이다 |
| proprioceptive 상태 | 관절 위치와 그리퍼 상태를 담은 14차원 벡터 |
| 지시문 | 상위 수준의 자연어 명령 하나 |
proprioception은 로봇이 자기 관절의 위치와 힘을 스스로 감지하는 능력을 뜻한다. policy는 이 관찰 이력과 지시문을 받아 예측 구간 H 동안의 action 시퀀스를 낸다. 각 action은 팔과 그리퍼의 목표 제어 명령을 담는다.
논문이 지목하는 어려움은 두 가지다. 첫째, 지시문은 이력에 의존하는 절차를 담고 있어 정교한 추론과 과제 분해가 필요하다. 둘째, 실제 manipulation 장면은 distractor로 어수선하다. distractor는 과제에 함께 노출되지만 풀이에는 필요 없는 물체를 뜻한다. 시스템은 지시문에서 올바른 subtask를 유도하고, 어수선한 배경 속에서 대상을 visual grounding한 뒤, 그 의도를 견고한 action으로 옮겨야 한다.
VLM planner
planner는 시스템의 인지 담당이며 무엇을 할지와 어디를 볼지를 정한다. 매 결정 시점에 다섯 가지 입력을 받는다.
- 전체 목표 지시문
- 현재 상태에서 읽은 그리퍼 상태
- 직전에 실행한 subtask
- 직전 action이 끝난 뒤의 장면 이미지
- 현재 장면 이미지
시각 이력을 함께 주는 이유는 manipulation이 순차 과제이기 때문이다. 무엇이 이미 끝났는지를 알아야 다음 단계를 고를 수 있다.
출력은 네 개의 키를 가진 JSON 객체 하나다. 프롬프트는 추가 설명 없이 이 객체만 내도록 강제한다.
| 키 | 내용 |
|---|---|
next_subtask_description |
다음에 수행할 subtask를 설명하는 문장 |
action_type |
pick 또는 place |
target_object |
대상 물체 이름. pick이면 집을 물체, place면 올려놓을 대상 |
bbox |
[ymin, xmin, ymax, xmax] 형식의 정규화 bounding box. 좌표 범위는 0에서 1000 |
과제 분해의 세밀함은 난이도에 따라 달라진다. 단순한 지시문은 subtask 하나로 끝난다. "블록 세 개를 쌓아라" 같은 long-horizon 과제는 여러 subtask로 나뉜다. long-horizon은 여러 단계를 순차로 완수해야 성공으로 인정되는 긴 과제를 가리킨다.
논문은 planner를 도구를 쓰는 에이전트로 해석한다. bounding box는 단순한 출력값이 아니라 Image Crop 도구를 호출하는 지시로 취급된다. 이 도구가 정규화 좌표를 받아 1920×1080 원본에서 물체 중심의 고해상도 패치를 잘라낸다. subtask 문장과 잘라낸 패치가 함께 하위로 전달되며, action expert 자체도 planner가 의도를 물리 동작으로 옮기기 위해 마지막으로 호출하는 도구로 서술된다.
이 구성의 이점은 두 가지다. pre-training된 VLM의 추론 능력을 그대로 물려받으므로 모든 과제를 일일이 학습시키지 않아도 넓은 범위의 지시문을 다룰 수 있다. 그리고 계획과 제어가 분리되어 있어 두 모듈을 각각 교체하거나 개선할 수 있다.
DiT action expert와 flow matching
action expert는 시스템의 실행 담당이며, 계획을 정밀한 저수준 제어 명령으로 옮긴다. 본체는 조건부 DiT이고, 학습 방식은 Conditional Flow Matching이다.
flow matching은 표준 정규분포에서 뽑은 잡음과 목표 action 시퀀스 사이를 잇는 확률 경로를 정의한다. HiVLA는 가장 단순한 선형 보간 경로를 쓴다. 연속 시간 변수를 0에서 1까지 두면 0에서는 순수 잡음이고 1에서는 목표 action 시퀀스가 된다.
신경망은 잡음에서 데이터로 향하는 벡터장을 예측하도록 학습된다. 손실은 예측 벡터장과 목표 벡터장 사이의 L2 거리다. 여기서 목표 벡터장은 목표 action 시퀀스에서 잡음 표본을 뺀 값이다.
추론은 학습된 벡터장이 정의하는 상미분방정식을 푸는 방식이다. 잡음 표본에서 출발해 전진 오일러법 같은 수치 해법으로 0에서 1까지 적분하면 조건에 맞는 action 시퀀스가 결정론적으로 나온다. 즉 추론 시점에 무작위성이 개입하는 지점은 초기 잡음 표본 하나뿐이다.
cascaded cross-attention
action expert의 핵심 구조는 각 Transformer 블록 안에서 세 종류의 조건을 순서대로 주입하는 cross-attention 층이다. 입력 토큰은 현재 proprioceptive 상태와 잡음이 섞인 미래 action 시퀀스이며, 각각 전용 MLP 어댑터로 은닉 차원에 사영된다. flow matching의 시각 변수는 임베딩으로 부호화한 뒤 Adaptive Layer Normalization으로 각 블록에 주입되어 활성값만 변조하고 특징 표현 자체는 바꾸지 않는다.
| 순서 | 조건 | 출처 | 역할 |
|---|---|---|---|
| 1 | global 시각 문맥 | 여러 시점 이미지를 DINOv2와 SigLIP 결합 인코더로 처리한 토큰 | 장면 전체의 물체 관계와 작업 공간 배치를 거칠게 파악한다 |
| 2 | 위치 인식 국소 특징 | bounding box로 1920×1080 원본에서 잘라낸 패치를 같은 인코더로 처리한 토큰 | 대상 물체의 고해상도 외형과 원본 좌표계 안의 정확한 위치를 제공한다 |
| 3 | subtask 언어 | subtask 문장을 부호화한 언어 임베딩 | pick, place, push 같은 필요 skill의 의미를 지정한다 |
모든 블록을 통과한 뒤 action 시퀀스에 대응하는 hidden state는 MLP 기반 디코더를 거쳐 로봇의 원래 action 공간으로 사상된다. 이 디코더도 시각 임베딩으로 변조된다.
세 조건을 하나의 attention에 합쳐 넣지 않고 층으로 나눈 이유는 주의를 단계적으로 좁히기 위해서다. 장면 전체에서 특정 물체로, 다시 수행할 동작의 의미로 좁혀 들어간다. 이 순서가 실제로 성능을 좌우한다는 근거는 아래 ablation 절에 있다.
절대 위치 정보의 복원
국소 크롭에는 구조적 약점이 있다. 원본 이미지에서 잘라낸 순간 그 패치는 자기가 원래 어디에 있었는지를 잃는다. 동일한 벨 세 개가 놓인 장면에서 왼쪽 벨과 오른쪽 벨의 크롭은 시각적으로 구분되지 않는다.
HiVLA는 이 정보를 명시적으로 되살린다. 크롭 안의 각 패치 토큰에 대해 원본 고해상도 프레임 안에서의 중심 좌표를 계산하고, 그 좌표를 고정 sinusoidal positional encoding으로 바꿔 국소 특징 토큰에 원소별로 더한다. 이 방식은 DETR의 위치 부호화에서 가져왔다.
결과적으로 국소 조건 신호는 대상 물체를 확대한 상세 이미지와 그 물체가 전체 장면 안에서 놓인 정확한 위치를 함께 담는다. 논문은 이 항이 고정밀 manipulation에 결정적이라고 본다.
아키텍처 사양과 학습 설정
action expert의 backbone은 H-RDT를 따르며, RMSNorm과 SwiGLU를 쓰는 LLaMA 계열 Transformer다. backbone은 상위 head가 올라타는 pre-training된 특징 추출 본체를 뜻한다.
| 항목 | 값 |
|---|---|
| 은닉 차원 | 2,176 |
| 층 수 | 16 |
| attention head | 16 (key-value head 8, Grouped Query Attention) |
| 활성화 함수 | SwiGLU |
| 정규화 | LayerNorm, epsilon 1e-5 |
| action chunk 크기 | 16 |
| vision backbone | DINOv2와 SigLIP 결합, 학습 중 동결 |
| 시각과 텍스트 어댑터 | 2층 MLP, SiLU |
| 상태와 action 어댑터 | 3층 MLP, SiLU |
| 상태와 action 차원 | 14 |
| 입력 해상도 | 384×384, 패치 14×14 |
| 최적화 | AdamW, 학습률 1e-4, 상수 스케줄에 500스텝 선형 warmup |
| weight decay | 1e-2 |
| gradient clipping | 1.0 |
| 전체 배치 크기 | 64 (GPU당 32) |
| 혼합 정밀도 | bfloat16 |
| 학습 스텝 | 15만 |
Grouped Query Attention은 여러 query head가 key-value head를 공유해 연산 효율과 성능을 절충하는 attention 구성이다. HiVLA는 query head 16개에 key-value head 8개를 쓴다.
가중치 초기화에는 한 가지 기법이 들어간다. DiT는 EgoDex로 pre-training된 H-RDT 가중치에서 출발하는데, 새로 추가한 국소 이미지 cross-attention 층은 대응하는 사전 가중치가 없다. 논문은 기존 global 이미지 cross-attention 층의 가중치를 그대로 복사해 이 층을 초기화했다. 학습은 NVIDIA H200 GPU 2대에서 PyTorch와 HuggingFace Accelerate로 수행했다.
결과
실험 환경과 데이터셋
시뮬레이터는 RoboTwin 2.0이고, 데이터 생성과 평가 모두 domain randomization 설정을 쓴다. domain randomization은 학습 환경의 시각과 물리 속성을 무작위로 바꿔 policy가 특정 환경에 과적합되지 않게 하는 기법이다. RoboTwin 2.0의 해당 설정은 배경, 어수선한 탁상, 탁자 높이, 조명을 무작위로 바꾸므로 visual grounding 능력이 직접 시험된다.
하드웨어는 시뮬레이션과 실제 양쪽에서 Aloha-Agilex-1.0을 쓴다. 팔 하나당 6자유도에 그리퍼 1자유도씩 더해 전체 14자유도를 가진 양팔 플랫폼이다. 앞서 나온 상태와 action 차원 14는 이 자유도 수와 일치한다.
데이터셋은 RoboTwin 2.0의 Hard 모드에서 생성한 HiVLA-HD다.
| 항목 | 내용 |
|---|---|
| 과제 수 | 15개 |
| 머리 카메라 해상도 | 1920×1080 |
| 손목 카메라 해상도 | 720p |
| 과제당 episode 수 | 필터링 후 약 1,000개 |
| subtask 경계 주석 | action 계획 스크립트가 자동 기록 |
| bounding box 주석 | 시뮬레이터의 고유 마스크 ID에서 직접 유도 |
시뮬레이터를 쓴 덕분에 주석 비용이 들지 않았다는 점이 이 데이터셋의 특징이다. 비교 대상 모델은 전부 같은 데이터셋으로 fine-tuning해 조건을 맞췄다.
비교 대상은 네 가지다.
| 모델 | 성격 | 비교에서 맡는 역할 |
|---|---|---|
| π0 | dual-system VLA | co-training과 병렬 추론으로 인지와 실행을 처리하는 대표 모델 |
| π0.5 | π0의 후속 | open-world 일반화를 강화한 변형 |
| StarVLA | 여러 VLA 아키텍처를 모은 코드베이스 | GR00T-N1.5와 공식 성능이 일치하는 Qwen-GR00T 변형을 사용. HiVLA와 동일한 Qwen3-VL backbone이라 아키텍처 패러다임만 비교된다 |
| H-RDT | 전역 이미지 특징만 쓰는 policy | visual grounding 기법을 뺀 ablation 역할을 겸한다 |
논문은 비교군이 좁은 이유도 밝힌다. 범용 manipulation을 겨냥한 오픈소스 계층형 grounding 시스템이 드물기 때문이다. DexGraspVLA는 다중 물체 grasping에 한정되어 과제 간 일반화가 없고, Gemini Robotics와 HiRobot은 비공개이며, InterleaveVLA는 완결된 계층 시스템이 아니라 물체 중심 policy에 가깝다.
RoboTwin 2.0 본 결과
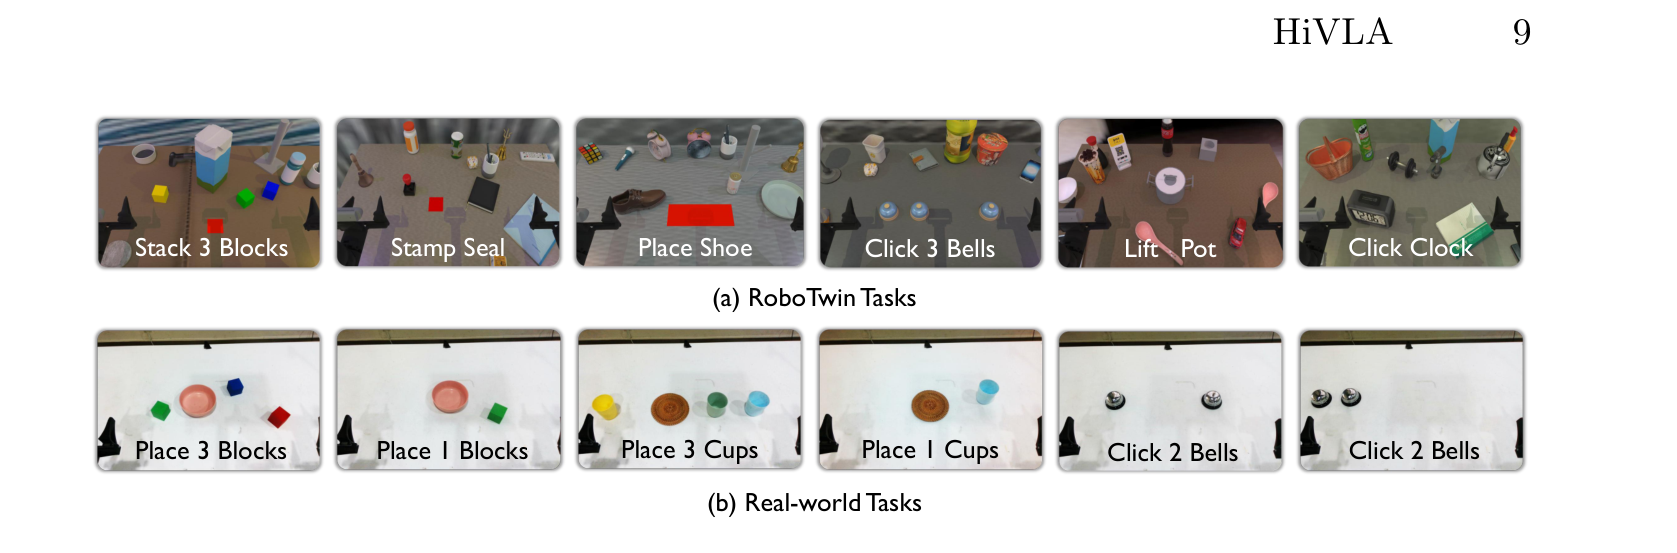
평가는 9개 과제를 Easy 4개와 Hard 5개로 나눠 진행했다. Easy 과제는 벨이나 스테이플러 같은 작은 물체를 정확히 다루는 단일 skill 과제다. Hard 과제는 여러 skill을 순차로 엮거나 고급 공간 추론을 요구한다. Stack 3 Blocks는 정해진 색 순서를 시각으로 추론해야 하고, Click 3 Bells는 동일한 벨 세 개 중에서 left, center, right라는 공간 표현만으로 대상을 골라야 한다.
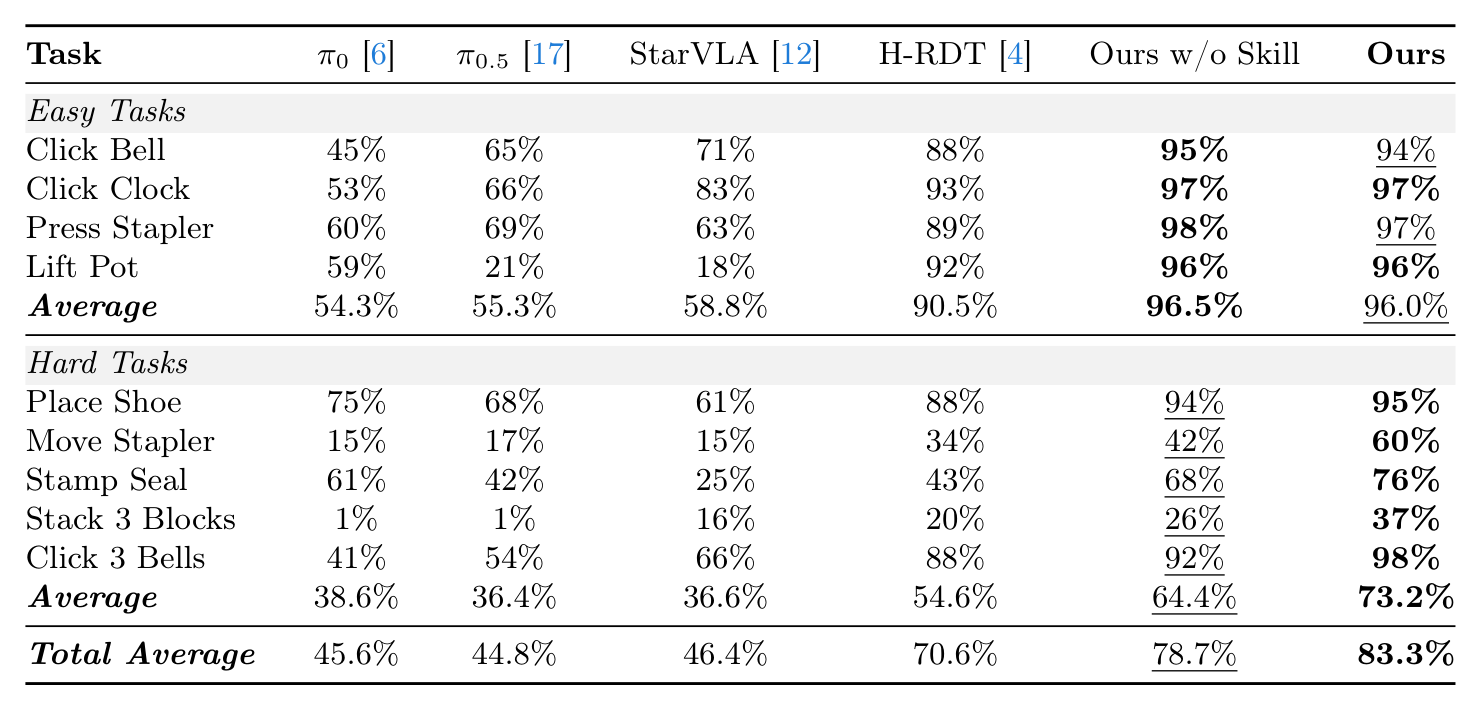
과제마다 학습에 쓰지 않은 환경 구성으로 100회씩 독립 시행했고, 통계적 안정성을 위해 마지막 세 개 체크포인트의 평균 성공률을 보고한다.
| 구분 | 과제 | π0 | π0.5 | StarVLA | H-RDT | Ours w/o Skill | Ours |
|---|---|---|---|---|---|---|---|
| Easy | Click Bell | 45% | 65% | 71% | 88% | 95% | 94% |
| Easy | Click Clock | 53% | 66% | 83% | 93% | 97% | 97% |
| Easy | Press Stapler | 60% | 69% | 63% | 89% | 98% | 97% |
| Easy | Lift Pot | 59% | 21% | 18% | 92% | 96% | 96% |
| Easy | 평균 | 54.3% | 55.3% | 58.8% | 90.5% | 96.5% | 96.0% |
| Hard | Place Shoe | 75% | 68% | 61% | 88% | 94% | 95% |
| Hard | Move Stapler | 15% | 17% | 15% | 34% | 42% | 60% |
| Hard | Stamp Seal | 61% | 42% | 25% | 43% | 68% | 76% |
| Hard | Stack 3 Blocks | 1% | 1% | 16% | 20% | 26% | 37% |
| Hard | Click 3 Bells | 41% | 54% | 66% | 88% | 92% | 98% |
| Hard | 평균 | 38.6% | 36.4% | 36.6% | 54.6% | 64.4% | 73.2% |
| 전체 | 평균 | 45.6% | 44.8% | 46.4% | 70.6% | 78.7% | 83.3% |
HiVLA의 전체 평균은 83.3%다. Easy 과제에서는 96.0%로 H-RDT의 90.5%를 5.5%p 앞선다. 고해상도 물체 중심 크롭이 작은 대상의 시각 세부를 보존한 결과이며, 특히 작은 물체를 다루는 과제에서 차이가 뚜렷하다.
격차는 Hard 과제에서 크게 벌어진다. dual-system VLA 세 종은 모두 40% 미만에 머무르는 반면 HiVLA는 73.2%를 기록해 H-RDT를 18.6%p 앞선다. 논문은 원인을 시간에 걸친 공간 일관성 유지 능력의 차이로 설명한다. end-to-end 모델은 긴 과제에서 지금이 어느 단계인지를 놓치지만, HiVLA는 상위 planner가 진행 상황을 파악하고 대상을 지정하므로 단계가 이어진다.
과제별로 보면 Lift Pot의 편차가 크다. π0.5는 21%, StarVLA는 18%에 그치는 반면 H-RDT는 92%, HiVLA는 96%다. Move Stapler는 모든 모델이 어려워하는 과제이며 HiVLA의 60%도 절대값으로는 낮다.
skill 분해의 기여와 오류 정정 동작
Ours w/o Skill은 subtask 문장 대신 전체 지시문을 그대로 조건으로 준 변형이다. 이 변형과 전체 구성의 차이가 언어 분해의 순수 기여를 보여준다.
| 구분 | Ours w/o Skill | Ours | 차이 |
|---|---|---|---|
| Easy 평균 | 96.5% | 96.0% | 0.5%p 낮음 |
| Hard 평균 | 64.4% | 73.2% | 8.8%p 높음 |
| 전체 평균 | 78.7% | 83.3% | 4.6%p 높음 |
Easy 과제에서는 차이가 사실상 없다. 전체 지시문이 이미 단일 skill과 일치하기 때문이다. Hard 과제에서만 8.8%p 차이가 난다. 하나의 명령이 하나의 동작에 대응하도록 쪼개면 diffusion policy의 부담이 줄고 국소 기하와 실행에 집중할 수 있다는 것이 논문의 해석이다.
논문은 계층 구조에서 관찰된 부수 효과도 보고한다. DiT policy가 grasping에 실패하면 동작만 수행되고 결과가 없는 상태가 되는데, 논문은 이를 phantom execution이라 부른다. 이때 planner는 subtask가 아직 끝나지 않았음을 인식하고 같은 시각 언어 명령을 다시 내보낸다. planner가 독립적인 의미 감독자 역할을 하므로 시스템이 skill을 재시도한다. 단일 모델로 묶인 VLA에서는 나타나지 않는 동작이다.
planner 오류에 대한 robustness
계층형 시스템에 흔히 제기되는 비판은 상위 오류가 하위로 누적되어 전체를 무효화한다는 점이다. 논문은 추론된 bounding box와 언어 지시문에 조정된 잡음을 주입해 이 우려를 직접 검증했다.
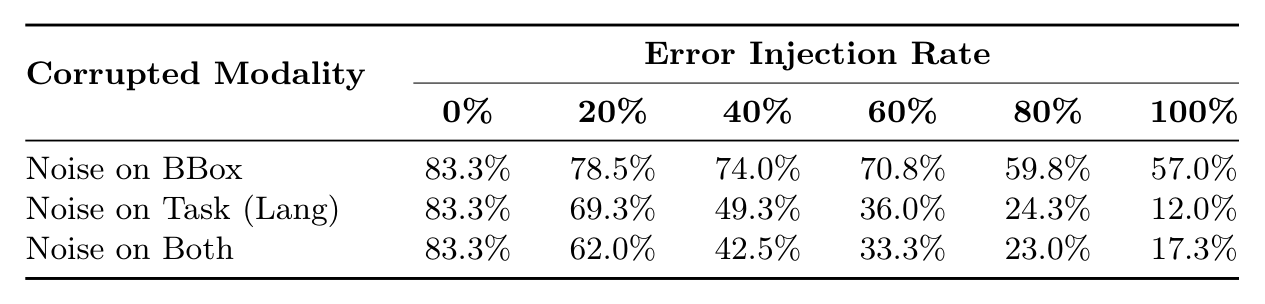
| 교란 대상 | 0% | 20% | 40% | 60% | 80% | 100% |
|---|---|---|---|---|---|---|
| bounding box에 잡음 | 83.3% | 78.5% | 74.0% | 70.8% | 59.8% | 57.0% |
| subtask 언어에 잡음 | 83.3% | 69.3% | 49.3% | 36.0% | 24.3% | 12.0% |
| 양쪽 모두 | 83.3% | 62.0% | 42.5% | 33.3% | 23.0% | 17.3% |
두 모달리티의 반응이 뚜렷하게 갈린다. bounding box를 100% 어긋나게 해도 성공률이 57.0%로 유지된다. policy가 global 이미지 특징을 보조 단서로 써서 실제 대상을 스스로 찾아내기 때문이다. 즉 공간 정보에 대해서는 상위 오류를 하위가 흡수한다.
반면 언어에 주입한 오류는 성공률을 주입 비율에 거의 비례해 떨어뜨린다. 100% 오류에서 12.0%까지 낮아진다. 논문은 이를 결함이 아니라 설계 의도의 확인으로 읽는다. policy가 언어 명령을 엄격히 따른다는 뜻이며, 시각 적응성과 언어 준수가 동시에 성립한다는 근거다.
세 번째 행이 두 번째 행보다 100% 지점에서 오히려 높은 점(17.3% 대 12.0%)은 논문이 따로 설명하지 않는다.
실제 로봇 평가
실제 환경 평가는 7개 물체 범주와 16개 세부 시나리오를 포함한다. 쉬운 과제를 고르는 대신 환경 간 일반화와 지시문 준수를 시험하도록 설계했다. 색과 공간 배치가 다양한 다중 물체 조합에서 특정 대상 하나를 고르는 형태가 중심이며, 지시문은 빨간 블록이나 초록 컵처럼 속성으로 대상을 지정한다.
학습과 평가 절차는 다음과 같다.
| 항목 | 내용 |
|---|---|
| 학습 데이터 | teleoperation으로 수집한 360개 episode |
| bounding box 주석 | GroundingDINO와 SAM2로 자동 생성 |
| 초기화 | H-RDT와 HiVLA 모두 시뮬레이션 학습 체크포인트에서 출발 |
| 추가 학습 | 실제 데이터로 8만 스텝 fine-tuning |
| 평가 | 과제마다 30회 시행, 물체 위치를 매번 무작위화 |
teleoperation은 사람이 원격으로 로봇을 조종해 시연 데이터(demonstration)를 만드는 방식을 뜻한다.
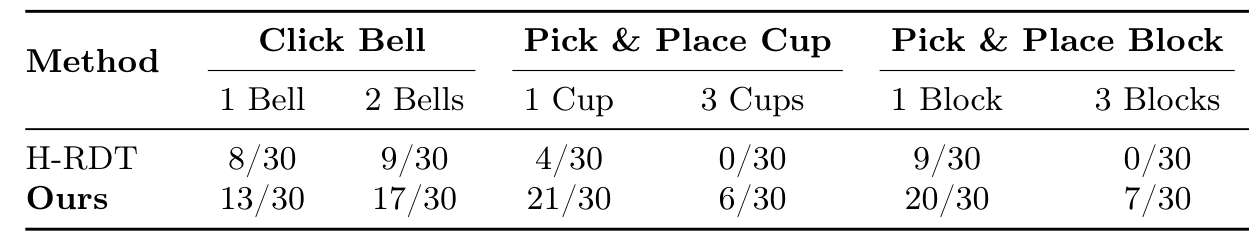
| 방법 | Click 1 Bell | Click 2 Bells | Place 1 Cup | Place 3 Cups | Place 1 Block | Place 3 Blocks |
|---|---|---|---|---|---|---|
| H-RDT | 8/30 | 9/30 | 4/30 | 0/30 | 9/30 | 0/30 |
| HiVLA | 13/30 | 17/30 | 21/30 | 6/30 | 20/30 | 7/30 |
H-RDT는 단일 물체 조건에서만 어느 정도 동작하고 다중 물체 조건인 3 Cups와 3 Blocks에서는 30회 중 0회 성공에 그친다. 전역 시각 특징만으로는 같은 모양의 물체를 색이나 공간 표현으로 구별하지 못하기 때문이다.
HiVLA는 같은 조건에서 각각 6회와 7회 성공했다. 절대 수치는 낮지만 baseline이 완전히 실패하는 구간에서 동작한다는 점이 논문의 주장이다. 단일 물체 조건에서도 Place 1 Cup이 4/30에서 21/30으로, Place 1 Block이 9/30에서 20/30으로 올랐다. 논문은 계층 분리가 DiT action expert에서 전역 추론 부담을 덜어내 희소한 실제 데이터를 국소 시각 언어 조건에 효율적으로 대응시킬 수 있게 한다고 설명한다.
ablation
ablation은 조건 주입 순서와 visual grounding 구성 요소 두 가지를 다룬다.
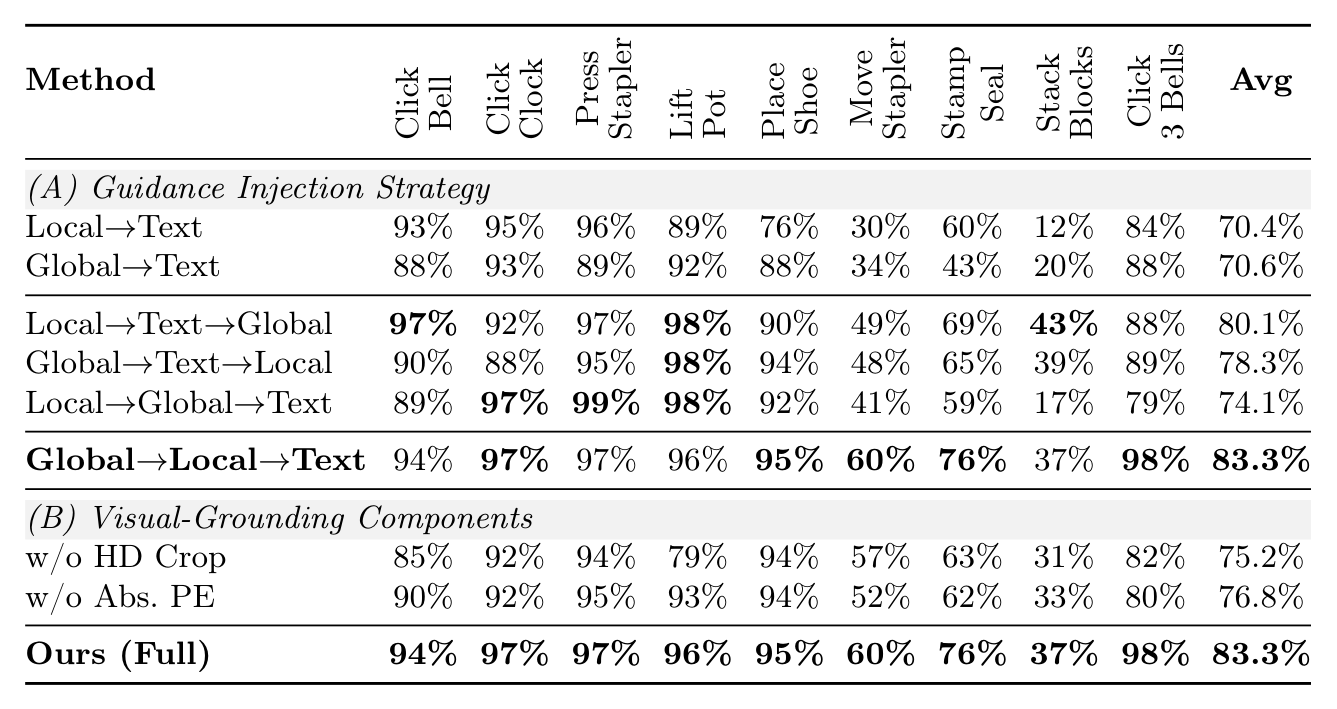
| 구분 | 방법 | 평균 |
|---|---|---|
| (A) 주입 순서 | Local → Text | 70.4% |
| (A) 주입 순서 | Global → Text | 70.6% |
| (A) 주입 순서 | Local → Text → Global | 80.1% |
| (A) 주입 순서 | Global → Text → Local | 78.3% |
| (A) 주입 순서 | Local → Global → Text | 74.1% |
| (A) 주입 순서 | Global → Local → Text | 83.3% |
| (B) 구성 요소 | 고해상도 크롭 제거 | 75.2% |
| (B) 구성 요소 | absolute positional encoding 제거 | 76.8% |
| (B) 구성 요소 | 전체 구성 | 83.3% |
(A)의 첫 두 행은 시각 조건을 하나만 쓴 경우다. 국소만 쓰든 전역만 쓰든 70% 근처에 머문다. 둘을 함께 쓰면 넓은 환경 파악과 대상 지정이 동시에 가능해져 74.1%에서 83.3% 구간으로 올라간다.
순서 사이의 차이도 작지 않다. 가장 좋은 Global → Local → Text가 83.3%이고 가장 나쁜 Local → Global → Text가 74.1%로 9.2%p 차이가 난다. 세 조건의 종류가 같아도 배치 순서만으로 이만큼 갈린다. 논문은 전역에서 국소로, 다시 언어로 좁혀가는 coarse-to-fine 구성이 DiT의 주의를 단계적으로 좁히기 때문이라고 해석한다.
(B)의 두 항목은 서로 다른 과제에서 효과를 보인다.
| 제거 대상 | 가장 크게 영향받는 과제 | 변화 |
|---|---|---|
| 고해상도 크롭 (640×360으로 축소한 이미지에서 크롭) | Lift Pot | 96%에서 79%로 하락 |
| absolute positional encoding | Click 3 Bells | 98%에서 80%로 하락 |
Lift Pot은 얇은 손잡이를 잡아야 하는 과제라 해상도가 낮아지면 그 구조가 보이지 않는다. Click 3 Bells는 동일한 벨 세 개를 위치로 구별해야 하는 과제라 절대 위치 정보가 사라지면 대상을 특정할 수 없다. 두 요소가 각각 시각 충실도와 공간 정보라는 서로 다른 문제를 담당한다는 뜻이다.
VLM planner 자체 평가
planner는 Qwen3-VL을 쓴다. 평가용으로 HiVLA-HD에서 21만 개 대화 인스턴스를 만들어 8대 2로 학습과 평가에 나눴다. fine-tuning은 H200 GPU 2대에서 배치 크기 4, 학습률 1e-5로 3 epoch 수행했다.
측정 지표는 두 가지다. grounding은 예측 bounding box의 mIoU로 재고, subtask 예측은 필요 skill과 대상 물체 이름을 모두 맞혀야 성공으로 치는 엄격한 일치 기준으로 잰다.
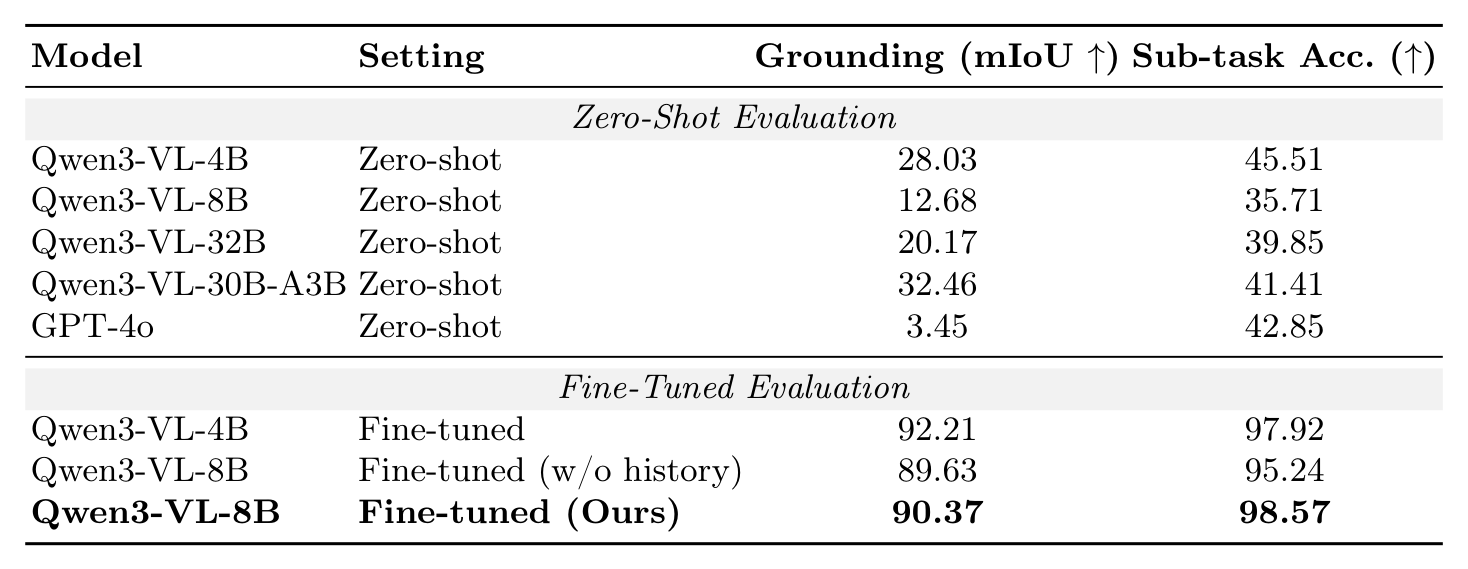
| 모델 | 설정 | grounding mIoU | subtask 정확도 |
|---|---|---|---|
| Qwen3-VL-4B | zero-shot | 28.03% | 45.51% |
| Qwen3-VL-8B | zero-shot | 12.68% | 35.71% |
| Qwen3-VL-32B | zero-shot | 20.17% | 39.85% |
| Qwen3-VL-30B-A3B | zero-shot | 32.46% | 41.41% |
| GPT-4o | zero-shot | 3.45% | 42.85% |
| Qwen3-VL-4B | fine-tuning | 92.21% | 97.92% |
| Qwen3-VL-8B | fine-tuning, 시각 이력 제거 | 89.63% | 95.24% |
| Qwen3-VL-8B | fine-tuning (채택 구성) | 90.37% | 98.57% |
zero-shot 성적만으로는 정밀한 long-horizon manipulation에 부족하다. GPT-4o는 subtask 정확도 42.85%로 경쟁력이 있지만 공간 grounding은 3.45% mIoU에 그친다. 의미 추론과 공간 지정이 서로 다른 능력이라는 점이 이 대비에서 드러난다.
도메인 데이터로 가볍게 fine-tuning하면 성적이 크게 오른다. 채택 구성인 8B 모델은 mIoU 90.37%와 subtask 정확도 98.57%를 기록했다. 4B 모델도 mIoU 92.21%로 8B와 비슷한 수준에 도달한다.
시각 이력을 제거하면 subtask 정확도가 98.57%에서 95.24%로 낮아진다. 과거 관찰이 과제 진행 상황 파악과 대상 구별에 필요하다는 근거다.
논문은 planner 교체 가능성을 설계상의 이점으로 든다. 도메인별 경량 fine-tuning을 하거나, zero-shot 성능이 충분해지면 기성 VLM을 그대로 붙일 수 있다. 더 큰 모델의 zero-shot 성적이 꾸준히 오르는 추세이므로 시스템이 그 향상을 그대로 물려받는다는 것이 저자들의 전망이다.
지연 시간과 control frequency
계층 구조는 느린 시각 언어 추론과 빠른 모터 제어 사이의 주기 불일치를 asynchronous inference로 해소한다. asynchronous inference는 상위 계획기와 하위 제어기가 서로의 완료를 기다리지 않고 각자의 주기로 동작하는 실행 방식을 말한다.
| 구성 요소 | 지연 |
|---|---|
| VLM planner 추론 1회 | 1.9초 (최적화 이전) |
| DiT policy의 16스텝 action chunk 추론 | 0.162초 |
| 시스템 control frequency | 8Hz |
control frequency는 로봇이 1초에 몇 번 새로운 action을 갱신하는지를 뜻한다. HiVLA는 8Hz로 동작하므로 1초에 8번 새로운 제어 명령을 낸다. 의미 계획기를 제어 policy와 병렬로 실행하고 실시간 추적으로 시간 일관성을 유지해 이 수치를 달성했다. planner 한 번의 1.9초 동안 제어 쪽은 멈추지 않고 이전 계획으로 계속 동작한다.
한계
논문은 별도의 한계 절을 두지 않는다. 본문에서 확인되는 제약은 다음과 같다.
- planner 지연. VLM planner 1회 추론이 1.9초다. 논문 스스로 최적화 이전 수치이며 소프트웨어 가속 여지가 크다고 적는다.
- 언어 오류에 대한 취약성. bounding box 잡음에는 견디지만 subtask 언어 오류는 성공률을 거의 비례해 낮춘다. planner의 subtask 예측 정확도가 시스템 전체의 상한을 정한다.
- 채택 구성이 fine-tuning에 의존한다. zero-shot grounding 성적이 낮아 본문 평가는 모두 도메인 데이터로 fine-tuning한 8B 모델을 쓴다. 기성 VLM을 그대로 붙이는 경로는 가능성으로만 제시된다.
- 평가 범위. 하드웨어는 Aloha-Agilex-1.0 양팔 플랫폼 한 종이고, 실제 로봇 과제는 벨, 컵, 블록을 다루는 7개 물체 범주다. 다른 embodiment로의 이전은 다루지 않는다.
- 비교군의 제약. 오픈소스 계층형 grounding 시스템이 드물어 직접적인 동종 비교가 빠져 있다. 가장 가까운 비교는 grounding을 뺀 H-RDT다.
- 실제 로봇 절대 성능. 다중 물체 조건 성공률은 3 Cups에서 6/30, 3 Blocks에서 7/30으로 낮다. baseline 대비 우위는 분명하지만 실용 수준과는 거리가 있다.
- 코드 공개. 프로젝트 페이지의 코드 링크는 공개 예정 상태다.
핵심 용어
| 용어 | 뜻 |
|---|---|
| visual-grounded-centric | VLM이 낸 bounding box와 그로부터 잘라낸 고해상도 크롭을 상위와 하위를 잇는 주 인터페이스로 삼는 설계 관점 |
| cascaded cross-attention | DiT 블록 하나 안에서 global 이미지, 국소 이미지, 언어를 각각 별도의 cross-attention 층으로 순서대로 주입하는 구조 |
| Image Crop 도구 | planner가 낸 정규화 bounding box를 인자로 받아 1920×1080 원본에서 물체 중심 패치를 잘라내는 도구. bounding box를 출력값이 아니라 tool call 지시로 취급한다 |
| absolute positional encoding | 크롭 안 패치 토큰의 원본 프레임 기준 중심 좌표를 고정 sinusoidal 임베딩으로 바꿔 국소 특징에 더하는 항 |
| HiVLA-HD | RoboTwin 2.0 Hard 모드에서 생성한 자체 데이터셋. 15개 과제, 머리 카메라 1920×1080, 과제당 약 1,000 episode |
| phantom execution | DiT policy가 grasping에 실패해 동작만 수행되고 결과가 없는 상태. planner가 이를 인식해 같은 subtask를 재발행한다 |
관련 페이지
- HiVLA: A Visual-Grounded-Centric Hierarchical Embodied Manipulation System (프로젝트 페이지): 같은 연구의 공식 프로젝트 페이지. 초록과 대표 도식, 시뮬레이션 결과 표만 싣는다
- Cortex: A Bidirectionally Aligned Embodied Agent Framework for Long-horizon Manipulation: subtask를 인터페이스로 삼는 또 다른 계층형 시스템. HiVLA가 bounding box를 함께 넘기는 데 비해 Cortex는 skill primitive 목록과 누적 메모리를 쓴다
- π0: A Vision-Language-Action Flow Model for General Robot Control: 비교 대상 π0. flow matching action expert를 쓰는 dual-system VLA의 기준선
- π0.5: a Vision-Language-Action Model with Open-World Generalization: 비교 대상 π0.5. subtask 문장과 bounding box를 pre-training 과제로 함께 학습하는 접근
- GR00T N1.5: StarVLA의 Qwen-GR00T 변형이 성능을 맞춘 대상 모델
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control: 단일 시스템 VLA의 대표. HiVLA가 우회하려는 end-to-end 구조의 원형
- OpenVLA: An Open-Source Vision-Language-Action Model: 단일 시스템 VLA의 오픈소스 구현
- OpenHelix: A Short Survey, Empirical Analysis, and Open-Source Dual-System VLA Model for Robotic Manipulation: dual-system VLA 설계 공간을 정리한 조사. HiVLA가 택한 명시적 분리의 위치를 가늠할 수 있다
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware: 실험에 쓰인 Aloha 양팔 플랫폼과 action chunking의 출처
- 용어집: Physical AI (Terminology Glossary): 이 페이지의 전문 용어 표기 기준